Darwin-180B-RSI, 허깅페이스 공식 리더보드 5관왕 — 엔지니어 관점 해설
모델: FINAL-Bench/Darwin-180B-RSI · Hugging Face
개발: 비드래프트(VIDRAFT)
공개: 2026-09-28
0. 요약
- 무엇을 했나
- 공개 모델 Qwen3.8-Flash-Next(180B MoE)의 파라미터를 약 0.02%만 바꿨습니다.
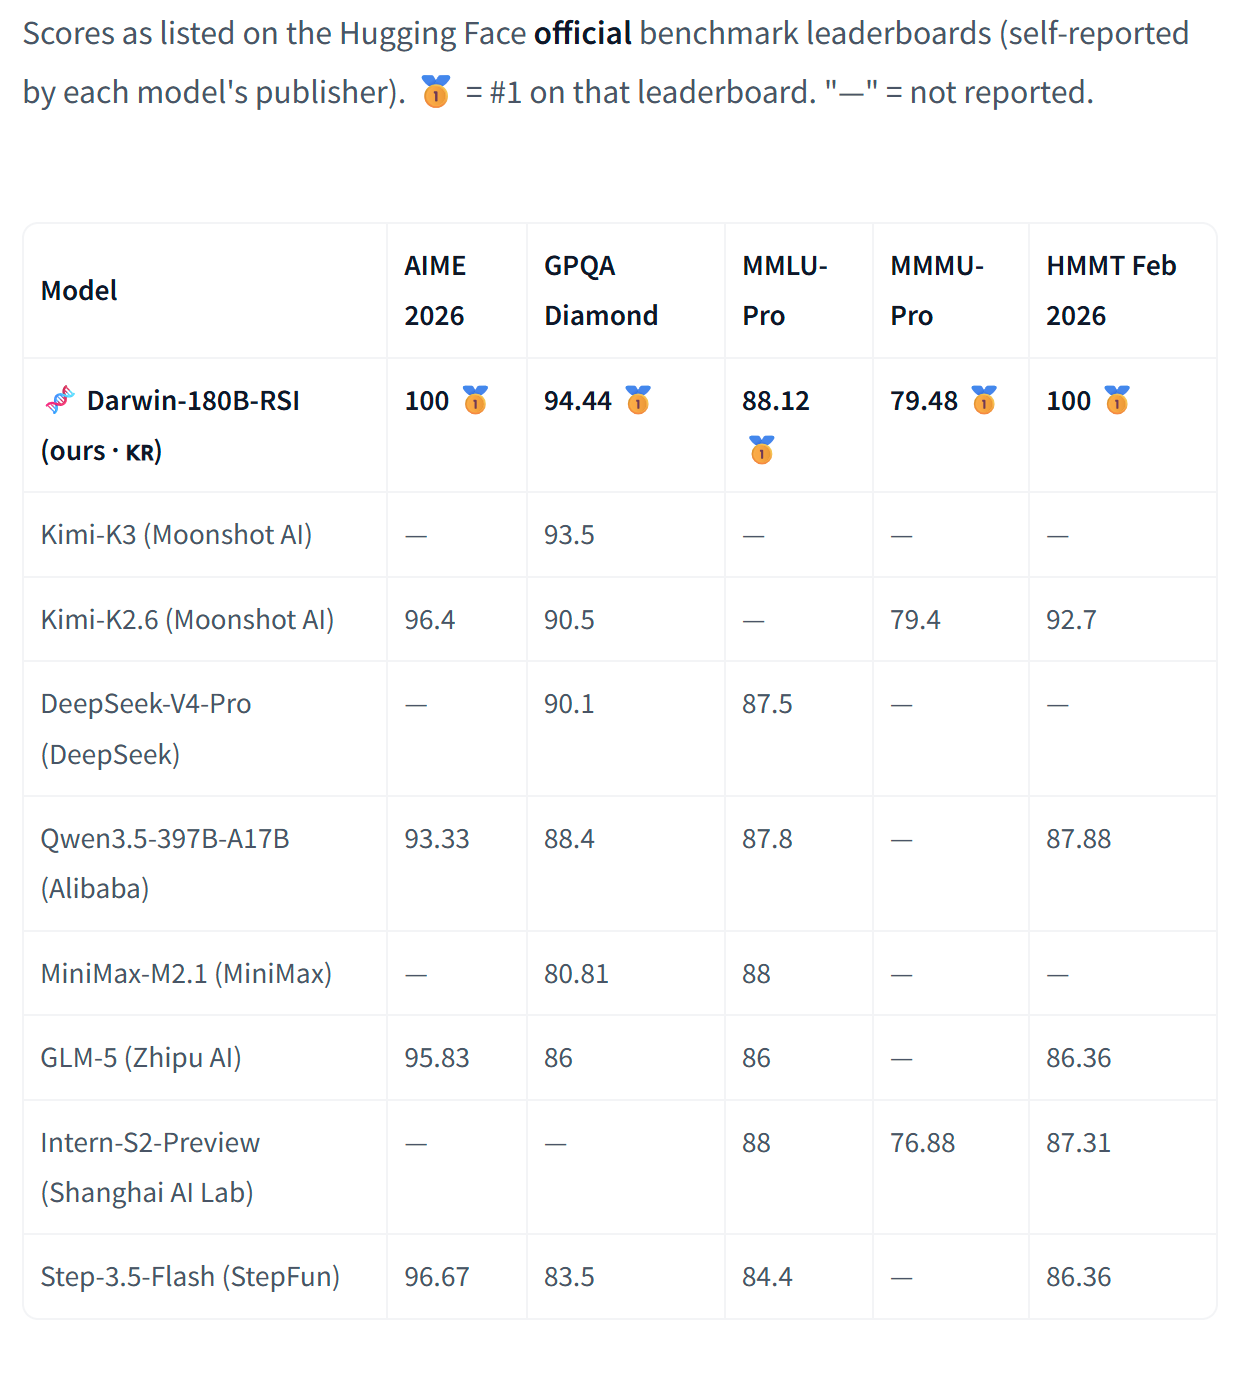
- 그 결과 허깅페이스가 「공식 벤치마크」로 지정한 리더보드 5곳에서 동시에 1위를 했습니다.
- 대상: 수학 2종, 과학 1종, 종합지식 1종, 시각추론 1종.
- 어떻게 했나
- 모델이 스스로 문제를 풀고, 검증 가능한 정답으로 채점한 뒤, 맞은 풀이로 자신을 다시 학습시켰습니다.
- 이 과정이 **재귀적 자가개선(RSI, Recursive Self-Improvement)**입니다.
- 사람이 새로 만든 정답 라벨은 쓰지 않았습니다.
- 의미
- 거대 모델을 처음부터 학습하는 데 드는 수천억 원 규모의 자원이 없어도, 공개 모델을 정밀하게 진화시켜 세계 최상위 성능에 닿을 수 있음을 보였습니다.
- AIME 2026과 HMMT Feb 2026에서는 리더보드 역사상 **처음으로 만점(100%)**이 기록됐습니다.
1. 결과
| 벤치마크 | 분야 | 문항 수 | Darwin-180B-RSI | 이전 1위 | 차이 |
|---|---|---|---|---|---|
| AIME 2026 | 올림피아드 수학 | 30 | 100.0 | 97.1 | +2.9 |
| HMMT Feb 2026 | 올림피아드 수학 | 30 | 100.0 | 92.7 | +7.3 |
| GPQA Diamond | 대학원 과학 | 198 | 94.44 | 93.5 | +0.94 |
| MMLU-Pro | 14개 분야 종합지식 | 12,032 | 88.12 | 88.0 | +0.12 |
| MMMU-Pro (vision) | 이미지 속 대학 문제 | 1,730 | 79.48 | 79.4 | +0.08 |
측정 방식
| 벤치마크 | 문항당 풀이 수 | 보고 값 | 1회 평균 |
|---|---|---|---|
| AIME 2026 | 16 | 다수결 | 98.75 |
| HMMT Feb 2026 | 16 | 다수결 | 96.59 |
| GPQA Diamond | 최대 16 | 다수결 | — |
| MMLU-Pro | 1 | 1회 풀이 | 88.12 |
| MMMU-Pro | 3 | 다수결 | — |
- 공통 설정: 생각 예산 131,072 토큰, temperature 1.0, top_p 0.95, top_k 20, 정밀도 bf16.
- 모든 벤치마크에서 같은 샘플링 설정을 썼습니다. 벤치마크마다 따로 튜닝하지 않았습니다.
2. 다섯 벤치마크는 무엇을 재나
2.1 AIME 2026 — 미국 수학 올림피아드 예선
- AIME(American Invitational Mathematics Examination)는 미국 수학 올림피아드(USAMO)로 가는 관문 시험입니다.
- 답은 0~999 사이 정수 하나이고, 부분 점수는 없습니다.
- 추측으로 맞힐 확률이 사실상 0이라, 끝까지 정확하게 추론했는지를 그대로 드러냅니다.
- 2026년 문제는 대부분의 모델 학습 데이터가 만들어진 뒤에 출제됐습니다. 그래서 데이터 오염(암기) 가능성이 낮은 시험으로 평가받습니다.
2.2 HMMT February 2026 — 하버드·MIT 수학 대회
- 하버드와 MIT 학생들이 주관하는, 세계에서 가장 어려운 고교 수학 대회 중 하나입니다.
- AIME보다 한 단계 높은 난도로 알려져 있으며, 대수·기하·조합·정수론을 두루 다룹니다.
- 기존 1위가 92.7점이었는데, 이번에 7.3점 차 만점을 기록했습니다. 다섯 부문 중 가장 큰 격차입니다.
2.3 GPQA Diamond — 박사급 과학
- 물리·화학·생물 박사들이 직접 출제한 198문항입니다.
- 이름 그대로 「구글로 검색해도 풀 수 없는」(Google-Proof) 문제들입니다. 해당 분야 박사도 정답률이 약 65%에 그칩니다.
- 94.44%는 전문가 평균을 약 30%p 웃도는 수준입니다.
2.4 MMLU-Pro — 종합 지식
- 기존 MMLU의 후속판입니다. 보기를 4개에서 10개로 늘려 찍어서 맞힐 확률을 크게 낮췄습니다.
- 추론이 필요한 문제의 비중도 높였습니다.
- 법·의학·공학·경제·심리 등 14개 분야, 12,032문항으로 폭넓은 지식과 추론의 균형을 봅니다.
- 이번 결과는 1회 풀이로 얻은 값입니다. 다수결 없이 1위를 했다는 점에서 기본 실력을 그대로 보여 줍니다.
2.5 MMMU-Pro (vision) — 이미지 속 문제
- 문제 글이 따로 주어지지 않고, 문제 자체가 이미지 안에 들어 있습니다. 차트, 악보, 의료 영상, 회로도, 지도 등입니다.
- 모델은 글자를 읽는 것(OCR)과 시각 정보를 해석하는 것, 그리고 추론을 한 번에 해내야 합니다.
- 30개 과목, 1,730문항입니다.
- 이번 개선은 언어 쪽만 손봤고 비전 인코더는 건드리지 않았습니다. 그런데도 시각추론 1위가 나왔습니다. 추론 능력의 개선이 모달리티를 넘어 옮겨 갔다는 뜻입니다.
3. 허깅페이스 공식 리더보드는 어떻게 움직이나
- 허깅페이스는 2026년부터 일부 벤치마크 데이터셋에
benchmark:official태그를 붙여 공식 리더보드를 운영합니다. - 모델 개발사가 자기 모델 저장소에 평가 결과 파일(
.eval_results/*.yaml)을 올리면, 해당 데이터셋의 리더보드에 자동으로 반영됩니다. - 파일에는 데이터셋, 과제, 점수, 측정일, 측정 방식 설명이 들어갑니다.
- 전 세계 연구소와 기업이 같은 방식으로 등재합니다. 그래서 이 보드들은 오픈·클로즈드 모델을 통틀어 최신 성능을 한눈에 비교하는 사실상의 기준점이 되고 있습니다.
- Darwin-180B-RSI는 전체 측정 프로토콜을 모델 카드에 공개했습니다. 누구나 같은 조건으로 다시 재 볼 수 있습니다.
4. 기반 모델: 180B MoE 구조 이해하기
4.1 MoE(Mixture of Experts)란
- 일반 모델(Dense)은 토큰 하나를 처리할 때 모든 파라미터를 씁니다.
- MoE 모델은 층마다 여러 「전문가(Expert)」 네트워크를 두고, 라우터가 토큰마다 일부 전문가만 골라 계산합니다.
- 그래서 전체 파라미터는 180B로 크지만, 토큰 하나에 실제로 쓰이는 계산량은 훨씬 작습니다. 큰 지식 용량과 빠른 추론을 함께 얻는 구조입니다.
4.2 Qwen3.8-Flash-Next의 구성
| 구성 요소 | 역할 |
|---|---|
| 라우팅 전문가 512개 | 분야별 지식과 패턴 저장. 토큰마다 일부만 활성화 |
| 공유 전문가 | 모든 토큰이 거치는 공통 처리 경로 |
| 라우터 | 토큰을 어느 전문가에게 보낼지 결정 |
| 어텐션 (하이브리드) | 문맥 전체를 연결. 긴 추론의 흐름을 유지 |
| 비전 인코더 | 이미지를 모델이 이해하는 표현으로 변환 |
5. 0.02%만 바꿨다 — 무엇을, 왜
5.1 바꾼 곳과 그대로 둔 곳
| 부분 | 바꿨나 | 이유 |
|---|---|---|
| 어텐션 |  |
추론의 흐름과 길이를 결정하는 핵심 경로 |
| 공유 전문가 | |
모든 토큰이 지나가는 길이라 적은 변경으로 효과가 큼 |
| 라우팅 전문가 512개 |  |
부모 모델이 쌓은 지식 보존 |
| 라우터 | |
전문가 선택 분포를 안정적으로 유지 |
| 비전 인코더 | |
시각 인식 능력 보존 |
5.2 왜 이 방식이 효율적인가
- 지식은 이미 충분합니다. 180B 부모 모델은 이미 방대한 지식을 갖고 있습니다. 부족했던 것은 지식이 아니라 그 지식을 끝까지 정확하게 꺼내 쓰는 추론 습관이었습니다.
- 추론 습관은 공통 경로에 있습니다. 얼마나 깊이 생각하고, 언제 검산하고, 언제 결론을 내릴지는 모든 토큰이 거치는 어텐션과 공유 전문가에서 주로 결정됩니다.
- 전문가를 건드리면 위험합니다. 라우팅 전문가나 라우터를 바꾸면 전문가 선택 분포가 흔들립니다. 그러면 특정 분야 성능이 예측 못 하게 떨어질 수 있습니다.
5.3 결과: 더 짧게 생각하고 같은 정확도
- 부모 모델과 비교해 정확도는 같고, 추론 길이는 약 11% 짧습니다.
- 추론 길이가 줄면 응답 시간과 추론 비용(GPU 사용 시간)이 그만큼 줄어듭니다.
- 즉 이번 개선은 점수만이 아니라 실서비스의 효율도 함께 높였습니다.
6. RSI — 재귀적 자가개선
6.1 개념
┌────────────────────────────────────────────┐
│ ① 모델이 연습 문제를 여러 번 풉니다          │
│ ② 검증 가능한 정답으로 채점합니다            │
│    (수학 정답 · 코드 실행 결과 · 정답표)     │
│ ③ 맞은 풀이만 골라 냅니다                    │
│ ④ 그 풀이로 모델을 다시 학습시킵니다         │
│ ⑤ 더 나아진 모델이 다음 바퀴를 돕니다 ─────┐ │
└──────────────────────────────────────────┴─┘
6.2 왜 중요한가
- 사람 라벨 병목 해소: 기존 방식은 전문가가 모범 답안을 써 줘야 했습니다. 박사급 문제일수록 비용과 시간이 기하급수적으로 늘어납니다. RSI는 검증만 가능하면 모델이 스스로 교재를 만듭니다.
- 확장성: 검증기만 있으면 수학·과학·코드 등 어느 분야로든 루프를 넓힐 수 있습니다.
- 자기 강화: 개선된 모델은 더 어려운 문제를 풀 수 있고, 그 풀이가 다시 다음 학습 재료가 됩니다.
6.3 공정성 장치
- 학습에 쓴 문제와 벤치마크 시험 문제는 서로 겹치지 않습니다.
- 시험 문제로 학습하거나 시험 문제를 보고 설정을 고르는 일은 없습니다.
6.4 RSI는 업계의 최전선
- 글로벌 선도 연구소들이 공통으로 「다음 단계」로 꼽는 주제가 모델이 스스로를 개선하는 능력입니다.
- Darwin-180B-RSI는 이 개념을 공개 모델과 공개 벤치마크로 실증한 사례입니다.
7. Darwin 프레임워크
- Darwin은 비드래프트의 「진단 후 진화」 모델 개발 프레임워크입니다(arXiv:2605.14386).
- 부모 모델의 약점을 먼저 진단하고, 필요한 부분만 골라 진화시켜 더 강한 자식 모델을 만듭니다.
- 허깅페이스에서 Darwin 계열은 공식 모델 50종 이상, 커뮤니티 파생 모델 400종 이상으로 성장했습니다.
- 이전 세대인 Darwin-397B-ZTC도 GPQA Diamond 리더보드 3위에 올라 있습니다. 1위와 3위를 한 계열이 함께 차지하고 있는 셈입니다.
8. 평가에서 얻은 엔지니어링 통찰
8.1 「잘림」은 「틀림」이 아니다
- 부모 모델이 AIME 2026에서 놓친 문제를 분석해 보니, 틀린 답을 낸 것이 아니었습니다. 생각 토큰이 모자라 결론에 도달하지 못한 경우였습니다.
- 생각 예산을 131K 토큰으로 넓히자 이 문제들이 풀렸습니다.
- 실무 팁:
- 추론 모델의 벤치 점수가 기대보다 낮으면, 모델을 바꾸기 전에 먼저
finish_reason == "length"비율을 확인하십시오. - 잘린 응답은 채점기가 오답으로 처리합니다. 그래서 실제 능력이 과소평가됩니다.
- 추론 모델의 벤치 점수가 기대보다 낮으면, 모델을 바꾸기 전에 먼저
8.2 다수결(Majority Vote)
- 같은 문제를 여러 번 풀게 하고, 가장 많이 나온 답을 최종 답으로 고르는 방식입니다.
- 추론 모델은 샘플링할 때마다 조금씩 다른 경로로 생각합니다. 여러 경로가 같은 답으로 모이면 그 답은 신뢰도가 높습니다.
- 우리 모델은 1회 평균만으로도 AIME 98.75, HMMT 96.59로 기존 1위를 넘었습니다. 다수결은 여기에 남은 편차를 없애 만점을 완성했습니다.
- 투명성을 위해 다수결 점수와 1회 평균을 함께 공개했습니다.
8.3 긴 생각의 서빙
- 131K 토큰의 생각을 수천 문항에 대해 여러 번 돌리려면, 대형 MoE 모델을 효율적으로 서빙해야 합니다.
- vLLM의 **텐서 병렬(TP)과 전문가 병렬(Expert Parallel)**을 함께 써서, 여러 GPU에 전문가를 나눠 싣고 대량 추론을 처리했습니다.
9. ZTC (Zero-Token Confidence)
- 개념: 모델이 답을 한 글자도 생성하기 전에 내부 상태만 읽어 「이 질문에 맞게 답할 확률」을 추정하는 비드래프트의 독자 기술입니다.
- 왜 필요한가:
- AI 에이전트가 실제 행동(결제, 코드 배포, 문서 발송)을 하기 전에 틀릴 가능성이 높은 경우를 미리 걸러 낼 수 있습니다.
- 생성 전에 판단하므로 추가 토큰 비용이 거의 없습니다.
- RSI와의 연결: 자가개선 루프에서 모델이 어떤 문제에 약한지 스스로 알아내는 신호로 쓸 수 있습니다. 약점에 학습을 집중할 수 있다는 뜻입니다.
10. 산업적 의미
| 관점 | 의미 |
|---|---|
| 비용 | 초거대 모델을 새로 학습하지 않고 공개 모델의 0.02%만 진화시켜 세계 1위 |
| 효율 | 같은 정확도에서 추론 11% 단축 → 서비스 비용 절감 |
| 개방성 | 가중치 전체 공개 → 누구나 내려받아 쓰고 검증 가능 |
| 주권 AI | 한국 스타트업이 공개 생태계에서 미·중 빅테크 모델과 정면 경쟁 |
| 방법론 | 사람 라벨 없는 자가개선을 공식 벤치마크로 실증 |
11. 재현 방법
- 가중치 받기:
FINAL-Bench/Darwin-180B-RSI(Qwen Community License 1.0) - 서빙: vLLM에서 텐서 병렬 8과 expert parallel을 켜고, 컨텍스트를 131K 이상으로 설정합니다.
- 샘플링: temperature 1.0, top_p 0.95, top_k 20, 생각 예산 131,072 토큰
- 채점: 문항마다 N회 풀고, 1회 평균과 다수결을 함께 기록합니다. 수학은
math_verify로 채점합니다.
12. FAQ
Q. 모델은 공개인가요?
네. 가중치, 설정, 토크나이저 모두 허깅페이스에 공개돼 있습니다.
Q. 멀티모달도 되나요?
네. 부모 모델의 비전 인코더를 그대로 유지해, 이미지를 입력으로 받을 수 있습니다. MMMU-Pro 1위가 그 증거입니다.
Q. 만점이 어떻게 가능했나요?
두 가지가 맞물렸습니다. RSI로 추론 습관을 개선해 1회 풀이만으로도 98~99% 수준에 도달했습니다. 여기에 충분한 생각 예산과 다수결로 남은 편차를 없앴습니다.
Q. 어디에 쓸 수 있나요?
수학·과학 추론, 전문 지식 질의응답, 문서·차트 이해, 그리고 ZTC와 결합한 신뢰도 높은 AI 에이전트에 쓸 수 있습니다.
참고
- 모델: FINAL-Bench/Darwin-180B-RSI · Hugging Face
- Darwin 프레임워크 논문: arXiv:2605.14386
- 비드래프트(대표 김민식) — AI 딥테크 스타트업