
Datadog의 변경 원인 분석 특화 9B 모델 소개
Datadog이 프로덕션 알림(alert)을 일으킨 배포, 기능 플래그, 설정 변경을 찾아내는 조사 에이전트를 9B 크기의 오픈 모델로 만든 과정을 공개했습니다. 큰 교사 모델 GLM-5.3이 남긴 조사 기록으로 Qwen3.5-9B를 파인튜닝한 결과, 교사 모델 재현율(Recall@5)의 87%를 유지하면서 조사 1건당 LLM 비용을 0.06달러에서 0.003달러로 약 20분의 1 수준까지 낮췄습니다.
장애 대응을 해 본 개발자라면 알림이 울렸을 때 가장 먼저 던지는 질문이 "최근에 뭐가 바뀌었지?" 라는 것을 알고 있을 것입니다. 많은 장애가 배포나 설정 변경 직후에 발생하지만, 여러 서비스와 수많은 변경 이력 속에서 실제로 문제를 일으킨 변경 하나를 골라내는 일은 여러 시스템을 오가며 증거를 맞춰 보는 시간 싸움입니다. 이 작업을 변경 원인 분석(Change Attribution) 이라고 부르며, 규칙 기반 시스템은 빠르고 저렴하지만 복잡한 장애에서는 정확도가 떨어지고, 프런티어 LLM 기반 에이전트는 깊이 있게 추론(reasoning)하지만 모든 알림마다 실행하기에는 비용이 너무 큽니다.
Datadog 엔지니어링 팀은 이 간극을 작고 특화된 모델로 메울 수 있는지 실험했습니다. 2026년 9월 23일 Datadog 블로그에 게시된 이 글은 Staff Engineer인 Scott Kramer와 엔지니어링 부사장(VP, Engineering) Junaid Ahmed가 작성했으며, 교사 모델의 조사 기록을 학습 데이터로 계속 불려 가는 데이터 플라이휠(Data Flywheel) 을 어떻게 구성했는지, 파인튜닝이 모델의 조사 행동을 어떻게 바꿨는지, 그리고 이 방식이 더 많은 알림에 에이전트 조사를 적용하는 데 어떤 의미가 있는지를 다룹니다.
이 사례가 흥미로운 이유는 결과 수치보다 방법의 재현 가능성에 있습니다. 사람이 직접 레이블을 달지 않고, 이미 프로덕션에서 돌아가는 상위 에이전트의 결론을 대리 레이블로 삼아 학습 데이터를 만들었고, 100개에서 186개 정도의 적은 예제로도 행동 변화를 이끌어냈습니다. 반복되는 에이전트 워크플로를 운영하면서 LLM 비용을 고민하는 팀이라면 참고할 만한 설계가 많습니다.
변경 원인 분석의 두 가지 접근: 규칙 기반 랭커와 에이전트 조사
Datadog의 Change Tracking은 배포, 기능 플래그, 설정 변경, 데이터베이스 수정은 물론 트래픽 급증, Kubernetes 변경, Watchdog 알림 같은 이벤트까지 서비스와 의존성 단위로 모아 장애 조사에 활용할 수 있도록 제공하는 기능입니다. 현재 Change Tracking은 서로 보완적인 두 가지 방식으로 장애 조사를 돕고 있으며, 이번 실험은 두 방식의 장점을 합칠 수 있는지에서 출발했습니다.
Relevant Changes: 몇 초 만에 결과를 주는 규칙 기반 탭
첫 번째는 Relevant Changes 탭입니다. 모니터(Monitor)의 알림 타임라인 위에 최근 변경들을 겹쳐 보여 주고, 그중 알림에 영향을 주었을 가능성이 높은 변경을 강조합니다. 엔지니어는 이 화면에서 관련 있어 보이는 배포, 기능 플래그, 설정 변경을 빠르게 훑어볼 수 있습니다.
아래 화면에서는 모니터링 중인 지표가 오르기 시작하기 직전에 발생한 기능 플래그 업데이트가 강조되어 있습니다.
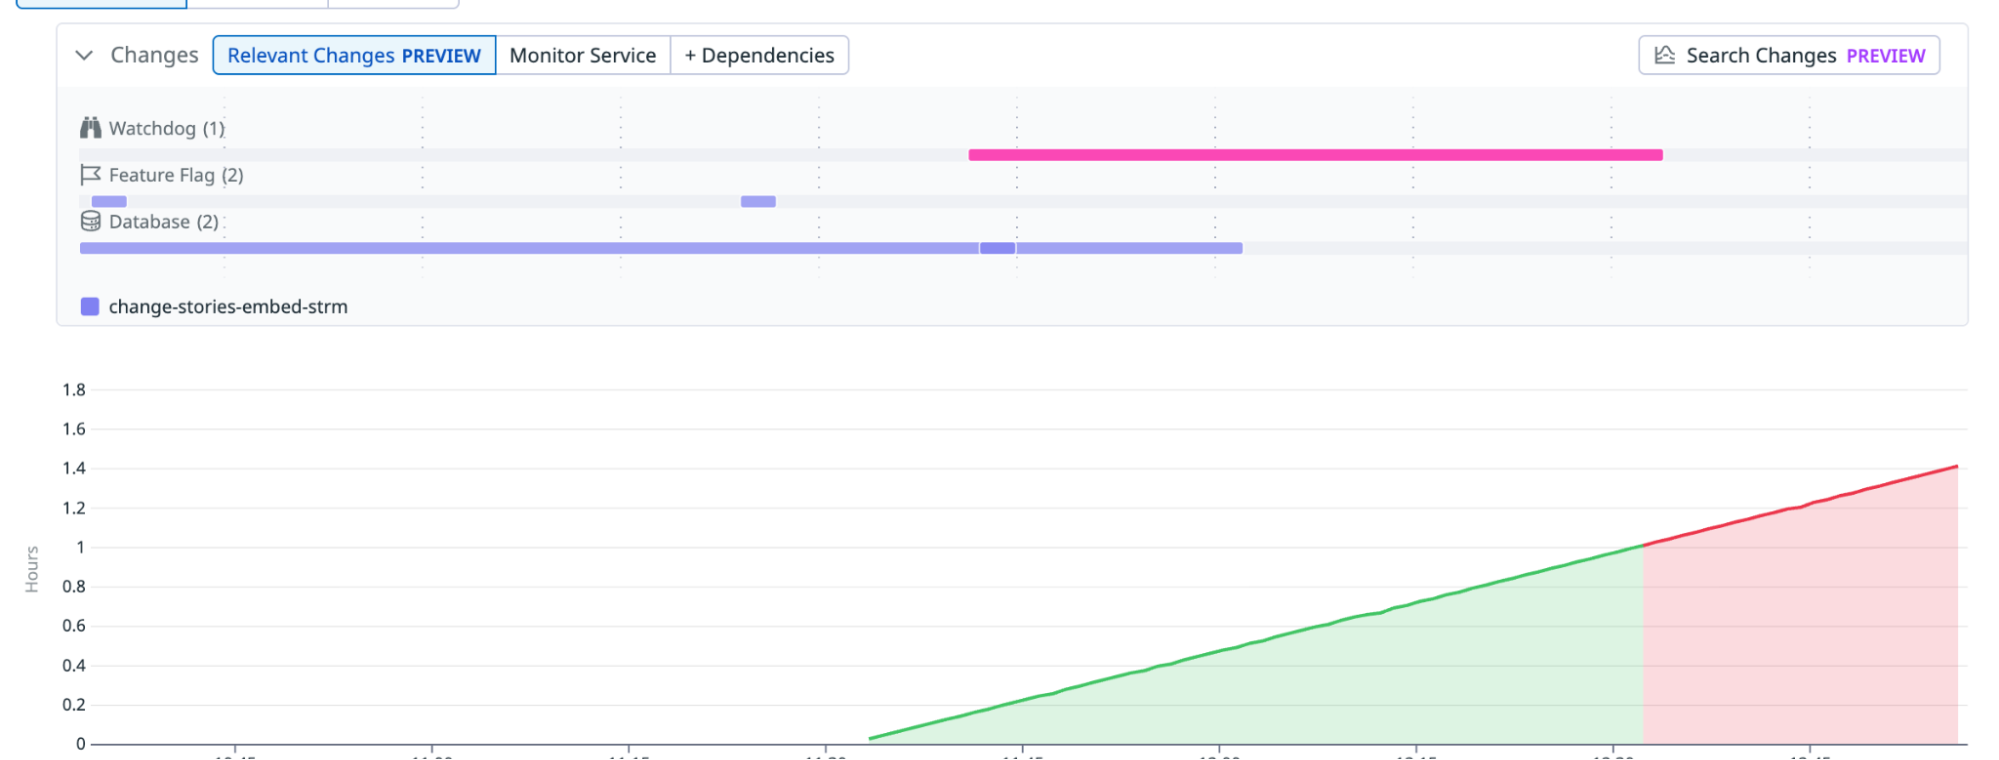
Relevant Changes는 몇 초 안에 결과를 돌려주고, APM(Application Performance Monitoring) 고객에게 무료로 제공할 수 있을 만큼 운영 비용이 낮습니다. 그러나 규칙 기반 검색(rules-based retrieval)에 의존하기 때문에, 복잡한 장애에서는 정확도에 한계가 있습니다.
MCP 도구와 Bits Investigation: 깊이 추론하지만 비싼 에이전트 조사
두 번째는 Change Tracking 데이터를 MCP(Model Context Protocol) 도구로 노출하는 방식입니다. Datadog MCP 서버의 get_change_stories, semantic_search_change_stories 도구를 통해 에이전트가 장애 조사 중에 변경 이력을 직접 조회할 수 있으며, Datadog의 자율 조사 에이전트인 Bits Investigation도 이 도구를 사용합니다. 2026년 7월 Datadog 내부 텔레메트리에 따르면 Change Tracking 도구는 매주 수천 건의 Bits 조사에 쓰이고 있고, Bits Investigation 결론의 20%가 Change Tracking이 수집한 변경을 근거로 언급합니다.
에이전트 조사는 여러 턴에 걸쳐 로그와 트레이스를 확인하며 증거를 따져 볼 수 있지만, 프런티어 모델로 멀티턴 조사를 하면 알림마다 실행하기에는 비용이 너무 큽니다. Datadog이 밝힌 규모로는 고객이 매주 상호작용하는 고유 모니터가 수백만 개에 이르므로, 조사 1건당 비용이 몇 센트만 되어도 전체 비용은 빠르게 불어납니다.
두 접근의 특성과, Datadog이 노린 세 번째 선택지를 정리하면 다음과 같습니다.
| 구분 | Relevant Changes (규칙 기반) | 프런티어 모델 에이전트 | 특화 소형 모델 에이전트 (이번 실험) |
|---|---|---|---|
| 동작 방식 | 고정된 규칙으로 변경 순위 산출 | MCP 도구로 멀티턴 조사 | MCP 도구로 멀티턴 조사 |
| 복잡한 장애 대응 | 제한적 | 강함 | 교사 모델에 근접하는 것이 목표 |
| 비용 | 매우 낮음 (APM 무료 제공) | 높음 | 낮게 유지하는 것이 목표 |
| 대규모 적용 | 가능 | 어려움 | 목표 |
즉, 변경 원인 분석에 특화된 작은 모델이 있다면 에이전트 조사의 깊이를 유지하면서도 훨씬 많은 알림을 감당할 수 있는 비용 구조를 만들 수 있다는 것이 이 실험의 가설이었습니다.
프롬프트만으로는 고칠 수 없었던 작은 모델의 조사 습관
Datadog 팀이 처음 시도한 것은 프롬프트 엔지니어링이었습니다. 시스템 프롬프트와 도구 설명을 여러 차례 고쳐 썼지만, Qwen3.5-9B는 가장 유력한 증거를 중심으로 조사 범위를 좁히지 못하고 너무 넓게 검색하는 경향을 보였습니다. 서비스와 변경 목록을 계속 훑다가 턴 제한이나 컨텍스트 창을 소진해 버리는 식입니다.
이런 행동을 막기 위해 프롬프트에 규칙을 계속 덧붙이는 방법도 있었지만, 팀은 방향을 바꿨습니다. 규칙으로 행동을 교정하는 대신, 더 유능한 모델이 실제로 조사하는 방식을 작은 모델에게 가르칠 수 있는지 시험한 것입니다. 이는 큰 모델의 출력을 작은 모델의 학습 데이터로 쓰는 지식 증류(Knowledge Distillation) 의 한 형태로, 여기서는 최종 답뿐 아니라 조사 트레이스(trace) 속 도구 호출과 추론 과정까지 학습 대상으로 삼았다는 점이 특징입니다.
 지식 증류의 원형과 관련해서는 다음 논문(Distilling the Knowledge in a Neural Network)을 참고해주세요:
변경 원인 분석 플라이휠: 교사의 조사 기록으로 학생을 가르치는 5단계 순환
Datadog은 NVIDIA가 공개한 Data Flywheel Blueprint를 변경 원인 분석에 맞게 변형했습니다. 큰 교사 모델로 조사 트레이스를 만들고, 성공한 트레이스로 작은 학생 모델을 파인튜닝하며, 새 프로덕션 조사가 쌓일 때마다 이 과정을 반복하는 구조입니다. NVIDIA는 NeMo 마이크로서비스 기반의 이 블루프린트를 고객 상담 에이전트 시나리오에 적용해, Llama-3.3-70B-Instruct의 도구 호출 트레이스로 Llama-3.2-1B를 LoRA 파인튜닝했고, 교사 정확도의 98%에 도달하면서 파라미터 수는 약 70분의 1로 줄였습니다.
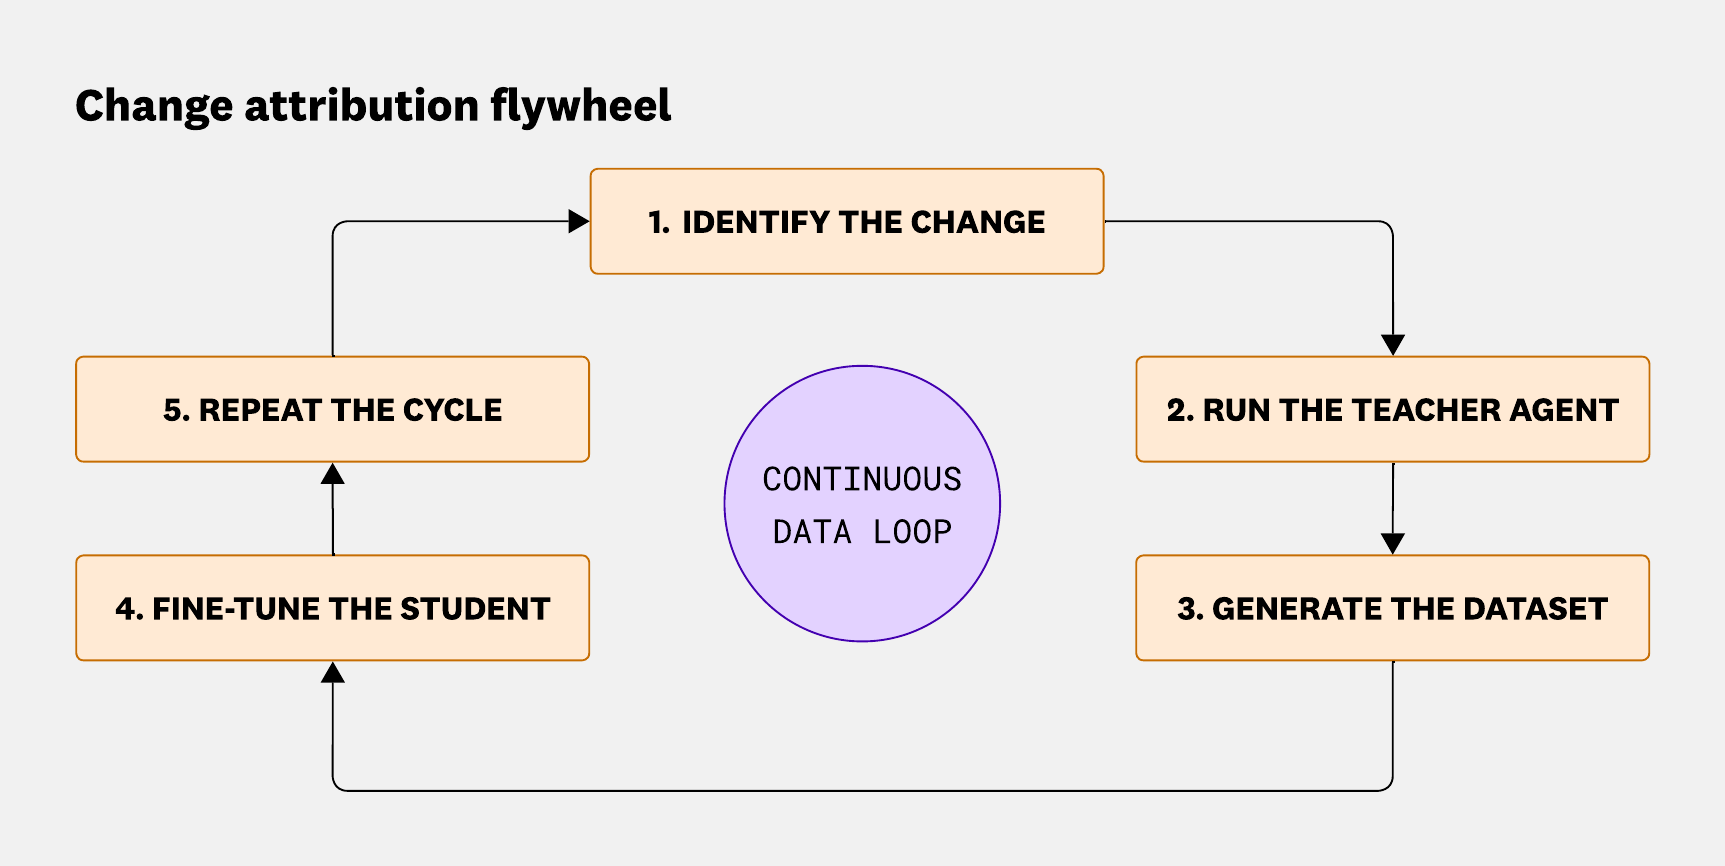
변경 원인 분석이 이 방식에 잘 맞는 이유는 두 가지입니다. 첫째, 조사의 구조가 일정합니다. 모든 조사가 같은 도구 세트를 쓰고, 장애의 원인일 가능성이 가장 높은 변경을 찾는다는 같은 목표를 향합니다. 둘째, Bits Investigation의 결론에서 사람의 수작업 없이 레이블이 달린 예제를 계속 뽑아낼 수 있습니다. 반복 가능한 워크플로와 계속 늘어나는 레이블 데이터가 함께 있으니, 특화 모델을 만들기에 좋은 조건입니다.
1단계: Bits Investigation 결론에서 대리 레이블 뽑기
Bits Investigation은 조사한 모든 장애에 대해 자유 형식의 결론을 작성합니다. Datadog은 GLM-5.3으로 이 결론을 파싱해 언급된 변경을 찾아내고, 이를 자사 시스템의 변경 ID에 매핑합니다.
이렇게 얻은 변경은 대리 레이블(Proxy Label) 로 취급합니다. 이 레이블은 독립적으로 검증된 인과관계가 아니라, Bits가 이 장애와 연관 지은 변경을 가리킵니다. 정답을 사람이 확인하지는 않지만, 그 대신 수작업 어노테이션 없이 레이블이 달린 예제를 계속 확보할 수 있습니다.
2단계: 일부러 제약한 조건에서 교사 에이전트 실행하기
교사 모델인 GLM-5.3은 같은 알림을 8턴, 5개 도구, 65,536 토큰 컨텍스트 창이라는 조건에서 조사하고, 가능성 있는 변경들의 순위 목록과 신뢰도 점수를 돌려줍니다. Z.ai의 플래그십 모델인 GLM-5.3은 1M 토큰 컨텍스트를 지원하지만, Datadog은 조사 과정을 의도적으로 제약했습니다. 교사가 훨씬 작은 모델이 따라 할 수 있는 범위 안에서 조사해야 학생이 그 행동을 재현할 수 있기 때문입니다.
증류 관점에서 보면, 교사가 학생이 가질 수 없는 자원(긴 컨텍스트, 많은 턴)에 기대어 문제를 풀면, 그 트레이스는 학생에게 따라 할 수 없는 시범이 됩니다. GLM 계열 모델에 대해서는 GLM-5 출시 소개글과 GLM-5.3-Flash 소개글을 함께 참고하실 수 있습니다.
3단계: 거부 샘플링으로 성공한 트레이스만 남기기
Datadog은 알림마다 교사 모델을 세 번씩 실행하고, 반환한 변경이 Bits Investigation 결론에서 뽑은 대리 레이블과 일치하는 예제만 남기고 나머지는 버렸습니다. 이렇게 여러 번 샘플링한 뒤 정답에 도달한 결과만 골라 학습하는 기법을 거부 샘플링 파인튜닝(Rejection Sampling Fine-Tuning, RFT) 이라고 합니다.
이 과정을 2026년 5월 26일부터 6월 24일 사이에 발생한 348건의 내부 장애에 적용했고, 여기서 100개의 교사 트레이스로 초기 데이터셋을 만들었습니다. 각 트레이스는 서로 다른 조사에서 나왔으며, 대리 레이블에 가장 높은 점수를 준 트레이스를 기준으로 선택했습니다. 이 데이터셋을 만드는 데 고객 데이터는 사용하지 않았습니다.
거부 샘플링 파인튜닝(RFT)과 관련해서는 다음 논문(Scaling Relationship on Learning Mathematical Reasoning with Large Language Models)을 참고해주세요:
4단계: 16비트 LoRA로 Qwen3.5-9B 파인튜닝하기
학생 모델 Qwen3.5-9B는 16비트 LoRA(Low-Rank Adaptation) 로 파인튜닝했습니다. LoRA는 모델의 전체 가중치를 갱신하는 대신, 원래 가중치 W_0 는 고정해 두고 작은 저랭크 행렬 두 개만 학습합니다:
학습해야 하는 파라미터가 r(d+k) 개로 줄어들기 때문에, 100개 남짓한 예제로 9B 모델을 조정하는 이번 실험처럼 데이터와 연산 예산이 작은 경우에 잘 맞습니다. 구현은 Hugging Face PEFT(Parameter-Efficient Fine-Tuning) 같은 라이브러리로 PyTorch 위에서 쉽게 구성할 수 있습니다.
또한 Datadog은 선택된 트레이스에서 어시스턴트 응답 부분에만 학습 손실을 계산했습니다. 트레이스에는 시스템 프롬프트, 도구 호출 결과(로그, 스팬, 지표 조회 결과) 같은 긴 입력이 섞여 있는데, 일반적으로 이 부분까지 손실에 넣으면 모델이 도구 출력을 흉내 내는 데까지 학습 신호가 분산됩니다. 어시스턴트 턴만 학습하면 어떤 도구를 언제 부르고 그 결과로 무엇을 결론 내리는지와 같은 조사 행동 자체에 학습이 집중됩니다.
LoRA와 관련해서는 다음 논문(LoRA: Low-Rank Adaptation of Large Language Models)을 참고해주세요:
5단계: 교사는 맞히고 학생은 놓친 사례로 순환하기
교사와 학생 모델은 모두 프로덕션에서 함께 실행됩니다. 교사의 예측은 대리 레이블과 일치하는데 학생의 예측이 일치하지 않으면, 그 교사 트레이스를 학습 데이터셋에 추가하고 확장된 데이터셋으로 학생을 다시 학습합니다. 학생이 틀리는 지점만 골라 보충하므로, 데이터가 늘어날수록 학생의 약점을 겨냥한 예제가 쌓입니다.
Datadog은 추가 내부 장애로 이 순환을 두 차례 진행했고, 86개의 학습 예제를 더해 데이터셋을 100개에서 186개로 늘렸습니다.
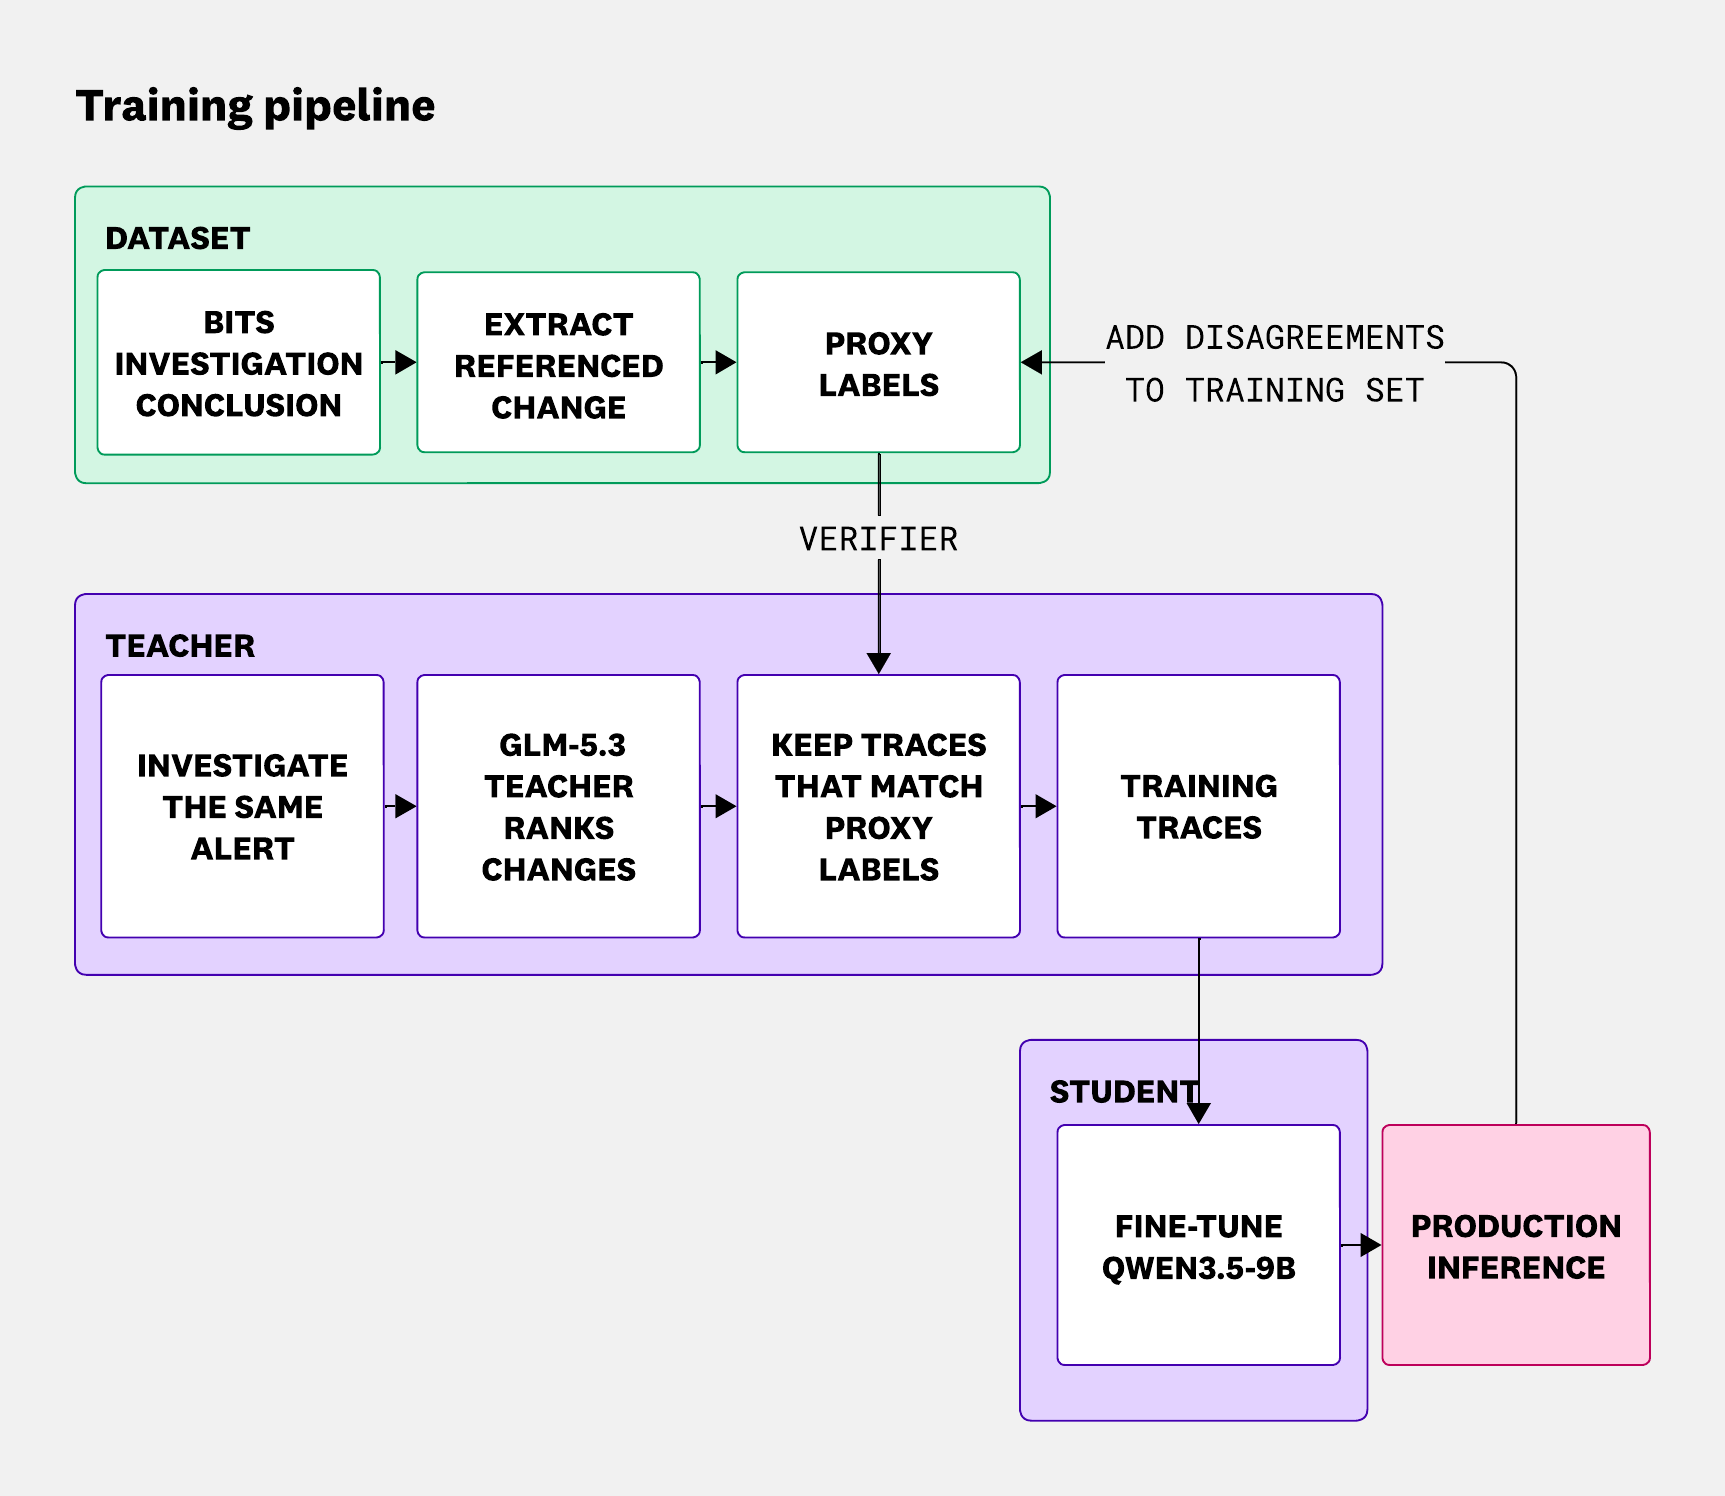
위 그림을 통해 전체 파이프라인이 세 영역으로 나뉘는 것을 알 수 있습니다. 데이터셋 영역에서는 Bits 결론으로부터 대리 레이블을 만들고, 교사 영역에서는 이 레이블을 검증기(verifier)로 삼아 성공한 트레이스만 걸러내며, 학생 영역에서 파인튜닝된 모델이 프로덕션 추론(inference)을 맡고, 교사와 학생의 불일치는 다시 데이터셋으로 돌아갑니다.
평가 결과: 교사 Recall@5의 87%를 약 5%의 비용으로
평가는 어떻게 했나: 학습 이후에 발생한 326건의 프로덕션 장애
평가는 2026년 8월 11일부터 25일 사이에 수집한 326건의 프로덕션 장애(내부 187건, 고객 139건)로 진행했습니다. 매일 크론(cron) 작업이 전날의 프로덕션 장애를 재생하면서 각 모델로 조사를 실행하는 방식입니다. 평가 지표인 Recall@5는 각 모델이 매긴 상위 5개 변경 안에 Bits Investigation 결론에서 뽑은 대리 레이블이 포함되어 있는지를 측정합니다:
여기서 y_i 는 i 번째 장애의 대리 레이블, \hat{R}_i 는 모델이 반환한 변경 순위 목록입니다. Datadog도 밝히고 있듯이, 이 지표는 Bits Investigation 결론과의 일치도를 재는 것이지 해당 변경이 장애의 실제 원인인지를 독립적으로 검증하지는 않습니다.
평가 대상 장애는 모두 학습 데이터 생성 이후에 발생했기 때문에 학습 세트와 완전히 분리되어 있습니다. 또 학생 모델은 내부 장애로만 학습했으므로, 고객 장애 139건은 학습한 행동이 다른 분포로도 옮겨 가는지 확인하는 시험대 역할을 합니다. 다만 GLM-5.3은 현재 Datadog 내부 용도로만 활성화되어 있어, 교사와 학생의 직접 비교는 내부 장애로 한정됩니다.
모델별 성능과 비용 비교
| 모델 | Recall@5 (내부 장애) | Recall@5 (고객 장애) | 조사 1건당 비용 | 조사 1건당 토큰 |
|---|---|---|---|---|
| Opus 5.0 | 0.68 | 0.71 | 0.32달러 | 80,500 |
| GLM-5.3 (교사) | 0.63 | 해당 없음 | 0.06달러 | 109,000 |
| 파인튜닝한 Qwen3.5-9B | 0.55 | 0.62 | 0.003달러 | 52,900 |
| 휴리스틱 기반 랭커 | 0.46 | 0.51 | 0.002달러 | 2,140 |
| 기본 Qwen3.5-9B | 0.43 | 0.52 | 0.005달러 | 76,500 |
아래 그래프는 가로축을 로그 스케일의 조사당 비용으로, 세로축을 Recall@5로 놓고 각 모델을 배치한 것입니다. 파인튜닝한 학생 모델이 휴리스틱 랭커 바로 옆의 비용 구간에서 교사 모델 쪽으로 크게 올라가 있는 것을 확인할 수 있습니다.

Datadog은 이 결과에서 다음 네 가지를 핵심으로 꼽았습니다.
교사 성능의 대부분을 5%의 비용으로 유지 (0.55 대 0.63): 파인튜닝한 학생은 Recall@5 0.55를 기록해 교사의 0.63에 근접했습니다. 학생의 자체 호스팅 서빙 비용은 조사 1건당 0.003달러, GLM-5.3의 API 요금은 0.06달러이므로, 추론 비용의 5%로 교사 Recall@5의 87%를 달성한 셈입니다.
파인튜닝이 조사 방식 자체를 바꿈: 같은 평가 세트에서 기본 Qwen3.5-9B는 조사의 25%에서 턴 제한이나 컨텍스트 창을 소진했습니다. 트레이스를 분석해 보니 서비스와 변경을 넓게 검색하기만 하고 조사를 충분히 빨리 좁히지 못한 것이 원인이었습니다. 파인튜닝 후에는 트레이스당 검색 호출이 6.8회에서 5.8회로 줄고, 로그, 스팬, 지표에서 증거를 모으는 호출은 4.7회에서 8.3회로 늘었습니다. 넓게 변경을 찾는 행동에서 집중적으로 증거를 수집하는 행동으로 옮겨 간 덕분에, Recall@5는 오르고 토큰 사용량은 76,500개에서 52,900개로 줄었습니다.
손으로 작성한 규칙을 넘어섬 (0.46 대 0.55): 파인튜닝한 학생은 Datadog의 프로덕션 규칙 기반 시스템보다 Recall@5를 0.46에서 0.55로 끌어올리면서도 조사당 비용은 약 0.003달러에 그쳤습니다. 특수한 규칙을 계속 늘려 가는 대신, 프로덕션에서 얻은 예제로 조사 행동을 학습하는 쪽이 더 나은 결과를 냈습니다. 다만 멀티턴 에이전트 조사를 수행하기 때문에, 고정된 규칙을 적용하는 휴리스틱 랭커(2,140 토큰)보다 훨씬 많은 토큰을 처리한다는 점이 주된 트레이드오프(trade-off)입니다.
더 높은 지능에는 대가가 따름 (0.32달러): Opus 5.0처럼 더 유능한 모델은 Recall@5를 계속 끌어올리지만, 조사당 평균 비용이 0.32달러로 학생 모델의 100배가 넘습니다. 대량의 알림에 조사를 실행해야 하는 Datadog의 사용 사례에서는 이 비용이 빠르게 누적됩니다.
에이전트의 성능을 도구 호출 하나하나가 아니라 과업 완수와 트레이스 수준에서 평가하는 방법에 대해서는 NVIDIA가 정리한 AI 에이전트 평가 지표와 트레이스 읽는 법 글도 함께 참고하시면 좋습니다.
고객 장애에서도 유지된 개선 폭
학습에 한 번도 쓰이지 않은 고객 장애에서 파인튜닝한 모델은 Recall@5 0.62를 기록했습니다. 같은 조건에서 기본 모델은 0.52, 휴리스틱 랭커는 0.51이었습니다. 내부 장애만으로 학습했는데도 기본 모델 대비 개선 폭이 내부 장애(+0.12)와 고객 장애(+0.10)에서 비슷하게 나타났으므로, 학습한 조사 행동이 학습 분포 밖으로도 옮겨 간다는 신호로 볼 수 있습니다.
조사 1건당 0.003달러는 어떻게 계산되었나
비용 추정은 모델 간 직접 비교에 쓴 내부 장애 187건을 기준으로 계산했습니다. 자체 호스팅하는 Qwen 모델은 측정된 조사 처리량과 할당된 GPU 인스턴스 비용으로 서빙 비용을 추정했습니다. 파인튜닝한 모델은 조사 1건당 평균 1,700개의 출력 토큰을 생성하고, NVIDIA A100 40GB GPU 1장에서 초당 280개 출력 토큰의 전체 처리량을 냅니다. GPU 비용은 AWS p4d.24xlarge 인스턴스 기준 GPU 시간당 유효 비용 1.74달러를 적용했습니다.
원문의 수치로 계산하면 조사 1건이 차지하는 GPU 시간과 비용은 다음과 같이 계산됩니다:
같은 방식으로 1주일(604,800초)을 조사 1건당 약 6.1초로 나누면 약 10만 건이 되는데, 이것이 Datadog이 밝힌 "A100 40GB GPU 1장으로 주당 약 10만 건의 조사를 감당할 수 있다" 는 수치의 근거입니다. 여기서 280 토큰/초는 여러 조사를 동시에 처리할 때의 합산 처리량이므로, 6.1초는 조사 1건의 실제 소요 시간이 아니라 GPU 시간 중 조사 1건이 차지하는 몫으로 이해해야 합니다. 다만 Datadog은 이 규모가 고객이 매주 상호작용하는 수백만 개의 모니터 중 일부를 조사할 수 있는 수준이라고 밝히며, 훨씬 많은 모니터로 넓히기 위한 추가 최적화를 진행 중이라고 설명합니다.
결과를 읽을 때 함께 볼 조건들
수치만 보면 9B 모델이 프런티어 모델을 거의 따라잡은 것처럼 읽히기 쉽지만, 원문이 직접 밝힌 조건들을 함께 보면 이 결과가 어디까지 일반화되는지가 더 분명해집니다.
-
레이블과 지표가 같은 출처에 기대고 있습니다: 학습용 대리 레이블과 평가 기준이 모두 Bits Investigation 결론에서 나옵니다. 따라서 Recall@5는 Bits와 얼마나 같은 결론을 내리는지를 재는 지표에 가깝고, 원문도 이 지표가 인과관계를 독립적으로 검증하지 않는다고 명시합니다.
-
교사와 학생의 직접 비교는 내부 장애 187건에 한정됩니다: GLM-5.3이 내부 전용이라 고객 장애에서의 교사 성능은 알 수 없습니다. 87%라는 비율은 내부 장애 기준입니다.
-
비용 비교의 기준이 서로 다릅니다: 학생의 0.003달러는 자체 호스팅 GPU의 유효 단가로 추정한 값이고, GLM-5.3과 Opus 5.0은 API 요금입니다. 원문도 "평가한 배포 조건에서" 라는 단서를 반복해서 붙이고 있어, GPU 가동률이나 인스턴스 단가가 달라지면 수치도 달라집니다.
-
학습 데이터가 매우 작습니다: 초기 100개, 두 차례 순환 후 186개입니다. 적은 데이터로 행동을 바꿀 수 있었다는 점은 긍정적이지만, 드문 유형의 장애에서도 같은 효과가 나는지는 데이터가 더 쌓여야 알 수 있습니다.
-
파인튜닝 전 기본 모델이 오히려 더 비쌌습니다: 기본 Qwen3.5-9B(0.005달러)가 파인튜닝한 모델(0.003달러)보다 비싼 것은 넓게 검색하느라 토큰을 더 많이 썼기 때문으로 보입니다(76,500 대 52,900 토큰). 작은 모델을 쓰는 것만으로 비용이 줄지는 않으며, 조사 행동을 효율적으로 만드는 것이 비용 절감의 실제 원천이라는 점을 보여 줍니다.
한편 이 조건들은 대부분 원문이 스스로 밝힌 것이며, 평가 세트를 학습 이후 시점으로 분리하고 고객 장애로 전이 성능을 따로 확인한 점은 결과를 해석할 때 도움이 됩니다.
지도 미세조정 다음 단계: Bits 결과를 보상으로 삼는 강화학습
지도 미세조정(Supervised Fine-Tuning, SFT)으로 쓸 만한 학생을 얻었지만, 여기에는 분명한 천장이 있습니다. 학생은 교사의 트레이스에 담긴 행동 이상을 배울 수 없습니다. 그래서 Datadog은 다음 단계로 강화학습(Reinforcement Learning, RL) 을 검토하고 있습니다.
이 문제에는 강화학습에 유리한 성질이 있습니다. Bits Investigation이 장애와 연관된 변경을 찾을 때마다 모델의 예측을 그 결과와 자동으로 비교할 수 있고, 이 일치 여부를 보상 신호로 활용할 수 있을 것으로 보고 있습니다. 그렇게 되면 좋아요, 싫어요 같은 명시적인 사람의 피드백 없이도 프로덕션 조사에서 계속 학습할 수 있습니다.
Datadog은 이를 Cursor가 수락되거나 거절된 코드 자동완성 피드백으로 Tab 모델을 온라인 강화학습하는 방식에 비유합니다. Cursor는 하루 4억 건이 넘는 Tab 요청에서 얻는 수락/거절 신호로 정책 그래디언트(policy gradient) 학습을 적용해, 제안 횟수는 21% 줄이면서 제안 수락률은 28% 높인 새 Tab 모델을 만들었습니다. Datadog의 경우에는 사용자 상호작용 대신 Bits Investigation 결과가 피드백 신호가 됩니다.
문제는 이 신호가 완벽하지 않다는 점입니다. Bits Investigation도 때로 잘못된 변경을 지목합니다. Datadog은 Bits Investigation 자체의 평가 체계가 개선될수록 레이블 품질도 좋아질 것으로 보고 있습니다. 대신 이 방식이 실현되면 별도의 사람 평가자나 학습된 보상 모델(reward model)이 필요하지 않고, 데이터 플라이휠에 쓰이는 바로 그 프로덕션 조사가 강화학습에 필요한 피드백까지 제공할 수 있습니다.
특화 소형 모델이 통하는 작업의 세 가지 조건
Datadog은 이 과정을 통해 적절한 조건을 갖춘 작업이라면 반복해서 적용할 수 있는 방법을 찾았다고 정리합니다. 그 조건은 다음 세 가지입니다.
- 일정한 구조의 에이전트 워크플로: 같은 도구 세트와 같은 목표로 반복되는 작업이어야 작은 모델이 조사 절차를 학습할 수 있습니다.
- 계속 늘어나는 유용한 레이블 출처: 이번 사례에서는 이미 프로덕션에서 돌아가는 Bits Investigation의 결론이 그 역할을 했습니다.
- 성공한 조사를 판별할 수 있는 평가 신호: 거부 샘플링으로 좋은 트레이스를 고르고, 이후 강화학습의 보상으로도 쓸 수 있는 신호가 필요합니다.
Datadog은 이런 방식이 AI 시스템을 만드는 점점 더 일반적인 방법이 될 것이라고 전망합니다. 프런티어 모델은 가장 어려운 문제를 푸는 데 여전히 필요하지만, 프로덕션 규모에서 모든 요청에 쓰기에는 너무 비쌀 수 있습니다. 추론 비용이 낮아지면 지출이 줄어들고 새로운 제품 경험도 가능해지며, Datadog은 추론 비용이 계속 떨어질수록 지금의 비용 수준에서는 비현실적인 관측(observability) 워크플로가 AI로 가능해질 것으로 기대합니다.
이 구조는 다른 에이전트 워크플로에도 옮겨 볼 수 있습니다. 이미 비싼 모델로 실행하고 있는 반복 작업이 있고 그 결과를 사후에 검증할 수단이 있다면, 그 로그 자체가 작은 모델을 위한 학습 데이터가 될 수 있습니다. 비슷한 흐름으로 큰 모델의 출력을 증류해 로컬에서 도는 작은 모델을 만든 사례로는 Distil-Text2SQL(SQirreL)도 함께 살펴볼 만합니다.
직접 환경에서 변경 원인 분석을 시도해 보려면 Bits Investigation을 실행하거나 Bits Chat에 변경 관련 질문을 할 수 있습니다.
Qwen3.5-9B의 라이선스
학생 모델로 쓰인 Qwen3.5-9B는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 원문에는 Datadog이 파인튜닝한 모델 가중치나 학습 데이터를 공개한다는 언급이 없습니다.
 Teaching a 9B model to investigate production alerts 소개 블로그
 NVIDIA Data Flywheel Blueprint 소개 블로그
 NVIDIA Data Flywheel Blueprint GitHub 저장소
더 읽어보기
-
How we built a real-world evaluation platform for autonomous SRE agents at scale | Datadog
-
NVIDIA가 정리한 AI 에이전트 평가: 도구 호출 정확도 대신 과업 완수를 채점하는 지표들과 트레이스 읽는 법
-
Distil-Text2SQL(SQirreL): 자연어 질문을 SQL 쿼리로 변환하는, 로컬에서 실행 가능한 경량 모델(0.6B/4B)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
