# Hugging Face Transformers, 이제 GGUF 가중치도 지원하여 바로 불러와 실행 가능 (feat. llama.cpp, ggml)
**URL:** https://discuss.pytorch.kr/t/hugging-face-transformers-gguf-feat-llama-cpp-ggml/12036
**Category:** 읽을거리&정보공유
**Tags:** gguf, quantization, local-llm, llama-cpp, apple-silicon, hugging-face, transformers
**Created:** [9월 29, 2026, 2:30오전 UTC](https://discuss.pytorch.kr/t/hugging-face-transformers-gguf-feat-llama-cpp-ggml/12036 "2026-09-29T02:30:02Z")
**Posts on this page:** 1
**Page:** 1
### Author:  [@9bow](https://discuss.pytorch.kr/u/9bow)
#### Post date: [9월 29, 2026, 2:30오전 UTC](https://discuss.pytorch.kr/t/hugging-face-transformers-gguf-feat-llama-cpp-ggml/12036/1 "2026-09-29T02:30:02Z")
## Transformers의 GGUF 직접 실행 지원 소개
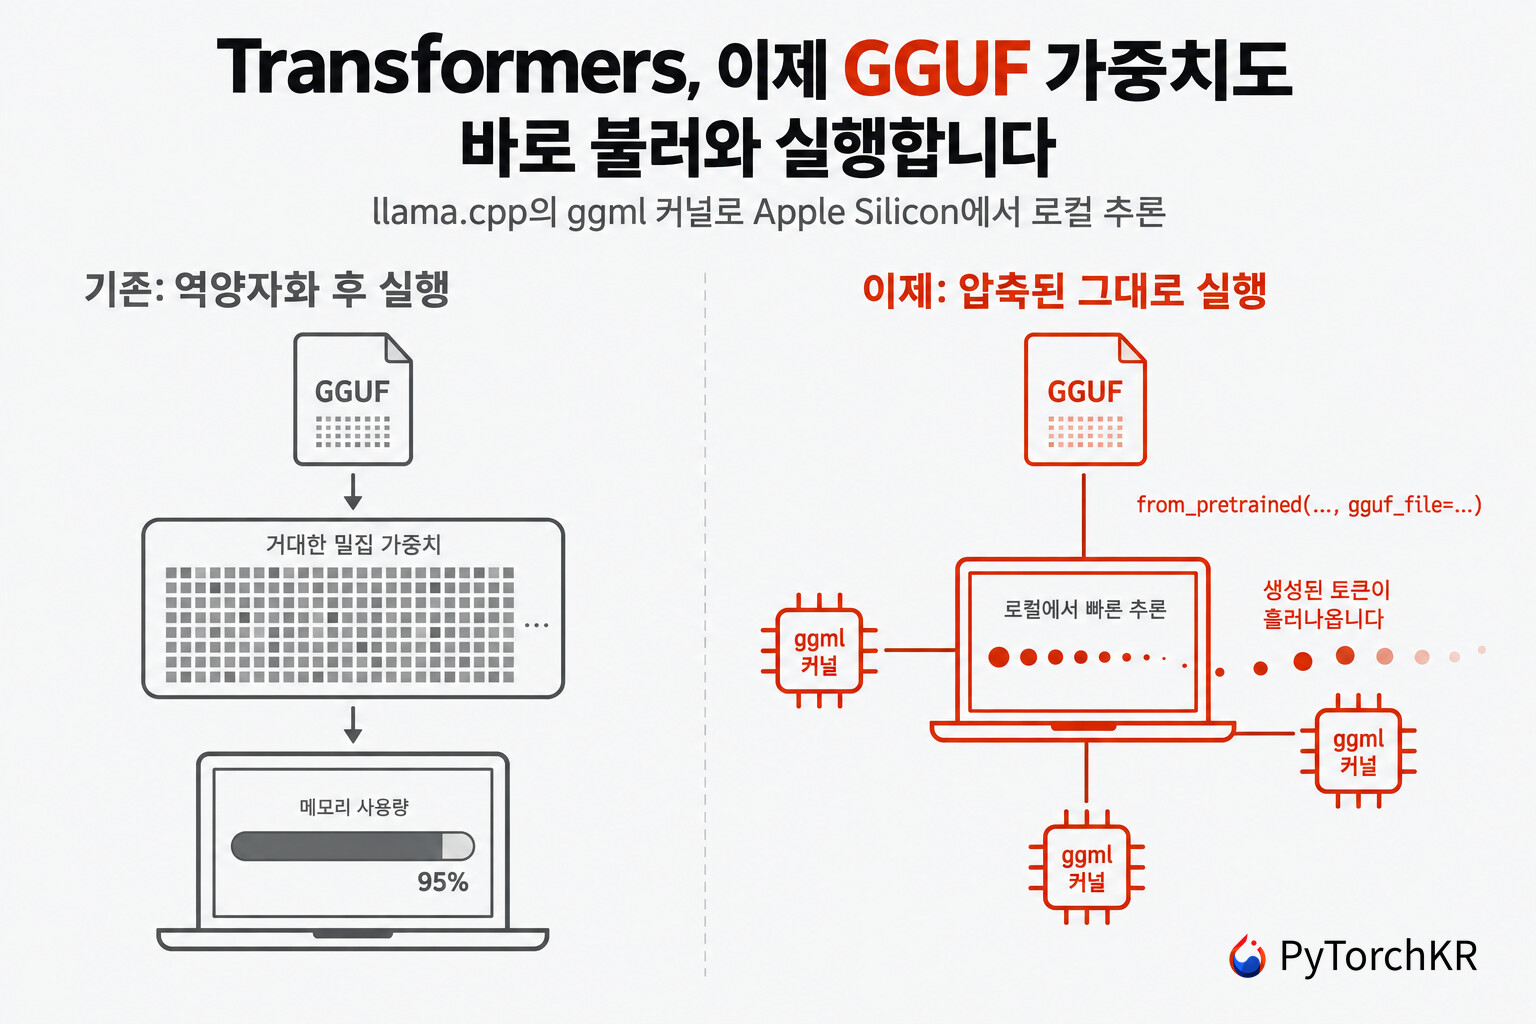
Hugging Face가 [Transformers](https://github.com/huggingface/transformers)에서 [llama.cpp](https://github.com/ggml-org/llama.cpp)용 GGUF 양자화 체크포인트를 압축된 그대로 불러와 실행하는 기능을 공개했습니다. Hub에서 GGUF 파일 하나를 골라 `from_pretrained()`에 파일 이름만 넘기면, 노트북 메모리에 맞게 줄여 둔 모델을 익숙한 Transformers API로 바로 생성에 쓸 수 있습니다. 첫 지원 대상은 Apple Silicon Mac과 Qwen3.5 계열 아키텍처입니다.
로컬 추론 생태계에서 llama.cpp가 차지하는 위치는 큽니다. [Ollama](https://ollama.com), [LM Studio](https://lmstudio.ai), [Jan](https://jan.ai) 같은 로컬 AI 도구가 llama.cpp의 추론 엔진 위에서 동작하고, Apple의 [MLX](https://github.com/ml-explore/mlx)와 함께 노트북에서 LLM을 실행하는 일을 일상적인 선택지로 만들었습니다. 이 과정에서 llama.cpp 팀이 만든 **GGUF** 포맷은 로컬 추론에 널리 쓰이는 포맷이 되었습니다. llama.cpp 팀은 [Hub의 ggml-org](https://huggingface.co/ggml-org)에 직접 양자화 체크포인트를 올리고 있고, [Unsloth](https://huggingface.co/unsloth), [LM Studio Community](https://huggingface.co/lmstudio-community), [bartowski](https://huggingface.co/bartowski) 같은 배포자도 여러 양자화 수준의 GGUF를 제공합니다. Hugging Face에 따르면 GGUF 모델의 누적 다운로드는 수백만 회에 이릅니다.
사실 Transformers에서 GGUF 파일을 여는 것 자체는 새로운 일이 아닙니다. 2024년 5월의 [Transformers v4.41.0](https://github.com/huggingface/transformers/releases/tag/v4.41.0)부터 `gguf_file` 인자로 GGUF를 불러올 수 있었습니다. 다만 이 방식은 불러오는 시점에 모든 가중치를 **역양자화(Dequantization)** 해서 일반적인 PyTorch 밀집(dense) 모델로 바꾸었기 때문에, 4비트로 줄여 둔 파일이 메모리 안에서는 다시 원래 크기로 부풀었습니다. 양자화로 얻은 메모리 절감이 불러오는 순간 사라지는 셈입니다. 이번 업데이트의 핵심은 가중치를 **압축된(packed) 상태 그대로** GPU에 올리고, llama.cpp가 쓰는 [ggml](https://github.com/ggml-org/ggml)의 Metal 커널로 그 압축 블록 위에서 바로 연산한다는 점입니다.
Hugging Face 팀은 "_호환성은 모델을 쾌적하게 실행할 수 있을 때에만 쓸모가 있다_"고 설명합니다. 그래서 ggml 커널을 [`kernels`](https://huggingface.co/docs/kernels/index) 라이브러리로 재사용하는 것과 함께 `generate()`의 오버헤드도 줄였고, 그 결과 MacBook Pro M2 Max에서 llama.cpp에 근접한 생성 속도를 기록했습니다. 이 글에서는 GGUF 포맷의 기본 개념부터 사용법, 벤치마크, 그리고 속도를 끌어올린 커널과 생성 루프의 변화까지 차례로 살펴보겠습니다.
## GGUF 포맷 이해하기: 한 파일에 담긴 가중치와 메타데이터
[GGUF](https://github.com/ggml-org/ggml/blob/master/docs/gguf.md)는 모델 가중치와 메타데이터를 파일 하나에 담는 포맷입니다. 메타데이터에는 토크나이저 정보와 선택적인 채팅 템플릿(chat template)까지 들어가므로, Transformers에서 토크나이저와 모델을 모두 같은 GGUF 파일에서 불러올 수 있습니다.
GGUF는 여러 양자화 수준을 지원하며, 정밀도를 일부 포기하는 대신 메모리 사용량을 줄이는 선택을 할 수 있게 해 줍니다. 예를 들어 `Q4_K_M` 같은 변형은 텐서마다 정밀도를 섞어 쓰는 방식으로, 대부분의 가중치는 4비트로 저장하되 양자화 오차에 민감한 텐서는 더 높은 정밀도로 유지합니다. 파일 이름의 `Q` 뒤 숫자는 대략적인 비트 수를, `K`는 가중치를 블록으로 나누고 이를 다시 슈퍼블록(super-block)으로 묶어 스케일을 저장하는 K-quant 계열을(`Q4_K`는 가중치당 4.5비트), `M`은 그 안에서의 중간 크기 구성을 뜻합니다. 사용할 수 있는 양자화 유형 전체는 [Hub의 GGUF 문서](https://huggingface.co/docs/hub/gguf#quantization-types)에 정리되어 있습니다.
원문은 [Unsloth의 Qwen3.5-4B GGUF](https://huggingface.co/unsloth/Qwen3.5-4B-GGUF/tree/main) 저장소를 예로 양자화에 따른 파일 크기 변화를 보여줍니다:
| GGUF 변형 | 파일 크기 | 특징 |
| --- | --- | --- |
| `BF16` | 8.42 GB | 양자화하지 않은 기준 모델 |
| `Q6_K` | 3.53 GB | 더 작은 변형보다 높은 정밀도 |
| `Q5_K_M` | 3.14 GB | 크기와 정밀도 사이의 절충 |
| `Q4_K_M` | 2.74 GB | 로컬 추론을 시작하기에 실용적인 선택 |
`Q4_K_M`은 `BF16` 대비 약 1/3 크기입니다. Hugging Face 팀은 `Q4_K_M`으로 시작한 뒤, 메모리 여유가 있다면 `Q5_K_M`이나 `Q6_K`를 시도해 볼 것을 권합니다. 더 공격적인 양자화는 큰 모델을 메모리에 맞추는 데 도움이 되지만 품질 손실의 정도는 모델과 작업에 따라 다르므로, 실제로 모델에게 시킬 작업으로 직접 평가해 보라고 덧붙입니다.
## Transformers에서 GGUF 모델 불러오기
### 준비 사항
현재 이 기능을 쓰려면 다음 세 가지가 필요합니다:
- **Apple Silicon Mac** : 압축된 가중치를 그대로 쓰는 경로는 현재 PyTorch의 [MPS(Metal Performance Shaders) 백엔드](https://docs.pytorch.org/docs/stable/notes/mps.html)에서만 동작합니다.
- **[ggml-quantization 커널 빌드](https://huggingface.co/kernels/ggml-org/ggml-quantization)가 지원하는 PyTorch 버전**: 보통 최신 PyTorch 릴리스 두 개가 해당합니다.
- **최신 Transformers와 호환되는 `kernels` 버전** : 다음 정식 릴리스 전까지는 Transformers의 `main` 브랜치를 설치해야 합니다.
```bash
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
```
### 모델과 토크나이저 불러오기
GGUF 모델을 불러올 때는 Hub의 `model_id`와 함께 파일 이름을 `gguf_file` 인자로 `from_pretrained()`에 넘깁니다. 한 저장소에 여러 양자화 파일이 들어 있는 경우가 많으므로, 파일 이름으로 어떤 양자화 수준을 쓸지 고르는 방식입니다.
```python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
model_id,
gguf_file=filename
)
```
별도의 설정은 필요하지 않습니다. 가중치가 Metal 위에서 압축된 상태로 유지되면 Transformers가 호환되는 ggml/Metal 레이어 커널을 자동으로 불러오고, 어텐션 구현으로 [`ggml-org/ggml-attn`](https://huggingface.co/kernels/ggml-org/ggml-attn)을 사용합니다. 이 커널을 받아오지 못하면 경고와 함께 PyTorch의 `"sdpa"` 어텐션으로 되돌아가며, `attn_implementation="sdpa"`를 직접 넘겨 강제할 수도 있습니다. [Transformers GGUF 문서](https://huggingface.co/docs/transformers/main/en/quantization/gguf)에 따르면 압축 경로로 불러온 모델은 MPS에서 더 빠르다는 이유로 자동으로 `float32`를 사용하며, 다른 `dtype`을 지정하면 경고가 출력됩니다.
GGUF에 특화된 단계는 여기까지입니다. 이후는 일반적인 Transformers API 그대로입니다:
```python
messages = [{"role": "user", "content": "Explain why the sky is blue in a few sentences."}]
inputs = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
with torch.inference_mode():
outputs = model.generate(**inputs, max_new_tokens=256)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
```
주의할 점도 있습니다. 호환되는 양자화 커널이 없으면 로더는 모델 전체를 역양자화하는 방식으로 되돌아가므로 메모리를 훨씬 많이 쓰게 됩니다. 즉, `kernels` 패키지를 설치하지 않았거나 지원 대상이 아닌 아키텍처라면 이전 버전과 같은 방식으로 동작합니다. 문서에 따르면 Qwen3.5와 Qwen3.5 MoE 이외의 아키텍처(Llama, Mistral, Qwen2, Phi3, Falcon, GPT2 등)는 여전히 항상 역양자화하는 기존 로더를 거칩니다.
## transformers serve로 OpenAI 호환 서버 띄우기
같은 체크포인트를 [`transformers serve`](https://huggingface.co/docs/transformers/main/en/serve-cli/serving) 명령으로 OpenAI 호환 API 서버로 띄울 수도 있습니다:
```bash
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels
transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
```
모델 인자는 `:.gguf` 형식입니다. 콜론 앞은 Hub 저장소(`unsloth/Qwen3.5-4B-GGUF`), 콜론 뒤는 불러올 파일(`Qwen3.5-4B-Q4_K_M.gguf`)로, 여러 양자화 파일이 든 저장소에서 특정 파일 하나를 지정합니다. 채팅 템플릿이 사고(thinking) 모드를 지원하는 모델이라면 `--reasoning off`로 끄거나 `--reasoning on`으로 켤 수 있고, 기본값인 `--reasoning auto`는 채팅 템플릿의 기본 설정을 따릅니다. 자세한 내용은 [추론(reasoning) 옵션 문서](https://huggingface.co/docs/transformers/main/en/serve-cli/serving#enable-reasoning-on-the-server)를 참고하세요.
서버를 띄운 뒤에는 [Jan](https://www.jan.ai/docs/desktop/remote-models/custom-endpoint)이나 코딩 에이전트 [Pi](https://pi.dev/) 같은 클라이언트에 OpenAI 호환 커스텀 공급자를 추가하면 됩니다:
| 설정 | 값 |
| --- | --- |
| Base URL | `http://localhost:8000/v1` |
| Model ID | `unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf` |
모델은 Transformers가 Mac 위에서 실행하고, 클라이언트는 대화 인터페이스만 담당하는 구조입니다. 이 API를 지원하는 다른 클라이언트도 같은 엔드포인트를 그대로 쓸 수 있습니다.
## llama.cpp와의 속도 비교: 세 체크포인트에서 근접한 성능
Hugging Face 팀이 로컬 추론 성능의 기준으로 삼은 것은 llama.cpp입니다. 비교에는 작은 밀집 모델(Qwen3.5-4B), 더 큰 밀집 모델(Qwen3.8-27B), 그리고 **전문가 혼합(Mixture-of-Experts, MoE)** 모델(Qwen3.5-35B-A3B) 세 가지 GGUF 체크포인트를 사용했습니다. 측정 환경은 MacBook Pro M2 Max(32GB 통합 메모리), macOS 26.6, PyTorch 2.12.1, kernels 0.17.0이며 전원을 연결한 상태였습니다.
두 도구의 측정 방식은 조금 다릅니다. llama.cpp 쪽은 [`llama-bench`](https://github.com/ggml-org/llama.cpp/tree/master/tools/llama-bench)(빌드 `5f55650a7`, 릴리스 b10200, ggml 0.18.0의 Metal 백엔드)를 `llama-bench -m -p 0 -n 128 -r 3`으로 실행해 얻은 `tg128` 값입니다. 128개 토큰을 디코딩하는 동안의 생성 속도를 3회 평균한 것으로, 프롬프트 처리 시간은 포함하지 않습니다. 반면 Transformers 쪽은 12토큰짜리 프롬프트로 128개 토큰을 생성하는 `generate()`를 예열 후 3회 실행해 가장 좋은 값을 취했고, 프롬프트 처리(prefill) 시간이 포함되어 있습니다.
Transformers 측정에 사용한 스크립트는 다음과 같습니다. 연속 실행 시 발열로 속도가 10% 이상 떨어지기 때문에 각 실행 사이에 90초씩 쉬도록 한 점이 눈에 띕니다:
```python
import time
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
model_id, filename = "unsloth/Qwen3.5-4B-GGUF", "Qwen3.5-4B-Q4_K_M.gguf"
model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
inputs = tokenizer("The capital of France is Paris. The capital of Germany is", return_tensors="pt")
inputs = inputs.to(model.device)
with torch.inference_mode():
model.generate(**inputs, max_new_tokens=8, min_new_tokens=8, do_sample=False) # warm up
torch.mps.synchronize()
for _ in range(3):
time.sleep(90) # let the machine cool: back-to-back runs decay by 10% or more
start = time.perf_counter()
model.generate(**inputs, max_new_tokens=128, min_new_tokens=128, do_sample=False)
torch.mps.synchronize()
print(f"{128 / (time.perf_counter() - start):.1f} tok/s")
```
llama.cpp 쪽은 다음 명령으로 측정했습니다:
```bash
llama-bench -hf unsloth/Qwen3.5-4B-GGUF:Q4_K_M -p 0 -n 128 -r 3
```
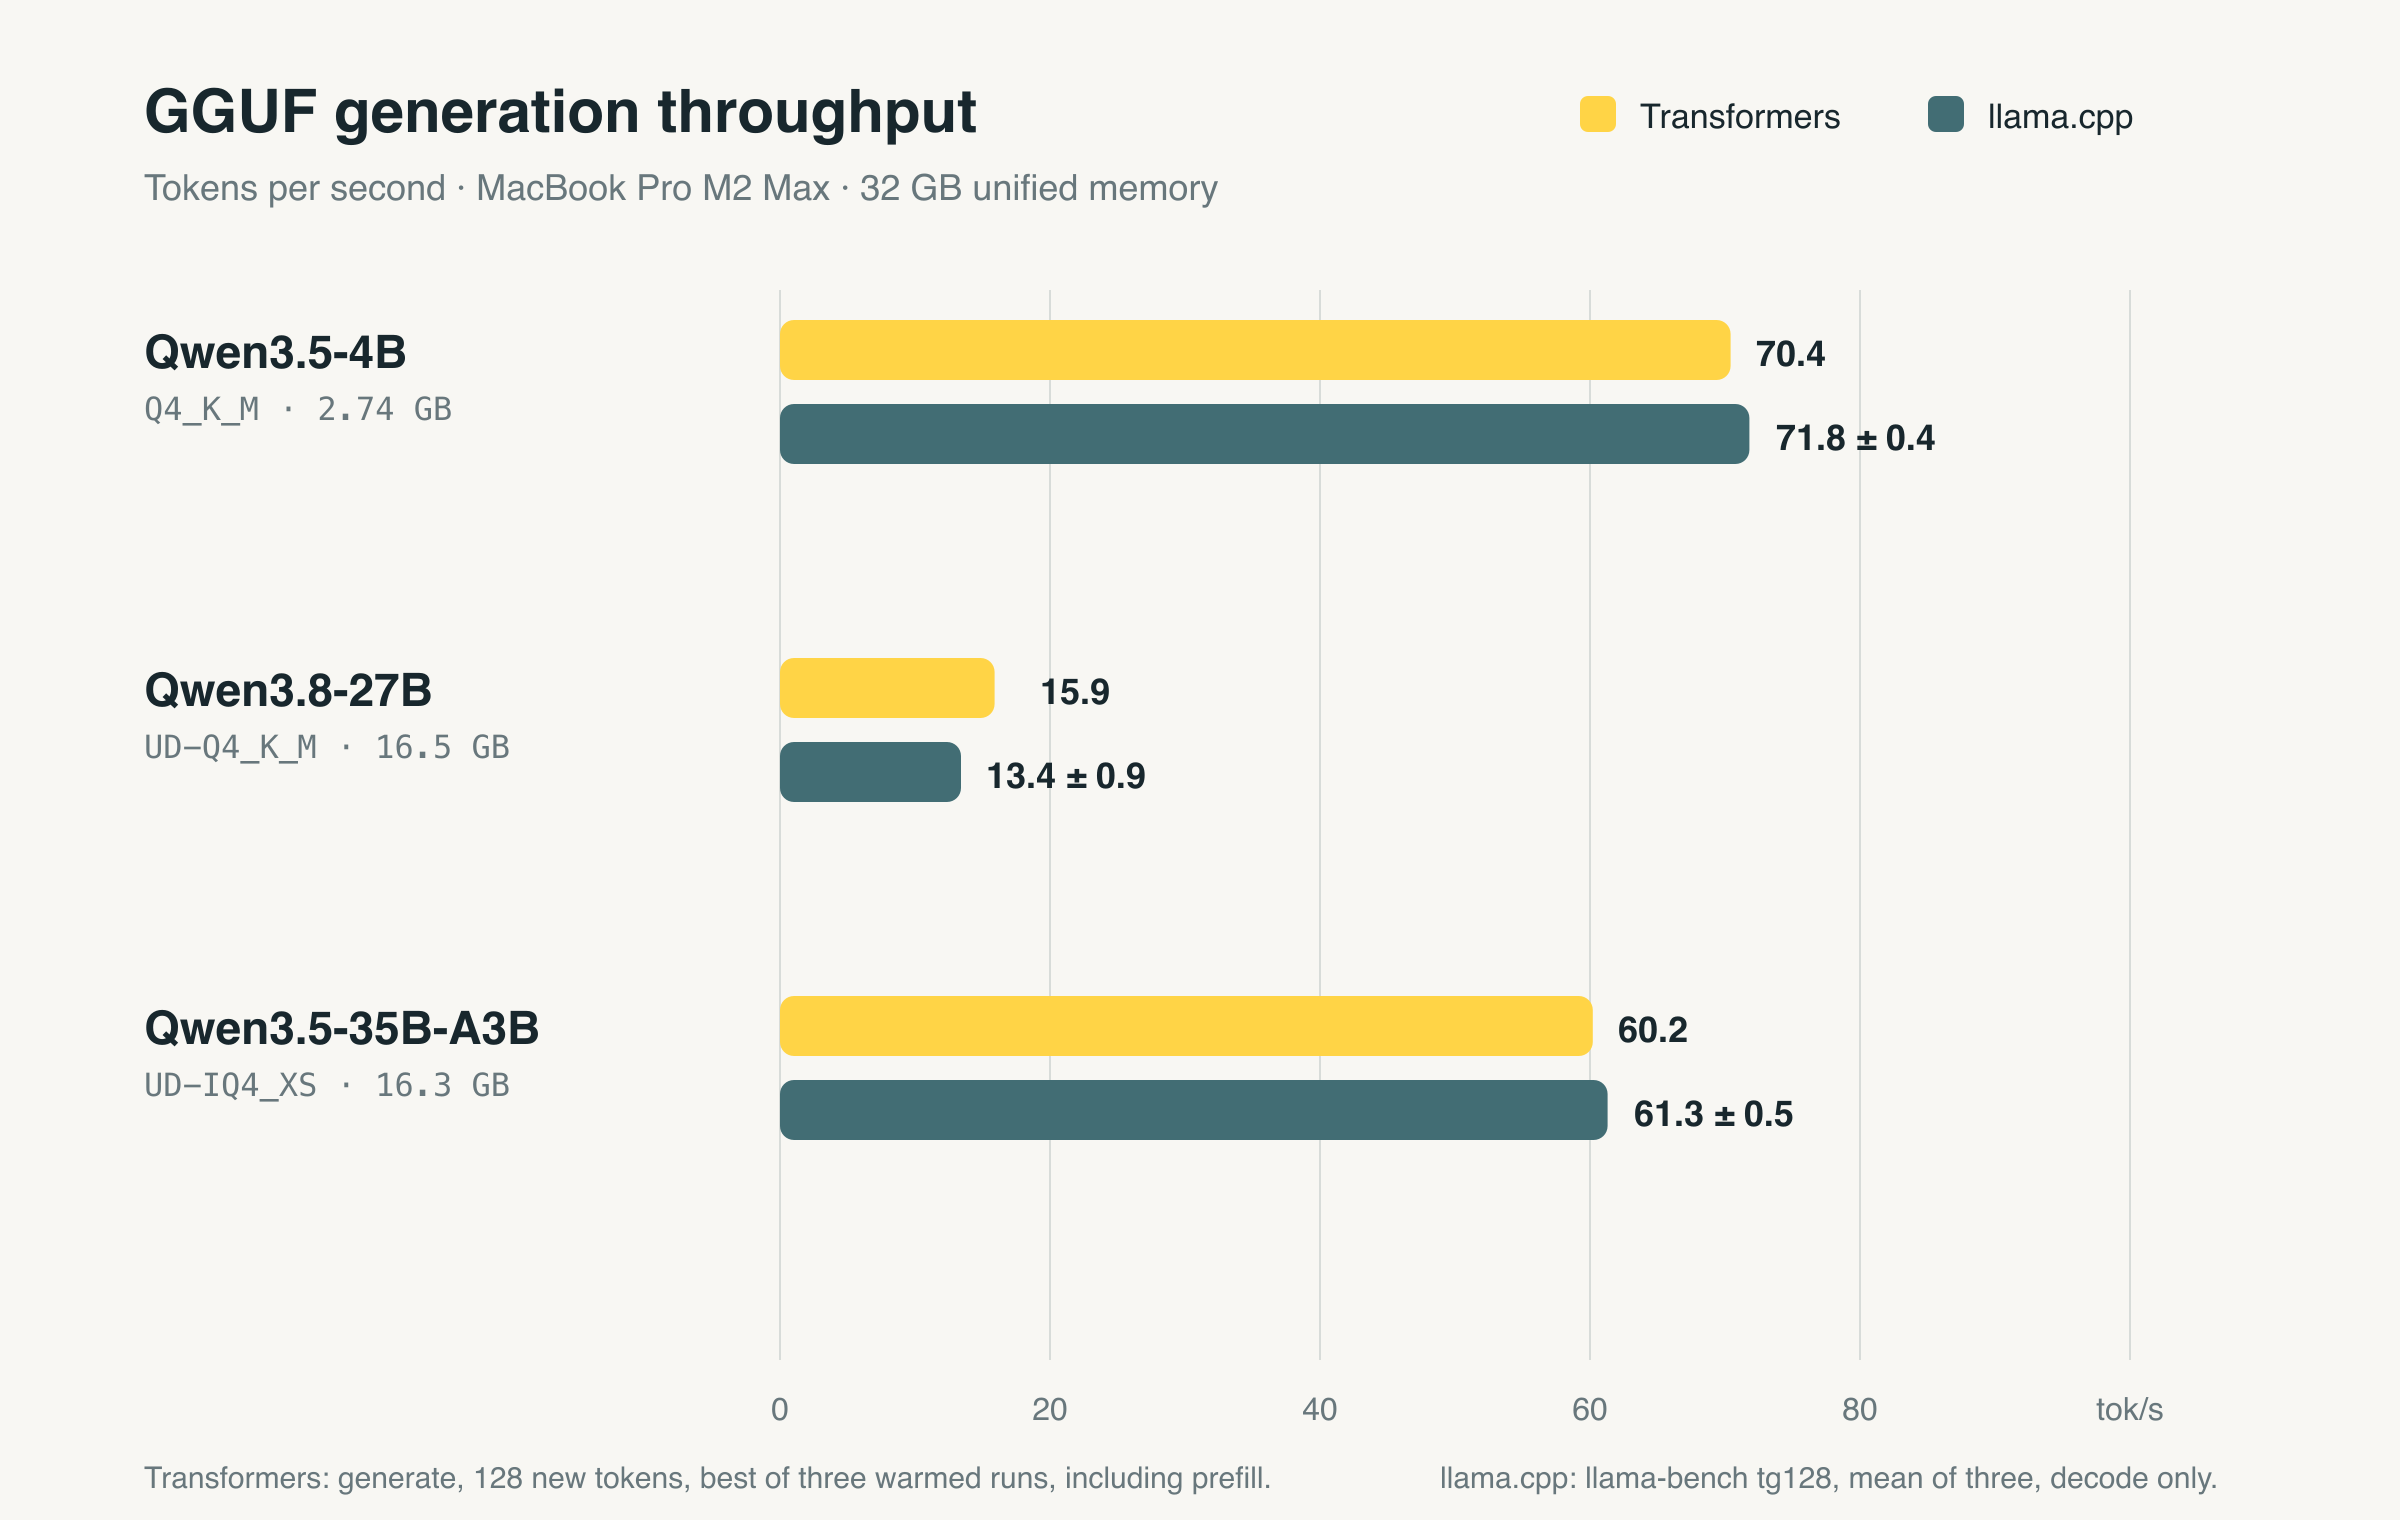
위 차트의 수치를 정리하면 다음과 같습니다. 단, Qwen3.5-35B-A3B 파일은 Hub에 17.5 GB로 표시되며, 차트의 16.3은 GiB 기준 값입니다:
| 모델 (양자화, 크기) | Transformers | llama.cpp |
| --- | --- | --- |
| Qwen3.5-4B (`Q4_K_M`, 2.74 GB) | 70.4 tok/s | 71.8 ± 0.4 tok/s |
| Qwen3.8-27B (`UD-Q4_K_M`, 16.5 GB) | 15.9 tok/s | 13.4 ± 0.9 tok/s |
| Qwen3.5-35B-A3B (`UD-IQ4_XS`, 16.3 GB) | 60.2 tok/s | 61.3 ± 0.5 tok/s |
Qwen3.5-4B와 Qwen3.5-35B-A3B에서는 Transformers가 llama.cpp의 약 98% 속도를 냈고, Qwen3.8-27B에서는 오히려 Transformers 쪽 수치가 더 높게 나왔습니다. 다만 원문도 강조하듯 이 차트는 동일한 벤치마크 조건을 뜻하지 않습니다. Transformers 측정에는 prefill이 포함되고 `llama-bench`는 디코딩만 측정하며, 한쪽은 최고값이고 다른 쪽은 평균값이기 때문입니다. 따라서 이 결과는 순위를 가리는 비교라기보다, Python으로 된 모델 정의와 생성 루프로도 C++ 전용 런타임(runtime)에 가까운 수준까지 올라왔다는 근거로 보는 것이 적절합니다.
## llama.cpp와 Transformers의 역할 분담
[GGML과 llama.cpp 팀이 Hugging Face에 합류](https://huggingface.co/blog/ggml-joins-hf)할 때, Hugging Face는 두 프로젝트의 역할을 서로 보완적인 관계로 설명했습니다. llama.cpp는 로컬 추론의 기반을, Transformers는 모델 정의의 기반을 맡는다는 것입니다. 이번 GGUF 지원은 이 두 축을 한층 가깝게 연결하는 작업입니다.
그렇다고 llama.cpp를 대체하려는 것은 아닙니다. Hugging Face 팀은 "_효율적인 로컬 추론이 최우선이라면 여전히 llama.cpp를 권장한다_"고 분명히 밝힙니다. llama.cpp의 전용 런타임, 메모리 관리, 폭넓은 하드웨어 지원은 모두 그 목표에 맞춰 만들어졌기 때문입니다. 대신 이번 통합은 같은 GGUF 체크포인트를 Transformers 안에서 다룰 수 있는 편리한 방법을 제공하며, 원문은 다음과 같은 활용처를 제시합니다:
- **Python과 PyTorch로 GGUF 실험하기** : hook으로 중간 활성값을 들여다보거나, 모델의 forward 과정을 수정하거나, 익숙한 PyTorch 도구로 커스텀 레이어를 프로토타이핑할 수 있습니다.
- **GGUF 모델 평가하기** : 기존 Transformers 평가 워크플로우를 그대로 써서 양자화 체크포인트의 품질을 측정할 수 있습니다.
- **GGUF 변환 검증하기** : 원본 체크포인트와 GGUF 변환본을 Transformers에서 함께 불러오면, 양자화 오차를 감안하고도 가중치가 올바르게 변환되었는지 확인하기 쉬워집니다.
- **새로운 디코딩 아이디어 시도하기** : `generate()`에 커스텀 logits processor나 stopping criteria를 붙이거나, Python으로 생성 루프를 직접 작성할 수 있습니다.
- **GGUF 체크포인트에서 파인튜닝하기** : 가중치를 역양자화한 뒤 일반적인 Transformers 학습 워크플로우로 이어갈 수 있습니다.
마지막 파인튜닝 시나리오에서는 `GgufConfig(dequantize=True)`를 사용해 원하는 `dtype`의 일반 밀집 모델을 얻습니다:
```python
import torch
from transformers import AutoModelForCausalLM, GgufConfig
model = AutoModelForCausalLM.from_pretrained(
"unsloth/Qwen3.5-4B-GGUF",
gguf_file="Qwen3.5-4B-Q4_K_M.gguf",
quantization_config=GgufConfig(dequantize=True),
dtype=torch.bfloat16,
)
```
## GGUF를 넘어서: llama.cpp가 지원하지 않는 모델에도 ggml 커널을
원문이 "_더 큰 기회_"로 꼽는 것은 GGUF 포맷 자체보다 한 걸음 더 나아간 방향입니다. 바로 **llama.cpp가 지원하지 않는 모델에도 ggml의 성능을 가져오는 것** 입니다.
llama.cpp에서 새 모델을 실행하려면 그 아키텍처를 C/C++로 전부 다시 구현해야 합니다. 반면 Transformers는 이미 수많은 아키텍처의 PyTorch 구현을 갖고 있습니다. ggml 커널과 양자화 방식을 PyTorch에서 쓸 수 있게 되면, llama.cpp에 모델 전체를 먼저 구현하지 않고도 지원되는 연산부터 하나씩 가속할 수 있습니다. 전용 llama.cpp 구현이 끝내 나오지 않을 수도 있는 새 아키텍처, 연구용 모델, 커스텀 변형에 특히 유용한 접근입니다.
이 기회는 GGUF 포맷에 국한되지도 않습니다. 커널은 텐서 위에서 동작할 뿐, 모델 전체가 GGUF 파일에서 왔을 것을 요구하지 않기 때문입니다. 같은 구성 요소를 다른 Transformers 모델과 로딩 워크플로우에 통합할 수 있고, 컴퓨터 비전, 오디오, 멀티모달 모델도 llama.cpp의 전체 구현 없이 호환되는 어텐션, 정규화, 행렬곱 커널을 재사용할 길이 열립니다. 물론 아키텍처마다 통합과 검증 작업은 따로 필요하며, 이번에 공개된 GGUF 예제는 텍스트 생성만 다룹니다.
## Python과 PyTorch로 빠른 로컬 추론을 만든 방법
Hugging Face 팀은 모델과 생성 루프를 Python에 그대로 둔 채 어디까지 빨라질 수 있는지도 보여주고자 했습니다. 원문의 표현을 빌리면 "_적절한 커널과 효율적인 생성 루프가 있으면 Python과 PyTorch로도 강력한 로컬 추론 성능을 낼 수 있다_"는 것입니다. 무거운 연산은 커널이 맡고, 생성 루프는 불필요한 동기화를 피해 GPU가 쉬지 않도록 합니다.
특히 [`torch.compile`](https://docs.pytorch.org/docs/stable/generated/torch.compile.html) 없이 eager 실행 자체를 빠르게 만드는 데 초점을 두었습니다. 대화형으로 쓸 때는 빠르게 시작하고 토큰이 끊김 없이 나오는 것이 중요한데, 컴파일을 쓰면 처음에 컴파일 대기 시간이 생기고 입력 형태가 바뀔 때마다 재컴파일이 일어날 수 있기 때문입니다. 이를 위한 작업은 크게 커널과 `generate()` 자체의 개선, 두 갈래로 나뉩니다.
### ggml의 Metal 커널 재사용하기
**커널(Kernel)** 은 GPU에서 하나의 연산을 수행하는 작은 프로그램입니다. PyTorch는 범용 구현을 제공하지만, 특화된 커널은 연산량을 줄이거나, 여러 연산을 하나로 합치거나(fusion), 양자화된 가중치를 저장된 형식 그대로 읽을 수 있습니다. Hugging Face의 [`kernels`](https://github.com/huggingface/kernels) 라이브러리는 이렇게 빌드된 커널을 Hub에 올려 배포하고 Transformers에서 불러 쓸 수 있게 해 주는 도구로, 이번 작업에서는 ggml의 Metal 커널을 호환 빌드로 배포하는 데 쓰였습니다. 덕분에 모델을 별도의 추론 런타임으로 교체하지 않고도 ggml의 성과를 PyTorch 모델 안으로 가져올 수 있습니다.
사용된 커널은 다음 다섯 가지입니다:
| 커널 | 역할 |
| --- | --- |
| [`ggml-quantization`](https://huggingface.co/kernels/ggml-org/ggml-quantization) | 압축된 양자화 가중치를 직접 읽어 행렬 연산을 수행합니다. MoE 모델에서 선택된 전문가의 가중치도 포함되며, 디코딩 연산마다 가중치 행렬 전체를 풀어 놓지 않아도 됩니다. |
| [`ggml-norm`](https://huggingface.co/kernels/ggml-org/ggml-norm) | 정규화 연산을 하나로 합칩니다(fusion). Qwen3.5와 Qwen3.8이 쓰는 zero-centered RMSNorm도 포함합니다. |
| [`ggml-attn`](https://huggingface.co/kernels/ggml-org/ggml-attn) | 프롬프트 처리와 토큰 디코딩에 ggml의 Metal 플래시 어텐션(flash attention)을 제공합니다. |
| [`ggml-gated-delta-net`](https://huggingface.co/kernels/ggml-org/ggml-gated-delta-net) | Qwen3.5와 Qwen3.8 하이브리드 아키텍처의 선형 어텐션 레이어에 쓰이는 gated delta network를 가속합니다. |
| [`topk`](https://huggingface.co/kernels/transformers-community/topk) | MoE 모델에서 토큰마다 전문가를 고르는 softmax와 top-k 라우팅을 하나로 합칩니다. Hugging Face가 직접 작성한 Metal 구현입니다. |
앞의 네 가지는 ggml 커널을 기반으로 하고, `topk` 커널은 MoE 라우팅에서 생기는 별도의 병목을 해결하기 위해 추가되었습니다. 함께 쓰이면 토큰 하나를 생성하는 데 필요한 GPU 작업량이 줄어듭니다.
_:pytorch::kr:gated delta network와 관련해서는 다음 논문(Gated Delta Networks: Improving Mamba2 with Delta Rule)을 참고해주세요:_
> **[Gated Delta Networks: Improving Mamba2 with Delta Rule](https://arxiv.org/abs/2412.06464)**
>
> Linear Transformers have gained attention as efficient alternatives to standard Transformers, but their performance in retrieval and long-context tasks has been limited. To address these limitations, recent work has explored two distinct mechanisms:...
레이어 커널의 기여도를 확인하기 위해 원문은 같은 압축 GGUF 체크포인트를 레이어 커널이 있을 때와 없을 때로 나누어 비교했습니다. 양자화 커널은 두 설정 모두에서 켜 두었는데, 이를 끄면 가중치 표현 방식 자체가 바뀌어(역양자화) 전혀 다른 절충을 측정하게 되기 때문입니다.
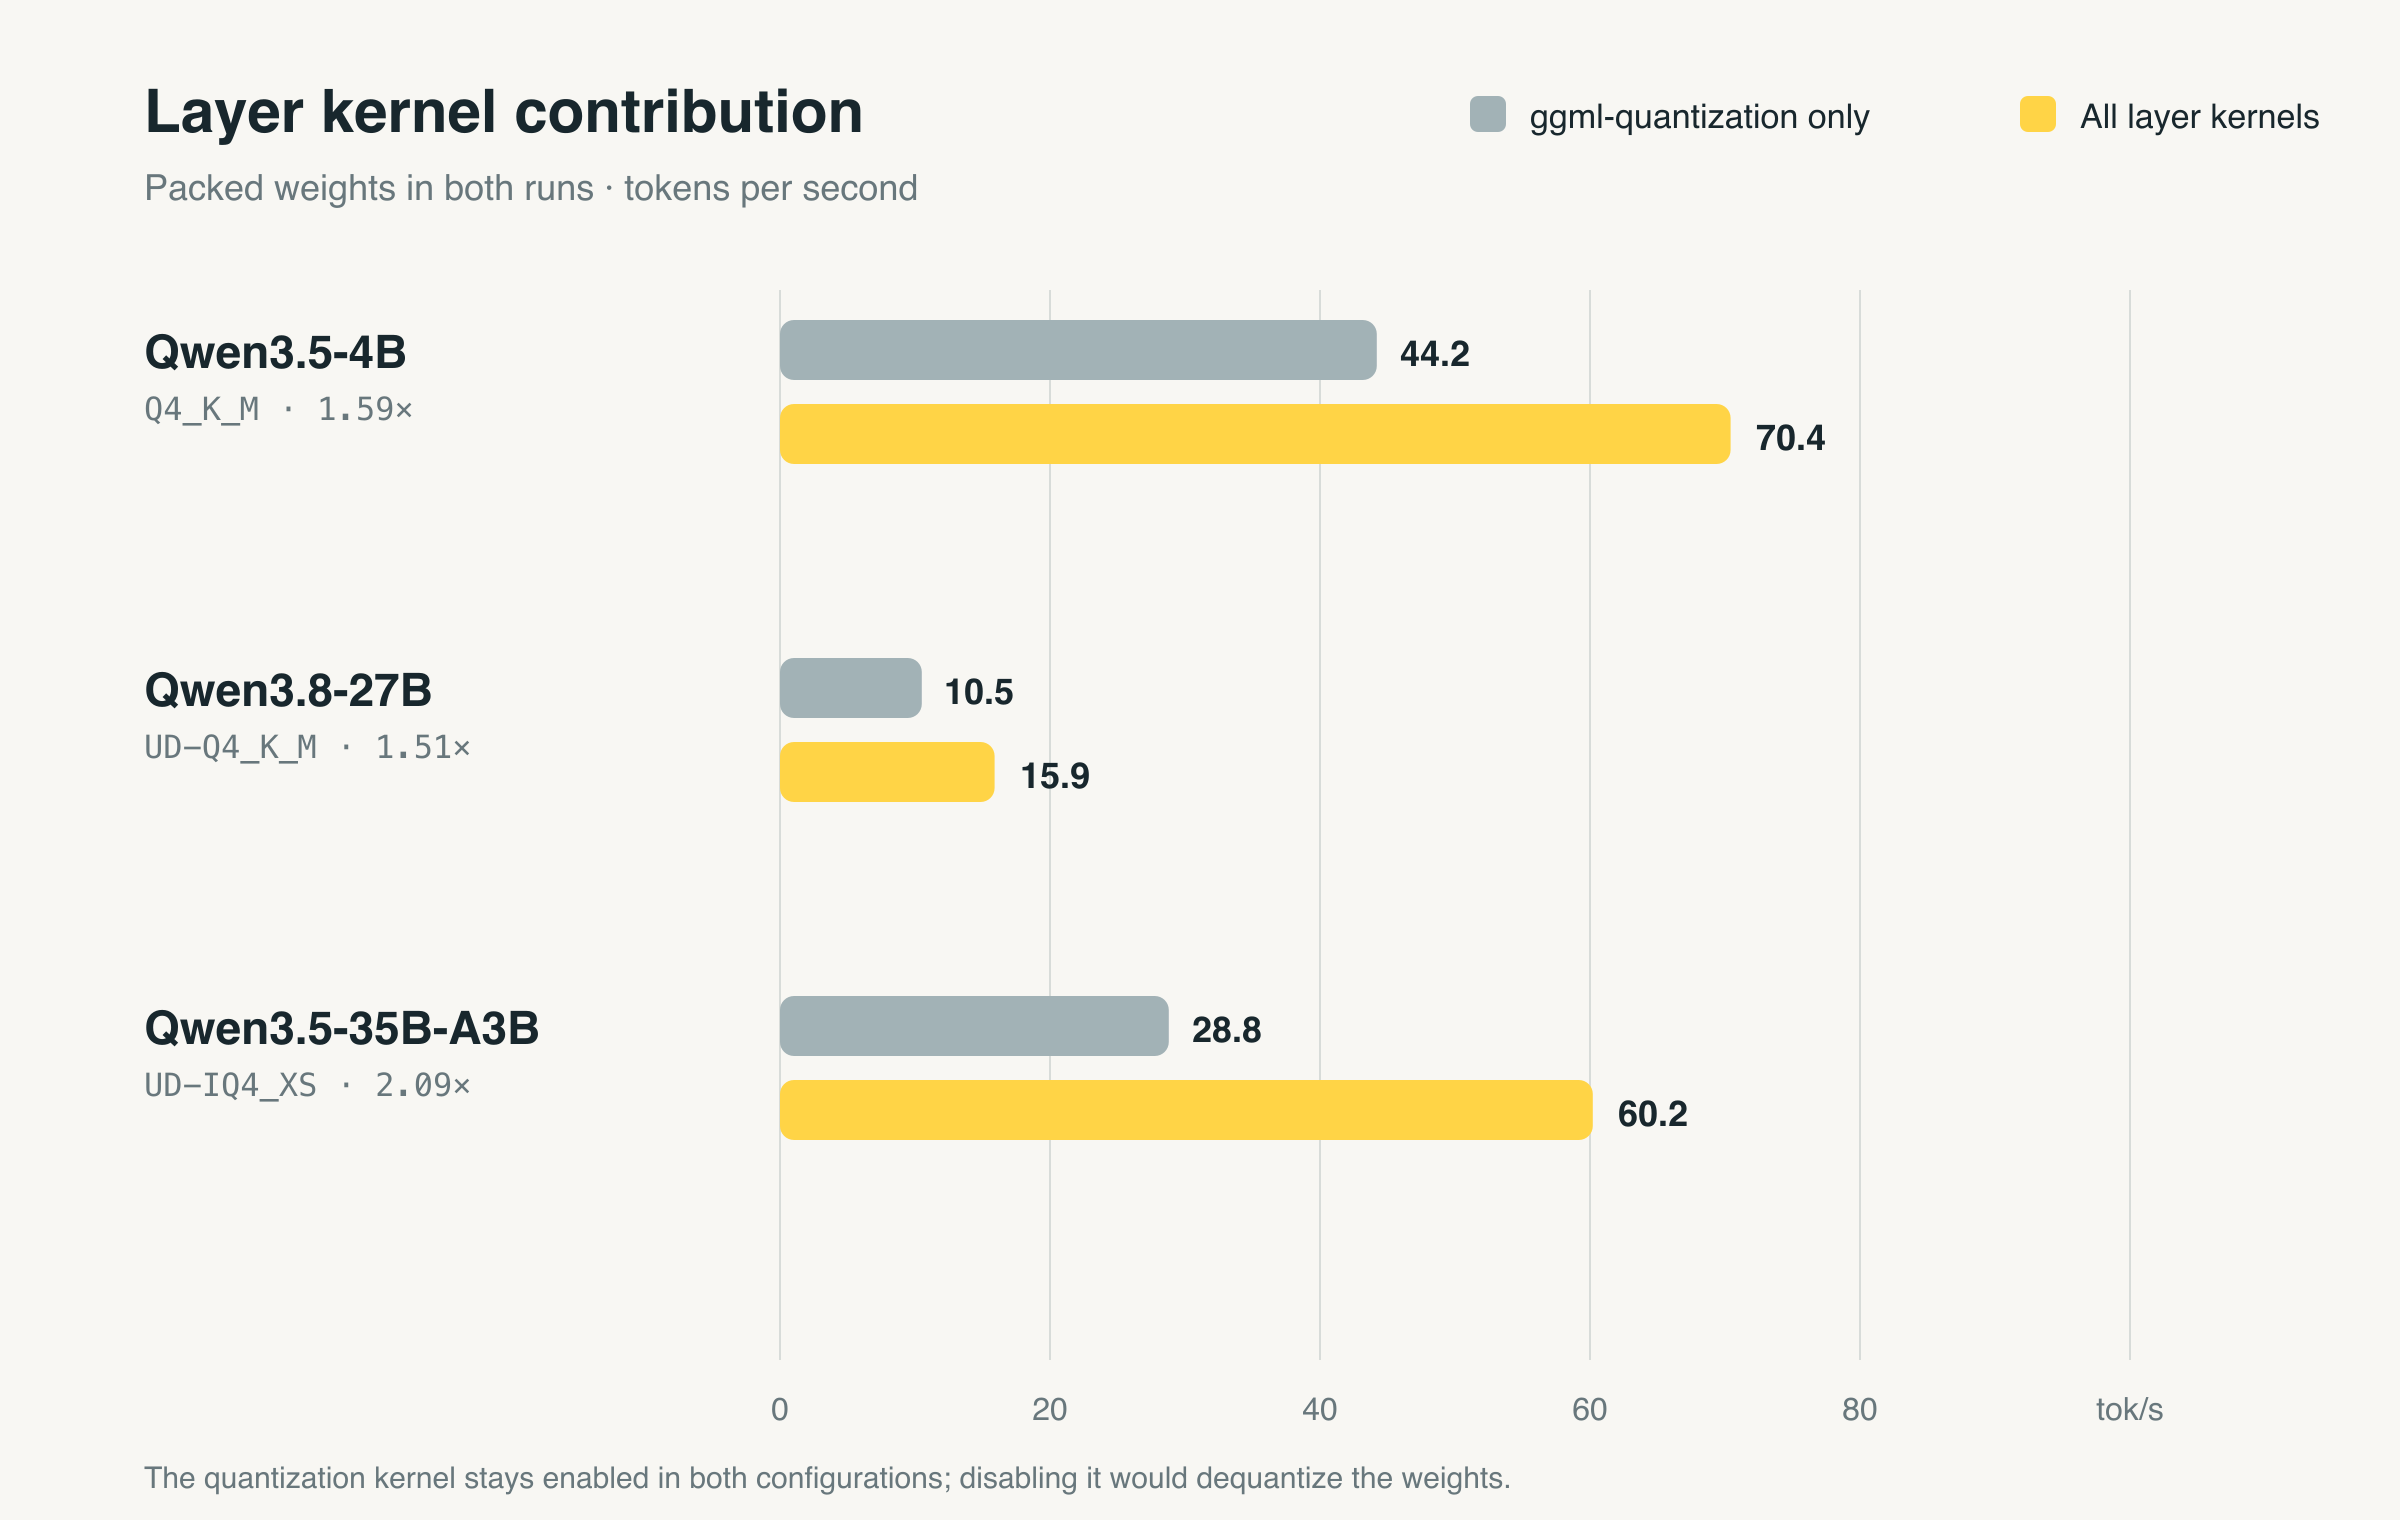
레이어 커널을 모두 켜면 Qwen3.5-4B는 44.2에서 70.4 tok/s로 1.59배, Qwen3.8-27B는 10.5에서 15.9 tok/s로 1.51배, Qwen3.5-35B-A3B는 28.8에서 60.2 tok/s로 2.09배 빨라졌습니다. 세 모델 중 MoE 모델인 Qwen3.5-35B-A3B의 향상 폭이 가장 컸습니다.
### CPU와 GPU가 서로 기다리지 않게 하기
커널이 빨라져도 GPU에 할 일이 끊기면 소용이 없습니다. 생성 과정에서 CPU는 GPU 연산을 예약(scheduling)하고, 다음 토큰을 만드는 루프를 제어합니다. 그런데 GPU의 결과를 CPU로 읽어 오는 순간, CPU는 대기열에 쌓인 GPU 연산이 모두 끝날 때까지 기다려야 할 수 있습니다. 토큰마다 짧은 대기가 한 번씩만 생겨도 전체 처리량은 눈에 띄게 줄어듭니다.
Hugging Face 팀은 이를 해결하기 위해 `generate()`에 두 가지 변경을 넣었으며, 이 개선은 GGUF 파일을 쓸 때뿐 아니라 모든 Transformers 모델에 적용됩니다:
- **[불필요한 어텐션 마스크를 초반에 제거 (#48814)](https://github.com/huggingface/transformers/pull/48814)**: 지원되는 디코더 전용(decoder-only) 모델의 입력에 패딩이 없으면, 모든 값이 1인 패딩 마스크를 생성 시작 시점에 제거합니다. 이후 어텐션 코드가 마스크를 건너뛰어도 되는지 매번 검사할 필요가 없어지며, 인과적(causal) 어텐션은 그대로 유지됩니다.
- **[종료 조건 확인을 한 단계 늦추기 (#47975)](https://github.com/huggingface/transformers/pull/47975)**: 지원되는 경로에서는 `generate()`가 종료 여부 판단 결과를 비동기로 복사해 두고 다음 단계에서 사용합니다. 그 사이 GPU가 연산하는 동안 CPU는 계속 다음 작업을 예약할 수 있습니다. 토큰 스트리밍도 같은 방식을 쓰며, 종료 조건을 넘어 한 단계 더 생성된 토큰은 결과에서 제거됩니다. PR 설명에 따르면 Metal에서는 이 대기가 디코딩 단계마다 약 1.4ms씩 더해졌고(단계당 12.4ms에서 11ms로 단축), CUDA에서는 GPU 연산이 이미 CPU의 예약과 겹쳐 진행되므로 이 변경만으로는 속도 향상이 없습니다.
두 변경은 모델 바깥의 생성 루프를 개선하는 것이라 GGUF가 아닌 모델에도 적용됩니다. 커널 작업과도 서로 보완적입니다. 커널은 연산 하나의 비용을 줄이고, 동기화 지점이 줄어들면 CPU의 예약과 GPU의 실행이 서로 겹쳐 진행될 수 있습니다.
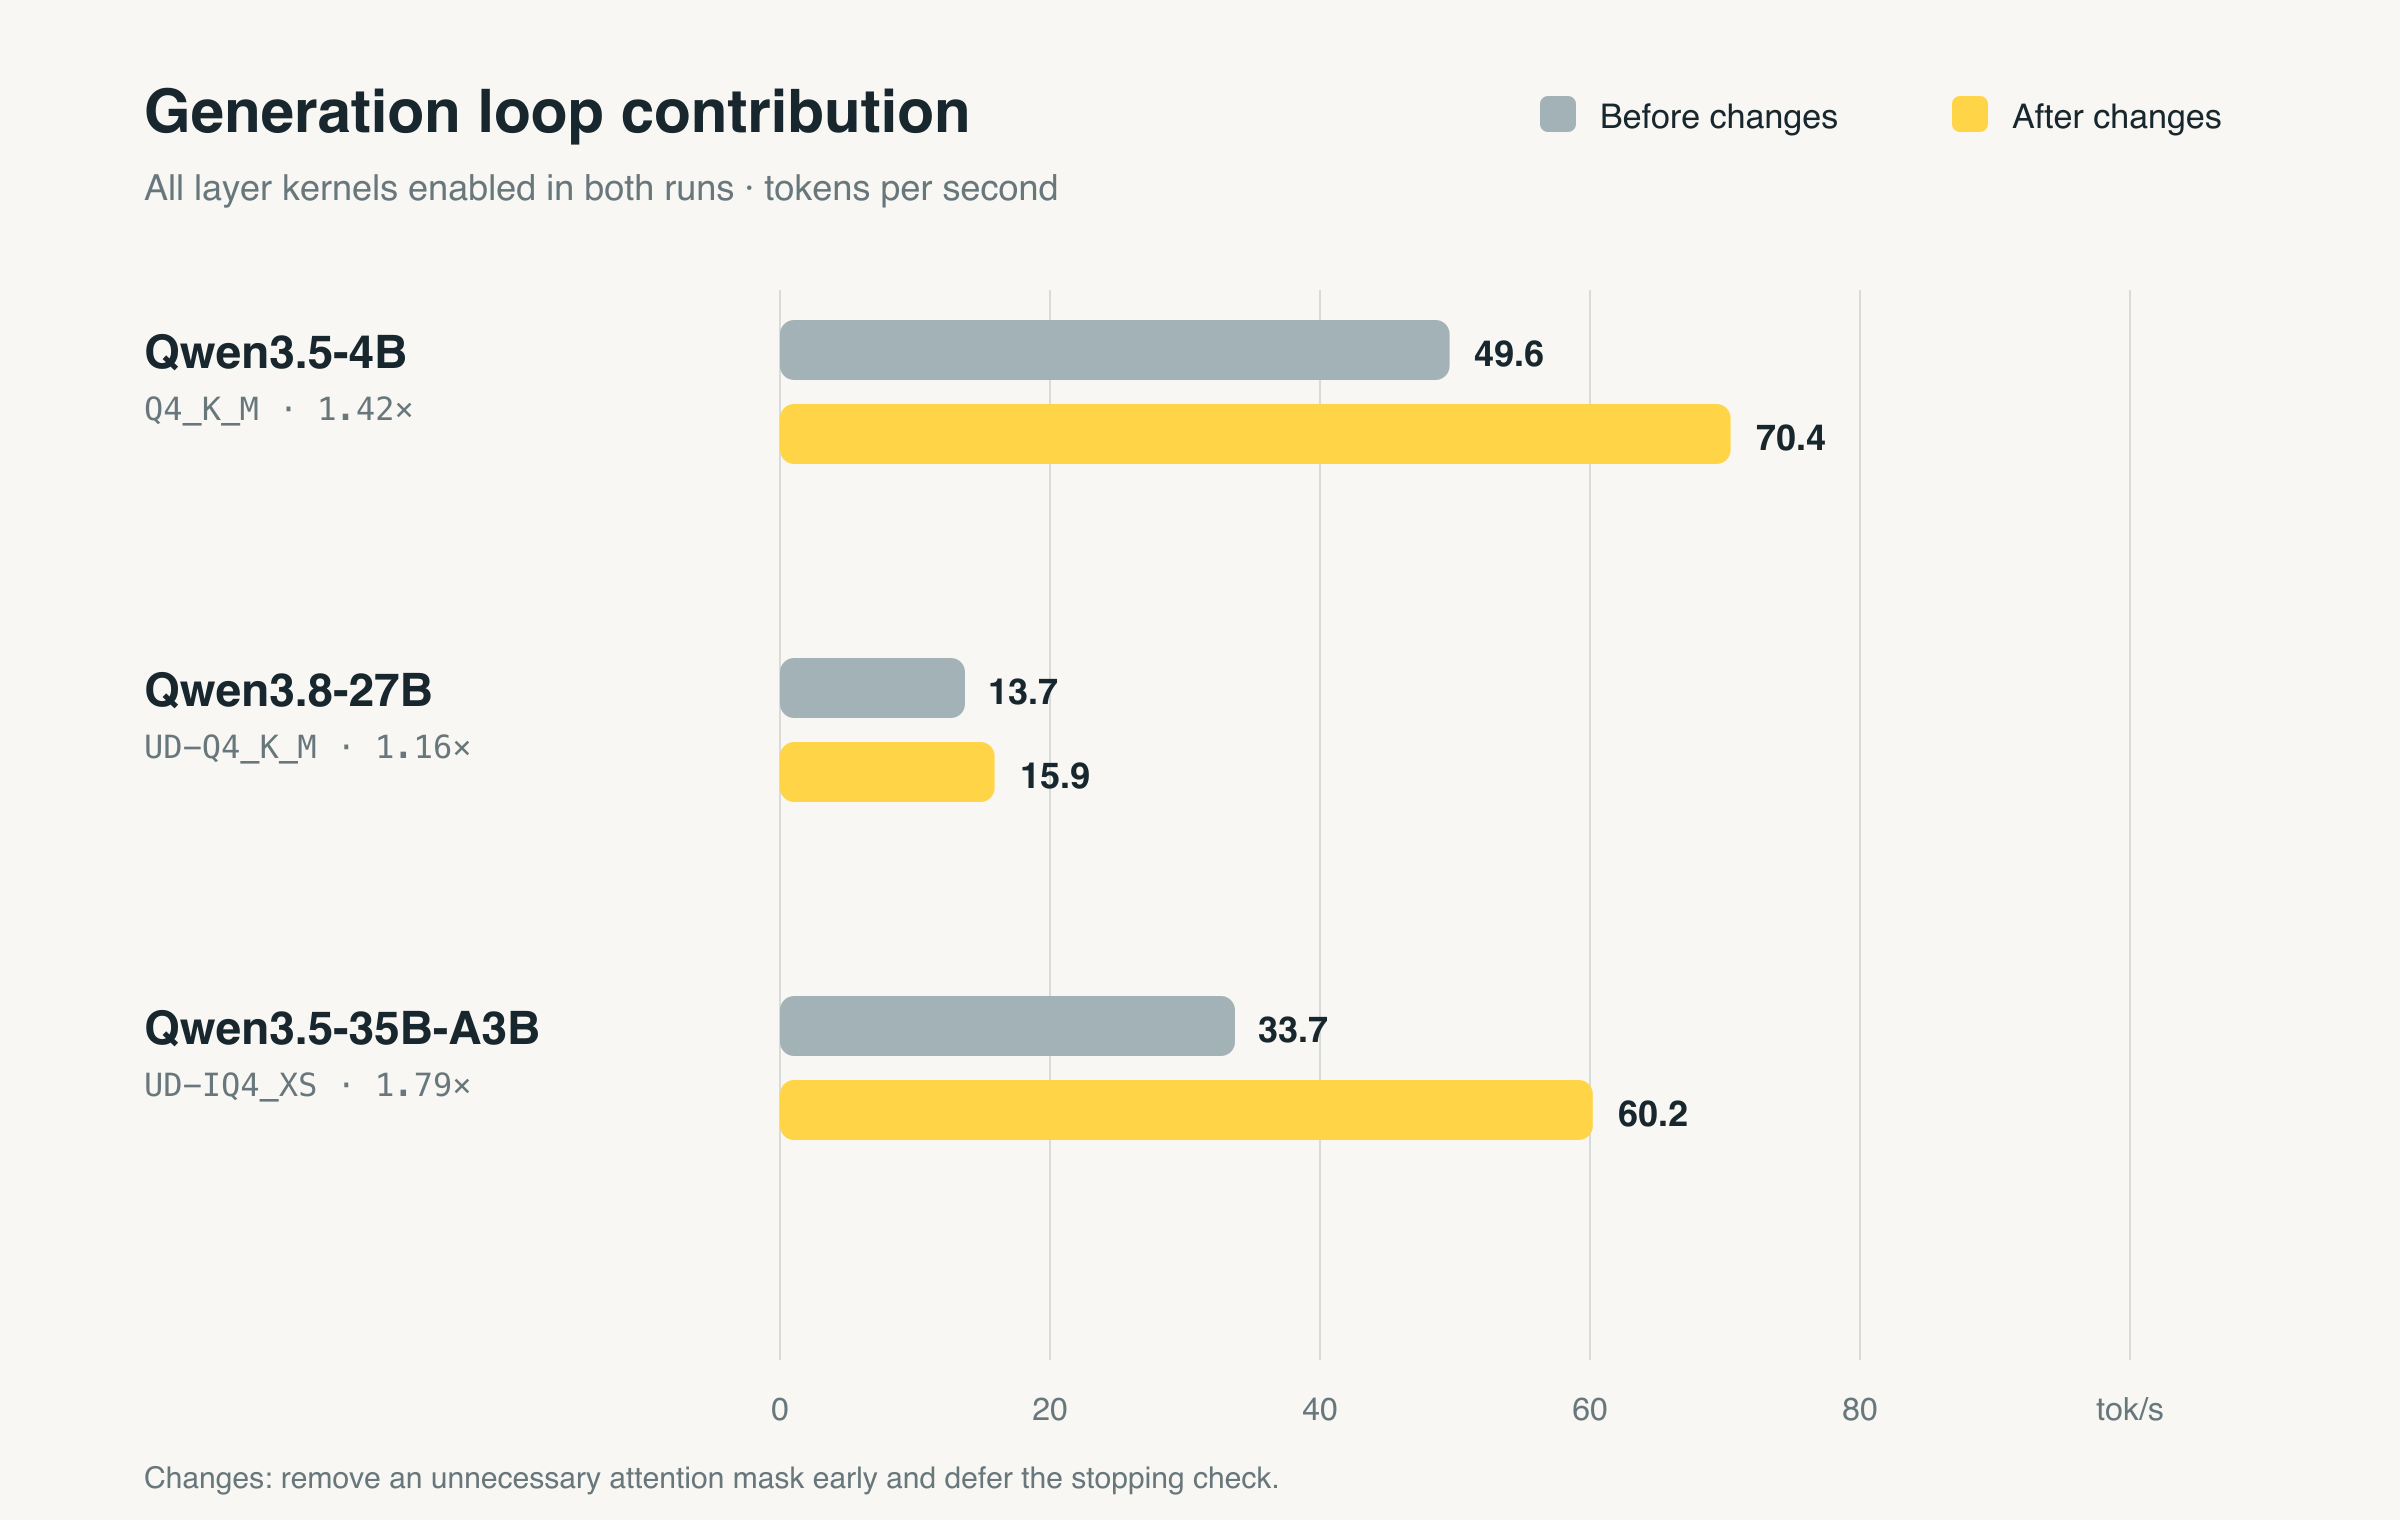
이 측정에서는 레이어 커널을 모두 켠 상태에서 생성 루프 변경만의 효과를 분리했습니다. Qwen3.5-4B는 49.6에서 70.4 tok/s로 1.42배, Qwen3.8-27B는 13.7에서 15.9 tok/s로 1.16배, Qwen3.5-35B-A3B는 33.7에서 60.2 tok/s로 1.79배 빨라졌습니다. 밀집 27B 모델의 향상 폭이 가장 작았고, 작은 모델과 MoE 모델에서 향상 폭이 컸습니다.
## 현재의 한계와 다음 단계
이번 작업의 1차 목표는 Apple Silicon에서 한 번에 하나의 대화를 처리하는 대화형 사용입니다. 따라서 다음과 같은 제약을 염두에 두어야 합니다:
- **압축된 가중치로 추론하는 경로는 현재 MPS 전용입니다.** 역양자화를 거쳐 GGUF를 불러오는 방식은 별도로 계속 쓸 수 있지만, GGUF 파일 포맷을 지원한다고 해서 모든 장치에서 압축 커널을 쓸 수 있다는 뜻은 아닙니다. CUDA GPU나 CPU에서는 아직 역양자화 경로를 거칩니다.
- **패딩과 배치 처리는 아직 개선이 필요합니다.** 패딩이 없는 입력은 앞서 설명한 마스크 최적화의 이점을 얻지만, 패딩이 있는 배치는 같은 지름길을 쓸 수 없어 성능이 낮을 수 있습니다. Hugging Face 팀은 이 작업을 MPS의 `generate_batch`로 확장할 계획입니다.
- **지원 아키텍처가 제한적입니다.** 압축 로더는 현재 Qwen3.5의 밀집 모델과 MoE 아키텍처, 그리고 호환되는 Qwen3.8 체크포인트만 지원합니다. 다른 아키텍처의 추가는 비교적 간단하다고 하며, 점진적으로 범위를 넓힐 예정입니다.
Transformers에서 써 보고 싶은 GGUF 모델이 있다면 체크포인트와 사용 사례를 적어 [Transformers 저장소에 이슈](https://github.com/huggingface/transformers/issues)를 열어 달라고 요청하고 있습니다. 사람들이 실제로 로컬에서 사용하는 모델을 우선 지원하는 데 참고하겠다는 것입니다.
정리하면, 이번 업데이트로 Transformers의 GGUF 지원은 파일을 열어 변환하는 단계에서, 압축된 가중치를 그대로 두고 빠르게 실행하는 단계로 넘어갔습니다. 지원 범위는 아직 Apple Silicon과 Qwen3.5 계열로 좁지만, llama.cpp가 다듬어 온 커널을 PyTorch 모델에서 재사용하는 구조가 자리 잡았다는 점에서 다음 확장 방향이 분명합니다. 로컬에서 GGUF 모델을 실행하면서 중간 활성값을 확인하거나 평가, 파인튜닝까지 이어가고 싶었던 PyTorch 사용자라면 `main` 브랜치에서 먼저 써 볼 만합니다.
## 📜 Transformers now runs llama.cpp quants 블로그
> **[Transformers now runs llama.cpp quants](https://huggingface.co/blog/transformers-llama-cpp-quants)**
>
> We’re on a journey to advance and democratize artificial intelligence through open source and open science.
## 📚 Transformers GGUF 공식 문서
> **[GGUF · Hugging Face](https://huggingface.co/docs/transformers/main/en/quantization/gguf)**
>
> We’re on a journey to advance and democratize artificial intelligence through open source and open science.
## :github: Transformers GitHub 저장소
> **[GitHub - huggingface/transformers: 🤗 Transformers: the model-definition framework for...](https://github.com/huggingface/transformers)**
>
> 🤗 Transformers: the model-definition framework for state-of-the-art machine learning models in text, vision, audio, and multimodal models, for both inference and training.
## 더 읽어보기
- [Hugging Face, PyTorch를 단일 Backend로 채택한 Transformers v5 공개](https://discuss.pytorch.kr/t/hugging-face-pytorch-backend-transformers-v5/8334)
- [Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model](https://discuss.pytorch.kr/t/qwen3-5-native-multimodal-agent-model/9013)
- [Qwen3.8-Flash-Next, 1/9의 학습 비용으로 Qwen3.7-Plus(397B-A17B) 수준에 도달한 125B-A6B 모델](https://discuss.pytorch.kr/t/qwen3-8-flash-next-1-9-qwen3-7-plus-397b-a17b-125b-a6b/11730)
- [ExecuTorch MLX 델리게이트로 Apple Silicon GPU에서 PyTorch 모델 실행하기 | 파이토치 한국 사용자 모임](https://discuss.pytorch.kr/t/executorch-mlx-apple-silicon-gpu-pytorch/10348)
- [Rapid-MLX: Apple Silicon 맥에서 로컬 LLM을 OpenAI 호환 서버로 띄우는 추론 엔진](https://discuss.pytorch.kr/t/rapid-mlx-apple-silicon-llm-openai/11516)
* * *
_이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다._ 🤗
[:pytorch:파이토치 한국 사용자 모임🇰🇷](https://pytorch.kr/)에서 이런 글들을 계속 정리하고 있습니다. [회원 가입](https://discuss.pytorch.kr/signup)으로 주요 글들을 이메일💌로, [텔레그램(Telegram)](https://t.me/pytorchkr)이나 [Slack/Discord/Teams/Dooray/GoogleChat 등](https://discuss-noti.pytorch.kr)으로 새 글 알림을 받아보세요! 😃
🎁 아래↘쪽에 좋아요👍를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~ 🤩