# Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
**URL:** https://discuss.pytorch.kr/t/jev-decision-index-jevbench/12095
**Category:** 읽을거리&정보공유
**Tags:** leaderboard, jev, typesafe-ai, decision-model, hugging-face, structured-output, benchmark
**Created:** [10월 5, 2026, 11:30오후 UTC](https://discuss.pytorch.kr/t/jev-decision-index-jevbench/12095 "2026-10-05T23:30:32Z")
**Posts on this page:** 1
**Page:** 1
### Author:  [@9bow](https://discuss.pytorch.kr/u/9bow)
#### Post date: [10월 5, 2026, 11:30오후 UTC](https://discuss.pytorch.kr/t/jev-decision-index-jevbench/12095/1 "2026-10-05T23:30:32Z")
## 핵심 요약
- [Jev Decision Index](https://huggingface.co/spaces/multimodalart/jev-decision-index)는 Hugging Face의 ML 엔지니어 apolinário(multimodalart)가 운영하는 Space입니다. News 탭은 Jev 재현 산출물 66개를 모으고, Index 탭은 모델 70개를 같은 38개 벤치마크로 채점합니다.
- Decision Index 0.2.1에서 Jev는 57.91점이고, 가장 가까운 오픈 모델은 Surogate Rune 26B-A4B v3(57.44점)와 Gemma 4 31B에 디코딩 기법만 얹은 Decider chat(57.33점)입니다. Jev를 넘은 오픈 모델은 아직 없습니다.
- 비용과 속도까지 점수에 넣는 [JevBench](https://benchmarkheaven.com/jev-models)에서는 순위가 달라집니다. 공식 점수 1, 2위는 Cygnet(73.7)과 Winnow-12B Q8(73.2)이고, Jev는 72.1로 3위입니다.
- 이미지를 보고 결정하는 [Image JevBench](https://benchmarkheaven.com/image-jev-bench)에는 Jev가 없습니다. Jev API가 이미지를 받지 않기 때문이며, 오픈 모델 중에서는 Imajev-4B가 종합 2위(76.39)입니다.
- 세 리더보드는 모두 영어 데이터로 채점합니다. 모델 카드에 한국어(`ko`)를 적은 모델은 Index의 70개 중 2개뿐이므로, 한국어 업무에 쓰려면 직접 검증이 필요합니다.
## 오픈소스 Jev 재현 모델과 Decision Index 소개
[TypeSafe AI](https://typesafe.ai/)가 2026년 9월 중순에 공개한 [Jev](https://docs.typesafe.ai/)는 문장을 생성하지 않는 **결정 모델(Decision Model)** 입니다. 프로그램 상태와 질문을 넣으면, 선택지 하나(Choice), 점수(Score), 참과 거짓(Noul) 중 하나를 확률과 함께 돌려줍니다. TypeSafe는 모든 질문을 한 번에 병렬로 처리해 응답이 빠르고, 출력 형식이 정해져 있어 파싱 오류가 나지 않는다고 설명합니다. Jev의 설계와 학습 방법인 **보정된 결정을 위한 강화학습(Reinforcement Learning for Calibrated Decisions, RLCD)** 은 [Jev 소개 글](https://discuss.pytorch.kr/t/jev-system-one-feat-typesafe-ai/11935)에서 자세히 다뤘습니다.
그러나 Jev는 가중치가 공개되지 않은 API 전용 모델이고, 공개 직후에는 얼리 액세스로만 제공되었습니다. 그래서 공개 직후부터 오픈소스 재현 시도가 이어졌습니다. 며칠 사이에 여러 방법이 나왔습니다. 일반 LLM의 선택지 로짓(logit)을 한 번에 읽는 디코딩 기법도 있고, Qwen이나 Gemma에 결정 헤드를 붙여 학습한 모델도 있습니다. 확산 언어 모델을 Jev처럼 쓰는 방법도 등장했습니다. 이렇게 생겨난 GitHub 프로젝트 1천여 개는 [Jev 생태계 목록 글](https://discuss.pytorch.kr/t/jev-jev-github-1-23/12003)에서 23개 분야로 정리했습니다.
프로젝트가 많아지자 "그래서 어떤 모델이 Jev에 가장 가까운가?"라는 질문이 남았습니다. 각 프로젝트가 서로 다른 벤치마크로 자체 성능을 발표했기 때문입니다. Hugging Face의 ML 엔지니어 apolinário가 만든 Space [Jev Decision Index](https://huggingface.co/spaces/multimodalart/jev-decision-index)는 이 질문에 답하려는 비공식 커뮤니티 프로젝트입니다. News 탭은 재현 산출물을 종류별로 모으고, Index 탭은 그중 실행 가능한 모델을 같은 GPU와 같은 시험지로 채점합니다. 채점 코드는 [apolinario/decision-index](https://github.com/apolinario/decision-index) 저장소에 MIT 라이선스로 공개되어 있습니다.
이 글은 두 탭의 내용을 정리하고, 비용과 속도를 함께 재는 독립 벤치마크인 Benchmark Heaven의 [JevBench](https://benchmarkheaven.com/jev-models)와 [Image JevBench](https://benchmarkheaven.com/image-jev-bench)를 함께 소개합니다. 같은 모델도 리더보드마다 순위가 크게 다르므로, 모델을 고르기 전에 각 점수가 무엇을 재는지 확인해야 합니다.
## News 탭: 66개 재현 산출물을 다섯 갈래로 나눈 추적표
News 탭의 제목은 _Jev Reproductions Tracker_입니다. 66개 산출물을 추적합니다(반응 지표는 2026년 9월 24일 스냅샷). 그중 30개는 Hugging Face Hub에 가중치가 있고, 50개는 GitHub 저장소, 8개는 Hugging Face Space를 갖고 있습니다. 카드는 X 좋아요, GitHub 스타, Hub 좋아요, 조회수를 합산한 _trending_ 점수로 정렬되고, 새 항목이 묻히지 않도록 날짜 가산점이 붙습니다.
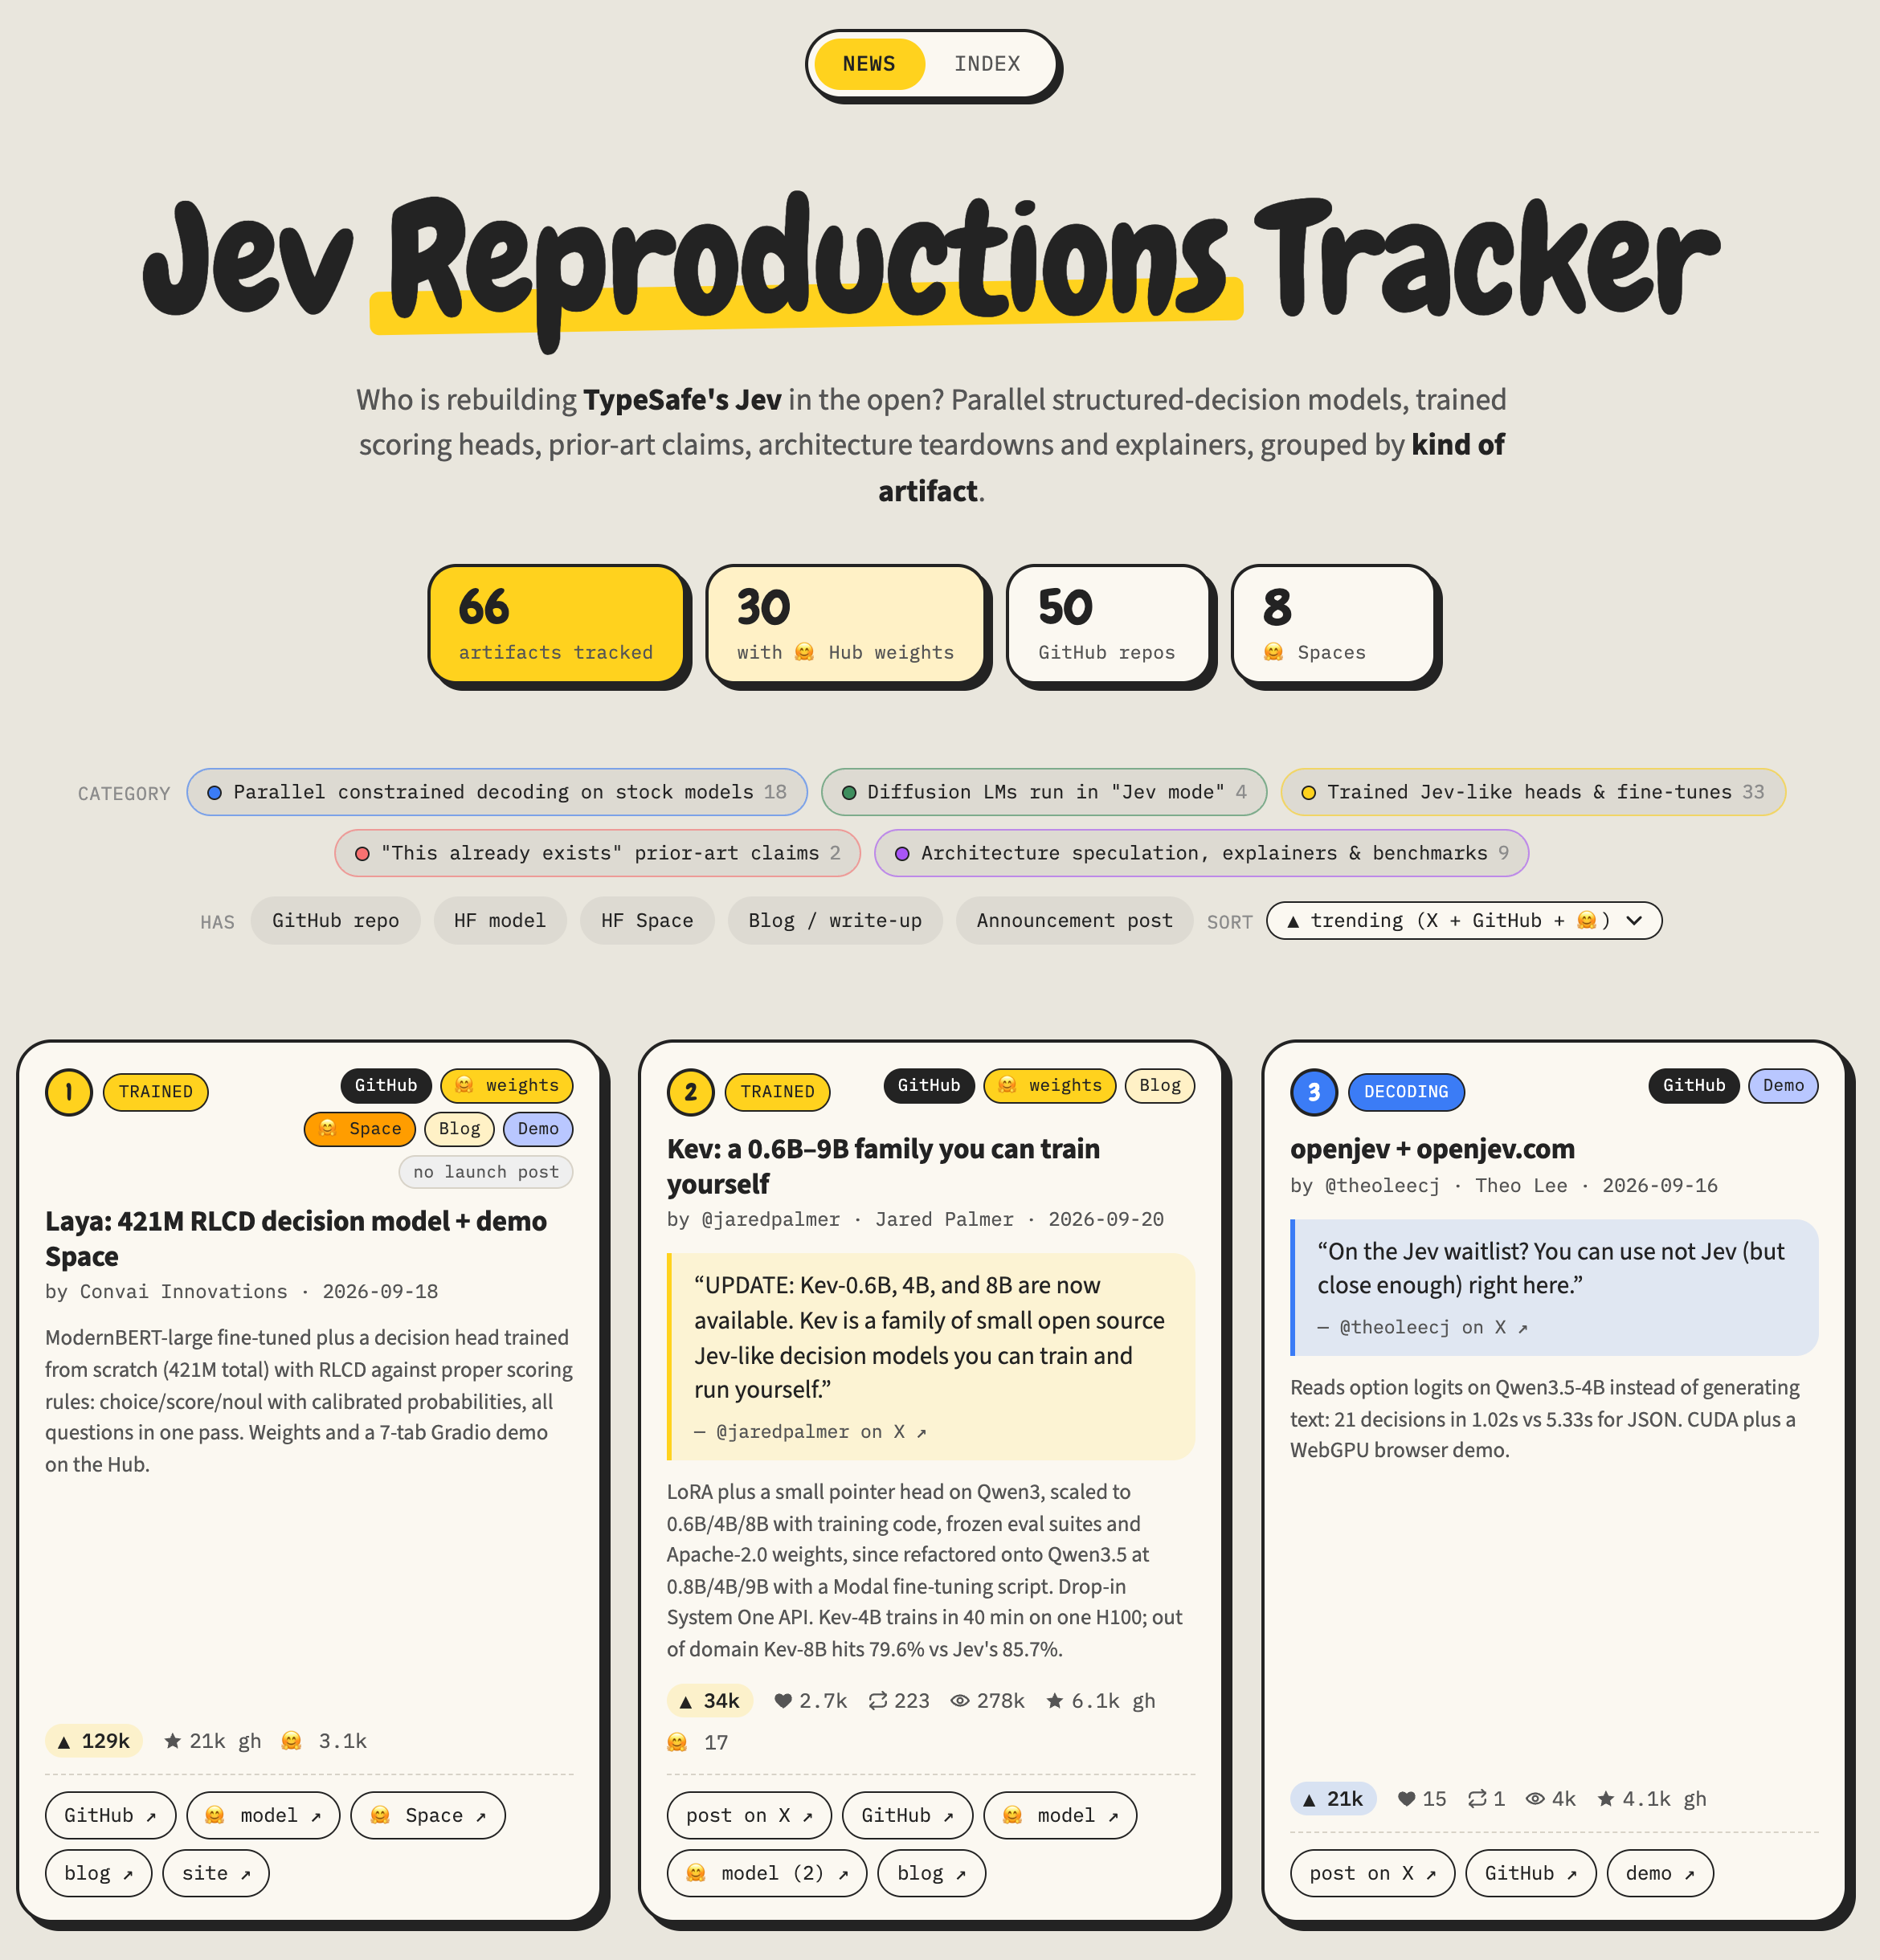
산출물은 만드는 방식에 따라 다섯 범주로 나뉩니다. 아래 표의 개수는 News 탭의 범주 필터에 표시된 값입니다.
| 범주 (원문 표기) | 개수 | 방식 | 대표 산출물 |
| --- | --- | --- | --- |
| 디코딩 기법 (Decoding) | 18 | 새 가중치 없이 기존 LLM의 선택지 로짓을 한 번에 읽음 | [openjev](https://github.com/TheoLeeCJ/openjev), [jevfire](https://github.com/kikoncuo/jevfire), [reflex](https://github.com/kshetrajna12/reflex) |
| 확산 언어 모델 (Diffusion) | 4 | DiffusionGemma 같은 확산 모델로 타입이 정해진 출력을 병렬로 채움 | [LocalJev](https://github.com/githubnext/localjev)(GitHub Next), [vLLM PR #57250](https://github.com/vllm-project/vllm/pull/57250) |
| 학습한 헤드와 파인튜닝 (Trained) | 33 | 기반 모델에 결정 헤드나 LoRA를 붙여 학습 | [Laya](https://huggingface.co/convaiinnovations/laya), [Kev](https://github.com/jaredpalmer/kev), [Bespoke Nimble](https://github.com/bespokelabsai/nimble) |
| 선행 사례 주장 (Prior art) | 2 | "이미 있던 방식"이라는 주장 | [GLiNER 2.5](https://huggingface.co/collections/fastino/gliner25-models) |
| 해설과 벤치마크 (Explainers) | 9 | 구조 추정, 해설, 비교 벤치마크, awesome 목록 | [Jev's Architecture Unmasked](https://archerhume.com/posts/jevs-architecture-unmasked/), [awesome-jev](https://github.com/AnotiaWang/awesome-jev) |
가장 큰 흐름은 **병렬 제약 디코딩(Parallel Constrained Decoding)** 입니다. 상태를 한 번만 프리필(prefill)한 뒤, 모든 선택지를 한 배치로 채점하고 결과는 코드에서 조립합니다. News 탭은 이 방식이 Jev의 입출력 형태와 속도는 재현하지만, Jev의 학습과 보정(calibration)은 재현하지 못한다고 설명합니다. 학습 범주는 그보다 Jev에 가깝지만, 여기에 속한 모델도 RLCD를 그대로 구현한 것은 아닙니다. 범주별 대표 프로젝트 중 일부는 PyTorchKR에서도 따로 소개했습니다. [Laya](https://discuss.pytorch.kr/t/laya-jev/12027), [Kev](https://discuss.pytorch.kr/t/kev-jev-qwen-lora/11963), [CLM](https://discuss.pytorch.kr/t/clm-contrastive-lm-jev/12013), [vLLM Semantic Router의 Decision 1.0](https://discuss.pytorch.kr/t/vllm-semantic-router-jev-decision-1-0-6-decision-studio/12005)이 그 예입니다.
### 아직 공개되지 않은 것들
News 탭 하단의 _Still not in the open_ 상자는 지금까지의 산출물이 Jev의 인터페이스를 흉내 낸 것이라고 정리합니다. 상태와 선택지를 넣으면 한 번에 확률이 나오는 형태만 같습니다. 그리고 다음 네 가지는 아직 공개되지 않았다고 적습니다.
- **TypeSafe의 Jev 가중치** : "openjev"나 "-RLCD"라는 이름의 Hub 저장소는 모두 기존 모델에 디코딩 코드를 더한 것이거나 독립적으로 학습한 헤드입니다.
- **RLCD 알고리즘, 손실 함수, 학습 데이터** : 블로그 수준의 설명만 있고 공개 구현은 없습니다.
- **Jev의 보정 성능에 맞먹는 오픈 모델** : News 탭에 따르면 가장 좋은 오픈 채점 모델(Bespoke Nimble)은 Jev와 답이 약 90% 일치합니다. 하지만 여전히 후보 로짓에 소프트맥스를 씌우는 방식이고, 그 신뢰도가 오류를 제대로 알려 주지 못한다는 연구가 있습니다.
- **Archer Hume이 약속한 오픈 가중치 버전** : 그의 회사가 9월 21일 [Solomon](https://huggingface.co/DoccyHealth/Solomon)을 공개했지만, News 탭은 모델 카드가 문서 질의응답 모델을 설명할 뿐 Jev 재현이라고 쓰지 않는다고 지적하며 "약속의 이행"으로만 분류합니다.
## Index 탭: 70개 모델을 같은 시험지로 채점한 Decision Index
Index 탭의 Decision Index 0.2.1은 모델 하나당 120,340건의 결정 요청을 43개 벤치마크에 걸쳐 보냅니다. 오픈 모델은 모두 NVIDIA RTX PRO 6000 한 장에서 실행했고, 데이터는 9월 28일에 갱신되었습니다. 헤드라인 점수는 그중 38개 벤치마크로 계산합니다.
상위 모델이 거의 만점을 받는 MMLU(MMLU-Pro로 대체)와 ARC-Easy, ARC-Challenge는 점수판에만 남깁니다. 프롬프트가 최적 경로를 드러내는 RouterBench와 데이터 구성 오류로 재실행을 기다리는 SGD도 지수에서 뺐습니다. 또한 RTX PRO 6000 한 장에서 요청당 중앙값 지연 시간이 1,000ms를 넘는 모델은 Jev와 성격이 다르다고 보고 점수판에 올리지 않습니다. 게임과 웹 조작 같은 대화형 환경 6종도 오픈 모델이 아직 실행하지 않아 제외했습니다.

### 점수를 계산하는 방법
38개 벤치마크는 다섯 영역으로 묶입니다. 영역 가중치는 같지 않습니다. 예술과 사람의 취향(Arts & Human Taste)이 10%로 고정되고, 나머지 90%는 각 영역의 벤치마크 수의 제곱근에 비례해 나눕니다.
| 영역 (원문 표기) | 가중치 | 포함 벤치마크 예 |
| --- | --- | --- |
| 지식과 추론 (Knowledge & Reasoning) | 25.8% | GPQA Diamond, GSM8K, MMLU-Pro, BBH, HLE |
| 언어 이해 (Language Understanding) | 25.8% | ANLI, WinoGrande, HellaSwag, ContractNLI, RAGTruth |
| 검색과 분류 (Retrieval & Classification) | 20.0% | BANKING77, CLINC150, BRIGHT, Amazon ESCI |
| 도구와 자동화 (Tools & Automation) | 18.3% | BFCL, ToolRet, API-Bank, When2Call |
| 예술과 취향 (Arts & Human Taste) | 10.0% | Humicroedit, POP909, ForecastBench, New Yorker |
각 벤치마크 점수는 먼저 **우연 수준 보정(chance correction)** 을 거칩니다. (\text{점수} - \text{우연 수준}) / (1 - \text{우연 수준}) 으로 바꿔, 무작위로 찍으면 0점, 모두 맞히면 100점이 되게 합니다. 영역 안에서는 MMLU-Pro, GPQA Diamond 같은 핵심 벤치마크에 1.2배 가중치를 줍니다. 또한 모델이 답하지 못하거나 거부한 요청은 모두 오답으로 셉니다. 어려운 문제를 건너뛰어 점수를 올릴 수 없게 하기 위해서입니다. Jev의 영역 점수에 위 가중치를 적용하면 57.906이 나와, 공개된 57.91과 일치합니다.
공정성을 위한 규칙도 명시되어 있습니다. 모든 요청은 잘라내지 않고 그대로 보냅니다. 컨텍스트 창에 들어가지 않으면 _unsupported_로 기록합니다. 선택지를 줄이지 않고, 모델마다 프롬프트를 조정하지도 않습니다. 각 모델은 작성자가 제공한 추론 코드와 출력 해석 규칙을 그대로 씁니다. 학습 데이터에 테스트 문항이 들어간 사실이 확인되면 그 문항은 오답으로 처리합니다.
예를 들어 Eikos-27B는 FinEntity 테스트셋 전체가 학습 데이터에 포함되어 있어 FinEntity 979문항이 모두 오답이 되었고, open-jev(pngwn)는 MMLU-Pro 9,542문항과 MMLU 5,308문항이 같은 처리를 받았습니다.
### 상위권 결과: 27B 안팎의 모델이 Jev에 근접
아래 표는 Decision Index 상위 10개 오픈 모델을 Jev와 함께 정리한 것입니다. 영역 점수의 단위는 우연 수준 보정 점수(0~100)입니다. **기대 보정 오차(Expected Calibration Error, ECE)** 는 낮을수록 모델이 말한 확률이 실제 정답률과 잘 맞습니다.
| 순위 | 모델 | 방식 | 기반 모델 | Decision Index | 지식 | 언어 | 검색 | 도구 | 예술 | ECE |
| --- | --- | --- | --- | --- | --- | --- | --- | --- | --- | --- |
| 기준 | Jev | 비공개 | 비공개 | **57.91** | **51.4** | 62.0 | 55.4 | 75.1 | 37.7 | 7.4 |
| 2 (공동) | [Surogate Rune 26B-A4B v3](https://huggingface.co/surogate/rune-26b-a4b-GGUF) | 전체 파인튜닝 | Gemma 4 26B-A4B | 57.44 | 43.4 | 63.1 | **63.5** | 71.2 | **41.9** | 12.0 |
| 2 (공동) | [Decider chat](https://github.com/Mapika/decider) | 디코딩 기법 | Gemma 4 31B | 57.33 | 44.3 | 60.4 | 63.1 | 75.6 | 38.3 | 4.7 |
| 4 | [pplx-decider-v1-27b](https://huggingface.co/perplexity-ai/pplx-decider-v1-27b) | 전체 파인튜닝 | Qwen3.8-27B | 56.40 | 40.9 | **63.5** | 54.9 | **79.3** | 39.4 | 1.8 |
| 5 | [simple-jev](https://github.com/featherless-ai/simple-jev) | 디코딩 기법 | Qwen3.8-27B | 55.74 | 36.6 | 62.1 | 63.2 | 76.2 | 36.5 | 11.3 |
| 6 | [Jebadiah 27B](https://huggingface.co/frontier-infra/jebadiah-27b) | LoRA | Qwen3.8-27B | 54.67 | 38.8 | 60.7 | 53.9 | 78.1 | 38.7 | **1.4** |
| 7 | [Eikos-27B](https://huggingface.co/caiovicentino1/Eikos-27B-FP8) | LoRA | Qwen3.8-27B | 53.13 | 39.9 | 54.3 | 55.9 | 74.4 | 39.8 | 5.7 |
| 8 | [reflex 27B](https://github.com/kshetrajna12/reflex) | 디코딩 기법 | Qwen3.8-27B | 52.16 | 35.1 | 54.2 | 57.8 | 74.1 | 39.6 | 2.4 |
| 9 | [Decider chat](https://github.com/Mapika/decider) | 디코딩 기법 | Qwen3.6-27B | 51.35 | 37.0 | 57.1 | 52.2 | 71.4 | 35.1 | 2.1 |
| 10 | [Winnow-12B](https://huggingface.co/EldanRing/Winnow-12B) | LoRA | Gemma 4 12B | 50.02 | 33.8 | 56.0 | 54.0 | 71.0 | 30.0 | 16.8 |
| 11 | [JoshuaSP open-jev](https://github.com/JoshuaSP/open-jev) | 확산 디코딩 | DiffusionGemma 26B-A4B | 49.47 | 32.7 | 53.5 | 58.4 | 70.2 | 26.7 | 21.6 |
위 표를 통해 세 가지를 알 수 있습니다. 첫째, Jev를 넘은 오픈 모델은 없지만 차이는 1점이 안 됩니다. Index 탭은 0.25점 이내의 차이를 동률로 표시하므로, Surogate Rune(57.44)과 Decider chat(57.33)은 공동 2위입니다. 둘째, Jev가 확실히 앞서는 영역은 지식과 추론뿐입니다. Jev의 51.4점에 비해 오픈 모델 최고점은 44.3점입니다. 반대로 나머지 네 영역에서는 오픈 모델 최고점이 Jev보다 높습니다.
셋째, 학습이 꼭 필요하지는 않습니다. 공동 2위인 Decider chat은 Gemma 4 31B IT의 가중치를 그대로 두고, 선택지 로짓을 읽은 뒤 선택지 수에 맞춘 온도 보정만 더합니다(bf16 가중치 62.5GB). 5위 simple-jev와 8위 reflex도 같은 계열입니다.
다만 상위 10개가 모두 12B 이상이며, 그중 9개는 26B급 이상입니다. 노트북이나 작은 GPU에서 돌릴 4B 안팎의 모델로 내려가면 점수가 크게 낮아집니다. 이 크기에서는 JPT-4B(43.04), Jet v6.2(42.60), Hopper (G) 1.2(40.77), Decider 4B(40.70)가 상위권입니다. 1억~4억 파라미터 규모의 인코더 계열(Laya 421M 6.04, Julia 1 141M 5.54 등)은 한 자릿수 점수에 머뭅니다. 다만 [Laya 글](https://discuss.pytorch.kr/t/laya-jev/12027)에서 다뤘듯 Laya의 README는 기본 설정에서 선택지가 20개를 넘으면 정확도가 떨어진다고 밝히므로, 이 점수는 선택지가 많은 문항을 포함한 범용 시험 기준이라는 점을 감안해야 합니다.
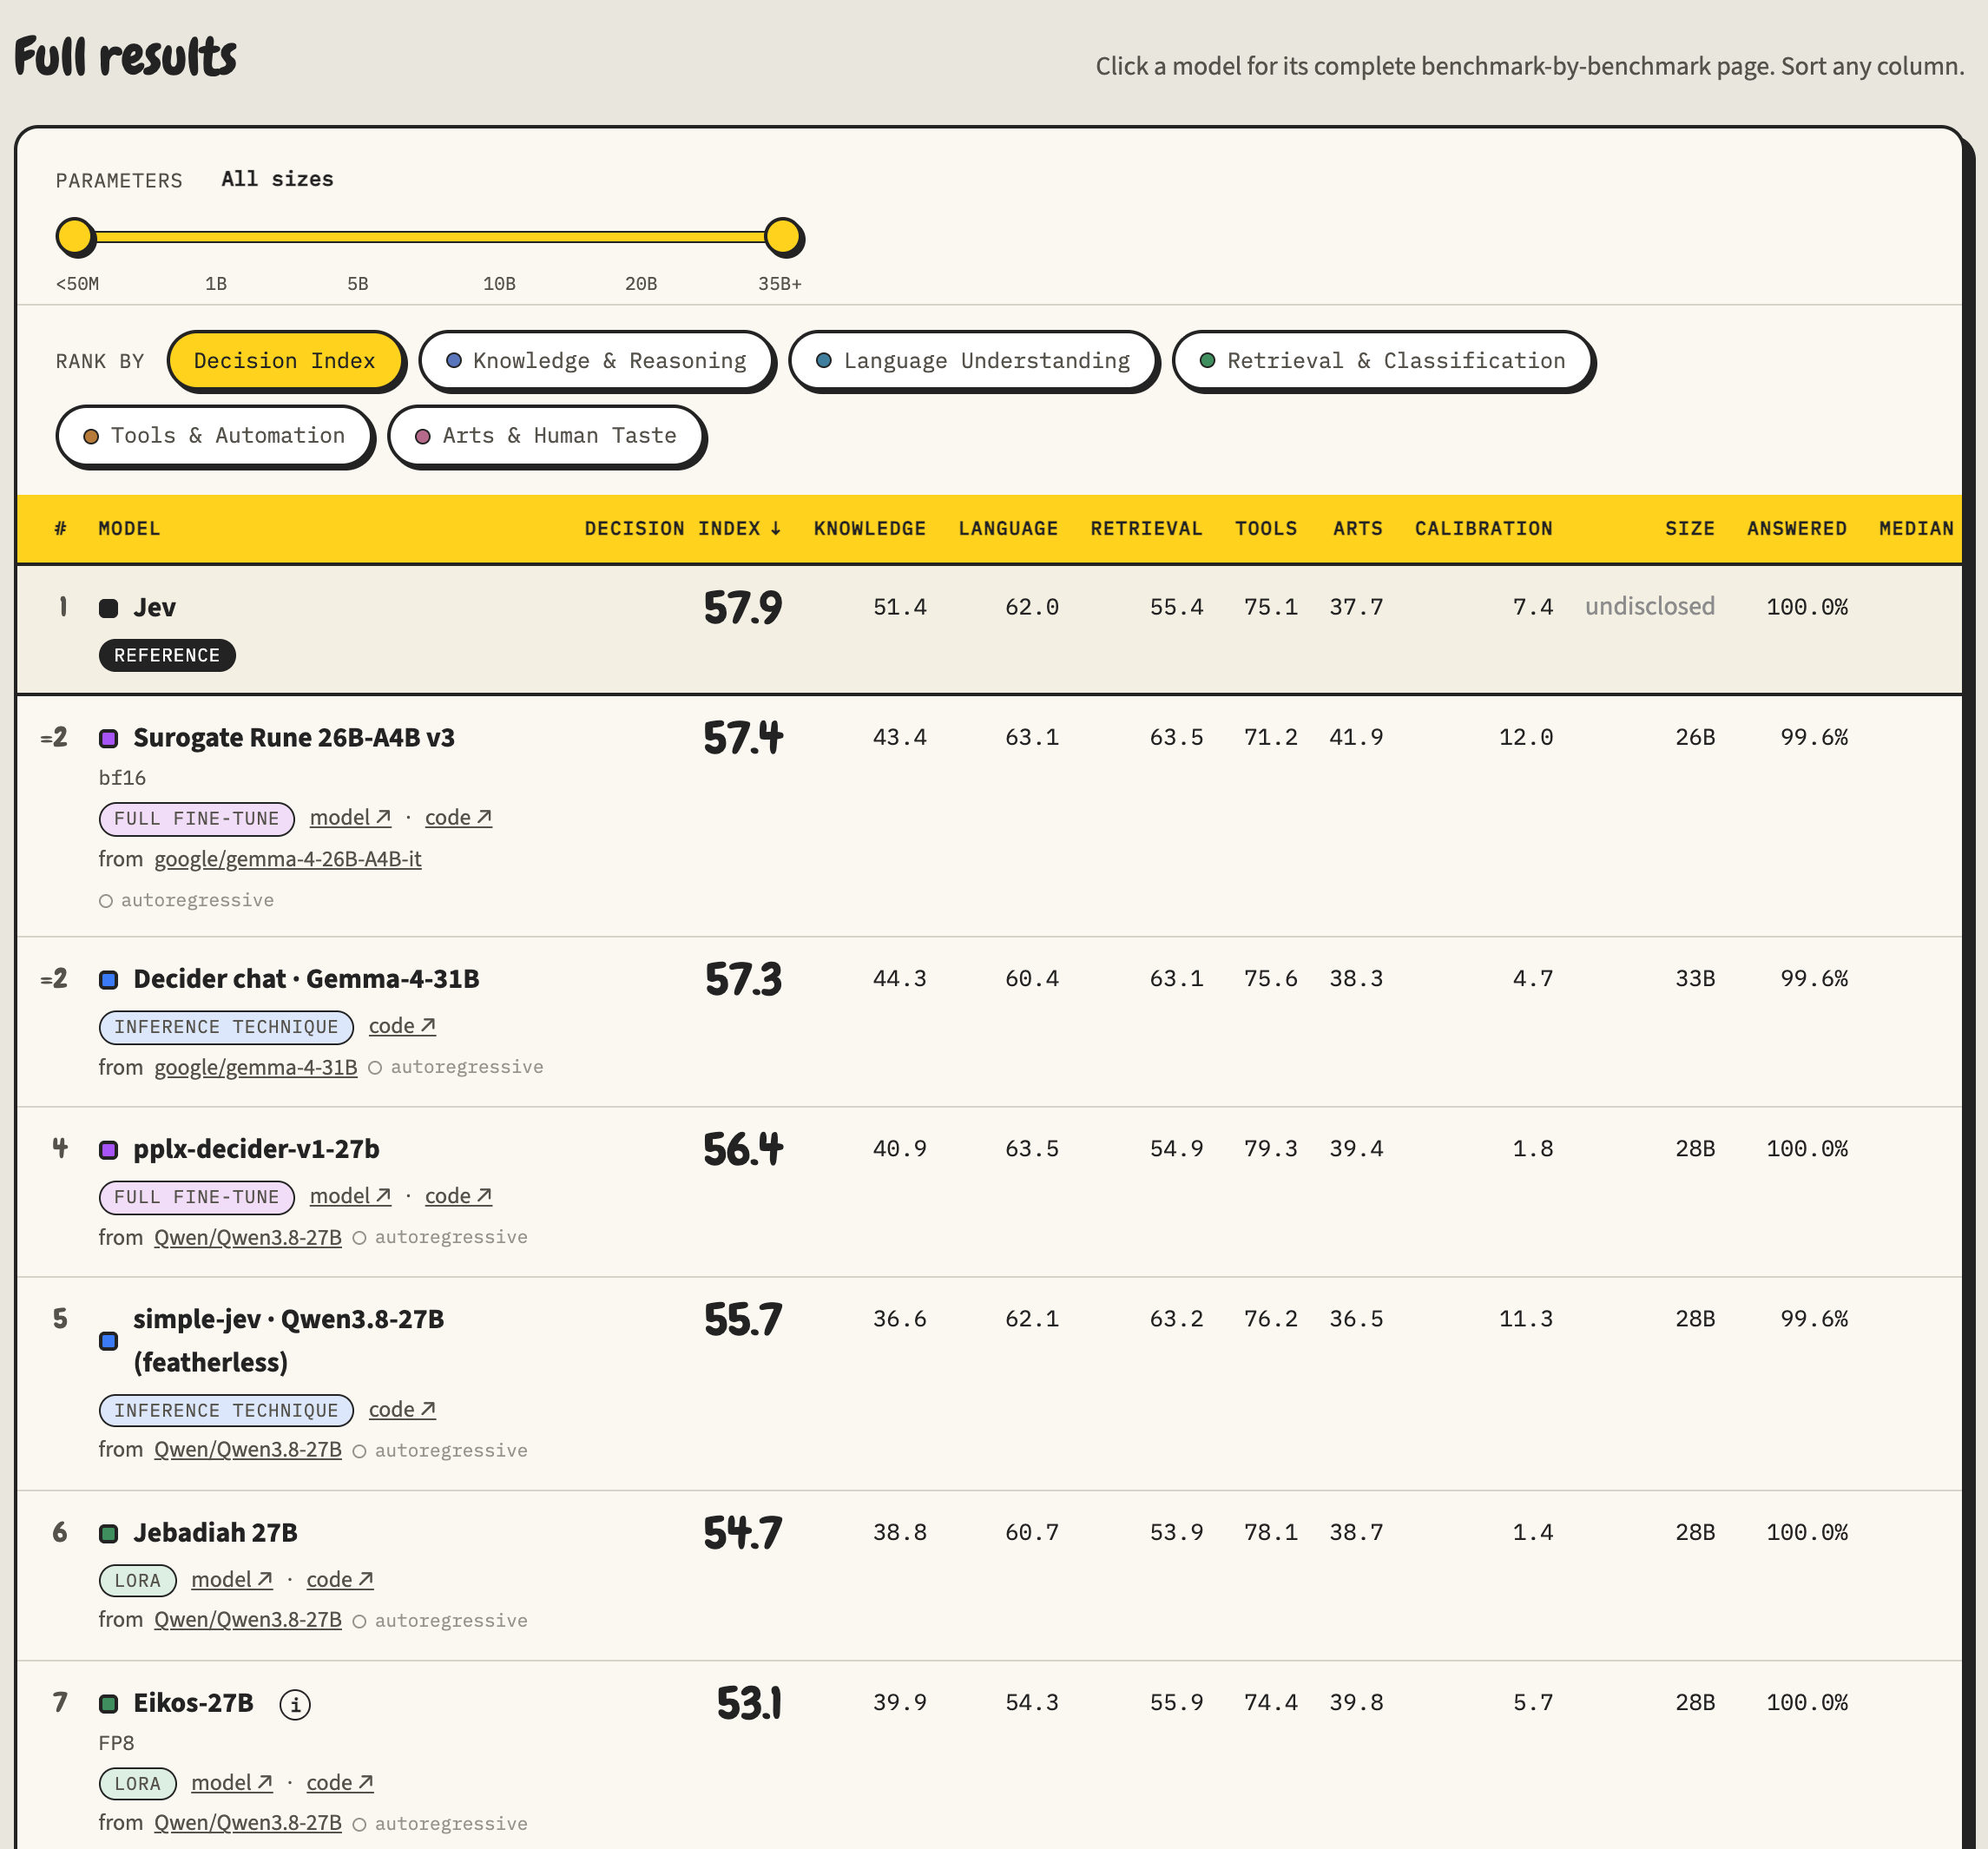
Index 탭은 모델마다 상세 페이지(`index.html?model=`)를 제공하므로, 표에서 모델 이름을 누르면 벤치마크별 점수와 응답 실패 원인까지 확인할 수 있습니다. 지연 시간 수치는 비교에 주의가 필요합니다. 오픈 모델은 GPU 한 장에서 잰 계산 시간이고, Jev(중앙값 524ms)는 HTTPS 왕복을 포함한 API 응답 시간이라 직접 비교할 수 없다고 Index 탭이 밝힙니다.
## JevBench: 비용과 속도까지 넣으면 순위가 바뀐다
Decision Index는 정확도만 봅니다. 그런데 Jev를 대체하려는 사람에게는 비용과 속도도 중요합니다. Florian Standhartinger가 운영하는 [Benchmark Heaven](https://benchmarkheaven.com/)의 [JevBench](https://benchmarkheaven.com/jev-models)는 이 두 가지를 점수에 넣습니다. 채점 하네스와 공개 문항은 [fstandhartinger/jevbench](https://github.com/fstandhartinger/jevbench) 저장소에 MIT 라이선스로 공개되어 있습니다.
JevBench v1.5.7은 시스템마다 1,624건의 결정을 묻습니다. 그중 904건은 공개 문항이고 720건은 비공개 문항입니다. 공개 문항에만 맞춘 과적합을 막기 위해, 지능(Intelligence) 점수의 절반을 비공개 문항에서 계산합니다. Choice, Noul, Score 세 질문 유형이 각각 3분의 1씩 반영되고, 쉬움, 표준, 판단, 어려움 등급에 10, 20, 30, 40%의 가중치가 붙습니다. 점수는 네 축으로 매깁니다.
- **지능 (Intelligence)**: 우연 수준을 보정한 정답률입니다.
- **보정 (Calibration)**: 모델이 말한 확률이 실제 정답률과 얼마나 맞는지입니다.
- **속도 (Speed)**: 중앙값과 p95 지연 시간을 로그 척도로 바꾼 점수입니다. 직접 띄운 모델과 데모 엔드포인트는 운영 환경을 감안해 지연 시간에 2를 곱하고 0.15초를 더합니다.
- **비용 (Cost)**: 결정 1,000건당 달러입니다. 가중치만 공개된 모델은 대형 추론 제공사가 같은 크기 모델에 매기는 가격으로 추정합니다.
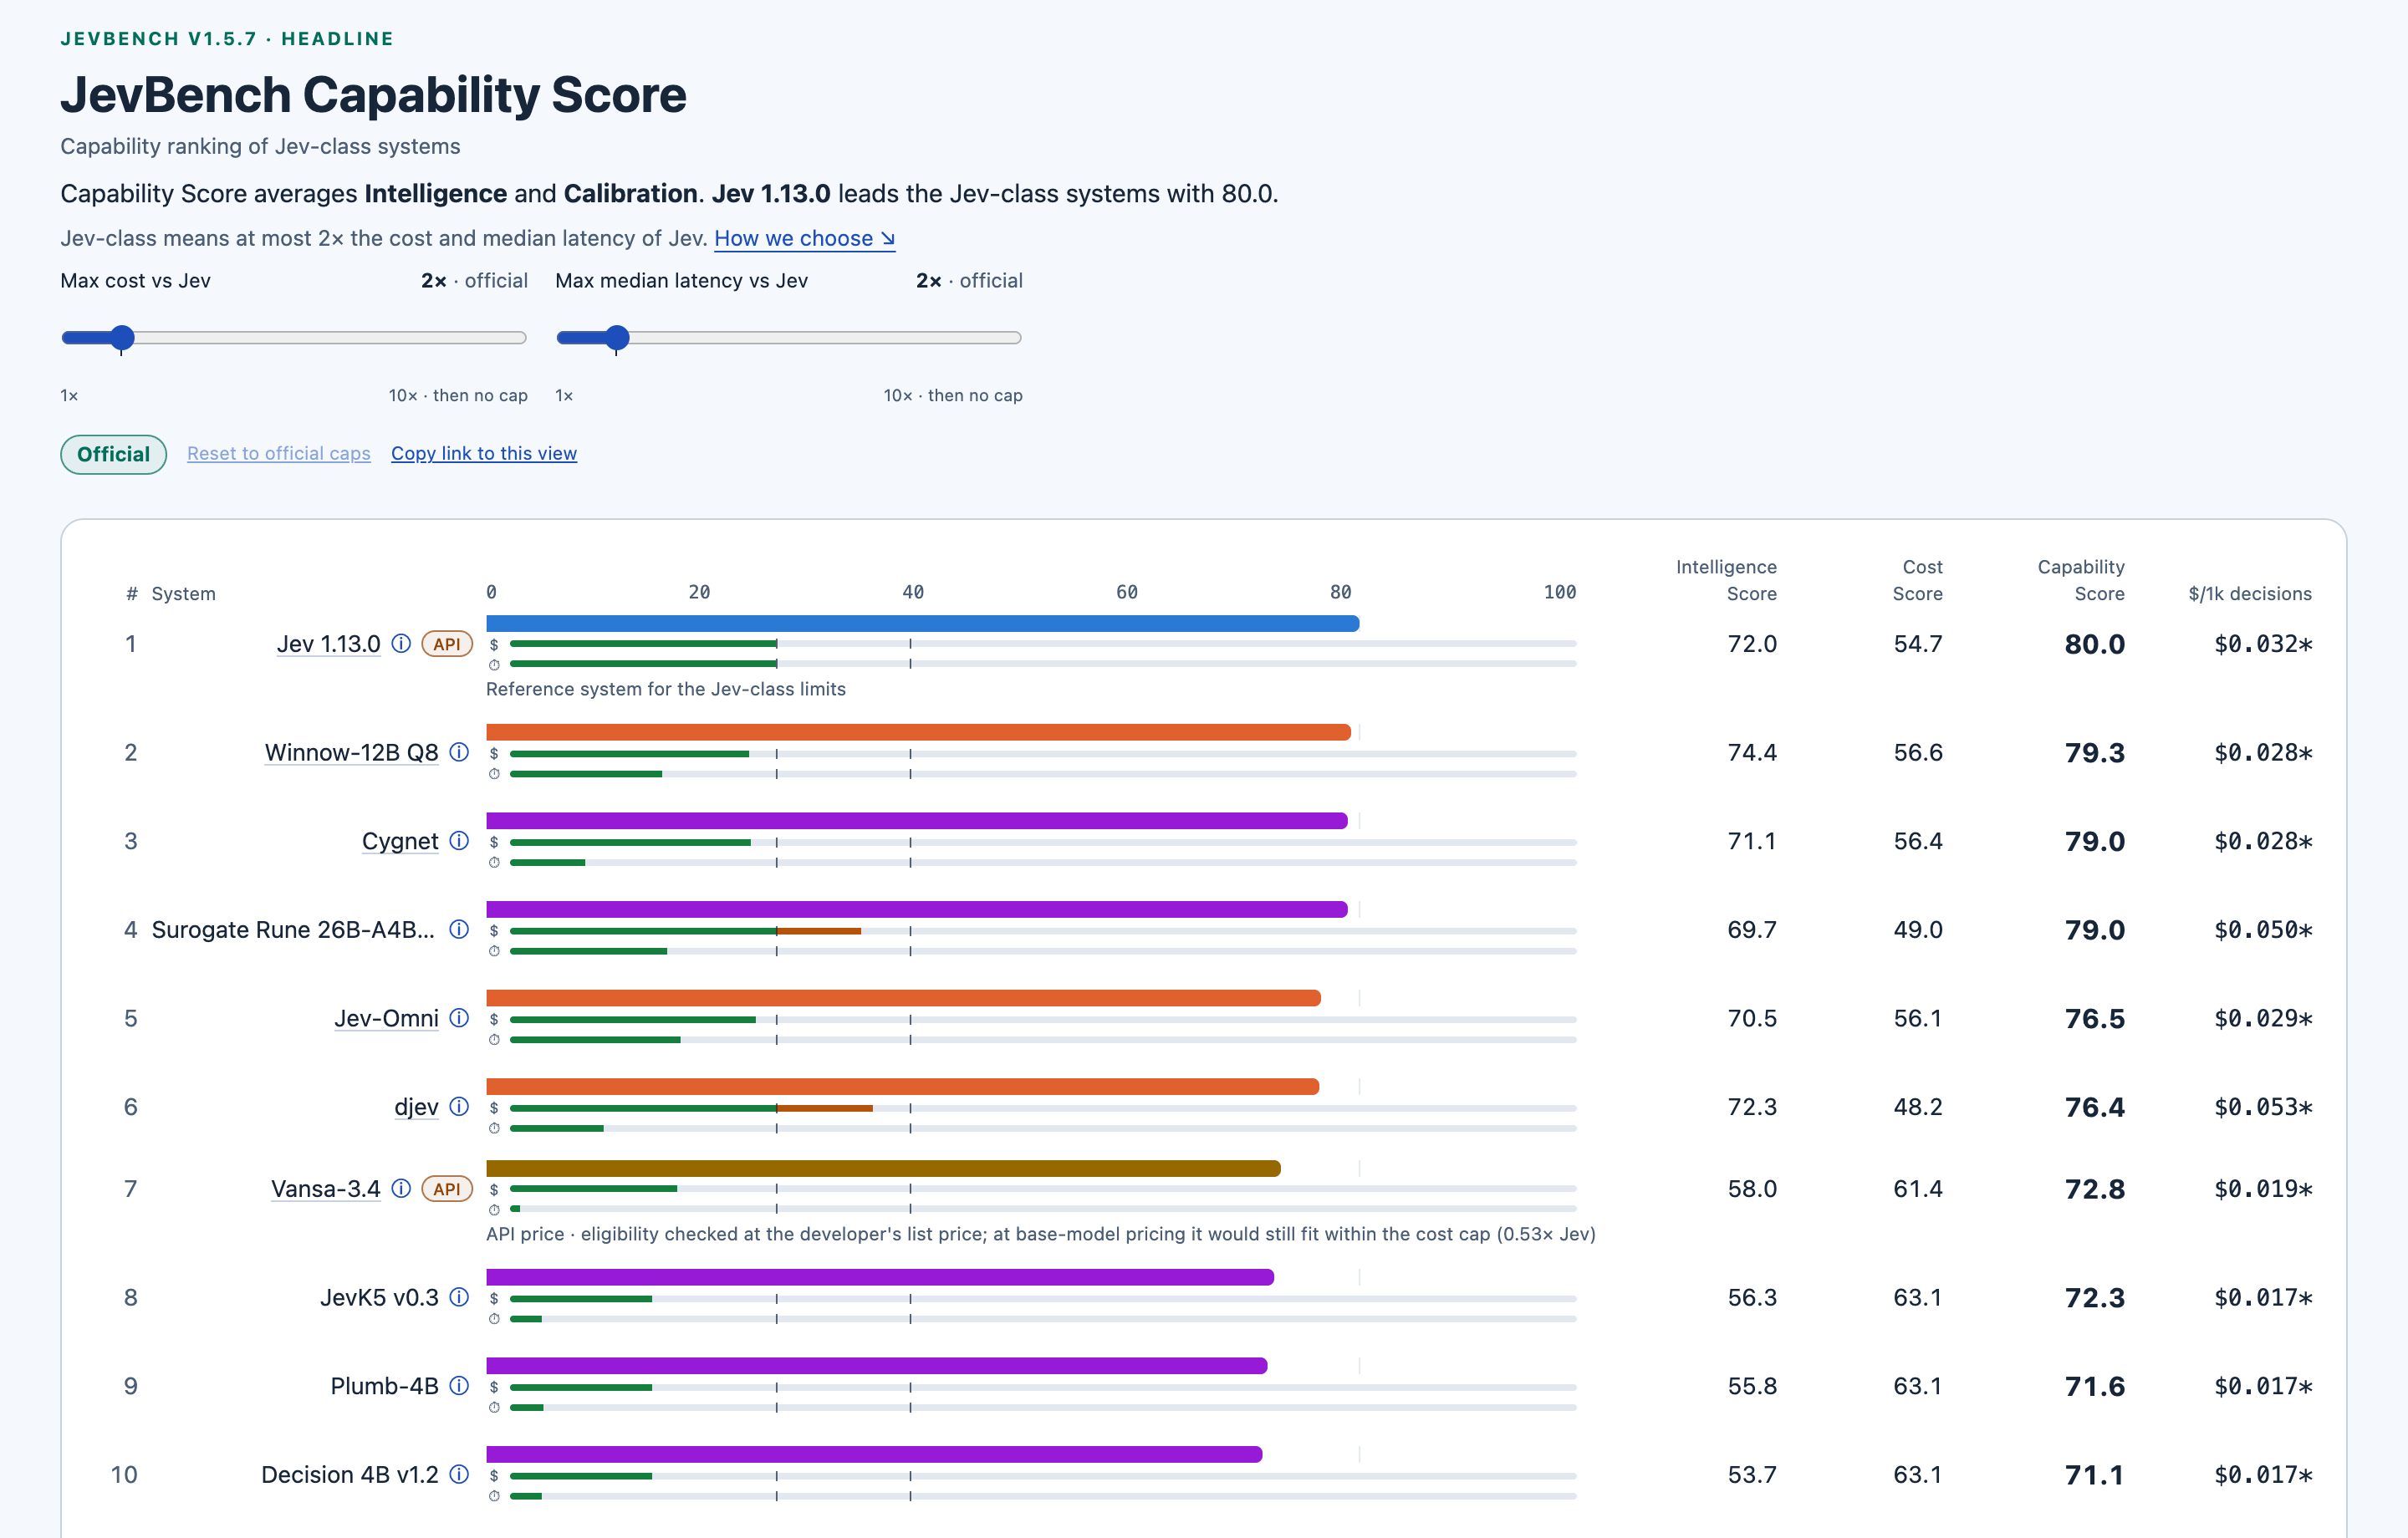
공식 점수(옵션 A)는 네 축을 25%씩 반영한 **조화 평균(harmonic mean)** 입니다. 조화 평균은 가장 약한 축에 끌려가므로, 한 축이 아무리 높아도 다른 축의 약점을 메우기 어렵습니다. 여기에 지능, 속도, 비용 중 하나가 50점 아래면 점수를 깎는 기준선이 더해집니다. 이와 별도로 페이지 상단의 **Capability Score** 는 지능과 보정의 평균인데, 비용과 지연 시간이 Jev의 2배 이내인 **Jev급(Jev-class)** 시스템만 순위에 올립니다.
| 기준 | 1위 | 2위 | 3위 | 비고 |
| --- | --- | --- | --- | --- |
| 공식 점수 (4축 조화 평균) | [Cygnet](https://github.com/blockbrain-ai/cygnet-recipe) 73.7 | [Winnow-12B Q8](https://huggingface.co/EldanRing/Winnow-12B) 73.2 | Jev 1.13.0 72.1 | 1, 2위는 통계적 동률 |
| Capability Score (지능과 보정 평균) | Jev 1.13.0 80.0 | Winnow-12B Q8 79.3 | Cygnet 79.0, Surogate Rune 79.0 | Jev급 63개 시스템 대상 |
공식 점수 1위인 Cygnet은 Gemma 4 12B IT를 학습하지 않은 채로 두고, 선택지 글자 한 토큰의 확률만 읽는 방식입니다. 2위 Winnow-12B는 Gemma 4 12B IT를 결정용으로 파인튜닝한 모델이며, 모델 카드에 따르면 Q8\_0 **양자화(Quantization)** 버전을 16GB VRAM의 RTX 5070 Ti에서 테스트했습니다. 두 모델 모두 결정 1,000건당 약 0.028달러로, Jev의 0.032달러보다 쌉니다. 참고로 공식 점수 74.7을 받은 classifier.dev는 내부에서 Jev를 호출하는 서비스라 순위에서 빠지고 별도로 표시됩니다.
같은 모델이 두 리더보드에서 받은 순위를 비교하면 차이가 큽니다. Decision Index에서 오픈 모델 공동 1위였던 Surogate Rune은 JevBench 공식 순위에서 19위입니다. 지능(69.7)과 보정(88.3)은 높지만, 비용 점수(49.0)가 낮아 조화 평균이 내려가고 기준선 50에 걸려 한 번 더 깎이기 때문입니다. Decision Index 7위 Eikos-27B도 비용 점수가 28.7이어서 JevBench에서 58위입니다. 반대로 Decision Index에서 10번째였던 Winnow-12B는 JevBench 2위입니다. 일반 LLM도 같은 문제를 겪습니다. GPT-6 Luna(기본 medium 추론)는 지능 점수 96.2로 전체 최고지만, 속도와 비용 때문에 공식 순위는 38위입니다.
결과를 읽을 때 알아 둘 한계도 페이지에 적혀 있습니다. 인접한 두 순위 중 부트스트랩 비교를 공개한 74쌍 가운데 67쌍이 통계적 동률이므로, 점수 차이보다 순서만 참고하라고 권합니다. 문항은 모두 영어입니다. GitHub 저장소 README는 아직 v1.4.2.2 결과(Imajev-4B 1위)를 현재 순위로 표시하므로, 순위는 라이브 페이지 기준으로 봐야 합니다. 지연 시간 보정(2배와 0.15초)은 측정값이 아니라 가정입니다. 또한 Benchmark Heaven 운영진은 오픈 결정 모델을 직접 호스팅하는 [jev-router.com](https://jev-router.com/)도 운영하며, 이 서비스는 순위에 참가하지 않고 점수상 이점도 없다고 밝힙니다.
## Image JevBench: Jev가 할 수 없는 이미지 결정
Benchmark Heaven은 이미지를 보고 결정하는 [Image JevBench](https://benchmarkheaven.com/image-jev-bench)도 운영합니다. 페이지에 따르면 Jev의 공식 인터페이스는 텍스트, 객체, 배열만 받고 이미지 입력이 없으므로, 이 벤치마크에는 Jev 행이 없습니다. 대신 JevBench와 같은 예산, 즉 Jev 1.13.0 비용의 2배(결정 1,000건당 0.0646달러 이하)와 중앙값 지연 시간의 2배(1.23초 이하)를 Jev급 기준으로 씁니다.
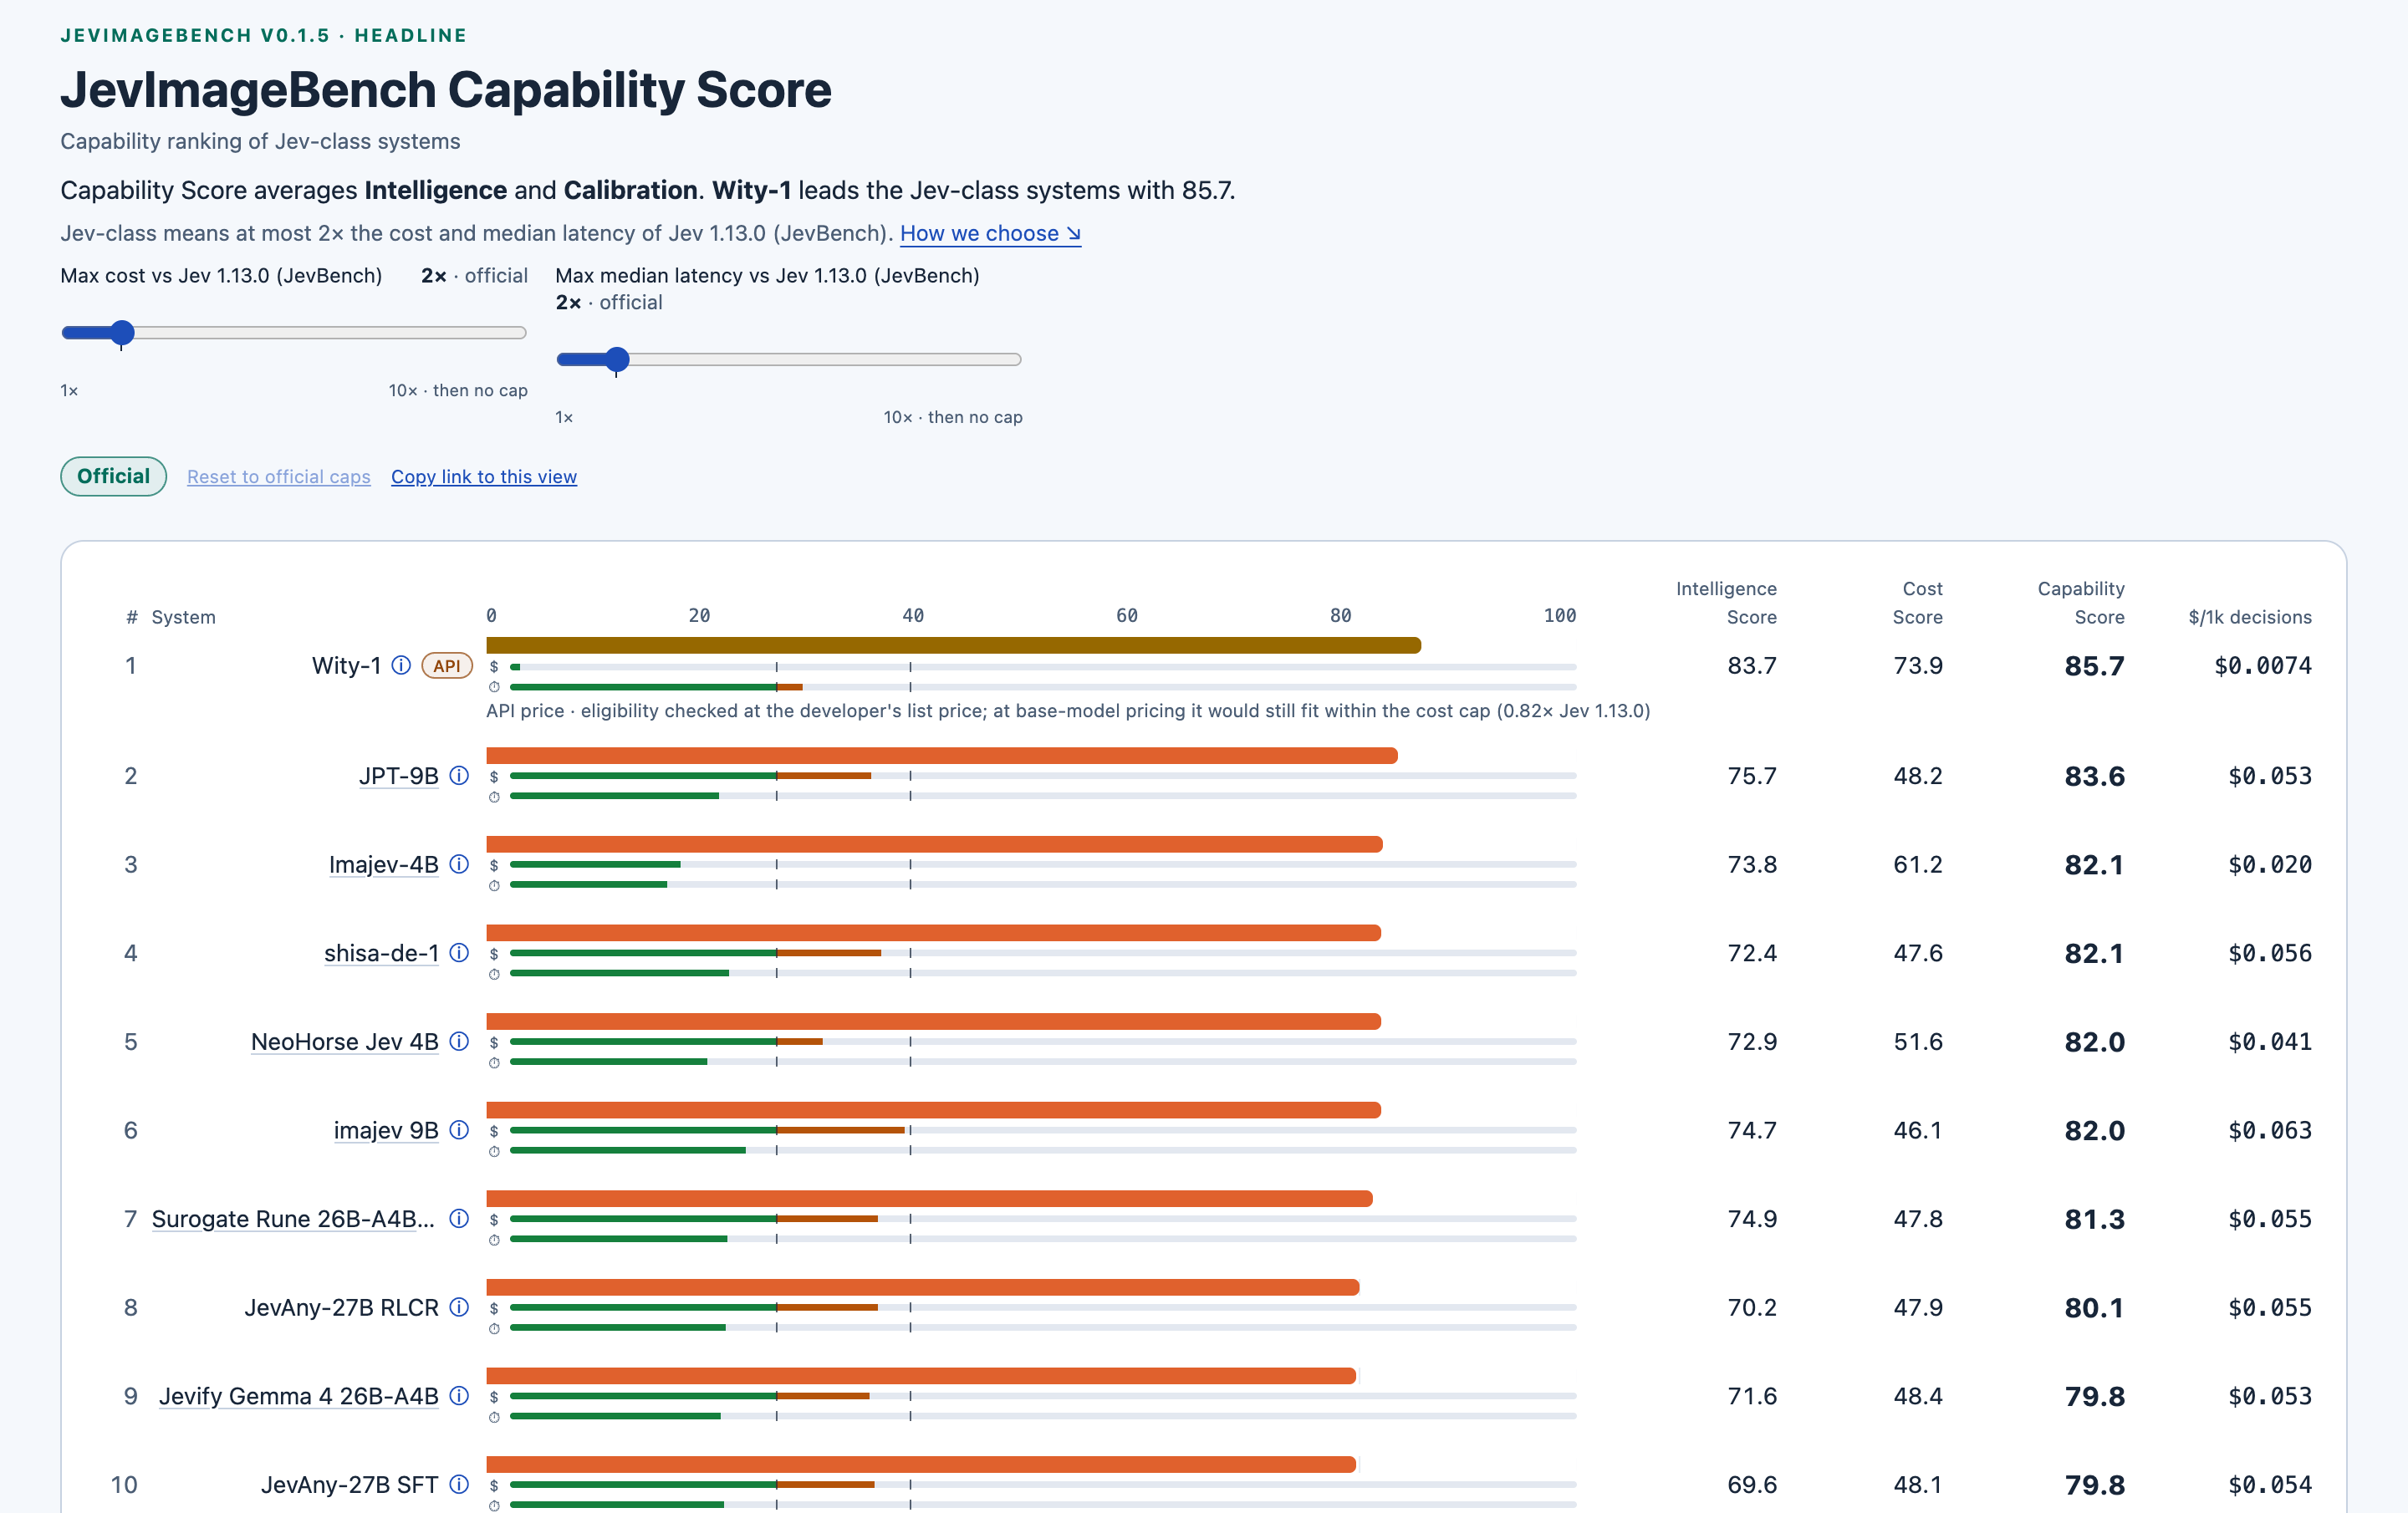
v0.1.5는 684건의 결정으로 구성됩니다. 화면 클릭 위치 선택(ScreenSpot), 금융 표(FinQA), 문서와 차트 같은 이미지를 다루는 Core 트랙 500건과, 택배 상태나 영수증 판독 같은 일상 사진 트랙 184건입니다. 공개 228건과 비공개 456건으로 나뉘며, 지능 점수는 공개 35%, 비공개 65%로 합산합니다. 컴퓨터 사용(Computer Use)과 브라우저 사용(Browser Use) 트랙도 미리보기로 준비되어 있습니다.
종합 점수 1위는 비공개 API인 Wity-1(80.20)입니다. 다만 페이지는 서버 빌드 ID가 기록되지 않아 작성자 검토 중이며 점수가 바뀔 수 있다고 표시합니다. 오픈 모델 중에서는 Qwen3.5-4B에 LoRA를 붙인 [Imajev-4B](https://huggingface.co/mohit67890/imajev-4b)가 76.39로 2위이고, [Jev-Omni](https://huggingface.co/akhilaaa3/Jev-Omni)(73.10), [NeoHorse Jev 4B](https://huggingface.co/TokenRhythm/NeoHorse-Jev-4B)(71.94), Visual-Jev 4B Answer-SFT(69.81)가 뒤를 잇습니다. 지능과 보정만 보는 Capability Score에서는 [JPT-9B](https://huggingface.co/kirp/jpt-9b)가 83.6으로 2위이지만, JPT 계열은 CC BY-NC 4.0 라이선스라 상업적으로 쓸 수 없습니다.
## 세 리더보드로 모델을 고를 때 확인할 것
세 리더보드는 서로 다른 질문에 답합니다. Decision Index는 정확도만 보고 Jev와의 거리를 잽니다. JevBench는 Jev와 같은 비용과 속도 예산 안에서 가장 쓸 만한 모델을 찾습니다. Image JevBench는 이미지를 보고 결정해야 할 때 쓸 수 있는 모델을 비교합니다. 아래 표는 이 글에서 다룬 주요 오픈 모델의 결과와 사용 조건을 함께 정리한 것입니다.
| 모델 | Decision Index | JevBench 공식 순위 | 라이선스 | 확인할 점 |
| --- | --- | --- | --- | --- |
| [Winnow-12B](https://huggingface.co/EldanRing/Winnow-12B) | 50.02 (10번째) | 2위 | Apache-2.0 | GGUF로 배포, Q8\_0은 16GB GPU에서 테스트됨, 이미지 입력 지원, 작성자 엔진 기본값은 선택지 64개까지(Decision Index는 255개로 올려 측정) |
| [Surogate Rune 26B-A4B v3](https://huggingface.co/surogate/rune-26b-a4b-GGUF) | 57.44 (오픈 공동 1위) | 19위 | Apache-2.0 | Hub 저장소가 접근 승인을 요구함, 비용 점수가 낮음 |
| [pplx-decider-v1-27b](https://huggingface.co/perplexity-ai/pplx-decider-v1-27b) | 56.40 | 목록에 없음 | Apache-2.0 | 모델 카드 기준 가중치만 약 49GiB |
| [Decider](https://github.com/Mapika/decider) 계열 | 57.33 (Gemma 4 31B 디코딩) | 4B v2가 8위 | Apache-2.0 | 디코딩 방식과 파인튜닝 방식이 모두 있음 |
| [Jev-Omni](https://huggingface.co/akhilaaa3/Jev-Omni) | 40.53 | 7위 | Apache-2.0 | Image JevBench 종합 3위 |
| [Kev](https://github.com/jaredpalmer/kev) 계열 | 38.48 (9B) | 4B가 40위 | Apache-2.0 | 학습 코드까지 공개되어 직접 학습 가능 |
| [JPT](https://github.com/tic-top/llm2jev) 계열 | 46.89 (9B) | 목록에 없음 | CC BY-NC 4.0 | 비상업적 용도만 가능 |
한국어 사용자라면 추가로 확인할 것이 있습니다. Decision Index의 38개 벤치마크와 JevBench 문항은 모두 영어이며, JevBench는 영어 전용이라고 명시합니다. Index 탭의 70개 모델 중 Hugging Face 모델 카드의 `language` 필드에 한국어(`ko`)를 적은 모델은 두 개뿐입니다. [Metask-Jev-4B](https://huggingface.co/wayfind/metask-jev-4b-policy-mix)(Decision Index 26.89)와 [LFM2.5-2.6B-RLCD](https://huggingface.co/monotykamary/LFM2.5-2.6B-RLCD)(6.76)입니다. 따라서 한국어 분류나 라우팅 업무에 쓰려면 자체 데이터로 다시 평가해야 합니다. Benchmark Heaven은 사용자 데이터 평가 옵션을 안내하고, Decision Index 저장소는 같은 평가를 로컬이나 Hugging Face Jobs에서 재현하는 방법을 제공합니다.
Jev와 같은 API 형태를 원한다면 Liquid AI가 공개한 [d1](https://discuss.pytorch.kr/t/liquid-ai-jev-api-d1/12063)도 선택지가 될 수 있습니다. 다만 d1은 가중치가 없는 API 전용 모델이라, 위 표의 오픈 모델과는 쓰임새가 다릅니다. 결정 모델을 추천 재순위화에 쓴 실험은 [Jev 재순위화 연구 글](https://discuss.pytorch.kr/t/jev-reranking-llm/12091)에서 확인할 수 있습니다.
## 🤗 Jev Decision Index Space (News, Index 탭)
> **[Jev Decision Index - a Hugging Face Space by multimodalart](https://huggingface.co/spaces/multimodalart/jev-decision-index)**
>
> Benchmarks and news on various repros of TypeSafe's Jev
## :github: Decision Index 채점 코드 GitHub 저장소
> **[GitHub - apolinario/decision-index: Decision Index: reproduce the Jev decision-model...](https://github.com/apolinario/decision-index)**
>
> Decision Index: reproduce the Jev decision-model benchmark suite locally or as one HF Job
## 📊 JevBench by Benchmark Heaven
> **[JevBench Capability Score by Benchmark Heaven — Jev-class model benchmark](https://benchmarkheaven.com/jev-models)**
>
> JevBench Capability Score ranks decision models within frozen cost and median-latency caps. Compare intelligence, calibration, speed, cost, use cases, topics and languages.
## 🖼 Image JevBench by Benchmark Heaven
> **[Image JevBench v0.1.5 — JevImageBench Capability Score](https://benchmarkheaven.com/image-jev-bench)**
>
> JevImageBench Capability Score ranks image decision systems inside the frozen JevBench cost and latency budget. Explore all 50 systems, composite scores and price alternatives.
## :github: JevBench 하네스 GitHub 저장소
> **[GitHub - fstandhartinger/jevbench: JevBench v1 - a benchmark for Jev-class typed...](https://github.com/fstandhartinger/jevbench)**
>
> JevBench v1 - a benchmark for Jev-class typed decision models: smart, cheap, fast, reliable, open.
## 더 읽어보기
- [Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)](https://discuss.pytorch.kr/t/jev-system-one-feat-typesafe-ai/11935)
- [Jev 생태계: Jev 모델 기반의 GitHub 프로젝트 1천여개를 23개 분야로 정리한 프로젝트 목록](https://discuss.pytorch.kr/t/jev-jev-github-1-23/12003)
- [Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들](https://discuss.pytorch.kr/t/laya-jev/12027)
- [kev: 비공개 모델 Jev를 Qwen과 LoRA로 재현해 맥북에서 학습하고 실행하는 결정 모델](https://discuss.pytorch.kr/t/kev-jev-qwen-lora/11963)
- [CLM(Contrastive LM), 대조 학습을 통해 Jev와 같은 형식으로, 상태에 맞는 행동을 빠르게 선택하는 언어 모델](https://discuss.pytorch.kr/t/clm-contrastive-lm-jev/12013)
- [vLLM Semantic Router팀, Jev와 유사한 Decision 1.0 기능 및 6개 모델, Decision Studio 공개](https://discuss.pytorch.kr/t/vllm-semantic-router-jev-decision-1-0-6-decision-studio/12005)
- [Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개](https://discuss.pytorch.kr/t/liquid-ai-jev-api-d1/12063)
- [Jev 기반 추천 재순위화(Reranking)에 대한 실증 연구: 결정 지향 모델과 LLM 재순위화의 품질 및 지연 시간 비교](https://discuss.pytorch.kr/t/jev-reranking-llm/12091)
* * *
_이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다._ 🤗
[:pytorch:파이토치 한국 사용자 모임🇰🇷](https://pytorch.kr/)이 정리한 이 글이 유용하셨나요? [회원으로 가입](https://discuss.pytorch.kr/signup)하시면 주요 글들을 이메일💌로 보내드립니다! [텔레그램(Telegram)](https://t.me/pytorchkr)이나 [Slack/Discord/Teams/Dooray/GoogleChat 등](https://discuss-noti.pytorch.kr)으로도 새 글 알림을 받으실 수 있습니다. 😃
🎁 아래↘쪽에 좋아요👍를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~ 🤩