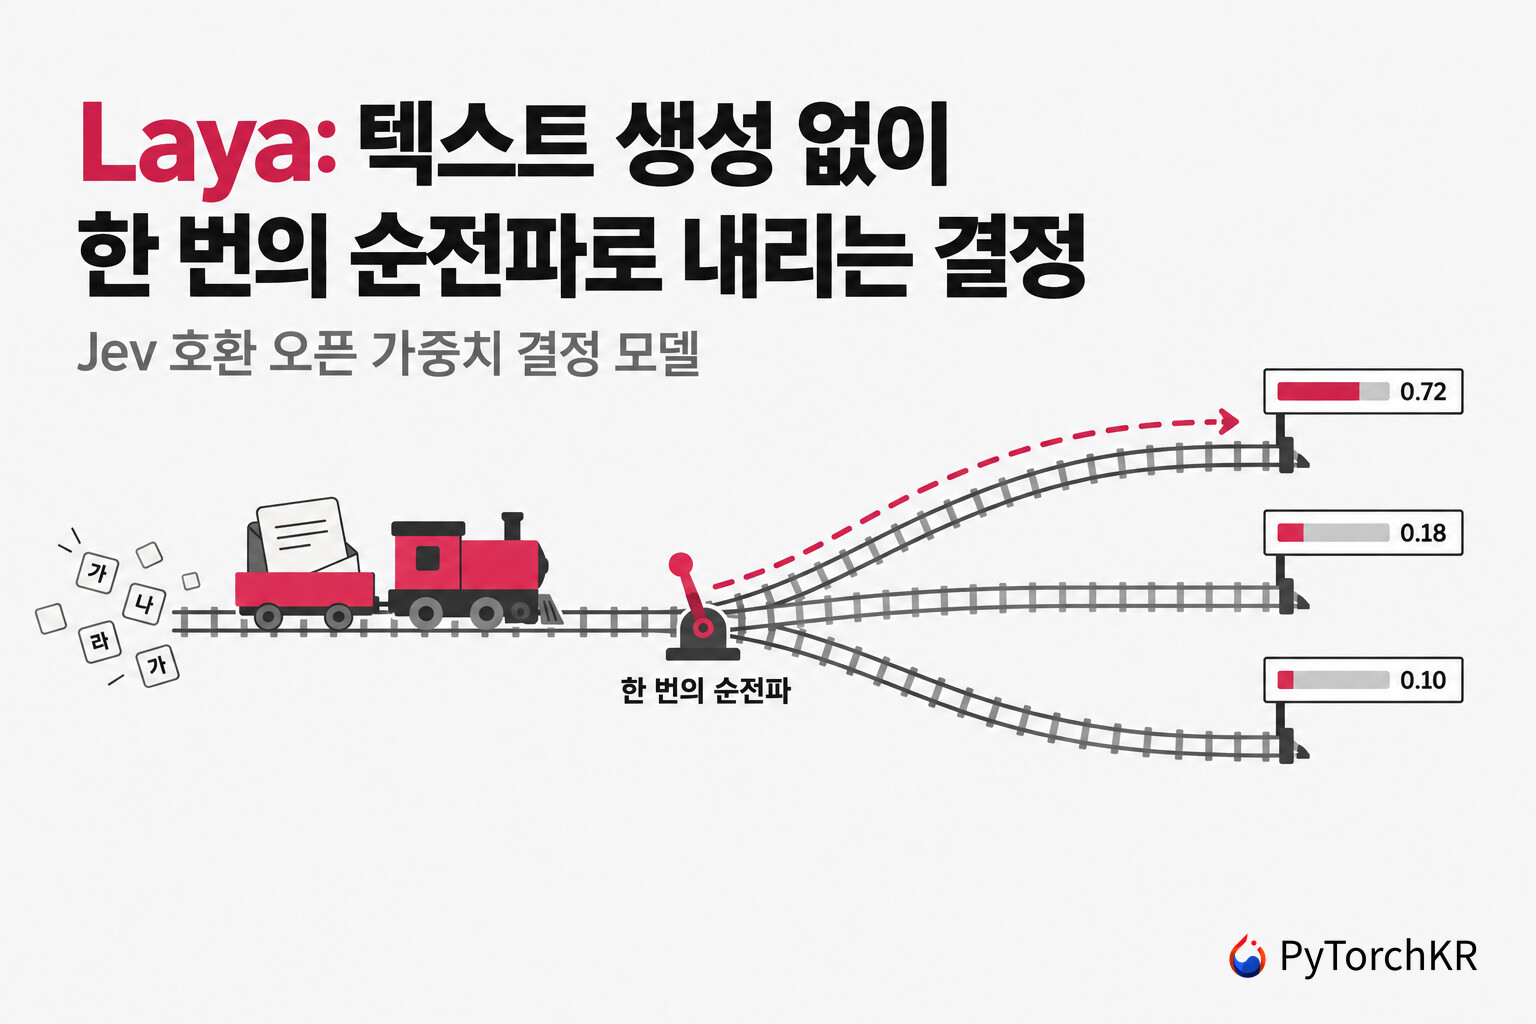
Laya 소개
문의 메일을 어느 팀에 배정할지, 이 프롬프트가 탈옥(jailbreak) 시도인지, 고객이 해지를 암시하는지처럼 소프트웨어가 짧게 내려야 하는 판단은 대부분 정해진 선택지 중 하나를 고르거나 확률 하나를 매기는 일입니다. 이런 판단을 대형 언어 모델(LLM)에 맡기면 답을 토큰 단위로 생성해야 하고, 생성된 문자열에서 레이블을 파싱해야 하며, 모델이 적어 낸 "confidence": 0.9 도 실제 정답 확률을 잰 값이 아니라 생성된 텍스트입니다. TypeSafe AI가 이 자리에 텍스트 대신 확률을 돌려주는 Jev (
 Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))를 호스팅 API로 내놓았고, 이번에 소개하는 Laya는 같은 방식의 결정 모델(Decision Model) 을 가중치까지 공개한 프로젝트입니다.
Laya는 문서, 이메일, 티켓, JSON 같은 상태(state) 하나와 타입이 정해진 질문 여러 개를 받아, 인코더를 한 번 통과시키는 순전파(forward pass)로 모든 질문에 답합니다. 질문 유형은 선택지 중 하나를 고르는 choice, 순서가 있는 등급에 위치를 매기는 score, 명제가 참일 확률을 돌려주는 noul 세 가지이며, 출력은 문장이 아니라 선택지별 확률 분포입니다. 개발사는 텍스트를 생성하지 않으므로 파싱할 것도 환각(hallucination)이 끼어들 자리도 없다고 설명합니다. 속도는 Tesla T4 한 장에서 질문 하나에 32.8ms(다국어 체크포인트), 질문 10개를 묶으면 72.3ms입니다.
Laya는 Convai Innovations가 개발했고, 대표인 Nandakishor가 저장소를 운영합니다. 영어용 ModernBERT-large와 100개 이상의 언어용 mmBERT-base를 인코더로 쓰는 체크포인트 세 개를 제공하고, 요청마다 언어를 감지해 체크포인트를 고르는 Router 를 함께 제공합니다. 저자는 2025년 3월 강화학습으로 영업 대화의 전환 확률을 예측한 SalesRLAgent 연구와 같은 해 9월의 후속 논문에서 얻은 경험을 바탕으로 이 모델을 만들었다고 밝히고 있습니다. 공개 직후 Apple Silicon에서 Laya를 실행하는 Laya-MLX와 Laya-CoreML, 그리고 Ollama처럼 결정 모델을 이름으로 내려받아 서빙하는 Ollaya가 잇따라 나왔으며, 이 글의 후반부에서 세 프로젝트를 짧게 정리합니다.
Laya vs. Jev
Laya는 Jev와 같은 문제를 풀지만 공개 범위와 설계가 다릅니다. Jev의 세부 구조는 공개되지 않았고, TypeSafe는 학습 방식을 보정된 결정을 위한 강화학습(Reinforcement Learning for Calibrated Decisions, RLCD)이라고 설명합니다. Laya는 같은 이름을 붙인 학습 방식을 자체적으로 구현해 코드와 가중치를 모두 공개했습니다. 두 모델의 차이를 정리하면 다음과 같습니다:
| 항목 | Laya | Jev |
|---|---|---|
| 공개 범위 | 가중치, 미세조정 노트북, 평가 코드 공개 | 가중치 비공개, 호스팅 API로만 제공 |
| 백본 | 양방향 인코더(ModernBERT-large, mmBERT-base) | 비공개 |
| 실행 위치 | 로컬, 자체 서버 | TypeSafe 클라우드 |
| 비용 | 자체 호스팅 | 입력 100만 토큰당 0.042달러 |
| 질문 하나의 p50 지연 | 32.8ms(T4, Convai 측정) | 236~276ms(제3자 측정) |
| 선택지 개수 | 약 20개를 넘으면 정확도 급락 | 최대 255개 |
| API | laya-serve 가 POST /v1/systemone 형식을 그대로 구현 |
POST /v1/systemone |
Jev의 정확도와 지연 수치는 모두 AbdelStark와 nibzard 같은 제3자가 공개한 값입니다. Convai Innovations는 TypeSafe API에 접근하지 않고 공개된 값을 옮겨 왔을 뿐이라, 표본 크기와 프롬프트가 다르다는 점을 스스로 밝히고 있습니다. 같은 문제를 Qwen과 LoRA로 재현한 kev가 디코더 모델의 프리필 한 번으로 상태를 공유하는 반면, Laya는 질문마다 상태와 선택지를 한 시퀀스로 묶어 양방향 인코더에 넣는다는 점도 다릅니다.
Laya를 사용하면 좋을 사용자
티켓 분류, 가드레일, 에이전트 라우팅처럼 선택지가 20개 안쪽인 판단을 로컬에서 수십 밀리초 안에 내려야 하고, 자기 도메인의 레이블 데이터로 미세조정(Fine-tuning)할 준비가 된 팀에게 Laya가 가장 잘 맞습니다. 체크포인트가 3~4억 파라미터 규모라 소비자 GPU나 노트북에서도 돌아가고, Jev와 같은 요청 형식을 구현한 서버가 있어 Jev를 쓰던 클라이언트를 주소를 바꿔 옮겨 볼 수 있습니다.
반대로 레이블 데이터 없이 바로 운영에 투입하려는 팀에게는 Laya가 아직 적절한 선택지가 아닙니다. Convai Innovations 스스로 기본 체크포인트의 typed-decisions 벤치마크 제로샷(zero-shot) 정확도가 무작위 추측 수준이라고 밝히고, Laya를 "a fast base to specialise, not a zero-shot decision engine" 이라고 정의합니다. 한국어 사용자라면 아래 벤치마크 절의 한국어 수치를 먼저 확인해야 합니다.
Laya의 동작 원리: 선택지 마커와 RLCD 학습
아래 그림은 입력이 라우터와 체크포인트, 결정 헤드를 거쳐 확률로 나오기까지의 흐름과, 같은 모델을 실행하는 네 가지 환경을 한 장에 정리한 것입니다:
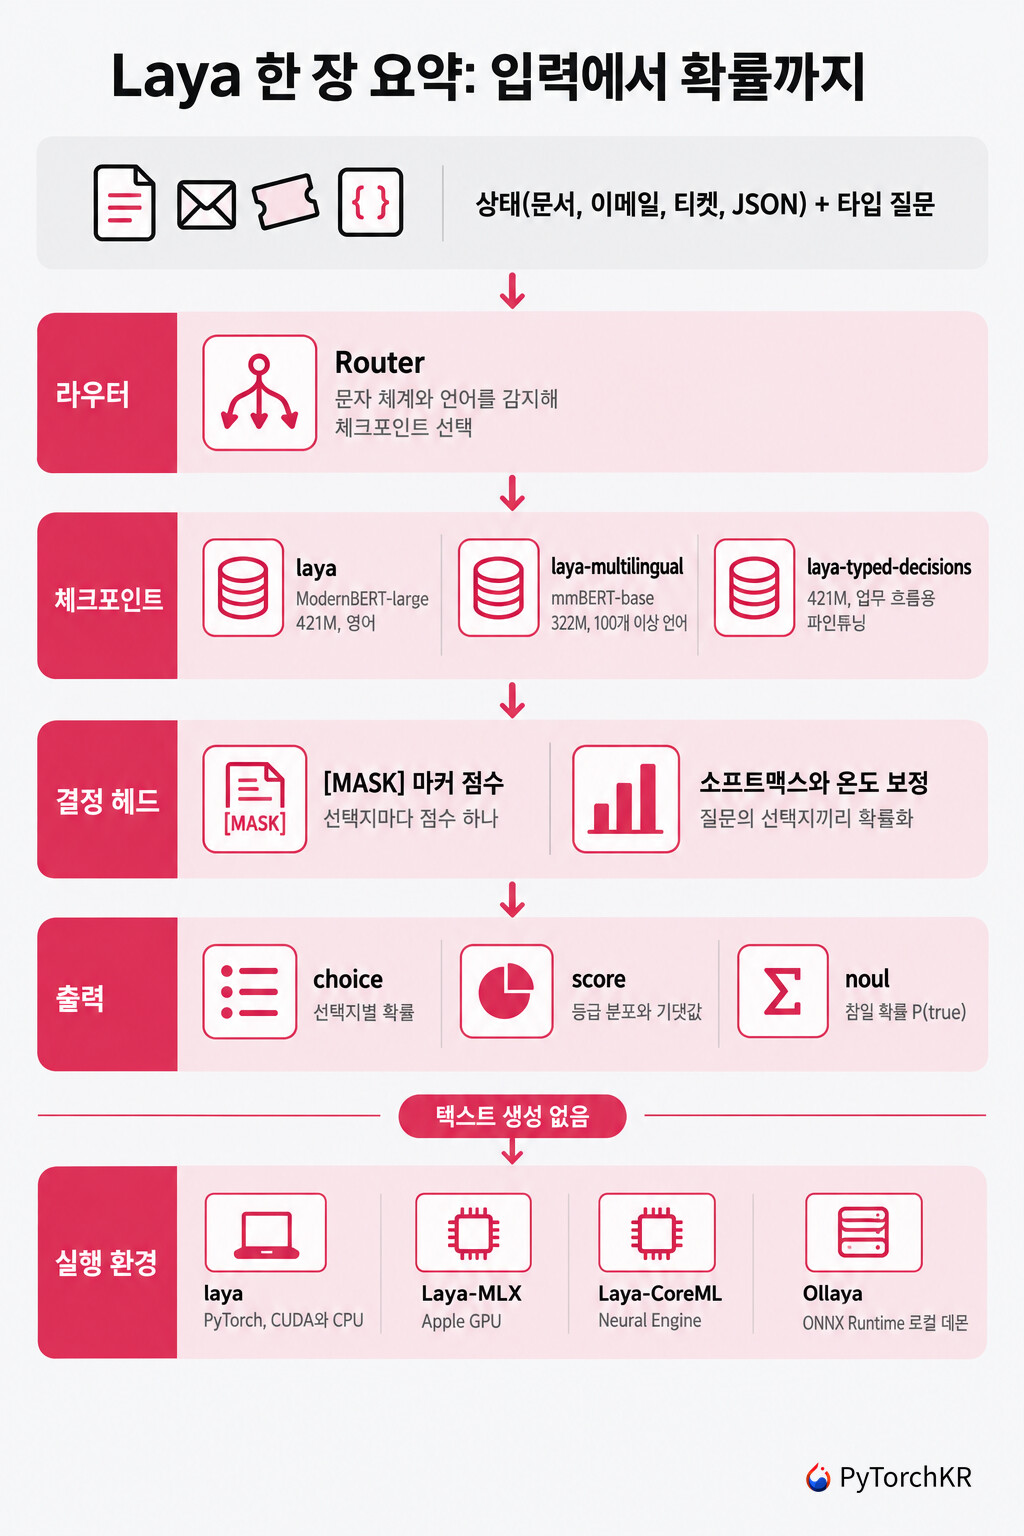
Laya는 질문 하나를 토큰 시퀀스 하나로 펼칩니다. 앞에 질문 유형과 지시문이 오고, 선택지마다 [MASK] 토큰을 하나씩 붙인 뒤, 마지막에 상태를 둡니다. 저자의 개발기에 실린 예시는 다음과 같습니다:
[CLS] choice question: Which team should handle `body`? [SEP]
[MASK] billing: payments [MASK] tech: bugs [MASK] other: general [SEP]
{"subject": "Refund request", "body": "I was billed twice..."} [SEP]
이 시퀀스가 인코더를 지나면, 새로 학습한 2층 트랜스포머 결정 헤드가 각 [MASK] 위치의 은닉 상태를 스칼라 점수 하나로 바꿉니다. 그 점수(로짓)를 질문 유형과 선택지 개수별로 맞춘 온도(temperature)로 나눈 뒤 해당 질문의 선택지끼리 소프트맥스하면 확률 분포가 됩니다. 선택지 공간이 요청 시점에 정해지므로 새로운 질문 스키마에도 재학습이 필요 없습니다. 영어 체크포인트는 ModernBERT-large(395M) 전체를 미세조정하고 결정 헤드를 더해 모두 421M이며, 다국어 체크포인트는 mmBERT-base(22층, 어휘 256k) 기반으로 322M입니다. 한 요청의 질문들은 각자의 행으로 한 배치에 묶여 순전파 한 번에 처리됩니다.
학습에는 교차 엔트로피 대신 강화학습을 씁니다. 모델 카드에 따르면 정책이 분포를 보고하고, 탐색 단계에서 로짓에 평균 0의 가우시안 잡음을 더하며, 보상으로는 엄격한 적정 점수 규칙(strictly proper scoring rule) 을 씁니다. 정직한 확률을 보고할 때만 기대 보상이 최대가 되도록 만든 설계입니다. 저자의 개발기가 적은 보상은 로그 점수, 구면(spherical) 점수, 순위 확률 점수(Ranked Probability Score, RPS)의 조합이며, RPS는 순서가 있는 score 질문에서 등급 사이의 거리를 가르칩니다:
갱신은 그룹 평균을 기준선으로 쓰는 REINFORCE(GRPO 방식)이고, 여러 턴의 대화는 턴마다 자른 접두 구간을 λ=1.0의 시간차(Temporal Difference, TD) 학습으로 다룹니다. 응답의 confidence 는 정규화 엔트로피를 1에서 뺀 값이라 Jev의 계산식과 다르므로, Jev에서 쓰던 임계값을 그대로 옮기면 안 되고 보고된 답의 확률인 answer_confidence 로 판정하라고 개발사가 안내합니다. 0.3.21부터는 predict(..., min_confidence=0.85) 처럼 임계값을 넘기면 answer_confidence 가 그보다 낮은 답에 low_confidence: True 가 붙습니다. 개발기는 저장소의 초기 버전을 기준으로 쓰여 있어 벤치마크 수치가 현재 README와 다르고, 0.85 임계값 예시도 answer_confidence 가 아니라 confidence 로 판정하므로, 수치와 임계값은 README와 BENCHMARKS.md를 기준으로 읽어야 합니다.
Laya의 세 가지 체크포인트와 Router
Laya가 제공하는 체크포인트는 세 개이며, 모두 Hugging Face의 convaiinnovations/laya 저장소 하나에 들어 있고 요청한 것만 내려받습니다:
| 체크포인트 | 인코더 | 파라미터 | 컨텍스트 | 용도 |
|---|---|---|---|---|
laya |
ModernBERT-large | 421M | 512 | 영어 |
laya-multilingual |
mmBERT-base | 322M | 1,024 (최대 8,192) | 100개 이상 언어, 약 2배 빠름 |
laya-typed-decisions |
ModernBERT-large | 421M | 1,024 | typed-decisions 네 가지 업무 흐름용 미세조정 |
Router 가 필요한 이유는 영어 체크포인트의 정확도가 영어 밖에서 크게 떨어지기 때문입니다. 51개 언어의 MASSIVE 의도 분류(선택지 20개, 무작위 0.050)에서 영어 체크포인트는 크메르어에 정확도 0.000을 내면서도 신뢰도를 0.952로 보고했습니다. 틀리면서도 확신하므로 신뢰도 임계값으로는 걸러낼 수 없고, 그래서 Router 가 순전파 전에 순수 파이썬으로 1ms 미만에 문자 체계와 언어를 감지해 체크포인트를 고릅니다(문자 체계 감지는 0.5ms 미만). 아래 그림의 왼쪽(Every language: which checkpoint can read it)이 언어별로 두 체크포인트의 정확도를 비교한 결과이고, 파란 점이 laya, 주황 점이 laya-multilingual 입니다:
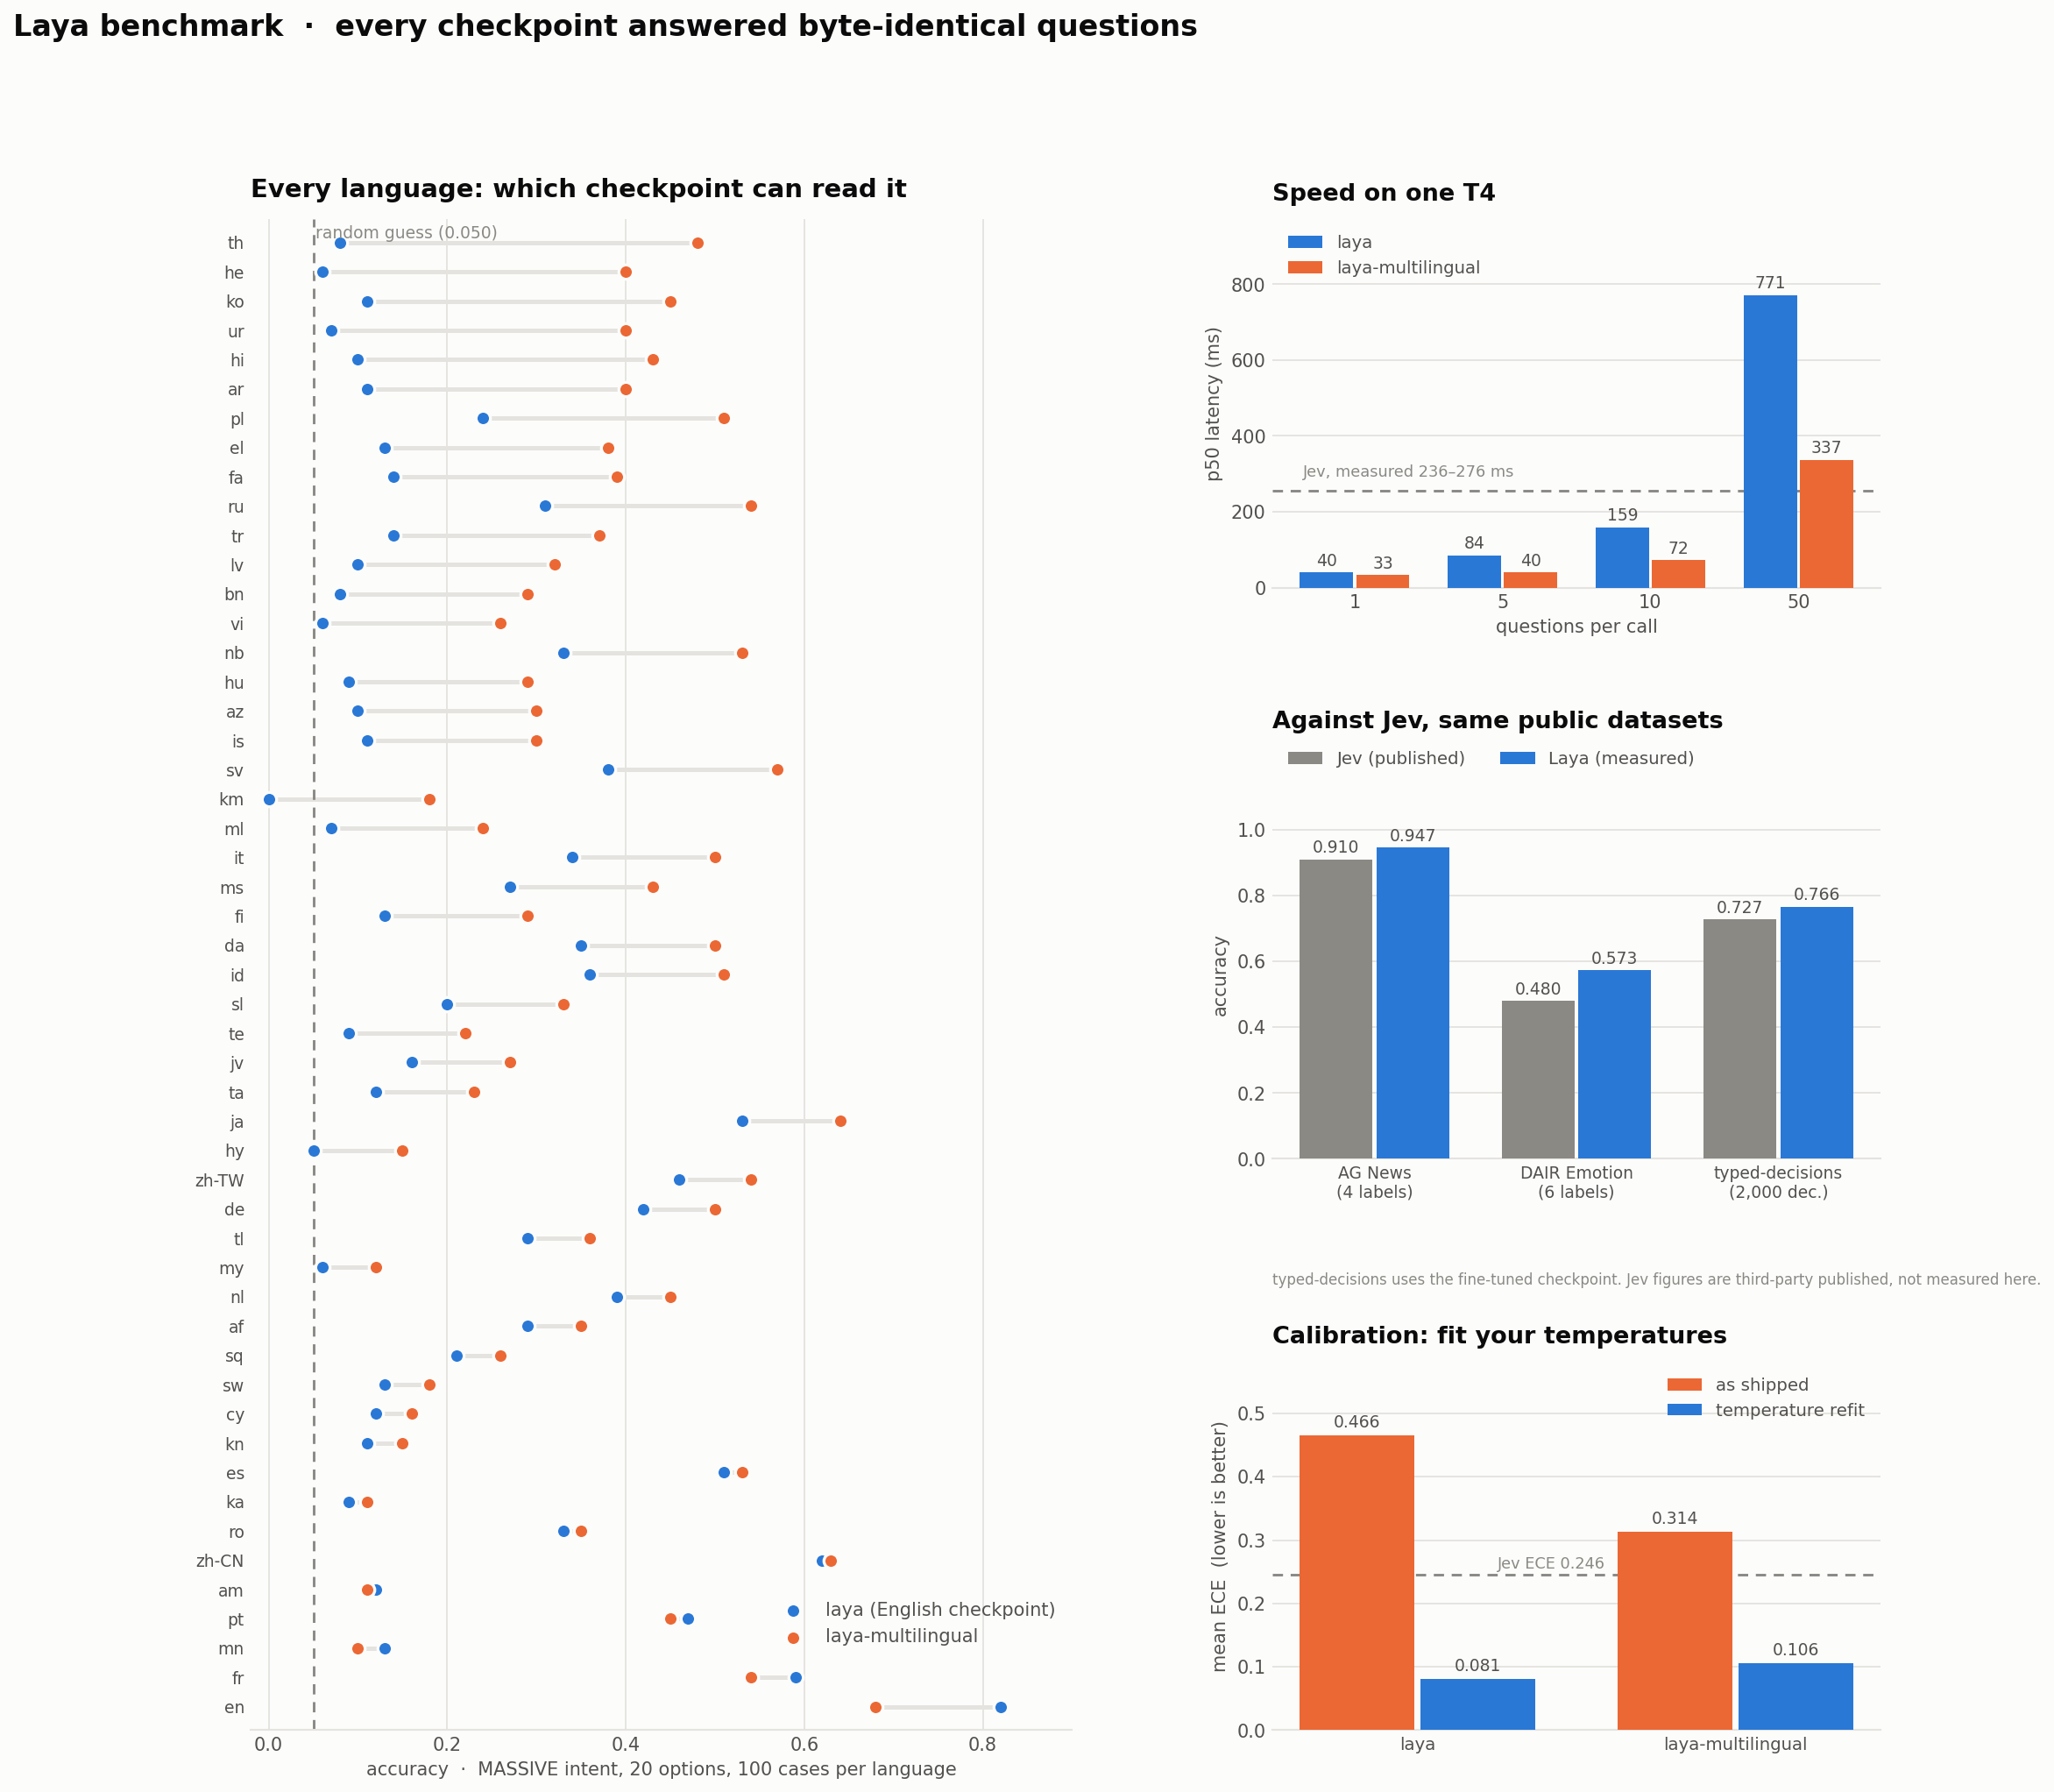
한국어(ko)는 이 차이가 큰 언어에 속합니다. BENCHMARKS.md의 언어별 표에서 한국어 정확도는 laya 0.110, laya-multilingual 0.450이고, 기대 보정 오차(Expected Calibration Error, ECE)는 각각 0.850과 0.329입니다. laya 의 ECE는 온도 상한이 도입되기 전에 잰 값으로, 같은 조건을 다시 잰 51개 언어 평균은 0.733에서 0.571로 내려갔습니다. 다국어 체크포인트로 가면 정확도가 네 배 남짓 나아지지만, 선택지 20개 문제에서 절반 이하의 정확도이므로 한국어 서비스에 쓰려면 자체 데이터로 미세조정과 온도 재추정을 거치는 것이 전제입니다.
Router 는 기본적으로 영어와 다국어 체크포인트 두 개만 메모리에 두고 LRU로 교체합니다. max_loaded=1 로 줄이면 언어가 바뀔 때마다 다시 적재하는 데 CPU에서 중앙값 7.4초, T4에서 10.3초가 걸리므로, 서버에서는 Router(preload=True) 로 미리 올려 두라고 권합니다. 라틴 문자로 쓴 짧은 문장은 언어를 판별할 단서가 부족해 기본값(영어)으로 가므로, 트래픽 대부분이 영어가 아니면 Router(default="multilingual") 로 바꾸거나 lang_guess 로 외부 언어 판별 결과를 넘기면 됩니다.
Laya 벤치마크와 저자가 밝힌 한계
아래 그림은 Convai Innovations가 공개한 Jev와의 비교 종합판으로, 위쪽(Accuracy)이 Jev 수치가 공개된 세 데이터셋의 정확도, 가운데(Every application workflow, every checkpoint)가 응용 과제별 정확도, 아래가 속도(Speed on one T4)와 보정(Calibration), 51개 언어(All 51 languages, routed) 결과입니다:
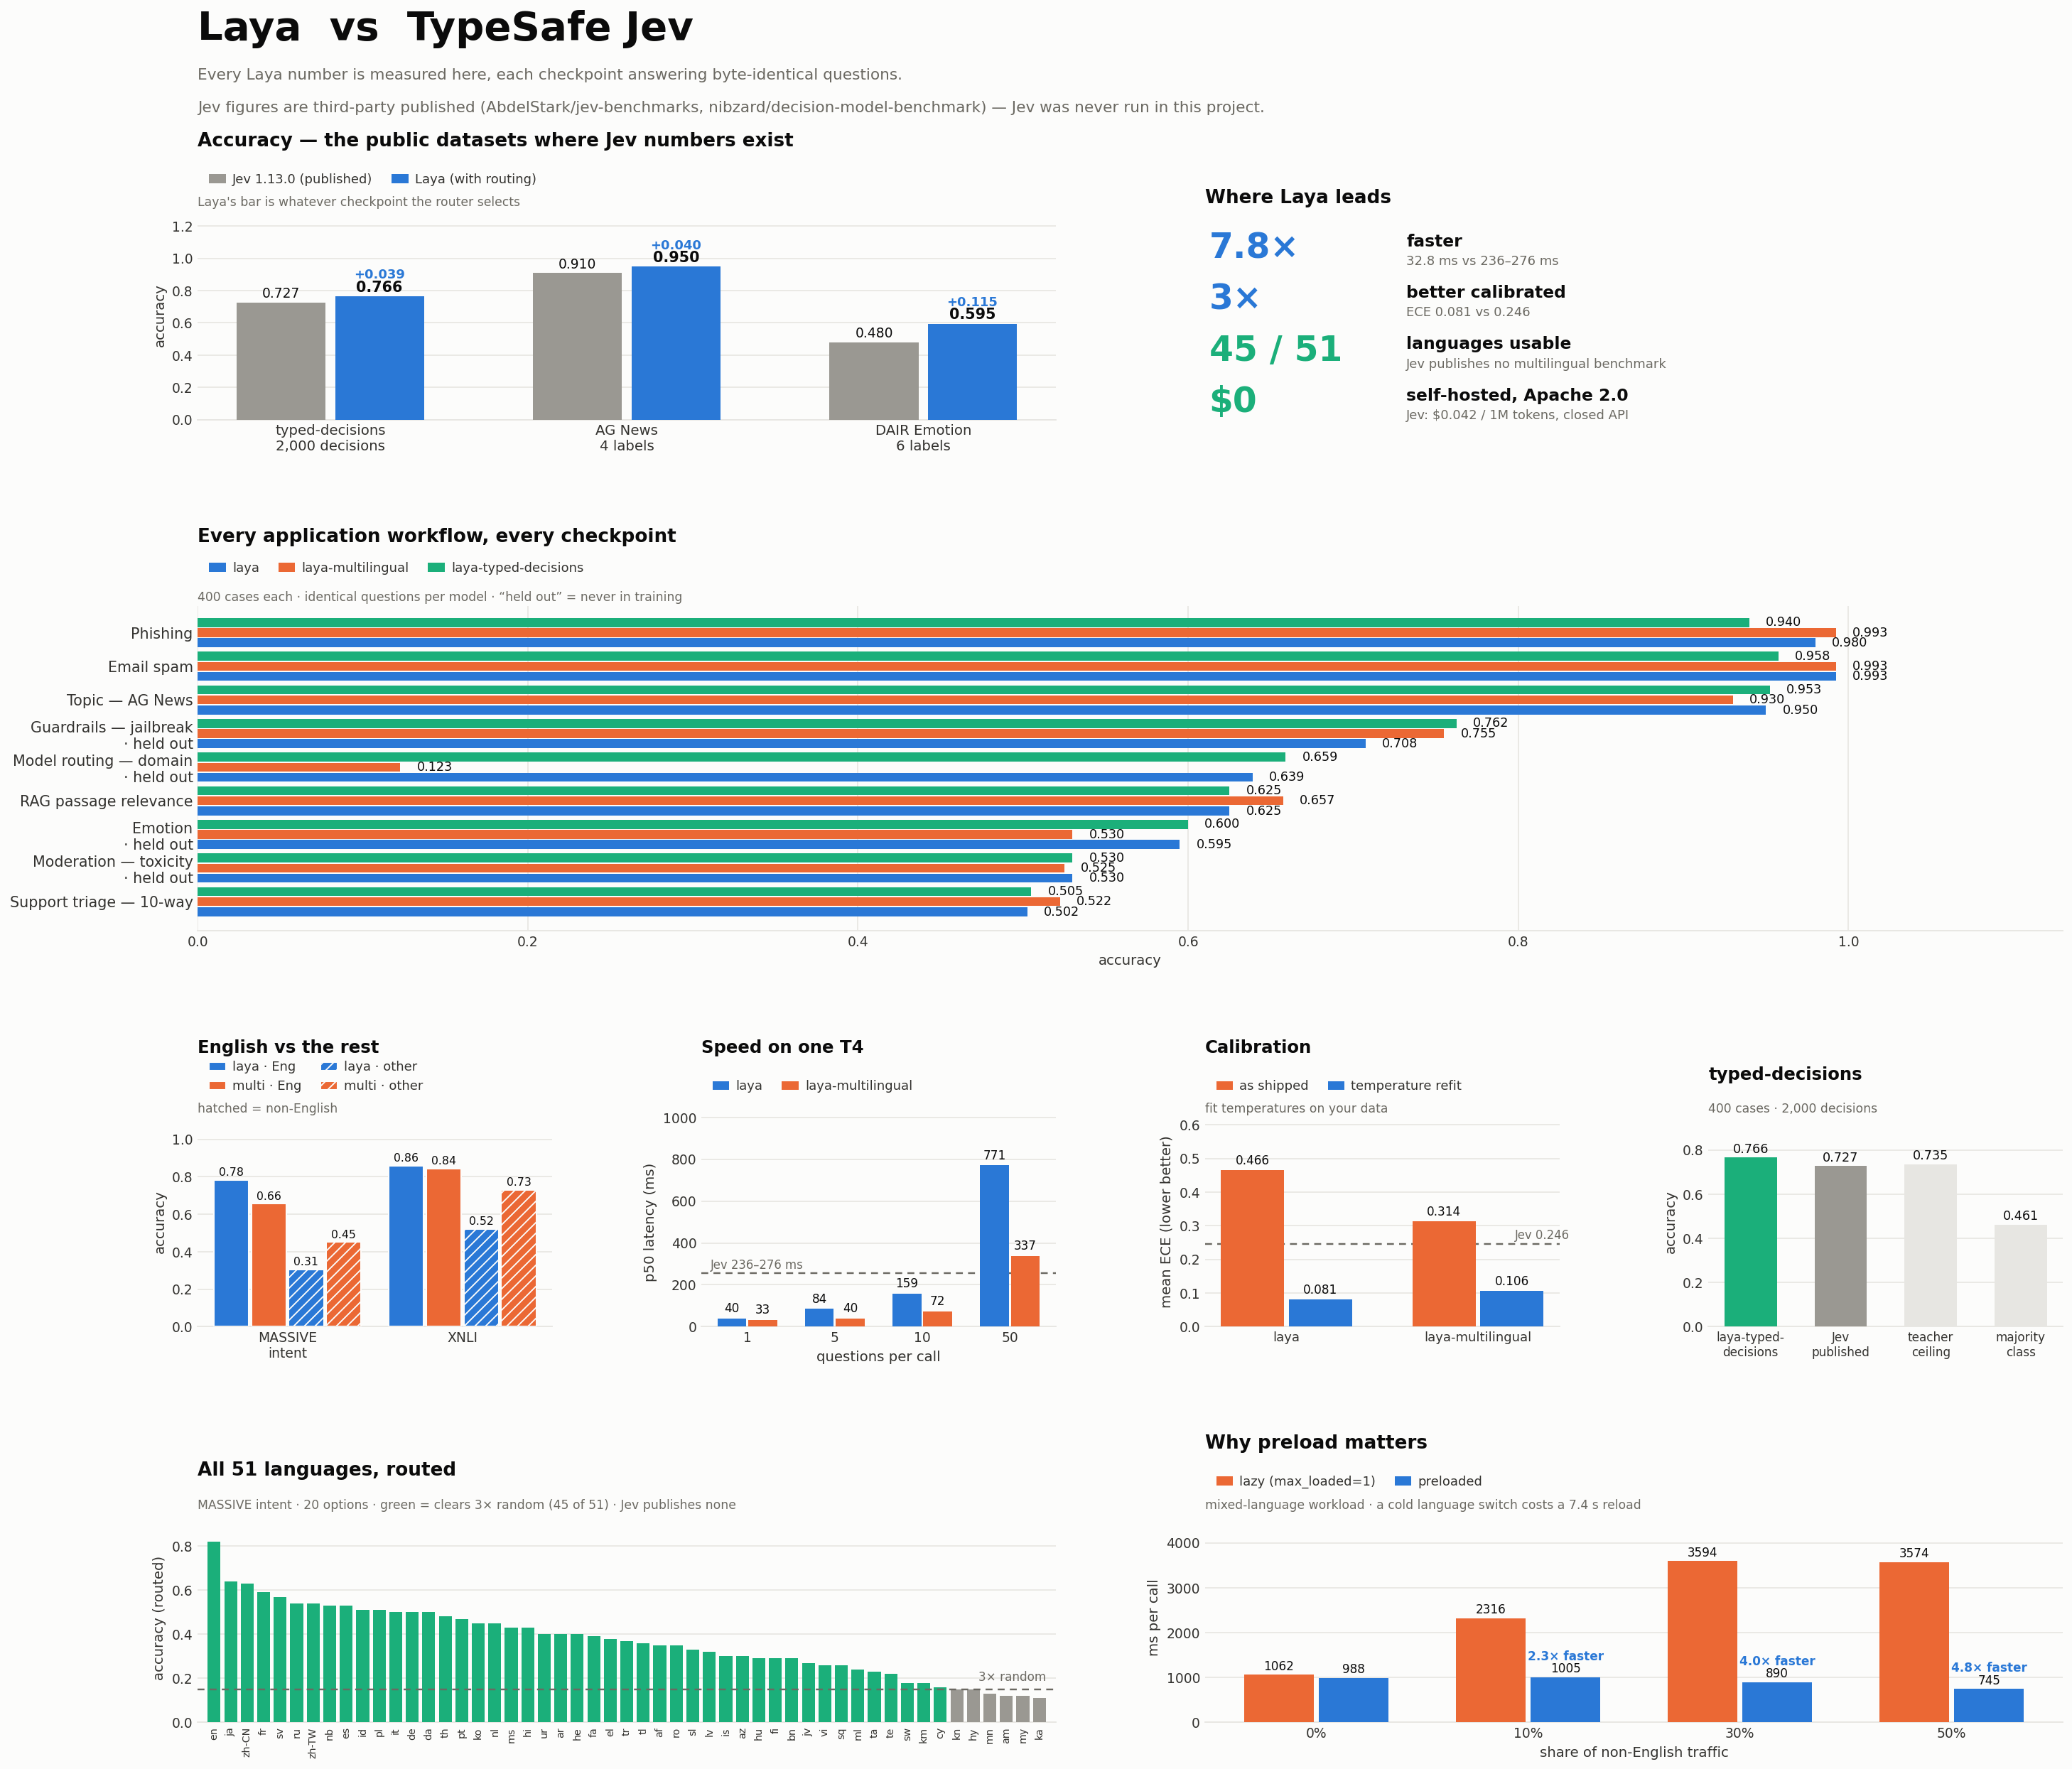
표로 옮기면 다음과 같습니다. Laya 수치는 Router().predict(...) 가 실제로 고른 체크포인트의 결과(typed-decisions 행만 미세조정 체크포인트)이고, Jev 수치는 제3자가 공개한 값입니다:
| 항목 | Jev 1.13.0 | Laya |
|---|---|---|
| typed-decisions, 결정 2,000개 | 0.727 | 0.766 |
| AG News, 레이블 4개 | 0.910 | 0.950 |
| DAIR Emotion, 레이블 6개 | 0.480 | 0.595 |
| Banking77, 레이블 Jev 72개, Laya 77개 | 0.870 | 0.425 |
| ECE(Laya는 온도 재추정 후, 낮을수록 좋음) | 0.246 | 0.081 |
이 표만 보면 Laya가 대부분 앞서지만, 저장소의 "Honest limits" 절을 함께 읽어야 수치의 의미가 정확해집니다. 가장 중요한 것은 typed-decisions의 0.766이 그 벤치마크의 학습 분할로 미세조정한 laya-typed-decisions 의 값이라는 점입니다. 같은 문제에서 기본 체크포인트는 0.362와 0.352로, 무작위 추측 0.318에 가깝고 질문별 최빈 클래스 기준선 0.461보다도 낮습니다. 개발사는 이 벤치마크의 능력이 전부 미세조정에서 나온다고 적고 있습니다. 미세조정 체크포인트도 교사 모델의 확률 분포 전체와 얼마나 맞는지를 보는 소프트 정확도(0.471 대 0.580)와 온도 재추정 전 ECE(0.213 대 0.144)에서는 Jev에 뒤진다고 개발사가 밝히고 있습니다.
나머지 한계도 도입 판단에 직접 영향을 줍니다:
- 선택지가 많은 질문: 선택지들이
head_max_len(영어 192토큰, 나머지 256토큰) 예산을 나눠 쓰므로, Banking77처럼 선택지가 77개면 레이블 하나에 3~4토큰만 남아 서로 구분되지 않습니다.head_max_len을 늘리거나, 임베딩으로 상위k개만 추리는predict_shortlist를 쓰거나, 질문을 두 단계로 나누라고 안내합니다. - 출고 상태의 과신: 두 체크포인트 모두 신뢰도가 실제 정확도보다 높게 나오며,
laya-multilingual에는 맞춰 둔 온도가 아예 없습니다. 질문 유형과 선택지 개수별로 온도를 다시 맞추면 평균 ECE가 0.466에서 0.081(laya), 0.314에서 0.106(laya-multilingual)으로 내려갑니다. - 레이블과 부정문에 흔들리는 답:
noul은 특히 영어 체크포인트에서 상태보다false/true레이블 자체를 따라가 명백한 긍정 입력에 확신에 찬 부정을 내기도 하고(#156, 모델에 보이는 레이블 문구를labels로 바꾸는 우회책이 있습니다), 해지를 하지 않겠다는 부정문 네 건에서 영어 체크포인트는 네 건 모두, 다국어 체크포인트는 두 건에cancel_account를 고른 사례도 있습니다(#377). - 가장 약한
score: 순서형 질문은 SST-5에서 0.372로 가장 약하고, 다국어 체크포인트는 첫 번째 등급을 거의 고르지 않는 위치 편향이 있습니다(#131). - 학습에 없던 데이터에서의 응용 과제: 과제마다 레이블 데이터 400건으로 잰 결과, 학습에 포함된 스팸과 피싱 분류는 0.993까지 나오지만 학습에 쓰지 않은 데이터에서는 탈옥 탐지가 0.708~0.762, 유해성 중재(moderation)가 0.530(macro-F1 0.400)에 그칩니다. 개발사는 데모의 중재 탭이 골라 둔 예시에서는 동작하지만 실제 트래픽에서는 그렇지 않다고 적고 있습니다.
- 긴 문서:
laya-multilingual은max_len=8192로 8,192토큰까지 읽습니다. 약 4,000토큰까지는 20건 중 16~18건을 맞혔지만 그 이후는 8~17건으로 흔들리고, 4,000토큰 입력은 Apple GPU에서 약 1.7초가 걸립니다.
속도는 하드웨어에 따라 크게 다릅니다. T4에서 질문 하나에 39.5ms(영어)와 32.8ms(다국어)였고, 4코어 AMD EPYC 서버 CPU에서는 580ms와 193ms였습니다. 기여자가 측정한 Intel Arc B390(XPU)에서는 영어 체크포인트가 질문 하나에 bf16 자동 혼합 정밀도로 29.7ms가 나와, 측정 조건은 다르지만 T4와 같거나 조금 빠른 수준이었습니다.
Laya 설치와 사용
Laya는 Python 3.10 이상이 필요하고 PyPI 패키지로 설치합니다. 첫 사용 시 체크포인트를 Hugging Face에서 내려받습니다:
python -m pip install laya
권장 진입점은 Router 입니다. 상태 하나에 세 가지 유형의 질문을 함께 던지는 예시는 다음과 같습니다:
from laya import Router

router = Router()  # downloads a checkpoint on first use; Router(preload=True) loads all three up front

state = "Hi, we were billed twice for March. Please refund the duplicate today or we will cancel our plan."
questions = {
    "department": {"type": "choice", "instructions": "Which department should handle this?",
                   "criteria": {"billing": "invoices, payments, refunds",
                                "technical": "bugs, outages, system errors",
                                "other": "everything else"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["not urgent", "soon", "blocking"]},
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
}

result = router.predict(state, questions)
print(result["answers"]["department"]["choice"])  # billing
print(result["answers"]["churn_risk"]["noul"])    # probability the answer is yes
print(result["routing"]["model"])                 # english
이 예제의 churn_risk 처럼 criteria 없이 쓴 noul 은 영어 체크포인트(laya)에서 상태와 무관하게 "아니오"로 답한다고 개발사가 밝히고 있으므로, 실제로 쓸 때는 true/false 에 해당하는 criteria 를 함께 적어야 합니다.
설치하면 laya 명령도 함께 생깁니다. 라우팅 결정만 확인하는 호출은 체크포인트를 내려받지 않으므로 오프라인에서도 동작합니다:
laya "I was charged twice, please refund"            # routing decision only; works offline, no download
laya "Refactor this service" --predict               # full answers (downloads the checkpoint on first use)
laya "My payment failed twice" --preset triage       # answer a ready-made preset (triage, email, guard, moderation, router)
HTTP 서버로 실행하면 Jev와 같은 POST /v1/systemone 형식으로 응답하므로, 기존 Jev 클라이언트는 기본 주소를 바꿔 연결할 수 있습니다. 다만 선택지 개수 예산, 설명이 비어 있는 score 등급의 거부(422), confidence 계산식 세 가지가 Jev와 다르고, HTTP 서버는 질문당 선택지를 100개까지만 받으므로(초과 시 413) 옮기기 전에 확인해야 합니다. 서버는 0.0.0.0 에 바인딩되고 LAYA_API_KEY 를 설정하지 않으면 인증이 없으므로, 외부에 노출하는 환경에서는 반드시 키를 설정해야 합니다:
pip install "laya[serve]"          # adds fastapi + uvicorn + python-multipart
LAYA_DEVICE=cuda LAYA_PRELOAD=1 laya-serve   # binds 0.0.0.0:8000, preloads all 3 checkpoints
이 밖에 MCP(Model Context Protocol) 서버(laya[mcp]), LangChain과 LangGraph 통합(laya[langchain]), LlamaIndex 선택기(laya[llamaindex]), CrewAI 라우팅(laya[crewai]), ONNX Runtime 실행(laya[onnx]), TileLang 커널로 만든 GPU 가속 경로(laya[fast])가 선택 설치로 제공됩니다. JSON 스키마나 pydantic 모델로 원하는 출력 형태를 적으면 순전파 한 번으로 타입이 맞는 값을 채워 주는 decide 와, 레이블 데이터셋으로 정확도와 ECE 기준을 CI에서 검사하는 laya-evals 도 함께 들어 있습니다. 미세조정은 Kaggle 무료 T4 두 장에서 도는 노트북으로 데이터셋 구성부터 RLCD 학습, 온도 추정, 평가, Hub 업로드까지 진행할 수 있으며, 약 3만 개 질문으로 4 에폭을 학습하는 데 4~5시간이 걸립니다.
Laya를 로컬에서 실행하는 세 가지 프로젝트
Laya 본체도 CPU와 CUDA, Apple의 MPS, Intel XPU에서 돌아가지만, PyTorch와 Transformers를 설치해야 합니다. 아래 세 프로젝트는 Laya의 원본 가중치를 변환하거나 그대로 읽어 실행 환경을 바꾼 것으로, 모두 Convai Innovations와 별개의 조직과 개인이 만든 독립 프로젝트입니다:
| 항목 | Laya-MLX | Laya-CoreML | Ollaya |
|---|---|---|---|
| 실행 엔진 | MLX ( MLX: 애플 전용칩(Apple silicon: M1, M2, M3 등)을 지원하는 새로운 머신러닝 프레임워크) |
Core ML, Neural Engine | ONNX Runtime, GGUF는 llama.cpp |
| 대상 | Apple Silicon GPU | Apple Silicon Neural Engine, CPU와 GPU | Linux, macOS, Windows의 CPU와 NVIDIA GPU |
| 형태 | Python 패키지(laya-mlx) |
Python 패키지(laya-coreml) |
Rust 단일 바이너리, 데스크톱 앱, Docker |
| 공개된 속도 | 짧은 질문 하나 P50 7.39ms(다국어), 13.42ms(영어), M3 Max | 짧은 질문 하나 P50 4.98ms(다국어), M3 Max | laya:en 질문 5개에 8~10ms, RTX 4090 |
| 다루는 모델 | Laya 체크포인트 세 개 | Laya 체크포인트 세 개와 Neural Engine 전용 변형 | Laya 외 winnow, decider, kev, Decision 1.0 등 여러 결정 모델 |
Laya-MLX: Apple GPU에서 PyTorch 없이 실행
Laya-MLX는 Laya의 인코더와 결정 헤드를 MLX로 다시 구현한 포트입니다. 프롬프트 구성, 출력 형식, 언어 라우팅, 프리셋은 원본 저장소의 특정 커밋에서 가져왔고, 추론(Inference)과 변환만 담당하며 학습과 미세조정은 원본 프로젝트에 남겨 두었습니다. 미리 FP16으로 변환한 가중치가 Hugging Face의 aac6fef/laya-mlx 등에 올라가 있고, 원본 체크포인트 아이디를 넣어도 그대로 불러옵니다:
pip install laya-mlx
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
    "I was billed twice. Please refund the duplicate.",
    {
        "department": {
            "type": "choice",
            "instructions": "Who should handle this?",
            "criteria": ["billing", "technical", "sales"],
        }
    },
)
print(result["answers"]["department"])
Apple Silicon, Python 3.11 이상, macOS 14 이상이 필요합니다. 저자는 세 체크포인트가 검증 질문 63개에서 FP32와 FP16 모두 원본과 같은 답을 골랐다(378건 중 378건)고 밝히면서, 이것이 모든 질문에서의 정확도가 아니라 이식 충실도라는 점을 분명히 적어 두었습니다. 매 수마다 Laya를 호출하는 터미널 Snake 데모도 들어 있습니다:

Laya-CoreML: Neural Engine에서의 짧은 결정
Laya-CoreML은 같은 저자가 Laya-MLX에 이어 만든 Core ML 포트로, 짧은 결정을 Apple Neural Engine(ANE)에서 실행하는 전용 그래프를 제공합니다. M3 Max에서 다국어 체크포인트의 짧은 결정 하나가 ANE FP16으로 P50 4.98ms였고, 같은 실험에서 컴파일한 MLX FP16 대비 결정 하나당 시스템 전체 에너지가 2.78배 적었습니다. 단, ANE 번들은 질문과 선택지, 상태를 모두 합쳐 96토큰이 상한이고, 1,024토큰 ANE 그래프는 실제 1,024토큰 요청에 약 91.7ms가 걸려 긴 입력에서의 이점은 확인되지 않았다고 저자가 적고 있습니다. 일반 용도에는 CPU와 GPU에서 도는 1,024토큰 번들을 쓰면 됩니다:
pip install laya-coreml
import laya_coreml as laya

agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
    "The customer requests a refund of a duplicate payment.",
    {
        "refund": {
            "type": "noul",
            "instructions": "Does the customer request a refund?",
        }
    },
)
print(result["answers"]["refund"])
macOS 15 이상과 Python 3.11~3.13이 필요하며, 추론에는 PyTorch, Transformers, MLX가 모두 필요 없습니다. Neural Engine의 동작 방식이 궁금하다면 maderix/ANE 분석 글도 함께 참고할 만합니다.
Ollaya: 결정 모델을 위한 Ollama
Ollaya는 Ollama가 LLM을 다루는 방식을 결정 모델에 옮긴 프로젝트입니다. Rust로 작성한 바이너리 하나가 pull, run, list, ps, serve 같은 Ollama식 명령과 로컬 데몬을 제공하고, 데몬이 TypeSafe의 /v1/systemone 형식을 그대로 말하므로 공식 SDK도 TYPESAFE_BASE_URL=http://localhost:11435 하나로 로컬을 가리킬 수 있습니다:
curl -fsSL https://ollaya.dev/install.sh | sh
ollaya run laya --preset triage "Your app crashed during checkout and I was charged twice. Please refund one of the charges."
Ollaya는 가중치를 다시 호스팅하지 않습니다. 약 3MB의 ONNX 그래프만 배포하고, 그 그래프가 원저자의 Hugging Face 저장소에서 커밋을 고정하고 sha256으로 검증한 원본 가중치 파일을 읽습니다. 프로젝트는 fp32 변환본이 체크포인트마다 질문 2,383개 전부에서 PyTorch 원본과 같은 답을 냈다고 밝히고 있습니다. Laya 외에 kev, vLLM Semantic Router 팀의 Decision 1.0, Qwen3Guard, 제로샷 자연어 추론(Natural Language Inference, NLI) 분류기 등 여러 결정 모델을 이름으로 내려받을 수 있고, 질문 세트를 모델에 고정하는 Modelfile과 MCP 서버(ollaya mcp)도 지원합니다.
Ollaya가 기본으로 권하는 모델은 Laya가 아니라 Gemma 4를 미세조정한 4B급 언어 모델 winnow:e4b 입니다. 프로젝트는 이 모델이 typed-decisions에서 0.722를 내고 RTX 4090에서 질문 다섯 개에 89ms가 걸린다고 밝히면서, NVIDIA GPU가 없다면 CPU에서도 1초 안쪽으로 답하는 laya 부터 시작하라고 안내합니다.
맥 사용자가 알아 둘 점도 하나 있습니다. Ollaya에서 ONNX로 실행되는 Laya는 CPU 또는 NVIDIA CUDA에서만 돌고, Apple Metal 가속은 GGUF 모델에만 적용됩니다. Apple Silicon에서 Laya 자체의 속도가 중요하면 Laya-MLX나 Laya-CoreML이, 여러 결정 모델을 한 데몬으로 바꿔 가며 쓰는 것이 중요하면 Ollaya가 맞습니다. Laya 저장소의 커뮤니티 도구 목록에는 MLX GPU와 Neural Engine을 함께 쓰는 laya-apple, 화웨이 Ascend NPU용 laya-Ascend 같은 실행 환경도 더 있고, 그 밖의 Laya 도구들은 Jev 생태계 프로젝트 목록에서 찾아볼 수 있습니다.
Laya의 라이선스
Laya는 Apache-2.0으로 공개되어 있고, 세 체크포인트의 모델 카드도 같은 라이선스를 명시하고 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. Laya-MLX, Laya-CoreML, Ollaya도 모두 Apache-2.0입니다.
단, Ollaya로 내려받는 모델은 각자의 라이선스를 따르고, 그중 nli:deberta-v3-large 는 MIT입니다. Laya 외의 모델을 상업적으로 쓰기 전에는 Ollaya README의 라이선스 절에서 모델별 조건을 확인해야 합니다.
 Laya 웹 데모 (Hugging Face Space)
 Ollaya 홈페이지
 Laya 공식 문서
 Laya 개발 배경을 정리한 저자의 글 (dev.to)
 Laya 프로젝트 GitHub 저장소
Laya-MLX 프로젝트 GitHub 저장소
Laya-CoreML 프로젝트 GitHub 저장소
Ollaya 프로젝트 GitHub 저장소
 Laya 모델 체크포인트 (Hugging Face)
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
vLLM Semantic Router팀, Jev와 유사한 Decision 1.0 기능 및 6개 모델, Decision Studio 공개
-
정확도 너머에: 시계열 파운데이션 모델(TSFM)이 잘 보정(Calibration)되어 있는지에 대한 연구 (feat. ICLR 2026)
-
MLX: 애플 전용칩(Apple silicon: M1, M2, M3 등)을 지원하는 새로운 머신러닝 프레임워크
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
