LFM2.5-2.6B 소개
Liquid AI가 온디바이스(on-device) 환경에서 에이전트를 직접 돌리는 것을 목표로 만든 2.6B 파라미터 모델 LFM2.5-2.6B를 공개했습니다. 휴대폰에 올라갈 만큼 작고, CPU에서도 반응이 끊기지 않을 만큼 빠르며, 계획을 세우고 도구를 호출하며 여러 단계에 걸친 작업을 수행할 만큼의 능력을 갖췄다는 것이 이 모델의 요지입니다. 에이전트용으로 사후학습을 마친 본 모델과, 미세조정 출발점으로 쓸 LFM2.5-2.6B-Base가 함께 공개되었으며, 둘 다 Hugging Face에서 내려받을 수 있습니다.
이 모델이 던지는 질문은 "작은 모델이 얼마나 똑똑한가" 보다는 "에이전트를 돌리는 비용이 0이 되면 개발 방식이 어떻게 바뀌는가" 에 가깝습니다. 클라우드 API에 의존하는 에이전트는 토큰마다 돈이 들기 때문에, 백그라운드에서 수백만 토큰을 태우며 도는 작업이나 수십 개를 동시에 띄우는 병렬 실행이 곧 비용 문제로 되돌아옵니다. 반면 로컬에서 도는 에이전트는 추론이 공짜이고, 왕복 지연이 없고, 데이터가 기기를 떠나지 않습니다. Liquid AI는 이 지점을 겨냥해 "토큰 비용이 제약이 아니게 되면 에이전트를 어디서든 하루 종일 돌릴 수 있다" 고 설명합니다.
Liquid AI는 MIT CSAIL에서 출발한 스타트업으로, 거대한 클라우드 모델 경쟁에 뛰어드는 대신 사용자 기기에서 직접 추론을 돌리는 방향을 택해 왔습니다. 이 회사의 모델군인 Liquid Foundation Models(LFM) 은 어텐션을 매 층마다 쌓는 일반적인 트랜스포머가 아니라, 값싼 게이트 단거리 합성곱 블록을 대부분의 층에 채우고 장거리 정보가 필요한 자리에만 소수의 어텐션을 끼워 넣은 하이브리드 구조를 씁니다. LFM 계열의 학술적 뿌리와 아키텍처 설계 과정은 이전에 다룬 LFM2.5와 LFM2.5 Retrievers 소개 글에서 자세히 정리했으니, 처음 접하는 분은 그 글을 함께 읽으면 이해가 훨씬 빠릅니다.
이번 모델이 이전 LFM2.5 라인업과 다른 점은 크게 세 가지입니다. 첫째, 컨텍스트 창이 기존 32K에서 128K 로 넓어져 도구 호출 기록과 여러 단계의 작업 이력을 담을 수 있게 되었습니다. 둘째, 어휘 크기를 65K에서 128K 로 두 배 늘려 비라틴 문자권 언어의 처리 효율을 크게 개선했습니다. 셋째, 사후학습의 마지막 단계를 실제 에이전트 하네스(harness) 안에서 진행하는 에이전틱 강화학습 으로 구성해, 특정 하네스의 도구 목록과 시스템 프롬프트, 상호작용 패턴에 익숙한 상태로 출시되었습니다.
클라우드에 매인 에이전트와 기기에서 끝나는 에이전트
에이전트를 로컬에서 돌린다는 것이 왜 단순한 비용 절감 이상인지 짚어 보겠습니다. 클라우드 API 기반 에이전트에서 개발자가 실제로 마주하는 제약은 세 가지가 겹쳐 있습니다. 토큰당 과금 때문에 시행착오가 많은 탐색형 작업을 마음껏 돌리기 어렵고, 네트워크 왕복 때문에 짧은 도구 호출을 수십 번 반복하는 루프에서 지연이 누적되며, 코드베이스나 개인 문서를 컨텍스트에 넣는 순간 그 내용이 외부로 나갑니다.
로컬 에이전트는 이 세 제약을 동시에 풀어 줍니다. 특히 세 번째는 규제 산업이나 사내 문서를 다루는 상황에서 결정적이고, 첫 번째는 개발 방식 자체를 바꿉니다. Liquid AI가 강조하는 것도 이 지점입니다. 한계 비용이 없으면 에이전트를 로컬 하드웨어에서 대규모로 병렬화할 수 있고, 백그라운드에서 계속 도는 작업을 아무 부담 없이 띄울 수 있습니다.
물론 여기에는 전제가 있습니다. 기기에서 도는 모델이 실제로 도구를 제대로 호출하고 여러 단계 작업을 끝까지 완주해야 합니다. 지금까지 소형 모델이 로컬 에이전트로 잘 쓰이지 못한 이유가 정확히 여기에 있었습니다. 단순 대화나 요약은 되지만, JSON 스키마에 맞춰 함수를 호출하고 그 결과를 해석해 다음 행동을 결정하는 다중턴(multi-turn) 루프에서는 자주 무너졌기 때문입니다. LFM2.5-2.6B의 사후학습 설계는 대부분 이 문제를 겨냥하고 있습니다.
한눈에 보는 제원: 22개 합성곱 블록과 8개 어텐션 블록
먼저 모델의 골격을 정리합니다. 아래 값은 공식 문서와 Hugging Face 모델 카드, 그리고 저장소의 config.json을 함께 확인한 것입니다.
| 항목 | 값 |
|---|---|
| 총 파라미터 | 2.69B |
| 층 구성 | 30층 (게이트 단거리 합성곱 22 + GQA 8) |
| 은닉 차원 | 2,048 |
| MLP 중간 차원 | 10,752 (SwiGLU) |
| 어텐션 헤드 | 32개 (KV 헤드 8개, GQA 4대1) |
| 합성곱 커널 길이 | 3 |
| 어휘 크기 | 128,000 |
| 컨텍스트 길이 | 131,072 토큰 (128K) |
| RoPE theta | 10,000,000 |
| 임베딩 | 입출력 임베딩 공유 (tied) |
| 사전학습 예산 | 약 34조 토큰 |
| 지원 언어 | 16개 (한국어 포함) |
| 권장 생성 파라미터 | temperature: 0.1, top_k: 50, repetition_penalty: 1.1 |
층 구성을 조금 더 풀어 보면, config.json의 layer_types 배열은 합성곱 블록 2~3개마다 어텐션 블록 하나가 끼어드는 패턴을 보여줍니다. 30개 층 중 22개가 값싼 게이트 단거리 합성곱이고 8개만 전체 어텐션(full attention)이므로, KV 캐시가 차지하는 메모리와 트래픽이 같은 크기의 트랜스포머보다 훨씬 작습니다. 이것이 뒤에서 살펴볼 CPU 추론 속도와 2.5GB 미만의 메모리 사용량이 나오는 근본 이유입니다.
RoPE의 기저 주기(rope_theta)가 1,000만으로 설정된 점도 눈에 띕니다. 기본값인 1만보다 세 자릿수 크게 잡은 것으로, 위치 인코딩의 주기를 늘려 128K 토큰까지 위치를 구분할 수 있게 만든 흔적입니다. 지원 언어는 영어, 아랍어, 중국어, 프랑스어, 독일어, 이탈리아어, 일본어, 한국어, 포르투갈어, 스페인어, 베트남어, 태국어, 인도네시아어, 힌디어, 러시아어, 폴란드어로 총 16개이며, 한국어가 공식 지원 목록에 포함되어 있습니다.
34조 토큰과 두 배로 늘린 어휘: 사전학습과 중간학습
LFM2.5-2.6B의 베이스 모델은 약 34조(34T) 토큰으로 사전학습되었습니다. 2.6B 크기의 모델에 34조 토큰을 먹인다는 것은 파라미터당 1만 토큰이 넘는 비율로, 이른바 "작은 모델을 오래 학습시켜 추론 비용을 낮춘다" 는 전략을 상당히 극단까지 밀어붙인 셈입니다. 엣지 배포가 목표라면 학습 비용은 한 번만 들지만 추론 비용은 사용자 기기에서 매번 발생하므로, 이 방향의 투자는 합리적입니다.
여기에 두 가지 중간학습(mid-training) 단계가 붙습니다. 하나는 컨텍스트 창을 128K까지 늘리는 전용 단계이고, 다른 하나는 어휘 확장입니다. 후자는 별도의 기술 보고서로 정리될 만큼 공들인 부분이라 조금 더 자세히 볼 만합니다.
기존 LFM2 계열은 65,536개 어휘의 바이트 수준 BPE 토크나이저를 썼는데, 이 크기로는 태국어나 힌디어처럼 비라틴 문자를 쓰는 언어가 과도하게 잘게 쪼개졌습니다. 한 글자가 여러 개의 바이트 토큰으로 나뉘면 같은 문장을 생성하는 데 필요한 디코딩 단계가 그만큼 늘어나므로, 사용자가 체감하는 속도가 언어에 따라 크게 달라집니다. Liquid AI는 모델을 처음부터 다시 학습시키는 대신 기존 토크나이저를 제자리에서 확장하는 방법을 택했고, 이 방식은 LFM2.5-8B-A1B에 먼저 적용된 뒤 이번 모델에도 같은 절차로 쓰였습니다.
절차는 세 단계입니다. 먼저 원래 토크나이저의 BPE 병합 규칙을 그대로 씨앗으로 삼아 동결한 뒤 다국어 코퍼스로 병합 학습을 이어갑니다. 이렇게 하면 기존 65K 토큰 대부분이 그대로 살아남아 학습된 표현이 직접 전이되고, 새로 생긴 토큰은 모두 기존 토큰들의 시퀀스로 정확히 분해됩니다. 다음으로 이 분해를 이용해 새 토큰의 임베딩을 하위 토큰 임베딩의 평균으로 초기화합니다. 무작위 초기화가 전혀 없고 토크나이저 간 정렬을 따로 계산할 필요도 없습니다. 마지막으로 모델을 두 단계에 걸쳐 적응시키는데, 1단계에서는 나머지를 동결한 채 새 임베딩 행만 학습해 어휘 교체로 잃은 품질을 대부분 회복하고, 2단계에서 전체를 풀어 균형 잡힌 다국어 혼합으로 사전학습을 이어가며 남은 격차를 메웁니다. 참고로 Liquid AI가 공개한 토큰 규모(1단계 6,000억, 2단계 4,000억)와 회복 폭 수치는 이 방법을 처음 적용한 LFM2.5-8B-A1B 기준이며, LFM2.5-2.6B에 대해서는 "같은 절차를 사용했다" 고만 밝혔습니다.
효과는 언어별로 갈립니다. 인코딩 길이 감소폭이 가장 큰 언어는 태국어(4.0배), 벵골어(3.4배), 베트남어(2.6배), 힌디어(2.4배)였고, 영어와 코드는 설계상 그대로 유지되었습니다. 대신 어휘가 커진 대가로 LM 헤드를 매 스텝 읽는 비용이 늘어 토큰당 디코딩 속도는 참조 기기에서 7~10% 느려집니다. 사용자가 실제로 느끼는 것은 토큰당 시간이 아니라 글자당 시간 이므로, 잘게 쪼개졌던 언어는 순수하게 이득을 보고 이미 잘 처리되던 언어는 최대 9% 정도의 작은 손실을 감수하는 거래가 됩니다. Liquid AI는 256K까지 어휘를 더 늘리면 스냅드래곤에서 처리량 손실이 37%까지 커져 이득을 상쇄하기 때문에 128K에서 멈췄다고 밝혔습니다.
한국어 사용자 입장에서 주목할 점은, 한국어가 기존 LFM2 토크나이저에서도 인코딩 효율을 고려한 언어 목록에 들어 있었다는 것입니다. 즉 태국어나 힌디어처럼 극적인 개선을 기대하기는 어렵지만, 128K 어휘로 넘어오면서 지원 언어 목록에 정식으로 남았고 다국어 혼합 학습을 추가로 받았다는 의미가 있습니다.
베이스 모델을 에이전트로 바꾸는 네 단계 사후학습
이 모델의 진짜 특징은 사후학습에 있습니다. Liquid AI는 베이스 모델을 에이전트로 바꾸는 과정을 네 단계로 구성했습니다.
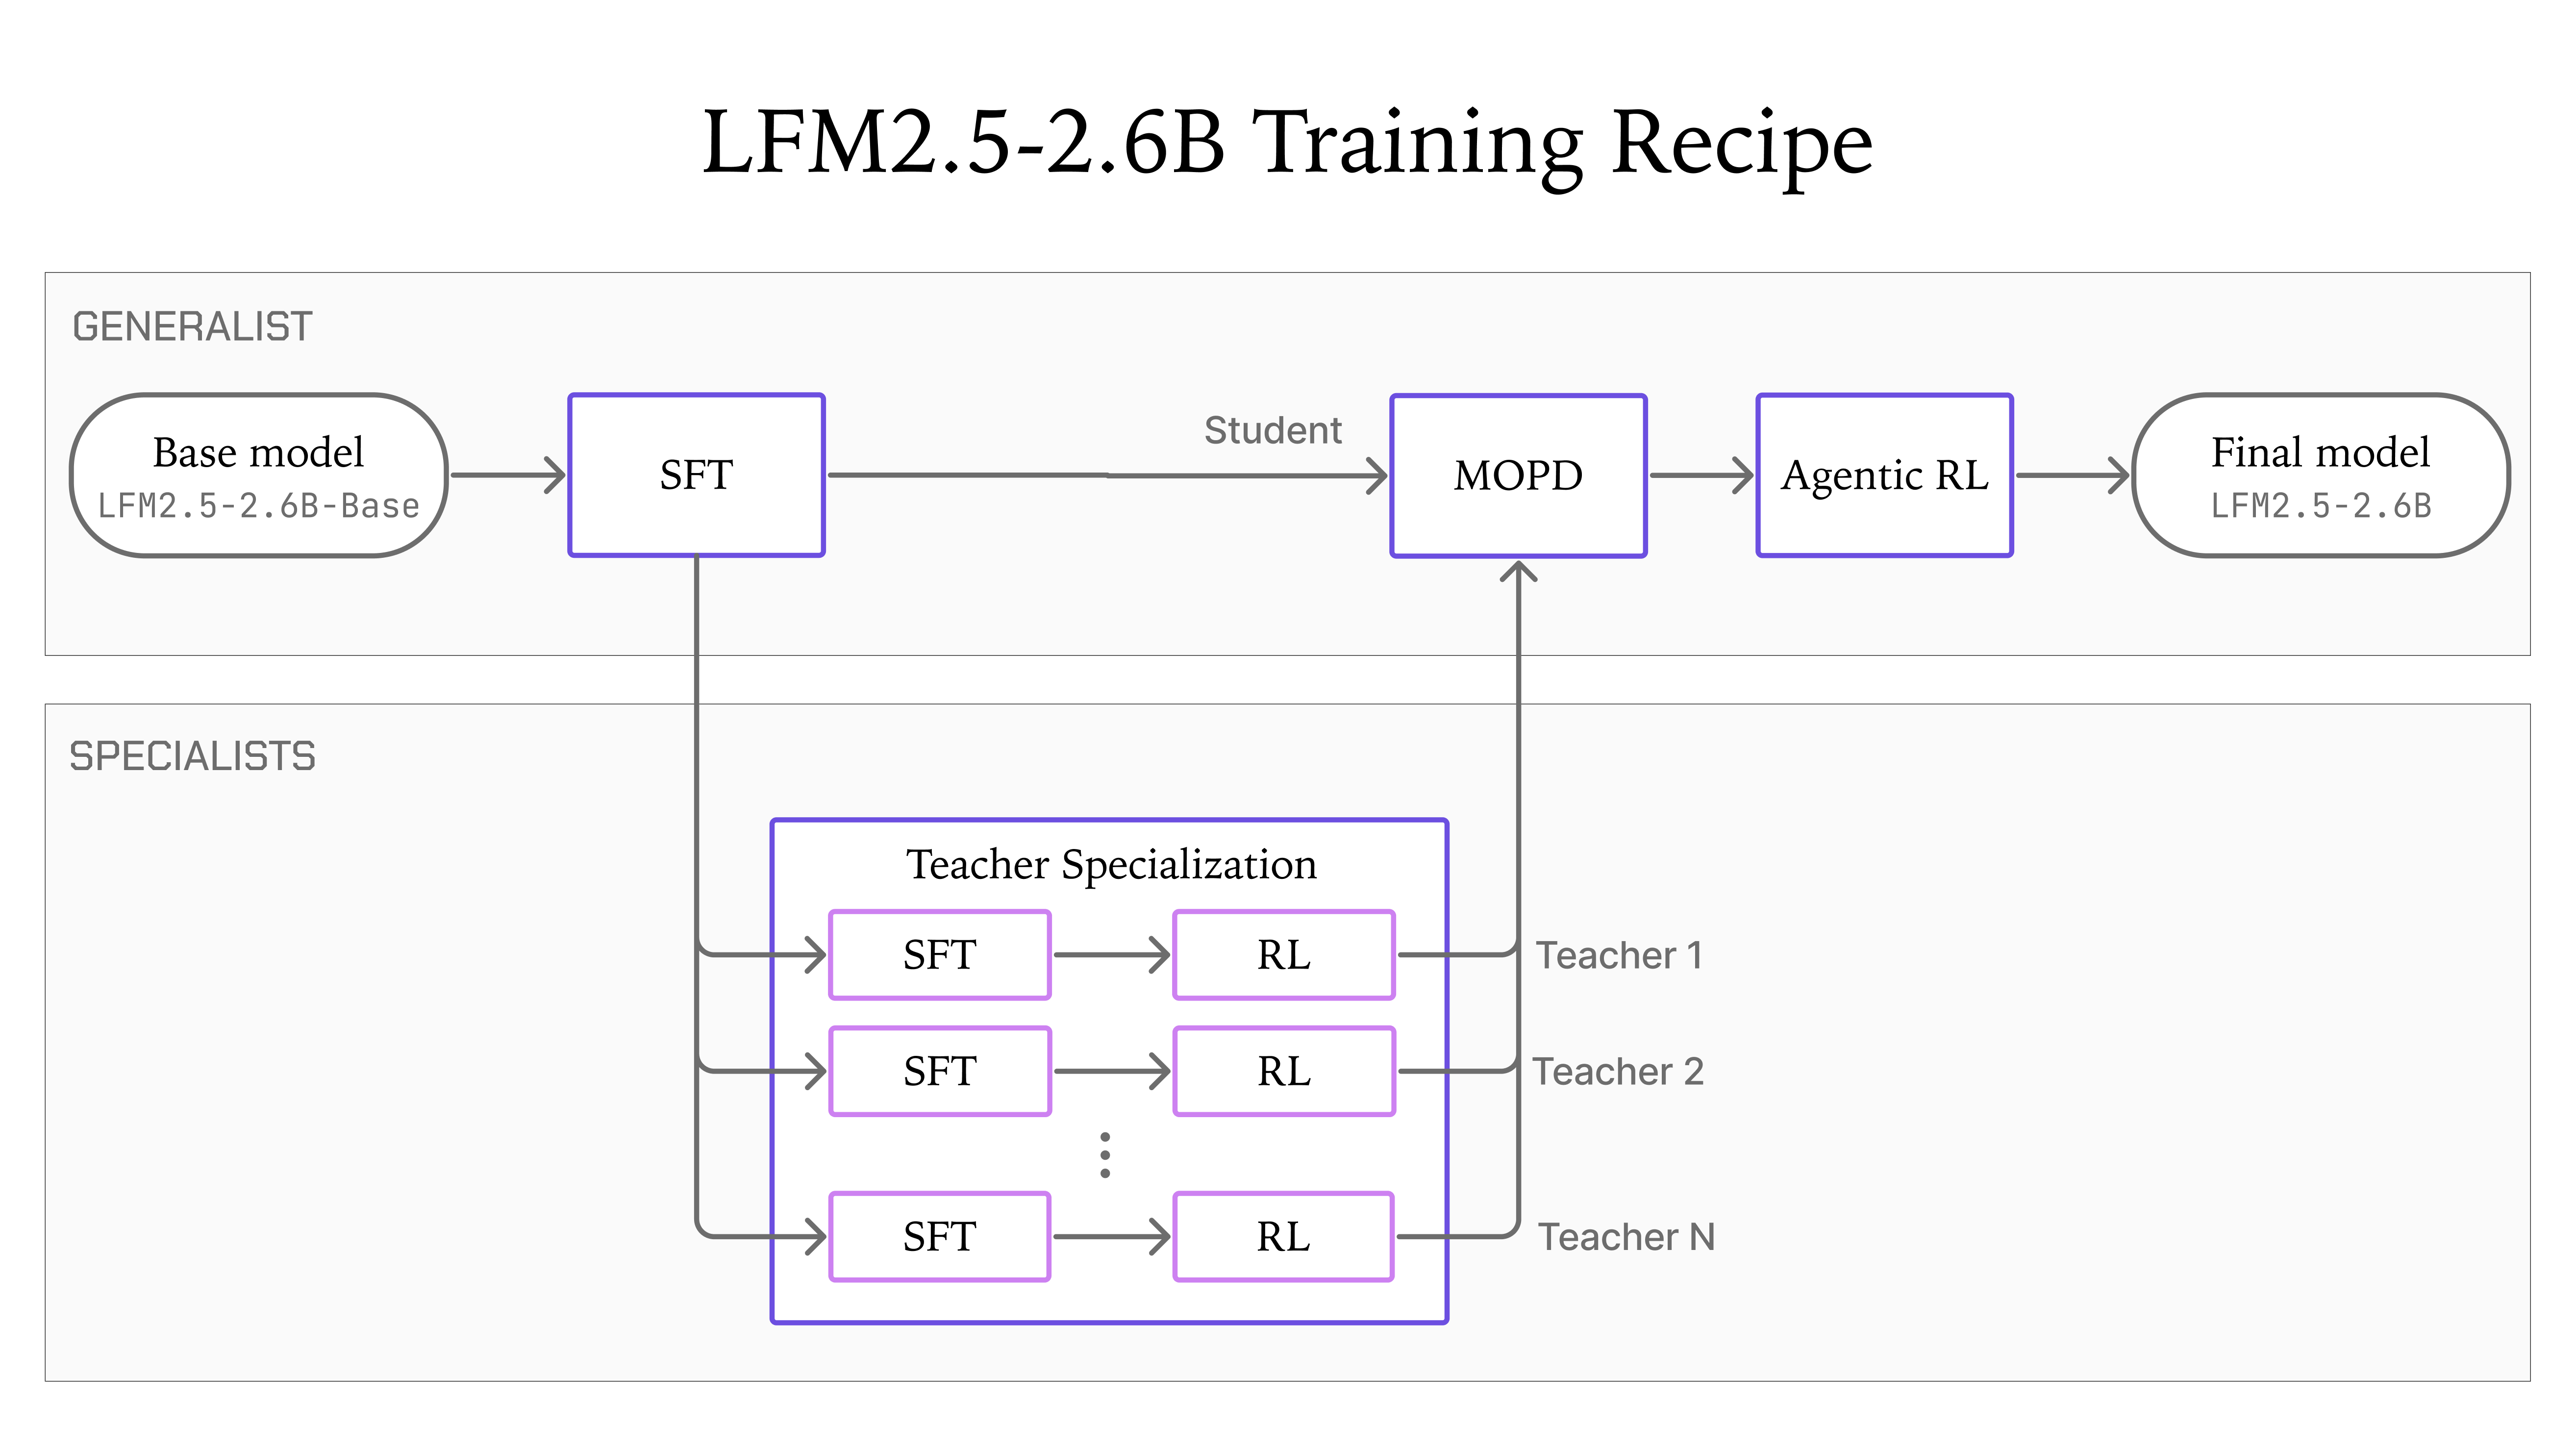
위 그림은 파이프라인 전체를 요약합니다. 위쪽 GENERALIST 흐름이 베이스 모델에서 최종 모델까지 이어지는 본 경로이고, 아래쪽 SPECIALISTS 박스는 같은 SFT 체크포인트에서 갈라져 나와 교사 모델들을 따로 기르는 부분입니다. 두 흐름이 MOPD 단계에서 다시 합쳐진다는 점이 이 레시피의 핵심입니다.
지도 미세조정: 넓게 덮은 뒤 다시 좁게 조이기
사후학습은 연속된 두 번의 지도 미세조정(Supervised Fine-Tuning, SFT) 으로 시작합니다. 첫 번째 라운드는 모든 도메인을 폭넓게 덮고, 두 번째 라운드는 에이전트 작업, 추론(reasoning), 도구 사용처럼 우선순위가 높은 능력에 집중해 다시 다듬습니다. 두 라운드를 합친 SFT 학습 혼합의 규모는 LFM2.5-8B-A1B에 쓰인 것의 약 7배이며, 도구 사용과 웹 검색, 소프트웨어 엔지니어링, 에이전트 트레이스 같은 에이전트성 데이터에 훨씬 큰 가중치가 실렸습니다.
여기서 나온 최종 SFT 체크포인트는 두 가지 역할을 동시에 맡습니다. 이후 증류 단계에서 배우는 학생 모델 이면서, 전문가 교사들을 기르는 출발 체크포인트 이기도 합니다. 이 공유가 뒤에 나올 안정성 논리의 출발점입니다.
교사 특화: 도메인마다 전문가를 따로 기른다
공유된 SFT 체크포인트에서 갈라져, 목표 도메인마다 하나씩 전문가 모델을 기릅니다. 각 전문가는 해당 도메인 쪽으로 비중을 조정한 데이터로 SFT를 한 번 더 받고, 이어서 검증 가능한 보상을 사용하는 강화학습(Reinforcement Learning with Verifiable Rewards, RLVR) 을 거칩니다. 이렇게 만들어진 전문가들이 담당하는 영역은 지시 따르기, 수학, 지식(환각 억제 포함), 코드, 도구 사용, 긴 컨텍스트입니다.
전문가를 따로 기르는 이유는 명확합니다. 하나의 모델에 여러 목표를 동시에 밀어 넣으면 서로 관련 없는 목적 함수들이 같은 파라미터를 두고 경쟁하며 갱신을 상쇄시킵니다. 도메인별로 분리하면 각 전문가가 자기 영역의 데이터와 보상만 보고 깊게 최적화할 수 있습니다.
MOPD: 학생이 자기 정책으로 굴러가며 전문가에게 배운다
다음 단계인 다중 도메인 온폴리시 증류(Multi-Domain On-Policy Distillation, MOPD) 는 이 전문가들을 교사로 삼아 그 능력을 다시 하나의 학생 모델로 모으는 과정입니다. 일반적인 오프폴리시(off-policy) 증류에서 학생은 다른 모델이 생성해 둔 궤적을 보고 배우지만, MOPD에서는 학생이 자기 정책으로 직접 롤아웃(rollout)을 만듭니다. 그리고 각 프롬프트는 해당 도메인을 담당하는 교사에게 라우팅되어, 그 교사가 학생의 응답을 토큰 단위로 지도합니다.
이 설계가 작동하는 이유는 앞에서 언급한 체크포인트 공유에 있습니다. 교사들이 학생과 동일한 SFT 체크포인트에서 갈라져 나왔으므로, 교사의 피드백이 학생의 분포에서 크게 벗어나지 않습니다. 학생이 도달할 수 없는 먼 분포에서 오는 신호로 학습을 흔들지 않으면서도 도메인별 능력을 주입할 수 있다는 것입니다. Liquid AI는 이 조밀하고 라우팅된 지도가 학생을 빠르게 수렴시킨다고 설명합니다.
에이전틱 RL: 실제 하네스 안에서 배우는 마지막 단계
마지막 단계는 모델이 실제 에이전트 환경 안에서 동작하는 법을 배우는 에이전틱 강화학습(Agentic Reinforcement Learning) 입니다. 다중턴 강화학습을 실제 에이전트 하네스 안에서 진행하는데, 이때 모델이 수행하는 과제는 자료를 조사하고, 글을 쓰고, 코드를 작성하고, 데이터를 분석하고, 문서를 관리하고, 외부 도구를 쓰고, 여러 단계의 워크플로우를 자동화하는 현실적인 업무들입니다.
학습 루프는 과제를 하나 뽑고 거기에 대응하는 하네스를 무작위로 고르는 방식으로 돌아갑니다. 각 롤아웃은 자체 런타임을 가진 전용 샌드박스에서 실행되며, 최적화는 GRPO로 수행합니다. 보상은 결과 기반(outcome-based)으로, LLM을 심판으로 쓰는 루브릭과 프로그램적 검사, 그리고 통과하지 못하면 곧바로 걸러내는 안전 게이트를 결합했습니다.
이 단계의 실질적 의미는 Hermes Agent와 OpenClaw 같은 실제 하네스 안에서 직접 학습했다는 점입니다. 모델이 그 하네스들의 도구 정의, 시스템 프롬프트, 상호작용 패턴에 미리 노출되기 때문에, 사용자가 같은 하네스에 붙였을 때 처음부터 안정적으로 동작할 가능성이 높아집니다. 소형 모델을 에이전트 하네스에 붙였을 때 흔히 겪는 문제가 "행동을 실제로 호출하지 않고 말로 설명하고 끝내는" 것인데, 이 학습 방식은 정확히 그 실패 모드를 겨냥합니다.
하네스를 블랙박스로 두고 학습하는 인프라
에이전틱 RL은 개념보다 구현이 어렵습니다. 학습 중에 실제 에이전트 하네스를 돌려야 하고, 그 하네스가 만들어 내는 토큰 단위 궤적을 손실 계산에 쓸 수 있는 형태로 되살려야 하기 때문입니다. Liquid AI가 공개한 인프라 구성도는 이 문제를 어떻게 갈랐는지 보여줍니다.
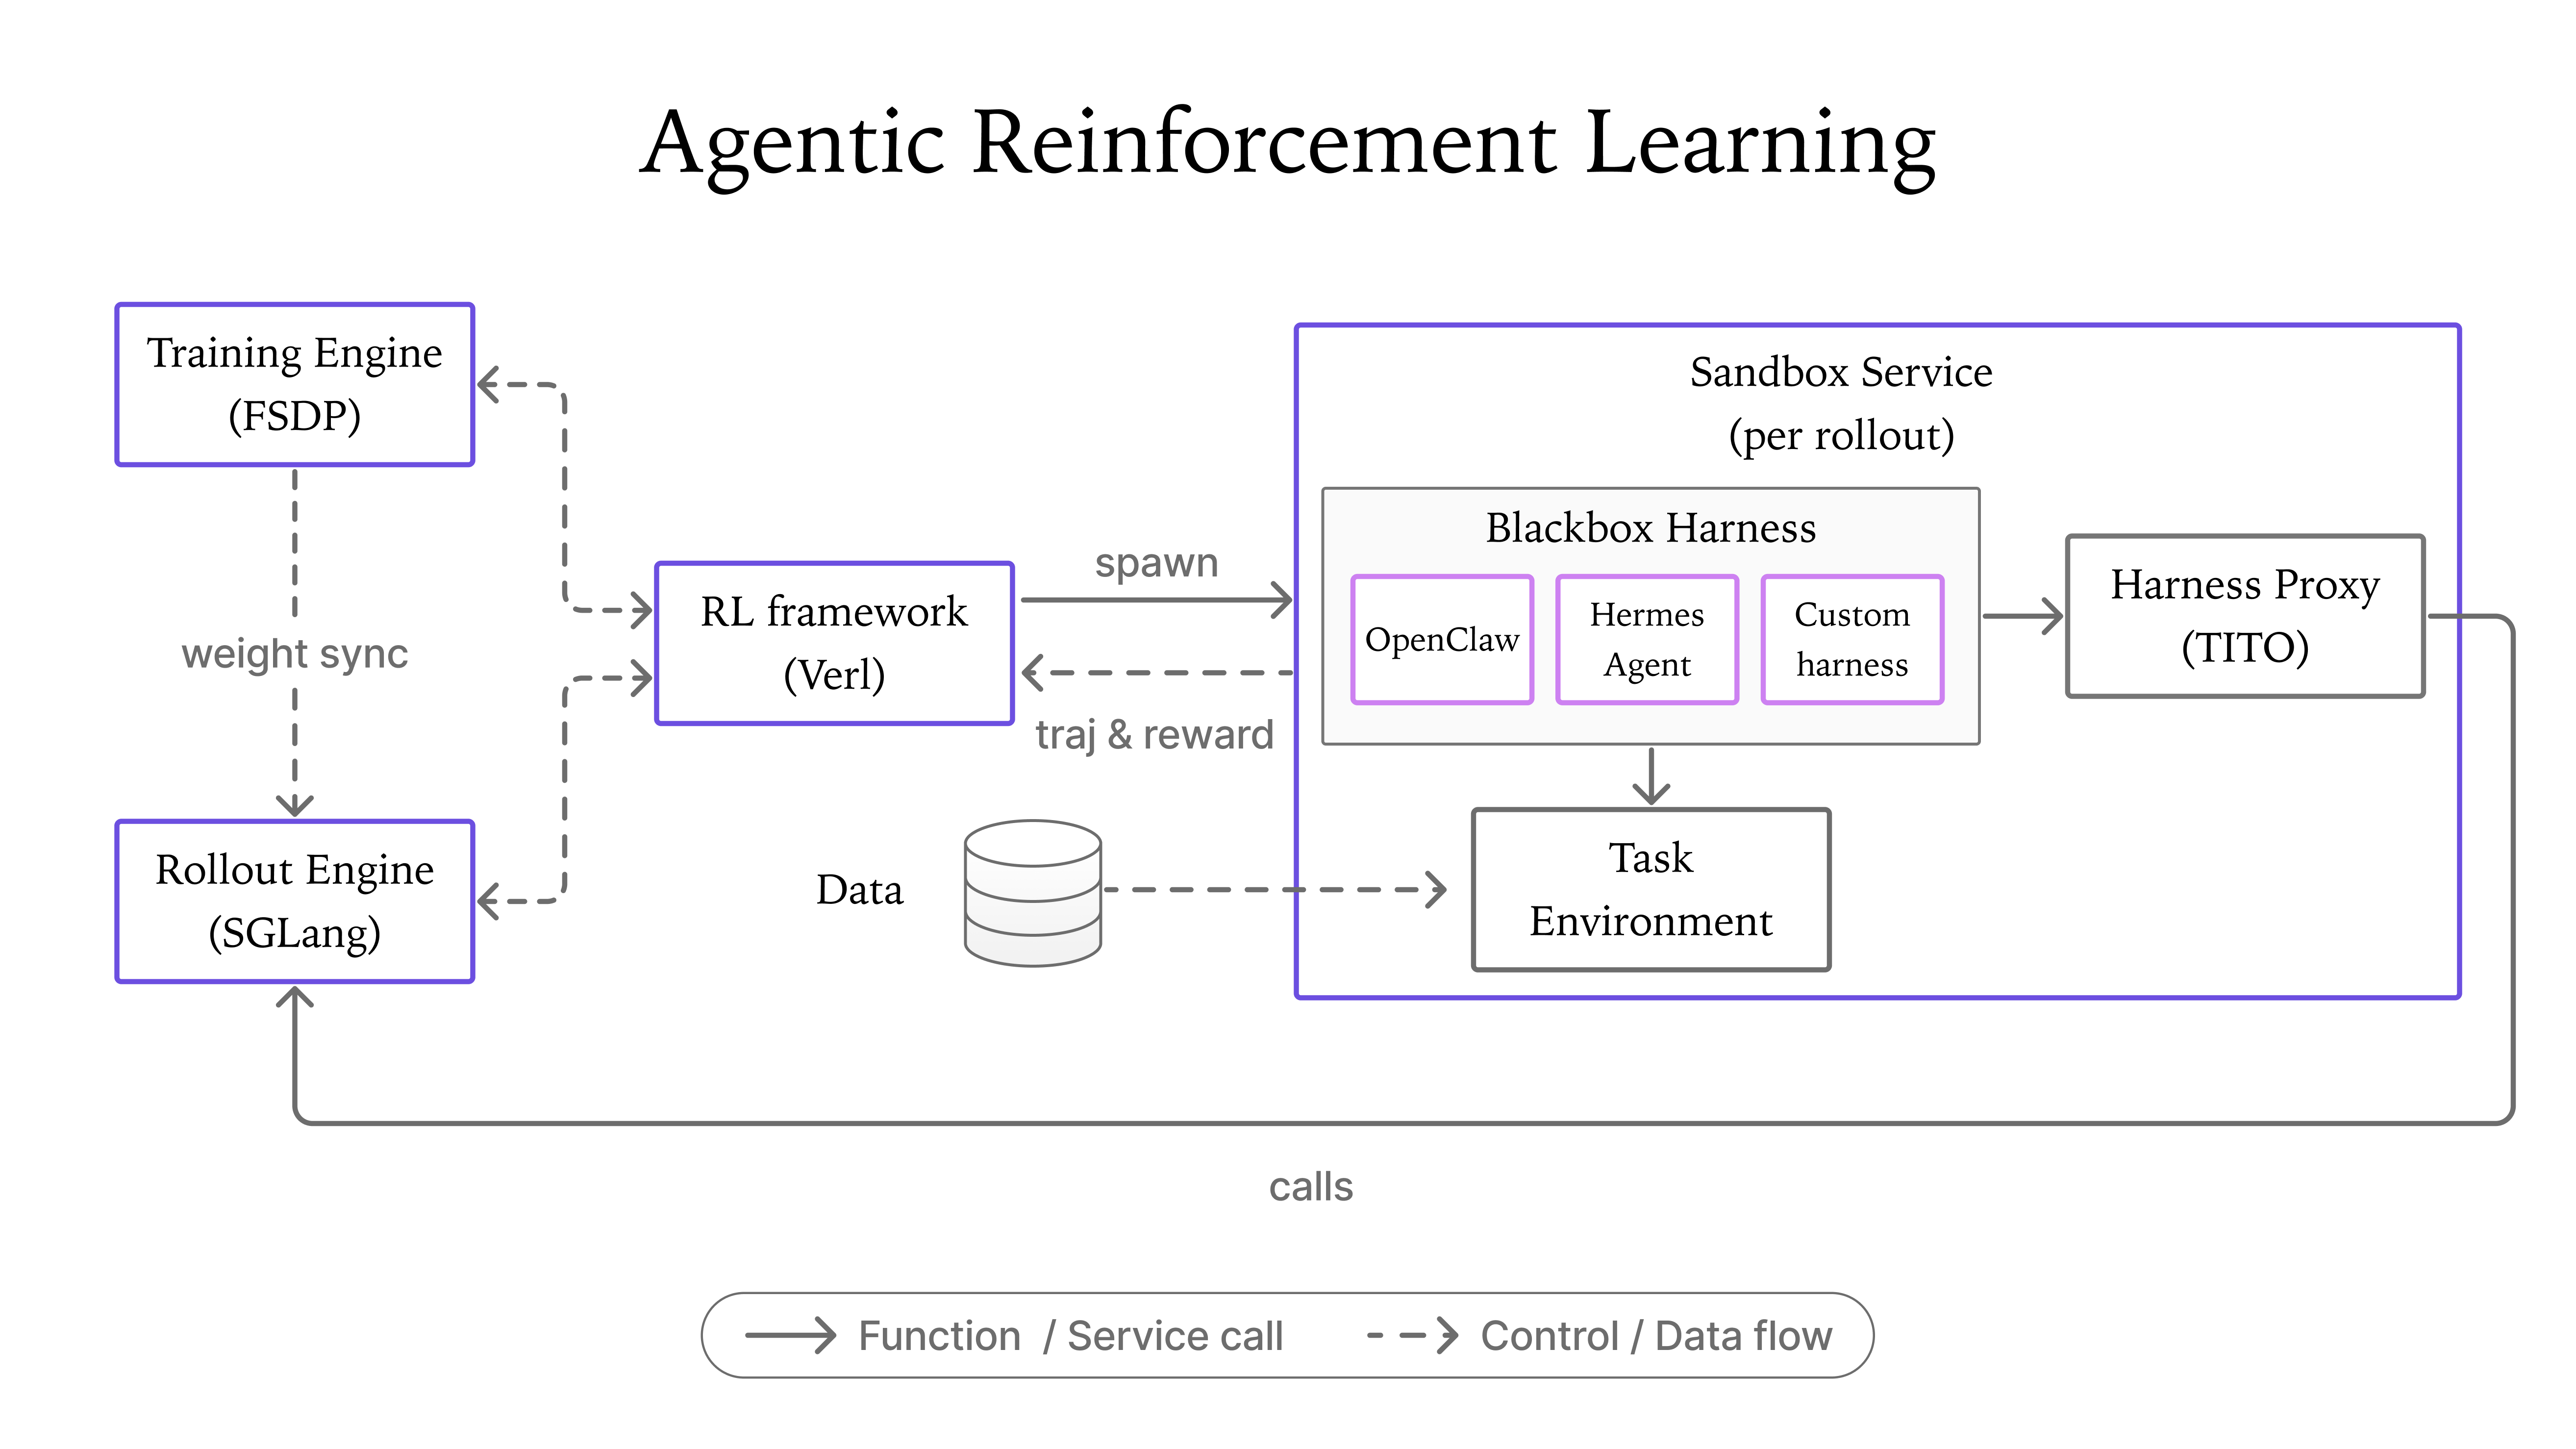
파이프라인은 모델 최적화, 추론, 환경 실행을 서로 다른 컴포넌트로 분리합니다. 학습 엔진(Training Engine) 은 FSDP로 모델을 최적화하고, 롤아웃 엔진(Rollout Engine) 은 SGLang으로 최신 정책에 따라 행동을 생성합니다. 그 사이에서 강화학습 프레임워크 인 verl이 롤아웃을 띄우고 궤적과 보상을 모아 모델을 갱신하는 학습 루프를 지휘합니다.
행동은 샌드박스 서비스(Sandbox Service) 안에서 실행됩니다. 그 안의 블랙박스 하네스(Blackbox Harness) 가 실제 에이전트를 호스팅하는데, 구성도에는 OpenClaw와 Hermes Agent, 그리고 직접 만든 커스텀 하네스가 나란히 들어가 있습니다. 하네스는 도구 호출과 코드 실행 같은 작업으로 과제 환경(Task Environment)과 상호작용합니다.
이 구조에서 가장 흥미로운 부분은 하네스 프록시(Harness Proxy) 입니다. 구성도에 TITO라는 이름이 붙은 이 컴포넌트 덕분에, 에이전트 하네스를 한 줄도 수정하지 않고 블랙박스 그대로 쓰면서 강화학습 샘플을 재구성하고 검증하는 데 필요한 토큰 단위 궤적을 투명하게 포착할 수 있습니다. 하네스마다 학습용 포크를 따로 관리하지 않아도 된다는 뜻이므로, 새 하네스를 학습 대상에 추가하는 비용이 크게 줄어듭니다. 여기에는 궤적의 선형 일관성 검사, 토큰 불일치 검사, 그리고 롤아웃 라우팅 재생(Rollout Routing Replay, R3)이 포함됩니다.
2.6B가 9.7B와 겨루는 벤치마크 결과
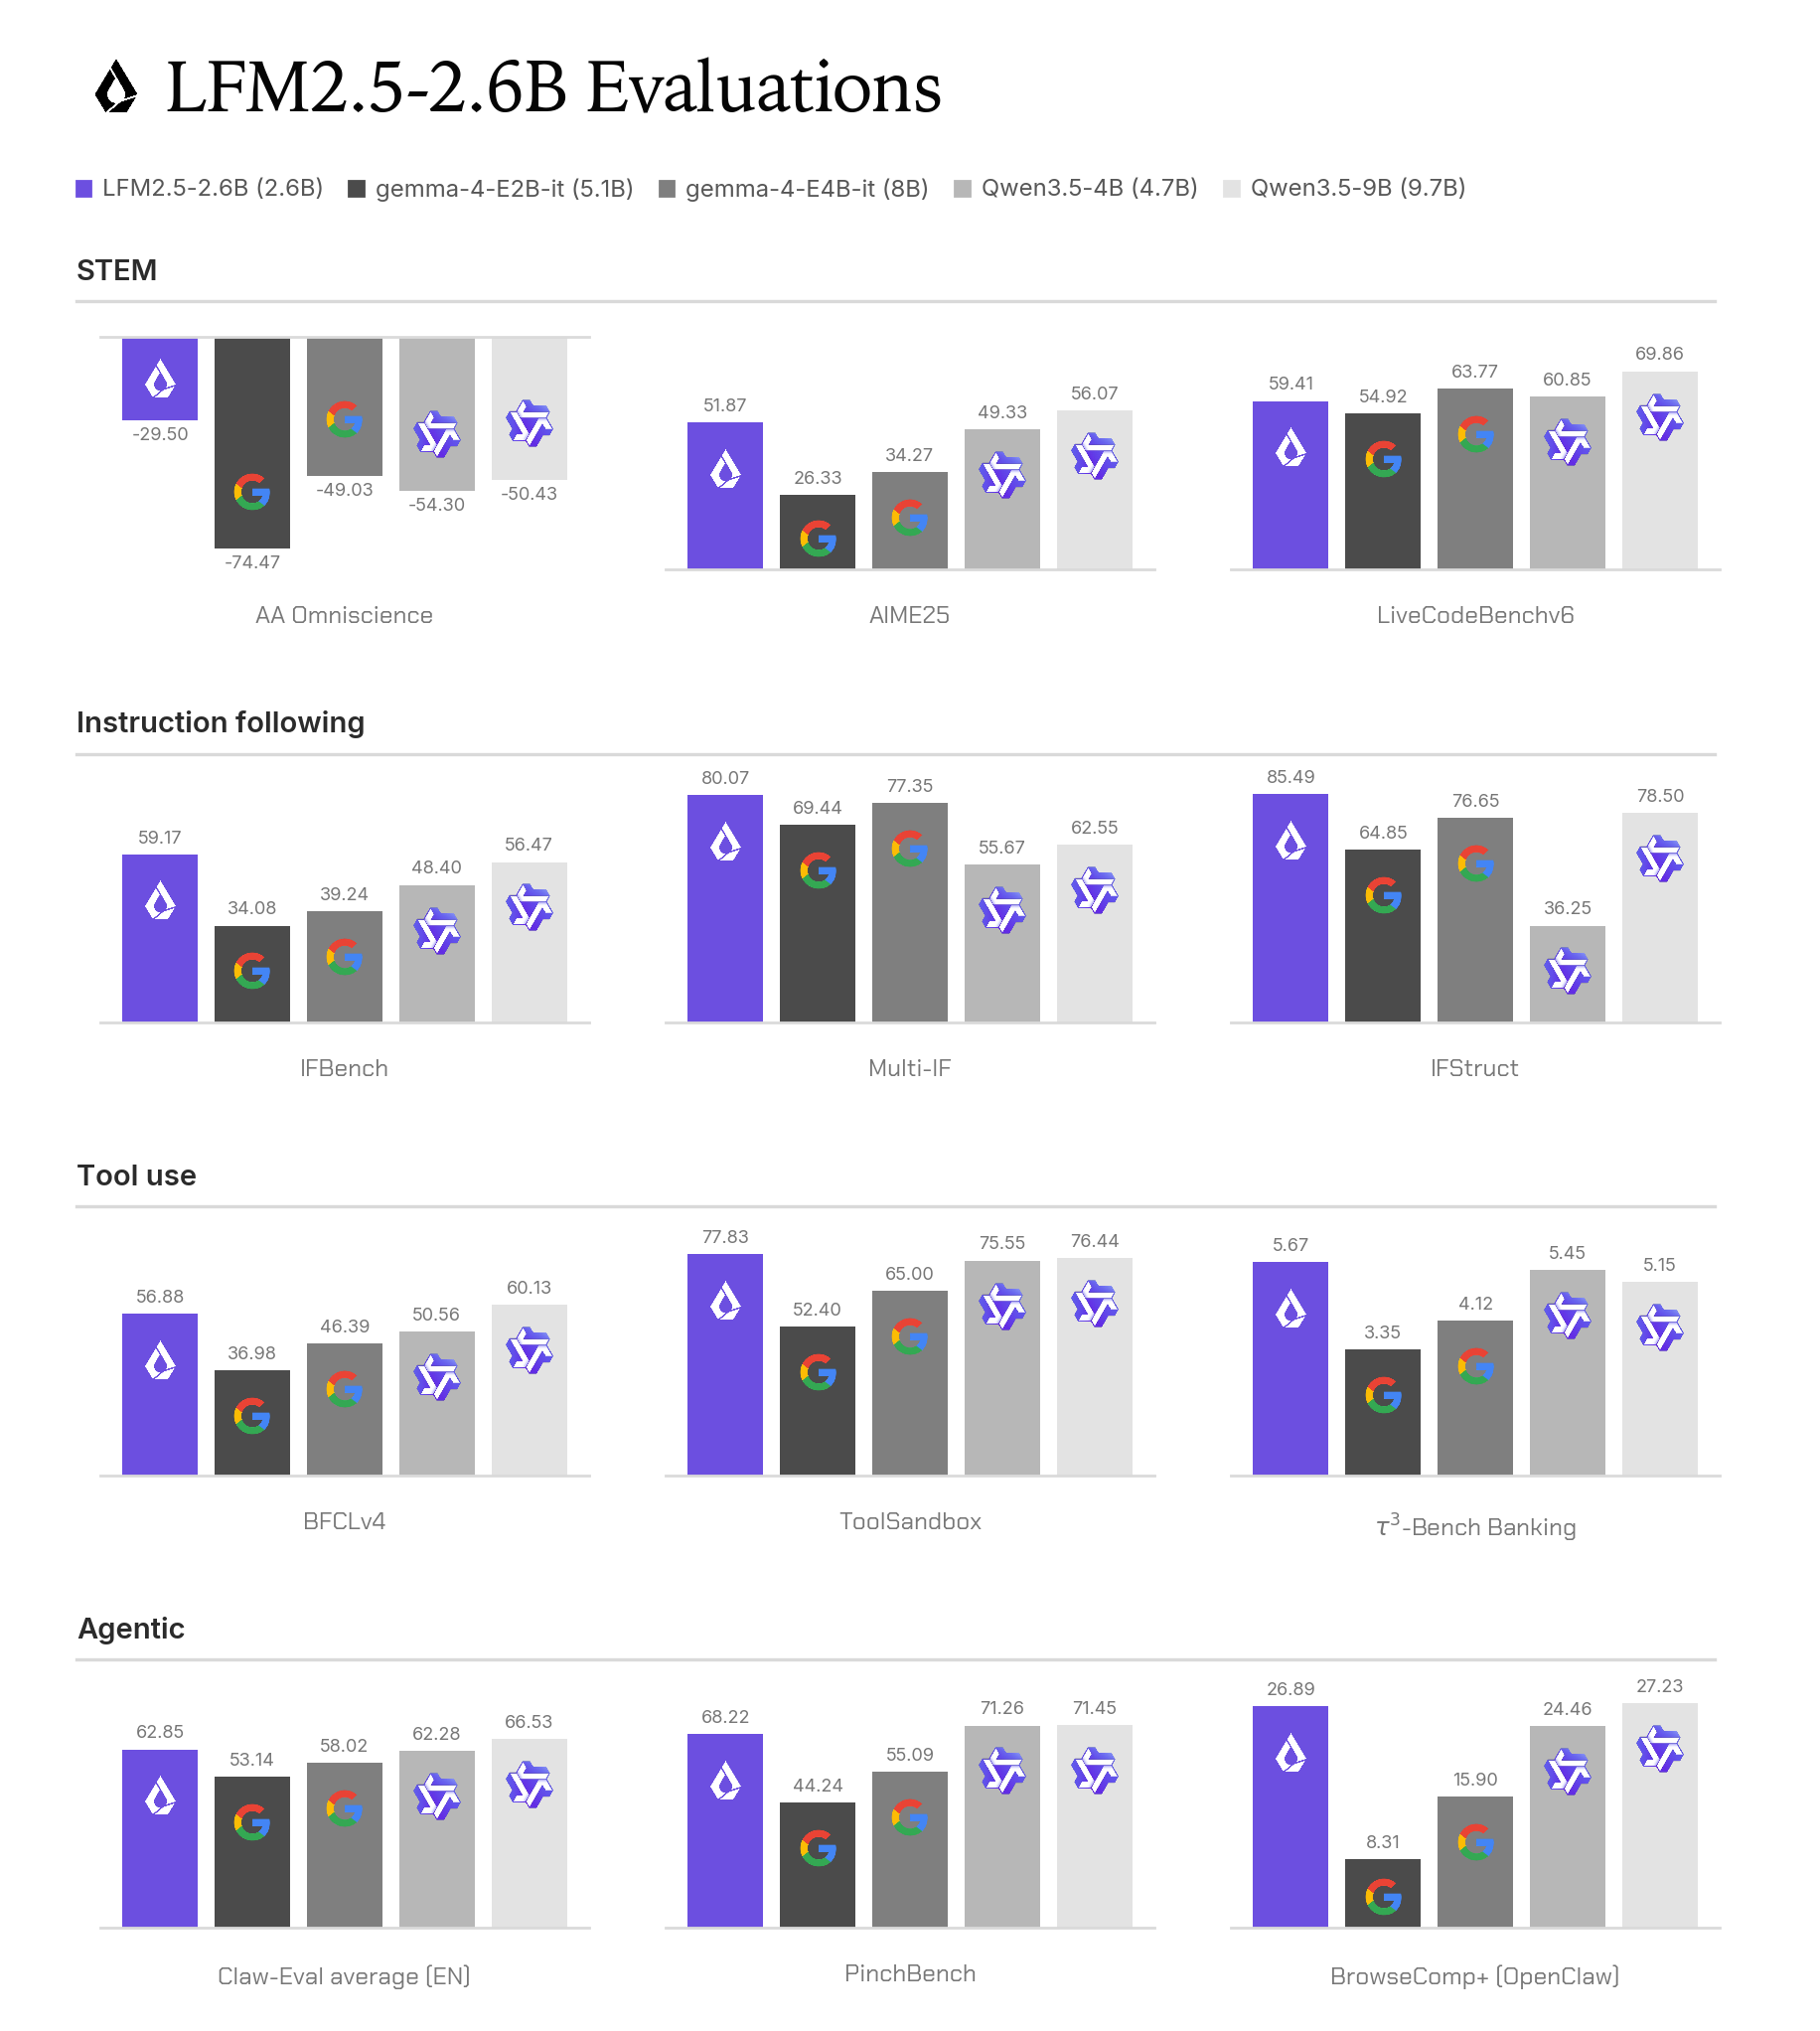
Liquid AI는 STEM, 지시 따르기, 도구 사용, 에이전트 워크플로우의 네 축으로 10B 미만 모델들과 비교했습니다. 비교 대상 중 가장 작은 모델이면서 자기보다 최대 네 배 가까이 큰 모델들과 겨룬다는 것이 결과의 요지입니다.
| 벤치마크 | LFM2.5-2.6B (2.6B) | gemma-4-E2B-it (5.1B) | gemma-4-E4B-it (8B) | Qwen3.5-4B (4.7B) | Qwen3.5-9B (9.7B) |
|---|---|---|---|---|---|
| AA Omniscience | -29.50 | -74.47 | -49.03 | -54.30 | -50.43 |
| AIME25 | 51.87 | 26.33 | 34.27 | 49.33 | 56.07 |
| LiveCodeBenchv6 | 59.41 | 54.92 | 63.77 | 60.85 | 69.86 |
| IFBench | 59.17 | 34.08 | 39.24 | 48.40 | 56.47 |
| Multi-IF | 80.07 | 69.44 | 77.35 | 55.67 | 62.55 |
| IFStruct | 85.49 | 64.85 | 76.65 | 36.25 | 78.50 |
| BFCLv4 | 56.88 | 36.98 | 46.39 | 50.56 | 60.13 |
| ToolSandbox | 77.83 | 52.40 | 65.00 | 75.55 | 76.44 |
| τ³-Bench Banking | 5.67 | 3.35 | 4.12 | 5.45 | 5.15 |
| Claw-Eval average (EN) | 62.85 | 53.14 | 58.02 | 62.28 | 66.53 |
| PinchBench | 68.22 | 44.24 | 55.09 | 71.26 | 71.45 |
| BrowseComp+ (OpenClaw) | 26.89 | 8.31 | 15.90 | 24.46 | 27.23 |
위 표에서 세 가지를 읽을 수 있습니다.
첫째, 지시 따르기에서는 모든 벤치마크를 앞섭니다. IFBench 59.17, Multi-IF 80.07, IFStruct 85.49로 9.7B 모델까지 포함해 1위입니다. 특히 IFStruct에서 Qwen3.5-4B가 36.25에 그친 것과 비교하면 격차가 큽니다. 구조화된 출력을 안정적으로 뽑아내는 능력은 에이전트 파이프라인에서 파싱 실패를 줄이는 데 직결되므로, 실용적으로 가장 값이 나가는 항목입니다.
둘째, 도구 사용에서도 거의 모든 항목을 앞서고 BFCLv4에서만 Qwen3.5-9B에 뒤집니다. ToolSandbox 77.83은 9.7B 모델보다 높고, BFCLv4 56.88은 60.13에 못 미치지만 4.7B 모델(50.56)보다는 앞섭니다. 에이전트 항목에서는 두 Gemma 모델을 전부 앞서고 Qwen 모델들과는 엎치락뒤치락합니다. BrowseComp+ 26.89는 9.7B 모델의 27.23에 거의 붙었습니다.
셋째, 약점은 코딩입니다. LiveCodeBenchv6에서 59.41로, 8B 모델(63.77)과 9.7B 모델(69.86)에 분명히 밀립니다. Liquid AI 스스로도 코딩은 큰 모델이 여전히 우위인 영역이라고 인정하고, 모델 카드에서 아예 "에이전트형 코딩과 지식 집약적 작업에는 권장하지 않는다" 고 명시합니다.
STEM 쪽에서는 AA Omniscience가 눈에 띕니다. Artificial Analysis의 이 지표는 정답에 점수를 주고 환각에는 벌점을 주되 "모른다" 며 답을 거절하는 것에는 벌점을 주지 않으며, 범위는 -100에서 100까지입니다. 0점이 정답과 오답이 같은 수라는 뜻이므로 음수는 오답이 정답보다 많다는 의미이고, 비교 대상 모델 전부가 음수라는 것은 이 크기대의 모델들이 아직 아는 것보다 틀리는 것이 많다는 뜻입니다. 그 안에서 LFM2.5-2.6B의 -29.50은 두 번째로 좋은 -49.03과도 상당한 차이가 있습니다. 사후학습에서 환각 억제를 담당하는 전문가 교사를 따로 둔 결과로 보입니다. 수학(AIME25 51.87)은 9.7B 모델에만 뒤집니다.
한 가지 주의할 점은 τ³-Bench Banking의 절대 점수가 모든 모델에서 5점 안팎으로 매우 낮다는 것입니다. 이 항목에서 1위라는 사실은 상대적 우위를 말해 주지만, 해당 과제를 실용적으로 수행할 수 있다는 뜻은 아닙니다. 벤치마크 조건은 모델별로 다르게 설정되었는데, 예컨대 BFCLv4는 temperature 0.001에 최대 출력 4,096 토큰, ToolSandbox는 temperature 0에 1,024 토큰, PinchBench는 temperature 0.6에 8,192 토큰이며, Qwen 모델은 그리디 디코딩에서 같은 답을 반복하는 현상 때문에 권장 설정인 temperature 0.6을 사용했다고 밝혔습니다.
CPU에서 초당 220 토큰, 휴대폰에서 30 토큰
벤치마크 점수보다 온디바이스 배포에서 더 중요한 것은 실제 기기에서의 속도와 메모리입니다. Liquid AI는 Q4_K_M 양자화(quantization)와 4K 토큰 입력 컨텍스트 조건으로 세 종류의 CPU에서 측정했습니다.
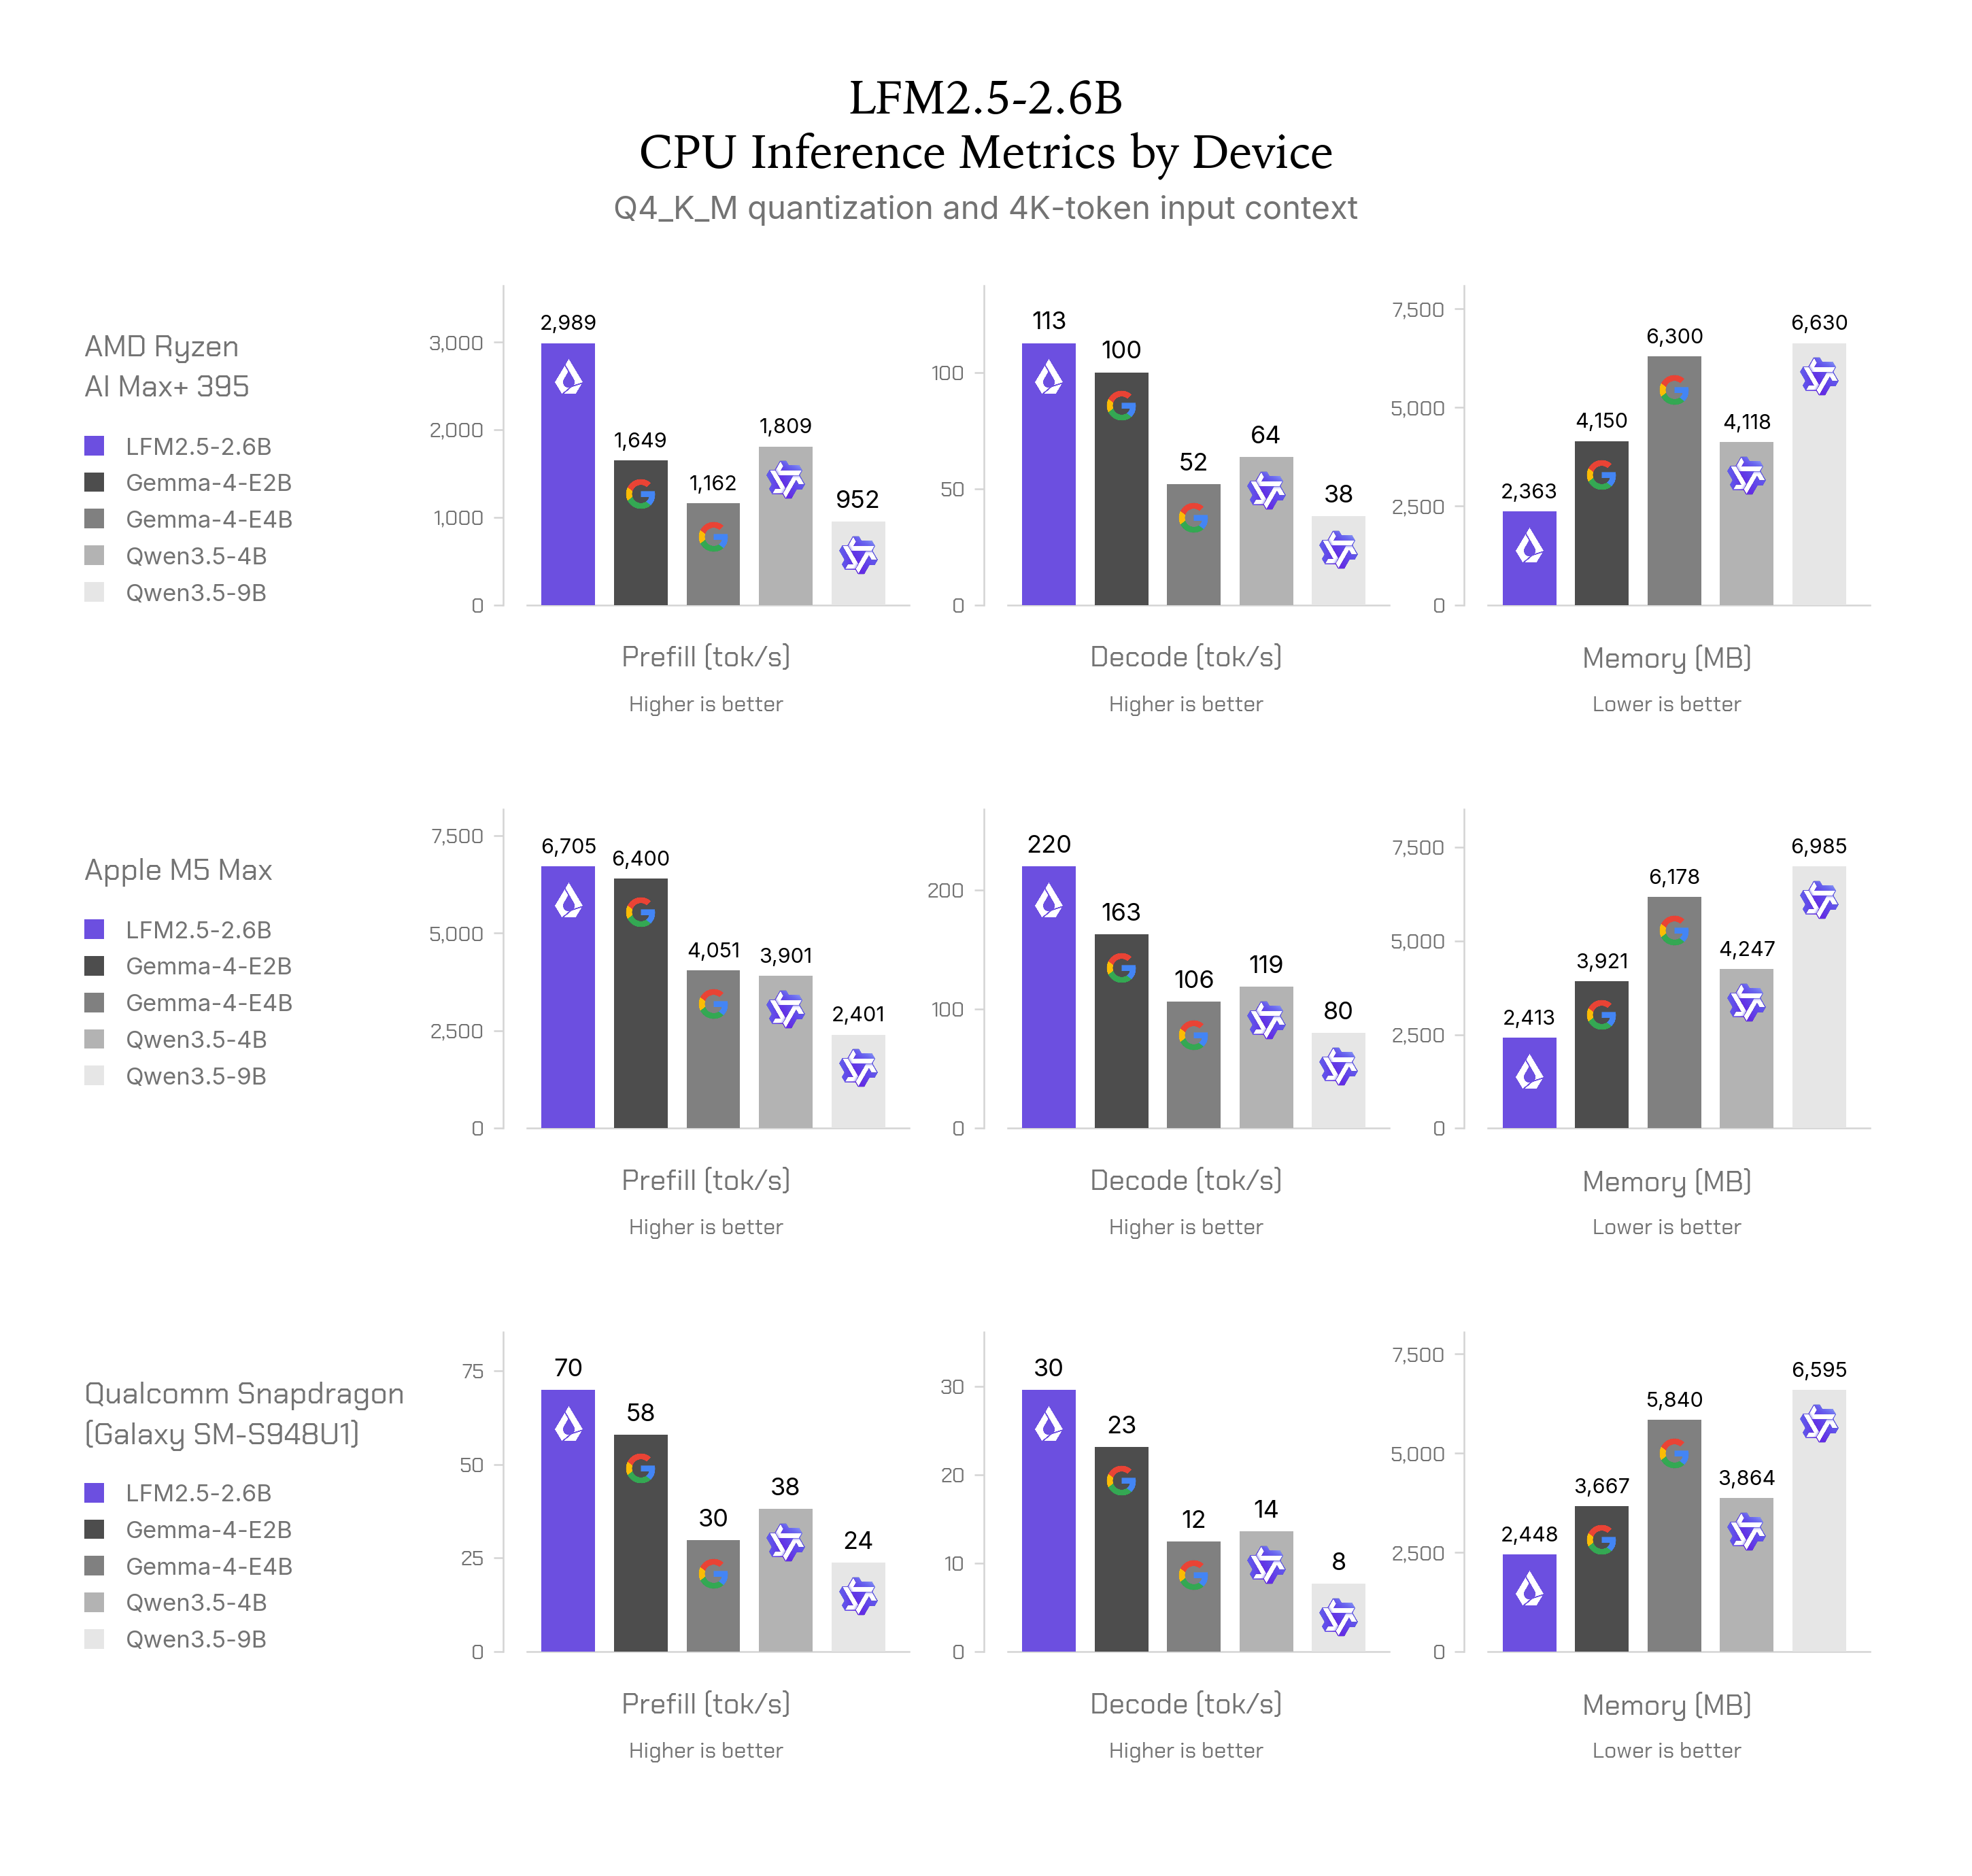
| 기기 | 프리필 (tok/s) | 디코드 (tok/s) | 메모리 (MB) |
|---|---|---|---|
| Apple M5 Max | 6,705 | 220 | 2,413 |
| AMD Ryzen AI Max+ 395 | 2,989 | 113 | 2,363 |
| Qualcomm Snapdragon (Galaxy SM-S948U1) | 70 | 30 | 2,448 |
세 기기 모두에서 프리필과 디코드가 비교 모델 중 가장 빠르고, 메모리는 가장 적게 씁니다. 메모리 항목이 특히 극적인데, 어떤 기기에서도 2.5GB를 넘지 않는 반면 Qwen3.5-9B는 6.6~7.0GB, gemma-4-E4B-it는 5.8~6.3GB를 씁니다. 8GB 램을 가진 보급형 기기에서 실행 가능 여부를 가르는 차이입니다.
같은 기기에서 다른 모델과 비교하면 격차가 더 뚜렷합니다. AMD Ryzen AI Max+ 395에서 디코드 속도는 LFM2.5-2.6B가 113 tok/s인데 Qwen3.5-4B는 64 tok/s, Qwen3.5-9B는 38 tok/s입니다. Apple M5 Max에서는 220 tok/s 대 119 tok/s 대 80 tok/s입니다. 프리필은 격차가 더 벌어져, M5 Max에서 6,705 tok/s와 2,401 tok/s의 차이가 납니다. 프리필이 빠르다는 것은 긴 도구 호출 기록을 다시 읽어들이는 에이전트 루프에서 대기 시간이 짧다는 뜻이므로, 실사용 체감에 직접 영향을 줍니다.
스냅드래곤 기기의 디코드 30 tok/s는 사람이 읽는 속도를 넘어서는 수준이라 대화형 응답에는 여유가 있습니다. 다만 프리필 70 tok/s는 다르게 읽어야 합니다. 4K 토큰을 처음부터 다시 읽히면 1분 가까이 걸린다는 뜻이므로, 휴대폰에서 에이전트를 돌릴 때는 긴 이력을 매 턴 새로 넣지 않고 KV 캐시를 재사용하거나 컨텍스트를 적극적으로 줄이는 설계가 필요합니다. 참고로 이 수치는 모두 CPU만 사용한 측정이며, NPU나 GPU 백엔드를 쓰면 달라집니다.
H100 한 장으로 하루 13억 토큰
온디바이스가 주 무대이지만 서버에서 대량 처리하는 경우도 측정되었습니다. NVIDIA H100 SXM5 한 장에서 SGLang 0.5.16, BF16, 입력 1,024 토큰과 출력 최대 256 토큰 조건으로, 각 동시성(concurrency) 수준에서 목표 개수의 요청을 계속 유지하며 완료된 요청을 즉시 새 요청으로 대체하는 지속 부하 방식으로 측정했습니다. 동시성 수준마다 3회 실행을 평균했습니다.
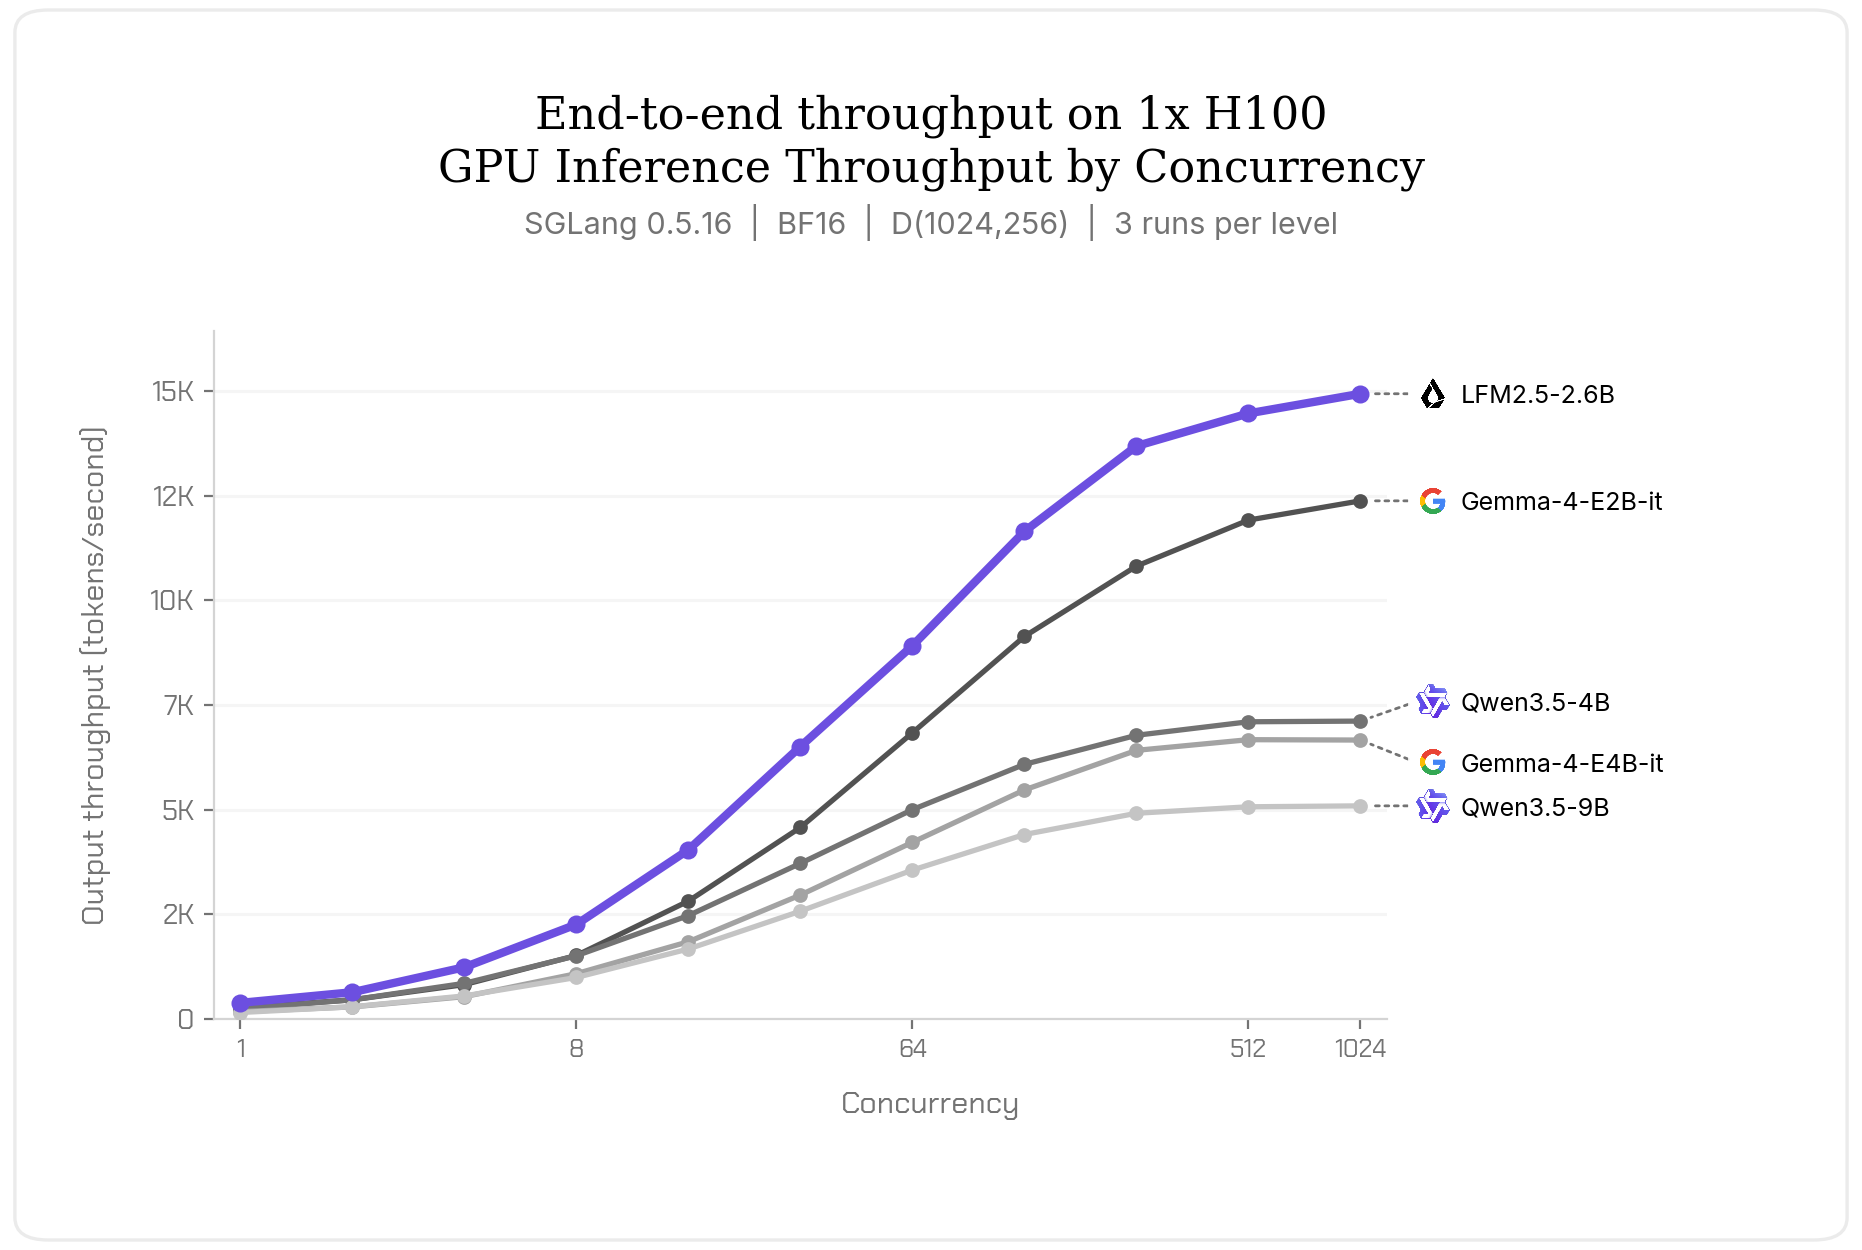
결과는 동시성 1,024에서 초당 약 15,000 출력 토큰으로, 하루로 환산하면 단일 H100에서 약 13억 토큰입니다. 같은 조건에서 gemma-4-E2B-it는 약 12,000, Qwen3.5-4B와 gemma-4-E4B-it는 약 6,500~6,700, Qwen3.5-9B는 약 5,100에 머무릅니다. 대량 데이터 추출이나 문서 분류처럼 같은 작업을 반복해 돌리는 배치 파이프라인에서는 이 처리량 차이가 곧 비용 차이가 됩니다.
온디바이스로 배포하는 경로: 로컬 서버부터 브라우저까지
LFM2.5-2.6B는 출시 첫날부터 주요 추론 엔진을 지원합니다. llama.cpp용 GGUF 체크포인트, Apple Silicon용 MLX, GPU 서빙용 vLLM과 SGLang, 그리고 다양한 가속기를 아우르는 ONNX가 모두 준비되어 있습니다. LM Studio는 모델 카탈로그에서 바로 검색해 내려받을 수 있고, Ollama 역시 hf.co/LiquidAI/LFM2.5-2.6B-GGUF 형태로 GGUF를 그대로 불러오는 방식이 공식 문서에 정리되어 있습니다.
양자화와 컨텍스트 길이를 먼저 정하기
배포 전에 결정할 것은 양자화 수준과 컨텍스트 길이 두 가지입니다. 둘 다 메모리를 품질 또는 용량과 맞바꾸는 선택이므로 하드웨어에 맞춰 고르면 됩니다. GGUF 계열은 다음 선택지가 제공됩니다.
| 양자화 | 크기 | 설명 |
|---|---|---|
Q4_K_M |
1.67 GB | 크기와 품질의 균형 (공식 권장 출발점) |
Q6_K |
2.22 GB | 품질 개선 |
Q8_0 |
2.87 GB | 거의 무손실. 도구 호출이 많은 에이전트 작업에 안전한 선택 |
BF16 |
5.4 GB | 전체 정밀도. 최대 충실도와 벤치마크 용도 |
MLX 저장소에는 4bit, 5bit, 6bit, 8bit 빌드가 별도 디렉터리로 들어 있고, vLLM과 SGLang은 GPU에서 전체 정밀도 가중치를 그대로 돌립니다. 컨텍스트는 128K까지 지원하지만 에이전트는 컨텍스트를 빠르게 소모하므로, 메모리에 여유가 없으면 단일 에이전트 작업에 보통 충분한 32K 정도로 줄여 서빙하는 것이 공식 문서의 권고입니다.
llama.cpp로 서버를 띄우고 하네스를 붙이기
로컬 에이전트를 구성하는 절차는 두 단계입니다. 먼저 모델을 OpenAI 호환 엔드포인트 뒤에 세우고, 그다음 에이전트 하네스가 그 엔드포인트를 가리키게 하면 됩니다. llama.cpp의 경우 -hf 플래그가 GGUF를 자동으로 내려받습니다.
llama-server -hf LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M \
  --jinja \
  --port 8080 \
  -c 131072 \
  -fa on \
  -ngl 99 \
  --temp 0.1 \
  --top-k 50 \
  --repeat-penalty 1.1
여기서 가장 중요한 플래그는 --jinja입니다. 모델의 채팅 템플릿을 사용해 도구 호출을 활성화 하는 스위치이므로, 이것을 빼면 에이전트가 도구를 호출하지 못합니다. -c 131072는 128K 컨텍스트, -fa on은 플래시 어텐션(Metal 또는 CUDA 빌드 필요), -ngl 99는 모든 층을 GPU에 올리라는 뜻입니다.
GPU 서버에서는 도구 호출 파서를 명시적으로 지정해야 합니다. vLLM과 SGLang 모두 lfm2 파서를 지정합니다.
# vLLM: serves at http://localhost:8000/v1
vllm serve LiquidAI/LFM2.5-2.6B \
  --enable-auto-tool-choice \
  --tool-call-parser lfm2

# SGLang: serves at http://localhost:30000/v1
sglang serve \
  --model-path LiquidAI/LFM2.5-2.6B \
  --host 0.0.0.0 \
  --port 30000 \
  --tool-call-parser lfm2
백엔드마다 기본 포트가 다른 점도 유의해야 합니다. llama.cpp와 MLX는 8080, vLLM은 8000, SGLang은 30000, LM Studio는 1234를 씁니다. Apple Silicon에서는 pip install mlx-lm 후 mlx_lm.server --model LiquidAI/LFM2.5-2.6B-MLX --port 8080으로 OpenAI 호환 엔드포인트를 열 수 있으며, 이때 설치된 mlx-lm 버전이 도구 정의를 채팅 템플릿으로 넘겨주는지 확인하라는 안내가 붙어 있습니다.
Hermes Agent, OpenClaw, Pi 연결하기
서버가 떴으면 하네스를 붙입니다. 공식 가이드는 Hermes Agent, OpenClaw, Pi 세 가지를 다루며, 모두 커스텀 OpenAI 호환 제공자로 등록하는 같은 방식입니다.
# Hermes Agent
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-2.6B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
마지막 줄의 agent.tool_use_enforcement는 꼭 켜라고 문서가 강조하는 설정입니다. 이 옵션 없이는 모델이 도구를 호출하는 대신 행동을 말로 설명하고 끝내는 경향 이 있다고 명시되어 있습니다. 앞서 본 에이전틱 RL이 겨냥한 실패 모드가 여전히 완전히 사라지지는 않았다는 뜻이므로, 로컬 에이전트를 구성할 때 반드시 확인할 지점입니다.
OpenClaw는 models.providers 아래에 커스텀 제공자를 JSON5로 추가하고, 비용을 전부 0으로 적어 두면 됩니다.
{
  models: {
    mode: "merge",
    providers: {
      local: {
        baseUrl: "http://localhost:8080/v1",
        apiKey: "sk-local",          // a local marker is accepted for loopback
        api: "openai-completions",
        models: [
          {
            id: "LFM2.5-2.6B",
            name: "LFM2.5-2.6B",
            input: ["text"],
            contextWindow: 131072,
            maxTokens: 8192,
            cost: { input: 0, output: 0, cacheRead: 0, cacheWrite: 0 },
          },
        ],
      },
    },
  },
}
Pi는 ~/.pi/agent/models.json에 같은 형태로 등록하며, /model 명령을 실행하면 파일이 다시 읽히므로 재시작이 필요 없습니다. 로컬 서버는 키가 없어도 되므로 apiKey에는 아무 자리표시자를 넣으면 됩니다.
앱에 심는 경로: LEAP SDK와 예제 저장소
위 방식은 로컬 서버를 띄우는 개발자용 경로입니다. iOS나 안드로이드 앱 안에 모델을 심으려면 LEAP SDK를 씁니다. LEAP는 Liquid AI의 엣지 AI 플랫폼으로, leap.liquid.ai에서 모델을 찾아 기기에 배포하는 흐름을 제공하며 Liquid Inference Engine을 통해 인터넷 없이 추론을 돌립니다.
LeapSDK-Examples 저장소에는 플랫폼별 예제 앱이 정리되어 있습니다. iOS와 macOS는 Swift Package Manager 기반이고, 안드로이드는 Gradle 프로젝트이며, 웹은 Kotlin/Wasm으로 포팅되어 있습니다.
- iOS: 슬로건 생성기(
LeapSloganExample), 실시간 스트리밍 채팅(LeapChatExample), 오디오 처리와 전사(LeapAudioDemo), 시각 언어 모델 데모(LeapVLMExample), 누르고 말하는 음성 비서(LeapVoiceAssistantDemo), JSON 출력을 제약한 레시피 생성기(RecipeGenerator) - macOS: 시각 언어 모델 데모와 음성 비서의 macOS 버전
- Android: Jetpack Compose 슬로건 생성기(
SloganApp), 채팅 앱(LeapChat), 오디오 데모, 웹페이지 요약기(ShareAI), 레시피 생성기, VLM 데모, 그리고 Koog 프레임워크와 LeapSDK를 결합한 에이전트 데모(LeapKoogAgent) - Web: Compose for Web으로 포팅한 음성 비서(
./gradlew wasmJsBrowserDevelopmentRun으로 개발 서버 실행)
다만 한 가지 정확히 짚어 둘 점이 있습니다. 이 글을 쓰는 시점에서 LEAP 모델 카탈로그에는 LFM2.5-350M, LFM2.5-1.2B 계열, LFM2.5-VL, LFM2.5-Audio, 그리고 이전 세대인 LFM2-2.6B가 올라 있지만 LFM2.5-2.6B는 아직 보이지 않습니다. 즉 이번 모델을 앱에 심으려면 카탈로그에서 바로 고르는 대신 LEAP 번들링 서비스로 직접 번들을 만들거나, GGUF와 llama.cpp를 앱에 임베드하는 경로를 택해야 합니다. 순수 온디바이스 실행 자체는 GGUF, MLX, ONNX로 이미 가능하므로, LEAP 카탈로그 등재 여부는 앱 개발 편의성의 문제입니다. 안드로이드 SDK의 시작 방법은 SDK 퀵스타트 문서에 정리되어 있고, 함수 호출 문서는 LeapFunction으로 도구를 정의하는 방법을 다룹니다.
브라우저에서 돌려 보기
설치 없이 성능을 확인하고 싶다면 두 가지 방법이 있습니다. 하나는 Liquid Playground에서 바로 대화해 보는 것이고, 다른 하나는 브라우저 안에서 완전히 로컬로 도는 WebGPU 리서치 에이전트 데모입니다. 후자는 ONNX 빌드를 사용하며, 질문을 조사해 요약을 만들어 주는 에이전트를 브라우저 탭 안에서 돌립니다. ONNX 저장소에는 fp16, q4, q4f16, q8 변형이 함께 들어 있어 웹과 모바일, NPU 같은 다양한 런타임에 맞춰 고를 수 있습니다.
채팅 템플릿과 도구 호출 규약
로컬 에이전트를 직접 만들려면 이 모델의 입출력 규약을 알아야 합니다. LFM2.5는 ChatML에 가까운 형식을 쓰며, 자세한 내용은 채팅 템플릿 문서에 정리되어 있습니다.
<|startoftext|><|im_start|>system
You are a helpful assistant trained by Liquid AI.<|im_end|>
<|im_start|>user
What is C. elegans?<|im_end|>
<|im_start|>assistant
한 가지 중요한 특성은 LFM2.5-2.6B가 항상 답하기 전에 생각하는 순수 추론 모델 이라는 점입니다. 어시스턴트 응답을 시작할 때 채팅 템플릿이 <think> 태그를 직접 삽입하므로, 추론 과정을 끄고 쓰는 모드가 따로 없습니다. 응답 파싱을 직접 구현한다면 이 부분을 반드시 고려해야 합니다.
도구 호출은 네 단계로 이뤄지며, 자세한 규약은 도구 사용 문서에 있습니다. 시스템 프롬프트에 JSON 객체로 도구 목록을 넣거나 tokenizer.apply_chat_template()에 tools=...를 넘겨 도구를 정의하고, 모델이 호출을 생성하고, 실행 결과를 tool 역할로 돌려주면, 모델이 그 결과를 해석해 최종 답변을 만듭니다. 기본 출력 형식이 JSON이 아니라 파이썬 문법의 함수 호출 이라는 점이 특이합니다.
<|startoftext|><|im_start|>system
List of tools: [{"name": "get_candidate_status", "description": "Retrieves the current status of a candidate in the recruitment process", "parameters": {"type": "object", "properties": {"candidate_id": {"type": "string", "description": "Unique identifier for the candidate"}}, "required": ["candidate_id"]}}]<|im_end|>
<|im_start|>user
What is the current status of candidate ID 12345?<|im_end|>
<|im_start|>assistant
<|tool_call_start|>[get_candidate_status(candidate_id="12345")]<|tool_call_end|>Checking the current status of candidate ID 12345.<|im_end|>
<|im_start|>tool
[{"candidate_id": "12345", "status": "Interview Scheduled", "position": "Clinical Research Associate", "date": "2023-11-20"}]<|im_end|>
<|im_start|>assistant
The candidate with ID 12345 is currently in the "Interview Scheduled" stage for the position of Clinical Research Associate, with an interview date set for 2023-11-20.<|im_end|>
<|tool_call_start|>와 <|tool_call_end|> 사이에 파이썬 리스트 형태로 호출이 들어갑니다. JSON 형식을 원하면 시스템 프롬프트에서 그렇게 지시해 재정의할 수 있습니다. Transformers로 직접 돌리는 코드는 transformers>=5.0.0이 필요합니다.
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-2.6B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=512,
    streamer=streamer,
)
미세조정: Unsloth와 TRL 노트북
Liquid AI는 특정 용도에 맞춰 미세조정하는 것을 권장하며, 실행 가능한 Colab 노트북을 함께 제공합니다. 소형 모델을 좁은 작업에 특화시키는 것이 이 모델군의 원래 사용 패턴이라, 여기가 실제로 성능을 끌어낼 지점입니다.
| 기법 | 도구 | 용도 |
|---|---|---|
| CPT | Unsloth | 텍스트 완성용 계속 사전학습(Continued Pre-Training) |
| CPT | Unsloth | 번역 특화 계속 사전학습 |
| SFT (LoRA) | Unsloth | 지도 미세조정 |
| SFT (LoRA) | TRL | 지도 미세조정 |
| DPO (LoRA) | TRL | 직접 선호 최적화(Direct Preference Optimization) |
| GRPO (LoRA) | TRL | 검증 가능한 과제를 위한 GRPO |
노트북 링크는 모델 카드와 미세조정 문서에 정리되어 있고, GRPO 예제는 Liquid AI 쿡북 저장소에서 직접 볼 수 있습니다.
어디에 쓰고 어디에 쓰지 않아야 하는가
Liquid AI가 모델 카드에 명시한 권장 용도와 비권장 용도는 이 모델을 평가하는 데 가장 정직한 기준입니다.
권장되는 쪽은 에이전트 워크플로우, 도구 사용, 데이터 추출, RAG(검색 증강 생성), 그리고 긴 컨텍스트를 다루는 작업입니다. 여기에 앞서 본 처리량 수치를 겹쳐 보면 성격이 더 분명해집니다. 초당 15,000 토큰의 처리량과 2.5GB 미만의 메모리는 "같은 작업을 아주 많이 반복하는" 파이프라인에 최적화된 조합입니다. 대량 문서에서 필드를 뽑아내거나, 사내 지식베이스를 대상으로 하는 RAG 파이프라인의 생성 단계, 여러 에이전트를 동시에 띄우는 백그라운드 자동화 같은 곳입니다.
권장되지 않는 쪽은 에이전트형 코딩과 지식 집약적 작업 입니다. LiveCodeBenchv6 점수가 큰 모델에 밀리는 것이 코딩 쪽 근거이고, 지식 집약적 작업은 2.6B라는 크기 자체가 담을 수 있는 사실의 양을 제한한다는 근본적인 이유가 있습니다. AA Omniscience에서 동급 최고를 기록한 것은 "모르는 것을 아는 척하지 않는" 능력이 좋다는 뜻이지 지식의 양이 많다는 뜻이 아니므로, 두 지점을 혼동하지 않아야 합니다. Liquid AI 자신도 더 복잡한 에이전트 과제나 코딩 중심 작업에는 큰 모델이 여전히 나은 선택일 수 있다고 적었습니다.
실무적으로는 하이브리드 구성이 현실적인 답일 것입니다. LEAP SDK가 OpenAI 호환 클라이언트를 제공하며 이를 온디바이스와 클라우드를 섞어 라우팅하는 용도로 소개하는 것도 같은 맥락입니다. 반복적이고 구조화된 작업은 기기에서 공짜로 돌리고, 어려운 판단이 필요한 순간에만 큰 모델로 넘기는 방식입니다.
라이선스
LFM2.5-2.6B는 LFM Open License v1.0 으로 배포됩니다. 가중치를 내려받아 미세조정하고 재배포할 수 있는 개방형 라이선스이지만, 여기에는 짚어 둘 조건이 하나 있습니다.
라이선스 제5조는 상업적 이용에 대해 연간 매출 1,000만 달러 이상 이라는 기준선(Threshold)을 두고, 이 기준을 넘는 법인의 상업적 이용은 이 라이선스로 허용되지 않는다고 규정합니다. 501(c)(3)에 해당하는 비영리 단체가 비상업적 또는 연구 목적으로 쓰는 경우에는 이 기준선이 적용되지 않습니다. 연구와 개인 프로젝트, 그리고 매출 1,000만 달러 미만 조직의 상업적 이용까지는 자유롭지만, 그 이상 규모의 기업이 제품에 넣으려면 Liquid AI와 별도 협의가 필요하다는 뜻입니다.
Liquid AI의 블로그는 이 모델군을 "제약 없이 내려받고 미세조정하고 배포할 수 있다" 고 소개하는데, 실제 라이선스 문구는 위와 같은 매출 기준선을 포함하고 있으므로 Apache 2.0이나 MIT 같은 완전 허용형과 동일하게 취급하기는 어렵습니다. 도입을 검토한다면 라이선스 원문을 직접 확인하시기 바랍니다.
 LFM2.5-2.6B, Deploy Agents Everywhere 소개 블로그
 LFM2.5-2.6B 공식 문서
 LFM2.5-2.6B 모델 (Hugging Face)
 로컬 에이전트 하네스 연결 가이드
 LeapSDK-Examples 저장소
 LEAP, Liquid AI의 엣지 AI 플랫폼
 LFM2.5-2.6B WebGPU 리서치 에이전트 데모
 LFM2 기술 보고서
더 읽어보기
-
In-Place Tokenizer Expansion for Pre-trained LLMs 기술 보고서 (영문)
-
Liquid AI, 엣지용 350M 모델 LFM2.5와 다국어 검색 리트리버 LFM2.5 Retrievers 공개
-
Needle: Gemini 3.1을 증류해 만든 26M 파라미터 함수 호출 전용 온디바이스 모델 (feat. Cactus)
-
Cactus: 스마트폰, 웨어러블 기기 등에서의 On-Device AI를 위한 고성능 추론 엔진 및 커널 라이브러리
-
OpenClaw: 사용자의 로컬 환경에서 구동하고 다양한 방식으로 연동할 수 있는 오픈소스 AI 비서 프로젝트 (Clawdbot, Moltbot🦞에서 이름 변경)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글이 유용하셨다면 아래 쪽 좋아요
 를 눌러주세요 —
 파이토치 한국 사용자 모임
 이 새로운 소식을 정리하고 공유하는 데 힘이 됩니다!
