# NVIDIA VSS 3.3: 영상 AI 에이전트를 프롬프트로 조립하고, 변하지 않은 화면의 VLM 토큰은 줄이기 (feat. Adaptive EVS)
**URL:** https://discuss.pytorch.kr/t/nvidia-vss-3-3-ai-vlm-feat-adaptive-evs/12077
**Category:** 읽을거리&정보공유
**Tags:** vlm, agent-skills, cosmos, nvidia, agent, vss, efficient-video-sampling, video-analytics
**Created:** [10월 3, 2026, 9:30오전 UTC](https://discuss.pytorch.kr/t/nvidia-vss-3-3-ai-vlm-feat-adaptive-evs/12077 "2026-10-03T09:30:42Z")
**Posts on this page:** 1
**Page:** 1
### Author:  [@9bow](https://discuss.pytorch.kr/u/9bow)
#### Post date: [10월 3, 2026, 9:30오전 UTC](https://discuss.pytorch.kr/t/nvidia-vss-3-3-ai-vlm-feat-adaptive-evs/12077/1 "2026-10-03T09:30:42Z")
## 핵심 요약
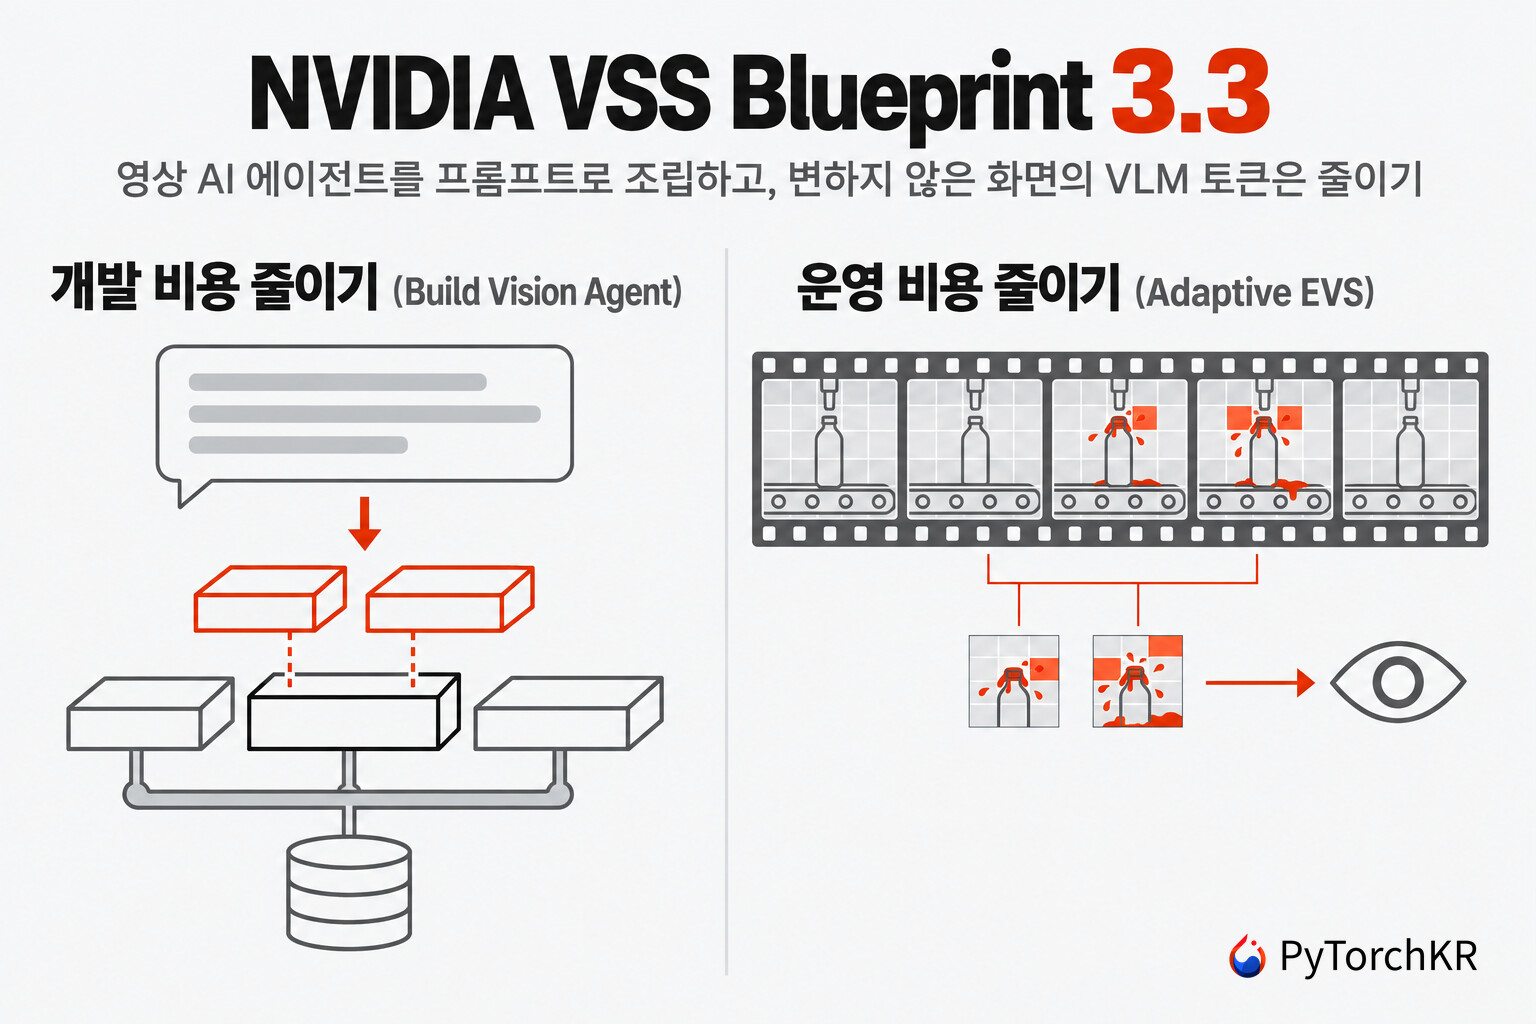
- NVIDIA가 영상 검색과 요약 블루프린트 VSS 3.3을 발표하며, 개발 비용을 줄이는 Build Vision Agent 스킬과 VLM 처리 비용을 줄이는 Adaptive EVS를 함께 소개했습니다.
- Build Vision Agent 스킬은 Claude Code나 Codex 같은 코딩 에이전트가 요청을 읽고, 검증된 4개 개발 프로필 중 하나를 바탕으로 필요한 서비스만 더하고 빼서 Docker Compose 배포를 만듭니다.
- Adaptive EVS는 이전 프레임과 비슷한 패치를 VLM 입력에서 빼며, NVIDIA 측정에서는 60분 영상 요약의 VLM 입력 토큰이 80% 줄고 동시 실시간 스트림 수가 13개에서 19개로 늘었습니다.
- 2026년 10월 1일 기준 GitHub 저장소의 정식 릴리스는 3.2.1이고, 3.3 스킬은 `3.3.0-rc0` 버전으로 기본 브랜치 `develop`에 있습니다. 컨테이너 이미지 기본값도 개발용 `develop-latest` 태그입니다.
## NVIDIA VSS Blueprint 3.3 소개
[NVIDIA Metropolis Blueprint for Video Search and Summarization(VSS)](https://build.nvidia.com/nvidia/video-search-and-summarization)는 실시간 카메라 스트림과 녹화 영상을 자연어로 검색하고, 질문에 답하고, 경보를 검증하고, 보고서를 만드는 **영상 AI 에이전트(Visual AI Agent)** 를 구성하기 위한 NVIDIA의 참조 아키텍처입니다. [NVIDIA Cosmos](https://www.nvidia.com/en-us/ai/cosmos/) 같은 **시각-언어 모델(Vision-Language Model, VLM)**, [NVIDIA Nemotron](https://www.nvidia.com/en-us/ai-data-science/foundation-models/nemotron/) 같은 LLM, 검색 증강 생성(RAG), 그리고 MCP(Model Context Protocol) 도구를 묶어 영상 데이터를 다룹니다. 저장소는 [Apache-2.0으로 공개](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization)되어 있고, 각 기능은 Docker Compose나 Helm으로 실행하는 마이크로서비스로 나뉘어 있습니다.
VLM 덕분에 영상을 "_이해_"하는 일 자체는 쉬워졌지만, 이를 운영 가능한 시스템으로 만드는 일은 여전히 어렵습니다. 이번 글의 저자들(NVIDIA의 Hassan Moustafa, Debraj Sinha, Ashwani Agarwal)은 실제 배포가 여러 워크플로우를 동시에 필요로 한다는 점에서 출발합니다. 스마트 시티라면 차량 검출, 충돌 경보, 사고 장면 검색, 시간별 요약, 운영자 보고서가 모두 필요하고, 물류 창고라면 사람과 지게차 추적, 아차사고 경보, 표준 작업 절차(SOP) 점검, 후속 질의응답이 필요합니다. 각 워크플로우는 따로도 쓸모가 있지만, 실제 가치는 이들이 함께 동작할 때 나옵니다.
원문은 여기서 생기는 비용을 세 가지로 정리합니다. 첫째는 **개발 비용** 으로, 마이크로서비스를 고르고 Kafka, Redis, Elasticsearch, 영상 입출력과 저장을 맡는 VIOS(Video IO and Storage) 같은 공유 서비스와 모델 엔드포인트, 환경 변수, API를 중복 없이 연결하는 일입니다. 둘째는 **운영 비용** 으로, 스트림과 프레임 구간, 프롬프트, 시각 토큰이 하나씩 늘 때마다 GPU 사용량과 대기열 지연, 요약 지연 시간이 커집니다. 셋째는 **변경 비용** 으로, 개념 검증(PoC)에서 운영 환경으로 옮기고 기능을 추가하면서 설정과 문서, 운영 절차를 맞춰 두는 일입니다.
VSS 3.3은 이 중 개발과 변경 비용은 **Build Vision Agent 스킬(`vss-build-vision-ai`)** 로, 운영 비용은 **Adaptive EVS(Adaptive Efficient Video Sampling)** 로 줄이겠다고 말합니다. 이 글에서는 두 기능이 각각 어떻게 동작하는지 살펴본 뒤, NVIDIA가 제시한 측정 조건과 함께 저장소 문서를 대조해 지금 따라 해 볼 때 확인할 점을 정리합니다.

위 애니메이션은 원문의 그림 1로, 창고 카메라용 에이전트를 만드는 요청 한 문장이 실행되는 과정을 보여줍니다. 요청 내용은 VLM으로 검증한 경보와 영상 아카이브 검색을 하나의 공유 파이프라인으로 묶고, 에이전트 UI 없이(headless) 구성하되 배포 전에 검증해 달라는 것입니다. 아키텍처가 제안되고(2단계), `search` 프로필을 바탕으로 서비스 2개를 더하고 3개를 뺀 구성이 검증된 뒤(3단계), 10개 서비스가 모두 실행됩니다(4단계). 마지막에는 사다리를 오르며 상자를 든 안전모 착용자를 찾은 결과를 VLM이 하나씩 확인하거나 기각하고, "_안전 위반인가?_"라는 질문에 추론 과정(reasoning trace)을 포함하여 함께 대답합니다.
[ ](https://www.youtube.com/watch?v=PQJKs1dyK7I)
## Build Vision Agent 스킬: 검증된 프로필 위에 가장 작은 차이만 더하기
### 에이전트 스킬로 VSS를 배포한다는 것
VSS는 이전 버전부터 배포, 카메라 설정, 요약, 검색, 경보, 분석 같은 개별 작업을 **에이전트 스킬(Agent Skills)** 로 제공해 왔습니다. 에이전트 스킬은 `SKILL.md` 파일에 작업 절차와 참고 자료를 담아 두면 코딩 에이전트가 필요할 때 읽어 실행하는 형식으로, VSS 스킬은 [agentskills.io 명세](https://agentskills.io/specification)를 따르기 때문에 Claude Code, Codex, [NVIDIA NemoClaw](https://discuss.pytorch.kr/t/nvidia-nemoclaw-ai/9266) 같은 호환 에이전트에서 쓸 수 있습니다. 저장소의 `skills/` 디렉토리가 원본이고, NVIDIA가 별도로 운영하는 [NVIDIA Agent Skills 카탈로그](https://discuss.pytorch.kr/t/nvidia-agent-skills-nvidia-ai/10414)(`github.com/nvidia/skills`)에 미러링됩니다.
VSS 3.3은 스킬을 배포(`deployment/`), 운영(`operations/`), 도구(`tools/`), 벤치마크(`benchmarking/`) 네 갈래로 다시 묶고, 그 맨 위에 나머지를 조합하는 진입점으로 `vss-build-vision-ai`를 두었습니다. 원문은 이 스킬이 경보, 검색, 요약 같은 워크플로우를 SOP 준수 점검이나 교통 관리 같은 사용 사례에 맞춰 하나의 애플리케이션으로 묶고, 실행 중인 배포를 전체 스택을 다시 빌드하지 않고 확장한다고 설명합니다. [3.3.0 릴리스 노트](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization/blob/develop/docs/release-notes.mdx)에 따르면 이 스킬은 기존 `vss-deploy-profile` 스킬을 대체하며, `-p base`처럼 프로필을 플래그로 지정하던 방식 대신 요청 문장으로 원하는 구성을 설명합니다.
### 네 개의 개발 프로필과 Foundation
이 스킬은 배포 구성을 처음부터 생성하지 않습니다. 대신 하나의 워크플로우에 대해 이미 검증된 **개발 프로필(Developer Profile)** 네 개 중 요청과 가장 가까운 것을 고르고, 이를 **Foundation** 으로 삼아 요청에 필요한 부분만 바꿉니다(물류 창고용 `warehouse` 산업 프로필도 배포할 수 있지만, 명시적으로 요청할 때만 쓰이고 Foundation 후보 비교에는 들어가지 않습니다).
| 프로필 | 기능 |
| --- | --- |
| `base` | 클립에 대한 VLM 상세 캡션(dense captioning)과 질의응답 |
| `alerts` | 실시간 VLM 경보, 또는 RT-CV 검출과 행동 분석(behavior analytics) 뒤 VLM으로 경보 검증 |
| `lvs` | 긴 영상 요약(Long Video Summarization) |
| `search` | 객체와 영상 임베딩 기반의 에이전트 검색 |
Foundation이 정해지면 스킬은 **가장 작은 차이(smallest delta)** 를 계산합니다. 서비스 키는 정확히 필요한 것만 더하거나 빼고, 요청한 기능이 실제로 닿는 서비스만 남기며, 역할이 겹치는 공유 서비스는 하나의 인스턴스로 합칩니다. 예를 들어 검출기가 필요한 기능이 둘이면 검출기는 하나만 실행하고, Kafka와 Elasticsearch가 필요한 기능이 둘이면 메시지 버스와 Elasticsearch를 하나씩만 두고 각 기능이 자기 인덱스에 씁니다. 규칙만으로 결정할 수 없는 선택이 남으면 추측하지 않고 구조화된 질문 하나를 사용자에게 던집니다.
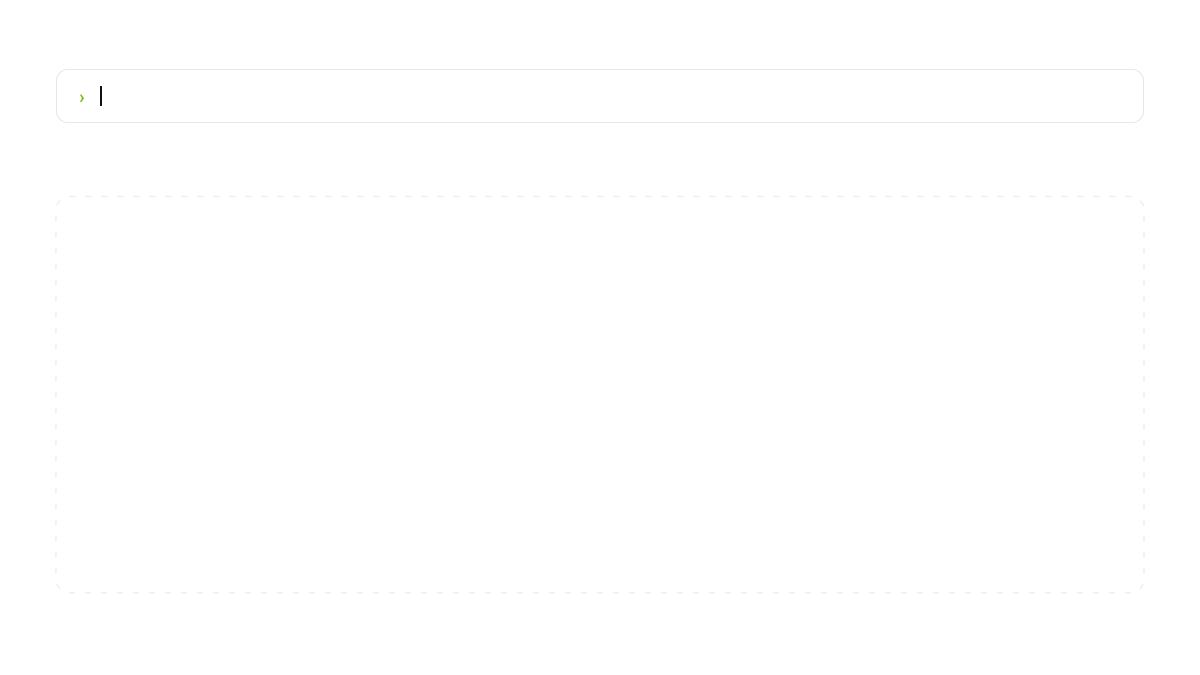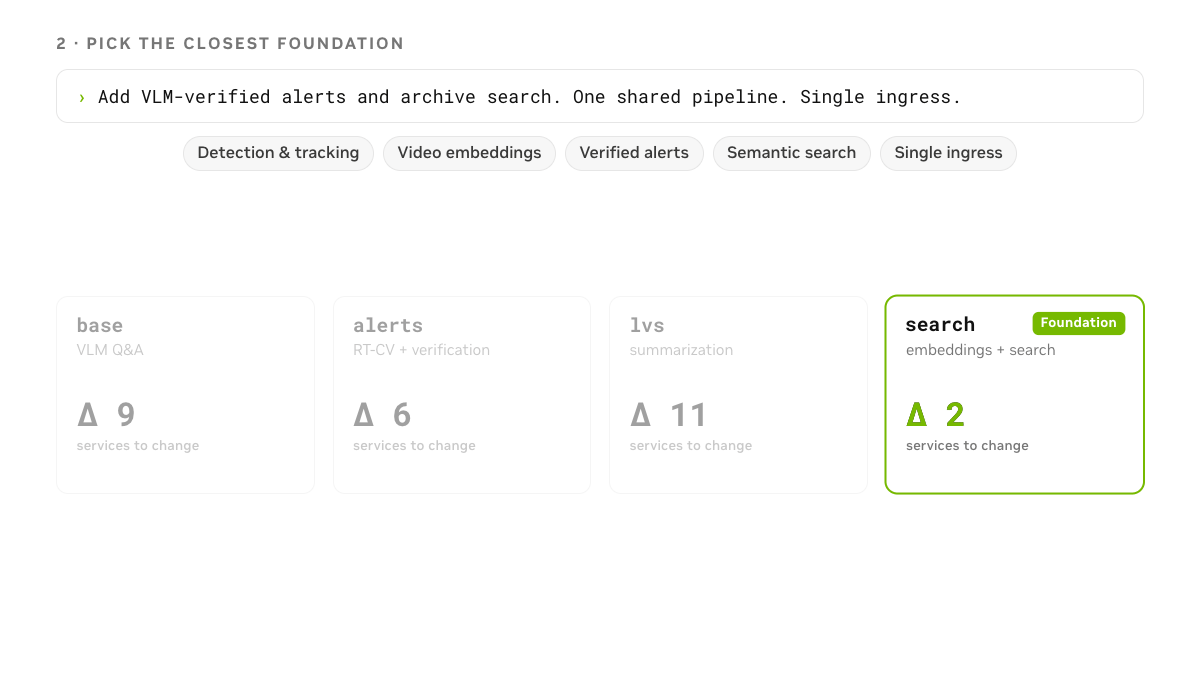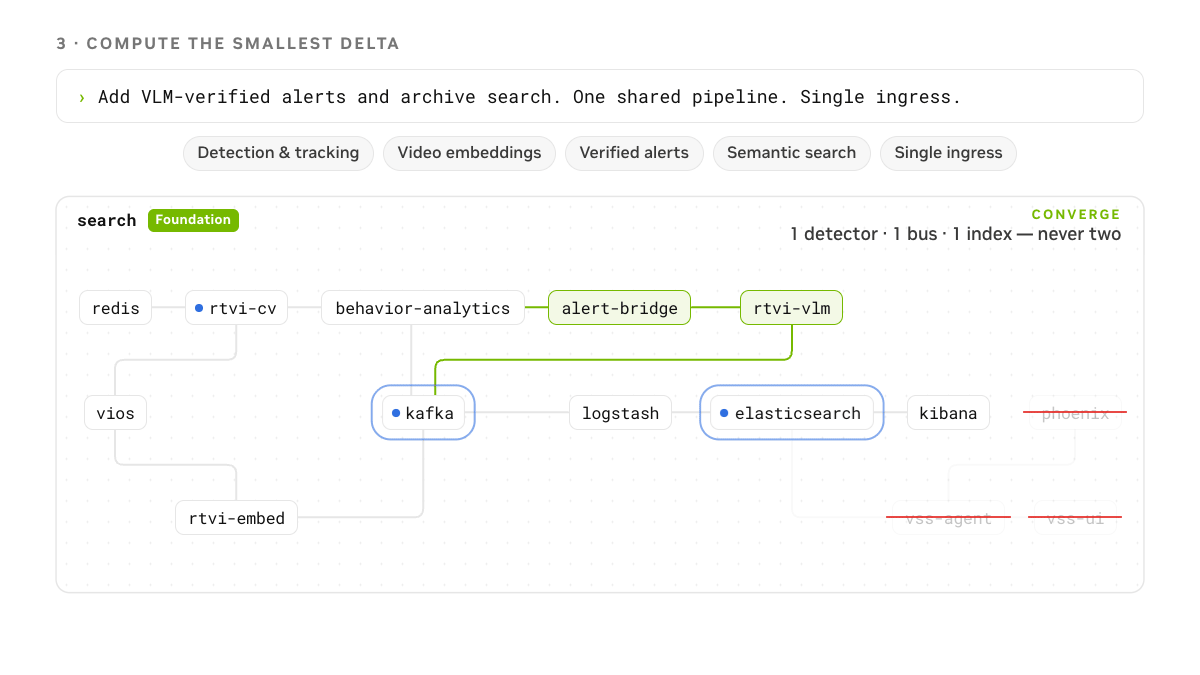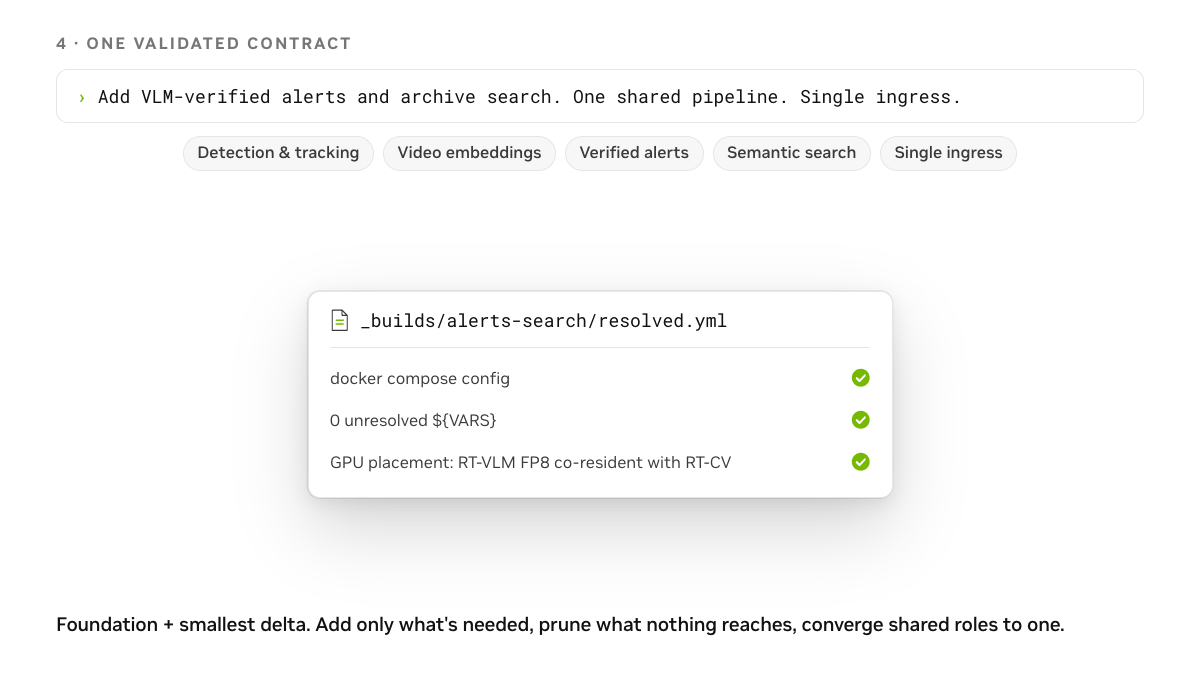
원문의 그림 2는 이 과정을 단계별로 보여줍니다. 흥미로운 점은 경보가 들어간 요청인데도 `alerts`가 아니라 `search` 프로필이 Foundation으로 뽑힌다는 것입니다. 그림 속 비교에서 바꿔야 할 서비스 수가 `base`는 9개, `alerts`는 6개, `lvs`는 11개, `search`는 2개였기 때문에, 이름이 아니라 변경량이 가장 적은 쪽을 고른 것입니다. 이후 `search` 구성에 `alert-bridge`와 `rtvi-vlm`을 더하고, 아무 기능도 닿지 않는 `vss-agent`, `phoenix`, `vss-ui`를 뺀 뒤, 검증 단계에서 미해결 변수가 0개인지와 RT-VLM(FP8)이 RT-CV와 같은 GPU에 올라가는지를 확인합니다.
### 스킬이 자동화하는 일
원문이 정리한 Build Vision Agent 스킬의 자동화 범위는 다음과 같습니다.
- 애플리케이션 목표를 필요한 VSS 워크플로우와 마이크로서비스로 대응시킵니다.
- 경보, 검색, 요약 같은 워크플로우를 하나의 배포 계획으로 합칩니다.
- VIOS, Kafka, Redis, Elasticsearch, HAProxy 인그레스, MCP 서비스 같은 공유 인프라를 재사용합니다.
- 배포를 독립된 빌드 디렉토리로 생성합니다. `_builds//override.env`에는 Foundation, 실제 적용되는 Compose 프로필, 사용자가 바꾼 설정만 들어가고, `compose.yml`과 `docker compose config`로 펼친 단일 파일 `resolved.yml`이 함께 만들어집니다. 저장소의 `deploy/docker/` 트리는 수정하지 않습니다.
- 무언가를 쓰거나 배포하기 전에 아키텍처 다이어그램을 보여 검토를 받고, 이후 검증, 배포, 준비 상태 확인까지 진행합니다.
- 에이전트 하네스(harness)를 함께 배포할지 묻습니다. 기본값은 VSS 스킬이 설치된 호스트 측 샌드박스인 NemoClaw이고, "아니오"를 고르면 VSS CLI로 다루는 headless 스택이 됩니다.
- 이미 실행 중인 배포도 기존 서비스를 재사용하는 더 작은 delta로 확장합니다.
하네스 질문은 저장소의 [`vss-build-vision-ai/SKILL.md`](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization/blob/develop/skills/vss-build-vision-ai/SKILL.md)를 보면 원문보다 구체적입니다. 어느 쪽으로 답하든 스택 내부의 에이전트와 추적용 `phoenix`가 빠지고, 긴 영상 요약 서버처럼 LLM을 쓰는 다른 서비스가 없으면 에이전트 전용 LLM NIM도 함께 빠집니다(문서는 이 LLM NIM이 빌드에서 GPU와 이미지 비용이 가장 큰 부분이라고 설명합니다), "예"를 고르면 NemoClaw 샌드박스가 별도 LLM으로 빌드를 조작합니다. 이 샌드박스의 기본 모델은 NVIDIA 추론 엔드포인트(`inference-api.nvidia.com`)를 거치는 `aws/anthropic/bedrock-claude-opus-5`이고 `COMPATIBLE_API_KEY`가 필요하며, 다른 OpenAI 호환 엔드포인트나 vLLM, Ollama 같은 로컬 모델로 바꿀 수 있습니다. 원문이 말하는 "_코딩 에이전트 사용료 몇 달러_"는 빌드를 만드는 코딩 에이전트 쪽 비용이므로, 하네스를 켜면 그 모델 사용료는 따로 생각해야 합니다.
## 예제: 오렌지 주스 병입 라인 에이전트를 프롬프트 한 번으로
원문은 오렌지 주스 병입(bottling) 라인을 예로 듭니다. 충전기(filler)와 캡핑기(capper)를 비추는 카메라를 감시하다가 넘침이나 쏟음을 경보하고, 과거 사고를 검색하고, 교대 근무 보고서를 만드는 에이전트입니다. 직접 개발한다면 이벤트 검출, 경보 검증, 저장, 검색용 수집, 요약, 보고를 하나씩 연결해야 하지만, Build Vision Agent 스킬에서는 원하는 결과를 설명하는 것에서 시작합니다.
[ ](https://www.youtube.com/watch?v=PPXoPSCdGyU)
위 영상(원문의 영상 1)은 한 번의 프롬프트로 병입 라인용 에이전트를 만들고 배포한 뒤, 에이전트가 넘침 경보를 내고 검증하는 과정을 보여줍니다. 원문은 영상 속 쏟음 장면이 데모를 위해 합성으로 만든 것이라고 밝히고 있습니다. 사용한 프롬프트는 다음과 같습니다.
```plaintext
Build a VSS vision agent for an orange juice bottling line. Use two RTSP cameras on the filler and capper. Detect bottle overflows and juice spills, verify each alert with the VLM, make alert clips searchable, and generate a shift report for the line supervisor.
```
이 요청에서 에이전트가 조립하는 구성 요소는 다음과 같습니다.
- RTSP(Real-Time Streaming Protocol) 카메라와 녹화 클립을 받아들이는 VIOS 기반 수집
- Foundation 프로필에 따라 실시간 검출, 추적, 캡션, 또는 VLM 기반 경보
- 넘침, 쏟음, 라인 정지 이벤트를 위한 행동 분석 또는 규칙
- 경보를 확인하고 그 이유를 설명하는 VLM 검증
- 검증된 클립과 색인된 영상에 대한 자연어 검색
- 운영자 인수인계와 사고 검토를 위한 요약과 보고
- 메시지, 저장소, API, 관측 기능의 공유
NVIDIA의 실행 환경은 RTX PRO 6000 Blackwell GPU 2장을 단 호스트였습니다. 스킬은 기존 서비스를 재사용해 검색과 경보를 합치면서 알림 브리지(alert bridge)와 실시간 VLM만 새로 더했고, FP8로 양자화(quantization)한 [Cosmos 3 Nano Reasoner](https://build.nvidia.com/nvidia/cosmos3-nano-reasoner)는 검출기와 같은 GPU를 나눠 써서 GPU를 따로 차지하지 않았습니다(저장소의 RT-VLM 참고 문서도 다른 GPU 서비스와 GPU를 함께 쓰면 FP8, GPU를 혼자 쓰면 BF16 변형을 고르도록 정해 두었습니다). 원문에 따르면 녹화로 진행한 경보 빌드는 30분이 안 되어 미리보기가 가능한 실제 배포 상태에 도달했습니다. 원문은 이를 영상은 한 번만 수집하고 증거는 워크플로우끼리 공유하는 재사용 가능한 패턴으로 정리합니다. 다만 30분과 몇 달러라는 수치는 NVIDIA가 한 번 녹화한 실행에서 나온 것이며, 반복 측정 결과나 사용한 코딩 에이전트 모델은 원문에 나와 있지 않습니다.
## Adaptive EVS: 이전 프레임과 같은 패치는 VLM에 보내지 않기
### 영상의 대부분은 반복이라는 관찰
병입 라인 에이전트가 배포되고 나면 카메라는 하루 종일 영상을 만들어 냅니다. 하지만 각 프레임의 대부분, 즉 충전기와 안전 가드, 바닥은 거의 변하지 않고 움직이는 것은 지나가는 병뿐이며 넘침은 드문 사건입니다. 그런데도 모든 프레임 구간은 VLM의 시각 입력이 되므로, 모델은 계산량 대부분을 직전 프레임과 똑같아 보이는 영역을 다시 읽는 데 씁니다. 원문은 이 VLM 처리가 배포된 영상 AI 에이전트의 주요 운영 비용이며 Adaptive EVS가 겨냥하는 비용이라고 설명합니다.
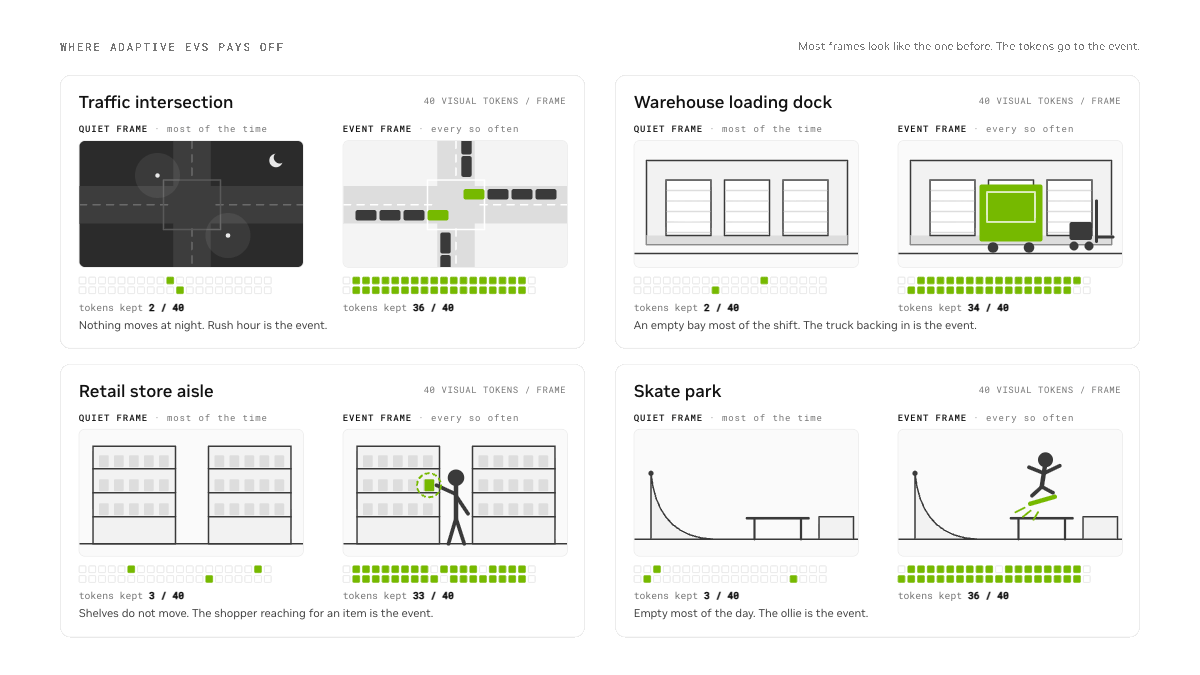
원문의 그림 3은 이 관찰을 네 장면으로 보여줍니다. 프레임당 40개 시각 토큰을 기준으로, 아무도 없는 야간 교차로나 빈 하역장처럼 조용한 프레임에서는 2~3개 토큰만 남고, 출퇴근 시간의 차량이나 후진하는 트럭처럼 이벤트가 있는 프레임에서는 33~36개가 남습니다. 원문은 이 그림의 토큰 수가 어떤 조건에서 나온 값인지 밝히지 않았으므로, 측정 결과보다는 동작을 설명하는 예시로 보는 것이 맞습니다.
### EVS에서 Adaptive EVS로
**EVS(Efficient Video Sampling)** 는 NVIDIA 연구진이 [2025년 10월 arXiv에 공개한 기법](https://arxiv.org/abs/2510.14624)으로, 연속된 프레임 사이에서 변하지 않은 공간 영역(patch)을 찾아 그 토큰을 언어 모델에 넣기 전에 잘라냅니다. 논문은 모델 구조를 바꾸거나 다시 학습하지 않아도 되는 플러그인 방식이며, 추론 시점에 적용하면 정확도 손실을 작게 유지하면서 LLM의 첫 토큰까지의 시간(Time-To-First-Token, TTFT)을 최대 4배 줄인다고 보고합니다. 이 기법은 이미 [vLLM](https://github.com/vllm-project/vllm)에 `video_pruning_rate` 옵션으로 들어가 있고, Cosmos NIM 마이크로서비스에도 고정된 가지치기(pruning) 비율로 들어가 있습니다. VSS에서도 3.2.0부터 `VLM_VIDEO_PRUNING_RATE`로 고정 비율 EVS를 쓸 수 있었습니다.
VSS 3.3의 Adaptive EVS는 이를 실시간 VLM 마이크로서비스(RT-VLM)에 통합하고, 남길 토큰을 패치별, 프레임별로 판단하도록 바꾼 것입니다. 원문이 설명하는 변화는 두 가지입니다.
- **동적 가지치기(Dynamic pruning):** 각 패치를 직전 프레임의 같은 패치와 코사인 유사도로 비교해, 변하지 않은 패치는 언어 모델에 도달하기 전에 버립니다.
- **이벤트 인식 배치(Event-aware batching):** 토큰이 얼마나 남았는지를 활동량 신호로 씁니다. 남은 토큰 비율이 약 70%를 넘는 클립은 이벤트로 묶어 처리하고, 약 30%에 못 미치는 클립은 버리거나 밀어내며(flush), 그 사이의 클립은 평소대로 처리합니다.
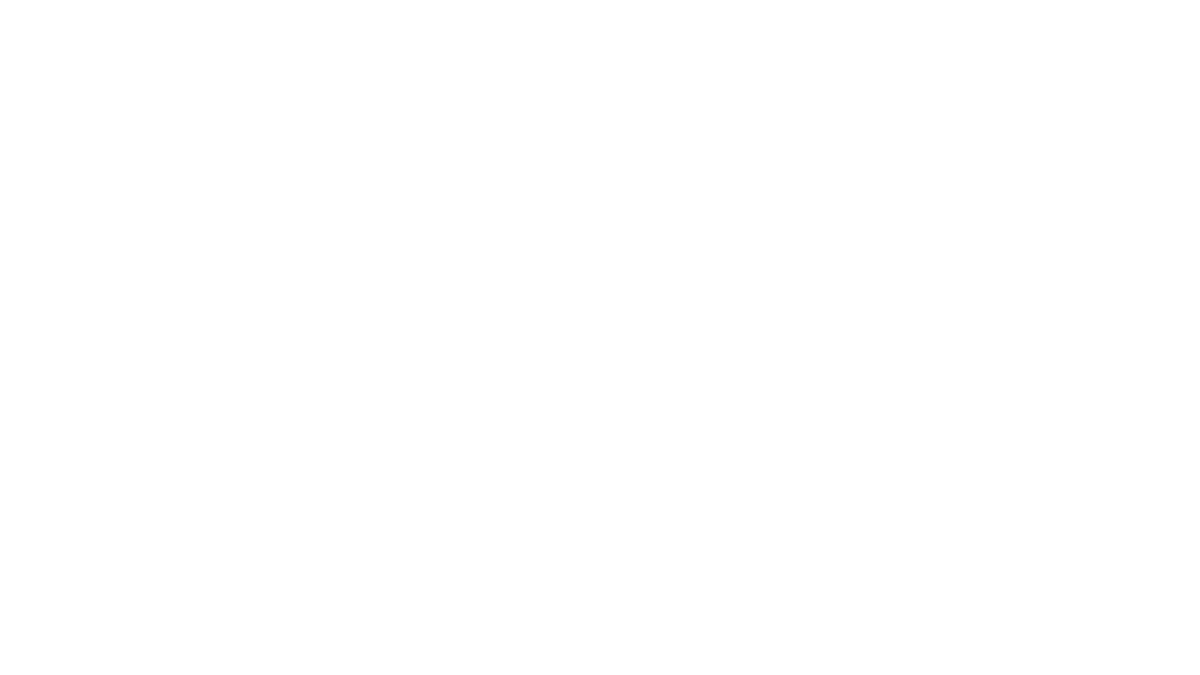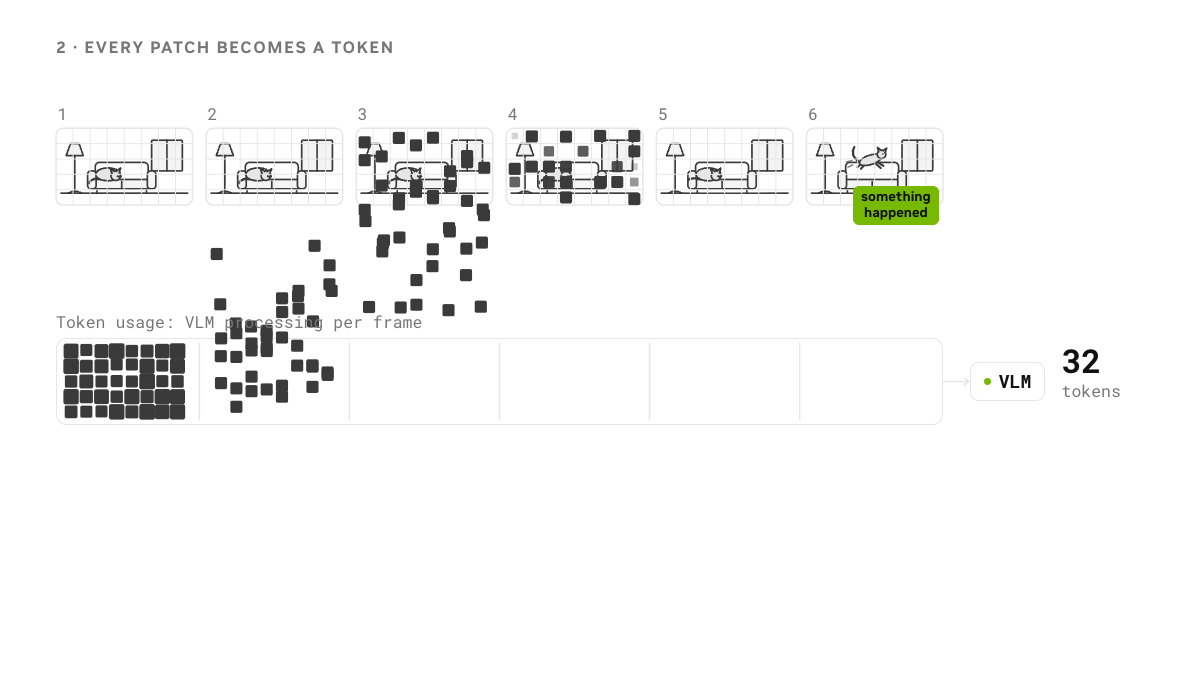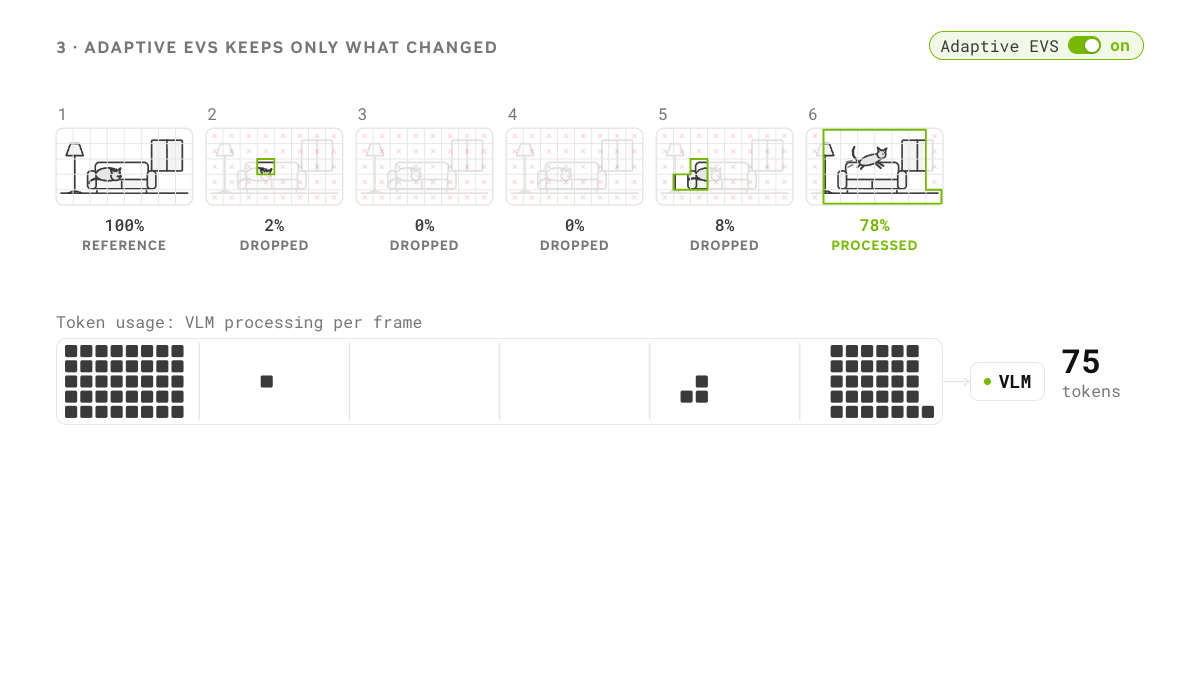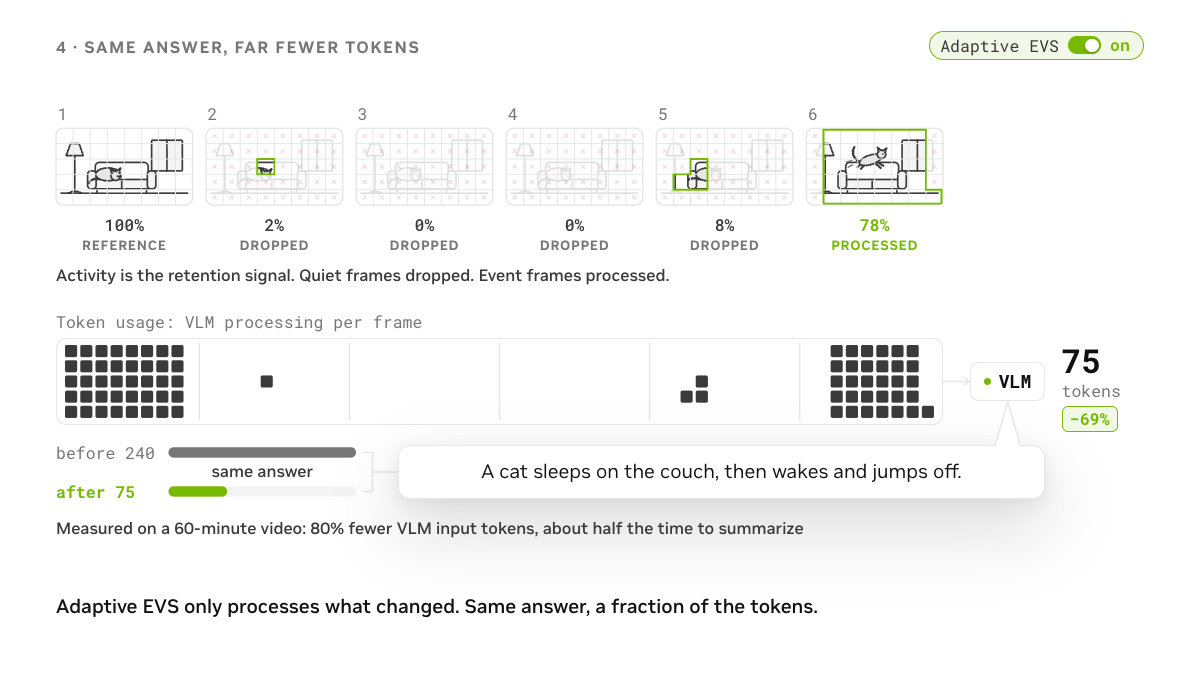
원문의 그림 4는 이 두 단계를 고양이 영상으로 보여줍니다. 6개 프레임을 모두 넣으면 240개 토큰이고, 그중 200개는 움직이지 않는 고양이를 다시 설명하는 데 쓰입니다. Adaptive EVS를 켜면 첫 프레임은 기준으로 모두 남기고, 변화가 2%, 0%, 0%, 8%인 2~5번 프레임은 버리며, 변화가 78%인 6번 프레임만 처리합니다. 결과적으로 VLM 입력은 75개 토큰(69% 감소)이 되지만 "_고양이가 소파에서 자다가 깨어나 뛰어내린다_"는 답은 같습니다. 이 고양이 예시의 69%와 아래에서 다룰 60분 영상의 80%는 서로 다른 값이므로 섞어 읽지 않아야 합니다.
## NVIDIA가 측정한 성능과 그 조건
NVIDIA는 [RTX PRO 6000 Blackwell](https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-6000/) GPU에서 FP8로 양자화한 [Cosmos 3 Super Reasoner](https://build.nvidia.com/nvidia/cosmos3-super-reasoner)를 실행해 Adaptive EVS를 켜기 전과 후를 비교했습니다. 여기서 FP8 모델은 NGC의 NIM이 제공하는 ModelOpt FP8 변형으로, Hugging Face의 [Cosmos3-Super](https://huggingface.co/nvidia/Cosmos3-Super) 모델 카드는 BF16만 시험했고 FP8은 공식 지원하지 않는다고 밝히고 있습니다. 또한 저장소 문서는 Super 변형을 H100과 RTX PRO 6000에서만 지원하며 VLM 전용 GPU 한 장이 필요하다고 안내합니다.
| 측정 항목 | 끄기 | 켜기 | 변화 |
| --- | --- | --- | --- |
| 경보 맥락화(alert contextualization) 지연 시간 | 1,021 ms | 844 ms | 17% 감소, 토큰 사용량도 비슷한 비율로 감소 |
| 동시 실시간 VLM 스트림 수 | 13개 | 19개 | 46% 증가 |
| 60분 영상 요약 | 기준 | 약 절반의 시간 | VLM 입력 토큰 80% 감소 |
원문은 결과가 장면의 움직임, 청크(chunk) 길이, 유사도 임계값에 따라 달라지므로, 운영 기본값을 정하기 전에 실제 환경과 비슷한 영상으로 벤치마크하라고 권합니다. 원문에는 정확도 비교 수치가 따로 실려 있지 않고, 측정에 쓴 영상의 종류와 반복 횟수도 나와 있지 않습니다. 따라서 위 수치는 NVIDIA가 자사 하드웨어와 모델로 측정한 사례로 읽는 것이 맞습니다.
원문은 Adaptive EVS가 가장 유용한 경우와 아닌 경우도 구분합니다. VLM이 많은 프레임을 읽고 짧게 답하는 상세 캡션, 긴 영상 요약, 경보 검증에 효과가 크고, 적은 프레임으로 긴 출력을 만드는 작업에는 효과가 작습니다. 또한 원격 엔드포인트가 아니라 RT-VLM 컨테이너 안에서 동작하며, 기본으로 켜져 있지 않은 선택 기능입니다.
## 설정할 때 확인할 점: 원문 예시와 저장소 문서의 차이
원문은 `override.env`에 다음 세 줄을 넣어 Adaptive EVS를 켜라고 안내합니다.
```bash
VIA_EVS_SESSION=true
VLM_VIDEO_PRUNING_RATE=0.5 # 0.0 to 1.0; higher prunes more
VLLM_EVS_SIMILARITY_THRESHOLD=0.2
```
그런데 저장소의 [RT-VLM 문서](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization/blob/develop/docs/real-time-vlm.mdx)와 대조해 보면 몇 가지가 다릅니다. 저장소 문서는 이 기능을 **EVS++ 세션 모드** 라고 부르며, 각 변수를 다음과 같이 설명합니다.
| 변수 | 원문 블로그 | 저장소 문서 (`develop`, 2026년 10월 1일 기준) |
| --- | --- | --- |
| `VIA_EVS_SESSION` | `true` | `true` 또는 `1`이면 vLLM 영상 세션 경로로 요청을 보냄. 기본은 꺼짐 |
| `VLM_VIDEO_PRUNING_RATE` | `0.5`, 주석은 "_0.0 to 1.0_" | 0보다 크고 1보다 작은 유한한 값만 허용. 0이나 1 같은 경계값, 범위 밖의 값, 숫자가 아닌 값은 RT-VLM 시작을 실패시킴. EVS++ 모드에서도 이 값이 있어야 가지치기가 켜짐 |
| `VLLM_EVS_SIMILARITY_THRESHOLD` | `0.2` | EVS++ 모드의 기본값은 `0.4`, 문서 예시도 `0.4` |
원문 주석의 "_0.0 to 1.0_"을 그대로 믿고 `1.0`이나 `0.0`을 넣으면 서비스가 뜨지 않는다는 점, 그리고 유사도 임계값이 원문 예시(0.2)와 문서 기본값(0.4)이 다르다는 점은 직접 튜닝할 때 기억해 둘 만합니다. 원문은 0.2가 측정에 쓴 값인지 밝히지 않았으므로, 두 값을 모두 자신의 영상으로 비교해 보는 편이 안전합니다.
저장소 문서에는 원문에 없는 제약도 있습니다. EVS++는 Qwen3-VL 구조를 바탕으로 한 로컬 vLLM 호환 모델에서만 지원되고, `openai-compat` 원격 엔드포인트에는 적용되지 않으며, `NemotronH_Nano_Omni_Reasoning_V3` 같은 Omni 모델은 지원하지 않습니다. 설정은 서비스 시작 시점에만 읽으므로 값을 바꾼 뒤에는 RT-VLM을 다시 시작해야 하고, 실행 중에 Config API로 바꿀 수 없습니다. 이 밖에 여러 클립에 걸쳐 쌓을 시각 토큰 예산(`VIA_EVS_TOKEN_BUDGET`, 기본값 1)과 동시 세션 수 상한(`VIA_EVS_MAX_SESSIONS`, 기본값 256)도 조정할 수 있습니다.
## VSS 3.3 시작하기
### 원문의 시작 절차
원문이 제시하는 시작 절차는 여섯 단계입니다.
1. VSS Blueprint 저장소를 클론하고 3.3 스킬이 있는 브랜치를 체크아웃합니다.
2. 코딩 에이전트의 표준 스킬 디렉토리에 VSS 스킬을 설치합니다.
3. 영상 소스, 워크플로우, 배포 제약을 포함해 원하는 에이전트를 설명하거나, `build a vision agent`라고만 말해 안내를 받습니다.
4. 아키텍처 다이어그램과 `_builds//override.env`를 검토합니다. 특히 GPU 배치, 모델 엔드포인트, 포트, 저장소, 보안 경계를 확인합니다.
5. RT-VLM 워크로드라면 Adaptive EVS를 켜고 가지치기 비율을 조정한 뒤, 실제와 비슷한 영상으로 정확도, 처리량, 지연 시간을 벤치마크합니다.
6. 인증, TLS, 요청 속도 제한(rate limiting), 외부 통제를 갖춘 신뢰할 수 있는 격리 네트워크에 배포합니다(VSS 문서는 이 기능들을 VSS가 아니라 인프라가 제공한다고 가정하므로, 서비스를 신뢰할 수 없는 네트워크에 바로 노출하지 않아야 합니다).
저장소 클론 명령은 다음과 같습니다.
```bash
git clone https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization.git
cd video-search-and-summarization
```
그다음 코딩 에이전트에게 다음과 같이 요청해 스킬을 설치합니다.
```plaintext
Read skills/README.md and every SKILL.md under skills/. Install each skill for this host
using the standard skills directory, symlinking rather than copying so a git pull keeps
them current.
```
스킬이 설치되면 다음과 같은 프롬프트로 시작할 수 있습니다.
```plaintext
Build a VSS vision agent that combines alert verification, natural-language video search,
and hourly summarization for my warehouse cameras. Reuse existing Kafka and Elasticsearch
services where possible, and produce a deployment plan before running Docker Compose.
```
### 따라 하기 전에 저장소에서 확인한 것들
원문의 절차만으로는 드러나지 않지만, 저장소를 직접 확인해 보면 시작 전에 알아 두면 좋을 점들이 있습니다.
**3.3은 아직 정식 릴리스가 아닙니다:** 원문은 "_3.3 스킬이 있는 브랜치_"라고만 적었는데, 2026년 10월 1일 기준 저장소의 최신 정식 릴리스는 `v3.2.1`(2026년 7월 23일)이고 3.3 관련 태그는 `v3.3.0rc0`뿐이며, [VSS 문서 사이트의 릴리스 노트](https://docs.nvidia.com/vss/latest/release-notes.html)도 3.2.1까지만 올라와 있습니다. 3.3 스킬은 기본 브랜치인 `develop`에 있으며, 스킬 메타데이터의 버전도 `3.3.0-rc0`입니다. 즉 `git clone` 직후의 기본 브랜치가 곧 3.3 스킬이 있는 브랜치입니다. 또한 Build Vision Agent 스킬은 컨테이너 이미지 태그를 따로 지정하지 않으면 `develop-latest`를 쓰는데, 저장소 README는 `develop-*`와 `nightly-*` 이미지가 개발과 시험용 사전 릴리스 산출물이며 운영 환경에는 NGC의 버전이 붙은 릴리스 이미지만 쓰라고 안내합니다.
**스킬 설치 범위가 원문과 다릅니다:** 원문의 설치 프롬프트는 `skills/` 아래의 모든 스킬을 설치하게 합니다. 반면 [저장소의 `skills/README.md`](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization/blob/develop/skills/README.md)는 `vss-build-vision-ai`와 `skills/operations/` 아래 스킬을 함께 설치하는 것을 권장 구성으로 제시합니다. Build Vision Agent 스킬은 의도적으로 배포까지만 담당하고 검색, 요약, 경보, 보고서 같은 운영 요청은 `operations/` 스킬로 넘기므로, 진입점만 설치하면 "_스택은 만들었지만 다룰 수는 없는_" 상태가 된다는 설명입니다. 전부 설치해도 문제는 없지만, 꼭 필요한 최소 구성은 이 두 묶음입니다.
**실행 환경 요구 사항:** 저장소 README는 NVIDIA NIM을 로컬에서 호스팅하려면 NVIDIA AI Enterprise 개발자 라이선스가 필요하고, [NVIDIA API 카탈로그](https://build.nvidia.com/) 또는 NGC API 키가 필요하다고 안내합니다. Docker Engine은 28.3.3 이상 29.5.0 미만이어야 하며(29.5.0 이상에서는 NGC 이미지 풀링이 실패할 수 있음), 직접 장비가 없다면 Brev Launchable로 AWS의 RTX PRO 6000 2장 인스턴스에 배포하는 노트북이 제공됩니다. 검증된 GPU 구성은 [VSS 문서의 사전 요구 사항](https://docs.nvidia.com/vss/latest/prerequisites.html)에 정리되어 있습니다.
**3.2.x에서 올리는 경우:** 3.3.0 릴리스 노트에 따르면 경보(Alerts) 마이크로서비스가 더 이상 Redis를 쓰지 않고 Kafka만 입출력으로 지원합니다. `event_bridge.sourceType` 또는 `sinkType`을 `redisStream`으로 둔 기존 설정은 서비스 시작을 실패시키므로, 업그레이드 전에 둘 다 `kafka`로 바꿔야 합니다.
## 라이선스
VSS Blueprint 저장소는 [Apache License 2.0](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization/blob/develop/LICENSE)으로 배포되어 연구 목적은 물론 상업적 용도로도 사용과 수정이 가능합니다. 다만 저장소에 포함된 Elasticsearch, Kibana, Redis 설정 파일은 SSPLv1과 AGPLv3 중 하나를 고르는 이중 라이선스이고, 데이터 자산에는 별도의 NVIDIA Asset License(`LICENSE.DATA`)가 적용됩니다. 또한 블루프린트가 사용하는 NIM 컨테이너와 모델은 저장소 코드와 별개의 이용 조건을 따르므로, 로컬 NIM 호스팅에 필요한 NVIDIA AI Enterprise 라이선스와 함께 확인해야 합니다.
## 📜 Lower the Cost of Building and Running Visual AI Agents with NVIDIA VSS Blueprint 3.3 블로그
> **[Lower the Cost of Building and Running Visual AI Agents with NVIDIA VSS...](https://developer.nvidia.com/blog/lower-the-cost-of-building-and-running-visual-ai-agents-with-nvidia-vss-blueprint-3-3)**
>
> Vision-language models have made it possible to build visual AI agents that understand video at production scale. The harder problem is turning that capability into a maintainable system that combines…
## :github: VSS Blueprint GitHub 저장소
> **[GitHub - NVIDIA-AI-Blueprints/video-search-and-summarization: NVIDIA AI Blueprint for video search and...](https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization)**
>
> NVIDIA AI Blueprint for video search and summarization (VSS) is a GPU-accelerated reference architecture for building video analytics agents with real-time verified alerts, visual Q&A, and automated reporting. The VSS Blueprint uses vision language models (VLMs) such as NVIDIA Cosmos, LLMs such as NVIDIA Nemotron, RAG, and NVIDIA NIMs.
## 📚 VSS 공식 문서
> **[Introduction — VSS](https://docs.nvidia.com/vss/latest/index.html)**
## 📜 Efficient Video Sampling 논문
> **[Efficient Video Sampling: Pruning Temporally Redundant Tokens for Faster VLM...](https://arxiv.org/abs/2510.14624)**
>
> Vision-language models (VLMs) have recently expanded from static image understanding to video reasoning, but their scalability is fundamentally limited by the quadratic cost of processing dense frame sequences. Long videos often exceed the token...
## 더 읽어보기
- [NVIDIA Agent Skills: NVIDIA가 공개한 검증된 AI 에이전트용 스킬 카탈로그](https://discuss.pytorch.kr/t/nvidia-agent-skills-nvidia-ai/10414)
- [NVIDIA NemoClaw: 안전한 자율형 AI 에이전트 구동을 위한 샌드박스 환경 가이드](https://discuss.pytorch.kr/t/nvidia-nemoclaw-ai/9266)
- [NVIDIA Cosmos 3: 물리 추론과 월드 생성, 행동 생성을 하나로 통합한 피지컬 AI 오픈 모델](https://discuss.pytorch.kr/t/nvidia-cosmos-3-ai/10497)
- [NVIDIA NemoClaw로 만든 기억하는 에이전트, 지식과 판단을 분리해 정확도 82.8% → 90.9%로 개선](https://discuss.pytorch.kr/t/nvidia-nemoclaw-82-8-90-9/11851)
* * *
_이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다._ 🤗
[:pytorch:파이토치 한국 사용자 모임🇰🇷](https://pytorch.kr/)에서 이런 글들을 계속 정리하고 있습니다. [회원 가입](https://discuss.pytorch.kr/signup)으로 주요 글들을 이메일💌로, [텔레그램(Telegram)](https://t.me/pytorchkr)이나 [Slack/Discord/Teams/Dooray/GoogleChat 등](https://discuss-noti.pytorch.kr)으로 새 글 알림을 받아보세요! 😃
🎁 아래↘쪽에 좋아요👍를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~ 🤩