# 허깅페이스 공인 벤치마크 리더보드 48개 전수 분석: 데이터 구조, 집계 방법, 그리고 숫자가 말해 주는 것
**URL:** https://discuss.pytorch.kr/t/topic/12099
**Category:** 읽을거리&정보공유
**Tags:** vidraft, 비드래프트, 허깅페이스, 벤치마크, 리더보드
**Created:** [10월 5, 2026, 7:56오전 UTC](https://discuss.pytorch.kr/t/topic/12099 "2026-10-05T07:56:47Z")
**Posts on this page:** 1
**Page:** 1
### Author:  [@AI\_OpenFree](https://discuss.pytorch.kr/u/AI_OpenFree)
#### Post date: [10월 5, 2026, 7:56오전 UTC](https://discuss.pytorch.kr/t/topic/12099/1 "2026-10-05T07:56:48Z")
기준 시점: 2026년 10월 5일 (허깅페이스 공개 API 실측)
실시간 대시보드: [Hugging Face Official Benchmarks Map - a Hugging Face Space by quantid](https://huggingface.co/spaces/quantid/huggingface-official-benchmark-leaderboards)
## TL;DR
- 허깅페이스가 `benchmark:official` 로 지정한 데이터셋은 **48개** , 그중 리더보드 항목이 1건 이상인 것은 **44개** , 기본 화면 기준 등록 항목은 \*\*1,023건(411개 모델, 95개 조직)\*\*이다.
- 참가 분포는 강하게 쏠려 있다. 벤치마크당 등록 수 **중앙값 11.5건, 지니계수 0.583** , 상위 5개 벤치마크가 전체의 **45.9%** , 상위 10개가 \*\*62.8%\*\*를 차지한다.
- 벤치마크 **수** 는 에이전트·터미널(17개)이 가장 많지만, **등록** 은 과학·지식(348건, 벤치마크당 58건)에 몰린다. 에이전트는 벤치마크당 11.6건에 그친다.
- 기본 리더보드 화면은 `base_model` 을 선언한 파생 모델을 **제외** 한다. 파생 모델까지 포함하면 등록은 **1,469건** 으로, 약 30%(446건)가 기본 화면에서 보이지 않는다.
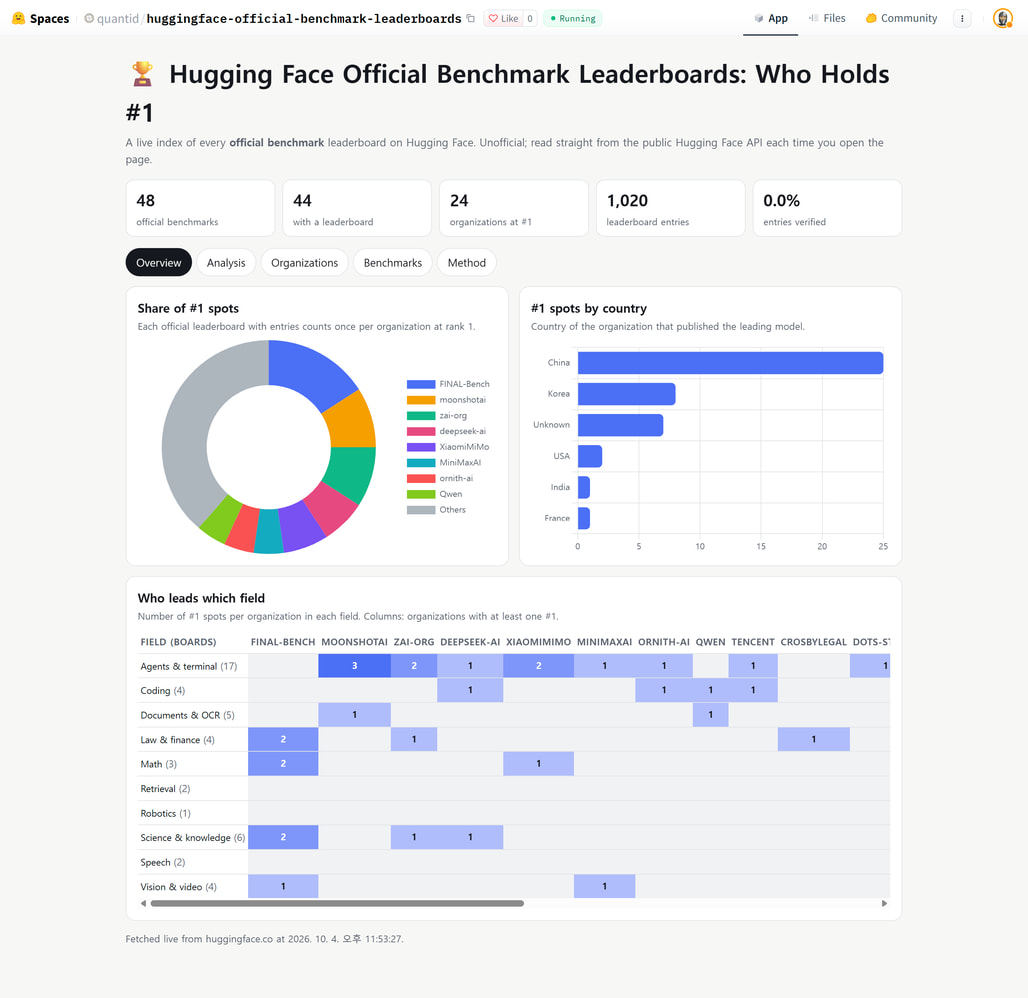
- 1위 보유 조직은 23곳이다. FINAL-Bench 9, Moonshot AI 4, Z.ai 4, DeepSeek 3, Xiaomi MiMo 3 순이다.
- 검증(verified) 표시가 붙은 항목은 **0건** 이다. 모든 점수는 제작사 자체 보고값이다.
* * *
## 1. 허깅페이스 공인 리더보드는 어떻게 만들어지는가
허깅페이스 데이터셋 페이지의 **Leaderboard** 섹션은 별도 제출 양식이 있는 게 아니라, **모델 저장소에 들어 있는 `.eval_results/*.yaml` 파일을 허깅페이스가 주기적으로 수집해서** 만든다. 모델 카드 메타데이터의 `model-index` 만으로는 등재되지 않는다.
YAML 한 항목의 형태는 대략 다음과 같다.
```yaml
- dataset:
id: Idavidrein/gpqa
task_id: diamond
value: 94.44
source:
url: https://huggingface.co//
name: Model Card
notes: "evaluation settings ..."
```
운영상 알아 두면 좋은 동작이 몇 가지 있다.
| 동작 | 내용 |
| --- | --- |
| 배치 색인 | 커밋 즉시 반영되지 않는다. 짧게는 수 분, 길게는 수일 걸린다 |
| 기본 화면 필터 | 모델 카드 front matter 에 `base_model:` 이 있으면 파생 모델로 분류되어 기본 화면에서 빠진다. `?base_model=false` 로 조회하면 포함된다 |
| 자체 보고 | 점수는 제작사가 자기 저장소에 쓴 값이다. `verified` 플래그는 허깅페이스가 별도로 표시하는 경우에만 참이다 |
| 파일명 | 자유다. 같은 GPQA 리더보드에도 `gpqa.yaml`, `gpqa_diamond.yaml`, `gpqa-diamond.yaml` 이 섞여 있다 |
`base_model` 필터는 집계 결과를 크게 바꾼다. 이번 측정에서 기본 화면 합계는 1,023건, 파생 포함 합계는 1,469건이었다. 미세조정·양자화·병합 모델이 많은 생태계 특성상, "리더보드에 몇 개가 올라 있나"를 말할 때는 어느 화면 기준인지부터 밝혀야 한다. 이 글의 수치는 모두 **기본 화면 기준** 이다.
## 2. 데이터 수집 방법
공개 API 두 개면 충분하다. 인증이 필요 없고, CORS 도 열려 있어 브라우저에서 직접 호출할 수 있다.
```plaintext
GET https://huggingface.co/api/datasets?filter=benchmark:official&limit=100
GET https://huggingface.co/api/datasets/{dataset_id}/leaderboard
GET https://huggingface.co/api/datasets/{dataset_id}/leaderboard?base_model=false # 파생 모델 포함
```
목록 API 는 페이지네이션을 `Link` 헤더의 `rel="next"` 로 돌려준다. 리더보드 API 는 항목마다 `rank`, `value`, `modelId`, `verified`, `source`, `filename` 을 준다.
재현용 최소 코드다.
```python
import requests, statistics, collections
API = "https://huggingface.co/api"
def get_all(url):
out = []
while url:
r = requests.get(url, timeout=30); r.raise_for_status()
out += r.json()
url = r.links.get("next", {}).get("url")
return out
benchmarks = get_all(f"{API}/datasets?filter=benchmark:official&limit=100")
rows, firsts = [], collections.Counter()
for d in benchmarks:
lb = requests.get(f"{API}/datasets/{d['id']}/leaderboard", timeout=30).json()
lb = lb if isinstance(lb, list) else []
rows.append((d["id"], len(lb)))
for e in lb:
if e.get("rank") == 1:
firsts[e["modelId"].split("/")[0]] += 1 # 조직 = 모델 저장소 네임스페이스
n = [c for _, c in rows]
print(len(benchmarks), sum(n), statistics.median(n))
print(firsts.most_common(5))
```
대시보드는 같은 로직을 브라우저 JavaScript 로 옮긴 것이다. 서버에 캐시하지 않고 페이지를 열 때마다 API 를 읽어 계산하기 때문에, 숫자를 고치거나 고를 수 있는 단계가 없다.
### 집계 규칙
- **조직** : 모델 저장소의 네임스페이스. 다른 네임스페이스가 올린 미세조정 모델은 그 네임스페이스로 센다(예: `Tort-AI/GLM-5.3` 은 Z.ai 가 아니라 Tort-AI).
- **공동 1위** : rank 1 이 여러 개면 해당 조직을 모두 센다.
- **분야** : 48개 벤치마크에 10개 분야를 사람이 붙였다(에이전트·터미널, 과학·지식, 문서·OCR, 코딩, 영상·시각, 법률·금융, 수학, 음성, 검색, 로봇).
- **국가** : 조직 본사 소재지 기준으로 사람이 붙였다. 공개 정보로 확정하기 어려운 조직은 `Unknown` 으로 둔다. 분류표는 대시보드의 `maps.js` 로 공개되어 있다.
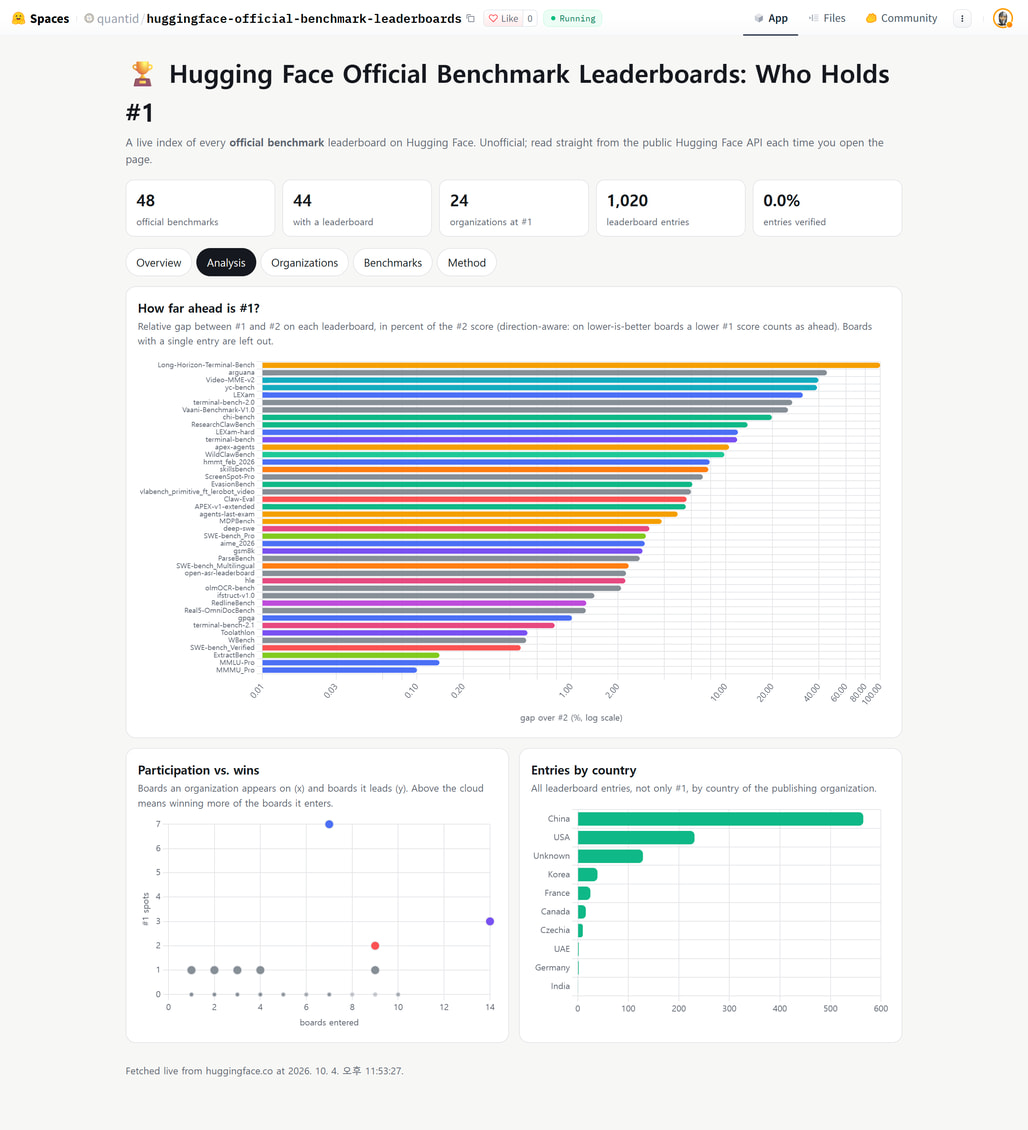
- **1위와 2위 격차** : `|#1 − #2| / |#2| × 100`. 단어 오류율처럼 낮을수록 좋은 지표도 rank 로 방향이 정해지므로 절댓값으로 처리한다.
## 3. 분포: 참가는 소수 벤치마크에 몰린다
| 통계량 | 값 |
| --- | --- |
| 공인 벤치마크 | 48 |
| 등록 1건 이상 | 44 |
| 등록 0건 | 4 |
| 총 등록(기본 화면) | 1,023 |
| 평균 / 중앙값 | 21.3 / 11.5 |
| 1사분위 / 3사분위 | 5 / 23 |
| 최대 | 141 (MMLU-Pro) |
| 지니계수 | 0.583 |
| HHI | 0.0578 |
| 상위 5개 점유율 | 45.9% |
| 상위 10개 점유율 | 62.8% |
| 등록 5건 이하 | 13 |
평균(21.3)이 중앙값(11.5)의 두 배에 가깝다는 건 분포가 오른쪽으로 길게 늘어져 있다는 뜻이다. MMLU-Pro(약 141), GPQA(약 111), HLE(약 89), SWE-bench Verified(약 67), Open ASR(약 62) 다섯 개가 절반 가까이를 가져간다.
실무적인 함의는 단순하다. **"OO 리더보드 1위"라는 문장은 그 리더보드의 참가 수와 함께 읽어야 한다.** 등록 141건 중 1위와 등록 3건 중 1위는 정보량이 전혀 다르다.
## 4. 분야: 벤치마크는 에이전트에, 등록은 과학에
| 분야 | 벤치마크 수 | 등록 수 | 벤치마크당 등록 |
| --- | --- | --- | --- |
| 과학·지식 | 6 | 348 | 58.0 |
| 에이전트·터미널 | 17 | 198 | 11.6 |
| 코딩 | 4 | 158 | 39.5 |
| 문서·OCR | 5 | 90 | 18.0 |
| 음성 | 2 | 72 | 36.0 |
| 수학 | 3 | 62 | 20.7 |
| 영상·시각 | 4 | 47 | 11.8 |
| 법률·금융 | 4 | 40 | 10.0 |
| 검색 | 2 | 4 | 2.0 |
| 로봇 | 1 | 4 | 4.0 |
에이전트 벤치마크는 공급(벤치마크 수)은 가장 많지만 수요(등록)는 벤치마크당 11.6건으로 과학·지식(58.0)의 5분의 1 수준이다. 원인은 평가 비용으로 보인다. GPQA·MMLU-Pro 는 객관식이라 단일 프로세스로 돌릴 수 있지만, Terminal-Bench·SWE-bench 계열은 컨테이너 샌드박스와 장시간 다단계 실행이 필요하고, 일부는 LLM 판정관 비용까지 든다. 결과적으로 **에이전트 영역은 아직 참가자가 적은 블루오션** 이고, 지식 영역은 경쟁이 포화된 레드오션이다.
## 5. 참가자: 95개 조직, 그러나 절반은 한 번만 낸다
- 조직 95개, 모델 411개.
- **45개 조직(47%)은 벤치마크 딱 한 곳에만** 등록했다. 소수의 대형 조직이 여러 리더보드에 동시에 이름을 올린다.
| 조직 | 참가 벤치마크 | 등록 수 | 1위 수 |
| --- | --- | --- | --- |
| Qwen | 31 | 136 | 1 |
| Z.ai (zai-org) | 32 | 84 | 4 |
| DeepSeek | 27 | 65 | 3 |
| Moonshot AI | 28 | 65 | 4 |
| NVIDIA | 15 | 63 | 0 |
| Ornith | 9 | 48 | 2 |
| OpenAI | 10 | 47 | 0 |
| MiniMax | 16 | 36 | 2 |
| Tencent | 17 | 34 | 2 |
| Xiaomi MiMo | 14 | 26 | 3 |
Qwen 은 31개 벤치마크에 136건을 올려 참가 규모로는 압도적이지만 1위는 1개다. 반대로 참가 폭은 좁아도 1위 비율이 높은 조직이 있다. 대시보드의 "참가 벤치마크 수 대 1위 수" 산점도가 이 차이를 보여 준다.
### 국가별 등록 비중
| 국가 | 등록 | 비중 |
| --- | --- | --- |
| 중국 | 565 | 55.2% |
| 미국 | 231 | 22.6% |
| 미상 | 129 | 12.6% |
| 한국 | 42 | 4.1% |
| 프랑스 | 25 | 2.4% |
| 캐나다 | 16 | 1.6% |
| 체코 | 10 | 1.0% |
오픈 가중치 모델 생태계에서 중국 조직의 비중이 과반이라는 점은 다른 지표와도 일치한다. 미국은 빅테크 상당수가 공개 가중치를 내지 않거나, 내더라도 `.eval_results` 를 쓰지 않는 경우가 많아 실제 역량보다 적게 잡혔을 가능성이 있다.
## 6. 1위 현황
| 조직 | 국가 | 1위 수 |
| --- | --- | --- |
| FINAL-Bench | 한국 | 9 |
| Moonshot AI | 중국 | 4 |
| Z.ai | 중국 | 4 |
| DeepSeek | 중국 | 3 |
| Xiaomi MiMo | 중국 | 3 |
| Ornith | 미상 | 2 |
1위 보유 조직은 23곳이다. FINAL-Bench 는 GPQA Diamond, MMLU-Pro, MMMU-Pro, AIME 2026, HMMT Feb 2026, LEXam, LEXam-hard, ExtractBench, IFStruct 에서 1위다. 등록 수가 가장 많은 두 리더보드(MMLU-Pro, GPQA)의 1위를 함께 갖고 있다는 점이 특징이다. 국내 조직 가운데 1위가 있는 곳은 FINAL-Bench 와 문서 파싱 모델의 KDLAI(ParseBench) 두 곳이다.
## 7. 1위와 2위 격차: 상당수는 오차 범위 안이다
2위가 있는 42개 리더보드에서 격차 중앙값은 \*\*5.2%\*\*다. 그런데 **7개는 1% 미만** 이다.
| 가장 근소한 격차 | 격차 |
| --- | --- |
| MMMU-Pro | 0.10% |
| MMLU-Pro | 0.14% |
| ExtractBench | 0.46% |
| SWE-bench Verified | 0.47% |
| WBench | 0.51% |
| Toolathlon | 0.52% |
MMLU-Pro 의 0.14% 차이는 문항 수와 표본 변동을 감안하면 통계적으로 구분하기 어려운 수준이다. 이런 리더보드의 1위는 새 제출 하나로 언제든 뒤집힐 수 있다. 반대로 Long-Horizon-Terminal-Bench(100%)처럼 격차가 커 보이는 곳은 점수 자체가 작아(6 대 3) 상대 격차가 부풀려진 경우다. **격차는 상대값과 절댓값, 그리고 문항 수를 함께 봐야** 의미가 있다.
## 8. 해석상 주의할 점
1. **전부 자체 보고다.** `verified` 표시가 붙은 항목은 0건이다. 같은 벤치마크라도 제출마다 샘플링(T=0 대 T\>0), 단일 실행 대 다수결, 생각 모드 여부, 생성 길이 상한이 다르다. 좋은 제출은 `notes` 에 이 조건을 적는다.
2. **기본 화면은 파생 모델을 숨긴다.** `base_model` 선언 여부에 따라 같은 모델이 보였다 안 보였다 한다. 이번 측정에서 약 30%가 기본 화면에서 빠졌다.
3. **조직 단위 집계는 계보를 반영하지 않는다.** 기반 모델 제작사가 아니라 저장소 소유자로 센다. Qwen 기반 파생 모델의 1위는 Qwen 의 1위로 잡히지 않는다.
4. **분야와 국가는 사람이 붙인 라벨이다.** 분류 기준을 공개하고 정정 요청을 받는 이유다.
5. **스냅샷이다.** 공인 벤치마크와 등록은 계속 늘어난다. 이 글의 수치는 2026년 10월 5일 기준이며, 대시보드는 항상 현재 값을 보여 준다.
## 9. 마치며
개별 리더보드는 "누가 이 시험에서 가장 높은가"를 말해 준다. 48개를 한데 놓으면 다른 질문에 답할 수 있다. 어떤 능력을 측정하려는 시도가 늘고 있는지(에이전트), 실제 경쟁은 어디서 벌어지는지(과학·지식), 누가 넓게 참가하고 누가 좁게 이기는지, 어느 1위가 단단하고 어느 1위가 위태로운지. 모델을 고르거나 평가 전략을 세울 때, 리더보드 숫자 하나보다 이 지형도가 더 많은 것을 알려 준다.
**대시보드:** [Hugging Face Official Benchmarks Map - a Hugging Face Space by quantid](https://huggingface.co/spaces/quantid/huggingface-official-benchmark-leaderboards)
(분야 히트맵, 벤치마크별 등록 수, 활발한 조직, 국가별 비중, 1위와 2위 격차, 참가 대비 1위 산점도 포함)