[2026/08/03 ~ 09] 이번 주에 살펴볼 만한 AI/ML 논문 모음
PyTorchKR


이번 주 선정된 10편의 논문들을 살펴본 결과, AI 에이전트의 구조적 고도화, 메모리 및 컨텍스트의 효율적 관리, 그리고 한계를 직시하는 엄격한 평가라는 3가지 주요 트렌드를 발견할 수 있었습니다:
 프롬프트 엔지니어링에서 "소프트웨어 공학 및 동적 하네스(Harness)"로의 진화: 이번 주 논문들에서는 AI 에이전트 개발을 단순한 프롬프트 텍스트 조립이 아닌, 체계적인 소프트웨어 엔지니어링 및 런타임 환경 구축으로 격상시키려는 시도가 돋보였습니다. NVIDIA-labs OO Agents (NOOA)는 에이전트를 파이썬 객체 지향 프로그래밍(OOP)과 결합하여 테스트와 유지보수를 일반 소프트웨어처럼 다룰 수 있게 만들었습니다. 또한, Continual Harness와 Harness-R1은 모델의 가중치를 직접 수정하는 대신, 에이전트를 둘러싼 도구, 메모리, 실행 런타임(하네스)을 실패 경험으로부터 실시간으로 자가 개선하고 최적화하는 방법론을 제시했습니다. 이는 에이전트의 성능 병목이 모델 자체의 지능뿐만 아니라, 이를 뒷받침하는 시스템적 스캐폴딩(Scaffolding) 설계에 있음을 시사합니다.
 단순 조회를 넘어선 "구조화된 메모리 및 능동적 컨텍스트 관리": RAG(검색 증강 생성)와 에이전트 메모리 처리 방식이 평면적인 텍스트 검색을 넘어, 고도로 구조화되고 비용 효율적인 아키텍처로 진화하고 있습니다. LLM-Wiki는 외부 지식을 파편화된 청크(Chunk)가 아닌 상호 연결된 위키 구조로 컴파일하여 에이전트가 능동적으로 탐색하고 논리적으로 추론할 수 있게 했습니다. Zero-Mem은 메모리 연산 과정에서 발생하는 LLM 호출 비용과 시간을 없애기 위해, 원본 기록을 그래프와 시간 계층으로 구조화하여 토큰 소비 없이 증거를 찾는 방식을 제안했습니다. 나아가 에이전틱 컨텍스트 관리(ACM)는 폭발적으로 증가하는 컨텍스트를 통제하기 위해 메모리를 단순 저장소가 아닌 수집, 압축, 통합을 아우르는 전체 '라이프사이클' 문제로 재정의하여 비용 절감과 정확도를 동시에 달성했습니다.
 엄격한 벤치마크 도입과 모델의 "근본적 한계 및 동적 상호작용 규명": 모델 성능이 상향 평준화됨에 따라, 실질적인 취약점을 파고들고 평가 지표 자체의 한계를 극복하려는 연구들이 두드러졌습니다. DataSpace는 흩어진 이기종 환경(PDF, CSV, DB 등)을 종합해야 하는 벤치마크를 통해 에이전트의 실제 데이터 처리 한계를 드러냈고, 표 형식 예측(Tabular Prediction) 연구는 고차원 데이터 환경에서 LLM이 고전 머신러닝에도 미치지 못하는 결정적 한계를 실증했습니다. 또한 벤치마크 포화(Plateau) 연구는 평가 도구가 빠르게 변별력을 잃는 현상을 분석하며 장기적 평가를 위한 전문가 큐레이션의 중요성을 강조했습니다. 끝으로 AI 가치 정렬 연구는 정적인 가치 학습이 변화하는 인류의 사회 규범 속에서 오히려 위험한 '가치 고착'을 유발할 수 있음을 경고하며, 안전하고 지속 가능한 AI를 위한 동적 평가의 필요성을 역설했습니다.
논문별 간략 요약
-
NVIDIA Object-Oriented Agents: 에이전트를 파이썬 객체로 정의하여 프롬프트와 모델 호출을 일반적인 소프트웨어 개발 과정과 완벽히 통합하는 프레임워크를 제안했습니다. 이를 통해 복잡한 워크플로 대신 객체 지향적인 방식으로 에이전트의 상태와 행동을 유연하게 관리할 수 있습니다.
-
Zero-Mem: 상호작용 기록을 개체-문맥 그래프와 시간 계층으로 구조화하여 중간 생성 과정 없이 증거를 검색하는 제로 토큰 메모리 연산을 도입했습니다. 언어 모델 호출 비용과 시간을 대폭 줄이면서도 장기 메모리 성능을 경쟁력 있게 유지하는 것이 특징입니다.
-
Continual Harness: 체화형 에이전트가 환경 초기화 없이 단일 실행 내에서 행동과 스킬 및 메모리 정제를 번갈아 수행하며 스스로 개선하는 온라인 적응 프레임워크를 제시했습니다. 수작업 스캐폴딩 없이도 게임과 같은 복잡한 환경에서 인간 전문가 수준의 성능에 도달할 수 있음을 보여줍니다.
-
LLM-Wiki: 외부 지식을 단순한 청크가 아닌 양방향 링크를 가진 위키 구조로 컴파일하여 에이전트가 직접 문서를 탐색하고 논리적으로 추론할 수 있는 에이전트 네이티브 검색 시스템을 제안했습니다. 자가 교정 기능을 더해 다중 문서 기반의 복잡한 질문에서 기존 검색 증강 생성 시스템을 뛰어넘는 성능을 달성했습니다.
-
DataSpace: 이기종 환경에 흩어진 데이터에서 증거를 탐색하고 완전한 표 형태의 결과를 생성하도록 요구하는 새로운 데이터 에이전트 벤치마크를 구축했습니다. 최신 모델들도 다중 모달리티 통합에서 높은 실패율을 보여 에이전트의 실제 데이터 처리 능력을 엄격하게 평가하는 기준이 됩니다.
-
표 형식 예측에서의 대규모 언어 모델 한계 규명: 언어 모델이 표 형식 데이터 예측에서 고전적인 기계학습 모델보다 성능이 떨어지는 원인이 입력 데이터의 차원 수 증가에 있음을 실험적으로 증명했습니다. 차원이 커질수록 예측 능력이 급격히 무너지는 현상을 확인하여 표 데이터 예측의 근본적인 취약점을 드러냈습니다.
-
Harness-R1: 대상 에이전트의 실패 경험을 바탕으로 실행 가능한 런타임 하네스를 스스로 수정하고 최적화하는 전용 엔지니어 모델을 강화학습으로 훈련시켰습니다. 모델 가중치를 직접 수정하지 않고도 런타임 환경 개선만으로 에이전트의 작업 성공률을 크게 높일 수 있음을 입증했습니다.
-
벤치마크 포화 현상 체계적 연구: 평가 지표들이 빠르게 한계점에 도달하여 변별력을 잃는 현상을 체계적으로 분석하고 이를 방지하기 위한 설계 요소를 연구했습니다. 테스트 데이터의 비공개 여부보다 전문가의 세밀한 문제 큐레이션이 벤치마크의 수명을 늘리는 핵심 요인임을 밝혔습니다.
-
진화하는 사회 규범을 위한 동적 AI 가치 정렬: 사회적 가치가 변하는 환경에서 정적인 가치 정렬 방식이 오히려 사용자를 과거의 가치관에 묶어두는 고착 현상을 유발할 수 있음을 수학적 모델로 분석했습니다. 환경 변화에 적응하고 하위문화의 다양성을 보존하기 위한 동적이고 유연한 정렬 설계의 필요성을 강조했습니다.
-
에이전틱 컨텍스트 관리: 에이전트의 컨텍스트 관리를 단순한 저장 및 검색이 아닌 정보의 수집부터 압축 및 통합을 아우르는 전체 수명 주기 문제로 재정의했습니다. 비용 상승과 정확도 하락을 막기 위해 검증된 압축 방식을 도입하여 효율적이고 안정적인 메모리 관리 아키텍처를 구현했습니다.
NVIDIA-labs OO Agents: 네이티브 Python 객체지향 에이전트 / NVIDIA-labs OO Agents: Native Python Object-Oriented Agents
논문 소개
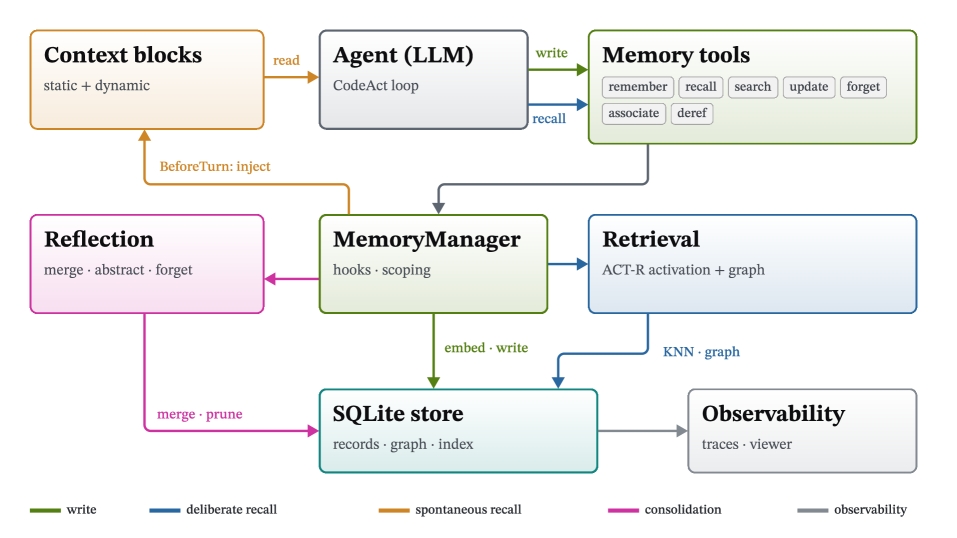
전통적인 AI 에이전트 개발은 프롬프트 템플릿, 툴 스키마, 콜백 코드, 워크플로 그래프가 서로 분리되어 있어 단일 사양(source of truth)을 유지하기 어렵고, 테스트·트레이싱·리팩터링도 일반 소프트웨어 공학의 경로와 어긋나기 쉽습니다. NVIDIA Object-Oriented Agents(NOOA)는 이러한 분열을 줄이기 위해, 모델에 중립적인(model-agnostic) 파이썬 프레임워크로서 에이전트를 하나의 파이썬 객체로 다루는 프로그래밍 모델을 제시합니다. 클래스의 메서드는 모델이 취할 수 있는 행동이고, 필드는 상태이며, 독스트링은 프롬프트로, 타입 어노테이션은 입출력 계약(contract)으로 기능합니다. 본문이 생략 부호(...)인 메서드는 런타임에 대규모 언어 모델(Large Language Model, LLM) 기반 에이전트 루프로 완성되고, 일반 본문을 가진 메서드는 결정적(deterministic) 파이썬으로 그대로 실행되어, 추론과 코드가 한 클래스 정의 안에서 자연스럽게 공존하는 하이브리드 에이전트를 표현할 수 있습니다.
NOOA의 설계 원칙은 에이전트 전용 언어나 그래프 DSL을 새로 만드는 대신, 파이썬에 이미 있는 클래스·상속·타입·독스트링 추상화를 에이전트 사양 자체로 채택하는 데 있습니다. 컨텍스트, 이벤트, 상태 렌더링, 장기 메모리, 검증된 LLM 루프와 같은 에이전트 특화 능력은 self.context, self.events처럼 모델이 호출·참조할 수 있는 Pythonic 하네스 API로 노출되며, 개발자와 에이전트가 동일한 메서드 시그니처를 공유합니다. 그 결과 에이전트 동작은 별도 워크플로 객체가 아니라 일반 소프트웨어 컴포넌트처럼 단위 테스트하고 개선할 수 있게 됩니다.
방법론적으로 NOOA가 하나의 모델 대면(model-facing) 표면에 묶는 핵심 아이디어는 타입이 있는 입출력(typed input/output), 살아있는 객체에 대한 참조 전달(pass-by-reference), 행동을 코드로 수행하는 code as action, @strategy 등으로 루프를 구성하는 programmable loop engineering, 필드로 드러나는 명시적 객체 상태, 그리고 컨텍스트·이벤트용 모델 호출 가능 하네스 API입니다. 예를 들어 프롬프트에는 긴 값이 절단되어 요약본으로만 보이더라도 변수 자체는 절단되지 않으므로, 모델은 execute_python으로 인덱싱·순회하며 전체 라이브 데이터를 다룰 수 있고, 최종 답은 return_result로 참조 전달합니다. Jupyter와 유사한 REPL 세션, PredictStrategy·CodeActStrategy에 의한 하위 과제 분해, 샌드박스형 실행 제약은 이러한 표면을 신뢰 가능하게 유지하기 위한 루프·안전 장치의 역할을 합니다.
이러한 객체 지향 파이썬 표면이 실제 모델에 통용되는지는 표적 능력 테스트와 SWE-bench Verified, Terminal-Bench 2.0, ARC-AGI-3와 같은 코딩·터미널·추상 추론 벤치마크에서의 실증으로 뒷받침됩니다. 즉 NOOA는 도메인별 전용 툴 JSON에 의존하기보다, 타입이 있는 메서드·코드 액션·전략 분해라는 단일 프로그래밍 모델로 다양한 에이전트 과제를 흡수하려는 시도이며, 에이전트 개발을 프롬프트 조립이 아닌 소프트웨어 엔지니어링의 연속선 위에 두고자 하는 점에서 의의가 있습니다.
초록(Abstract)
전통적인 에이전트 개발은 프롬프트 템플릿, 도구 스키마, 콜백 코드, 워크플로 그래프에 분산되어 있습니다. 우리는 신뢰할 수 있는 AI 에이전트를 구축하기 위한 모델 비종속적(model-agnostic) Python 프레임워크인 NVIDIA Object-Oriented Agents(NOOA)를 제시합니다. NOOA는 더 단순한 접근을 취합니다. 에이전트는 Python 객체입니다. 메서드는 모델이 취할 수 있는 행동이고, 필드는 상태이며, docstring은 프롬프트이고, 타입 애노테이션은 계약(contract)입니다. 코드 본문이 "..."로 구성된 메서드는 런타임에 대규모 언어 모델(LLM) 기반 에이전트 루프에 의해 완성되며, 일반 본문을 가진 메서드는 표준적인 결정적(deterministic) Python으로 유지됩니다. 이를 통해 개발자와 에이전트가 동일한 인터페이스를 갖게 되어, 에이전트 동작을 다른 소프트웨어와 마찬가지로 테스트·추적·리팩터링·개선할 수 있습니다. 본 논문은 세 가지 기여를 합니다. (1) 우리는 에이전트를 Python 객체로 보는(agent-as-a-Python-object) 프로그래밍 모델과 그 설계 원칙을 제시합니다. Python에 기존 추상화가 있는 경우 이를 그대로 채택합니다. 에이전트 특화 기능—컨텍스트, 이벤트, 상태 렌더링, 장기 메모리, 검증된 LLM 루프—은 간단한 Pythonic API로 노출되어, 개발자와 에이전트 모두 하나의 친숙한 프로그래밍 모델을 공유합니다. (2) 우리는 NOOA가 단일 표면에서 결합한, 우리 지식으로는 최초인 여섯 가지 모델 대면(model-facing) 아이디어를 식별합니다: 타입이 지정된 입출력, 라이브 객체에 대한 참조 전달(pass-by-reference), 행동을 위한 코드(code as action), 프로그래밍 가능한 루프 엔지니어링, 명시적 객체 상태, 그리고 컨텍스트와 이벤트를 위한 모델 호출 가능 하네스 API. 커뮤니티가 이미 이러한 아이디어 중 여러 가지에—종종 실험적이거나 부분적인 기능으로—수렴하고 있음을 확인하며, 추가 채택을 장려하기 위해 비교를 제시합니다. (3) 우리는 현재 모델들이 이 인터페이스를 효과적으로 사용함을 보여줍니다. 이는 표적 능력 테스트와 SWE-bench Verified, Terminal-Bench 2.0, ARC-AGI-3와 같은 에이전트 및 추론 벤치마크 모두에서 확인됩니다.
Traditional agent development is split across prompt templates, tool schemas, callback code, and workflow graphs. We present NVIDIA Object-Oriented Agents (NOOA), a model-agnostic Python framework for building reliable AI agents. NOOA takes a simpler approach: an agent is a Python object. Its methods are the actions the model can take, fields are its state, docstrings are its prompts, and its type annotations are contracts. A method whose code body consists of "..." is completed at runtime by an LLM-driven agent loop, while methods with normal bodies remain standard deterministic Python. This gives developers and agents the same interface, so agent behavior can be tested, traced, refactored, and improved just like other software. This paper makes three contributions. (1) We present the agent-as-a-Python-object programming model and the design principles behind it. Where Python has existing abstractions, we adopt them directly. Agent-specific capabilities--context, events, state rendering, long-term memory, and validated LLM loops--are exposed through simple Pythonic APIs, so both developers and agents share one familiar programming model. (2) We identify six model-facing ideas that NOOA is, to our knowledge, the first to combine on a single surface: typed input/output, pass-by-reference over live objects, code as action, programmable loop engineering, explicit object state, and model-callable harness APIs for context and events. We find the community already converging on several of these ideas--often as experimental or partial features--and present the comparison to encourage further adoption. (3) We demonstrate that current models use this interface effectively, both in targeted capability tests and on agentic and reasoning benchmarks such as SWE-bench Verified and Terminal-Bench 2.0 and ARC-AGI-3.
논문 링크
더 읽어보기
Zero-Mem: LLM 에이전트를 위한 제로 토큰 메모리 연산 / Zero-Mem: Zero-Token Memory Operations for LLM Agents
논문 소개
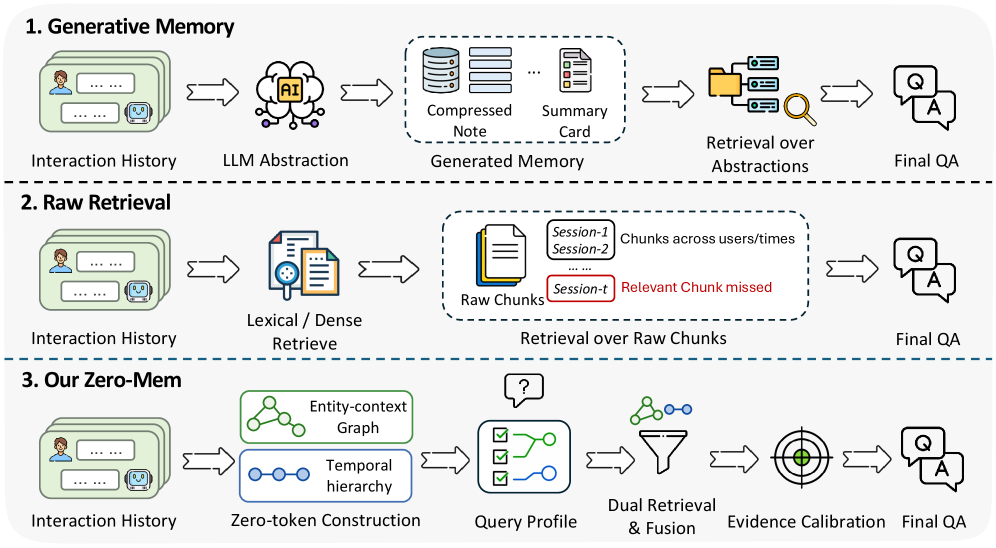
대규모 언어 모델(Large Language Model, LLM) 에이전트가 긴 상호작용을 일관되게 수행하려면 과거 증거를 정확히 되찾는 메모리가 필수적입니다. 그런데 기존 메모리 체계는 요약·반영·그래프 생성 등 중간 기록을 LLM이 직접 만들고 중재하는 경우가 많아, 토큰·시간 비용이 반복적으로 발생하고 원문 증거가 누락되거나 섞일 위험도 따릅니다. Zero-Mem은 최종 질의응답(Question Answering, QA)을 제외한 모든 메모리 단계에서 LLM 호출과 입출력 토큰을 사용하지 않는 zero-token memory operations(제로 토큰 메모리 연산)을 제안하며, 구조화된 메모리 접근에 생성형 중간 표상이 꼭 필요한지 묻습니다. 핵심은 원본 상호작용 기록을 유일한 근거 자료(source of record)로 유지한 채, 생성 없이 두 개의 상호보완적 구조 위에서 증거를 선택하는 것입니다.
구체적으로는 개체–문맥 그래프(entity–context graph)로 상호작용 간 공출현과 인접 관계를 드러내고, 시간 계층(temporal hierarchy)으로 대화의 지역성·세션 상태를 보전합니다. 질의마다 주체·키워드·답변 유형·시간 단서를 담은 가벼운 프로파일로 두 관점의 상대 가중치를 정한 뒤, 그래프 전파와 Personalized PageRank(개인화 페이지랭크), 에피소드–윈도우–턴으로 이어지는 계층 검색을 병행합니다. 이어 이중 관점 융합·증거 폐쇄(evidence closure)로 관계적 다리와 주변 문맥을 보충하고, 결정론적 보정(deterministic calibration)으로 충돌·경계 위반 증거를 걸러 최종 독자(reader)가 원 기록에 근거하도록 합니다. LLM은 오직 최종 QA 독자 단계에서만 호출됩니다.
LoCoMo와 HotpotQA 등 장기 메모리·장문맥 벤치마크에서 Zero-Mem은 동일한 최종 독자와 컨텍스트 예산 하에 경쟁력 있는 성능을 보이면서 메모리 연산의 LLM 토큰을 제거하고, 가장 빠른 비교 기준 대비 메모리 연산 시간을 57.6% 줄였습니다. 절제 실험은 그래프·계층 관점과 질의 의존적 조율, 폐쇄·보정의 기여를 뒷받침하며, 구조화된 에이전트 메모리가 과거를 생성물로 재작성하지 않아도 충분할 수 있음을 보여줍니다.
초록(Abstract)
대규모 언어 모델(LLM) 에이전트는 긴 상호작용에 걸쳐 일관되게 행동하기 위해 메모리가 필요하지만, 많은 시스템은 해당 메모리를 운용하기 위해 추가적인 LLM 호출을 사용합니다. 중간 기록을 생성하고 그 검색을 중재하는 과정은 반복적인 토큰·시간 비용을 유발하며, 세부 정보가 생략되거나 병합되면 원래의 근거가 흐려질 수 있습니다. 본 연구에서는 구조화된 메모리 접근에 과연 생성이 필요한지를 묻습니다. Zero-Mem은 \emph{제로 토큰 메모리 연산}을 도입합니다. 즉, 최종 질의응답을 제외한 어떤 단계에서도 LLM을 호출하지 않으며 LLM 입력·출력 토큰을 소비하지 않고, 인코더 연산은 별도로 집계합니다. Zero-Mem은 원본 상호작용 트레이스를 기록의 원천으로 보존합니다. 이 트레이스는 상호 보완적인 두 가지 방식으로 조직됩니다. 개체–컨텍스트 그래프는 상호작용 간의 연결을 드러내고, 시간적 계층구조는 대화의 국소성과 세션 상태를 보존합니다. 각 쿼리에 대해 Zero-Mem은 두 관점을 가중합하여 양쪽에서 검색하고, 그 구조를 따라 근거가 되는 관계나 주변 컨텍스트를 복원합니다. 결정적 보정(calibration)은 먼저 상충하는 증거를 제거하고, 이어서 리더(reader)의 답이 검색된 트레이스에 그라운딩되도록 유지합니다. LLM을 호출하는 것은 최종 질의응답 리더뿐입니다. 장기 메모리 및 장문 컨텍스트 질의응답 벤치마크에서 Zero-Mem은 메모리 연산의 LLM 호출과 LLM 토큰 소비를 제거하면서도 경쟁력 있는 성능을 달성합니다. 동일한 최종 질의응답 리더와 컨텍스트 예산에서, Zero-Mem은 비교 대상 중 가장 빠른 베이스라인 대비 메모리 연산 시간 비용을 57.6% 절감합니다. 제거 실험(ablation)은 두 관점과 쿼리 의존적 조정의 기여를 뒷받침합니다. 종합하면, 이 결과는 구조화된 에이전트 메모리가 과거의 중간 표현을 생성할 필요가 없음을 보여줍니다. 동료 심사 이후, 코드와 구현 세부사항은 \textcolor{blue}{GitHub - Zero-Mem/Zero-mem · GitHub}에서 공개될 예정입니다.
LLM agents need memory to act consistently over long interactions, yet many systems use additional LLM calls to operate that memory. Generating intermediate records and mediating their retrieval adds recurring token and time costs, while omitted or merged details can obscure the original evidence. We ask whether structured memory access requires generation at all. Zero-Mem introduces \emph{zero-token memory operations}: no step outside final question answering invokes an LLM or consumes LLM input or output tokens; encoder computation is accounted for separately. Zero-Mem preserves original interaction traces as its source of record. It organizes the traces in two complementary ways. An entity--context graph exposes connections across interactions, while a temporal hierarchy preserves conversational locality and session state. For each query, Zero-Mem weighs the two views, retrieves from both, and follows their structure to recover supporting relations or surrounding context. Deterministic calibration first discards conflicting evidence and then keeps the reader's answer grounded in the retrieved traces. Only the final-QA reader invokes an LLM. Across long-memory and long-context question-answering benchmarks, Zero-Mem achieves competitive performance while eliminating LLM calls and LLM-token consumption from memory operations. With the same final-QA reader and context budget, it reduces memory-operation time cost by 57.6% relative to the fastest compared baseline. Ablations support the contribution of the two views and their query-dependent coordination. Overall, the results show that structured agent memory need not generate an intermediate representation of the past. After peer review, the code and implementation details will be available at \textcolor{blue}{GitHub - Zero-Mem/Zero-mem · GitHub}.
논문 링크
더 읽어보기
Continual Harness: 자기 개선형 파운데이션 에이전트를 위한 온라인 적응 / Continual Harness: Online Adaptation for Self-Improving Foundation Agents
논문 소개
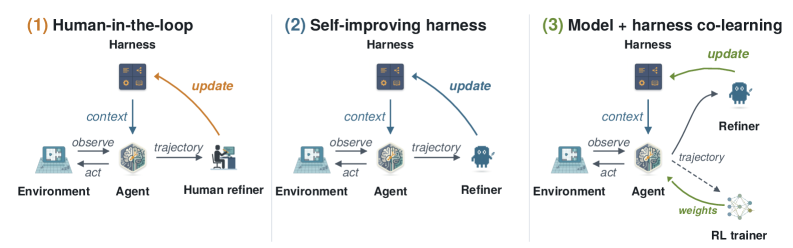
코딩용 에이전틱 하네스(agentic harness)가 Claude Code나 OpenHands처럼 도구·메모리·기획으로 파운데이션 모델(foundation model)을 감싸며 성공한 것과 달리, 장기 호라이즌과 부분 관측이 지배하는 엠보디드(embodied) 의사결정에는 동등한 인프라가 거의 없었습니다. Gemini Plays Pokémon(GPP) 실험은 이 공백을 인간-인-더-루프(human-in-the-loop) 하네스 정제로 메우며, Pokémon Blue, Yellow Legacy 하드 모드, Crystal(무패전)을 클리어한 최초의 AI 시스템으로서 하네스 설계 자체가 성능의 병목일 수 있음을 empirically 보여 주었습니다. 특히 어려운 구간에서 모델이 롱컨텍스트 메모리(long-context memory)로 전략을 스스로 반복 개선한 창발적 신호는, 이후 Continual Harness가 형식화·자동화할 핵심 관찰이 되었습니다.
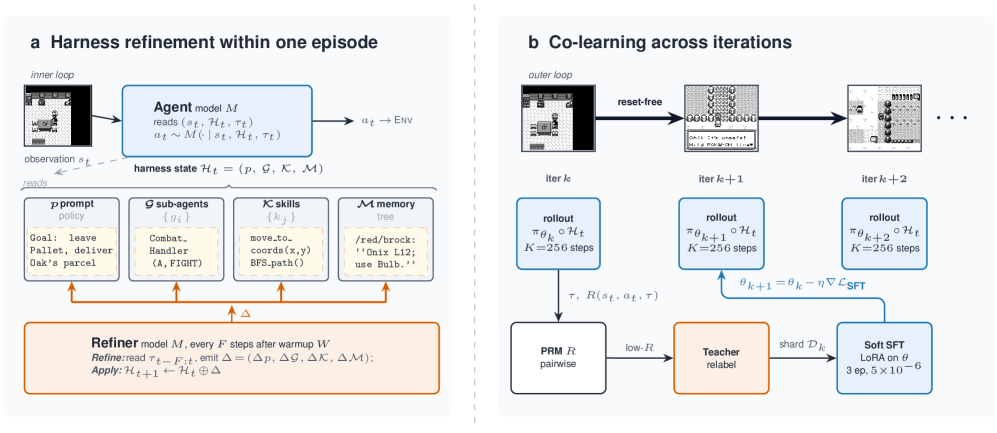
Continual Harness는 프레임 관측, 가시 영역의 ASCII(American Standard Code for Information Interchange) 텍스트 맵, 버튼 입력으로 이루어진 최소 환경 인터페이스만으로 시작해, 에피소드 리셋 없이 단일 런 안에서 행동과 하네스 정제를 교대하는 리셋-프리 온라인 적응 프레임워크입니다. 매 F 스텝마다 Refiner가 최근 궤적의 실패 시그니처를 읽고, 시스템 프롬프트·서브에이전트·스킬 라이브러리·메모리에 대해 네 패스의 CRUD(Create, Read, Update, Delete) 편집을 적용합니다. GEPA와 같이 완전 에피소드를 돌린 뒤 리셋하는 프롬프트 최적화와 달리, 에피소드 중간 업데이트로 문맥 내 학습(In-Context Learning, ICL)을 이어가므로 장기 엠보디드 롤아웃에 자연스럽게 맞습니다.
Pokémon Red와 Emerald에서 Gemini 3 Pro·Flash·Flash-Lite를 대상으로 한 평가에서는, 큐레이션된 지식·수작업 도구·도메인 스캐폴딩 없이도 미니멀리스트 베이스라인 대비 버튼 입력 비용을 크게 줄이고 수동 전문가 하네스와의 격차 상당 부분을 회복했습니다. 다만 비용–완료 Pareto 평면에서 이득은 모델 능력에 조건화되어, Pro에서는 강한 우세가, Flash-Lite에서는 능력 하한(capability floor) 아래로 부트스트랩이 실패하는 양상이 관측되었습니다. 나아가 오픈소스 Gemma-4 롤아웃을 프로세스 보상 모델(process reward model)로 점수화하고 저보상 구간을 프론티어 교사가 재라벨링한 뒤 soft SFT(Supervised Fine-Tuning)로 갱신하는 온라인 공동학습 루프는, 환경 상태를 리셋하지 않은 채 Red에서 인게임 마일스톤 진전을 지속시켰습니다. 이처럼 Continual Harness는 하네스 자동 구축과 모델–하네스 공진화를 하나의 리셋-프리 제어 루프로 묶어, 엠보디드 에이전트 연구에서 스캐폴딩을 수동 설계가 아닌 온라인 자기개선의 대상으로 재정의한다는 점에서 의 있습니다.
초록(Abstract)
Claude Code와 OpenHands와 같은 코딩 하네스는 파운데이션 모델을 도구, 메모리, 계획으로 감싸지만, 체화형 에이전트의 장기 지평·부분 관측성 의사결정에 상응하는 것은 존재하지 않는다. 우리는 먼저 Gemini Plays Pokemon(GPP) 실험 결과를 보고한다. 반복적인 휴먼-인더루프 하네스 개선을 통해 GPP는 Pokémon Blue, 하드 모드의 Yellow Legacy, 그리고 전투 패배 없이 Crystal을 클리어한 최초의 AI 시스템이 되었다. 가장 어려운 단계에서는 에이전트 자신이 긴 컨텍스트 메모리를 통해 전략을 반복 개선하기 시작했으며, 휴먼-인더루프 개선과 함께 창발적 자기 개선 신호가 드러났다. Continual Harness는 이 루프에서 인간을 완전히 제거한다. 이는 우리가 관찰한 바를 형식화하고 자동화하는, 체화형 에이전트를 위한 리셋 없는 자기 개선 하네스이다. 최소한의 환경 인터페이스만으로 시작하여, 에이전트는 행동과 자체 프롬프트·서브 에이전트·스킬·메모리 개선을 번갈아 수행하며, 과거의 모든 궤적 데이터를 활용한다. 프롬프트 최적화 방법은 에피소드 리셋이 필요하지만, Continual Harness는 단일 실행 내에서 온라인으로 적응한다. 프론티어 모델 전반에 걸쳐 Pokémon Red와 Emerald에서, 처음부터 시작하는 Continual Harness는 최소한주의 베이스라인 대비 버튼 입력 비용을 크게 줄이고, 수작업으로 설계된 전문가 하네스와의 격차 상당 부분을 회복하며, 이는 동일한 원시 인터페이스에서 시작하여 선별된 지식, 수작업 도구, 도메인 스캐폴딩 없이 진행되었음에도 능력에 따라 이득이 달라지는 결과를 보였다. 이어서 모델을 자체적으로 루프에 닫는다. 개선 중인 하네스를 통한 오픈소스 에이전트의 롤아웃을 프론티어 티처가 재라벨링하여 모델 업데이트에 활용하는 온라인 프로세스-보상 공동학습 루프가, 학습 반복 사이에 환경을 리셋하지 않고도 Pokémon Red에서 지속적인 인게임 마일스톤 진전을 이끈다.
Coding harnesses such as Claude Code and OpenHands wrap foundation models with tools, memory, and planning, but no equivalent exists for embodied agents' long-horizon partial-observability decision-making. We first report our Gemini Plays Pokemon (GPP) experiments. With iterative human-in-the-loop harness refinement, GPP became the first AI system to complete Pokemon Blue, Yellow Legacy on hard mode, and Crystal without a lost battle. In the hardest stages, the agent itself began iterating on its strategy through long-context memory, surfacing emergent self-improvement signals alongside human-in-the-loop refinement. Continual Harness removes the human fully from this loop: a reset-free self-improving harness for embodied agents that formalizes and automates what we observed. Starting from only a minimal environment interface, the agent alternates between acting and refining its own prompt, sub-agents, skills, and memory, drawing on any past trajectory data. Prompt-optimization methods require episode resets; Continual Harness adapts online within a single run. On Pokemon Red and Emerald across frontier models, Continual Harness starting from scratch substantially reduces button-press cost relative to the minimalist baseline and recovers a majority of the gap to a hand-engineered expert harness, with capability-dependent gains, despite starting from the same raw interface with no curated knowledge, no hand-crafted tools, and no domain scaffolding. We then close the loop with the model itself: an online process-reward co-learning loop, in which an open-source agent's rollouts through the refining harness are relabeled by a frontier teacher and used to update the model, drives sustained in-game milestone progress on Pokemon Red without resetting the environment between training iterations.
논문 링크
더 읽어보기
추론으로서의 검색: LLM-Wiki를 통한 자가진화 에이전트 네이티브 검색 / Retrieval as Reasoning: Self-Evolving Agent-Native Retrieval via LLM-Wiki
논문 소개
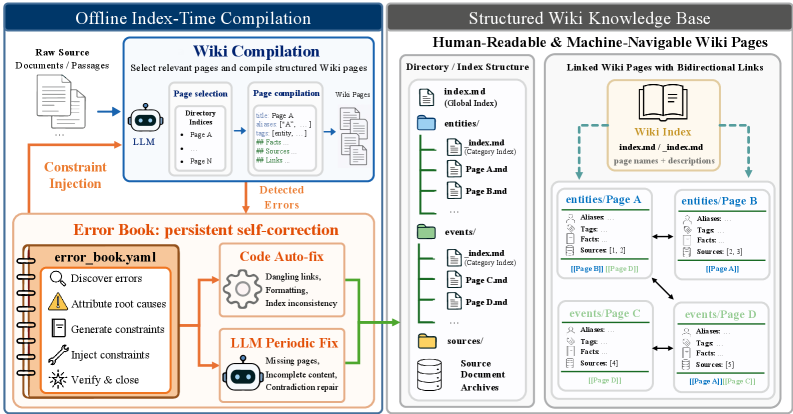
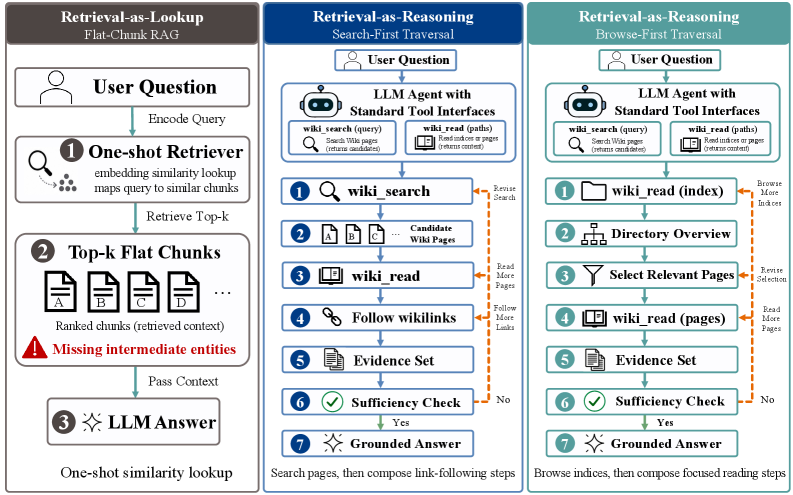
대규모 언어 모델(Large Language Model, LLM) 에이전트가 복잡한 지식집약 질문에 답하려면, 검색은 고정된 문단을 한 번에 가져와 소비하는 단순 조회가 아니라 증거를 찾고 읽고 관계를 따라가며 충분성을 판단하는 추론 과정이어야 합니다. 기존의 검색-증강 생성(Retrieval-Augmented Generation, RAG)은 외부 지식을 임베딩 유사도로 꺼내는 평평한 청크(flat chunks)로 조직화하여 retrieval-as-lookup 인터페이스를 만들며, 이는 중간 엔티티를 추적하거나 교차 문서 관계를 구성적으로 따라가야 하는 멀티홉(multi-hop) 추론에 구조적으로 취약합니다. 예를 들어 영화 비교에서 감독 식별, 생년 비교로 이어지는 질의처럼 중간 증거가 원 질의와 의미적으로 멀어지면 dense retrieval은 핵심 페이지를 놓치기 쉽고, 병목은 순위 함수만이 아니라 지식이 조직·노출되는 방식에 있습니다.
이러한 한계를 넘어서기 위해 Retrieval-as-Reasoning 패러다임이 제안됩니다. 이 관점에서 검색은 계획 수립, 증거 검사, 중간 관찰에 따른 경로 수정, 증거가 충분할 때의 중지가 결합된 구성적(compositional) 추론이며, 지식 API는 에이전트가 제어할 수 있는 연산으로 열려 있어야 합니다. LLM-Wiki는 이 패러다임을 운영화한 에이전트-네이티브(agent-native) 검색 시스템으로, 원문 문서를 양방향 링크가 있는 구조화된 Wiki 페이지로 컴파일하고, search·read·link-following·충분성 점검(sufficiency-checking)을 표준 도구 호출(tool-calling)로 노출하며, Error Book을 통해 구조적·의미적 오류를 탐지·귀속·재사용 제약으로 축적해 지식 표면을 자기진화적으로 유지합니다. RAPTOR, GraphRAG, HippoRAG 2, LightRAG 등이 요약·트리플·엔티티 인덱스로 검색을 부분적으로 강화한 데 비해, LLM-Wiki의 차별점은 그래프나 LLM 사용 여부 자체가 아니라 인간이 감사할 수 있는(human-auditable) Wiki 표면을 에이전트가 순회 가능한 연산으로 열려 있게 만든다는 점에 있습니다.
평평한 청크가 검색을 매칭으로 축소하고, 검색을 단일샷 블랙박스로 고정하며, 컴파일된 지식 기반(Knowledge Base, KB)의 자기수정 루프를 약화시킨다는 세 한계는 각각 Wiki 컴파일, 에이전트 제어 순회, Error Book에 대응합니다. HotpotQA, MuSiQue, 2WikiMultiHopQA에서 HippoRAG 2, LightRAG, GraphRAG 대비 2.0–8.1 F1의 향상이 보고되며, AuthTrace에서는 전체 정확도 최고와 함께 다중 문서 구조화 질의에서의 강점이 확인되어, 컴파일 기반 검색이 체인형 멀티홉을 넘어 일반화됨을 시사합니다. 결국 LLM-Wiki는 지식집약 QA의 해법을 더 나은 top-k 조회가 아니라 컴파일·순회·자기교정이 가능한 지식 인터페이스로 재설정하며, 에이전트 추론이 깊어질수록 그 구조적 이점이 더욱 분명해짐을 보여줍니다.
초록(Abstract)
대규모 언어 모델(LLM) 에이전트는 검색이 일회성 컨텍스트 가져오기(one-shot context fetching)가 아니라 추론처럼 동작하기를 요구한다. 즉 검색하고, 읽고, 탐색하며, 증거가 충분한지 판단하는 과정이 필요하다. 그러나 현재의 검색-증강 생성(Retrieval-Augmented Generation, RAG) 시스템은 외부 지식을 임베딩 유사도로 검색하는 평면적 청크로 구성하여, 반복적 추론 에이전트에 적합하지 않은 조회형 검색(retrieval-as-lookup) 인터페이스를 제공한다. 본 논문은 외부 지식을 정적 검색 인덱스가 아니라 컴파일 가능하고 조합 가능하며 스스로 진화하는 구조로 취급함으로써 Retrieval-as-Reasoning 패러다임을 구현하는 에이전트 네이티브 검색 시스템인 LLM-Wiki를 제안한다. LLM-Wiki는 문서를 양방향 링크를 가진 구조화된 Wiki 페이지로 컴파일하고, 표준 도구 호출(tool-calling) 인터페이스를 통해 검색·읽기·링크 추적 연산을 제공하며, 지속적인 구조적·의미적 자기 수정을 위한 Error Book을 도입한다. LLM-Wiki는 HotpotQA, MuSiQue, 2WikiMultiHopQA에서 최고 수준의 성능을 달성하며, HippoRAG 2, LightRAG, GraphRAG를 2.0–8.1 F1 포인트 앞선다. AuthTrace에서는 LLM-Wiki가 전체 정확도에서 최고 성능을 보이며, 특히 다중 문서 구조화 질의에서 두드러진 향상을 나타내어, 컴파일 기반 검색이 체인 형태의 다중 홉(multi-hop) 추론을 넘어 일반화됨을 확인한다.
LLM agents require retrieval to behave less like one-shot context fetching and more like reasoning: searching, reading, traversing, and deciding when evidence is sufficient. Yet current Retrieval-Augmented Generation (RAG) systems organize external knowledge as flat chunks retrieved by embedding similarity, exposing a retrieval-as-lookup interface ill-suited to iterative reasoning agents. We propose LLM-Wiki, an agent-native retrieval system that operationalizes the Retrieval-as-Reasoning paradigm by treating external knowledge as a compilable, composable, and self-evolving structure rather than a static retrieval index. LLM-Wiki compiles documents into structured Wiki pages with bidirectional links, exposes search, read, and link-following operations through standard tool-calling interfaces, and introduces an Error Book for persistent structural and semantic self-correction. LLM-Wiki achieves state-of-the-art results on HotpotQA, MuSiQue, and 2WikiMultiHopQA, outperforming HippoRAG 2, LightRAG, and GraphRAG by 2.0-8.1 F1 points. On AuthTrace, LLM-Wiki achieves the best overall accuracy, with especially strong gains on multi-document structured queries, confirming that compilation-based retrieval generalizes beyond chain-style multi-hop reasoning.
논문 링크
DataSpace: 이기종 워크스페이스에서 검증 가능한 분석을 위한 데이터 에이전트 벤치마킹 / DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces
논문 소개
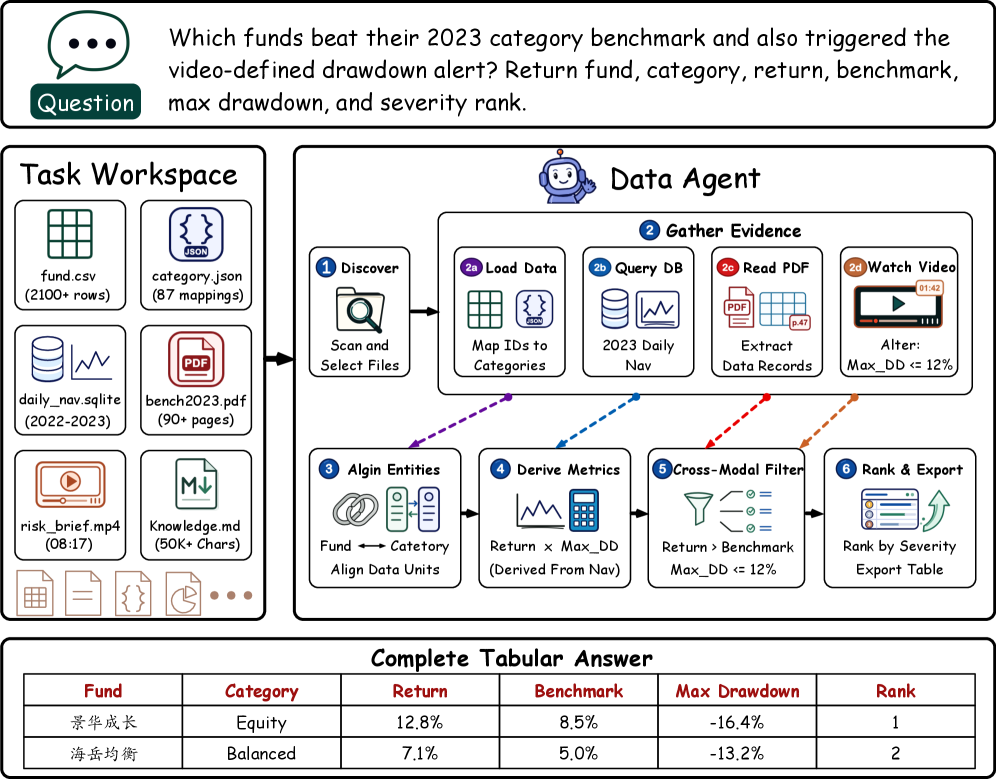
조직 데이터의 자연어 분석에서 필요한 증거는 단일 표나 사전에 지정된 데이터베이스에만 있지 않고, CSV·JSON·SQLite와 같은 구조화 자료, Markdown·PDF 장문서, 비디오 등 이종(heterogeneous) 워크스페이스(workspace)에 흩어져 있는 경우가 많다. DataSpace는 데이터 에이전트(data agent)가 질문과 태스크 로컬(task-local) 워크스페이스만을 입력으로 받아, 증거를 스스로 탐색·정렬·결합한 뒤 사용자가 바로 소비할 수 있는 완전한 표 형태 결과를 제출하도록 요구하는 벤치마크로, 410개의 교차언어(cross-language) 태스크와 7,439개 아티팩트(총 15.01 GB)를 금융·거시경제·헬스케어 도메인에 걸쳐 제공한다. 기존 벤치마크가 구조화 질의, 검색·그라운딩, 개방형 분석을 각각 분리해 다루거나 출력을 factoid·리포트·파이프라인 등으로 제각각 정의한 것과 달리, DataSpace는 워크스페이스 범위, 완전한 표 출력 계약, 결정적 평가라는 세 축을 하나의 설정으로 통합한다.
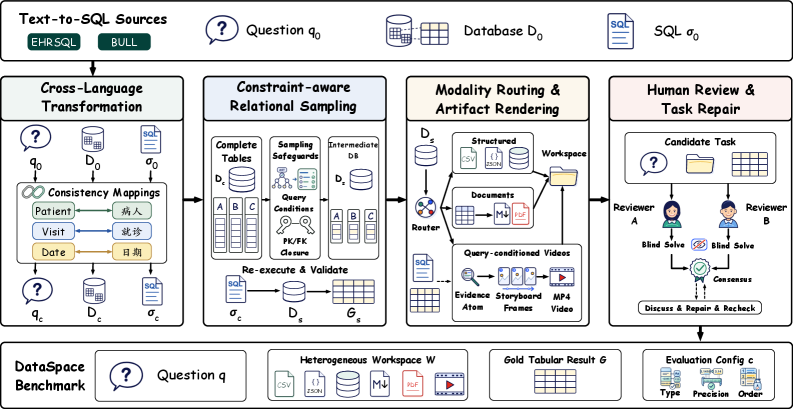
벤치마크 구축의 핵심은 실행 기반 프레임워크 DataSpace-Builder이다. 영어 Text-to-SQL 자원인 EHRSQL과 BULL을 출발점으로, 교차언어 변환(Cross-Language Transformation)에서는 데이터베이스·질문·SQL을 공동 마이그레이션하여 엔티티명·술어값·실행 결과가 어긋나지 않도록 하고, 제약 인식 관계형 샘플링(Constraint-Aware Relational Sampling)으로 키·조인·술어 제약을 보존한 태스크 로컬 테이블 인스턴스를 만든다. 이어 모달리티 라우팅 및 아티팩트 렌더링(Modality Routing & Artifact Rendering)이 테이블을 CSV·JSON·SQLite·Markdown·PDF로 배정하고, 사실 근거(fact-grounded) 문서와 조건·중간값을 담은 비디오를 생성하며, 마지막으로 11명의 도메인 전문가가 블라인드 해결·골드 합의·평가 설정 작성을 통해 태스크를 검수·수정한다. 평가는 헤더 불변 열 정렬, 타입·정밀도 인식 정규화, 순서 인식 행 비교를 수행하는 의미 인식(semantics-aware) 결정적 평가기로 이루어지며, 표기 동등성은 허용하되 불완전하거나 오류인 답은 완전 일치 기준으로 거부한다.
이러한 설계는 에이전트를 단순한 질의응답기가 아니라, 가용 데이터를 조사·선택하고 표현을 정렬하며 다단계 계산 후 완전한 표를 물질화(materialization)하는 워크스페이스 솔버(workspace solver)로 평가하게 한다. 6개 프런티어 멀티모달 모델과 5개 에이전트 하네스(harness) 실험에서 최고 정확도는 66.34%에 그쳤고, 동일 백본에서도 하네스 선택에 따라 15.36%p 격차가 나타났으며, 멀티모달 증거 통합과 조인(join)은 모든 백본에서 일관되게 성능을 떨어뜨렸다. 실패 분석 역시 소스 오선택보다 요청된 출력 스키마로의 정확한 물질화 오류가 더 빈번함을 보여, DataSpace가 아직 포화되지 않은 엄격한 테스트베드이자 KDD Cup 2026 Data Agents for Complex Data Analysis의 공식 평가 기준으로 기능함을 뒷받침한다.
초록(Abstract)
데이터 에이전트는 조직 워크스페이스에 대한 자연어 분석을 가능하게 하며, 관련 증거는 데이터베이스, 구조화된 파일, 긴 문서, 멀티미디어 전반에 흩어져 있을 수 있습니다. 기존 벤치마크는 대체로 구조화된 질의, 검색, 또는 개방형 분석을 서로 분리하여 다루며, 이질적 증거 발견, 완전한 표 형식 출력, 결정적 평가를 충분히 통합하지 못하고 있습니다. 본 논문에서는 데이터 에이전트가 태스크 로컬의 이질적 워크스페이스로부터 검증 가능한 표 형식 결과를 생성하는 벤치마크인 DataSpace를 소개합니다. DataSpace는 CSV, JSON, SQLite, Markdown, PDF, 비디오에 걸쳐 총 15.01GB 규모의 410개 교차 언어 태스크와 7,439개 아티팩트를 포함합니다. DataSpace는 또한 KDD Cup 2026 Data Agents for Complex Data Analysis 대회의 공식 평가 벤치마크로도 사용되었습니다. 각 에이전트는 질문과 워크스페이스만을 받고, 요청된 완전한 표 형식 결과를 반환합니다. 우리는 교차 언어 변환, 제약 조건 인식 관계형 샘플링, 모달리티 라우팅 및 아티팩트 렌더링, 그리고 11명의 도메인 전문가에 의한 인간 검토와 태스크 수정을 포함하는 실행 기반(execution-grounded) 프레임워크인 DataSpace-Builder로 DataSpace를 구축합니다. 결정적 평가기는 헤더 불변 열 정렬, 타입 및 정밀도 인식 정규화, 순서 인식 행 비교를 수행합니다. 최근 공개된 6개의 최첨단 멀티모달 모델과 널리 사용되는 5개의 에이전트 하네스에 걸쳐, 최고 정확도는 66.34%에 달하며, 백본을 고정한 상태에서 하네스 선택에 따라 15.36포인트의 차이가 발생합니다. 멀티모달 증거 통합과 조인(join)은 6개 백본 모두에서 일관되게 정확도를 저하시킵니다. 이러한 결과는 DataSpace가 아직 포화되지 않았음을 보여 주며, 데이터 에이전트 신뢰성 향상을 위한 핵심 과제를 제시합니다.
Data agents enable natural-language analytics over organizational workspaces, where relevant evidence may be scattered across databases, structured files, long documents, and multimedia. Existing benchmarks largely isolate structured querying, retrieval, or open-ended analysis, leaving heterogeneous evidence discovery, complete tabular outputs, and deterministic evaluation insufficiently unified. We introduce DataSpace, a benchmark in which data agents produce verifiable tabular results from task-local heterogeneous workspaces. It contains 410 cross-language tasks and 7,439 artifacts totaling 15.01 GB across CSV, JSON, SQLite, Markdown, PDF, and video. DataSpace also served as the official evaluation benchmark for the KDD Cup 2026 Data Agents for Complex Data Analysis competition. Each agent receives only a question and workspace and returns the complete requested tabular result. We construct DataSpace with DataSpace-Builder, an execution-grounded framework comprising cross-language transformation, constraint-aware relational sampling, modality routing and artifact rendering, and human review and task repair by 11 domain experts. A deterministic evaluator performs header-invariant column alignment, type- and precision-aware normalization, and order-aware row comparison. Across six recently released frontier multimodal models and five widely used agent harnesses, the best accuracy reaches 66.34%, while harness choice creates a 15.36-point spread with the backbone fixed. Multimodal evidence integration and joins consistently reduce accuracy across all six backbones. These results show that DataSpace remains unsaturated and identify key challenges for improving data-agent reliability.
논문 링크
대규모 언어 모델이 테이블형 예측에 실패하는 이유 / Why Large Language Models Fail at Tabular Prediction
논문 소개
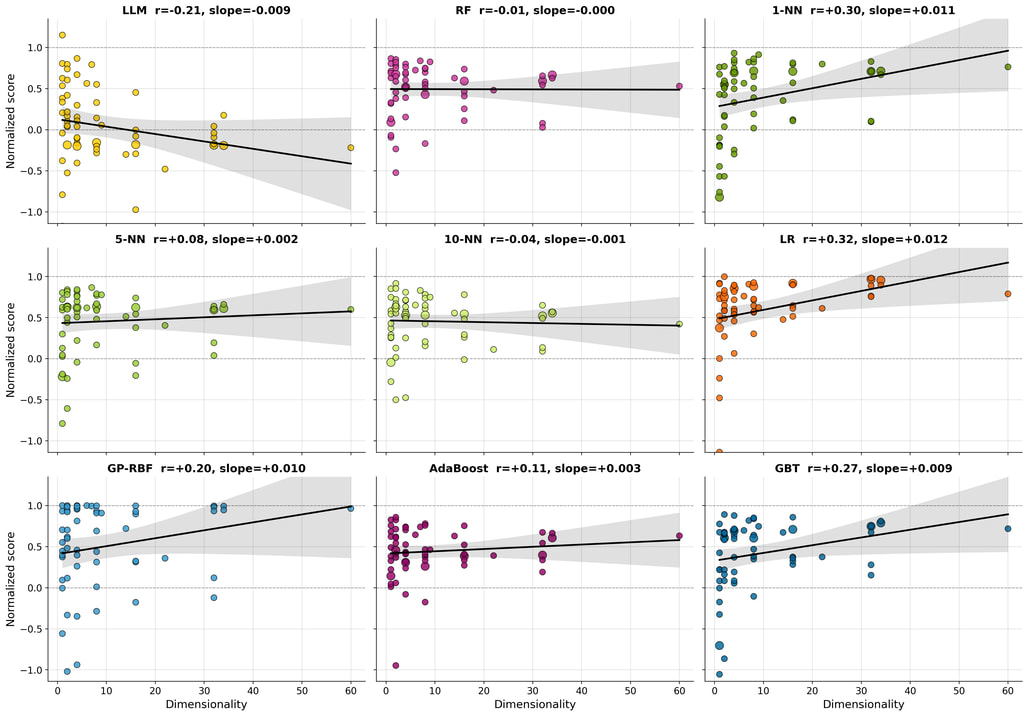
대규모 언어 모델(Large Language Model, LLM)은 다양한 과제에서 기본 도구처럼 쓰이지만, 표 형식 데이터에 대한 예측 분석에서는 고전적인 기계학습 기법에 비해 뚜렷한 성공을 보이지 못했습니다. 표 데이터 전용 파운데이션 모델(tabular foundation model) 연구가 빠르게 성장하는 배경에도, 일반적인 LLM이 왜 이 과제에서 실패하는지는 충분히 해명되지 않은 채 남아 있었습니다. 본 연구는 도구 호출, 에이전트형 스캐폴딩(agentic scaffolding), 파인튜닝 없이 학습 데이터와 테스트 데이터를 모두 담은 프롬프트에 대해 한 번의 생성으로 예측하는 순수 추론 설정에서 최신 LLM을 평가하고, 실패 원인에 대한 다섯 가지 가설을 체계적으로 검증합니다. 가설은 각각 노이즈가 많거나 선형 분리가 어려운 데이터에 대한 처리 능력 부족, 열 구조를 흐리게 만드는 선형화된 CSV(comma-separated values) 형식, 수치 토큰화(tokenisation)의 부작용, 질의당 분류하는 테스트 샘플 수, 그리고 입력 차원수로 구성됩니다. 통제 실험 결과 앞의 네 가설은 기각되었고, 결정적인 요인은 차원수로 나타났습니다. 서른한 개 벤치마크 데이터셋에 무작위 선형 투영(random linear projection)을 적용해 차원을 변화시키면, 비교한 아홉 가지 방법 중 LLM만이 차원이 커질수록 정확도가 떨어졌고, 고전 베이스라인은 성능이 유지되거나 오히려 향상되었습니다. 이백오십이 개 설정의 고전 모델과의 행동 비교에서는, 이차원에서는 LLM의 예측이 거리 기반의 국소적 방법과 최대 91.6%까지 격자 일치도를 보이지만, 고차원에서는 차원에 의존하는 노이즈를 맞춘 고전 학습기로도 그 예측 패턴을 재현할 수 없었습니다. 저자들은 내부 메커니즘을 규명했다고 주장하지는 않으며, 보다 겸손하게 LLM의 표 예측 능력이 차원 증가와 함께 무너지는 방식이 노이즈로 손상된 어떤 고전 학습기로도 모사되지 않는다는 점을 보여줍니다. 이러한 결과는 LLM이 다른 영역에서는 뛰어난 성능을 보이면서도 표 데이터에서는 수십 년 된 베이스라인에 지속적으로 밀리는 현상을 설명하는 실증적 근거를 제시하며, 구체적인 예측 메커니즘의 규명은 후속 연구의 과제로 남겨 둡니다.
초록(Abstract)
대규모 언어 모델(LLM)은 놀라울 정도로 다양한 과제에서 기본 도구가 되었지만, 가장 흔한 머신러닝 워크로드 중 하나인 표 형식 데이터에 대한 예측 분석에서는 눈에 띄게 거의 성공하지 못했다. 이 간극은 빠르게 성장하는 표 형식 파운데이션 모델 분야의 출발점이 되었으나, 범용 LLM이 왜 실패하는지에 대한 질문은 여전히 열려 있다. 우리는 최전선 LLM을 가장 순수한 추론 체제에서 연구한다. 즉, 전체 학습 및 테스트 데이터를 담은 프롬프트에 대한 단일 생성 패스이며, 도구도, 에이전트 스캐폴딩도, 파인튜닝도 없는 상태에서, 실패에 대한 다섯 가지 가설을 체계적으로 평가한다. (a) 잡음이 있거나 선형 분리가 불가능한 데이터를 다루지 못함; (b) 선형화된 CSV 형식이 열 구조를 가림; (c) 수치 값의 토큰화; (d) 쿼리당 분류되는 테스트 점의 수; (e) 입력의 차원. 통제 실험은 (a)–(d)를 반증한다. 반면 차원은 결정적이다. 31개 벤치마크 데이터셋의 무작위 선형 투영을 스윕했을 때, LLM은 비교한 아홉 가지 방법 중 차원이 커질수록 정확도가 감소하는 유일한 방법이며, 모든 고전적 베이스라인은 평탄하거나 오히려 향상된다. 252개로 구성된 고전 모델과의 행동 비교에서, 2차원에서는 LLM이 국소적·거리 기반 방법처럼 예측한다(격자 일치도 최대 91.6%). 그러나 고차원에서는 고전 모델 중 어느 것도—튜닝된 차원 의존 잡음으로 증강하더라도—그 예측을 재현하지 못한다. 우리는 내부 메커니즘을 규명했다고 주장하지 않는다. 우리의 결과는 보다 겸손하게, LLM의 능력이 어떤 잡음 오염된 고전 학습기도 흉내 내지 못하는 방식으로 차원과 함께 소멸함을 보여 준다. 이는 다른 곳에서는 그토록 유능한 LLM이 표에서는 50년 된 베이스라인에 계속 지는 이유를 설명하면서도, 그 예측의 메커니즘은 열린 질문으로 남긴다.
Large language models (LLMs) have become the default tool for a remarkable range of tasks, yet they have had conspicuously little success at one of the most common machine learning workloads: predictive analytics over tabular data. This gap is the founding premise of the fast-growing field of tabular foundation models, but the question of why generic LLMs fail has remained open. We study a frontier LLM in its purest inference regime - a single generation pass over a prompt containing the full training and test data, with no tools, no agentic scaffolding, and no fine-tuning - and systematically evaluate five hypotheses for the failure: (a) an inability to handle noisy or non-linearly-separable data; (b) the linearised CSV format obscuring column structure; (c) the tokenisation of numeric values; (d) the number of test points classified per query; and (e) the dimensionality of the input. Controlled experiments falsify (a)-(d). Dimensionality, in contrast, is decisive: sweeping random linear projections of thirty-one benchmark datasets, the LLM is the only method among nine whose accuracy decreases as dimensionality grows, while every classical baseline stays flat or improves. A behavioural comparison against 252 configured classical models finds that in two dimensions the LLM predicts like a local, distance-based method (up to 91.6% grid agreement), but in higher dimensions no classical model - even when augmented with tuned, dimension-dependent noise - reproduces its predictions. We do not claim to have identified the internal mechanism; our results show, more modestly, that the LLM's capability dissolves with dimension in a way no noise-corrupted classical learner mimics - which explains why LLMs, so capable elsewhere, keep losing to fifty-year-old baselines on tables, while leaving the mechanism of the prediction as an open question.
논문 링크
Harness-R1: 에이전트 실패 궤적으로부터 실행 가능한 런타임 하네스 편집 학습 / Harness-R1: Learning to Edit Executable Runtime Harnesses from Agent Failure Trajectories
논문 소개
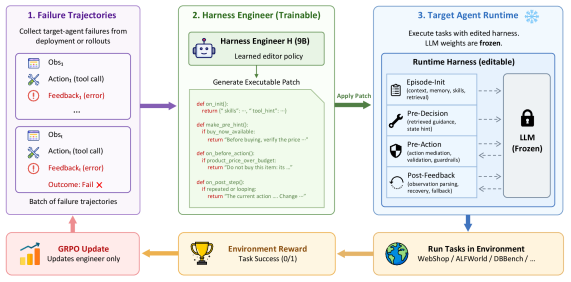
대규모 언어 모델(LLM, Large Language Model) 기반 에이전트는 배포 과정에서 관찰·행동·피드백을 담은 상호작용 궤적을 계속 쌓지만, 그 경험을 이후 개선에 충분히 활용하지 못하는 경우가 많습니다. 모델 가중치를 직접 갱신하는 경로와 별도로, 컨텍스트 구성, 도구 중개, 행동 검증, 실행 복구를 담당하는 에이전트 하네스(agent harness), 즉 실행 가능 런타임(runtime)을 최적화하면 동일 모델에서도 성능이 크게 달라질 수 있습니다. 기존 하네스 진화 연구는 프롬프트·도구·메모리 등을 공동 편집하더라도 제안자(proposer) 자체는 대개 고정된 채 후보만 선택·정제하는 한계가 있었고, 고정 규칙형 Self-Refine 같은 전략은 오히려 보상을 떨어뜨리기도 했습니다. Harness-R1은 실패에 조건화된(failure-conditioned), 생애주기 전반에 걸친(lifecycle-wide) 기존 실행 런타임 편집을 전용 하네스 엔지니어(harness engineer)의 학습된 능력으로 정식화한 최초의 방법에 해당합니다.
방법론의 핵심은 타깃 에이전트를 동결(frozen)한 채, 분리된 9B 엔지니어만 결과 기반(outcome-grounded)으로 사후학습한다는 점입니다. 비수정 타깃을 과제 배치에 돌려 실패 에피소드만을 압축한 실패 패킷을 만들고, 엔지니어는 이로부터 검증된 실행 가능 패치(executable patch)를 생성합니다. 패치는 에피소드 초기화, 결정 전(pre-decision), 행동 전(pre-action), 피드백 후(post-feedback)의 네 생애주기 훅에 개입하며, 설치 후 동일 배치를 재실행하여 얻은 성능 변화가 엔지니어의 보상(reward)이 됩니다. 학습은 강한 교사가 제안하고 재실행으로 걸러낸 유효 패치로 콜드스타트 지도 파인튜닝(SFT, Supervised Fine-Tuning)을 수행한 뒤, 그룹-상대 정책 최적화(GRPO, Group-Relative Policy Optimization)로 후보 패치의 실현된 과제 효용을 온라인 최적화하는 이단계로 진행됩니다.
이러한 설계는 “그럴듯한 편집”과 “실제로 과제 성공을 올리는 편집”을 분리하여, 텍스트 형식이나 고정 에디터의 제안이 아니라 재실행으로 관측된 이득에 편집 정책을 맞춥니다. WebShop, ALFWorld, DBBench에서 vanilla Qwen3.5-9B의 평균 성공률을 44.3%에서 53.6%로(+9.3%p) 끌어올렸고, 결과 기반 학습은 지도만 수행한 엔지니어보다 평균 +7.1%p 우세하며, 프런티어 모델을 고정 에디터로 쓰는 방식보다도 안정적이었습니다. 타깃을 직접 파인튜닝한 뒤에도 타깃 특화 엔지니어가 평균을 59.2%에서 64.2%로(+5.0%p) 추가 개선하여, 하네스 편집이 액터 개선에 쉽게 포화되지 않음을 보여줍니다. 아울러 학습에 쓰지 않은 타깃 모델과 held-out 과제에도 이득이 전이되어, 하네스 구성이 가중치 갱신을 보완하는 학습 가능 능력으로, 엔지니어와 타깃 에이전트의 공진화(co-evolution)를 열어 주는 실용적 경로임을 시사합니다.
초록(Abstract)
대규모 언어 모델(LLM)을 중심으로 구축된 에이전트는 배포 과정에서 상호작용 궤적을 지속적으로 축적하지만, 그 행동은 일반적으로 고정된 채로 유지된다. 모델 가중치 업데이트 외에도, 이러한 궤적은 컨텍스트를 구성하고, 도구를 중재하며, 행동을 검증하고, 실행을 복구하는 에이전트 하네스(harness)를 개선하는 데 활용될 수 있다. 우리는 기존 실행 가능 런타임에 대한 실패 조건부·생애주기 전반의 편집을 학습된 능력으로 만드는, 우리 지식 범위 내에서 최초의 방법인 Harness-R1을 소개한다. 이 방법은 전용 하네스 엔지니어를 온라인 강화학습(RL)으로 사후학습하여, 편집이 고정된 편집기가 제안하는 방식이 아니라 실제로 달성한 과제 성공에 최적화되도록 한다. 별도의 9B 엔지니어가 대상 에이전트의 실패 배치를 검증된 실행 가능 패치로 변환하며, 동결된 대상을 동일 배치로 새로 재실행하여 결과 보상을 제공하므로, 학습 업데이트는 엔지니어에만 적용된다. 콜드스타트 지도 파인튜닝으로 이 편집 정책을 초기화한 뒤, 그룹 상대 정책 최적화(group-relative policy optimization)로 온라인 학습한다. WebShop, ALFWorld, DBBench에서 Harness-R1은 바닐라 Qwen3.5-9B의 성공률을 44.3%에서 53.6%로 끌어올렸다(+9.3%p). 대상 에이전트를 직접 파인튜닝한 후에는, 대상-특화 엔지니어가 평균을 59.2%에서 64.2%로 추가로 향상시켰다(+5.0%p). 이러한 이득이 대상 파인튜닝 전과 후에 모두 유지되므로, Harness-R1은 하네스 엔지니어와 대상 에이전트의 공동 진화를 시사한다.
Agents built around large language models continually accumulate interaction trajectories during deployment, yet their behavior typically remains fixed. Beyond updating model weights, these trajectories can improve the agent harness that constructs context, mediates tools, validates actions, and recovers execution. We introduce Harness-R1, the first method, to our knowledge, that makes failure-conditioned, lifecycle-wide editing of an existing executable runtime a learned capability. It post-trains a dedicated harness engineer with online reinforcement learning so that its edits are optimized for the realized task success they produce, rather than proposed by a fixed editor. A separate 9B engineer converts batches of target-agent failures into validated executable patches; fresh same-batch reruns of the frozen target provide outcome rewards, so training updates only the engineer. Cold-start supervised fine-tuning initializes this editing policy, which is then trained online with group-relative policy optimization. Across WebShop, ALFWorld, and DBBench, Harness-R1 raises vanilla Qwen3.5-9B success from 44.3% to 53.6% (+9.3 percentage points). After direct target-agent fine-tuning, a target-specific engineer raises the average further from 59.2% to 64.2% (+5.0 points); because these gains hold both before and after fine-tuning the target, Harness-R1 points toward co-evolving the harness engineer and the target agent.
논문 링크
더 읽어보기
AI 벤치마크가 정체될 때: 벤치마크 포화에 대한 체계적 연구 / When AI Benchmarks Plateau: A Systematic Study of Benchmark Saturation
논문 소개
인공지능(artificial intelligence) 벤치마크는 모델의 진전을 측정하고 배포 결정을 안내하는 핵심 장치이지만, 성능이 상한에 가까워지는 포화(saturation) 현상이 빠르게 나타나면 모델 간 변별력이 약해지고 평가 도구로서의 장기적 가치가 감소합니다. 본 연구는 이러한 문제를 체계적으로 다루기 위해 벤치마크 포화를 명확히 정의한 뒤, 언어 모델(language model) 벤치마크 60개를 포화와 관련된 14개 속성과 함께 비교·분석합니다. 목적은 개별 벤치마크의 성공·실패를 단편적으로 논하는 데 그치지 않고, 어떤 설계 선택이 포화에 대한 회복력(resilience)을 높이는지를 경험적으로 밝혀 더 오래 쓸 수 있는 평가 체계를 안내하는 데 있습니다.
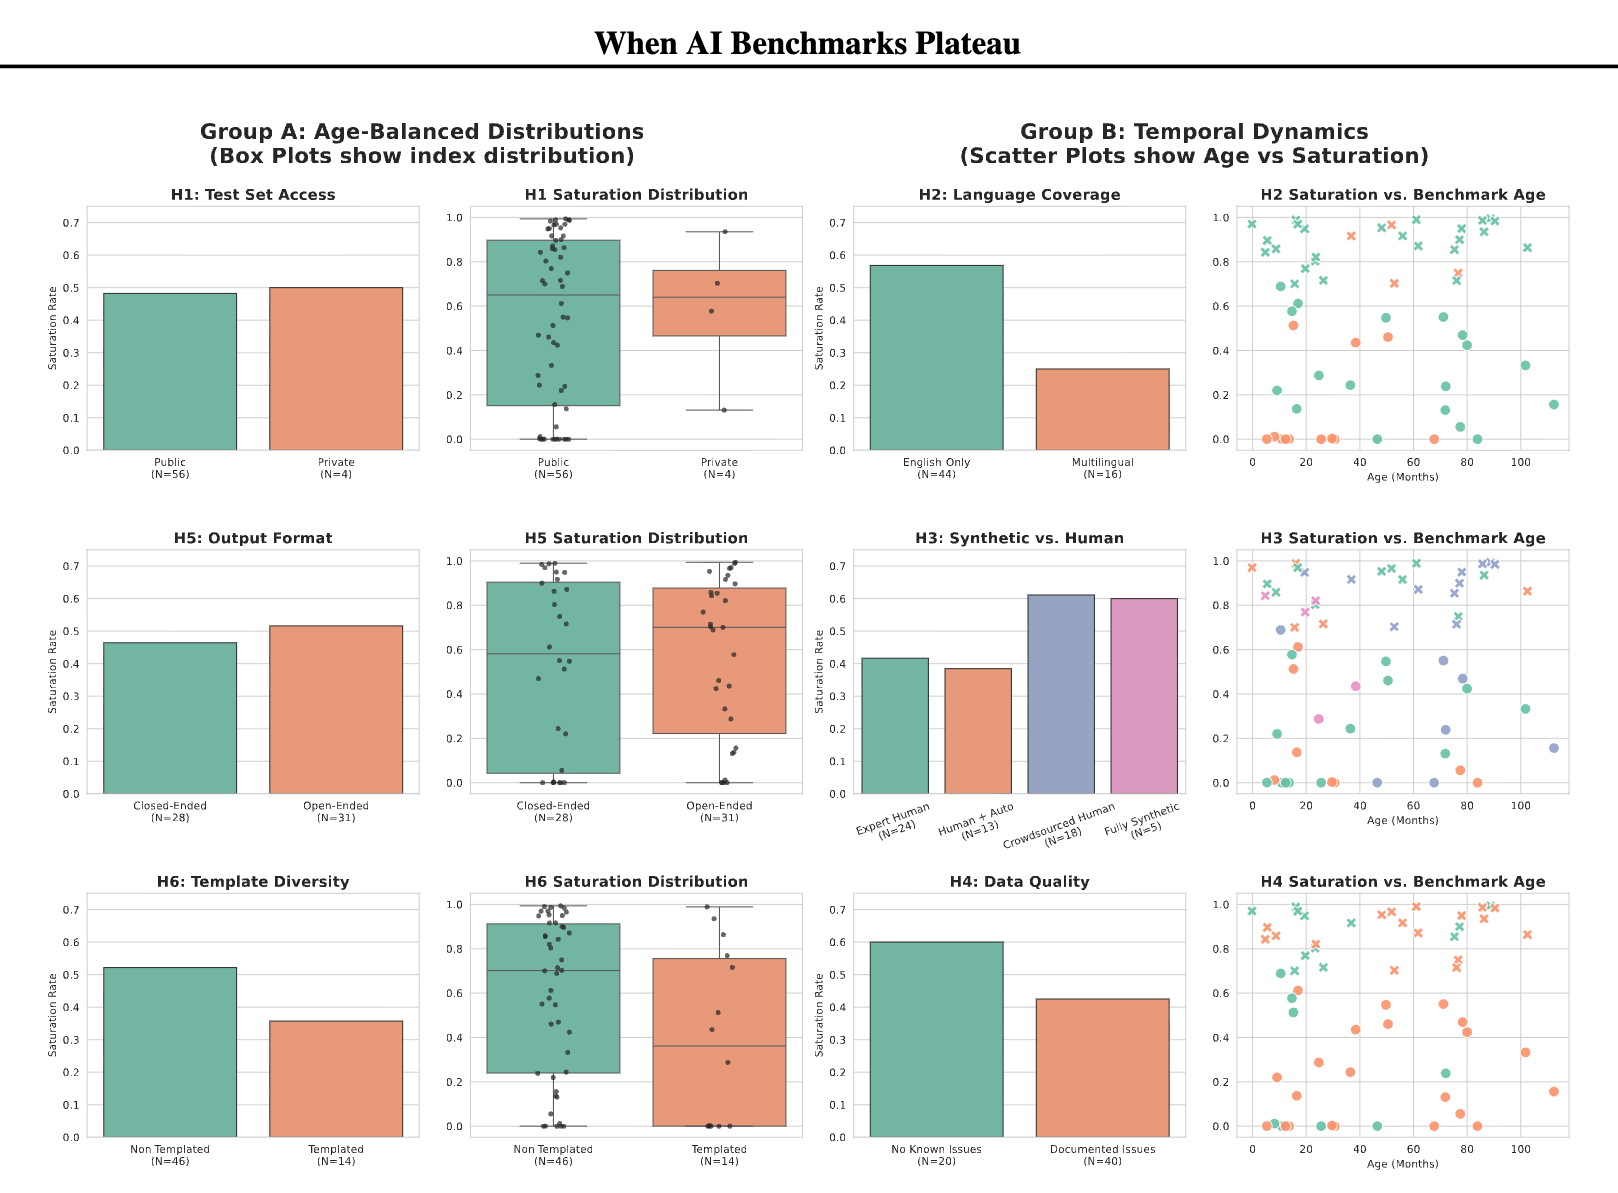
분석 결과, 연구 대상의 약 절반이 이미 포화를 보이며, 벤치마크의 나이가 증가할수록 포화 비율도 함께 높아지는 경향이 관찰됩니다. 특히 포화에 대한 내성은 전문가 큐레이션(expert-curation)의 영향을 받는 반면, 테스트 데이터의 공개 여부는 핵심 요인으로 나타나지 않았다는 점은 통념과 어긋나는 중요한 시사점입니다. 즉, 단순한 비공개 전략만으로는 평가의 수명을 보장하기 어렵고, 문항 구성·난이도 설계·전문가 검수와 같은 큐레이션 품질이 변별력을 더 오래 유지하는 데 실질적으로 기여할 수 있음을 시사합니다.
이러한 접근은 AI 평가가 ‘한때의 순위표’를 넘어 ‘지속 가능한 측정 인프라’로 기능해야 한다는 넓은 연구 맥락과도 맞닿아 있습니다. 벤치마크가 빠르게 상한에 도달하면 연구 방향 설정과 안전한 도입 판단이 모두 왜곡될 수 있으므로, 포화를 사후 문제로 다루기보다 설계 단계에서부터 고려하는 관점이 필요합니다. 본 연구의 기여는 포화를 정의하고 대규모 벤치마크 집합에서 관련 속성을 체계적으로 대조함으로써, 어떤 설계 선택이 평가의 수명을 연장하는지를 실증적으로 제시하고, 이후의 더 견고한 평가 방법론을 위한 근거를 마련한 데 있습니다.
초록(Abstract)
인공지능 벤치마크는 모델의 진전을 측정하고 배포 결정을 안내하는 중요한 메커니즘입니다. 그러나 벤치마크는 빠르게 “포화(saturate)”되어 모델 간 차별화가 어려워지고 장기적 가치가 감소합니다. 본 연구에서는 벤치마크 포화를 정의하고, 포화와 관련된 14가지 속성을 사용해 60개의 언어 모델 벤치마크에 걸쳐 이를 분석합니다. 그 결과, 분석 대상 벤치마크의 거의 절반이 포화를 보이며, 포화 비율은 벤치마크의 연한이 길어질수록 증가합니다. 또한 포화에 대한 회복력은 공개 테스트 데이터가 아니라 전문가 큐레이션의 영향을 받는다는 점을 확인합니다. 본 결과는 설계 선택이 벤치마크의 수명을 연장할 수 있으며, 보다 지속 가능한 평가 접근법에 대한 시사점을 제공함을 보여줍니다.
Artificial intelligence benchmarks are an important mechanism for measuring model progress and guiding deployment decisions. However, benchmarks quickly "saturate", making it difficult to differentiate models and diminishing their long-term value. In this study, we define benchmark saturation and analyze it across 60 language model benchmarks using 14 properties that relate to saturation. We find that nearly half of the our benchmarks exhibit saturation, with rates increasing with age. Further, we find that resilience to saturation is impacted by expert-curation, not by public test data. Our results suggest that design choices can extend benchmark longevity and inform more durable evaluation approaches.
논문 링크
더 읽어보기
진화하는 사회 규범을 위한 AI 가치 정렬 / AI Value Alignment for Evolving Social Norms
논문 소개
진화하는 사회 규범 속에서 개인화된 AI 어시스턴트가 일상화될 때, 가치 정렬(value alignment)은 단순한 선호 일치 문제를 넘어 집단 수준의 장기 동역학을 좌우하는 사회기술적 문제로 재정의된다. 기존 접근이 인간 피드백 강화학습(Reinforcement Learning from Human Feedback, RLHF)을 통해 선호 모델과 실제 선호 사이의 발산을 줄이는 데 초점을 두었다면, 본 연구는 가치와 선호가 시간·문화·맥락에 따라 변한다는 전제 아래, 사용자와 AI에 내장된 가치 모델이 서로 끌어당기며 공진화하는 과정을 사회물리학(social physics) 기반의 수학적 모델링 프레임워크로 정식화한다. 프레임워크는 사용자–AI 쌍 집단을 환경 드리프트와 규범 쇼크가 존재하는 연속 가치 공간에 두고, 정렬 강도(alignment strength) \alpha, AI 학습률 \lambda, 사회적 영향, 환경 학습, 탐색 가중치를 체계적으로 변화시키며 거시적 규범 진화를 추적한다. 이때 AI 정렬 항은 Friedkin–Johnsen 의견 동역학의 완고함 앵커와 구조적으로 유사하나, 고정된 초기 의견이 아니라 지연을 두고 사용자를 추적하는 이동 앵커로 작동한다는 점에서 핵심적 차이를 갖는다. 해석적 평균장 분석과 에이전트 기반 시뮬레이션을 병행한 결과, 정적·강한 정렬은 AI 모델이 저역 통과 필터(low-pass filter)처럼 역사적 가치를 평활화·보존하게 만들어 환경 변화에 대한 구조적 지연과 부적응 갭(maladaptation gap)을 키우며, 갑작스런 규범 쇼크 이후의 회복도 크게 늦춘다. 이처럼 사용자를 과거 선호에 묶어 두는 가치 고착(value lock-in)과, 강한 사회적 결합이 하위문화 다양성을 소실시키는 규범적 모드 붕괴(normative mode collapse)는 특히 비적응적(non-adaptive) 정렬에서 두드러지는 실패 모드로 확인된다. 반면 AI 학습률을 높여 가치 모델의 최신성을 유지하거나, 인간 환경 학습이 AI 영향을 압도할 수 있게 설계하면 이러한 고착 위험이 완화되며, “정렬이 강할수록 항상 좋다”는 직관은 동적 규범 환경에서 성립하지 않음이 드러난다. 이에 따라 실무 정렬은 시간적으로 동적이고, 맥락에 민감하며, 추론 능력을 갖추고, 사용자의 에이전시(agency)를 보존하는 방향으로 진화해야 한다는 규범적·설계적 함의가 도출된다. 방법론적으로 이 사회물리학 모형은 계산 비용이 큰 대규모 언어 모델(Large Language Model, LLM) 멀티에이전트 평가에 앞서 파라미터 공간의 취약 영역을 빠르게 지도화하는 인식론적 다리(epistemic bridge)이자, 사회기술 foresight를 위한 다루기 쉬운 전구체로 제안된다.
초록(Abstract)
AI 정렬(AI alignment)은 고도화된 AI 시스템의 안전한 배포에 필수적입니다. 가치와 선호가 시간·문화·사회적 역할·맥락에 따라 변화한다는 점을 감안할 때, 특히 개인화된 AI 어시스턴트가 미래에 광범위하게 사용될 가능성을 고려하여 AI 정렬의 가능한 장기적 결과에 대한 이해를 더욱 심화할 필요가 있습니다. 본 연구는 사회물리학(social physics)에 기반한 유연하고 확장 가능한 수학적 모델링 프레임워크를 도입하며, AI의 빈번한 사용을 전제로 인간 집단에서 진화하는 사회적 규범에 관한 거시적 질문에 답하는 것을 목표로 합니다. 분석은 부분적으로 해석적(analytical)이고 부분적으로 시뮬레이션 기반이며, 다양한 초기 가정 하에서의 장기적 동역학적 결과를 특성화할 수 있게 합니다. 우리는 비적응적 정렬 공식화에서 두드러지게 나타나는 가치 록인(value lock-in)과 규범적 모드 붕괴(normative mode collapse)의 위험을 강조합니다. 정렬을 넘어, 이러한 사회물리학 모델을 인식론적 다리(epistemic bridge)로 더 널리 채택할 것을 주장합니다. 이는 일반 AI 미래에 대한 사회기술 전망(sociotechnical foresight)에서 신속하고 엄밀하며 정량적으로 근거가 있는 가설 검증을 가능하게 하고, 계산 비용이 더 큰 대규모 에이전트 평가의 실현 가능한 전구체 역할을 합니다.
AI alignment is essential for the safe deployment of advanced AI systems. Given that values and preferences change over time, culture, social roles, and context, we need to develop a better understanding of the possible long-term consequences of AI alignment, in particular considering the likely ubiquitous future use of personalized AI assistants. We introduce a flexible and extensible mathematical modelling framework, rooted in social physics, aimed at answering macro-level questions regarding the evolving social norms in human populations under the assumption of frequent AI use. Our analysis is part-analytical, and part-simulation, enabling us to characterize the long-term dynamical consequences under a diverse set of starting assumptions. We highlight the risk of value lock-in, and normative mode collapse, prominently featured in non-adaptive alignment formulations. Beyond alignment, we advocate for the wider adoption of these kinds of social physics models as an epistemic bridge: enabling rapid, rigorous, and quantitatively-grounded hypothesis testing for sociotechnical foresight in general AI futures, and acting as a tractable precursor to more computationally expensive large-scale agentic evaluations.
논문 링크
에이전틱 컨텍스트 관리: 에이전트 메모리와 비용을 라이프사이클 및 아키텍처 문제로 다루어 해결하기 / Agentic Context Management: Solving Agent Memory and Cost by Treating Them as Lifecycle and Architecture Problems
논문 소개
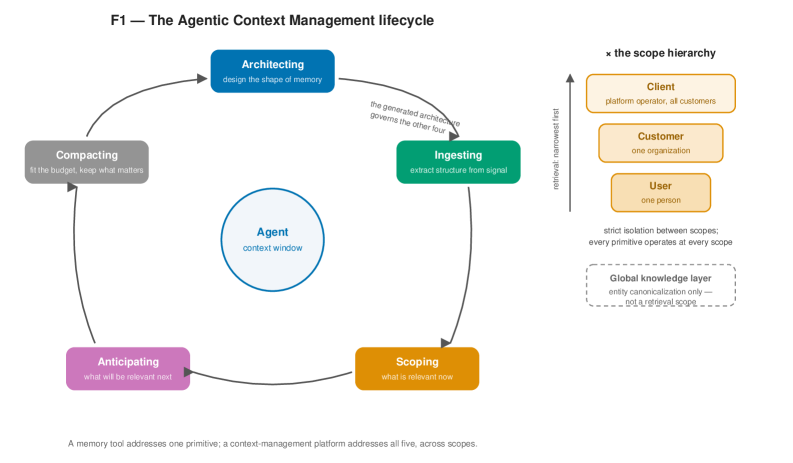
프로덕션 AI 에이전트의 실패는 추론 능력의 한계보다, 대화 이력·대형 프롬프트·도구 정의·팽창하는 도구 출력을 컨텍스트 윈도우에 담는 과정에서 생기는 규율 부재에 더 가깝다. 기존 생태계는 이를 사실을 넣고 꺼내는 저장·검색(storage and retrieval) 문제로 다루지만, 턴마다 내려야 하는 결정은 무엇을 남길지, 어떤 구조로 남길지, 이번 턴에 무엇을 넣을지, 다음 턴이 무엇을 필요로 할지, 예산을 넘으면 어떻게 줄일지에 걸쳐 있다. 에이전틱 컨텍스트 관리(Agentic Context Management, ACM)는 이 결정을 라이프사이클·아키텍처 문제로 재정의하고, 아키텍처 설계(architecting), 수집(ingesting), 스코프 설정(scoping), 예상(anticipating), 압축·통합(compacting and consolidation)이라는 다섯 원시 연산으로 분해한다. 한 연산만 강한 시스템은 메모리 도구에 머물고, 다섯을 사용자(user)·고객 조직(customer)·플랫폼 운영자(client) 스코프 계층과 전역 지식 계층 위에서 일관되게 다루는 시스템이 컨텍스트 관리 플랫폼이 된다.
방법론의 핵심은 연산 간 결합이다. 에이전트 연결 시 목적 설명으로부터 범주·보존·압축 정책을 합성하는 architecting이 이후 수집·검색·압축 행동을 규율하고, ingesting은 원시 신호를 사실·선호·에피소드·시간적 사건 등으로 구조화해 검색 품질의 상한을 높인다. scoping은 가장 좁은 스코프부터 해석하며 엄격 격리를 유지하고, anticipating은 투기적 프리페치(speculative prefetching)로 명시 요청 전에 컨텍스트를 준비해 임계 경로 지연을 줄인다. compacting은 검증 점수와 압축비를 보고 실패 시 덜 공격적으로 재시도하는 검증된 압축(validated compaction) 으로, 조악한 요약이 만드는 정확도 절벽과 컨텍스트 붕괴를 피한다. 경제적으로는 전체 이력 추가(full-append)가 대화 길이에 대해 이차(O(n^{2})) 토큰 비용을 내고, 검증 압축만이 선형 비용과 충실도를 동시에 달성한다. 참조 구현 Maximem Synap은 비동기 수집, 하이브리드(의미·관계) 검색, 스코프 인식 조립을 멀티테넌트 서비스로 구현해 LongMemEval 92%, LoCoMo 93.2%를 보고하며, 남은 전선으로 지연시간·토큰 효율·컨텍스트 부패(context-rot) 저항성과 의사결정·조직 수준 컨텍스트를 제시한다.
초록(Abstract)
프로덕션 AI 에이전트의 실패는 추론을 잘하지 못해서라기보다, 추론 컨텍스트에 담긴 내용—대화 이력, 대용량 프롬프트, 대규모 도구 정의, 급증하는 도구 출력—을 관리하지 못하는 데서 더 자주 비롯된다. 에이전트는 매 턴마다 늘어나는 토큰 비용을 치르며 스스로 누적되는 이력에 빠져들고, 대화 내·대화 간 회상 누락을 초래한다. 기존의 대응은 이를 저장-및-검색 문제로 취급한다. 우리는 이러한 프레이밍이 지나치게 협소하다고 주장한다. 에이전트가 머릿속에 유지하는 내용을 능동적으로 관리하는 것은 단순한 저장소가 아니라 라이프사이클이다. 이는 무엇을 기억할지 결정하고, 추출·구조화하며, 데이터 유형별 적합한 저장소를 선택하고, 출처(provenance)를 보존하면서 통합·망각하며, 지금 관련 있는 것을 판단하고, 다음에 필요한 것을 예측하며, 중요한 정보를 잃지 않으면서 컨텍스트를 예산에 맞게 압축하는 전 과정에 걸쳐 있다. 본격적인 프로덕션 환경에서 이는 단일 사용자가 아니라 조직 범위 계층 전반에 걸쳐 작동한다. 우리는 이 분야를 에이전틱 컨텍스트 관리(Agentic Context Management, ACM)라 명명하고, 아키텍처 설계(architecting), 수집(ingesting), 범위 설정(scoping), 예측(anticipating), 압축 및 통합(compacting & consolidation)의 다섯 가지 프리미티브로 분해한다. 이어서 우리는 경제적 논거를 제시한다. 단순한 컨텍스트 누적은 대화 길이에 대해 토큰 비용이 이차적으로 증가하고, 조잡한 요약은 정확도 급락을 대가로 선형 비용을 얻으며, 검증된 압축만이 충실도를 유지한 채 선형 비용을 달성한다. 우리는 다섯 가지 프리미티브를 멀티테넌트 서비스로 구현한 참조 구현 Maximem Synap을 기술하며, 6절에 상세히 기술된 구성에서 LongMemEval 92%, LoCoMo 93.2%를 보고한다. 마지막으로, 기존 벤치마크가 아직 포착하지 못하는 차원—지연시간, 토큰 효율, 컨텍스트 부패(context-rot) 저항성—과 이 카테고리가 가리키는 의사결정 수준 및 조직 수준 컨텍스트의 프론티어로 글을 맺는다.
Production AI agents' failures are less often due to an inability to reason well and more often because they cannot manage what is in their reasoning context: conversation histories, large prompts, large tool definitions, and ballooning tool outputs. Agents drown in their own accumulating history while paying a token cost that grows every turn, producing missing recalls within and across conversations. The incumbent response treats this as a storage-and-retrieval problem. We argue that framing is too narrow. Actively managing what an agent holds in mind is a lifecycle, not merely a store: it spans deciding what to remember, extracting and structuring it, choosing the right store per data type, consolidating and forgetting while preserving provenance, deciding what is relevant now, anticipating what is needed next, and compacting context to a budget without losing what matters. In serious production this operates not over a single user but across an organizational scope hierarchy. We name this discipline Agentic Context Management (ACM) and decompose it into five primitives: architecting, ingesting, scoping, anticipating, and compacting & consolidation. We then make the economic case: naive context accumulation grows token cost quadratically in conversation length, crude summarization buys linear cost at the price of an accuracy cliff, and only validated compaction achieves linear cost with preserved fidelity. We describe a reference implementation, Maximem Synap, that realizes the five primitives as a multi-tenant service and reports 92% on LongMemEval and 93.2% on LoCoMo under the configuration detailed in Section 6. We close with dimensions existing benchmarks do not yet capture, latency, token efficiency, and context-rot resistance, and the frontier of decision-level and organization-level context the category points toward.
논문 링크
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일 로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 뉴스 발행에 힘이 됩니다~
