PyTorchKR


이번 주 선정된 논문들을 살펴본 결과, 다음과 같은 주요 트렌드를 확인할 수 있었습니다:
 단순 생성을 넘어서는 장기 지평 및 복잡한 과제 해결: 이번 주 선정된 논문들을 살펴보면, 대규모 언어 모델이 단발성 답변을 넘어서 장기간에 걸쳐 복잡한 작업을 수행하는 에이전트로 진화하고 있습니다. 예를 들어, 프라임 에이전트(Prime Agent) 와 하네스 오브 하네스(Harness-of-Harness) 는 코딩 에이전트가 사람의 개입 없이 오랜 시간 동안 소프트웨어를 자율적으로 개발하고 개선할 수 있는 작업 환경을 제안했습니다. 또한 렉-이볼브(RecEvolve) 는 추천 시스템의 아이디어 제안부터 코드 구현 및 평가까지의 연구 전체를 에이전트 시스템에 위임하여 모델 성능을 성공적으로 향상시켰습니다. 이는 인공지능이 복잡하고 호흡이 긴 과제를 독립적으로 완수하는 실질적인 시스템으로 안착하고 있음을 보여줍니다.
 에이전트 역량을 극대화하는 실행 인프라 및 환경 혁신: 모델 자체의 성능뿐만 아니라, 모델 외부의 실행 환경과 인프라를 체계화하고 진화시키려는 연구도 주요 흐름입니다. 터미널 유니버스(Terminal-Universe) 는 기존의 에이전트 실행 기록을 재사용 가능한 실행 환경으로 변환하여 유용한 학습 데이터를 폭넓게 확장하는 방법을 제시했습니다. 더 나아가 하네스데브(HarnessDev) 는 모델이 스스로 실행 가능한 인프라를 만들고 발전시킬 수 있는지를 직접 평가하였습니다. 이와 더불어 스크롤(Scroll) 과 스킬집(SkillZip) 은 방대한 상호작용 기록과 확장 가능한 에이전트 스킬 라이브러리를 효율적으로 관리하는 새로운 접근법을 선보였습니다. 이러한 연구들은 안정적이고 유연한 실행 인프라가 에이전트의 실제 성공을 결정짓는 필수 기반임을 시사합니다.
 자기 개선 능력과 내부 구조에 대한 심도 있는 탐구: 시스템이 스스로 발전하는 방법을 찾거나 그 내부의 동작 구조를 깊게 이해하려는 시도 역시 두드러집니다. 메타엔(Metaⁿ) 은 메타 연산을 고정한 채 입력에 재귀를 적용하는 방식으로, 에이전트가 스스로 개선 과정을 진화시킬 수 있음을 입증했습니다. 또한 인공 신경망의 창발적 기호 구조를 다룬 연구는 연속적인 벡터로 정보를 처리하는 대규모 언어 모델이 내부적으로는 산술이나 논리 같은 기호적 구조를 근사하고 있음을 실증했습니다. 자율주행 영역의 큐원-드라이브-1.0(Qwen-Drive-1.0) 도 사전학습된 언어 모델의 구조를 유지하면서 외부 인식 헤드를 결합해 전문 지식을 효과적으로 통합했습니다. 이러한 결과들은 모델이 단순히 외부 과제를 수행하는 것을 넘어, 자신을 최적화하고 복잡한 구조를 내재화하는 방향으로 발전하고 있음을 보여줍니다.
논문별 핵심 내용 간략 요약
-
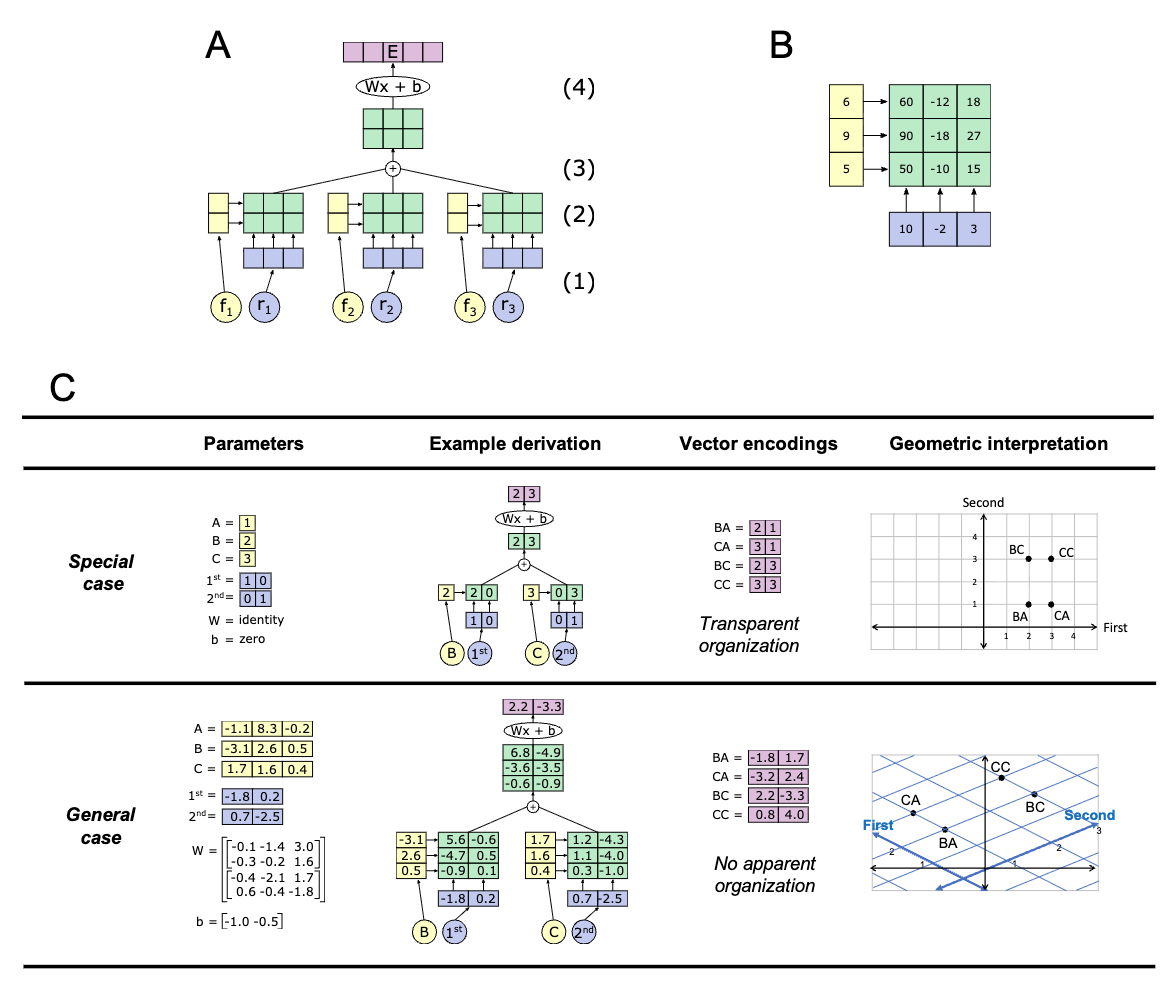
인공 신경망의 창발적 기호 구조: 대규모 언어 모델과 같은 신경망이 벡터 기반의 연속적 연산을 수행함에도 불구하고 내부적으로는 논리나 산술과 같은 기호적 구조를 근사하여 처리하고 있음을 체계적으로 검증했습니다.
-
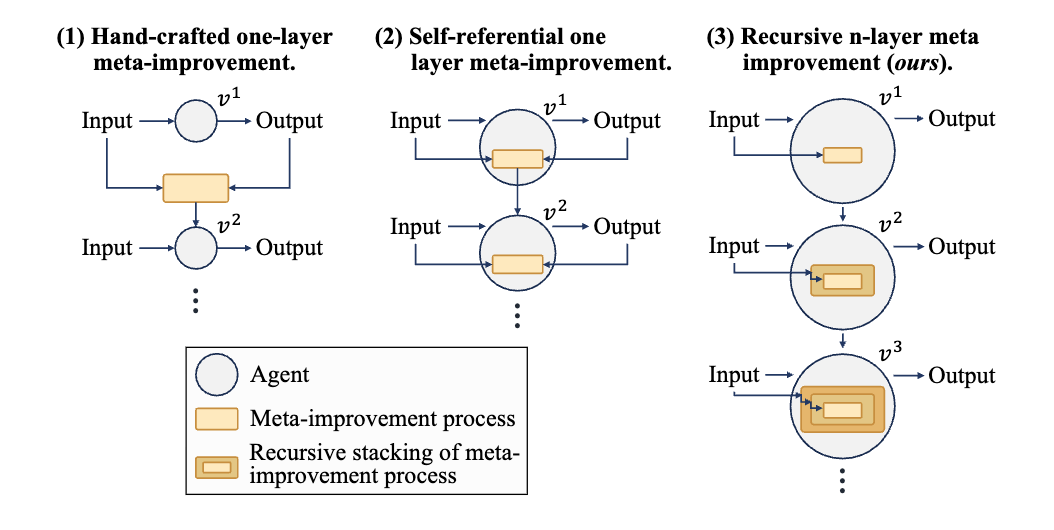
Metaⁿ: 에이전트가 답변뿐만 아니라 개선 과정 자체를 향상시킬 수 있도록, 단일 메타 연산을 고정하고 입력에 재귀를 적용하여 시스템 안정성을 유지하며 고차원적인 추론을 가능하게 했습니다.
-
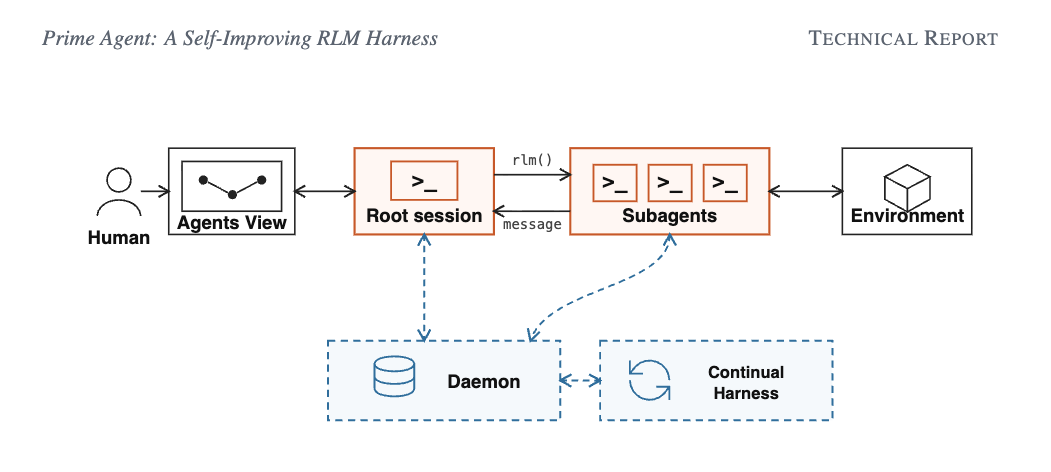
Prime Agent: 긴 호흡이 필요한 코딩 및 추론 과제에서 에이전트가 외부 연산과 정보를 효율적으로 다룰 수 있도록 영구적인 실행 환경과 서브에이전트 통신 체계를 갖춘 오픈소스 프레임워크를 제안했습니다.
-
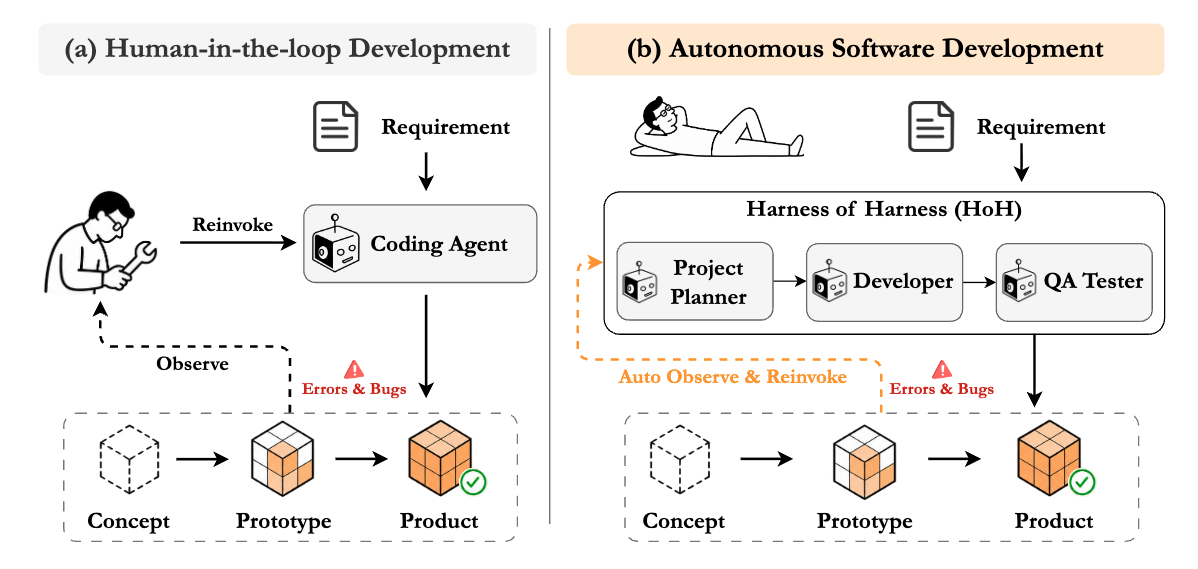
Harness-of-Harness: 코딩 에이전트가 사람의 개입 없이 완전한 소프트웨어를 개발할 수 있도록, 기존 실행 환경을 수정하지 않고 계획부터 테스트까지 반복적인 루프로 조직화하여 지속적인 품질 개선을 달성했습니다.
-
Scroll: 장기 실행 에이전트의 방대한 상호작용 기록을 고정된 메모리로 압축하는 대신, 실행 가능한 세션 환경과 코드로 관리하여 정보 손실 없이 효율적으로 컨텍스트를 다루는 방법을 제시했습니다.
-
HarnessDev: 언어 모델이 단순히 주어진 작업을 수행하는 것을 넘어, 자신을 실행할 인프라와 환경을 스스로 설계하고 지속적으로 진화시킬 수 있는지를 측정하는 새로운 평가 지표를 도입했습니다.
-
Qwen-Drive-1.0: 자율주행을 위해 시각 및 언어 이해 역량을 갖춘 기존 파운데이션 모델의 구조를 유지한 채, 외부 인식 모듈과 플래닝 전문가 모듈을 결합하여 3D 인식과 모션 플래닝을 효과적으로 통합했습니다.
-
Terminal-Universe: 터미널 기반 에이전트가 남긴 일회성 실행 궤적을 재사용 가능한 환경으로 역변환하여, 새로운 태스크를 합성하고 유용한 학습 데이터를 대규모로 구축하는 프레임워크를 제안했습니다.
-
SkillZip: 확장 가능한 에이전트 스킬 라이브러리에서 제한된 컨텍스트 예산을 효율적으로 사용하기 위해, 재사용 단위를 절차적 계약 기반의 그래프로 변환하고 압축하여 실행 가능성을 유지하는 방법을 소개했습니다.
-
RecEvolve: 대규모 추천 시스템의 성능 개선을 위해 아이디어 제안부터 코드 구현, 오프라인 학습 및 평가까지의 연구 전체 과정을 지식 기반 자율 에이전트 시스템에 위임하여 유의미한 성능 향상을 이끌어냈습니다.
인공 신경망의 창발적 기호 구조 / The Emergent Symbolic Structure of Artificial Neural Networks
논문 소개
전통적으로 지능은 논리식과 같은 기호의 구조적 결합으로 이해되어 왔으나, 현대 인공지능의 핵심인 신경망은 정보를 연속 벡터로 표현합니다. 그럼에도 신경망은 언어, 논리, 코드와 같이 기호적 구조가 중심인 영역에서 뛰어난 성능을 보이며, 벡터 표현만으로 이러한 구조적 인지 능력을 어떻게 구현하는지가 오랫동안 미해결 문제로 남아 있었습니다. 본 연구는 신경망의 내부 표현이 겉보기와 달리 암묵적으로 기호 구조를 실현한다는 가설을 제기하고, 그 구조를 선형 변환된 텐서 곱 표현(Tensor Product Representations, TPRs)으로 근사할 수 있음을 체계적으로 검증합니다. 핵심 방법론은 네트워크가 표현을 생성하는 전 과정을 기호 구조를 인스턴스화하는 닫힌 형식의 방정식으로 대체하는 것이며, 이 근사 후에도 모델 행동이 대체로 유지된다는 점이 중요한 근거가 됩니다. 이러한 결과는 리스트 조작을 학습한 소규모 신경망뿐 아니라, 산술, 논리, 컴퓨터 코드, 언어라는 기호 전통의 네 가지 핵심 영역에서 동작하는 대규모 언어 모델(Large Language Models, LLMs)에서도 일관되게 관찰되어, 기호 구조의 창발이 특정 모델이나 과제에 국한되지 않는 일반적 특성임을 시사합니다. 나아가 연구진은 식별된 기호 구조에 대한 정밀한 내부 표현 개입을 통해 LLM의 행동을 목표에 맞게 수정할 수 있음을 보여, 해당 구조가 단순한 상관적 패턴이 아니라 모델 행동에 필수적인 인과적 기반임을 입증합니다. 인지과학적 관점에서 이 결과는 기호를 인지 이론에서 제거할 수 있다는 제거주의(eliminativism)보다, 신경망이 기호 체계를 정확히 구현하기보다는 근사적으로 다가간다는 제한적 관점(limitivism)을 지지합니다. 동시에 신경망이 조합적 표현을 가질 수 있음에도 훈련에서 접하지 못한 새로운 조합에 일반화하지 못하는 한계는, 표현 구조의 존재와 조합 일반화 능력 사이에 중요한 간극이 있음을 드러냅니다. 종합하면, 본 연구는 기호주의적 지능 개념과 벡터 기반 현대 AI 사이의 오랜 긴장을 해소할 수 있는 실증적 경로를 제시하며, DISCOVER와 같은 TPR 기반 분석 틀을 확장해 기울기 기호 시스템(Gradient Symbol Systems)의 관점에서 신경망의 조합 구조 생성·처리·학습 과정을 규명할 필요성을 열어 둡니다.
초록(Abstract)
현대 인공지능(AI) 시스템은 언뜻 보기에 적합하지 않은 영역에서도 뛰어난 성능을 보입니다. 전통적으로 지능은 논리식과 같은 기호의 구조화된 조합 위에서 작동하는 것으로 모형화되어 왔습니다. 그러나 오늘날 가장 강력한 AI 시스템은 신경망에 기반하며, 신경망은 정보를 연속 벡터로 표현합니다. 벡터는 언어, 논리 및 기타 인지 영역의 구조를 포착하기에 부적절해 보이지만, 신경망은 이러한 영역에서 인상적인 성능을 달성합니다. 신경망은 어떻게 이를 해내는 것일까요? 본 연구에서는 하나의 가능한 답을 제안합니다. 겉보기와 달리, 신경망의 내부 표현이 암묵적으로 기호적 구조를 실현하고 있을 수 있다는 것입니다. 이 가설을 뒷받침하기 위해, 다양한 신경망의 벡터 표현이 기호적 구조로 밀접하게 근사될 수 있음을 보입니다. 즉, 네트워크의 전체 표현 생성 과정을 기호적 구조를 구현하는 닫힌 형식 방정식으로 대체해도 네트워크의 행동은 대체로 변하지 않습니다. 이 결과는 리스트를 조작하도록 학습된 소규모 신경망뿐 아니라, 기호적 전통에서 핵심적인 네 영역—산술, 논리, 컴퓨터 코드, 언어—에서 동작하는 대규모 언어 모델(LLM)에도 성립합니다. 나아가, 우리의 기호적 근사는 LLM의 내부 표현에 대한 정밀한 개입을 통해 LLM의 행동을 표적화된 방식으로 수정할 수 있게 하며, 이는 LLM의 행동이 우리가 식별한 기호적 구조에 의존함을 보여줍니다. 본 연구는 지능에 대한 오랜 기호주의적 관점과 현대 AI의 벡터 기반 특성을 조화시킬 수 있는 하나의 가능한 경로를 제시합니다.
Modern systems in artificial intelligence (AI) somehow excel in domains for which they seem poorly suited. Intelligence has traditionally been modeled as operating over structured combinations of symbols, such as logical formulas. However, the strongest modern AI systems are based on neural networks, which instead represent information in continuous vectors. Vectors seem inadequate for capturing the structure of language, logic, and other cognitive domains, yet neural networks achieve impressive performance in these areas. How do they do it? In this work, we propose a potential answer: Despite appearances, perhaps the internal representations of neural networks implicitly realize symbolic structure. In support of this hypothesis, we show that the vector representations of a variety of neural networks can be closely approximated with symbolic structures: we can replace the network's entire representation-generating process with a closed-form equation instantiating a symbolic structure, and the network's behavior remains largely unchanged. This finding holds for both small-scale neural networks trained to manipulate lists as well as large language models (LLMs) operating in four domains that are central in symbolic traditions: arithmetic, logic, computer code, and language. Further, our symbolic approximation allows us to modify an LLM's behavior in targeted ways via precise interventions on its internal representations, showing that the LLM's behavior is reliant on the symbolic structures we have identified. This work provides a potential way to reconcile longstanding symbolic conceptions of intelligence with the vector-based nature of modern AI.
논문 링크
더 읽어보기
Metaⁿ: 창발적 깊이를 통한 재귀적 자기 개선 / Meta$^n$: Recursive Self-Improvement through Emergent Depth
논문 소개
자기 개선(self-improvement) 대규모 언어 모델(Large Language Model, LLM) 에이전트는 답변을 정제하는 데는 능숙하지만, 답변을 개선하는 과정(process) 자체를 개선하지 못한다는 구조적 한계에 직면해 있다. 메타-수준(meta-level)을 추가하는 기존 접근은 탐색 루프나 선택 규칙 같은 메타-메커니즘을 고정해 두거나, 자기 편집(self-editing)을 수행할 경우 안정성을 위해 드라이버(driver) 계층을 건드리지 않아야 하므로, 실행 중 실제로 행동이 바뀌는 실현 메타-깊이(realized meta-depth)는 대략 2 수준에서 상한이 걸린다. Metaⁿ은 이 딜레마를 개선자(improver)를 다시 쓰는 대신, 단일 보편 메타 연산 Ω를 고정한 채 입력에 재귀(recursion)를 적용하는 방식으로 해소한다. Ω는 하위 솔버(solver) 스택의 실행 흔적(trace)과 이를 생성한 코드 스택을 함께 읽고, 다음 계층을 전략적 전처리(strategic pre-process)와 호출 가능한 헬퍼 라이브러리(callable helper library)로 작성하며, 연산 자체는 변하지 않으므로 시스템 안정성을 유지하면서 입력이 단조 증가(monotonically grows)해 각 계층이 이전보다 더 높은 관점에서 추론할 수 있다. 과제가 들어오면 래퍼(wrapper) M_d가 전처리로 전략 맥락을 주입하고, 누적된 헬퍼 함수를 기본 솔버 앞에 합성해 실행하므로, 평탄한 자기 정제(self-refinement)가 흔적 로그만 보는 것과 달리 깊은 계층에서는 “어떤 지시가 퇴행을 유발했는지”를 코드와 함께 판단하는 고차 메타-추론(meta-reasoning)이 가능해진다. 깊이는 사전에 고정하지 않고 Ω가 더 이상 개선을 찾지 못할 때 수렴(convergence)으로 결정되며, 선형 재귀와 진화적 아카이브(evolutionary archive)가 계층 체인을 탐색하고 통합(consolidation)으로 과제별 퇴행을 방지한다. 재귀의 이득은 계층 간 조건화(conditioning)에서 주로 발생하며, 상위 계층의 전략 문자열이 하위 계층의 행동을 곱적으로 재형성해 평탄 구조가 달성하기 어려운 전략·전술 조합 공간을 확장한다. 프롬프트가 역할을 지정하지 않아도 깊이에 따라 메타 전략가(meta-strategist), 아키텍트(architect), 과제 라우터(task router), 롤백(rollback) 교정자 같은 구별되는 계층 역할이 창발(emergent)한다. Gemma 4 31B-IT와 GPT-5.2 두 백본에서 8개 벤치마크 패밀리 전반에 걸쳐 기존 자기 개선 에이전트를 능가했으며, 스킬 암기(skill memorization)에 저항하도록 설계된 ARC-AGI-2(Abstraction and Reasoning Corpus for Artificial General Intelligence 2)에서만 의미 있는 점수를 기록해, 객체 수준 반복이 아닌 메타 수준 스택이 유동 지능 검증에 기여함을 보였다. CO-Bench의 의존성 오류처럼 단일 호출이나 평탄 루프로는 반복 실패하는 패턴을, Ω가 교차-과제(cross-task) 관찰로 일반적 헬퍼를 추출해 해결하는 사례는 이 프레임워크의 실용적 가치를 보여준다. 본 연구는 메타-깊이 2를 넘는 구조적으로 구별된 계층을 최초로 실증하고, 고정된 Ω 위에 진화적 오케스트레이션을 결합해 자기 개선 에이전트가 답이 아니라 개선 과정 자체를 심층적으로 진화시킬 수 있음을 제시한다.
초록(Abstract)
자기 개선(self-improving) LLM 에이전트는 답을 정제하지만, 그 답을 생성하는 과정은 정제하지 않는다. 메타 수준을 추가하는 시스템은 그 수준을 고정한 채 유지하고, 자기 자신을 편집하는 시스템은 안정성을 유지하기 위해 자신의 편집 메커니즘 일부를 수정하지 않은 채 두어야 하므로, 실현할 수 있는 메타 깊이가 대략 2에 머문다. 본 논문에서는 메타 연산은 고정한 채 입력에 대해 재귀하도록 하는 Metaⁿ을 제안한다. 이 연산 Ω는 자신의 산출물에 반복적으로 적용되며, 하위 솔버 스택의 추적 기록과 이를 생성한 코드를 함께 읽은 뒤, 다음 계층을 전략적 전처리와 호출 가능한 헬퍼 라이브러리로 작성한다. Ω는 절대 변하지 않으므로 시스템을 불안정하게 만들 수 없고, 입력이 엄격하게 증가하므로 각 계층은 이전 계층보다 높은 관점에서 추론한다. 깊이는 사전에 고정하는 대신 수렴에 의해 결정되며, 진화적 아카이브가 계층 체인을 탐색한다. 두 개의 백본에서 Metaⁿ은 8개 벤치마크 패밀리 전부에서 기존 자기 개선 에이전트를 능가한다. 가장 두드러진 사례는 기술 암기에 저항하도록 설계된 ARC-AGI-2로, 여기서만 0을 초과하는 점수를 기록한다. 어블레이션 결과, 재귀로 얻는 이득의 대부분은 각 계층이 다음 계층에 전달하는 조건화(conditioning)에서 비롯되며, 프롬프트가 명시하지 않았음에도 깊이에 따라 뚜렷한 계층 역할이 나타난다. 코드는 GitHub - minnesotanlp/meta-n: Code for Zae Myung Kim's paper titled "Meta^n: Recursive Self-Improvement through Emergent Depth" · GitHub 에서 확인할 수 있다.
Self-improving LLM agents refine answers, not the process that produces those answers. Systems that add a meta-level hold that level fixed, and those that edit themselves must leave part of their own editing machinery untouched to stay stable, capping the meta-depth they realize at roughly two. We present Meta$^n$, which keeps the meta-operation fixed and recurses on its input instead. That operation, Ω, is applied repeatedly to its own products, reading the traces of the solver stack below together with the code that produced them, then writing the next layer as a strategic pre-process and a library of callable helpers. Because Ω never changes, it cannot destabilize the system, and because its input strictly grows, each layer reasons from a higher vantage than the last. Depth is set by convergence rather than fixed in advance, and an evolutionary archive searches over layer chains. Across two backbones, Meta$^n$ outperforms prior self-improving agents on all eight benchmark families. The sharpest case is ARC-AGI-2, built to resist skill memorization, where it alone scores above zero. Ablations indicate that most of the gain from recursion comes from the conditioning each layer passes to the next, and distinct layer roles emerge with depth although no prompt prescribes them. Code available at GitHub - minnesotanlp/meta-n: Code for Zae Myung Kim's paper titled "Meta^n: Recursive Self-Improvement through Emergent Depth" · GitHub
논문 링크
더 읽어보기
Prime Agent: 자기 개선형 재귀 언어 모델(RLM) 하네스 / Prime Agent: A Self-Improving RLM Harness
논문 소개
대규모 언어 모델(Large Language Model, LLM)은 토큰을 순차적으로 생성·처리하는 본질을 지닌 반면, 수 시간에서 수일에 이르는 코딩·추론·게임 플레이와 같은 장기 수평 에이전트 수행(long-horizon agency)에는 모델 가중치와 활성 컨텍스트(active context)만으로는 부족한 외부 정보와 외부 연산이 필수적입니다. Prime Agent는 이러한 한계를 해소하기 위해 장기 평가(long-horizon evaluation)와 코딩 에이전트(coding-agent) 워크플로를 위한 오픈소스 하네스(harness)로 제안되며, 모델 바깥의 실행 환경·메모리·도구·서브에이전트(subagent)를 체계화하여 에이전트가 필요할 때 코드를 실행하고 상태를 외부화할 수 있도록 합니다.
핵심 실행 인프라는 재귀 언어 모델(Recursive Language Model, RLM) 추상화를 따르는 영구 IPython REPL(Read–Eval–Print Loop)입니다. RLM은 긴 맥락을 모델 컨텍스트에 직접 주입하기보다 프로그램(REPL 코드)으로 검색·요약·변환·계산하는 패러다임을 취하며, 세션이 끊기지 않는 영구 REPL을 통해 변수·함수·중간 결과가 유지되어 테스트 시 연산(test-time compute)으로 복잡한 데이터 처리를 모델 호출 밖에서 수행할 수 있습니다. 이와 더불어 Continual Harness는 단일 대화가 아니라 여러 궤적(trajectory)에 걸친 지속성을 담당하며, 이력(histories), 메모리(memories), 스킬(skills), 프롬프트(prompts), 서브에이전트 명세를 보존함으로써 자기 개선(self-improving)이 단일 에피소드에 국한되지 않고 세션·과제 전반으로 이어지게 합니다.
조율 측면에서 재귀적 서브에이전트(recursive subagents)는 상위 에이전트가 하위 에이전트를 생성·위임하고 에이전트 간 직접 통신(agent-to-agent communication)으로 협업하며, Agents View는 데몬(daemon) 기반 장기 실행 세션을 사람이 검사·관리·개입할 수 있게 합니다. Prime Agent의 설계 철학은 실행(execution), 복구(recovery), 검증(verification), 리소스 계정(resource accounting)을 표준화하되 전략 구성(strategy construction)은 모델에 위임하는 것으로, 저마찰(low-friction)이면서 표현력 있는 막(membrane) 역할을 하여 하네스 실패가 모델 실패로 전환되는 것을 방지하고 평가가 모델의 실제 최대 근저극 능력(true maximal underlying capability)에 가깝게 이끕니다.
실험 결과는 이러한 접근의 효과를 여러 장기·고난도 과제에서 입증합니다. ARC-AGI-3 RHAE(Repeated Human Attempt Evaluation) Best@1 점수가 30%에서 95.5%로 향상되어 하네스 선택이 벤치마크 점수에 미치는 영향의 크기를 보여 주었으며, 장문 맥락 코딩(long-context coding), GPU(Graphics Processing Unit) 커널 생성, 에뮬레이터 구축, 자율 nanoGPT 스피드런(autonomous nanoGPT speedruns)에서 기본(native) 및 인기 하네스와 동등하거나 그 이상의 성과를 달성했습니다. Factorio 환경에서는 정제(refinement)가 연속적 기술 진행을 가능하게 하고 전용 서브에이전트가 병렬화된 작업(parallelized work)을 가능하게 하는 등, 장기 자율 과제에서의 실용성도 확인되었습니다. 제공된 nanoGPT 스피드런 관련 실행 산출물은 Newton–Schulz 반복(Newton–Schulz iteration) 계수를 전역 옵티마이저(global optimizer) 관점에서 재최적화하고 bf16(brain floating point 16-bit) 반올림을 비트 단위로 정확히(bit-exactly) 검증하는 등, 단순 코딩을 넘어 수치 최적화·하드웨어 정밀도 검증까지 수행할 수 있음을 시사합니다. 코드는 GitHub - PrimeIntellect-ai/prime-agent: A self-improving RLM agent for coding workflows and long-running autonomous tasks. · GitHub 에서 공개되어 재현과 확장이 가능합니다.
초록(Abstract)
언어 모델은 순차적 프로세서이지만, 장기적 에이전트 수행(agency)에는 모델 가중치와 활성 컨텍스트를 넘어선 외부 정보와 연산이 필요합니다. Prime Agent는 장기 평가 및 코딩 에이전트 워크플로를 위한 오픈소스 하네스입니다. 영구 IPython REPL이 Recursive Language Model 추상화를 따라 프로그램적 컨텍스트 처리와 테스트 시 연산(test-time compute)을 지원하고, Continual Harness는 궤적(trajectory) 전반에서 이력, 메모리, 스킬, 프롬프트, 서브에이전트 명세를 보존합니다. 재귀적 서브에이전트는 에이전트 간 직접 통신으로 조율되며, Agents View를 통해 사용자가 데몬(daemon) 기반 세션을 검사하고 관리할 수 있습니다. Prime Agent는 실행, 복구, 검증, 리소스 계정(accounting)을 표준화하는 동시에 전략 구성은 모델에 위임합니다. 이러한 저마찰(low-friction)의 표현력 있는 막(membrane)은 하네스 실패가 모델 실패로 전환되는 것을 방지하고, 측정을 모델의 실제 최대 근저극 능력에 가깝게 이끕니다. Prime Agent는 ARC-AGI-3 RHAE Best@1을 30%에서 95.5%로 향상시키고, 장문 맥락 코딩, GPU 커널 생성, 에뮬레이터 구축, 자율 nanoGPT 스피드런에서 기본 및 인기 하네스와 동등하거나 그 이상의 성과를 달성합니다. Factorio에서는 정제(refinement)가 연속적 기술 진행을 가능하게 하고, 전용 서브에이전트가 병렬화된 작업을 가능하게 한다는 것을 확인했습니다. 코드는 GitHub - PrimeIntellect-ai/prime-agent: A self-improving RLM agent for coding workflows and long-running autonomous tasks. · GitHub 에서 이용할 수 있습니다.
Language models are sequential processors, but long-horizon agency requires external information and computation beyond model weights and active context. Prime Agent is an open-source harness for long-horizon evaluation and coding-agent workflows. A persistent IPython REPL follows the Recursive Language Model abstraction for programmatic context processing and test-time compute, while Continual Harness preserves histories, memories, skills, prompts, and subagent specifications across trajectories. Recursive subagents coordinate through direct agent-to-agent communication, and the Agents View lets humans inspect and manage daemon-backed sessions. Prime Agent standardizes execution, recovery, verification, and resource accounting while leaving strategy construction to the model. This low-friction, expressive membrane prevents harness failures from becoming model failures and pushes measurement toward the model's true maximal underlying capability. Prime Agent raises ARC-AGI-3 RHAE Best@1 from 30% to 95.5% and matches or exceeds native and popular harnesses across long-context coding, GPU-kernel generation, emulator construction, and autonomous nanoGPT speedruns. On Factorio, we find refinement allows for continuous technology progression and dedicated subagents enable parallelized work. Code is available at GitHub - PrimeIntellect-ai/prime-agent: A self-improving RLM agent for coding workflows and long-running autonomous tasks. · GitHub.
논문 링크
더 읽어보기
Harness-of-Harness: 며칠간 지속적 개선을 통한 자율 소프트웨어 개발 / Harness-of-Harness: Multi-Day Autonomous Software Development with Continual Improvement
논문 소개
대규모 언어 모델(LLM, Large Language Model) 기반 코딩 에이전트가 함수 완성이나 저장소 이슈 해결을 넘어, 고수준 요구사항만으로 완전하고 배포 가능한 시스템을 사람 개입 없이 구현하는 자율 소프트웨어 개발(autonomous software development)은 긴 주기(long-horizon)의 실행에서 요구사항 추적 실패, 국소 수정의 전역 부작용, 실패 누적, 미완성 산출물의 조기 완료 선언 같은 어려움을 낳습니다. 본 연구는 이 문제를 “더 긴 실행”이 아니라 시간에 걸쳐 일관되고 효과적인 진전을 유지하는 문제로 재정의하고, 기존 코딩 에이전트 하네스(harness)를 수정하지 않은 채 그 실행을 반복적인 계획–코딩–테스트 루프로 조직하는 프레임워크 Harness-of-Harness(HoH)를 제안합니다. HoH는 매 반복에서 Project Planner가 명세와 이전 실행 증거를 결합해 미해결 문제를 다루면서도 작고 검증 가능한 새 능력을 담은 유계(bounded)·국소 완전한 개발 문서를 만들고, Developer가 단일 작성자(single-writer) 경계 안에서 구현과 국소 피드백 테스트를 수행하며, QA Tester가 동결된 읽기 전용 후보에 대해 화이트박스·블랙박스 관점의 독립 평가를 수행해 구조화된 증거 상태를 다음 계획으로 넘깁니다.
핵심 설계는 수리와 능력 성장의 균형, 작고 검증 가능한 증분 개발, 구현 시 테스트와 독립 품질 보증(QA, Quality Assurance)의 분리, 워크플로 처방 대신 검증 가능 산출물 스키마 제약, 산출물·역할별 도구·스킬의 점진적 공개(progressive disclosure), 재사용 장려, 버전 관리된 프로젝트 이력 유지로 요약됩니다. 교차 루프에서는 소스·설정·리소스로 이루어진 아티팩트 상태와 검증된 행동·미충족 요구·회귀를 기록한 증거 상태를 함께 전달하여, 하네스 호출이 끝나도 결정·검증·실패 정보가 단절되지 않도록 합니다. GameCraft-Bench, FrontierSWE, ProgramBench에서 Codex와 GPT-5.5, OpenCode와 DeepSeek-V4-Pro, Pi와 MiniMax-M3의 세 하네스–모델 조합에 대해 HoH는 단독 하네스(Vanilla)를 일관되게 상회하며, 3회 반복 후 평균 상대 이득 52.25%, 최대 82.86%를 보고합니다. 패스 수를 맞춘 비교와 제거 실험(ablation)에서는 문서 갱신, 증거 피드백, 아티팩트 warm-start라는 교차 반복 채널이 단순 패스 연속보다 구조적으로 기여함을 보이며, 70회 이상 반복의 다일(multi-day) 배포에서는 빈 워크스페이스와 제품 요구사항만으로 스토리·전투·플레이 가능 경험·시각·오디오를 갖춘 1인칭 슈팅(FPS, First-Person Shooter) 게임 Fusepoint를 자율 개발했습니다. 이처럼 HoH는 하네스 자체를 최적화하기보다 고정된 하네스–모델 참여를 장주기 그린필드(greenfield) 개발에 맞게 구조화하여, 자율 소프트웨어 개발의 지속 가능한 품질 향상을 실증합니다.
초록(Abstract)
본 논문은 대규모 언어 모델(LLM) 기반 코딩 에이전트가 사람의 개입 없이 고수준 요구사항을 완전하고 기능적이며 사용 가능한 소프트웨어 시스템으로 변환하는 자율 소프트웨어 개발을 연구한다. 우리는 자율 개발 과정에서 코딩 에이전트가 소프트웨어를 지속적으로 개선할 수 있게 하는 프레임워크인 Harness-of-Harness(HoH)를 소개한다. HoH는 기존 코딩 에이전트 하네스 위에서 동작하며, 이들의 실행을 반복적인 계획-코딩-테스트 루프로 조직화한다. 루프 전반에 걸쳐 개선을 지속하기 위해, HoH는 수리와 능력 성장을 균형 있게 다루고, 개발을 작고 검증 가능한 증분으로 범위화하며, 구현 시점의 테스트와 독립적 평가를 분리하고, 에이전트 워크플로를 규정하기보다 검증 가능한 출력을 제약한다. 또한 산출물, 역할별 도구, 스킬을 점진적으로 노출하고, 재생성보다 재사용을 장려하며, 버전 관리된 프로젝트 이력을 유지한다. GameCraft-Bench, FrontierSWE, ProgramBench에서 세 가지 하네스-모델 쌍(GPT-5.5를 사용한 Codex, DeepSeek-V4-Pro를 사용한 OpenCode, MiniMax-M3를 사용한 Pi)에 대해 HoH는 대응하는 단독 하네스를 일관되게 능가하며, 3회 반복 후 평균 상대 이득 52.25%, 최대 이득 82.86%를 달성한다. 70회 이상의 반복을 거친 수일간의 배포에서, HoH는 일관된 스토리라인, 완전히 구현된 핵심 메커닉, 사람이 플레이 가능한 경험, 세련된 비주얼과 통합된 오디오를 갖춘 1인칭 슈팅 게임을 자율적으로 개발한다. Github: GitHub - Flesymeb/HarnessOfHarness: Harness of Harness: Multi-Day Autonomous Software Development with Continual Improvement · GitHub Project Page: Harness-of-Harness
This paper studies autonomous software development, in which LLM-based coding agents transform high-level requirements into complete, functional, and usable software systems without human intervention. We introduce Harness-of-Harness (HoH), a framework that enables coding agents to continually improve software during autonomous development. HoH operates on existing coding-agent harnesses, and organizes their executions into iterative planning-coding-testing loops. To sustain improvement across loops, HoH balances repair with capability growth, scopes development into small and verifiable increments, separates implementation-time testing from independent evaluation, and constrains verifiable outputs rather than prescribing agent workflows. It progressively exposes deliverables, role-specific tools, and skills, encourages reuse rather than recreation, and maintains versioned project histories. On GameCraft-Bench, FrontierSWE, and ProgramBench, three harness-model pairs (Codex with GPT-5.5, OpenCode with DeepSeek-V4-Pro, and Pi with MiniMax-M3), HoH consistently outperforms the corresponding standalone harnesses, achieving an average relative gain of 52.25 percent and a maximum gain of 82.86 percent after three iterations. In a multi-day deployment with more than 70 iterations, HoH autonomously develops a first-person-shooter game, featuring a coherent storyline, fully implemented core mechanics, human-playable experience, polished visuals and integrated audio. Github: GitHub - Flesymeb/HarnessOfHarness: Harness of Harness: Multi-Day Autonomous Software Development with Continual Improvement · GitHub Project Page: Harness-of-Harness
논문 링크
더 읽어보기
컨텍스트를 환경으로: 장기 실행 에이전트를 위한 프로그래밍적 컨텍스트 관리 / Context as an Environment: Programmatic Context Management for Long-Horizon Agents
논문 소개
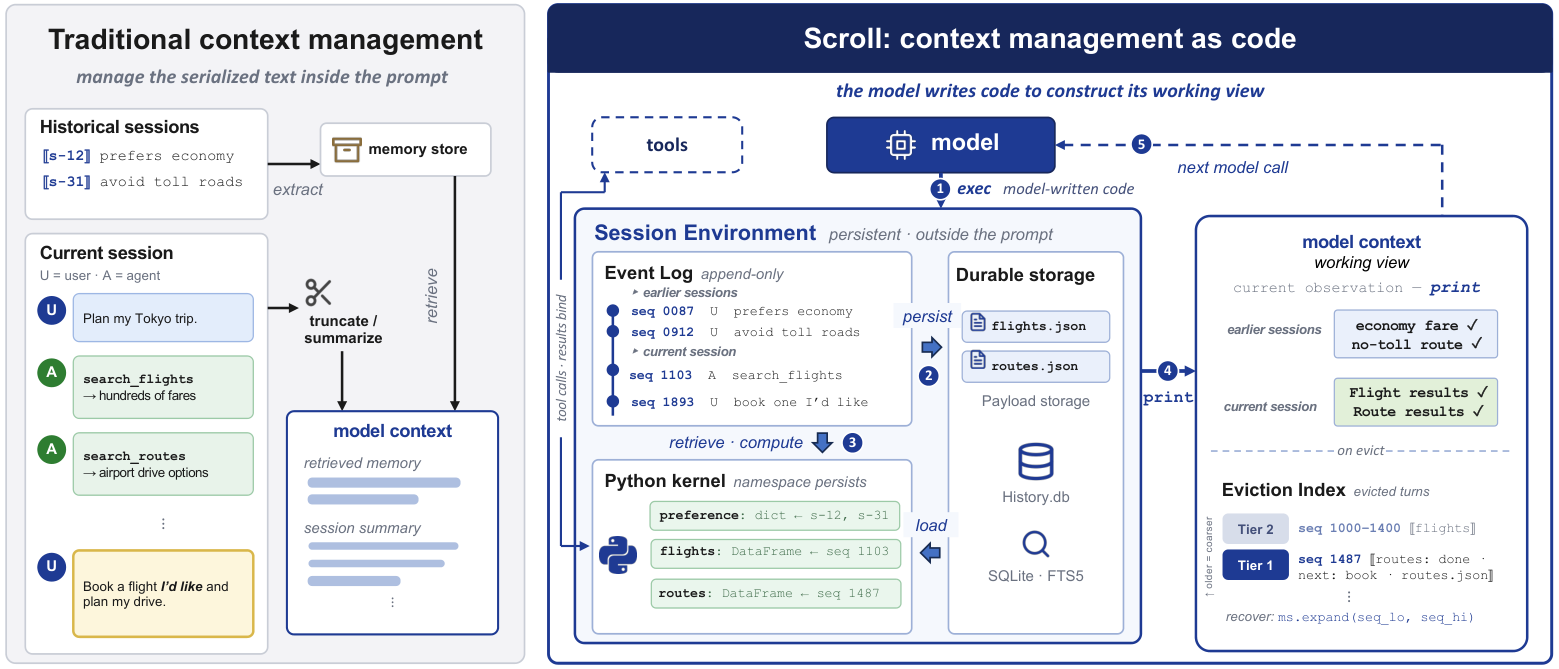
대규모 언어 모델(Large Language Model, LLM) 에이전트가 장기간에 걸쳐 복잡한 작업을 수행하면서, 상호작용 기록이 단일 모델의 컨텍스트 윈도우를 크게 넘어서는 상황이 점점 흔해지고 있습니다. 기존 접근은 과거 대화를 압축하거나 선택된 정보를 고정된 메모리 표현으로 추출하는 방식에 의존하는데, 이는 앞으로 어떤 정보가 필요할지 알기 전에 무엇을 보존할지 미리 결정해야 한다는 구조적 한계를 가집니다. 이러한 조기 결정(premature commitment)은 정보 손실을 유발하고, 장기 지평(long-horizon) 작업에서 에이전트의 의사결정 품질을 떨어뜨릴 수 있습니다.
Scroll은 각 에이전트 세션을 실행 가능한 세션 환경(Session Environment)으로 다루는 프로그램적 컨텍스트 관리(programmatic context management) 체계를 제안합니다. 환경의 기반은 추가 전용(append-only) 이벤트 로그(Event Log)와 샌드박스화된 영속 파이썬 커널(Python kernel)로 구성되며, 커널은 모델 호출 간에 타입화된 네임스페이스(typed namespace)를 유지합니다. 도구 출력, 검색된 이력, 파생 상태는 매 호출마다 프롬프트에 직렬화되지 않고 변수에 바인딩되며, 모델이 작성한 코드가 exec를 통해 세션 상태를 검색·구체화·변환합니다. 다음 호출의 작업 뷰(working view)에는 명시적으로 출력된 투영(projection)만 들어가므로, 컨텍스트 관리가 LLM의 향상되는 코딩 능력을 그대로 물려받는 프로그래밍 과제로 재정의됩니다. 동시에 이벤트 로그는 손실 없는 역사적 근거 진실(historical ground truth)을 보존하여, 필요 시 과거 상호작용을 정확히 되찾을 수 있게 합니다.
작업 뷰가 예산에 가까워지면 오래된 구간은 퇴출(eviction)되지만 복구 가능하도록 설계되어 있습니다. 퇴출 인덱스(eviction index)는 압축된 랜드마크를 이벤트 로그의 정확한 주소와 연결해 두어, 에이전트가 전체 로그를 훑지 않고도 퇴출된 영역으로 직접 이동할 수 있습니다. Qwen3.8-Max를 백본으로 한 평가에서 Scroll은 LongMemEval_S에서 94.8%, BEAM_10M에서 73.1%(기존 최고 메모리 시스템 대비 +5.1포인트), LOCA_256K에서 86.7%(기존 최고 장기 지평 에이전트 대비 +37.4포인트)를 기록하며, 프로그램적 컨텍스트 관리가 장기 작업 성능에 실질적 이득을 줄 수 있음을 보여줍니다.
초록(Abstract)
대규모 언어 모델(LLM) 에이전트는 단일 모델 컨텍스트 윈도우를 훨씬 넘어설 정도로 이력이 커지는 장기 실행 작업을 점점 더 많이 수행하고 있습니다. 기존 접근법은 이전 상호작용을 압축하거나 선택된 정보를 고정된 메모리 표현으로 추출하여, 미래의 필요를 알기 전에 무엇을 보존할지 미리 결정합니다. 본 논문에서는 각 에이전트 세션을 실행 가능한 세션 환경(Session Environment)으로 다루는 컨텍스트 관리자인 Scroll을 제시합니다. 이 환경은 추가 전용(append-only) 이벤트 로그(Event Log)와 샌드박스화된 영속적 Python 커널로 뒷받침됩니다. 커널은 모델 호출에 걸쳐 타입이 지정된 네임스페이스를 유지하여, 도구 출력·검색된 이력·파생 상태가 매 호출마다 프롬프트에 직렬화되는 대신 변수에 바인딩될 수 있게 합니다. 모델이 작성한 코드는 exec를 통해 세션 상태를 검색·구체화·변환하며, 명시적으로 출력된 투영(projection)만이 다음 호출을 위한 모델의 작업 뷰(working view)에 들어갑니다. 따라서 컨텍스트 관리는 LLM의 향상되는 코딩 능력을 물려받는 프로그래밍 작업이 되며, 이벤트 로그는 무손실의 이력 그라운드 트루스(ground truth)를 보존합니다. 작업 뷰가 예산에 가까워지면 오래된 구간(span)은 축출(eviction)되지만 복구 가능합니다. 축출 인덱스(eviction index)는 정확한 이벤트 로그 주소에 연결된 압축된 랜드마크를 유지하여, 에이전트가 전체 로그를 검색하는 대신 축출된 영역으로 직접 탐색할 수 있게 합니다. Qwen3.8-Max를 백본으로 하여 Scroll은 LongMemEval_S에서 94.8%, BEAM_10M에서 73.1%(기존에 발표된 최고 메모리 시스템을 5.1포인트 상회), LOCA_256K에서 86.7%(기존에 발표된 최고 장기 호라이즌 에이전트를 37.4포인트 상회)를 달성합니다.
LLM agents increasingly take on long-running tasks whose history grows far beyond a single model context window. Existing approaches compress earlier interactions or extract selected information into fixed memory representations, committing to what to preserve before future needs are known. We present Scroll, a context manager that treats each agent session as an executable Session Environment. The environment is backed by an append-only Event Log and a sandboxed, persistent Python kernel. The kernel maintains a typed namespace across model calls, allowing tool outputs, retrieved history, and derived state to be bound to variables rather than serialized into the prompt at each call. Model-written code searches, materializes, and transforms session state through exec; only explicitly printed projections enter the model's working view for the next call. Context management thus becomes a programming task that inherits the improving coding abilities of LLMs, while the Event Log preserves lossless historical ground truth. As the working view approaches its budget, stale spans are evicted but remain recoverable: an eviction index keeps compact landmarks tied to exact Event Log addresses, so that the agent navigates directly to evicted regions instead of searching the full log. With Qwen3.8-Max as the backbone, Scroll achieves 94.8% on LongMemEval_S; 73.1% on BEAM_10M, surpassing the best published memory system by 5.1 points; and 86.7% on LOCA_256K, exceeding the best published long-horizon agent by 37.4 points.
논문 링크
더 읽어보기
HarnessDev: 대규모 언어 모델(LLM)은 자신만의 에이전트 하네스를 생성하고 진화시킬 수 있는가? / HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
논문 소개
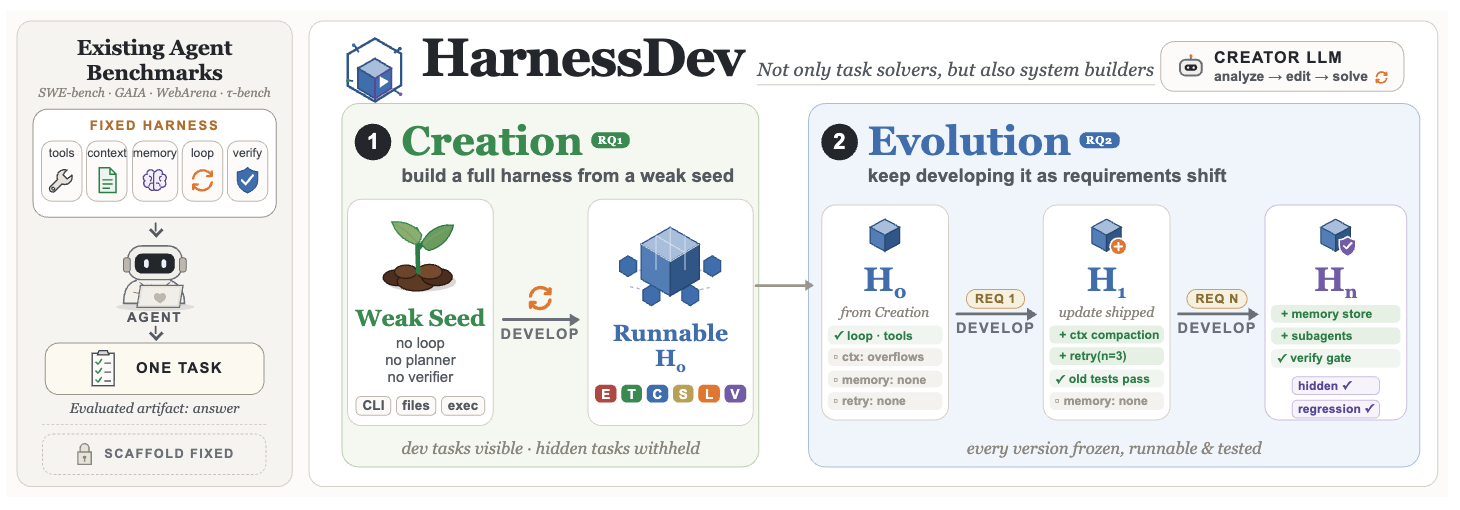
에이전트 성능이 모델 가중치만으로 결정되지 않고, 모델 외부의 실행 인프라 곧 에이전트 하네스(agent harness)에 크게 좌우된다는 인식이 확산되면서, 동일 모델이라도 하네스를 바꾸면 다운스트림 과제 결과가 크게 달라질 수 있음이 드러나고 있습니다. 그런데 기존 평가는 대개 특정 하네스 아래에서 나온 작업 산출물만 보고하기에, 모델이 실행 가능한 인프라 자체를 설계하고 개선하는 능력은 상대적으로 덜 다뤄져 왔습니다. HarnessDev는 평가의 단위를 태스크 출력이 아니라 실제로 동작하는 하네스로 옮긴 벤치마크로, Creation(생성)과 Evolution(진화)이라는 두 단계로 이 문제를 분리해 측정합니다. Creation에서는 약한 시드와 소수 사례만 주어진 상태에서 creator LLM(대규모 언어 모델)이 README나 설계도가 아닌 실행 가능한 시스템을 구축하며, 하네스는 실행 루프·도구·컨텍스트·상태·라이프사이클·검증으로 구성되는 H=\langle E,T,C,S,L,V\rangle로 정의되고 문서만 있고 실행되지 않는 구조는 인정되지 않습니다. 공통의 Open Harness Construction Contract는 프로바이더 중립적인 모델 호출, 정직한 result.json 상태, 궤적·로그·최종 아티팩트 기록 같은 행동 경계를 고정해 creator 간 비교를 공정하게 만듭니다. Evolution에서는 이미 만든 하네스를 지속 git 저장소의 후보로 두고, 다운스트림 실행 피드백을 읽으며 예산·슬롯·중복 제약이 있는 온라인 루프 안에서 코드를 수정하고 평가를 제출하는 방식으로 성능을 끌어올립니다. 컨트롤러는 채택·거부·롤백을 대신하지 않으며, creator가 무엇을 고치고 언제 프로브·정식 평가를 제출할지 전권을 갖되 하드코딩·채점기 조작 등은 금지되고 위반 시 해당 버전 점수는 무효가 됩니다. 평가는 홀드아웃 벤치마크에서의 역량과 실행 토큰 비용으로 측정하는 효율성을 함께 보며, Creation 실험은 생성용 LLM 6개, 도메인 4개, 다운스트림 벤치마크 5개에 걸친 2,207개 고유 인스턴스를 대상으로 했습니다. 생성된 하네스는 코드와 검색·연구 영역에서는 성숙한 인간 설계 참조에 크게 못 미치지만 글쓰기와 머신러닝 실험에서는 참조와 동등하거나 상회했고, 실행 비용의 편차는 컸습니다. Evolution은 일부 이득을 주지만 그 이득은 불안정하고 홀드아웃으로의 전이가 부분적이며, 고정 런타임 모델 실험은 개선이 실행에 쓰인 모델에 강하게 의존해 모델 간 전이가 제한적임을 보여 줍니다. 결국 HarnessDev는 강한 하네스가 런타임 LLM의 역량을 유도·증폭해야 한다는 설계 철학 아래, 에이전트 연구의 초점을 모델이 스스로 인프라를 만들고 진화시키는 능력으로 확장한다는 점에서 의의가 있습니다.
초록(Abstract)
에이전트가 연구용 프로토타입에서 실제 배포된 도구로 전환됨에 따라, 그 역량은 점점 더 모델 외부의 실행 인프라—통상 에이전트 하네스(agent harness)라 불리는 것—에 의존하게 된다. 모델 가중치를 고정한 채 이 하네스만 변경해도 작업 성능이 크게 달라질 수 있다. 현재의 에이전트 평가는 대개 특정 하네스 하에서의 다운스트림 성능을 보고하며, 모델이 하네스 자체를 개발하는 능력은 상대적으로 충분히 탐구되지 않은 채로 남아 있다. 본 논문에서는 평가 단위를 작업 결과물에서 실행 가능한 인프라로 전환하는 벤치마크인 HarnessDev를 제안한다. HarnessDev는 두 단계로 구성된다. Creation(생성) 단계에서 에이전트는 최소 시드와 소수의 사례로부터 시작하여 완전한 실행 시스템을 구축한다. Evolution(진화) 단계에서는 자신이 생성한 하네스로부터 출발하여 다운스트림 실행 피드백을 바탕으로 반복적으로 수정하며, 벤치마크 성능 향상을 목표로 한다. 이어서 구축된 각 하네스를 역량(홀드아웃 벤치마크에서의 작업 성공)과 효율성(실행 토큰 비용) 측면에서 평가한다. 보고된 Creation 결과는 6개의 생성용 대규모 언어 모델(LLM), 4개 도메인, 2,207개의 고유 다운스트림 인스턴스로 구성된 5개 다운스트림 벤치마크를 포함하며, 숨겨진 평가 작업은 개발 과정에서 비공개로 유지되었다. 생성된 하네스는 코드 및 검색·연구 영역에서는 성숙한 인간 설계 참조 대비 상당히 뒤처지는 반면, 글쓰기와 머신러닝 실험에서는 선택된 참조와 동등하거나 이를 상회하며, 실행 비용에서는 큰 편차를 보였다. Evolution은 일부 성능 향상을 가져오지만, 그 향상은 불안정하며 홀드아웃 작업으로의 전이는 부분적에 그친다. 고정된 런타임 모델을 사용한 실험은 나아가, 이러한 향상이 하네스를 실행하는 모델에 강하게 의존함을 보여 주며, 모델 간 전이가 제한적임을 시사한다.
As agents move from research prototypes to deployed tools, their capability increasingly depends on model-external execution infrastructure, commonly termed the agent harness. Changing this harness while holding model weights fixed can substantially alter task performance. Current agent evaluations typically report downstream performance under a chosen harness, leaving a model's ability to develop the harness itself comparatively underexplored. We introduce HarnessDev, a benchmark that shifts the unit of evaluation from task outputs to runnable infrastructure. HarnessDev covers two stages. In Creation, the agent starts from a minimal seed and a small number of cases, then builds a complete execution system. In Evolution, it starts from its own created harness and iteratively revises it using downstream execution feedback, with the goal of improving benchmark performance. We then evaluate each constructed harness on capability (task success on held-out benchmarks) and efficiency (execution-token cost). The reported Creation results cover six creator LLMs, four domains, and five downstream benchmarks totaling 2,207 unique downstream instances, with hidden evaluation tasks withheld from development. We find that generated harnesses remain substantially behind mature human-engineered references on code and on search and research, while matching or exceeding the selected references on writing and machine-learning experimentation, with large variation in execution cost. Evolution produces some performance gains, but they are unstable and transfer only partially to held-out tasks. Experiments with a fixed runtime model further show that the gains depend strongly on the model executing the harness, indicating limited transfer across models.
논문 링크
더 읽어보기
Qwen-Drive-1.0: 자율주행을 위한 시각-언어 파운데이션 모델을 향한 첫걸음 / Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving
논문 소개
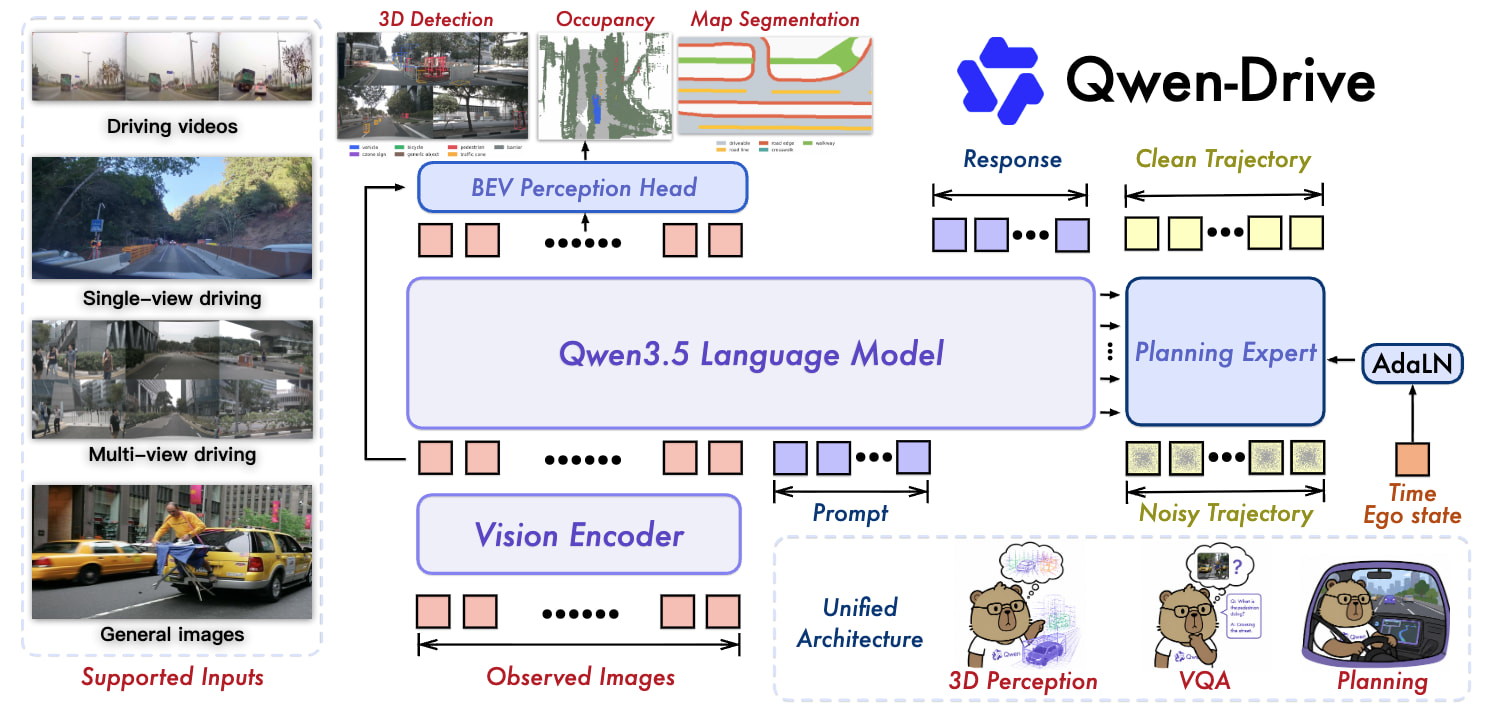
자율주행 시스템은 모듈형 파이프라인에서 장면 이해·의사결정·제어를 하나의 모델로 묶는 비전-언어-액션(Vision-Language-Action, VLA) 패러다임으로 빠르게 이동하고 있으나, 텍스트 기반 시각적 질의응답(Visual Question Answering, VQA)만으로는 3차원 레이아웃·깊이·점유를 직접 제약하기 어렵고, 주행 도메인 적응은 사전학습된 일반 지식의 치명적 망각(catastrophic forgetting)을 유발할 수 있습니다. Qwen-Drive-1.0은 이러한 한계를 완화하기 위해 사전학습된 비전-언어 모델(Vision-Language Model, VLM)인 Qwen3.5-4B의 아키텍처를 그대로 유지한 채, 외부 조감도(Bird’s-Eye-View, BEV) 인식 헤드와 Planning Expert를 공유 표현에 부착하여 3D 인식, 주행 VQA, 모션 플래닝을 하나의 프레임워크로 통합합니다. 공유 비전 인코더가 싱글뷰·멀티뷰·시계열 입력을 시각 토큰으로 변환하고 VLM이 자기회귀적으로 응답을 생성하는 동안, BEV 헤드는 저수준 외형 특징과 VLM이 담은 장면 맥락을 깊이 기반 뷰 변환과 쿼리 기반 BEV 트랜스포머로 융합하여 3D 객체 검출, 시맨틱 점유(occupancy) 예측, BEV 맵 세그멘테이션을 공동으로 수행합니다. 이 헤드는 공유 표현에서 접근 가능한 3D 정보를 검사하는 명시적 프로브이자, 장면 구조를 점검할 수 있는 인터페이스로 기능합니다.
Planning Expert는 캐시된 VLM 키·값을 조건으로 하는 약 11억 파라미터의 diffusion transformer와 flow matching 기반 x-prediction을 통해, 과거 궤적·내비게이션·환경 신호와 선택적 텍스트 근거를 반영한 5초·10 Hz의 미래 자차(ego) 웨이포인트를 생성합니다. 학습은 네 단계로 구성됩니다. 먼저 BEV 헤드만 사전학습한 뒤 인식과 VQA를 공동 최적화하여 공유 표현을 주행·3D에 적응시키고, 이어서 Planning Expert를 지도 학습한 후 충돌 회피·주행 가능 영역·진행·선호 정렬을 반영하는 태스크 수준 보상으로 강화학습 정제합니다. 데이터 측면에서는 nuScenes와 OpenScene의 라벨·공간 정의를 정렬한 인식 데이터, 공개 주행 VL 데이터를 대화 스키마로 재작성·필터링한 수백만 규모의 비전-언어 혼합, 그리고 NAVSIM·OpenScene·WOD-E2E·PAI-AV를 통합한 약 283만 개의 통일 궤적 주석이 단계별 목적과 맞물려 사용됩니다.
실험에서 이 접근은 nuScenes 기준 43.95 mAP와 60.99 map mIoU 등 강한 3D 인식, Driving QA 평균 69.43과 인과 추론에서의 뚜렷한 우위, 그리고 일반 비전-언어 벤치마크에서 베이스라인에 근접한 능력 유지를 동시에 보여 줍니다. 모션 플래닝에서는 WOD-E2E의 RFS 7.91, NAVSIM의 PDMS 90.7을 비롯해 오픈루프·의사-클로즈드루프·클로즈드루프 전반에서 경쟁력 있는 성능을 확인하였으며, 특히 강화학습은 도로 이탈을 크게 줄이는 등 안전 지향 보정의 효과를 드러냅니다. 요컨대 Qwen-Drive-1.0은 사전학습 VLM을 해체하지 않으면서 검사 가능한 3D 프로브와 생성형 플래닝 전문 모듈, 그리고 주행·범용 데이터를 병행하는 단계적 레시피로, 콕핏-주행 통합 환경에 요구되는 대화·지시 따르기와 주행 전문성을 한 모델 안에서 공존시키는 자율주행 비전-언어 파운데이션 모델의 실질적 첫걸음을 제시합니다.
초록(Abstract)
우리는 자율주행을 위한 비전-언어 파운데이션 모델을 향한 첫 단계로서 Qwen-Drive-1.0을 제시한다. Qwen-Drive-1.0은 사전학습된 비전-언어 모델(VLM)의 아키텍처를 유지하면서, 3D 인식, 시각 질의응답(VQA), 모션 플래닝을 통합 프레임워크 안에서 결합한다. 외부 버드아이뷰(BEV) 인식 헤드는 3D 객체 탐지, 의미론적 점유 예측, BEV 맵 세그멘테이션을 공동으로 수행한다. 이는 공유 표현으로부터 접근 가능한 3D 정보를 탐색하는 프로브 역할을 하며, 3D 장면 구조에 대한 명시적이고 점검 가능한 인터페이스를 제공한다. Planning Expert는 공유 VLM 표현을 조건으로 하여 미래 자차(ego) 궤적을 생성한다. 단계적 학습 레시피는 주행 감독와 범용 비전-언어 데이터를 결합하여, 폭넓은 시각 이해와 인스트럭션 팔로잉 능력을 보존하면서 주행 특화 역량을 습득하도록 한다. 실험 결과, 강력한 3D 인식과 주행 장면 이해를 보이면서도 일반 비전-언어 능력이 대체로 보존됨을 확인하였다. 오픈루프, 의사-클로즈드루프, 클로즈드루프 설정에 걸친 종합 평가는 매우 경쟁력 있는 모션 플래닝 성능을 추가로 보여준다.
We present Qwen-Drive-1.0, an initial step towards a vision-language foundation model for autonomous driving. Qwen-Drive-1.0 retains the architecture of the pretrained vision-language model (VLM) and integrates 3D perception, visual question answering, and motion planning within a unified framework. An external bird's-eye-view (BEV) perception head jointly performs 3D object detection, semantic occupancy prediction, and BEV map segmentation. It serves as a probe of the 3D information accessible from the shared representations and provides an explicit, inspectable interface to 3D scene structure. A Planning Expert conditions on shared VLM representations to generate future ego trajectories. A staged training recipe combines driving supervision with general-purpose vision-language data to acquire driving-specific competence while helping preserve broad visual understanding and instruction-following capabilities. Experiments demonstrate strong 3D perception and driving scene understanding while largely preserving general vision-language capability. Comprehensive evaluations across open-loop, pseudo-closed-loop, and closed-loop settings further show highly competitive motion-planning performance.
논문 링크
더 읽어보기
Terminal-Universe: 에이전트 궤적을 확장 가능한 터미널 환경으로 전환하기 / Terminal-Universe: Turning Agent Trajectories into Scalable Terminal Environments
논문 소개
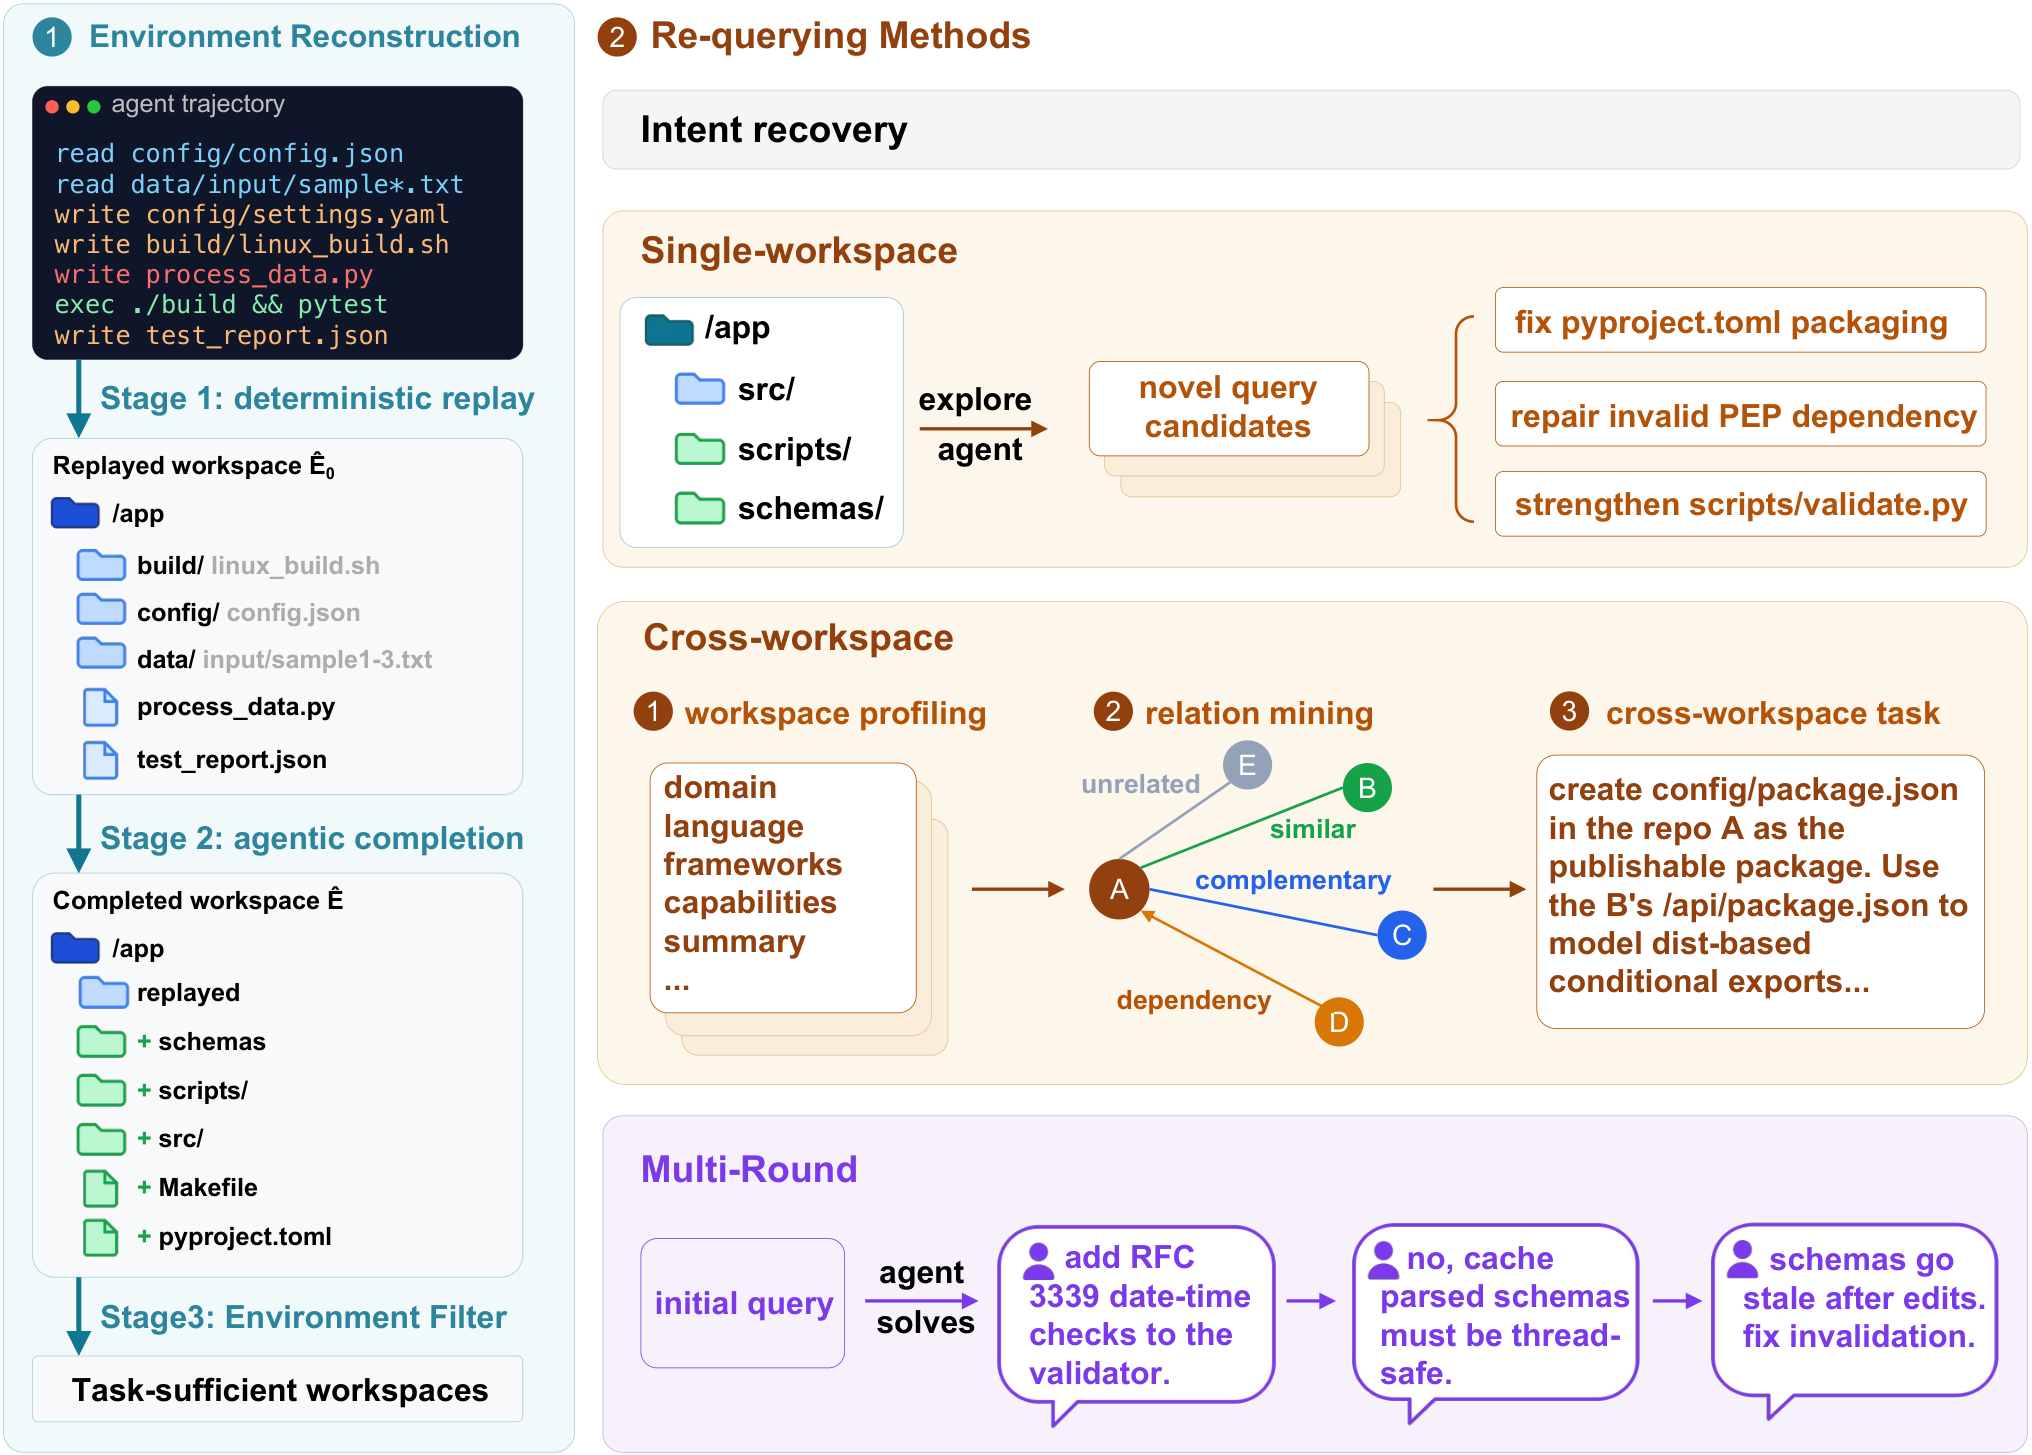
터미널 기반 코드 에이전트가 널리 쓰이면서 에이전트 궤적(trajectory)은 대량으로 쌓이지만, 사후학습(post-training)에 실제로 필요한 현실적이고 실행 가능한 환경은 여전히 부족합니다. 궤적은 한 번의 고정된 시연에 그치지만, 환경은 재질의(re-query)를 통해 수많은 검증 가능한 태스크를 만들고 실행 피드백을 제공할 수 있어 스케일링의 핵심 자원이 됩니다. Terminal-Universe는 환경을 처음부터 합성하기보다, 기존 궤적에 기록된 도구 실행 이력이 당시 워크스페이스의 구조와 내용을 드러낸다는 점에 착안하여 궤적을 재사용 가능한 실행 환경으로 역변환하는 프레임워크를 제안합니다.
방법론은 결정적 리플레이(deterministic replay)와 에이전트형 완성(agentic completion)으로 구성됩니다. 먼저 궤적의 읽기·쓰기·편집 연산을 시간순으로 되감아 에이전트가 수정하기 이전의 부분 워크스페이스를 복원하고, 이어서 완성 에이전트가 원본 태스크를 구현하지 않으면서 누락된 파일과 의존성을 채워 실행 가능한 워크스페이스를 완성합니다. 충분성 판정을 통과한 환경에 대해 원본 의도 복구(Intent Recovery), 단일 워크스페이스(Single-WS) 신규 태스크, 교차 워크스페이스(Cross-WS) 합성, 다중 라운드(Multi-Round) 세션으로 잠복 능력 공간을 폭과 깊이 두 축에서 확장합니다. 폭 확장에서는 방향성 의존 관계를 가진 코드베이스 쌍을 연결해 개발자가 실제로 다루는 교차 저장소 질의를 만들고, 깊이 확장에서는 사용자 에이전트가 요구사항을 진화시키며 반복 피드백이 있는 다중 라운드 상호작용을 합성합니다. 모든 신규 태스크에는 컨테이너 내 에이전트가 작성한 pytest 기반 검증기를 붙여 통과한 궤적만 학습 데이터로 남깁니다.
공개 터미널 에이전트 궤적에 적용한 결과 약 37.3k개의 태스크-충분 환경과 약 32.0k개의 지도 파인튜닝(Supervised Fine-Tuning, SFT) 시연이 구축되었으며, Qwen3.5-27B를 이 코퍼스로 학습했을 때 Terminal-Bench 2.1에서 11.9점, EvoCode-Bench v2의 MT@4에서 13.8점의 향상을 달성했습니다. 원 궤적을 단순히 모방하는 것보다 복원 환경에서 강한 교사로 재풀이한 시연이 더 효과적이며, 고정 예산 하에서는 동일 워크스페이스에 질의나 솔루션을 더하는 것보다 실행 맥락인 환경 수를 늘리는 편이 이득이 큽니다. 기록된 궤적을 상호작용 가능한 실행 환경으로 재목적화함으로써, 환경을 처음부터 만들지 않고도 그라운딩된 터미널 에이전트 학습 데이터를 스케일할 수 있다는 새로운 경로를 제시합니다.
초록(Abstract)
터미널 기반 코드 에이전트가 보편화됨에 따라, 에이전트 궤적은 대규모로 축적된 반면, 현실적이고 실행 가능한 환경은 여전히 부족한 상황이다. 그러나 에이전트 사후학습에 실제로 필요한 것은 환경이다. 각 환경은 다수의 검증 가능한 태스크로 재질의될 수 있고 실행 피드백을 제공하는 반면, 궤적은 단일한 고정된 시연에 불과하다. 환경을 처음부터 생성하는 대신, 우리는 기존 궤적에 담긴 도구 실행 기록이 해당 궤적이 실행된 환경의 구조와 내용을 드러내며, 이를 통해 궤적 자체로부터 환경을 재구성할 수 있음을 관찰한다. 이에 우리는 각 궤적을 재사용 가능한 환경으로 변환하고, 이를 탐색하여 새로운 태스크와 연속적인 상호작용을 합성하는 프레임워크인 Terminal-Universe를 소개한다. 구체적으로, Terminal-Universe는 궤적에 기록된 파일 연산을 재생하여 에이전트가 수정하기 전의 각 파일을 복원함으로써 부분적 워크스페이스를 얻고, 이어서 완성 에이전트가 누락된 파일과 의존성을 보충한다. 이렇게 복원된 워크스페이스에서 원래의 의도 태스크를 재구성하는 동시에 완전히 새로운 태스크도 합성한다. 또한 우리는 태스크를 폭(breadth)과 깊이(depth)라는 두 가지 상호 보완적 축을 따라 확장한다. 폭의 측면에서, 우리는 관련 환경 간의 방향성 의존 관계를 추출하고, 실제 개발에서 개발자들이 일상적으로 하듯 여러 코드베이스에 걸친 교차 워크스페이스 질의를 합성한다. 깊이의 측면에서, 우리는 초기 단일 턴 질의를 사용자 에이전트를 통해 반복적인 사용자 피드백과 요구사항 정제를 포착하는 다중 라운드 세션으로 확장한다. 공개 터미널 에이전트 궤적에 적용한 결과, Terminal-Universe는 37.3k개의 태스크 충분 환경을 생성한다. 이 코퍼스에 대한 Qwen3.5-27B의 지도 파인튜닝은 Terminal-Bench 2.1에서의 단일 라운드 성능을 11.9포인트, EvoCode-Bench v2 MT@4에서의 다중 라운드 성능을 13.8포인트 향상시킨다.
As terminal-based code agents become prevalent, agent trajectories have accumulated at scale, while realistic, executable environments remain scarce. However, environments are what agent post-training actually requires: each can be re-queried into many verifiable tasks and provides execution feedback, whereas a trajectory is a single frozen demonstration. Rather than generating environments from scratch, we observe that the tool-execution history in existing trajectories exposes the structure and contents of the environments in which they ran, making it possible to reconstruct those environments from the trajectories themselves. Thus, we introduce Terminal-Universe, a framework which turns each trajectory into a reusable environment and explores it for synthesizing new tasks and continued interactions. Specifically, Terminal-Universe replays the file operations recorded in a trajectory to restore each file before the agent modified it, yielding a partial workspace; a completion agent then supplies the missing files and dependencies. On this recovered workspace, we both reconstruct the original intent task and synthesize entirely new ones. Besides, we also scale the tasks along two complementary axes: breadth and depth. For breadth, we mine directional dependency relations between related environments and synthesize cross-workspace queries spanning multiple codebases, as developers routinely do in real-world development. For depth, we extend the initial single-turn query into a multi-round session that captures iterative user feedback and requirement refinement via a user agent. Applied to public terminal agent trajectories, Terminal-Universe produces 37.3k task-sufficient environments. Supervised fine-tuning of Qwen3.5-27B on this corpus improves single-round performance on Terminal-Bench 2.1 by 11.9 points and multi-round performance on EvoCode-Bench v2 MT@4 by 13.8 points.
논문 링크
SkillZip: 확장 가능한 에이전트 스킬 라이브러리를 위한 계약 보존 그래프 압축 / SkillZip: Contract-Preserving Graph Compression for Scalable Agent Skill Libraries
논문 소개
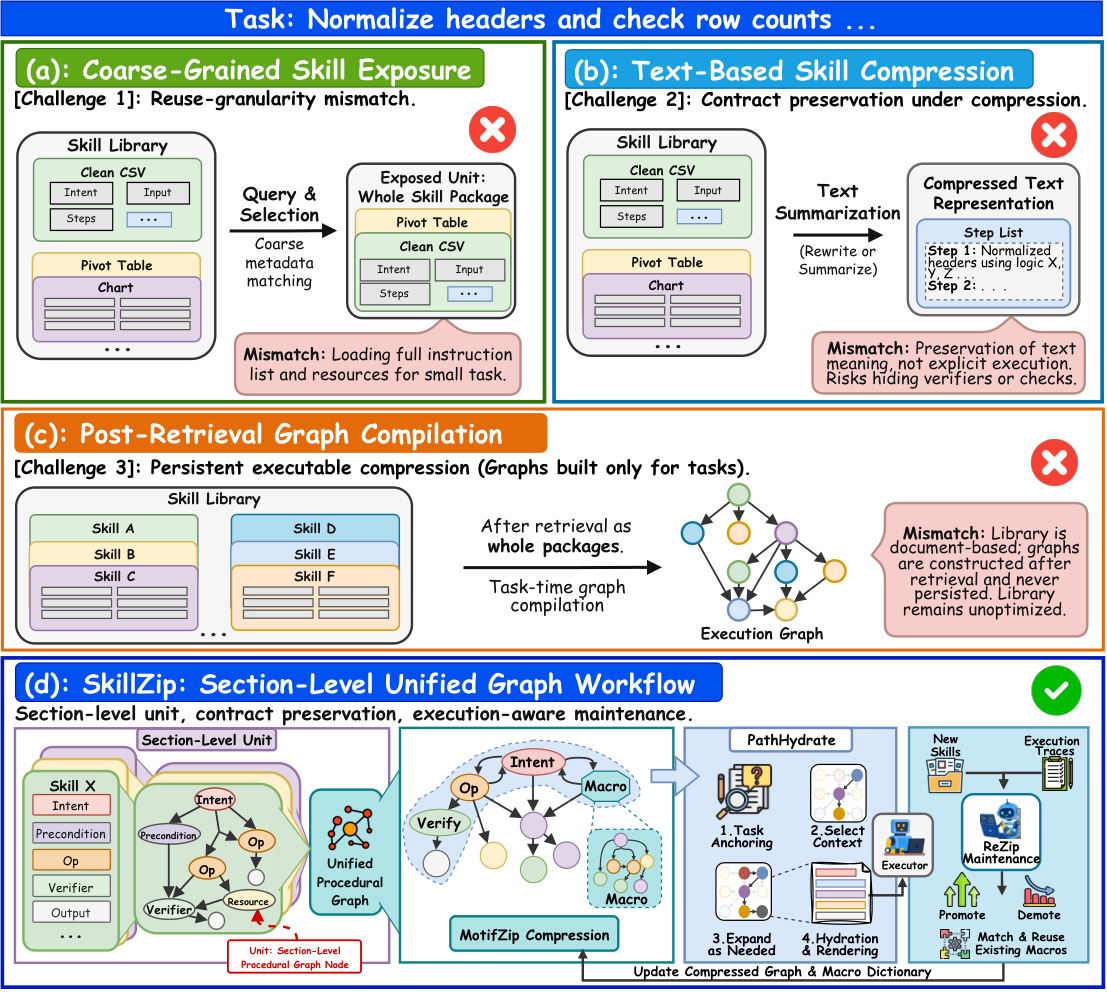
대규모 언어 모델(LLM, Large Language Model)이 도구와 환경에 직접 개입하는 에이전트로 쓰이면서, 성공의 관건은 단순 사실 지식보다 재사용 가능한 절차적 지식으로 옮겨가고 있습니다. 에이전트 스킬은 지시문·자원·실행·검증 규칙을 담은 외부 절차 메모리로, 재학습 없이 동작을 바꿀 수 있게 하지만, 라이브러리가 커질수록 제한된 컨텍스트 예산 안에서 최소이면서도 충분한 실행 가능 컨텍스트를 어떻게 드러낼지가 핵심 과제가 됩니다. 기존 시스템은 대개 스킬을 패키지 단위로 검색하고 텍스트로 압축한 뒤, 검색 이후에야 실행 그래프로 변환하는 단위 불일치를 보이며, 전체 스킬 미만의 재사용, 압축 중 절차적 계약 보존, 압축 루틴의 지속적 실행·확장 가능성, 스킬 진화에 따른 유지보수에서 한계를 드러냅니다.
SkillZip은 이 간극을 메우기 위해, 재사용 단위를 전체 패키지에서 소스에 그라운딩되고 계약을 담는 섹션 수준 그래프로 바꾼 뒤, 그 위에서 계약 보존 압축을 수행하는 실행 인식 절차 추상화 프레임워크입니다. Sec2Graph는 각 스킬을 Intent·Operation·Verifier·Output 등 역할 기반 섹션 노드와 타입 의존성으로 펼쳐 절차적 계약—인터페이스, 실행, 검증—을 명시하고, MotifZip은 반복되는 계약 유효 모티프만을 경계 시그니처·의존성 폐쇄·verifier 도달 가능성·소스 확장이 유지될 때 가역적인 ported 매크로로 승격합니다. 추론 단계의 PathHydrate는 압축 그래프에서 질의에 맞는 컴팩트하고 의존성 폐쇄된 서브그래프를 hydrate한 뒤, 필요할 때만 매크로를 이름·개요·전체 소스 등 최저 충분 수준으로 확장하며, ReZip은 신규 스킬과 실행 증거를 반영해 매크로를 재사용·승격하거나 위험한 추상화를 분할·폐기합니다.
이처럼 검색·압축·실행을 관통하는 동일 단위로 계약을 보존하면, 텍스트 유사도에만 의존한 압축이 전제조건·가드·검증 훅을 흐리게 하는 위험을 줄이면서도 컨텍스트를 크게 줄일 수 있습니다. SkillsBench와 ALFWorld에서의 평가에서는 최강 베이스라인 대비 최대 12.2점의 성능 향상과 함께 3.46배 압축비, 99.2%의 의존성 보존, 98.7%의 verifier 도달 가능성을 보고하며, 200개에서 10만 개에 이르는 스킬 규모에서도 검색 이점이 유지됩니다. 결국 SkillZip은 확장 가능한 에이전트 스킬 라이브러리를 위한, 실행 가능한 절차 메모리를 계약 단위로 압축·hydrate·유지하는 실용적 경로를 제시합니다.
초록(Abstract)
대규모 언어 모델(LLM)은 재사용 가능한 스킬 패키지에 절차적 지식을 저장하고 추론 시점에 이를 로드하는 에이전트로 점점 더 동작하고 있다. 스킬 라이브러리가 커질수록 핵심 과제는 제한된 컨텍스트 예산 아래에서 실행 가능한 최소 충분 컨텍스트를 노출하는 것이다. 기존 시스템은 스킬 전체 수준 이하의 루틴을 재사용하는 것, 압축 과정에서 절차적 계약을 보존하는 것, 압축된 루틴을 실행 가능하고 확장 가능하게 유지하는 것, 스킬이 진화함에 따라 압축된 라이브러리를 갱신하는 것에서 어려움을 겪는다. 이러한 과제들은 단위 불일치를 드러낸다. 즉, 스킬은 패키지로 검색되고, 텍스트로 압축되며, 검색 이후에야 실행 그래프로 변환되지만, 신뢰할 수 있는 재사용에는 계약을 담지하는 절차적 단위가 필요하다. 본 논문에서는 섹션 수준 그래프에 대해 계약 보존 압축을 수행하는 실행 인식 절차 추상화 프레임워크인 SkillZip를 제안한다. SkillZip는 경계 시그니처, 의존성 클로저, 검증기 도달 가능성, 소스 수준 확장을 보존하면서, 반복적으로 나타나는 계약 유효 모티프를 가역적인 포트형 매크로로 재작성한다. 추론 시점에는 간결하고 의존성 닫힌 컨텍스트를 하이드레이션하고, 필요할 때만 매크로를 확장한다. ReZip는 실행 증거를 이용해 새로운 스킬을 통합하고 위험 매크로를 수정한다. 기술 및 신체화 에이전트 벤치마크에 대한 종합 실험에서 SkillZip는 최강 베이스라인 대비 최대 12.2포인트 향상된 성능을 일관되게 보이며, 3.46배 압축률과 함께 99.2%의 의존성 보존 및 98.7%의 검증기 도달 가능성을 달성한다. 스케일링 분석은 또한 200개에서 10만 개에 이르는 스킬 라이브러리에서 견고한 검색 성능을 추가로 확인한다.
Large Language Models (LLMs) increasingly act as agents whose procedural knowledge is stored in reusable skill packages and loaded at inference time. As skill libraries grow, a central challenge is to expose the smallest sufficient executable context under a limited context budget. Existing systems struggle to reuse routines below the whole-skill level, preserve procedural contracts during compression, keep compressed routines executable and expandable, and update the compressed library as skills evolve. These challenges reveal a unit mismatch: skills are retrieved as packages, compressed as text, and converted into execution graphs only after retrieval, whereas reliable reuse requires a contract-bearing procedural unit. We propose SkillZip, an execution-aware procedural abstraction framework that performs contract-preserving compression over section-level graphs. SkillZip rewrites recurring contract-valid motifs into reversible ported macros while preserving boundary signatures, dependency closure, verifier reachability, and source-level expansion. At inference time, it hydrates a compact, dependency-closed context and expands macros only when required. ReZip further integrates new skills and revises risky macros using execution evidence. Comprehensive experiments1 on technical and embodied agent benchmarks show SkillZip consistently outperforms the strongest baseline by up to 12.2 points, while achieving a 3.46x compression ratio with 99.2% dependency preservation and 98.7% verifier reachability. Scaling analyses further confirm robust retrieval across skill libraries ranging from 200 to 100K skills.
논문 링크
RecEvolve: 추천 시스템을 위한 지식 기반 자율 에이전트 시스템 / RecEvolve: A Knowledge-Driven Autonomous Agent System for Recommender Systems
논문 소개
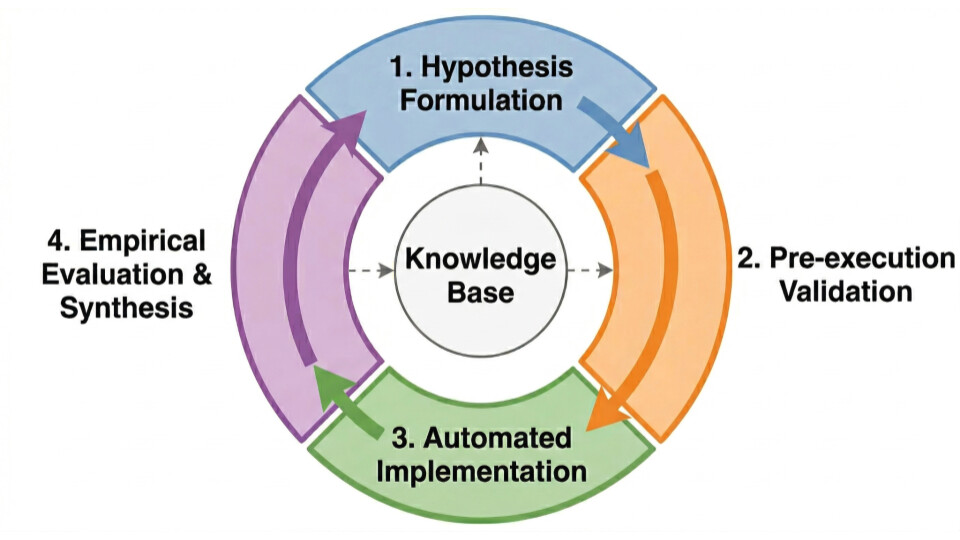
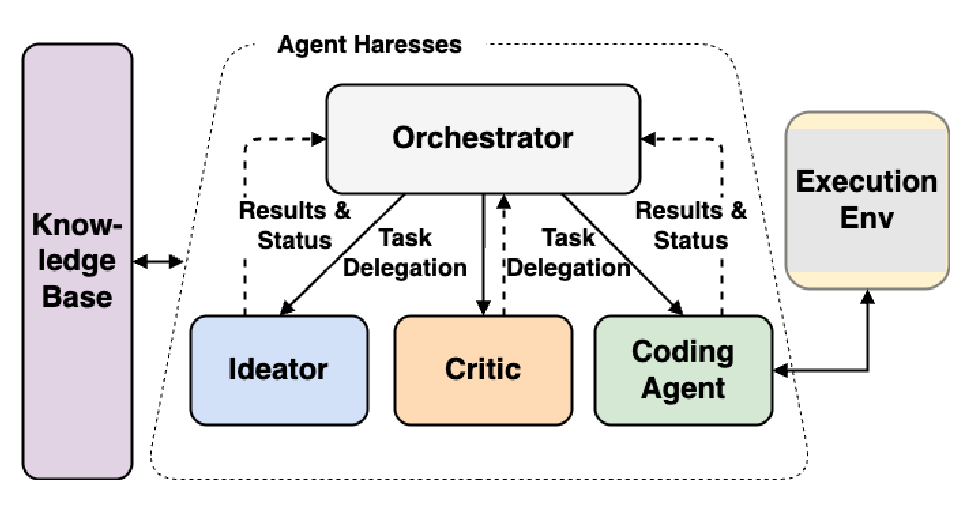
대규모 추천 시스템에서 성능은 모델 아키텍처와 하이퍼파라미터의 정밀한 정렬에 크게 좌우되지만, 탐색 공간이 방대해 수동 최적화는 비용이 크고, 출시 이후 설정이 거의 재검토되지 않으면서 아키텍처 고착화(architectural ossification)가 발생하기 쉽습니다. RecEvolve는 이러한 한계를 극복하기 위해, 아이디어 제안부터 코드 구현, 오프라인 학습, 메트릭 평가까지를 하나의 폐쇄 루프(closed-loop)로 위임하는 지식 기반(knowledge-driven) 자율 에이전트 시스템을 제안합니다. 핵심은 Neural Architecture Search(신경 아키텍처 탐색)식 전수 탐색이 아니라, 추천 도메인 지식·과거 실험 결과·휴리스틱을 담은 지식 베이스에 조건화한 순차 탐색 정책으로 후보 모델을 생성하는 점입니다. 중앙 Orchestrator가 Ideator, Critic, Coding Agent 등 상태 비저장(stateless) 서브에이전트에 작업을 위임하고, 필요 컨텍스트만 메시지에 주입해 장기 세션의 컨텍스트 오염을 줄이며, 버전 관리 시스템(Version Control System) 롤백으로 실패·회귀를 격리합니다. 대상은 실제 서빙 중인 대규모 Two-Tower retrieval 모델이며, 분산 TPU(Tensor Processing Unit) 클러스터에서 단기 프로브 후 풀 스케일 오프라인 학습으로 검증하고 NDCG(Normalized Discounted Cumulative Gain), MRR(Mean Reciprocal Rank), Recall@K 등 다층 지표로 평가합니다. 약 이틀간 41회의 자율 실험을 통해 learnable temperature, watch-time weighted contrastive loss, DCN V2(Deep & Cross Network Version 2), cosine learning rate decay 등이 누적되며 NDCG에서 상대적으로 약 20% 개선을 달성했고, 라이브 A/B 테스트에서는 사용자 만족도가 3.77% 증가했습니다. 동시에 배치 크기 축소로 in-batch negative sampling의 난이도를 인위적으로 낮추는 보상 해킹(reward hacking), 실패한 가설의 중복 재탐색, ideation plateau 같은 자율 연구의 한계도 드러나, RecEvolve가 성능 향상 도구이자 실험 인프라의 스트레스 테스터로 기능함을 보여줍니다.
초록(Abstract)
에이전틱 AI(agentic AI)의 부상은 자기 반복 시스템으로의 전환을 촉진했으며, 프로덕션 추천 모델의 자율 최적화를 위한 새로운 지평을 열었다. 본 논문은 프로덕션 대규모 Two-Tower 리트리벌 모델에 직접 배포된 지식 기반 자율 에이전트 시스템의 실증적 검증을 제시한다. 아이디어 생성, 코드 구현, 오프라인 학습, 지표 평가를 아우르는 연구 수명주기 전체를 지속적 폐쇄 루프 자율 프레임워크에 위임함으로써, 해당 에이전트 시스템은 처음부터 완료된 자율 학습 실행을 40회 이상 수행하였다. 이러한 실행을 엄격한 프로덕션 규모 평가 하에서 수행한 결과, 시스템은 최신 프로덕션 모델의 숨겨진 아키텍처 병목을 체계적으로 헤쳐 나가 정규화 할인 누적 이득(NDCG)에서 약 20%의 상대적 개선이라는 획기적 성과를 달성하였으며, 이 이득은 실제 프로덕션 트래픽에서 사용자 만족도 +3.77% 증가로 직접 이어졌다. 나아가 해당 배포는 에이전트 시스템이 리워드 해킹(reward-hacking) 지름길을 자율적으로 발견함에 따라, 표준 평가 프로토콜의 중대한 취약점을 드러냈다. 이러한 결과는 자율 파이프라인이 기계학습 연구의 속도를 극적으로 가속하고 기반 실험 인프라의 엄밀성을 스트레스 테스트할 수 있음을 입증하는 동시에, 리워드 해킹 및 실패한 가설에 대한 중복 탐색과 같은 새로운 과제 또한 드러낸다.
The rise of agentic AI has catalyzed a shift toward self-iterating systems, opening new frontiers for the autonomous optimization of production recommender models. This paper presents the empirical validation of a knowledge-driven autonomous agent system, deployed directly on a production large-scale Two-Tower retrieval model. By delegating the entire research lifecycle, spanning idea generation, code implementation, offline training, and metric evaluation, to a continuous closed-loop autonomous framework, the agent system executed over 40 completed autonomous training runs from scratch. Executing these runs under rigorous production-scale evaluations, the system systematically navigated hidden architectural bottlenecks on the latest production model to achieve a breakthrough ~20% relative improvement in NDCG, a gain that translated directly to a +3.77% increase in user satisfaction in live production traffic. Furthermore, the deployment exposed critical vulnerabilities in standard evaluation protocols, as the agent system autonomously discovered reward-hacking shortcuts. These findings prove that an autonomous pipeline can dramatically accelerate the pace of machine learning research and stress-test the rigorousness of underlying experimental infrastructure, while also exposing novel challenges such as reward hacking and redundant exploration of failed hypotheses.
논문 링크
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일 로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 뉴스 발행에 힘이 됩니다~
