PyTorchKR


이번 주에 선정된 논문들을 종합해 보면, AI 모델을 더욱 실용적이고 효율적인 시스템으로 발전시키기 위한 세 가지 연구 흐름을 확인할 수 있습니다:
 에이전트 하네스 최적화 및 자기개선의 고도화: 이번 주 선정된 논문들을 살펴보면, 대규모 언어 모델의 가중치 자체보다 에이전트를 둘러싼 프롬프트나 제어 흐름인 하네스를 최적화하여 성능을 극대화하는 연구가 돋보입니다. SoL-Pi와 RRSI는 에이전트의 재귀적 자기개선 과정을 정규화하고 자동화하여, 특정 작업에 과적합되는 현상을 방지하면서도 토큰 사용량과 구동 비용을 크게 절감했습니다. 또한 Harness-Zero는 외부 하네스에 의존하던 기존 에이전트의 한계를 넘어, 하네스가 유도하는 행동을 모델 내부 가중치로 증류시킴으로써 배포 시의 효율성과 자율성을 높였습니다. 이는 무작정 모델의 크기를 키우기보다, 에이전트의 시스템적 작동 방식을 내재화하여 운영 비용과 성능을 모두 잡으려는 실용적인 접근입니다.
 실세계 배포를 위한 지식 증류 및 시스템 경량화: 또 다른 주요 트렌드는 무겁고 복잡한 모델을 하드웨어 한계가 명확한 실제 환경이나 기존 산업 인프라에 원활하게 통합하기 위한 경량화 시도입니다. 시각-언어-행동 모델을 다룬 연구에서는 무거운 세계 모델이 가진 물리적 이해 능력을 작고 빠른 정책 모델로 증류하여 로봇의 실제 응답 시간을 밀리초 단위로 단축시켰습니다. 또한 개인화 관련 논문은 모바일 기기 내에서 하이퍼네트워크를 통해 순전파만으로 가중치를 생성해 온디바이스 연산의 한계를 극복했으며, LIGE-GR는 기존의 추천 인프라를 전면 교체하지 않고도 생성형 추천 패러다임으로 부드럽게 전환하는 방법을 제안했습니다. 이는 고성능 AI를 연구실 밖의 모바일 기기, 로봇, 대규모 상용 서비스에 안정적으로 안착시키기 위한 필수적인 진전입니다.
 복잡한 추론을 위한 기억 구조 및 다중 모달리티의 통합: 마지막으로, 모델이 더 길고 복잡한 문맥을 이해할 수 있도록 기억 구조를 개편하고 이종 데이터를 하나의 공간으로 통합하려는 시도 역시 두드러집니다. Jev-Mem은 인간의 인지 구조를 빌려 빠르고 가벼운 기억 검색과 깊이 있는 추론을 분리함으로써 지연 시간을 획기적으로 줄였습니다. WFM(Wiki Foundation Model) 은 기존의 그래프 대신 밀집 문서 맥락과 연결망을 결합한 방식을 채택해 장기 기억 성능을 끌어올렸으며, Ovis-Embedding은 텍스트부터 비디오, 오디오까지 모든 모달리티를 파편화 없이 단일 표현 공간으로 묶어냈습니다. 더불어 SlopShape는 텍스트의 표면적 단어가 아닌 정보가 제시되는 구조적 서명을 분석해 AI를 판별함으로써, 단편적인 데이터 처리 너머의 본질적인 구조와 의미를 포착하려는 공통된 흐름을 보여줍니다.
논문별 핵심 내용 간략 요약
-
Harness-Zero: 에이전트 하네스가 유도하는 최적의 행동을 모델 가중치로 증류하여, 배포 시 외부 하네스 없이도 높은 작업 성공률을 유지하게 만드는 방법론을 제시합니다.
-
SoL-Pi: 코딩 에이전트의 재귀적 자기개선 과정에서 발생하는 토큰 비효율을 해결하기 위해, 하네스 계층에서 자동 연구 루프를 스케일링하여 API 비용과 토큰 트래픽을 대폭 절감합니다.
-
Jev-Mem: 인지 이론에 기반하여 빠르고 가벼운 통제 평면과 느리고 깊은 추론 평면을 분리함으로써, 에이전트의 기억 구성 및 검색 속도를 크게 높인 새로운 아키텍처를 제안합니다.
-
WFM(Wiki Foundation Model) : 밀집된 문서 맥락과 다층적 토폴로지 링크를 결합한 위키 그래프 스키마를 통해, 기존 검색 방식의 한계를 극복하고 에이전트의 복합적인 동적 추론을 지원합니다.
-
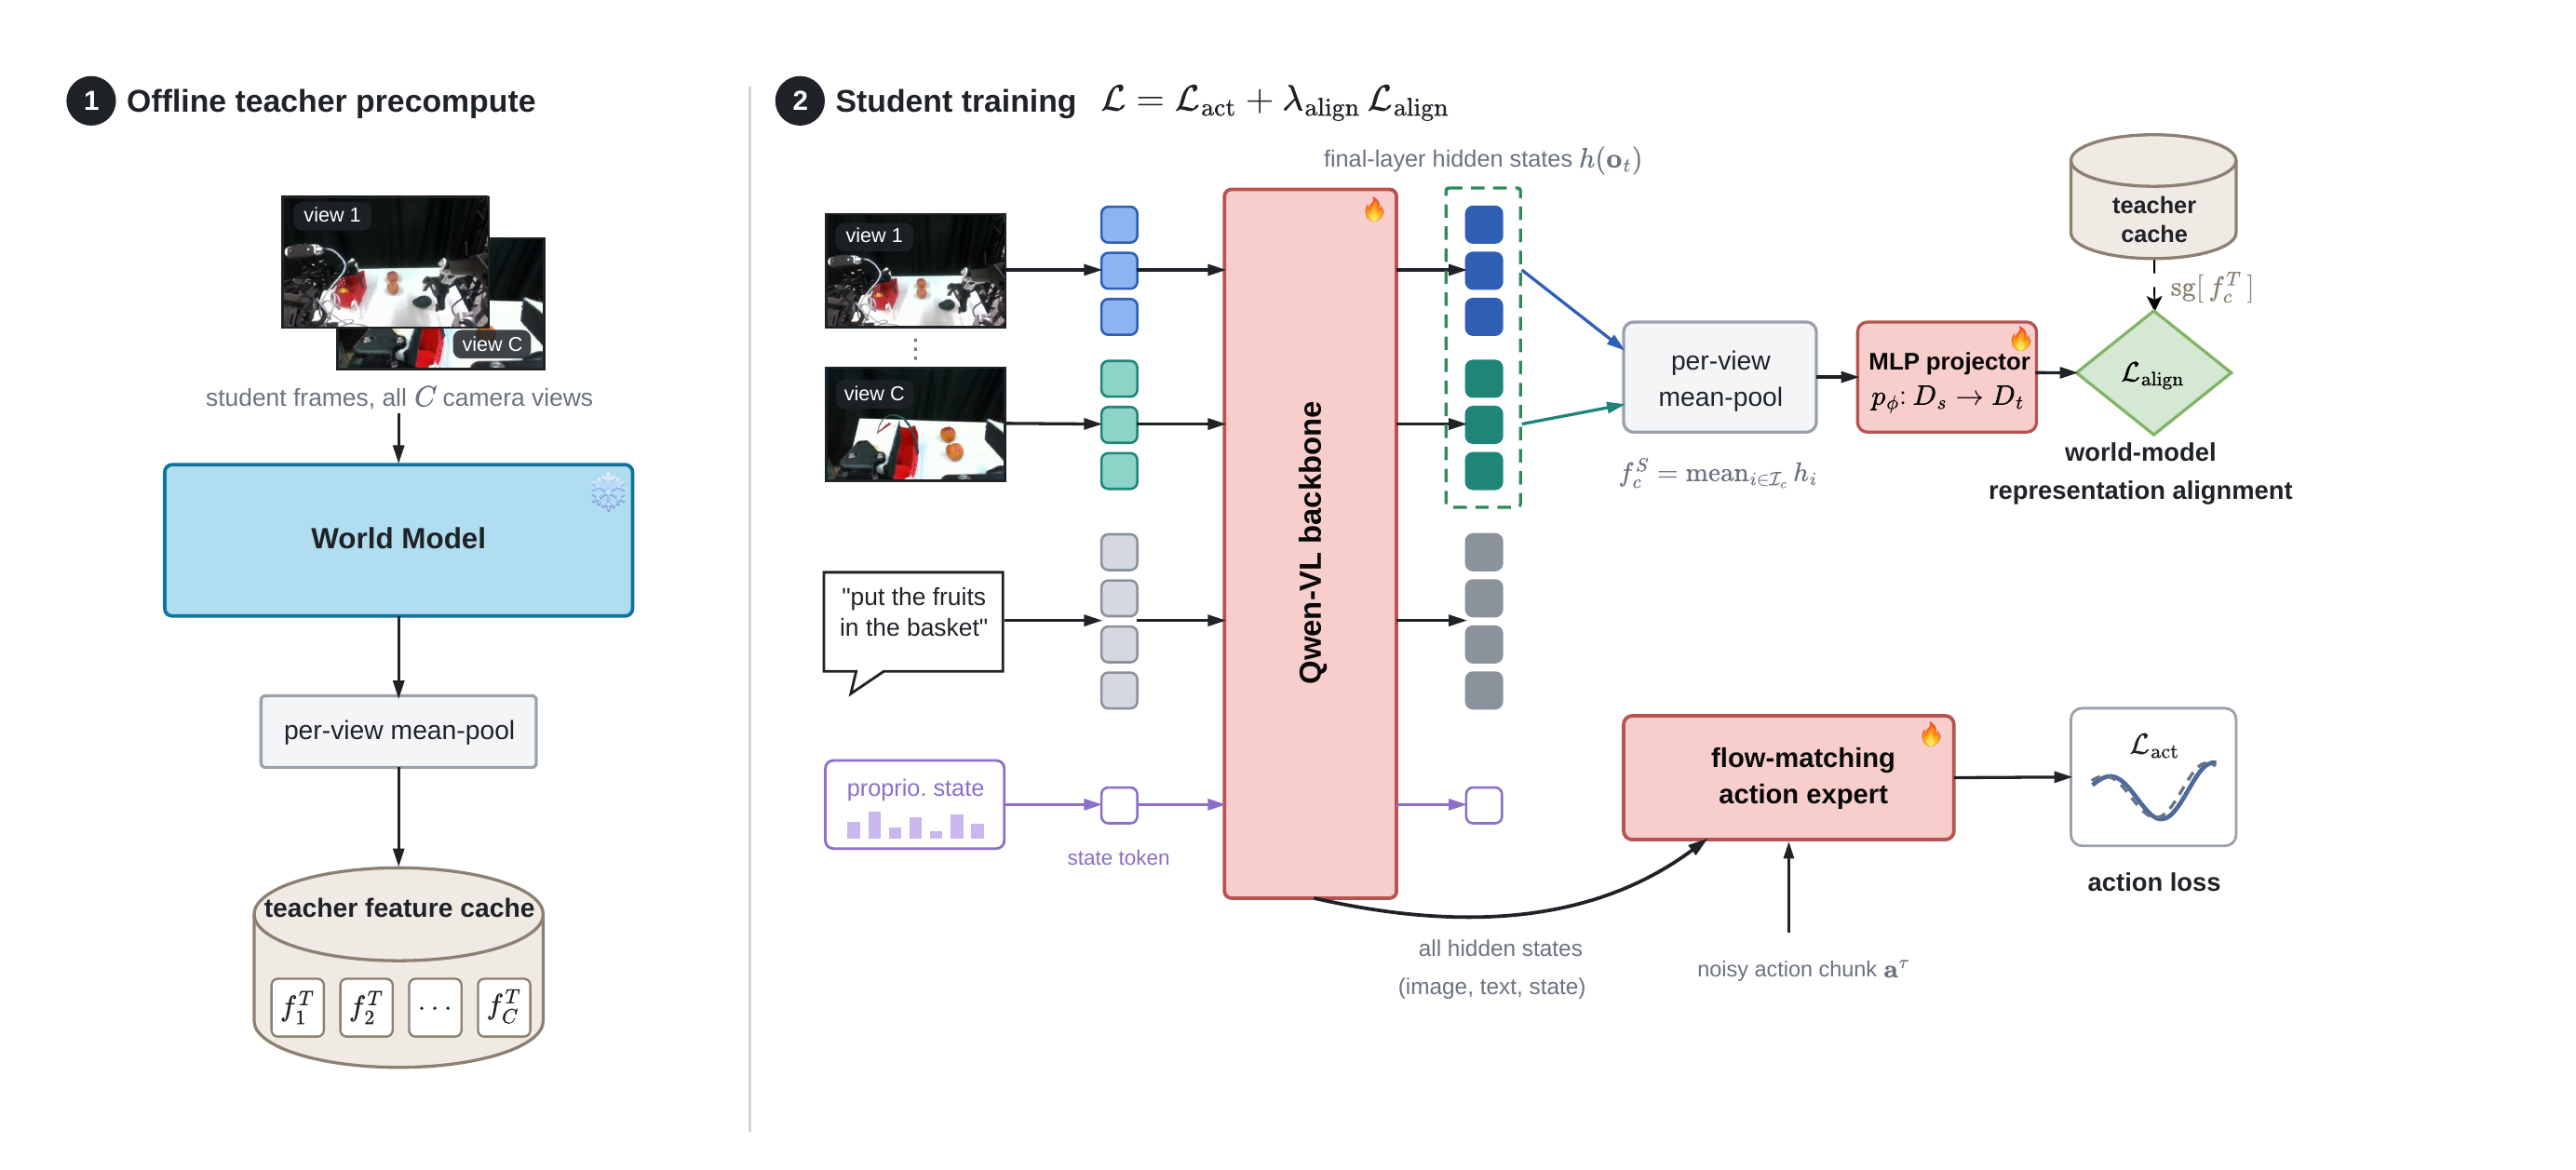
세계 모델 표현 증류: 무거운 세계 모델이 가진 물리적 장면에 대한 지식을 고정된 캐시로 추출하고 이를 학생 정책 모델에 학습시켜, 로봇이 실시간으로 빠르고 강건하게 반응할 수 있도록 합니다.
-
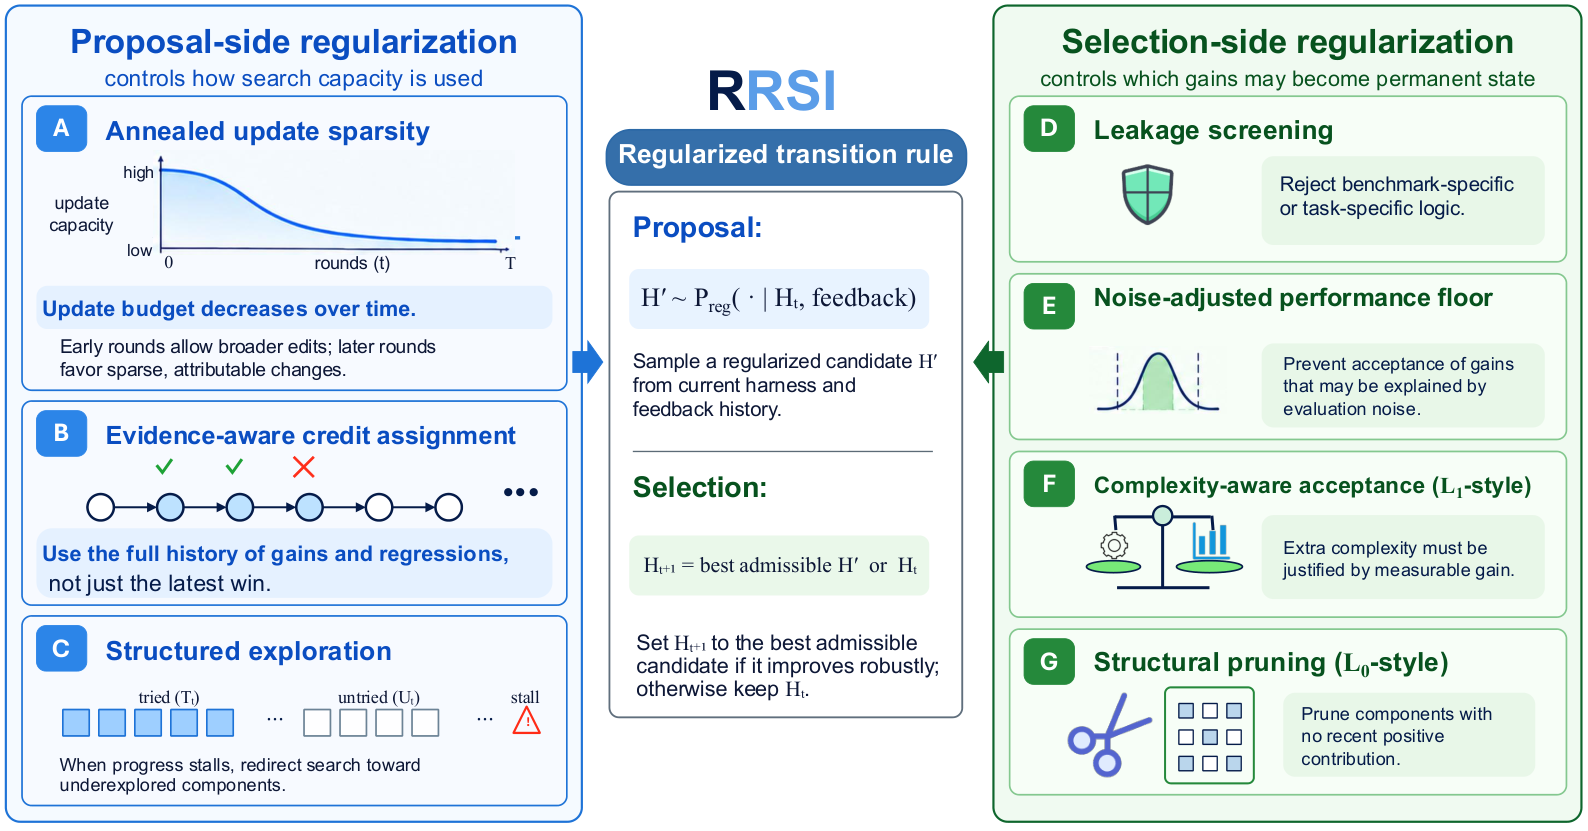
RRSI: 에이전트 하네스의 편집과 탐색 과정에 정규화 기법을 도입하여, 특정 평가 지표에 과적합되는 현상을 막고 범용적으로 재사용 가능한 시스템 개선을 이끌어냅니다.
-
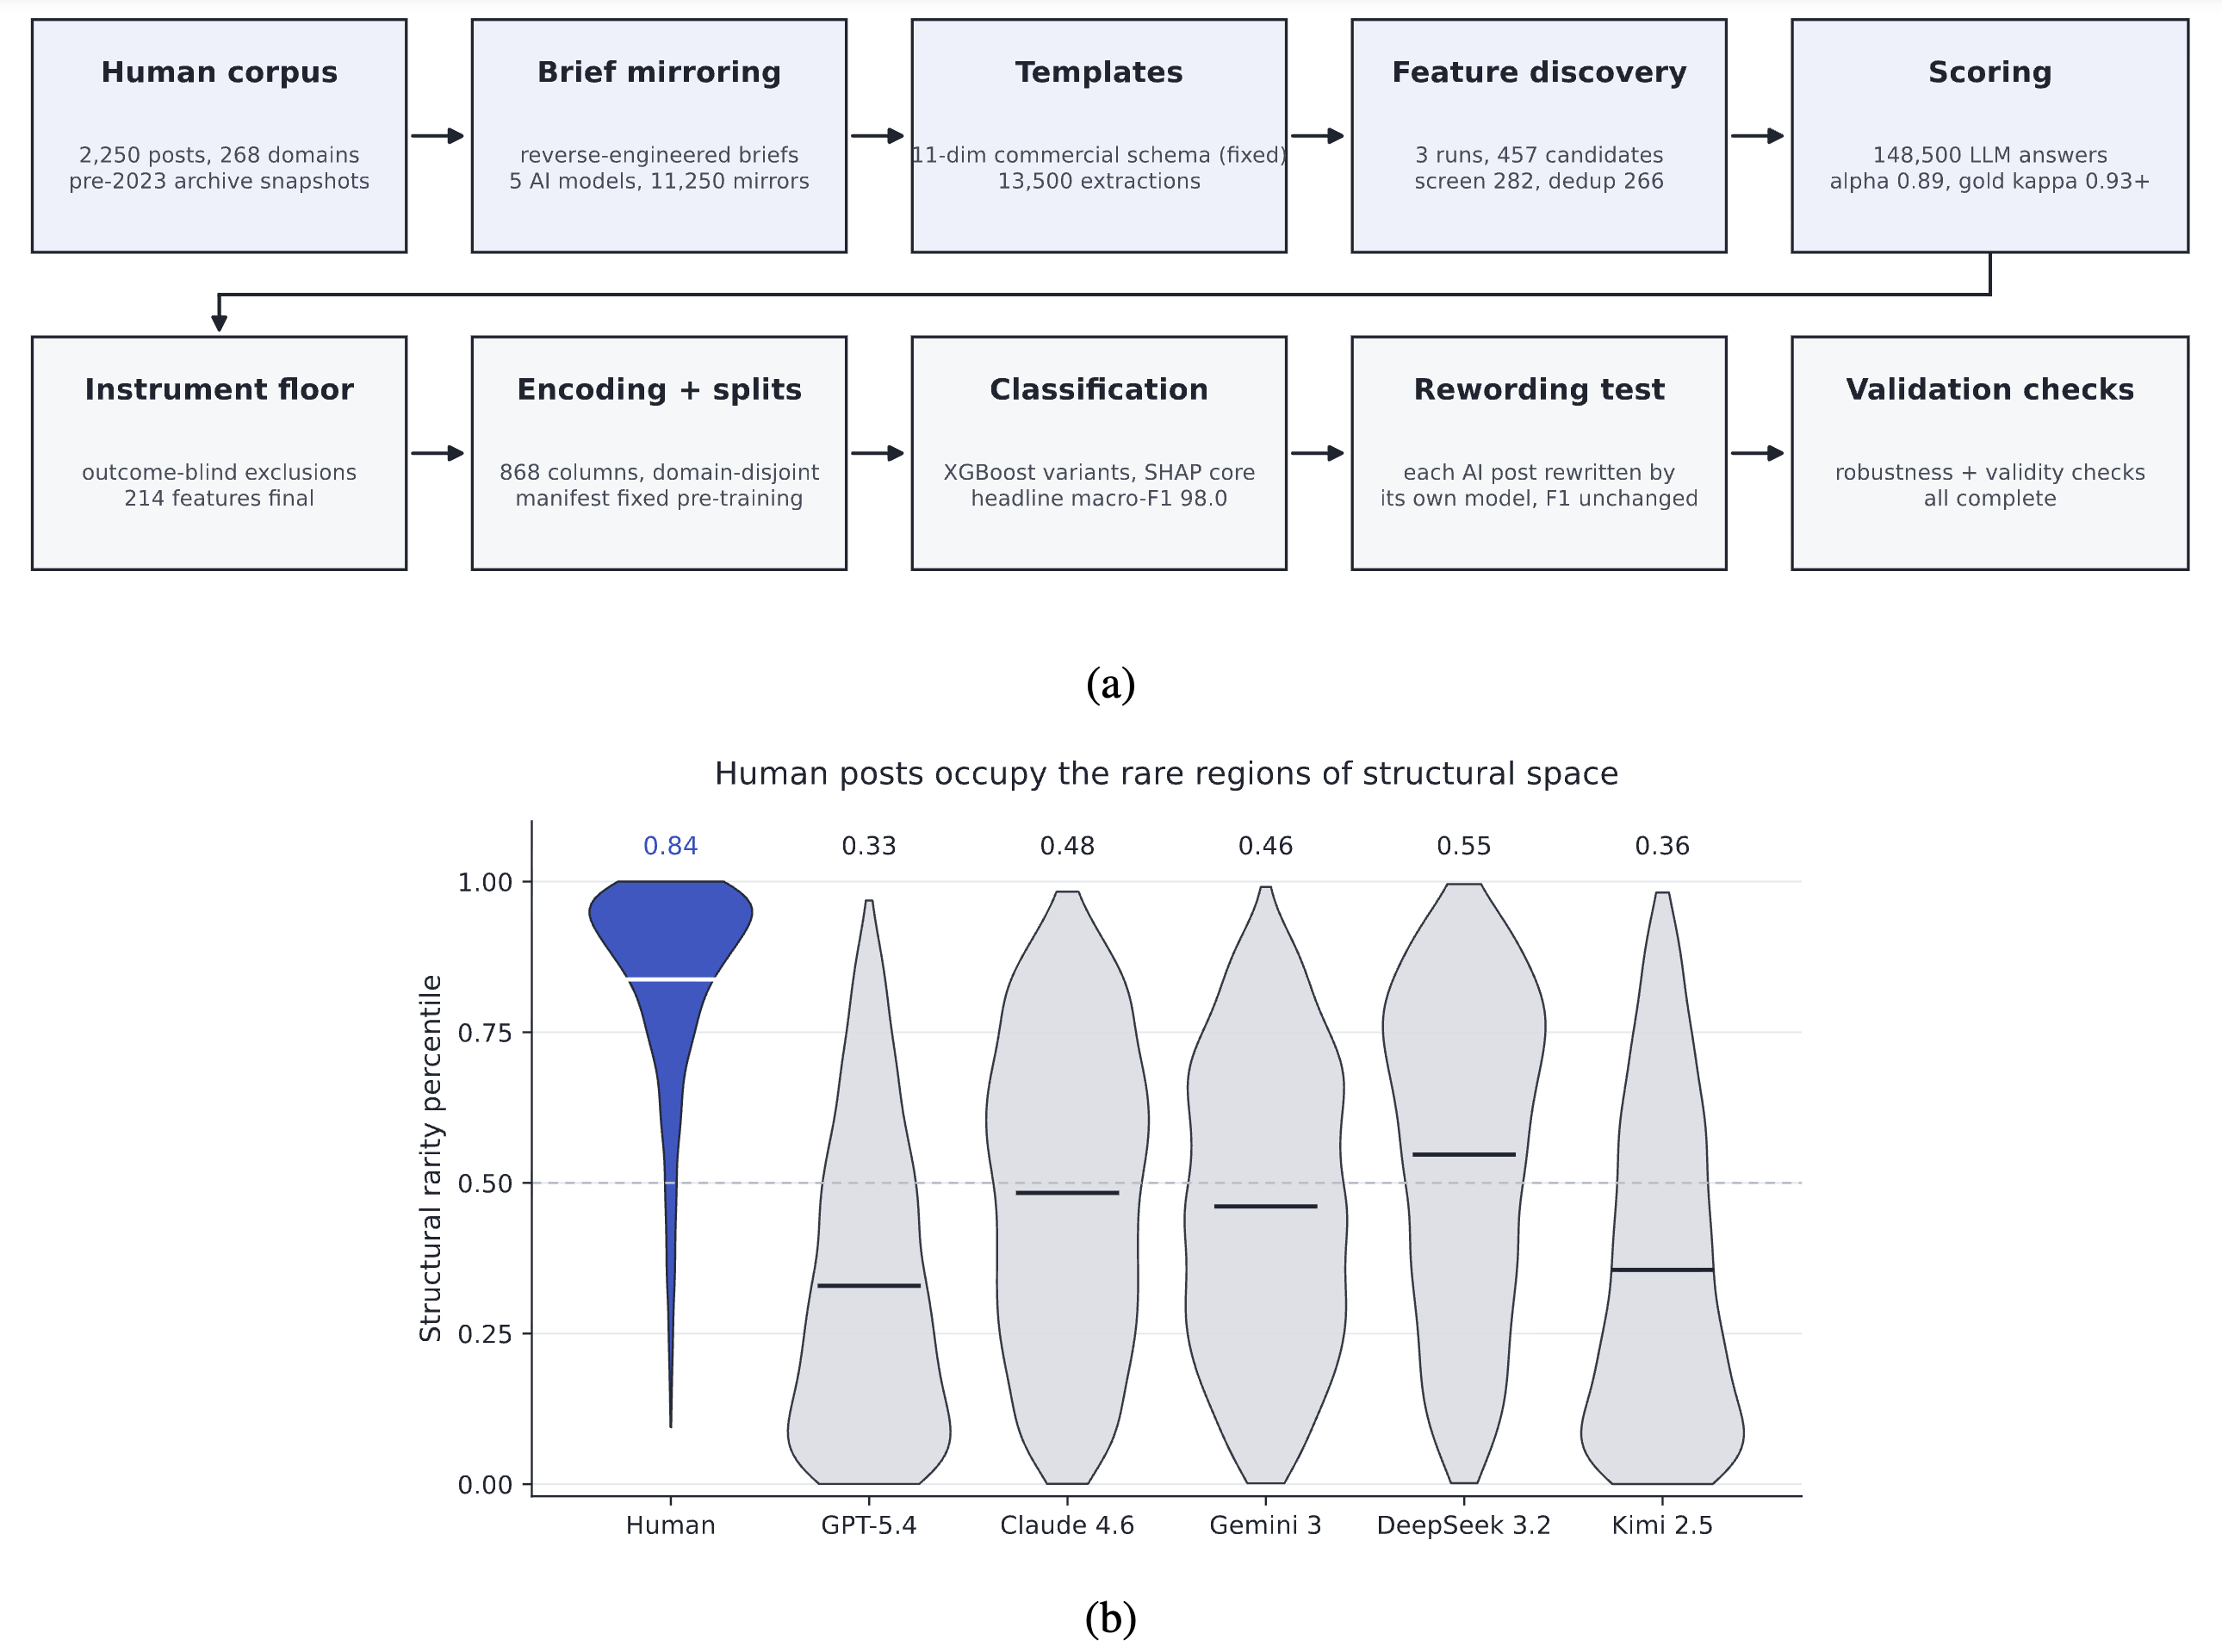
SlopShape: AI가 생성한 상업용 웹 콘텐츠를 단어가 아닌 정보 제시 순서, 근거, 어조 등 구조적 특징을 통해 식별하여, 재작성 우회 공격에 강건한 탐지 체계를 구축했습니다.
-
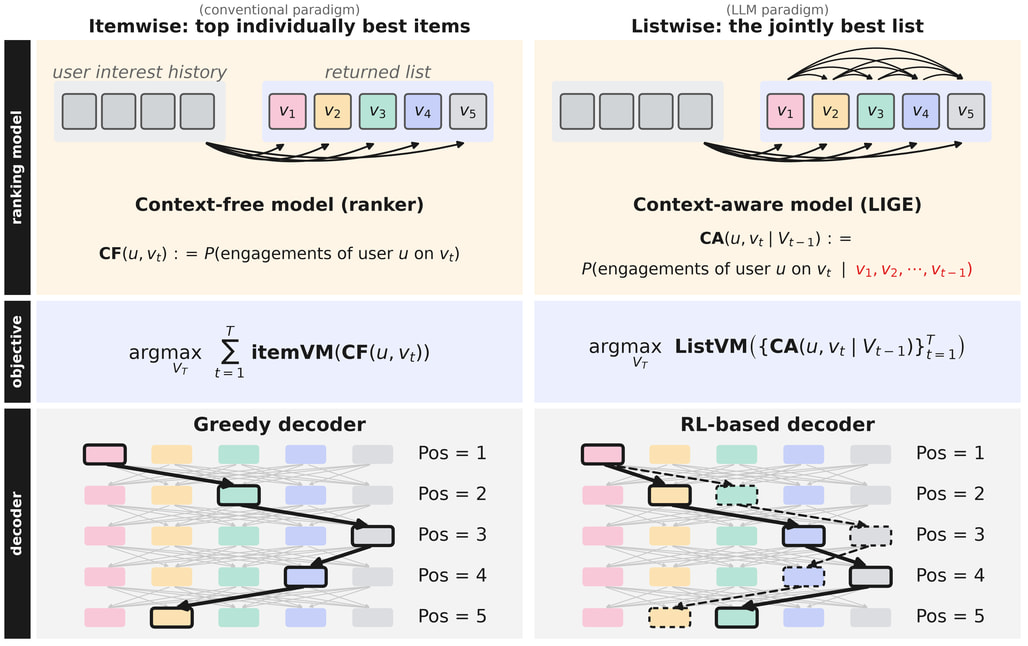
LIGE-GR: 기존 산업용 추천 시스템의 인프라를 유지하면서 컨텍스트 인식 모듈과 리스트 기반 평가를 도입해, 기존 랭킹 시스템에서 생성형 추천으로 안전하게 전환하는 프레임워크를 선보입니다.
-
LoRA-generating hypernetworks: 기기 내에서 사용자의 컨텍스트를 기반으로 맞춤형 가중치를 합성함으로써, 지연 시간 증가 없이 장문 생성 품질을 높이는 효율적인 모바일 LLM 개인화 방안을 제시합니다.
-
Ovis-Embedding: 텍스트, 이미지, 비디오, 오디오를 개별 타워가 아닌 단일 옴니모달 백본으로 통합하여, 서로 다른 모달리티 간의 직접적이고 세밀한 검색을 가능하게 하는 범용 임베딩 모델입니다.
하네스-제로: 에이전트를 활용한 하네스 증류 / Harness-Zero: Harness Distillation via Agent-as-Harness
논문 소개
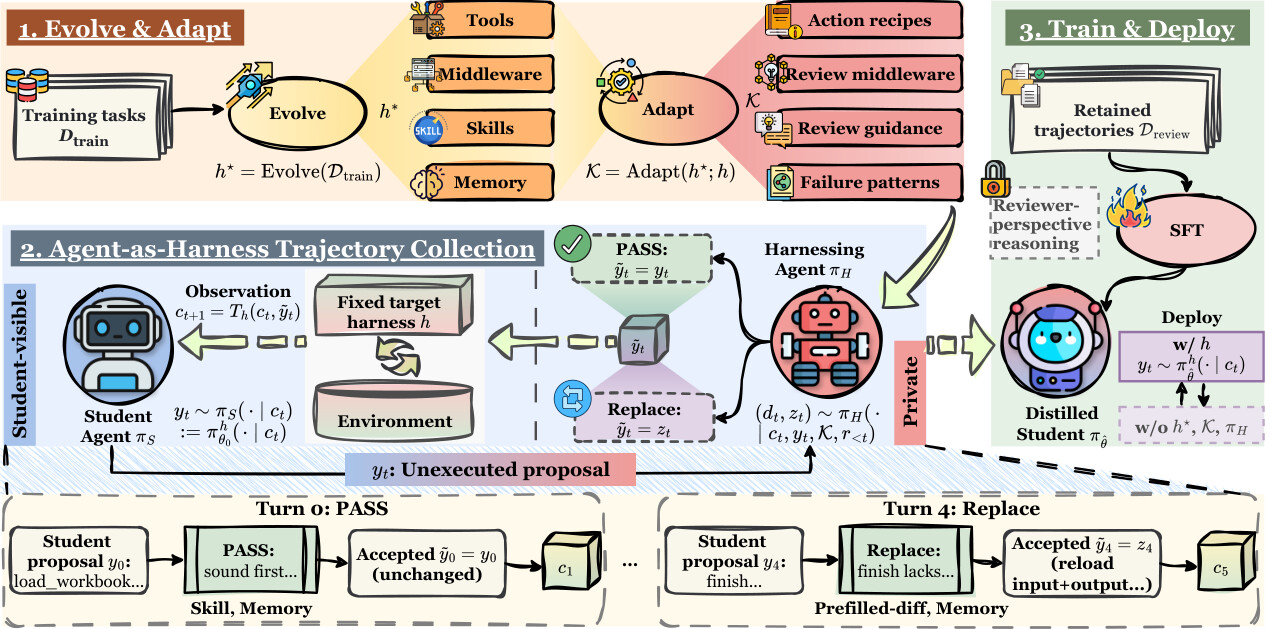
에이전트 하네스는 모델과 환경 간의 상호작용을 중재하여 에이전트의 성능을 크게 향상시키는 중요한 요소로 작용하지만, 그 효과는 배포 시 하네스에 의존하는 문제점이 존재한다. 최적의 하네스는 도메인이나 인스턴스, 모델에 따라 다르기 때문에 범용 에이전트는 최적화된 공유 하네스를 사용하거나 다양한 전문 하네스 중에서 선택해야 하는 어려움에 직면하게 된다. 이러한 문제를 해결하기 위해 연구에서는 하네스 증류를 통해 도메인 또는 인스턴스 최적화된 하네스를 학습 중 가이드로 활용하고, 이를 통해 유도된 행동을 모델 가중치로 전이함으로써 고정된 목표 하네스 하에서도 성과를 유지할 수 있는 방법론을 제시한다. 최적화된 하네스와 목표 하네스 간의 액션 스페이스와 정보의 차이로 인해, 최적화된 하네스의 가이드를 직접적으로 목표 하네스의 감독으로 사용할 수 없는 문제를 해결하기 위해 Harness-Zero를 고안하였다. 이 방법은 하네스를 에이전트로 활용하여 하네스 증류를 가능하게 하며, 최적화된 하네스에 의해 유도된 가이드를 바탕으로 하네스 에이전트가 목표 하네스의 액션 스페이스 내에서 학생의 응답을 수정하여 하네스 가이드를 학습 시 시연으로 변환한다.
이 과정을 통해 생성된 궤적에 대해 파인튜닝을 실시하여 하네스 유도 행동이 모델에 내재화되도록 하고, 결과적으로 배포 시 전문 하네스를 제거할 수 있게 된다. 연구 결과는 지식 작업, 도구 사용, 과학 분야를 포함한 다양한 실험을 통해 검증되었으며, 에이전트를 하네스로 사용할 경우 코드 하네스보다 우수한 성능을 보임을 확인하였다. 특히, 전문 하네스가 제거된 후에도 기본 모델의 매크로 평균 작업 성공률이 크게 개선되는 것을 보여주었으며, 기본 모델에서 누락된 하네스 유도 행동을 회복하는 데에도 성공하였다. 이러한 연구는 에이전트 성능 최적화를 위한 새로운 방법론을 제시하며, 머신러닝 및 인공지능 분야에서의 활용 가능성을 한층 넓힌다. Harness-Zero는 기존 하네스를 활용하는 혁신적인 접근 방식을 통해 보다 효과적인 학습을 가능하게 하여, 다양한 도메인에서의 응용 가능성을 제시하고 있다.
초록(Abstract)
에이전트가 모델-환경 상호작용을 중재하는 외부 시스템인 하네스를 활용하는 것은 에이전트의 성능을 상당히 향상시킬 수 있지만, 이러한 이점은 배포 시 하네스에 묶여 있습니다. 최상의 하네스는 도메인, 인스턴스 및 모델에 따라 달라지기 때문에 범용 에이전트는 최적이 아닌 공유 하네스에 만족하거나 점점 더 많은 특화된 하네스 사이를 전환해야 합니다. 따라서 우리는 에이전트 하네스 증류를 연구합니다: 도메인 또는 인스턴스 최적화된 하네스를 학습 시 가이드로 사용하고, 이로 인해 유도된 행동을 모델 가중치로 전이하여 단일 고정 목표 하네스 하에서도 이득이 지속되도록 합니다. 문제는 두 하네스가 행동 공간과 사용 가능한 정보에서 다르기 때문에 최적화된 하네스에서의 가이드는 목표 하네스에 대한 감독으로 직접 사용할 수 없다는 것입니다. 우리는 에이전트를 하네스로 활용한 하네스-제로(Harness-Zero)를 소개합니다. 최적화된 하네스에 의해 안내된 하네스 에이전트는 목표 하네스의 행동 공간에서 실행 전에 학생의 응답을 수정하여 하네스 가이드를 학습 데모로 전환합니다. 결과적인 경로에서의 파인튜닝은 모델에 하네스 유도 행동을 내재화하여 배포 시 특화된 하네스를 제거할 수 있게 합니다. 지식 작업, 도구 사용 및 과학 도메인을 아우르는 우리의 실험은 다음과 같은 결과를 보여줍니다: (1) 동일한 진화된 하네스를 사용하는 최전선 대규모 언어 모델에서 에이전트-하네스가 코드-하네스보다 뛰어난 성능을 보입니다. (2) 배포 시 특화된 하네스가 제거된 상태에서 하네스-제로는 기본 모델의 매크로 평균 작업 성공률을 23.3%에서 44.3%로 향상시키며, 여전히 해당 하네스가 부착된 상태에서의 41.7%를 초과합니다. (3) 하네스-제로는 기본 모델에서 결여된 하네스 유도 행동을 회복하며, 세 가지 도메인에서 28개의 패턴에 대해 평균 82.3%의 회복률을 보입니다.
Agent harnesses, the external systems that mediate model-environment interaction, can substantially improve agent performance, but their gains remain tied to the harness at deployment. Because the best harness varies across domains, instances, and models, a general-purpose agent must either settle for a suboptimal shared harness or route among an ever-growing set of specialized ones. We therefore study agent harness distillation: using a domain- or instance-optimized harness as training-time guidance and transferring the behaviors it induces into model weights, so that its gains survive under a single fixed target harness. The challenge is that the two harnesses differ in action space and available information, so guidance from the optimized harness cannot serve directly as supervision for the target one. We introduce Harness-Zero, which enables harness distillation through agent-as-harness. Guided by the optimized harness, a harnessing agent corrects student responses before execution in the target harness's action space, turning harness guidance into training demonstrations. Fine-tuning on the resulting trajectories internalizes harness-induced behavior into the model, so the specialized harness can be removed at deployment. Our experiments spanning knowledge work, tool use, and science domains show that: (1) For frontier LLMs using the same evolved harness, agent-as-harness outperforms code-as-harness. (2) With the specialized harness removed at deployment, Harness-Zero improves the base model's macro-average task success from 23.3% to 44.3%, even exceeding the 41.7% it reaches with that harness still attached. (3) Harness-Zero recovers harness-induced behaviors absent from the base model, with 82.3% average recovery across 28 patterns in the three domains.
논문 링크
더 읽어보기
SoL-Pi: 효율적인 에이전트 하네스를 위한 자동 연구 루프의 재귀적 스케일링 / SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
논문 소개
코딩 에이전트가 감독형 코드 완성에서 무인·장시간 탐색으로 확장되면서, 작업은 단일 예측이 아니라 추론·도구 사용·피드백이 이어지는 긴 궤적으로 바뀌고, 재귀적 자기개선(Recursive Self-Improvement, RSI)을 스케일링할 때 토큰 효율이 1차 시스템 문제로 떠오릅니다. 기존 효율 연구가 어텐션 커널, 서빙 인프라, 양자화(quantization), 저가 모델 사용처럼 토큰당 비용이나 모델 쪽을 줄이는 데 집중해 온 것과 달리, SoL-Pi는 모델과 환경을 매개하는 에이전트 하네스(agent harness) 계층에서, 추가 학습 없이 토큰 사용을 개선하는 직교적 경로를 탐구합니다. 다만 도구 사용·컨텍스트 관리·검증·위임·복구·종료가 강하게 결합되어 있어 국소적 이득이 하류 실패나 비용 전가로 이어질 수 있고, 사람이 긴 실행 트레이스를 검사하며 반복 실패 모드를 코드 변경으로 바꾸는 기존 하네스 개발은 비용이 크고 태스크·환경 간 스케일링이 어렵습니다.
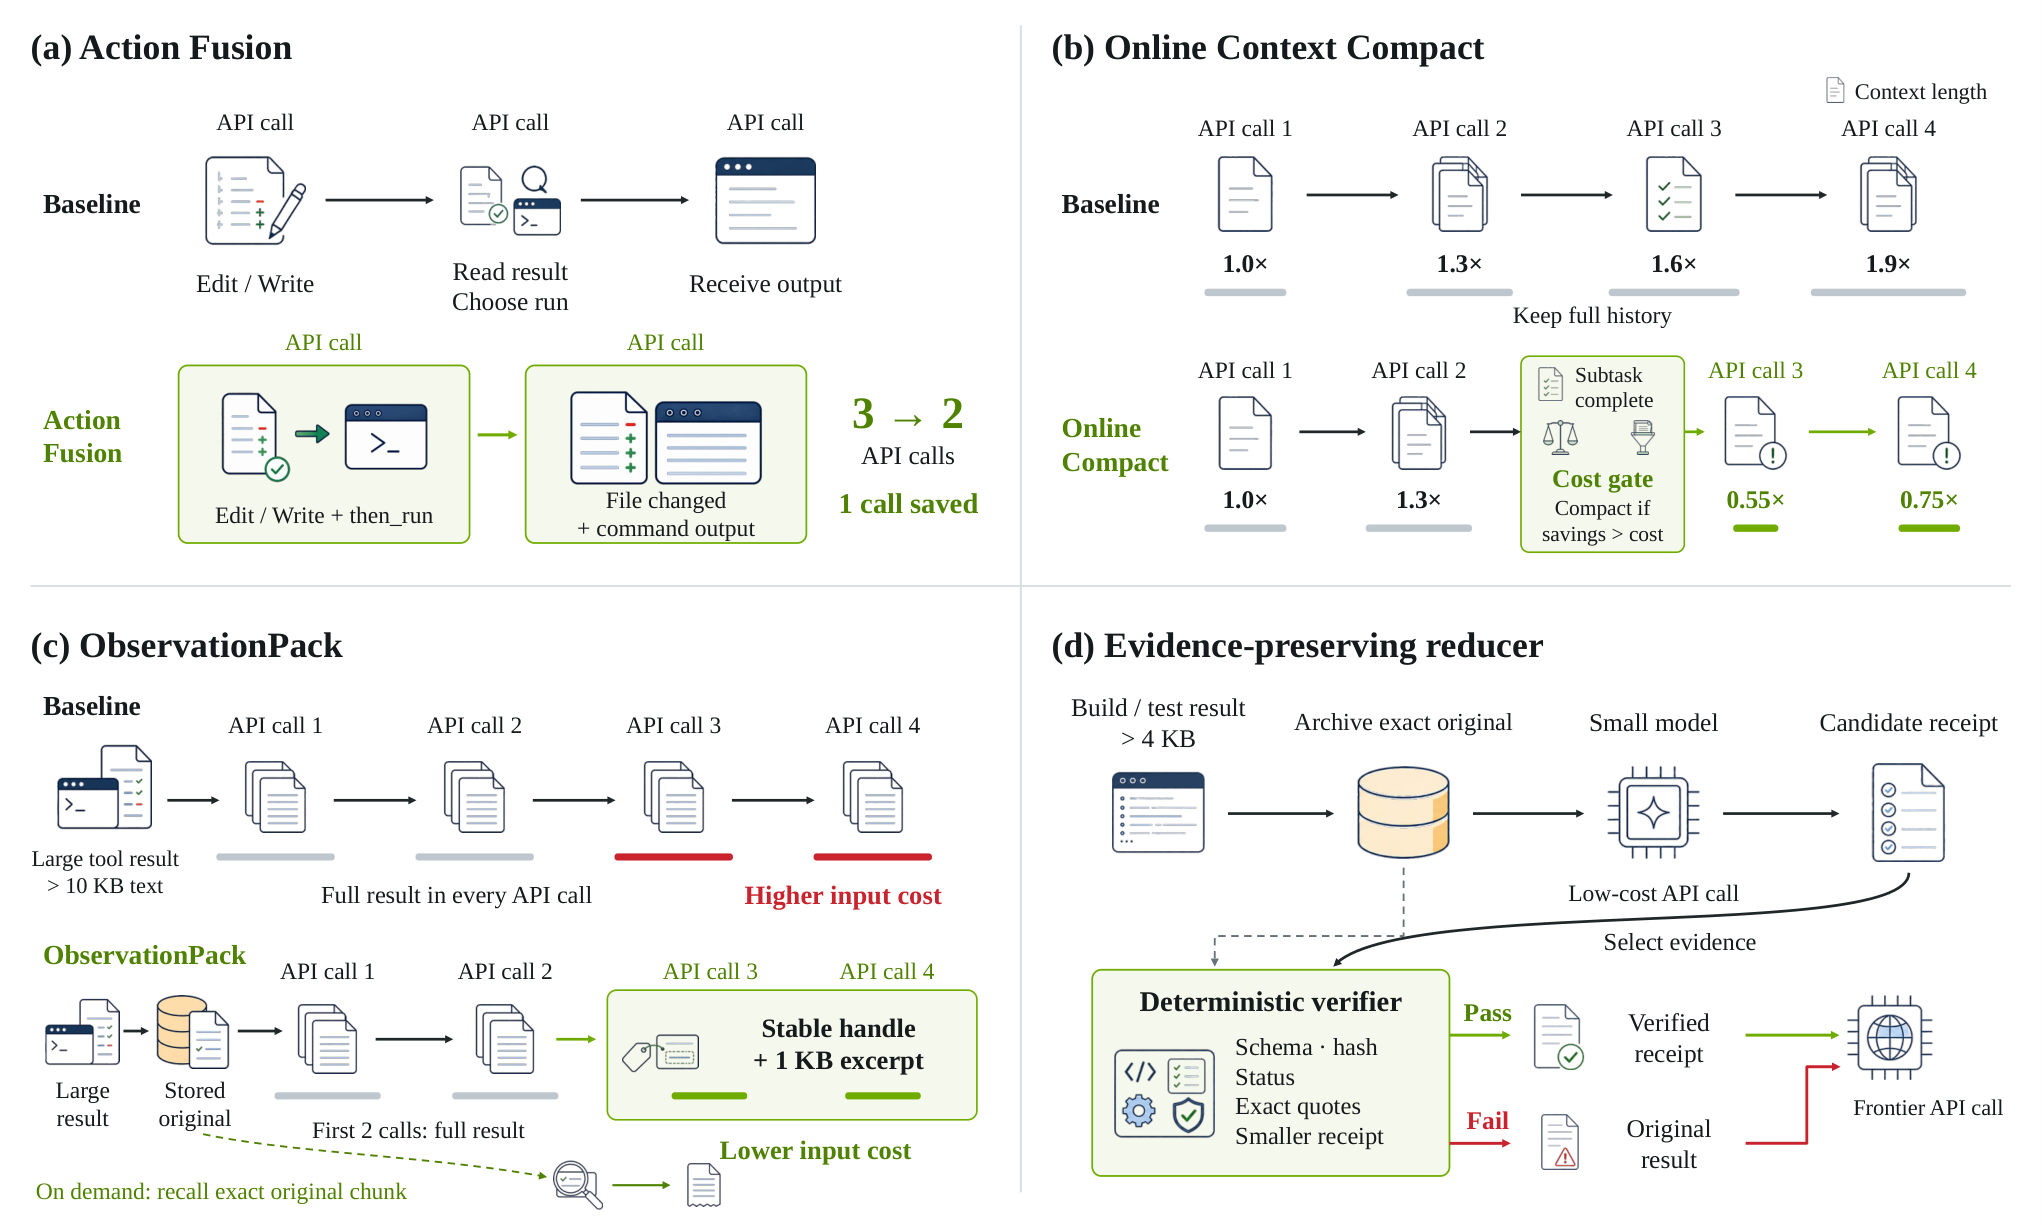
이를 가속하기 위해 연구 AI가 기본 하네스 실행 트레이스를 관찰하고 후보 변경을 제안·시험한 뒤, 능력과 효율 게이트로 유지 여부를 결정하는 RSI 영감 auto-research를 채택합니다. SoL-Pi는 후보 개발과 held-out 검증을 분리하고, 가설 커버리지를 넓힌 뒤 유망 후보를 독립·일회성 계보에서 깊게 정제하는 broad-to-deep 퍼널로 검색을 조직합니다. 약 150개 제안 방향, 약 535개 실행 환경, 수천 회 실행과 수만 회 에이전트–환경 상호작용 규모에서 능력 보존 제약을 통과한 네 재사용 메커니즘—Action Fusion, Online Context Compact, ObservationPack, Evidence-Preserving Reducer—이 각각 행동 실행, 컨텍스트 압축, 관측 처리, 위임된 읽기를 담당하며 반복 작업을 줄입니다. Action Fusion은 인접한 편집·검증 행동을 단일 도구 요청과 단일 관측으로 묶어 중간 모델 라운드트립을 제거하고, Online Context Compact는 플랜 스텝 완료 경계에서 예상 입력 절감과 프롬프트 캐시 재작성 비용을 비교한 뒤 압축을 호출합니다. ObservationPack은 큰 도구 출력을 로컬에 아카이브하고 안정 핸들과 짧은 발췌로 반복 삽입을 억제하며, Evidence-Preserving Reducer는 대형 빌드·테스트 로그에서 검증된 핵심 증거를 compact receipt로 남기고 실패 시 원본으로 폴백합니다.
EdgeBench 51개 태스크에서 완전 스택 SoL-Pi는 Pi와 비교 가능한 성능을 유지하면서 기록된 토큰 트래픽을 44.7–49.0%, API 비용을 약 3분의 1 줄였고, GPT-5.6 Sol에서 개발한 구성을 Opus 5에 추가 적응 없이 적용해도 유사한 효율 이득이 관찰되었습니다. Terminal-Bench 4, IMO 2026, 커널 최적화 에이전트 스웜에서도 효율 이득이 일부 전이되어, 스케일된 하네스 계층 auto-research가 개발 설정을 넘는 재사용 가능 개선을 산출할 수 있음을 시사합니다.
초록(Abstract)
코딩 에이전트가 지도 학습 기반 코드 완성에서 무인·24시간 상시 탐색으로 전환됨에 따라, 이들의 작업은 단발성 예측에서 추론, 도구 사용, 피드백으로 이루어진 긴 궤적으로 확장됩니다. 따라서 토큰 효율성은 재귀적 자기 개선(RSI)을 스케일링하는 데 중요해집니다. 우리는 하네스 계층에서 RSI에서 영감을 받은 접근을 취하여, 하네스 롤아웃을 위해 점점 더 많고 다양한 환경에 걸쳐 자동 연구 루프를 스케일링합니다. 이 규모에서 해당 과정은 개발 환경을 넘어 전이되는 재사용 가능한 개선을 산출하며, 자동화된 하네스 발견을 프로덕션 수준의 결과로 진전시킵니다. 선별을 통과한 네 가지 메커니즘이 SoL-Pi를 구성하며, 이는 액션 실행, 컨텍스트 압축, 관찰 처리, 위임된 읽기에 걸쳐 있습니다. 51개 태스크로 구성된 EdgeBench 평가에서 SoL-Pi는 GPT-5.6 Sol과 Opus 5 전반에 걸쳐 Pi와 대등한 성능을 달성하면서도, 기록된 토큰 트래픽을 44.7–49.0% 줄이고 API 비용을 약 1/3 절감합니다. 달리 말하면, 시간당 예상 절감액은 네이티브 Codex 및 Claude Code 하네스 대비 $8.75–$13.50, Pi 대비 $4.36–$5.71입니다.
As coding agents move from supervised code completion to unattended, around-the-clock exploration, their work expands from isolated predictions into long trajectories of reasoning, tool use, and feedback. Token efficiency therefore becomes important for scaling recursive self-improvement. We take an RSI-inspired approach at the harness layer, scaling auto-research loops across increasingly numerous and diverse environments for harness rollouts. At this scale, the process yields reusable improvements that transfer beyond their development setting, moving automated harness discovery toward production-level outcomes. Four mechanisms survive selection and form SoL-Pi, spanning action execution, context compaction, observation handling, and delegated reading. On the 51-task EdgeBench evaluation, SoL-Pi achieves performance comparable to Pi across GPT-5.6 Sol and Opus 5 while reducing recorded token traffic by 44.7-49.0% and API cost by about one third. In other words, estimated hourly savings are $8.75-$13.50 relative to native Codex and Claude Code harnesses, and $4.36-$5.71 relative to Pi.
논문 링크
더 읽어보기
Jev-Mem: 효율적인 AI 에이전트를 위한 시스템-원 제어 기억 구조 / Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
논문 소개
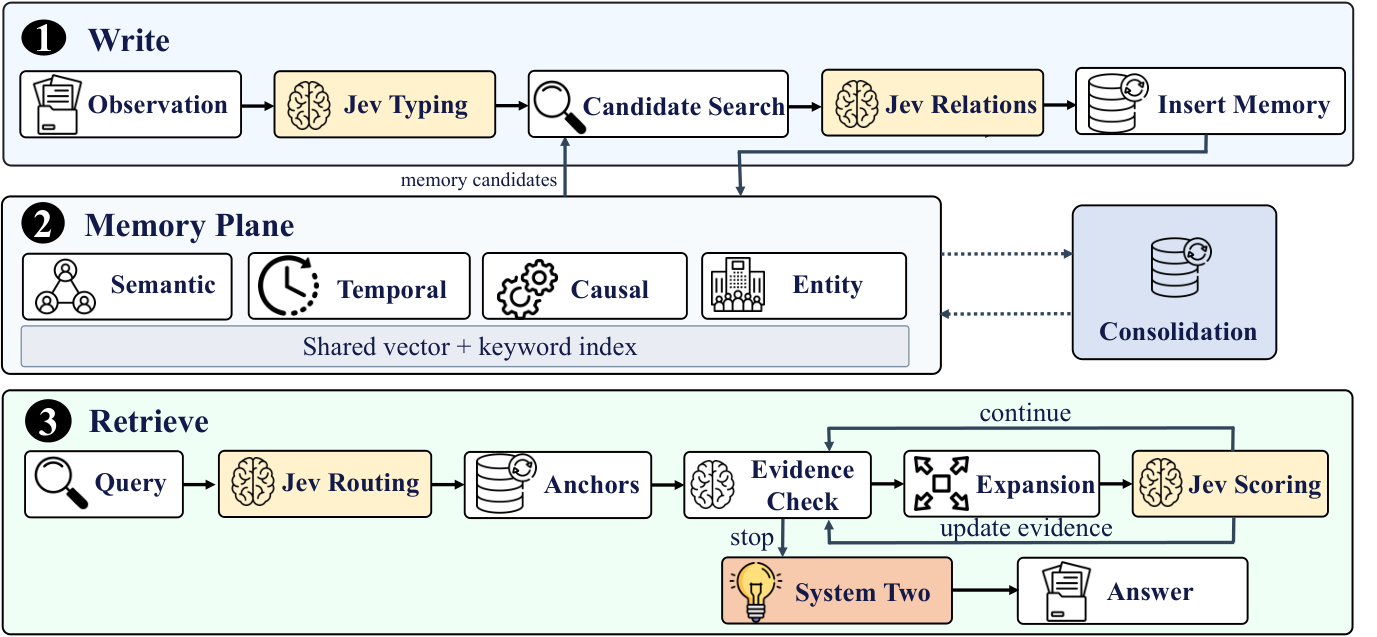
Agentic Memory은 장기적인 인공지능 에이전트의 효율성을 위해 점점 더 중요해지고 있으며, 기존 시스템들은 자기 회귀 대규모 언어 모델을 사용하여 기억의 조직, 검색 및 활용을 관리하고 있다. 그러나 이러한 접근은 기억 작업에서 높은 비용의 생성이 필수적인 경로에 놓이게 한다. 이에 대한 해결책으로 제안된 Jev-Mem은 System-One/System-Two 인지 이론에서 영감을 받아 새로운 행위 기억 아키텍처를 구축하였다. 이 시스템은 빠르고 경량의 의사 결정을 담당하는 System One과 느리고 심사숙고적인 추론을 수행하는 System Two를 통해 기억의 효율성을 극대화한다. Jev-Mem은 전용 System-One 제어 평면, 구조적 다관계 기억 평면, 그리고 System-Two 추론 평면을 통해 이 두 가지 시스템 간의 분업을 효과적으로 구현한다.
System-One 제어기는 기억의 유형 및 관계적 조직을 관리하고, 동적으로 쿼리 라우팅, 검색 예산 할당, 그래프 탐색 및 후보 점수 매기기를 수행하여 효율적인 기억 검색을 가능하게 한다. 반면, System Two는 복잡한 질문에 대한 심도 있는 답변을 도출하는 과정에서만 호출된다. 이러한 설계는 기억의 효과성과 시스템의 전반적인 효율성을 모두 향상시킨다. 실제로 Jev-Mem은 LoCoMo라는 벤치마크에서 0.777의 LLM-as-a-Judge 점수를 기록하며, 이는 가장 강력한 기준선에 비해 11.0%의 상대적 개선을 보여준다. 또한, 기억 구성 시간을 158초로 단축시켜 기존의 경쟁 시스템보다 6.6배의 속도 향상을 이루었으며, 평균 쿼리 대기 시간을 0.93초로 낮춰 36.7%의 감소를 기록하였다.
Jev-Mem은 기존의 기억 관리 접근 방식과는 달리, 기억 생애 주기 내에서의 미세 조정 결정을 중시하며, 저장소의 정보를 어떻게 관리하고 재구성할지를 제어하는 데 중점을 둔다. 이러한 혁신적인 아키텍처는 기억 제어를 새로운 차원으로 끌어올리며, 에이전트의 기억 효율성을 높이는 데 기여한다. Jev-Mem은 빠른 의사 결정과 깊이 있는 추론 간의 효과적인 상호작용을 통해 인공지능의 기억 관리에 대한 새로운 패러다임을 제시한다.
초록(Abstract)
행위적 기억(agentic memory)은 장기 AI 에이전트에게 필수적이 되고 있지만, 많은 기존 시스템은 기억이 조직되고 검색되며 사용되는 방식을 제어하기 위해 자가 회귀 대규모 언어 모델(autoregressive LLMs)에 의존하고 있으며, 이는 기억 작업의 중요한 경로에서 비싼 생성 비용을 발생시킵니다. 우리는 System-One/System-Two 인지에서 영감을 받은 새로운 행위적 기억 아키텍처인 \textbf{\method}를 소개합니다. System One은 빠르고 경량의 의사결정을 포착하는 반면, System Two는 느린 신중한 추론을 수행합니다. Jev-Mem은 전용 System-One 제어 평면, 구조화된 다중 관계 기억 평면, 그리고 System-Two 추론 평면을 통해 행위적 기억에 이 노동 분업을 가져옵니다. System-One 컨트롤러는 기억 유형화 및 관계 조직을 구성하는 동안 관리하며, 검색 중에는 동적으로 쿼리 라우팅, 검색 예산 할당, 그래프 탐색, 후보 점수 매기기 및 적응형 중지를 수행합니다. System Two는 복잡한 추론 및 답변 합성에만 호출됩니다. 이 설계는 기억의 효과성과 시스템 효율성을 모두 개선합니다: LoCoMo에서 Jev-Mem은 전체 LLM-as-a-Judge 점수 0.777을 달성하며, 이는 가장 강력한 기준선에 비해 11.0%의 상대적 개선을 이루었고, 기억 구축 시간을 158초로 단축시켜 가장 빠른 경쟁 기억 시스템에 비해 6.6배의 속도 향상을 이루었으며, 평균 쿼리 지연 시간을 0.93초로 낮추어 36.7% 감소시켰습니다.
Agentic memory is becoming essential for long-horizon AI agents, yet many existing systems rely on autoregressive LLMs to control how memories are organized, retrieved, and used, placing expensive generation on the critical path of memory operations. We introduce \textbf{\method}, a new agentic memory architecture inspired by System-One/System-Two cognition. System One captures fast, lightweight decision-making, whereas System Two performs slower, deliberative reasoning. Jev-Mem brings this division of labor to agentic memory through a dedicated System-One control plane, a structured multi-relational memory plane, and a System-Two reasoning plane. The System-One controller governs memory typing and relational organization during construction, and dynamically performs query routing, retrieval-budget allocation, graph traversal, candidate scoring, and adaptive stopping during retrieval. System Two is invoked only for complex reasoning and answer synthesis. This design improves both memory effectiveness and system efficiency: on LoCoMo Jev-Mem achieves an overall LLM-as-a-Judge score of 0.777, an 11.0% relative improvement over the strongest baseline, while reducing memory construction time to 158,s, a 6.6$\times$ speedup over the fastest competing memory system, and lowering average query latency to 0.93,s, a 36.7% reduction.
논문 링크
더 읽어보기
WFM: 복잡한 에이전틱 추론을 위한 위키 파운데이션 모델 / WFM: Wiki Foundation Model for Complex Agentic Reasoning
논문 소개
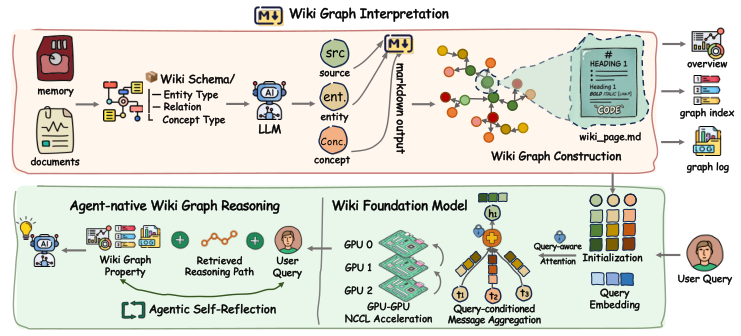
복합 에이전틱 추론을 위한 새로운 패러다임으로 제안된 Wiki Foundation Model(WFM)은 지속적이고 비모수적인 지식을 활용하여 동적 추론을 가능하게 합니다. 기존의 희소 그래프 표현은 기계 가독성과 의미 밀도를 제한하여 복잡한 에이전틱 워크플로우에 적합하지 않았습니다. 이 논문에서는 이러한 한계를 극복하기 위해 LLM Wiki라는 에이전트 친화적인 지식 표현 방식을 도입하였으며, 이는 밀집 문서 컨텍스트와 다층적인 토폴로지 링크를 결합하여 에이전트의 작업을 지원합니다. WFM의 핵심 기여는 세 가지로 요약될 수 있습니다. 첫째, 위키 그래프 스키마를 정형화하여 밀집 컨텍스트와 세밀한 구조를 매끄럽게 연결합니다. 둘째, 쿼리 조건의 어텐션 집계를 통해 풍부한 위키 메시지 전파를 구현하고, 이 과정에서 어텐션 변동 정규화를 적용하여 그래디언트 잠금을 제거합니다. 셋째, NCCL(NVIDIA Collective Communications Library) 경계 교환 프로토콜을 통해 정적 파티션 인덱스를 효율적으로 활용하고, CPU 직렬화 및 메모리 복사 오버헤드를 우회하여 성능을 극대화합니다.
이러한 방법론은 WFM이 텍스트 증강 토폴로지에 대한 조인트 표현 학습을 위한 최초의 파운데이션 모델로 자리 잡는 데 기여하였습니다. 다양한 실험을 통해 WFM은 다섯 가지 장기 에이전트 메모리 및 다중 홉 추론 벤치마크에서 뛰어난 성능을 발휘하며, 10.5배의 학습 가속도를 기록하였습니다. WFM은 기존의 그래프 기반 접근 방식의 한계를 극복하며, 에이전틱 검색과 시스템 효율성을 통합한 강력한 도구로 자리매김할 가능성을 보여줍니다. 이러한 혁신은 향후 연구와 실제 응용 분야에서도 중요한 기여를 할 것으로 기대됩니다. WFM은 복잡한 문제를 해결하기 위한 하나의 엔드 투 엔드 프레임워크를 제공하며, 지속적인 발전을 통해 보다 나은 에이전트 기반 시스템을 구현하는 데 기여할 것입니다.
초록(Abstract)
실제 에이전트는 동적 추론을 위한 지속적인 비모수 지식, 즉 장기 기억 및 검색-증강 생성을 근본적으로 요구합니다. 그래프는 구조화된 증거를 제공하는 데 신뢰할 수 있는 장점을 보여주었지만, 희소 그래프 표현은 복잡한 에이전트 워크플로우에 필요한 기계 가독성과 의미 밀도를 자연스럽게 제한합니다. 이러한 한계에 의해, 전체 산업은 전통적인 희소 그래프에서 LLM 위키(LLM Wiki)로의 패러다임 전환을 목격하고 있으며, 이는 다층 토폴로지 연결이 포함된 마크다운 파일과 밀집된 문서 맥락을 결합한 에이전트 고유의 지식 표현입니다. 그러나 이러한 풍부한 의미를 매개화하는 것은 전통적인 희소 그래프 임베딩을 사용하여 밀집된 텍스트 맥락을 인코딩하는 데 어려움이 있습니다. 게다가 기존 그래프 인코더로 LLM 위키를 학습하는 것은 대규모 상업적 시나리오에서 배포를 방해하는 분산 시스템 오버헤드를 초래할 수 있습니다. 이를 해결하기 위해, 우리는 확장 가능하고 에이전트 고유의 표현 및 검색을 위해 맞춤화된 새로운 패러다임인 위키 파운데이션 모델(Wiki Foundation Model, WFM)을 제안합니다. 구체적으로, (i) 우리는 세밀한 구조와 밀집된 맥락을 원활하게 연결하는 위키 그래프 스키마를 형식화하여 명시적인 토폴로지를 지속적인 의미와 함께 유지합니다; (ii) 풍부한 위키 메시지 전송 및 명시적 어텐션 변동 정규화를 위해 쿼리 조건화된 어텐티브 집계를 맞춤화합니다; (iii) 우리는 정적 파티션 인덱스를 끌어올리고 고정형 GPU-투-GPU 집단을 활용하여 CPU 직렬화 및 메모리 복사 오버헤드를 우회하는 인프라 NCCL 경계 교환 프로토콜을 설계합니다. 다섯 가지 장기 에이전트 기억 및 다중 홉 추론 벤치마크에 대한 광범위한 평가 결과, WFM의 뛰어난 성능을 입증하며 분산 클러스터에서 10.5배의 훈련 가속을 달성했습니다.
Real-world agents fundamentally require persistent non-parametric knowledge for dynamic reasoning, i.e., long-term memory and retrieval-augmented generation. While graphs have shown reliable advantages in providing structured evidence, the sparse graph representations naturally restrict machine readability and semantic density required for complex agentic workflows. Driven by this limitation, the entire industry is witnessing a paradigm shift from traditional sparse graphs to LLM Wiki, an agent-native knowledge representation that couples dense document contexts with markdown files containing multi-layered topological linkages. However, parameterizing such rich semantics is challenging to encode dense textual contexts using traditional sparse graph embeddings. Moreover, learning LLM Wiki with existing graph encoders could overwhelm distributed system overheads that hinder deployment in large-scale commercial scenarios. To this end, we propose a novel paradigm Wiki Foundation Model, i.e., WFM, tailored for scalable, agent-native representation and retrieval. Specifically, (i) we formalize a Wiki Graph schema that seamlessly bridges fine-grained structures with dense contexts, maintaining explicit topologies alongside continuous semantics; (ii) A query-conditioned attentive aggregation is tailored for rich wiki message passing and explicit attention variance regularization; (iii) We engineer an infrastructural NCCL boundary exchange protocol that hoists static partition indices and leverages fixed-shape GPU-to-GPU collectives, bypassing CPU serialization and memory copy overheads. Extensive evaluations across five long-term agent memory and multi-hop reasoning benchmarks demonstrate the remarkable performance of WFM, while achieving a 10.5 times training acceleration on distributed clusters.
논문 링크
세계 모델처럼 사고하고 VLA처럼 행동하기: 세계 모델 표현을 압축 로봇 정책으로 증류하기 / Think Like a World Model, Act Like a VLA: Distilling World-Model Representations into Compact Robot Policies
논문 소개
Vision-Language-Action (VLA) 모델은 관찰을 행동으로 매핑하는 데에 초점을 맞추지만, 이러한 접근은 환경의 반응을 고려하지 않기 때문에 데이터의 범위에 의존하는 한계가 있다. 반면, 세계 모델(World Model)은 물리적 장면에 대한 깊이 있는 이해를 제공하며, 이 연구에서는 이러한 두 모델의 장점을 통합할 수 있는 혁신적인 방법론을 제시한다. 세계 모델의 내부 특징은 물리적 장면에 대한 지식을 담고 있으며, 미래를 예측하는 과정은 단순히 이러한 특징을 생성하기 위한 목표에 불과하다는 점에 착안하여, 두 모델의 기능을 분리할 수 있음을 보여준다.
이 연구에서는 고정된 세계 모델을 훈련 프레임에서 한 번 실행하여 캐시를 생성하고, VLA 모델의 학생이 이 캐시에 기반하여 학습하도록 하는 특성 정렬(term)을 추가함으로써, 훈련 과정에서 교사가 필요하지 않도록 하였다. 최종적으로 배포되는 정책은 비증류 모델과 동일한 성능을 유지하면서도, 32밀리초의 응답 시간과 1.86기가바이트의 메모리 소비로 작동한다. 이로 인해, 성능 향상은 단순히 추가적인 용량이나 계산 능력에 기인한 것이 아니라, 세계 모델의 표현력 덕분임을 입증하였다.
연구 결과, 0.8B의 학생 모델은 LIBERO 벤치마크에서 97.9%의 성공률을 달성하였고, RoboCasa-GR1에서 인간형 조작의 성공률이 48.2%에서 50.5%로 향상되었다. 이러한 성과는 실제 하드웨어에서도 적용 가능성을 보여주며, 단일 팔 및 이인용 플랫폼 모두에서 우수한 성능을 발휘하였다. 연구의 결과는 학생 모델의 규모, 백본, 정렬 레이어, 교사 변화에도 불구하고 일관되게 유지되었으며, 이는 두 네트워크 간의 단순한 정렬이 아닌, 보다 넓은 표현 사전의 특성을 나타낸다. 이러한 접근 방식은 실제 로봇 정책의 성능을 획기적으로 개선할 수 있는 잠재력을 지니고 있으며, 향후 연구 방향에 대한 중요한 통찰을 제공한다.
초록(Abstract)
시각-언어-행동(Vision-Language-Action, VLA) 모델은 세계가 어떻게 반응하는지를 고려하지 않고 관찰을 행동으로 매핑하므로, 그 강건성은 주로 데이터 커버리지에 의해 제한됩니다. 월드 모델은 바로 그 누락된 목표를 갖고 있으며, 그로 인해 더 잘 기반을 마련합니다. 그러나 미래를 예측하는 데는 결정마다 몇 초가 소요되므로 제어 루프에서 제외됩니다. 우리는 두 가지를 분리할 수 있음을 보여줍니다. 월드 모델이 물리적 장면에 대해 알고 있는 것은 내부 특징에 존재하며, 미래를 생성하는 것은 단지 그것들을 생성한 목표일 뿐이므로 그 기반은 물려받을 수 있으며 생성 기계는 남겨둘 수 있습니다. 우리는 일반 VLA 학습에 하나의 특징 정렬 항을 추가합니다: 고정된 월드 모델이 학습 프레임에서 한 번 실행되어 캐시되고, 학생은 그 캐시에 동의하도록 학습합니다. 학습 중에는 교사가 로드되지 않으며, 프로젝터는 이후에 버려지고, 배포된 정책은 증류되지 않은 기준과 동일하게 작동하여 소비자 RTX5090에서 32ms와 1.86GB로 실행되므로 모든 이득은 추가 용량이나 테스트 시간 계산이 아닌 표현에 기인합니다. 0.8B 학생은 LIBERO에서 97.9%에 도달하고, RoboCasa-GR1 휴머노이드 조작에서 48.2%에서 50.5%로 개선되며, 동일한 목표가 단일 팔 및 양손 플랫폼 모두에서 실제 하드웨어로 이어집니다. 이득은 학생의 규모, 백본, 정렬 레이어 및 교사의 변화에도 생존하며, 두 특정 네트워크 간의 취약한 정렬이 아닌 폭넓은 표현적 선험을 나타냅니다. 프로젝트 페이지: 이 https URL.
Vision-Language-Action (VLA) models map observations to actions with no objective that accounts for how the world responds, so their robustness is bounded primarily by data coverage. World models carry precisely that missing objective and are better grounded for it, yet rolling the future forward costs seconds per decision and rules them out of the control loop. We show the two can be separated. What a world model knows about physical scenes lives in its internal features; generating the future is merely the objective that produced them, so the grounding can be inherited while the generative machinery is left behind. We add one feature-alignment term to ordinary VLA training: a frozen world model is run over the training frames once and cached, and the student learns to agree with that cache. No teacher is loaded during training, the projector is discarded after it, and the deployed policy is identical to the undistilled baseline, running in 32ms and 1.86GB on a consumer RTX5090, so every gain is attributable to the representation rather than to added capacity or test-time compute. A 0.8B student reaches 97.9% on LIBERO, improves from 48.2% to 50.5% on RoboCasa-GR1 humanoid manipulation, and the same objective carries over to real hardware, on both a single-arm and a bimanual platform. The gain survives changes of student scale, backbone, alignment layer, and teacher, indicating a broad representational prior rather than a fragile alignment between two particular networks. Project page: this https URL .
논문 링크
더 읽어보기
RRSI: 에이전트 하네스의 정규화된 재귀적 자기개선 / RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
논문 소개
대규모 언어 모델(Large Language Model, LLM) 에이전트의 실질적 성능은 고정된 백본 가중치보다, 그 주변을 구성하는 하네스(harness)—프롬프트, 제어 흐름, 도구, 메모리, 컨텍스트 관리—에 더 크게 좌우됩니다. 최근에는 하네스 구성요소를 반복적으로 제안·선택하며 개선하는 재귀적 자기개선(Recursive Self-Improvement, RSI)이 에이전트 시스템 수준에서 자동화되고 있으나, 유한한 evolve 집합을 라운드마다 재사용하면 학습 과제를 암기하는 과적합(overfitting)이 발생하기 쉽습니다. 그 결과 분포 내(in-distribution) 점수는 크게 오르더라도, 과제 설명·도구 인터페이스·검증기(verifier)가 다른 분포 외(out-of-distribution, OOD) 벤치마크에서는 이득이 축소되거나 사라질 수 있습니다. Regularized Recursive Self-Improvement of Agent Harnesses(RRSI)는 편집 공간 자체를 닫지 않으면서, 탐색이 피드백에 반응하는 방식을 정규화하여 이 문제를 다룹니다. 제안자(proposer)는 시간에 따라 어닐링되는 편집 예산으로 한 후보가 묶을 수 있는 독립 편집 수를 제한하고(L_0 스타일 희소 업데이트), 진화 이력에 조건화하여 이미 반증된 가설을 피하며 미탐색 구성요소로의 구조화된 탐색을 장려합니다. 선택자(selector)는 critic으로 벤치마크 특화 내용이나 누설(leakage)성 편집을 평가 전에 걸러내고, 경험적 노이즈 대역을 반영한 안정성 기준과 점수 이득 대비 정책 토큰 비용 증가를 제한하는 복잡도 인식 수락 규칙(Ridge/L_2 스타일)을 적용합니다. 여기에 최근 이득이 없는 구성요소를 삭제 대상으로 넘기는 구조적 가지치기(pruner, Lasso/L_1 스타일)를 더해, 벤치마크 특화 맞춤·평가 노이즈 추종·불필요한 복잡도 누적이 영구 하네스 상태로 남지 않도록 합니다. 이처럼 제안 분포와 후보 선택을 동시에 제약함으로써 RRSI는 evolve 점수만을 최대화하는 진화와 구분되며, 재사용 가능한 에이전트 메커니즘을 우선하는 탐색 역학을 만듭니다. 코딩, 에이전틱 워크스페이스, 엔지니어링 설계를 아우르는 여덟 개 벤치마크에서 RRSI는 evolve 분할에서 최대 14.1점, OOD 다섯 개에서 최대 4.7점의 향상을 보이며, 비정규화 진화 대비 약 30% 적은 정책 토큰으로 동작하는 하네스를 얻습니다. 결국 에이전트 시스템을 RSI로 고도화하려면 “무엇이 바뀔 수 있는가”뿐 아니라, 반복 피드백이 영속적 변경으로 변환되는 경로까지 제어해야 한다는 점이 이 접근의 핵심 메시지입니다.
초록(Abstract)
대규모 언어 모델(LLM) 에이전트의 역량은 동결된 백본 모델을 둘러싼 프롬프트, 제어 흐름, 도구, 메모리, 컨텍스트 관리로 구성되는 하네스(harness)에 의해 크게 증폭된다. 최근 방법들은 에이전트 하네스의 구성 요소별 수정을 반복적으로 제안하고 선택함으로써 이 과정을 점점 더 자동화하고 있으며, 실질적으로 에이전트 시스템 수준의 재귀적 자기 개선(recursive self-improvement, RSI) 형태를 확립하고 있다. 그러나 이러한 재귀적 진화는 학습 과제를 암기함으로써 과적합될 수 있으며, 분포 내(in-distribution)에서는 큰 성능 향상을 보이지만 분포 외(out-of-distribution) 벤치마크에서는 그 향상이 축소되거나 심지어 사라진다. 본 논문에서는 진화 후보의 제안과 선택을 제약함으로써 정규화(regularization) 원리를 하네스 자기 개선에 통합하는 Regularized Recursive Self-Improvement of Agent Harnesses(RRSI)를 제안한다. 제안자(proposer)는 시간적으로 어닐링(annealed)되는 예산을 사용하여 후보가 묶을 수 있는 수정 수를 제한하고, 진화 이력에 기반하여 미탐색 궤적을 장려한다. 선택자(selector)에는 크리틱(critic)과 프루너(pruner)가 장착되어 있다. 크리틱은 벤치마크 특화 제안을 선별하고, 프루너는 너무 작거나, 너무 비싸거나, 더 이상 유용하지 않은 변경을 제거한다. 이러한 제약들이 함께 작용하여 벤치마크 특화 메커니즘이나 노이즈보다 재사용 가능한 에이전트 메커니즘을 선호한다. 코딩, 에이전트 워크스페이스, 엔지니어링 설계 과제를 아우르는 여덟 개 벤치마크에서, RRSI는 진화에 사용된 분할에서 최대 14.1점, 다섯 개의 분포 외 벤치마크에서 최대 4.7점의 성능 향상을 얻었으며, 정규화되지 않은 진화 대비 정책 토큰을 30% 적게 사용하는 하네스를 생성하였다. 코드는 GitHub - google-research/rrsi · GitHub 에서, 프로젝트 페이지는 https://regularized-rsi.com/ 에서 확인할 수 있다.
An LLM agent's capability is largely magnified by its harness, namely the prompts, control flow, tooling, memory, and context management surrounding the frozen backbone model. Recent methods increasingly automate this process by iteratively proposing and selecting component-wise edits of an agent harness, practically establishing a form of recursive self-improvement (RSI) at the agent-system level. However, such recursive evolution may overfit by memorizing the training tasks, showing large in-distribution gains that shrink or even vanish on out-of-distribution benchmarks. We introduce Regularized Recursive Self-Improvement of Agent Harnesses (RRSI), which incorporates the principles of regularizations into harness self-improvement by constraining the evolution candidate proposal and selection. The proposer operates with a temporally annealed budget, limiting how many edits a candidate can bundle, and it encourages unexplored trajectories based on evolution history. The selector is equipped with a critic and a pruner: the critic screens benchmark-specific proposals, while the pruner, removes changes that are too small, too expensive, or no longer useful. Together these constraints favor reusable agent mechanisms over benchmark-specific ones or even noises. Across eight benchmarks spanning coding, agentic workspace and engineering design tasks, RRSI gains up to 14.1 points on the split it evolves against and up to 4.7 points on the five out-of-distribution benchmarks, while producing a harness that runs on 30% fewer policy tokens than the unregularized evolution. Code is available at GitHub - google-research/rrsi · GitHub and project page is https://regularized-rsi.com/.
논문 링크
더 읽어보기
SlopShape: AI가 생성한 상업용 웹 콘텐츠 식별 / SlopShape: Identifying AI-Generated Commercial Web Content
논문 소개
단어 수준 탐지기는 편집되지 않은 AI 생성 텍스트를 거의 완벽하게 구분하지만, 재작성(rewording)과 humanizer에 취약하고, 점수만으로는 텍스트의 성격이나 생성 모델을 설명하기 어렵습니다. SlopShape는 정보가 어떻게·어떤 순서로·어떤 근거로·어떤 목소리로 제시되는지에 주목하는 구조적 서명(structural signature)으로, 상업 웹 콘텐츠에서도 AI를 식별·특성화·귀속할 수 있는지 묻습니다. 연구는 StoryScope가 허구 서사에서 보인 패턴을 B2B(Business-to-Business) 블로그로 옮긴 도메인 전이 재현으로, ChatGPT 이전 2,250편의 인간 게시물(268개 회사 도메인)과 다섯 개 프론티어 모델의 11,250개 AI 미러로 페어드 코퍼스를 구축합니다.
측정은 목적·독자·흐름·설명·근거·목소리·실행 가능성·상업적 통합·시의성·페이지 형식·문체 등 11차원 상업 템플릿 스키마를 먼저 도출한 뒤, 템플릿 추출·교차출처 비교·특징 발견·품질 게이트·중복 제거·적용의 파이프라인으로 214개 특징 계측기를 만듭니다. Writing Style을 분리해 스타일 특징을 제외하면 구조 신호만 남기고, LLM(Large Language Model)이 채점한 결과는 인간 골드 주석에서 human-human κ 0.928, human-model κ 0.946으로 타당성을 확인합니다. 회사 도메인을 분리한 held-out 평가에서 187개 구조 특징만으로 macro-F1 98.0을 달성하며, 테스트 분할의 모든 AI 글을 생성 모델 자신이 span 단위로 재작성해도 98.1로 유지됩니다. 반면 스타일만으로는 88.1에 머물러, 구조가 스타일보다 강하고 재작성에도 견고하다는 가설이 지지됩니다.
SHAP(SHapley Additive exPlanations)로 압축한 핵심 특징은 AI 글이 제목에 성과를 약속하고, 본문 앞에서 논지를 선언하며, 맺음에서 재진술하는 tidy하고 self-announcing한 형태를 공유함을 보여 줍니다. 6개 출처 분류 정확도는 79.3%(우연 16.7%)이고, 구조 공간의 희귀성에서 인간은 평균 0.84, AI는 0.44(Cohen’s d 1.83)로 인간이 드문 구성을 차지합니다. 효과의 방향은 StoryScope와 같고 크기는 더 크며, 파이프라인·계측기·프롬프트·코드·집계 아티팩트를 공개해 검색·GEO(Generative Engine Optimization) 환경에서 단어 공격에 덜 취약한 구조 신호를 검증 가능하게 제시합니다.
초록(Abstract)
단어 수준 탐지기는 편집되지 않은 AI 생성 텍스트를 거의 완벽하게 식별하지만, 기존 문헌은 재서술(rewording)에 대한 취약성을 보고해 왔으며, 단어 수준 점수는 텍스트의 특성을 규명하지도, 어떤 AI 모델이 작성했는지를 식별하지도 못한다. 본 연구는 AI 생성 텍스트를 한 단계 더 깊이, 즉 구조적 시그니처(structural signature)—정보가 어떻게 제시되는지, 어떤 순서로, 어떤 근거로, 어떤 어조(voice)로 전달되는지—로부터 식별할 수 있는지를 묻는다. 우리는 AI 생성 픽션에서 이러한 패턴을 보여 준 StoryScope(Russell et al., 2026)를 상업용 콘텐츠에 복제한다. 구체적으로, ChatGPT 이전(pre-ChatGPT) 시기의 인간 작성 블로그 게시물 2,250편(268개 기업 도메인)과 다섯 개 최전선(frontier) 모델이 생성한 AI 미러(mirror) 11,250편을 대조한다. LLM이 적용하고 인간 골드 주석(gold-annotation) 세션으로 검증한 214개 피처 계측기(instrument)(인간–인간 카파(kappa) 0.928, 인간–모델 0.946)는, 187개의 구조적 피처만으로 홀드아웃(held-out) 기업에서 AI 게시물을 매크로-F1 98.0으로 탐지하며, 모든 AI 게시물을 해당 모델로 재서술해도 성능은 변하지 않는다(98.1). 이 신호는 특성을 규명하고 출처를 귀속(attribution)한다. AI 게시물은 깔끔하고 자기 선언적인(self-announcing) 형태를 공유하며, 79.3%가 기회 수준 16.7%에 비해 올바른 출처로 귀속되고, 인간 게시물은 희귀한 구조적 구성을 차지한다. 모든 효과는 StoryScope의 결과를 방향이 일치하고 크기가 더 큰 형태로 복제한다. 우리는 파이프라인, 계측기, 프롬프트, 코드, 집계 산출물을 공개한다.
Word-level detectors identify unedited AI-generated text almost perfectly, but the literature documents their brittleness under rewording, and a word-level score neither characterizes a text nor identifies which AI model wrote it. We ask whether AI-generated text can be identified one level deeper, from structural signatures: how information is presented, in what order, with what evidence, and in what voice. We replicate StoryScope (Russell et al., 2026), which showed such patterns for AI-generated fiction, on commercial content: 2,250 pre-ChatGPT human blog posts from 268 company domains against 11,250 AI mirrors from five frontier models. A 214-feature instrument, applied by an LLM and validated in a human gold-annotation session (human-human kappa 0.928, human-model 0.946), detects AI posts from its 187 structural features alone at 98.0 macro-F1 on held-out companies, unchanged (98.1) when every AI post is reworded by its own model. The signal characterizes and attributes: AI posts share a tidy, self-announcing shape, 79.3% are attributed to the correct source against a 16.7% chance rate, and human posts occupy rare structural configurations. All effects replicate StoryScope's, consistent in direction and larger in magnitude. We release pipeline, instrument, prompts, code, and aggregate artifacts.
논문 링크
더 읽어보기
LIGE-GR: 대규모 언어 모델(LLM) 시대, 랭킹에서 생성형 추천으로의 부드러운 도약 / LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
논문 소개
대규모 언어 모델(LLM, Large Language Model)의 성공은 추천 시스템을 아이템 단위 점수의 정렬이 아니라, 사용자 경험을 최적화하는 순서화된 시퀀스 생성 문제로 다시 바라보게 했습니다. 다만 산업용 추천기는 제품 제약, 가치 함수, 서빙 인프라, 조직 소유권에 맞춰 수년간 다듬어진 성숙 시스템이라, 생성형 스택으로 한꺼번에 교체하기는 기술적으로도 조직적으로도 부담이 큽니다. LIGE-GR(Listwise Generation and Evaluation for Generative Recommendation)는 이러한 간극을 메우기 위해, 기존 포인트와이즈(pointwise) 랭킹 파이프라인을 유지한 채 리스트와이즈(listwise) 생성·평가 패러다임으로 일반화하는 가산적·가역적 프레임워크를 제시합니다.
핵심 방법론은 세 구성 요소의 점진적 업그레이드에 있습니다. 먼저 컨텍스트 비인식(context-free) 랭커 위에 경량 인과 트랜스포머(causal Transformer) 기반 컨텍스트 인식(context-aware) 모듈을 얹어, 이미 선택된 접두사(prefix)를 조건으로 후보의 참여 가치를 재예측합니다. 다음으로 아이템별 가치 모델(itemVM, item Value Model)을, 계속 시청 확률로 위치별 기여를 가중하는 리스트와이즈 가치 모델(ListVM, Listwise Value Model)로 확장하여 시퀀스 전체의 기댓값을 더 충실히 반영합니다. 마지막으로 Palette 디코더가 강화학습(RL, Reinforcement Learning) 관점에서 부분 시퀀스를 빔(beam)으로 확장·가지치기하며, 닫힌 형태 미래 가치 추정을 통해 탐욕적 단일 경로를 넘어 대안 조합을 탐색합니다. 세 요소를 각각 되돌리면 기존 아이템별 탐욕 디코딩이 그대로 복원되므로, 전면 교체가 아닌 엄밀한 일반화이자 안전한 전환 경로가 됩니다.
서빙 측면에서는 기존 컨텍스트 비인식 임베딩을 캐시해 재사용하고 재점수화 후보 풀을 축소하며, 지연 초과 시 아이템별 경로로 자동 폴백하여 추가 추론 비용을 소폭으로 억제합니다. Instagram Reels와 Facebook Video의 숏폼 추천에서 검증한 결과, 체류 시간(time spent)이 각각 1.14%, 0.72% 개선되었고, 기본 구성의 추가 추론 자원은 컨텍스트 비인식 대비 약 10% 수준에 머물렀습니다. 이처럼 LIGE-GR는 LLM이 보여 준 시퀀스 수준 생성·최적화의 본질을, 성숙한 산업 추천 스택의 호환성과 신뢰성을 지키면서 흡수하는 실무적 도약으로 이해할 수 있습니다.
초록(Abstract)
대규모 언어 모델(LLM)의 괄목할 만한 성공은 차세대 추천 시스템에 중요한 영감을 제공해 왔다. 구조적으로 추천과 언어 생성은 유사점을 공유한다. 둘 다 사용자의 경험을 최적화하는 순서화된 시퀀스를 생성하는 것을 목표로 한다. 그러나 LLM 패러다임의 본질을 성숙한 산업용 추천 시스템에 정확히 흡수하는 방법은 여전히 미해결 문제로 남아 있다. 여기에는 두 가지 도전 과제가 있다. 첫째, LLM 패러다임의 시퀀스 수준 생성과 최적화를 추천에 어떻게 통합할지가 불분명하다. 둘째, 실제 추천 시스템은 특정 제품, 비즈니스 제약, 서빙 인프라, 조직적 소유권을 중심으로 수년간 반복적으로 맞춤화된 성숙한 시스템이다. 이러한 시스템을 전면 교체하는 것은 종종 기술적으로 위험하고 조직적으로 혼란을 초래한다. 본 논문에서는 아이템와이즈(itemwise) 추천 기반의 전통적 랭킹 시스템에서 생성형 추천 패러다임으로 고도화하는 리스트와이즈(listwise) 생성 및 평가 추천 프레임워크인 LIGE-GR를 제안한다. 추천 스택 전체를 처음부터 재구축하는 대신, LIGE-GR는 기존 포인트와이즈(pointwise) 추천 시스템을 리스트와이즈 생성 시스템으로 일반화한다. 이를 통해 성숙한 추천 시스템은 기존 모델, 가치 함수, 서빙 인프라와의 호환성을 유지하면서도 리스트와이즈 최적화의 이점을 누릴 수 있다. 우리는 Instagram Reels와 Facebook Video의 숏폼 동영상 추천에서 LIGE-GR를 검증한다. 이들 추천 표면에서 LIGE-GR는 Instagram Reels에서 체류 시간을 1.14%, Facebook Video에서 0.72% 개선하였으며, 추가 추론 자원은 소폭만 필요로 하였다.
The remarkable success of large language models (LLMs) has provided important inspiration for the next generation of recommender systems. Structurally, recommendation and language generation share a similarity: both aim to produce an ordered sequence that optimizes the user's experience. However, how to precisely absorb the essence of the LLM paradigm into mature industrial recommender systems remains an open problem. There are two challenges. First, it is unclear how to incorporate sequence-level generation and optimization from the LLM paradigm into recommendation. Second, real-world recommender systems are mature systems that have been iteratively customized for years around specific products, business constraints, serving infrastructure, and organizational ownership. Replacing such systems wholesale is often technically risky and organizationally disruptive. In this paper, we propose LIGE-GR, a listwise generation and evaluation recommendation framework that upgrades from a traditional ranking system based on itemwise recommendation toward a generative recommendation paradigm. Instead of rebuilding the entire recommendation stack from scratch, LIGE-GR generalizes the existing pointwise recommendation system into a listwise generation system. This allows mature recommender systems to benefit from listwise optimization while preserving compatibility with existing models, value functions, and serving infrastructure. We validate LIGE-GR in short-video recommendation on Instagram Reels and Facebook Video. On these recommendation surfaces, LIGE-GR improves time spent by 1.14 percent on Instagram Reels and 0.72 percent on Facebook Video, while requiring only modest additional inference resources.
논문 링크
효율적인 온-디바이스 LLM 생성적 개인화를 위한 LoRA 생성 하이퍼네트워크 / LoRA-generating hypernetworks for efficient on-device LLM generative personalization
논문 소개
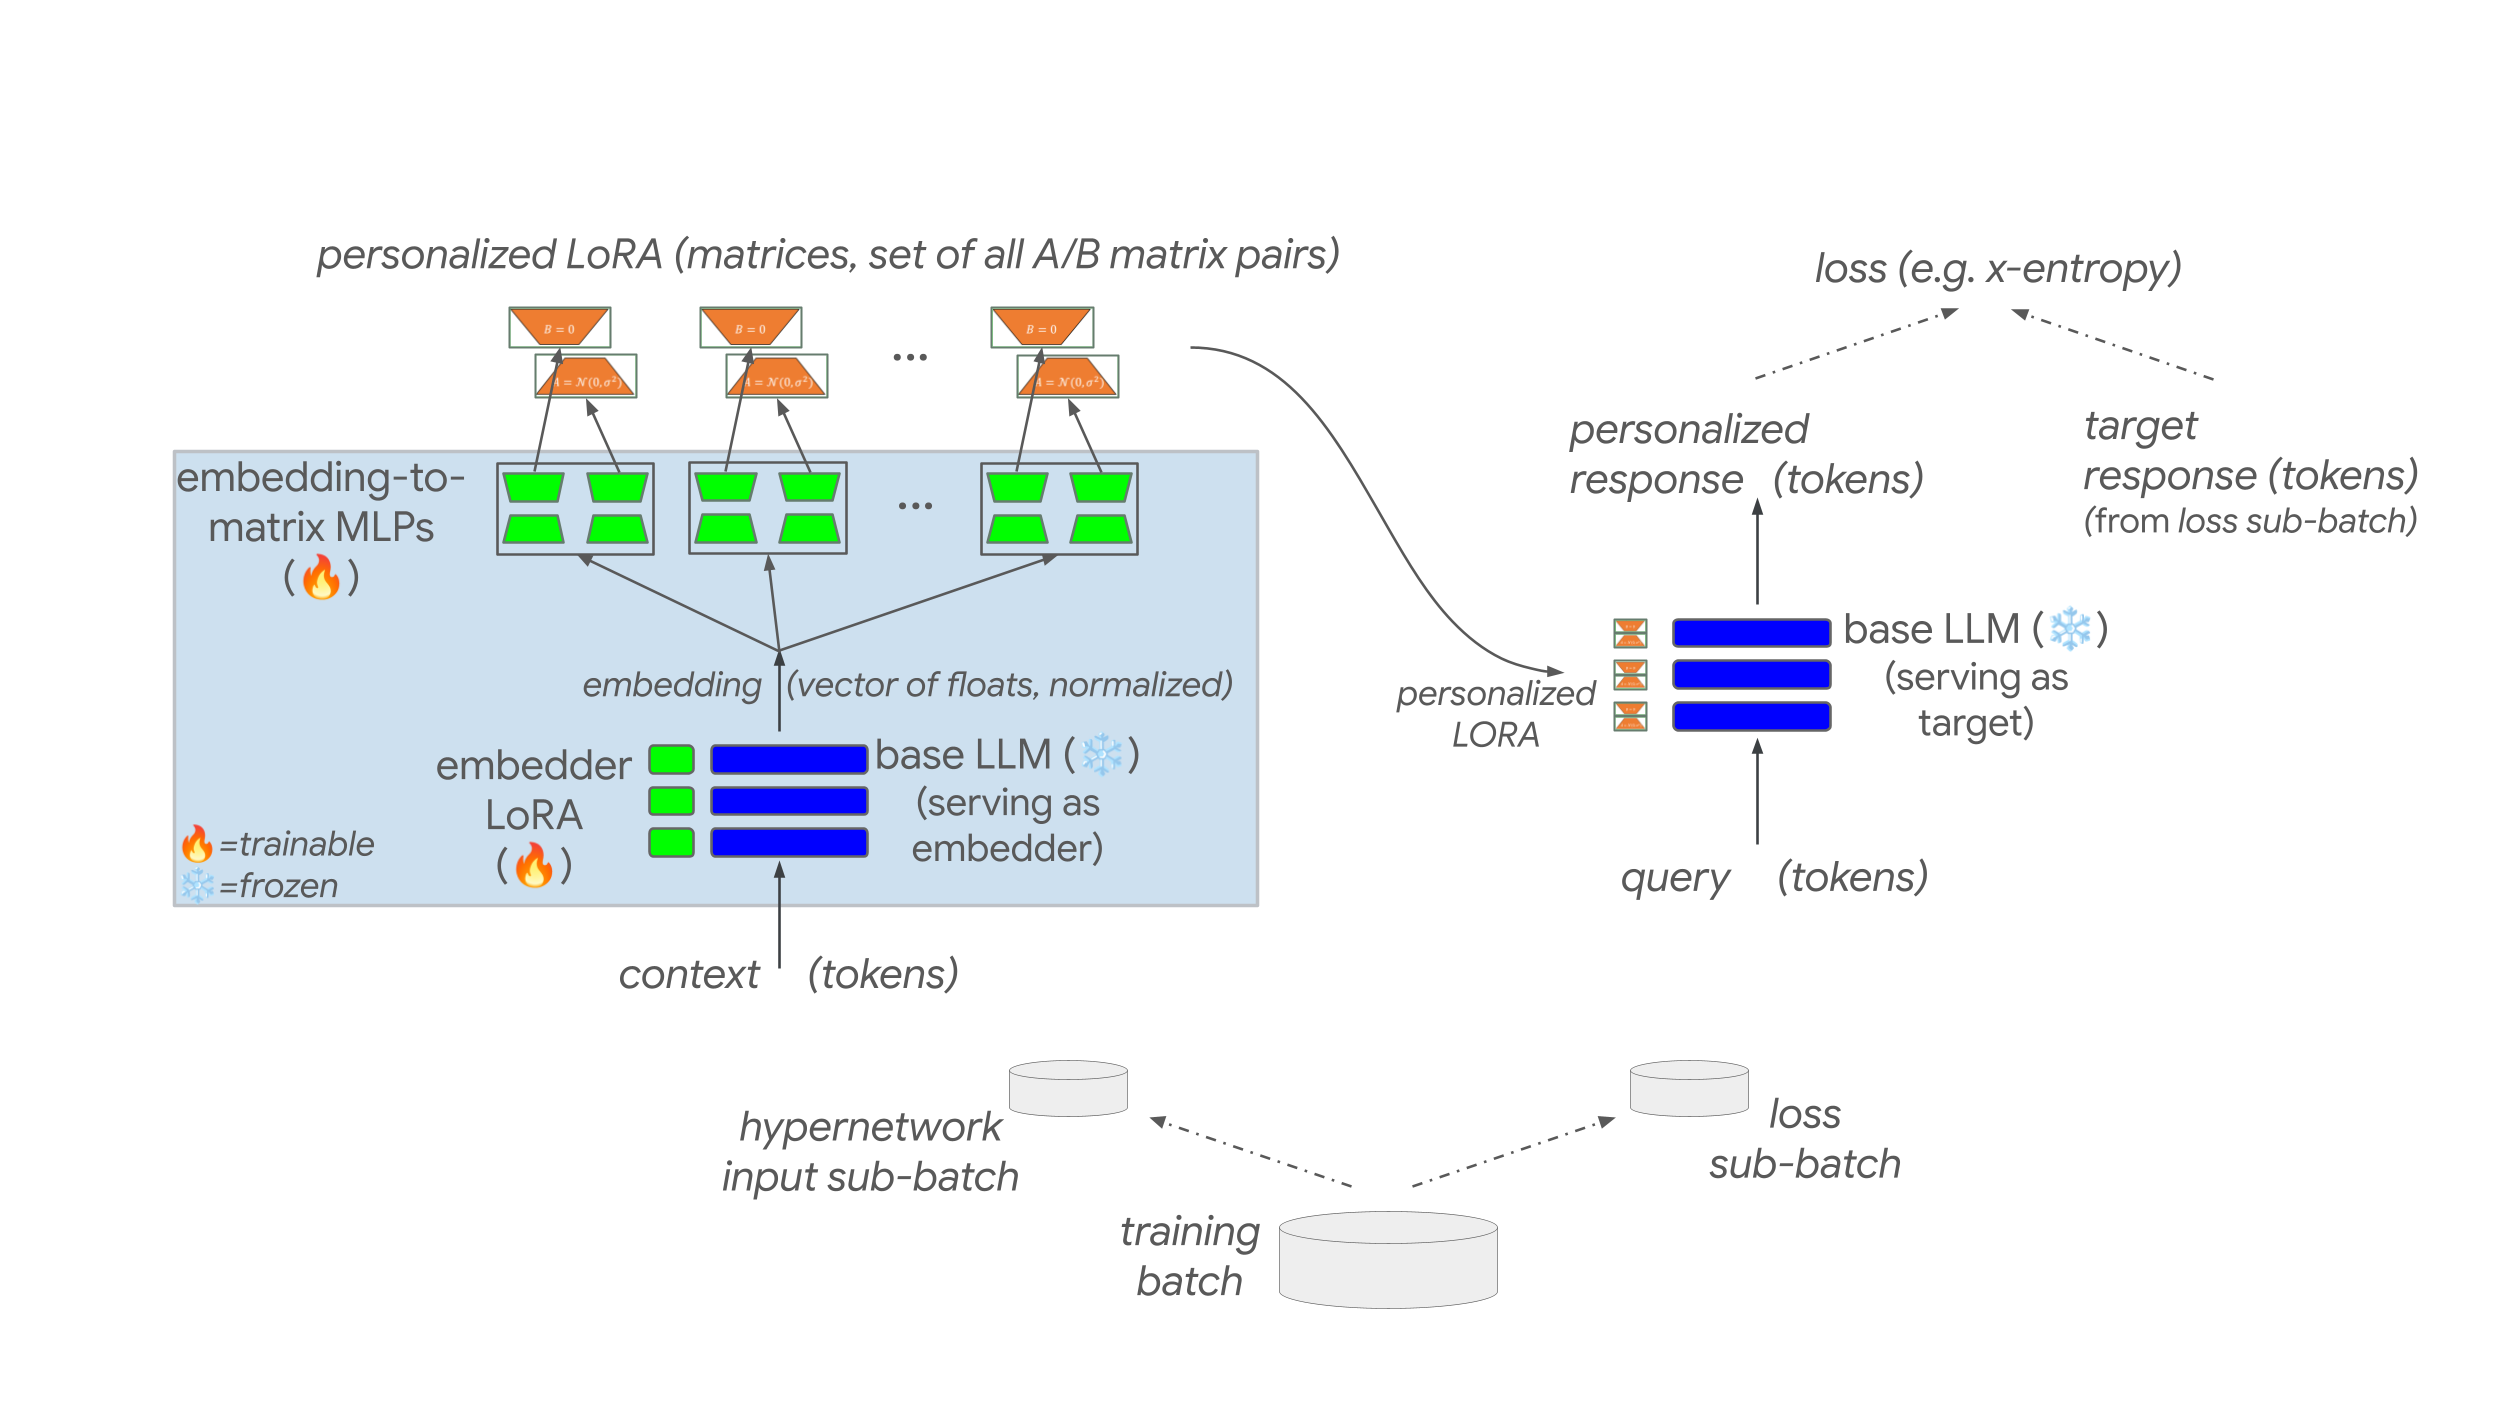
온-디바이스 대규모 언어 모델(LLM, Large Language Model)은 모바일 기기의 연산·메모리 한계로 인해 파라미터 규모가 제한되어 품질 상한이 낮지만, 기기가 특정 사용자와 강하게 결합되어 문체·톤과 같은 중장기 사용 패턴이 반복된다는 점에서 개인화가 실질적인 품질 이득을 가져올 수 있습니다. 기존 하류 적응 축인 문맥 내 학습(ICL, In-Context Learning)은 순전파만으로 실현 가능하나 입력 시퀀스 연장에 따른 지연 증가와 긴 컨텍스트에서의 품질 저하(context rot)가 따르며, 파라미터 효율 파인튜닝(PEFT, Parameter-Efficient Fine-Tuning)은 저랭크 적응(LoRA, Low-Rank Adaptation)으로 가중치를 수정할 수 있으나 사용자별 기울기 하강이 모바일 환경에 비현실적입니다. 이에 사용자 컨텍스트 토큰을 해당 사용자에 적합한 LoRA 행렬 집합으로 사상하는 하이퍼네트워크(Hypernetwork)를 학습하고, 공통 아티팩트를 배포한 뒤 각 기기에서 순전파만으로 개인화 LoRA를 합성하는 접근이 제안됩니다. 이 파이프라인은 공통 학습 비용을 Phase 1으로 집중시키고, Phase 2의 개인 LoRA 생성과 Phase 3의 쿼리별 추론을 기기에서 가볍게 수행할 수 있도록 설계되어 ICL의 실현 가능성과 PEFT의 가중치 기반 적응을 절충합니다.
아키텍처는 이미 기기에 존재하는 타깃 디코더 LLM을 최대한 재사용합니다. 동결된 베이스에 학습 가능한 embedder LoRA를 붙여 사용자 예시(쿼리–응답)를 연결 시퀀스로 인코딩한 뒤 풀링으로 사용자 임베딩을 얻고, embedding-to-matrix MLP(다층 퍼셉트론)가 이를 각 층·모듈의 A·B 저랭크 행렬로 변환합니다. 병목 폭은 주성분 LoRA 계수 해석과 맞물리며, 생성 후에는 하이퍼네트워크 추가 가중치를 삭제할 수 있어 저장 오버헤드를 최소화합니다. 학습은 비지도 대비학습 기반 임베더 사전학습과 종단간 학습의 두 단계로 이루어지며, 특히 ICL 교사 분포를 사용자별로 증류하는 컨텍스트 증류가 생성 품질을 높이는 데 유효합니다. LongLaMP·LaMP 계열의 사용자 분할 데이터셋에서 Gemma 계열 소형 인스트럭션 튜닝 모델을 대상으로 장문 생성 개인화를 평가한 결과, 하이퍼네트워크는 평균 ROUGE-1과 개선 사용자 비율에서 ICL·PEFT와 동등하거나 이를 상회하는 성능을 보이며, 입력 용량은 즉시 적응에 남기고 장기 페르소나는 교체 가능한 LoRA로 다루는 온디바이스 개인화 경로를 제시합니다.
초록(Abstract)
온디바이스 대규모 언어 모델(LLM), 예를 들어 모바일 폰에서 실행되는 모델은 개인화를 통한 개선의 여지가 크다. 모바일 기기의 제한된 연산 자원은 모델 규모와 그에 따른 모델 품질에 제약을 가하므로, 실현 가능한 품질 향상이라면 그 영향이 매우 크다. 동시에, 기기의 개인적 특성(즉, 특정 사용자와의 긴밀한 결합)으로 인해 주어진 온디바이스 LLM은 시간이 지남에 따라 유사하고 예측 가능한 패턴으로 사용되는 경향이 있다. 본 논문은 온디바이스 LLM을 개인화하는 새로운 방법을 제시한다. 이 방법은 하이퍼네트워크(hypernetwork)를 학습하여 사용자의 컨텍스트 토큰을 해당 사용자에게 적합한 저랭크 적응(LoRA)으로 매핑한다. 학습된 공통 산출물이 사용자 기기에 배포되면, 각 사용자는 하이퍼네트워크를 이용해 (전적으로 기기 상에서) 개인화된 LoRA를 합성한다. 이 접근은 LLM 커스터마이징의 기존 두 방법, 즉 문맥 내 학습(ICL)과 파라미터 효율적 파인튜닝(PEFT)의 이점을 결합하면서도 각각의 단점은 피한다. ICL과 같이(그리고 PEFT와 달리) 본 접근의 온디바이스 단계는 신경망을 통한 순전파만 필요하므로 계산적으로 실현 가능하다. PEFT와 같이(그리고 ICL과 달리) 본 접근은 가중치(LoRA)를 통해 ‘대상’ 베이스 LLM을 수정하므로, 입력 시퀀스 확장에 따른 부정적 결과(예: 지연 시간 증가)를 피할 수 있다. 본 접근은 모바일 기기 환경에 특히 적합하다. 앞서 언급한 온디바이스 연산 및 지연 시간상의 이점 외에도, 내부적으로 그 아키텍처가 개인화 대상 LLM에 속하는 것과 동일한 LLM 가중치를 부분적으로 활용하므로 추가 저장 공간도 최소로 필요하다. 우리는 여러 대표적인 개인화 데이터셋에서 LoRA 생성 하이퍼네트워크의 이점을 보이며, ICL 및 PEFT와 같은 베이스라인과 비교한다. 특히, 우리의 개인화 실험은 더 어렵고 덜 연구된 장문 텍스트 생성 과제에 초점을 둔다.
On-device large language models (
LLMs'), e.g. running on mobile phones, are ripe for improvement via personalization. The limited compute resources of mobile devices impose limits on model scale and thus model quality, making any realizable quality gains highly impactful. At the same time, their personal nature (i.e., the close coupling to a particular user) means that a given on-device LLM tends to be used in similar, predictable patterns over the course of time. This paper presents a novel method for personalizing on-device LLMs. It trains a hypernetwork to map a user's context tokens to a low-rank adaptation (LoRA') well-suited to that user. Once the trained common artifacts are deployed to users' devices, each user uses the hypernetwork to synthesize (entirely on device) a personalized LoRA. This approach blends the benefits while avoiding the drawbacks of two existing approaches to LLM customization: in-context learning (ICL') and parameter-efficient fine-tuning (PEFT'). Like ICL (and unlike PEFT), the on-device phase of our approach is computationally feasible, requiring only forward passes through neural networks. Like PEFT (and unlike ICL), our approach modifies the `target' base LLM via weights (the LoRA), avoiding negative consequences (e.g. increased latency) associated with extending the input sequence. Our approach is particularly well-suited to the mobile device regime. Apart from the on-device compute and latency benefits mentioned, it also requires minimal additional storage, as internally its architecture partly leverages the same LLM weights as belong to the target LLM to be personalized. We demonstrate the benefits of LoRA-generating hypernetworks on several representative personalization datasets, comparing against baselines like ICL and PEFT. Of note, our personalization experiments focus on more challenging and less studied long-form text generation tasks.
논문 링크
Ovis-Embedding: 범용 옴니모달 임베딩의 지평을 넓히다 / Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
논문 소개
밀집 임베딩(dense embedding)은 검색, 검색-증강 생성(Retrieval-Augmented Generation, RAG), 추천, 에이전트 시스템의 핵심 검색 계층으로 자리 잡았지만, 실제 정보 저장소는 텍스트·이미지·비디오·오디오·시각 문서·인터페이스 상태가 섞인 이종 콘텐츠로 구성됩니다. 이상 기계 소리와 짧은 텍스트로 비디오 튜토리얼, PDF 도식, 과거 서비스 기록을 한꺼번에 찾는 유지보수 시나리오처럼, 질의와 후보가 서로 다른 모달리티여도 동일 인덱스에서 직접 매칭해야 하는 Any-to-Any Retrieval이 요구되며, 이를 위해서는 모달리티 간 관련성 점수가 비교 가능하면서도 모달리티 내 세밀한 구분이 남는 일관된 의미 공간이 필요합니다. 기존 비전–언어 특화 모델은 오디오를 다루지 못하고, 많은 옴니모달 시스템은 텍스트–비전 임베더에 오디오 경로를 사후 부착하거나 별도 인코더를 기존 기하에 정렬하는 방식에 의존해, 음향 입력이 오디오 없이 학습된 공간에 적응되며 교차 정렬의 정밀도가 제한될 수 있습니다.
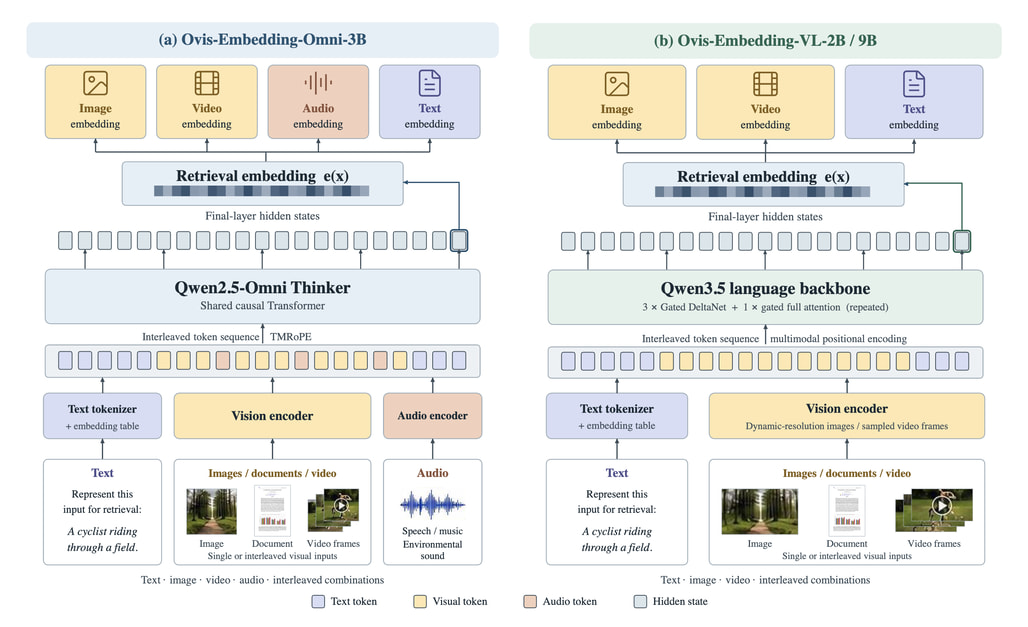
Ovis-Embedding은 이러한 모달리티 단편화를 넘어서기 위해, 사전학습된 Qwen-Omni를 공유 멀티모달 백본으로 두고 음성 생성 경로를 제거한 뒤, 모달리티별 프로젝션 헤드 없이 마지막 비패딩 토큰의 최종 층 은닉 상태를 검색 임베딩으로 사용하는 네이티브 옴니모달 초기화를 채택합니다. Ovis-Embedding-Omni-3B는 텍스트·시각·오디오를 인터리브드(interleaved) 토큰 시퀀스로 인코딩하고 Qwen2.5-Omni Thinker와 TMRoPE로 처리하며, Ovis-Embedding-VL 계열은 텍스트·시각 입력을 Qwen3.5 언어 백본으로 처리해, 단일·인터리브드 입력을 모두 지원하는 통합 인코더로 이해 모델을 재목적화합니다. 학습은 저랭크(low-rank) 초기화와 대조 학습(contrastive training)으로 광역 옴니모달 정렬을 잡고, 약 5,000만 (query, target) 쌍에 이르는 고품질 코퍼스—이미지 분류·질의응답·검색·그라운딩, 비디오 수집–검증–정제, 오디오 인식·매칭·양방향 검색, 일반·인스트럭션·추론·다중조건·장문맥 텍스트 검색, 도구·GUI·지식 중심 에이전트 데이터—를 query–positive–negative 형식으로 표준화한 뒤 평가셋과의 엄격한 중복 제거를 거쳐 구축합니다.
데이터 효율을 높이기 위해 동종 소스 샘플링(homogeneous-source sampling)으로 마이크로배치를 한 소스에서만 구성하고, 풀링된 후보를 중복 제거해 과제 일관의 정보량 높은 배치 내 네거티브를 만듦으로써 모달리티 숏컷을 줄이고 공유 공간의 세밀 판별을 강화합니다. 임베딩 특화 최적화로는 포컬 손실(focal loss)로 어려운 예제에 가중치를 두고, 유사도 기반 Embedding Distillation으로 모달리티 전문가의 세밀한 유사도 구조를 단일 인코더에 전이하며, 추론 시에는 저랭크 특징 분해와 경량 잔차 적응으로 차원 유연한 압축 임베딩을 제공해 인덱스·유사도 비용을 줄입니다. 이러한 네이티브 초기화, 데이터 중심 학습, 임베딩 특화 최적화의 결합으로 Ovis-Embedding 계열은 MMEB-v3, MMEB-v2, MVEB, MAEB, RTEB에서 최신(state-of-the-art)급 성능을 보이며, 통합 옴니모달 학습이 any-to-any 검색을 위한 범용 임베딩의 실질적 전진임을 보여 줍니다.
초록(Abstract)
본 보고서에서는 텍스트, 이미지, 비디오, 오디오의 네이티브 통합을 기반으로 구축된 최신(state-of-the-art) 옴니모달 임베딩 계열인 Ovis-Embedding을 소개한다. 별도의 모달리티 타워를 조립하는 대신, Ovis-Embedding은 공유 멀티모달 백본을 사용하여 서로 다른 모달리티를 공통 표현 공간에 인코딩한다. 구체적으로, 우리는 세 가지 핵심 진전을 이룬다. (1) 네이티브 옴니모달 초기화: 사전학습된 Qwen-omni 모델을 임베딩 백본으로 채택하고, 저랭크 초기화와 함께 대조 학습을 통해 적응시킨다. (2) 데이터 중심 옴니모달 학습: 텍스트, 이미지, 비디오, 오디오 및 인터리브드 멀티모달 데이터를 아우르는 광범위하고 고품질의 코퍼스를 구축한다. 데이터 효율을 높이기 위해, 정보가 풍부한 배치 내 네거티브를 포함하는 과제 일관 배치를 구성하도록 동종 소스 샘플링을 도입한다. (3) 임베딩 특화 학습 및 추론 최적화: 포컬 손실을 사용해 어려운 예제에 더 큰 비중을 두고, 유사도 기반 Embedding Distillation으로 상호 보완적인 전문가들로부터 세밀한 유사도 구조를 전이한다. 추론 시에는 저랭크 특징 분해를 통해 유연한 차원과 최소 성능 손실로 압축된 임베딩을 얻을 수 있다. 실험 평가 결과, Ovis-Embedding 계열은 MMEB-v3, MMEB-v2, MVEB, MAEB, RTEB에서 최신 최고 성능을 달성하여, 텍스트·이미지·비디오·오디오 모달리티 전반에서의 효과성을 입증한다. 이러한 결과는 통합 옴니모달 학습이 모달리티 단편화를 극복하고, any-to-any 검색을 위한 범용 임베딩 모델을 발전시킬 잠재력을 가짐을 보여준다.
In this report, we introduce \textbf{Ovis-Embedding}, a state-of-the-art omni-modal embedding family built on native integration of text, image, video, and audio. Instead of assembling separate modality towers, Ovis-Embedding uses a shared multimodal backbone to encode different modalities in a common representation space. Specifically, we make \textbf{three key advances}: (1) \textbf{native omni-modal initialization}: we adopt a pretrained Qwen-omni model as the embedding backbone and adapt it through contrastive training with low-rank initialization; (2) \textbf{data-centric omni-modal training}: we construct a broad, high-quality corpus spanning text, images, video, audio, and interleaved multimodal data. To improve data efficiency, we introduce homogeneous-source sampling to form task-consistent batches with informative in-batch negatives; and (3) \textbf{embedding-specific training and inference optimization}: we use focal loss to emphasize hard examples and similarity-based Embedding Distillation to transfer fine-grained similarity structure from complementary experts. At inference time, low-rank feature decomposition enables compact embeddings with flexible dimensionality and minimal performance loss. Empirical evaluations show that the \textbf{Ovis-Embedding} family achieves state-of-the-art performance on \textbf{MMEB-v3}, \textbf{MMEB-v2}, \textbf{MVEB}, \textbf{MAEB}, and \textbf{RTEB}, demonstrating its effectiveness across text, image, video, and audio modalities. These results highlight the potential of unified omni-modal training to overcome modality fragmentation and advance universal embedding models for any-to-any retrieval.
논문 링크
더 읽어보기
</br />
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일 로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 뉴스 발행에 힘이 됩니다~
