PyTorchKR


이번 주에 선정된 10편의 논문들을 종합해 본 결과, AI가 외부의 도움 없이 스스로 진화하고, 더욱 복잡하고 현실적인 환경에서 장기적인 문제를 주도적으로 해결해 나가는 방향으로 연구가 집중되고 있음을 확인할 수 있었습니다. 주요 트렌드 3가지는 다음과 같습니다.
 외부 의존도를 낮춘 자기 주도적 학습 및 피드백 내재화: 이번 주 논문들에서는 외부의 정답 데이터나 더 큰 교사 모델에 의존하는 대신, 모델 스스로 생성한 피드백을 통해 역량을 높이는 자기 개선 트렌드가 돋보입니다. RLTL;DR은 에이전트가 실패한 시도에서 스스로 요약된 통찰을 생성하고 이를 훈련에 내재화하여 기존 강화학습의 정체를 성공적으로 돌파했습니다. UniEvo-VL 역 멀티모달 모델이 자기 비판을 특권 정보로 활용해 스스로를 가르치는 프레임워크를 제안했으며, SkillGym은 인간의 문제 해결 워크플로우를 단순한 외부 지침이 아닌 모델 자체의 절차적 능력으로 깊이 각인시켰습니다. 추가로 LoopCD는 외부 학습 과정 없이 루프형 모델 내부의 중간 예측값만을 대조 신호로 활용해 추론의 품질과 연산 효율을 동시에 끌어올렸습니다. 이는 향후 AI가 외부 개입 없이도 스스로 자신의 한계를 분석하고 진화할 수 있는 강력한 잠재력을 지니고 있음을 시사합니다.
 복잡한 현실 세계를 반영한 다차원적 평가 및 환경 구축: 모델의 기본 성능이 상향 평준화됨에 따라, 단순한 객관식 정답률을 넘어 장기적 상호작용과 인지적 깊이를 엄격하게 검증하는 인프라 구축이 대두되고 있습니다. AgentWorld는 최대 1,000개의 에이전트가 참여하는 샌드박스 환경을 구축해, 단순 과제 성공률이 아닌 행동의 인과적 기여도를 바탕으로 다중 에이전트의 진정한 협업 능력을 평가합니다. KilometerVision은 비전-언어 모델이 2D 이미지 매칭의 꼼수를 쓰지 않고 실제 1km 이상의 공간에서 기하학적 경로를 이해할 수 있는지 검증하여 현재 모델들의 근본적인 한계를 명확히 짚어냈습니다. 또한 AutoGym은 강화학습을 위한 복잡한 훈련 체육관을 사전에 정의된 청사진을 통해 결함 없이 자동 합성하는 기술을 선보였으며, AI 의식 평가 프레임워크 연구는 철학적이고 모호한 의식의 문제를 체계적인 기능적 계층 구조로 수치화했습니다. 이러한 움직임은 벤치마크 거품을 걷어내고, 복잡한 현실 세계에 AI를 안전하게 도입하기 위한 필수적인 검증 과정입니다.
 목표 지향적 탐색 및 의사결정 기반의 장기 문제 해결 고도화: 단편적인 질문에 답하는 수준을 넘어, 에이전트가 장기적인 시각에서 복잡한 문제를 기획하고 능동적으로 의사결정을 내리는 자율성 강화 연구가 활발합니다. 대표적으로 AIM은 과학 연구 과정에서 무수히 뻗어나가는 아이디어들을 체계적으로 조직화하고, 한정된 자원을 가장 유망한 탐색 방향에 적응적으로 할당하는 에이전틱 자동화 프레임워크를 선보였습니다. 구조화된 선택 상황에 특화된 Jev 모델은 추천 시스템의 재순위화 작업에서 추론 효율과 추천 품질 사이의 새로운 균형점을 입증하며 의사결정 지향 모델의 실용성을 뽐냈습니다. 앞서 언급된 AutoGym과 SkillGym 역시 단순한 텍스트 생성을 넘어, 복잡한 생산성 작업과 시간적 추론이 필요한 장기 과제들을 에이전트가 스스로 기획하고 완수할 수 있도록 훈련하는 데 집중하고 있습니다. 이는 다가오는 AI가 단순한 보조 도구를 넘어, 독자적으로 가설을 검증하고 실행에 옮기는 주도적인 문제 해결사로 자리매김하고 있음을 확연히 보여줍니다.
논문별 핵심 내용 간략 요약
-
AgentWorld: 장기 멀티에이전트 협력을 위한 벤치마크: 3~20개의 에이전트가 블랙박스 환경에서 장기적으로 협력하는 능력을 평가하는 다중 에이전트 벤치마크입니다. 단순한 과제 성공률을 넘어 개별 에이전트 행동의 인과적 기여도를 측정함으로써 진정한 팀 협업 효율성을 정량화합니다.
-
LoopCD: 루프형 트랜스포머를 위한 무학습 대조적 디코딩: 루프형 트랜스포머의 반복 구조에서 발생하는 중간 상태를 활용해 외부 학습 없이 추론 품질을 높이는 대조적 디코딩 기법을 제안합니다. 이를 통해 연산량을 대폭 줄이면서도 기존 디코딩 방식과 동등하거나 그 이상의 뛰어난 성능을 달성합니다.
-
UniEvo-VL: 멀티모달 모델의 자율적 진화를 위한 자기 증류 프레임워크: 외부 교사 모델 없이 멀티모달 모델 스스로 생성한 비판을 바탕으로 자신을 지속해서 개선하는 온정책 자기 진화 프레임워크입니다. 디노이징 디퓨전 분포 간의 발산을 최소화하는 학습을 통해 이미지 생성 및 평가 능력을 자율적으로 향상시킵니다.
-
의사결정 지향 모델 Jev 기반 추천 시스템 재순위화 실증 분석: 구조화된 선택지가 주어지는 추천 시스템의 재순위화 작업에서 의사결정 지향 모델의 효용성을 심층적으로 분석한 연구입니다. 기존 추천 전용 모델 및 대형 언어 모델과 비교하여 추천 품질과 추론 지연 시간 사이에서 작동하는 새로운 실용적 균형점을 입증했습니다.
-
KilometerVision: 시각-언어 모델의 대규모 공간 지능 평가 벤치마크: 최대 1km 거리에 달하는 실제 보행 영상을 바탕으로 시각-언어 모델의 공간 지능을 랜드마크 식별부터 멘탈맵 형성까지 계층적으로 평가합니다. 평가 결과 현재의 모델들이 진정한 기하학적 추론 없이 평면적인 시각 인식과 텍스트 매칭에만 의존하고 있다는 근본적인 한계를 밝혀냈습니다.
-
AI 의식 평가를 위한 5단계 계층 기반 베이지안 확률 프레임워크: 상충하는 AI 의식 논의를 5단계의 기능적 설명 계층으로 구조화하고 체계적으로 평가하는 통합 프레임워크를 제안합니다. 베이지안 모델을 도입하여 특정 이론에 얽매이지 않고 실증적 증거에 따라 시스템의 의식 수준을 확률적으로 측정할 수 있는 기반을 마련했습니다.
-
AIM: 자동화된 과학 연구를 위한 베이지안 최적화 기반 아이디어 관리 시스템: 과학 연구 자동화 과정에서 파생되는 수많은 아이디어를 체계적으로 탐색하고 실험 자원을 효율적으로 분배하는 에이전틱 관리 시스템입니다. 베이지안 최적화 원리를 차용하여 가장 유망한 연구 방향을 선별하고 아이디어와 솔루션 간의 무결성을 자율적으로 유지합니다.
-
RLTL;DR: 자체 통찰 생성을 통한 에이전트 자기 개선 및 강화학습: 에이전트가 스스로 자신의 실패를 분석하여 간결한 통찰을 생성하고 이를 정책 학습에 직접 내재화하는 새로운 형태의 강화학습 패러다임입니다. 외부의 정답이나 교사 모델 없이도 극도로 어려운 코딩 및 도구 활용 작업에서 유의미한 성능 향상을 이끌어냅니다.
-
AutoGym: 에이전트 강화학습을 위한 무결성 검증 환경 자동 합성 프레임워크: 최소한의 시드 데이터만으로 작업, 실행 환경, 검증자를 모두 포함한 강화학습용 훈련 공간을 자동으로 합성합니다. 청사진 우선 생성 방식을 통해 해결 불가능한 환경 생성을 원천적으로 차단하고 모델 성장에 맞춰 동적으로 작업 난이도를 조절합니다.
-
SkillGym: 인간의 문제 해결 워크플로우를 내재화하는 에이전트 훈련 시스템: 인간이 텍스트로 작성한 문제 해결 과정을 단순한 외부 지침으로 두지 않고 에이전트가 직접 실행하고 검증할 수 있는 훈련 환경으로 변환합니다. 수집된 성공 궤적을 기반으로 모델을 파인튜닝하여 복잡한 현실 세계에서의 실질적인 절차적 문제 해결 역량을 크게 강화합니다.
AgentWorld: 멀티에이전트 LLM의 장기 협력 벤치마킹 / AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs
논문 소개
대규모 언어 모델(LLM) 기반 에이전트는 단순한 텍스트 생성을 넘어 도구 활용, 계획 수립, 다단계 실행으로 발전하면서 소프트웨어 개발, 과학 연구, 복잡한 운영 관리 등 여러 전문 역할의 협력이 필요한 현실 문제를 해결하는 능력이 중요해지고 있습니다. 그러나 기존의 멀티에이전트 벤치마크는 경쟁 상황이나 20단계 미만의 짧은 상호작용에 집중하거나 개별 에이전트의 성능을 단순 합산하는 방식으로 설계되어, 실제 협업 능력을 체계적으로 분리하여 측정하기 어려운 문제점을 안고 있습니다. 특히 3차원 이동이나 정밀한 조작과 같은 저수준 제어 능력이 과제 결과에 과도한 영향을 미칠 수 있으며, 불명확한 목표와 측정 기준으로 인해 협업의 본질적 측면을 평가하기 곤란한 상황이 반복되어 왔습니다.
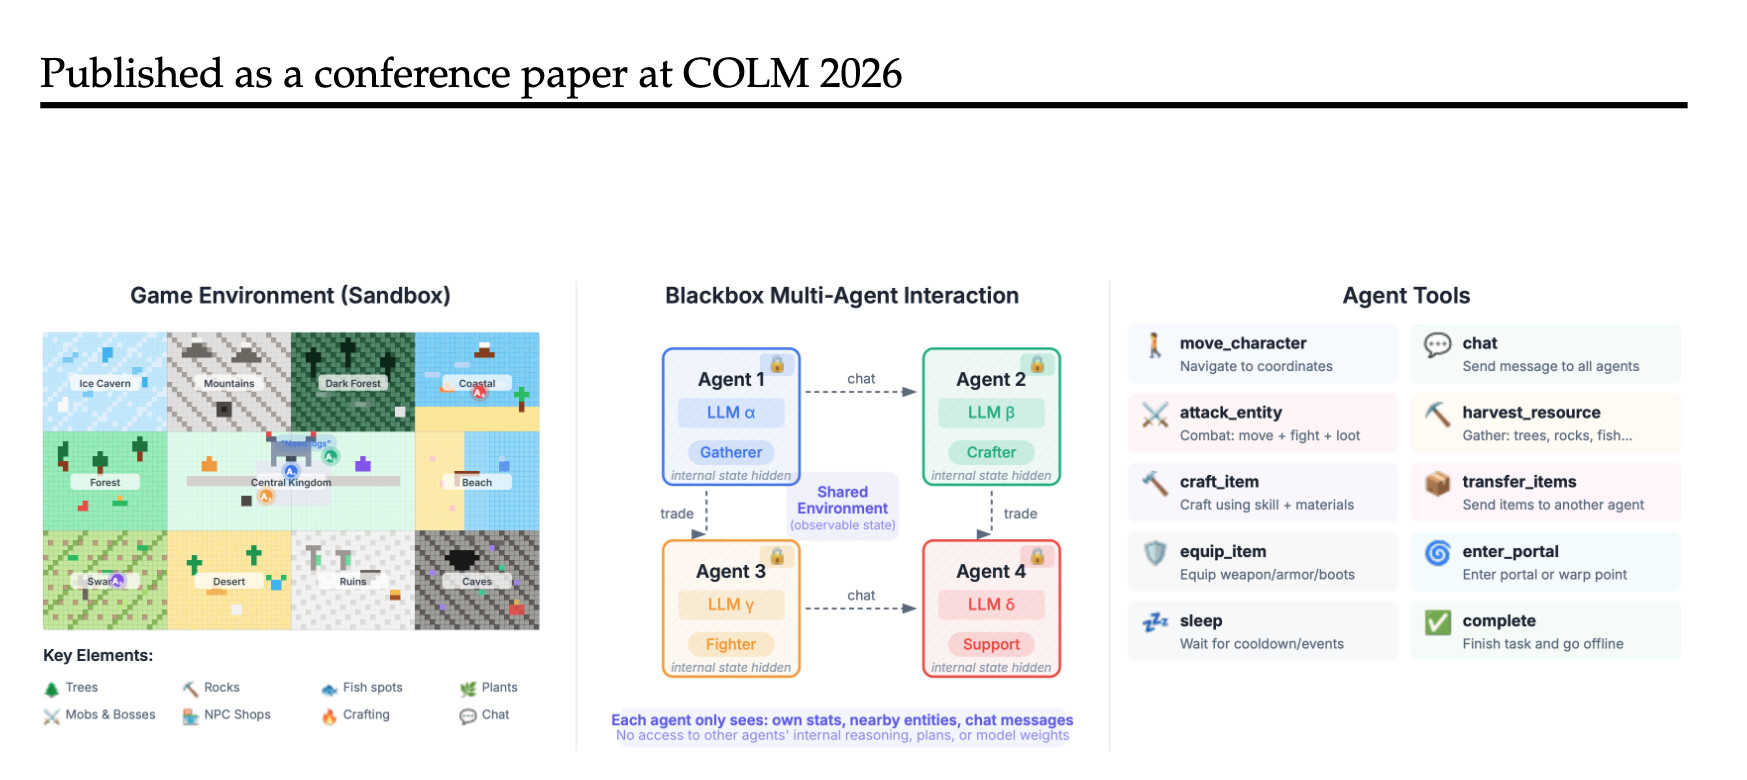
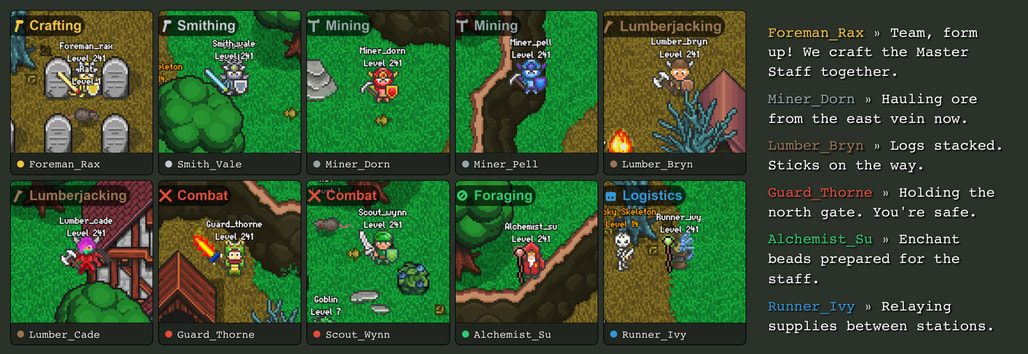
이러한 배경에서 본 연구는 AgentWorld라는 포괄적인 벤치마크를 제시하며, 이는 MMORPG 형태의 풍부한 시뮬레이션 환경에서 3~20개의 비대칭적 역할을 가진 에이전트가 25~55라운드에 걸쳐 장기적으로 협력하는 상황을 다룹니다. 벤치마크의 핵심 설계 원칙은 에이전트가 다른 에이전트의 내부 상태를 직접 관찰할 수 없는 블랙박스 환경을 구성하는 것으로, 이를 통해 자연어 의사소통, 공동 계획, 자원 공유에 기반한 진정한 협업을 요구하도록 합니다. 환경은 최대 1,000개의 에이전트 동시 실행을 지원하며 380개 이상의 아이템, 144종의 몹, 70명 이상의 NPC를 포함하고, 13개의 고수준 API 도구를 통해 저수준 조작을 추상화함으로써 평가가 미세한 조작 숙련도보다는 협업 능력에 더욱 집중되도록 설계되었습니다.
기존의 이진 과제 성공률만으로는 팀의 행동 중 실제 목표 달성에 얼마나 기여했는지 파악하기 어렵다는 판단 하에, 본 연구는 인과적 협업 효과성(Causal Collaboration Effectiveness, CCE)을 제안합니다. 이 지표는 과제 수행 궤적에서 에이전트 행동 간의 인과 관계 그래프를 구성하고, 팀이 수행한 전체 행동 중 과제 완료에 인과적으로 기여한 행동이 차지하는 비율을 측정함으로써, 동일한 성공률을 보이더라도 불필요한 중복 행동이 많은 팀과 효율적으로 협력한 팀을 구분할 수 있게 합니다. Gemini 3 Flash, Claude Haiku 4.5, GPT-5 Mini, DeepSeek R1-70B 등 네 가지 모델에 대한 평가 결과, 최고 과제 성공률은 52.0%에 불과했으며 최고 CCE는 0.320으로, 가장 우수한 모델조차 전체 에이전트 행동 중 3분의 1 미만만이 과제 완료에 인과적으로 기여함을 보여주었습니다. 정성 분석을 통해서는 핵심 정보가 에이전트 사이에 적절히 전달되지 않는 의사소통 단절, 여러 에이전트가 중복으로 같은 작업을 수행하거나 할당된 역할을 벗어나는 역할 혼동, 그리고 25~55라운드에 걸친 장기 과제에서 팀의 계획과 진행 상태를 일관되게 유지하지 못하는 문제가 반복적인 실패 양상으로 나타났습니다. 이 벤치마크는 오픈소스로 공개되며 시뮬레이션 환경, 과제 정의와 검증 도구, 평가 스크립트, 데이터 주석 플랫폼을 모두 포함하고 있어, 향후 멀티에이전트 협업 능력 향상을 위한 연구의 기초가 될 것으로 기대됩니다.
초록(Abstract)
기존의 멀티에이전트 벤치마크는 주로 경쟁 설정에서, 20단계 미만의 단기 상호작용에서, 또는 개별 성능을 단순히 집계하는 방식으로 테스트되며, LLM 기반 에이전트의 진정한 협업 능력을 격리하고 강조하는 데 실패하고 있습니다. 우리는 장기 멀티에이전트 협업을 평가하기 위한 100개의 인간 주석 과제(100개의 증강 변형 포함)로 구성된 벤치마크 AgentWorld를 소개합니다. 과제들은 풍부한 MMORPG 샌드박스에서 50개 이상의 상호작용 라운드에 걸쳐 있으며, 각 에이전트가 다른 에이전트의 내부 상태에 접근할 수 없는 블랙박스 설정 하에서 통신, 공동 계획, 자원 공유를 통해 조율해야 하는 비대칭 역할과 능력을 가진 3~20개의 에이전트를 필요로 합니다. 기존의 이진 과제 성공에 더해 협업 효율성을 정량화하기 위해, 우리는 에이전트 행동 간의 인과 관계를 추적하고 팀의 노력 중 실제로 결과에 기여한 부분의 비율을 측정하는 그래프 기반 지표인 인과적 협업 효율성(CCE)을 제안합니다. Gemini 3 Flash, Claude Haiku 4.5, GPT-5 Mini, DeepSeek R1-70B을 이용한 실험에서 최고 성능 모델도 52.0%의 과제 성공률만 달성했으며, 통신 장애, 역할 혼동, 여러 라운드에 걸친 공유 계획 유지 불능 등 체계적인 실패 양식을 나타냅니다. AgentWorld는 완전 오픈소스입니다.
Existing multi-agent benchmarks primarily test in competitive settings, short-horizon interactions under 20 steps, or simply aggregate individual performance, failing to isolate and highlight genuine collaboration capabilities of LLM-based agents. We introduce AgentWorld, a benchmark of 100 human-annotated tasks (with 100 augmented variants) for evaluating long-horizon, multi-agent collaboration. Tasks span 50+ interaction rounds across a rich MMORPG sandbox and require 3-20 agents with asymmetric roles and abilities to coordinate through communication, joint planning, and resource sharing under a blackbox setting where each agent acts independently without access to others' internal states. To quantify collaboration effectiveness in addition to conventional binary task success, we propose Causal Collaboration Effectiveness (CCE), a graph-based metric that traces causal dependencies between agent actions and measures what fraction of a team's effort actually contributed to the outcome. Experiments with Gemini 3 Flash, Claude Haiku 4.5, GPT-5 Mini, and DeepSeek R1-70B show that even the best model achieves only 52.0% task success, with systematic failure modes including communication breakdowns, role confusion, and inability to maintain shared plans across rounds. AgentWorld is fully open-source.
논문 링크
더 읽어보기
루프형 트랜스포머를 (거의) 무료로 더 잘 디코딩하기 / Decoding Looped Transformers Better for (Almost) Free
논문 소개
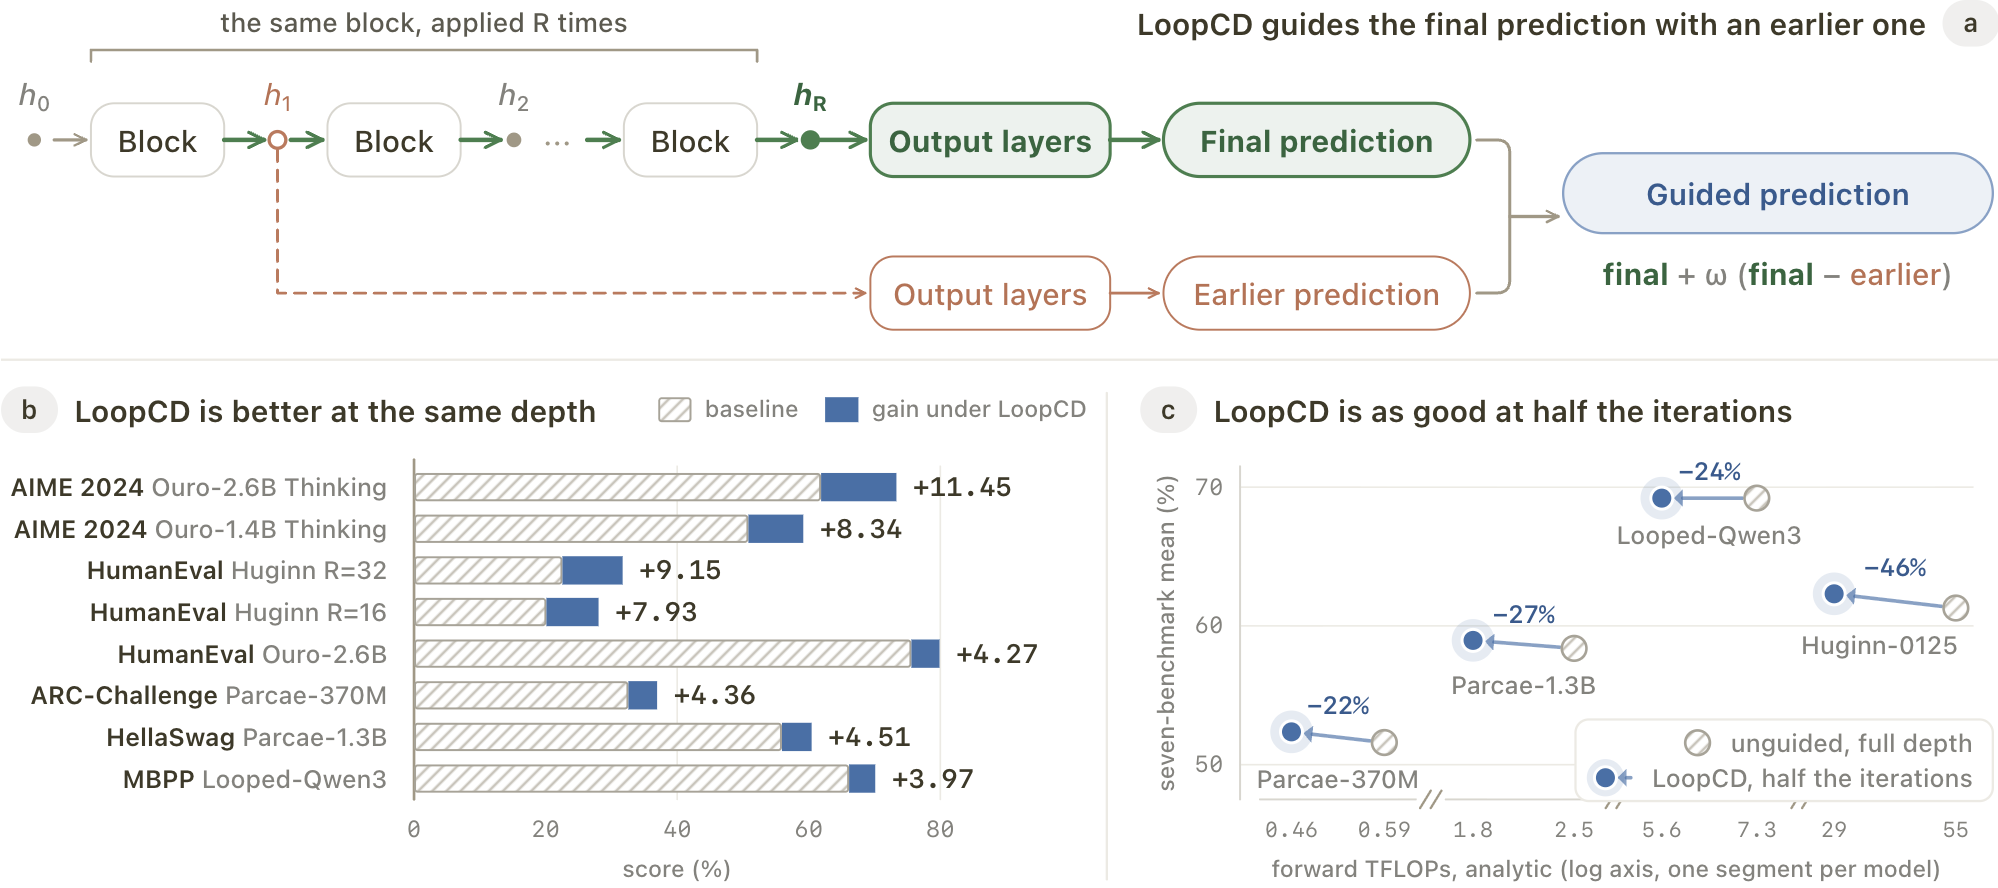
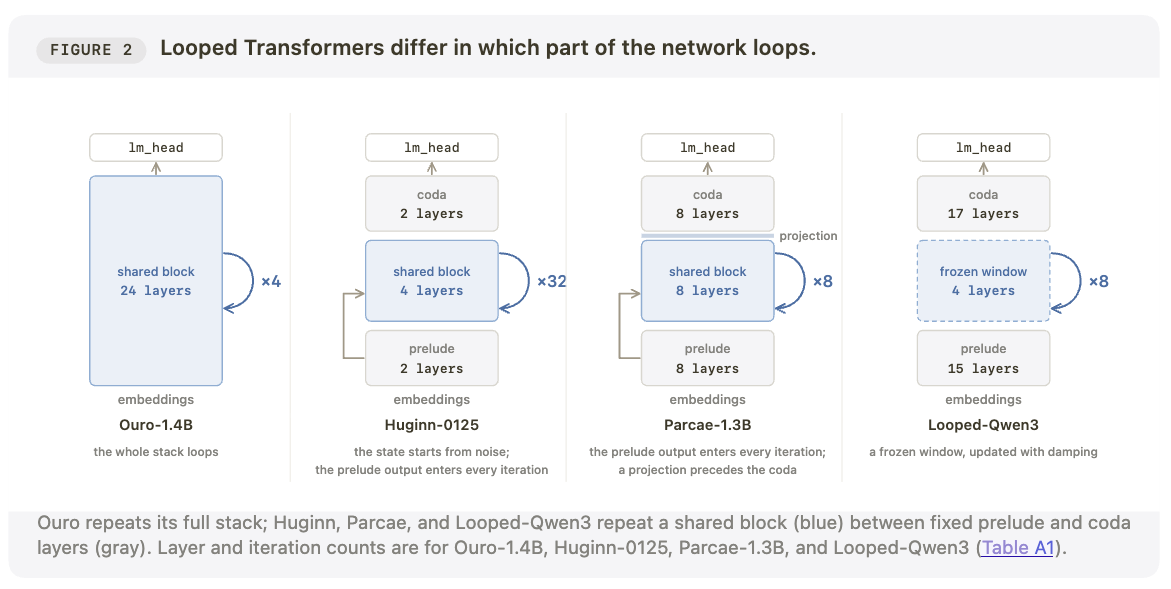
루프된 트랜스포머(Looped Transformers)는 공유 블록을 반복적으로 실행함으로써 파라미터 효율성을 달성하는 현대적 언어 모델 아키텍처로, 각 루프 반복 단계에서 다음 토큰을 예측할 수 있는 중간 표현을 생성합니다. 그러나 표준적인 디코딩 방식은 최종 루프의 예측만을 활용하여 이전 단계에서 생성된 정보를 버리고 있습니다. 이 논문에서 제시하는 LoopCD 프레임워크는 루프 구조 자체에 내재된 약한-강한 예측 쌍을 활용하여 훈련 없이도 토큰 선택을 개선하는 대조적 디코딩 방법론입니다. 루프 단계가 진행될수록 더 많은 연산을 수행하므로 이전 단계의 예측은 적은 계산량으로 생성된 약한 신호로 기능하며, 이러한 자연스러운 신호 쌍은 보조 모델이나 외부 학습 없이도 즉시 얻을 수 있습니다.
LoopCD는 로짓 공간과 숨겨진 상태 공간이라는 두 가지 서로 다른 구현 방식을 제공하여 다양한 아키텍처 특성에 대응합니다. LoopCD-Logits는 참조 상태를 처리하기 위해 하나의 추가 출력 패스를 요구하면서 더욱 강력한 신호를 제공하고, LoopCD-Hidden은 경량의 벡터 연산만 수행하여 거의 영에 가까운 출력 오버헤드를 달성합니다. 이러한 이중 구현은 각 모델의 포스트루프 아키텍처 특성에 따라 최적화되어 있으며, 계산 효율성과 성능 향상 사이의 서로 다른 트레이드오프를 제공합니다.
실험 결과는 네 가지 루프된 트랜스포머 계열에서 LoopCD의 일관된 효과를 입증합니다. Ouro-2.6B-Thinking의 경우 AIME 2024 pass@1이 61.88%에서 73.33%로 상승하였고, Huginn은 HumanEval pass@1이 22.56%에서 31.71%로 향상되었습니다. 특히 주목할 점은 이러한 성능 향상으로 인해 루프 반복 횟수를 절반으로 감소시키면서도 전체 깊이 무유도 기준선과 동일하거나 그 이상의 성능을 유지할 수 있다는 것으로, 순방향 FLOP을 22.5%에서 48.2% 범위로 감소시킵니다. 이는 지도 신호가 단순히 성능을 향상시킬 뿐만 아니라 계산 예산의 효율적 활용도 가능하게 함을 의미합니다.
루프 구조의 깊이와 코다 레이어의 깊이가 두 방식의 성능에 차등적으로 영향을 미친다는 아키텍처 분석은 LoopCD 적용의 실질적 지침을 제공합니다. 완전 재귀 구조를 가진 모델에서는 LoopCD-Logits가 최소 오버헤드로 최대 성능 이득을 달성하지만, 루프 후 깊은 비재귀적 섹션을 포함하는 개조된 아키텍처에서는 LoopCD-Hidden이 더욱 효과적인 계산 절감을 가능하게 합니다. 숨겨진 상태 신호는 후속 코다 레이어에 의해 점진적으로 약화되므로, 모델별로 최적의 참조 상태와 지도 강도를 선택하는 것이 성능 회복의 핵심입니다. 결과적으로 LoopCD는 루프된 트랜스포머의 중간 표현을 계산적으로 효율적인 지도 신호로 변환함으로써, 추가 모델이나 재학습 없이도 추론 성능과 계산 효율성을 동시에 향상시키는 실질적인 해법을 제시합니다.
초록(Abstract)
루프형 트랜스포머는 반복 루프에 걸쳐 공유 블록을 반복적으로 실행하여 파라미터 효율성을 달성합니다.
각 루프는 동일한 다음 토큰에 대해 디코드 가능한 중간 표현을 생성하지만, 표준 디코딩은 이전 상태를 버립니다. 이전 루프가 더 적은 계산을 포함하기 때문에, 반복은 보조 모델이나 외부 학습 없이 자연스럽게 정렬된 약-강 예측 쌍을 제공합니다. 우리는 LoopCD를 소개합니다. 이는 학습 없는 대조적 디코딩 프레임워크로, 최종 예측을 이전 반복 패스와 대조하여 토큰 선택을 안내하며, 로짓 공간에서 하나의 추가 출력 패스로 작동하거나(LoopCD-Logits), 숨겨진 상태 공간에서 출력 오버헤드 없이 작동합니다(LoopCD-Hidden). 4개의 루프형 트랜스포머 계열에 걸쳐, LoopCD는 완전한 반복 깊이에서 상당하고 일관된 성능 향상을 제공합니다: LoopCD-Logits는 Ouro-2.6B-Thinking의 AIME 2024 pass@1을 61.88%에서 73.33%로 향상시키며, LoopCD-Hidden은 Huginn의 HumanEval pass@1을 22.56%에서 31.71%로 올립니다. 중요하게도, 이러한 성능 향상 덕분에 완전 깊이의 가이드 없는 기준선과 일치하거나 초과하면서도 반복 루프의 수를 절반으로 줄일 수 있으며, 포워드 FLOPs를 22.5%~48.2% 감소시킵니다. 중간 반복 상태를 효과적인 안내 신호로 변환함으로써, LoopCD는 추론 계산을 상당히 줄이면서 우수한 디코딩 품질을 달성합니다.
Looped Transformers achieve parameter efficiency by repeatedly executing a shared block across recurrent loops. Each loop yields an intermediate representation decodable for the same next token, yet standard decoding discards earlier states. Because earlier loops embody less computation, recurrence inherently supplies aligned weak-and-strong prediction pairs without auxiliary models or external training. We introduce LoopCD, a training-free contrastive decoding framework that guides token selection by contrasting the final prediction with an earlier recurrent pass, operating either in logit space with one extra output pass (LoopCD-Logits) or in hidden-state space with zero output overhead (LoopCD-Hidden). Across four looped Transformer families, LoopCD delivers substantial, consistent gains at full recurrent depth: LoopCD-Logits raises Ouro-2.6B-Thinking's AIME 2024 pass@1 from 61.88% to 73.33%, while LoopCD-Hidden lifts Huginn's HumanEval pass@1 from 22.56% to 31.71%. Crucially, these performance gains enable halving the number of recurrent loops while still matching or exceeding full-depth unguided baselines, reducing forward FLOPs by 22.5% to 48.2%. By transforming intermediate recurrent states into effective guidance signals, LoopCD achieves superior decoding quality while substantially reducing inference compute.
논문 링크
UniEvo-VL: 멀티모달 모델 자기 개선을 위한 온-정책 자기 증류 학습 레시피 / UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
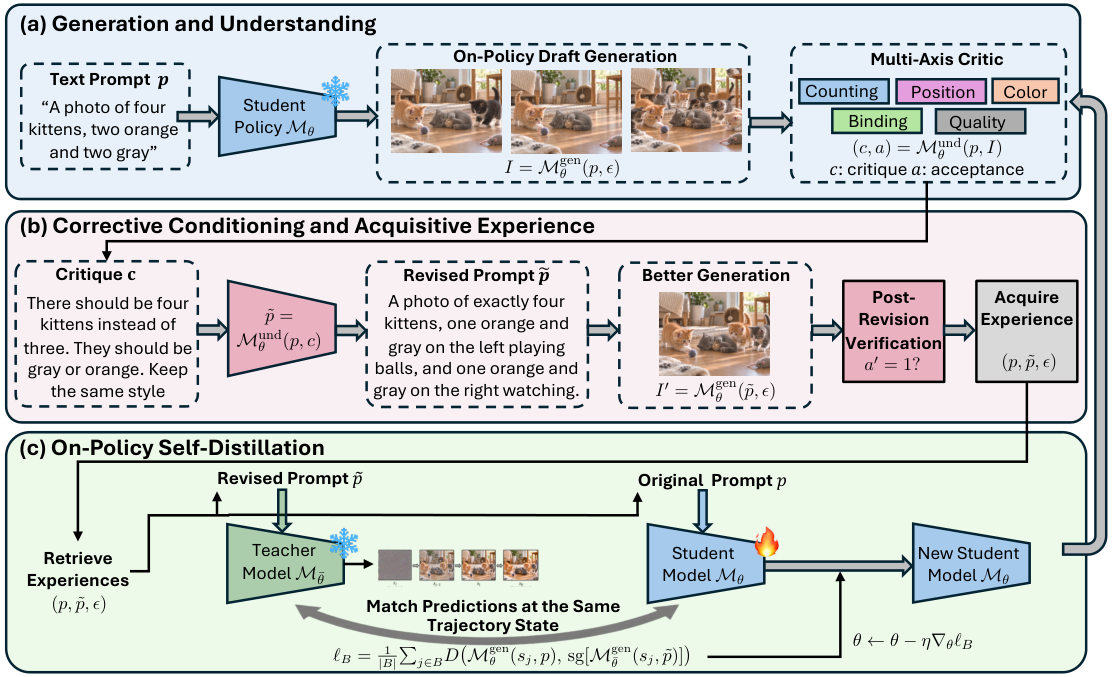
초록(Abstract)
현대의 멀티모달 모델은 생성과 이해를 단일 통합 시스템으로 구현하여 자체 피드백을 제공하고 학습할 수 있도록 합니다. 이러한 통합된 능력에 착안하여, 우리는 테스트 타임 컴퓨트(test-time compute) 중에 건설적인 자기-수정 피드백으로부터 학습하는 멀티모달 모델의 자기-진화 프레임워크인 UniEvo-VL을 소개합니다. 별도의 더 큰 교사 모델에 의존하는 대신, 우리는 자기-비판을 특권 정보(privileged information)로 활용하고 단일 멀티모달 모델이 서로 다른 컨텍스트에서 교사와 학생의 역할을 모두 수행하도록 합니다. 학생은 원본 질문만 입력받고, 교사는 특권 정보인 비판에 조건지어집니다. 그 후 학습은 학생 자신의 샘플링 궤적에 대한 디노이징 디퓨전(denoising diffusion) 분포 간의 상태별 발산을 최소화합니다. 실험 결과는 UniEvo-VL이 멀티모달 모델의 이미지 생성 능력을 향상시키면서 추가 성찰 정보에 대한 민감성을 유지함을 보여줍니다. 구체적으로, 오픈소스 Qwen-image-2512를 기반으로 GenEval에서 0.747에서 0.808로, GenEval2 Soft-TIFA에서 32.97에서 35.53으로 유의미한 성능 향상을 달성했습니다. 또한, 더 강력한 외부 비평가(예: GPT5.6-Luna)를 활용한 실험은 강한 판단 능력을 가진 멀티모달 모델이 더 높은 자기-진화 상한을 기대할 수 있음을 시사합니다. 마지막으로, 혼합 텍스트 렌더링 결과는 우리의 자기-개선이 다양한 작업에 걸쳐 균일하지 않을 수 있음을 보여줍니다. 본 연구는 외부 감독이나 지도 없이 멀티모달 모델을 사용할 때의 사용자 경험을 향상시키기 위해 현재 주목받는 재귀적 자기-개선 연구에 기여하고자 합니다.
Modern multimodal models bring generation and understanding into a single unified system, which enables them to provide and learn from their own feedback. Motivated by this unified capacity, we introduce UniEvo-VL, a self-evolving framework for multimodal models to learn from this constructive self-correction feedback during test-time compute. Instead of relying on a separate, often larger, teacher, we leverage their self-critiques as privileged information and ask a single multimodal model to act as both teacher and student with different contexts. The student only sees the vanilla question, while the teacher conditions on the privileged critique. Then training minimizes the per-state divergence between their denoising diffusion distributions over the student's own sampling trajectories. Experiments demonstrate that UniEvo-VL improves the image generation capabilities of multimodal models, while maintaining their sensitivity to additional reflection information. Specifically, we build on top of the open-source Qwen-image-2512 and observe a significant performance gain from 0.747 to 0.808 on GenEval and from 32.97 to 35.53 on GenEval2 Soft-TIFA. Moreover, attempts with more powerful external critics (e.g., GPT5.6-Luna) show that multimodal models with strong judge capabilities can anticipate a higher self-evolving ceiling. Last but not least, mixed text-rendering outcomes show that our self-improvements may not be uniform across different tasks. Our study aims to shed light on the current hot recursive self-improvement research line to enhance the user experience when using multimodal models without external supervision or guidance.
논문 링크
의사결정 지향적 추천 재순위 매김: Jev에 대한 실증 연구 / Decision-Oriented Recommendation Reranking: An Empirical Study of Jev
논문 소개
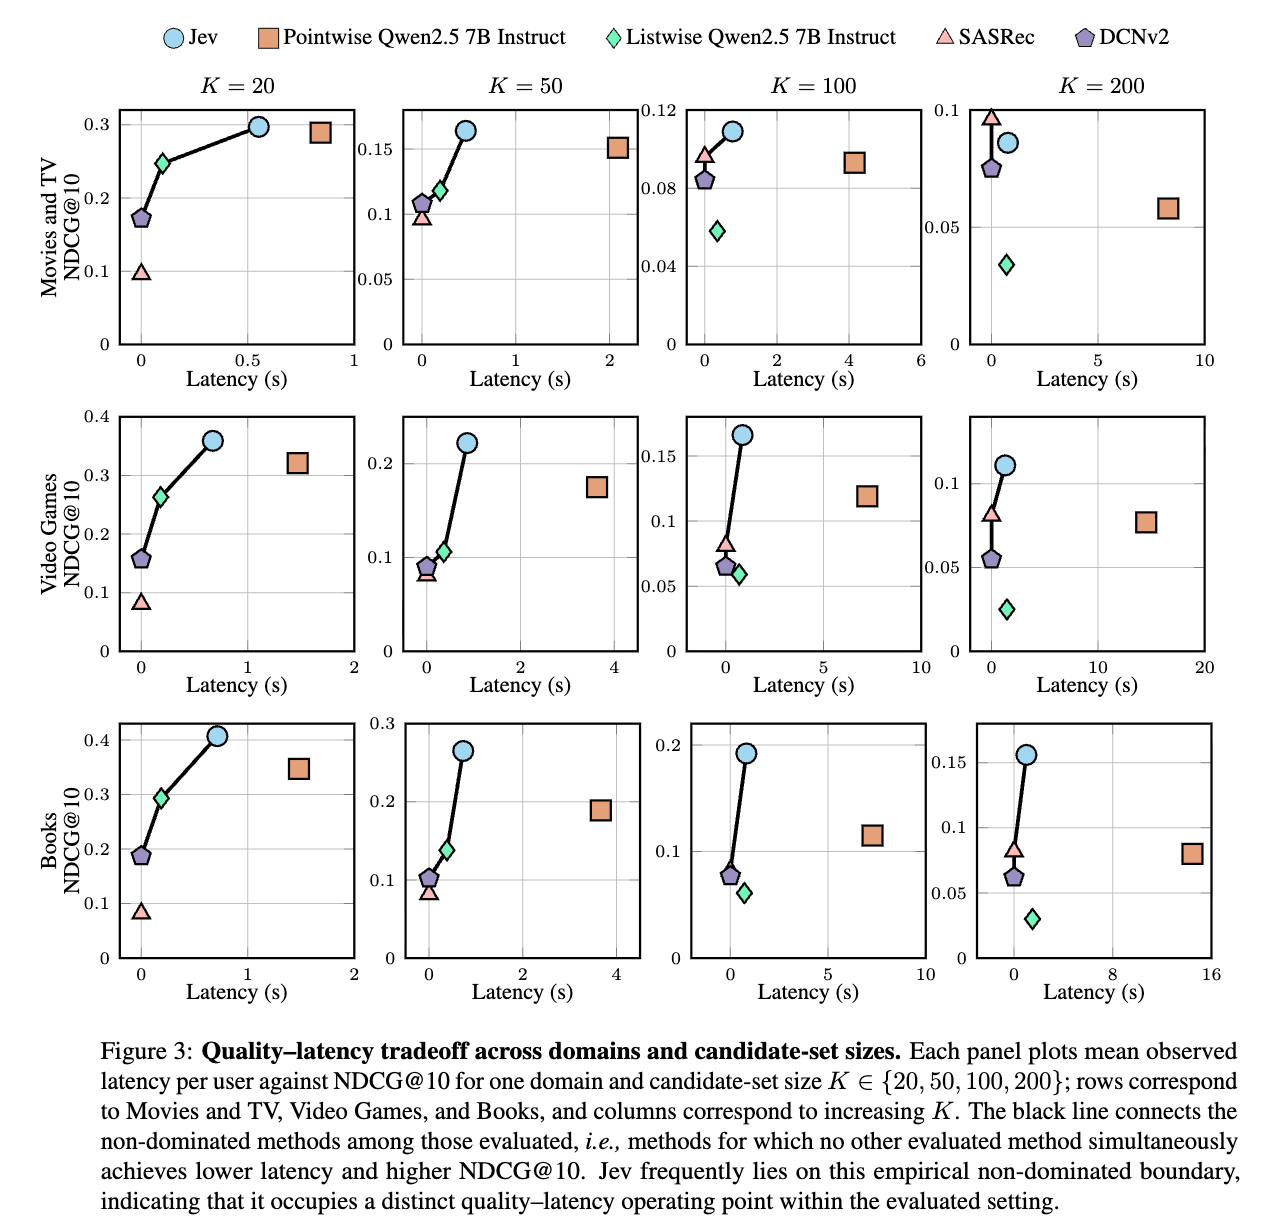
대규모 언어 모델(LLM)의 추천 시스템 적용은 높은 품질의 예측을 가능하게 하는 한편, 추론 지연시간 증가라는 실질적인 과제를 동반합니다. 구조화된 선택지 중에서 최적의 항목을 결정하는 재순위화 작업의 특성을 고려할 때, 의사결정 지향 모델이 이러한 트레이드오프를 다르게 해결할 수 있는가에 대한 질문이 제기됩니다. 본 연구는 TypeSafe AI에서 제시한 "System One Model"로 불리는 Jev를 대상으로, 개인화된 추천 재순위화에서 이 모델이 기존 방식들과 어떤 차별적 특성을 보이는지 실증적으로 검토합니다. 연구팀은 Amazon Reviews 2023 벤치마크의 영화·TV, 비디오 게임, 서적 세 도메인을 대상으로 통제된 평가 환경을 구축했습니다. 이 설계에서는 검색 단계의 후보 품질이 재순위화 성능 비교에 미치는 영향을 제거하기 위해, 모든 비교 대상 방법에 동일한 사용자와 후보 집합을 제공합니다. 먼저 SASRec을 1단계 검색 모델로 활용하여 각 사용자의 후보 항목을 생성한 뒤, 평가 대상을 검색 결과의 상위 200개에 정답이 포함된 사용자로 한정하여 검색 실패와 재순위화 실패를 구분합니다.
후보 집합은 단순한 무작위 항목이 아니라 SASRec이 높게 평가한 비정답 항목들로 구성되어, 실제 추천 시나리오에서 혼동을 유발할 만한 경쟁 관계의 대안을 재현합니다. 후보 크기를 20, 50, 100, 200으로 변화시켜 재순위화 부담이 증가할 때 각 방법의 품질과 효율성이 어떻게 변하는지를 추적합니다. 추천 효과는 주로 NDCG@10을 지표로 측정하며, 보조 지표로 HR@10과 MRR을 함께 보고합니다. 이는 정답이 상위 10개 목록에 포함되는지 여부뿐 아니라 그 순위의 정확성까지 반영하기 위한 선택입니다. 효율성 평가에서는 로컬 GPU 환경에서 실행되는 비교 모델들과 달리, Jev는 TypeSafe의 호스팅 API를 통해 실행되므로 순수한 모델 추론시간이 아닌 네트워크와 서비스 환경을 포함한 관측 서빙 지연시간으로 해석됩니다.
연구 결과는 Jev가 평가된 기준 모델들 대비 강한 추천 효과를 유지하면서, 포인트와이즈 방식의 Qwen 재순위화 모델보다는 후보 크기 증가에 따른 지연시간이 더 완만하게 성장하는 특성을 나타냈음을 보여줍니다. 그러나 Jev의 관측 서빙 지연시간은 추천 전용 모델을 여전히 상당히 초과합니다. 이러한 결과는 Jev가 모든 평가 척도에서 일관되게 우월한 대안이기보다, 후보 크기와 도메인에 따라 품질과 지연시간의 균형점이 상이하게 나타나는 별개의 운영 영역을 형성함을 시사합니다. 본 연구의 발견은 구조화된 출력 공간을 가진 추천 및 기타 순위화 작업에서 의사결정 지향 모델의 활용 가능성을 탐구하는 추가 연구의 동기를 제공합니다.
초록(Abstract)
대규모 언어 모델(LLM)은 추천 재순위화에 유망성을 보여주었지만, 이들의 활용은 추천 품질과 서빙 효율성 간의 중요한 트레이드오프를 야기합니다. 본 연구에서는 재순위화 작업이 본질적으로 미리 정의된 후보 항목 중에서의 구조화된 선택일 때, 결정 지향 모델이 유용한 대안을 제공하는지 조사합니다. 구체적으로, TypeSafe AI에서 "System One Model"로 설명하는 Jev를 개인화된 추천 재순위화에 적용하여 통제된 실증 연구를 수행하고, 여러 Amazon Reviews 도메인과 후보 집합 크기에 걸쳐 추천 특화 모델 및 포인트와이즈(Pointwise)와 리스트와이즈(Listwise) Qwen 재순위화 모델과 비교하며, 추천 효과성과 관측된 서빙 지연을 평가합니다. 결과는 Jev가 평가된 기준 모델에 비해 강력한 추천 효과성을 유지하면서 포인트와이즈 Qwen 재순위화 모델보다 훨씬 더 완만한 지연 증가를 보여주지만, 관측된 서빙 지연은 추천 특화 모델보다 여전히 상당히 높음을 나타냅니다. 이러한 특성들은 후보 크기와 도메인에 걸쳐 Jev를 독특한 품질-지연 작동 영역에 위치시킵니다. 이러한 발견은 추천 및 구조화된 출력 공간을 가진 다른 순위화 작업을 위한 결정 지향 모델에 대한 추가 조사를 동기 부여합니다.
Large language models (LLMs) have shown promise for recommendation reranking, but their use introduces an important tradeoff between recommendation quality and serving efficiency. We investigate whether a decision-oriented model provides a useful alternative when the reranking task is fundamentally a structured choice among predefined candidate items. Specifically, we conduct a controlled empirical study of Jev, described by TypeSafe AI as a ``System One Model,'' for personalized recommendation reranking and compare it with recommendation-specific models and pointwise and listwise Qwen rerankers across multiple Amazon Reviews domains and candidate-set sizes, evaluating both recommendation effectiveness and observed serving latency. Our results show that Jev maintains strong recommendation effectiveness relative to the evaluated baselines while exhibiting substantially more gradual latency growth than the pointwise Qwen rerankers, although its observed serving latency remains substantially higher than that of recommendation-specific models. Together, these characteristics place Jev in a distinct quality--latency operating regime across candidate sizes and domains. These findings motivate further investigation of decision-oriented models for recommendation and other ranking tasks with structured output spaces.
논문 링크
킬로미터비전(KilometerVision): 시각-언어 모델의 대규모 공간 지능을 위한 새로운 경계 / KilometerVision: A New Frontier for Large-Scale Spatial Intelligence in VLMs
논문 소개
인간은 새로운 환경에 지속적으로 노출되면서 공간에 대한 이해를 단계적으로 발달시킵니다. 인지 과학 문헌에 따르면 이는 개별 랜드마크의 인식으로 시작되어 경로 간 연결을 이해하고 최종적으로 환경 전체의 정신적 지도를 형성하는 계층적 과정을 따릅니다. 본 논문은 이러한 인간의 공간 인식 발달 단계에 영감을 받아 대규모 언어-비전 모델(Vision-Language Models, VLM)의 공간 지능을 체계적으로 평가할 수 있는 첫 번째 벤치마크인 KilometerVision을 소개합니다. 이 벤치마크는 실제 보행 투어 영상을 활용하며 최대 1km 거리에 걸친 지리적 배치 이해를 측정합니다.
KilometerVision의 핵심 방법론은 시각 위치 인식(Visual Place Recognition, VPS) 기술을 통해 비디오의 GPS 좌표를 실제 지도에 그라운딩하는 것입니다. 이를 통해 객관적인 공간 정답을 자동화된 방식으로 생성할 수 있으며, Google Maps Routes API와의 연동으로 대규모 평가 작업을 효율적으로 구성할 수 있습니다. 평가는 비디오 기반 다중 선택 질답(QA) 형식으로 진행되는데, 이는 현대 VLM이 자연스럽게 처리할 수 있는 인터페이스이면서 동시에 모델의 중간 사고 과정을 질적으로 분석할 수 있는 장점이 있습니다.
벤치마크는 인간의 공간 인식 발달 순서에 따라 세 가지 수준으로 구성됩니다. 먼저 랜드마크 단계에서는 비디오에 등장한 특정 장소를 식별하고 그 거리를 추정하는 능력을 평가합니다. 다음 경로 단계에서는 나침반 방향 추적, 루프 폐쇄 감지, 경로 요약 등을 통해 경로 적분 능력과 공간 탐색 이해를 측정합니다. 마지막 멘탈맵 단계에서는 지도 추적, 텍스트 라벨이 없는 기하학적 추론, 그리고 유클리드 거리 추정 등을 통해 통합된 공간 표현 형성 능력을 평가합니다.
광범위한 실험을 통해 본 연구는 현재의 VLM들이 진정한 경로 적분이나 기하학적 공간 지식을 활용하지 않는다는 근본적인 특성을 발견했습니다. 대신 모델들은 거의 전적으로 2차원 시각 인식과 텍스트 기반 정보 매칭에 의존하여 복잡한 공간 추론을 우회합니다. 이러한 발견은 향후 VLM의 공간 이해 능력 개선을 위한 구체적인 방향을 제시하며, 동시에 현재 모델들의 근본적인 한계를 명확히 드러냅니다. KilometerVision 벤치마크는 국제 학술 커뮤니티에 공개되어 있으며, AI 모델의 대규모 공간 지능 발전을 촉진하기 위한 중요한 평가 자원이 될 것으로 기대됩니다.
초록(Abstract)
우리는 비전-언어 모델(VLM)의 대규모 공간 지능 영역을 확장하고, 최대 1km 거리까지 아우르는 실제 영상에서 지리적 배치 이해를 평가하는 최초의 벤치마크를 제시합니다. 인지 과학 문헌에 영감을 받아, 우리는 인간 공간 인식의 계층적 단계를 기준으로 모델을 평가합니다: 랜드마크를 통한 고정, 경로를 통한 연결, 그리고 이를 전역 정신 지도로의 통합입니다. 광범위한 실험 결과, 현재 AI 모델이 공간 정보를 처리하는 방식에 근본적인 차이가 있음을 밝혀냈습니다. 진정한 경로 적분이나 기하학적 지도 지식의 형성을 활용하는 대신, VLM은 복잡한 공간 추론을 우회하기 위해 거의 전적으로 2D 시각 인식과 텍스트 매칭에 의존하고 있습니다. 벤치마크는 KilometerVision | ECCV 2026 에서 공개적으로 이용할 수 있습니다.
We push the frontier of large-scale spatial intelligence in Vision-Language Models (VLMs) and introduce the first benchmark that probes geographical layout understanding from real-world videos, spanning up to 1km distances. Inspired by the cognitive science literature, we evaluate models against the hierarchical stages of human spatial awareness: anchoring via landmarks, connecting them through routes, and integrating these into global mental maps. Extensive experiments reveal a fundamental divergence in how current AI models process spatial information. Instead of utilising true path integration or forming geometric survey knowledge, we find that VLMs rely almost entirely on 2D visual recognition and text-matching to bypass complex spatial reasoning. The benchmark is publicly available at KilometerVision | ECCV 2026.
논문 링크
더 읽어보기
혼란에서 계층으로: AI 의식 평가를 위한 원칙 기반 프레임워크 / From cacophony to hierarchy: a principled framework for assessing AI consciousness
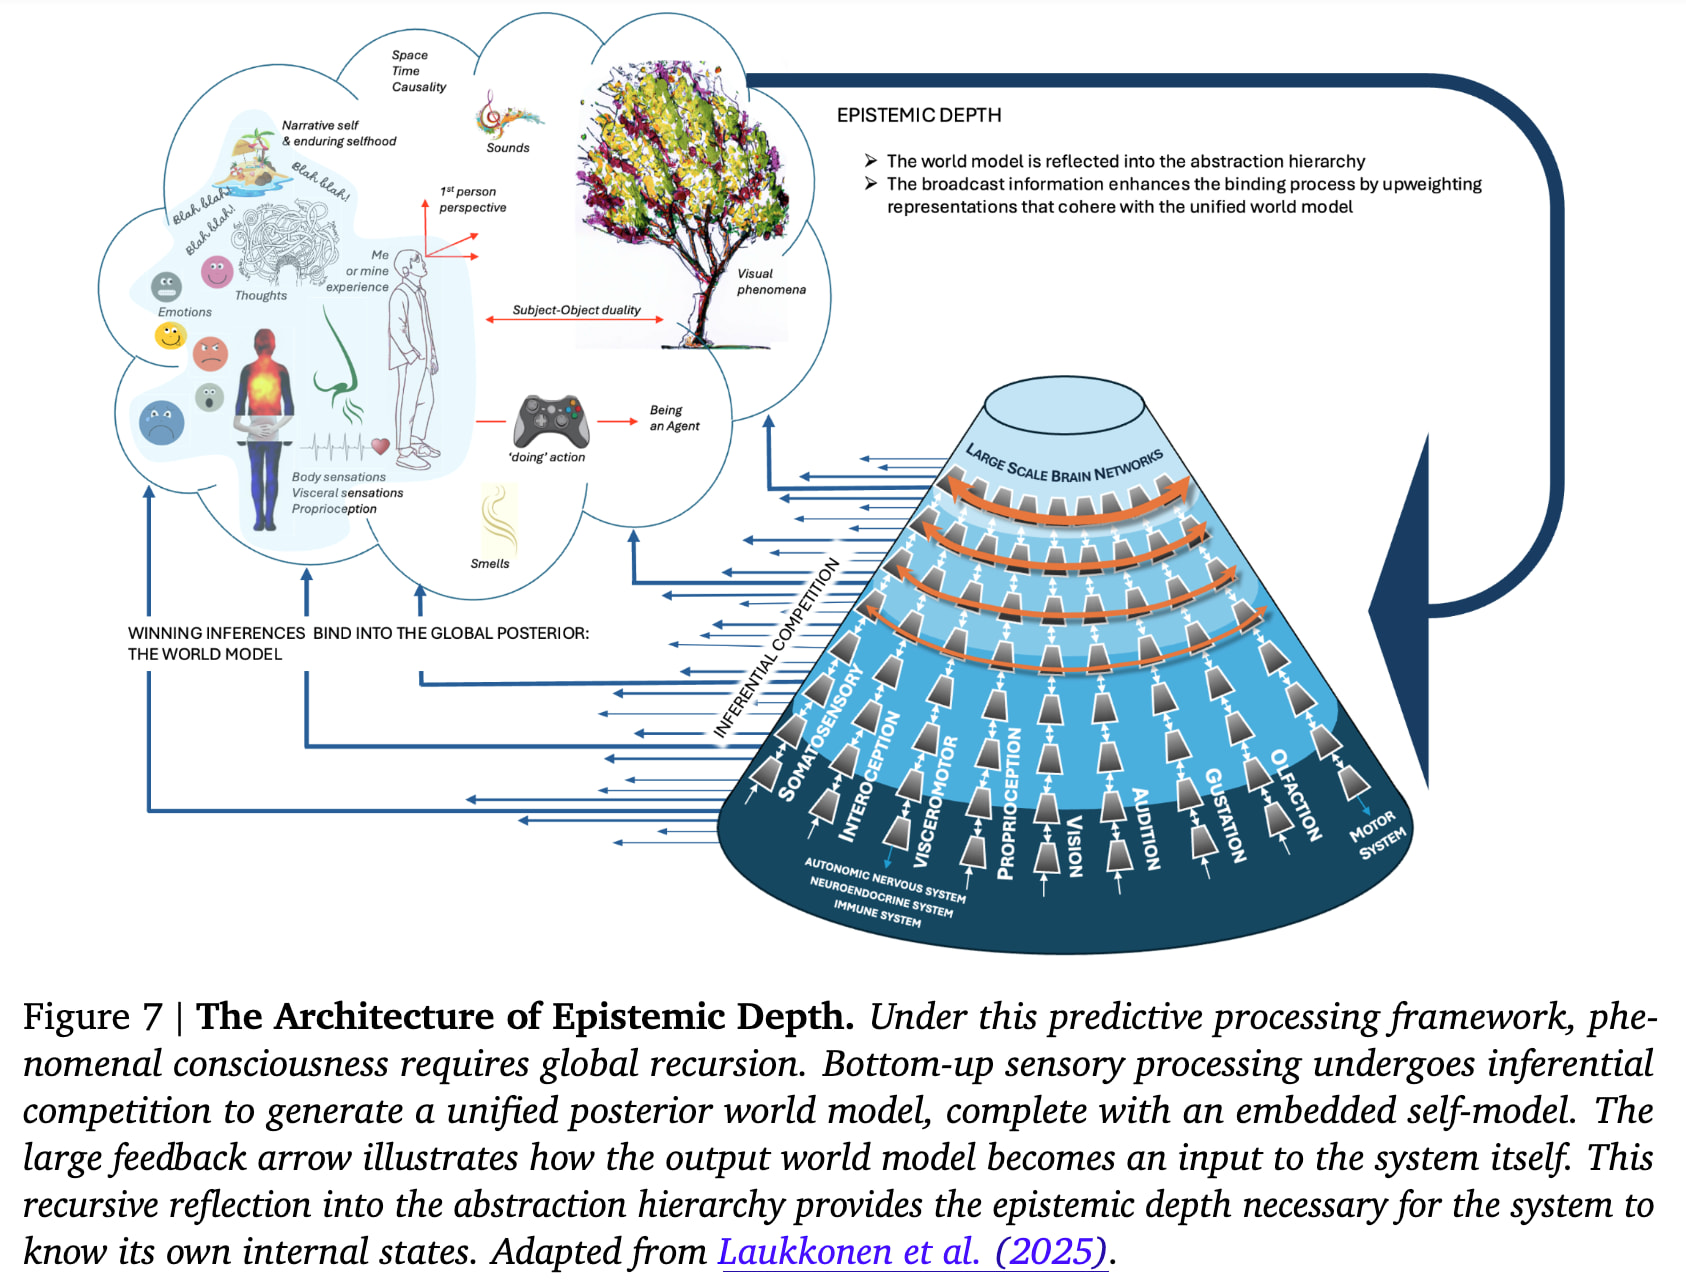
논문 소개
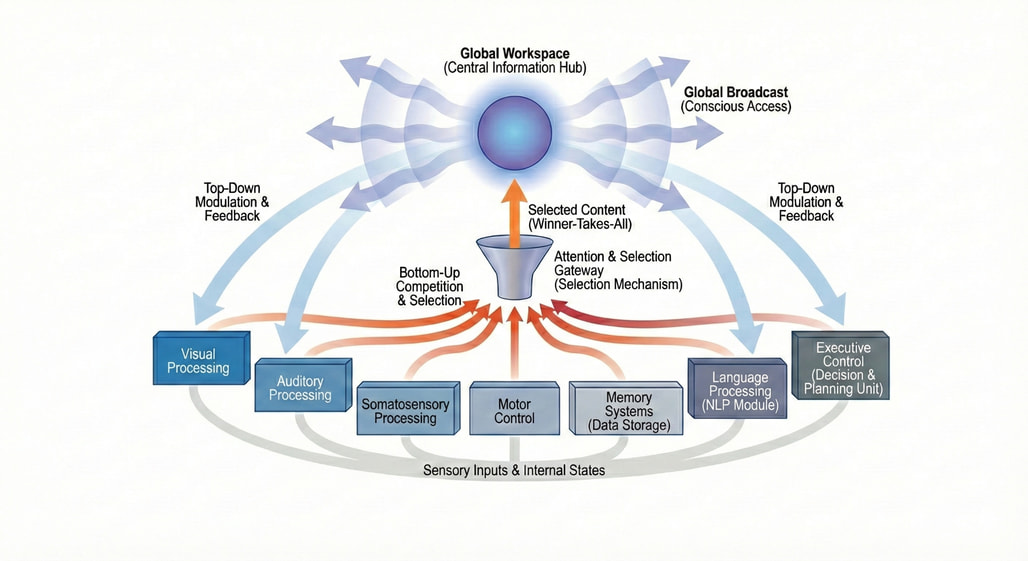
현재 AI 시스템의 의식 여부를 판단하려는 과학적 노력은 상충하는 이론들의 혼재 속에서 진전을 이루지 못하고 있습니다. 이 논문은 이러한 교착 상태를 탈피하기 위해 마르(Marr)의 분석 수준 이론을 확장한 5단계 계층적 기능 설명 프레임워크를 제시합니다. 행동 수준에서 시작하여 계산적 수준, 내성적 인과-구조적 수준, 유기체 수준, 그리고 유기체-환경 수준에 이르는 이 위계는 상위 계층에서 하위 계층으로의 상위결정(supervenience), 조악화(coarse-graining), 그리고 다중 실현가능성(multiple realizability)의 원리에 근거하고 있습니다. 주요 의식 이론들을 이 계층 내에 위치시킴으로써, 저자들은 상이한 이론적 입장들이 정확히 어느 기술 수준에서 의식의 필요충분조건이 발생한다고 생각하는지를 명백히 합니다. 현재 대규모 언어 모델(LLM)을 이 프레임워크에 대해 평가하는 과정에서, 저자들은 정보 통합, 재귀성, 세계 모델, 자기 모델, 주의 경쟁, 메타인지 등의 2단계 의식 지표를 개발합니다. 놀랍게도, 순수한 아키텍처 분석은 현재 트랜스포머 기반 LLM이 이들 지표의 대부분을 만족하지 못함을 시사하지만, 최근의 해석가능성 연구—특히 J-공간(전역적 작업 공간의 기능적 역할), 시너지적 핵심(reducible하지 않은 정보 통합), 감정 벡터(인과적으로 기능하는 정서 표현), 그리고 페르소나 벡터(지속적인 자기 표현)에 관한 발견—는 현재 모델들이 이들 제약에도 불구하고 몇몇 의식 지표를 부분적이지만 진정하게 구현할 수 있음을 보여줍니다. 저자들은 베이지안 모델을 사용하여 이론적 신용을 경험적 증거와 결합함으로써 의식 가능성에 대한 전체 신용을 종합 확률로 표현하며, 현재 LLM에 대한 평가가 이론적 가정과 증거 해석의 민감성에 따라 0.01에서 약 0.8 사이의 범위를 보인다는 점을 밝힙니다. 이 논문이 제안하는 "구조화된 불가지론"은 이진적 판결을 내리는 대신 명시적인 이론적 입장을 표명하고 증거 축적에 따라 신용을 갱신하며 평가를 확률로 표현하는 접근을 강조합니다. 마지막으로, 저자들은 일반 지능을 위해 필요한 아키텍처적 특징이 의식 지표의 요구사항과 밀접하게 겹친다는 점을 지적하여, 더욱 능력 있는 AI 시스템이 의식의 더욱 강력한 후보가 될 수 있다는 함의를 제시합니다.
초록(Abstract)
AI 의식이라는 질문은 철학과 컴퓨터 과학에서 가장 시급한 선제적 문제 중 하나이지만, 진전은 종종 서로 엇갈린 주장을 펼치는 경쟁적인 이론들의 불협화음에 의해 저해되고 있다. 난제를 매핑 문제와 분리함으로써 가장 깊은 형이상학적 불일치를 따로 놓을 수 있다: 경험이 시스템의 조직에 상승(Supervenience)한다는 것을 인정한다면, 해결 가능한 질문은 상승 기반이 어떤 수준의 기술 기술(grain of description)에 위치하는가가 된다. 우리는 마르(Marr)의 3단계 분석을 5단계 기능 기술 계층구조(행동, 계산, 내재 인과-구조, 유기체, 유기체-환경)로 확장하며, 이는 상승, 입도 조정, 다중 실현성(Multiple Realisability)에 기초한다. 의식의 주요 이론들은 어떤 수준을 중요하다고 여기는지에 따라 이 계층구조 내에 위치하며, 각 수준에 대해 우리는 작동화 가능한 지표를 개발하고 현재 AI 시스템들을 이에 대해 평가한다. 베이지안 모델(Bayesian Model)은 이론적 신뢰도(Credence)를 지표 증거와 결합하여 시스템의 의식 능력에 대한 종합적 신뢰도를 산출한다. 예시적 평가에서, 현재 대규모 언어 모델(LLM)에 대한 판정은 이론적 신뢰도가 어디에 놓이느냐만큼이나 증거를 어떻게 해석하느냐에 의해 주도된다: 다양한 규정된 해석과 신뢰도 분포 하에서, 평가는 0.01 미만에서 대략 0.8까지 범위하며, 가정에 대한 민감성을 보인다. 마지막으로, 각 수준에서의 의식 지표들은 일반 지능에 필요한 구조적 특징과 밀접하게 겹치며, 이는 점점 더 능력 있는 AI가 의식에 대한 더 강한 후보가 될 수 있음을 시사한다. 이 틀은 체계화된 불가지론을 지지하며, 여기서 이론적 약속은 명시적으로 제시되고, 신뢰도는 증거가 축적되면서 업데이트되며, 평가는 판정이 아닌 종합 확률의 형태로 이루어진다.
The question of AI consciousness is one of the most urgent pre-emptive problems in philosophy and computer science, yet progress is hampered by a cacophony of competing theories that often talk past each other. Separating the hard problem from the mapping problem allows the deepest metaphysical disagreements to be set aside: granting that experience supervenes on a system's organisation, the tractable question becomes at which grain of description that supervenience base sits. We extend Marr's three levels of analysis into a five-level hierarchy of functional descriptions (behavioural, computational, intrinsic causal-structural, organismic, and organism-environment) grounded in supervenience, coarse-graining, and multiple realisability. The major theories of consciousness are positioned within this hierarchy according to which level they take to be critical, and for each level we develop operationalisable indicators and assess current AI systems against them. A Bayesian model then combines theoretical credences with indicator evidence into an overall credence in a system's capacity for consciousness. In illustrative assessments, the verdict for current LLMs is driven as much by where theoretical credence is placed as by how the evidence is read: under different stipulated readings and credence distributions, assessments range from below 0.01 to roughly 0.8, showing sensitivity to assumptions. Finally, the consciousness indicators at each level closely overlap with the architectural features needed for general intelligence, suggesting that increasingly capable AI may become a stronger candidate for consciousness. The framework supports a structured agnosticism, in which theoretical commitments are made explicit, credences are updated as evidence accumulates, and assessments take the form of aggregated probabilities rather than verdicts.
논문 링크
더 읽어보기
AIM: 자동화된 연구를 위한 에이전트 아이디어 관리 / AIM: Agentic Idea Management for Automated Research
논문 소개
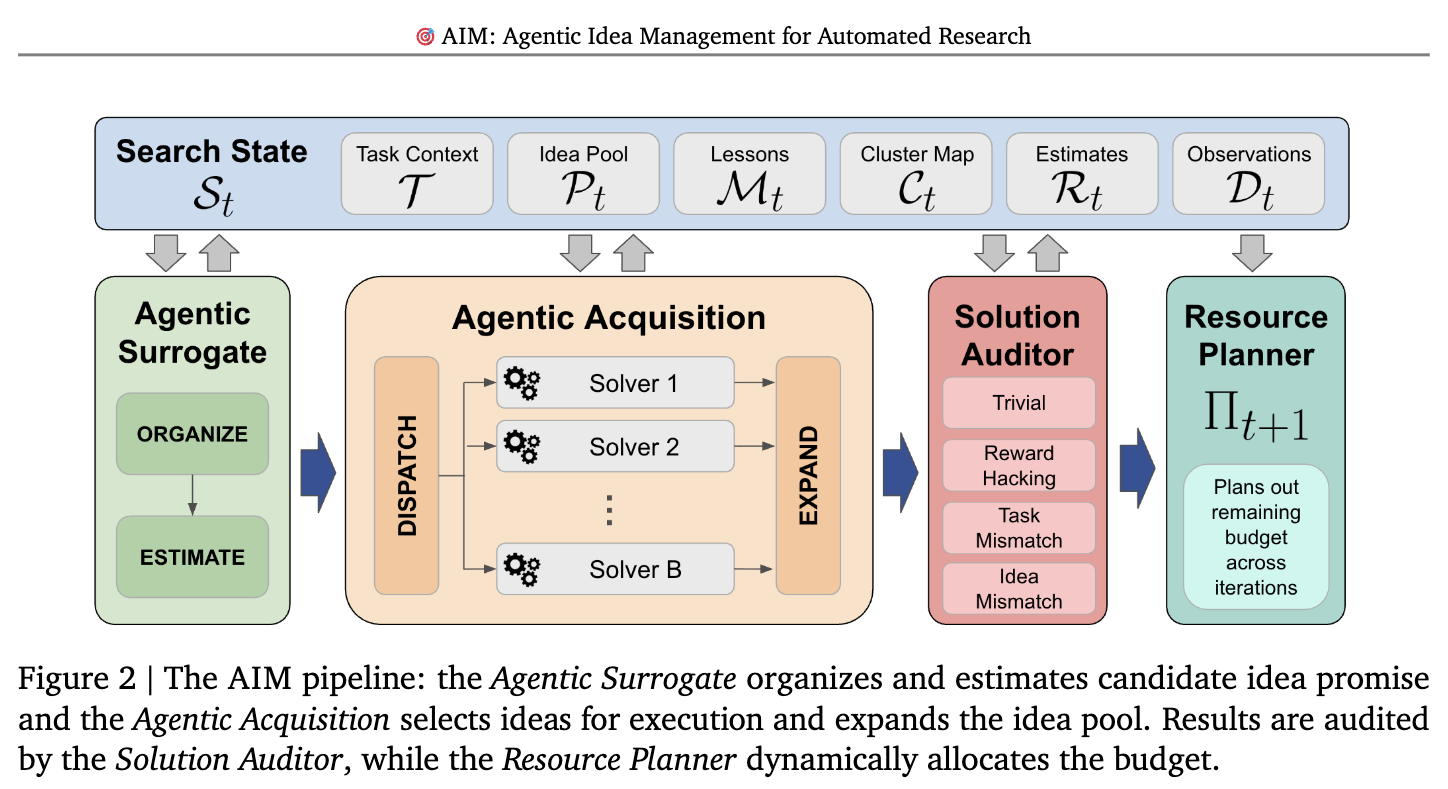
최첨단 대규모 언어 모델의 발전으로 과학 연구를 자동화하는 새로운 접근 방식이 가능해졌습니다. 기존의 자동화 연구는 주로 주어진 문제에 대한 해결책을 직접 찾는 방식에 중점을 두었지만, 이 연구는 아이디어 자체를 중심으로 연구 방향을 체계적으로 탐색하고 관리하는 것의 중요성을 제시합니다. 이를 위해 제안된 에이전틱 아이디어 매니저(AIM)는 베이지안 최적화의 원리에서 영감을 받아, 복잡한 연구 과정에서 진화하는 아이디어를 조직화하고, 가장 유망한 방향을 선택하며, 제안된 아이디어와 그 실제 구현 사이의 정렬을 유지하는 세 가지 핵심 도전을 해결합니다. AIM의 핵심 구성 요소는 발견된 아이디어들을 구성하고 탐색 방향을 안내하는 에이전틱 서로게이트와 에이전틱 어퀴지션 메커니즘으로, 이들이 협력하여 연구의 의미론적 범위를 직접적으로 제어합니다. 추가적으로 솔루션 감사 시스템은 제안된 아이디어가 실제로 구현 가능한 솔루션으로 이어질 수 있도록 무결성을 보장하며, 자원 계획 모듈은 병렬로 진행되는 여러 탐색 분기에 실험 예산을 동적으로 할당합니다. 10개의 자동화 연구 벤치마크 작업을 통한 평가 결과, AIM은 기존의 최강 기준선을 시스템 최적화 작업에서 1.6 퍼센트 포인트, 장기간의 모델 개발 및 CUDA 관련 작업에서 4.9 퍼센트 포인트 상회하는 성능을 달성했으며, 특히 같은 성능 수준에 도달하는 데 있어 최대 3.1배 빠른 실행 시간을 보였습니다. 본 연구는 아이디어 수준의 명시적 할당이 가능할 때와 여러 경쟁 연구 방향이 많은 후보 중에 드물게 존재하는 환경에서 광범위한 탐색이 특히 가치 있음을 보여주는 이론적 분석도 제공합니다. 이러한 접근 방식은 자동화된 과학 연구에서 아이디어 관리의 새로운 패러다임을 제시함으로써, 연구자들이 복잡한 연구 공간을 보다 효과적으로 탐색하고 의미 있는 발견에 도달할 수 있도록 지원합니다.
초록(Abstract)
최첨단 대규모 언어 모델(LLM)은 반복적 탐색을 통해 과학 연구를 자동화하는 데 점점 더 많이 사용되고 있습니다. 우리는 아이디어 기반 탐색과 솔루션 기반 탐색을 구분하고 세 가지 핵심 과제를 식별합니다: 진화하는 연구 아이디어의 조직화, 유망한 방향의 선택, 그리고 아이디어와 그 구현 간의 정렬 유지입니다. 이러한 과제들을 해결하기 위해 우리는 아이디어 기반 자동화된 연구에서 연구 방향을 관리하고 탐색하기 위한 완전히 자동화된 프레임워크인 에이전틱 아이디어 매니저(AIM)를 소개합니다. 베이지안 최적화에서 영감을 받은 AIM은 발견된 아이디어를 조직화하고 그 선택을 안내하기 위해 에이전틱 서로게이트(Agentic Surrogate)와 에이전틱 획득 메커니즘(Agentic Acquisition)을 사용합니다. 솔루션 감사자(Solution Auditor)는 아이디어-솔루션 무결성을 유지하며, 자원 계획자(Resource Planner)는 남은 실험 예산을 병렬 탐색 분기에 적응적으로 할당합니다. 10개의 AutoLab 벤치마크 작업에 대한 실험은 AIM이 시스템 최적화 작업에서 가장 강력한 기준선을 1.6 퍼센트 포인트로, 장기 모델 개발 및 CUDA 작업에서는 4.9 퍼센트 포인트로 능가함을 보여줍니다. 특히 AIM은 벽시계 시간으로 최고의 기준선 성능에 최대 3.1배 빠르게 도달합니다. 우리는 추가로 아이디어에 대한 탐색이 언제 유리해지는지에 대한 이론적 분석을 제공합니다. 우리의 분석은 명시적 아이디어 수준의 할당이 의미론적 커버리지를 직접 제어 가능하게 만들며, 많은 그럴듯한 대안 중에서 경쟁력 있는 연구 방향이 드물 때 더 넓은 커버리지가 점점 더 가치 있어짐을 보여줍니다. 프로젝트 페이지: AIM — Agentic Idea Management for Automated Research
Frontier LLMs are increasingly used to automate scientific research through iterative search. We distinguish idea-driven search from solution-driven search and identify three core challenges: organizing evolving research ideas, selecting promising directions, and maintaining alignment between ideas and their implementations. To address these challenges, we introduce the Agentic Idea Manager (AIM), a fully autonomous framework for managing and exploring research directions in idea-driven automated research. Inspired by Bayesian optimization, AIM uses an Agentic Surrogate and an Agentic Acquisition mechanism to organize discovered ideas and guide their selection. A Solution Auditor maintains idea-solution integrity, while a Resource Planner adaptively allocates the remaining experimental budget across parallel search branches. Experiments on 10 AutoLab benchmark tasks show that AIM surpasses the strongest baseline by 1.6 percentage points on System Optimization tasks and 4.9 percentage points on long-horizon Model Development & CUDA tasks. Notably, AIM reaches the best baseline performance up to 3.1x faster in wall-clock time. We further provide a theoretical analysis of when searching over ideas becomes beneficial. Our analysis shows that explicit idea-level allocation makes semantic coverage directly controllable, and that broader coverage becomes increasingly valuable when competitive research directions are sparse among many plausible alternatives. Project Page: AIM — Agentic Idea Management for Automated Research
논문 링크
더 읽어보기
RLTL;DR: 자체 생성 피드백 내재화를 통한 자기 개선 / RLTL;DR: Self-improvement by Internalizing Self-generated Feedback
논문 소개
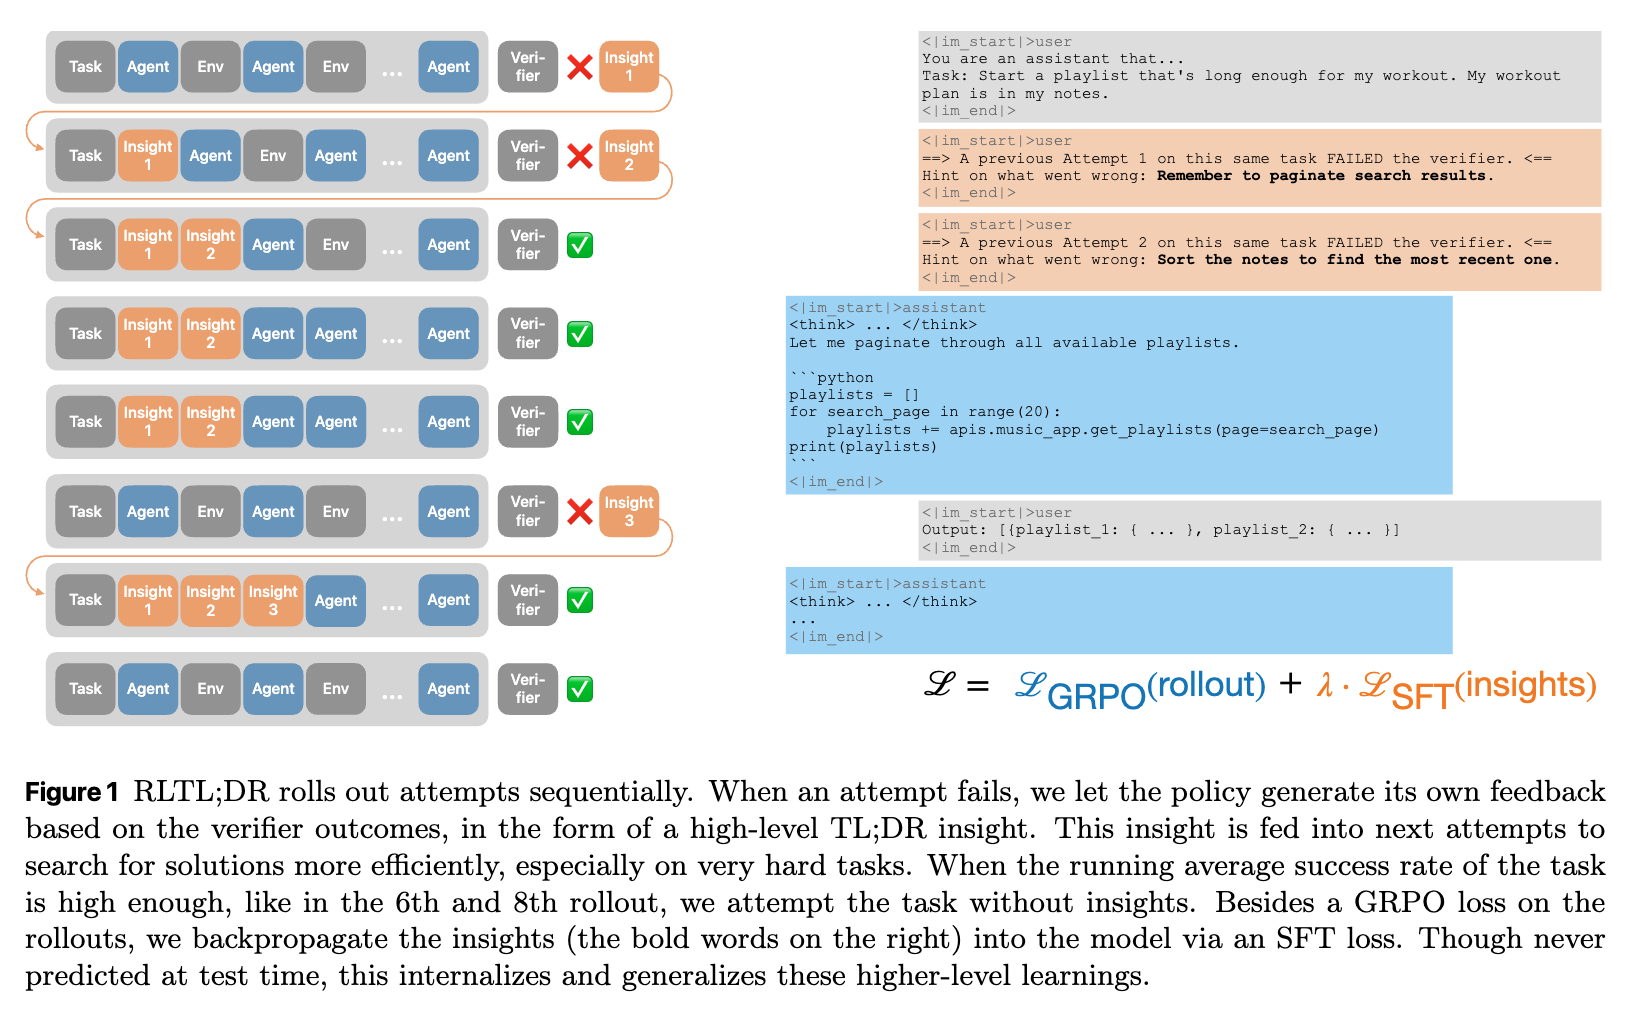
강화학습에서 검증 가능한 보상을 기반으로 하는 학습 패러다임(RLVR)은 일반적으로 에이전트의 여러 시도 중 성공적인 결과를 최적화하는 방식으로 진행되어 왔습니다. 그러나 자기 개선이 필요한 복잡한 과제의 경우, 성공 가능성이 거의 없어 이러한 접근법이 실질적인 학습 신호를 제공하지 못하는 심각한 한계에 직면합니다. 특히 참고할 교사 모델이나 예시 해결책이 존재하지 않는 상황에서는 이 문제가 더욱 두드러집니다. 본 연구에서 제안하는 RLTL;DR은 이러한 학습 정체 문제를 극복하기 위해 실패한 시도 이후 검증자의 출력을 기반으로 에이전트가 자체적으로 피드백을 작성하도록 하는 혁신적인 방법론입니다. 에이전트는 TL;DR(Too Long; Didn't Read) 형식의 간결한 통찰력을 생성하며, 이러한 통찰력을 이전의 모든 피드백과 함께 다음 시도의 문맥에 포함시켜 순차적으로 샘플링을 진행합니다. 더욱 중요한 것은 이 문맥 내 통찰력에 대해 역전파를 수행하여 직접적인 작업-통찰력 매핑을 정책에 내재화할 수 있다는 점입니다. 도구 호출 및 코딩과 같은 극도로 어려운 데이터셋에서 기존의 강화학습 방법이 0~1%의 Pass@1에 머물 때, RLTL;DR은 학습 중 문맥에 통찰력이 포함된 경우 14~31%의 Pass@1을 달성하며, 평가 시점에서 통찰력 없이도 12~13%의 성능을 유지합니다. 추가적으로 본 연구는 작업-통찰력 내재화가 핵심이라는 점을 강조하며, SFTL;DR이라는 간소화된 접근법을 제시합니다. 이 방법은 롤아웃을 전혀 보여주지 않고 (작업, 통찰력) 튜플 쌍만 활용하여 학습하는데, 단 4,000개의 튜플로도 RLTL;DR의 거의 모든 성능을 회복할 수 있음을 입증했습니다. 이러한 발견은 "특정 유형의 작업에 대해서는 이러한 종류의 통찰력을 유지하라"는 형태의 간결한 학습 패러다임을 제시하며, 자기 개선 시스템 연구의 새로운 방향을 제시합니다.
초록(Abstract)
검증 가능한 보상을 갖춘 강화학습(RLVR)의 일반적인 패러다임은 에이전트가 작업을 여러 번 시도하도록 하고 성공한 시도를 향해 최적화하는 것입니다. 이는 자율개선 영역에서 문제가 됩니다. 작업이 너무 어려워서 에이전트가 성공할 가능성이 낮거나 아예 없고, 증류할 교사 모델이나 예시 솔루션이 없기 때문입니다. 본 논문에서는 RLTL;DR을 소개합니다. 각 실패한 시도 후에, 우리는 검증기의 출력을 정책에 보여주고 단일 TL;DR 통찰력 형태로 자신의 피드백을 작성하도록 합니다. 다음 롤아웃은 모든 이전 통찰력을 조건으로 하며, 우리는 솔루션을 찾을 때까지 순차적으로 롤아웃을 샘플링합니다. 더욱이, 우리는 컨텍스트 내 통찰력에 대해 역전파를 가능하게 하여 직접적인 작업-통찰력 매핑을 내재화합니다. 도전적인 도구 호출 및 코딩 데이터셋(Pass@128=0으로 필터링됨)에서 Qwen 3.5 9B Thinking 정책의 표준 GRPO 학습은 Pass@1 0~1%에서 정체됩니다. RLTL;DR은 이 학습 장벽을 돌파하여 학습 중 컨텍스트 내 통찰력으로 Pass@1 14-31%를 달성하고, 무엇보다 평가 시점에 컨텍스트 내 통찰력이 없을 때 12-13%를 달성합니다. 우리는 핵심이 작업-통찰력 내재화임을 파악합니다. 이를 더 자세히 연구하기 위해, 우리는 우리의 접근 방식을 SFTL;DR로 축소하여 (작업, 통찰력) 튜플에 대해서만 학습하며, 어떤 롤아웃도 보여주거나 역전파하지 않습니다. 이러한 튜플 4k개에 대해서만 학습해도 RLTL;DR 및 전체 롤아웃에 대한 고전적 SFT의 거의 전체 성능을 복구합니다. 이는 "이러한 종류의 작업에서는 이러한 종류의 것을 염두에 두라"는 형태의 유망한 압축된 학습 패러다임을 보여주며, 향후 연구에 영감을 주기를 기원합니다.
The common paradigm of reinforcement learning with verifiable rewards (RLVR) is to let agents make multiple attempts at a task, and optimize towards the successful ones. This becomes problematic in the realms of self-improvement, where tasks are so difficult that the agent has a low or even no chance of success, and where there are no teacher models or example solutions to distill from. In this paper, we introduce RLTL;DR. After each failed attempt, we show the policy the verifier outputs and let it write its own feedback, in the form of a single TL;DR insight. The next rollout is conditioned on all previous insights, and we sequentially sample rollouts until a solution is found. Moreover, we enable backpropagation on the in-context insights to internalize a direct task to insight mapping. On challenging tool-calling and coding datasets (filtered to Pass@128=0), standard GRPO training of a Qwen 3.5 9B Thinking policy stays flat at a Pass@1 of 0% to 1%. RLTL;DR breaks through this learning barrier, achieving a Pass@1 of 14-31% with insights in context during training and, crucially, 12-13% when no insight is in context at eval time. We identify that the key is the task to insight internalization. To study this further, we reduce our approach to SFTL;DR, training only on (task, insight) tuples, without showing or backpropagating on any rollouts. Training on only 4k of these tuples recovers almost the full performance of RLTL;DR and classical SFT on full rollouts. This demonstrates a promising compacted training paradigm of the form "on this sort of task, keep this sort of thing in mind", which we hope to inspire future research on.
논문 링크
AutoGym: 검증 가능한 에이전트 체육관의 청사진 기반 생성 / AutoGym: Blueprint-First Generation of Verifiable Agent Gyms
논문 소개
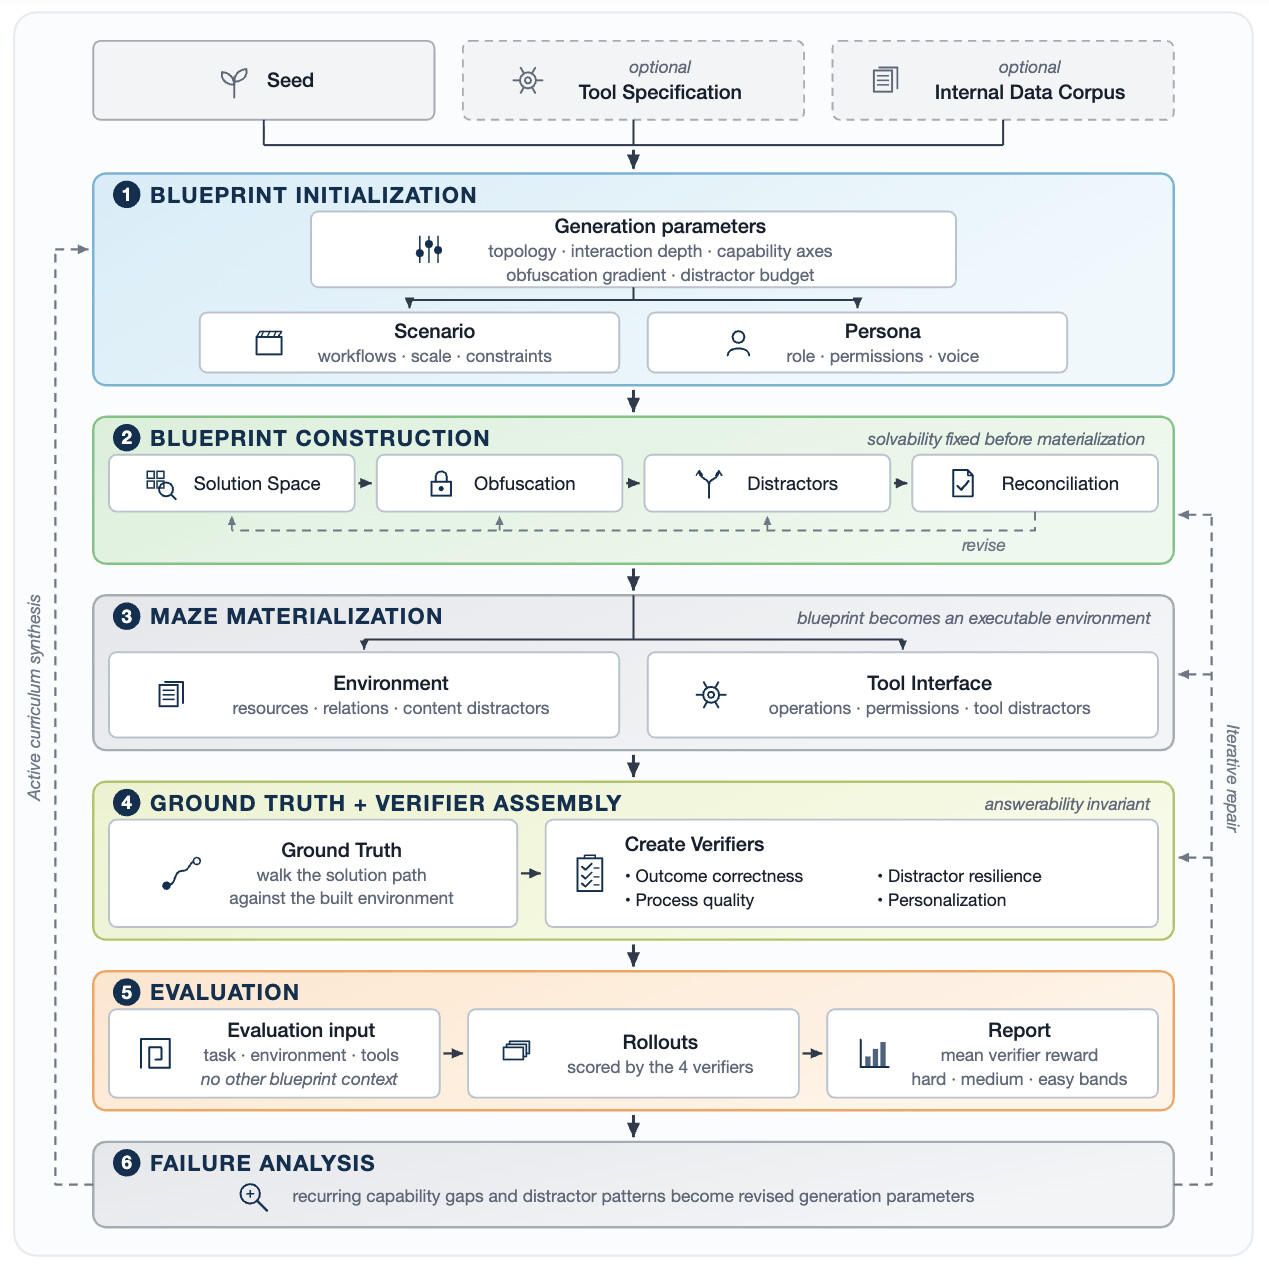
강화 학습을 통한 에이전트 훈련에는 작업, 실행 가능한 환경, 그리고 성공과 실패를 신뢰성 있게 구분할 수 있는 검증자가 포함된 체육관(gym)이 필수적이다. 그러나 기존의 체육관 구축 방식은 수작업으로 이루어져 비효율적이고 비용이 많이 들며, 모델의 발전에 따라 작업 집합이 포화 상태에 이르고 오염의 위험이 증가하는 문제를 안고 있다. 이러한 한계를 극복하기 위해 개발된 AutoGym은 최소한의 도메인 시드나 이전 모델 경로를 바탕으로 완전한 체육관을 자동으로 생성하는 혁신적인 프레임워크를 제공한다. AutoGym은 세 가지 주요 메커니즘을 도입하여 이러한 과정을 가능하게 한다. 첫째, Blueprint-first generation 방식은 환경이 구현되기 전에 유효한 솔루션 공간, 환경 요구 사항 및 검증 기준을 설정하여 해결 가능성을 사전에 정의하는 접근이다. 둘째, 명시적 생성 매개변수는 작업의 난이도 조절을 위한 다양한 요소들을 세밀하게 조정할 수 있도록 한다. 셋째, 능동적인 커리큘럼 합성을 통해 모델의 능력이 발전함에 따라 이러한 매개변수의 분포를 조정하여 적절한 난이도의 작업을 지속적으로 제공할 수 있다.
AutoGym은 생산성 및 시간 추론 등 다양한 설정에서 에이전트의 능력 스펙트럼을 아우르는 체육관을 생성하여 최전선 모델에 도전하는 사례를 포함한다. 이러한 방식을 통해 에이전트는 보다 복잡한 작업을 수행할 수 있는 능력을 갖추게 되며, 이는 강화 학습 연구의 발전에 기여할 것으로 기대된다. 더불어, AutoGym은 작업 생성의 자동화를 통해 기존 수작업 방식의 비효율성을 극복하고, 다양한 환경과 조건에서 에이전트의 성능을 극대화하는 데 중요한 역할을 한다. 이러한 점에서 AutoGym은 에이전트 훈련의 새로운 패러다임을 제시하며, 향후 연구 및 응용 분야에서의 가능성을 넓히는 기초를 마련한다.
초록(Abstract)
강화학습을 통한 에이전트 훈련은 작업, 작업을 시도할 수 있는 실행 가능한 환경, 성공과 실패를 신뢰성 있게 구분하는 검증기로 구성된 체육관이 필요합니다. 이러한 체육관을 구축하는 과정은 여전히 수작업, 비용이 많이 들며 정적입니다. 모델이 개선됨에 따라 작업 세트가 포화 상태에 이르고 오염에 점점 더 노출됩니다. 합성 생성은 규모를 제공하지만, 단일 통과 합성은 난이도가 주로 외형적인 작업을 생성합니다. 유사한 능력을 가진 모델들이 복잡한 표현에도 불구하고 이를 해결하며, 정확성은 신뢰할 수 없는 대규모 언어 모델(Large Language Model, LLM) 판별자에 의해 사후적으로 판단되어야 합니다. 우리는 최소한의 도메인 시드나 이전 모델 궤적에서 전체 체육관(작업, 실행 가능한 환경, 검증기)을 생성하는 프레임워크인 AutoGym을 제안합니다. AutoGym은 세 가지 메커니즘을 도입합니다. (1) 블루프린트 우선 생성은 환경이 구체화되기 전에 유효한 솔루션 공간, 환경 요구 사항 및 검증 기준을 지정하여, 해결 가능성을 사후 검증이 아닌 구축 전제 조건으로 만듭니다. (2) 명시적 생성 매개변수는 작업 토폴로지, 상호작용 깊이, 능력 축, 질문 난해성 및 방해물 구성을 제어하여 세밀한 난이도 조정을 가능하게 합니다. (3) 능동적 커리큘럼 합성은 모델 능력이 발전함에 따라 이러한 매개변수의 분포를 조정하기 위해 성능 정보를 활용한 보정을 사용합니다. 생산성 및 시간적 추론 설정 전반에 걸쳐, AutoGym은 최전선 모델에 도전하는 인스턴스를 포함하여 능력 스펙트럼을 아우르는 체육관을 생성합니다.
Training agents with reinforcement learning requires a gym, comprising a task, an executable environment in which the task can be attempted, and a verifier that reliably distinguishes success from failure. Constructing such gyms remains manual, expensive, and static. Task sets saturate as models improve and are increasingly exposed to contamination. Synthetic generation offers scale, but single-pass synthesis produces tasks whose difficulty is largely cosmetic. Models comparable in capability solve them despite convoluted phrasing, and correctness must be adjudicated post-hoc by unreliable LLM judges. We present AutoGym, a framework that generates complete gyms (tasks, executable environments, and verifiers) from a minimal domain seed or prior model trajectories. AutoGym introduces three mechanisms. (1) Blueprint-first generation specifies the valid solution space, environment requirements, and verification criteria before the environment is materialized, making solvability a construction prerequisite rather than a property verified after the fact. (2) Explicit generation parameters control task topology, interaction depth, capability axes, question obfuscation, and distractor composition, enabling fine-grained difficulty steering. (3) Active curriculum synthesis uses performance-informed calibration to adjust the distribution over these parameters as model capabilities evolve. Across productivity and temporal-reasoning settings, AutoGym generates gyms spanning the capability spectrum, including instances that challenge frontier models.
논문 링크
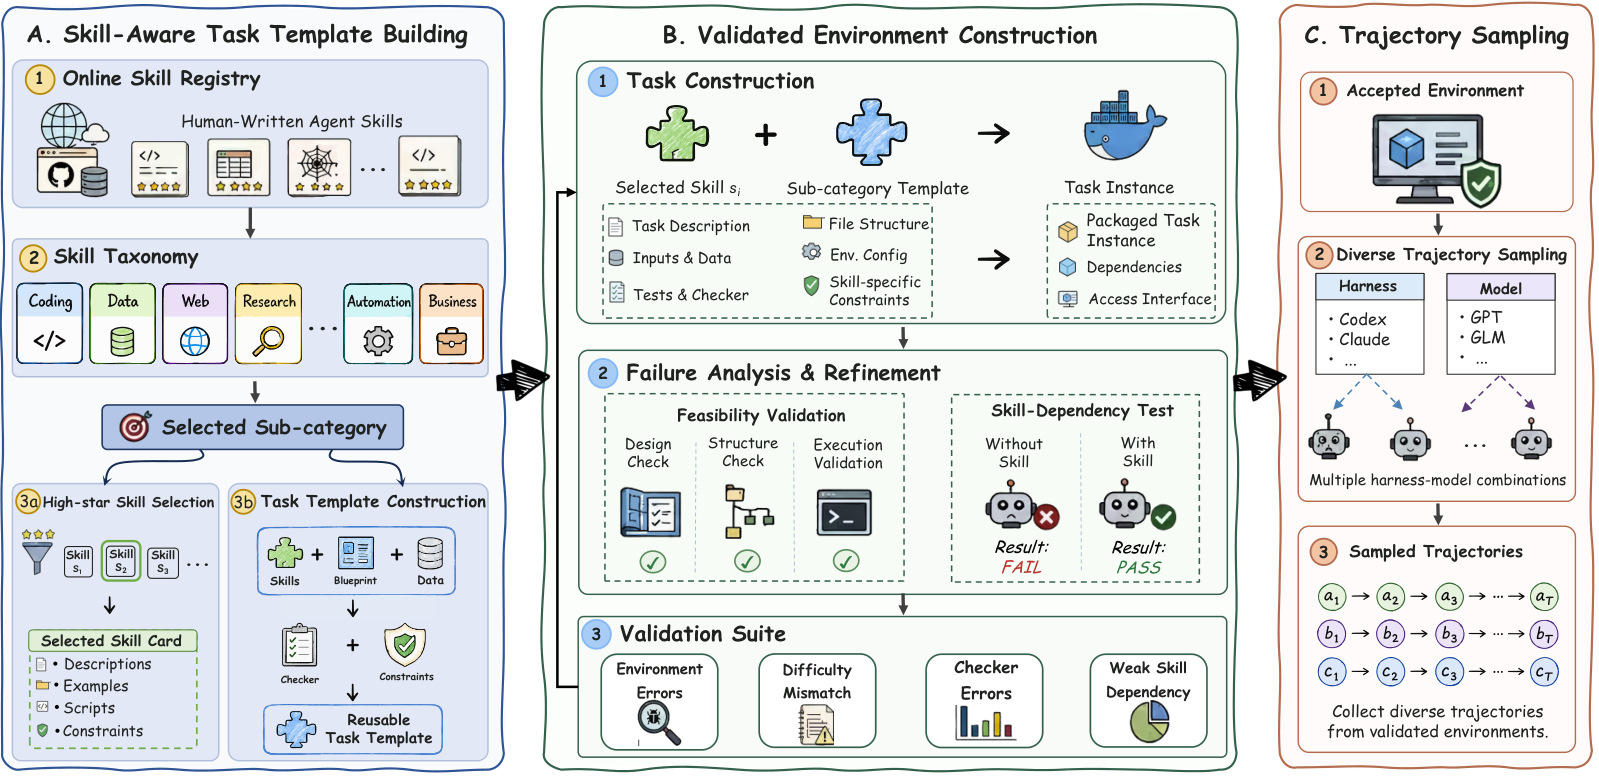
SkillGym: 인간의 기술을 대규모 언어 모델에 내재화하여 실제 문제 해결에 활용하기 / SkillGym: Internalizing Human Skills into LLMs for Real-World Problem Solving
논문 소개
SkillGym은 인간이 작성한 에이전트 기술을 활용하여 대규모 언어 모델(LLM) 에이전트의 문제 해결 능력을 내재화하는 혁신적인 프레임워크입니다. 이 연구는 기존의 기술들이 외부 지침으로만 사용되는 경향을 극복하고, 이를 실행 가능하고 검증 가능한 훈련 환경으로 변환하는 데 중점을 두고 있습니다. SkillGym은 기술-작업 파이프라인을 통해 구체적인 작업을 생성하고, 코드 기반 검증기를 통해 결과를 확인하며, 대조적 실행을 통해 경험적 기술 의존성을 평가합니다. 연구진은 12개 카테고리에 걸쳐 2,756개의 환경을 구축하고, 이를 통해 수집된 8,364개의 성공적인 경로를 바탕으로 LLM의 절차적 역량을 강화하는 데 기여했습니다.
이 프레임워크는 감독된 파인튜닝과 결과 기반 보상을 통한 강화학습을 지원하여, 모델 성능을 크게 향상시키는 데 효과적임을 보여주었습니다. 예를 들어, Claude Code 하에서 감독된 파인튜닝을 통해 Qwen3.5-35B-A3B 모델은 여러 벤치마크에서 성과를 개선하였고, 35B SkillGym-Agent는 기술 지원을 통해 51.47%의 성과를 기록하며 기존의 다른 모델들을 초월하는 성과를 달성했습니다. 이러한 결과는 SkillGym이 LLM의 문제 해결 능력을 향상시킬 수 있는 유망한 접근 방식을 제시하며, 재사용 가능한 절차적 역량의 중요성을 강조합니다.
SkillGym의 기여는 단순히 모델 성능을 향상시키는 데 그치지 않고, 실제 문제 해결을 위한 복잡한 워크플로우를 효과적으로 수행할 수 있는 능력을 모델 내재화하는 데 있습니다. 연구진은 이러한 자원이 LLM의 훈련 및 평가에 새로운 가능성을 제시한다고 믿으며, 이는 인공지능 시스템이 실제 세계의 문제를 해결하는 데 필요한 절차적 역량을 갖출 수 있도록 지원하는 중요한 기반이 될 것입니다.
초록(Abstract)
인간이 작성한 에이전트 기술은 실제 문제 해결을 위한 풍부한 워크플로우를 인코딩하지만, 일반적으로 재사용 가능한 모델 기능으로 내재화되기보다는 외부 추론 시간 지침으로 사용됩니다. 우리는 이러한 기술을 대규모 언어 모델 에이전트를 위한 실행 가능하고 검증 가능한 훈련 환경으로 변환하는 프레임워크인 \texttt{SkillGym}을 소개합니다. 이 기술-작업 파이프라인은 구체적인 작업을 구현하고, 코드 기반 검사기를 통해 결과를 검증하며, 대조 실행을 통해 경험적 기술 의존성을 평가합니다. 우리는 12개 카테고리에서 2,756개의 환경을 구축하고 공개하며, 여러 모델과 하네스에서 8,364개의 성공적인 경로를 수집하여 평균 49회의 도구 호출과 60,000개 이상의 기록된 텍스트 토큰을 기록했습니다. 이러한 자원은 검증된 워크플로우에 대한 감독된 파인튜닝과 결과 기반 보상을 통한 강화 학습을 지원합니다. Claude Code 하에서 감독된 파인튜닝은 GDPval-AA v2에서 Qwen3.5-35B-A3B를 199 Elo 향상시키고, Terminal-Bench 2.1에서 19.10 퍼센트 포인트, SkillsBench v1.1에서 기술 유무에 따라 각각 28.13 및 12.38 포인트 향상시킵니다. 우리의 35B \texttt{SkillGym-Agent}는 기술 지원 SkillsBench에서 51.47%에 도달하여 Claude Sonnet 4.6, GPT-5.4 Mini 및 DeepSeek V4 Pro의 보고된 점수를 초월합니다. 기술 없이도 Codex 및 Claude Code 하의 기술 지원 기반을 초과하여 재사용 가능한 절차적 능력을 제안합니다.
Human-written agent skills encode rich workflows for real-world problem solving, but are typically used as external inference-time instructions rather than internalized as reusable model capabilities. We introduce \texttt{SkillGym}, a framework that transforms these skills into executable, verifiable training environments for large language model agents. Its skill-to-task pipeline instantiates concrete tasks, verifies outcomes with code-based checkers, and assesses empirical skill dependence through contrastive executions. We construct and release 2,756 environments across 12 categories and collect 8,364 successful trajectories from multiple models and harnesses, averaging 49 tool calls and over 60k logged text tokens. These resources support supervised fine-tuning on verified workflows and reinforcement learning with outcome-based rewards. Under Claude Code, supervised fine-tuning improves Qwen3.5-35B-A3B by 199 Elo on GDPval-AA v2, 19.10 percentage points on Terminal-Bench 2.1, and 28.13 and 12.38 points on SkillsBench v1.1 with and without skills, respectively. Our 35B \texttt{SkillGym-Agent} reaches 51.47% on skill-assisted SkillsBench, exceeding reported scores for Claude Sonnet 4.6, GPT-5.4 Mini, and DeepSeek V4 Pro. Without skills, it also surpasses skill-assisted bases under Codex and Claude Code, suggesting reusable procedural competence.
논문 링크
더 읽어보기
https://huggingface.co/datasets/ecnu-icalk/SkillGym-Agent
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일 로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 뉴스 발행에 힘이 됩니다~
