9arm-skills 소개
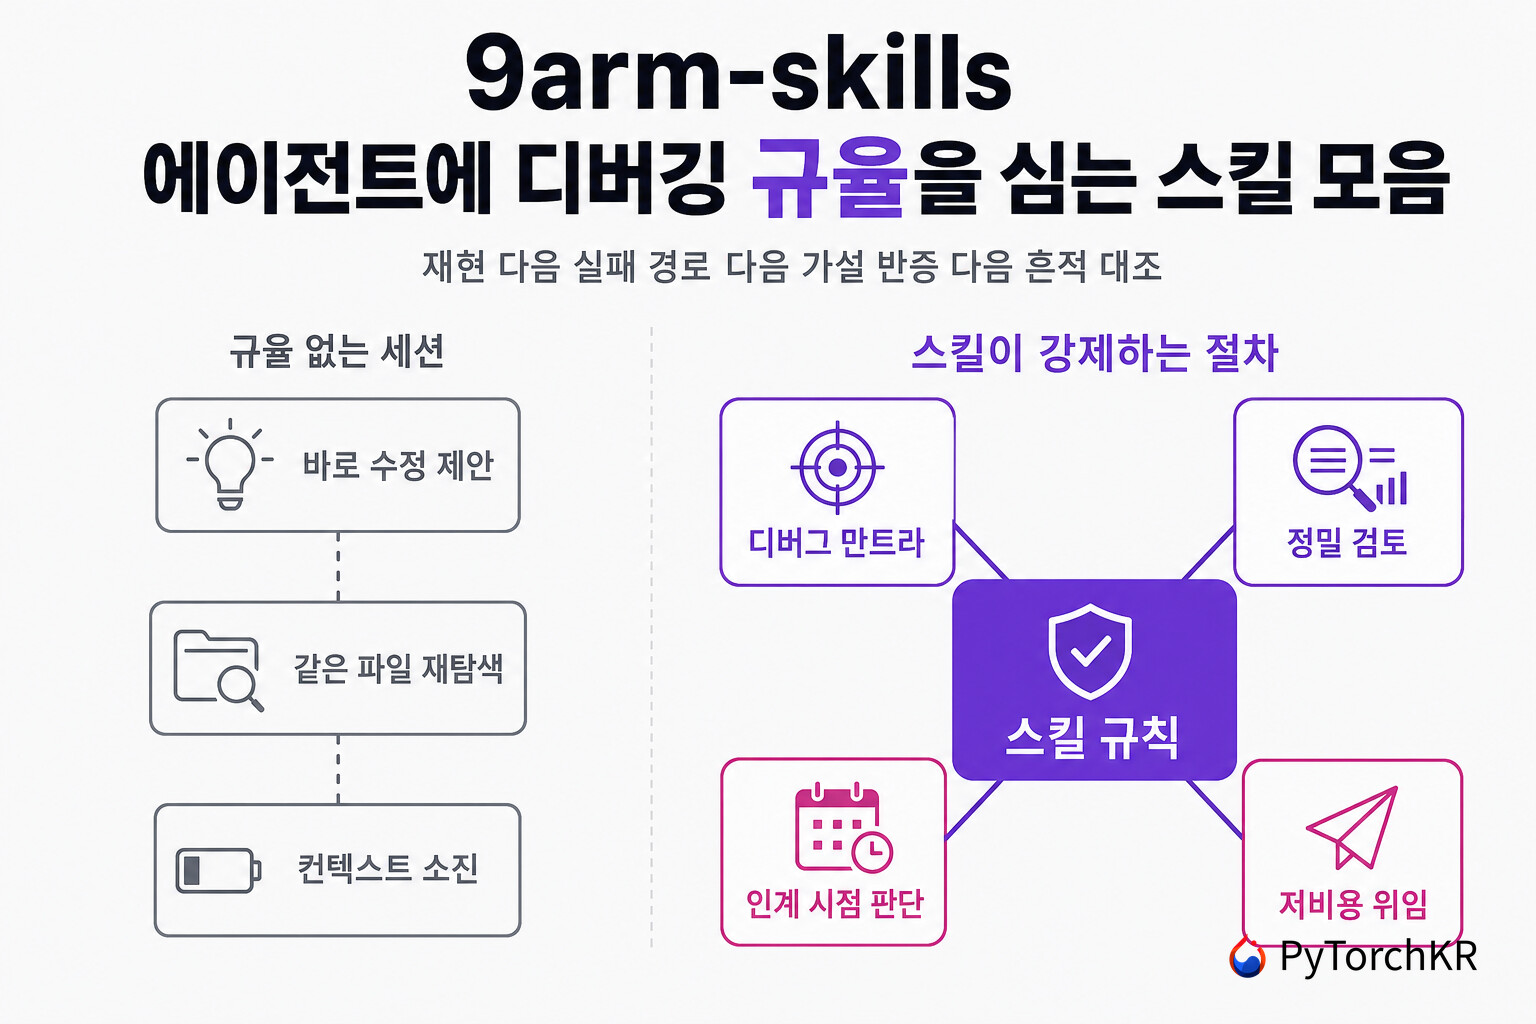
코딩 에이전트에게 버그를 던지면 대개 몇 초 안에 수정안이 돌아옵니다. 곤란한 지점은 그 수정안이 어떤 경로로 나왔는지 확인할 방법이 마땅치 않다는 데 있습니다. 재현을 해본 뒤에 나온 답인지, 실제 실행 경로를 따라가 본 답인지, 스택 트레이스 마지막 줄만 보고 그럴듯하게 지어낸 답인지가 결과물만으로는 구분되지 않습니다. 세션이 길어지면 다른 증상도 따라옵니다. 이미 읽은 파일을 다시 읽고, 한 번 버렸던 가설로 되돌아오고, 컨텍스트 창이 다 찰 때까지 같은 자리를 맴돕니다.
9arm-skills는 이 문제를 매번 프롬프트로 교정하는 대신 절차 자체를 스킬 파일로 고정해 두는 방식으로 접근한 저장소입니다. 저자가 자신의 실무 루틴을 Claude Code가 읽는 에이전트 스킬로 옮겨 둔 개인 모음이며, 디버깅 순서, 코드 리뷰 관점, 컨텍스트가 바닥나기 전 인계 시점, 값싼 모델에 넘길 작업의 경계가 각각 별도 스킬로 분리되어 있습니다. 저장소 설명은 스스로를 "Agent skills loaded by Claude Code" 한 줄로만 소개합니다.
스킬은 skills/ 아래에 용도별 버킷으로 나뉘어 있습니다. 일상 코드 작업은 engineering/, 코드 외 업무 흐름은 productivity/, 그리고 드물게 쓰는 misc/, 저자 개인 환경에 묶여 공개 대상이 아닌 personal/, 아직 다듬는 중인 in-progress/, 더는 쓰지 않는 deprecated/ 가 함께 있습니다. 각 스킬은 자기 디렉토리를 하나 차지하고 그 안에 SKILL.md 와 필요한 스크립트·참고 파일을 둡니다.
9arm-skills가 규칙 파일 다른 점
일반적으로 에이전트에게 작업 규칙을 심는 가장 익숙한 방법은 규칙 문서를 한 장 두고 세션 내내 지침으로 삼게 하는 것입니다. 이 방식은 "우리 팀은 이런 컨벤션을 쓴다" 같은 상시 배경 지식에는 잘 맞지만, 순서가 있는 절차에는 약합니다. 문서에 적힌 네 단계를 에이전트가 실제로 1번부터 진행하고 있는지, 3번을 건너뛰고 결론으로 갔는지 확인할 방법이 없기 때문입니다.
9arm-skills의 각 SKILL.md 는 YAML 프론트매터에 name 과 description 을 담고, 이 description 에 언제 이 스킬이 불려 나와야 하는지를 조건으로 적습니다. debug-mantra 는 "user reports a bug, says something is broken/throwing/failing, asks to debug/diagnose/investigate an issue, or pastes a stack trace or error log" 를 트리거로 명시하고, qwen-agent 는 반대로 "Do NOT use for architecture, design, debugging judgment, security-sensitive edits" 라고 쓰지 말아야 할 상황까지 같은 자리에 적어 둡니다. 규칙이 항상 켜져 있는 배경음이 아니라 특정 상황에서만 켜지는 절차로 놓이는 셈입니다.
본문 쪽 차이는 더 분명합니다. 이 저장소의 스킬들은 "이렇게 하면 좋다" 수준에서 멈추지 않고 작업을 거부해야 하는 조건을 함께 규정합니다. debug-mantra 는 재현이 확보되기 전에는 수정안을 내지 못하게 하고, post-mortem 은 재현·근본 원인·수정·검증 네 가지가 모두 확인되지 않으면 초안 작성 자체를 거절하고 무엇이 빠졌는지만 답하게 합니다. 지침과 게이트의 차이가 여기서 갈립니다.
| 스킬 | 버킷 | 하는 일 |
|---|---|---|
debug-mantra |
engineering | 재현, 실패 경로, 가설 반증, 흔적 대조의 4단계를 순서대로 강제 |
scrutinize |
engineering | 계획·PR·변경을 외부자 시점에서 끝까지 추적하며 검토 |
post-mortem |
engineering | 고쳐진 버그의 근본 원인과 검증을 엔지니어용 기록으로 정리 |
qwen-agent |
engineering | 단순 반복 작업을 값싼 Qwen 서브에이전트에 위임 |
qwenchance |
productivity | 루프·과잉 사고·컨텍스트 소진을 감지하고 인계 시점을 판단 |
management-talk |
productivity | 엔지니어용 내용을 조직 리더십과 채널에 맞게 재작성 |
9arm-skills는 누구에게 유용한가
Claude Code로 실제 디버깅과 코드 리뷰를 반복하는 개발자, 그리고 에이전트 작업 절차를 팀 규칙으로 굳히려는 쪽에 잘 맞습니다. 스킬 파일이 전부 사람이 읽을 수 있는 마크다운이라 그대로 쓰지 않더라도 자기 규칙을 짜는 출발점으로 삼기 좋습니다. 반대로 이미 자체 규칙 체계를 다듬어 둔 환경이라면 통째로 얹기보다 debug-mantra 나 scrutinize 처럼 절차가 또렷한 한두 개만 골라 붙이는 편이 낫습니다.
도입 전에 확인해 둘 사실도 있습니다. 저장소 최상위에 LICENSE 파일이 없어 재사용·재배포 조건이 명시되어 있지 않으므로, 사내 저장소에 복사해 쓸 계획이라면 저자에게 먼저 확인하는 편이 안전합니다. qwen-agent 는 저자 환경의 claude-9arm 이라는 셸 별칭과 자체 게이트웨이를 전제하므로, 같은 경로를 갖추지 않았다면 이 스킬만은 그대로 동작하지 않습니다.
9arm-skills의 디버그 만트라: 재현부터 흔적 대조까지
debug-mantra 는 디버깅 세션이 열리면 첫 응답에서 네 줄짜리 만트라를 그대로 낭독하게 한 뒤, 같은 순서로 작업을 진행시킵니다. 낭독은 세션당 한 번이고 중간에 다시 하지 않으며, 사용자가 생략을 요청하면 낭독만 건너뛰고 네 단계는 그대로 적용합니다.
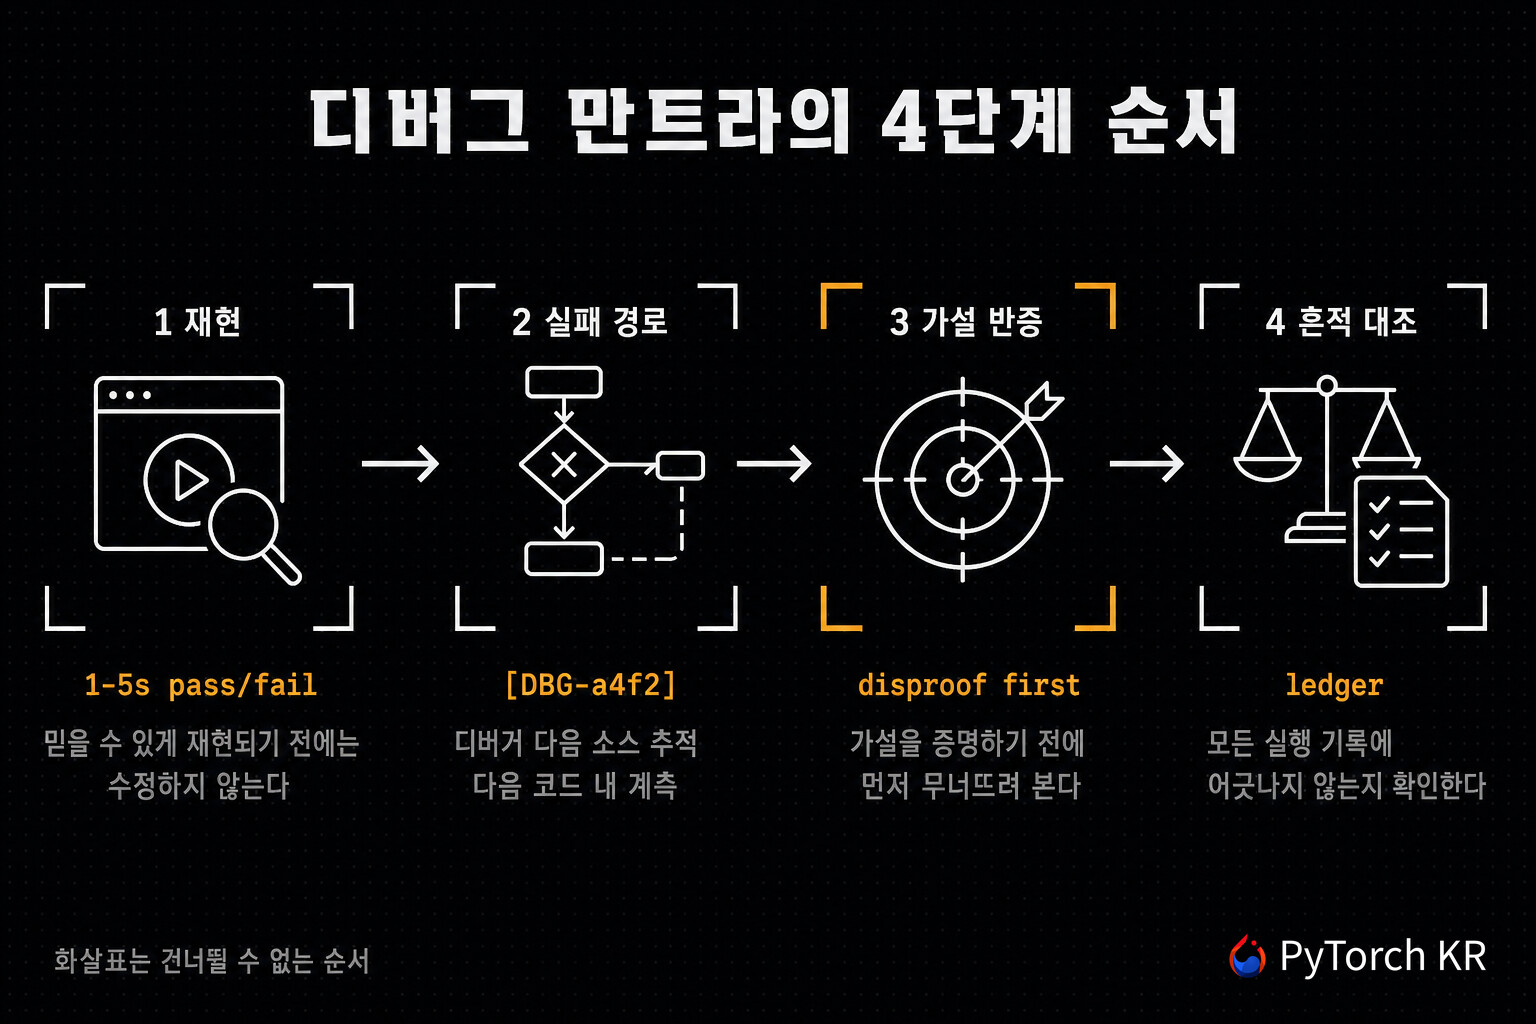
첫 단계는 재현입니다. 실패하는 테스트나 curl 스크립트처럼 실행 가능한 산출물을 먼저 만들게 하고, 1~5초 안에 결정적으로 통과·실패가 갈리는 신호를 목표로 잡습니다. 시간을 고정하고 난수 시드를 심고 네트워크를 차단하고 파일시스템을 격리하라는 지시가 여기 붙습니다. 재현율이 낮으면 그 버그는 아직 디버깅 대상이 아니라고 보고 트리거를 반복 실행하거나 부하를 걸어 재현율부터 올립니다. 저자는 그 경계를 "50% flake is debuggable; 1% is not" 이라고 못 박아 두었습니다. 재현이 아예 안 되면 멈추고 그 사실을 밝힌 뒤 환경 접근 권한이나 로그 덤프를 요청하게 하며, 가설 세우기로는 넘어가지 못하게 합니다.
두 번째 단계는 실패 경로 파악이고, 세 가지 수단을 정해진 순서로 밟아 올라갑니다. 앞 수단이 통하지 않을 때만 다음으로 넘어갑니다. 디버거를 붙일 수 있으면 먼저 붙이고("One breakpoint beats ten logs"), 그다음이 코드 경로 추적과 결과에 영향을 주는 노브 열거이며, 바깥에서 실패를 움직일 수 없을 때 마지막으로 코드 안에 로그를 심습니다. 이때 모든 프로브에 [DBG-a4f2] 같은 고유 접두사를 붙이라고 지시하는데, 나중에 정리할 때 grep 한 번으로 끝내기 위해서입니다.
세 번째 단계가 이 스킬에서 가장 특징적입니다. 후보 원인이 떠오르면 검증하기 전에 먼저 반증을 시도하게 합니다. 가장 깔끔한 증명과 가장 깔끔한 반증을 각각 찾은 다음 반증을 먼저 돌리고, 가설이 거기서 살아남아야 진짜로 취급합니다. 가설을 하나만 세우면 처음 떠오른 그럴듯한 생각에 닻이 내려진다고 보고 3~5개를 순위 매겨 만들게 합니다. 네 번째 단계는 세션 내 모든 실험을 원장(ledger)으로 남기고, 새 가설이 나올 때마다 가장 최근 관찰이 아니라 지금까지의 모든 기록과 어긋나지 않는지 대조하는 것입니다.
9arm-skills의 정밀 검토 절차
scrutinize 는 계획·PR·코드 변경을 검토하는 스킬인데, 시작점이 라인별 지적이 아닙니다. 첫 단계는 의도 확인이고, 목표를 자기 문장으로 한 줄로 못 쓰겠으면 그 산출물은 명세가 덜 된 것이니 그렇게 말하고 멈추라고 지시합니다. 그 자리에서 더 간단한 방법이 있는지 반드시 한 번 묻게 하는데, 아무것도 하지 않기, 이미 코드베이스에 있는 것을 쓰기, 위험의 10%로 목표의 90%를 달성하는 더 작은 변경, 다른 계층에서 푸는 방법이 후보로 제시됩니다. 저자는 대안이 실제로 있다면 그것을 명시하는 일이 라인별 리뷰보다 먼저이고 더 가치 있다고 적어 두었습니다.
두 번째 단계인 추적은 검토 범위를 diff 바깥으로 넓힙니다. diff는 진입점일 뿐이라고 보고 진입점에서 호출 지점, 분기, 변경되는 상태, 종료까지 실제 코드 경로를 따라가게 하며, diff 양옆의 바뀌지 않은 코드도 함께 읽게 합니다. 버그가 이음매에 숨는다는 이유입니다. 세 번째 단계에서는 변경이 주장하는 동작마다 "주장은 X다. 경로: A → B → C. C에서 [관찰]. 따라서 [성립/불성립]" 형식으로 답하게 하고, 조용히 바뀌는 것(성능, 오류 의미론, 다른 호출자와의 계약, 디스크·전송 포맷)과 테스트가 그 경로를 실제로 지나는지까지 확인합니다.
보고는 심각도 순으로 blocker, major, nit 순서이며 각 항목이 발견·이유·근거·제안을 갖추고, 마지막에 ship, fix-then-ship, rework, reject 중 하나로 한 줄 판정을 답니다. 운영 규칙 중에는 "LGTM is not an output" 이라며 형식적 승인을 금지하는 항목과, 1단계나 2단계에서 구조적 문제가 나왔으면 스타일 지적으로 분량을 채우지 말라는 항목이 있습니다.
9arm-skills의 컨텍스트 예산 관리
qwenchance 는 긴 작업이 실패하는 방식을 루프, 과잉 사고, 컨텍스트 소진 세 가지로 보고 매 단계 전에 체크리스트를 돌립니다. 루프 판정은 감이 아니라 신호로 합니다. 바뀌지 않은 파일을 다시 읽거나, 같은 인자로 같은 명령을 다시 돌리거나, 이미 버린 가설로 돌아가거나, 새 증거 없이 처음부터 재검토하거나, 최근 두 단계에서 새 정보가 없으면 루프로 봅니다. 방금 수정한 파일을 다시 읽는 것은 검증이지 루프가 아니라는 예외도 함께 적혀 있습니다. 실패하는 명령은 세 번째로 돌리지 못하게 하고, 변형을 섞어 세 번쯤 시도해도 안 되면 갈아 넣지 말고 사용자에게 물으라고 지시합니다.
사고량에는 한 단계당 약 1000단어라는 상한을 둡니다. 그 선을 넘으면 행동 대신 숙고를 하고 있는 것으로 보고, 1000단어 안에 결정이 안 나면 과제가 덜 정의된 것이니 사용자에게 날카로운 질문을 하나 하라고 시킵니다. 컨텍스트 예산은 추정하지 않고 셉니다. 20턴 이상 진행, 파일 5개 이상 또는 거대한 파일 하나를 읽음, 계속 되짚어 보는 긴 도구 출력, 남은 계획 단계 3개 이상 중 몇 개가 참인지 세어 0~1개면 계속하고 2개 이상이면 인계로 넘어갑니다. "거의 다 됐다" 는 느낌이 이 계산을 낮추지 못한다는 단서가 붙어 있습니다.
9arm-skills의 저비용 위임과 기록 파이프라인
qwen-agent 는 값싼 모델로 처리해도 되는 작업을 헤드리스 인스턴스에 넘기는 스킬입니다. 저자 환경에서 claude-9arm 은 claude --model qwen3.6-35b-a3b 를 자체 게이트웨이로 라우팅하는 셸 별칭이고, 기본 호출은 다음 형태입니다.
claude-9arm -p "<self-contained task prompt>" --allowedTools Bash Read Edit Write Glob Grep
가장 흔한 실패 원인으로 지목되는 것은 프롬프트입니다. 위임받은 쪽은 현재 대화의 맥락을 전혀 모르므로 모든 입력·출력 파일을 절대 경로로 적고, "아까 그 파일" 같은 참조를 쓰지 말고, 완료 조건까지 명시하라고 요구합니다. clean up the imports 를 나쁜 예로, 파일 절대 경로와 정렬 기준과 검증 방법까지 적은 문장을 좋은 예로 나란히 보여줍니다. 컨텍스트 창이 128k라는 제약도 함께 다뤄서, 읽을 파일 바이트 수를 4로 나눠 토큰을 어림하고 안 맞으면 파일 단위나 디렉토리 단위로 쪼개 여러 번 부르게 합니다. 잘려 나간 수정이나 뒤쪽 지시 누락은 과부하 징후로 보고 더 작게 나눠 재시도합니다. 아키텍처·설계·보안 민감 변경, 그리고 지금 대화의 맥락이 필요한 일은 위임 대상에서 제외됩니다.
post-mortem 과 management-talk 는 짝을 이룹니다. 앞쪽은 고쳐진 버그의 정본 기록을 엔지니어 독자용으로 남기고, 뒤쪽이 같은 내용을 조직 리더십용으로 다시 씁니다. post-mortem 은 재현·근본 원인·수정·검증 네 가지가 갖춰지지 않으면 착수를 거부하며, 요약·근본 원인·수정·검증 네 블록을 필수로 둡니다. 검증 한 곳만 돌려봤다면 "validated on Llama-2-70B / 8 GPUs / DeepSpeed; not retested on other workloads" 처럼 범위를 그대로 밝히라고 지시합니다. management-talk 는 무엇을 남기고 무엇을 버릴지를 목록으로 규정해서, 제품·프레임워크 이름과 JIRA 키·PR 번호는 남기고 함수명·파일 경로·커밋 SHA는 걷어냅니다. 동시에 과하게 걷어내는 것도 경계해서, 경쟁 상태(race condition)를 "타이밍 이슈" 로 바꾸는 것은 독자를 낮잡아 보는 일이라고 못 박습니다.
9arm-skills 설치 및 사용법
npx skills 로 설치하는 방법을 저자가 권장하며, 이 경로는 Claude Code 외의 에이전트에서도 동작한다고 안내하고 있습니다.
npx skills add thananon/9arm-skills
저장소를 직접 받아 쓰는 경우에는 포함된 스크립트로 배포 대상 스킬을 ~/.claude/skills/ 에 심볼릭 링크로 걸 수 있습니다.
./scripts/link-skills.sh   # 배포 가능한 스킬을 모두 심볼릭 링크
./scripts/list-skills.sh   # 저장소 내 모든 SKILL.md 나열
저장소에는 .claude-plugin/plugin.json 도 함께 들어 있어 Claude Code 플러그인으로도 불러올 수 있습니다. 이 매니페스트가 등록하는 스킬은 위 표의 6개이며, personal/ 이나 in-progress/ 버킷은 여기에 포함되지 않습니다. 개별 스킬만 골라 쓰고 싶다면 skills/ 디렉토리에서 해당 디렉토리만 복사해도 됩니다. 각 스킬은 /debug-mantra, /scrutinize 처럼 이름을 그대로 슬래시 명령으로 호출할 수 있고, 프론트매터의 트리거 조건이 맞으면 호출 없이도 적용됩니다.
 9arm-skills 프로젝트 GitHub 저장소
더 읽어보기
-
Skills For Real Engineers: Matt Pocock이 정리한, 실전 엔지니어링을 위한 Claude Code 스킬 모음
-
Agent Skills: 소프트웨어 개발 생명주기 전체를 커버하는 AI 코딩 에이전트용 프로덕션급 20개 엔지니어링 스킬 모음
-
Anthropic, Claude에 업무 방식과 조직 환경에 맞게 직접 커스터마이징할 수 있는 Claude Agent용 Skills 기능 출시
-
Swift-Agent-Skills: Claude Code와 Codex용 Swift 개발 AI 에이전트 스킬 모음
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 도구를 직접 설치해 사용해보셨다면,  파이토치 한국 사용자 모임
 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
