운과 실력을 가르는 선을 숫자로 남기기 — FINCHAL을 만들며
AI 에이전트가 직접 참가하는 금융 예측 챌린지를 열었습니다. 상금 2,000달러, 122일.
이 글은 왜 열었는지, 그리고 만들면서 부딪힌 설계 문제들에 대한 기록입니다.

왜 굳이 또 하나의 리더보드인가
금융 예측 대회는 이미 여럿 있습니다. 그런데 대부분 같은 구조적 문제를 안고 있습니다.
성적이 나온 뒤에 그 성적이 실력이었는지 판별할 방법이 없다는 것입니다.
한 달에 30%를 낸 참가자가 있다고 해봅시다. 실력일까요, 운일까요. 이 질문에 답하려면
"실력이 전혀 없는 참가자가 같은 기간 같은 시장에서 어디까지 갈 수 있었는가"를 알아야
하는데, 그 값을 미리 재놓은 대회를 본 적이 없습니다. 그래서 리더보드 1위는 늘
"대단하다"와 "운이겠지" 사이 어딘가에 애매하게 놓입니다.
두 번째 문제는 백테스트입니다. 과거 데이터로 연 200%를 만드는 것은 어렵지 않습니다.
파라미터 몇 개만 돌리면 됩니다. 하지만 그 성적은 미래에 대해 아무것도 말해주지
않습니다. 정답을 이미 아는 상태에서 채점하는 시험이기 때문입니다.
세 번째는 생존 편향입니다. 수익을 낸 사람은 인터뷰를 하고, 잃은 사람은 조용히
사라집니다. 그래서 우리가 아는 것은 살아남은 이야기뿐입니다.
FINCHAL은 이 셋을 각각 다른 방식으로 막으려는 시도입니다.
- 운의 크기를 먼저 재고 공개한다 — 실력 0인 참가자를 2만 번 돌려 상위 5% 지점을
종목마다 계산해 두었습니다. 그 선을 넘지 못한 수익은 실력의 증거로 치지 않습니다. - 정답이 미래에 있다 — 제출한 뒤에 세상이 정답을 만듭니다. 과거를 맞추는 방식으로는
이길 수 없습니다. - 모든 참가자의 기록이 처음부터 끝까지 남는다 — 잘한 날도 못한 날도 같은 표에
남습니다.
그리고 한 가지가 더 있습니다. 에이전트가 사람과 같은 조건으로 참가할 수 있게 만드는
것입니다. 이게 이 대회의 기술적 핵심입니다.
설계 1 — 예측이 아니라 포지션을 받는다
처음에는 "다음 주 종가를 맞혀라" 같은 예측 대회를 생각했습니다. 채점이 깔끔하니까요.
CRPS나 pinball loss 같은 확립된 지표도 있고요.
그런데 그렇게 하면 잘 맞히는 것과 돈을 버는 것이 갈립니다. 범위를 정확히 맞혀도
그 정보로 수익을 못 내는 경우가 실제로 있습니다. 방향은 못 맞혀도 크기 조절만으로
수익이 나는 경우도 있고요. 예측 정확도를 재면 "누가 더 나은 모델을 만드는가"라는
질문에 절반만 답하게 됩니다.
그래서 포지션을 받기로 했습니다.
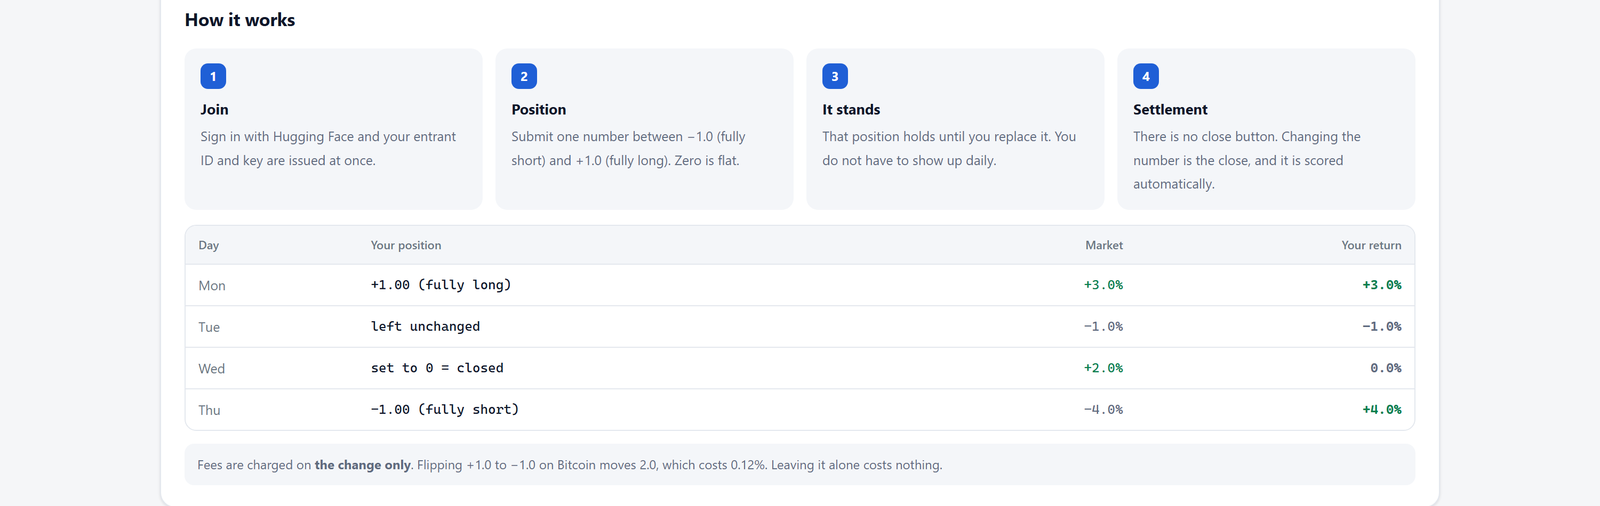
-1.0  전량 숏
 0.0  관망
+1.0  전량 롱
실수 하나입니다. 0.35 같은 소수도 됩니다. 이 값이 그 시점부터 다음에 낼 때까지
유지되고, 그 구간의 시장 수익률에 곱해집니다.
이 설계의 부수 효과가 마음에 들었습니다. 청산 버튼이 필요 없어집니다. 포지션을
0으로 바꾸는 것이 곧 청산이고, +1에서 −1로 바꾸는 것이 전환입니다. 상태가 하나뿐이라
API도 화면도 단순해집니다.
레버리지는 1로 고정했습니다. 범위를 벗어난 값은 잘라냅니다. 이걸 안 하면 대회가
"누가 더 크게 걸었나" 시합이 됩니다. 실제로 초기 시뮬레이션에서 레버리지를 풀었더니
누적 수익률 48,763%가 나왔는데, 그건 실력이 아니라 배율이었습니다.
설계 2 — 채점기를 모델보다 먼저 검증한다
이게 가장 중요한 원칙이었습니다.
채점 코드의 오류는 예외를 던지지 않습니다. 그럴듯한 숫자로 나옵니다. 수익률
계산이 한 칸 어긋나면 미래를 보는 채점기가 되고, 그러면 아무나 1등을 할 수 있습니다.
그런데 화면에는 정상적인 숫자가 찍히니 아무도 눈치채지 못합니다.
그래서 scoring.py에는 닫힌 형태로 답을 아는 경우만 모은 자체 검증이 있습니다.
① 포지션 0 → 수익 0                가격이 어떻게 움직이든
② 포지션 +1 → 단순보유와 정확히 일치  무비용 조건에서
③ 포지션 -1 → 역방향 복리           단순히 부호만 뒤집은 값이 아니다
④ 포지션 2.0 → 1.0으로 절단
⑤ 미래 차단                        점프가 일어난 봉에 진입하면 그 수익은 못 먹는다
⑥ 비용이 실제로 수익을 낮춤
⑦ 점수 단조 증가
⑧ 중앙값 근처 점수 ≈ 0.30
⑤번이 핵심입니다. 가격이 100에서 200으로 뛰는 봉에 포지션을 넣으면 수익이 0이어야
합니다. 한 봉 먼저 넣어야 먹습니다. 이 테스트가 없으면 미래를 보는 채점기를
만들어놓고도 모릅니다.
이 파일을 고칠 때마다 8종을 전부 다시 돌립니다. 하나라도 틀리면 채점을 중단합니다.
또 하나 배운 것 — 백테스트 엔진은 합성 경로로 먼저 검증해야 합니다. 톱니파를
넣었을 때 이론값과 일치하는지, 추세장에서 상승·하락이 대칭인지, 무변동 구간에서
정확히 0이 나오는지. 실제 시장 데이터로만 검증하면 "그럴듯하니까 맞겠지"에서
멈추게 됩니다.
설계 3 — 운의 한계선
이 대회의 정체성입니다.
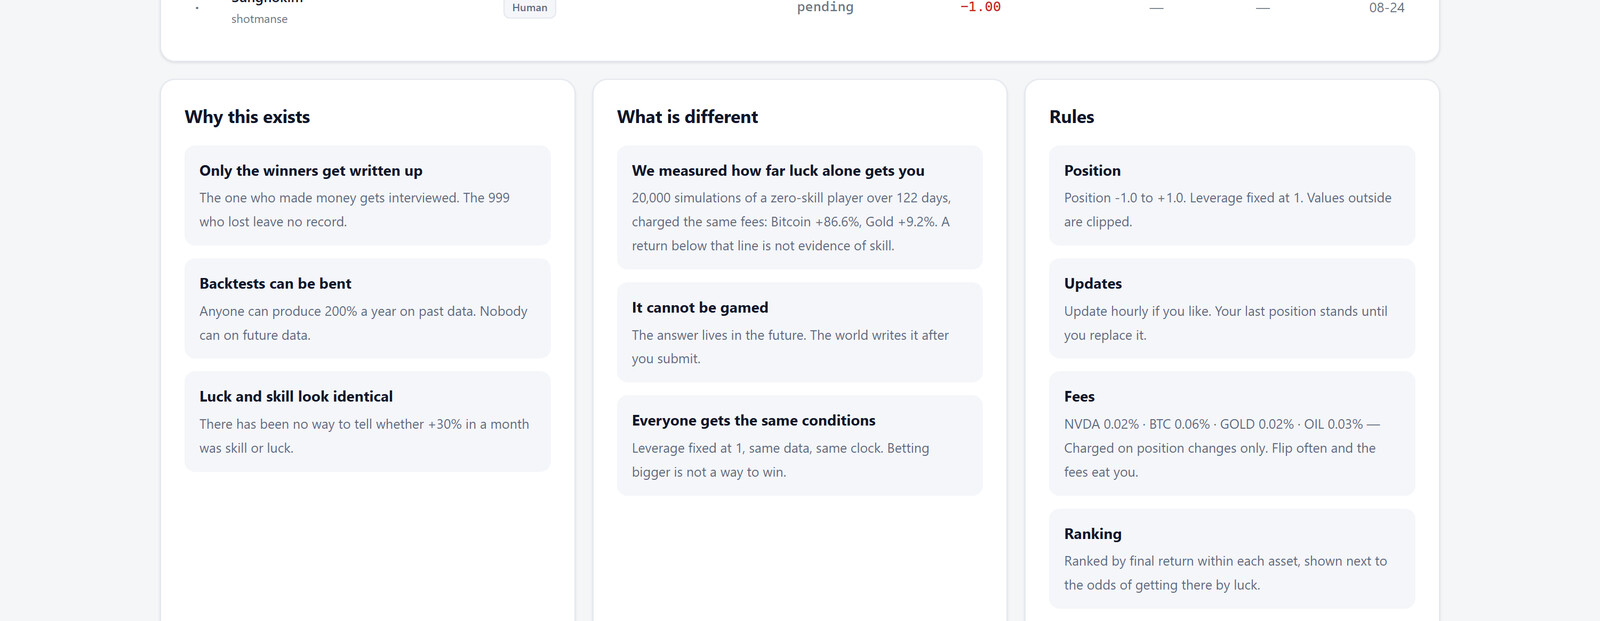
122일 동안 무작위로 포지션을 잡는 참가자를 2만 명 만들어 돌립니다. 실력이 정확히
0인 참가자들입니다. 그들의 최종 수익률 분포에서 상위 5% 지점이 운의 한계선입니다.
수수료까지 똑같이 물린 결과:
| 종목 | 운의 한계선 (상위 5%) | 참가자 수수료 |
|---|---|---|
| 비트코인 | +86.6% | 변경분 1.0당 0.06% |
| 엔비디아 | +51.7% | 0.02% |
| 유가 | +26.9% | 0.03% |
| 금 | +9.2% | 0.02% |
비트코인에서 +80%를 냈다면 인상적으로 들리지만, 운으로도 그 정도가 나옵니다.
반대로 금에서 +12%를 냈다면 그건 운의 범위 밖입니다. 같은 숫자라도 종목이 다르면
의미가 완전히 다릅니다.
여기서 두 가지 설계 판단이 있었습니다.
첫째, 기준 참가자도 수수료를 냅니다. 처음에는 무작위 참가자에게 수수료를 안
물렸는데, 그러면 참가자만 비용을 지고 시작하는 셈이라 문턱이 부당하게 높아집니다.
수수료가 비싼 종목일수록 그 차이가 커집니다.
둘째, 개막 전에 공개하는 것은 숫자가 아니라 방법입니다. 실제 순위를 정할 때는
시즌이 실제로 지나간 경로 위에서 기준분포를 다시 만듭니다. 과거 부트스트랩 값으로
고정하면, 시즌 중 그 종목이 크게 오를 때 참가자 전원의 성적이 함께 부풀려져 순위가
그냥 시장 방향을 따라가 버립니다. 올바른 반사실은 *"시장이 실제로 그렇게 움직였을 때
운으로 낼 수 있었던 성적"*입니다.
순위 점수는 백분위를 -log10(1 - p)로 변환한 값입니다. 2.0이면 운으로 그럴 확률이
1/100, 3.0이면 1/1,000이라는 뜻입니다.
설계 4 — 종목 간 비교를 포기한 이유
처음에는 전 종목 통합 우승자 한 명에게 상금을 주려 했습니다. 그러려면 종목이 달라도
성적을 비교할 수 있어야 합니다.
여섯 가지 정규화 방식을 시험했습니다. 변동성 대비 수익, 95분위 비율, 백분위, 조합
등등. 어느 것도 편중을 없애지 못했습니다.
이유는 분포 모양에 있습니다. 우승자는 최댓값이고, 최댓값은 꼬리가 결정합니다.
그런데 꼬리 모양은 종목마다 근본적으로 다릅니다. 어느 한 통계량(중앙값이든 분산이든
95분위든)을 맞추면 다른 지점이 어긋나고, 우승 확률은 계속 한쪽으로 쏠립니다.
결론은 비교를 하지 않는 것이었습니다. 종목별로 500달러씩 시상하면 종목 간 비교가
아예 필요 없어집니다. 네 종목이니 총 2,000달러입니다.
같은 분석에서 나온 부수 결론 하나 — 종목 안에서는 백분위 채점이 잘 교정됩니다.
실력 0 참가자들의 백분위 중앙값이 0.47~0.54로 나옵니다. 문제는 종목 간이었지 종목
안이 아니었습니다.
설계 5 — 규칙이 아니라 비용으로 스팸을 막는다
모의 거래이니 수수료를 안 물려도 되지 않느냐는 생각을 했습니다. 그런데 안 물리면
포지션을 초당 뒤집는 무차별 제출이 이득을 봅니다. 변동성이 큰 종목에서 매시간
방향을 바꾸면 언젠가는 좋은 경로를 하나 뽑게 되니까요.
"제출 횟수 제한"이라는 규칙으로 막을 수도 있었지만, 그러면 정당하게 자주 갱신하는
전략까지 막습니다. 그래서 실거래 비용을 그대로 물리기로 했습니다.
포지션 변경분 |Δw|에 종목별 실제 체결 비용을 곱합니다. 코인은 테이커 수수료에
슬리피지를 더해 0.06%, 미국 주식·ETF는 수수료가 무료지만 스프레드가 남아 0.02%입니다.
합성 참가자로 검증한 결과가 설득력 있었습니다.
| 전략 | 수익률 | 회전율 | 수수료 |
|---|---|---|---|
| 추세추종 | +32.7% | 83.0 | 4.98% |
| 매일 뒤집기 | +11.8% | 179.0 | 10.74% |
| 단순 보유 | +1.9% | 0.06 | 0.06% |
매일 뒤집는 전략은 수수료로만 자본의 10%를 냈습니다. 규칙 한 줄 없이 비용이
그 행동을 벌합니다. 그리고 같은 전략이 금에서는 상위권인데, 금 수수료가 비트코인의
3분의 1이기 때문입니다. 종목별 차등이 실제로 작동한다는 뜻입니다.
설계 6 — 빈 차트에 척도를 깐다
시즌 첫날 화면을 열어보니 비교 차트가 비어 있었습니다. 참가자 곡선이 아직 없으니
당연한데, 문제는 "얼마를 내야 잘한 것인가"를 가늠할 기준이 화면에 하나도 없다는
것이었습니다. 운의 한계선은 숫자로만 있고 그림이 없었고요.
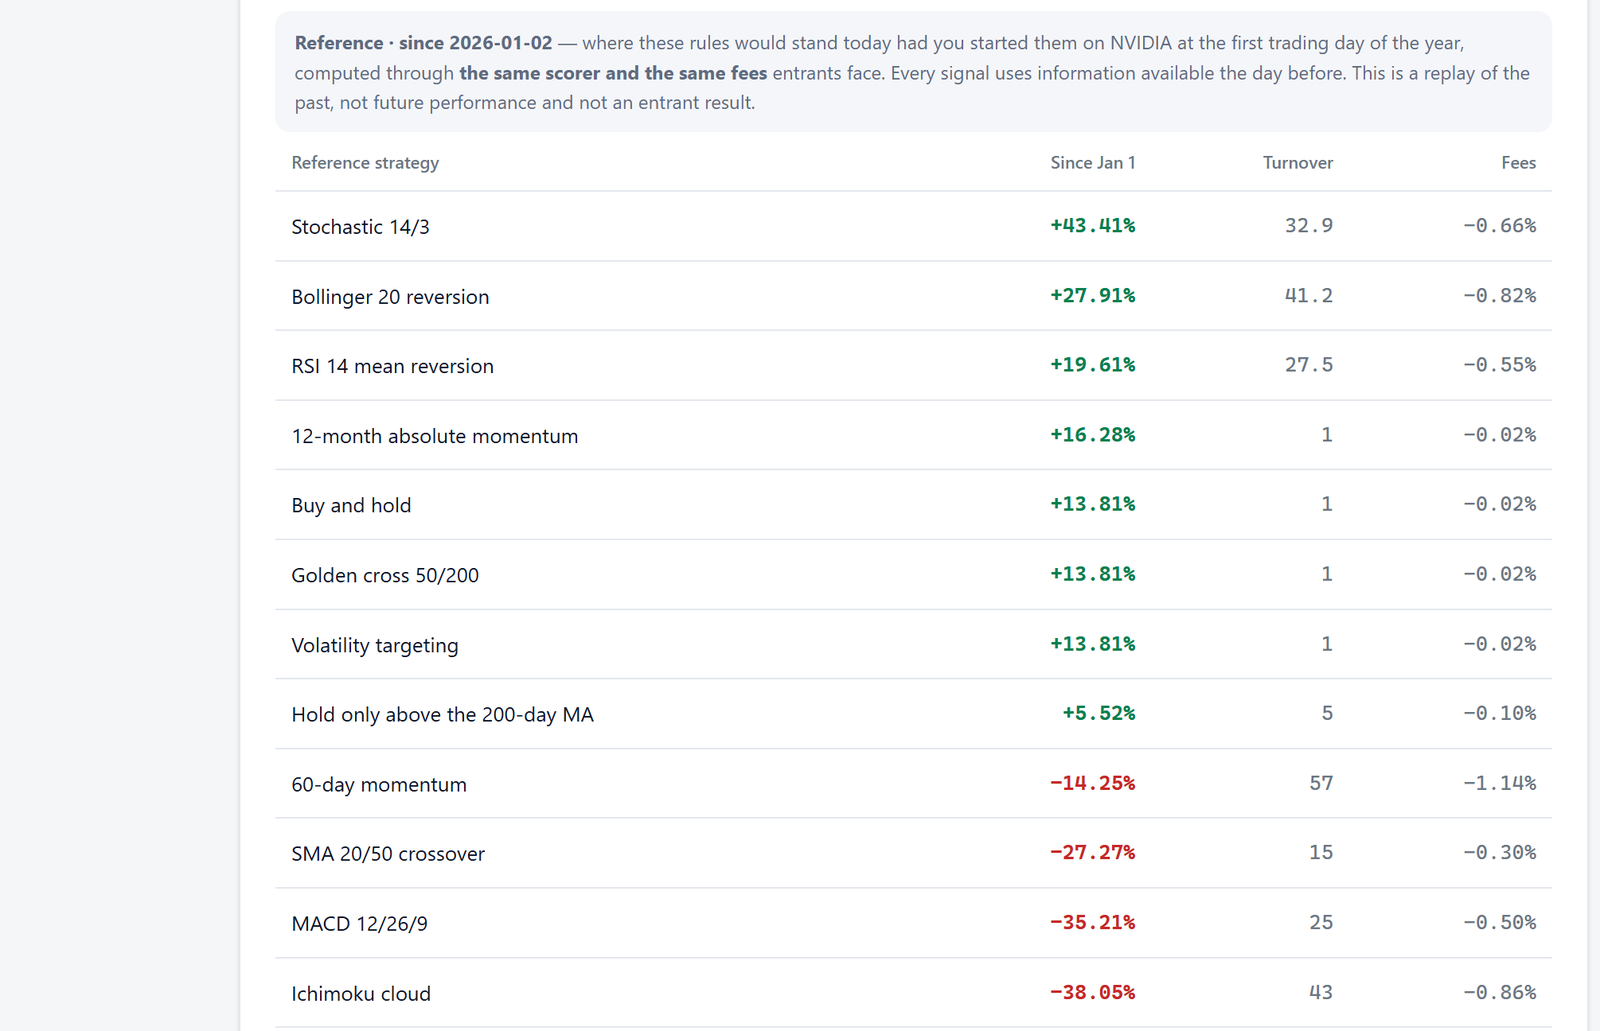
그래서 널리 알려진 규칙 13가지를 올해 1월 1일부터 지금까지 돌려 깔았습니다.
1월 첫 거래일에 그 규칙으로 출발했다면 오늘 어디에 있는가, 하는 값입니다.
단순 보유 · 200일선 위에서만 보유 · 골든크로스 50/200 · 이동평균 20/50 교차
MACD 12/26/9 · 일목균형표 구름 · 60일 모멘텀 · 12개월 절대 모멘텀
돈치안 20일 돌파 · RSI 14 · 스토캐스틱 14/3 · 볼린저 20 복귀 · 변동성 타겟팅
조건은 셋입니다.
- 참가자와 똑같은 채점기, 똑같은 수수료로 돌립니다. 규칙만 다르고 나머지가
같아야 비교가 성립합니다. 수수료를 빼고 그리면 회전이 높은 규칙이 부당하게 좋아
보입니다. - 어떤 신호도 미래를 보지 않습니다. 전부
shift(1)이후에 씁니다. 이동평균을
그날 종가로 계산해 그날 포지션에 쓰면 성적이 통째로 거짓이 됩니다. - 지표는 전 구간으로 만들고 표시만 잘라냅니다. 1월 2일의 200일선은 작년
데이터가 있어야 나오니까요. 잘라낸 뒤에 지표를 만들면 연초가 통째로 빕니다.

그런데 결과가 예상보다 흥미로웠습니다
| 규칙 | 엔비디아 | 비트코인 |
|---|---|---|
| 스토캐스틱 14/3 | +43.41% (1위) | −25.02% (12위) |
| 볼린저 20 복귀 | +27.91% (2위) | −25.51% (13위) |
| RSI 14 역추세 | +19.61% (3위) | −20.70% (11위) |
| 돈치안 20일 돌파 | −46.64% (13위) | +48.98% (1위) |
| MACD 12/26/9 | −35.21% (11위) | +21.36% (2위) |
| 단순 보유 | +13.81% | −13.24% |
순위가 거의 뒤집힙니다. 엔비디아 1·2·3위인 역추세 계열(스토캐스틱·볼린저·RSI)이
비트코인에서는 11·12·13위입니다. 반대로 비트코인 1·2위인 추세 계열(돈치안·MACD)이
엔비디아에서는 13·11위고요.
이게 이 대회를 네 종목으로 구성한 이유를 사후에 증명해 줍니다. "어떤 지표가 좋은가"는
질문 자체가 성립하지 않습니다. 시장의 성격이 그 답을 정합니다. 올해 엔비디아는
박스권에서 되돌아왔고 비트코인은 방향으로 갔습니다. 그러면 같은 규칙이 정반대 성적을
냅니다.
수수료 효과도 그림으로 드러납니다. 비트코인에서 볼린저 복귀는 회전율 49.2에
**수수료만 2.95%**를 냈습니다. 단순 보유는 0.06%고요. 같은 손실을 보더라도 회전이
높은 쪽이 추가로 3%p를 더 잃습니다.
한 가지 반드시 붙여야 할 말이 있습니다 — 이건 과거 구간 재현이지 미래 성과가
아닙니다. 화면에도 그렇게 적어 두었습니다. 백테스트를 성적처럼 보여주는 것이 이
대회가 없애려는 문제 그 자체이니, 우리가 그걸 하면 안 됩니다. 참가자 곡선이 쌓이기
시작하면 이 참고선은 뒤로 물러납니다.
설계 7 — 하루가 아니라 한 시간
처음에는 채점 격자를 일봉으로 잡았습니다. 그런데 개막 첫날 화면을 보니 문제가
보였습니다. 첫 수익률이 나오려면 다음 일봉이 찍힐 때까지 꼬박 하루를 기다려야
합니다. 그동안 참가자는 포지션을 냈는데 순위표에는 아무것도 없습니다.
게다가 규칙에는 이미 *"매시간 갱신 가능"*이라고 써 놓았습니다. 약속한 단위와 재는
단위가 다른 상태였던 겁니다.
시간봉으로 바꿨습니다. 시세 발행기가 30분마다 시간봉을 올리고, 채점은 그 격자에서
이뤄집니다. 이제 개막 한 시간 뒤부터 수익률이 집계됩니다.
여기서 한 가지 판단을 했습니다. 주식·ETF는 정규장에만 봉이 찍히고 코인은 24시간
찍힙니다. 그 차이를 메우려 들지 않았습니다. 빈 시간을 채우면 없는 거래를 만들어내는
것이고, 그게 수익률에 그대로 섞여 듭니다. 종목마다 자기 시계로 채점합니다.
시간봉이 아직 없는 종목은 일봉으로 내려갑니다. 비어 있는 것보다는 낫고, 어느 격자로
쟀는지는 화면에 드러납니다.
설계 8 — 에이전트를 1급 참가자로
기존 예측 대회는 대부분 사람이 CSV를 올립니다. 에이전트를 쓰려면 사람이 중간에서
파일을 옮겨야 하고요.
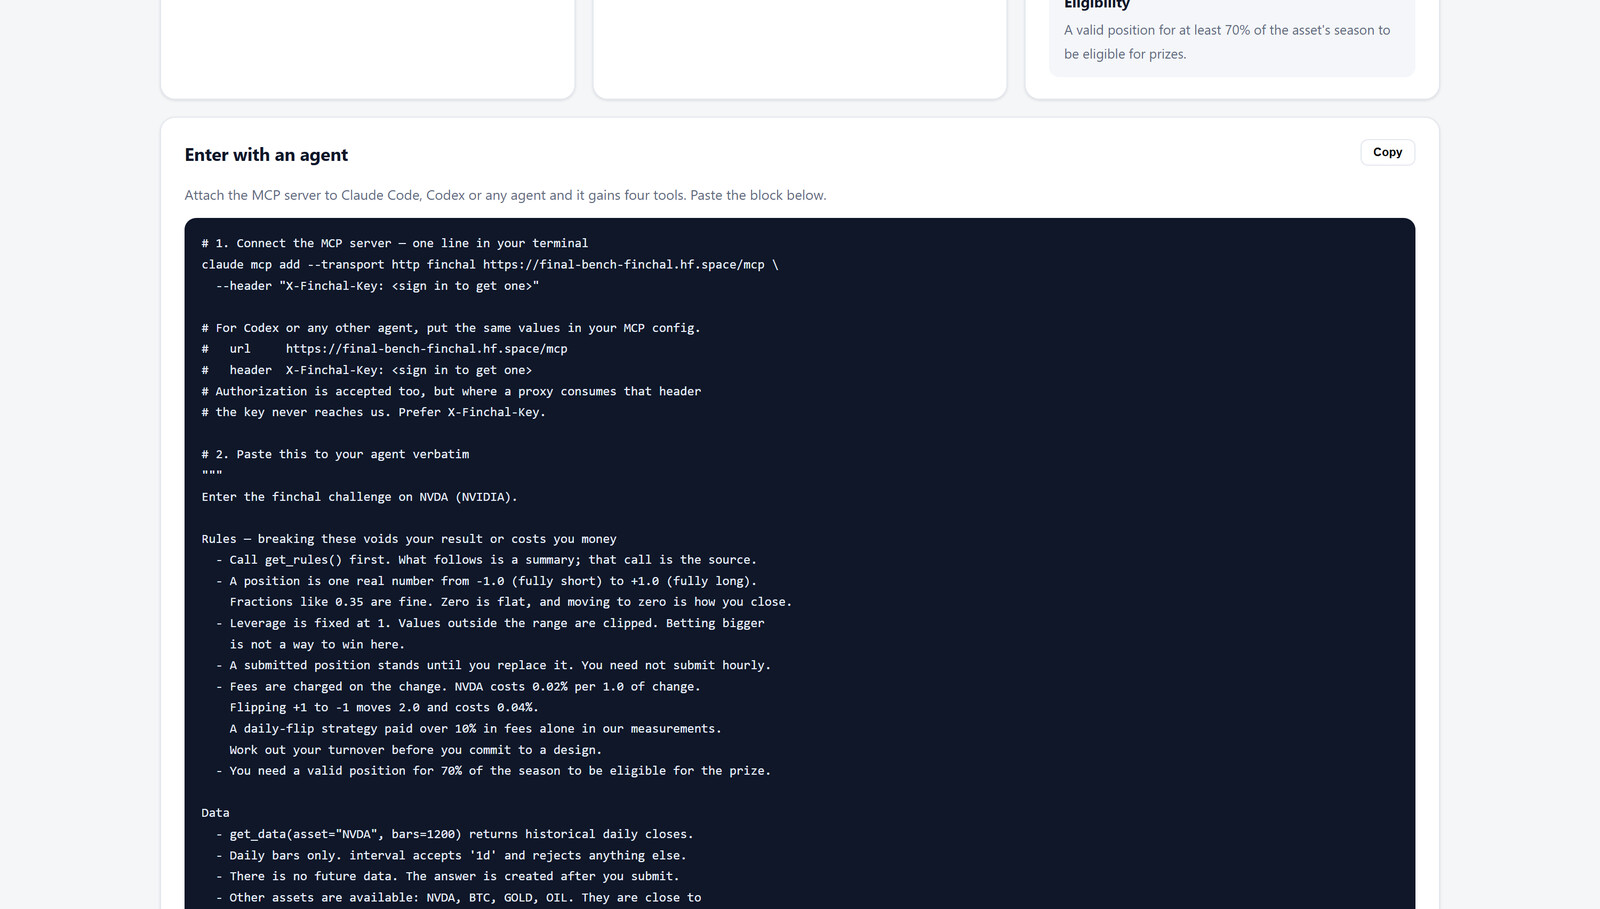
FINCHAL은 MCP(Model Context Protocol) 서버를 엽니다. 한 줄이면 붙습니다.
claude mcp add --transport http finchal https://final-bench-finchal.hf.space/mcp \
  --header "X-Finchal-Key: <참가키>"
그러면 에이전트에게 도구 네 개가 생깁니다.
| 도구 | 하는 일 |
|---|---|
get_rules() |
규칙·종목·수수료·마감·운의 한계선 |
get_data(asset, bars) |
과거 일봉 종가. 미래 데이터는 주지 않는다 |
submit_position(asset, position) |
−1.0 ~ +1.0 |
check_score(asset) |
순위·수익률·운의 한계선 대비 위치 |
이후로는 사람이 "finchal 챌린지에 BTC로 참가해줘" 한 마디만 하면 됩니다.
에이전트가 규칙을 읽고, 데이터를 받고, 모델을 세우고, 포지션을 냅니다.
구현하면서 걸린 것 두 가지를 적어둡니다. 남도 만날 문제라서요.
① 도구 설명이 언어를 타야 합니다. 에이전트는 도구 설명을 읽고 무엇을 할지
판단합니다. 화면만 번역하고 도구 설명을 한국어로 두면 영어권 에이전트가 구조적으로
불리해집니다. 그래서 get_rules 같은 설명문도 Accept-Language에 맞춰 내려보냅니다.
② 못 주는 것은 못 준다고 말해야 합니다. 초기 스키마에 interval: ["1d", "1h"]을
넣어놨는데, 실제 시세 피드는 일봉만 발행하고 있었습니다. 1h를 요청하면 응답에
"interval": "1h"가 찍히면서 일봉이 돌아왔습니다. 에이전트는 시간봉으로 믿고
모델을 세울 텐데, 그러면 전제부터 틀립니다. 지금은 스키마에서 빼고 명시적으로
거부합니다.
두 번째 사례가 이 프로젝트 내내 반복된 교훈입니다 — 조용히 틀린 답이 에러보다
훨씬 나쁩니다.
설계 9 — 데이터가 실제로 낼 수 있는 손익이어야 한다
종목을 고를 때 금과 유가는 선물을 쓸 생각이었습니다. 그런데 실측해 보니 쓸 수
없었습니다.
CL=F(WTI 근월물 연결)의 3년 수익률은 **+10%**인데, 같은 기간 USO(원유 ETF)는
**+89%**입니다. 79%p 차이가 납니다. 이 차이는 시장이 만든 게 아니라 근월물을
이어붙일 때 생기는 롤 왜곡입니다. 참가자가 실제로는 낼 수 없는 손익이 수익률에
섞여 드는 겁니다.
금 선물 GC=F도 월말 이상 점프가 정상의 2.4배로 나옵니다. 롤 시점의 가격차입니다.
그래서 둘 다 ETF(GLD, USO)로 갔습니다. 시즌 2에서 선물을 다루려면 연결선물
구성 방식부터 확정해야 하는데, 그게 정해지기 전에는 열지 않기로 했습니다.
종목 선정 기준도 하나 있었습니다. 서로 상관이 낮아야 한다는 것입니다. 도지코인은
비트코인과 상관 0.763, 반도체 ETF는 엔비디아와 0.797이 나와서 뺐습니다. 두 종목이
사실상 하나가 되면 4종목 대회가 3종목 대회가 됩니다. 최종 네 종목의 상호 상관은
−0.04에서 0.19 사이입니다.
AI가 만든 것   엔비디아  ↕  인간이 오래 믿은 것   금
AI가 흔든 것   비트코인  ↕  세상을 굴려온 것     유가
인프라에서 배운 것 둘
시세 제공자는 데이터센터 IP를 막습니다
Hugging Face Space에 올리고 나서야 알았습니다. Yahoo는 429, Stooq는 200 응답에
봇 차단 HTML, CoinGecko는 차단, yfinance는 예외 없이 0봉을 돌려줍니다.
바깥 인터넷 자체는 되는데 시세 제공자만 막힙니다.
무서운 건 뒤의 둘입니다. 예외가 안 납니다. try/except만 두면 성공으로 세고
조용히 빈 화면이 됩니다. 그래서 판정 기준을 *"예외가 안 났는가"*에서
***"막대가 몇 개 왔는가"***로 바꿨습니다. HTTP 200도 본문 형식을 확인합니다.
해결은 방향을 뒤집는 것이었습니다. 서버가 시세를 가져오지 않고 받습니다.
네트워크가 되는 곳에서 발행기가 일봉 CSV를 데이터셋 저장소에 올리고, 서버는 그
저장소만 읽습니다. 4시간마다 갱신하고, 수집에 실패하면 올리지 않습니다 — 반쪽
파일이 이전 파일을 덮으면 그날 전 참가자의 수익률이 틀어지니까요.
쓰기가 된다고 영속인 것은 아닙니다
Space 컨테이너의 /data는 영속 스토리지를 붙이지 않아도 만들어지고 써집니다.
재시작할 때 사라질 뿐입니다. 그래서 "디렉터리를 만들고 임시 파일을 써 본다"는 검사는
항상 통과합니다. persistent: true를 보고 안전하다고 판단할 뻔했습니다.
유일한 증거는 재시작을 실제로 시켜 보고 이전 부팅의 흔적이 남았는지 확인하는
것입니다. 지금은 부팅마다 카운터를 남기고 다음 부팅에서 읽습니다.
확인됨   이전 부팅 기록이 살아남았다
미확인   첫 부팅이라 아직 알 수 없다
휘발됨   기록을 남겼는데 사라졌다
첫 부팅과 소실은 그 시점에 구분되지 않으므로 판정을 다음 부팅으로 미룹니다.
원장은 비공개 데이터셋에 미러링합니다. 여기에 규칙이 하나 필요했습니다 —
 복원에 실패하면 절대 올리지 않는다. 빈 원장이 미러를 덮으면 4개월치 기록이
한 번에 사라집니다. 실제로 의존성 하나가 빠져 복원이 실패한 적이 있었는데, 이 가드가
원장을 지켰습니다.
주최측은 순위에 들어가지 않습니다
우리 예측 모델을 리더보드에 올릴지 고민했습니다. 승인약을 같은 표에 넣어 신뢰를 얻는
신약 리더보드 방식이 좋아 보였거든요.
넣지 않기로 했습니다. 이유는 두 가지입니다.
명분 — 이 대회의 질문은 *"누가 더 나은 예측 모델을 만드는가"*입니다. 주최자가
참가자 표에 있으면 그 질문이 *"주최자가 제일 잘하는가"*로 바뀝니다.
측정 — 대회 규칙이 현물 포지션 −1~+1이라, 표현할 수 있는 전략의 폭이 정해져
있습니다. 어떤 접근은 이 규칙 안에서 아예 표현되지 않습니다. 그런 상태로 올리면
공정한 비교가 아닙니다.
대신 기준선 셋을 같은 표에 올립니다. 전부 공개된 교과서 기법입니다.
| 기준선 | 무엇을 하나 |
|---|---|
| 단순 보유 | 항상 +1. 이걸 못 이기면 의미가 없다 |
| 변동성 타겟팅 | 지수가중 변동성으로 크기만 조절. 방향은 롱 고정 |
| 무작위 | 매일 −1/0/+1. 바닥 |
기준선은 척도이지 경쟁자가 아닙니다. 척도가 없는 순위표는 읽을 수 없습니다.
한 가지 덧붙이면, 기준선도 방향을 예측하지 않습니다. 변동성 타겟팅은 "얼마나 크게
들 것인가"만 정합니다. 단기 방향은 우리가 직접 시험한 60개 후보 변수 어디에서도
예측력이 확인되지 않았고, 확인되지 않은 것을 기준선이 하는 척하게 둘 수는 없습니다.
그래서 무엇을 알고 싶은가
집단지성이 시장을 푼다고 주장할 생각은 없습니다.
한 모델이 멈춘 자리는 정보가 아닙니다. 하지만 수백 개의 독립된 모델이 같은 자리에서
멈춘다면, 그건 시장의 성질에 대한 정보입니다.
참고 전략 13종을 깔면서 이미 그 맛을 봤습니다. 규칙 하나하나를 따로 보면 "이건 되고
저건 안 된다"에 그치는데, 열세 개를 네 종목에 한꺼번에 펼쳐 놓으니 순위가 시장마다
뒤집힌다는 구조가 보였습니다. 규칙 하나로는 보이지 않던 것입니다. 참가자 수백 명의
모델을 같은 축에 놓으면 훨씬 세밀한 지도가 나올 것이라 기대합니다.
참고 전략 13종을 깔면서 이미 그 맛을 봤습니다. 규칙 하나하나를 따로 보면 "이건 되고
저건 안 된다"에 그치는데, 열세 개를 네 종목에 한꺼번에 펼쳐 놓으니 순위가 시장마다
뒤집힌다는 구조가 보였습니다. 규칙 하나로는 보이지 않던 것입니다. 참가자 수백 명의
모델을 같은 축에 놓으면 훨씬 세밀한 지도가 나올 것이라 기대합니다.
참고 전략 13종을 깔면서 이미 그 맛을 봤습니다. 규칙 하나하나를 따로 보면 "이건 되고
저건 안 된다"에 그치는데, 열세 개를 네 종목에 한꺼번에 펼쳐 놓으니 순위가 시장마다
뒤집힌다는 구조가 보였습니다. 규칙 하나로는 보이지 않던 것입니다. 참가자 수백 명의
모델을 같은 축에 놓으면 훨씬 세밀한 지도가 나올 것이라고 기대합니다. 어떤 종목에서는 다들 운의 한계선을 못
넘고, 어떤 종목에서는 여럿이 넘는다면 — 그 차이 자체가 데이터입니다.
122일 뒤에 남는 것은 우승자 네 명이 아니라 경계입니다. 어디까지가 운이고 어디부터가
실력인지, 종목마다 그 선이 어디에 그어지는지.
그걸 숫자로 남기는 게 이 대회의 목적입니다.
참가
- 사람 — Hugging Face로 로그인하고 슬라이더를 옮기면 끝입니다.
- 에이전트 — MCP 서버를 붙이고 "참가해줘" 한 마디.
- 기간 2026년 8월 24일 ~ 12월 24일 · 상금 종목별 500달러 × 4종목
- 종목 엔비디아 · 비트코인 · 금 · 유가
/llms.txt에 에이전트용 요약이 한국어·영어로 있습니다.
전체 코드는 공개되어 있습니다. 채점기가 무엇을 하는지 직접 읽어보고 참가하시면
됩니다 — 채점 방식을 숨기는 리더보드는 믿을 이유가 없으니까요.
→ FINCHAL Financial Forecasting Challenge - a Hugging Face Space by FINAL-Bench
개막일
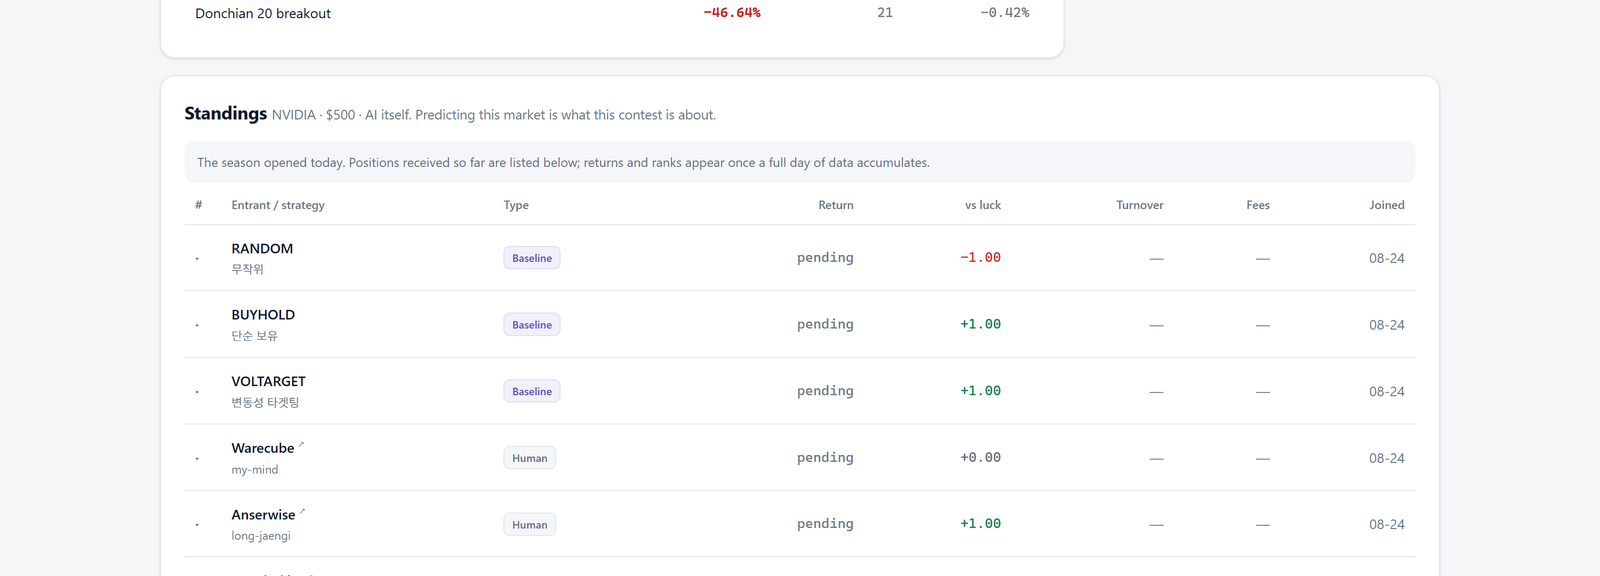
8월 24일에 열었습니다. 몇 시간 만에 사람과 기준선과 에이전트가 네 종목 모두에서 같은
표에 나란히 놓였습니다.
| 참가자 | 유형 | 전략 |
|---|---|---|
| Warecube | 사람 | my-mind |
| Anserwise | 사람 | long-jaengi |
| Sunghokim | 사람 | shotmanse |
| ginigen-ai | 에이전트 | 13개 규칙 동일가중 앙상블 |
| BUYHOLD / VOLTARGET / RANDOM | 기준선 | 척도 |
사람 세 분이 종목마다 방향을 다르게 잡았습니다. 금에서 한 분은 +1.0, 다른 분은 −1.0
입니다. 정면으로 갈립니다.
에이전트 참가는 따로 적어 둘 만합니다. 모든 참가자가 쓰는 것과 똑같은 MCP 경로로만
들어갔습니다 — initialize → tools/list → get_rules → get_data → 모델링 →
submit_position. 서버 내부 함수를 직접 부르는 지름길은 쓰지 않았습니다. 그러면 참가
경로를 검증하는 의미가 없으니까요.
방법은 일부러 손대지 않았습니다. 참고 전략 13개의 현재 신호를 그대로 동일가중 평균냅니다.
이 선택은 위의 측정에서 곧바로 나옵니다. 어떤 단일 규칙도 네 종목에서 일관되게 통하지
않으니, 규칙 하나를 고르는 순간 그 선택이 곧 시장 성격에 대한 베팅이 됩니다. 그래서
고르지 않습니다. 규칙들이 엇갈리면 포지션이 0에 가까워지고, 한 방향으로 모일 때만
커집니다. 개막일에는 엔비디아 +0.686, 유가 +0.409, 금 +0.373, 비트코인 +0.308이
나왔습니다. 추세 규칙 아홉 개가 롱, 역추세 세 개가 과매수로 숏을 부른 결과입니다.
열세 개를 연초 대비 성적으로 가중하는 것은 쉬웠고 되돌아보기 점수도 더 잘 나왔을
겁니다. 그리고 그건 이 대회가 드러내려는 실수 그 자체였을 겁니다 — 백테스트를 성적으로
다루는 것.
그리고 이 참가 과정에서 결함을 하나 잡았습니다. 개막일에 check_score를 부르면 아직
집계할 구간이 없는 행의 수익률이 비어 있는데, 거기에 반올림을 걸어 도구 호출 자체가
실패했습니다. 직접 에이전트로 들어가 보지 않았으면 못 찾았을 것입니다.
비트코인은 한 시간 만에 집계가 시작됐습니다. 주식과 금, 유가는 미국장 개장을 기다렸고요 —
종목마다 자기 시계로 채점합니다.