핵심 요약
- Auto Ontology는 NVIDIA가 공개한 파이썬 프레임워크로, 기업 데이터베이스의 메타데이터에서 온톨로지(용어 정의, 컬럼 매핑, 관계)를 생성하고 이를 근거로 자연어 질문을 SQL로 바꿔 실행합니다.
- AI 에이전트는 읽기 전용 도구 9개를 제공하는 MCP 서버, REST API, 웹 UI로 접근하며, 답변에는 실행한 SQL과 출처가 함께 돌아옵니다.
- Postgres(pgvector), FastAPI 백엔드, Next.js 프런트엔드로 이루어진 풀스택이며 Docker Compose 또는 Helm으로 배포합니다. 기본 모델은 NVIDIA NIM의 Nemotron 모델이고, OpenAI 호환 엔드포인트로 바꿀 수 있습니다.
- 지원 소스 데이터베이스는 Databricks, Postgres, Snowflake, DuckDB이며, 현재 외부 기여(이슈, PR)를 받지 않습니다.
- NVIDIA는 자체 테스트에서 온톨로지 작성 시간이 90% 줄었다고 밝혔지만, 저장소에는 Text-to-SQL 정확도 수치가 없고 별도 평가 도구인 Ontology SQL Eval로 직접 재야 합니다.
Auto Ontology 소개
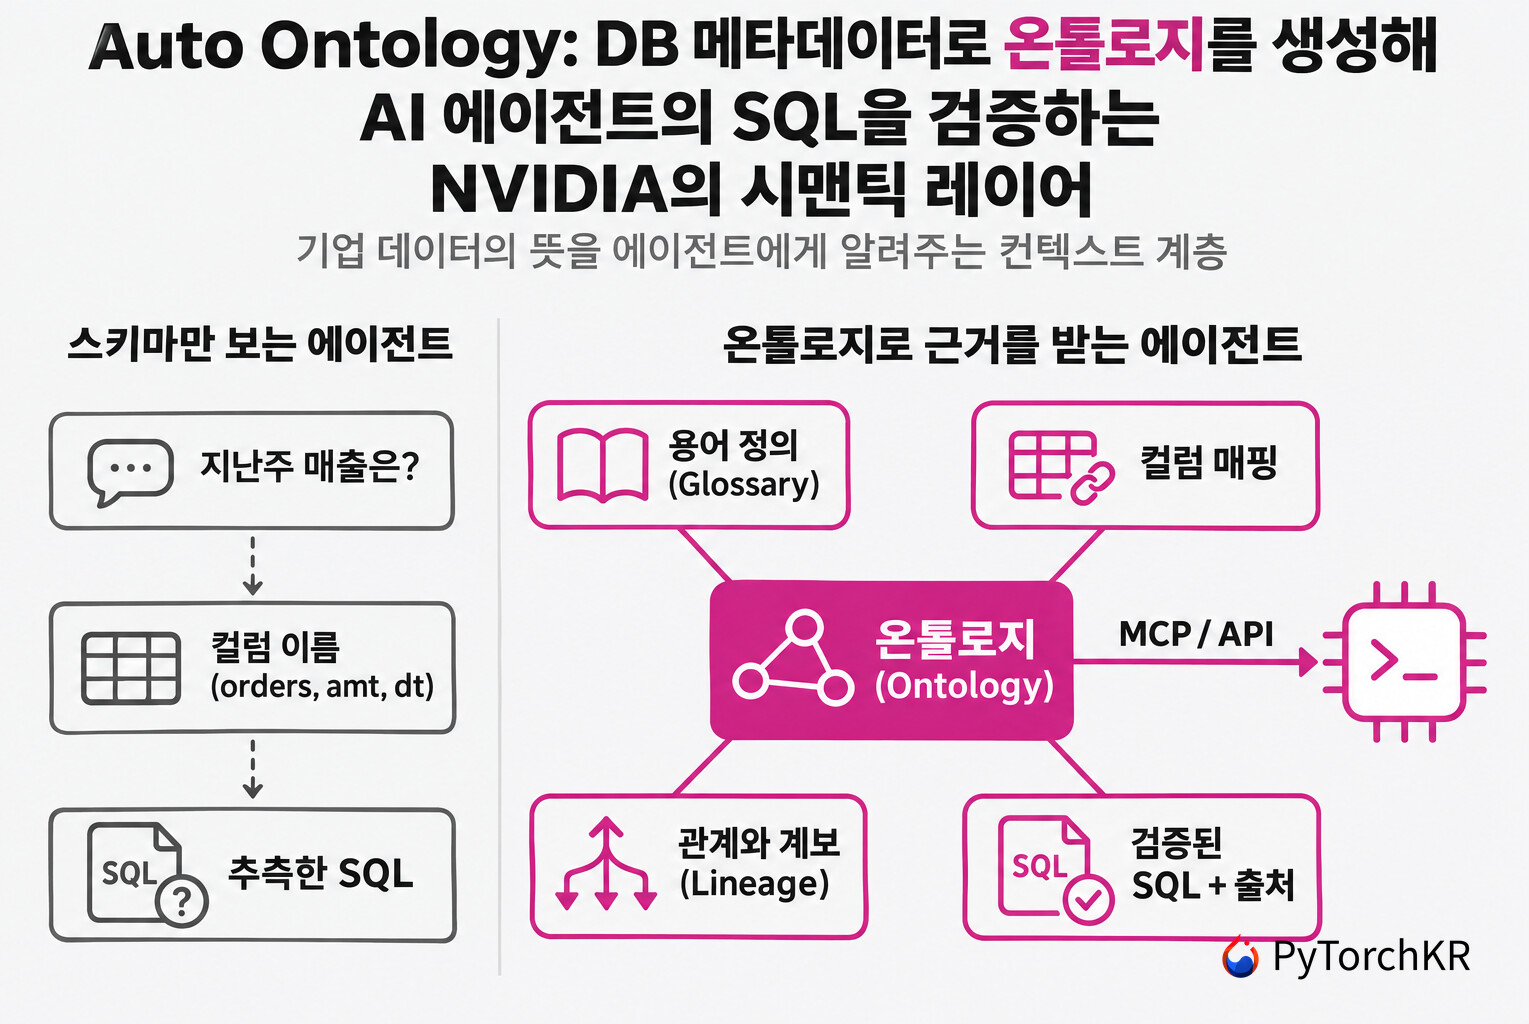
AI 에이전트가 문서를 검색하고 데이터베이스에 SQL을 던지는 일은 이제 어렵지 않습니다. 문제는 그 결과를 믿을 수 있느냐입니다. "지난 분기 매출"이라는 질문 하나에도 영업 시스템과 재무 시스템의 매출 정의가 다르고, 같은 지표가 테이블마다 다른 이름의 컬럼에 들어 있습니다. 에이전트가 컬럼 이름만 보고 SQL을 추측하면 실행은 되지만 숫자가 틀린 답이 나옵니다. 틀린 숫자는 빨리 나와도 쓸모가 없습니다. NVIDIA는 에이전트에게 데이터가 어디에 있고, 무엇을 뜻하며, 써도 되는지, 어떻게 쓰는지, 어디서 왔는지, 무엇과 비슷한지를 알려주는 컨텍스트 계층이 필요하다고 설명합니다. 이번에 소개하는 Auto Ontology는 그 계층을 기업 메타데이터에서 자동으로 만들어 에이전트에 제공하는 NVIDIA의 오픈소스 프로젝트입니다.
Auto Ontology는 연결된 데이터베이스의 스키마와 테이블 데이터를 수집해 온톨로지(Ontology)를 생성합니다. 온톨로지에는 비즈니스 용어(Glossary Term), 용어와 물리 컬럼의 매핑, SQL 속성(SQL Attribute), 용어 사이의 의미 관계가 들어갑니다. 여러 시스템에서 서로 어긋나는 정의는 하나로 조정(reconcile)하고, 생성된 SQL은 인증된 정의와 계보(Lineage)에 대조해 검증하며, 모든 답변에 출처(Provenance)를 붙여 돌려줍니다. 이 계층은 MCP(Model Context Protocol) 서버, CLI, REST API를 통해 어떤 에이전트 하네스(Agent Harness)에서도 쓸 수 있습니다. 또한 사용자가 이미 운영 중인 시맨틱 모델을 대체하는 것이 아니라 보완하는 것을 목표로 하며, 모델을 YAML로 내보내고 가져올 때 자체 형식 외에 Apache Ossie 형식도 지원합니다.
기술적으로는 파이썬 라이브러리 하나가 아니라 Next.js 웹 UI, FastAPI 백엔드, 수집 워커, Postgres(pgvector)로 이루어진 풀스택 애플리케이션입니다. 자연어 질문을 SQL로 바꾸는 추론(Inference)과 임베딩, 재순위화(Reranking)에는 NVIDIA NIM 엔드포인트를 기본으로 쓰고, 설정만 바꾸면 OpenAI 호환 엔드포인트를 연결할 수 있습니다. NVIDIA는 이 프로젝트를 Nemotron Retriever, Kumo, cuVS 등과 함께 묶은 Agent Knowledge Foundation의 한 구성 요소로 소개합니다. NVIDIA는 자체 테스트에서 온톨로지 작성 시간을 90% 줄였다고 밝히고 있지만, 이 수치는 NVIDIA가 공개한 자체 측정치이며 측정 조건은 공개되어 있지 않습니다.
Auto Ontology와 스키마만 보는 Text-to-SQL 비교
에이전트가 데이터베이스에 질문하게 만드는 가장 단순한 방법은 테이블과 컬럼 목록을 프롬프트에 넣고 SQL을 생성하게 하는 것입니다. Auto Ontology가 이 방식과 어디서 다른지는 다음과 같습니다:
| 항목 | 스키마만 주는 Text-to-SQL | Auto Ontology |
|---|---|---|
| 에이전트가 받는 컨텍스트 | 테이블과 컬럼 이름, 타입 | 용어 정의, 컬럼 매핑, SQL 속성, 의미 관계, 계보 |
| 정의가 시스템마다 다를 때 | 모델이 매번 추측 | 온톨로지에서 하나로 조정한 정의를 사용 |
| 답변에 붙는 것 | 생성한 SQL | 답변, 실행한 SQL, 결과 행, 출처 |
| 에이전트의 접근 경로 | DB 자격 증명을 직접 보유 | MCP 서버의 읽기 전용 도구, API 토큰, SSO |
| 정의를 고치는 방법 | 프롬프트 수정 | 웹 UI와 API로 용어와 SQL 속성을 수정하고 인증 |
NVIDIA는 이 차이를 수치로 재기 위해 Ontology SQL Eval 저장소를 따로 공개했습니다. 스키마만 준 대조군(control)과 온톨로지를 준 실험군(treatment)을 BIRD, BEAVER, FDABench-Lite 같은 벤치마크에서 실행하는 도구입니다. 채점은 LLM 심판 없이 실행 결과 일치로 하고, 두 값의 차이를 보고합니다. 다만 두 저장소의 README 어디에도 측정된 정확도 수치는 실려 있지 않으므로, 도입 전에는 자기 데이터로 직접 실행해 봐야 합니다. 모델 쪽에서 DB를 먼저 살펴보도록 학습한 SQRL 같은 접근이 모델 자체를 바꾸는 것이라면, Auto Ontology는 모델은 그대로 두고 모델에 주는 컨텍스트와 검증 절차를 바꾸는 쪽입니다.
Auto Ontology를 사용하면 좋을 사용자
Auto Ontology가 잘 맞는 경우는 Postgres, Snowflake, Databricks, DuckDB에 있는 운영 데이터를 에이전트에서 질의하게 하되 권한과 정의를 통제해야 하는 데이터 팀입니다. 그 에이전트는 Cursor나 Claude Desktop 같은 MCP 클라이언트일 수도 있고 사내 에이전트일 수도 있습니다. MCP 서버가 사용자별 로그인으로 동작하고 모든 도구가 읽기 전용이라, 에이전트에 DB 자격 증명을 쥐여 주지 않아도 됩니다. 이미 시맨틱 모델이나 용어집이 있다면 Apache Ossie 형식으로 가져와 출발점으로 삼을 수 있습니다.
파이썬 라이브러리 하나를 설치해 기존 파이프라인에 끼워 넣으려는 개발자에게는 Auto Ontology가 적절한 선택지가 아닙니다. Postgres, 웹 프런트엔드, 백엔드, 수집 서비스를 함께 띄워야 하고, 기본 설정은 NVIDIA가 호스팅하는 API에 질문과 스키마를 보냅니다. 폐쇄망이라면 NIM을 자체 호스팅하거나 OpenAI 호환 엔드포인트를 따로 준비해야 합니다. 현재 외부 기여를 받지 않으므로 버그를 직접 고쳐 올릴 수도 없습니다. 평가 도구의 벤치마크가 모두 영어 질문이고 문서 어디에도 다국어 언급이 없어, 한국어 질문과 한국어 컬럼 설명에서 같은 품질이 나오는지는 확인된 바가 없습니다. 한국어 데이터에 쓰려면 소규모 질문 집합으로 먼저 검증하는 편이 안전합니다(공개된 설정과 데이터셋 구성에서 끌어낸 편집자의 판단입니다).
Auto Ontology의 구성 요소와 질의 흐름
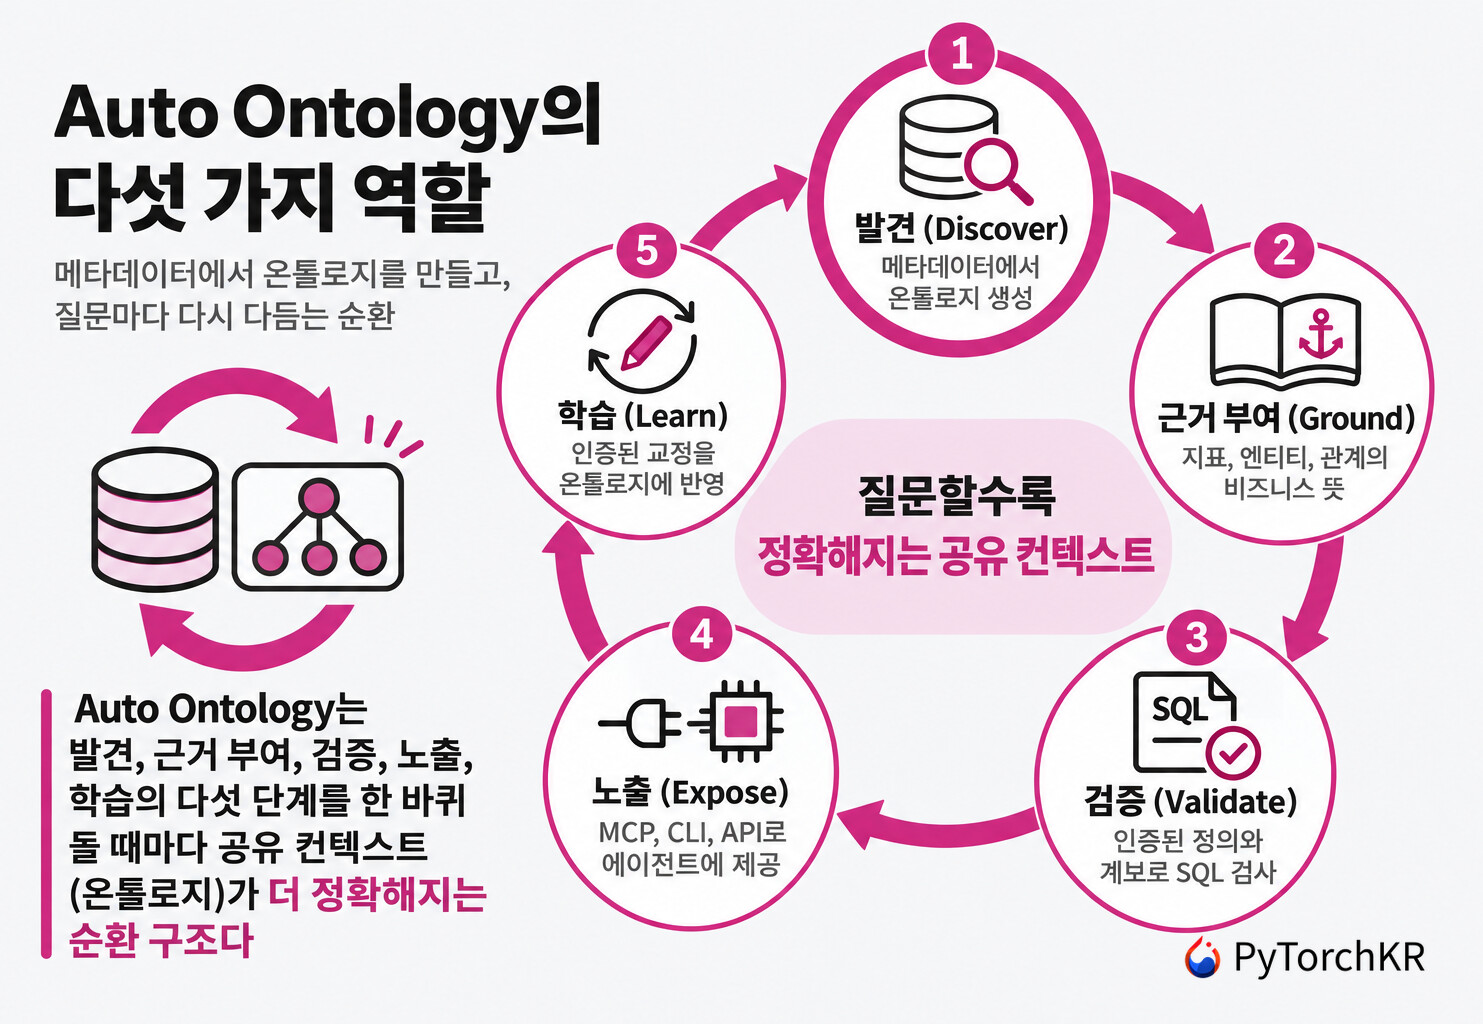
Auto Ontology의 기능은 다섯 가지 역할로 요약됩니다. 메타데이터에서 온톨로지를 생성하고 기존 온톨로지와 시맨틱 모델을 연결하는 발견(Discover), 지표와 엔티티와 관계에 신뢰할 수 있는 비즈니스 뜻을 부여하는 근거 부여(Ground), 생성된 쿼리를 인증된 정의와 계보에 대조하는 검증(Validate), MCP와 CLI와 API로 컨텍스트를 제공하는 노출(Expose), 그리고 인증된 교정과 사용 기록을 온톨로지에 다시 반영하는 학습(Learn)입니다. 아래 그림은 이 다섯 역할이 질문마다 한 바퀴 도는 순환을 그린 것입니다:
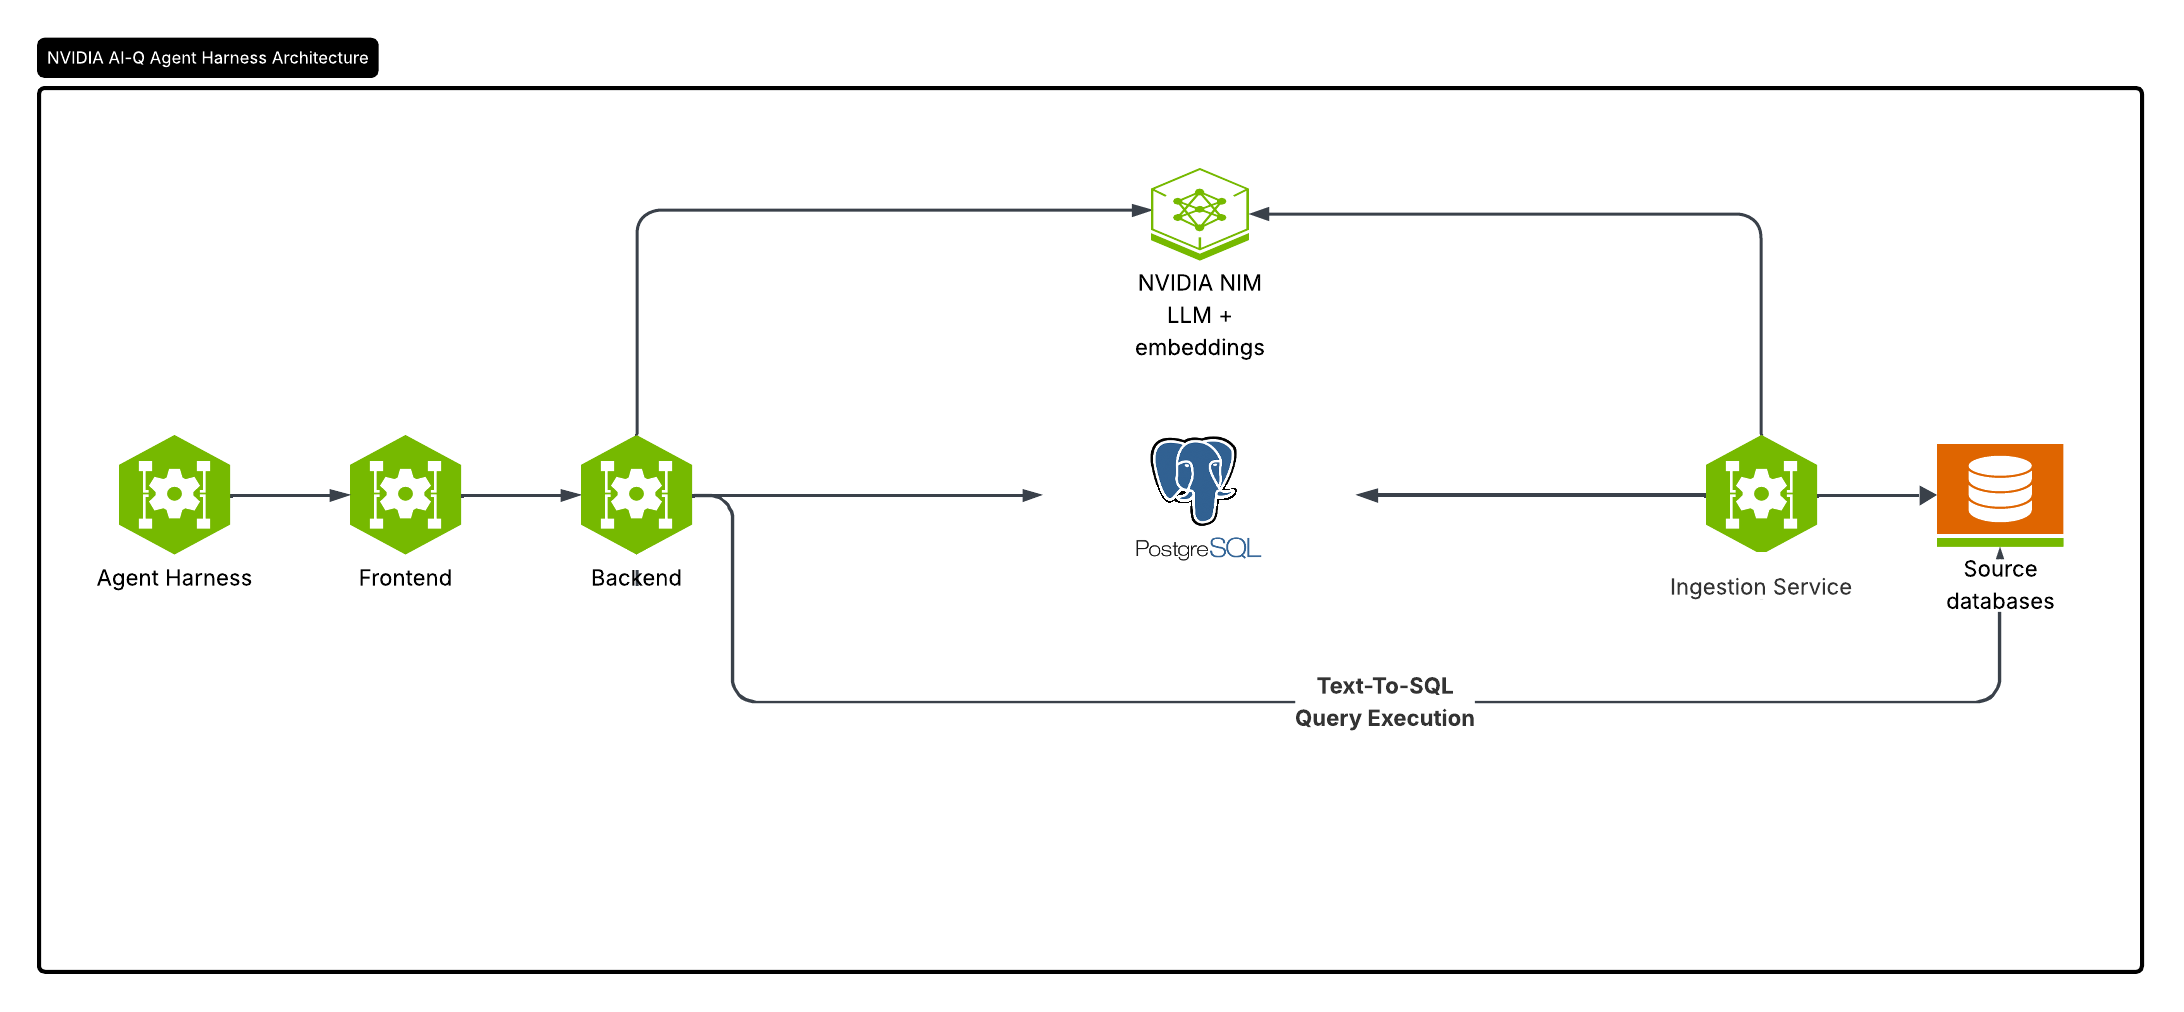
실행 구성은 네 개의 서비스로 나뉩니다. 아래 그림은 저장소가 공개한 아키텍처 다이어그램으로, Agent Harness에서 Frontend와 Backend를 거쳐 PostgreSQL에 이르는 질의 경로와 Ingestion Service가 Source databases를 읽어 NVIDIA NIM으로 임베딩하는 수집 경로를 보여줍니다:
각 구성 요소의 기술과 역할은 다음과 같습니다:
| 구성 요소 | 기술 | 역할 | 기본 포트 |
|---|---|---|---|
| Frontend | Next.js 16 (React 19, TypeScript, Tailwind CSS 4), Better Auth, Prisma | 웹 UI(채팅, 분석, 데이터 카탈로그, 설정), 인증, API 게이트웨이 | 3000 |
| Backend | FastAPI (Python 3.12 이상), LangChain | 채팅과 NL-to-SQL, 카탈로그, 데이터 소스 API | 3001 |
| Ingestion worker | FastAPI (Python 3.12 이상) | 테이블 데이터 수집과 임베딩 기록 | 3002 |
| Postgres + pgvector | 관계형 데이터베이스 | 앱 메타데이터, 카탈로그와 온톨로지, 벡터 저장소 | 5432 |
| HashiCorp Vault | 선택 | 연결 자격 증명의 안전한 저장 | 없음 |
온톨로지와 카탈로그는 별도의 그래프 데이터베이스가 아니라 Postgres에 카탈로그와 나란히 저장됩니다. 질의 흐름은 소스 DB를 연결하고, 수집 서비스가 스키마와 데이터를 추출해 임베딩을 기록하고, 시맨틱 컴파일(Semantic Compilation)로 시맨틱 레이어를 만든 뒤, 질문을 받아 SQL을 생성하고 실행하는 순서입니다. 백엔드는 LangGraph 기반의 Text-to-SQL 그래프로 구성되어 있습니다. 저장소의 .env.example에는 질문의 출력 유형을 되묻는 대화형 명확화 흐름, 생성한 SQL의 리터럴과 JSONB 키 경로와 조인 경로를 실행 전에 DB에서 확인하는 프로브, 행마다 고유한 컬럼으로 GROUP BY 하는 무의미한 집계를 거부하는 검사 같은 선택 옵션이 설명과 함께 들어 있습니다. 이 검사들은 기본적으로 꺼져 있고, 켜면 쿼리 비용이 조금 늘어나는 대신 실행은 되지만 틀린 SQL을 더 잡아냅니다.
모델은 역할별로 세 변수 묶음(엔드포인트, API 키, 모델명)으로 설정합니다. DEFAULT_MODELS 묶음이 공통 기본값이고, 메인 채팅과 NL-to-SQL용 REASONING, 엔티티 추출용 경량 모델 NON_REASONING, 임베딩용 EMBED, 재순위화용 RERANK 묶음에서 비워 둔 항목은 기본값으로 대체됩니다. 기본 모델은 LLM이 nvidia/nemotron-3-nano-30b-a3b, 임베딩이 nvidia/nemotron-3-embed-1b, 재순위화가 nvidia/llama-nemotron-rerank-vl-1b-v2입니다. 임베딩 모델은 수집 시점과 질의 시점에 같아야 하며, 바꾸면 다시 수집해야 합니다. KUMO_RFM_API_KEY를 설정하면 KumoRFM 예측 질의 분기가 켜져 예측형 질문을 처리하지만, 이때는 제한된 규모의 데이터가 호스팅된 KumoRFM 서비스로 업로드됩니다.
Auto Ontology의 MCP 서버와 에이전트 스킬
저장소의 mcp/ 디렉토리에 있는 MCP 서버는 Auto Ontology 공개 API의 HTTP 클라이언트입니다. DB 자격 증명도 모델 설정도 갖지 않고, 인증과 권한 검사를 Next.js 계층에 그대로 맡기므로 배포에 접근할 수 있는 어디서든 실행할 수 있습니다. 클라이언트 설정에는 URL만 적고, 사용자는 Auto Ontology의 로그인 화면(SSO 포함)으로 로그인합니다. Auto Ontology 자체가 OAuth 인가 서버 역할을 하므로 클라이언트 ID나 시크릿을 등록할 필요가 없고, 토큰은 매 호출마다 계정 권한으로 확인되어 역할 변경이나 계정 정지가 즉시 반영됩니다. 서버 자체에 토큰을 설정하는 방법은 일부러 두지 않았는데, 그러면 모든 호출자가 토큰 소유자로 행동하게 되기 때문입니다. 제공하는 도구는 다음과 같습니다:
| 도구 | 용도 |
|---|---|
ask_question |
자연어 질문을 던지고 답변, 실행한 SQL, 결과 행(최대 100행)을 받는 주 도구 |
check_answerable |
시맨틱 레이어가 질문을 다룰 수 있는지 미리 확인하는 저비용 사전 점검 |
check_readiness |
컴파일된 시맨틱 레이어와 살아 있는 DB 연결이 모두 있는지 확인 |
search_terms |
비즈니스 용어집 검색 |
get_term |
용어 하나의 설명, 동의어, 관련 용어 |
get_term_columns |
용어가 매핑된 물리 컬럼 |
get_term_sql_attributes |
용어 아래 정의된 SQL 속성 |
get_sql_attribute |
SQL 속성 하나의 식과 목적 |
describe_table |
테이블의 컬럼, 관련 용어, SQL 속성 |
데이터베이스, 스키마, 원시 컬럼을 훑는 도구는 일부러 넣지 않았습니다. 카탈로그 브라우저가 있으면 에이전트가 시맨틱 레이어 대신 원시 테이블로 추론하려 들기 때문이라고 프로젝트는 설명합니다. 이 가운데 일곱 개는 mcp/auto_ontology_mcp/tools.py의 허용 목록으로 OpenAPI 명세의 119개 연산에서 고른 것이고, 응답을 스트리밍하는 ask_question과 엔드포인트 세 개를 하나의 판정으로 묶는 check_readiness는 따로 구현되어 있습니다. 서버는 핸드셰이크 때 도구 호출 순서(check_readiness → search_terms → check_answerable → ask_question)를 안내문으로 함께 보내는데, 이를 두지 않으면 모델이 곧장 ask_question으로 가는 경향이 있기 때문입니다. ask_question은 웹 UI와 같은 Text-to-SQL 에이전트를 끝까지 실행하므로 보통 수십 초가 걸립니다.
저장소 루트의 skills/에는 코딩 에이전트용 스킬 세 개가 들어 있습니다. nvidia-ontology-setup은 Helm과 Docker Compose 설치와 문제 해결, nvidia-ontology-management는 용어와 SQL 속성과 관계를 수정하고 게시하는 쓰기 경로, nvidia-ontology-query는 MCP 우선과 REST 대체 경로로 질의하고 SQL과 결과 행을 검증하는 절차를 다룹니다. MCP는 읽기 전용이므로 쓰기는 모두 Next.js의 /api/... 경로로 갑니다. 이 스킬들은 NVIDIA의 스킬 카탈로그에도 동기화되어 npx skills add nvidia/skills로 설치할 수 있습니다.
Auto Ontology 설치와 사용
로컬 실행에는 Docker Compose v2, NVIDIA API 카탈로그에서 받은 nvapi- 키, 질의할 소스 DB(Databricks, Postgres, Snowflake, DuckDB)의 연결 정보가 필요합니다. 저장소를 받은 뒤 .env.example을 복사해 Postgres 자격 증명, DEFAULT_MODELS_API_KEY, CONNECTION_STRINGS 등을 채우고 스택을 띄웁니다. AUTH_SECRET과 APP_URL은 필수이며, 비어 있으면 모든 페이지가 Better Auth 오류로 실패합니다. 저장소 이름은 프로젝트 이름과 달리 auto-ontology이므로 아래 명령에서는 그 이름을 그대로 씁니다:
git clone https://github.com/NVIDIA/auto-ontology.git auto_ontology && cd auto_ontology
cp .env.example .env
# .env 편집: AUTH_SECRET, APP_URL, DEFAULT_MODELS_API_KEY, CONNECTION_STRINGS 등
docker compose up -d --build
백엔드와 프런트엔드 이미지를 빌드하고 Postgres와 pgAdmin을 띄운 뒤 스키마 동기화 작업을 거쳐 앱이 시작되며, UI는 http://localhost:3000, 백엔드 API는 3001번, pgAdmin은 5050번 포트에서 열립니다. 셀프 가입은 비활성화되어 있어 .env의 관리자 이메일과 비밀번호로 첫 관리자를 만듭니다. 소스 DB 연결은 UI에서 추가하는 것이 기본이고, CONNECTION_STRINGS 환경 변수는 UI에서 추가한 연결이 하나도 없을 때만 쓰입니다. UI에서 추가한 연결의 자격 증명은 Vault를 설정하지 않으면 Postgres에 평문으로 저장되므로, 운영 환경에서는 VAULT_ADDR 등 네 개의 Vault 변수를 설정해야 합니다.
스크립트나 노트북에서는 사용자 메뉴의 API Tokens에서 발급한 토큰을 x-api-key 헤더로 보냅니다. 토큰은 소유자의 권한을 그대로 따르며, 서버에는 SHA-256 해시만 저장되어 발급 시 한 번만 보여 줍니다. 아래는 README의 파이썬 예제입니다:
import os
import requests

session = requests.Session()
session.headers["x-api-key"] = os.environ["AUTO_ONTOLOGY_API_TOKEN"]

terms = session.get("https://auto_ontology.example.com/api/terms").json()

answer = session.post(
    "https://auto_ontology.example.com/api/chat/completions",
    json={"question": "How many orders shipped last week?"},
).json()
POST /api/chat/completions의 응답은 step, result, error 이벤트가 이어진 뒤 [DONE]으로 끝나는 SSE 스트림입니다. conversation_id에 클라이언트가 만든 UUID를 넣으면 대화가 이어지고, 이때 백엔드는 최근 완료된 다섯 턴(최대 12,000자)을 불러 "지난달은?" 같은 후속 질문을 독립 질문으로 다시 쓴 뒤 Text-to-SQL 그래프를 실행합니다. 같은 대화에 요청이 겹치면 409 Conversation in progress가 돌아옵니다. FastAPI 포트는 사용자 식별 헤더를 따로 검증하지 않는 내부 경계이므로 외부에 노출하면 안 됩니다. 외부 클라이언트는 항상 Next.js 게이트웨이를 통해야 합니다.
MCP 서버는 uvx로 저장소에서 바로 받아 실행합니다. PyPI에는 아직 등록되어 있지 않아 uvx auto-ontology-mcp만으로는 설치되지 않습니다:
AUTO_ONTOLOGY_API_URL=http://localhost:3000 \
  uvx --from "git+https://github.com/NVIDIA/auto-ontology.git#subdirectory=mcp" auto-ontology-mcp
Cursor나 Claude Desktop의 MCP 설정에는 자격 증명 없이 서버 주소만 적고, 끝에 /mcp를 붙입니다. 저장소 문서에는 아직 "NVIDIA 내부용이라 GitHub 자격 증명이 필요하다"는 문구가 남아 있지만, 저장소는 현재 공개 상태입니다:
{
  "mcpServers": {
    "auto-ontology": {
      "url": "https://auto-ontology-mcp.example/mcp"
    }
  }
}
Kubernetes에는 NGC 카탈로그에 공개된 Helm 차트로 배포합니다. 백엔드와 수집 이미지(nvcr.io/nvidia/auto-ontology), 프런트엔드 이미지, MCP 서버 이미지가 함께 공개되어 있고, 차트는 자기 버전과 같은 태그의 이미지를 고정합니다. 관리자 계정과 Postgres 비밀번호, 모델 API 키는 값 파일에 적어 설치하며, 자세한 절차는 저장소의 DEPLOYMENT.md에 있습니다:
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia
helm repo update
helm install auto-ontology nvidia/auto-ontology -f auto-ontology-secrets.yaml
kubectl port-forward svc/frontend 3000:3000
Auto Ontology의 라이선스
Auto Ontology는 Apache-2.0으로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 함께 쓰는 서드파티 구성 요소는 THIRD_PARTY_NOTICES.md에 정리되어 있습니다.
단, 소프트웨어가 실행 중에 호출하는 외부 자원은 라이선스와 별개로 각자의 약관을 따릅니다. 기본 설정의 NVIDIA 호스팅 모델 API는 NVIDIA API 카탈로그와 각 모델의 약관을 따르고, 직접 연결한 OpenAI 호환 엔드포인트와 KumoRFM 서비스는 해당 제공자의 약관을, 소스 데이터베이스는 자기 계약을 따릅니다. 그래서 운영 데이터를 연결하기 전에 어떤 데이터가 어느 서비스로 나가는지 확인해야 합니다.
 NVIDIA Agent Knowledge Foundation 페이지 (Auto Ontology를 소개하는 NVIDIA 개발자 페이지)
 Auto Ontology 프로젝트 GitHub 저장소
Ontology SQL Eval 평가 도구 GitHub 저장소 (Auto Ontology용 Text-to-SQL 벤치마크)
더 읽어보기
-
feyn, 답변 전 DB를 먼저 살펴보는 text-to-SQL 모델 SQRL 공개 (feat. Chonkie)
-
Ontology Playground: 브라우저에서 온톨로지를 배우고 설계하는 오픈소스 웹 앱 (feat. Microsoft)
-
NVIDIA, RTEB 1위 오픈 임베딩 모델 Nemotron 3 Embed 공개 (feat. RAG, 에이전트 검색)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
