Cloudflare가 제안하는 에이전트 개발 수명 주기(ADLC) 소개
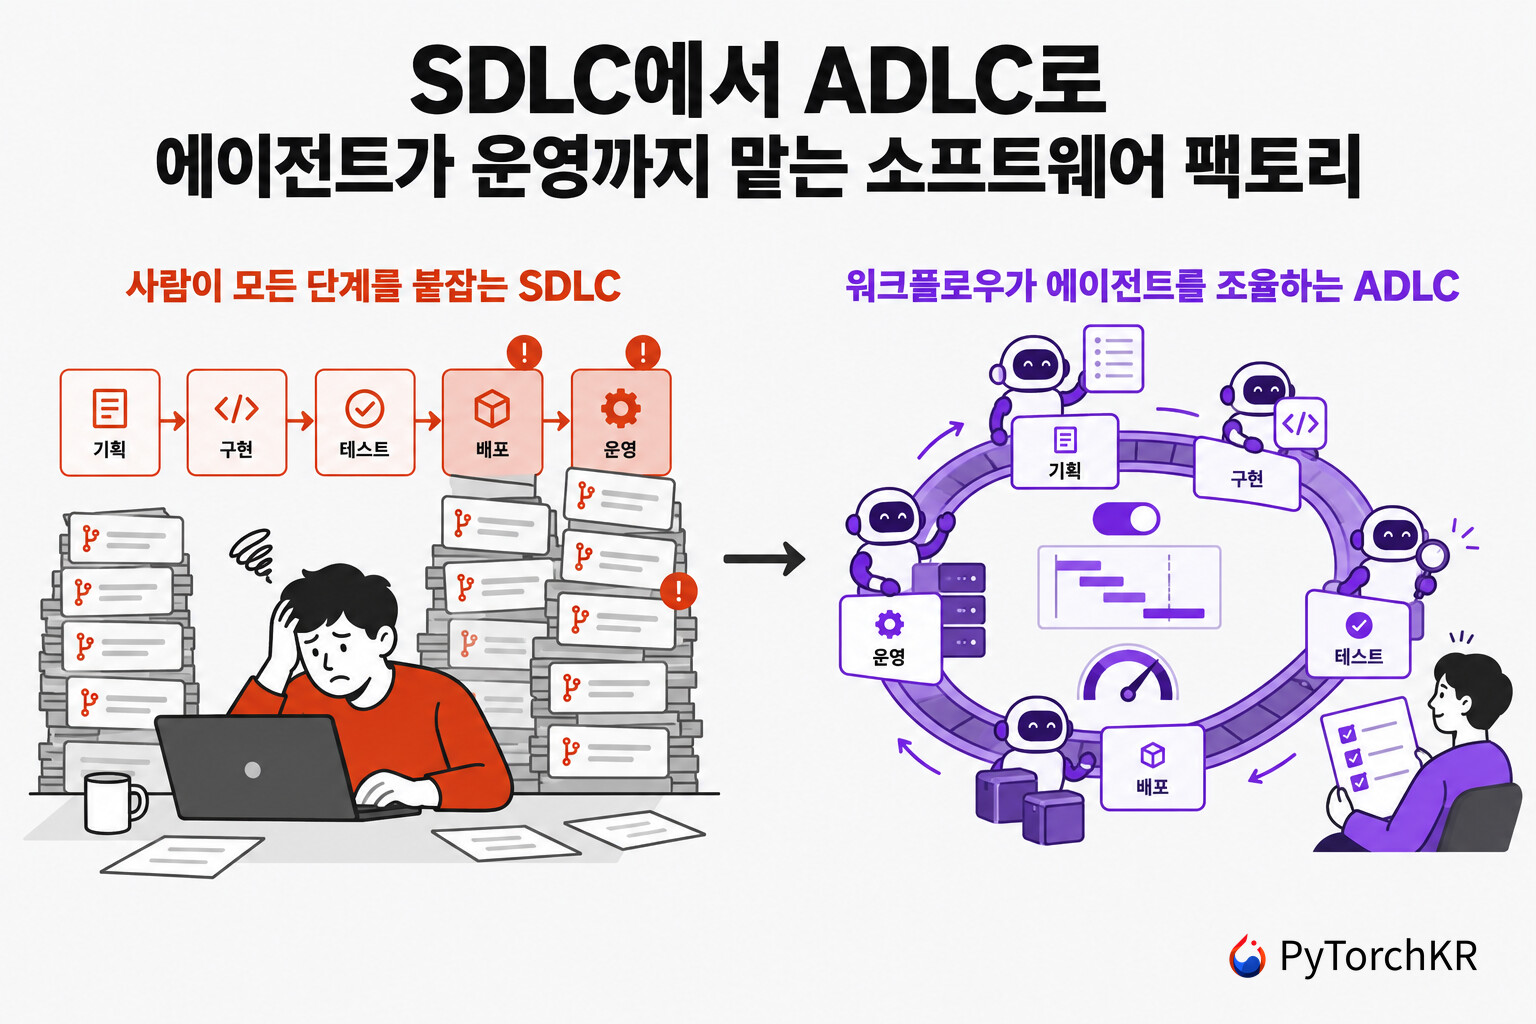
에이전트 개발 수명 주기(Agent Development Lifecycle, ADLC) 는 Cloudflare가 2026년 8월 4일 블로그 글 The Agent Development Lifecycle has arrived on Cloudflare 에서 제안한 개념으로, 코드 작성뿐 아니라 테스트, 배포, 운영, 유지보수까지 AI 에이전트가 맡을 수 있도록 개발 절차와 플랫폼을 다시 설계하자는 주장입니다. AI가 가장 느리고 비쌌던 구현 단계를 가장 빠르고 싼 단계로 바꾸자, 그 뒤에 있는 리뷰, 테스트, 배포, 운영 단계에 사람의 부담이 몰리고 있다는 것이 출발점입니다.
글을 쓴 Brendan Irvine-Broque는 이 문제를 이렇게 표현합니다. 팀에 새로 들어온 엔지니어에게 코드만 쓰게 하고, 검증과 병합, 배포, 프로덕션 온콜(on-call), 버그 분류는 모두 다른 사람이 하게 두는 회사는 없습니다. 그런데 지금 많은 회사가 에이전트를 바로 그렇게 쓰고 있다는 것입니다. 모델은 좋아졌고 에이전트는 더 긴 시간 동안 더 큰 작업을 처리하지만, 개발 수명 주기 전체에 고르게 쓰이지는 않고 있습니다. 그래서 원문은 역설적으로 "에이전트가 더 많은 일을 하도록 권한을 주는 것"이 해법이라고 말합니다.
이 글은 한 편의 발표문이면서, 같은 날 함께 공개된 다섯 편의 글을 묶는 서문 역할도 합니다. @cloudflare/ci(Workflow 기반 CI/CD), 로컬 개발 환경의 OpenTelemetry 트레이스, Cloudflare Agents와 Agent Traces, AI로 엔지니어링 표준을 강제하는 사내 사례, 그리고 Astro 저장소의 GitHub 이슈를 0개로 줄이는 소프트웨어 팩토리 사례입니다. 이 게시물에서는 ADLC라는 문제 제기를 먼저 정리한 뒤, 함께 발표된 도구와 사례를 원문과 각 하위 글의 내용으로 함께 살펴봅니다.
Cloudflare는 이전부터 에이전트를 고객으로 대하는 기능을 꾸준히 내놓았습니다. 에이전트가 직접 도메인을 구매하고, 임시 계정을 만들고, Cloudflare API 전체를 사용하는 기능이 그 예입니다. PyTorchKR에서도 Cloudflare와 Stripe가 함께 만든 에이전트용 계정 생성 및 배포 프로토콜을 소개한 적이 있습니다. ADLC는 이러한 흐름을 코드 생성 이후의 모든 단계로 넓히겠다는 선언에 가깝습니다.
구현만 빨라진 SDLC: 병목이 뒤쪽 단계로 밀려나다
여러 프로그래머가 하나의 코드베이스에서 함께 일하는 방법은 수십 년 동안 다듬어져 왔습니다. 원문은 그 뿌리를 RAND 연구소(RAND Corporation)가 1975년에 발표한 보고서의 "시스템 개발 수명 주기(Systems Development Lifecycle)"에서 찾습니다. 오늘날에는 소프트웨어 개발 수명 주기(Software Development Lifecycle, SDLC) 라고 부르며, 다음 7단계로 정의합니다.
- 계획(Plan)
- 설계(Design)
- 구현(Implement)
- 테스트(Test)
- 배포(Deploy)
- 유지보수(Maintain)
- 폐기(Retire)
AI 코딩 도구는 이 중 3단계인 구현을 가장 빠르고 싼 단계로 만들었습니다. 문제는 그 효과가 아래쪽 단계에 부담으로 전가된다는 점입니다. 원문은 수천 개의 풀 리퀘스트(Pull Request)와 이슈에 파묻힌 오픈소스 메인테이너, 그리고 소프트웨어가 배포되는 속도가 몇 자릿수씩 빨라지면서 프로덕션이 무너지지 않도록 버티는 운영 엔지니어를 예로 듭니다. 원문의 표현을 빌리면 "우리 모두는 시스템과 고객, 그리고 우리 자신을 슬롭(slop)으로부터 지키려 애쓰고 있습니다."
아래 그림은 원문에 실린 도식으로, SDLC 단계별로 AI가 가져온 처리량 증가(파란색)와 사람이 짊어지는 부담(주황색)을 비교합니다. 구현 단계에서는 AI의 처리량 증가가 가장 크고 사람의 부담은 가장 작지만, 테스트부터 폐기까지의 단계에서는 AI의 기여가 작고 사람의 부담이 크게 남아 있습니다.
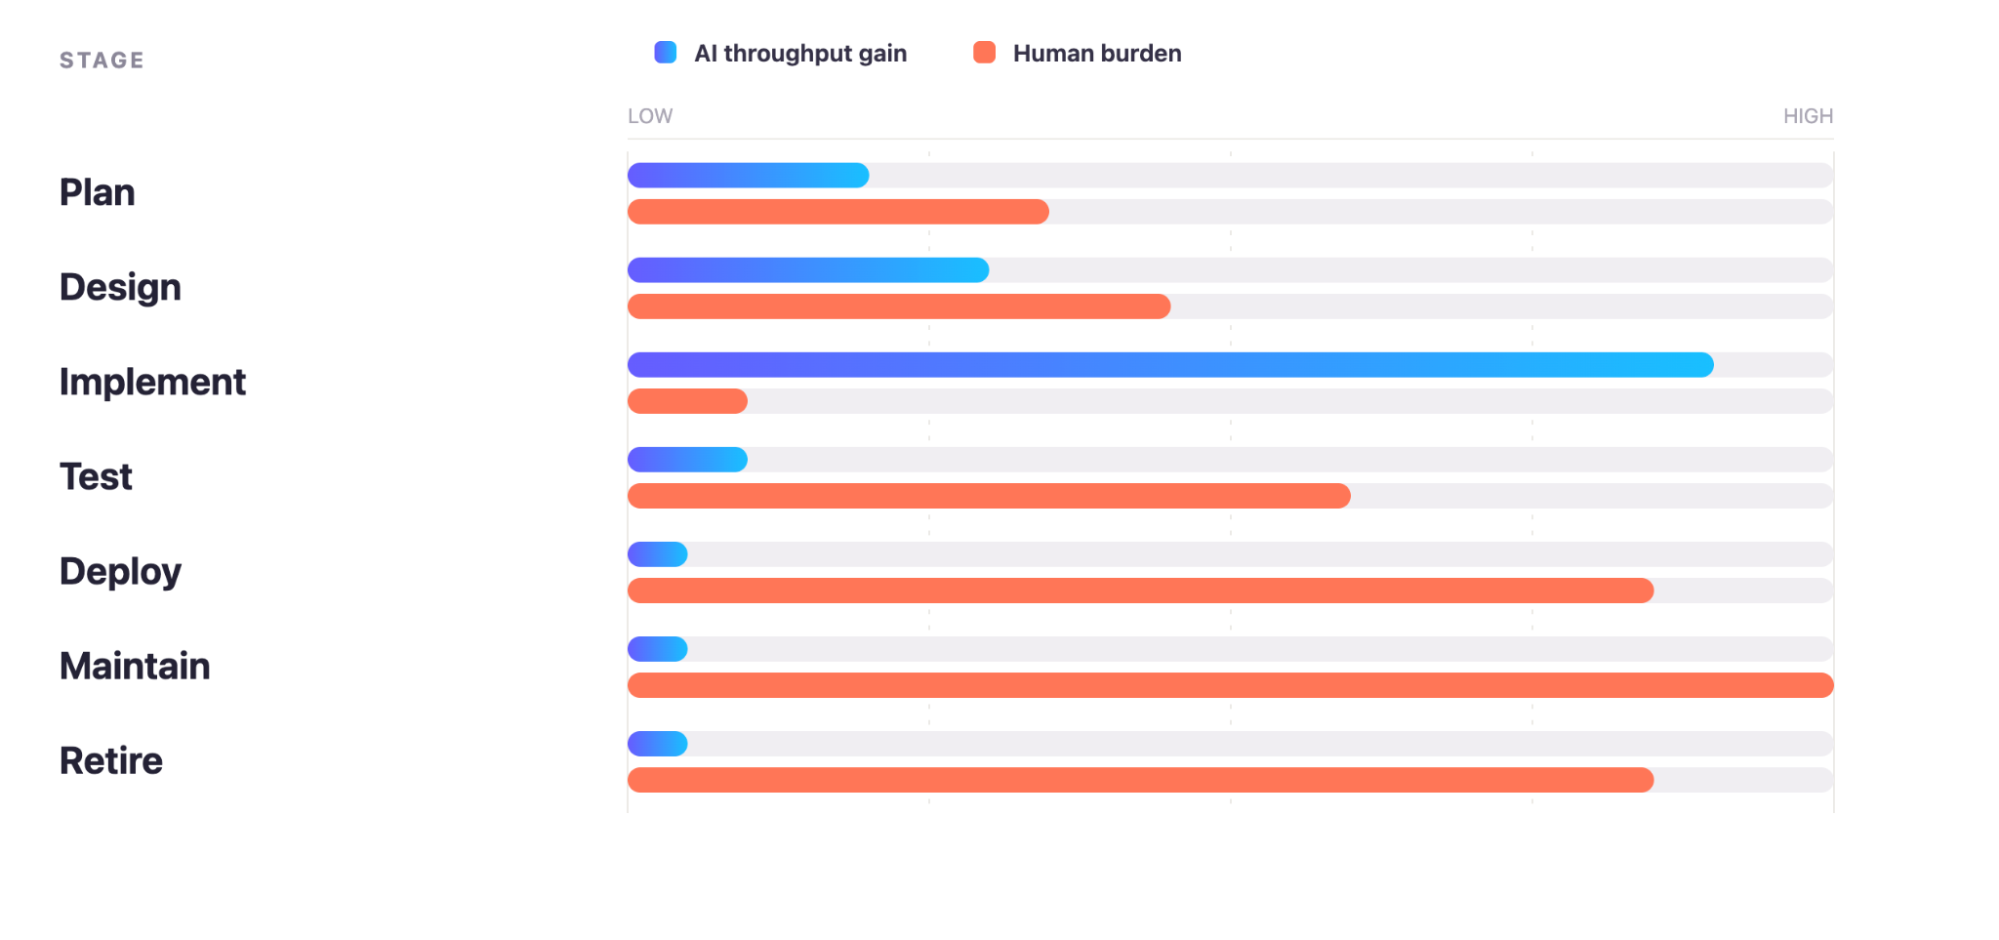
이 도식은 정량 측정 결과가 아니라 저자의 주장을 시각화한 개념도라는 점을 감안해서 읽어야 합니다. 그럼에도 메시지는 분명합니다. 코드를 더 빨리 만드는 도구만으로는 전체 속도가 빨라지지 않고, 병목이 구현에서 테스트와 배포, 운영으로 옮겨 갈 뿐이라는 것입니다. 원문은 여기서 한 걸음 더 나아가, 자동화를 아무리 잘 갖춰도 SDLC의 전제 자체가 에이전트가 만들어 내는 코드의 양과 속도를 감당하도록 설계되지 않았으므로 ADLC로 대체할 때가 되었다고 주장합니다.
SDLC는 소프트웨어 팀을 위한 것, ADLC는 소프트웨어 팩토리를 위한 것
최근 개발자 커뮤니티에서 자주 오르내리는 말 중 하나가 소프트웨어 팩토리(Software Factory) 입니다. 입력을 받아 소프트웨어를 자율적으로 만들고, 개선하고, 배포하고, 관리하는 에이전트 기반 시스템을 뜻합니다. 입력은 프로덕션 에러일 수도, 고객의 버그 리포트일 수도, 새로운 기능 아이디어일 수도 있으며, 이를 통째로 에이전트에게 위임하는 것이 목표입니다. PyTorchKR에서도 매주 1,300개의 PR을 사람 코드 없이 만드는 Stripe의 무인 코딩 에이전트 Minions나 작업 절차를 그래프로 정의해 실행하는 오케스트레이터 Fabro처럼 비슷한 방향의 시도를 소개한 바 있습니다.
그러나 에이전트를 쓰더라도 대부분의 소프트웨어 프로젝트는 여전히 사람이 개입하는 휴먼 인 더 루프(Human-in-the-loop) 단계에 묶여 있습니다. 사람이 에이전트에게 프롬프트를 주고, 계속 진행하라고 말하고, 코드 리뷰 피드백을 반영하라고 지시하며, 여러 에이전트를 끊임없이 돌봐야 합니다. 원문은 이를 "대부분의 팀에서 SDLC의 각 단계는 여전히 사람이 관리하고, 달라진 것은 각 단계 안의 작업을 에이전트에게 위임한다는 점뿐"이라고 정리합니다.
소프트웨어 팩토리의 꿈은 이 구조를 뒤집는 것입니다. 소프트웨어를 만드는 과정 전체를 위한 공장을 짓고, 사람의 시간은 영감, 취향, 판단이 정말 필요한 일로 옮기자는 것입니다. 원문은 그렇게 되면 설계하고, 고객과 이야기하고, 더 큰 꿈을 꿀 시간이 늘어날 것이라고 말합니다.
에이전트가 운전하려면 필요한 7가지 조건
소프트웨어 팩토리도 결국 SDLC와 같은 단계를 거쳐야 하지만, 그 기반이 되는 플랫폼에 훨씬 많은 것을 요구합니다. 사람에게 의존하던 모든 수작업 단계를 다음 7가지 성질을 갖도록 바꿔야 한다는 것이 원문의 주장입니다.
프로그래밍 가능해야 함 (Programmatic): 대시보드를 손으로 클릭하며 운영하는 이른바 ClickOps는 사람에게도 나쁜 관행이었지만 에이전트에게는 아예 불가능합니다. 모든 작업에는 에이전트가 호출하고, 디버깅하고, 의존할 수 있는 API가 있어야 합니다.
수평 확장이 가능해야 함 (Horizontally scalable): 사람이 화면을 보며 개발하던 시절에는 프리뷰 배포(preview deployment)가 있으면 좋은 기능 정도였고, 프로덕션 전에 스테이징 서버 하나를 잡아 두고 문제를 확인하면 충분했습니다. 에이전트가 운전하려면 에이전트마다 프로덕션과 일치하는 자기만의 프리뷰 환경이 있어야 합니다.
재현 가능해야 함 (Reproducible): iPhone 15에서 4G 네트워크를 흉내 낼 때만, 또는 특정 국가의 IP에서 접속할 때만 재현되는 버그가 있다면 어떻게 할까요? 일반적인 단위 테스트와 통합 테스트 도구로는 이런 상황을 다루기 어렵습니다.
실시간, 푸시 기반이어야 함 (Real-time, push based): 사람이 알맞은 대시보드를 들여다보길 기대하는 방식은 원래도 좋지 않았지만 에이전트에게는 완전히 작동하지 않습니다. 에이전트가 일을 시작하도록 촉발하는 이벤트가 필요합니다.
원자적이어야 함 (Atomic): 모든 변경은 관련 없는 동작에 영향을 주지 않고 독립적으로 테스트하고, 릴리스하고, 관측하고, 되돌릴 수 있어야 합니다.
권한이 관리되어야 함 (Permissioned): 오늘날에도 일이 정말 잘못될 때를 대비해 믿을 만한 엔지니어 몇 명에게 프로덕션 SSH 접근 권한을 주곤 합니다. 에이전트에게 그런 권한을 그대로 줄 수는 없지만, 필요할 때 권한을 상승(escalate)할 방법이 없다면 에이전트는 제 일을 할 수 없습니다.
스스로 개선되어야 함 (Self-improving): 사람은 경험에서 배웁니다. 첫 배포 주간이나 첫 온콜 로테이션에서는 느리고 누군가를 따라다녀야 하지만, 점점 더 나아지고 빨라집니다. 에이전트에게도 경험에서 배울 방법이 필요합니다.
원문은 소프트웨어 팩토리가 자율주행차 같은 다른 자율 시스템과 같은 과제에 직면해 있다고 봅니다. 80%의 확률로 성공하는 수준에서, 99% 뒤에 9가 여러 개 붙는 수준으로 올라가야 한다는 과제입니다.
사람을 위해 설계된 차로는 에이전트가 운전할 수 없다
원문은 이 과제를 자율주행차에 빗대어 설명합니다. 자율주행차에는 일반 자동차에 없는 라이다(LiDAR) 센서, 카메라, 추론(inference)을 실행하는 강력한 컴퓨팅, 그리고 필요할 때 원격으로 제어를 넘겨받을 수 있는 중앙 관제 시스템과의 연결이 들어 있습니다. 사람 운전자의 80% 수준에 도달하는 데는 이 모든 것이 필요하지 않을 수도 있고, 실제로 자율주행은 10년 전에 이미 그 수준에 도달했습니다. 그러나 기계에 운전대를 맡기고 고속도로에서 낮잠을 자려면, 사람보다 훨씬 낫고 안전해야 합니다. 자율주행차에 자율주행 전용 기술이 실리는 이유가 바로 그것입니다.
원문은 이 비유를 소프트웨어로 가져와 독자에게 질문을 던집니다. "왜 아직 에이전트가 자신이 만든 PR을 스스로 승인하고 프로덕션 서비스에 병합하도록 두지 않았습니까?" 다루는 시스템의 중요도가 높을수록 그 이유의 목록도 길어질 것입니다.
그 목록을 풀어 보면 매우 복잡합니다. 치명적으로 잘못될 수 있는 일들뿐 아니라, 고객을 위해 올바른 것을 만드는 데 필요한 일들까지 포함되기 때문입니다. 원문은 이것이 GitHub Actions YAML 파일 속의 선형적인 단계 목록에 들어맞지 않고, 전통적인 자동화 테스트의 범위도 훨씬 넘어선다고 지적합니다. 대시보드의 작은 변경조차 여러 역할과 전문 분야, 조직 구조에 걸쳐 있으며, 주관적인 변경일수록 테스트하기도, 위임하기도 어렵습니다. 이런 일들 대부분은 오늘날 CI/CD 파이프라인에 들어 있지 않지만, 에이전트에게 소프트웨어 팩토리의 전권을 주면서도 계속 일어나게 하려면 파이프라인 안으로 들어와야 합니다.
그래서 원문이 내놓는 답은 워크플로우(Workflow) 입니다. 컨테이너, 에이전트, 브라우저를 띄울 수 있고, 기능 플래그를 설정해 테스트 사용자에게만 켜 보고, 로그와 트레이스를 조사하고, 변경이 점진적으로 롤아웃되는 동안 프로덕션 지표를 관찰하는 등 안전하게 배포하는 데 필요한 모든 일을 하는 워크플로우입니다.
CI/CD 파이프라인은 Workflow일 뿐, 하지만 Workflow는 그 이상이다
Cloudflare Workflows는 여러 단계를 연결하고, 실패한 작업을 자동으로 재시도하며, 상태를 몇 분에서 몇 주까지 유지할 수 있는 지속 실행(Durable Execution) 기반의 오케스트레이션 도구입니다. 복잡하고 동적인 비즈니스 프로세스를 이해하기 쉬운 프로그램으로 표현하도록 설계되었습니다. 원문은 이 Workflows와 수백만 개 저장소 규모로 확장되는 버전 관리형 코드 저장소 Artifacts를 함께 쓰면 CI/CD 파이프라인을 정의하고 실행하는 일이 근본적으로 단순해진다고 설명합니다.
@cloudflare/ci: TypeScript로 작성하는 CI 파이프라인
함께 발표된 @cloudflare/ci는 CI의 각 단계를 Workflow의 step.do() 한 단계로 옮기는 SDK입니다. 하위 글에 따르면, GitHub Actions처럼 YAML로 정의한 CI/CD는 금방 복잡해지는데, 결국 CI/CD 파이프라인은 정해진 순서대로 단계를 실행하다 하나라도 실패하면 멈추고 에러를 보고하는 일련의 단계일 뿐이므로 Workflow로 그대로 표현할 수 있다는 것입니다. 각 명령은 Sandbox SDK 위의 격리된 환경에서 실행되고, Artifacts 저장소에 푸시가 일어나면 Workflow 인스턴스가 자동으로 시작됩니다.
원문에 실린 예시는 다음과 같습니다. install 단계에서 의존성을 한 번 설치해 캐시한 뒤, 린트, 테스트, 타입 검사, 빌드를 병렬로 실행하고, 모두 통과하면 배포합니다.
import { CIWorkflow } from `@cloudflare/ci`

const deps: CiRunnerResult = await ci.runner({
      name: 'install',
      command: 'bun install --frozen-lockfile',
      cache: { inputs: ['package.json', 'bun.lock'] },
    });

    await Promise.all([
      deps.runner({ name: 'lint', command: 'bun run lint' }),
      deps.runner({ name: 'test', command: 'bun run test' }),
      deps.runner({ name: 'typecheck', command: 'bun run typecheck' }),
      deps.runner({ name: 'build', command: 'bun run build' }),
    ]);

    await deps.runner({
      name: 'deploy',
      command: 'bun wrangler deploy',
      cloudflareCredentials: {
        accountId: this.env.CLOUDFLARE_DEPLOY_ACCOUNT_ID,
      },
    });
install 단계의 캐시는 샌드박스 스냅샷으로 만들어져 사용자 계정의 R2 버킷에 저장되므로, 이후 단계들은 의존성을 다시 설치하지 않고 같은 스냅샷에서 출발합니다. Workflow의 단계는 기본적으로 독립적으로 시작되므로, Promise.all()로 묶으면 네 가지 검사가 동시에 실행되고 모두 끝난 뒤에야 배포 단계로 넘어갑니다. 계정 자격 증명은 cloudflareCredentials로 배포 단계에만 넘기므로, 공식 가이드 설명대로 API 토큰에 접근할 수 있는 단계를 배포로 한정할 수 있습니다. 앞서 본 7가지 조건 중 권한 관리에 해당하는 부분입니다. 다만 저장소 README는 러너 명령이 재시도 가능한 Workflow 단계 안에서 실행되므로, 외부에 부수 효과를 남기는 명령은 멱등(idempotent)하게 작성해야 한다고 안내합니다.
스스로 고치는 CI: Self-healing 파이프라인
YAML 대신 코드로 CI를 작성하면 파이프라인 안에서 에이전트를 부를 수 있습니다. 하위 글은 빌드 단계가 실패하면 에이전트가 원인을 고쳐 수정 커밋을 푸시하고 사람의 승인을 기다리는 자가 치유(Self-healing) CI를 예로 듭니다. 아래 도식은 그 흐름입니다. 푸시 트리거로 CI Workflow가 시작되면(1), 각 단계는 Artifacts 저장소를 복제한 샌드박스에서 명령을 실행하고 결과를 돌려받습니다(2~6). 앞 단계의 샌드박스는 스냅샷으로 다음 단계에 이어집니다. 2단계에서 에러가 나면 실패 정보가 AI 치유 에이전트(AI Healing Agent)에게 전달되고(7), 에이전트는 수정 사항을 커밋해 Artifacts 저장소에 푸시합니다(8).
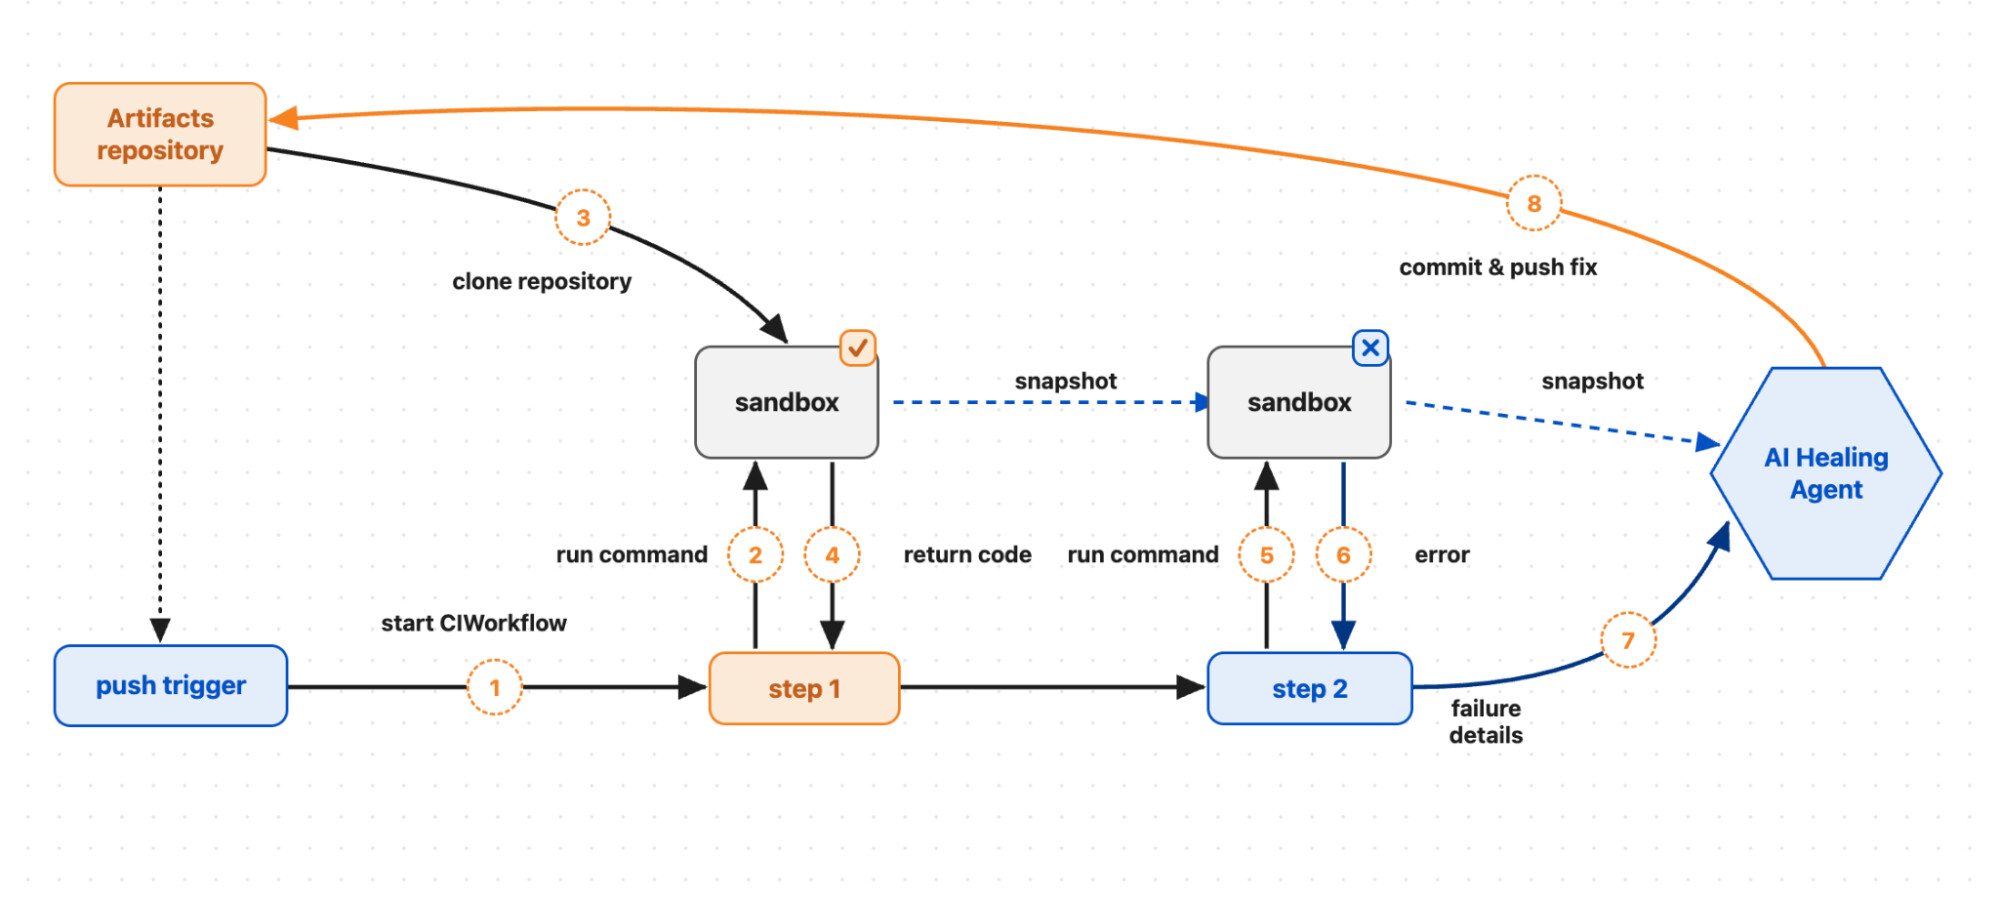
치유 에이전트는 Cloudflare의 에이전트 하네스인 Think로 만들며, HealingAgent 클래스를 상속하고 사용할 모델을 지정합니다. HealingAgent 는 self-healing 예시에 들어 있는 Think 기반 클래스로, @cloudflare/ci 패키지 자체에는 치유 에이전트와 그 도구, AI 의존성이 포함되어 있지 않습니다. 하위 글의 예시는 Workers AI의 @cf/moonshotai/kimi-k2.7-code 모델을 사용합니다.
export class Healer extends HealingAgent {
 getModel() {
   return '@cf/moonshotai/kimi-k2.7-code';
 }
}
그리고 CI 단계를 try/catch로 감싸, 러너가 보고한 실패일 때만 치유 에이전트를 호출합니다. 치유 단계에는 재시도 없이 최대 5시간의 제한 시간이 걸려 있고, 에이전트에게는 "검증을 약화시키지 않고 관찰된 모든 실패를 고치라"는 프롬프트가 주어집니다. 눈여겨볼 점은 원래 CI 실행은 실패 상태로 남고, 검증된 수정은 별도 브랜치에 올라간다는 점입니다. 에이전트가 테스트를 지우거나 검사를 끄는 식으로 "통과"를 만들어 내는 것을 막기 위한 설계로 읽힙니다.
let deps: CiRunnerResult;
try {
  // Install once, then run independent checks from the shared and cached snapshot
  deps = await ci.runner({
    name: 'install',
    command: 'bun install --frozen-lockfile',
    cache: { inputs: ['package.json', 'bun.lock'] },
  });

  await Promise.all([
    deps.runner({ name: 'lint', command: 'bun run lint' }),
    deps.runner({ name: 'test', command: 'bun run test' }),
    deps.runner({ name: 'typecheck', command: 'bun run typecheck' }),
    deps.runner({ name: 'build', command: 'bun run build' }),
  ]);
} catch (failure) {
  // This catches both failed Sandbox commands and ordinary Workflow errors.
  // Only failures reported by a runner should be healed; rethrow the rest.
  if (!isCiRunnerFailure(failure)) {
    throw failure;
  }

  // Pass the error along to the agent so that it can fix it
  const healed = await step.do(
    'heal',
    { retries: { limit: 0, delay: 0 }, timeout: '5 hours' },
    async () => {
      const healer = await getAgentByName(this.env.HEALER, event.instanceId);
      using result = await healer.heal({
        failure: enrichFailure({ failure, event, baseBranch }),
        prompt: 'Fix every observed failure without weakening validation.',
      });
      // Report the Fix Branch, its commit, and how many steps it took.
      const { branch, commit, steps } = result;
      return { branch, commit, steps };
    }
  );

  // The source run stays failed; its verified fix lives on another branch
  throw new CiRunFailedWithFix(failure, healed);
}

await deps.runner({
  name: 'deploy',
  command: 'bun wrangler deploy',
});
하위 글은 CI를 Workflow로 실행하면 세 가지를 자동으로 얻는다고 정리합니다. 첫째, 단계가 실패해도 상태가 보존된 채 재시도되고 특정 단계부터 다시 시작할 수 있는 지속 실행입니다. 둘째, Workflows 대시보드에서 각 단계의 입력과 출력, 실행 시간을 확인할 수 있는 관측성입니다. 셋째, 코드로 표현할 수 있는 것은 무엇이든 단계로 넣을 수 있는 유연성입니다. 이는 Artifacts 비공개 베타에 참여해야 쓸 수 있는 기능이며, 향후 계획으로는 Workers용 프리뷰 및 배포 기본 기능, Workflow로 관리하는 점진적 배포, 모노레포 지원, Artifacts 외 버전 관리 시스템의 푸시 이벤트 지원이 언급되어 있습니다.
Workflow 안에서 에이전트를 부르기: Flue
Workflow는 선형적인 단계 목록에 그치지 않습니다. 동적으로 정의할 수 있고, 에이전트나 다른 Workflow를 띄울 수도 있습니다. 원문은 모델과 배포 환경을 가리지 않는 TypeScript 기반 오픈 에이전트 프레임워크 Flue 문서에 실린 예시를 소개합니다. 매일 밤 전날의 데이터를 모아 리뷰 에이전트에게 넘기는 Workflow로, Workflow가 에이전트에게 언제, 어떻게 프롬프트를 줄지 완전히 통제하고 단계 사이에 컨텍스트를 전달합니다.
import { WorkflowEntrypoint, type WorkflowEvent, type WorkflowStep } from 'cloudflare:workers';
import { init } from '@flue/runtime';
import { Reviewer } from './agents/reviewer.ts';
import { collectFindings } from './shared/nightly.ts';

type Params = { date: string };

export class NightlyReview extends WorkflowEntrypoint {
  async run(event: WorkflowEvent<Params>, step: WorkflowStep) {
    const findings = await step.do('collect findings', () => collectFindings(event.payload.date));

    const agent = init(Reviewer, { id: `nightly-${event.payload.date}` });

    const receipt = await step.do('dispatch review', () =>
      agent.dispatch(`Review these findings:\n${findings}`),
    );

    const review = await step.do('read review', async () => {
      const reply = await agent.read(receipt);
      return { text: reply.text, data: reply.data };
    });

    // ...
  }
}
이 패턴에 익숙해지면 자연스럽게 다음 질문이 떠오릅니다. 사람이 병목인 다른 단계 중 Workflow와 Flue 에이전트의 조합에 맡길 수 있는 것은 무엇일까요? 원문은 스스로를 Workflow에 푹 빠진(Workflow-pilled) 회사라고 부르며 이 질문을 독자에게 던집니다.
@cloudflare/ci와 Flue 더 알아보기
Run CI/CD for millions of repos, on your platform, on Cloudflare - Cloudflare Blog
Workflows CI guide: Build and deploy on push - Cloudflare Docs
Self-healing CI 예시 코드
Cloudflare 스택으로 구성한 ADLC: 단계별 도구 지도
원문은 Workflows가 복잡한 단계를 조율하고 Artifacts가 코드 저장 계층을 맡으면, 에이전트가 소프트웨어를 만들고, 배포하고, 유지보수하는 전 과정을 소유하는 데 필요한 것이 모두 Cloudflare에 있다고 주장합니다. 원문의 표를 한국어로 옮기면 다음과 같습니다.
| SDLC 단계 | Cloudflare 도구 | 에이전트에게 주는 것 |
|---|---|---|
| 계획, 설계, 구현 | Vite, Rolldown, Oxc | 에이전트를 위한 빠른 툴체인 |
| 모든 것을 로컬에서 개발 | 로컬에서 보는 환경이 프로덕션과 같은 런타임 | |
| Local Explorer, Local Traces | 프로덕션과 같은 디버깅 API를 로컬에서 사용 | |
| Remote bindings | 코드는 로컬에서 실행하되 실제 프로덕션 리소스 사용 | |
| Preview URLs | 모든 PR에 에이전트가 검증할 프리뷰 제공 | |
| 테스트 | Browser Run | 클라우드의 프로그래밍 가능한 헤드리스 브라우저 |
| Vitest 통합 | Workers 런타임 안에서 테스트 실행 | |
| 배포 | Flagship | 모든 변경에 개별 기능 플래그 부여 |
| Gradual Deployments | 트래픽의 일부에만 배포한 뒤 점차 확대 | |
| 유지보수, 폐기 | Workers Logs | 실시간 로그를 보거나 필요할 때 조회해 자동 수정할 문제 발견 |
| Agent Traces | 모든 에이전트 세션을 기록해 개선에 활용 | |
| Cloudflare MCP Server | Code Mode와 Dynamic Workers 기반의 API 접근 | |
| Analytics Engine | ClickHouse 기반 고카디널리티 분석으로 누가 무엇을 쓰는지 조회 |
표에 등장하는 도구 중 Browser Run과 Dynamic Workers는 PyTorchKR에서도 따로 소개한 적이 있습니다. 앞서 살펴본 7가지 조건과 연결해 보면, Preview URLs는 수평 확장, Browser Run은 재현성, Flagship과 Gradual Deployments는 원자성, Agent Traces는 자기 개선에 대응한다고 볼 수 있습니다. 아래에서는 이번에 함께 발표된 로컬 트레이스와 Agent Traces, 그리고 원문이 배포 단계의 핵심으로 꼽은 Flagship을 조금 더 자세히 살펴봅니다.
로컬 개발에서도 프로덕션 수준의 관측성: Local Traces
하위 글에 따르면, 이제 wrangler dev와 vite dev는 로컬에서 실행되는 Worker 호출의 OpenTelemetry 트레이스를 자동으로 수집합니다. 개발 서버가 코딩 에이전트 세션을 감지하면 로컬 디버깅용 Local Explorer API 의 주소를 출력해 에이전트에게 알려 줍니다. SDK 설치나 트레이싱 설정, 에이전트 설정은 물론 프롬프트에서 관측성을 언급할 필요도 없습니다. API 루트가 OpenAPI 스키마를 제공하므로 에이전트는 미리 작성된 지시 없이도 실행 중에 사용 가능한 엔드포인트를 찾아낼 수 있습니다.
하위 글의 예시는 POST /api/orders 엔드포인트가 스키마 변경 후 500 에러를 반환하는 상황입니다. 트레이스가 없다면 에이전트는 KV, D1, Queue 주변에 로그를 추가하고 다시 요청하는 과정을 반복하며 토큰을 소모합니다. 트레이스가 있으면 KV 읽기는 성공했고, D1 삽입이 no such column: delivery_window 에러로 실패했으며, Queue는 호출되지 않았다는 사실을 한 번에 확인할 수 있습니다. 에이전트는 저장소에 있던 마이그레이션이 로컬에 적용되지 않았음을 찾아 적용하고, 다시 요청해 새 트레이스로 수정 결과를 검증합니다.
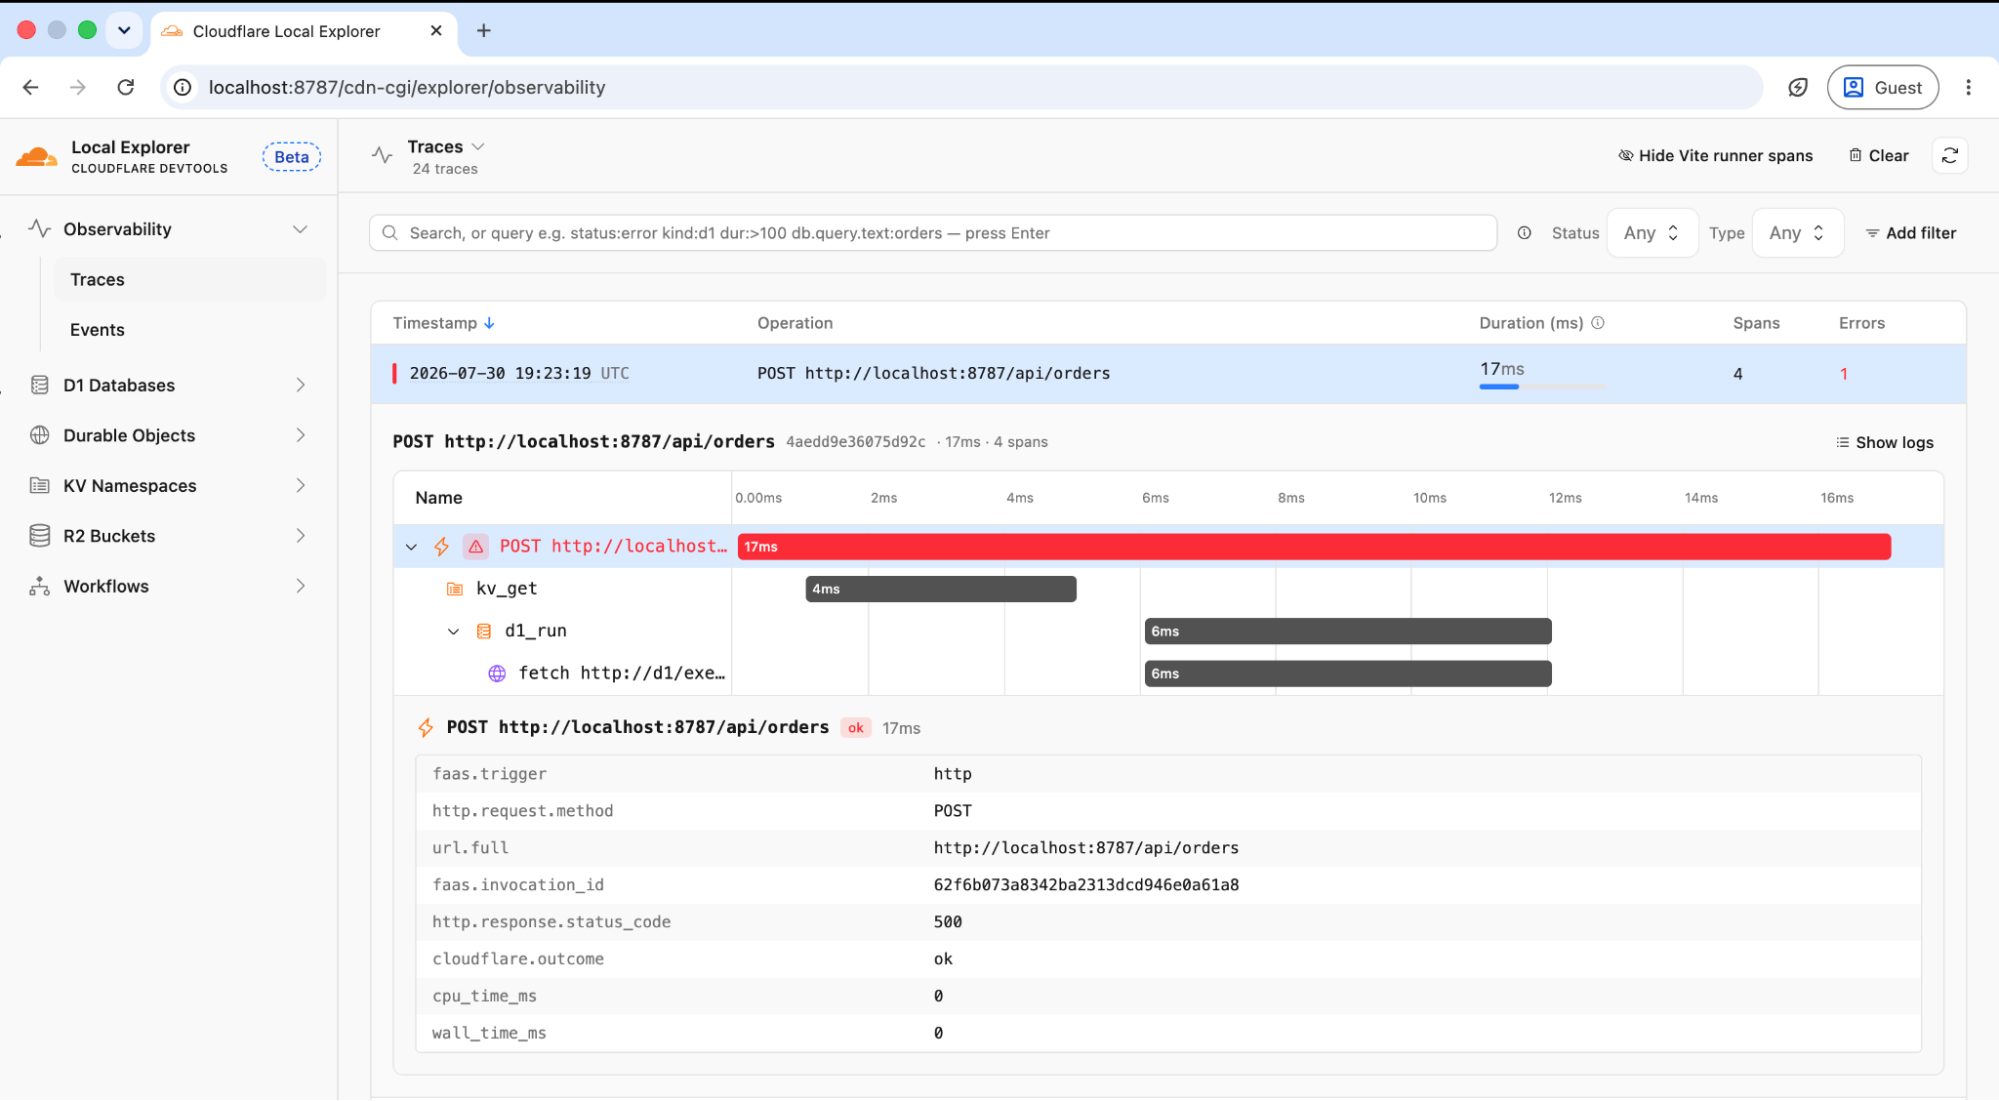
이 기능은 Workers의 오픈소스 런타임인 workerd에 내장된 계측 기능을 기반으로 합니다. 런타임은 코드 변경 없이 외부 HTTP 호출, KV, R2, D1, Durable Objects, Queues 같은 바인딩 호출, 그리고 핸들러 호출의 스팬(span)을 수집합니다. Miniflare가 이를 OpenTelemetry 트레이스와 로그로 묶어 로컬 트레이스 저장소에 기록하고, Local Explorer API가 이를 에이전트에게 노출합니다. 앞서 살펴본 7가지 조건 중 재현성과 프로그래밍 가능성을 로컬 개발 단계에서 충족시키는 기능입니다.
배포를 켜고 끄는 스위치: Flagship 기능 플래그
Flagship은 이번 발표보다 앞선 2026년 4월에 공개된 Cloudflare의 네이티브 기능 플래그(Feature Flag) 서비스로, CNCF의 기능 플래그 평가 개방형 표준인 OpenFeature를 기반으로 합니다. Workers, Node.js, Bun, Deno, 브라우저에서 모두 동작하지만, Workers에서는 바인딩을 통해 요청을 처리하는 위치의 KV에서 플래그 설정을 바로 읽어 HTTP 왕복 없이 평가하므로 가장 빠릅니다. 앞의 표에 함께 나온 Gradual Deployments가 서로 다른 Worker 버전 사이로 트래픽을 나누는 방식이라면, Flagship의 비율 롤아웃은 같은 코드 안에서 userId 같은 사용자 속성의 해시로 동작을 나눕니다.
Flagship 발표 글은 에이전트 시대의 기능 플래그 활용법을 이렇게 설명합니다. 에이전트가 새 코드 경로를 플래그 뒤에 두고 배포하면, 플래그가 꺼져 있으므로 사용자에게는 아무 변화가 없습니다. 에이전트는 자신이나 소규모 테스트 그룹에게만 플래그를 켜서 프로덕션에서 기능을 실행해 보고 결과를 관찰합니다. 지표가 좋으면 롤아웃을 확대하고, 문제가 생기면 플래그를 끕니다. 사람은 모든 단계에 개입하지 않고 경계만 설정합니다. 7가지 조건 중 원자성에 해당하는 부분으로, 변경을 독립적으로 릴리스하고 되돌릴 수 있게 해 줍니다.
await OpenFeature.setProviderAndWait(
    new FlagshipServerProvider({ binding: env.FLAGS })
);
에이전트 자체를 관측하기: Cloudflare Agents와 Agent Traces
Cloudflare Agents는 Cloudflare에 배포된 에이전트 세션을 한곳에 모아 보여 주는 대시보드로, 첫 기능으로 에이전트 트레이싱(Agent Tracing) 을 출시했습니다. 발표 글은 "에이전트는 HTTP 200을 반환하면서도 실패할 수 있다"고 지적합니다. 잘못된 도구를 고르거나, 하위 에이전트에게 오래된 컨텍스트를 넘기거나, 재시도 루프에서 토큰을 낭비할 수 있기 때문입니다. 기존의 Workers 트레이싱은 fetch 호출이나 KV 읽기, D1 쿼리 같은 인프라 계층만 보여 주었고, 에이전트 트레이싱은 여기에 에이전트 호출, 모델 호출, 도구 실행, 승인 이벤트, 하위 에이전트 호출 스팬을 더합니다.
아래 화면은 발표 글에 실린 예시로, TravelPlanner 에이전트가 itinerary_builder 하위 에이전트에게 작업을 위임하고, 하위 에이전트가 모델을 호출하고, 도구를 실행하고, D1과 KV에 접근하는 과정이 하나의 워터폴로 표시됩니다. 상단에는 전체 소요 시간(2.73분)과 토큰 사용량(22,375개), 사용한 모델이 함께 나타납니다.
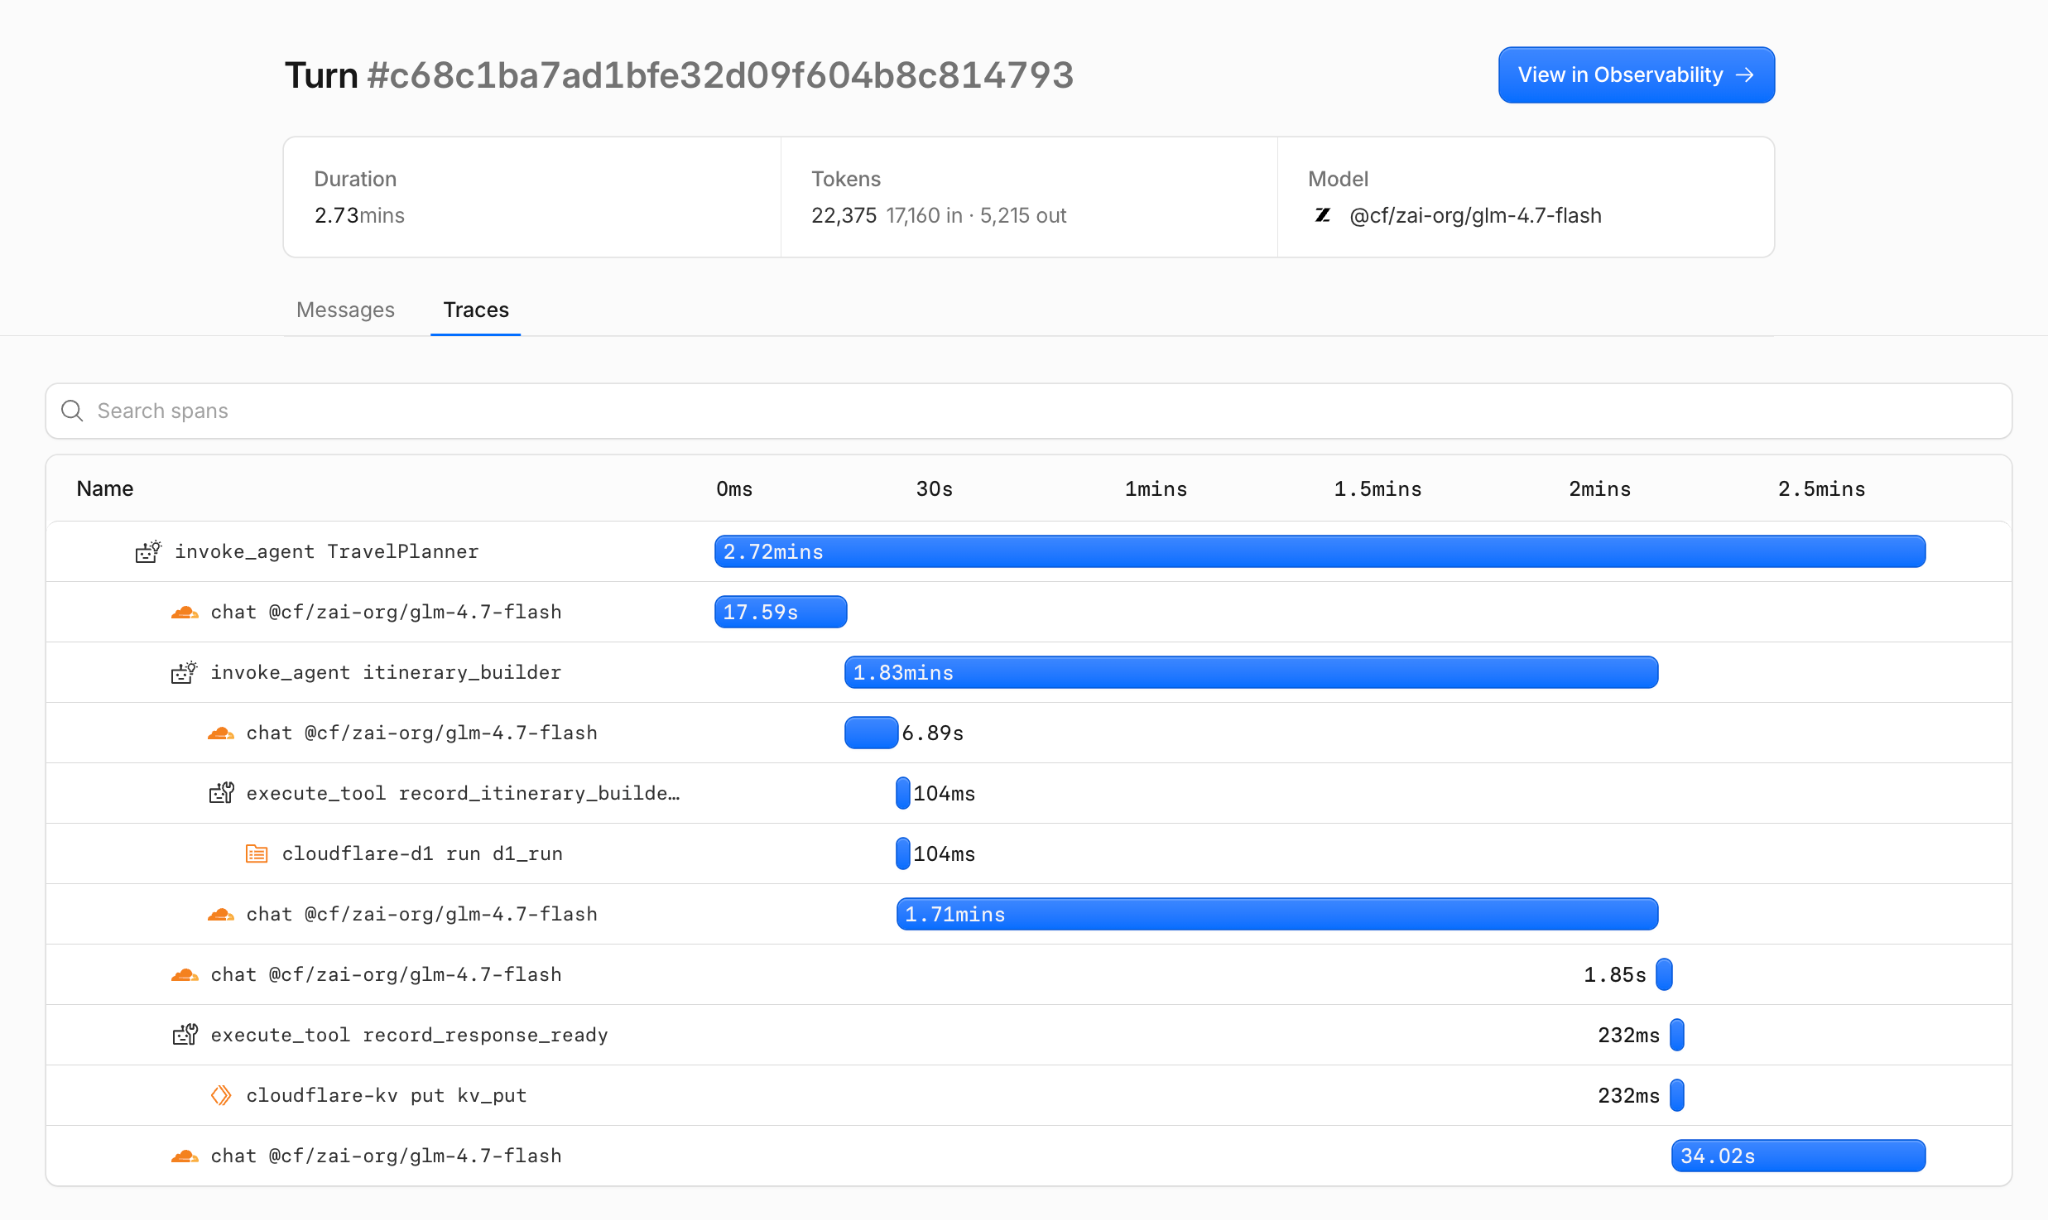
에이전트 트레이싱은 OpenTelemetry 호환 하네스인 Think, Flue, AI SDK를 지원하며, 직접 만든 하네스는 커스텀 스팬 API와 OpenTelemetry 생성형 AI 시맨틱 컨벤션을 따라 계측할 수 있습니다. 트레이스는 OTLP(OpenTelemetry Protocol) 호환 외부 서비스로 내보낼 수도 있습니다. 메시지와 도구 페이로드를 기록하는 기본값은 하네스마다 다릅니다. 공식 문서에 따르면 Think와 wrapAISDK()는 기본적으로 기록하지 않아 storeMessages, storeTools를 켜야 하고, Flue(v2 이상)는 기본으로 기록하므로 개인정보나 비밀 값이 포함될 수 있다면 직접 꺼야 합니다. 베타 기간 동안 트레이싱은 무료이며, 2026년 10월 1일부터 기존 Workers Observability 요금에 포함됩니다.
| 요금제 | 이벤트 | 보존 기간 |
|---|---|---|
| Workers Free | 하루 200,000건 | 3일 |
| Workers Paid | 월 2,000만 건 포함, 추가 100만 건당 $0.60 | 7일 |
원문은 이렇게 수집한 에이전트 트레이스를 ADLC에 연결하면 에이전트가 자율적으로 스스로를 개선할 수 있다고 봅니다. 7가지 조건의 마지막 항목인 자기 개선을 뒷받침하는 기반이 관측 데이터라는 관점입니다. PyTorchKR에서 소개한 LangChain의 에이전트 관측성용 데이터베이스 SmithDB도 같은 문제의식에서 출발한 사례입니다.
ADLC 스택 더 알아보기
Your agent can now debug Workers with local tracing - Cloudflare Blog
Introducing Flagship: feature flags built for the age of AI - Cloudflare Blog
Introducing: Cloudflare Agents - Cloudflare Blog
Agent tracing - Cloudflare Docs
Cloudflare가 직접 운영해 본 두 가지 사례
원문은 도구 발표와 함께, Cloudflare가 이 문제를 직접 풀면서 만들고 배운 것을 공유한다고 밝힙니다. 함께 공개된 두 편의 사례 글은 ADLC의 서로 다른 구간을 보여 줍니다. 하나는 사내 엔지니어링 표준을 설계부터 운영까지 에이전트가 검사하게 한 사례이고, 다른 하나는 오픈소스 프로젝트의 이슈 분류부터 수정까지를 자동화한 사례입니다.
엔지니어링 표준을 AI로 강제하기: Cloudflare Codex
첫 번째 사례의 중심에는 Cloudflare Codex 라는 사내 엔지니어링 표준 모음이 있습니다(OpenAI의 코딩 에이전트 Codex와는 무관합니다). 과거 Cloudflare의 개발 지침은 공식 문서, 저장소 파일, 채팅 스레드, 개별 엔지니어의 경험 등 여러 곳에 흩어져 있어, 엔지니어가 지침을 찾는 데 너무 많은 시간을 썼고 찾더라도 최신이고 권위 있는 내용인지 판단하기 어려웠습니다. Cloudflare는 이를 사람과 에이전트가 모두 작업 시점에 조회하고 적용할 수 있는 표준 모음으로 다시 만들었습니다.
Codex의 각 표준은 RFC(Request for Comments) 형식으로 작성되며, 요구 사항은 RFC 2119에 정의된 SHOULD와 MUST 키워드로 표현합니다. 아래 도식처럼 RFC는 작성, 자동 검사, 거버넌스, 승인, 강제의 5단계를 거칩니다. 자동 검사 단계에서는 에이전트가 RFC에서 SHOULD와 MUST 문장을 추출해 기계가 읽을 수 있는 JSON으로 만들고, 승인된 RFC는 차단 없이 위반만 표시하다가 명시적으로 강제(enforced) 상태로 승격된 뒤에야 MUST 위반을 차단합니다. 60개가 넘는 RFC 전체를 LLM의 컨텍스트에 넣는 대신 추출된 문장만 넘겨 관련 규칙을 정확히 찾게 한 것이 핵심입니다.
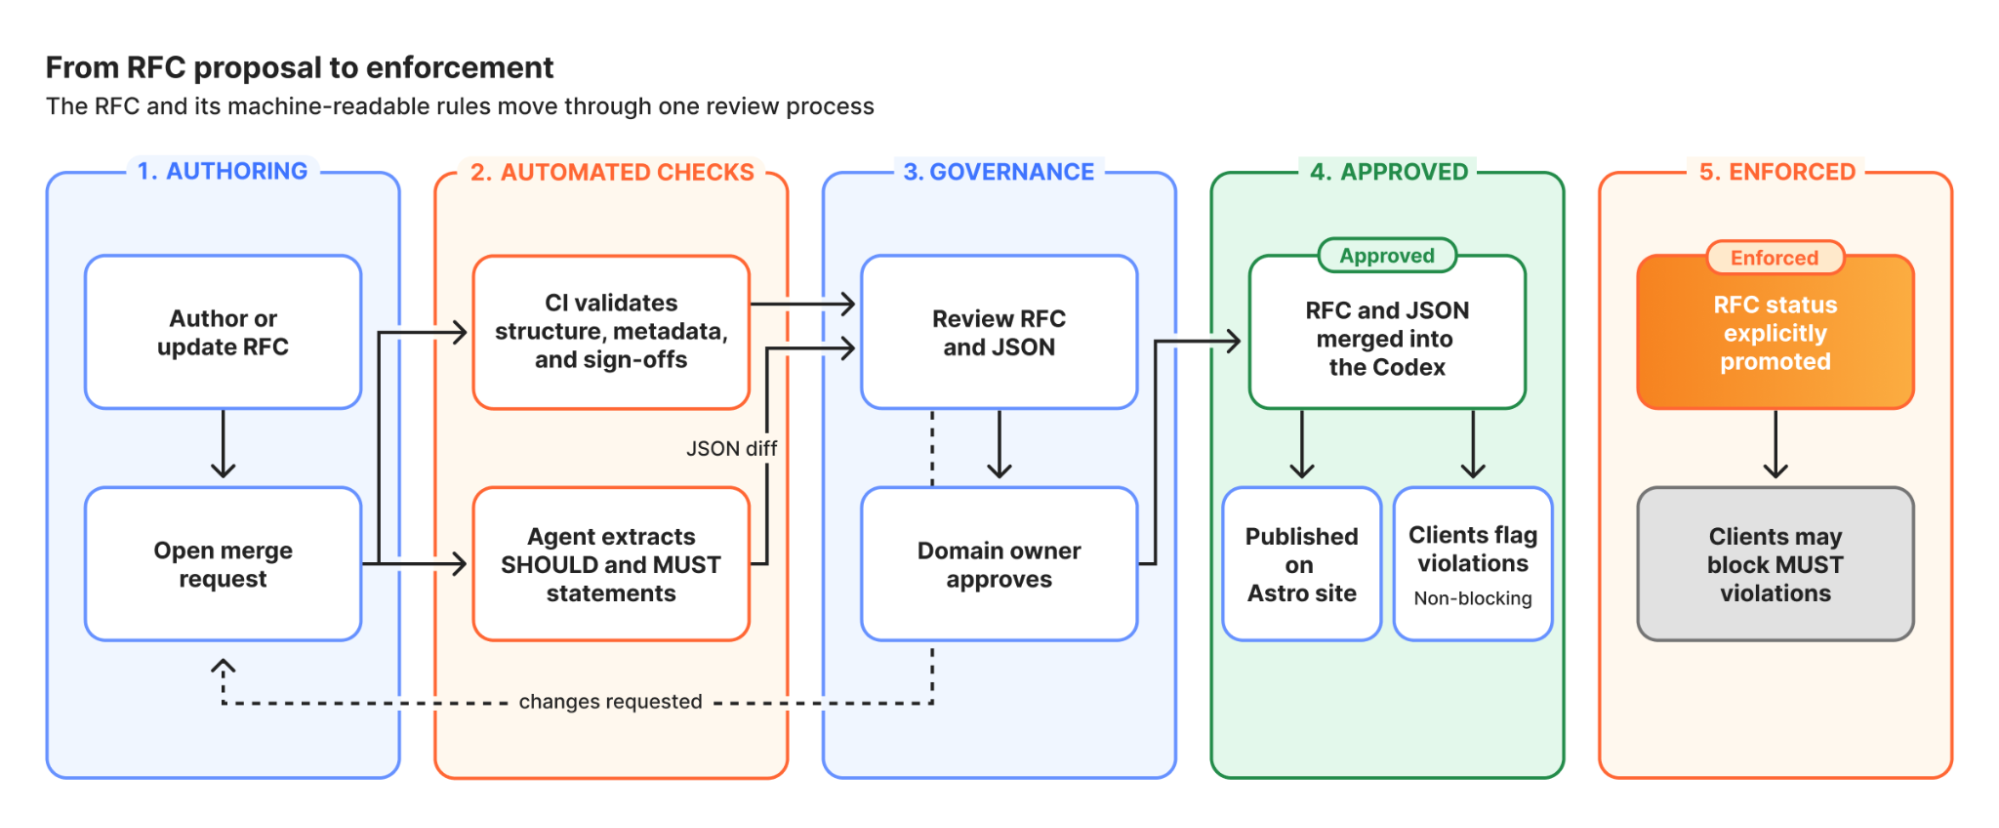
Codex를 사용하는 에이전트는 세 가지입니다. AI 코드 리뷰어 는 Codex 도입 이후 약 23만 건의 위반을 표시했고, 그중 약 16,000건은 강제 상태 RFC의 MUST 위반으로 승인을 보류했습니다. 스펙 리뷰어 는 2026년 5월 초부터 약 600개의 설계 문서를 검토했으며(재실행 포함 3,200회 이상), 발견 사항의 심각도는 major 65%, minor 29%, critical 6%였습니다. 인시던트 보고서 리뷰어 는 같은 기간 200건 이상의 포스트모템을 검토해 후속 조치 누락이나 불완전한 타임라인 같은 빈틈을 찾았습니다. 코드 리뷰가 몇 분씩 걸린다는 불만에는 기계적으로 검증할 수 있는 규칙을 oxlint 기반 린터 설정으로 만들어 밀리초 단위로 검사하고, OpenCode 기반 리뷰어를 로컬 CLI로 돌릴 수 있게 하는 방식으로 대응했습니다.
사례 글의 향후 계획에서 눈여겨볼 대목은 이 모델을 SDLC 전체로 확장하되, "에이전트가 점점 더 높은 자율성으로 문제를 찾고 수정을 제안하는 동안, 그 변경을 검토하고 승인할 책임은 엔지니어에게 남는다"고 명시한 부분입니다. ADLC가 곧 사람을 루프에서 완전히 빼는 것을 뜻하지는 않는다는 점을 보여 줍니다.
Astro의 GitHub 이슈를 0개로: 이슈 분류 소프트웨어 팩토리
두 번째 사례는 웹 프레임워크 Astro 팀의 이야기입니다. Astro를 만든 회사는 Cloudflare에 합류했습니다. Astro 팀은 몇 달 동안 들어오는 버그 리포트를 읽고, 샌드박스에서 재현하고, 근본 원인을 진단하고, 제보자가 확인할 수 있는 프리뷰 릴리스를 배포하는 자동 이슈 분류(Triage) 파이프라인을 운영했습니다. 그 결과 200개가 넘던 열린 이슈를 약 30개로 줄였고, 한 달 안에 5년이 넘는 저장소 역사상 처음으로 0개에 도달할 것으로 예상한다고 밝혔습니다. 오래된 이슈를 일괄 종료하거나 무시하는 방식이 아니었다는 점도 강조합니다.
분류 스킬은 메인테이너가 손으로 이슈를 처리하던 절차를 그대로 따릅니다. 재현(Reproduce), 진단(Diagnose), 검증(Verify), 수정(Fix)의 네 단계이며, 버그가 아닌데도 억지로 해결책을 만들어 내는 LLM의 경향을 막기 위해 각 단계를 격리된 하위 에이전트가 실행하고 발견 내용을 report.md 파일로 다음 단계에 넘깁니다. 파이프라인 전체는 이슈 라벨로 움직이는 상태 기계(state machine)이며, 라벨 전이 외에 별도의 상태를 저장하지 않고 이슈의 기존 댓글을 읽어 현재 위치를 파악합니다.
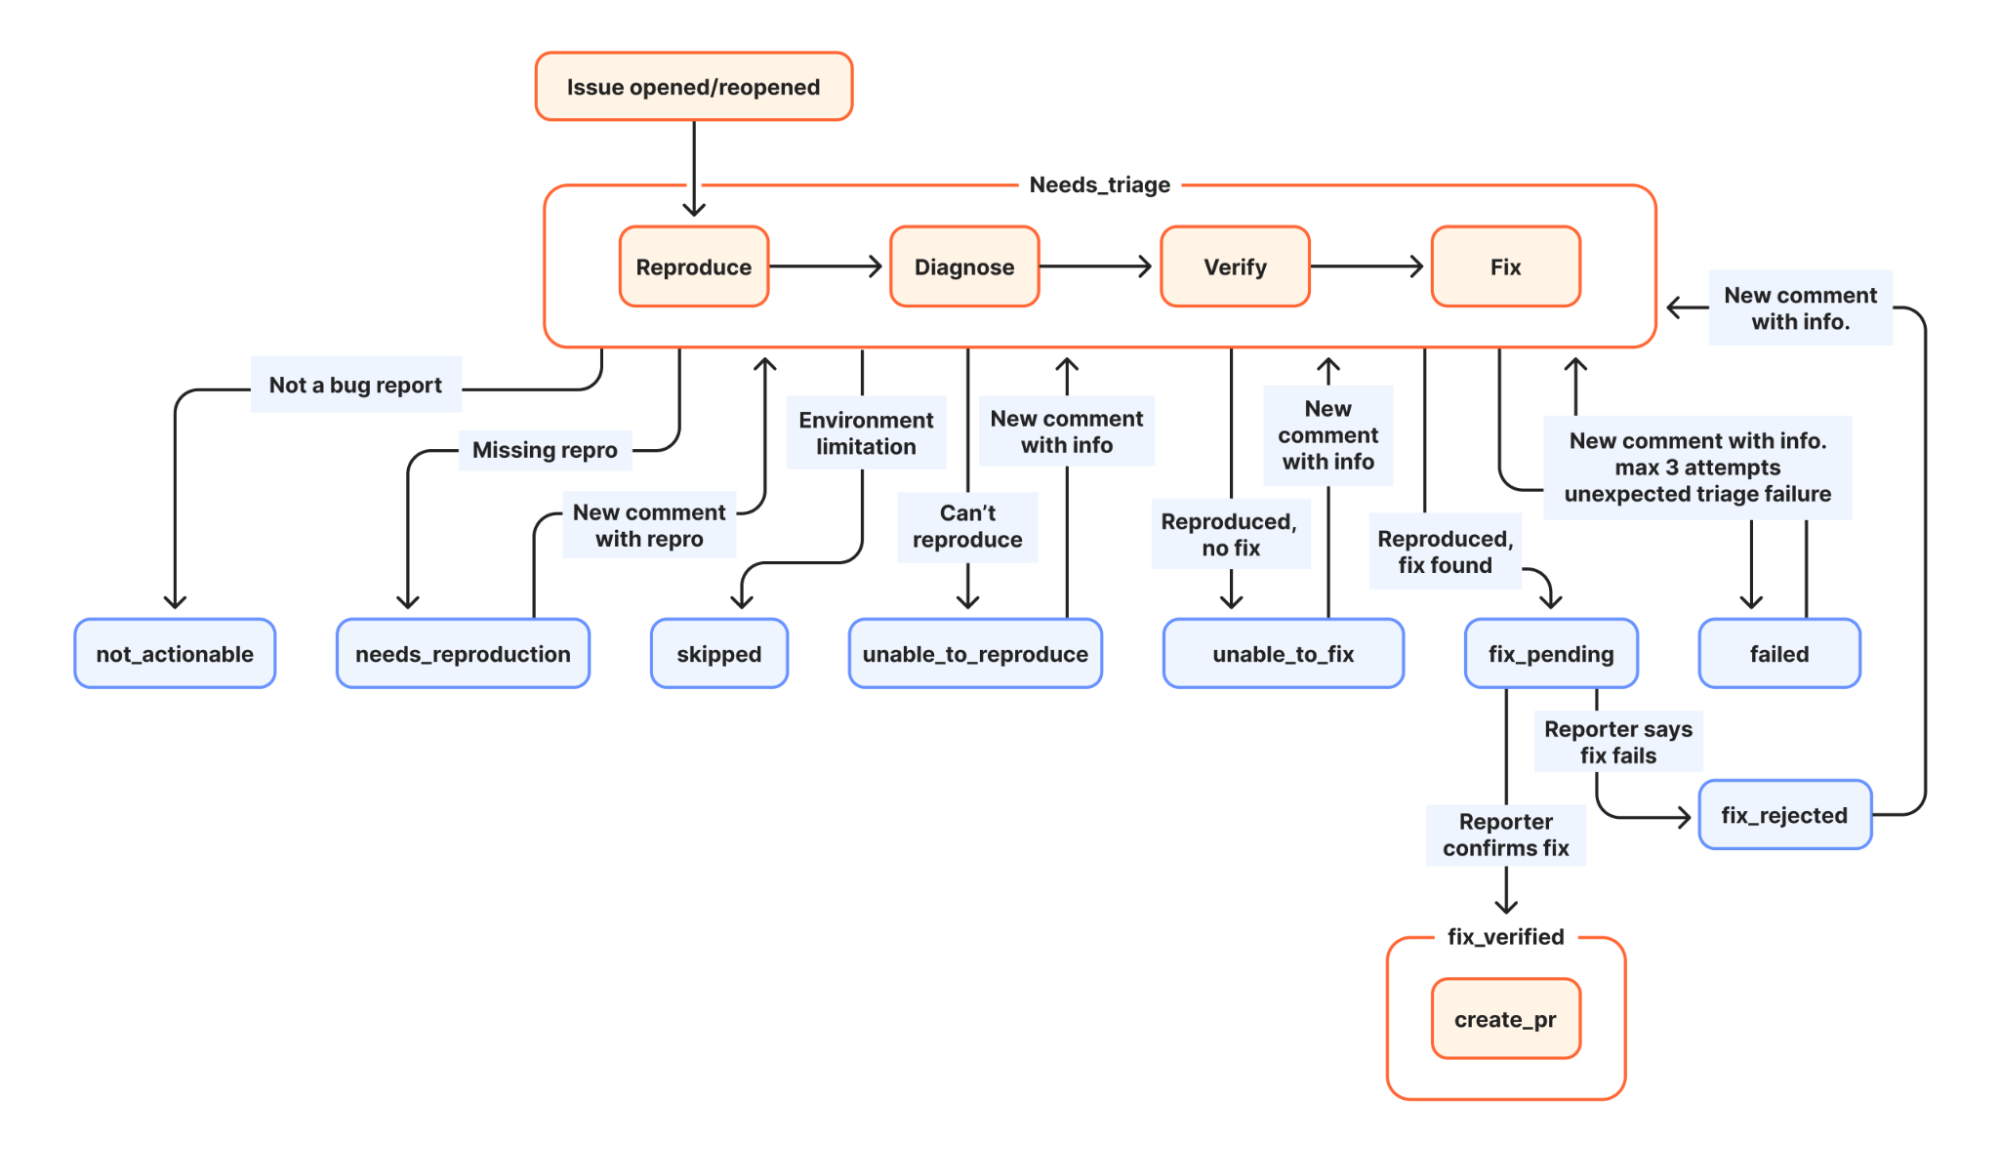
에이전트가 수정안을 찾으면 pkg.pr.new로 프리뷰 릴리스를 만들어 요약, 로그, 설치 방법을 이슈에 댓글로 남기고, 제보자가 자기 프로젝트에서 수정이 동작한다고 확인하면 이슈와 연결된 PR을 엽니다. 이 파이프라인을 일반화한 것이 Flue이고, 분류 로직은 triagebot-action이라는 별도 GitHub Action으로 분리되어 공개되었습니다. 프리뷰 릴리스를 만들 수 없는 저장소는 auto-pr-on-fix: true 옵션으로 제보자 확인 단계 없이 곧바로 PR을 열 수 있고, 예상치 못한 분류 실패는 최대 3회까지 다시 시도합니다. 다만 저장소에 아직 라이선스 파일이 없으니, 포크해 쓰기 전에 이용 조건을 확인해야 합니다.
      - uses: withastro/triagebot-action@v1
        with:
          read-token: ${{ secrets.GITHUB_TOKEN }}
          write-token: ${{ secrets.BOT_GITHUB_TOKEN }}
          cloudflare-api-key: ${{ secrets.CLOUDFLARE_API_KEY }}
          cloudflare-account-id: ${{ secrets.CLOUDFLARE_ACCOUNT_ID }}
          triage-model: cloudflare-workers-ai/@cf/moonshotai/kimi-k2.7-code
          verification-model: cloudflare-workers-ai/@cf/moonshotai/kimi-k2.6
          triage-skill: .agents/skills/triage
이 사례에서 가장 실용적인 교훈은 에이전트의 실패를 다루는 방식입니다. Astro 팀은 에이전트가 올바른 해결책을 찾지 못하면 그것을 코드베이스의 문제를 가리키는 신호로 해석하며, 원인을 세 가지로 분류합니다.
-
불투명한 추상화 (Opaque Abstractions): 에이전트가 컴포넌트 사이의 경계를 이해하지 못한다면, 사람 개발자도 그 코드 구조를 이해하기 어려울 가능성이 큽니다.
-
문서 부족 (Missing Documentation): 중요한 코드에 구현 이유를 설명하는 주석이 없는 경우입니다.
-
테스트 부족 (Insufficient Testing): 특히 단위 테스트 커버리지가 충분하지 않은 경우입니다.
실제로 HMR(Hot Module Replacement) 관련 버그들에서 분류 봇이 특정 if 조건을 반복해서 고치려 했고, 그 수정은 해당 버그는 고쳤지만 테스트가 없던 다른 곳에서 회귀를 일으켰습니다. 그 조건의 논리를 설명하는 주석을 추가하자 봇은 그 영역을 잘못 수정하려는 시도를 멈췄다고 합니다. 빠진 주석이나 테스트, 경계를 보완할 때마다 봇이 그 부분에서 나아지고, 다음에 그 코드를 만질 사람도 함께 나아진다는 것이 Astro 팀의 결론입니다.
사례 더 알아보기
How Cloudflare enforces engineering standards using AI - Cloudflare Blog
How we built a software factory to drive Astro's GitHub issue count to zero - Cloudflare Blog
triagebot-action GitHub 저장소
ADLC 제안을 읽을 때 함께 생각해 볼 점
원문은 마지막에 소프트웨어 팩토리가 언젠가는 에이전트와 AI처럼 소프트웨어를 만드는 평범한 방식이 되겠지만, 대부분의 사람과 조직은 아직 그 단계에 있지 않다고 인정합니다. 그리고 가장 작은 스타트업부터 가장 큰 플랫폼까지 누구나 쓸 수 있는 기반 기본 기능(primitive)이 이미 갖춰졌으며, 이를 연결하는 일은 아직 남아 있다고 말합니다.
이 제안에서 가장 설득력 있는 부분은 문제 정의입니다. 구현 속도만 빨라지고 리뷰, 테스트, 배포, 운영이 그대로라면 병목이 옮겨 갈 뿐이라는 지적, 그리고 에이전트에게 더 많은 단계를 맡기려면 프로그래밍 가능성, 재현성, 원자성, 권한 관리 같은 성질을 플랫폼이 먼저 갖춰야 한다는 7가지 조건은 특정 클라우드와 무관하게 적용해 볼 수 있는 점검 목록입니다. 사내 CI를 GitHub Actions로 운영하든 다른 도구로 운영하든, 우리 파이프라인의 어느 단계가 아직 사람의 클릭에 의존하는지 점검하는 데 쓸 수 있습니다.
반면 이 글이 Cloudflare 제품 발표문이라는 점도 함께 고려해야 합니다. ADLC의 각 단계는 Cloudflare 제품에 하나씩 대응되도록 제시되며(Flue는 배포 환경을 가리지 않고 @cloudflare/ci도 Apache 2.0으로 공개되어 있지만, 후자는 Workers 런타임 전용 패키지입니다), 앞서 본 SDLC 단계별 부담 차트도 측정값이 아닌 개념도입니다. @cloudflare/ci는 Artifacts 비공개 베타를 전제로 하고, 에이전트 트레이싱은 베타 단계입니다. 또한 원문이 스스로 제시한 80%에서 99.9...%로 가는 과제에 대해, 에이전트가 만든 변경을 사람의 승인 없이 프로덕션에 병합해도 될 만큼의 신뢰성을 보여 주는 정량 데이터는 아직 제시되지 않았습니다. Cloudflare Codex 사례에서도 변경의 검토와 승인 책임은 엔지니어에게 남겨 두었습니다. PyTorchKR에서 소개한 Agentic Coding은 함정이다 같은 비판적인 시각과 함께 읽어 보는 것도 균형을 잡는 데 도움이 됩니다.
그럼에도 두 사례가 보여 주는 방향은 구체적입니다. Astro 팀은 에이전트의 실패를 코드베이스의 약점을 찾는 신호로 쓰고, Cloudflare Codex는 조직의 암묵지를 에이전트가 읽을 수 있는 규칙으로 바꾸었습니다. 에이전트에게 더 많은 단계를 맡기는 일은 결국 사람도 이해하기 쉬운 코드와 명시적인 규칙, 관측 가능한 시스템을 만드는 일과 겹친다는 점에서, 이 제안은 Cloudflare 사용 여부와 관계없이 참고할 만합니다.
 The Agent Development Lifecycle has arrived on Cloudflare 블로그
Agent Development Lifecycle가 Cloudflare에 도입되었습니다 (Cloudflare 공식 한국어 번역)
 Cloudflare CI SDK GitHub 저장소
 Flue 프레임워크 홈페이지
더 읽어보기
-
Cloudflare OS: Cloudflare 오픈소스로 공개한 사내 AI 에이전트 워크스페이스 도구 (및 커뮤니티 의견들)
-
Cloudflare와 Stripe가 함께 만든 새 프로토콜로 AI 에이전트가 직접 계정 생성과 도메인 구매, 배포까지 처리합니다 (feat. Stripe Projects)
-
Cloudflare Dynamic Workers: 컨테이너보다 100배 빠른 실행 환경을 제공하는 AI 에이전트 코드 샌드박스 오픈 베타
-
Stripe의 무인 코딩 에이전트 Minions, 매주 1,300개 PR을 사람 코드 없이 만드는 방법 (feat. goose, MCP)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
