RAG나 문서 분석 파이프라인을 만들다 보면 PDF 파싱 단계에서 고민이 생깁니다. 최근에는 VLM에 PDF를 통째로 넣는 방식이 많이 쓰이지만, 페이지당 API 비용과 처리 시간이 만만치 않습니다. 반대로 CPU 기반 파서는 빠르고 싸지만, "정확도는 떨어지지 않나?"라는 의문이 따라붙습니다.
그래서 공개 벤치마크에서 CPU 파서인 PyMuPDF와 최신 VLM인 GPT-6 Astra를 같은 문서로 비교해 봤습니다.
실험 설정
- 벤치마크: ParseBench (LlamaIndex가 공개한 문서 파싱 벤치마크)
- 비교 대상: GPT-6 Astra는 ParseBench 리더보드와 동일한 설정으로 실행했고, 같은 문서에 대한 PyMuPDF 결과와 비교했습니다.
- 실행 환경: PyMuPDF는 GPU 없이 CPU만 사용했고, GPT-6 Astra는 외부 API로 호출했습니다.
- 속도·비용 측정: 30페이지 샘플 기준입니다.
결과 1: 속도와 비용
3,267개 셀로 이뤄진 대형 표(ParseBench p29_page1)에서는 두 제품 모두 모든 셀 값을 정확하게 추출했습니다. 차이는 처리 시간이었습니다. PyMuPDF는 7.8초, GPT-6 Astra는 259초가 걸렸고, Astra는 이 표 하나에 API 비용 $1.3을 썼습니다.
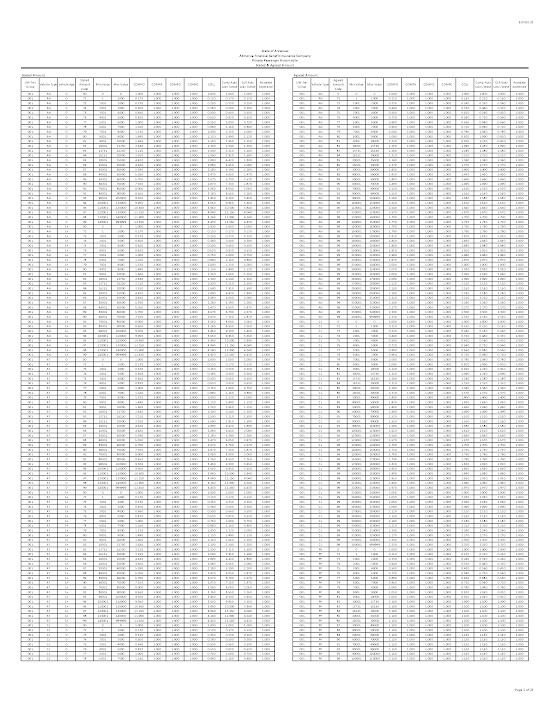
30페이지 샘플 전체에서도 비슷했습니다. 페이지당 처리 시간(중앙값)은 PyMuPDF 1.3초, GPT-6 Astra 30초였고, Astra의 API 비용은 30페이지에 $8.13이었습니다. PyMuPDF는 GPU 없이 CPU 비용만 들었습니다.
단순 계산으로 1만 페이지를 순차 처리하면 PyMuPDF는 약 3.6시간, GPT-6 Astra는 약 83시간입니다.
벤치마크 상의 표 항목 전체 점수는 GPT-6 Astra가 높았습니다(93.2 vs 72.0). 복잡한 표의 구조 복원이 핵심인 워크로드라면 이 점을 함께 고려하는 것이 좋습니다.
결과 2: 레이아웃 위치 정확도
레이아웃 파싱은 벤치마크상 PyMuPDF가 더 높았습니다. 실제 문서에서 어떤 차이가 나는지 두 가지 사례로 보여 드립니다. 그림에서 녹색 점선은 정답(Ground Truth), 파란색은 GPT-6 Astra, 보라색은 PyMuPDF의 검출 영역입니다.
사례 ① 이사회 소개 페이지
사진, 이름, 약력, 범례가 촘촘하게 배치된 페이지입니다.
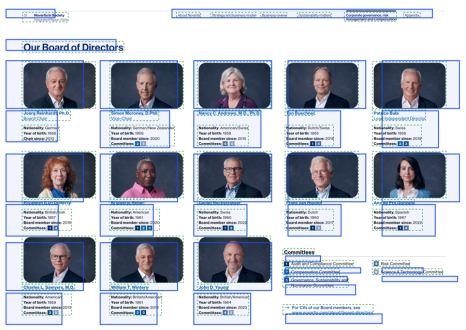
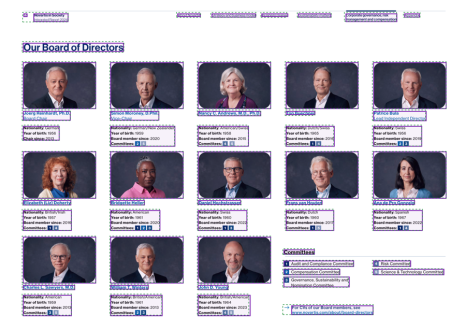
GPT-6 Astra에서는 세 가지 유형의 오류가 보였습니다.
- 좌표 어긋남: 사진과 약력 박스가 실제보다 왼쪽으로 밀리거나 크기가 맞지 않음
- 영역 병합: 상단 페이지 번호와 제목, 메뉴 항목 6개를 각각 하나의 박스로 합침. 둘째 줄 이름도 사진 영역에 포함됨
- 영역 누락: 우측 하단 범례는 빈 곳에 박스가 찍혔고 일부 항목은 검출되지 않음
PyMuPDF는 작은 영역도 정답과 거의 같은 위치로 잡았습니다.
사례 ② 재무 스케줄 페이지
대손충당금 스케줄 페이지에서 GPT-6 Astra는 표 아래 각주 2개와 페이지 번호(S-1)를 검출하지 못했고, PyMuPDF는 모두 정답 위치에서 검출했습니다.
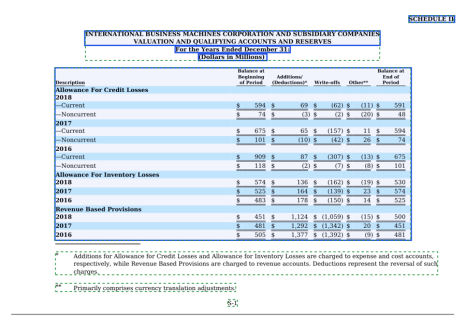
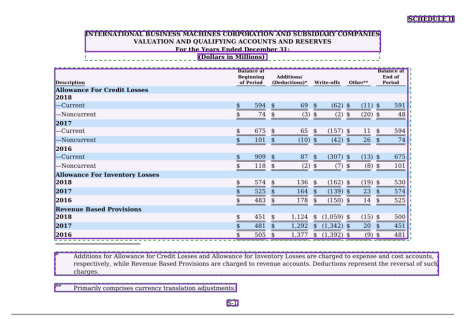
RAG에서 각주는 숫자의 기준을 설명하는 컨텍스트이고, 좌표는 답변의 출처를 표시하는 데 쓰입니다. 청크에서 각주가 빠지거나 좌표가 어긋나면 답변 품질과 출처 표시에 바로 영향을 줍니다.
왜 차이가 날까?
"VLM에 PDF 텍스트를 같이 주면 되지 않나?"라는 질문이 있을 수 있는데, 이미 그렇게 동작합니다. OpenAI API는 PDF를 입력받으면 텍스트와 페이지 이미지를 모두 추출해 모델에 넣습니다
즉 입력 정보는 비슷합니다. 차이는 출력을 만드는 방식에서 납니다.
- VLM: 입력을 보고 영역의 종류와 좌표를 모델이 토큰으로 생성합니다. 크고 뚜렷한 영역은 잘 잡지만, 작은 영역을 놓치거나 좌표가 조금씩 어긋날 수 있고, 생성 시간이 길어집니다.
- PyMuPDF: PDF 내부에 기록된 글자·도형의 좌표와 구조를 직접 해석합니다. 추정 단계가 없으니 빠르고, 좌표가 정답과 거의 일치합니다.
결국 결과를 가르는 것은 PDF 내부 구조를 얼마나 정밀하게 해석하느냐입니다. PyMuPDF는 이파피루스와 Artifex가 수십 년간 개발해 온 PDF 엔진 MuPDF의 파이썬 바인딩입니다.
그래서 어떻게 쓰면 좋을까
VLM과 CPU 파서는 경쟁보다는 역할 분담에 가깝다고 생각합니다. 문서를 정확하고 빠르게 읽는 일은 파서가 맡고, 그 위의 이해와 추론은 LLM이 맡는 구성이 비용과 품질 면에서 효율적입니다.
이번 실험에서도 PyMuPDF는 GPU 없이 CPU만으로 페이지당 1.3초에 문서를 처리했고, 페이지마다 쌓이는 API 비용 없이 CPU 비용만 들었습니다. 외부 API를 쓰지 않아서 온프레미스 환경에도 적용할 수 있습니다.
RAG 파이프라인의 문서 파싱 단계에서 GPU와 API 비용을 고민하고 계신다면, 이번 비교가 파서를 고르는 데 하나의 참고 자료가 되었으면 합니다.
- 원문: 비용은 알겠는데, 성능은 어떨까? 최신 VLM과 직접 비교한 PyMuPDF Office (이파피루스 블로그)
- PyMuPDF Office: 홈페이지
 GitHub: pymupdf/PyMuPDF