Ember-1 소개
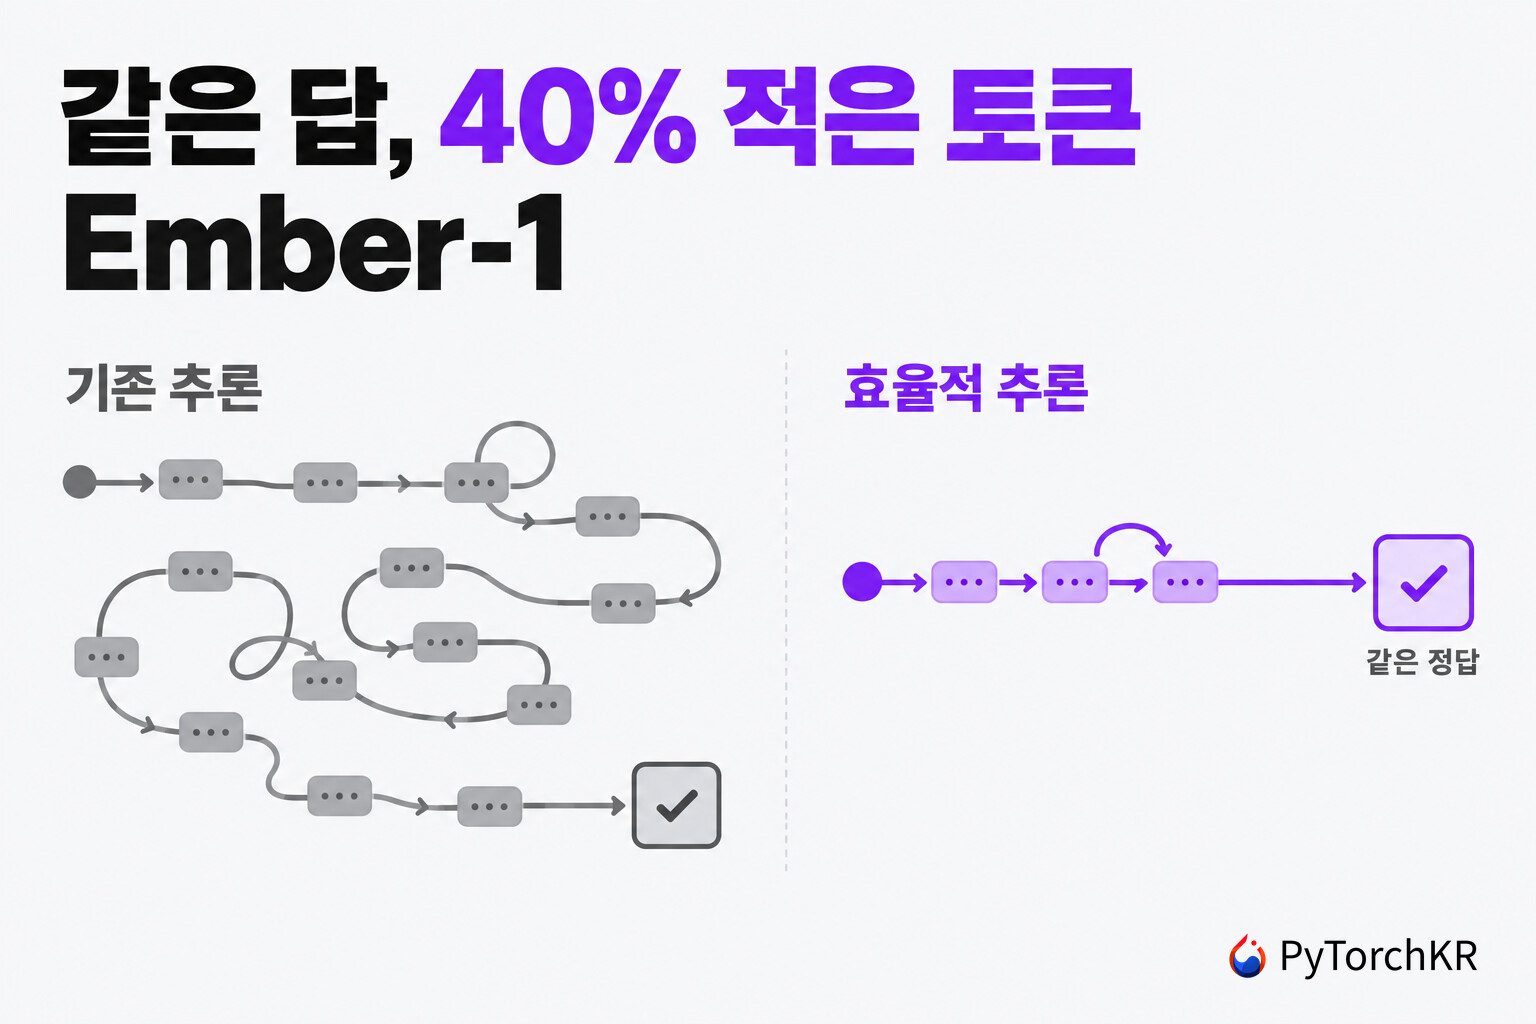
Ember-1은 Fireworks AI의 연구 조직 Fireworks Research가 2026년 9월 23일 공개한 추론(reasoning) 효율화 모델로, Kimi K3를 기반으로 추가 학습해 비슷한 품질을 약 40% 적은 토큰으로 내도록 만든 것이 핵심입니다. 모델 구조를 새로 설계한 것이 아니라, 이미 공개된 오픈 웨이트 모델이 불필요하게 길게 생각하는 습관을 학습으로 고친 모델입니다.
이런 모델이 나온 배경은 추론 모델의 비용 구조에 있습니다. Fireworks AI에 따르면 Kimi K3 같은 추론 모델은 생성하는 토큰의 대부분, 경우에 따라 90% 이상을 답변이 아닌 내부 추론에 씁니다. 이 비용은 여러 턴을 주고받는 에이전트 작업에서 더 커집니다. 매 턴마다 이전 추론이 다시 컨텍스트로 들어가므로 컨텍스트가 턴 수에 따라 대략 제곱으로 늘어나고, 초반 턴의 긴 추론 기록이 이후 호출마다 다시 읽히고 다시 과금됩니다.
Fireworks AI는 사용자들로부터 Kimi K3의 코딩 능력을 더 낮은 비용으로 쓰고 싶다는 요청을 받았다고 합니다. 추론 기록이 길어 자동화된 코딩을 대규모로 실행하면 비용이 크게 늘었기 때문입니다. 그렇다고 추론 강도(reasoning effort)를 낮추는 설정만으로는 해결되지 않았다고 합니다. 추론 강도를 낮추면 품질이 너무 많이 떨어졌기 때문에, Fireworks Research는 모델이 스스로 더 효율적으로 추론하도록 학습시키는 방향을 택했습니다. 같은 Kimi K3를 바탕으로 비용 대비 성능을 끌어올린 사례로는 앞서 소개한 Cognition의 SWE-2도 있는데, SWE-2가 코딩 특화 강화 학습으로 추론 노력 단계별 비용 대비 성능 곡선 전체를 끌어올렸다면, Ember-1은 수학, 대화, 검색까지 포함한 폭넓은 작업에서 추론 길이 자체를 줄이는 데 초점을 둡니다.
추론을 줄이되 자기 성찰은 남기는 학습 방식
Fireworks Research는 Kimi K3의 추론이 모두 낭비는 아니라고 봅니다. 가정을 다시 점검하거나, 피드백에 반응하거나, 결과를 앞선 결정과 연결해 보는 자기 성찰(Self-reflection) 은 모델이 실수에서 회복하는 데 도움이 됩니다. 따라서 목표는 추론을 일괄적으로 자르는 것이 아니라, 이런 능력은 유지하면서 불필요한 추론과 생산성 없는 반복 루프만 줄이는 것이었습니다.
학습 데이터는 수학, 코딩, 지시 따르기, 대화, 검색, 도구 사용, 소프트웨어 엔지니어링을 아우르며, 단발성 문제와 여러 단계에 걸친 상호작용을 모두 포함합니다. 과제와 환경에서 오는 피드백이 온-정책(On-policy) 계획과 학습을 이끄는 구조이고, 에이전트 작업에서는 모델이 행동을 탐색하고 새 관찰을 반영하며 추론을 다듬도록 했다고 설명합니다. 원문은 구체적인 알고리즘을 공개하지 않았지만, 50회가 넘는 학습 실험과 200회가 넘는 평가를 거치며 정확도를 잃지 않고 추론을 줄이는 새 학습 알고리즘을 개발했다고 밝혔습니다.
학습은 모두 Fireworks Serverless Training에서 진행했습니다. GPU를 직접 준비하거나 관리할 필요가 없어 아이디어가 생기면 바로 실험을 시작하고 실행한 만큼만 비용을 냈다고 하며, 고객 데이터는 사용하지 않고 자체 데이터만 썼다고 합니다. 그 결과 7개 벤치마크와 두 고객사의 실제 트래픽에서 Kimi K3의 추론 길이를 정확도 손실 없이 35~50% 줄일 수 있었고, 실패하는 시도에서도 토큰을 절제해 쓰는 경향이 나타났다고 설명합니다.

 추론을 길게 할수록 오히려 성능이 떨어지는 현상에 관해서는 다음 글(Inverse Scaling in Test-Time Compute)을 참고해주세요:
벤치마크 결과: 비용 대비 품질의 파레토 프론티어
Specialized Intelligence Index의 Bedside Bench
Fireworks AI는 Ember-1 발표와 같은 주 초에 업계 전문가가 만든 실제 과제로 모델을 평가하는 Specialized Intelligence Index(SII)를 공개했습니다. Ember-1은 이 중 Doximity의 Bedside Bench로 평가했는데, 의사가 검증한 500개 임상 사례를 10개 전문 분야로 나눈 벤치마크입니다.
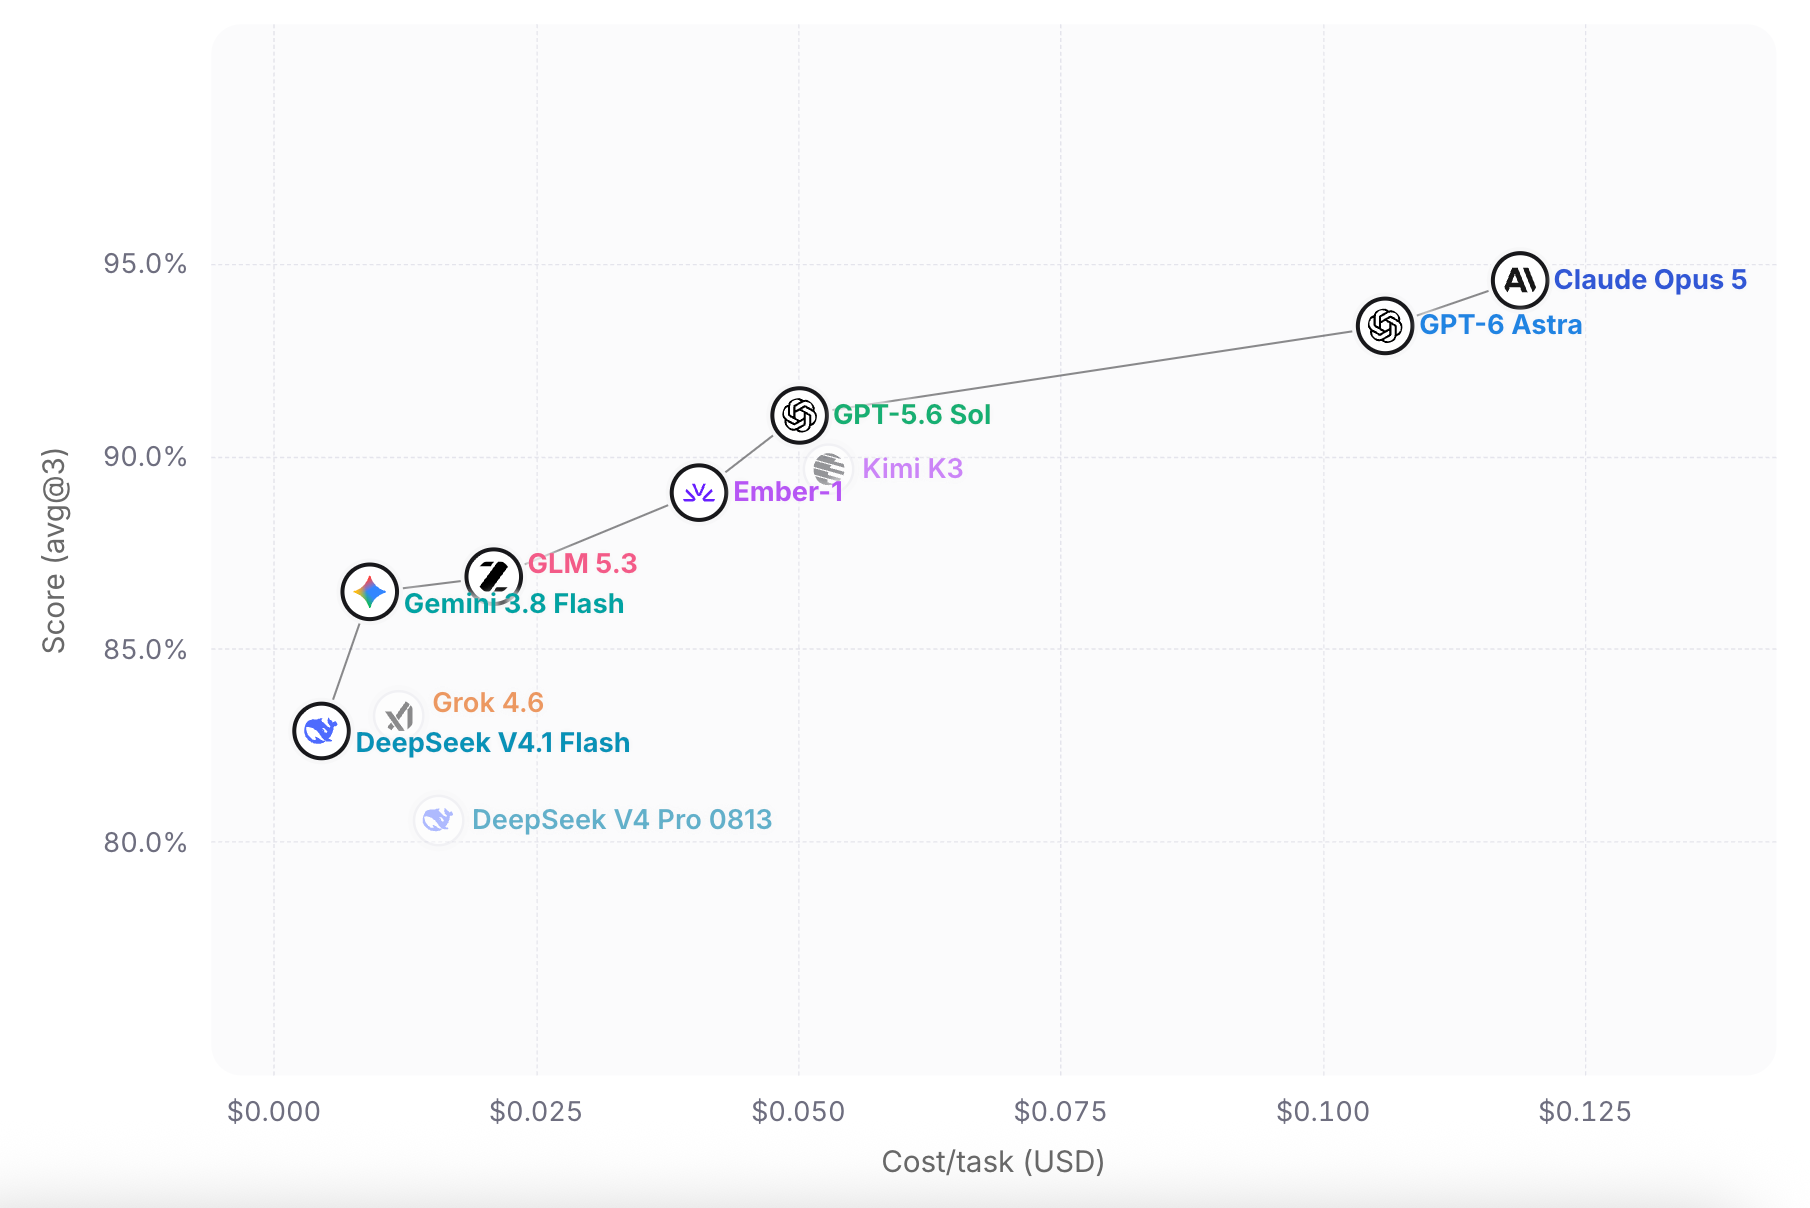
아래 그림 1에서 Ember-1은 작업당 비용 기준으로 GPT-5.6 Sol, GPT-6 Astra, Claude Opus 5 등이 이루는 파레토 프론티어(Pareto Frontier), 즉 이보다 저렴하면서 점수도 높은 모델이 없는 지점을 이은 경계선 위에 올라 있습니다. 다만 점수만 보면 Ember-1은 원본 Kimi K3보다 약간 낮은 위치에 있고, 프론티어에 오른 이유는 같은 수준의 점수를 더 낮은 비용으로 냈기 때문입니다.
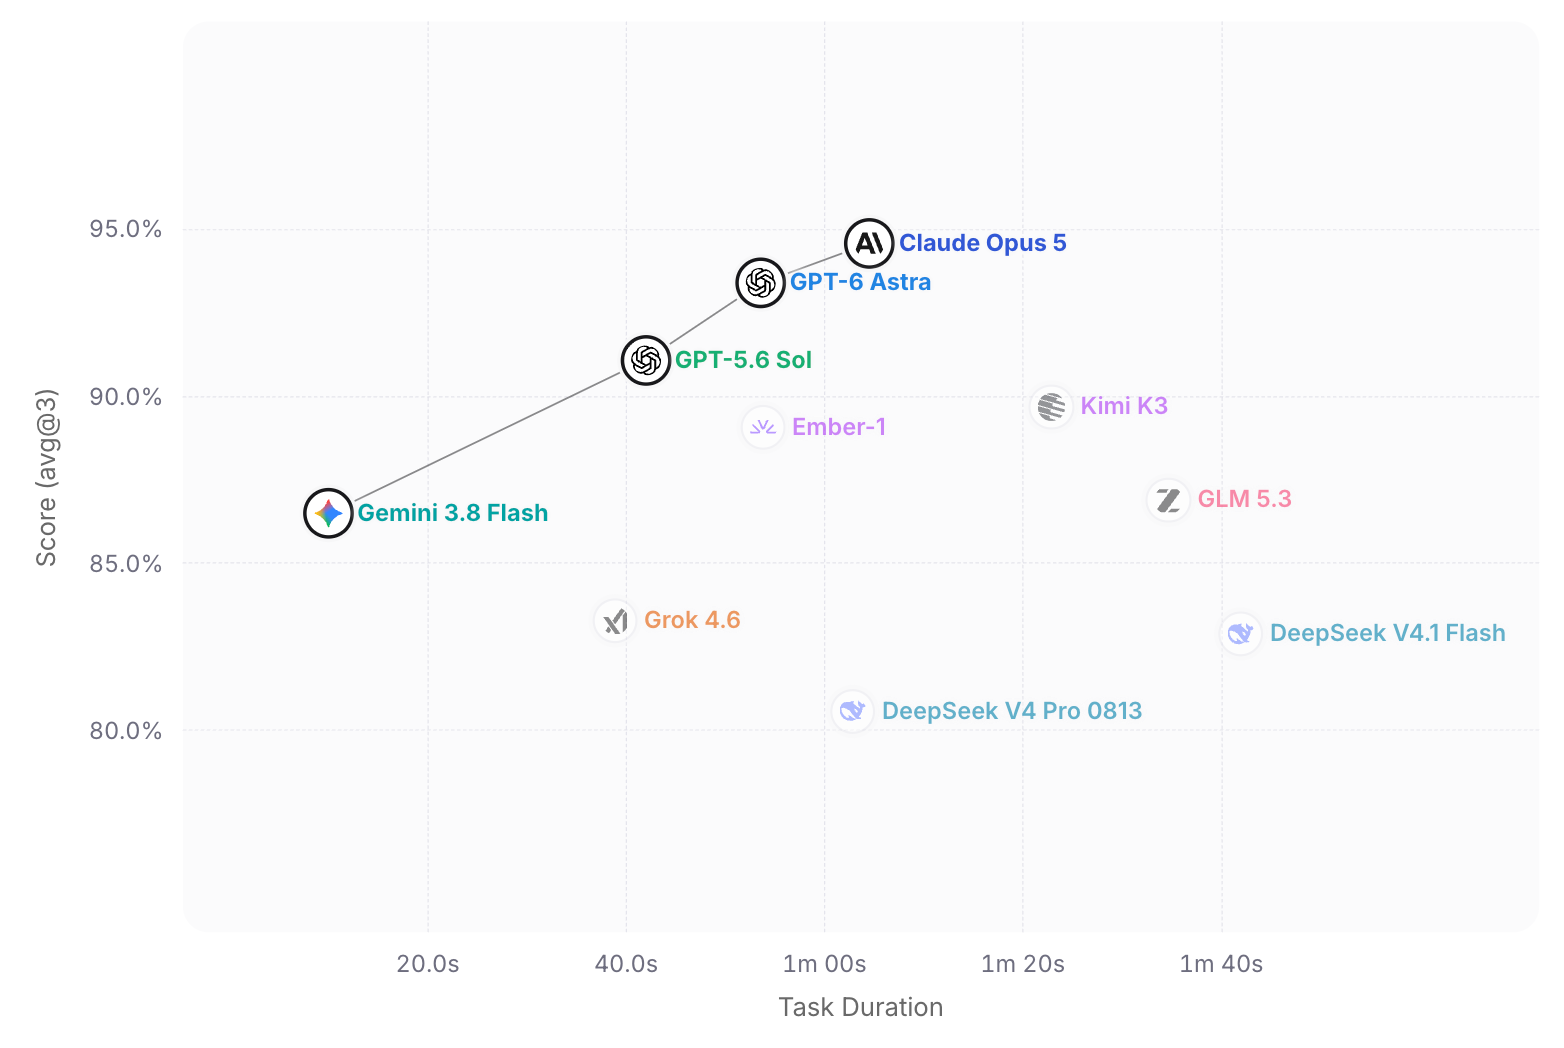
작업 시간 기준으로 그린 그림 2에서는 Ember-1이 Kimi K3보다 짧은 시간에 과제를 마치지만, 시간 기준 프론티어에는 들지 못했습니다. 원문은 이 그림에 대한 별도 해석을 달지 않았습니다.
Kimi K3의 추론 강도 설정과 비교한 업계 벤치마크
Fireworks AI는 Kimi K3의 공개 API 가격(입력 100만 토큰당 3달러, 캐시된 입력 0.30달러, 출력 15달러)으로 벤치마크별 비용을 계산하고, 이를 통과율과 함께 비교했습니다. 비교 대상은 추론 강도를 low, high, max(기본값)로 둔 Kimi K3 세 가지와 Ember-1이며, GPT-6 Astra, Claude Opus 5, GLM 5.3도 함께 분석했습니다. 5개 벤치마크 평균을 그린 그림 3에서 Ember-1은 Kimi K3 max보다 점수가 높고 비용은 낮은 위치에 있습니다.
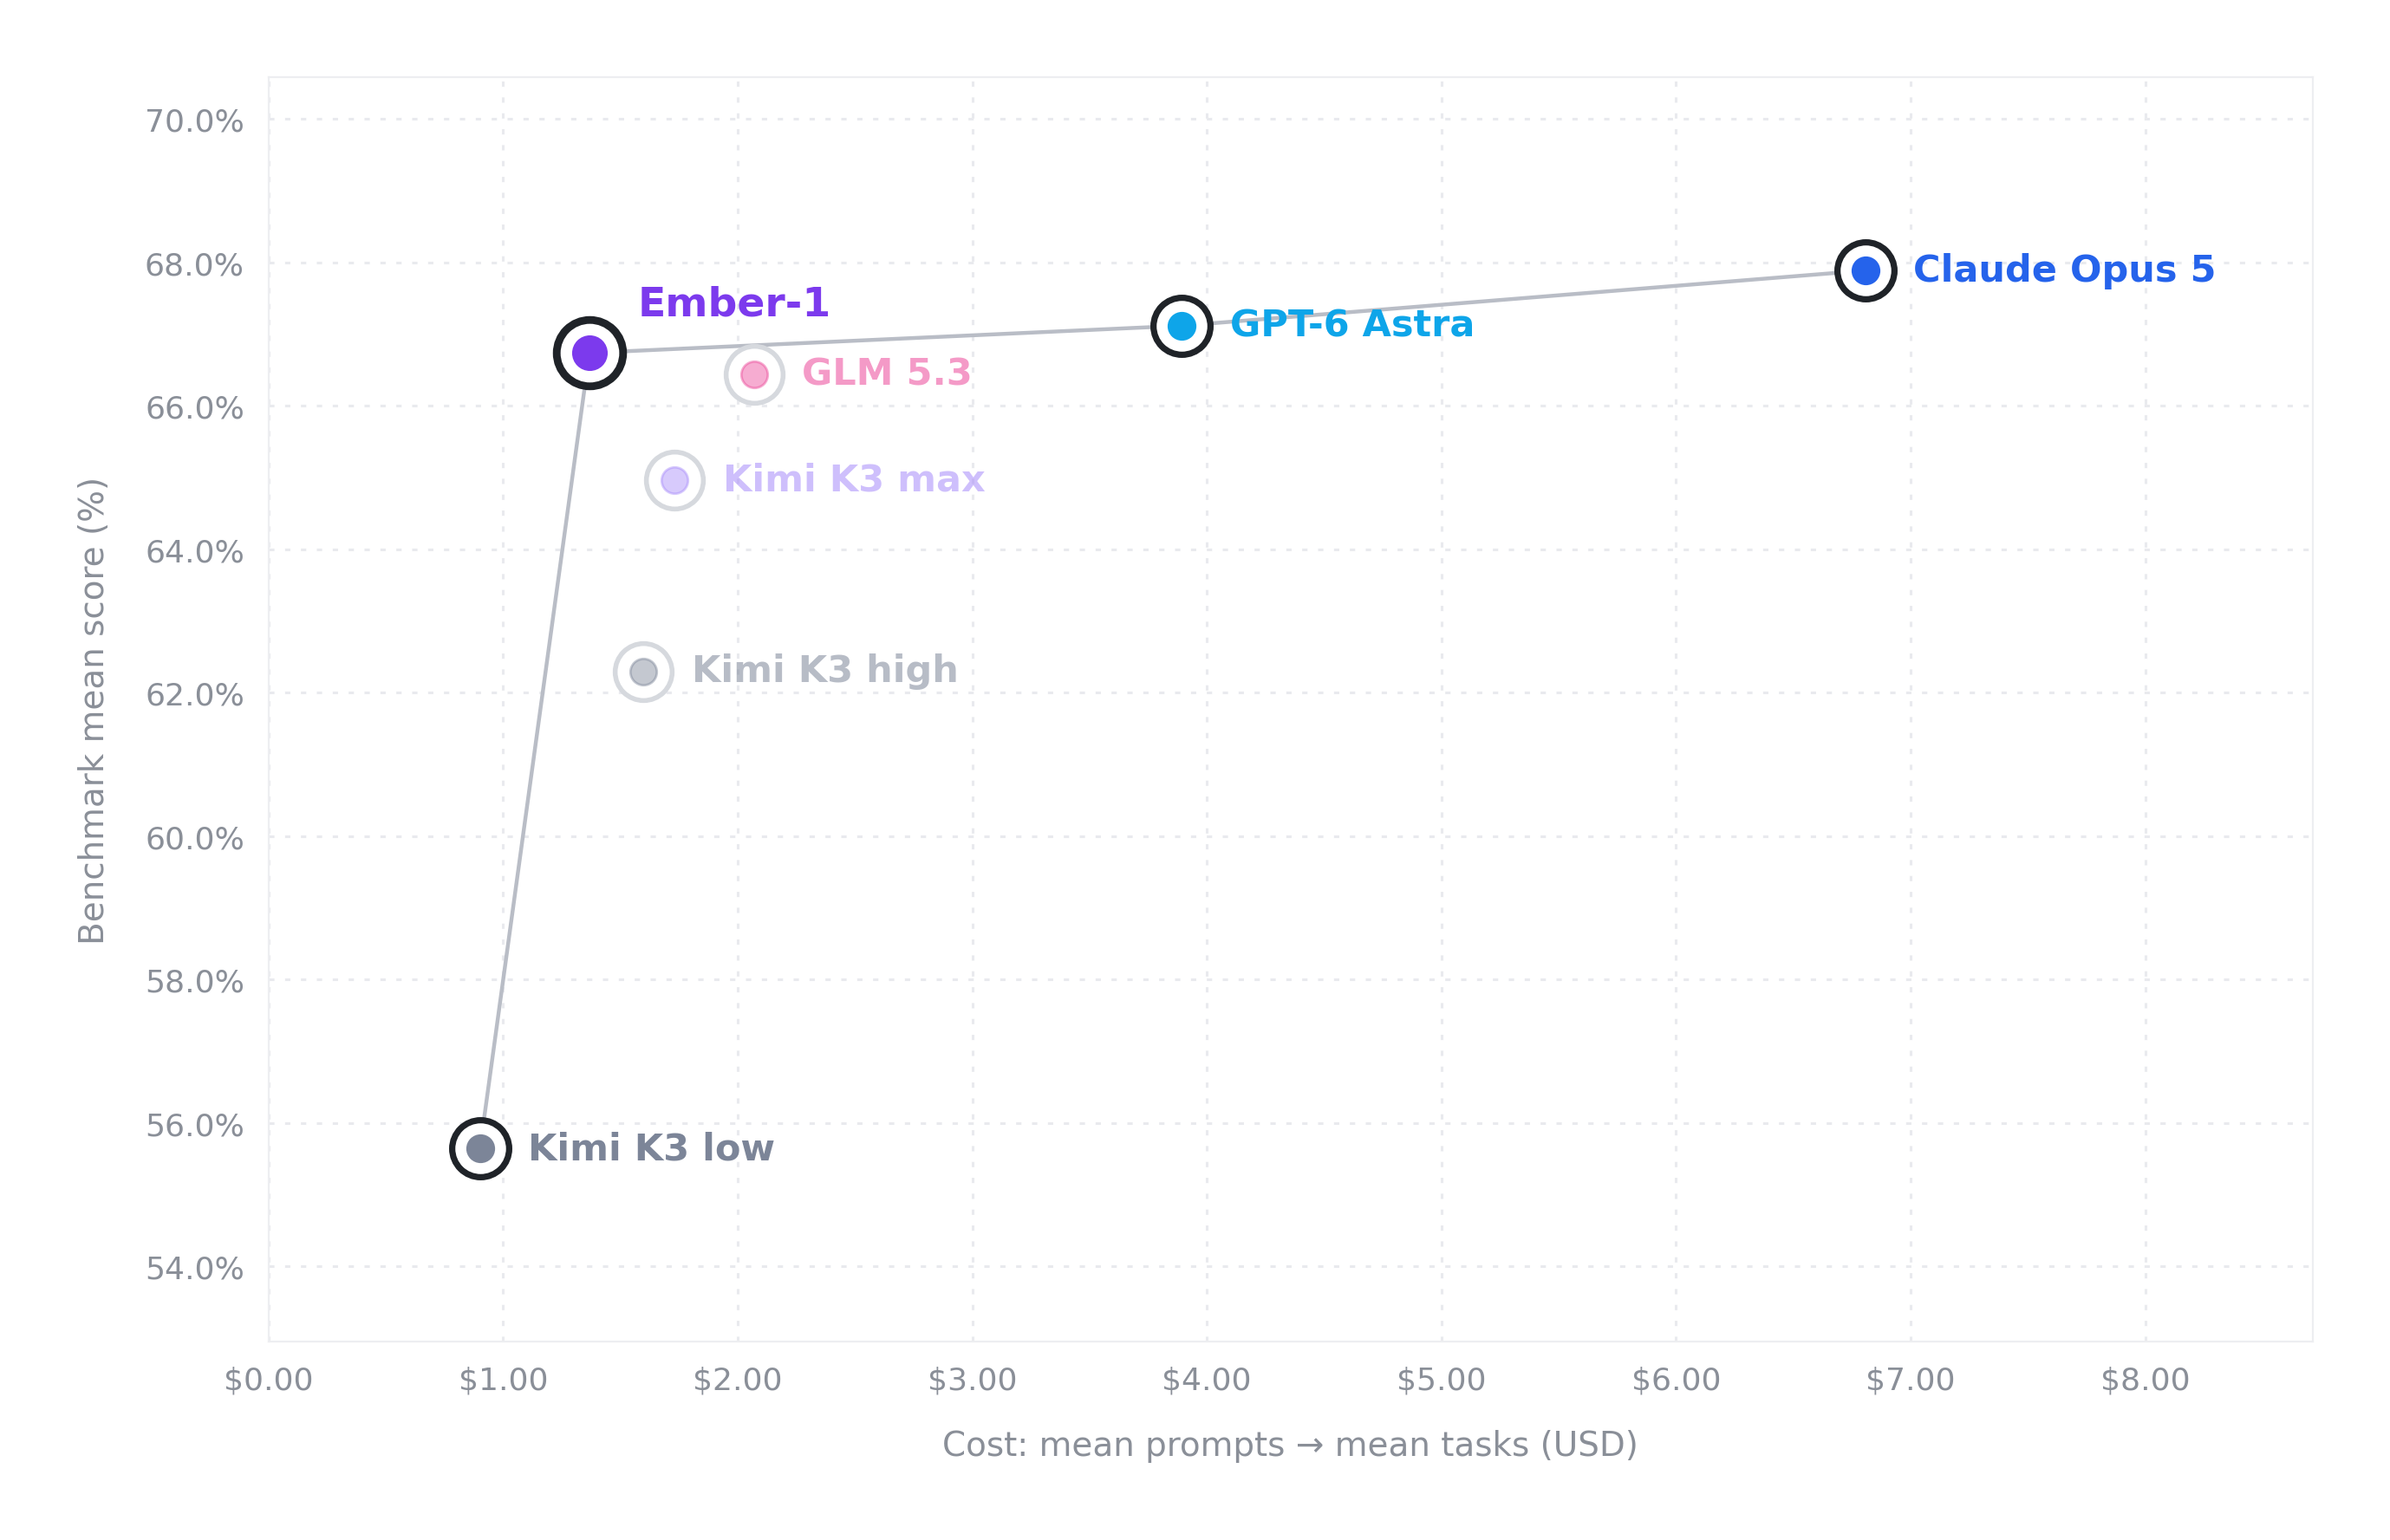
원문은 샘플이 50개를 넘는 모든 벤치마크에서 Ember-1이 파레토 프론티어 위나 그 근처에 있고, K3 max와 같은 품질을 훨씬 낮은 비용으로 내며, K3 low를 엄격히 앞선다(strictly dominating)고 정리합니다. 다만 그림 3의 평균에서는 K3 low가 Ember-1보다 비용이 낮게 찍혀 있으므로, 적어도 평균 기준으로는 K3 low에 대한 우위를 점수 측면의 우위로 읽는 것이 정확합니다.
벤치마크별 결과는 다음과 같습니다. 마지막 열은 원문 표의 Ember-1 vs. K3 Max 값을 그대로 옮긴 것입니다. 원문은 이 열의 의미를 따로 설명하지 않았지만, 달러 금액이 함께 적혀 있어 K3 max 대비 비용 차이로 읽힙니다.
| 벤치마크 | 샘플 수 | K3 low | K3 high | K3 max | Ember-1 | Ember-1 vs. K3 max |
|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 89 | 76.4% | 77.6% | 80.9% | 82.0% | -51.9% / -23.1 USD |
| SWE-bench Verified | 500 | 80.4% | 86.0% | 93.2% | 92.2% | -15.5% / -68.1 USD |
| SWE-Interact | 75 | 6.7% | 13.3% | 21.3% | 20.0% | -32.5% / -60.8 USD |
| DeepSWE 1.1 | 113 | 55.8% | 62.8% | 66.4% | 75.2% | -23.7% / -126.9 USD |
| τ²-Bench Airline | 50 | 64% | 64% | 64% | 66% | -5.9% / -0.3 USD |
위 표를 통해 3가지를 알아볼 수 있습니다. 첫째, Ember-1은 5개 벤치마크 모두에서 Kimi K3 low와 high보다 높은 점수를 냈습니다. 둘째, SWE-bench Verified와 SWE-Interact에서는 Kimi K3 max보다 각각 1.0%p, 1.3%p 낮아, 모든 과제에서 품질이 같거나 높다고 보기는 어렵습니다. 셋째, 마지막 열의 감소 폭은 과제에 따라 5.9%에서 51.9%까지 차이가 크며, 감소 폭이 가장 작은 τ²-Bench Airline은 샘플이 50개라 원문이 말한 50개 초과 기준에 들지 않습니다. Fireworks AI는 이 결과를 두고 "K3를 가장 비용 효율적으로 쓰는 방법은 더 이상 덜 생각하게 만드는 것이 아니라, 효율적으로 생각하도록 학습한 Ember-1을 쓰는 것"이라고 정리했습니다.
참고로 같은 Terminal-Bench 2.1에서 Cognition의 SWE-2 발표는 Kimi K3를 88.3%로 보고해, 이 표의 K3 max(80.9%)와 차이가 있습니다. 측정 주체와 하네스 설정에 따라 수치가 달라지므로, 서로 다른 발표의 숫자를 직접 비교하기보다 각 발표 안에서의 상대 비교로 보는 것이 좋습니다.
실제 트래픽에서의 검증: 고객 A/B 테스트와 사내 사용
벤치마크와 별도로, Fireworks AI는 두 고객사의 실제 코딩 워크로드에서 A/B 테스트를 진행했습니다. 두 경우 모두 비슷한 품질에서 작업당 토큰을 약 35% 덜 썼고, 과제 완료율, 성공 점수, 실패율 같은 제품 지표도 대부분 유지되거나 개선되었다고 합니다. 원문에는 다음 표가 함께 실렸는데, 두 고객사 중 어느 쪽 결과인지 또는 합산 결과인지는 밝히지 않았습니다.
| 모델 | 점수 | 스텝 수 | 출력 토큰 | 추론 토큰 감소 | 전체 토큰 감소 |
|---|---|---|---|---|---|
| Kimi K3 | 0.751 | 23.8 | 49.3K | - | - |
| Ember-1 | 0.753 | 21.4 | 29.9K | 71.3% | 39% |
점수는 거의 같으면서 스텝 수는 23.8에서 21.4로 줄었고, 추론 토큰은 71.3%, 전체 토큰은 39% 줄었습니다. A/B 테스트 이후 한 고객사는 Ember-1을 실제 서비스에 적용했고, 기반 모델을 완전히 대체하는 방향으로 확대할 계획이라고 합니다.
고객 공개에 앞서 Fireworks AI는 사내 코딩 트래픽에도 Ember-1을 먼저 적용했습니다. 원문은 이 결과를 "소식이 없었다(no news)"고 표현하는데, 개발자들은 모델이 바뀐 것을 알아채지 못한 채 평소처럼 작업했고, 토큰 사용량만 크게 줄었습니다. 사내 사용에 대한 구체적인 수치는 공개하지 않았습니다. "같은 답, 더 적은 토큰"을 내세우는 모델이므로 사용자가 차이를 느끼지 못했다는 점 자체를 핵심 근거로 제시한 것입니다.
사용 방법과 가격
Ember-1은 Fireworks AI 서버리스(Serverless)에서 기본 Kimi K3 모델과 나란히 제공되는 리서치 프리뷰(Research Preview) 로 출시되었습니다. Fireworks AI는 이번에 리서치 릴리스라는 방식을 도입했는데, 새 연구 모델을 2주 동안 서버리스로 제공하고 커뮤니티 수요에 따라 정식 제공 여부를 정한다고 합니다. 모델 페이지 기준 주요 사양은 다음과 같습니다.
- 모델 경로:
accounts/fireworks/models/ember-1 - 가격: 100만 토큰당 입력 3.00달러, 캐시된 입력 0.30달러, 출력 15.00달러 (Kimi K3 공개 API 가격과 동일)
- 구조: 2.78T 파라미터 전문가 혼합(Mixture-of-Experts, MoE) 모델
- 컨텍스트 길이: 1,040K 토큰
- 지원 기능: 함수 호출(Function Calling), 이미지 입력
토큰 단가는 Kimi K3와 같으므로, 절감 효과는 전적으로 사용하는 토큰 수가 줄어드는 데서 나옵니다. 또한 Fireworks AI는 기업이 자체 데이터로 Ember-1을 추가 학습할 수 있는 학습 지원도 함께 발표했지만, 글 작성 시점의 모델 페이지에는 미세 조정(Fine-tuning)이 아직 Not supported로 표시되어 있습니다. 가중치 공개 여부나 라이선스는 원문과 모델 페이지 어디에도 언급이 없어, 현재로서는 Fireworks AI의 API로만 사용할 수 있는 모델로 보는 것이 맞습니다.
Ember-1은 Fireworks Research가 이어서 내놓을 특화 모델 시리즈의 첫 모델이며, Fireworks AI는 앞으로도 토큰 효율을 회사의 주요 방향으로 삼겠다고 밝혔습니다. 추론 토큰이 비용 대부분을 차지하는 에이전트 코딩 워크로드를 운영하고 있다면, 모델을 바꾸지 않고 같은 기반 모델의 효율화 버전으로 비용을 줄이는 선택지가 생긴 셈입니다. 원문 안에서도 절감 폭은 문맥마다 다르게 표현됩니다. 소제목은 토큰 절반(half the tokens), 소개 문단과 모델 페이지는 약 40%, 학습 결과 설명은 추론 길이 35~50%, 고객 A/B 테스트는 작업당 약 35%입니다. 또한 위 결과는 모두 Fireworks AI가 직접 수행한 평가이므로, 도입 전에는 자신의 워크로드로 확인해 보는 것이 좋습니다.
 Introducing Ember-1 블로그
 Ember-1 모델 페이지
더 읽어보기
-
Kimi K3, Moonshot AI가 공개한 세계 첫 3T급 오픈 웨이트 모델 (전체 가중치 공개는 7월 27일 예정)
-
Cognition, Kimi K3 기반 코딩 모델 SWE-2 공개: Fable 5.1과 1점 차, 비용은 64% 절감
-
추론 능력 향상을 위한 Test-time Computing의 역설 (Inverse Scaling in Test-Time Compute)에 대한 연구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
