HarnessTax 소개: 코딩 에이전트에서 모델이 아니라 하네스를 바꾸면 무엇이 달라지는가
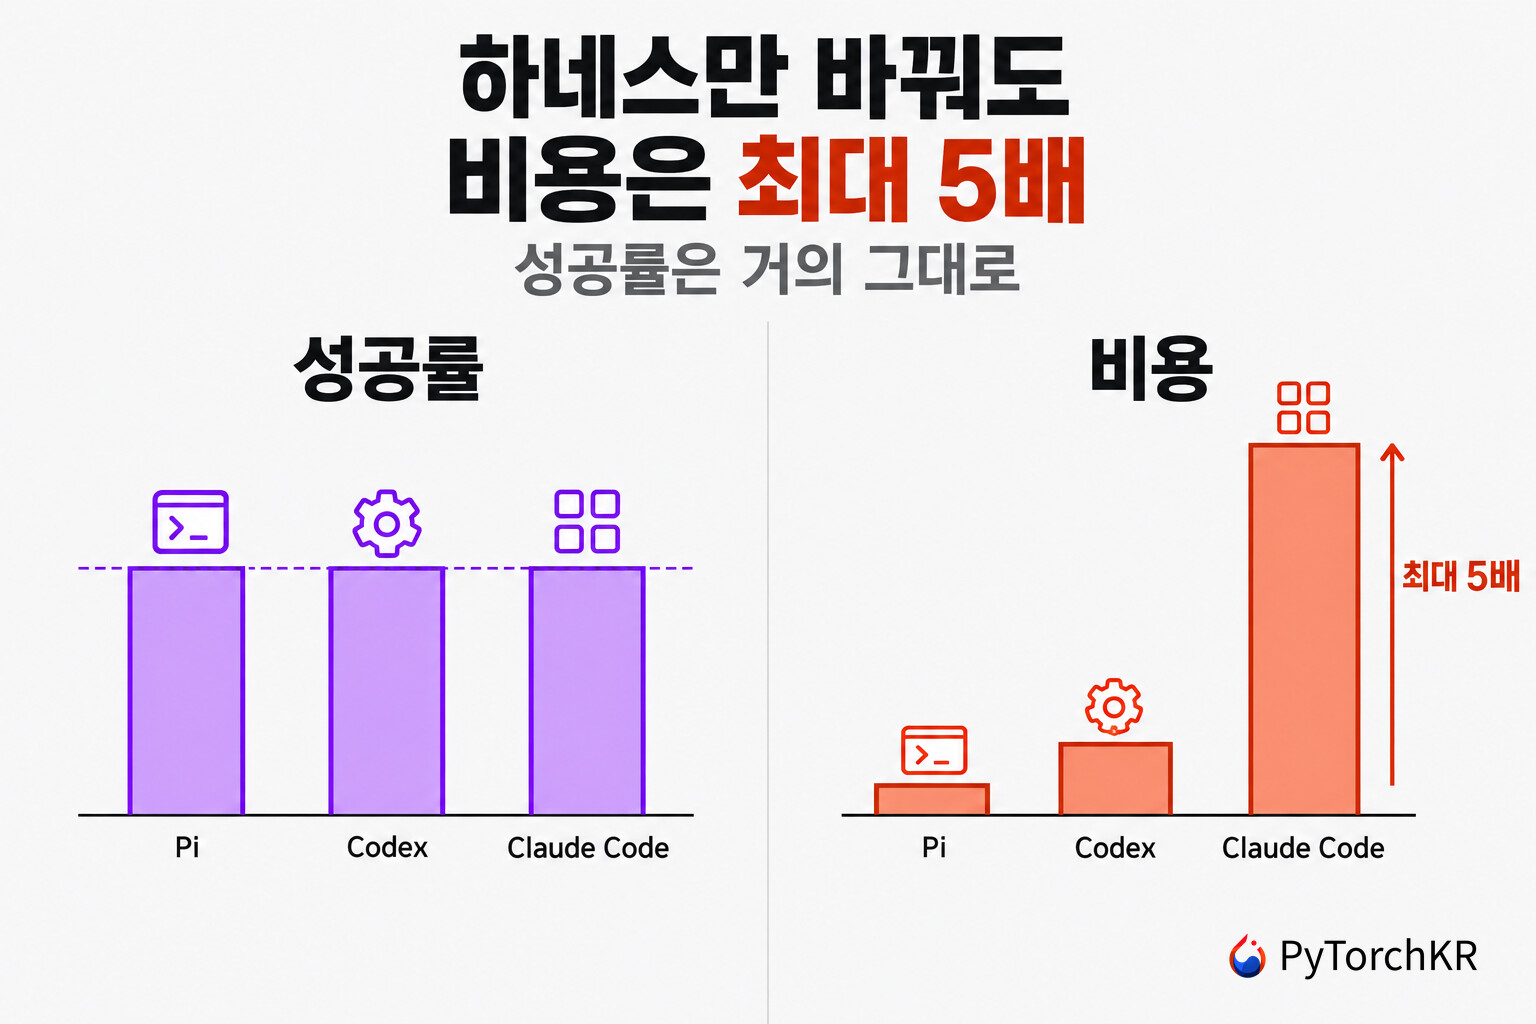
HarnessTax는 UC Berkeley Sky Computing Lab과 Arena의 연구진이 공개한 코딩 에이전트 프로파일링 연구로, 같은 모델을 서로 다른 하네스(harness) 위에서 돌렸을 때 과제 성공률과 비용이 각각 얼마나 달라지는지를 21개 조합에 걸쳐 측정한 결과입니다. 결론부터 말하면 성공률은 하네스를 바꿔도 거의 움직이지 않는 반면, 같은 품질을 얻는 데 드는 비용은 최대 5배까지 벌어졌습니다.
여기서 말하는 하네스는 모델을 감싸고 있는 소프트웨어 계층 전체를 가리킵니다. 모델에게 어떤 도구를 쥐여 줄지, 시스템 프롬프트에 무엇을 적을지, 컨텍스트를 어떻게 관리하고 잘라낼지, 몇 턴까지 루프를 돌릴지, 샌드박스와 권한을 어떻게 구성할지를 결정하는 것이 전부 하네스의 몫입니다. Claude Code, Codex CLI, Cursor, Gemini CLI 같은 도구가 모두 이 계층에 해당합니다. 즉, 우리가 "코딩 에이전트를 쓴다"고 말할 때 실제로는 모델 하나가 아니라 모델과 하네스의 조합 을 고르고 있는 셈입니다.
그런데 지금까지의 평가는 대부분 모델 쪽만 바라봤습니다. 벤치마크 점수표는 모델 이름으로 줄을 세우고, 하네스는 "어떤 걸 썼는지" 정도의 각주로만 남습니다. SWE-agent 이후로 에이전트와 컴퓨터 사이의 인터페이스 설계가 성능을 좌우한다는 인식은 자리를 잡았고, Anthropic의 장시간 실행 에이전트를 위한 하네스 설계 글이나 OpenAI가 공개한 Codex 에이전트 루프 해설처럼 하네스 자체를 정면으로 다루는 자료도 늘었습니다. 그럼에도 "같은 모델을 다른 하네스에 꽂으면 무슨 일이 벌어지는가"를 통제된 조건에서 정량적으로 비교한 자료는 드물었습니다. PyTorchKR에서도 Artificial Analysis가 모델과 하네스의 조합으로 평가한 코딩 에이전트 벤치마크를 소개한 적이 있는데, HarnessTax는 비슷한 문제의식을 훨씬 좁은 통제 조건에서 파고든 쪽에 가깝습니다.
저자는 UC Berkeley의 Melissa Z. Pan, Shuo Yang, Negar Arabzadeh, Ion Stoica, Matei Zaharia와 Arena의 Wei-Lin Chiang입니다. Sky Computing Lab은 vLLM을 비롯해 LLM 서빙과 평가 인프라를 내놓아 온 연구실이고, 이번 실험에 필요한 API 접근은 Arena가, Anthropic API 크레딧은 Laude Institute가 지원했다고 밝히고 있습니다.
이 연구가 던지는 질문은 단순합니다. "다른 하네스를 쓰면 같은 모델이 더 많은 과제를 풀거나 비용을 줄일 수 있을까?" 저자들은 이 질문에 답하기 위해 7개 모델과 3개 하네스를 교차시킨 21개 조합을 두 개의 공개 벤치마크에서 돌렸고, 그 과정에서 관측된 비용 격차를 Portkey가 먼저 사용한 표현을 빌려 "하네스 세금(Harness Tax)"이라고 부릅니다. 기본 하네스를 별다른 비교 없이 받아들이는 순간, 같은 결과를 얻으면서 더 많은 돈을 내게 됩니다.
실험 설계: 21개 조합을 같은 과제, 같은 가격표 위에 올려놓기
저자들은 두 벤치마크에서 각각 30개 과제를 무작위로 뽑아 고정하고, 21개 모델 하네스 조합이 정확히 같은 과제 집합 을 풀게 했습니다. 각 과제는 3회씩 반복 실행해 시도 간 편차를 담았으므로, 조합 하나당 90회의 실행 기록이 쌓입니다. 표본이 작다는 점은 저자들도 신뢰구간으로 명시하고 있고, 이 글 뒤쪽에서 따로 다룹니다.
비교 대상은 다음과 같습니다.
| 구분 | 항목 |
|---|---|
| 모델 (7종) | Claude Fable 5, Claude Opus 4.8, Claude Sonnet 4.6, Claude Haiku 4.5, GPT-5.6 Sol, GPT-5.6 Luna, Kimi K3 |
| 하네스 (3종) | Claude Code 2.1.224, Codex CLI 0.146.0, Pi 0.85.1 |
| 벤치마크 | SWE-bench Lite, Terminal-Bench 2.0 (공식 페이지는 현재 4.0 기준) |
| 과제 수 | 벤치마크당 무작위 추출 30개, 과제당 3회 반복 |
SWE-bench Lite는 전체 SWE-bench의 2,294개 이슈 중 300개를 추려낸 부분집합으로, 이미지나 외부 링크가 없고 한 파일만 수정하며 수정 덩어리가 3개 이하인 비교적 자족적인 버그 수정만 남긴 세트입니다. 이번 실험의 30개 과제는 이 300개에서 뽑은 것입니다.
실행 조건은 하네스마다 기본 설정에서 출발하되 각 하네스가 정의한 고강도(high effort) 설정을 선택했고, 긴 실행의 비용을 통제하기 위해 한 번의 시도를 100턴으로 제한했습니다. 턴 수와 노력 수준의 정의는 하네스마다 다르므로 이 값들을 하네스 간에 직접 비교할 수는 없습니다. 과제 성공 여부는 각 벤치마크의 공식 평가기로 판정했습니다.
측정 방식에서 특히 중요한 부분은 비용 표준화 입니다. 저자들은 2026년 9월 1일 자 직접 API 가격표를 고정해 두고 모든 하네스에 같은 단가를 적용했습니다. 구독 요금제나 하네스별 할인 조건이 비교를 오염시키지 않도록 토큰 사용량만으로 비용을 환산한 것입니다. 신뢰구간은 30개 과제 평균을 복원 추출로 다시 뽑아 전체 평균을 재계산하는 방식으로 10,000회 부트스트랩(bootstrap)해 구했습니다.
공정성을 위한 조치도 들어갔습니다. SWE-bench Lite에서는 모든 과제 컨테이너의 외부 네트워크 접근을 차단하고, Claude Code와 Codex의 기본 웹 도구를 비활성화했으며, 호스팅 도구 선언은 API 요청 수준에서 거부했습니다. 검색으로 정답을 우회하는 경로를 막기 위한 조치입니다. Pi에는 구독 키 설정과 에이전트 턴 제어를 위해 두 개의 패키지를 추가했고, Kimi K3는 Fireworks AI를 통해 접근하면서 세 하네스 모두에서 이 모델의 단일 네이티브 사고 모드를 사용했습니다.
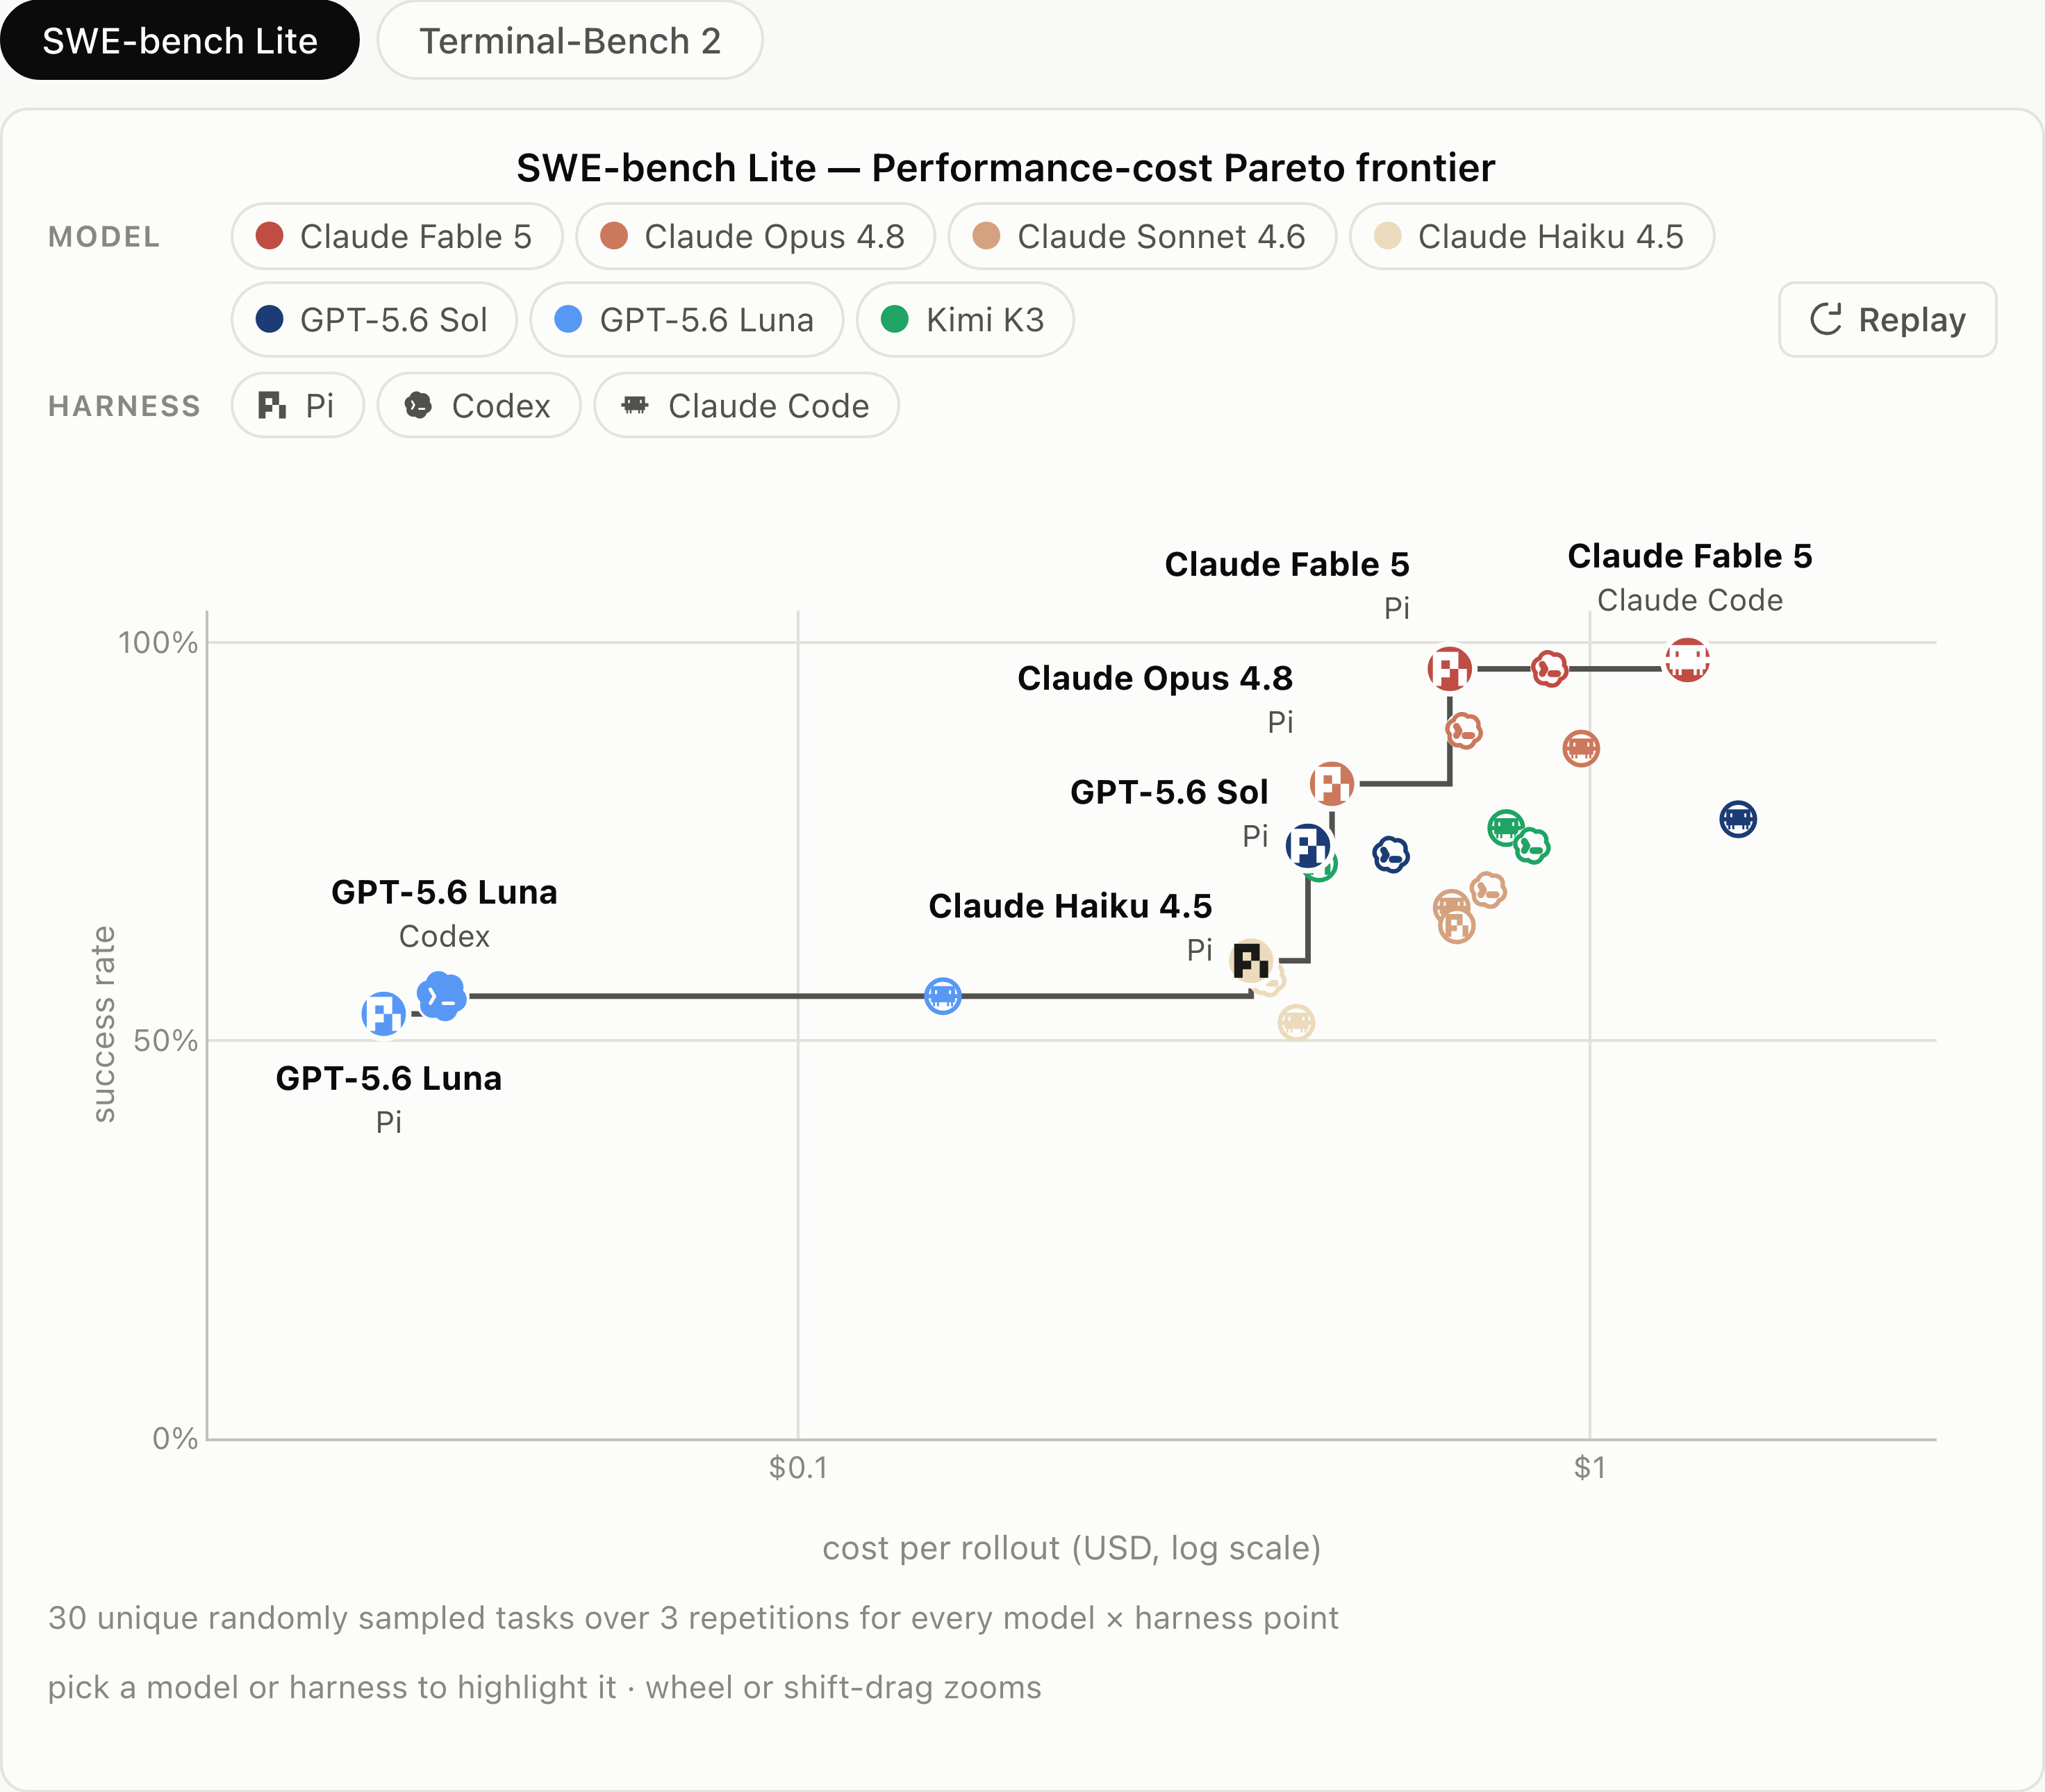
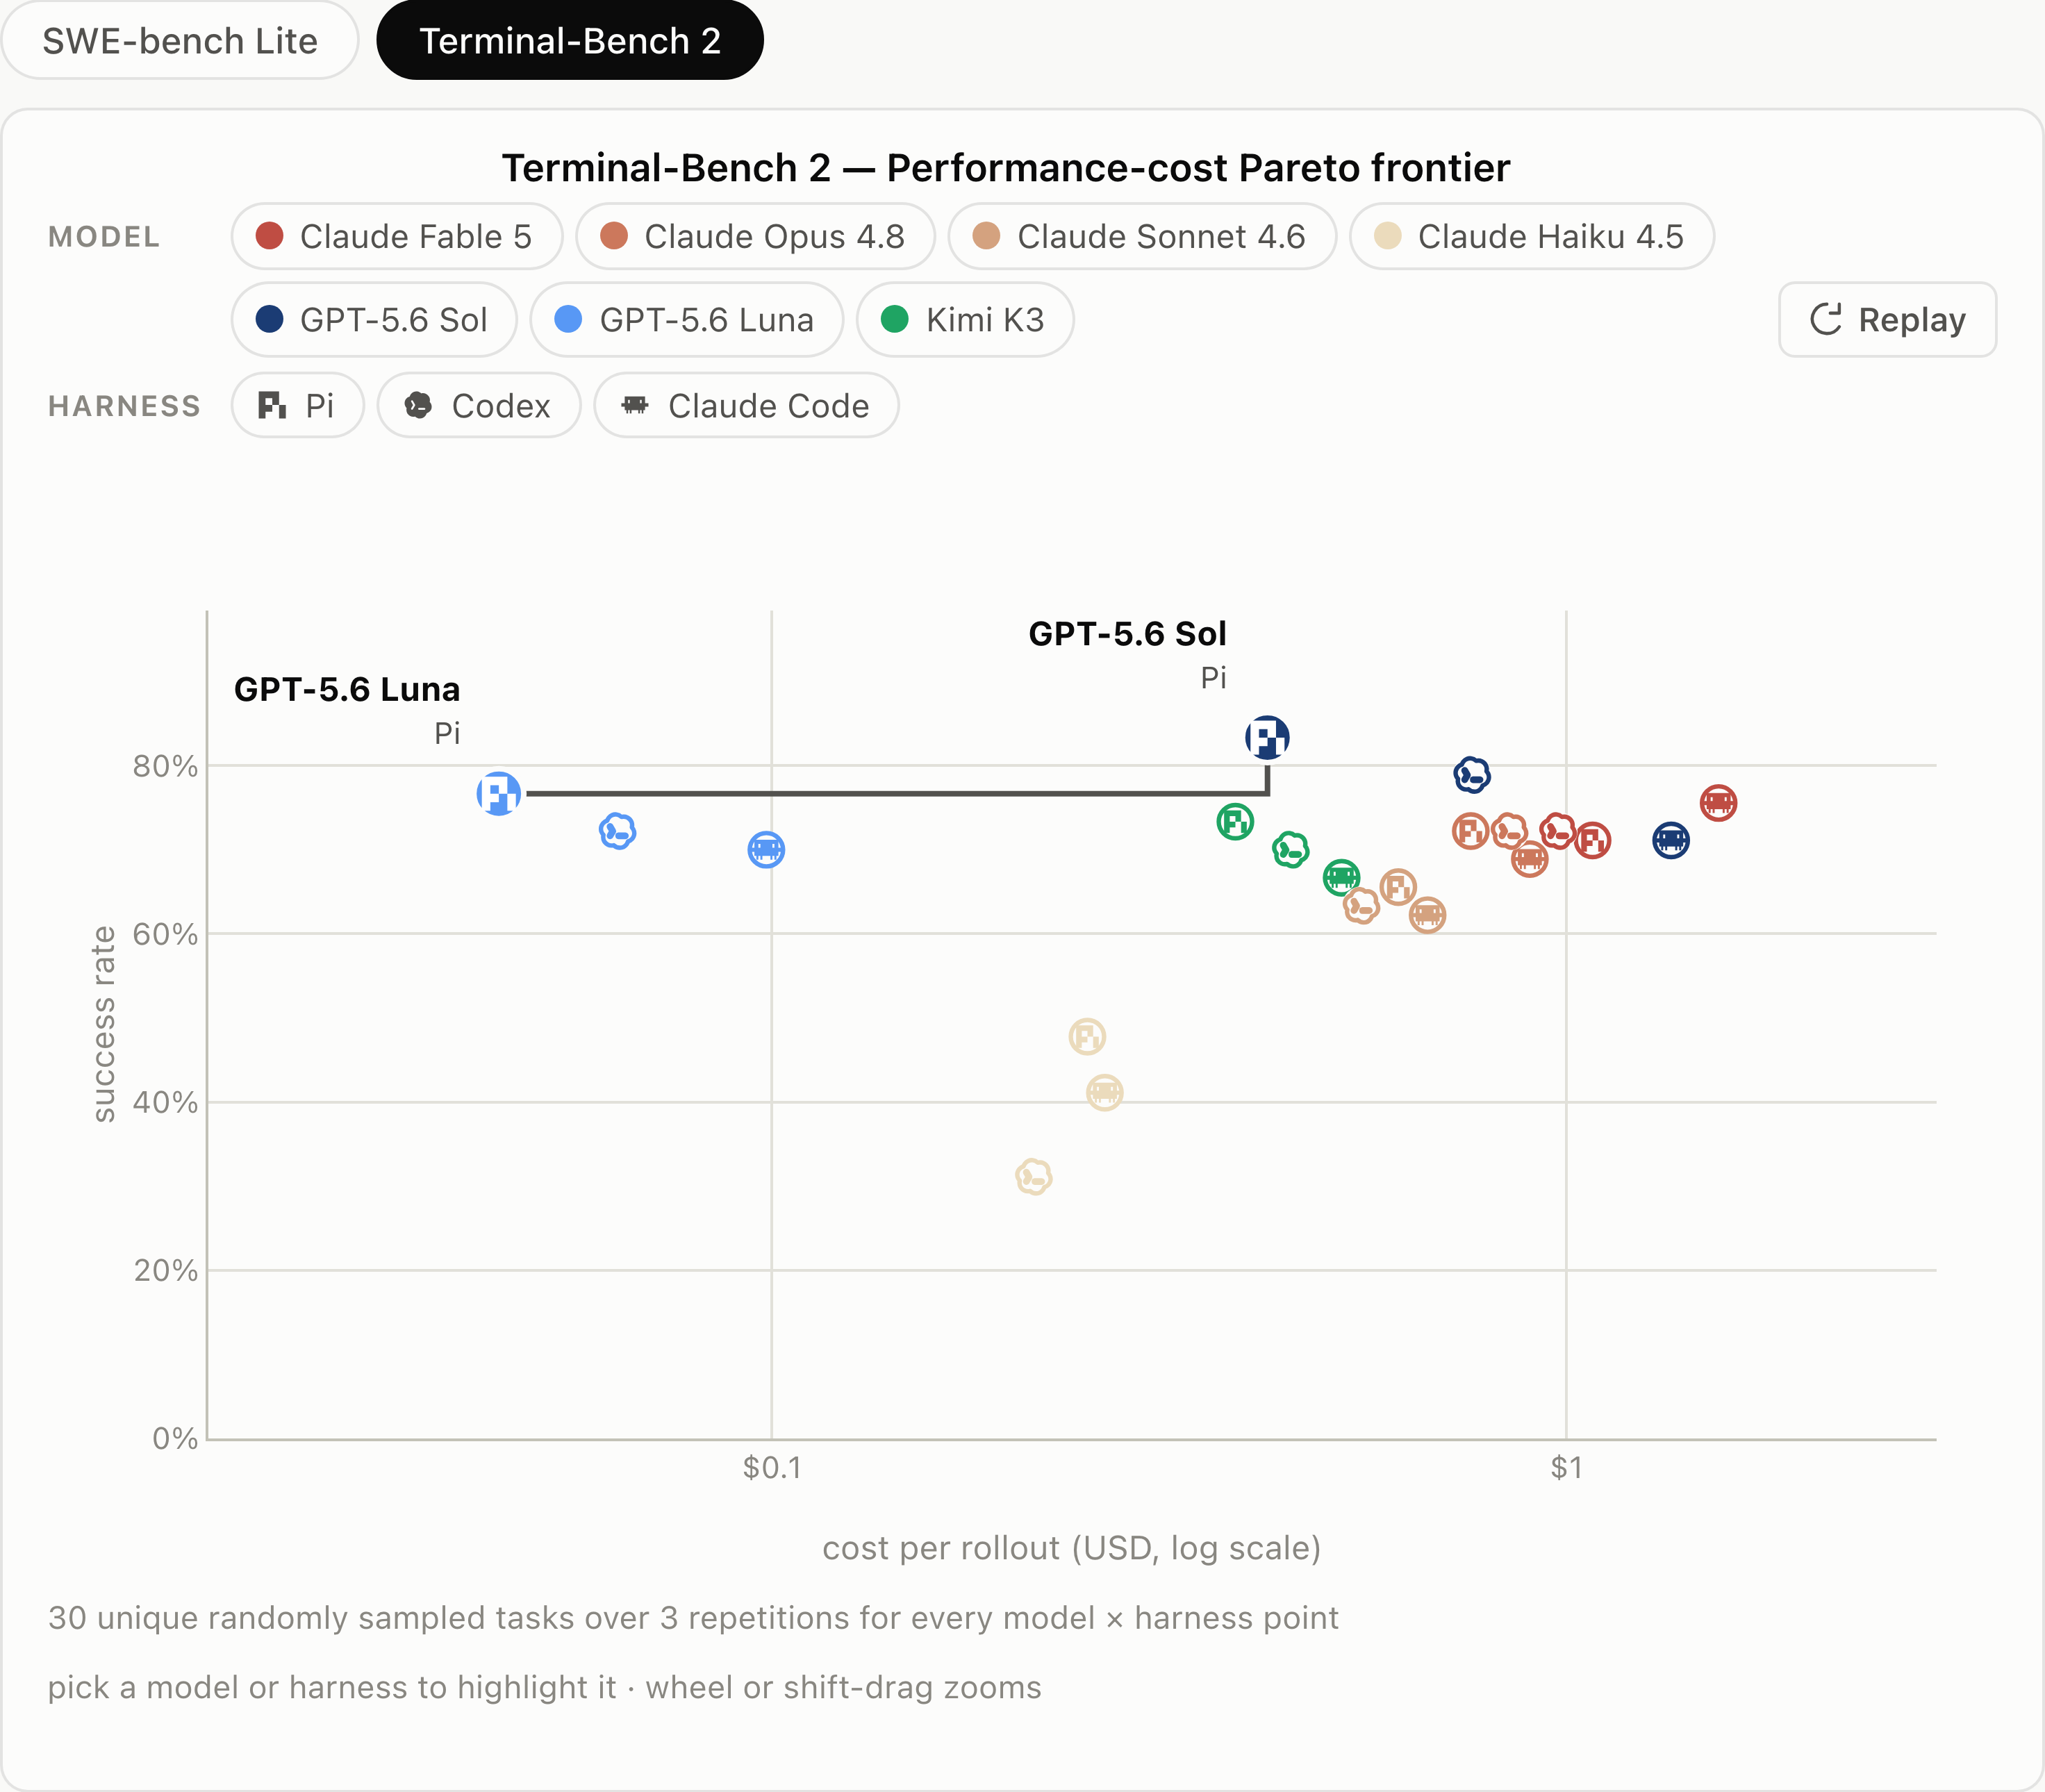
위 두 그림은 가로축에 회당 비용(로그 스케일), 세로축에 성공률을 놓고 21개 조합을 흩뿌린 것입니다. 계단 모양의 선은 각 비용 수준 이하에서 관측된 최고 성공률, 즉 파레토 프론티어(Pareto frontier) 를 나타냅니다. 프론티어에 오른 조합에 대해서는 그보다 싸면서 동시에 더 잘하는 조합이 관측되지 않았습니다.
발견 1: 하네스는 정답률보다 비용을 훨씬 크게 흔든다
두 그림에서 가장 먼저 눈에 들어오는 것은 같은 모델의 점들이 세로로는 거의 같은 높이에 모여 있는데 가로로는 넓게 흩어진다는 점입니다. 성공률은 하네스를 바꿔도 잘 움직이지 않고, 비용만 크게 움직입니다.
Claude Fable 5가 대표적입니다. SWE-bench Lite에서 이 모델은 Claude Code에서 97.8%, Codex에서 96.7%, Pi에서 96.7%의 시도를 성공시켰습니다. 세 하네스 사이의 성공률 차이는 1.1%포인트에 불과합니다. 그런데 회당 비용은 Pi가 $0.666, Codex가 $0.890, Claude Code가 $1.329로, Claude Code가 Pi의 약 2배를 씁니다. 같은 모델이 같은 과제를 거의 같은 비율로 풀면서 지출만 두 배가 된 것입니다.
격차가 가장 벌어진 쪽은 GPT-5.6 Luna입니다. SWE-bench Lite에서 Pi로 실행하면 회당 $0.030에 53.3%를 풀고, Claude Code로 실행하면 회당 $0.152에 55.6%를 풉니다. 성공률은 2.3%포인트 올랐지만 비용은 5.09배가 되었습니다. 원문 서두가 말하는 "같은 성공률에 최대 5배 비용"은 이 조합을 가리킵니다.
개별 사례를 넘어 전체를 보면, 저자들은 비용 비율의 기하평균으로 다음과 같이 정리합니다. SWE-bench Lite에서 Claude Code는 Pi의 약 2.0배, Codex의 약 1.6배를 쓰고, Terminal-Bench 2.0에서는 Pi의 약 1.5배를 씁니다. 반면 같은 기준에서 하네스가 성공률에 미친 평균 효과는 SWE-bench Lite에서 ±2% 이내, Terminal-Bench 2.0에서 약 ±5% 이내에 머물렀습니다.
SWE-bench Lite 21개 조합 전체 결과
아래 표는 원문 대시보드가 제공하는 조합별 수치를 성공률 순으로 정렬한 것입니다. 해결당 비용은 성공한 한 건을 얻는 데 든 평균 지출이고, 프론티어 부트스트랩은 재표집에서 그 조합이 프론티어에 남은 비율입니다.
| 모델 + 하네스 | 성공률 | 회당 비용 | 해결당 비용 | 프론티어 부트스트랩 | 파레토 |
|---|---|---|---|---|---|
| Claude Fable 5 + Claude Code | 97.8% | $1.329 | $1.360 | 34% | O |
| Claude Fable 5 + Pi | 96.7% | $0.666 | $0.689 | 99% | O |
| Claude Fable 5 + Codex | 96.7% | $0.890 | $0.921 | 38% | - |
| Claude Opus 4.8 + Codex | 88.9% | $0.694 | $0.780 | 28% | - |
| Claude Opus 4.8 + Claude Code | 86.7% | $0.976 | $1.126 | 0% | - |
| Claude Opus 4.8 + Pi | 82.2% | $0.473 | $0.575 | 86% | O |
| GPT-5.6 Sol + Claude Code | 77.8% | $1.540 | $1.980 | 0% | - |
| Kimi K3 + Claude Code | 76.7% | $0.784 | $1.023 | 1% | - |
| GPT-5.6 Sol + Pi | 74.4% | $0.441 | $0.592 | 59% | O |
| Kimi K3 + Codex | 74.4% | $0.845 | $1.135 | 0% | - |
| GPT-5.6 Sol + Codex | 73.3% | $0.561 | $0.765 | 6% | - |
| Kimi K3 + Pi | 72.2% | $0.455 | $0.630 | 31% | - |
| Claude Sonnet 4.6 + Codex | 68.9% | $0.745 | $1.081 | 0% | - |
| Claude Sonnet 4.6 + Claude Code | 66.7% | $0.669 | $1.004 | 0% | - |
| Claude Sonnet 4.6 + Pi | 64.4% | $0.679 | $1.054 | 0% | - |
| Claude Haiku 4.5 + Pi | 60.0% | $0.374 | $0.623 | 51% | O |
| Claude Haiku 4.5 + Codex | 57.8% | $0.392 | $0.678 | 26% | - |
| GPT-5.6 Luna + Codex | 55.6% | $0.035 | $0.064 | 79% | O |
| GPT-5.6 Luna + Claude Code | 55.6% | $0.152 | $0.274 | 38% | - |
| GPT-5.6 Luna + Pi | 53.3% | $0.030 | $0.056 | 100% | O |
| Claude Haiku 4.5 + Claude Code | 52.2% | $0.426 | $0.816 | 1% | - |
프론티어에 오른 7개 조합 중 5개가 Pi입니다. 나머지 둘은 가장 싼 구간의 GPT-5.6 Luna와 Codex의 조합, 그리고 가장 비싼 구간의 Claude Fable 5와 Claude Code의 조합입니다. 오픈 웨이트 모델인 Kimi K3는 Pi 위에서 $0.455에 72.2%를 기록해, 프론티어에 오른 GPT-5.6 Sol과 Pi의 조합($0.441, 74.4%) 바로 옆에 자리합니다.
Terminal-Bench 2.0 21개 조합 전체 결과
| 모델 + 하네스 | 성공률 | 회당 비용 | 해결당 비용 | 프론티어 부트스트랩 | 파레토 |
|---|---|---|---|---|---|
| GPT-5.6 Sol + Pi | 83.3% | $0.421 | $0.505 | 94% | O |
| GPT-5.6 Sol + Codex | 78.9% | $0.761 | $0.965 | 6% | - |
| GPT-5.6 Luna + Pi | 76.7% | $0.045 | $0.059 | 100% | O |
| Claude Fable 5 + Claude Code | 75.6% | $1.554 | $2.057 | 1% | - |
| Kimi K3 + Pi | 73.3% | $0.383 | $0.523 | 13% | - |
| GPT-5.6 Luna + Codex | 72.2% | $0.064 | $0.089 | 17% | - |
| Claude Opus 4.8 + Pi | 72.2% | $0.758 | $1.049 | 1% | - |
| Claude Opus 4.8 + Codex | 72.2% | $0.848 | $1.174 | 1% | - |
| Claude Fable 5 + Codex | 72.2% | $0.976 | $1.351 | 1% | - |
| Claude Fable 5 + Pi | 71.1% | $1.079 | $1.517 | 0% | - |
| GPT-5.6 Sol + Claude Code | 71.1% | $1.355 | $1.905 | 1% | - |
| GPT-5.6 Luna + Claude Code | 70.0% | $0.098 | $0.141 | 8% | - |
| Kimi K3 + Codex | 70.0% | $0.450 | $0.643 | 0% | - |
| Claude Opus 4.8 + Claude Code | 68.9% | $0.899 | $1.305 | 0% | - |
| Kimi K3 + Claude Code | 66.7% | $0.521 | $0.782 | 0% | - |
| Claude Sonnet 4.6 + Pi | 65.6% | $0.614 | $0.937 | 1% | - |
| Claude Sonnet 4.6 + Codex | 63.3% | $0.552 | $0.872 | 0% | - |
| Claude Sonnet 4.6 + Claude Code | 62.2% | $0.669 | $1.075 | 0% | - |
| Claude Haiku 4.5 + Pi | 47.8% | $0.250 | $0.522 | 0% | - |
| Claude Haiku 4.5 + Claude Code | 41.1% | $0.263 | $0.639 | 0% | - |
| Claude Haiku 4.5 + Codex | 31.1% | $0.214 | $0.687 | 0% | - |
터미널 과제에서는 순위가 상당히 달라집니다. SWE-bench Lite를 압도하던 Claude Fable 5가 71~76% 구간으로 내려오고, 대신 GPT-5.6 Sol과 Pi의 조합이 83.3%로 가장 높습니다. 회당 $0.045에 76.7%를 기록한 GPT-5.6 Luna와 Pi의 조합은 모든 재표집에서 프론티어를 지켰습니다. 이 벤치마크에서는 프론티어에 오른 조합이 둘뿐이고 둘 다 Pi입니다. 참고로 Claude Haiku 4.5와 Claude Code의 조합은 100턴 상한에 4회 걸렸고 그 4회는 모두 실패로 기록되었으므로, 이 조합의 41.1%는 상한 설정의 영향을 일부 포함한 값으로 읽어야 합니다.
하네스 세금(Harness Tax)이라는 이름
저자들은 이 상황에 이름을 붙입니다.
"본질적으로 같은 품질에 대해 서로 다른 하네스를 쓴다는 이유로 추가 비용을 내는 것은 일종의 하네스 세금을 내는 것과 같습니다."
"Paying extra for essentially the same quality because the use of different harnesses is like paying a... Harness Tax"
세금이라는 표현이 들어맞는 이유는 이 지출이 청구서에는 남지만 평가표에는 남지 않기 때문 입니다. 코딩 에이전트를 고를 때 우리는 보통 벤치마크 점수부터 보고, 점수가 비슷하면 익숙한 도구를 씁니다. 그 사이에 기본 하네스가 부과하는 비용 차이는 비교 대상에서 빠집니다. 저자들은 그래서 모델 평가가 널리 쓰이는 하네스들에 걸쳐 같은 모델의 비용과 성공률을 함께 비교해야 한다고 주장합니다.
발견 2: 도구 4개짜리 최소 하네스가 프론티어에 오른다
두 번째 발견은 하네스의 기능이 많을수록 좋다는 직관을 정면으로 건드립니다. Pi는 read, write, edit, bash 네 가지 도구만 제공하는 최소 구성의 오픈소스 하네스인데, 두 벤치마크 모두에서 파레토 프론티어에 올랐습니다. 이 최소주의는 기능을 덜 만든 결과가 아니라 명시된 설계 방침입니다. Pi 저장소의 철학 문서는 MCP, 서브 에이전트, 권한 승인 팝업, 플랜 모드, 내장 할 일 목록, 백그라운드 bash를 모두 코어에서 뺐다고 밝히고 있고, 필요한 기능은 확장(Extension)과 스킬(Skill)로 각자 붙이도록 설계되어 있습니다. PyTorchKR에서도 Gemma 4와 Pi Coding Agent로 완전히 로컬에서 실행하는 코딩 에이전트를 만드는 글을 통해 소개한 적이 있는 프로젝트입니다.
저자들은 이 차이가 어디서 오는지 확인하기 위해 완료된 시도들의 비용 누적, 기록된 턴 수, 그리고 첫 호출의 초기 컨텍스트를 들여다봅니다.
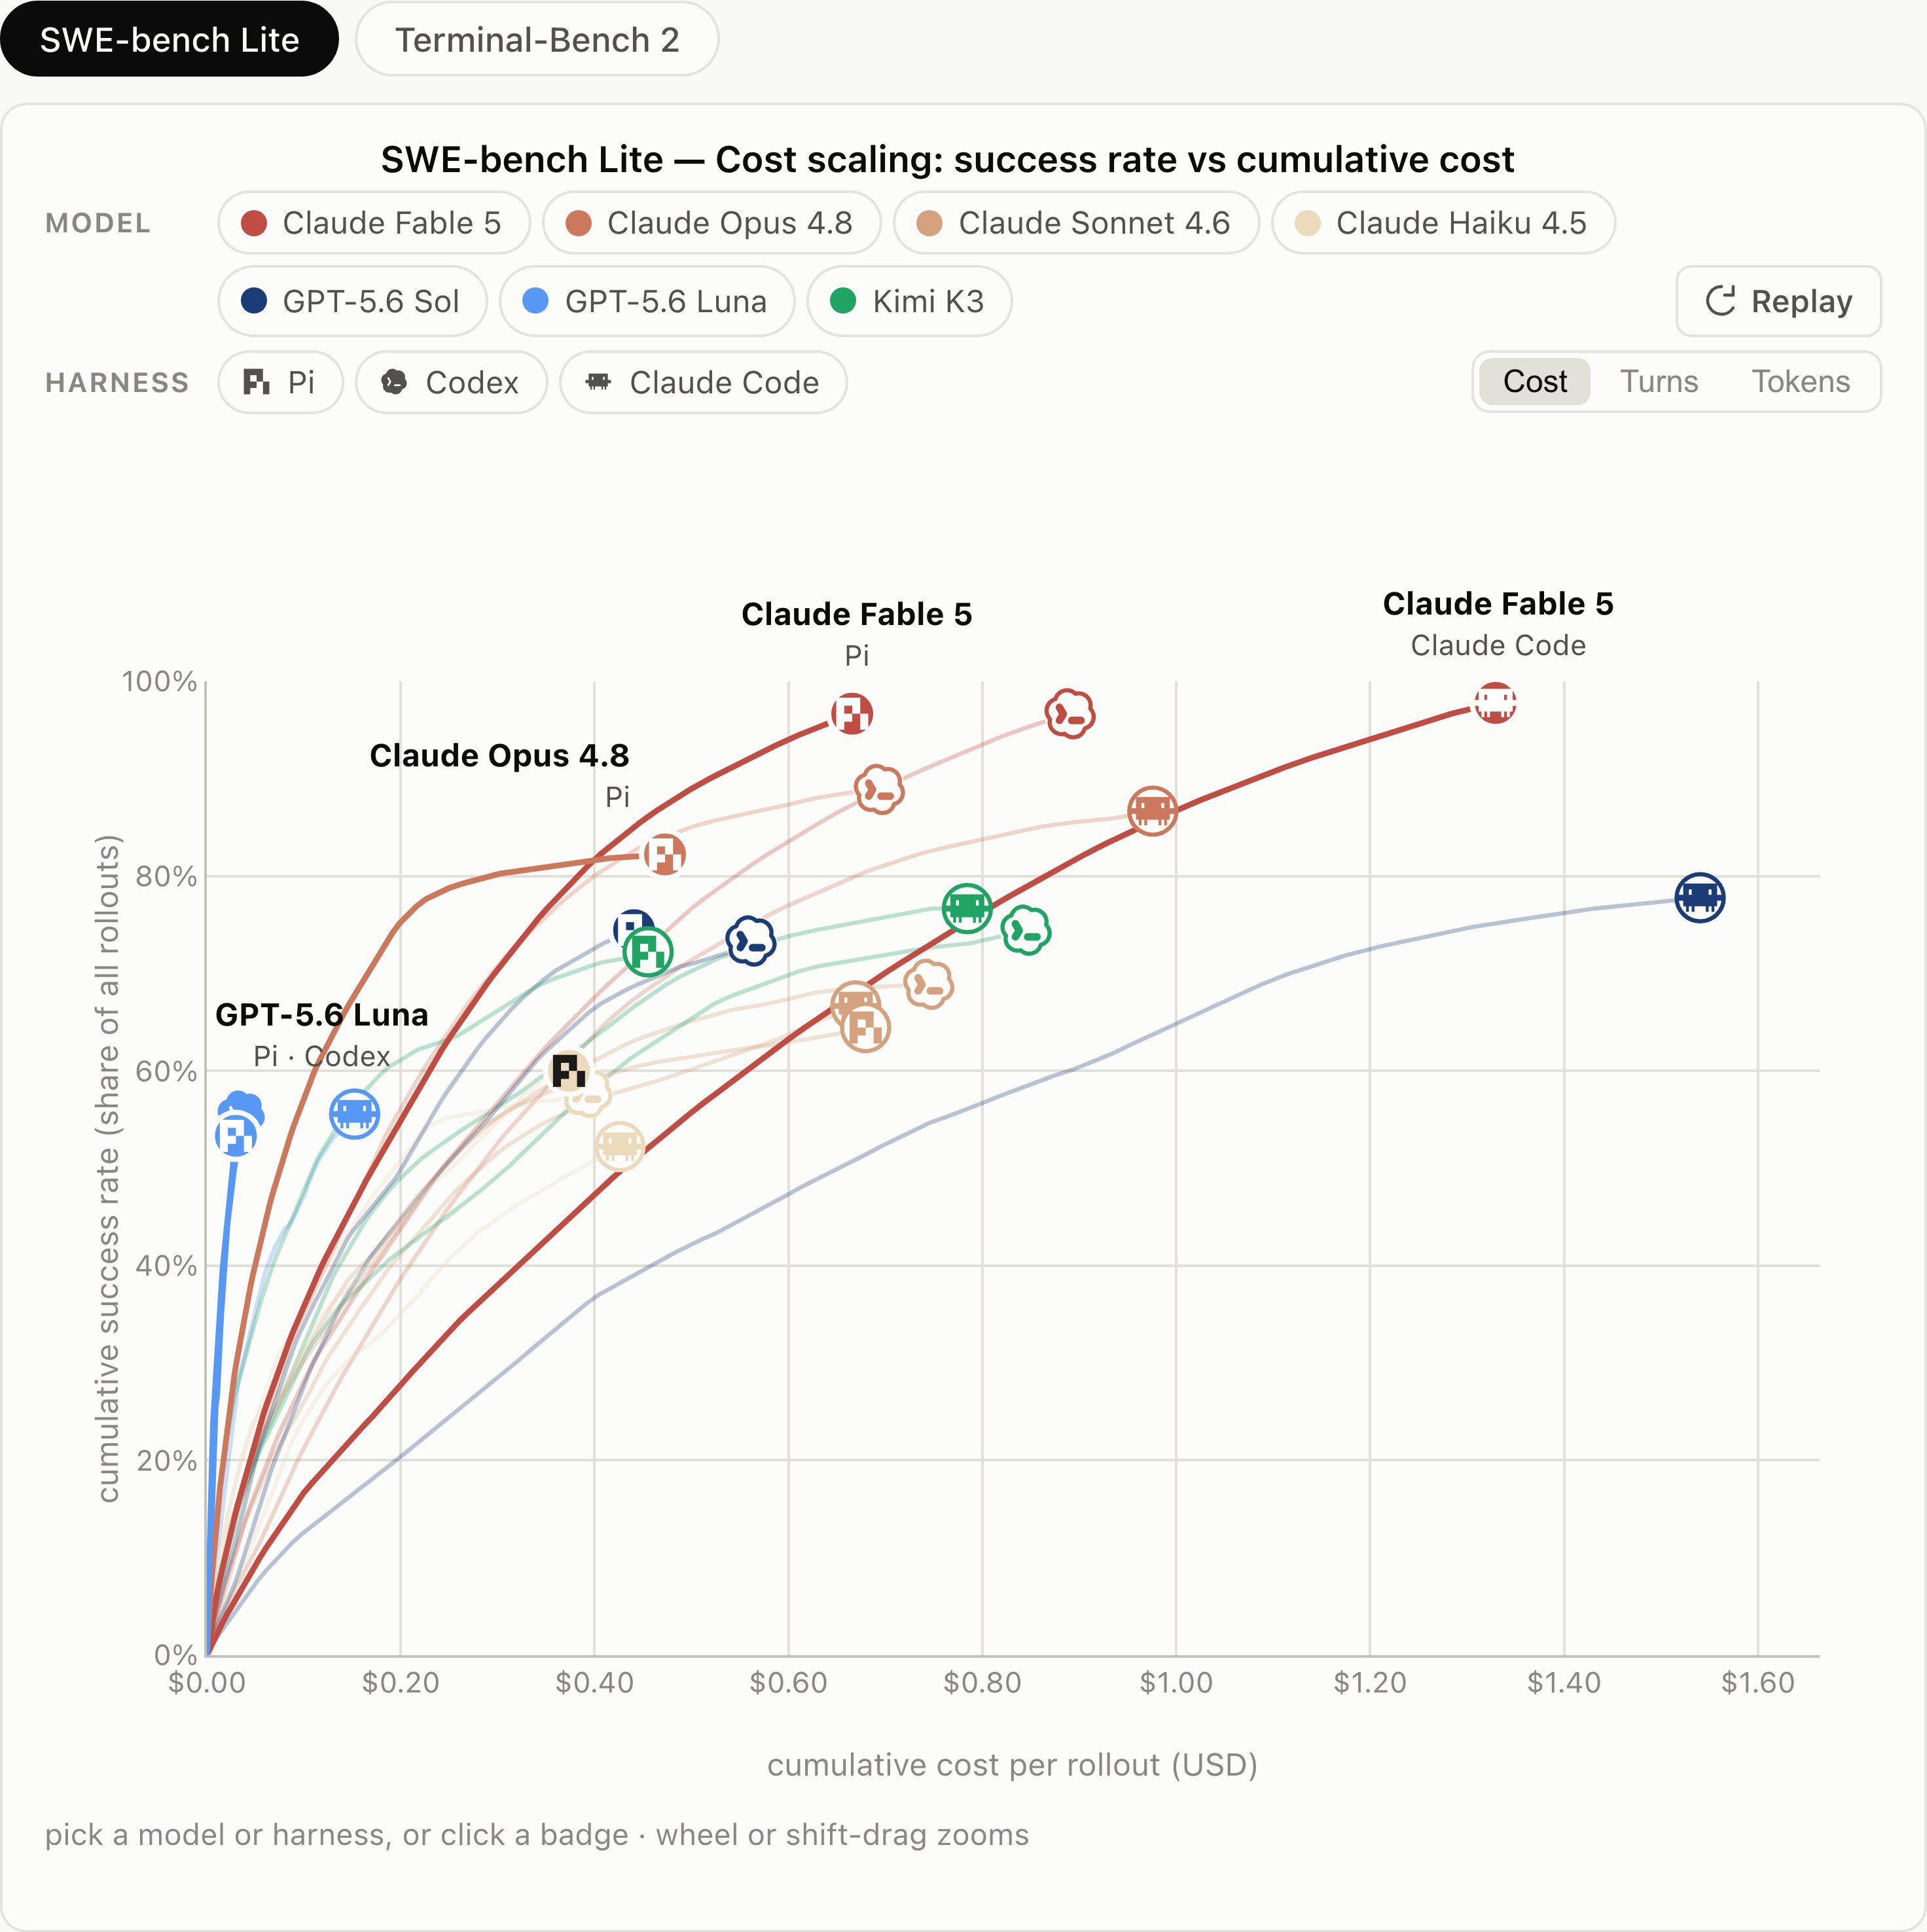
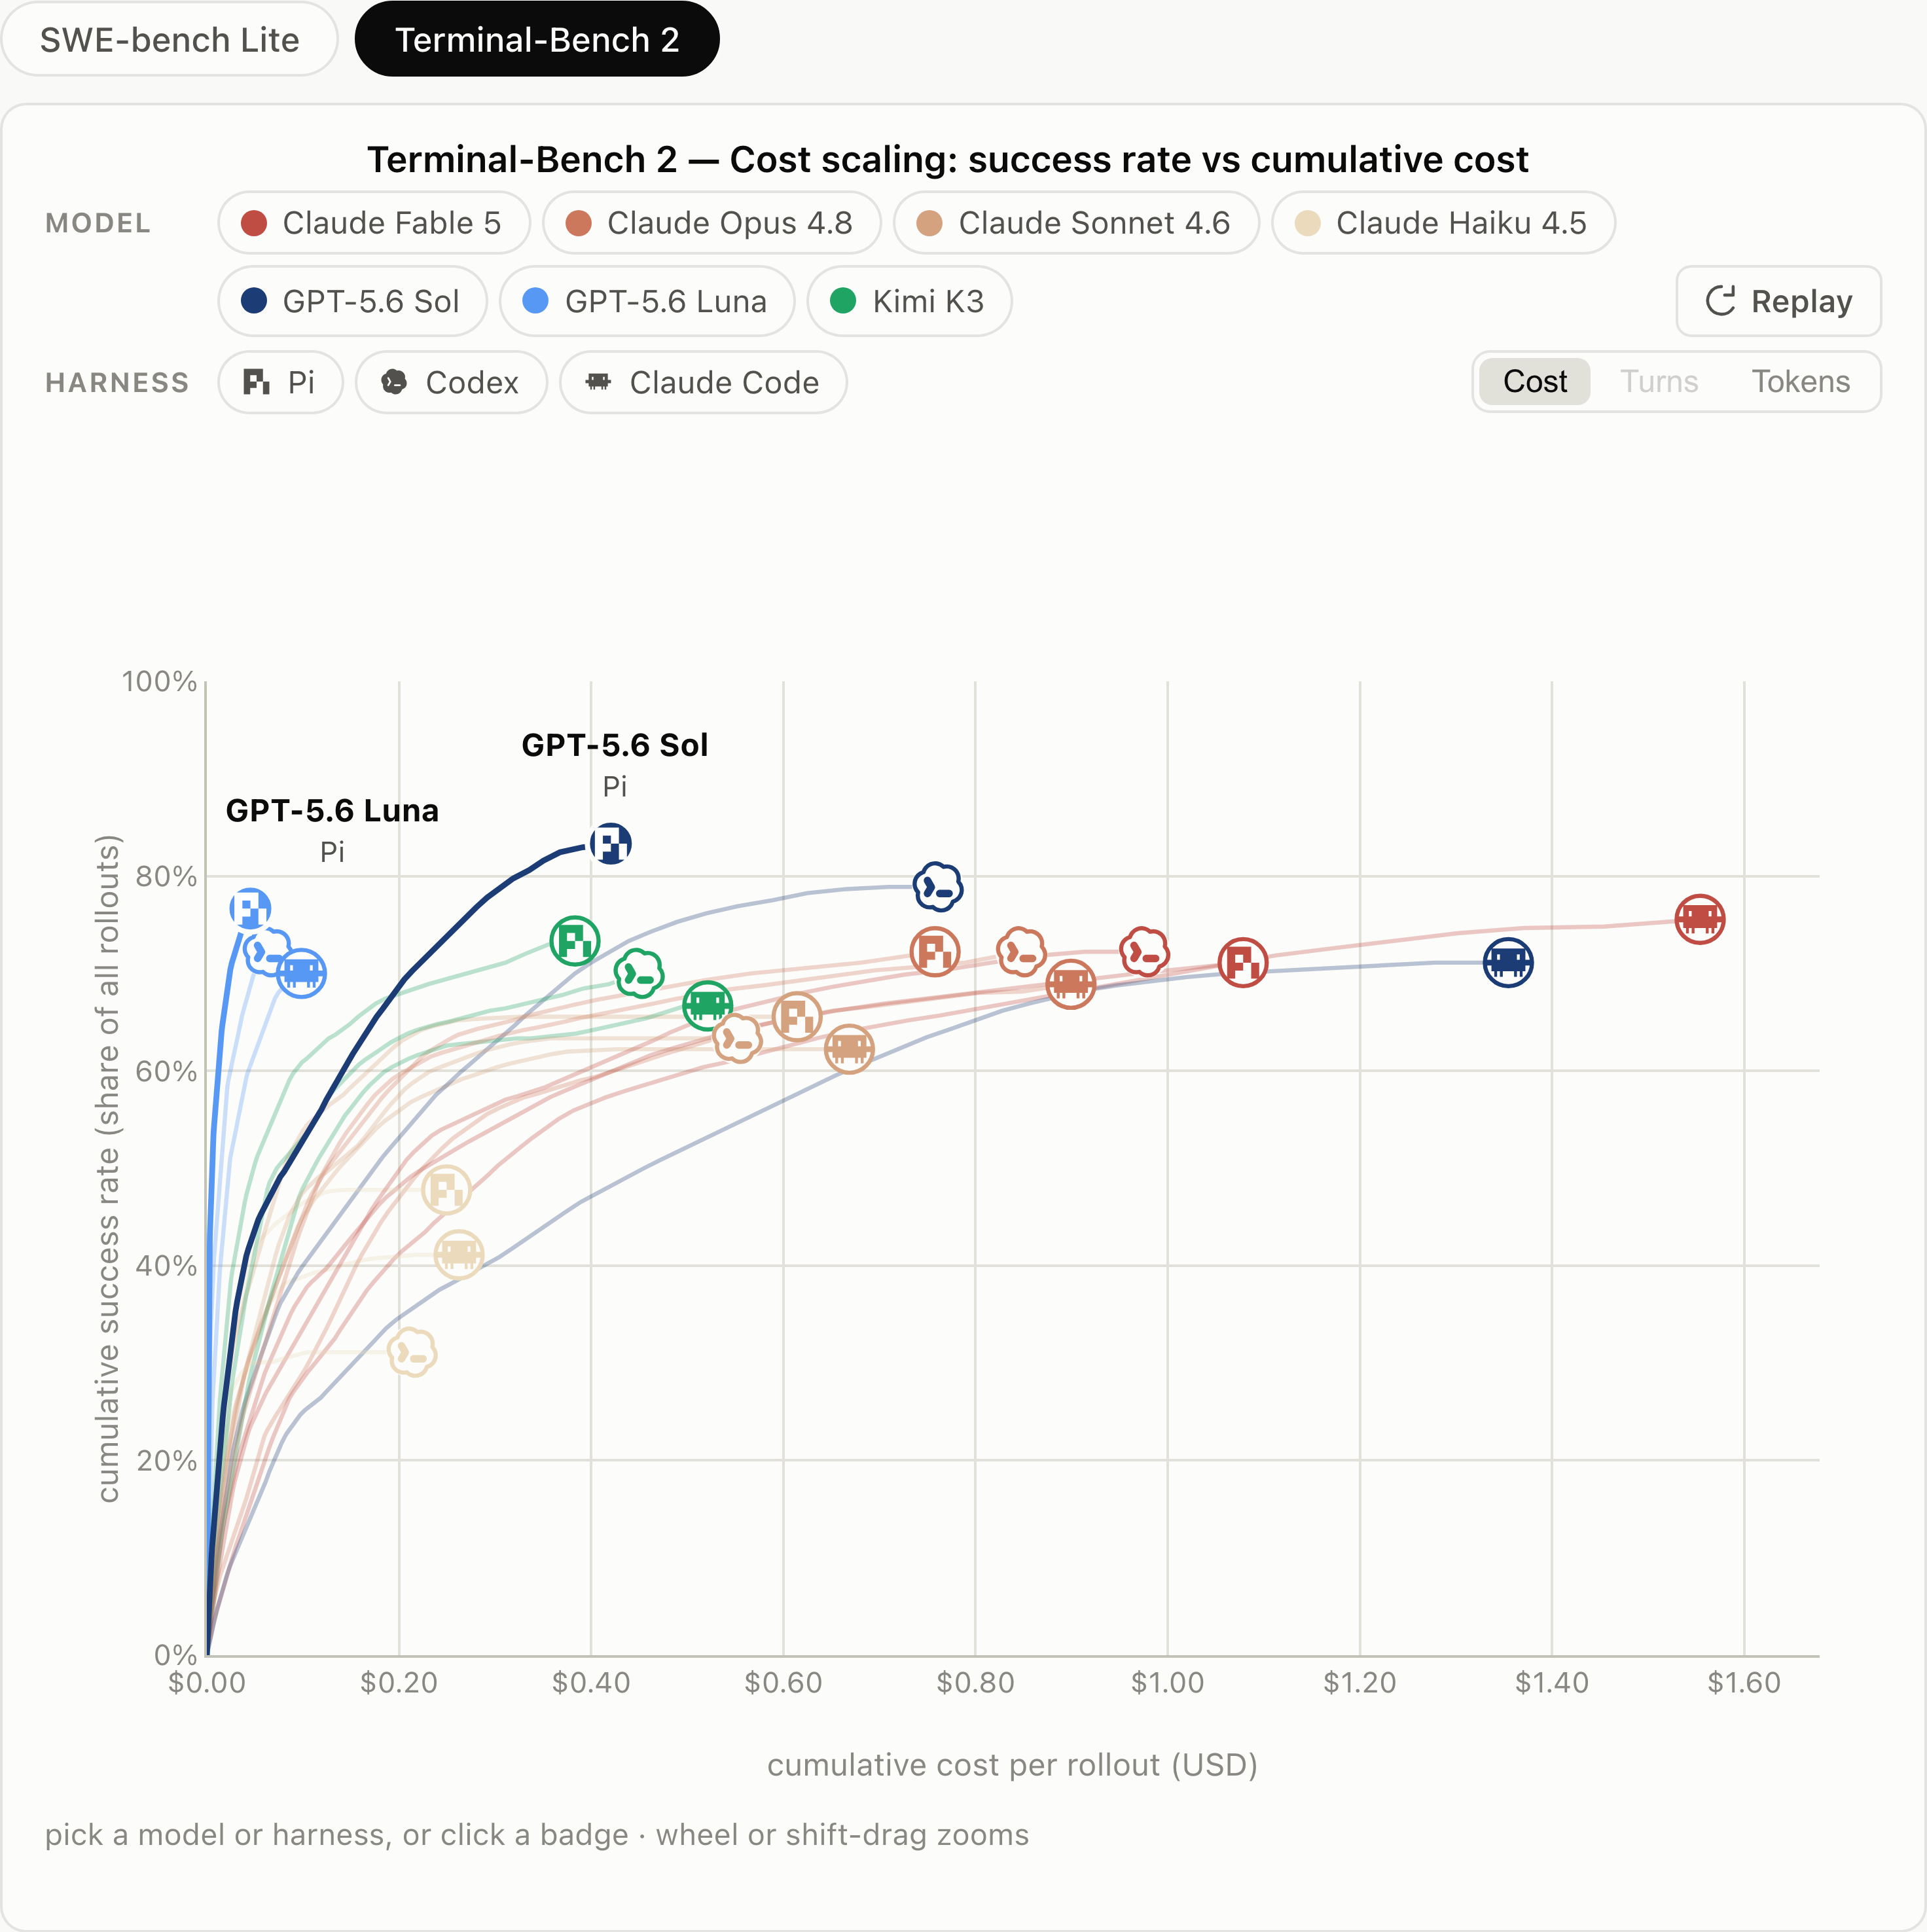
위 두 그림은 완료된 시도를 싼 것부터 비싼 것 순으로 정렬한 뒤 비용과 성공을 차례로 누적한 곡선입니다. 두 값 모두 시도 횟수로 나누었습니다. 실패한 시도는 비용만 더하고 성공은 더하지 않으므로, 곡선이 오른쪽으로 길게 누울수록 돈은 썼지만 결과를 얻지 못한 구간이 깁니다. 곡선 자체에는 9점 이동평균이 적용되어 있고, 평활하지 않은 끝점이 앞의 표에 나온 회당 비용과 최종 성공률에 해당합니다.
턴 수는 비슷한데 턴당 지출이 다르다
같은 대시보드에서 비용 대신 턴과 토큰을 축으로 놓으면 구조가 더 선명해집니다. 아래는 SWE-bench Lite에서 네 모델을 골라 회당 비용, 보고된 토큰 총량, 하네스가 정의한 턴 수를 함께 정리한 것입니다.
| 모델 + 하네스 | 회당 비용 | 토큰 | 턴 | 성공률 |
|---|---|---|---|---|
| Claude Fable 5 + Pi | $0.666 | 175.9k | 15.4 | 96.7% |
| Claude Fable 5 + Codex | $0.890 | 336.0k | 14.0 | 96.7% |
| Claude Fable 5 + Claude Code | $1.329 | 629.3k | 15.3 | 97.8% |
| Claude Opus 4.8 + Pi | $0.473 | 346.6k | 18.2 | 82.2% |
| Claude Opus 4.8 + Codex | $0.694 | 595.4k | 20.3 | 88.9% |
| Claude Opus 4.8 + Claude Code | $0.976 | 1.013M | 22.0 | 86.7% |
| GPT-5.6 Sol + Pi | $0.441 | 461.0k | 20.7 | 74.4% |
| GPT-5.6 Sol + Codex | $0.561 | 639.3k | 20.4 | 73.3% |
| GPT-5.6 Sol + Claude Code | $1.540 | 1.743M | 52.4 | 77.8% |
| GPT-5.6 Luna + Pi | $0.030 | 666.2k | 27.1 | 53.3% |
| GPT-5.6 Luna + Codex | $0.035 | 810.4k | 22.1 | 55.6% |
| GPT-5.6 Luna + Claude Code | $0.152 | 4.508M | 92.4 | 55.6% |
Claude Fable 5의 세 줄을 나란히 놓고 보면 논지가 분명해집니다. Pi와 Claude Code는 시도당 평균 15.4턴과 15.3턴으로 사실상 같은 횟수를 돌지만, 소비한 토큰은 175.9k와 629.3k로 3.6배 차이가 나고 비용은 2배가 됩니다. 턴 수가 같은데 지출이 다른 것은 한 턴에 실어 보내는 컨텍스트의 양 에서 차이가 난다는 신호입니다. 다만 턴의 정의가 하네스마다 다르므로 이 비교는 같은 모델 안에서만 유효합니다.
표의 아래쪽을 보면 다른 양상도 보입니다. GPT-5.6 Luna는 Pi에서 평균 27.1턴을 도는 반면 Claude Code에서는 92.4턴을 돌아 100턴 상한에 근접했고, 소비 토큰도 666.2k에서 4.508M으로 늘었습니다. GPT-5.6 Sol도 Pi에서 20.7턴, Claude Code에서 52.4턴으로 벌어집니다. 컨텍스트가 커지는 것만이 아니라 루프를 더 오래 도는 조합도 있다는 것입니다.
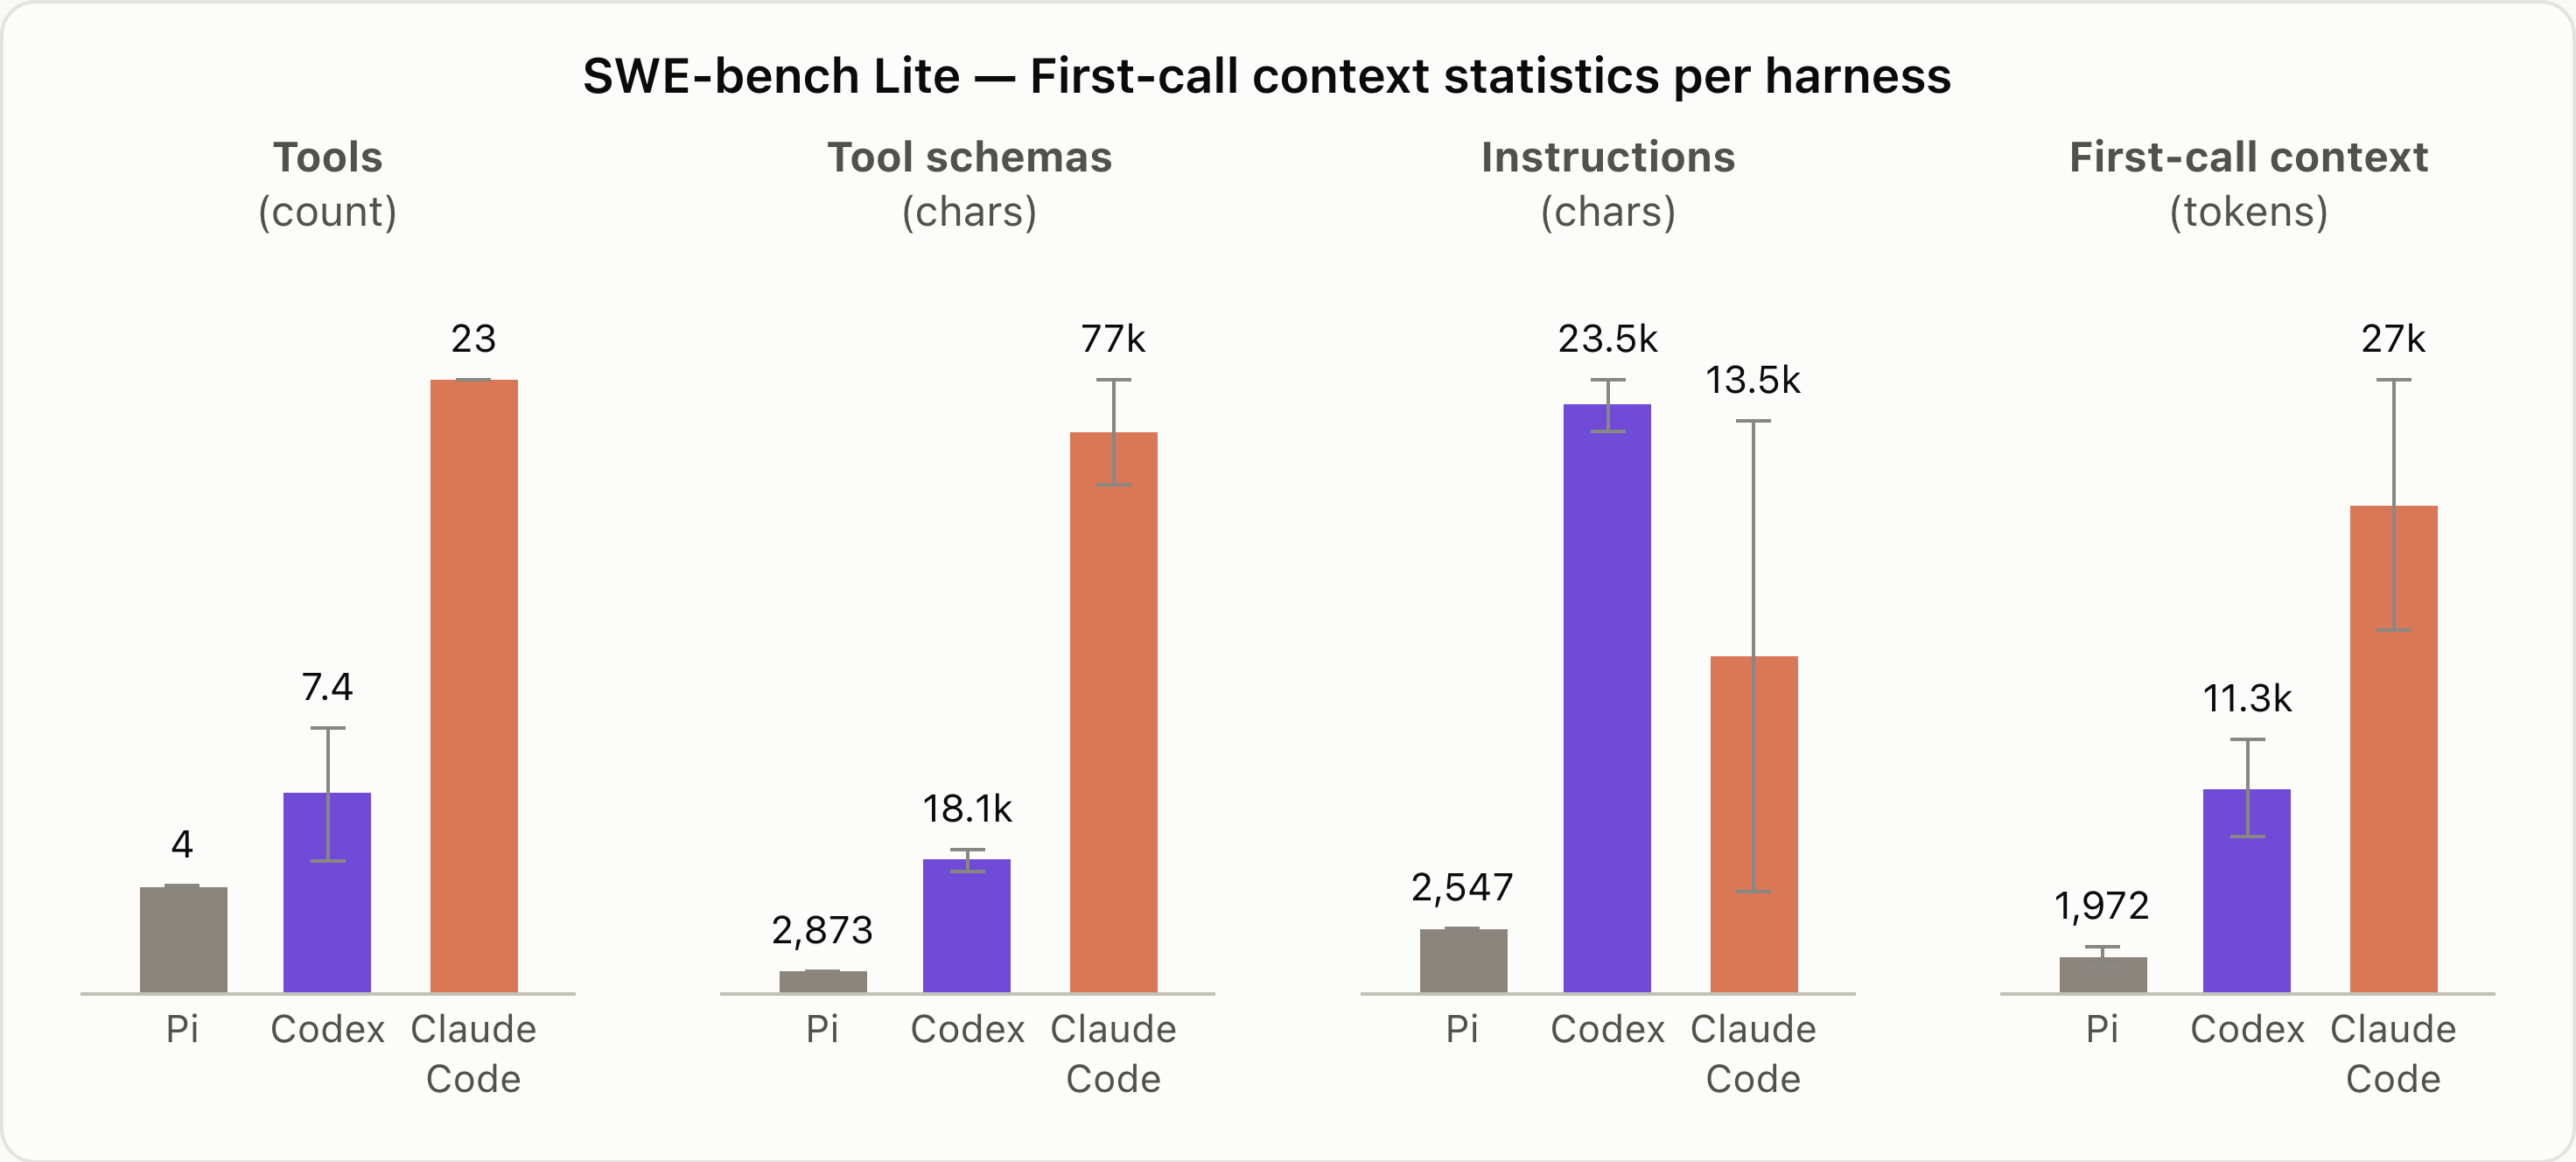
하네스 세금은 첫 모델 호출에서 이미 시작된다
위 그림은 첫 번째 주요 모델 호출 시점의 컨텍스트를 네 개 패널로 분해한 것입니다. 왼쪽부터 선언된 도구 개수, 도구 스키마의 문자 수, 시스템 및 개발자 지시문의 문자 수, 그리고 제공자가 보고한 입력 토큰입니다. 막대는 하네스별 평균이고 수염은 시도 간 표준편차입니다.
- 도구 개수: Pi는 4개로 고정되어 있고, Codex는 평균 7.4개, Claude Code는 23개를 선언합니다.
- 도구 스키마 길이: Pi 2,873자, Codex 18,114자, Claude Code 76,995자입니다. Claude Code의 도구 스키마 하나가 Pi의 지시문과 스키마를 합친 5,420자의 열네 배를 넘습니다.
- 지시문 길이: Pi 2,547자, Claude Code 13,465자, Codex 23,502자로, 이 항목에서는 Codex가 가장 깁니다.
- 첫 호출 컨텍스트: 제공자가 보고한 입력 토큰 기준으로 Pi 1,972토큰, Codex 11,308토큰, Claude Code 27,011토큰입니다.
이 격차는 이번 연구만의 관측이 아닙니다. 앞서 Portkey가 게이트웨이로 같은 요청을 통과시켜 측정했을 때도 Pi는 약 2,600토큰, Claude Code는 약 27,000토큰을 보냈습니다. 측정 방식과 과제가 전혀 다른데도 양쪽이 비슷한 자리에 도달한 셈입니다.
7개 모델 전체를 합쳐 보면 Claude Code의 평균 초기 컨텍스트는 Pi의 10배를 넘습니다. 다만 저자들은 이 추가 컨텍스트가 비용을 올릴 수 있다고만 말하고, 총 지출은 캐싱과 생성 토큰, 이후 호출까지 함께 결정된다는 단서를 답니다. 초기 컨텍스트는 하네스 세금이 어디서부터 붙기 시작하는지를 가리키는 지점이지, 그 자체로 비용 차이 전체를 설명하지는 않습니다.
오픈소스 하네스 연구에 열려 있는 문
저자들은 Pi와 Codex의 성적에서 연구 기회를 읽습니다. 최신 수준의 코딩 하네스를 다루기 위해 굳이 비공개 하네스에 접근하거나 모델과 함께 공동 학습할 필요가 없다는 것입니다. 실제로 하네스 설계를 다루는 자료는 최근 빠르게 쌓이고 있습니다. PyTorchKR에도 코드를 에이전트의 운영 기반으로 보는 서베이 논문, 하네스 엔지니어링 자료를 모은 큐레이션 저장소, Claude Code와 Codex의 하네스 설계 철학을 다룬 온라인 도서 같은 글이 올라와 있습니다.
다만 저자들은 결론을 "단순한 하네스가 이긴다"로 밀고 가지 않습니다. 더 풍부한 하네스 기능이 다른 모델이나 다른 워크로드, 다른 상호작용 환경에서는 도움이 될 수 있다고 덧붙이면서, 하네스 복잡도를 경험적으로 따져 볼 트레이드오프(trade-off) 로 다루자고 제안합니다.
발견 3: 모델은 자기 회사 하네스 밖에서도 잘 돈다
세 번째 발견은 제공자별 최적화에 관한 것입니다. 모델 제공사들은 종종 자사 코딩 환경에 맞춰 모델을 다듬습니다. OpenAI가 GPT-5-Codex를 Codex에서의 에이전틱 소프트웨어 엔지니어링에 최적화된 모델로 소개한 것이 그런 사례입니다. 그렇다면 Claude 모델은 Claude Code에서, GPT 모델은 Codex에서 가장 잘 돌아야 자연스럽습니다.
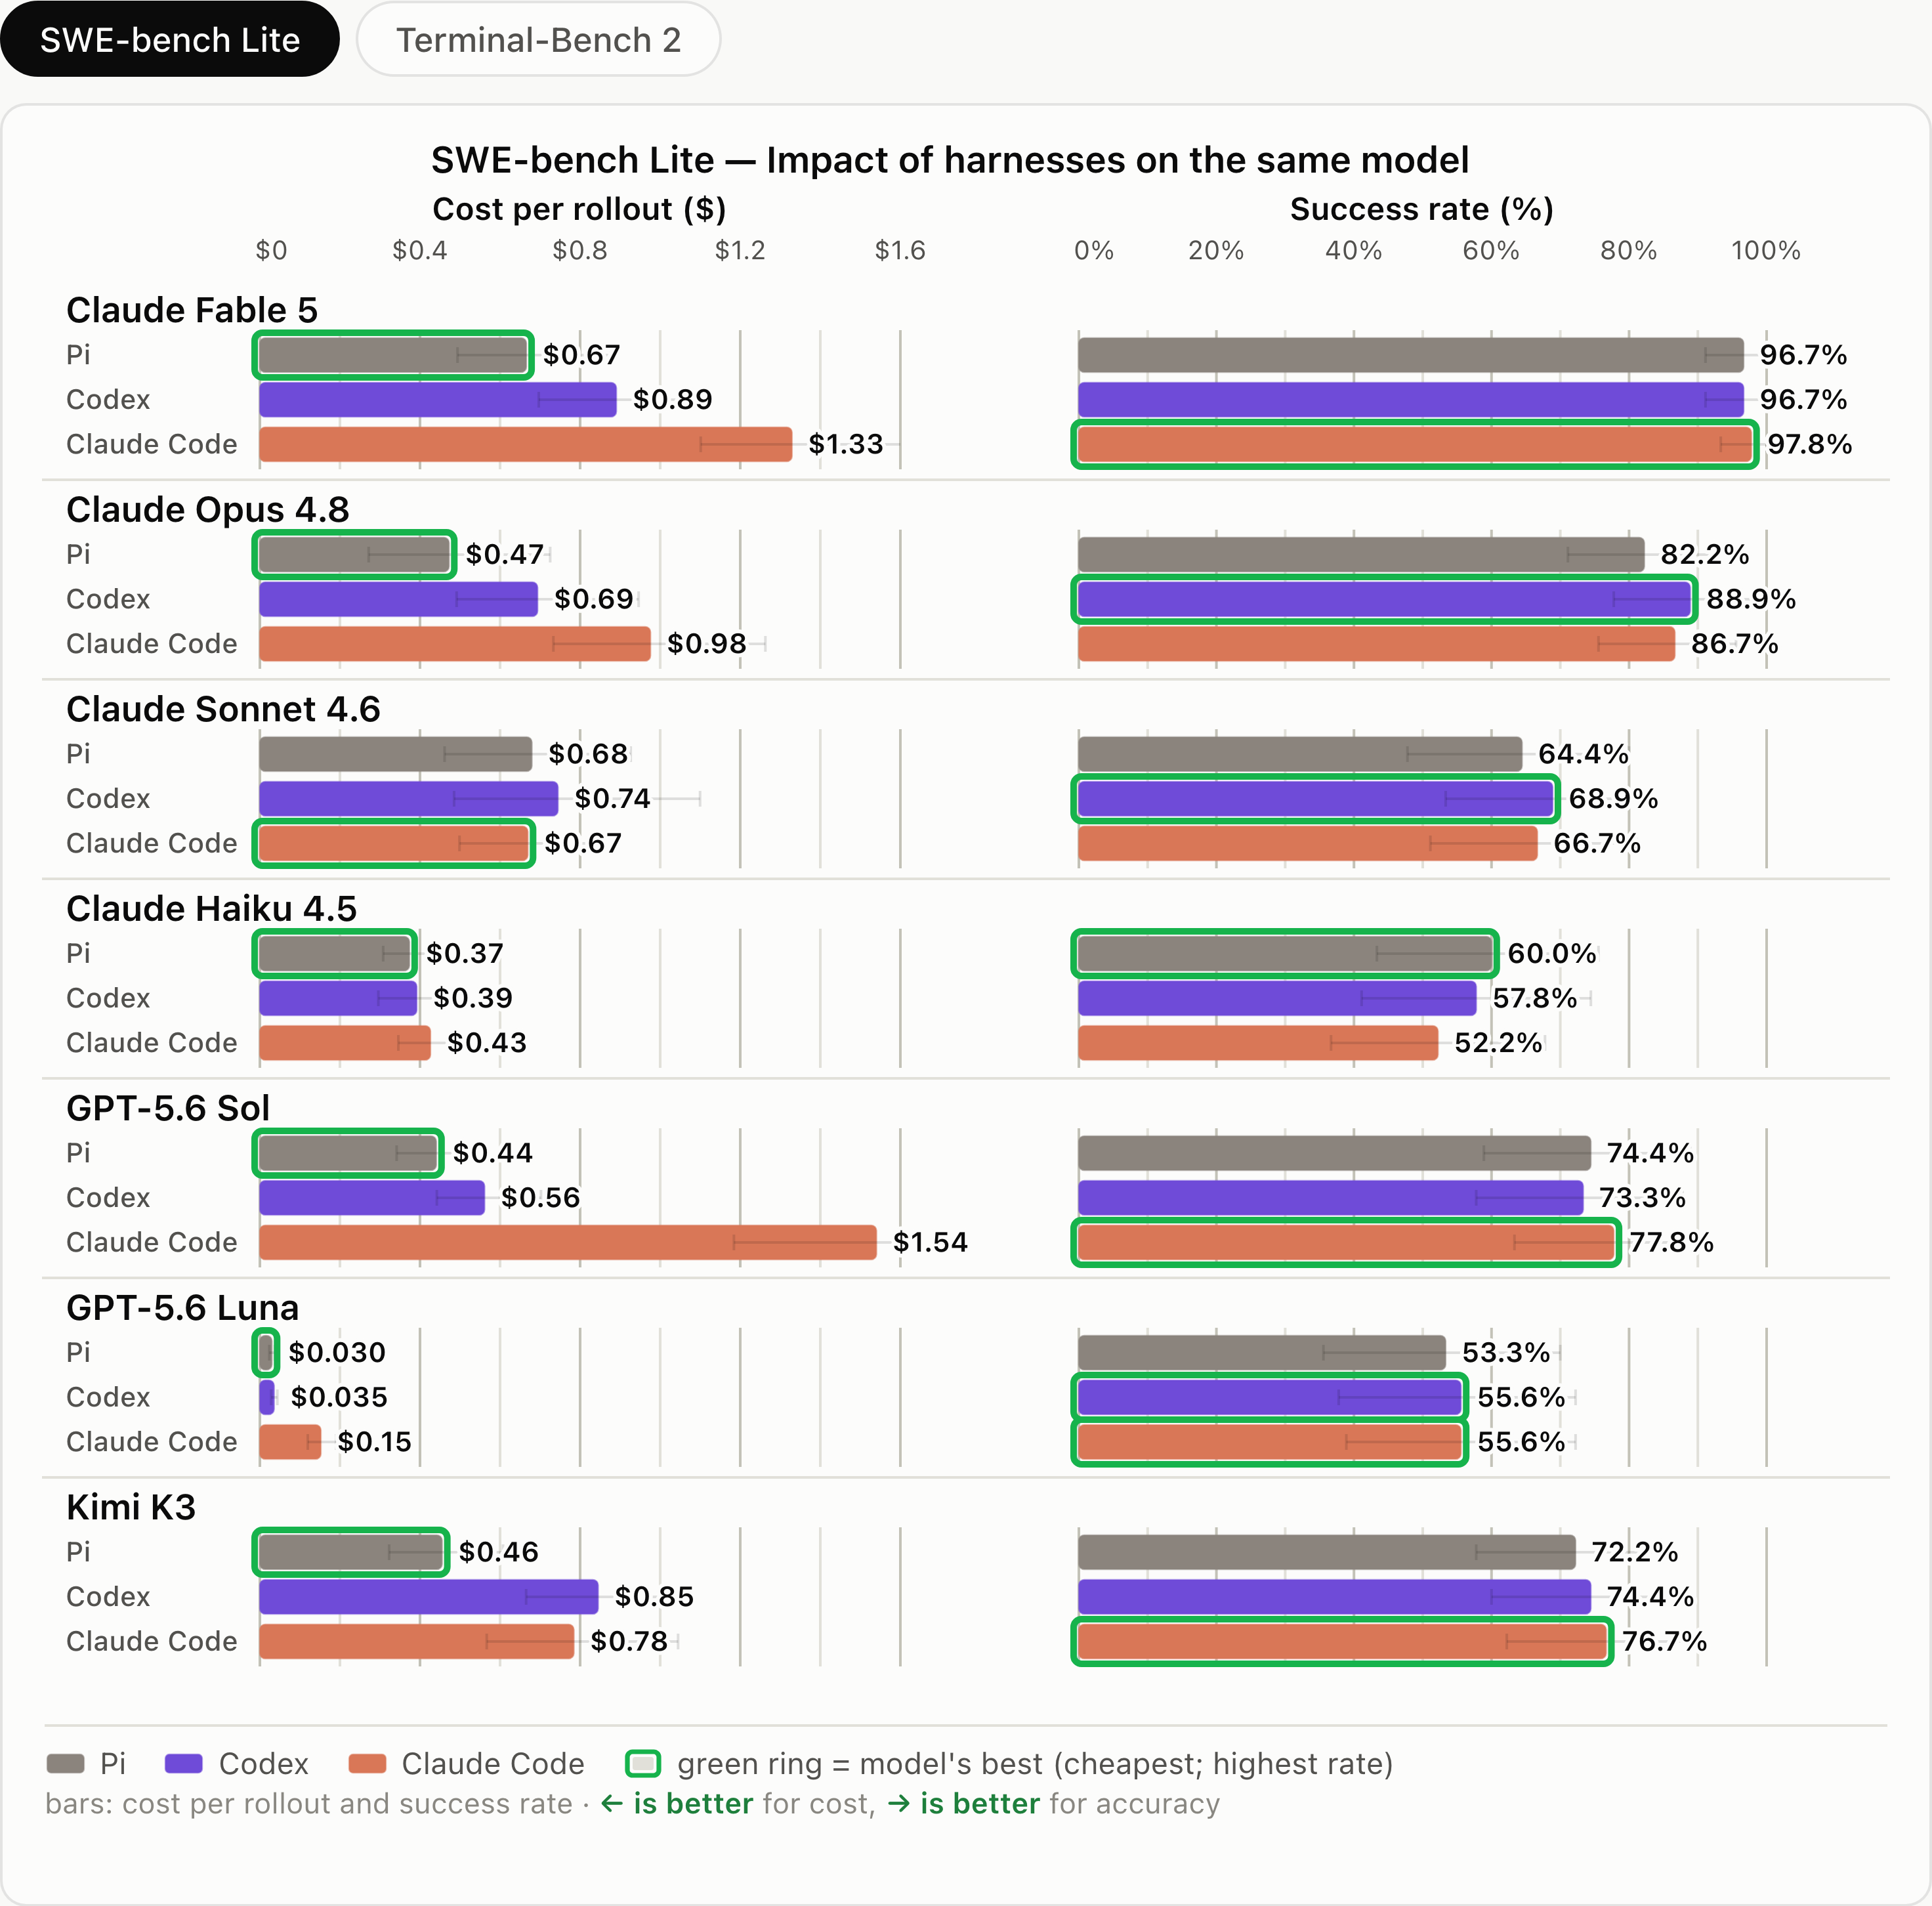
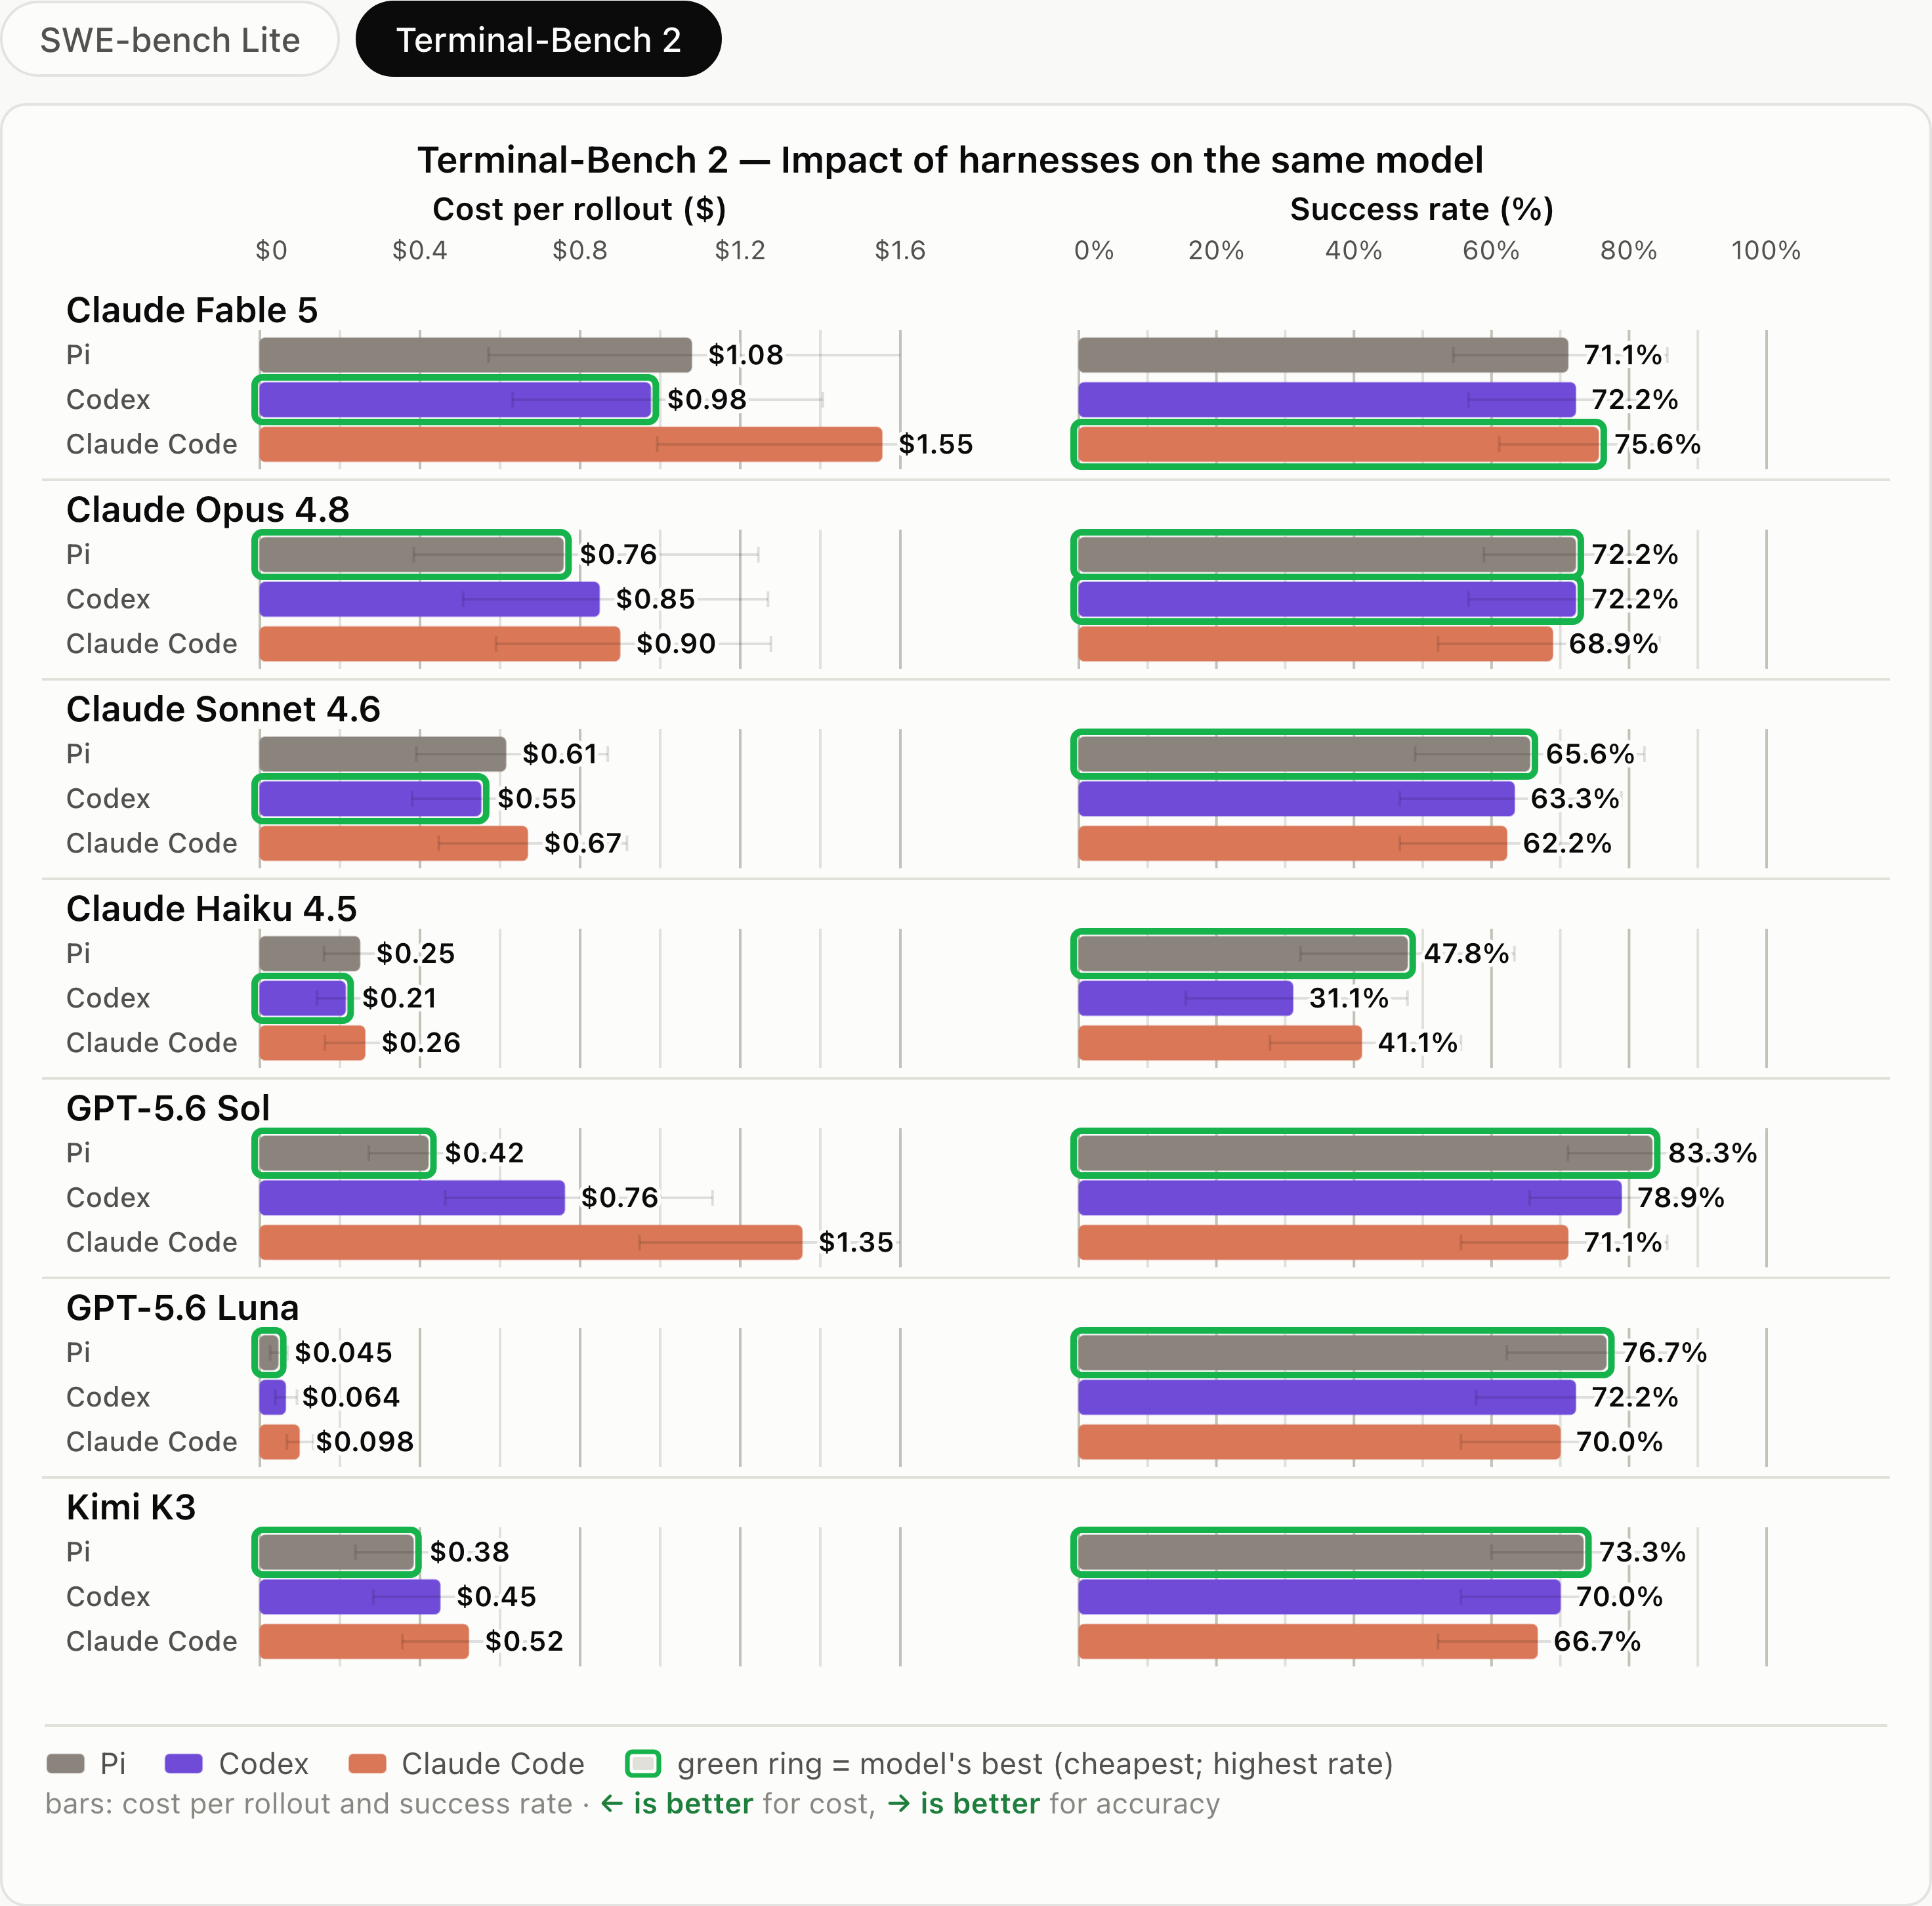
위 두 그림은 모델을 기준으로 묶어 왼쪽에 회당 비용, 오른쪽에 성공률을 나란히 놓은 것입니다. 수염은 95% 신뢰구간이고, 초록색 테두리는 그 모델에서 가장 싼 조합과 가장 성공률이 높은 조합을 각각 표시합니다.
Anthropic과 OpenAI의 6개 모델을 두 벤치마크에서 비교하면 총 12번의 대결이 나오는데, 그중 9번은 자사 하네스가 아닌 다른 하네스가 최고 성공률을 기록 했습니다. 어느 쪽이 이겼는지 정리하면 다음과 같습니다.
| 모델 | 벤치마크 | 자사 하네스 | 최고 성공률 조합 | 결과 |
|---|---|---|---|---|
| Claude Fable 5 | SWE-bench Lite | Claude Code 97.8% | Claude Code 97.8% | 자사 |
| Claude Opus 4.8 | SWE-bench Lite | Claude Code 86.7% | Codex 88.9% | 타사 |
| Claude Sonnet 4.6 | SWE-bench Lite | Claude Code 66.7% | Codex 68.9% | 타사 |
| Claude Haiku 4.5 | SWE-bench Lite | Claude Code 52.2% | Pi 60.0% | 타사 |
| GPT-5.6 Sol | SWE-bench Lite | Codex 73.3% | Claude Code 77.8% | 타사 |
| GPT-5.6 Luna | SWE-bench Lite | Codex 55.6% | Codex 55.6% (Claude Code와 동률) | 자사 |
| Claude Fable 5 | Terminal-Bench 2.0 | Claude Code 75.6% | Claude Code 75.6% | 자사 |
| Claude Opus 4.8 | Terminal-Bench 2.0 | Claude Code 68.9% | Pi, Codex 72.2% | 타사 |
| Claude Sonnet 4.6 | Terminal-Bench 2.0 | Claude Code 62.2% | Pi 65.6% | 타사 |
| Claude Haiku 4.5 | Terminal-Bench 2.0 | Claude Code 41.1% | Pi 47.8% | 타사 |
| GPT-5.6 Sol | Terminal-Bench 2.0 | Codex 78.9% | Pi 83.3% | 타사 |
| GPT-5.6 Luna | Terminal-Bench 2.0 | Codex 72.2% | Pi 76.7% | 타사 |
구체적인 사례를 보면 이렇습니다. Claude Sonnet 4.6은 SWE-bench Lite에서 Codex로 68.9%, Claude Code로 66.7%를 기록했는데 비용은 $0.745와 $0.669로 비슷합니다. GPT-5.6 Sol은 Terminal-Bench 2.0에서 Pi로 83.3%, Codex로 78.9%를 기록하면서 비용은 $0.42와 $0.76으로 절반 수준이었습니다. 성공률과 비용이 동시에 나아진 경우입니다.
저자들은 이 결과를 모델 능력의 이전 가능성으로 해석합니다.
"이 결과들은 모델의 능력이 호환 가능하고 일반화되며 다른 하네스로도 이어질 수 있음을 보여줍니다."
"These results show that a model's capabilities are compatible, generalizable and can carry over to other harnesses."
즉, 제공자가 같다는 사실만으로 최적의 짝이 보장되지는 않습니다. 남는 질문은 여전히 실무적입니다. 주어진 모델과 워크로드에 대해 어떤 하네스가 비용과 성공률의 균형을 가장 잘 맞추는가 하는 것입니다.
무엇이 통계적으로 확실하고 무엇이 아닌가
이 연구를 인용할 때 함께 봐야 할 것은 각 주장의 증거 강도입니다. 원문 대시보드는 조합별로 어떤 검정을 통과했는지를 따로 표기하는데, 그 결과가 꽤 비대칭적입니다.
SWE-bench Lite에서 Pi를 기준으로 14개 비교를 수행했을 때, 다중 비교를 보정하는 홀름 보정(Holm correction)을 통과한 항목은 다음과 같습니다.
- 비용 차이가 보정 후에도 유의한 비교 8건: Claude Fable 5와 Claude Code(2.00배), Claude Fable 5와 Codex(1.34배), Claude Opus 4.8과 Claude Code(2.06배), GPT-5.6 Sol과 Claude Code(3.50배), GPT-5.6 Sol과 Codex(1.27배), GPT-5.6 Luna와 Claude Code(5.09배), Kimi K3와 Claude Code(1.72배) 및 Kimi K3와 Codex(1.86배)가 여기에 해당합니다.
- 성공률 차이가 보정 후에도 유의한 비교 1건: Claude Opus 4.8을 Codex로 돌렸을 때 Pi 대비 6.7%포인트 높았던 것 하나뿐입니다.
- 나머지 성공률 비교: 신뢰구간이 0을 포함하거나 보정 후 유의성이 사라졌습니다.
정리하면, "비용은 다르다"는 통계적으로 반복해서 확인되는 반면 "성공률은 다르다"는 대체로 확인되지 않습니다. 이 연구의 핵심 주장이 성공률이 아니라 비용 쪽에 놓인 근거가 여기에 있습니다.
Terminal-Bench 2.0 쪽은 조건이 다릅니다. 원문 대시보드는 이 벤치마크의 하네스 비교를 "공통 n=30 기준의 서술적 추정치이며 확증적 검정은 수행하지 않음" 으로 명시합니다. 따라서 터미널 과제에서 관측된 차이는 방향성을 참고하는 수준으로 읽는 편이 안전합니다.
표본 크기도 함께 봐야 합니다. 벤치마크당 30개 과제에 3회 반복이므로 성공률의 95% 신뢰구간이 넓습니다. 예를 들어 Claude Opus 4.8과 Pi의 조합은 82.2%지만 구간은 71.1%에서 92.2%에 걸쳐 있고, GPT-5.6 Luna와 Pi의 조합은 53.3%에 구간이 35.6%에서 70.0%입니다. 모델 간 순위를 이 표만으로 단정하기는 어렵습니다. 반대로 비용 쪽 신뢰구간은 훨씬 좁아서, 이 연구가 비용 축에서 더 단단한 이야기를 할 수 있는 이유가 됩니다.
저자들이 직접 밝힌 한계
저자들은 결과의 적용 범위를 스스로 좁혀 둡니다. 두 벤치마크 모두 공개 데이터셋이므로 모델이 학습 과정에서 이미 접했을 가능성이 있고, 다른 벤치마크나 실제 워크로드에서는 결과가 달라질 수 있다는 점을 명시합니다. SWE-bench Lite에서 Claude Fable 5가 96~98%를 기록한 것도 이 맥락에서 읽을 필요가 있습니다. 앞서 본 것처럼 Lite는 한 파일만 고치는 자족적인 버그 수정으로 추려진 세트라 상단이 이미 포화에 가깝고, 그만큼 하네스 차이가 성공률로 드러날 여지도 좁습니다.
또한 하네스마다 턴과 노력 수준의 정의가 다르므로 하네스 간 턴 수 비교에는 제약이 있습니다. 100턴 상한도 긴 실행의 비용을 통제하기 위한 인위적 장치이고, 앞서 본 Claude Haiku 4.5와 Claude Code의 조합처럼 상한에 걸린 사례가 결과에 섞여 있습니다.
마지막으로 이 실험은 일회성 자동 실행을 측정한 것입니다. 실제 개발 환경에서는 요구사항이 바뀌고, 개발자가 중간에 피드백을 주며, 작업이 여러 세션에 걸쳐 이어집니다. 저자들은 하네스 선택을 모델과 시스템 설정을 함께 고르는 기존 연구 계열의 연장선에 놓습니다. 같은 저자들이 앞서 내놓은 검색 에이전트 설정 선택 연구가 질의마다 LLM과 검색기, 문서 수 같은 조합을 골라 정확도나 비용 목표를 맞추는 문제였다면, 코딩 에이전트의 하네스 선택은 사용 규모와 확산 정도가 훨씬 큰 만큼 더 시급하다는 것입니다. 그래서 저자들은 상호작용형 사용자 세션에서 코딩 에이전트를 평가하는 연구를 인용하면서, 실제 개발 워크플로우에서 하네스를 평가하고 그 선택을 자동화하는 것이 다음 단계라고 말합니다.
이 연구가 남기는 실무적 질문
이 결과가 개발자와 팀에게 주는 함의는 몇 갈래로 나뉩니다.
하네스를 평가 대상에 포함시키는 것이 첫 번째입니다. 모델을 고르는 자리에서 하네스는 대개 이미 정해진 것으로 취급됩니다. 그러나 21개 조합의 데이터가 보여주듯 같은 모델이라도 하네스에 따라 회당 비용이 2배에서 5배까지 갈립니다. 팀의 실제 과제 몇 개를 골라 두세 하네스에서 같은 모델로 돌려 보고 토큰 사용량을 비교하는 것만으로도 상당한 정보를 얻을 수 있습니다.
비용 단위를 회당이 아니라 해결당으로 보는 것이 두 번째입니다. 앞의 표에 해결당 비용 열을 함께 실은 이유가 여기에 있습니다. 회당 비용이 싸도 실패가 많으면 해결 한 건의 단가는 올라갑니다. SWE-bench Lite에서 Claude Haiku 4.5와 Claude Code의 조합은 회당 $0.426으로 중간 수준이지만, 성공률이 52.2%라 해결당 $0.816으로 올라가 Claude Fable 5와 Pi 조합($0.689)보다 비싸집니다. 더 싼 모델을 골랐는데 결과적으로 더 비싸지는 구간이 실재합니다.
작업의 난이도에 따라 하네스의 역할이 달라진다는 것이 세 번째입니다. 저자들은 마무리에서 코딩 에이전트의 역할을 두 갈래로 나눕니다. 일상적인 작업에서 코딩 에이전트는 사실상 모델 지능에 접근하는 인터페이스이므로, 모델이 강해질수록 오늘날의 보조 코드(Scaffolding)가 덜 필요해질 수 있습니다. 이 영역에서는 비용 효율과 안정성이 우선입니다. 반면 모델 능력의 경계에 있는 어려운 문제, 예컨대 AlphaEvolve가 다루는 알고리즘 발견이나 미해결 수학 문제 같은 영역에서는 아이디어 탐색과 후보 평가, 피드백 학습을 구조화해 주는 하네스가 여전히 기여할 수 있다고 봅니다.
저자들은 여기에 한 가지 조건을 답니다. 사용자가 이런 설정을 직접 결정해야 하는 상황 자체가 바람직하지 않다는 것입니다. 작업이 진행되는 동안 스스로 적응하면서도 범용성을 유지하는 하네스를 다시 설계해야 한다는 것이 이 글의 마지막 제안입니다.
프로파일링 트레이스는 공개 예정이라고 밝히고 있으며, 원문 사이트의 대시보드에서는 모델과 하네스를 직접 선택해 가며 위 그림들을 인터랙티브하게 탐색할 수 있습니다.
 HarnessTax 연구 소개 블로그
 Pi 코딩 에이전트 GitHub 저장소
 Pi 코딩 에이전트 홈페이지
Effective harnesses for long-running agents (Anthropic Engineering)
Unrolling the Codex agent loop (OpenAI Engineering)
https://openai.com/index/unrolling-the-codex-agent-loop/
 SWE-bench Lite 벤치마크 공식 페이지
Terminal-Bench 공식 페이지
더 읽어보기
-
Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces (arXiv)
-
SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (arXiv)
-
SWE-Together: Evaluating Coding Agents in Interactive User Sessions (arXiv)
-
Natural Language Query to Configuration for Retrieval Agents (arXiv)
-
Benchmarking Coding Agents on Databricks' Multi-Million Line Codebase
-
The Harness Tax: The Dead Weight Inside Your Coding Agent (Portkey)
-
Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과
-
Awesome Harness Engineering: AI 에이전트를 안정적으로 만드는 하네스 엔지니어링 자료 모음
-
Harness Books: Claude Code와 Codex의 하네스 설계 철학을 다룬 온라인/PDF 도서 (영문/중문)
-
Gemma 4와 Pi Coding Agent로 완전히 로컬에서 실행하는 코딩 에이전트 만들기 (feat. LM Studio)
-
Codex 하네스의 비밀 풀기: App Server 구축기 (Unlocking the Codex harness: how we built the App Server)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
