핵심 요약
- IBM Research가 Granite 시계열 앙상블 소개 글에서 사전학습 시계열 모델 4종의 분위수 예측을 하나의 분포로 합치는 레시피를 공개했습니다. 추가 학습이나 가중치 학습 없이
pip install "granite-tsfm>=0.3.11"뒤 몇 줄로 씁니다. - 기본값은 네 모델을 같은 비중으로 섞는 확률 앙상블이고, 예측 구간이 좁은 모델에 더 큰 비중을 주는 IQR(사분위 범위, Interquartile Range) 앙상블을 대안으로 제공합니다.
- GIFT-Eval 97개 설정에서 두 앙상블 모두 MASE와 평균 MASE 순위로 구성 모델 넷을 앞섰지만, 차이는 0.683 대 0.685로 작고 확률 예측 점수(CRPS)는 단일 모델 PatchTST-FM-r2가 가장 좋았습니다.
- 원문의 "적격 시스템 중 3위"는 IBM이 고른 라이선스 기준을 적용한 순위이며, 같은 날짜 리더보드 전체 153개 중에서는 MASE 순위 기준 39위입니다. 직접 재현한 결과는 아래에 정리했습니다.
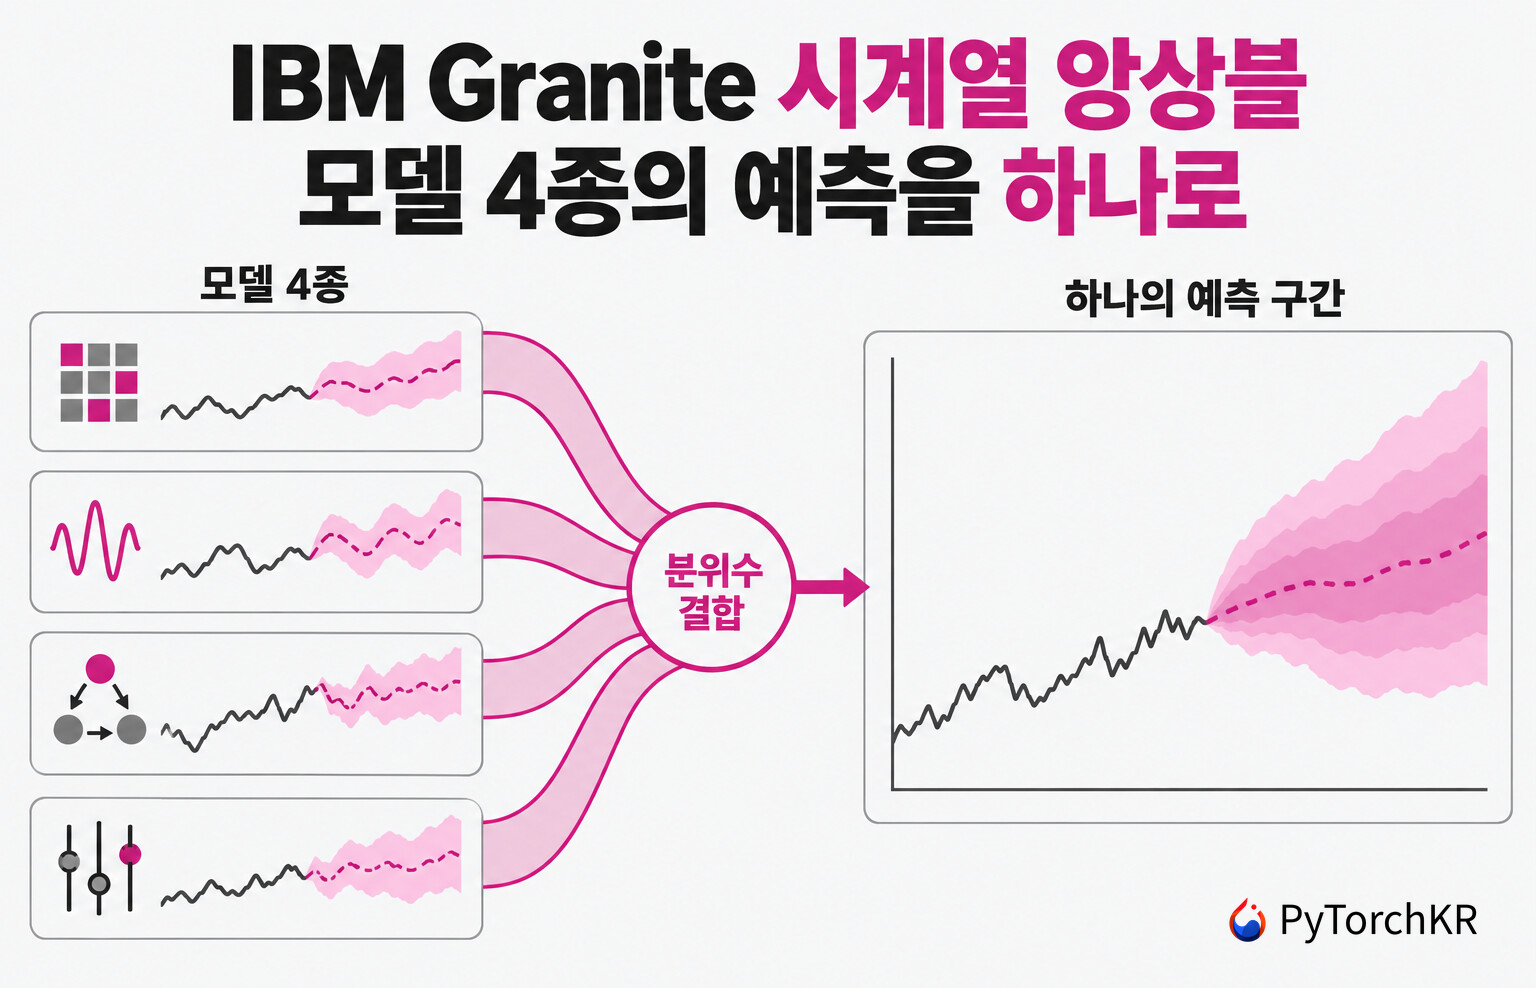
Granite Timeseries Ensemble R1 소개
사전학습된 시계열 파운데이션 모델(Time Series Foundation Model, TSFM)은 내 데이터로 학습하지 않아도 예측을 냅니다. 그래도 어떤 모델을 쓸지는 여전히 골라야 합니다. 원문 저자들은 매끄러운 산업 신호에 강한 모델이 잡음 많은 소매 수요나 계절성이 긴 예측 구간에서는 약할 수 있다고 설명합니다. 결국 최선의 선택은 계열과 과제마다 달라집니다.
Granite Timeseries Ensemble R1은 이 선택을 하나의 기본값으로 줄이려는 시도입니다. 구조가 서로 다른 IBM Granite 시계열 모델 4개를 한 번에 호출하고, 각 모델이 낸 분위수(Quantile) 예측을 하나의 예측 분포로 합칩니다. 분위수 예측은 값이 그 아래일 확률이 10%, 50%, 90%인 지점들을 함께 내는 방식이라, 점 하나가 아닌 범위로 미래를 보여 줍니다. 저자들은 이 아이디어가 기상 예보에서 익숙한 것이라고 설명합니다. 여러 가능한 결과를 탐색하는 ECMWF의 앙상블 예보와 계절 예측을 위해 여러 모델을 합치는 NOAA의 North American Multi-Model Ensemble이 그 예입니다.
배포 형태는 일반 모델 저장소와 다릅니다. Hugging Face의 ibm-granite/granite-timeseries-ensemble-r1 저장소에는 합쳐진 모델 가중치가 없고, 어떤 모델을 어떤 방식으로 섞을지 적은 config.json 레시피만 들어 있습니다. 실제 체크포인트 4개는 실행 시점에 각자의 저장소에서 내려받습니다. 실행 코드는 granite-tsfm 라이브러리에 있습니다. 앙상블 모듈은 0.3.10(2026년 10월 2일)부터 들어 있고, 원문 예제가 쓰는 prediction_outputs, quantile_outputs 속성은 10월 21일 배포된 0.3.11에서 추가되었습니다. 소개 글은 Fearghal O'Donncha, Chandramouli Kamanchi, Wesley M. Gifford 등 IBM Research 연구자 9명이 2026년 10월 22일 공개했습니다.
이 글은 원문 블로그와 함께 모델 카드, 레시피 파일, granite-tsfm 소스 코드와 시작 노트북을 읽고 정리했습니다. 원문 예제를 직접 실행했고, GIFT-Eval 리더보드의 원시 결과로 원문의 표를 재현했습니다. 직접 확인한 내용은 해당 절에서 따로 밝힙니다.
앙상블에 들어간 4개 모델: 구조가 서로 다른 Granite 시계열 모델
기본 레시피는 아래 4개 체크포인트를 묶습니다. 저자들은 이 구조들이 추세, 계절성, 국소 변동을 서로 다르게 포착하기 때문에 오차가 같은 자리에서 겹칠 필요가 없다고 설명합니다.
| 모델 | 구조 | 파라미터 수 | 가중치 라이선스 | 배경 자료 |
|---|---|---|---|---|
| Granite PatchTST-FM-r1 | 패치 단위 Transformer | 약 2억 6천만 | Apache-2.0 | 논문 |
| Granite PatchTST-FM-r2 | 패치 단위 Conformer (셀프 어텐션 + 시간축 합성곱) | 약 3억 8,500만 | Apache-2.0 또는 OpenMDW-1.0 (이중) | 소개 글 |
| Granite FlowState-r1.1 | 상태 공간 모델(State-Space Model) | 1,850만 | Apache-2.0 | 논문 |
| Granite TTM-r3 | Tiny Time Mixers (경량 MLP 믹서) | 100만~3,500만 규모 전문가 혼합 | Apache-2.0 | 논문 |
파라미터 수와 라이선스 열은 원문에 없는 내용으로, 각 모델 카드에서 확인한 값입니다. 기본 레시피의 네 모델은 모두 상업적 이용이 가능한 라이선스입니다. 파라미터 수로 보면 앙상블의 대부분은 PatchTST-FM 두 모델(합계 약 6억 4,500만 개)입니다.
여러 예측을 합치면 왜 도움이 될까요? 원문은 예측 결합 50년 리뷰 논문을 인용해, 예측을 결합하면 "잘못된 단일 모델을 고를 위험"을 줄일 수 있다고 설명합니다. 다만 같은 논문이 구성 모델의 품질과 다양성이 여전히 중요하다고 강조한다는 점도 함께 적습니다. 모델 카드도 약하거나 서로 비슷한 모델을 더하는 것은 도움이 보장되지 않는다고 적어 둡니다.
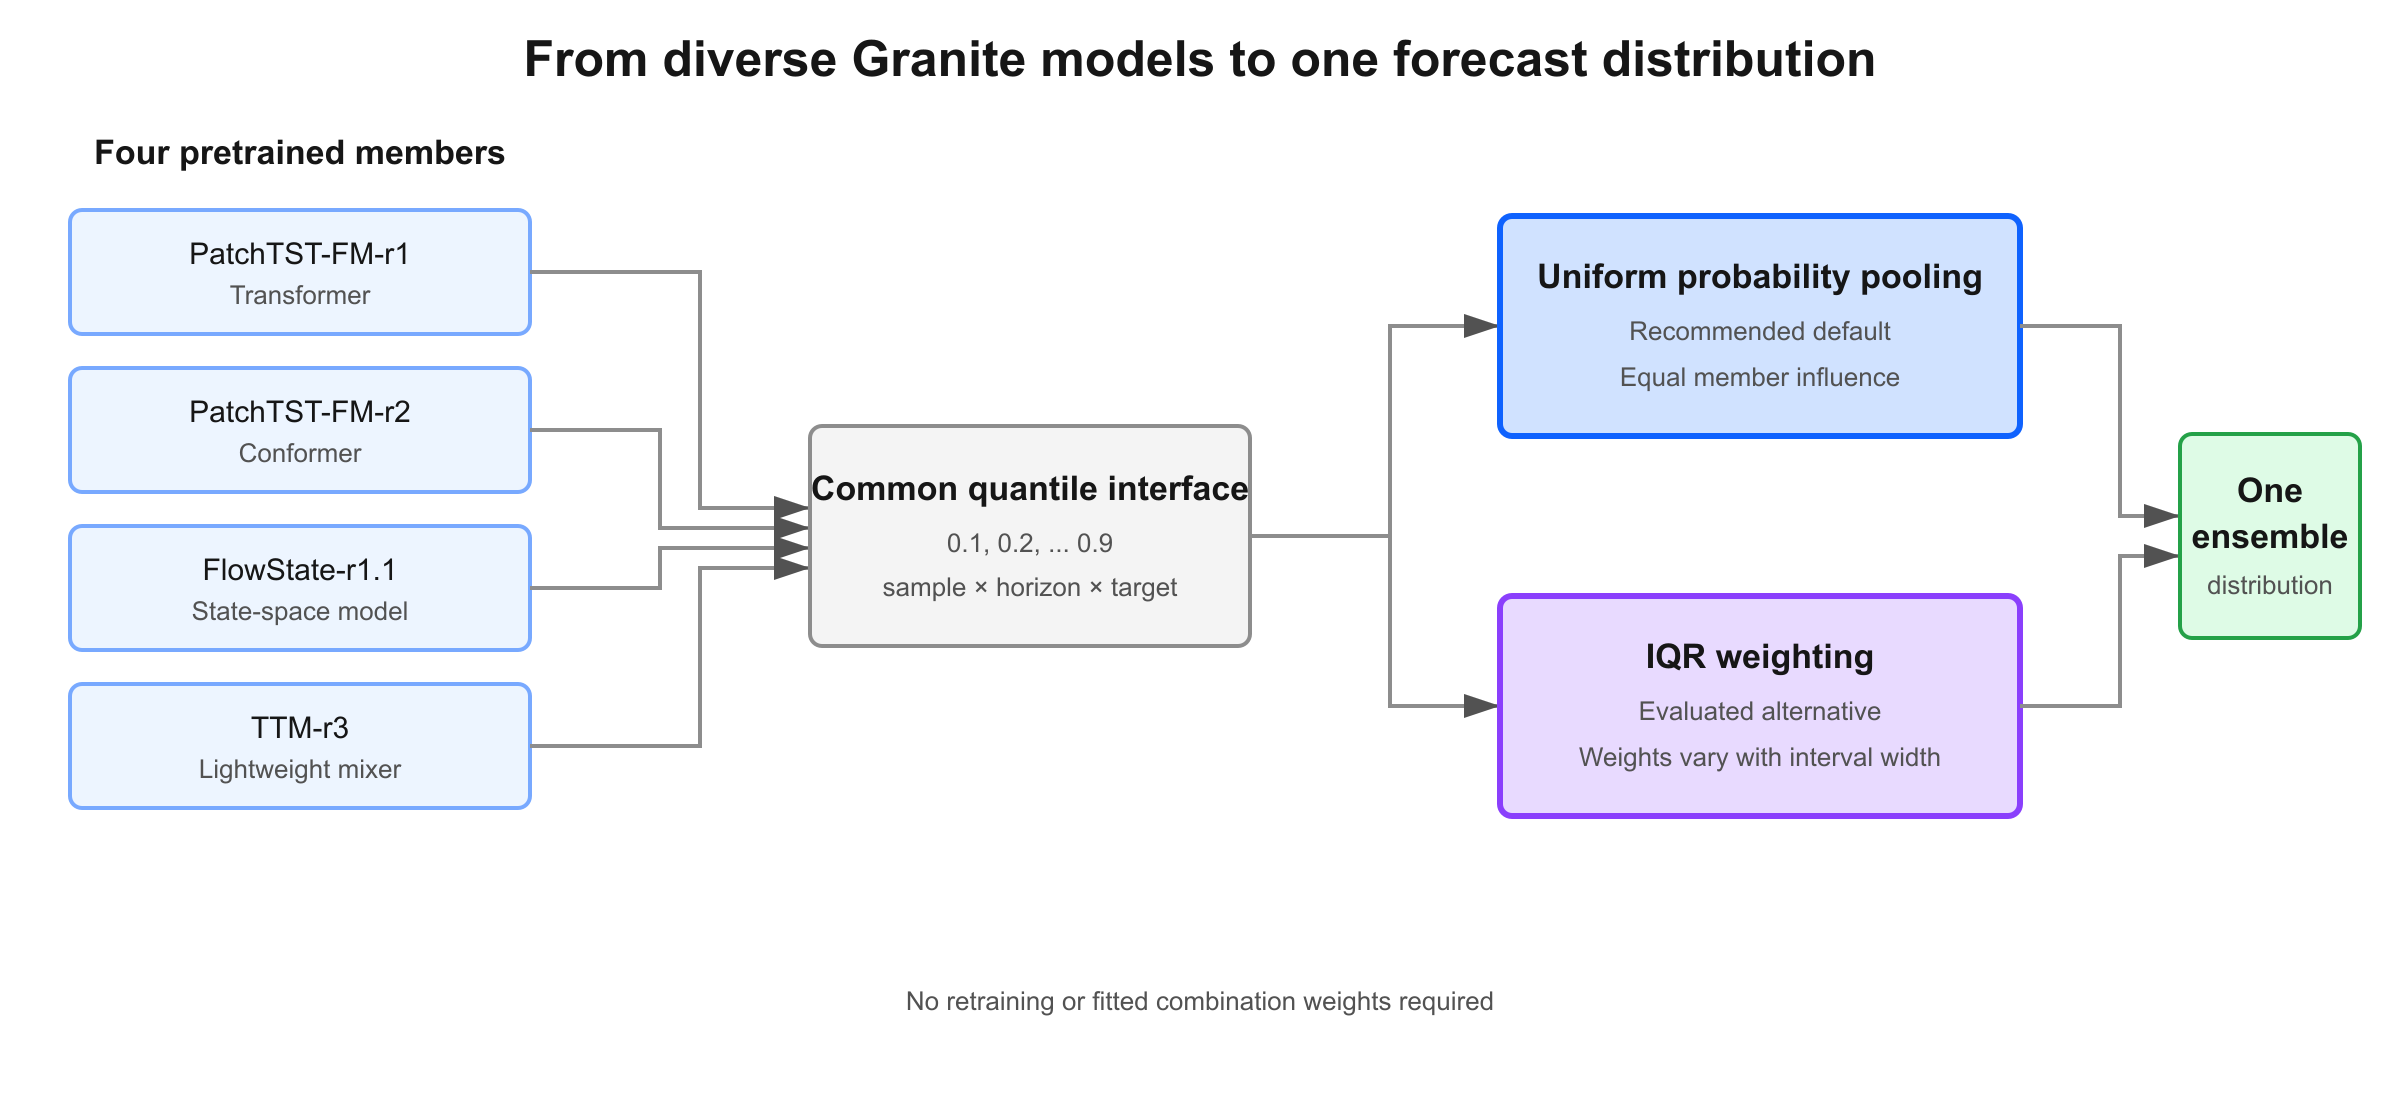
위 그림처럼 네 모델은 모두 0.1부터 0.9까지 9개 분위수를 같은 모양(샘플 × 예측 시점 × 대상 변수)으로 내고, 그 결과를 두 결합 방식 중 하나가 받습니다.
예측을 합치는 두 가지 방법: 확률 앙상블과 IQR 앙상블
확률 앙상블: 권장 기본값
확률 앙상블(Probabilistic Ensemble) 은 네 모델에 같은 영향력을 줍니다. 모델 카드에 따르면 구현은 단순합니다. 모델마다 9개씩, 모두 36개의 분위수 값을 한 묶음으로 펼친 뒤, 그 묶음에서 다시 0.1~0.9 분위수를 뽑습니다. 점 예측은 이렇게 뽑은 0.5 분위수(중앙값)입니다. 소스 코드에서도 aggregate_linear_pool 함수가 두 축을 합쳐 np.quantile 을 호출하는 것을 확인했습니다.
가중치가 고정되어 있으므로 학습 단계가 없고, 새 계열마다 조정할 가중치 관련 하이퍼파라미터도 없습니다. 저자들은 그 근거로 예측 결합 퍼즐(Forecast Combination Puzzle) 을 듭니다. 점 예측에서는 단순한 균등 가중 결합이 과거 성능으로 가중치를 추정한 방법만큼 잘 버티는 경우가 많았다는 관찰입니다(Smith and Wallis, 2009). 모델 카드는 추정한 가중치의 편향과 분산의 상충이 이 현상을 일부 설명한다고 덧붙입니다. 대표 학습 데이터가 있다면 학습한 결합이 더 나을 수 있지만, 이 레시피는 제로샷 사용을 위해 단순함을 택했다는 것이 모델 카드의 설명입니다.
모델 카드는 한계도 함께 적습니다. 모델들의 의견이 갈리면 그만큼 합쳐진 구간이 넓어지므로, 구간이 지나치게 좁은 예측을 보완하는 데 도움이 될 수 있습니다. 하지만 보정(calibration)을 보장하지는 않고, 오히려 구간이 지나치게 넓어질 수도 있습니다. 여기서 보정은 80% 구간이라고 한 범위에 실제로 관측값의 약 80%가 들어오는지를 뜻합니다.
IQR 앙상블: 구간 폭에 따라 비중을 바꾸는 대안
IQR 앙상블(Interquartile Range Ensemble) 은 예측 구간이 좁은 모델에 더 큰 비중을 줍니다. 비중은 샘플, 대상 변수, 예측 시점마다 따로 계산하며, 과거 예측 오차로 학습하는 단계는 여기에도 없습니다. 모델 카드가 밝힌 계산식은 다음과 같습니다. 모델 m 의 25%, 75% 분위수 근처 값으로 구간 폭 I_m 을 구하고, 그 역수에 소프트맥스를 씌웁니다.
\tau 는 온도(temperature), p_m 은 선택적인 사전 비중, \epsilon=10^{-6} 입니다. 기본 분위수 격자(0.1, 0.2, ..., 0.9)에는 0.25와 0.75가 없으므로 실제로는 0.2와 0.8 사이 폭을 씁니다. 합친 분위수의 순서가 뒤집히지 않도록 등위 회귀(isotonic regression)로 단조 증가를 강제합니다. 온도를 높이면 비중이 균등 쪽으로 가고, max_weight 로 한 모델의 비중 상한을 둘 수 있습니다.
원문은 이 방법의 약점을 직접 밝힙니다. "구간이 좁다고 더 정확하거나 더 잘 보정된 예측인 것은 아니며, IQR 가중은 지나치게 자신만만한 모델을 편들 수 있다"는 것입니다. 평가된 IQR 레시피는 하위 폴더 이름만 바꿔 불러옵니다.
ensemble = QuantileEnsembleForecaster.from_pretrained(
    "ibm-granite/granite-timeseries-ensemble-r1",
    subfolder="recipes/granite-iqr",
)
직접 확인한 점 1: IQR 비중은 데이터의 단위에 따라 달라집니다
위 식에서 I_m 은 원래 데이터 단위의 구간 폭입니다. 소스 코드를 보면 앙상블은 각 모델의 예측을 원래 단위 그대로 받아 집계하고, 그 사이에 정규화 단계가 없습니다. 그래서 같은 계열을 kWh로 넣을 때와 MWh로 넣을 때 s_m 의 크기가 달라지고, 소프트맥스 비중도 바뀝니다.
이를 확인하려고 원문 예제(ETTh1, OT 열, 24시점 예측)에서 네 모델의 실제 분위수 예측을 받았습니다. 그 값에 상수만 곱해 단위를 바꾼 뒤, granite-tsfm의 aggregate_iqr_weighted 를 평가 레시피 설정(온도 1.0, 상한 없음)으로 호출했습니다. 원래 단위에서 첫 시점의 0.2~0.8 구간 폭은 PatchTST-FM-r1 0.561, PatchTST-FM-r2 0.426, FlowState 0.409, TTM-r3 1.924였습니다. 아래 표의 비중과 구간 폭은 24시점 평균이며, 구간 폭은 원래 단위로 되돌린 값입니다.
| 데이터 단위 | 네 모델의 비중 (r1, r2, FlowState, TTM) | IQR 앙상블의 80% 구간 폭 | 확률 앙상블의 80% 구간 폭 |
|---|---|---|---|
| 원래 값 × 0.01 | 0.00, 0.00, 1.00, 0.00 | 1.555 | 1.780 |
| 원래 값 그대로 | 0.23, 0.26, 0.32, 0.19 | 2.232 | 1.780 |
| 원래 값 × 100 | 0.25, 0.25, 0.25, 0.25 | 2.355 | 1.780 |
값이 작은 단위에서는 구간이 가장 좁은 FlowState가 비중을 독차지하고, 값이 큰 단위에서는 사실상 균등 평균이 됩니다. 같은 데이터인데도 IQR 앙상블의 80% 구간 폭이 24시점 평균으로 약 1.5배, 첫 시점만 보면 0.599에서 1.321로 2배 넘게 달라졌습니다. 확률 앙상블은 분위수 값을 모아 다시 분위수를 뽑을 뿐이라 단위와 무관하게 같은 결과를 냅니다. 따라서 IQR 레시피를 쓴다면 온도 값과 함께 데이터 단위(또는 정규화 여부)도 검증 대상에 넣어야 합니다. 원문과 모델 카드는 이 성질을 언급하지 않습니다.
직접 확인한 점 2: 설정 클래스의 IQR 기본값은 평가된 레시피와 다릅니다
평가된 recipes/granite-iqr 레시피는 온도 1.0, 상한 없음을 씁니다. 그런데 ProbabilisticEnsembleConfig 클래스의 IQR 기본값은 온도 0.5, max_weight 0.4입니다. 루트 config.json(확률 앙상블 레시피)을 불러온 뒤 aggregation_method 만 "iqr_weighted" 로 바꾸면 이 기본값이 적용되며, 실행해 보니 실제로 {'temperature': 0.5, 'max_weight': 0.4} 가 나왔습니다. 시작 노트북의 고급 예제가 정확히 이 방식입니다. GIFT-Eval 결과를 재현하려면 위처럼 subfolder="recipes/granite-iqr" 로 불러와야 합니다.
어떤 방법부터 쓸까
| 목적 | 시작점 | 이유 |
|---|---|---|
| 단순한 기본값 | 확률 앙상블 | 같은 영향력, 학습한 가중치 없음 |
| 예측 폭에 따른 적응형 가중 | IQR 앙상블 | 모델마다 예측한 폭에 따라 영향력이 달라짐 |
원문의 권고는 확률 앙상블로 시작하고, 예측 폭이 쓸모 있는 신호로 보이면 대표 데이터에서 IQR 앙상블과 비교해 보라는 것입니다. 정확도와 보정은 계열과 예측 길이에 따라 달라지기 때문입니다.
설치와 첫 실행
granite-tsfm을 설치하고 Hugging Face에서 기본 레시피를 불러옵니다. 아래 코드는 원문 예제 그대로입니다.
pip install "granite-tsfm>=0.3.11"
import pandas as pd

from tsfm_public.models.ensemble.modeling_ensemble import QuantileEnsembleForecaster

df = pd.read_csv(
    "https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
    parse_dates=["date"],
)

ensemble = QuantileEnsembleForecaster.from_pretrained(
    "ibm-granite/granite-timeseries-ensemble-r1",
)

result = ensemble(
    df.tail(1024),
    timestamp_column="date",
    target_columns=["OT"],
    context_length=1024,
    prediction_length=24,
)

print(result.prediction_outputs) # point forecast
print(result.quantile_outputs)   # quantiles
result.prediction_outputs 는 점 예측, result.quantile_outputs 는 0.1~0.9 분위수 예측입니다. 원문 설명대로 0.1과 0.9 분위수 사이가 명목상 80% 예측 구간입니다.
이 예제를 Apple Silicon macOS의 CPU에서 Python 3.12, granite-tsfm 0.3.11, PyTorch 2.11.0, Transformers 5.20.2로 실행했습니다. 체크포인트 4개를 처음 내려받는 레시피 로딩에 약 120초, 예측 한 번에 약 14초가 걸렸고, 결과 모양은 점 예측 (1, 24, 1), 분위수 (1, 24, 1, 9) 였습니다. 실행 중 확인한 사항은 세 가지입니다.
- Python 버전: PyPI의 granite-tsfm 0.3.11은 Python 3.11 이상, 3.14 미만을 요구하고 PyTorch는 2.10 이상, 2.12 미만으로 고정합니다. 저장소 README에는 아직 3.10이 지원 버전으로 적혀 있지만, 0.3.11 패키지 메타데이터 기준으로는 3.10에 설치되지 않습니다.
- TTM 리비전 자동 선택: TTM은 레시피에 리비전을 고정하지 않고, 요청한 문맥 길이와 예측 길이로 실행 시점에 고릅니다. 위 예제에서는 24시점이 TTM의 지원 예측 길이와 정확히 맞지 않아, 더 긴 예측을 잘라 쓴다는 경고가 나왔습니다.
- 구성 모델 실패 시 동작: 소스 코드상 한 모델이 예외를 내면 경고 로그만 남기고 나머지 모델로 계속 집계합니다. 모델 카드도 이 경우 레시피가 사실상 바뀐다며, 보고된 4모델 결과를 재현하려면 네 모델이 모두 성공했는지 로그를 확인하라고 적어 둡니다. 결과의
metadata['n_models']값으로도 확인할 수 있습니다.
시작 노트북은 같은 ETTh1 데이터의 HUFL 열로 문맥 4,096시점, 예측 96시점을 실행하고, 실제값과 함께 중앙값과 10~90% 구간을 그립니다. 노트북의 설치 셀은 아직 저장소 체크아웃을 편집 모드로 설치하는 개발 브랜치용 명령이므로, 배포된 패키지를 쓰려면 그래프용 의존성이 함께 들어가는 pip install "granite-tsfm[notebooks]>=0.3.11" 로 바꿔 실행하면 됩니다. 저장소의 노트북에는 실행 결과가 저장되어 있지 않습니다.
GIFT-Eval 결과: 앙상블은 구성 모델보다 나은가
저자들은 두 레시피를 GIFT-Eval 벤치마크의 97개 데이터셋 설정에서 평가했습니다. 모든 모델은 미세조정(fine-tuning) 없이 예측했고, 결합 방법을 고르거나 맞추는 데 테스트 정답은 쓰지 않았다고 밝힙니다. 지표는 두 가지입니다. MASE(Mean Absolute Scaled Error) 는 점 예측 오차이고, CRPS 는 GIFT-Eval의 mean_weighted_sum_quantile_loss 로 확률 예측의 품질을 잽니다. 두 점수 모두 계절 단순 예측(Seasonal Naive) 대비 비율로 정규화한 뒤 97개 설정에서 기하평균하며, 낮을수록 좋습니다. 순위 열은 설정마다 매긴 순위를 평균한 값입니다.
| 예측 | MASE ↓ | MASE 순위 ↓ | CRPS ↓ | CRPS 순위 ↓ |
|---|---|---|---|---|
| 확률 앙상블 | 0.683 | 47.175 | 0.471 | 50.948 |
| IQR 앙상블 | 0.684 | 48.773 | 0.471 | 47.619 |
| Granite PatchTST-FM-r2 | 0.685 | 51.371 | 0.467 | 48.918 |
| Granite FlowState-r1.1 | 0.701 | 66.474 | 0.490 | 69.485 |
| Granite PatchTST-FM-r1 | 0.717 | 74.794 | 0.488 | 68.134 |
| Granite TTM-r3 | 0.724 | 83.062 | 0.520 | 88.959 |
굵은 글씨는 이 여섯 예측 안에서 가장 좋은 값입니다. 두 앙상블은 MASE와 평균 MASE 순위에서 구성 모델 넷을 모두 앞섭니다. 다만 가장 강한 단일 모델과의 MASE 차이는 0.683 대 0.685로 작고, 저자들도 "주된 이점은 견고함"이라고 정리합니다. 데이터에 어떤 구조가 맞을지 미리 알지 못해도, 가장 강한 단일 모델과 비슷하거나 더 나은 종합 정확도를 얻는다는 설명입니다.
반면 확률 예측 점수(CRPS)는 단일 모델 PatchTST-FM-r2가 가장 낮고, 평균 CRPS 순위는 IQR 앙상블이 가장 낮습니다. 원문의 표현대로 종합 오차와 평균 순위가 서로 다른 선택을 가리키는 셈입니다.
리더보드 원시 결과로 재현해 보기
GIFT-Eval은 모델별 원시 결과(all_results.csv)와 집계 코드를 공개합니다. 2026년 10월 26일 기준 리더보드 Space에서 158개 모델의 결과를 내려받아 공식 집계 함수로 다시 계산했습니다. 리더보드에는 10월 23일에 5개 모델(TimeH2O-v1, TimeH2O-v1-tiny, RegLab-AH-2, PCFM, Mobius-0)이 추가되었습니다. 이 5개를 뺀 153개로 계산하면 위 표의 24개 수치가 소수점 셋째 자리까지 모두 일치합니다. 원문이 말한 10월 20일 스냅숏이 이 153개 구성입니다.
원문이 경고한 대로 순위 값은 리더보드에 모델이 추가될 때마다 움직입니다. 158개 기준으로 다시 계산하면 확률 앙상블의 MASE 순위는 47.175에서 49.711로, IQR 앙상블의 CRPS 순위는 47.619에서 50.371로 커집니다. 여섯 예측 사이의 순서는 그대로였습니다. MASE와 CRPS 값 자체는 다른 모델과 무관하므로 바뀌지 않습니다.
"적격 시스템 중 3위"의 범위
원문은 두 지표의 평균 순위에서 앙상블 방식이 "적격 시스템 중 3위"라고 밝히고, 아래 그림으로 적격 상위 10개와 함께 보여 줍니다.
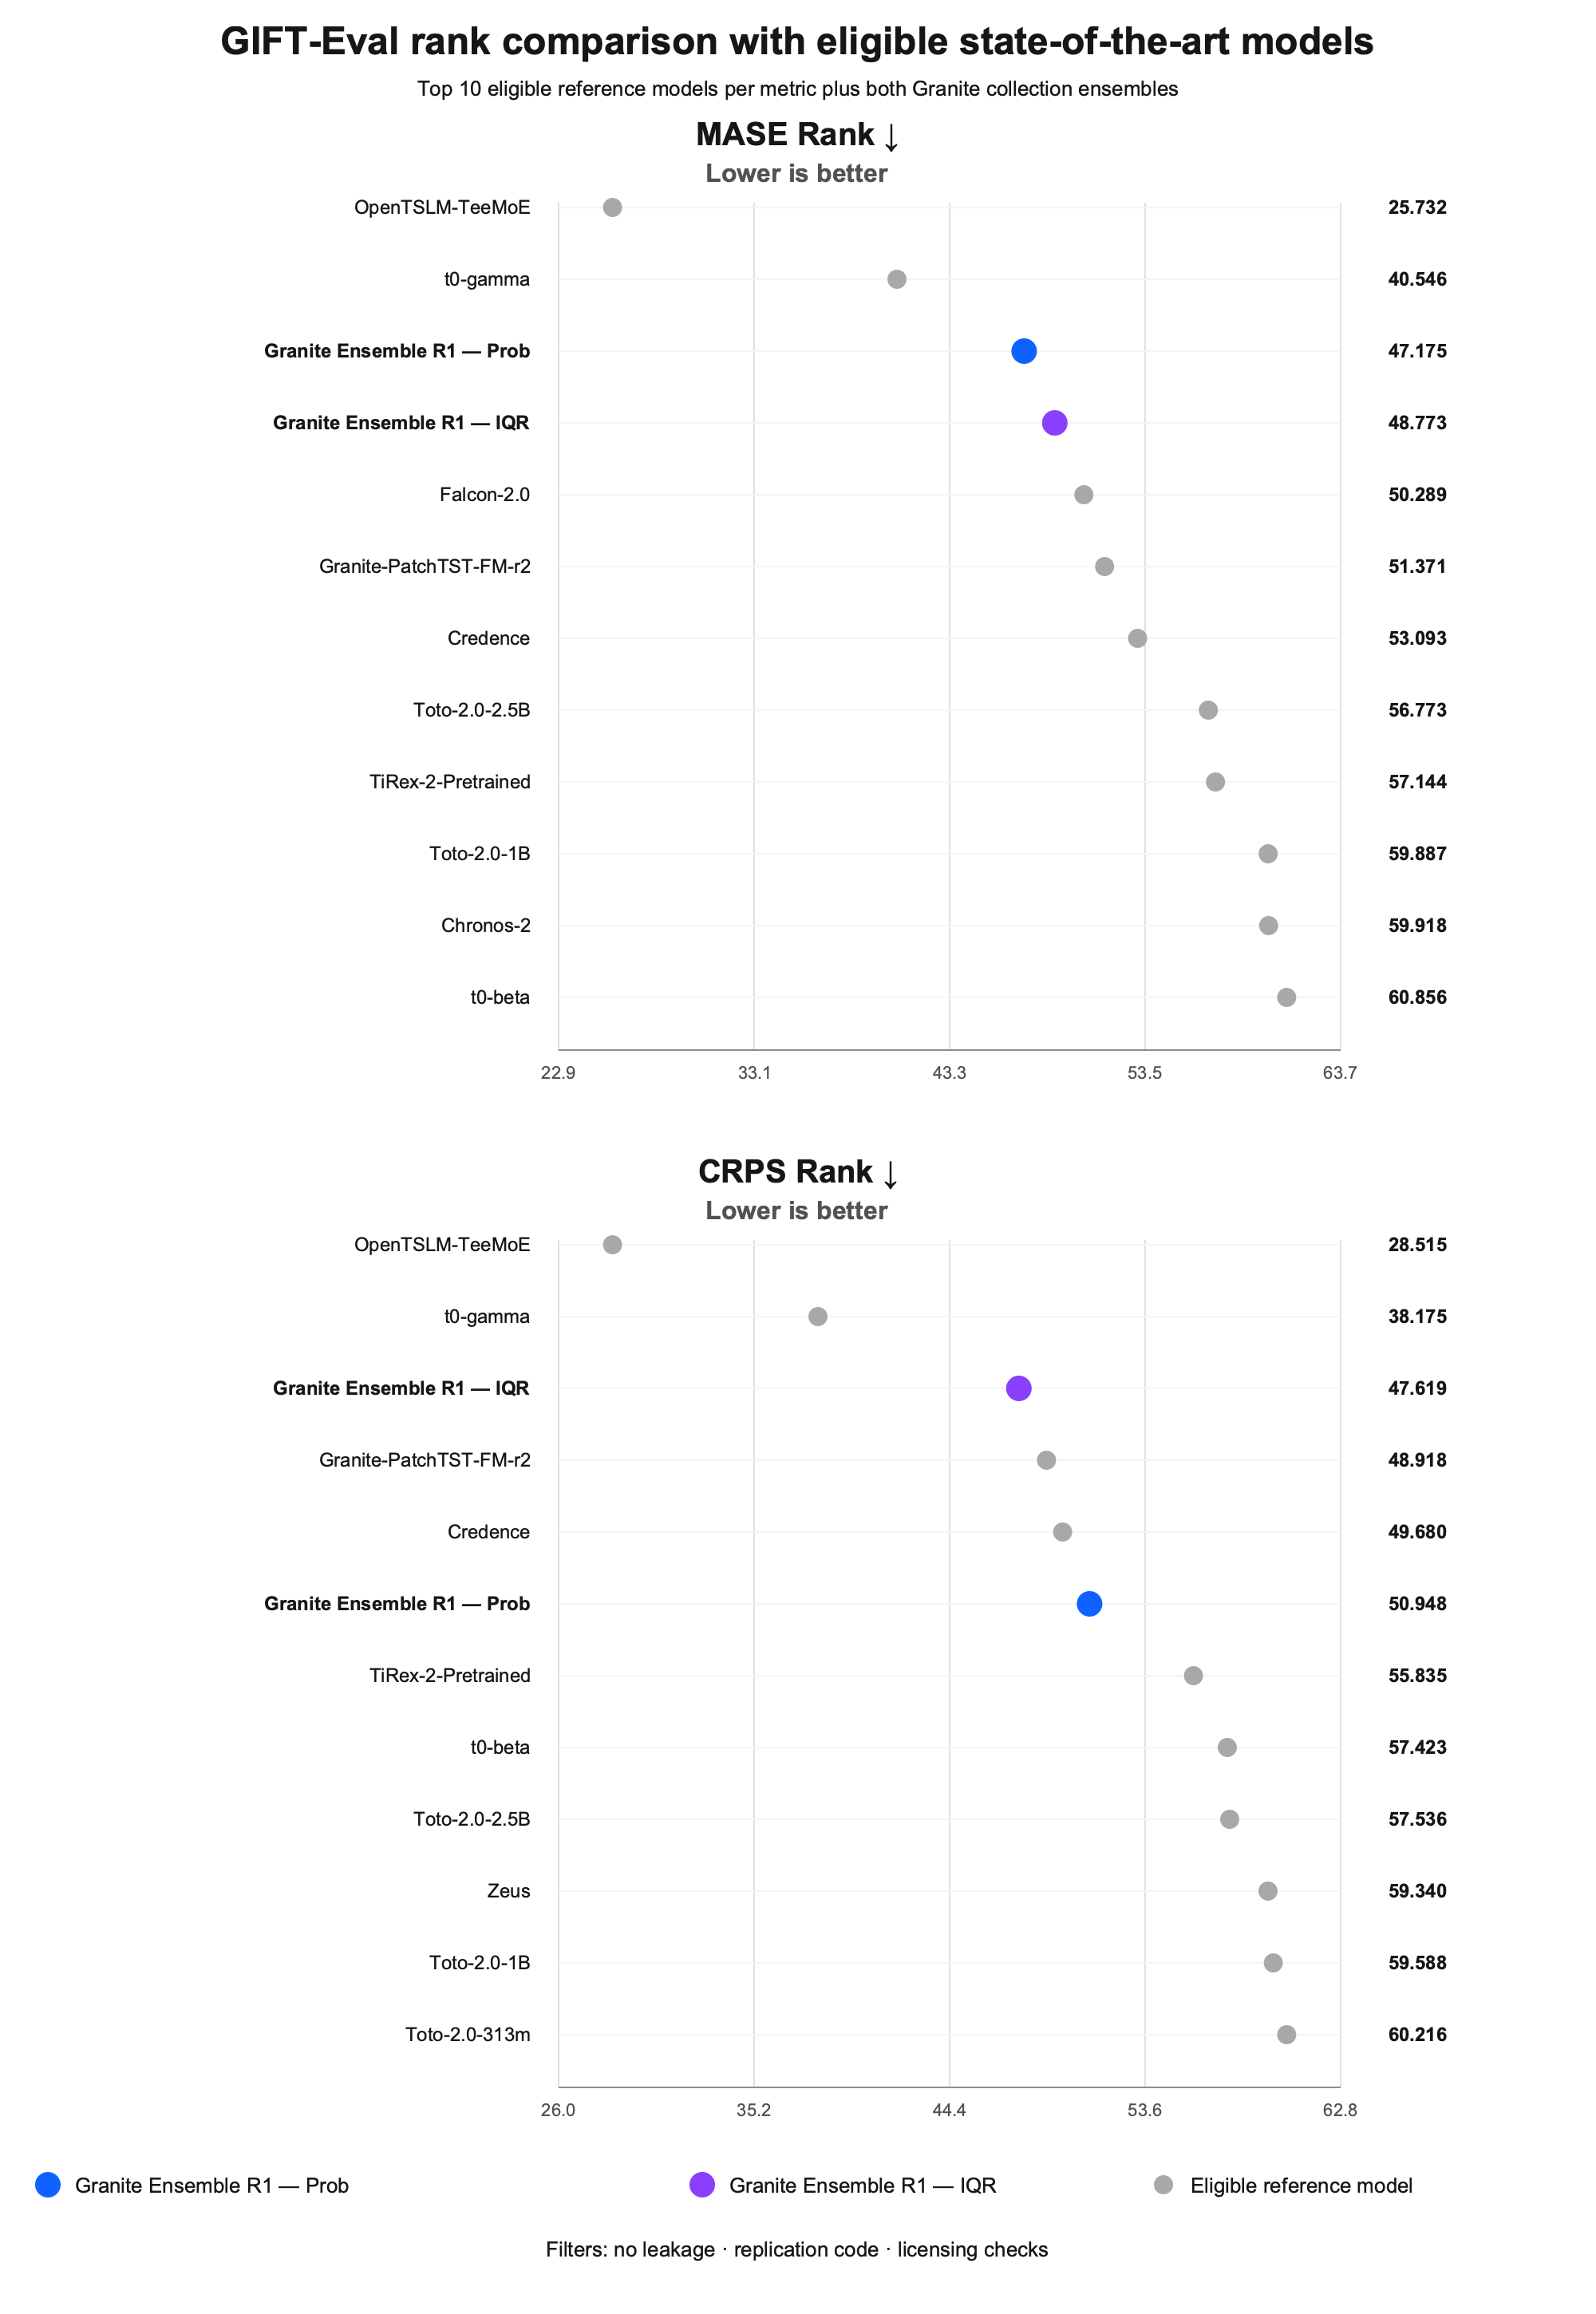
그림 설명에 따르면 적격 기준은 재현 코드가 있고, 테스트 데이터 누출을 선언하지 않았으며, 미세조정 항목이 아니고, 알려진 비허용 라이선스나 그런 구성 모델에 의존하지 않는 시스템입니다. 재현한 10월 20일 스냅숏으로 이 기준을 단계별로 적용해 보면 순위가 꽤 달라집니다.
| 비교 범위 (10월 20일, 153개 시스템) | 확률 앙상블의 MASE 순위 위치 | IQR 앙상블의 CRPS 순위 위치 |
|---|---|---|
| 리더보드 전체 | 39위 | 41위 |
| 재현 코드 있음, 누출 없음, 미세조정 제외 (73개) | 13위 | 13위 |
| IBM의 라이선스 기준까지 적용 (원문 그림) | 3위 | 3위 |
두 번째 행에서 앙상블 위에 있던 시스템 가운데 원문 그림에는 OpenTSLM-TeeMoE와 t0-gamma만 남습니다. 빠진 시스템에는 비상업 라이선스인 TimesFM-3과 별도 라이선스의 Timestral 계열이 있고, Apache-2.0 모델 저장소를 둔 RacineCast-1과 Toto-2.0-FnF도 있습니다. 원문은 시스템별 제외 사유를 따로 밝히지 않았습니다. 상업적으로 쓸 수 있는 앙상블을 찾는 독자에게는 IBM의 기준이 의미가 있지만, "3위"는 이 범위 안의 순위입니다. 저자들도 "앙상블의 가치는 리더보드 1위가 아니라, 구성 모델을 고르지 않아도 여러 계열에서 강하고 일관된 결과를 낸다는 데 있다"고 정리합니다.
GIFT-Eval에서 두 앙상블은 zero-shot 이 아닌 agentic 유형으로 등록되어 있습니다. 구성 모델 넷은 각각 zero-shot 또는 pretrained 로 등록되어 있습니다. 리더보드에서 유형 필터로 비교하는 독자는 이 분류를 염두에 두어야 합니다.
레시피 확장과 라이선스
다른 예측 모델을 구성원으로 넣기
원문은 공통 Forecaster 인터페이스가 호환되는 외부 모델도 받는다고 설명합니다. 소스 코드를 보면 확장 경로가 두 가지로 나뉩니다. config.json 레시피로 지정할 수 있는 구성 모델 유형은 현재 patchtst, flowstate, ttm 셋뿐이고, 다른 유형을 넣으면 체크포인트를 불러오기 전에 검증 오류가 납니다. 외부 모델은 forecast_for_ensemble 메서드를 구현한 Forecaster 객체를 만들어 QuantileEnsembleForecaster(members=[...], quantile_levels=[...]) 생성자에 직접 넘기는 방식으로 넣습니다. 이 메서드는 (샘플 수, 예측 길이, 대상 변수 수, 분위수 수) 모양의 배열을 돌려주어야 합니다. 집계 함수도 같은 방식으로 바꿀 수 있으며, 코드에는 분위수 수준마다 모델 값의 중앙값(옵션으로 평균)을 취하는 aggregate_vincent 도 들어 있습니다.
새 조합을 만들 때 원문이 권하는 확인 항목은 예측 형식 호환성, 정확도, 보정, 지연 시간, 라이선스 다섯 가지입니다.
확장 레시피와 라이선스 주의점
레시피 저장소에는 6모델 확장 레시피(recipes/expanded-linear, recipes/expanded-iqr)도 있습니다. 레시피 파일을 열어 보면 기본 4모델에 더하는 구성이 아닙니다. Granite PatchTST-FM-r1, PatchTST-FM-r2, FlowState-r1.1 세 개에 IBM Research 체크포인트 ibm-research/patchtst-fm-r1, ibm-research/flowstate, ibm-research/ttm-r3 를 더하고, Granite TTM-r3는 빠져 있습니다. 이 가운데 ibm-research/patchtst-fm-r1 과 ibm-research/ttm-r3 는 CC BY-NC-SA 4.0으로, 비상업 용도로만 쓸 수 있습니다. 모델 카드도 이 레시피를 "연구 비교" 용도로 분류합니다. 상업 서비스에서는 기본 레시피를 쓰고, 확장 레시피는 각 구성 모델의 카드를 먼저 확인해야 합니다.
내 데이터에 적용하기 전에 확인할 것
원문은 GIFT-Eval이 폭넓은 벤치마크이지만 "종합 성능 향상이 모든 계열에 이득이라는 뜻은 아니며, 평균 순위가 보정을 보장하지도 않는다"고 말합니다. 그래서 대표 데이터로 직접 백테스트(backtest)하라고 권하며, 다음 네 가지를 제시합니다.
- 사용 사례에 맞춥니다: 각 예측 시점에서 실제로 쓸 수 있었던 데이터, 필요한 예측 길이, 서비스할 계열을 반영한 과거 구간을 씁니다.
- 같은 조건에서 비교합니다: 확률 앙상블, IQR 앙상블, 그리고 강한 단일 모델(예: PatchTST-FM-r2)을 같은 구간에서 돌립니다.
- 점 오차 너머를 봅니다: MASE와 함께 분위수 손실을 평가하고, 0.1~0.9 구간에 실제 관측이 명목상 80%만큼 들어오는지 확인합니다.
- 비용을 잽니다: 실행 시간과 메모리를 기록해, 모델 4개를 실행하는 비용만큼 이득이 있는지 판단합니다.
원문과 모델 카드가 밝힌 한계도 함께 봅니다. 현재 레시피는 다변량 데이터의 각 채널을 독립적으로 예측하고, 채널 간 정보는 쓰지 않습니다. 체크포인트 4개를 불러오므로 단일 모델보다 추론(inference) 시간과 메모리가 늘어납니다. 모델마다 문맥 길이 한도, 예측 길이, 전처리, 결측값 처리 방식도 다릅니다. 모델 카드 기준으로 PatchTST-FM 계열은 예측 구간을 포함해 8,192, FlowState-r1.1은 4,096 길이로 사전학습했습니다. 두 결합 방법 모두 보정이나 분포 변화(distribution shift)에 대한 견고성을 보장하지 않으므로 배포 뒤에도 예측을 계속 모니터링해야 합니다. 시계열 파운데이션 모델의 보정 문제는 TSFM 보정 연구를 정리한 글에서 더 자세히 다룹니다.
라이선스
레시피 저장소의 LICENSE 파일은 이 프로젝트를 Apache License 2.0과 OpenMDW License 1.0 중 하나를 골라 쓸 수 있는 이중 라이선스로 밝히고, granite-tsfm 코드는 Apache-2.0입니다. 따라서 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 구성 모델의 가중치는 위 표처럼 각 저장소의 라이선스를 따릅니다. granite-tsfm 저장소 README 끝에는 IBM이 이 코드의 개선, 업데이트, 지원 의무를 지지 않는다는 IBM 공개 저장소 공지가 있습니다.
 Ensemble forecasting with IBM Granite time-series models 소개 블로그
 Granite Timeseries Ensemble R1 모델 카드
 Granite TSFM GitHub 저장소
더 읽어보기
-
정확도 너머에: 시계열 파운데이션 모델(TSFM)이 잘 보정(Calibration)되어 있는지에 대한 연구 (feat. ICLR 2026)
-
Nexus: 시계열 예측을 멀티 에이전트 추론 문제로 푸는 프레임워크에 대한 연구 (feat. Google)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
