TypeSafe AI가 Jev를 내놓으면서 «System One 모델»이라는 이름이 붙었다. 텍스트를 생성하지 않고
참·거짓·선택·점수 같은 유형화된 판정만 돌려주는 모델이다. 생성 토큰이 0개이므로 같은 일을
프런티어 LLM에게 시키는 것보다 수십에서 수천 배 싸다.
발표 직후부터 생태계가 빠르게 생겼다. 오픈소스 재구현판, 구조가 같은 대안 모델, 인접 도구까지
합치면 반년 만에 열 개가 넘는다. 그런데 이들이 같은 시험지 위에 선 적은 없었다. 각자
자기 벤치마크를 발표하고, 그 벤치마크에서 자기가 1위다.
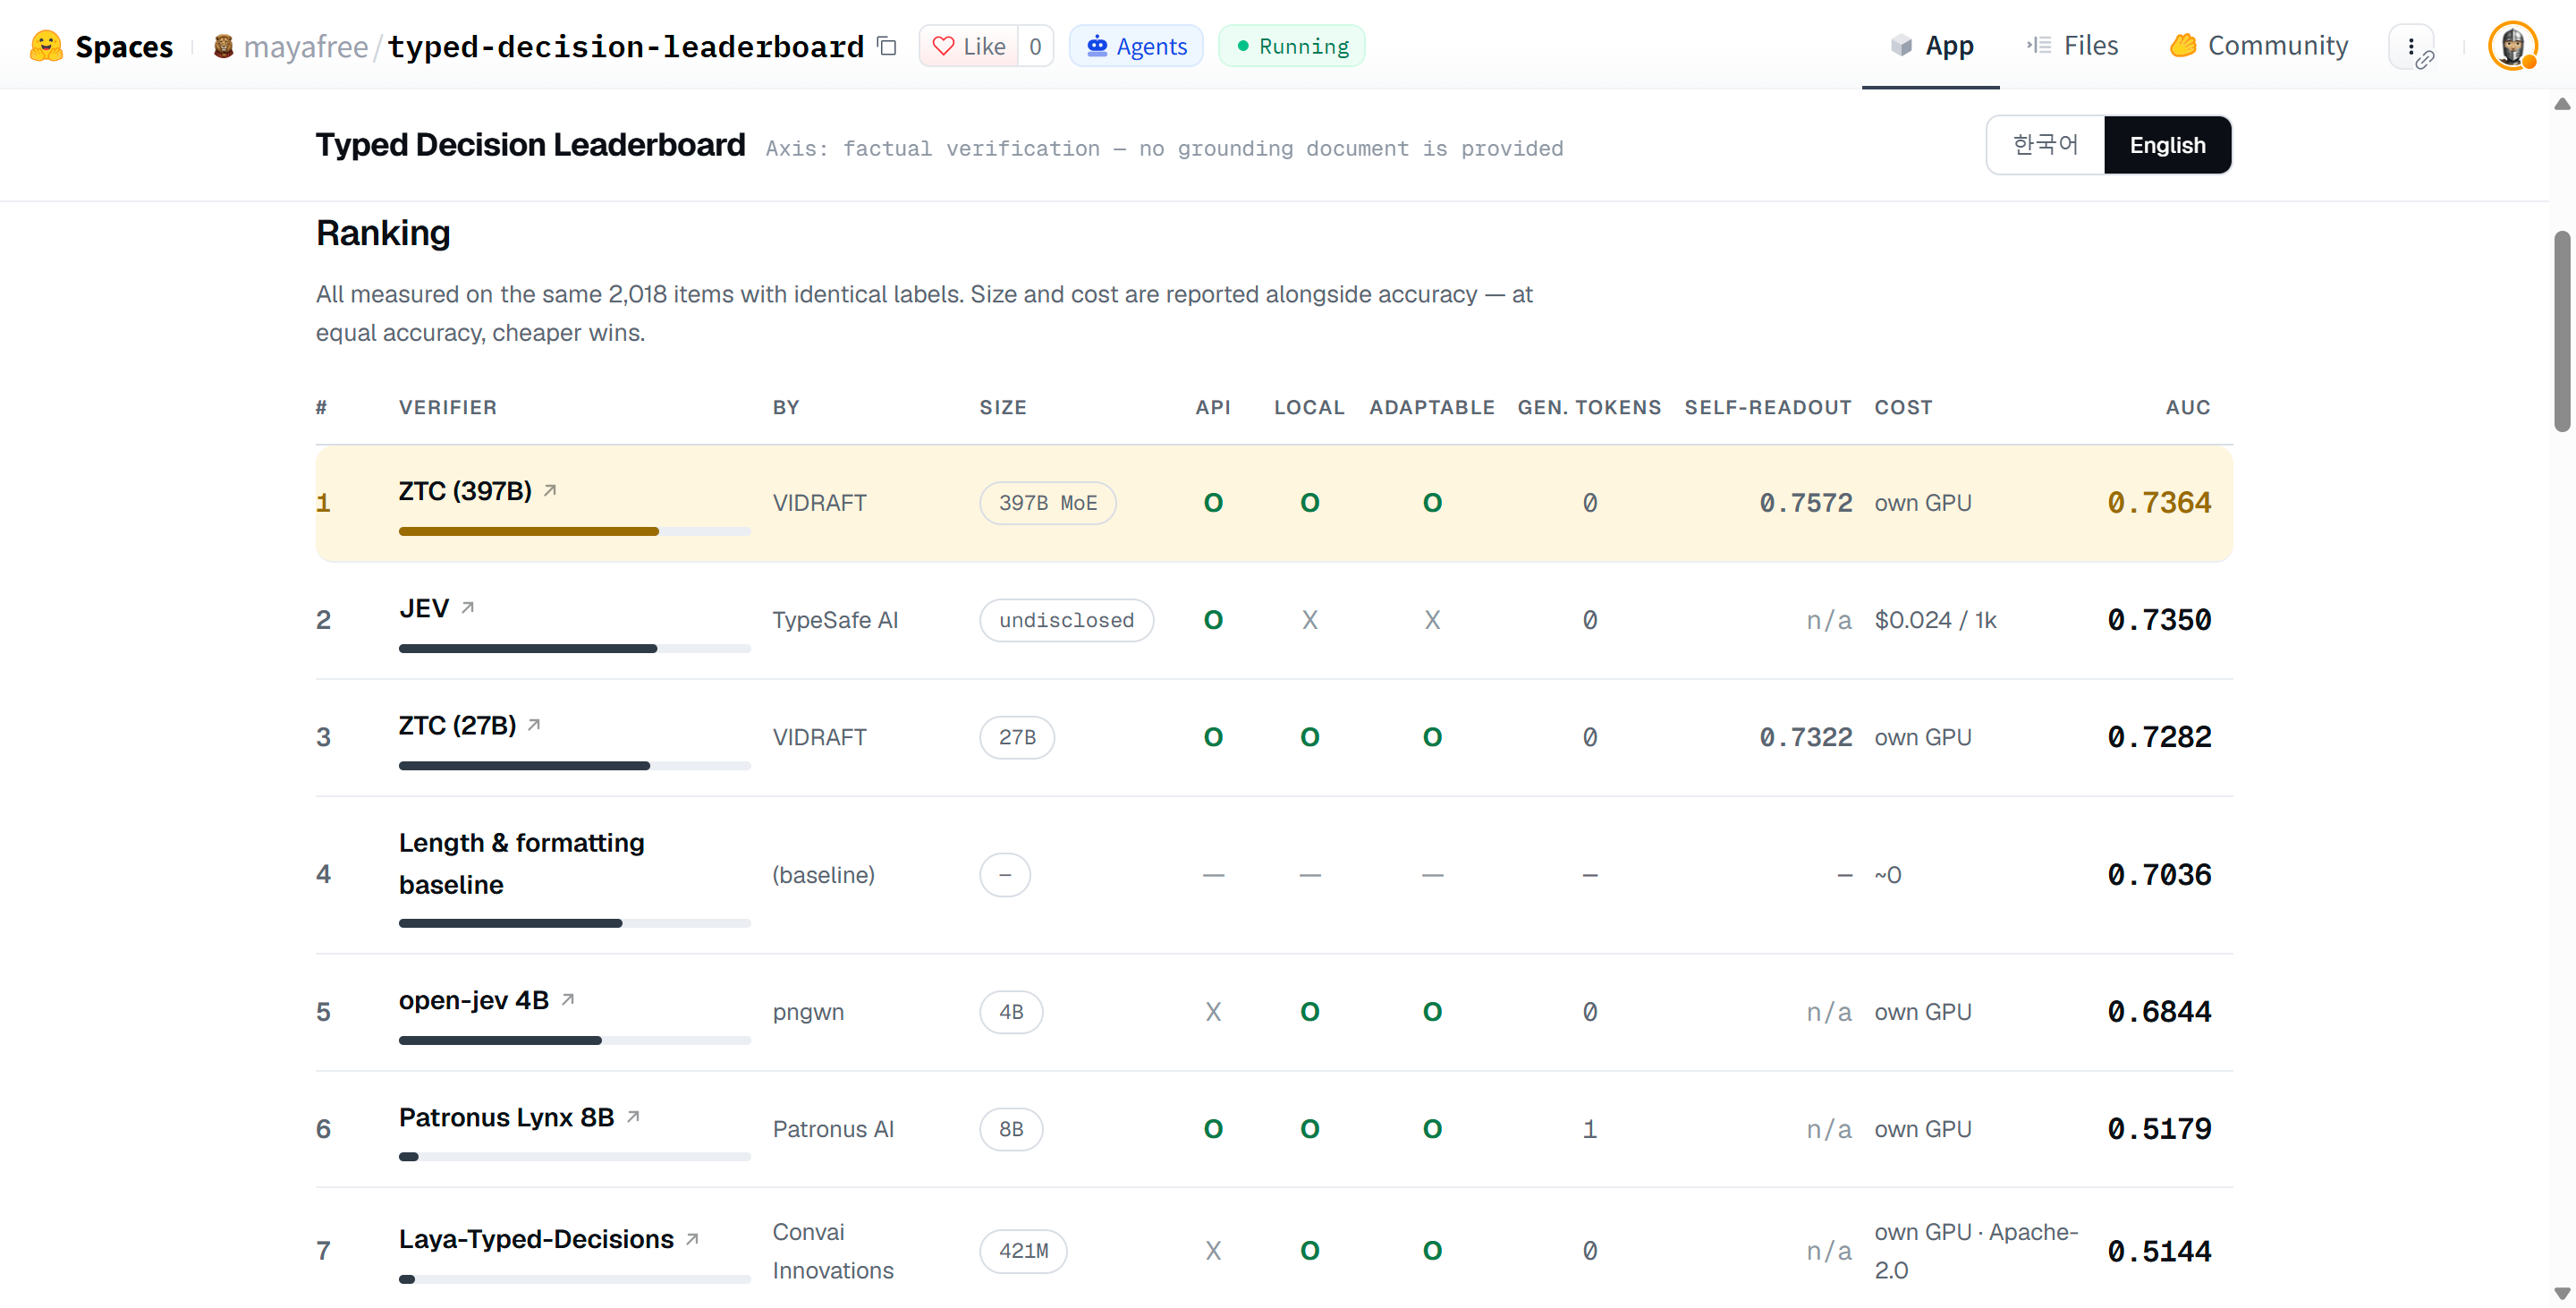
mayafree 계정이 공개한 Typed Decision Leaderboard는 그 빈칸을 메운 측정이다.
13개 시스템을 2,018문항·동일 라벨·동일 채점 코드로 한 번에 돌렸다.
- 리더보드: https://huggingface.co/spaces/mayafree/typed-decision-leaderboard
- 체험관: https://huggingface.co/spaces/mayafree/verifier-playground
이 글은 그 공개 자료를 놓고 무엇이 측정됐고, 무엇이 측정되지 않았으며, 수치가 실제로
무엇을 뜻하는지를 정리한다.
1. 측정 설계 — 눈여겨볼 선택 세 가지
| 항목 | 내용 |
|---|---|
| 과제 | 문제와 «어떤 모델이 쓴 답»을 받아, 그 답이 맞는지 점수화 |
| 문항 | 2,018건 · 오답 508건 · 5개 분야 · 답을 쓴 모델 4종 |
| 지표 | AUC — 오답이 아래로 정렬되는 정도. 문턱 없음. 0.5 = 동전 |
| 축 | 근거 문서를 주지 않는 사실 검증 |
| 집계 | 분야별로 먼저 재고, 문항 수로 가중평균 |
| 불확실성 | 짝지은 부트스트랩 3,000회 · 구간이 0을 품으면 순위 없음 |
설계에서 결과 해석을 바꾸는 선택이 셋 있다.
① 분야별로 재고 나서 합친다. 2,018문항을 한 덩어리로 섞어 AUC를 내면 값이 올라간다.
분야마다 점수 눈금이 달라, 그 눈금 차이가 변별력으로 계산되기 때문이다.
공개 자료에 따르면 같은 시스템이 섞어서 재면 0.80, 분야별로 재면 0.73이 나온다.
리더보드는 낮은 쪽을 채택했다.
② 기준선을 표에 올려놓는다. 답의 길이·숫자 개수·서식 등 겉모습 10가지만 쓰는 모형과,
답을 쓴 모델 자신이 신고한 확신도. 둘 다 순위표에 행으로 들어가 있다.
③ 축이 다른 도구는 순위에서 뺀다. 근거 문서가 필요한 도구(Vectara HHEM)와
토큰을 생성하는 LLM 심판은 별도 칸으로 내렸다. 성능이 낮아서가 아니라 재는 것이 다르기 때문이다.
2. 결과
| # | 시스템 | 제공 | API | 로컬 가중치 | AUC |
|---|---|---|---|---|---|
| 1 | ZTC (397B) | VIDRAFT | ○ | ○ | 0.7364 |
| 2 | JEV | TypeSafe AI | ○ | ✕ | 0.7350 |
| 3 | ZTC (27B) | VIDRAFT | ○ | ○ | 0.7282 |
| — | 길이·서식 기준선 | 참고 | — | — | 0.7036 |
| 4 | open-jev 4B | pngwn | ✕ | ○ | 0.6844 |
| 5 | Patronus Lynx 8B | Patronus AI | ○ | ○ | 0.5179 |
| 6 | Laya-Typed-Decisions 421M | Convai | ✕ | ○ | 0.5144 |
| — | 모델 자기신고 확신도 | 참고 | — | — | 0.5000 |
| 7 | Laya-Multilingual 322M | Convai | ✕ | ○ | 0.4796 |
참고 칸 — LLM에게 직접 물어본 경우(토큰을 생성하므로 순위 밖):
GPT-5.2 0.7148 · Qwen3-Next-80B 0.6366 · GPT-4o-mini 0.5878 · Gemini 2.5 Flash-Lite 0.5822.
축 불일치: Vectara HHEM-2.1 0.4852.
공개돼 있으나 그대로는 실행되지 않은 구현 4건도 표에 남아 있다.
판정층이 체크포인트에 없거나, 구조를 라이브러리가 인식하지 못하거나, 토크나이저가 결손된 경우다.
점수 없이 사유와 링크만 달려 있다.
1위와 2위는 가르지 않았다
1위와 2위의 차이는 0.0014, 구간은 −0.019 ~ +0.032다.
구간이 0을 품으므로 리더보드 자체 규칙에 따라 순위를 부여하지 않았다.
표 위쪽에 그 사실이 각주가 아니라 본문으로 적혀 있다. 자기 항목이 1위인 표에서
이 규칙을 그대로 적용한 점은 기록해 둘 만하다.
3. 수치가 말하는 것 네 가지
3.1 진짜 문턱은 0.5가 아니라 0.7036이다
답의 길이와 서식만 보는 모형이 0.7036을 받는다. 13개 중 8개가 그 아래다.
이 선을 못 넘는 도구는 «정답 여부»가 아니라 «답이 잘 쓰였는지»를 재고 있는 것에 가깝다.
기준선이 없는 리더보드는 참가자를 실제보다 좋아 보이게 만든다. 이 표에서 기준선은
4위와 5위 사이가 아니라 3위와 4위 사이에 놓여 있다.
3.2 크기가 성능을 정하지 않는다
같은 계열 안에서도 분야에 따라 순서가 뒤집힌다.
과학추론 27B 0.7410 · 397B 0.6287
14배 큰 모델이 0.11 낮다. 리더보드 운영 측은 이 칸을 대표값 하나로 줄이지 않고
두 값을 같이 실었다. 180B급 모델이 4B보다 낮게 나온 별도 관측도 같은 방향이다.
⟹ 이 축에서는 파라미터 수보다 내부 표현의 구조가 성능을 정한다고 읽는 편이 자연스럽다.
3.3 «그냥 큰 모델에 물어보면 된다»는 비싸고, 중간이다
GPT-5.2가 0.7148로 JEV와 ZTC 두 구성 아래에 있다.
비용은 1,000건당 약 $0.55로 JEV의 $0.024 대비 23배다. 게다가 토큰을 생성한다.
더 작은 심판들은 더 내려간다(GPT-4o-mini 0.5878, Gemini 2.5 Flash-Lite 0.5822).
3.4 오픈 대안은 있으나 격차는 실재한다
Convai의 Laya는 구조상 Jev에 가장 가까운 공개 모델이다. 비자기회귀·생성 토큰 0개·
Apache-2.0·건당 약 0.015초. 속도 주장은 이 측정에서도 확인된다.
다만 정확도는 0.4796 / 0.5144로, 제작사가 자체 영문 벤치에서 Jev를 이겼다고 밝힌 것과
방향이 다르다.
두 결과가 동시에 참일 수 있다 — 다른 시험지이기 때문이다. 공용 시험지가 필요한 이유가 여기 있다.
4. AUC는 배포 기준이 아니다
리더보드가 답하는 질문은 «어느 도구가 정답과 오답을 잘 가르나»다.
«어느 도구가 내 에이전트를 실제로 도와주나»는 다른 질문이고, 공개 자료에는 그것도 측정돼 있다.
구성: 답을 검증기로 채점하고, 점수가 낮은 하위 k%를 더 센 모델에 보내 다시 풀게 한 뒤
그 답으로 교체한다. 세 팔이 같은 재시도 풀을 공유하고, 동점은 무작위로 200회 섞어 평균냈다.
재시도 예산 20%, 관문 없을 때 74.83% 기준
| 관문 | 최종 정답률 | 기본 대비 |
|---|---|---|
| ZTC | 76.16% | +1.34%p |
| JEV | 74.76% | −0.07%p |
| 무작위 | 74.58% | −0.25%p |
AUC 차이는 0.0014인데, 에이전트 정답률 차이는 1.4%p다.
왜 갈리는가
다시 푸는 행위 자체가 양날의 칼이다.
오답을 다시 풀면   →  38% 고쳐진다
정답을 다시 풀면   →  30% 망가진다
따라서 관문의 값은 **«오답을 얼마나 많이 부르는가»(재현율)가 아니라
«맞는 답을 얼마나 안 부르는가»(정밀도)**가 정한다.
20% 예산에서 JEV가 부른 403건 중 216건이 이미 맞는 답이었다.
고친 만큼 망가뜨려 결과적으로 본전이 됐다. 이 비대칭은 AUC 한 칸에는 보이지 않는다.
범위 주의: 재시도 상대는 한 종류, 시험지도 한 벌이다. 보편 상수가 아니라 기전으로 읽어야 한다.
5. 공개 범위와 한계
전부 공개: 점수, 라벨, 채점 코드.
재배포하지 않음: 문항 원문. 변형·재배포를 금지하는 라이선스이거나 접근 승인제인 코퍼스,
그리고 약관이 불분명한 상용 모델 출력이 섞여 있다. 대신 채점 코드를 열어 두어
동일 절차를 각자의 비공개 시험지에 돌릴 수 있게 했다.
보류로 표시된 칸이 있다. 한 항목은 재측정값이 기존 값과 크게 어긋났는데,
재현 코드가 상류 구현과 일치한다는 확인이 아직 안 돼 기존 값을 유지하고 표시만 해 두었다.
자체 코드를 근거로 타사 점수를 낮추지 않겠다는 선택이다. 이런 항목이 표에 남아 있다는 사실
자체가 이 측정의 성격을 보여준다.
측정되지 않은 칸도 사유를 갈라 적었다. 어떤 분야는 답이 숫자라 방식이 맞지 않았고,
어떤 분야는 정정 후에도 동전 수준이라 원인 미규명으로 남겼다. 추측은 각주에 넣지 않았다.
6. 직접 확인할 수 있다
같은 계정이 체험관을 함께 열어 두었다. 문제와 답변을 넣으면
ZTC · JEV · Laya가 같은 입력으로 동시에 점수를 낸다.
각 칸 아래에 리더보드 성적이 함께 표시되고, 눈금이 서로 다르다는 점도 화면에 명시돼 있다
(ZTC는 범위 없는 실수, JEV·Laya는 0~1 확률).
https://huggingface.co/spaces/mayafree/verifier-playground
한 건의 결과로 우열을 말할 수는 없다. 다만 표에 적힌 주장을 자기 사례로 대조해 볼 수 있다는
점에서, 리더보드와 체험관을 같이 연 구성은 검증 가능성을 한 단계 높인다.
정리
- 이 축에서 0.70을 넘긴 시스템은 셋뿐이고, 그중 1·2위는 통계적으로 구분되지 않는다.
- 겉모습 기준선 0.7036이 실질적인 합격선이며, 13개 중 8개가 그 아래다.
- 크기는 성능을 보장하지 않는다. 분야에 따라 14배 작은 모델이 이긴다.
- AUC만 보고 검증기를 고르면 안 된다. 같은 예산에서 에이전트 이득은 1.4%p까지 갈린다.
리더보드: https://huggingface.co/spaces/mayafree/typed-decision-leaderboard
영문 원자료: https://huggingface.co/blog/mayafree/jve-ecosystems
수치는 2026-09-20 공개본 기준이며, 시스템이 추가되거나 재측정되면 갱신된다.