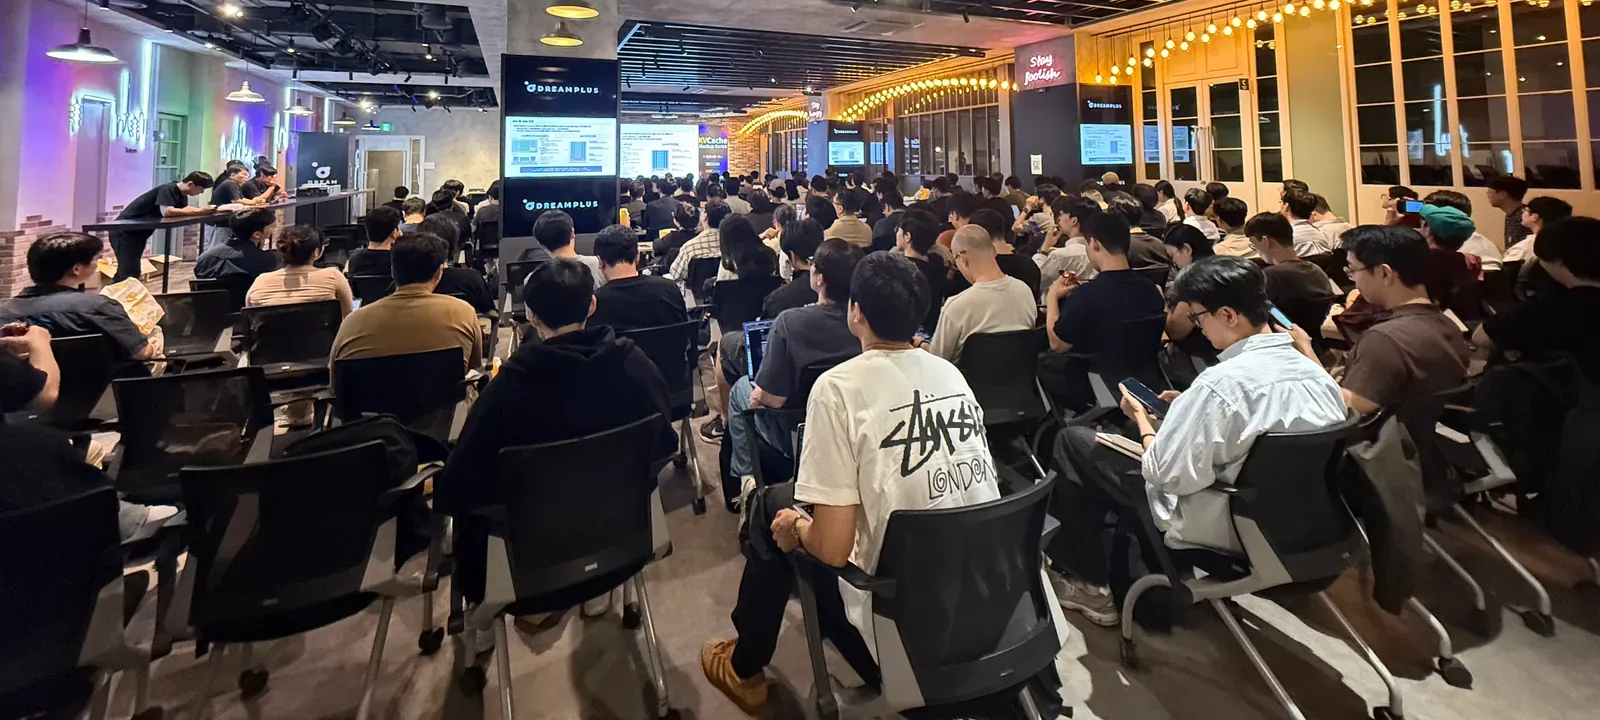
KVCache Meetup Korea 개요
지난 2026년 9월 30일 저녁, 서울 강남 드림플러스에서 KVCache Meetup Korea 행사가 진행되었습니다. PyTorchKR과 CXL 전문 스타트업 XCENA가 공동으로 주최하고, LMCache의 개발사 Tensormesh가 후원했습니다. 이번 행사는 대규모 언어 모델(LLM, Large Language Model)의 추론 과정에서 메모리 병목을 줄이는 방법과 경험을 나누는 자리였습니다.
이번 밋업의 주제는 KV 캐시(KV Cache)였습니다. KV 캐시는 모델이 앞서 처리한 토큰의 어텐션 키(Key)와 값(Value)을 저장해, 다음 토큰을 생성할 때 같은 계산을 반복하지 않도록 하는 데이터입니다. 이를 어디에 보관하고, 어떻게 재사용하며, 필요한 곳까지 얼마나 빠르게 가져올 것인지를 하드웨어와 추론 소프트웨어의 관점에서 함께 살펴봤습니다.
XCENA, SK하이닉스, FuriosaAI, LMCache의 연사들은 CXL을 통한 메모리 확장, GPU와 HBM의 자원 활용 분석, RNGD의 요청 스케줄링, LMCache의 MP Mode를 소개했습니다. 발표 뒤에는 연사들과의 질의응답, 참석자 간 네트워킹도 이어졌습니다.
관심 분야 스티커로 시작한 만남
이번 행사는 발표를 듣는 시간과 함께, 비슷한 문제를 고민하는 참석자들이 서로 만날 수 있는 자리를 준비했습니다. 등록 데스크에는 Model, Serving, Infra, Hardware, Memory의 다섯 분야 스티커를 마련했습니다. 네트워킹에 관심 있는 참석자들은 자신의 관심사에 맞는 스티커를 최대 두 장 골랐습니다.
각자의 관심 분야를 고르며 행사를 시작한 참석자들.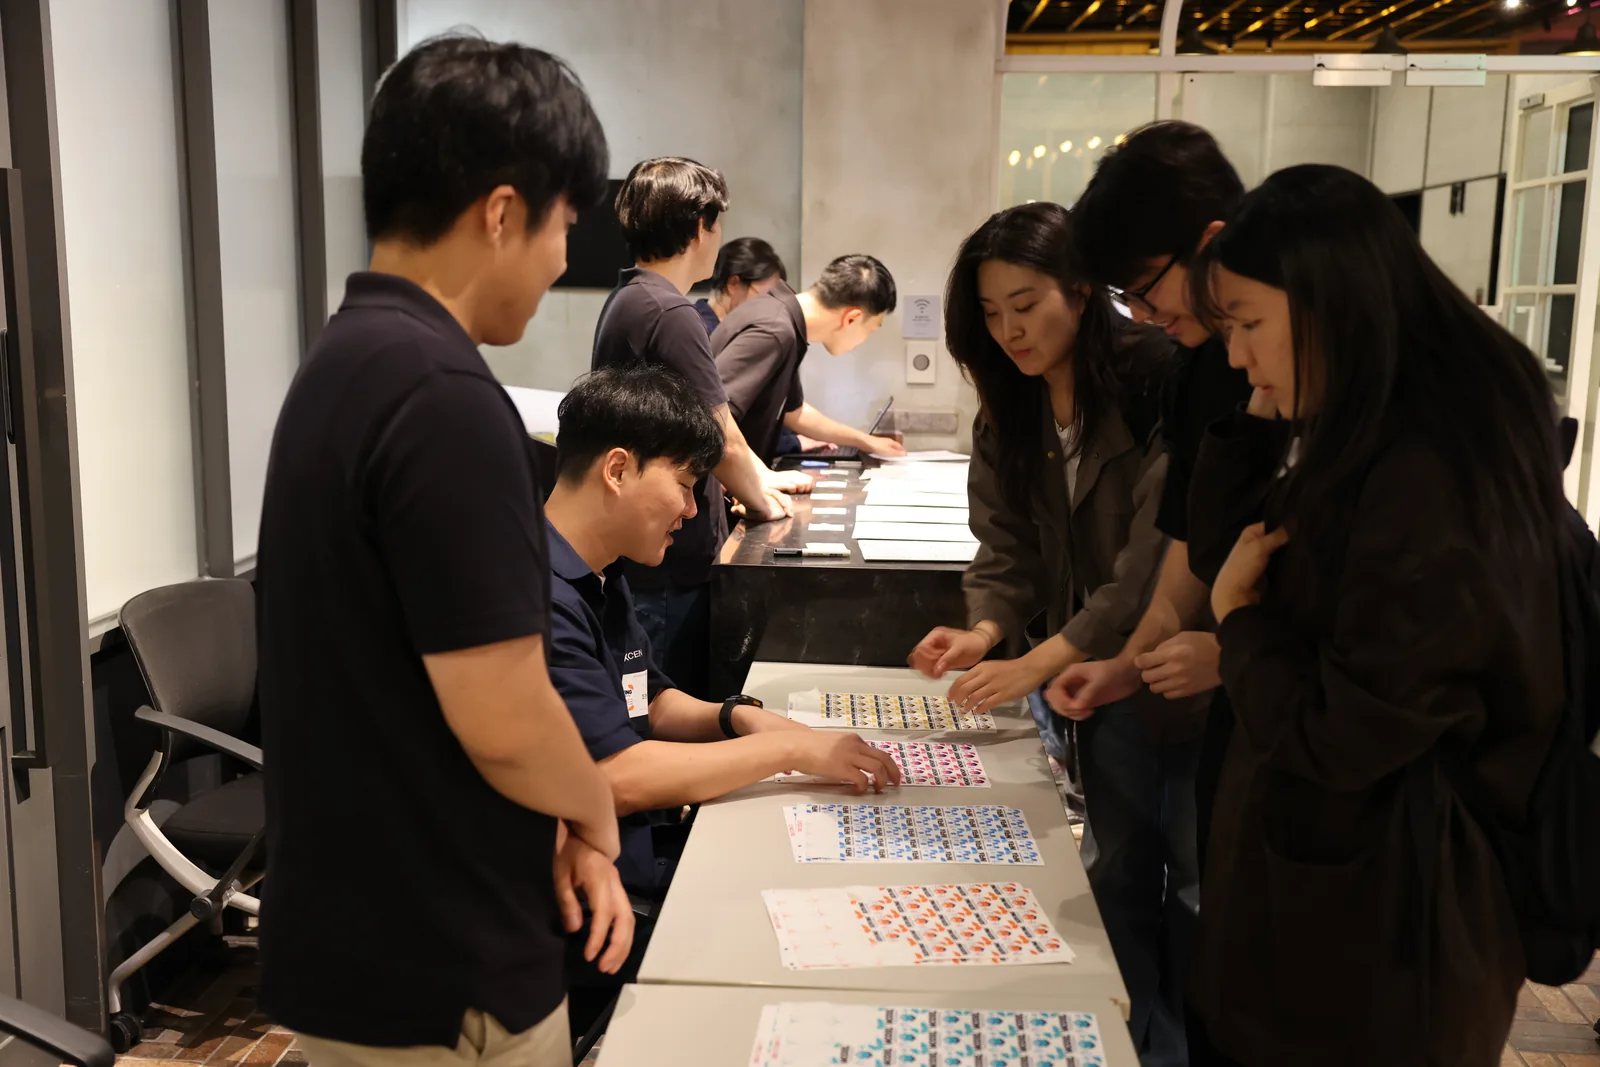
오프닝은 PyTorchKR 박정환 운영자와 XCENA 김주현 CPO가 함께했습니다. 이어 XCENA 이주호 님, SK하이닉스 오세진 님, FuriosaAI 이동훈 님, LMCache Baoloong Mao 님의 발표가 진행됐습니다.
PyTorchKR 박정환 운영자의 오프닝. XCENA 김주현 CPO의 오프닝.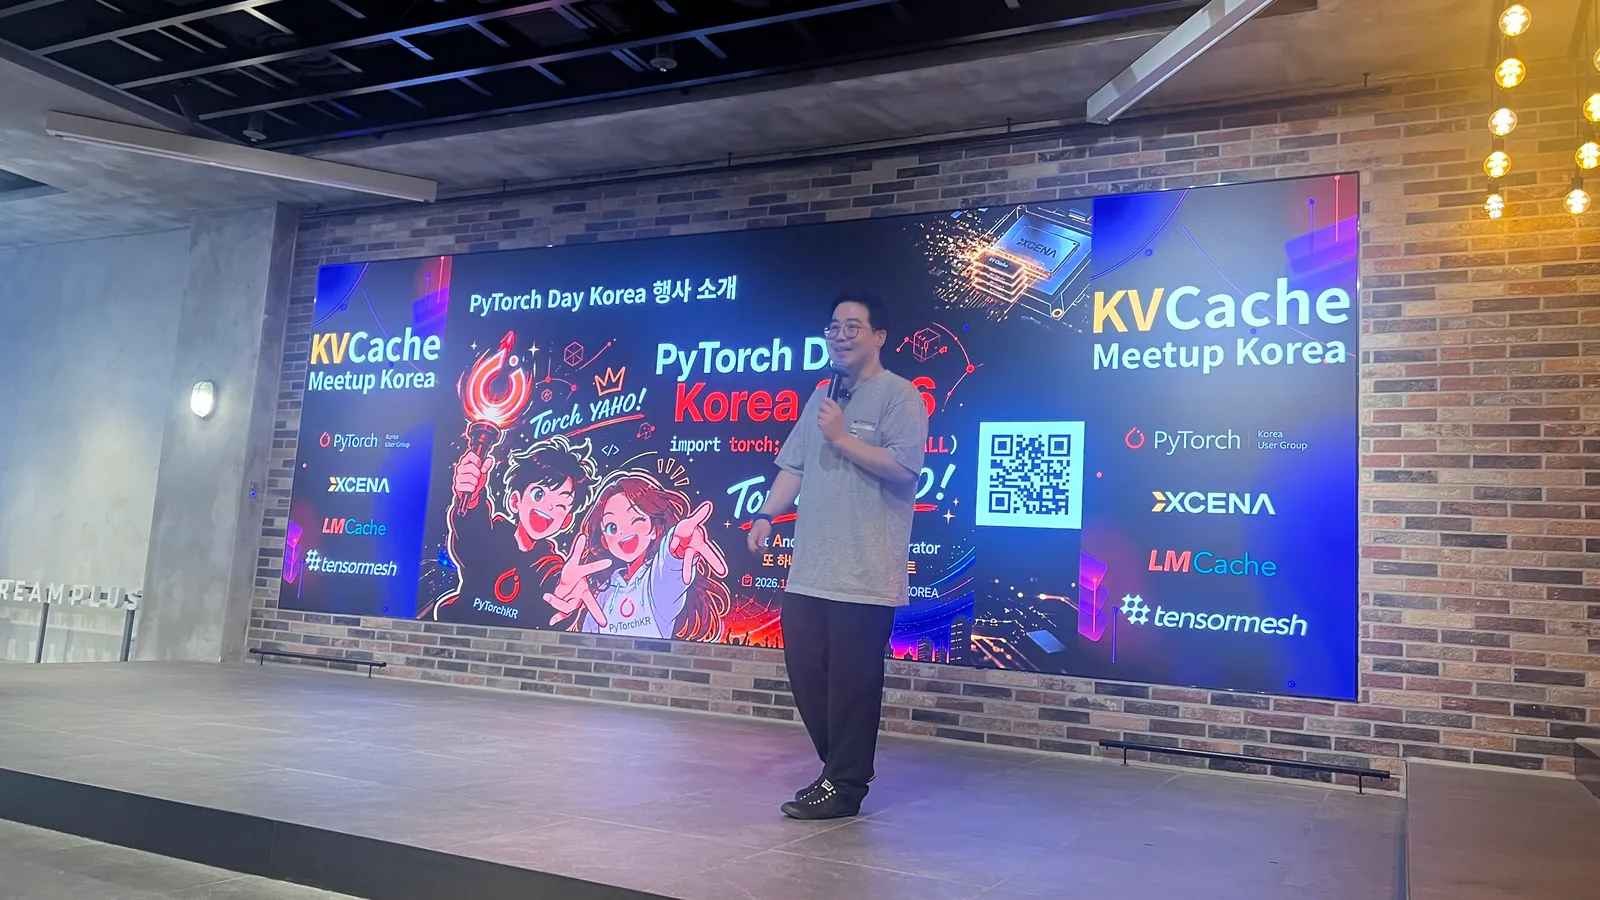
CXL과 KV 캐시 저장 계층, XCENA 이주호 님
이주호 님의 「CXL for KVCache」 세션은 메모리 연결 기술인 CXL(Compute Express Link)의 기본 구조와 메모리 확장 방식에서 출발했습니다. CPU가 읽기·쓰기 명령으로 접근할 수 있는 메모리 공간을 넓히고, 여러 호스트가 메모리 풀을 활용하는 구성을 설명했습니다.
이와 함께 XCENA의 오픈소스 프로젝트 Maru를 소개했습니다. Maru는 LLM 추론에서 CXL 공유 메모리를 활용하기 위한 KV 캐시 저장 엔진입니다.
CXL의 메모리 확장 방식과 KV 캐시 저장 구조를 소개하는 이주호 님.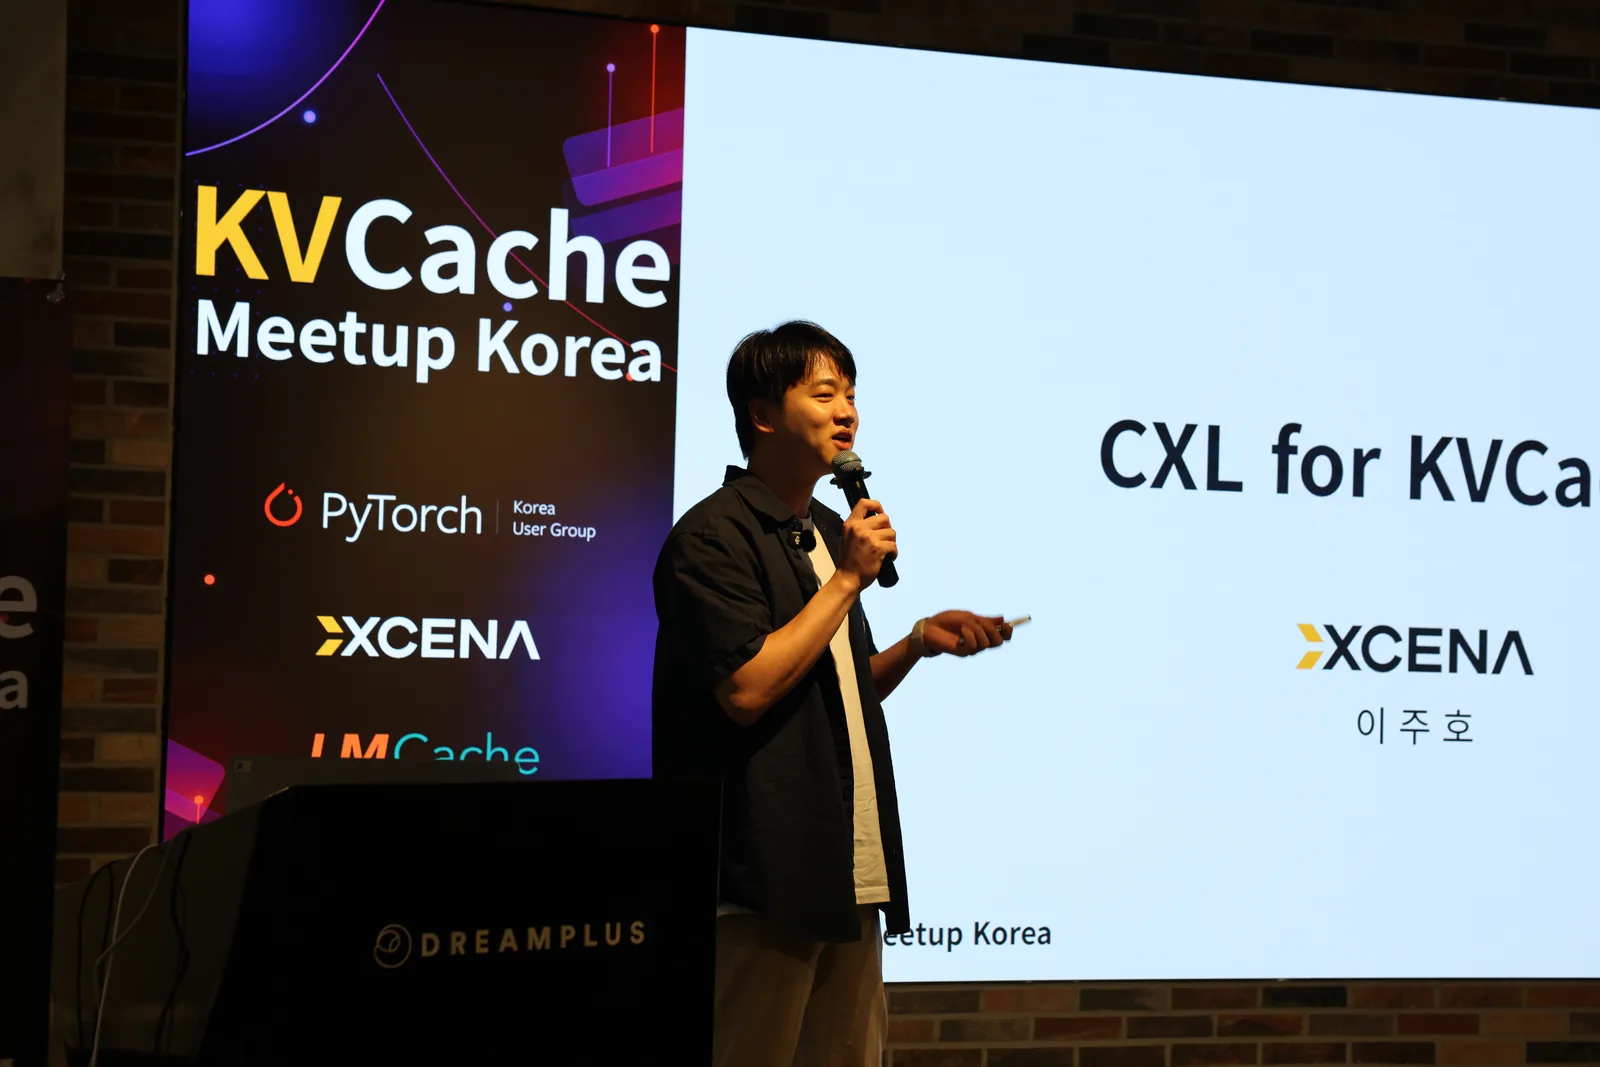
발표에서는 CXL 메모리 풀에 DRAM과 SSD를 결합하는 구조를 다뤘습니다. 자주 사용하는 캐시는 DRAM에, 덜 사용하는 캐시는 SSD에 두고 Maru로 추론 엔진과 저장 계층을 연결하는 방식입니다. 저장할 수 있는 캐시의 양과 함께, 캐시를 GPU까지 가져오는 경로와 비용도 고려해야 한다는 점을 짚었습니다.
전문가 혼합 모델(MoE, Mixture of Experts)의 연산을 GPU와 XCENA의 MX1에 나누는 구성도 소개했습니다. 일부 전문가(expert)의 가중치를 MX1 쪽 메모리에 두고 그 가까이에서 연산하면, 연결 경로로 가중치 전체를 옮기는 대신 활성값(activation)과 연산 결과를 주고받을 수 있습니다. KV 캐시의 저장 위치에서 시작해 가중치 배치와 데이터 이동을 줄이는 방법까지 살펴본 세션이었습니다.
GPU 연산과 HBM 대역폭의 병목, SK하이닉스 오세진 님
오세진 님은 「Analyzing Utilization of GPU and HBM in LLM Serving Systems」에서 입력을 처리하는 프리필(prefill)과 이후 토큰을 생성하는 디코드(decode)의 자원 사용 양상을 분석했습니다. GPU 연산 성능과 고대역폭 메모리(HBM, High Bandwidth Memory)의 대역폭 중 어떤 자원이 성능을 제한하는지, 루프라인(Roofline) 분석과 실제 시스템의 프로파일링을 대조해 설명했습니다.
프리필과 디코드의 자원 사용 양상을 설명하는 오세진 님.
발표에서 소개한 H100 두 장, Llama 3.1 8B, vLLM 환경의 실험에서는 프리필의 주요 프로젝션(projection) 구간에서 연산 자원 활용률이 높았고, 디코드에서는 HBM 대역폭 사용률이 높았습니다. 첫 토큰이 나올 때까지 걸리는 시간(TTFT, Time to First Token)과 출력 토큰당 시간(TPOT, Time per Output Token)을 구분해 살펴봐야 하는 이유를 실험으로 설명했습니다.
KV 캐시를 재사용해 프리필 연산을 줄인 뒤에는 메모리 대역폭이 병목이 될 가능성도 다뤘습니다. 메모리 용량과 대역폭 중 무엇을 늘려야 할지는 입력·출력 길이와 배치 크기 등 서비스 조건에 따라 달라진다는 점을 짚었습니다.
RNGD의 요청 스케줄링과 KV 캐시 관리, FuriosaAI 이동훈 님
이동훈 님은 「LLM Inference Engine for RNGD」에서 FuriosaAI의 RNGD를 위한 추론 엔진 Furiosa-LLM을 개발하며 겪은 문제를 공유했습니다. 요청을 받아 실행하기까지의 흐름을 따라 KV 캐시를 블록 단위로 관리하는 PagedAttention, 실행 중인 배치에 요청을 추가하는 연속 배칭(continuous batching), 입력 처리를 나눠 진행하는 청크 프리필(chunked prefill)을 설명했습니다.
실행할 텐서의 형태를 미리 컴파일하는 버킷(bucket) 구조와 요청 스케줄링도 다뤘습니다. 여러 요청을 하나로 묶으면 처리량을 늘릴 수 있지만, 더 큰 버킷과 패딩이 필요해 지연 시간이 늘어날 수도 있습니다. 패딩(padding)은 정해진 텐서 형태에 맞춰 사용하지 않는 위치를 채우는 작업입니다. Furiosa-LLM은 실제 장치에서 실행 비용을 측정하고, 두 배치를 따로 처리하는 것보다 비용이 낮을 때 병합하는 방식을 소개했습니다. 요청마다 다른 문맥 길이와 패딩 비용도 함께 고려합니다.
KV 캐시를 다른 노드와 공유하는 경로를 설명하는 이동훈 님.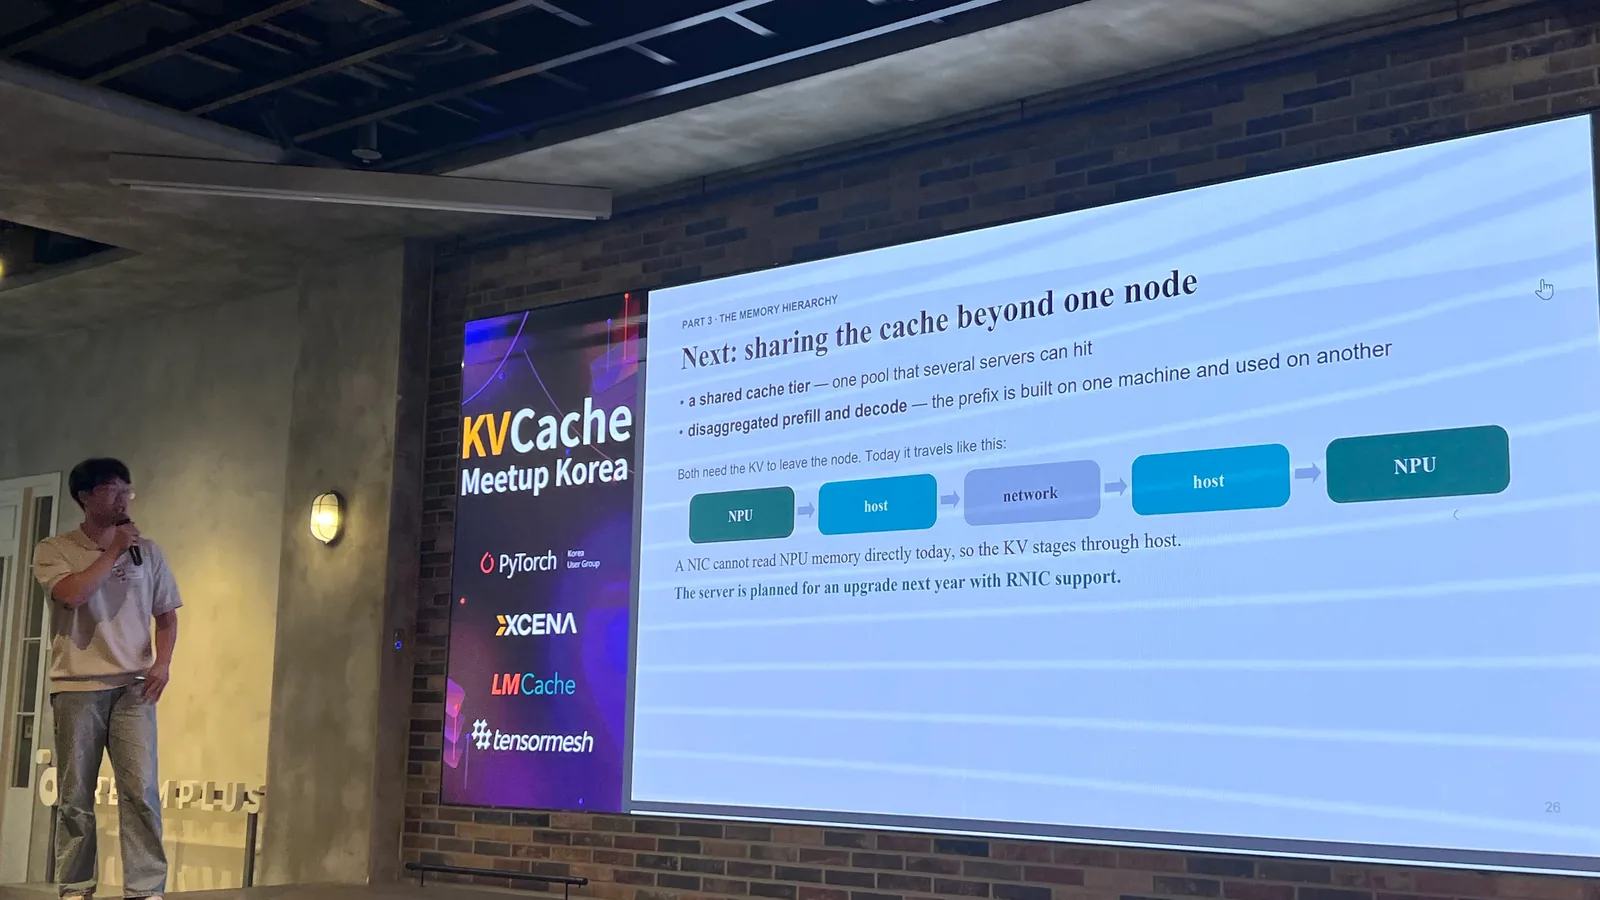
캐시 재사용으로 줄일 수 있는 계산과 캐시 전송에 드는 시간을 비교한 사례도 있었습니다. 발표 사례는 12,370토큰 프롬프트를 요청 하나씩, 조건별 세 차례 측정한 결과였습니다. 호스트 캐시를 가져와 첫 토큰을 생성하는 데 약 92ms, 다시 계산하는 데 약 900ms가 걸렸습니다. 해당 실험 조건에서는 호스트 캐시를 가져오는 편이 빨랐습니다.
캐시 전송과 연산을 레이어 단위로 겹치는 방법도 설명했습니다. 발표에서는 전송량과 대역폭에 따라 효과가 달라진다는 점과 함께, 네트워크 공유 캐시 및 프리필·디코드 분리 같은 실험적 기능과 확장 방향을 소개했습니다.
통합 KV 캐시 관리 계층과 MP Mode, LMCache Baoloong Mao 님
LMCache의 메인테이너이자 핵심 아키텍트인 Baoloong Mao 님은 여러 추론 엔진과 저장소, 하드웨어를 연결하는 LMCache의 구조를 소개했습니다. LMCache는 Tensormesh를 설립한 팀이 만든 오픈소스 KV 캐시 프로젝트입니다.
이번 발표에서는 캐시 관리를 추론 엔진 내부에서 별도 프로세스로 분리하는 MP Mode(Multiprocess Mode)를 다뤘습니다. 추론 연산과 캐시 입출력(I/O)을 분리해 자원 경합을 줄이려는 설계입니다.
여러 추론 엔진과 저장 계층을 연결하는 LMCache의 구조를 소개하는 Baoloong Mao 님.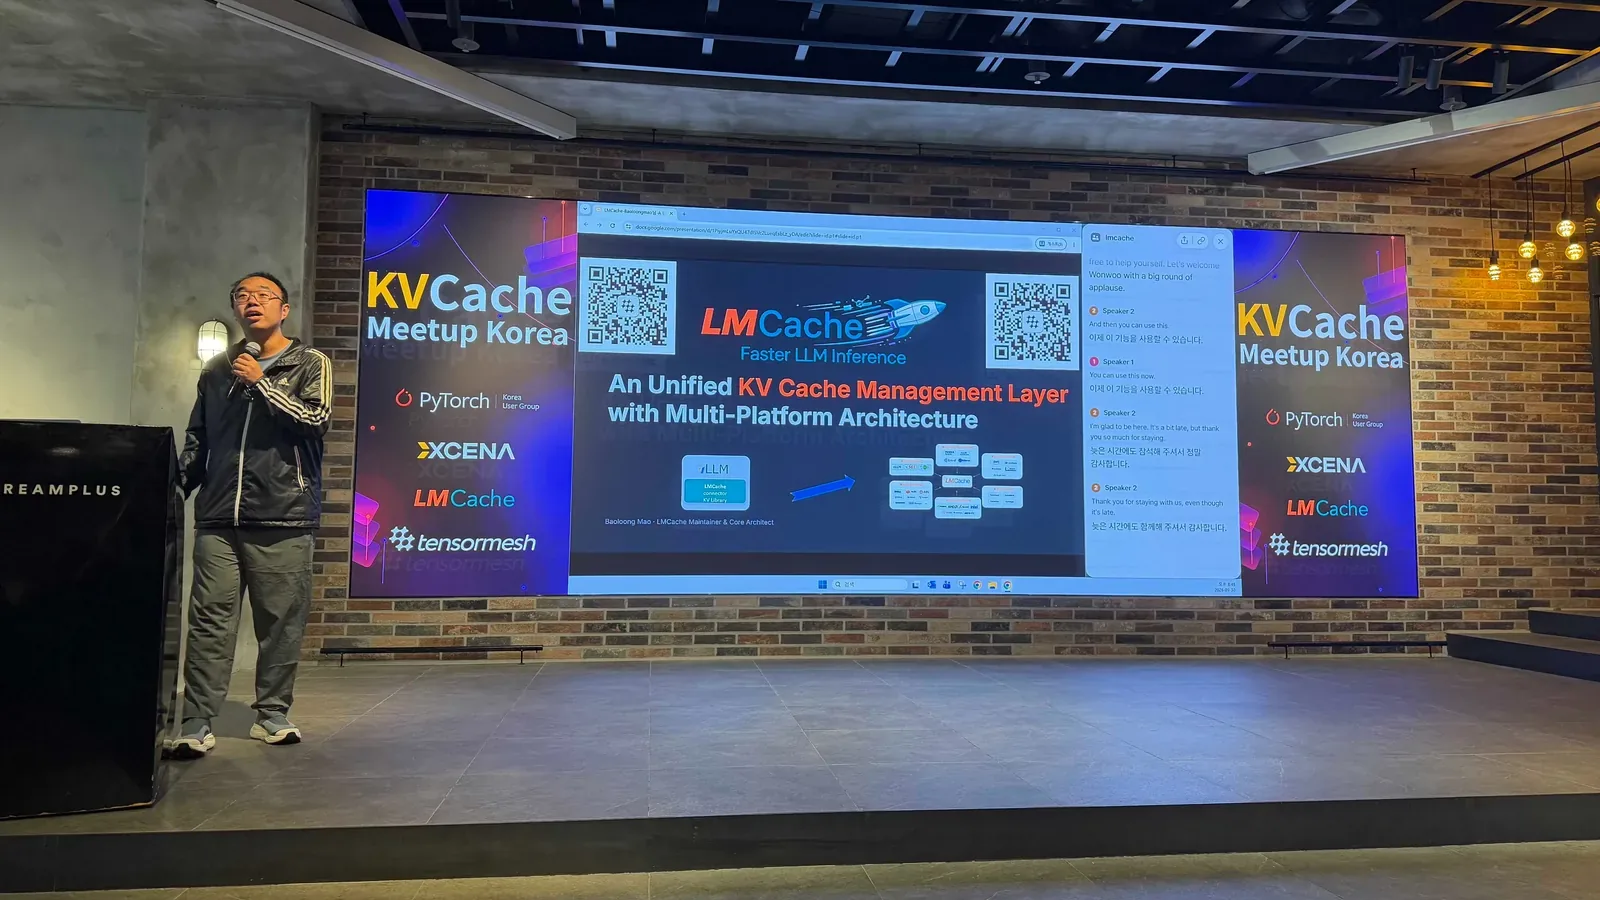
발표에서 소개한 CUDA 환경에서는 프로세스 간 통신 기능인 CUDA IPC(Inter-Process Communication)로 GPU 메모리를 공유하고, 프로세스 사이에는 블록 ID 같은 제어 정보를 전달합니다. 노드 안의 공유 CPU 메모리 풀로 중복 저장을 줄이고, 여러 저장 계층을 병렬로 조회하고 불러오는 구성도 설명했습니다.
배포와 운영에 필요한 내용도 이어졌습니다. Kubernetes 배포, 캐시 적중률과 수명 주기 모니터링, 추론 엔진과 캐시 프로세스의 장애 격리, 외부 플러그인을 통한 저장소 및 장치 확장 등을 다뤘습니다.
발표 뒤에도 이어진 질문과 대화
발표가 끝난 뒤에는 연사들이 함께 무대에 올라 참석자들의 질문에 답했습니다. 프리필·디코드 분리와 혼합 배칭의 차이, LMCache와 vLLM 내장 캐시 기능의 역할, MP Mode의 다중 노드 확장 계획 등 발표 내용을 더 구체적으로 살펴보는 질문들이 이어졌습니다. 혼합 배칭(mixed batching)은 프리필과 디코드 작업을 함께 처리하는 방식입니다.
현장에서 접수한 질문을 보며 답변하는 연사들.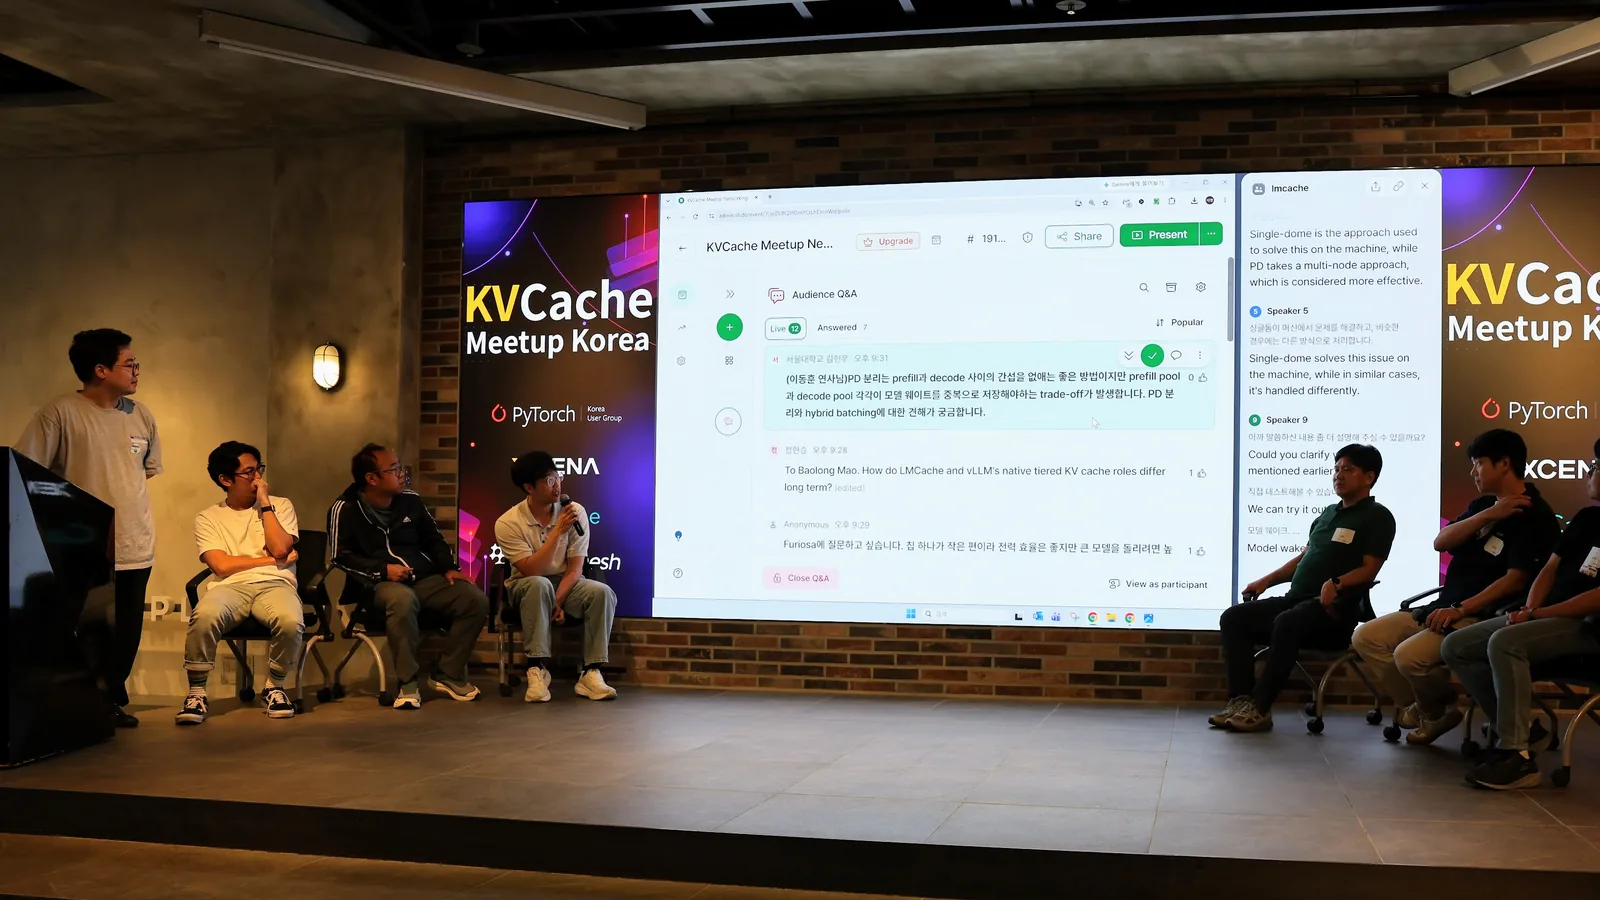
질의응답 뒤에는 참석자들이 삼삼오오 모여 이야기를 나눴습니다. 등록할 때 골랐던 관심 분야 스티커는 서로의 관심사를 알아보고 대화를 시작하는 데 활용됐습니다. 연사와 참석자가 함께 이야기를 나누며 같은 문제에 대한 서로 다른 접근을 공유했습니다.
발표 뒤 자유롭게 대화를 나누는 참석자들.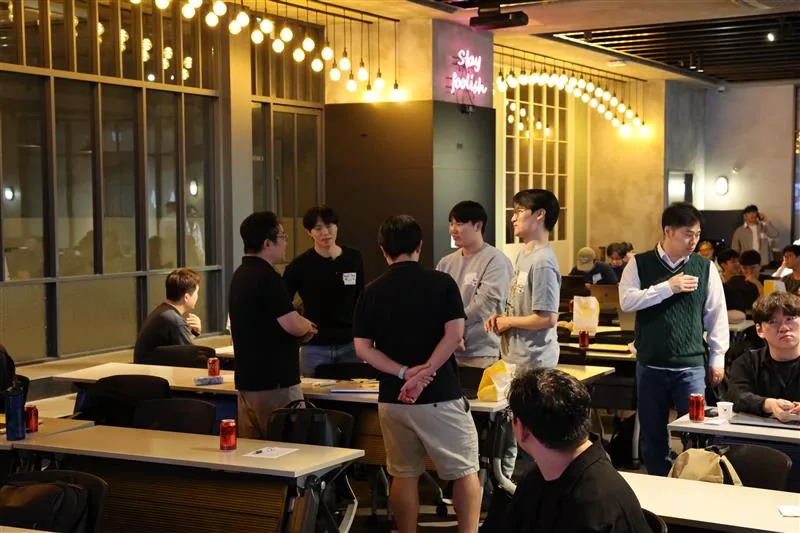
행사장 한쪽에 마련한 XCENA의 CXL 서버 주변에서도 교류가 이어졌습니다. 참석자들은 장비를 가까이에서 살펴보며 궁금한 점을 묻고 답했습니다. 발표에서 소개한 메모리 확장 기술을 실제 장비와 연결해 보는 시간이었습니다.
행사장 곳곳에서 이어진 네트워킹.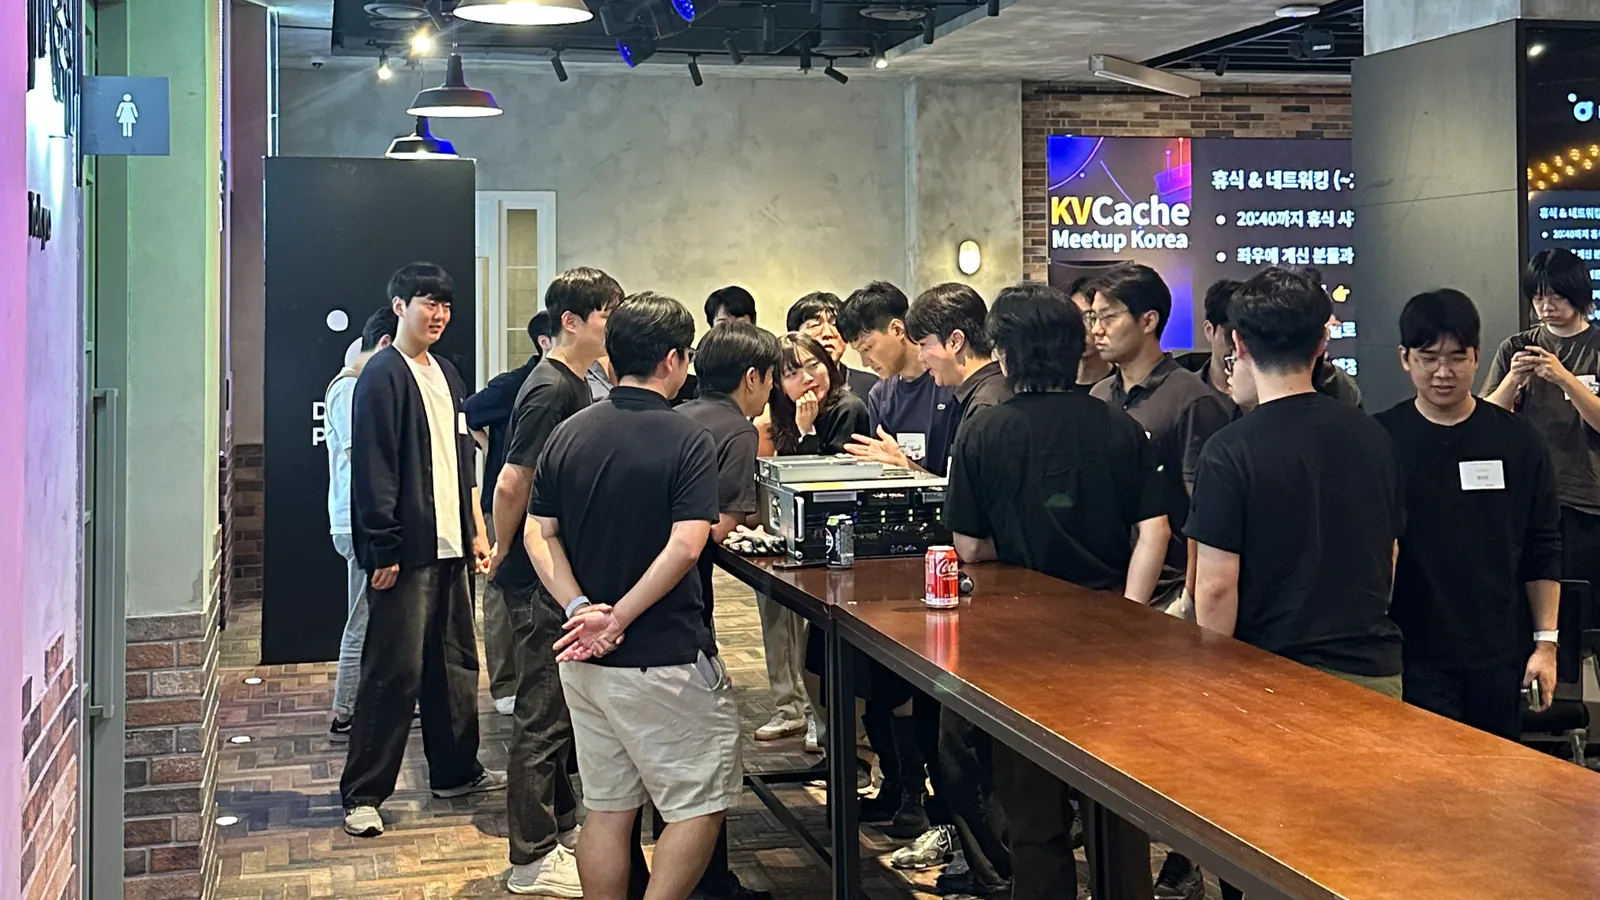
설문 응답 72건으로 돌아본 행사
행사 뒤에는 총 72건의 설문 응답을 받았습니다. 아래 수치와 비율은 전체 참석자가 아닌 설문 응답 72건을 기준으로 합니다. 복수 선택 문항에서는 한 응답자가 여러 항목을 선택할 수 있습니다.
행사 만족도는 5점 만점에 평균 4.50점이었습니다. 5점 응답은 46건, 4점은 17건으로, 두 항목을 합한 63건이 전체 응답의 87.5%를 차지했습니다.
평균 만족도 4.50점. 4점 또는 5점을 선택한 응답은 63건으로 87.5%였습니다.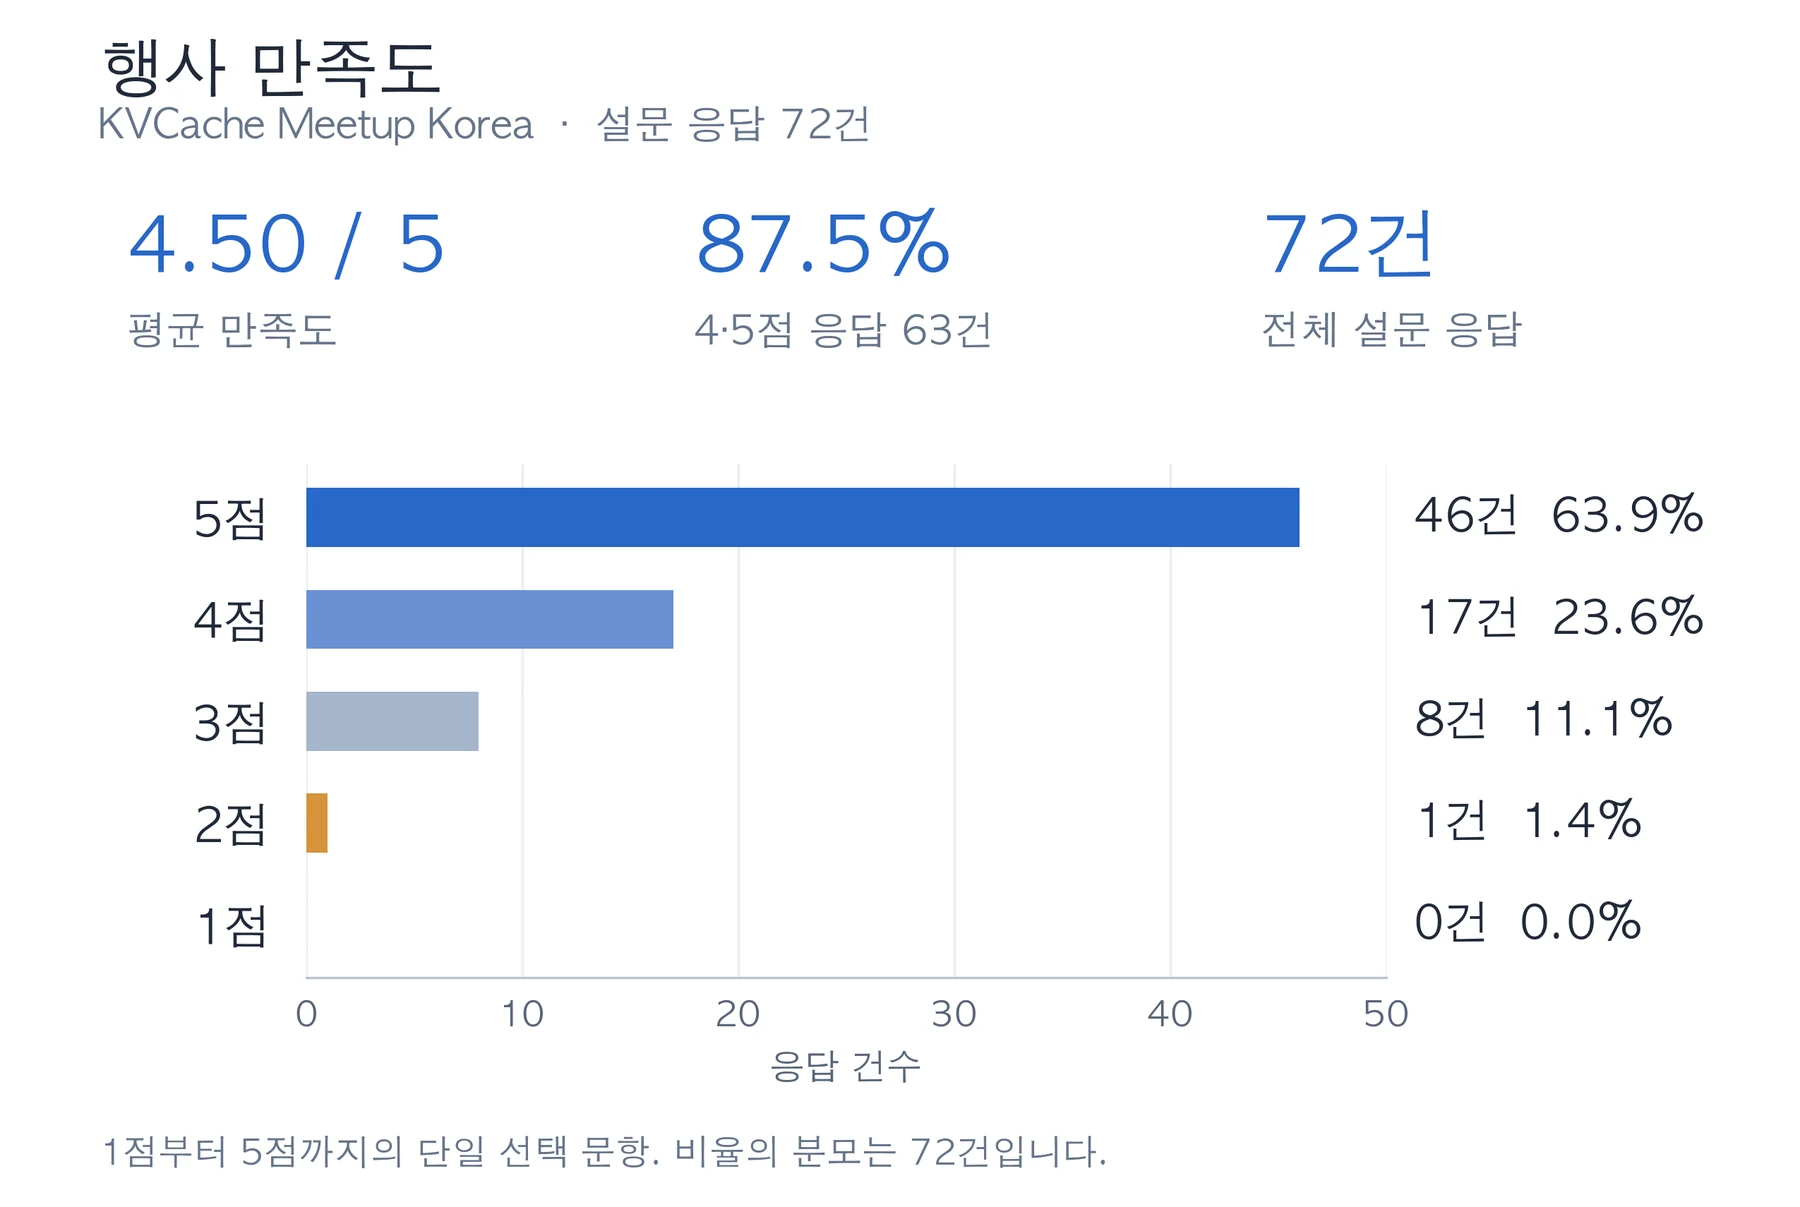
응답자의 업무와 연차도 살펴봤습니다. AI/ML 엔지니어, 소프트웨어 엔지니어, 하드웨어 엔지니어, 학생 등 여러 배경의 참석자들이 설문에 참여했습니다.
설문 응답 72건을 기준으로 정리한 업무별 연차 분포. 업무와 연차의 학생 항목은 서로 다른 문항입니다.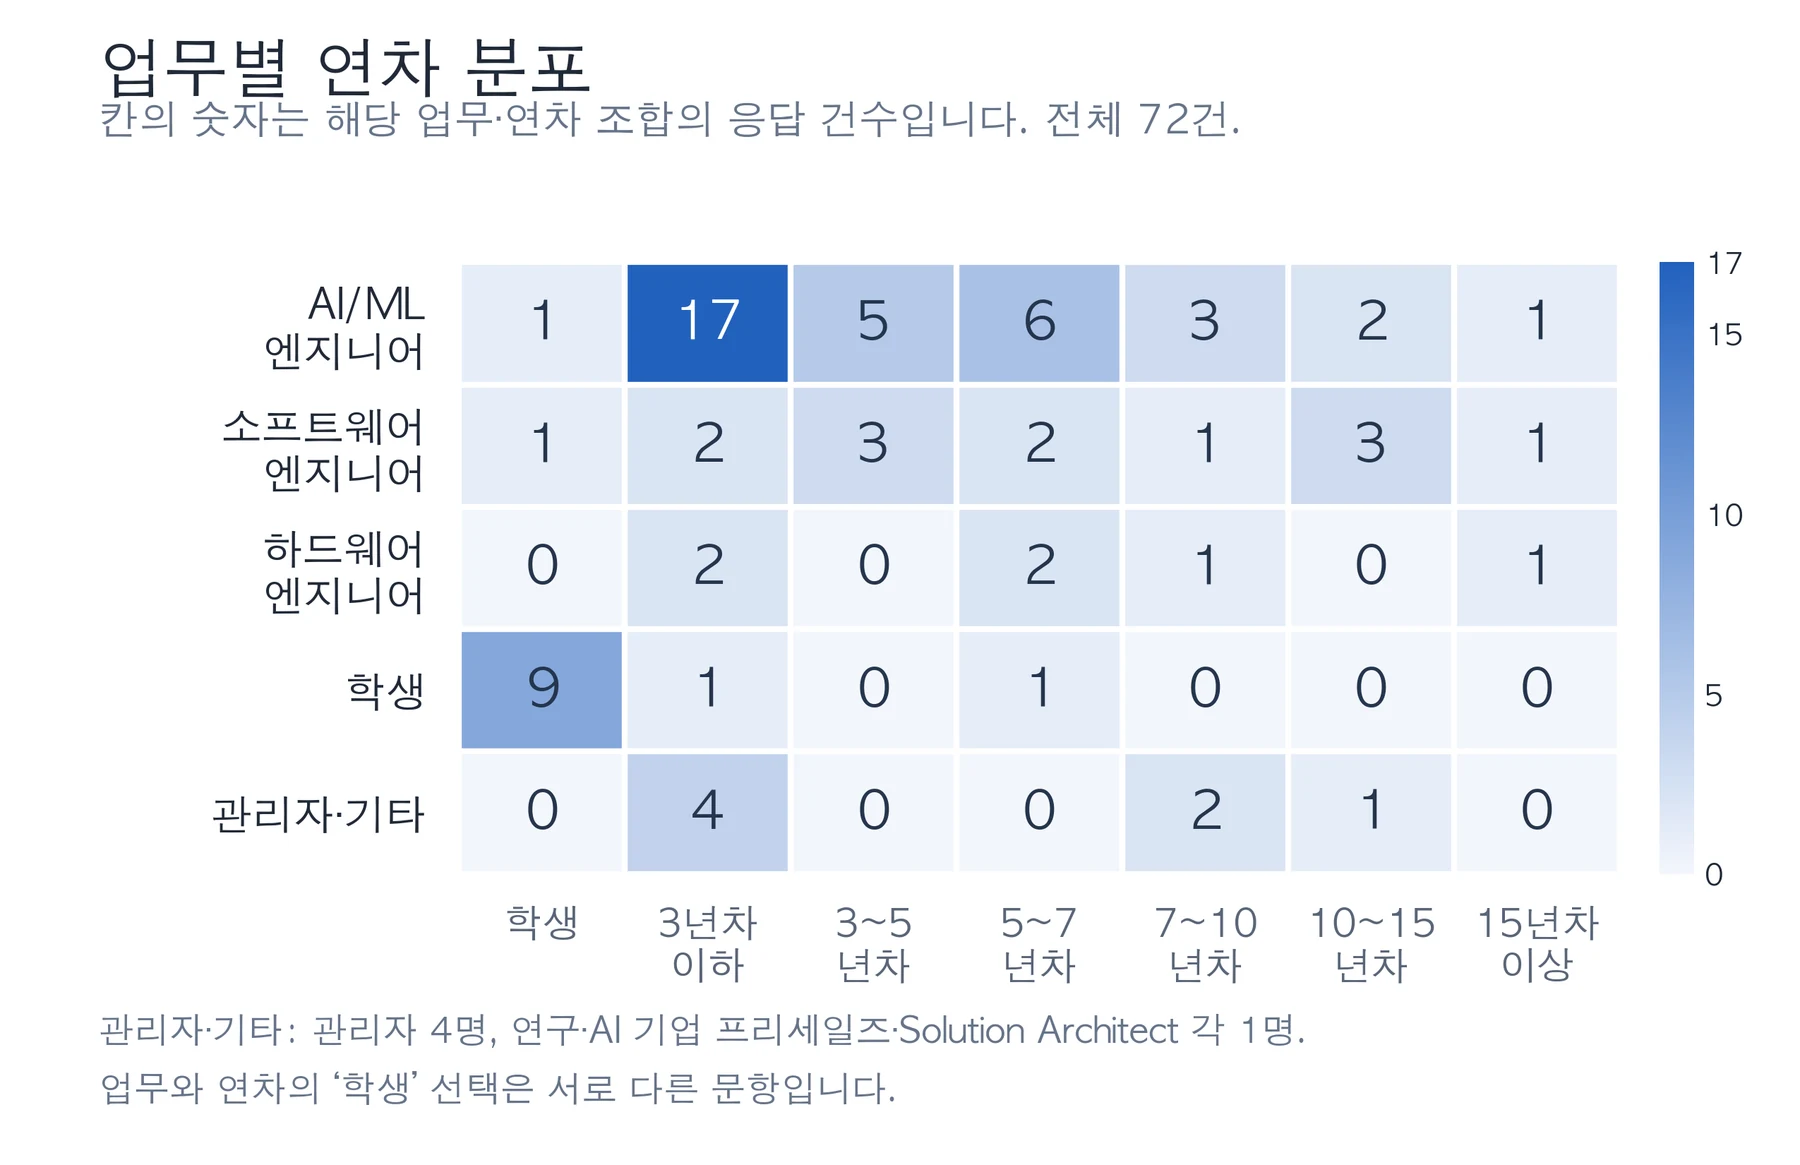
좋았던 점을 묻는 복수 선택 문항에서는 프로그램 구성이 48건(66.7%)으로 가장 많이 선택됐습니다. 행사 장소 및 시설은 30건(41.7%), 참여자 간 소통 분위기와 행사 시간 및 일정은 각각 22건(30.6%)이었습니다.
개선할 점도 함께 확인했습니다. 마이크 음질과 음량, 뒷좌석의 화면 가독성, 공간의 여유에 관한 의견이 반복해서 나왔습니다. 영어 발표의 이해를 돕는 통역·번역과 같은 분야의 개발자끼리 대화할 수 있는 시간을 바라는 의견도 있었습니다.
다음 행사에서 듣고 싶은 내용으로는 실제 프로덕션 적용 사례, vLLM과 SGLang의 내부 동작, 신경망 처리 장치(NPU, Neural Processing Unit)용 컴파일러, 최신 추론 최적화 기법, 시연과 데모가 제시됐습니다. 제품 소개에 더해 운영 중 겪은 문제와 시행착오, 해결 과정을 구체적으로 나눠달라는 요청도 있었습니다.
함께 해주셔서 감사합니다!
KVCache Meetup Korea에 함께한 참석자들과 연사들.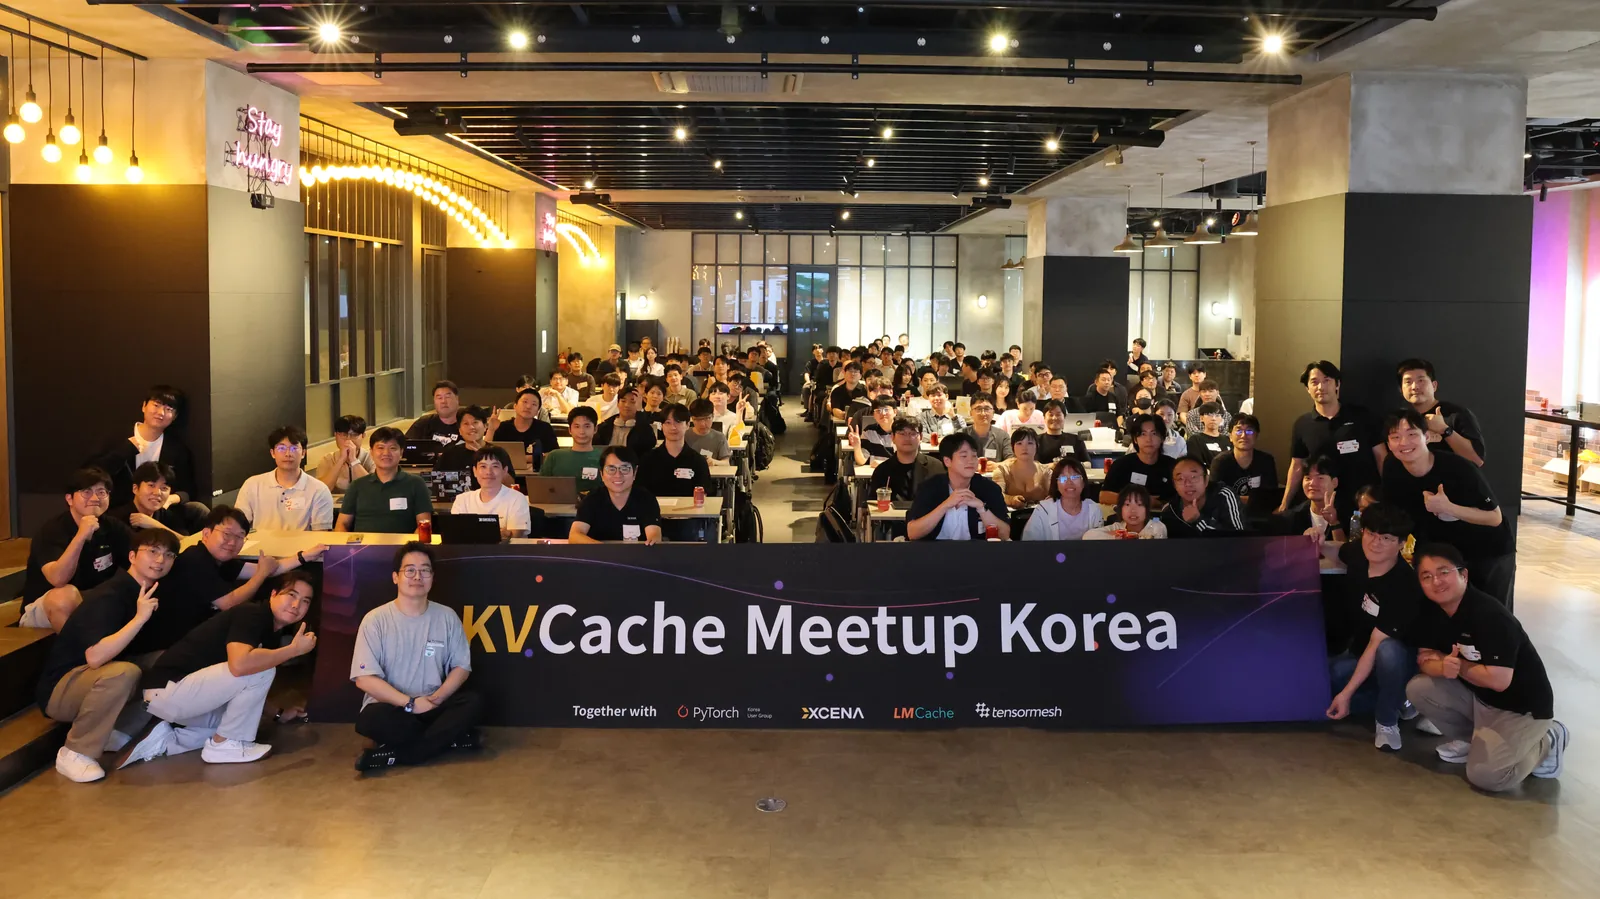
PyTorchKR은 이번 설문에서 받은 의견을 다음 행사 준비에 반영하겠습니다. 발표를 더 잘 듣고 볼 수 있는 환경과 함께, 관심 분야가 비슷한 참석자들이 쉽게 만나 대화를 시작할 수 있는 방식도 검토하겠습니다.
평일 저녁 시간을 내어 함께해 주신 참석자 여러분, 지식과 경험을 나눠주신 이주호 님, 오세진 님, 이동훈 님, Baoloong Mao 님께 감사드립니다. 행사를 함께 준비한 XCENA와 후원해 주신 Tensormesh에도 감사드립니다.
행사 영상 다시 보기
KVCache Meetup Korea의 행사 영상은 PyTorchKR YouTube에서 다시 보실 수 있습니다. 행사에 함께하지 못하신 분들도 영상을 통해 현장을 살펴보세요.
덧글 작성 및 공유를 위해 https://pytorch.kr/blog/2026/kvcache-meetup-korea-2026/에 게시된 글이 커뮤니티에도 함께 게시되었습니다.