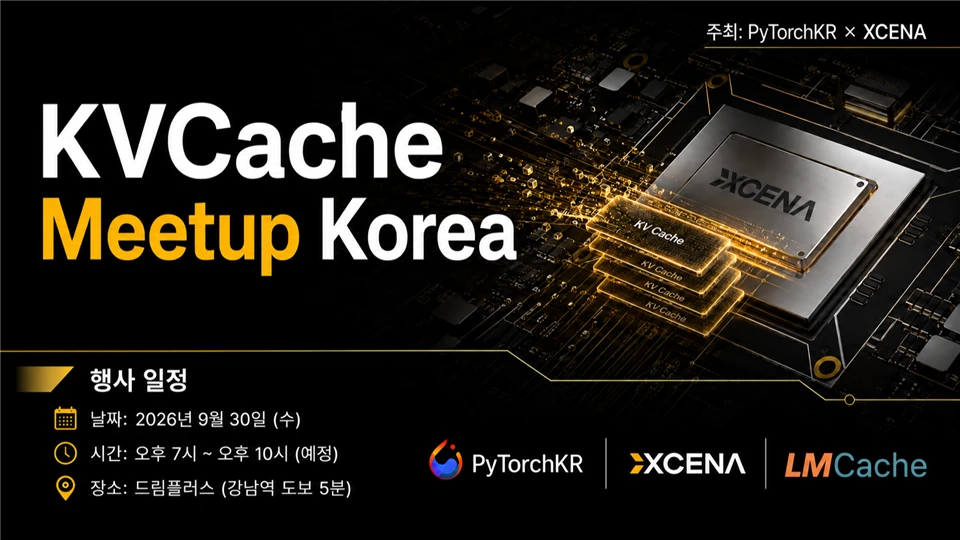
대규모 모델 추론 시 병목은 어디에서 주로 발생할까요? 대규모 모델 추론 인프라의 메모리 병목에 대해서 고민해보셨던 실무자들라면, KVCache Meetup Korea와 함께 해주세요!
이번 KVCache Meetup은 추론 비용과 지연시간을 좌우하는 병목이 연산에서 메모리로 옮겨가고 있는 이 때, 어떻게 Cache를 관리할 것인지에 대한 고민과 경험을 나누는 자리입니다. 우리 파이토치 한국 사용자 모임(PyTorchKR)과 CXL 전문 스타트업 엑시나(XCENA)가 함께 주최하는 이번 행사에 함께 해주세요!
SK Hynix, FuriosaAI, LMCache Lab에서 연사로 함께 참여하는 이번 Meetup에 대한 자세한 정보는 다음과 같습니다:
행사 개요
- 행사명: KV-Cache Meetup Korea
- 일시: 2026년 9월 30일(수) 19:00 ~ 22:00
- 장소: 강남 드림플러스 (서울특별시 서초구 강남대로 311, B1)
행사 시간표
- 18:00 ~ 19:00, 참가자 등록 및 네트워킹
- 19:00 ~ 19:25, 오프닝
- 19:25 ~ 19:55, 세션 발표, "Analyzing Utilization of GPU and HBM in LLM Serving Systems", 오세진님 (SK Hynix)
- 20:00 ~ 20:30, 세션 발표, "LLM Inference Engine for RNGD", 이동훈님 (FuriosaAI)
- 20:30 ~ 21:00, 세션 발표, "A Unified KV Cache Layer and Multi-Platform Architecture", Baolong Mao (LMCache)
- 21:00 ~ 22:00, 참가자 네트워킹
각 세션은 발표 25분과 Q&A 5분으로 구성되며, 현장 상황에 따라 세부 일정은 변경될 수 있습니다.
참가 신청
- 신청 마감: 2026년 9월 20일(일) 오후 11시 59분
- 선정 안내: 2026년 9월 23일(수) 중
- 신청 링크: KVCache Meetup Korea - 이벤터스
다양한 조직과 환경에서의 경험과 고민을 공유할 수 있도록 가능한 다양한 신청자들을 모시고자 하오니 양해 부탁드립니다.
기타 안내
- 본 행사는 별도의 주차 지원은 제공되지 않습니다. 가급적 대중교통 이용을 부탁드립니다.
- 본 행사는 소규모 커뮤니티 행사로 운영되며, 신청 인원에 따라 조기 마감될 수 있습니다.
- 행사 관련 안내는 신청 시 작성해주신 이메일을 통해 전달될 예정입니다.
- 행사 문의: kvcache@pytorch.kr