탐지·분할·깊이 추정을 하나의 모델로? SenseNova-Vision 소개
좌표는 텍스트로, 마스크와 깊이는 이미지로. 컴퓨터 비전의 다양한 출력을 하나의 생성 인터페이스로 다루는 접근입니다.
이미지에서 사람의 위치를 찾고, 사람 영역만 분리하고, 장면의 깊이를 추정한다고 생각해 보겠습니다. 모두 같은 사진을 보지만 필요한 답은 서로 다릅니다. 위치에는 좌표가, 영역에는 마스크가, 깊이에는 픽셀별 값이 필요합니다.
SenseNova-Vision은 이렇게 다른 형태의 답을 텍스트·이미지·혼합 출력으로 생성하도록 학습한 통합 비전 모델입니다. 2026년 7월 공개된 기술 보고서 Vision as Unified Multimodal Generation에서 제안했습니다. 논문
이 글은 공식 자료와 2026년 9월 17일 공개 Hugging Face GPU 데모에서 확인한 깊이 추정 실행 결과를 바탕으로 정리했습니다. 벤치마크 성능 수치는 저자 보고 결과이며, 아래 도식과 성능 차트는 설명을 위해 제작한 자료입니다.
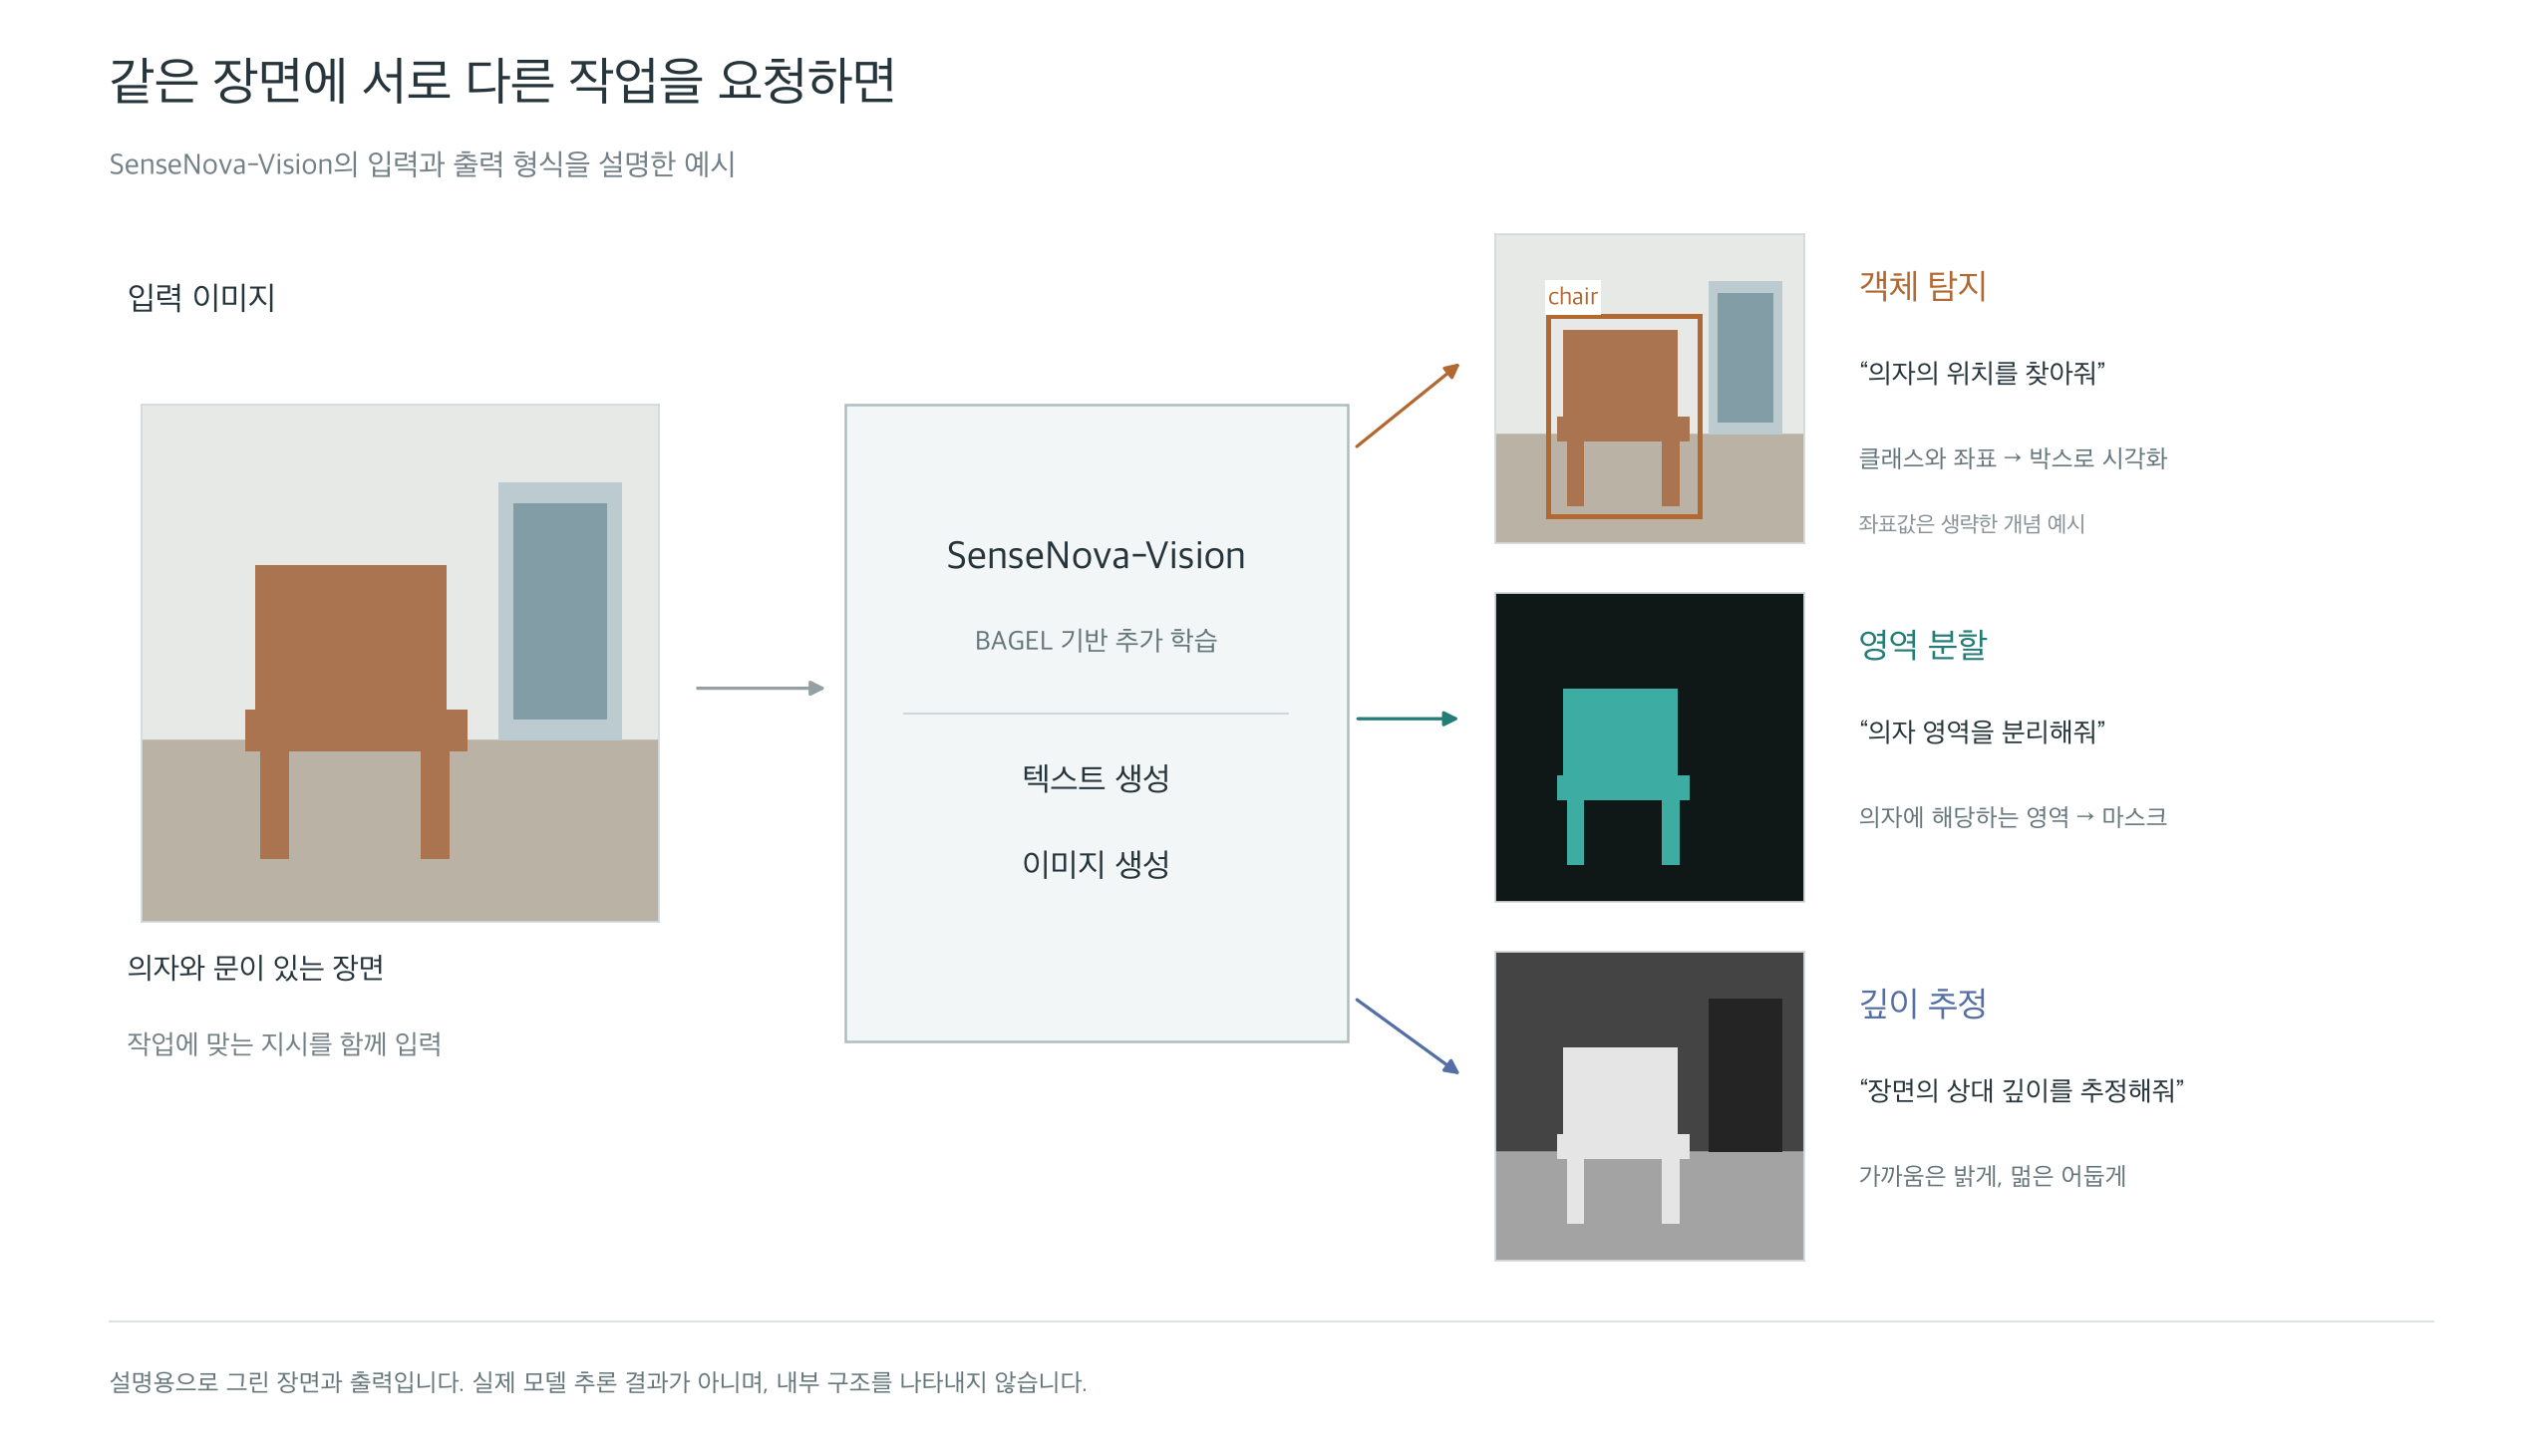
그림 1. 같은 장면에 서로 다른 작업을 요청했을 때의 출력 형식을 설명한 예시입니다. 장면과 출력은 직접 그린 개념 예시로, 실제 추론 결과나 세부 네트워크 구조가 아닙니다.
1. 무엇을 할 수 있나요?
모델 카드가 제시하는 작업을 출력 형태에 따라 나누면 이해하기 쉽습니다.
| 출력 형태 | 대표 작업 | 결과를 읽는 방식 |
|---|---|---|
| 텍스트 | 객체 탐지, OCR, 키포인트, 카메라 파라미터 | 클래스·문자열·좌표 등의 구조화된 기록 |
| 이미지 | 깊이, 표면 법선, 분할 마스크, 포인트 맵 | 공간에 정렬된 지도 형태의 출력 |
| 텍스트+이미지 | 여러 객체의 분할, 설명과 영역을 함께 제공하는 작업 | 라벨·설명과 마스크의 대응 관계 |
여기서 깊이 지도는 각 위치의 깊이를, 표면 법선 지도는 표면이 향하는 방향을 나타냅니다. 포인트 맵은 픽셀과 3차원 위치의 대응을 표현합니다. 따라서 ‘이미지 생성’은 보기 좋은 사진을 만드는 것뿐 아니라, 분석에 사용할 공간 정보를 이미지 형태로 출력하는 것까지 포함합니다. 공식 모델 카드
실제 출력의 모습은 공식 저장소의 Showcase에서 탐지·분할·기하 예제를 비교해 볼 수 있습니다. 이 결과들은 저자가 공개한 예시이며, 여기서 별도로 실행한 결과는 아닙니다.
2. 핵심은 ‘답의 형태’를 통합하는 것입니다
독자의 관점에서 이 연구를 이해하는 질문은 간단합니다.
“작업마다 전용 출력 모듈을 추가하는 대신, 이미 텍스트와 이미지를 생성하는 모델에 다양한 비전 정답을 학습시킬 수 있을까?”
SenseNova-Vision은 BAGEL-7B-MoT에서 출발해 추가 학습합니다. 텍스트 정답에는 다음 토큰 예측의 cross-entropy를, 시각 정답에는 VAE 잠재 공간에서의 rectified-flow 학습을 사용합니다. VAE는 이미지를 압축된 표현으로 바꾸는 구성 요소이며, 여기서는 그 공간에서 이미지 출력을 학습합니다. 논문 §4
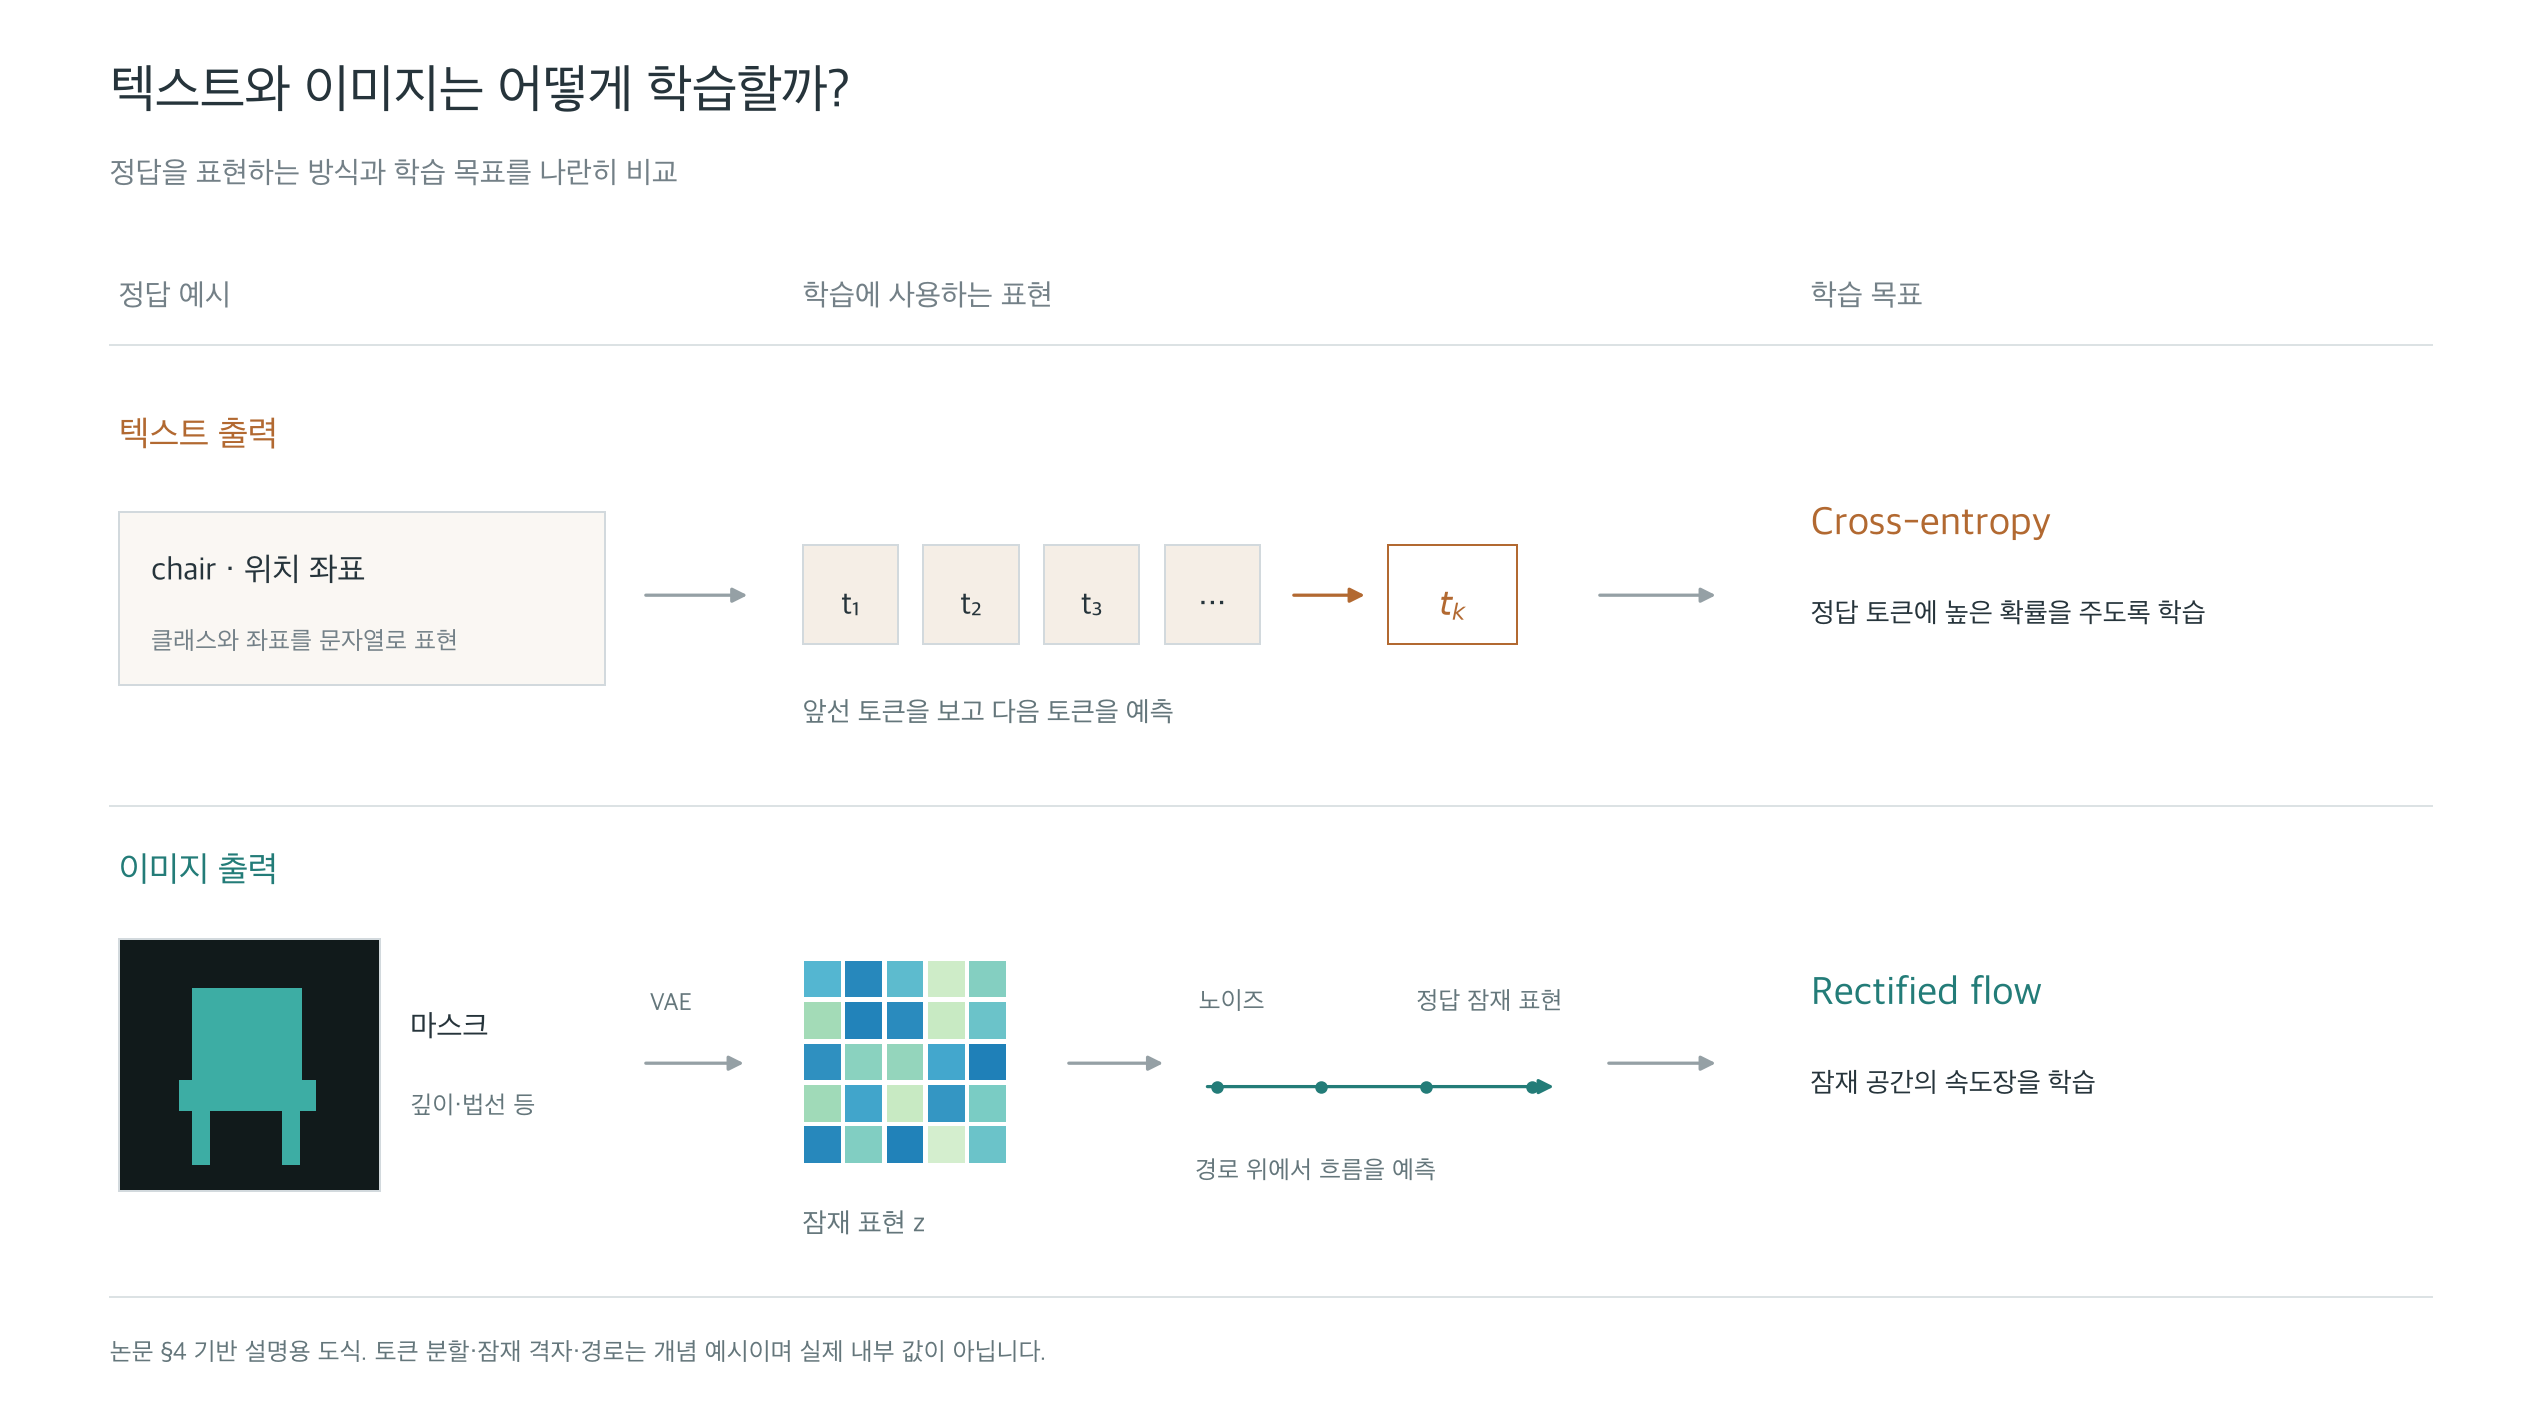
그림 2. 논문에서 설명하는 두 출력 경로의 학습 방식을 비교했습니다. 토큰·잠재 격자·경로는 설명용으로 그렸으며 실제 내부 값이 아닙니다. 텍스트와 이미지가 하나의 모델에서 다뤄져도 학습 목표까지 하나로 같아지는 것은 아닙니다.
‘작업별 head가 없다’는 표현에서 head는 특정 작업의 예측을 위한 출력 모듈을 뜻합니다. 이 연구는 기존 생성 경로를 활용하며, 탐지·분할·깊이용 예측 head를 각각 추가하지 않습니다. 그렇다고 출력 변환 규칙까지 없어지는 것은 아닙니다.
실제 추론 코드에는 작업에 따라 프롬프트를 만들고 실행 모드를 선택하는 경로가 있습니다. binary_seg는 분할 프롬프트로, bbox_detection은 탐지 프롬프트로 연결됩니다. 모델 수준의 통합과 프로그램 수준의 작업 처리는 구분해서 봐야 합니다. 공식 추론 코드
예를 들어 좌표가 텍스트로 나와도 사용하려면 좌표계를 해석해야 합니다. 색으로 표현된 마스크도 어떤 색이 어떤 객체를 뜻하는지 알아야 합니다. 이 부분은 모델 출력과 실제 응용을 연결하는 인터페이스 설계 문제로 볼 수 있습니다.
3. 데이터도 같은 인터페이스로 바꿔야 합니다
모델 구조만큼 흥미로운 부분은 SenseNova-Vision-Corpus-50M입니다. 데이터 카드에 따르면 73개의 데이터셋–작업 항목을 10가지 작업 유형으로 구성합니다. 공개된 프레임 수는 구조화된 시각 이해 18.9M, 분할 1.3M, 밀집 기하 예측 17.3M, 다중 시점 기하 12.5M입니다. 이는 카드의 작업군별 프레임 집계이며, 중복 없는 원본 사진 5천만 장이라는 뜻으로 확대해서 읽으면 안 됩니다. 공식 데이터 카드
학습 데이터는 다양한 주석을 ‘시각 입력 + 지시문 + 정답’ 형태로 정리합니다. 같은 출력 공간에 넣더라도 좌표·색상·마스크와 설명이 서로 일치해야 하므로, 변환 과정의 일관성이 중요합니다.
재학습을 생각한다면 데이터 준비 방식도 확인해야 합니다. 공식 가이드는 공개 코퍼스의 주석·파생 자산과 원본 데이터셋 이미지를 함께 준비하도록 안내합니다. 코퍼스만 내려받으면 모든 원본 이미지가 자동으로 갖춰지는 구조는 아닙니다. 학습 데이터 준비 문서
제가 이 부분에서 주목한 것은 기존 비전 주석을 생성 모델이 배울 수 있는 형식으로 바꾸는 작업 자체가 통합 모델의 중요한 구성 요소라는 점입니다. 새로운 작업을 추가할 때 출력의 표현과 해석 규칙도 함께 설계해야 한다는 관점으로 읽었습니다.
4. 성능은 어디까지 좋을까요?
지원하는 작업이 많다는 것과 각 작업에서 가장 높은 점수를 낸다는 것은 다릅니다. 아래는 공식 공개 결과 중 분할 관련 네 항목을 X-SAM과 나란히 놓은 것입니다. 두 모델의 전체 성능을 대표하는 종합 순위는 아닙니다.
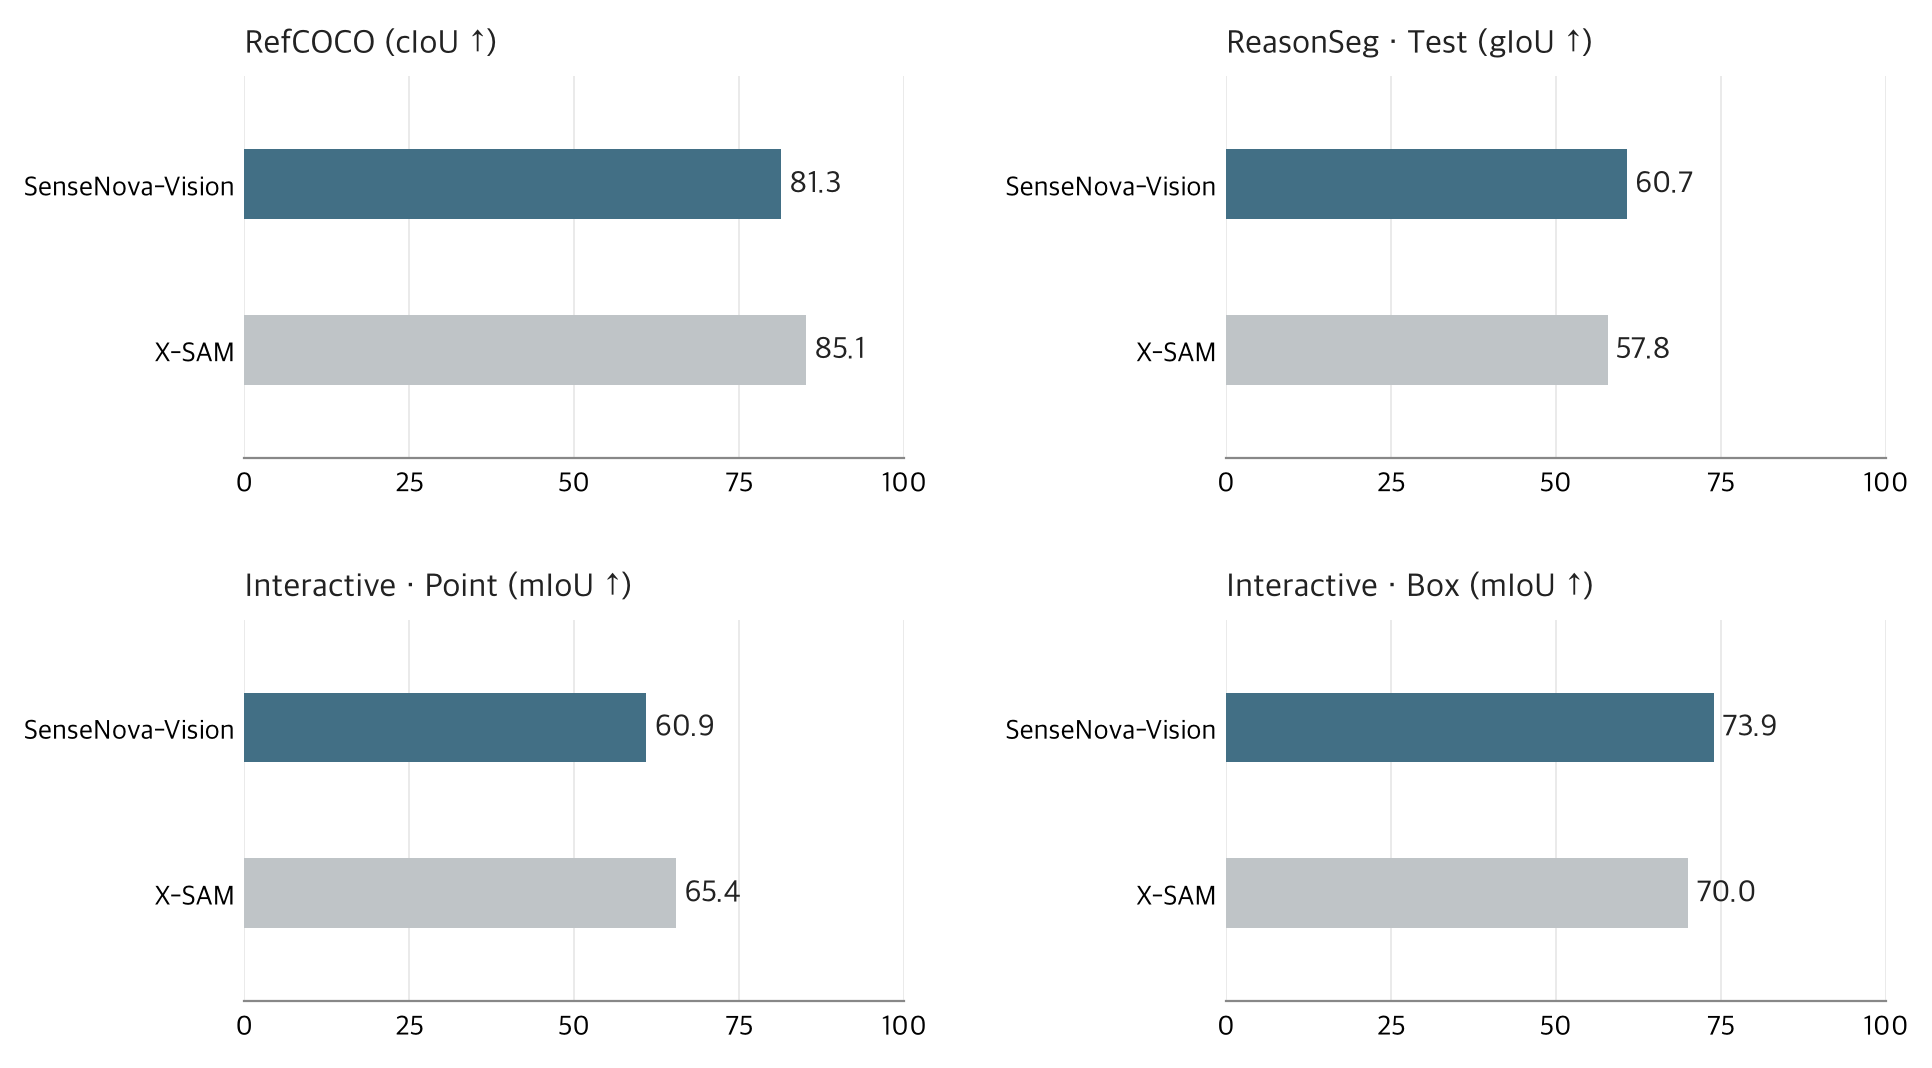
그림 3. 논문 Table 3 및 공식 저장소의 수치를 재시각화했습니다. 직접 재현한 결과가 아니며, 모든 항목은 높을수록 좋습니다. 작업별로 지표가 달라 패널 간 점수를 합산하지 않습니다.
| 평가 항목 | 지표 | SenseNova-Vision | X-SAM |
|---|---|---|---|
| RefCOCO | cIoU ↑ | 81.3 | 85.1 |
| ReasonSeg Test | gIoU ↑ | 60.7 | 57.8 |
| Interactive: Point | mIoU ↑ | 60.9 | 65.4 |
| Interactive: Box | mIoU ↑ | 73.9 | 70.0 |
RefCOCO는 표현으로 지정한 대상을 분할하는 평가이고, 인터랙티브 분할은 점이나 박스 같은 입력을 활용합니다. IoU 계열 지표는 예측 영역과 정답 영역의 겹침을 측정하지만 집계 방식이 다릅니다. 이 논문의 gIoU는 ReasonSeg 평가 표기를 따르며, 객체 탐지에서 말하는 Generalized IoU와 혼동하지 않는 것이 좋습니다. 논문 Table 3 · 공식 결과표
이 네 항목만 보아도 성능의 방향이 엇갈립니다. 따라서 저는 이 모델을 **‘모든 전문 모델을 대체했다’보다 ‘여러 출력 형태를 하나의 모델로 다루는 접근을 보여준다’**는 관점에서 소개하는 편이 적절하다고 생각합니다.
비교표의 각주도 읽어야 합니다
논문의 Vision Banana 비교에는 주의할 조건이 있습니다. 일부 깊이 점수는 absolute-depth와 affine-invariant 평가가 섞여 있고, ReasonSeg에는 Gemini 보조 결과가 표시되어 있습니다. 저자도 해당 항목을 참고 비교로 구분합니다. 같은 열에 숫자가 있다고 모두 동일 조건의 우열 비교인 것은 아닙니다. 논문 Table 5 각주
5. 직접 사용하려면: 공식 실행 경로
아래는 공식 문서에 근거한 로컬 실행 예시이며, 이 명령으로 가중치를 설치하고 실행하는 과정은 검증하지 않았습니다. 공개 GPU 데모 실행과는 구분해 주세요. 가중치 다운로드와 호환되는 GPU 환경이 필요합니다.
환경과 가중치 준비
공식 저장소를 내려받은 뒤 저장소 루트에서 환경을 만듭니다. 공식 저장소
git clone https://github.com/OpenSenseNova/SenseNova-Vision.git
cd SenseNova-Vision
bash setup.sh sensenova-vision
conda activate sensenova-vision
가중치를 로컬 디렉터리에 받는 예시입니다. 모델 카드
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="sensenova/SenseNova-Vision-7B-MoT",
    local_dir="./checkpoints/SenseNova-Vision-7B-MoT",
)
분할 요청 한 번 실행하기
export MODEL_PATH="$PWD/checkpoints/SenseNova-Vision-7B-MoT"
bash scripts/run_sensenova_vision.sh inference binary_seg "person" examples/images/2.jpg
binary_seg는 작업, person은 대상, 마지막 인자는 입력 이미지입니다. 공식 wrapper는 작업에 맞는 프롬프트와 실행 경로를 선택합니다. 결과는 기본적으로 examples/output/demo/<task>/에 저장되며, raw 출력과 시각화 파일을 구분해 볼 수 있습니다. 공식 추론 가이드
공식 문서의 기준 환경은 PyTorch 2.5.1+cu124, CUDA 12.4, flash-attn 2.6.3입니다. BF16 웹 데모는 A800 80GB 한 장에서 검증했으며, 기록된 요청의 프로세스 GPU 메모리 최대치는 38,226MiB입니다. 이는 모든 작업의 최소 요구 메모리가 아닙니다. 문서는 80GB GPU를 권장하며 더 작은 메모리에서 전체 작업을 검증하지 않았다고 밝힙니다. 환경·웹 데모 안내
전체 벤치마크는 데이터 준비와 추론 후 평가 과정이 추가됩니다. 공식 가이드는 전체 실행에 8×80GB GPU 머신 한 대 이상을 권장합니다. 단일 이미지 데모와 전체 평가의 자원 규모를 구분해야 합니다. 벤치마크 가이드
공개 GPU 데모에서 깊이 추정을 실행해 보니
2026년 9월 17일 hugging-apps의 SenseNova-Vision 공개 데모에서 실내 사무실 예제와 Depth Estimation을 선택했습니다. 예제 선택 후 결과가 표시되는 것을 확인하고, Run 버튼으로 다시 요청해 출력 이미지가 표시되는 것까지 확인했습니다. 실행 조작과 화면 확인에는 AI 도구를 사용했습니다.
프롬프트는 가까운 물체를 밝게, 먼 물체를 어둡게 표현하는 상대 깊이의 흑백 이미지를 요청했습니다. 결과에서는 앞쪽 서류함과 가구가 밝고, 문 너머 공간이 어둡게 나타났습니다. 입력의 공간 배치에 대응하는 깊이 맵을 시각적으로 확인할 수 있었습니다.
다만 이것은 데모 제공 예제 한 장에 대한 정성적 확인입니다. 정답 깊이와 비교하지 않았으므로 정확도나 일반화 성능을 입증하지 않습니다. 실제 거리(m)를 읽을 수도 없습니다. 서버의 정확한 GPU 사양, 모델 리비전, 내부 추론 설정을 기록하지 못했으므로 재현 가능한 로컬 벤치마크로 취급하지 않습니다. 공개 데모의 처리 시간에는 대기와 전송이 포함될 수 있어 추론 속도 수치도 제시하지 않습니다.
로컬 장비는 Apple M5 Pro와 통합 메모리 48GiB였고 PyTorch의 MPS 사용 가능 여부는 확인했습니다. 다만 공식 wrapper의 자동 장치 선택은 CUDA 또는 CPU로 향하며, 이를 Apple GPU에서 실행하려면 장치 배치와 연산 호환성을 추가로 점검해야 합니다. 이번 실행은 Mac에 모델을 설치한 결과가 아니라 공개 GPU 서비스에 요청한 결과입니다.
6. 사용 전에 알아둘 한계
모델 카드는 프롬프트와 출력 형식에 따른 민감도, 작업별 파싱 필요성, 기하 예측의 정확도 한계를 명시합니다. 따라서 출력 지도가 그럴듯하다는 것과 후속 계산에 필요한 정확도를 충족한다는 것은 따로 확인해야 합니다. 모델 카드의 한계 설명
또한 코드는 Apache-2.0, 모델 가중치는 CC BY-NC 4.0으로 공개되어 있습니다. 코드의 라이선스만 보고 가중치도 같은 조건이라고 판단하면 안 됩니다. 코드 라이선스 · 가중치 라이선스 안내
제 관점에서 실제 활용을 검토할 때는 다음 세 질문이 중요합니다.
- 정말 여러 작업이 필요한가? 한 작업의 지연 시간과 정확도가 핵심이라면 전문 모델과 함께 비교해야 합니다.
- 출력을 안정적으로 읽을 수 있는가? 좌표·마스크·라벨의 형식 오류가 후속 시스템에 미치는 영향을 봐야 합니다.
- 우리 입력에서도 일관적인가? 표현을 조금 바꾸거나 객체가 작고 가려진 장면에서도 결과가 유지되는지 확인해야 합니다.
이는 이 글에서 검증한 성능 주장이 아니라, 후속 실험을 설계할 때 확인하고 싶은 항목입니다.
마치며
SenseNova-Vision에서 흥미로운 점은 CV의 여러 작업을 ‘무엇을 생성해야 하는가’라는 질문으로 연결한다는 것입니다. 좌표와 문자열은 텍스트로, 공간에 정렬된 값은 이미지로, 두 종류가 함께 필요한 작업은 혼합 출력으로 다룹니다.
이런 접근을 이해할 때는 구조의 단순화뿐 아니라 데이터 변환, 출력 해석, 작업별 성능과 실행 비용을 함께 봐야 합니다. 저는 ‘하나의 모델이 얼마나 많은 것을 할 수 있는가’에 더해, ‘그 결과를 얼마나 안정적으로 사용할 수 있는가’도 다음 관심사라고 생각합니다.