핵심 요약
- ToyBlocks는 블록 조작 시연을 자동으로 생성하고 모델 학습과 평가를 연결하는 공개 로봇 실험 프레임워크입니다.
- 계획 모델과 동작 모델을 각각 평가할 수 있어, 로봇 학습 실험에서 실패 원인을 구분하는 데 활용할 수 있습니다.
- 공개 데이터셋은 세 블록 쌓기의 성공 시연으로 구성되며, 발표문과 데이터 카드의 규모 집계가 다릅니다.
- 실행에는 Linux와 NVIDIA GPU가 필요하며, 실제 로봇의 전체 과제 실험은 Easy 조건에서 30회 중 15회 성공했습니다.
ToyBlocks 소개
로봇이 블록 탑을 완성하지 못했을 때는 여러 원인을 생각할 수 있습니다. 목표를 잘못 이해했거나, 필요한 글자가 있는 블록을 찾지 못했거나, 올바른 블록을 골랐어도 집는 동작에 실패했을 수 있습니다. 성공률 하나만으로는 이 차이를 구분하기 어렵습니다. ToyBlocks는 데이터와 시작 장면을 통제하고 계획과 동작을 따로 평가할 수 있도록 설계했습니다.
Ai2(Allen Institute for AI)는 특정 영역의 시뮬레이션, 과제와 시연 생성 도구, 행동 측정 지표를 묶은 연구 환경을 FoundationWorlds라고 부르며, ToyBlocks를 첫 사례로 소개했습니다. 2026년 11월 6일 발표 블로그와 공식 사용자 가이드를 함께 보면, 블록 조작 모델뿐 아니라 데이터 생성부터 실패 분석까지 연결하는 도구를 공개했다는 점을 알 수 있습니다.
블록의 위치와 방향을 통제하는 실험 환경
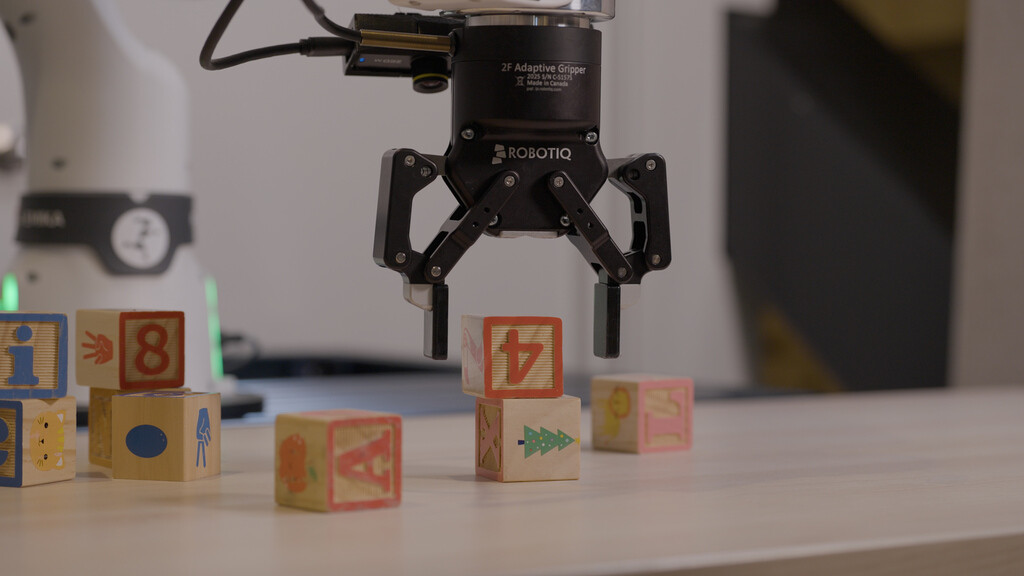
ToyBlocks는 글자나 그림이 표시된 블록과 단색 블록을 함께 사용합니다. 특정 단어를 만들려면 블록을 쌓는 순서와 글자의 방향을 맞춰야 하며, 필요한 면이 보이지 않으면 먼저 뒤집거나 돌려서 확인해야 합니다. 단순한 물체를 사용해도 시각 정보 해석, 탐색, 여러 단계의 계획과 정밀한 동작을 함께 평가할 수 있는 이유입니다.
FoundationWorlds의 설계 요건은 현실적인 물리와 외관, 대규모 과제 및 시연 자동 생성, 판단과 조작이 함께 필요한 과제, 선택한 영역 안에서의 폭넓은 과제 구성입니다. ToyBlocks는 물체와 로봇의 범위를 좁혀 이 조건들을 연구할 수 있게 합니다. 다양한 가정 환경이나 모든 종류의 로봇 작업을 대표하는 벤치마크로 소개된 것은 아닙니다.
공식 데이터 생성 설명에서는 블록 크기, 탁자 높이 등 환경 조건과 시각적 외관을 바꾸는 도메인 무작위화(Domain Randomization) 를 설명합니다. 물리 실행과 영상 렌더링을 분리하기 때문에, 같은 동작을 여러 조명과 배경으로 다시 렌더링할 수 있습니다. 동작 경험을 유지하면서 영상 조건을 바꾸는 실험이 가능합니다.
목표를 입력하면 계획과 시연 데이터를 자동으로 생성
목표 상태와 실제 동작 계획의 연결
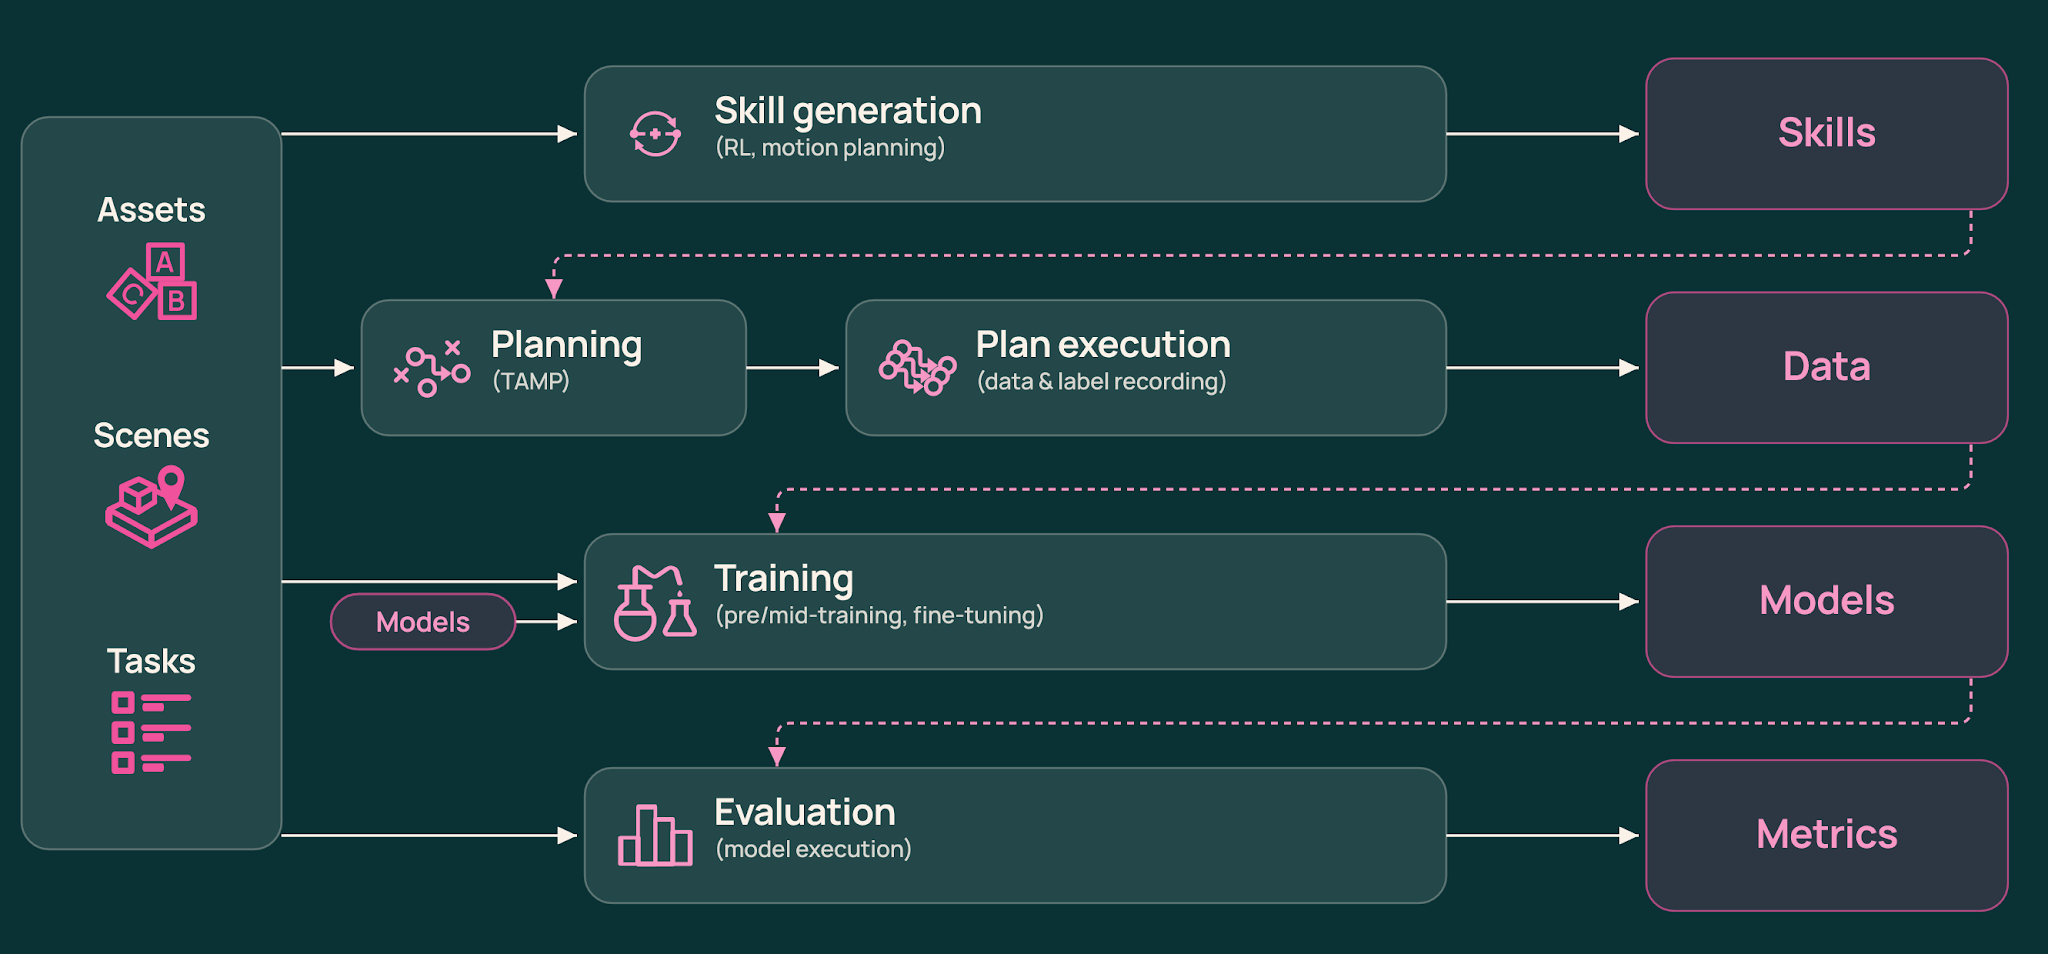
과제는 PDDL(Planning Domain Definition Language)로 표현합니다. 예를 들어 특정 블록이 다른 블록 위에 있고, 원하는 면이 정해진 방향을 향한다는 목표를 지정합니다. 과제 및 동작 계획(Task and Motion Planning, TAMP) 은 목표를 달성할 동작 순서와 로봇 팔의 이동 경로를 함께 구합니다.
상위 계획에서는 무엇을 먼저 치우고, 뒤집고, 쌓을지 결정합니다. 하위 동작에서는 실제 장면을 기준으로 이동 공간을 확인하고 cuRobo로 경로를 계산합니다. 뒤집을 블록 옆에 다른 블록이 있으면 먼저 공간을 확보하는 단계가 추가될 수 있습니다. 실행이 끝난 뒤에는 시뮬레이터 상태로 각 단계의 결과와 최종 목표를 확인합니다.
블로그에서는 Isaac Lab 기반의 강화학습(Reinforcement Learning, RL) 과 동작 계획을 이용한 스킬 생성도 설명합니다. 여기서 스킬은 집기, 뒤집기, 회전처럼 비교적 짧은 동작입니다. 생성기는 물체의 정확한 위치와 방향처럼 시뮬레이터가 제공하는 정보를 활용할 수 있습니다. 반면 학습된 시각 기반 정책은 관측 영상에서 필요한 정보를 파악해야 합니다.
물리 실행 이후 렌더링과 주석 추가
자동 데이터 생성 가이드는 과제 생성, 환경 생성, 실행, 렌더링, 병합, 주석 추가의 여섯 단계로 나뉩니다. 실행 단계에서 상태와 동작을 기록한 뒤, 렌더링 단계에서 카메라 영상과 외관 변형을 만듭니다. 병합과 주석 추가가 끝나면 LeRobot 형식의 학습 데이터를 얻습니다.
목표와 실행 계획을 이미 알고 있으므로 프레임별 동작 종류, 대상 블록, 영상 안의 목표 좌표 등을 자동으로 기록할 수 있습니다. 사람이 원격 조작해 시연하거나 프레임별로 주석을 달 필요가 없습니다. 이 정보는 팔을 제어하는 모델과 다음 스킬을 고르는 모델을 학습하는 데 쓰입니다. 기록 필드 문서에서 관측값과 동작의 구체적인 구성을 확인할 수 있습니다.
공식 설명의 데이터 생성 속도는 단일 GPU에서 최대 실시간의 24배입니다. 이는 여러 환경의 계획과 동작을 병렬 실행하는 결과이며, 영상 렌더링이나 전체 학습 과정의 속도를 뜻하지 않습니다. 다음 영상은 자동 생성 과정의 예시입니다.
공개 데이터셋의 구성과 통계 차이
allenai/toyblocks-data 데이터셋 카드는 Franka FR3와 Robotiq 2F-85 그리퍼가 세 블록을 쌓는 성공 시연을 제공합니다. 각 장면에는 블록 4~10개가 있으며, 데이터는 초당 25프레임의 LeRobot v3 형식입니다. 정면 카메라와 손목 카메라의 RGB 및 깊이 영상, 관절 상태, 동작, 목표와 기호 상태를 포함합니다.
| 데이터셋 카드의 상세 집계 | 에피소드 수 | 프레임 수 | 실행 시간 |
|---|---|---|---|
| 학습용 합계 | 77,496 | 133,600,574 | 1,484.5시간 |
| 검증용으로 집계한 6개 세트 합계 | 6,000 | 10,075,851 | 112.0시간 |
| 전체 합계 | 83,496 | 143,676,425 | 1,596.4시간 |
발표 블로그와 홈페이지는 첫 공개 규모를 시연 85,336개로 소개하지만, 데이터셋 카드의 상세 표 합계는 83,496개입니다. 계획 길이도 블로그는 세트에 따라 약 6~12개 스킬로 설명하고, 카드의 상세 통계는 중앙값 5개, 범위 1~18개로 제시합니다. 자료마다 집계가 달라 출처와 함께 확인해야 합니다.
카드의 상세 집계에는 서로 다른 목표 문제 3,600개가 있으며, 학습용 3,000개와 검증용 600개로 나뉩니다. 홈페이지는 학습 문제를 약 3만 개로 안내하므로 이 수도 카드의 집계와 다릅니다. 위 표의 검증용 6,000개는 Val과 Test 폴더를 모두 포함한 카드의 집계입니다.
난이도는 글자가 바로 읽히는 시작 상태, 뒤집기가 필요한 상태, 임의의 방향으로 놓인 상태로 나뉩니다. 블록 종류도 학습에 사용한 그룹과 제외한 그룹으로 나누므로, 처음 보는 물체에 대한 성능과 방향을 바꾸는 동작의 어려움을 구분해 볼 수 있습니다.
데이터는 성공한 에피소드만 남기고 실패한 재시도 구간을 제거했습니다. 카드에서는 이 필터링 때문에 어려운 시작 상태가 적게 남는 생존자 편향(Survivorship Bias) 을 설명합니다. 시뮬레이션에서 생성한 모든 시도와 공개 파일에 남은 성공 시연을 구분해야 하며, 공개 데이터가 실패 후 복구 동작까지 포함한다고 가정해서는 안 됩니다.
두 모델을 조합하고 한쪽을 기준 모델로 바꾸는 평가
Molmo2-4B-tb는 카메라 영상과 목표를 보고 다음 스킬과 대상 좌표를 고르는 시각 언어 모델(Vision-Language Model, VLM) 입니다. ManiFlow-tb는 그 명령과 목표 위치를 받아 팔을 움직이는 하위 정책입니다. ManiFlow는 스킬 완료를 알리는 출력도 학습하므로, 완료 시점에 상위 모델에 다음 명령을 요청하는 구성을 지원합니다.
학습 및 평가 설명은 이 두 단계 중 하나를 오라클(Oracle) 로 바꿀 수 있게 합니다. 여기서 오라클은 계획기나 동작 계획 기반 스킬처럼 비교 기준으로 사용하는 구성요소입니다. 상위 모델만 남기거나 하위 모델만 남겨, 실패가 어느 단계와 관련 있는지 조사합니다.
| 평가 방식 | 상위 단계 | 하위 단계 | 확인할 내용 |
|---|---|---|---|
| 전체 시스템 | Molmo 2 | ManiFlow | 계획과 동작을 합친 성능 |
| 비동기 상위 호출 | 시작 시점과 스킬 완료 후 호출하는 Molmo 2 | 완료 신호를 출력하는 ManiFlow | 상위 호출 횟수를 줄인 구성의 성능 |
| 상위 오라클 | 기호 계획기 | ManiFlow | 올바른 명령이 주어질 때의 동작 성능 |
| 하위 오라클 | Molmo 2 | 동작 계획 기반 스킬 | 하위 실행의 오차를 줄였을 때의 계획 성능 |
| 기록 동작 재생 | 없음 | 데이터셋에 기록된 동작 | 데이터와 시뮬레이션 설정의 일치 여부 |
실패한 평가 장면에서 새 전문가 시연을 만드는 TAMPER(TAMP Expert Relabeling) 절차도 제공합니다. 실패 상태를 저장하고, 그 상태에서 목표까지 새 계획을 만든 뒤 학습 데이터에 추가하는 방식입니다. 공개 데이터셋이 성공 시연으로 구성된다는 사실과, 프레임워크가 실패 상태를 활용하는 기능을 제공한다는 사실은 구분됩니다.
공간 일반화와 여러 단계 계획에서 나타난 차이
작업 공간과 블록 높이의 변화
실험 과제는 쌓기(Stack), 쌓인 블록 해체(Unstack), 뒤집기(Flip), 회전(Rotate)의 네 가지입니다.
시각 언어 행동 모델(Vision-Language-Action Model, VLA) 은 시각 관측과 언어 지시를 로봇 동작에 연결합니다. ToyBlocks의 공간 일반화 실험은 학습한 영역 안의 새 배치와 학습 영역 밖의 배치를 구분합니다. 탁자 왼쪽에서 학습하고 오른쪽에서 평가하거나, 높이 2개와 5개인 탑으로 학습한 뒤 3개와 4개 높이에서 평가하는 방식입니다.
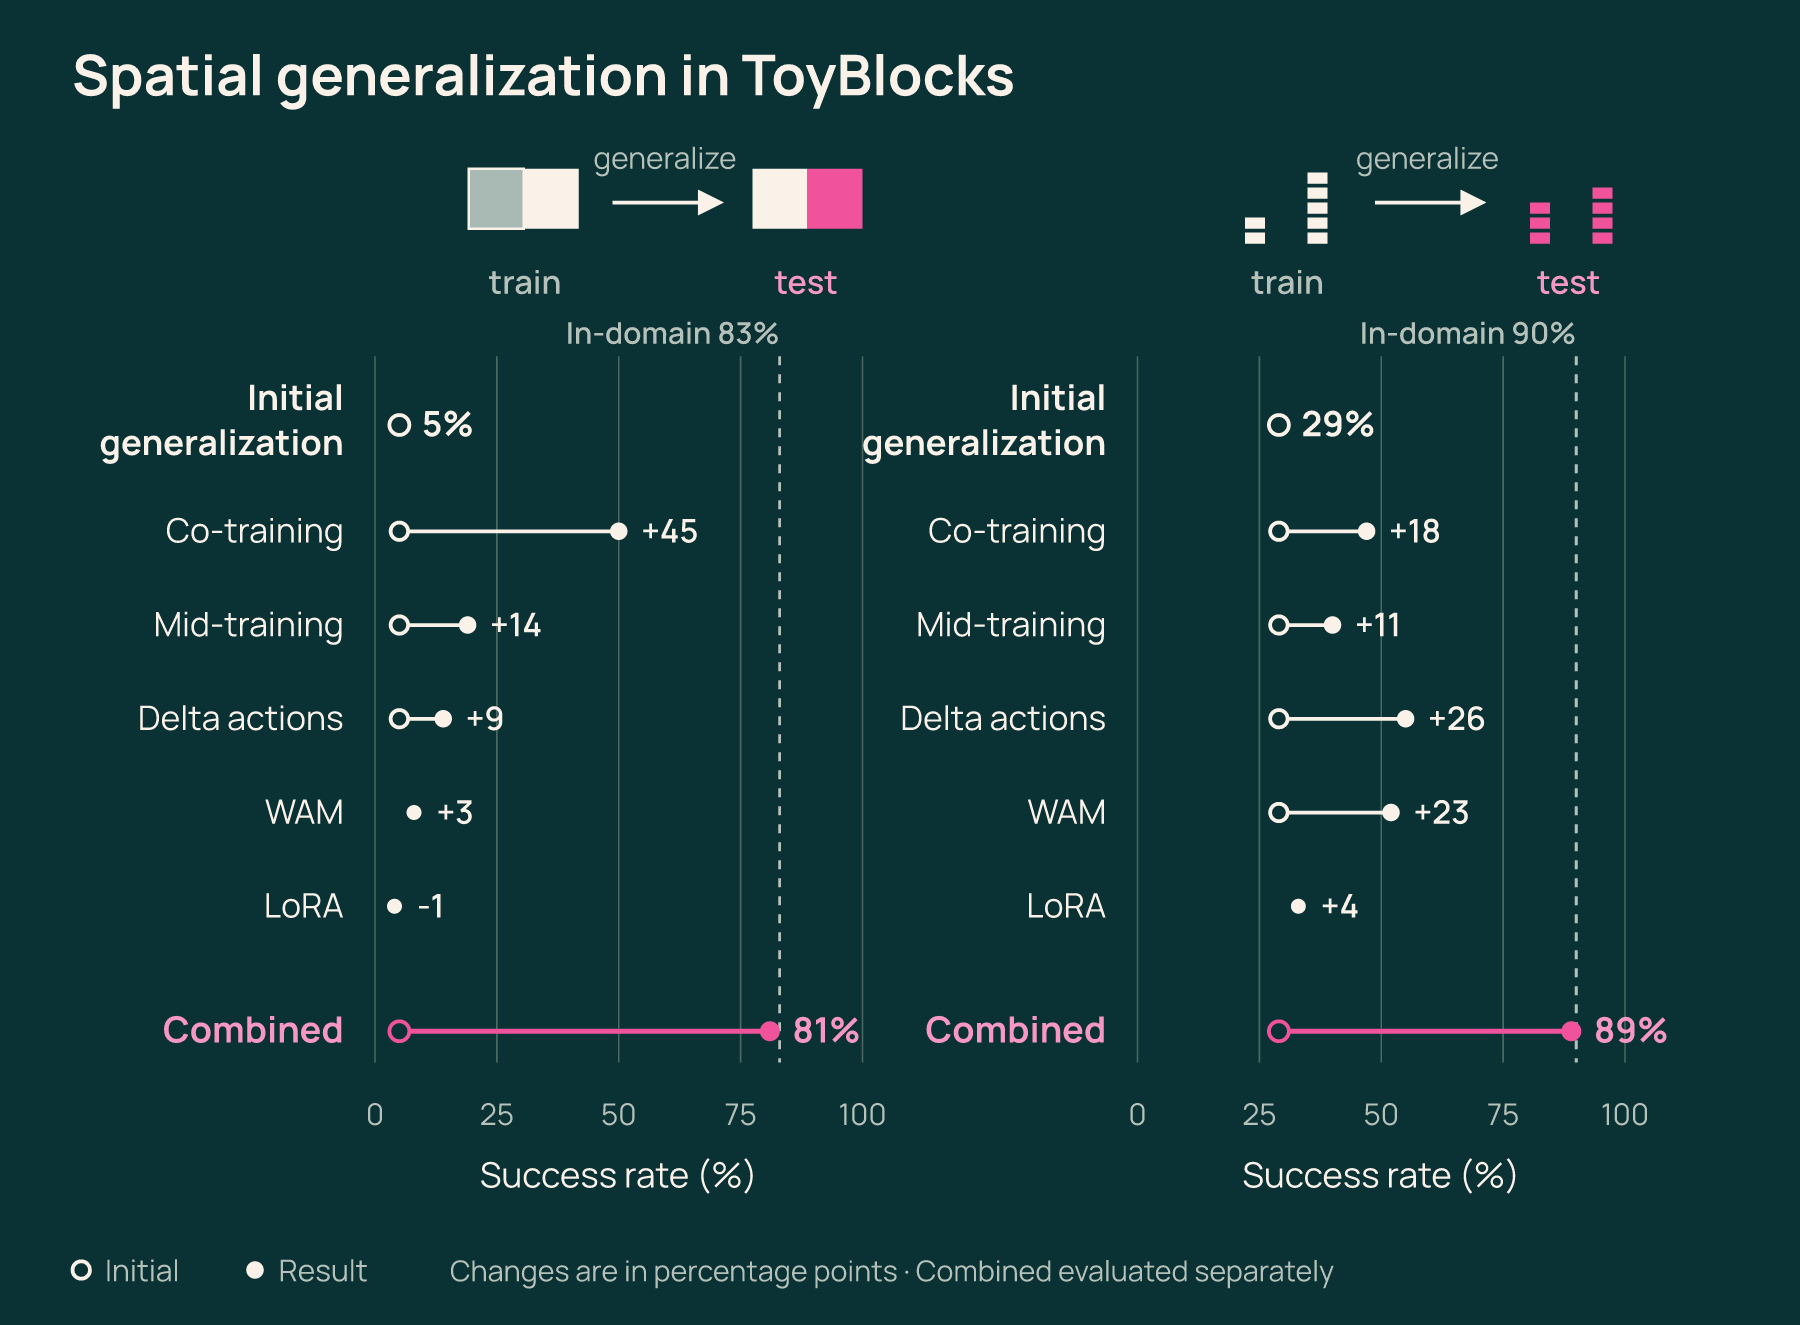
작업 공간 실험의 초기 평균 성공률은 5%였으며, 다른 세 과제의 시연을 함께 학습하는 공동 학습(Co-training)만 적용하면 50%로 높아졌습니다. 여러 방법을 결합한 결과는 81%였고, 학습 조건 안의 성능은 83%였습니다. 블록 높이 실험은 초기 29%, 결합 적용 89%, 학습 조건 안 90%로 보고했습니다. 각 값은 여러 과제와 모델 구조를 평균한 결과입니다.
결합 구성은 공동 학습, 중간 학습(Mid-training), 현재 관절 위치에 대한 변화량 예측(Delta Actions), 영상 예측을 함께 학습하는 WAM(World Action Model)을 사용합니다. 공동 학습은 전체 작업 공간의 다른 세 과제 시연을 배치의 절반으로 사용합니다. 중간 학습도 대상 과제를 제외한 전체 작업 공간 데이터를 활용하며, WAM은 전체 영역의 영상과 학습 영역의 동작 정답을 사용합니다. 결합 결과는 이 조건들을 함께 적용해 별도로 평가한 값입니다.
처음 보는 블록과 숨겨진 글자
상위 계획 모델 평가는 글자가 보이고 똑바른 Easy, 보이지만 방향을 고쳐야 하는 Medium, 글자가 처음에는 보이지 않는 Hard로 나눕니다. 각 막대는 200개 에피소드의 결과이며, 학습에 사용한 블록과 제외한 블록을 구분합니다.
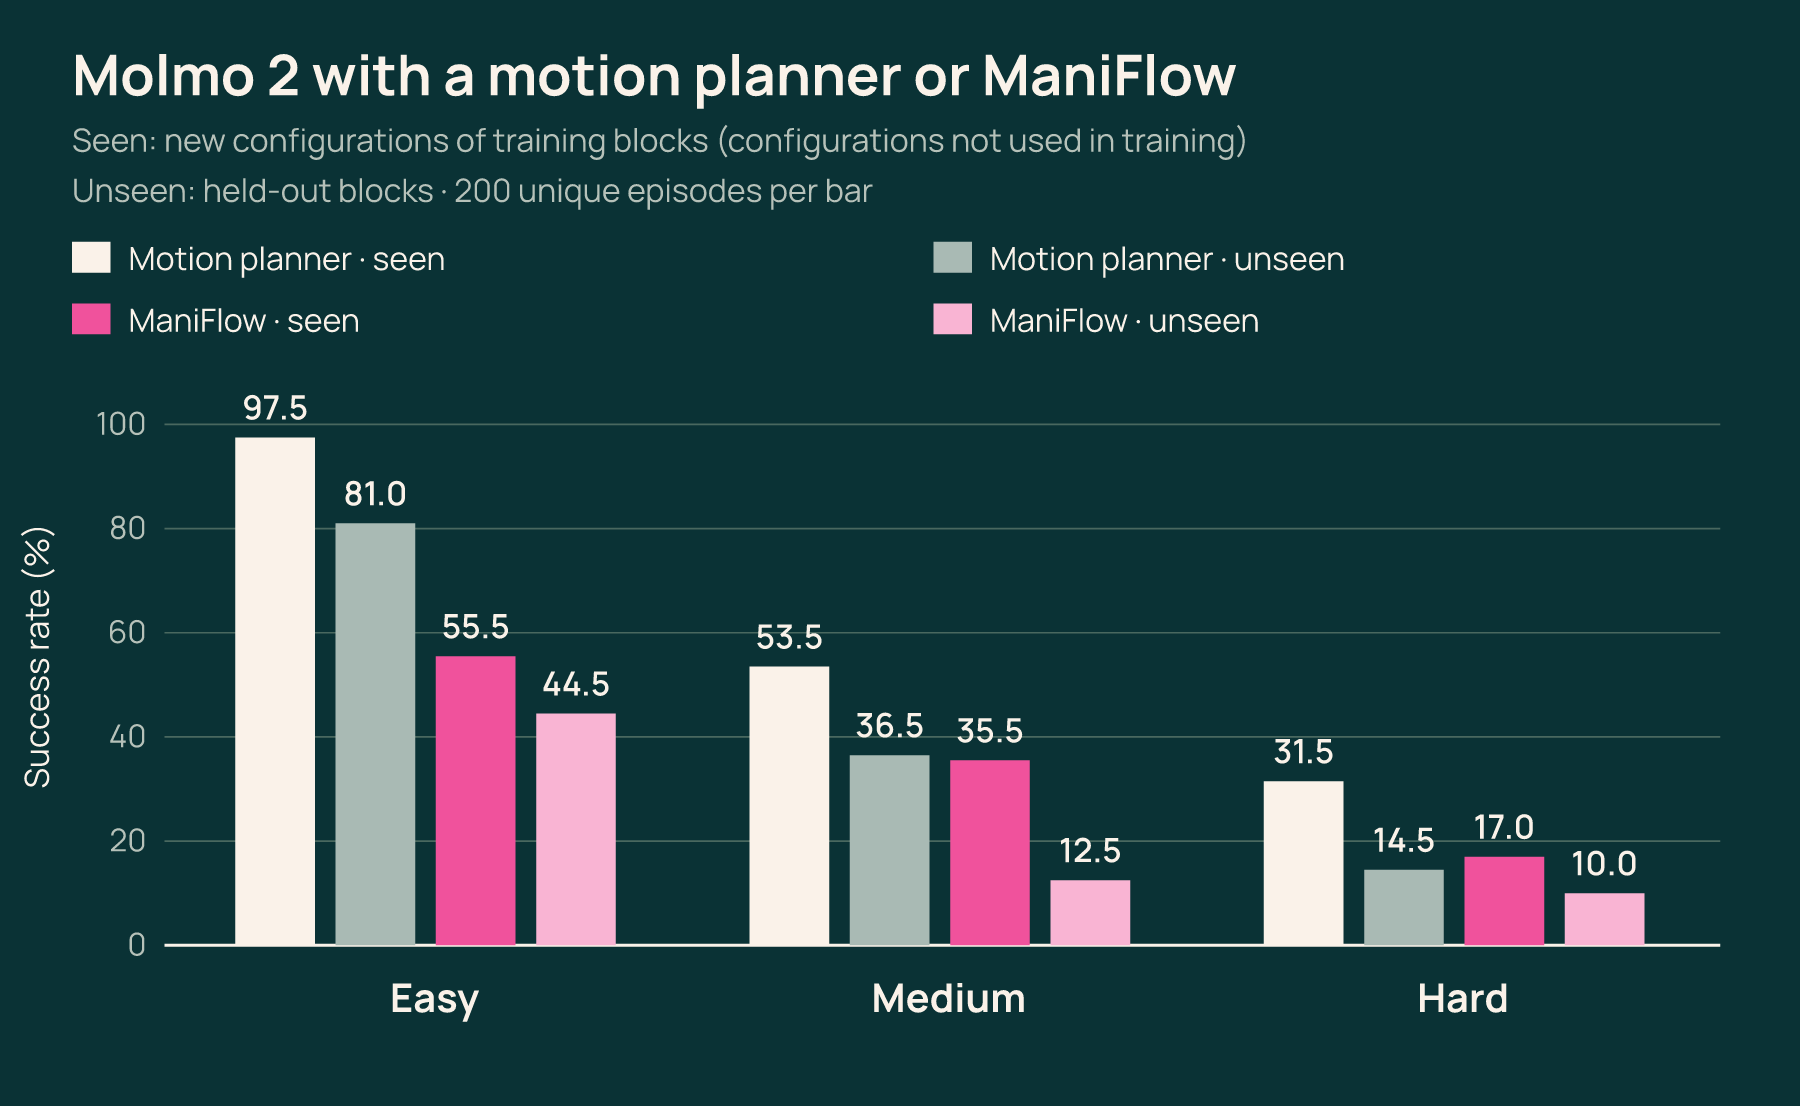
Easy에서 학습에 사용한 블록의 성공률은 하위 오라클과 결합하면 97.5%, ManiFlow와 결합하면 55.5%였습니다. 처음 보는 블록에서는 각각 81.0%, 44.5%였습니다. Hard에서는 익숙한 블록도 각각 31.5%, 17.0%로 낮아졌습니다. 하위 동작을 기준 스킬로 바꿔도 어려운 탐색과 계획에서 실패가 남는다는 점을 확인할 수 있습니다.
도구를 호출하는 에이전트의 탐색과 완료 판단
에이전트 프레임워크는 카메라 관측, 집기, 쌓기, 회전, 뒤집기 등을 MCP(Model Context Protocol) 도구로 제공합니다. 에이전트는 영상의 좌표를 지정해 대상 블록을 선택하며, 성공 여부를 직접 전달받지 않고 영상으로 작업 완료나 불가능 여부를 판단합니다. 실행 기록에는 영상, 대화, 도구 호출과 모델 사용 비용이 남습니다.
공식 실험 페이지는 Claude Opus 5.5를 사용한 결과를 설명합니다. 고전적인 블록 쌓기 계획 과제는 텍스트 설명으로 30개 중 30개, 카메라 영상을 보며 매번 다음 동작을 고르는 구성에서도 30개 중 30개를 해결했습니다. 세 글자 단어를 찾고 쌓는 과제에서는 최대 8개 블록을 사용했고, 절반의 장면은 필요한 글자가 없어 해결할 수 없도록 구성했습니다.
이 탐색 과제의 63%는 올바른 탑을 만들거나 불가능한 과제를 정확히 불가능하다고 보고한 비율입니다. 모든 과제에서 탑을 완성한 비율과는 다릅니다. 전체 과제 중 13%는 비슷하게 생긴 글자의 혼동, 15%는 글자 방향 오류로 실패했습니다.

위 그림의 세로축은 성공률이 아니라 에이전트가 확인한 블록 면의 비율입니다. 같은 글자의 대문자, 소문자와 관련 그림이 한 블록에 모여 있으면, 보이지 않는 면을 추정해 확인 횟수를 줄일 수 있었습니다. 별도 설명문 비교 실험에서는 기본 스킬 설명으로 24%, 전문가가 쓴 설명으로 36%, 에이전트가 직접 실험해 작성한 설명으로 63%를 보고했습니다.
공개 시연 영상의 모델은 Claude Fable 5.1로 표기되어 있습니다. 위 정량 실험의 모델명과 다르므로 같은 실행으로 묶지 않았습니다. 다음 영상은 블록 방향에 관한 가설을 시험한 뒤에도 최종 탑의 글자 방향을 틀리는 사례입니다.
월드 모델이 물체의 움직임과 성공 여부를 예측하는 실험
행동 조건부 월드 모델(Action-conditioned World Model) 은 초기 장면과 로봇 동작을 받아 이후 상태를 예측합니다. ToyBlocks의 월드 모델 실험은 집어 옮기기, 뒤집기, 회전, 혼합 과제마다 궤적 900개를 만들고 성공과 실패를 절반씩 포함했습니다. 성공만 예측하는 모델의 정확도가 50%가 되는 구성입니다.
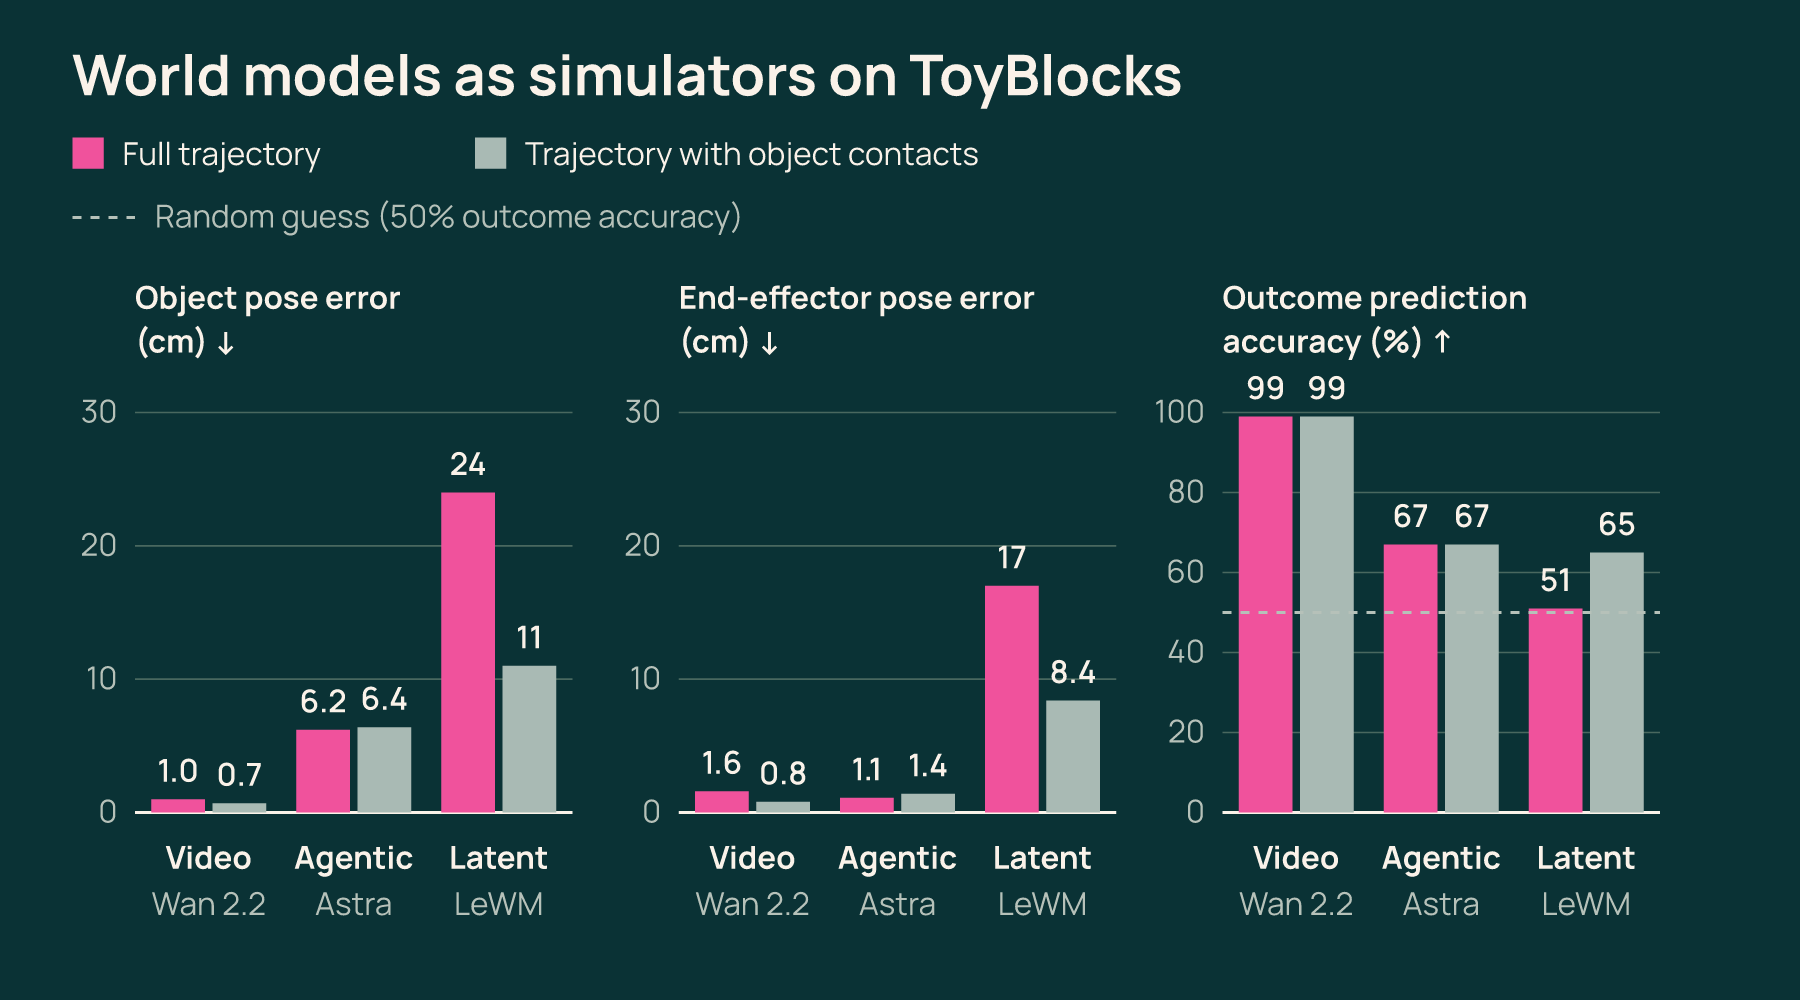
비교 대상은 영상 예측 모델 Wan 2.2, 직접 물리 시뮬레이터를 구성한 에이전트 Astra, 잠재 상태 기반 모델 LeWM입니다. 전체 궤적을 예측할 때 Wan 2.2의 물체 위치 오차는 1.0cm, 결과 예측 정확도는 99%였습니다. Astra는 그리퍼 위치 오차가 1.1cm였지만 결과 예측 정확도는 67%였으며, LeWM은 짧은 상호작용 구간에서 65%, 전체 궤적에서 51%였습니다.
전체 궤적 평가는 처음 영상만 제공하고, 짧은 구간 평가는 해당 접촉 직전의 실제 영상에서 다시 시작합니다. 또한 Astra에는 실제 초기 물체 위치가 주어졌습니다. 이 조건 차이를 포함해 결과를 비교해야 합니다. 추가 실험에서는 Wan 2.2로 생성한 궤적 100개를 추가했을 때, 시연이 없던 탁자 영역에서 ManiFlow 성공률이 19%에서 78%로 높아졌습니다.
실제 로봇 전이에서 확인한 결과와 제한
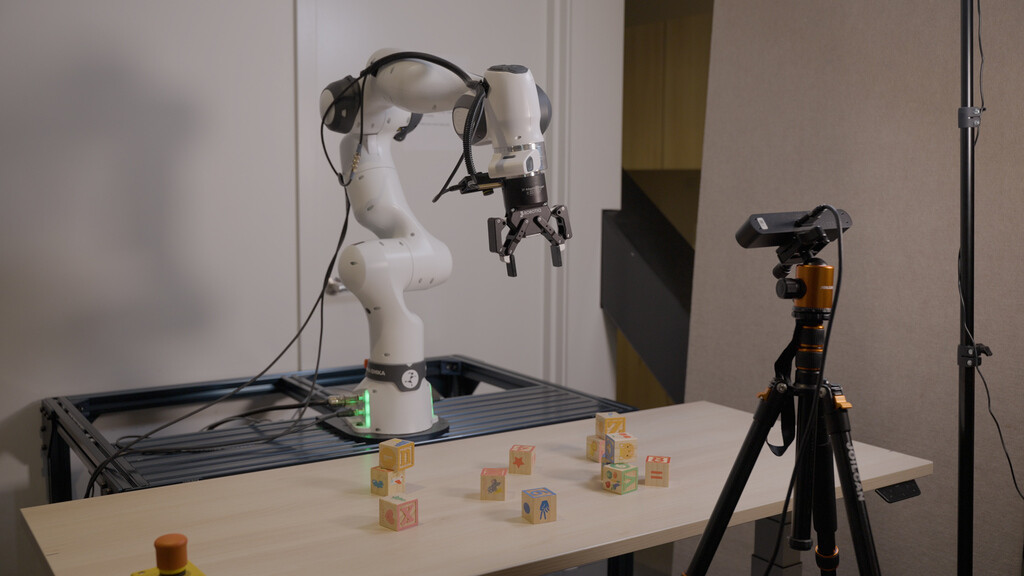
시뮬레이션에서 실제 로봇으로의 전이(Sim-to-real) 실험에서는 ToyBlocks 데이터로 학습한 Molmo 2와 ManiFlow를 Franka FR3에 적용했습니다. 실제 로봇 시연으로 추가 학습하지 않은 결과이며, 학습에 등장한 블록을 사용했습니다. 전체 단어 쌓기 과제는 글자가 보이고 똑바로 놓인 Easy 조건입니다.
| 평가 대상과 집계 단위 | 시뮬레이션 | 실제 로봇 |
|---|---|---|
| ManiFlow 개별 스킬, 명령별 성공 | 80.0%, 990/1,237 | 81.1%, 43/53 |
| Molmo 2와 ManiFlow의 전체 과제, 에피소드별 성공 | 55.5%, 111/200 | 50.0%, 15/30 |
Molmo2-4B-tb 모델 카드는 별도로 실제 로봇 10회에서 60% 성공을 보고합니다. 위 표는 블로그와 공식 실험 페이지의 30회 집계이며, 두 집계의 관계는 공개 자료에 설명되어 있지 않습니다.
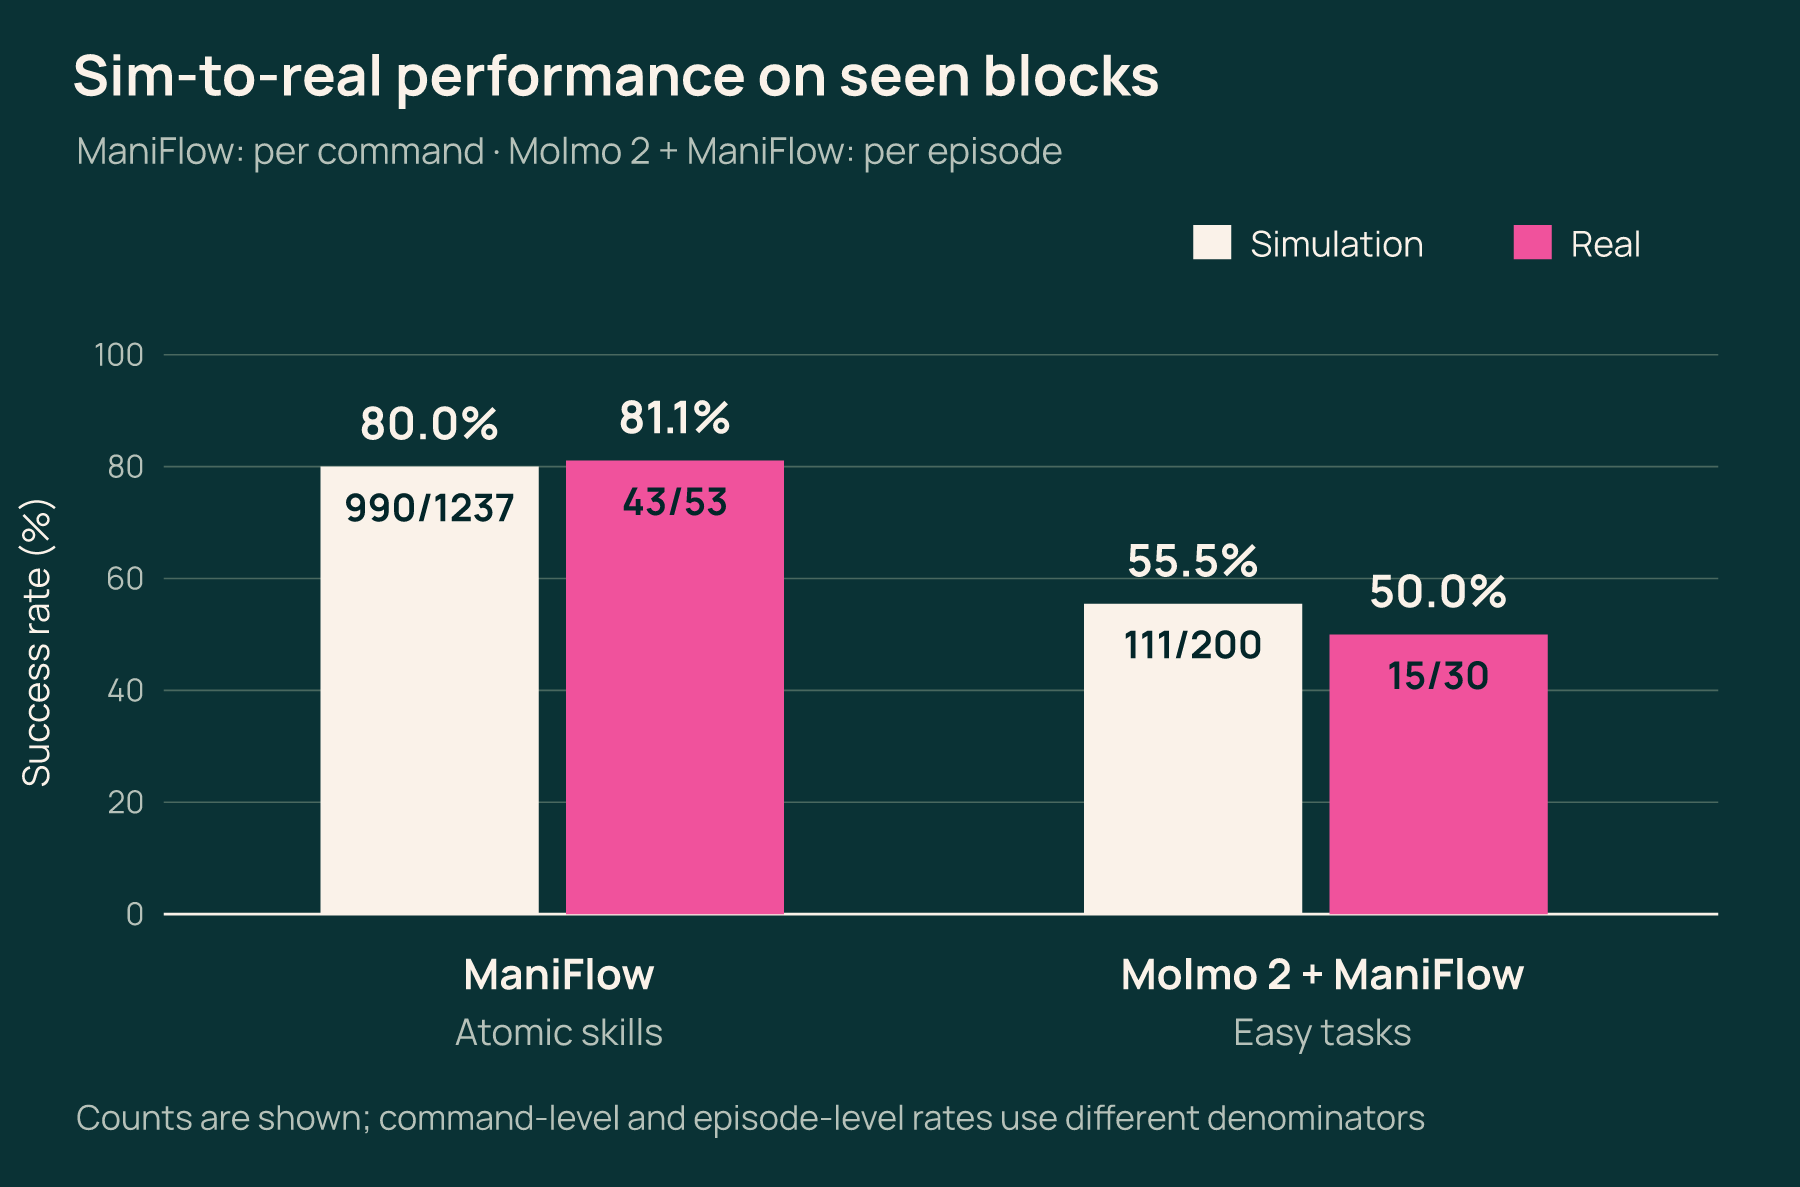
개별 명령의 성공률과 여러 동작으로 이루어진 과제의 성공률은 집계 단위가 다릅니다. 실제 로봇의 전체 과제는 30회뿐이므로, 이 결과로 시뮬레이션과 실제 환경의 성능이 동등하다고 단정할 수 없습니다. Ai2도 더 많은 실험이 필요하다고 설명합니다. 블로그에서는 안전하지 않은 동작 때문에 운영자가 중단한 에피소드를 실패로 처리했다고 명시합니다.
전이 과정에는 실제 궤적에 맞춘 로봇 파라미터 조정, 학습 영상의 무작위화, 정면 및 손목 카메라가 사용됩니다. 전이 도구 설명은 현재 공개 저장소에 보정된 시뮬레이션 장면이 있으며, 실제 로봇에서 정책을 실행하는 코드와 시스템 식별 가이드는 추후 제공할 예정이라고 구분합니다. 시뮬레이션 예제를 설치하는 것만으로 실제 로봇 실행 도구까지 갖춰지는 것은 아닙니다.
다음 비교 영상은 잡기와 놓기 시점을 맞추기 위해 시뮬레이션 재생 속도를 조정한 영상입니다. 두 환경의 실제 처리 속도를 비교하는 자료로 사용할 수는 없습니다.
공개 코드로 시작하는 방법과 이용 조건
설치 가이드는 Linux, CUDA 12.8을 지원하는 NVIDIA 드라이버 570 이상, Python 3.11과 uv를 전제로 합니다. 다음은 공식 설치 절차에서 데이터 생성에 필요한 구성을 발췌한 예시입니다. 이 글을 작성하면서 GPU 시뮬레이션을 실행한 결과는 아닙니다.
git clone https://github.com/allenai/ToyBlocks.git
cd ToyBlocks
uv venv --python 3.11
source .venv/bin/activate
git submodule update --init --recursive
uv pip install -e ".[dev,isaac,torch-cu128,vecgen]"
get-toyblocks-assets --asset-manifest asset_manifest.json
pytest tests/install
Isaac Sim을 처음 실행할 때는 NVIDIA Omniverse 최종 사용자 사용권 계약(End User License Agreement, EULA) 동의가 필요합니다. 무인 실행에서 동의 입력을 처리하는 방법과 GPU 설치 검사는 같은 가이드에 나와 있습니다. 상위 및 하위 정책을 함께 사용하려면 maniflow 추가 구성이, MCP 에이전트 실행에는 agentic 추가 구성과 별도의 모델 서비스 API 키가 필요합니다.
가상환경을 활성화하고 자산을 받은 저장소 루트에서는 README의 소규모 데이터 생성 예시를 사용할 수 있습니다. 다음 명령은 쌓기 문제 2개를 생성하고 실행한 뒤 영상을 렌더링하고 데이터를 병합합니다.
python scripts/datagen/run_datagen_pipeline.py \
    --experiment-id my_first_run --output-root data \
    --task-gen-script scripts/task_gen/stack_three.py --task-gen-count 2 \
    --env-per-problem 8 --num-envs 8 --exec-num-envs 8 --vecgen-problems-per-env 1 \
    --render-pass src/toyblocks/domain_randomization/flags/render_flags_plain.yaml
데이터 생성 후에는 ManiFlow 학습 가이드와 정책 평가 가이드로 이어집니다. 기존 시연 데이터와 공개 모델을 먼저 살펴보거나, 평가에서 상위 또는 하위 단계를 교체해 실패 원인을 조사하는 방식으로 시작할 수 있습니다.
ToyBlocks 코드는 Apache License 2.0, 공개 데이터셋은 ODC-BY 1.0입니다. 두 공개 모델의 카드에는 Apache 2.0이 표시되어 있습니다. 하위 모듈과 내려받는 자산은 각자의 라이선스를 따르므로 코드의 라이선스를 전체 자료에 적용하면 안 됩니다. Molmo2 모델 카드는 기반 모델 학습에 쓰인 외부 데이터의 학술 및 비상업적 연구용 조건도 안내합니다. 모델 활용 전에는 모델 카드의 이용 조건도 확인해야 합니다.
공개 패키지의 범위에도 차이가 있습니다. 블로그에서 설명한 RL 기반 스킬 생성 연구와 별개로, 완전히 통합된 RL 학습 기능은 향후 제공 대상으로 안내했습니다. 두 팔 조작과 손가락이 있는 로봇 손, 쌓인 블록과의 자유로운 상호작용도 후속 연구 방향입니다. 현재 공개된 기능과 예정된 확장을 구분해서 살펴볼 필요가 있습니다.
 ToyBlocks 소개 블로그
 ToyBlocks 공식 홈페이지
 ToyBlocks GitHub 저장소
 ToyBlocks 공개 데이터셋
ToyBlocks 모델 및 데이터 컬렉션
 ToyBlocks 사용자 가이드
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
