핵심 요약
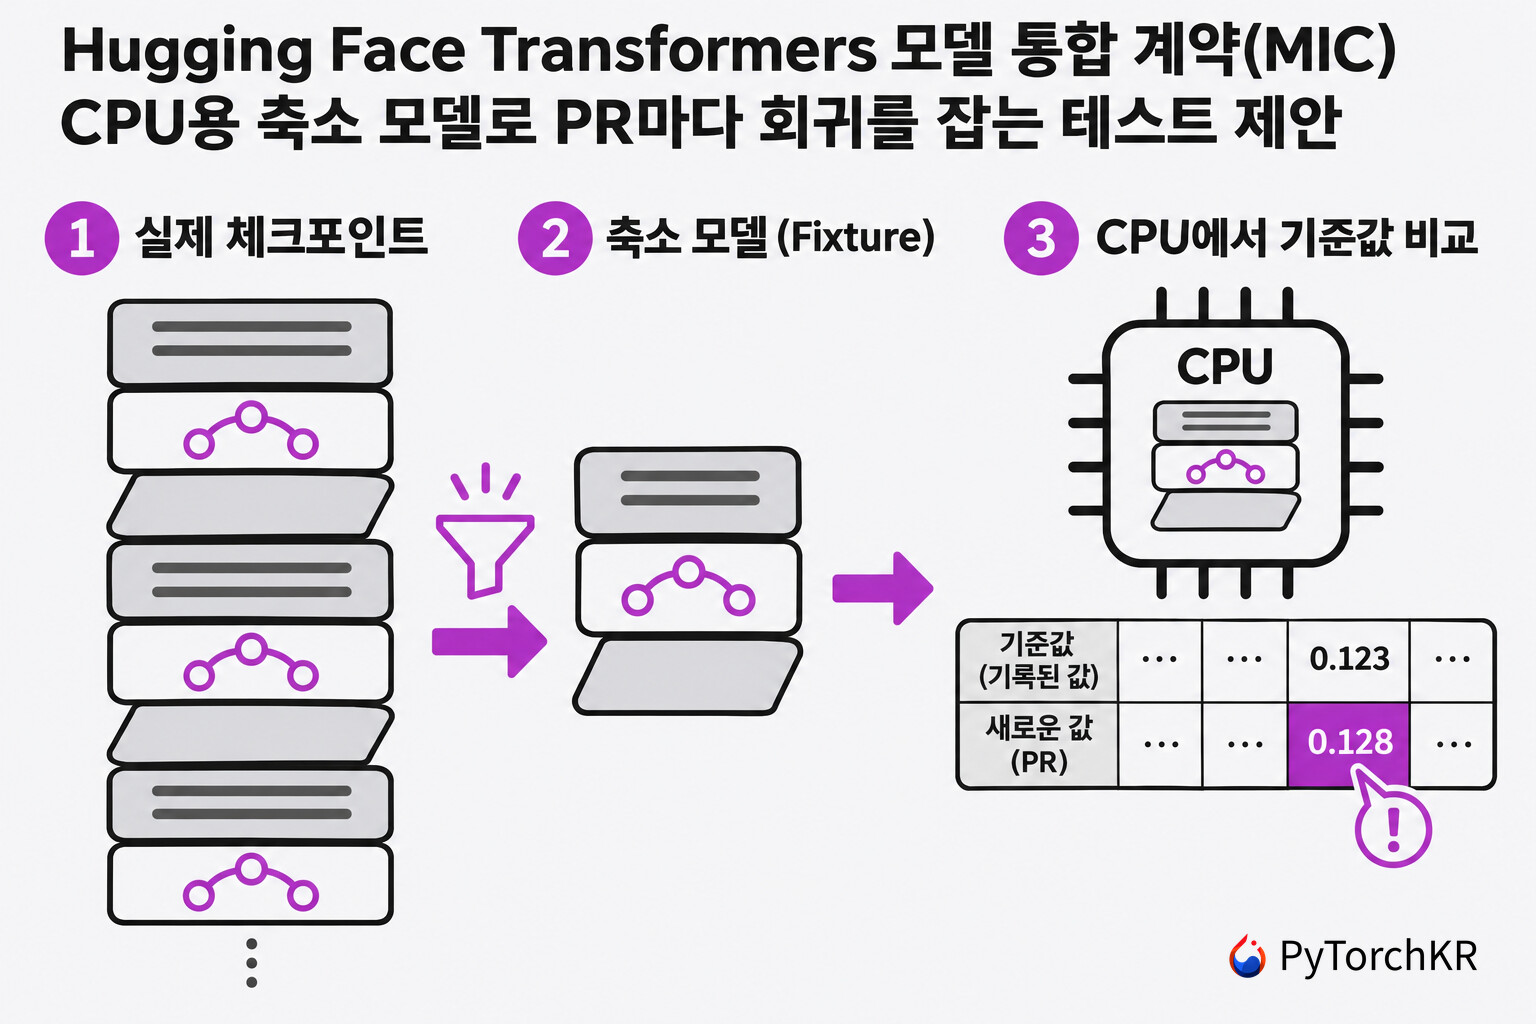
- Hugging Face는 Transformers Model Integration Contracts 글에서 모델 통합 계약(MIC) 을 표준안으로 제안했습니다. 실제 체크포인트의 설정으로 만든 작은 모델을 CPU에서 실행해 PR 단계에서 회귀를 잡는 방식입니다.
- 2026년 7월 30일 T5에 SDPA를 켠 변경 이후 UMT5 디코더가 미래 토큰을 보던 버그가 두 달 가까이 main에 남아 있었습니다. 나중에 그 기간을 재생한 실험에서 축소한 UMT5 모델은 커밋 597개 모두에서 이 버그를 잡았습니다.
- 같은 5개월 재생 실험에서 고정된 계약은 실제 회귀 5건 중 1건만 잡았고 4건은 놓쳤습니다. 놓친 4건은 모두 계약이 해당 API를 호출하지 않은 경우였습니다.
- transformers-mic 저장소의
tmicCLI(0.1.1, 알파)로 로컬에서 계약을 만들어 볼 수 있습니다. Transformers CI의 MIC 작업은 아직 실패를 보고만 하고 PR을 막지는 않습니다.
Transformers 모델 통합 계약(MIC) 소개
모델 통합 계약(Model Integration Contract, MIC) 은 Hub에 올라간 모델이 특정 프레임워크에서 실제로 동작하는지를 그 프레임워크의 CI가 실행해 확인하는 검사 묶음입니다. Hugging Face의 Tarek Ziadé가 2026년 11월 3일 Hugging Face 블로그에 이 제안을 공개했고, 도구와 실험 기록은 Apache 2.0 라이선스의 transformers-mic 저장소에 있습니다.
글은 하나의 버그에서 시작합니다. 2026년 7월 30일 Transformers는 PR #47014로 T5 계열에 PyTorch의 scaled dot-product attention(SDPA)을 켰습니다. 그 부작용으로 UMT5의 디코더가 미래 토큰을 볼 수 있게 되었습니다. 학습 중에는 맞혀야 할 정답을 미리 엿보는 셈입니다. 오류가 나지 않았기 때문에 이 버그는 9월 28일 PR #49135로 고쳐질 때까지 두 달 가까이 main에 남아 있었습니다.
나중에 그 기간의 커밋을 다시 돌려 보니, CPU에서 도는 작은 UMT5 모델이 모든 커밋에서 이 버그를 잡아냈습니다. 원문은 이 작은 모델과 그 주변에 만든 테스트 체계를 설명합니다. 이 글은 원문과 함께 저장소의 실험 기록(docs/evidence.md, docs/fixtures.md)과 미해결 문제 문서까지 대조해, 원문이 짧게 넘어간 한계와 수치도 함께 정리합니다. Transformers 자체의 큰 변화가 궁금하다면 Transformers v5 공개 소식도 함께 보시기를 권합니다.
테스트가 많아도 버그가 main에 들어가는 이유
Transformers는 750개가 넘는 모델 타입을 지원하고, main에서 88,000개 이상의 CPU 테스트와 매일 200,000개 이상의 GPU 테스트를 돌립니다. 모델 테스트 외에도 파이프라인, 학습, 분산 실행, 양자화(quantization), 어텐션 커널을 테스트합니다. 하드웨어도 CPU, NVIDIA GPU, AMD GPU, Intel XPU, Intel Gaudi 3까지 다양합니다.
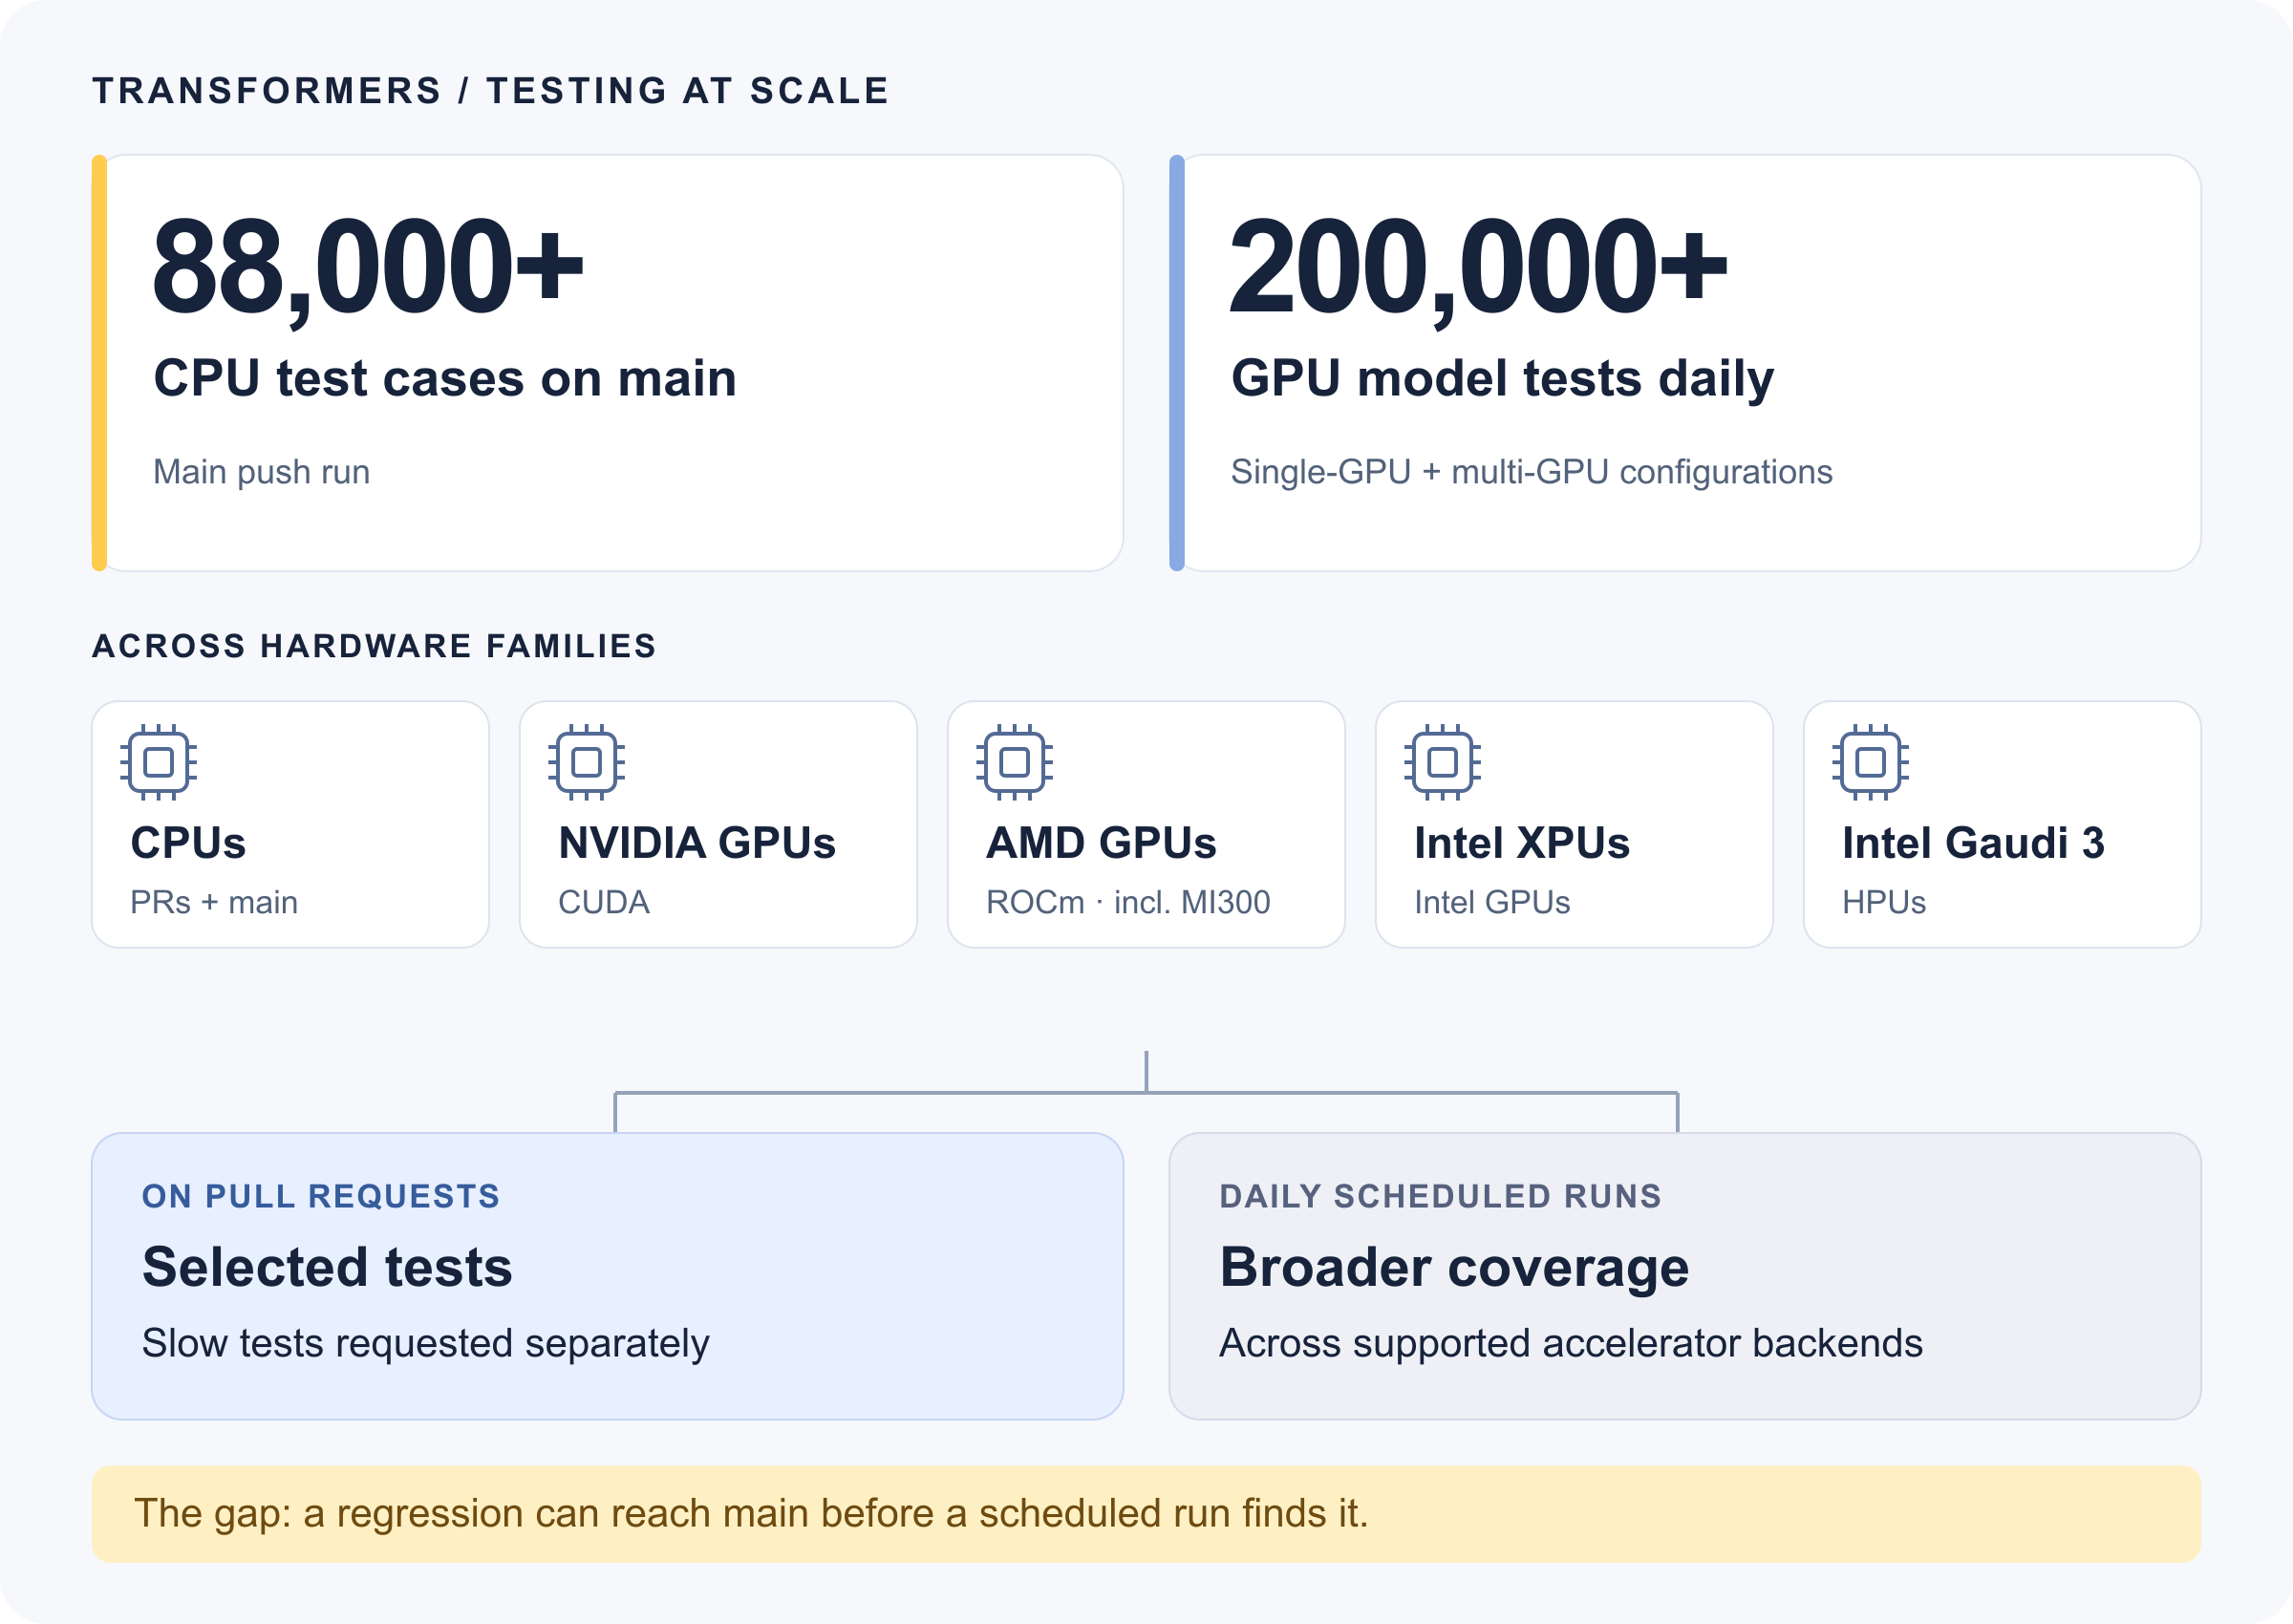
문제는 통합 테스트(integration test) 입니다. 통합 테스트는 실제 체크포인트를 내려받아 실제 하드웨어에서 모델의 API를 실행합니다. 이를 모든 PR에서 실행하면 GPU를 하루 종일 붙잡아 두어야 하므로, PR에서는 일부만 돌리고 나머지는 정기 실행에 맡깁니다. 그래서 정기 실행이 회귀를 찾았을 때는 이미 main에 들어가 있는 경우가 생깁니다. 위 도식의 맨 아래 문장이 바로 이 틈을 가리킵니다.
Hugging Face 팀의 답은 모델을 줄이는 것입니다. 실제 체크포인트의 설정에서 출발해 층 수와 폭은 줄이되 층의 종류는 모두 남기고, 토크나이저와 프로세서 파일은 그대로 둔 작은 모델을 만듭니다. 원문은 이를 fixture 라고 부르고, 한 번 공개한 뒤 고정해서 재사용합니다. 원문의 CPU 실험에서 UMT5 fixture의 가중치는 66MB였고, 원래 체크포인트는 1,227MB였습니다. 표준 GPU 러너에 올라가지 않는 아주 큰 모델도 fixture는 CPU에서 돌릴 수 있습니다.
작은 테스트 모델 자체는 새롭지 않습니다. Transformers에는 이미 tiny-random-* 체크포인트가 있습니다. 다만 저장소의 fixture 문서에 따르면, 이 모델들은 단위 테스트용 설정을 써서 실제 RoPE, 슬라이딩 윈도우, MoE 설정을 잃고, 프로세서 파일도 다시 저장한 것을 씁니다. 저자들의 실험에서 forward 통과 여부만 보는 검사는 인위적으로 넣은 결함 126개 중 하나도 잡지 못했고, 다시 저장한 프로세서 파일은 실제 회귀 3건을 가렸습니다. UMT5 버그도 forward를 실행하는 것만으로는 오류 없이 통과했을 것이라고 원문은 말합니다.
MIC의 세 구성 요소: fixture, 사용 경로, 기준 출력
transformers-mic는 이런 테스트를 묶는 표준안입니다. MIC 하나는 세 부분으로 이루어집니다.
- fixture: 위에서 설명한 축소 모델입니다. 한 번 공개하고 버전을 고정합니다.
- 사용 경로(usage path): 사람들이 그 모델로 실제로 하는 일, 예를 들어 텍스트 생성이나 학습 한 스텝을 실행 가능한 Markdown 예제로 적은 것입니다. hf-doc-builder의 실행 가능한 Markdown 형식이라 문서이면서 테스트입니다.
- 기준 출력(baselines): 그 예제를 실행했을 때 나온 출력을 기록하고 사람이 검토한 값입니다.
사용 경로를 fixture에서 다시 실행했을 때 기준 출력이 그대로 나오면 계약이 지켜진 것입니다. 계약은 체크포인트 하나가 아니라 아키텍처와 사용 경로 단위로 정합니다. 호환되는 체크포인트들은 fixture 하나를 공유하고, 기대 결과는 각자 따로 둡니다. 공개된 계약은 Hub의 huggingface-mic 조직에 있으며, 2026년 11월 4일 기준 모델 저장소 223개가 올라와 있습니다.
예를 들어 SmolLM 계약은 "The capital of France is" 같은 프롬프트로 생성을 하고, 나온 토큰 ID를 기록된 답과 비교합니다. 모델과 토크나이저를 불러온 뒤의 생성 코드를 프롬프트 하나로 줄이면 다음과 같습니다.
inputs = tokenizer("The capital of France is", return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)
new_tokens = outputs[:, inputs["input_ids"].shape[1]:]
print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))
이 계약은 생성 결과 외에도 학습 손실을 비교하고, 그래디언트가 유한한지, 옵티마이저 스텝이 가중치를 실제로 바꾸는지까지 확인합니다. 전체 예제는 SmolLM 계약의 usage.md에서 볼 수 있습니다. 저장소의 증거 문서는 이런 단언(assertion)이 왜 필요한지 보여 줍니다. fixture나 실제 체크포인트로 잡힌 회귀 18건 중 오류를 낸 것은 6~7건이었고, 11건은 오류 없이 틀린 값만 돌려주었습니다. "실행이 끝났다"만 보는 검사로는 이 11건을 잡을 수 없습니다. 실행 중에 조용히 값이 바뀌는 문제는 vLLM의 rope_scaling 측정 글에서도 다룬 적이 있습니다.
Hub의 fleet 데이터셋은 각 MIC를 고정된 리비전에 묶고, 기준 출력을 기록할 때 쓴 패키지 버전도 함께 남깁니다. CI 실행은 자신이 쓴 fleet 리비전을 기록하므로 나중에 같은 조건으로 재현할 수 있습니다. PR에서는 패치가 바꾼 파일을 보고 실행할 MIC를 고릅니다.
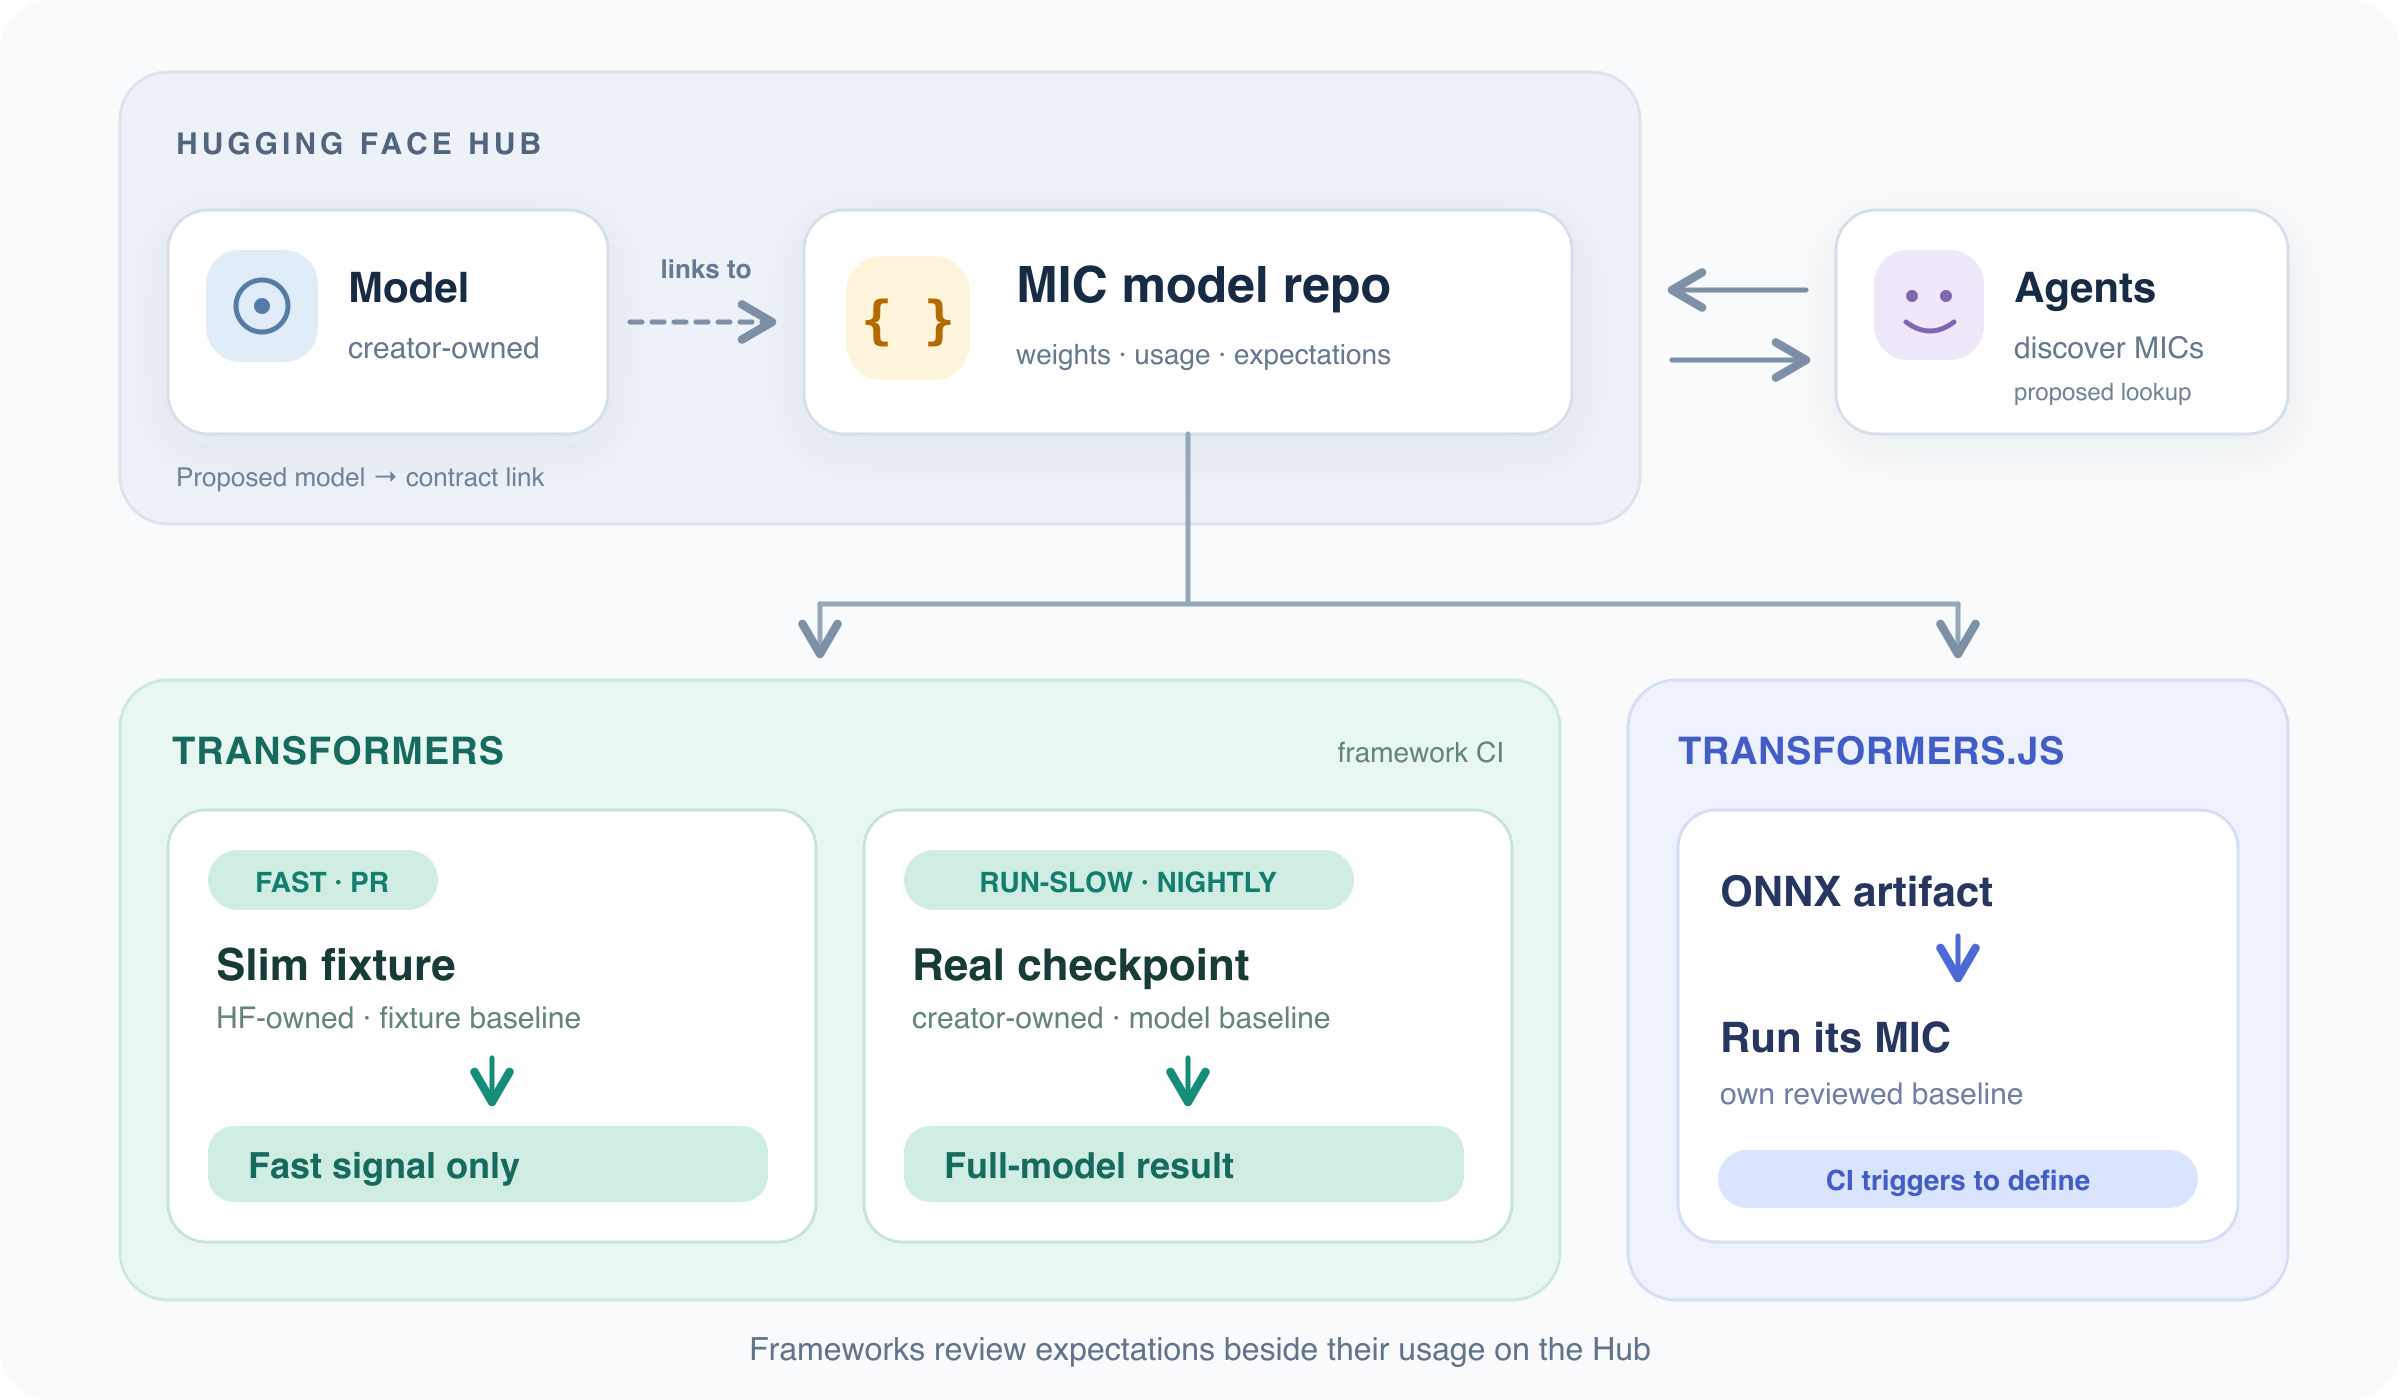
저장소 README의 위 도식은 원문보다 큰 그림을 보여 줍니다. PR에서는 fixture가 빠른 신호만 주고, 실제 체크포인트 검사는 유지보수자가 요청하는 run-slow, 병합 뒤 실행, nightly에서 돕니다. Transformers.js도 같은 계약을 자체 기준값으로 돌릴 수 있지만, CI에서 언제 실행할지는 아직 정해지지 않았습니다. README는 이 차이를 "fixture 통과는 빠른 회귀 신호일 뿐, 실제 모델의 통과가 아니다"라고 분명히 적습니다.
UMT5 회귀: 축소 모델이 두 달 숨은 버그를 잡은 과정
저자들은 고정한 MIC를 Transformers의 5개월치 커밋에 다시 돌렸습니다. 저장소 기록으로는 2026년 5월 2일부터 10월 7일까지 main의 커밋 1,468개에 fixture 8개를 돌려 결과 11,744건을 얻었습니다. 작은 UMT5 fixture는 버그가 들어온 7월 30일 커밋부터 고쳐진 9월 28일 커밋까지 커밋 597개 모두에서 실패를 보고했습니다. 레이블 로그 확률은 검토된 기준 출력과 1.22만큼, 학습 손실은 약 0.20만큼 달랐습니다.
여기서 중요한 조건이 하나 있습니다. 이 계약은 기본 어텐션 경로인 SDPA를 썼습니다. eager 어텐션 변형만 돌렸다면 버그를 놓쳤습니다. 원문의 표현으로는 "fixture는 실제 체크포인트와 같은 코드를 지날 때만 도움이 된다"는 것입니다. 저장소 기록에는 이 조건의 함정도 하나 남아 있습니다. 모델을 불러온 뒤 set_attn_implementation("sdpa")를 호출하면 T5는 SDPA로 보고하면서 실제로는 eager로 계속 돌았습니다(이슈 #49372). 그래서 계약은 불러오는 시점에 정해지는 기본값 그대로 실행해야 합니다.
저자들은 이어서 Transformers CI의 증명용 브랜치에서 수정을 되돌려 보았습니다. 검사는 같은 차이(1.22, 0.204)로 실패했고, 선택된 T5 계약의 러너 단계는 설치를 제외하고 CPU에서 13.4초 걸렸습니다. 기준 출력은 AMD CPU에서 기록했는데, 이 실행은 Intel Xeon 6975P-C와 CI 이미지의 다른 패키지 버전에서도 같은 차이를 냈습니다. 같은 실험에서 문서 페이지만 바꾼 PR은 계약을 하나도 고르지 않았고, models/clip/만 바꾼 PR은 CLIP 계약 하나만 골랐습니다. 공유 코드인 generation/utils.py를 바꾸면 계약 6개를 모두 돌렸습니다.
원문이 짧게 넘어간 숫자: 1건 적중, 4건 놓침, 1건 오탐
원문은 UMT5 사례를 중심으로 쓰였지만, 같은 재생 실험의 전체 결과는 저장소의 shadow backfill 절에 있습니다. 5개월 동안 고정된 계약이 잡은 실제 회귀는 UMT5 1건이고, 놓친 회귀가 4건, 오탐이 1건이었습니다.
| 결과 | 사례 | 원인 |
|---|---|---|
| 적중 | UMT5 디코더 인과 마스크 누락 (#47014 → #49135) | SDPA 기본 경로를 계약이 실행함 |
| 놓침 4건 | CLIP text_kwargs, 프로세서 설정 헬퍼, Whisper 타임스탬프 배치 디코딩, T5 배치 디코딩 |
어떤 계약도 해당 API를 호출하지 않음 |
| 오탐 1건 | Wav2Vec2 학습 손실이 0.39 변함 | 불러올 때의 난수 스트림이 바뀐 무해한 변경 (기준 출력 1회 갱신) |
놓친 호출을 계약에 추가하고 다시 실행하자 5건 모두 각자의 수정 커밋 직전까지 정확히 실패했고, 새 오탐은 없었습니다. 다만 저자들은 이것이 "버그를 알고 나서 쓴 호출"이므로 모르는 버그를 잡는 비율의 증거는 아니라고 직접 적었습니다. 미리 알지 못한 버그를 잡은 사례도 하나 있습니다. 다른 버그 때문에 추가한 Whisper의 보조 디코딩(assisted decoding) 호출이 PR #48981이 만든 새 회귀를 재생 실험에서 그 PR의 커밋부터 잡았습니다. 저장소의 미해결 문제 문서는 첫 번째 한계를 "계약은 자신이 호출하는 것만 잡는다"로 정리합니다.
큰 모델을 줄이는 4단계 레시피
처음 레시피는 단순했습니다. 차원을 줄이고 층을 몇 개만 남기는 방식이었습니다. 그런데 이 방식은 층 종류가 섞인 아키텍처에서 통하지 않았습니다. 층 두 개만 남겼는데 둘 다 슬라이딩 어텐션이면, 전체 어텐션 층은 아예 사라집니다. 저장소 문서의 예로 google/gemma-3-1b-it에서 층 2개를 고정으로 남기면 슬라이딩 층 2개만 남고, 전체 어텐션 층은 만들어지지도 않습니다. 그래서 지금의 레시피는 네 단계입니다.
- 설정 축소: 실제 체크포인트에서 시작해 은닉 크기, 어텐션 헤드 수, 깊이를 줄입니다. 슬라이딩과 전체 어텐션, dense와 MoE 층처럼 서로 다른 층 종류는 남깁니다. 규칙이 이름으로 모르는 폭은 그 모델의 Transformers 테스트 파일(
test_modeling_<model>.py)에 있는ModelTester가 이미 손으로 고른 작은 설정에서 가져옵니다. - 전처리 유지: 어휘, 특수 토큰, 입력 차원을 유지하고 토크나이저와 프로세서 파일은 바이트 단위로 복사합니다. 불러오기와 전처리도 테스트 대상이기 때문입니다.
- 가중치 생성과 검증: 시드를 고정한 무작위 가중치를 먼저 시도하고, 입력을 바꿨을 때 출력이 움직이는지 확인합니다. 움직이지 않으면 계약의 작은 예제 배치로 학습해 봅니다. 저장한 모델을 다시 불러와 출력, 손실, 그래디언트가 유한한지 확인하고, 실패한 빌드는 버립니다.
- 고정과 기록: 통과한 가중치를 저장하고, 정상으로 알려진 Transformers 빌드에서 반복 가능한 출력을 측정합니다. 지원하는 플랫폼과 정밀도마다 기준 출력을 검토한 뒤 고정 스냅샷으로 공개합니다. CI는 PR마다 fixture를 다시 만들지 않고 이 스냅샷을 재사용합니다.
원문은 원래 가중치 파일 형식도 유지한다고 씁니다. 그렇지 않으면 사용자가 실제 체크포인트를 불러올 때 도는 변환 코드를 건너뛰기 때문입니다. 다만 저장소의 현재 레시피(0.1.1 이후 미출시 변경)는 파일을 항상 model.safetensors로 쓰고, 변환 코드가 읽는 텐서 이름, 접두사, 전문가 배치를 원본대로 둡니다. 세부 규칙은 레시피 문서에 있습니다. 저장소 문서 기준으로 기본 폭은 은닉 64, 중간 128, 헤드 4개이고, MoE는 전문가 4개로 줄입니다. 매개변수가 2천만 개 이하인 체크포인트는 줄이지 않고 학습된 가중치를 그대로 fixture로 씁니다.
큰 모델에서 이 레시피가 어떻게 보이는지는 Llama 4 Scout 축소 보고서가 보여 줍니다. 원본 RedHatAI/Llama-4-Scout-17B-16E-Instruct의 매개변수 1,086억 개가 4,470만 개가 되고, 비전 층은 34개에서 2개로, 언어 층은 48개에서 4개로 줄어듭니다. 확인 대상인 층 종류와 MoE 라우팅 방식(16개 중 top-1에서 4개 중 top-1로)은 유지됩니다. 보고서를 열어 보면 어휘 크기 202,048을 그대로 두기 때문에, 축소 모델에서는 임베딩과 출력층이 각각 1,290만 개로 매개변수의 큰 몫을 차지합니다.
레시피가 모든 아키텍처에 통하지는 않습니다. 저장소의 전수 실험은 Transformers 모델 타입 786개 중 사용 경로를 시도한 582개에서 383개(66%)만 축소, 빌드, forward와 backward를 모두 통과했다고 기록합니다. 나머지는 주로 서로 묶인 크기 필드, 아키텍처별 제약, 합성 입력을 만들 수 없는 모달리티(비디오, 시계열) 때문에 실패했고, 저자들은 이를 체크포인트가 아닌 모델 계열 단위의 규칙으로 고치고 있습니다.
에이전트로 MIC 만들기
저장소의 CLI인 tmic은 계약을 만들고 fixture를 빌드합니다. 새 모델이면 LLM이 사용 코드와 매니페스트 초안을 쓰고, CPU와 GPU 실행이 후보 기준 출력을 측정합니다. 원문의 표현으로는 "LLM은 초안을 쓸 뿐 승인하지 않습니다". 바뀐 기대값은 사람이 검토해야 합니다. 저자들은 에이전트로 여러 모델 계열의 MIC를 만들었고, 예외 사례를 만나면 그 fixture 하나가 아니라 레시피 자체를 모델 전문가와 함께 고쳤다고 합니다. 공개된 모델과 남은 빈칸은 coverage Space에서 볼 수 있습니다.
무작위 가중치와 과적합 가중치
무작위 가중치로 만든 Whisper fixture는 오디오가 바뀌어도 출력이 거의 변하지 않았습니다. 돌아가기는 하지만 오디오 경로를 시험하기에는 부족했습니다. 그래서 저자들은 몇 가지 톤(tone)을 "red", "green" 같은 단어와 짝지어 학습시켰습니다. 음성 인식을 가르치려는 것이 아니라, 오디오가 바뀌면 출력에서 그 변화가 보이게 하려는 것입니다. 이렇게 일부러 몇 개의 예제에 과적합(overfit) 시킨 가중치를 쓰는 방식이 두 번째 선택지입니다.
가중치 초기화 실험에서 무작위 Whisper fixture는 주입한 결함 24개 중 18개를, 과적합 fixture는 24개 모두를 잡았습니다. 여섯 모델 계열 전체로는 무작위 120/126, 과적합 126/126입니다. 하지만 원문은 이 결과로 우열이 정해지지 않는다고 말합니다. 주입한 결함은 어텐션을 0으로 만들거나 입력을 바꿔 치는 식의 인위적인 결함이고, 과적합 fixture만 잡은 실제 회귀는 아직 하나도 찾지 못했습니다. 두 방식 모두 실제 Whisper 체크포인트가 드러낸 보조 디코딩 버그(#48108)를 놓쳤습니다.
저장소의 비교표에는 반대 방향의 사례도 있습니다. MusicGen Melody의 조건 입력이 사라지는 실제 버그(#48679)에서, 두 행의 텍스트가 같은 입력 조합 4가지는 과적합 fixture가 모두 놓치고 무작위 fixture가 모두 잡았습니다. 전체 12가지 조합으로는 과적합 8/12, 무작위 12/12였습니다.
| 기준 | 무작위 가중치 | 과적합 가중치 |
|---|---|---|
| 사람이 읽을 수 있는 생성 결과 | 같은 단어를 반복하거나 입력을 무시함 | 프롬프트의 수도 이름, 톤의 색 이름을 답함 |
| 인위적 결함 탐지 (6개 계열) | 120/126 | 126/126 |
| 과적합만 잡은 실제 회귀 | 해당 없음 | 아직 0건 |
그래서 지금 규칙은 무작위 가중치가 검사를 통과하면 그대로 쓰고, 더 높은 민감도나 읽을 수 있는 답이 필요할 때만 과적합 가중치를 쓰는 것입니다. 학습 자체는 몇 초면 끝나지만, 수렴에 실패할 수 있는 단계가 하나 더 생기고 유지할 것도 하나 늘어납니다.
직접 실행해 보기: tmic CLI
transformers-mic는 2026년 11월 2일 PyPI에 0.1.0으로 처음 올라왔고, 이 글을 쓰는 시점의 최신 버전은 11월 3일의 0.1.1입니다. 패키지 분류는 알파(Development Status 3)이고, 변경 기록은 생성된 계약에 아직 코드 리뷰가 필요하다고 적고 있습니다. Python 3.11 이상이 필요하고, runtime 추가 의존성은 transformers>=5와 torch>=2.11을 요구합니다. Hugging Face 팀이 원문과 README에서 안내하는 로컬 실행 명령은 다음과 같습니다. org/model 자리에 원래 체크포인트 이름을 넣습니다.
pip install "transformers-mic[runtime]" "hf-doc-builder @ git+https://github.com/huggingface/doc-builder.git"
hf auth login
tmic run org/model --local-only --fixtures-only --no-history --bill-to ''
이 명령은 계약 초안을 만들고, fixture를 빌드하고, 기준 출력을 내 컴퓨터에서 기록합니다. 축소 모델 설정과 계약 코드(usage.md)를 검토하도록 묻고, 아무것도 업로드하지 않고 멈춥니다. 각 옵션의 의미는 CLI 문서에 있습니다.
--local-only: 이 컴퓨터에서만 측정하고 Hub 업로드 전에 멈춥니다.--fixtures-only: fixture만 대상으로 삼아 실제 체크포인트를 불러오지 않습니다.--no-history: GitHub 이력 검색을 건너뛰어ghCLI가 없어도 됩니다.--bill-to '': 새 모델의 초안은 Inference Providers를 거친 LLM이 쓰는데, 그 비용을 내 계정에 청구합니다.
마지막 옵션은 빠뜨리지 않는 것이 좋습니다. CLI 문서에 따르면 초안 작성 LLM의 기본값은 Together를 거친 deepseek-ai/DeepSeek-V4.1-Flash-1017이고, 비용은 기본적으로 huggingface 조직에 청구됩니다. 조직이 청구를 거부하면 tmic은 개인 청구로 넘어가지 않고 멈춥니다. 내장 카탈로그에 이미 있는 모델이면 LLM 호출 자체가 없습니다. 클라우드 기준 출력 수집과 공개 단계는 huggingface-mic 조직 관리자용입니다.
아직 답하지 못한 질문들
2026년 11월 1일 기준으로 Transformers CI의 MIC 작업은 실패를 보고하지만 PR을 막지는 않습니다. 저장소의 11월 2일 기록으로는 이 작업이 아직 매 실행마다 fleet 데이터셋의 main을 읽고, Transformers가 PR #49802로 추가한 고정 파일 tests/contracts.lock은 아직 읽지 않습니다. PR을 막는 검사로 바꿀지는 저자들이 아직 측정하지 못한 세 가지에 달려 있습니다. 저장소는 이를 병합된 PR마다 매일 재생해 mic-impact Space에서 추적하고, 한 달 뒤 결정할 기준을 제안해 두었습니다.
- 재생 실험이 아닌 실제 PR에서 진짜 버그를 몇 건이나 잡는가
- 잘못된 경보로 사람을 얼마나 자주 헛걸음시키는가
- 기준 출력 검토에 일이 얼마나 드는가
Whisper 보조 디코딩 버그처럼 실제 가중치에서만 드러나는 버그가 얼마나 많은지, 과적합이 무작위 가중치가 놓치는 실제 버그를 잡는지도 아직 모릅니다. 모델 계열과 API 범위도 일부만 덮고 있습니다. 회귀가 빠져나가면 빠진 사용 경로를 추가하고 깨진 버전과 고친 버전에서 다시 실행하는 식으로 메우며, 기존 테스트는 그 범위가 확인될 때까지 유지합니다.
비용에 대한 기대치도 조정이 필요합니다. 저장소의 비용 측정에 따르면 이미 캐시된 작은 체크포인트에서는 fixture가 로컬 실행 시간을 거의 줄이지 못합니다. 프로세스 시작 시간이 대부분을 차지하기 때문입니다. 절감은 내려받기와 크기에서 나옵니다. fixture 가중치는 실제 가중치보다 10~1,300배 작고, 계약 8개를 한 프로세스에서 묶어 실행하면 Mac에서 4.9초로 프로세스당 하나씩 돌릴 때의 27.4초보다 짧습니다. 작성, 축소 규칙 수리, 기준 출력 검토 같은 사람의 비용은 아직 측정하지 않았다고 미해결 문제 문서는 적고 있습니다.
마지막으로 저자들은 원래 Hub 모델 페이지를 그 모델의 MIC와 연결하고 싶다고 말합니다. 그러면 체크포인트를 쓰는 개발자나 에이전트가 그 체크포인트, 환경, 기대 출력으로 검증된 예제에서 출발할 수 있습니다. 원문은 참여 방법도 안내합니다. coverage Space에서 아직 덮이지 않은 모델을 골라 tmic 흐름을 실행해 보고, 사용 경로를 기여하거나 생성된 계약을 검토하는 것입니다.
자기 모델이나 라이브러리를 Transformers에 통합해 본 분이라면, 지금 쓰는 테스트가 forward 통과 너머로 무엇을 확인하는지 댓글로 나눠 주셔도 좋겠습니다.
라이선스
transformers-mic 저장소는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
 Transformers Model Integration Contracts 소개 블로그
 transformers-mic GitHub 저장소
 huggingface-mic Hub 조직
더 읽어보기
-
vLLM에 rope_scaling을 실행 때 넘기면 인기 모델 180개 중 64개의 RoPE 밑이 조용히 바뀝니다 — 측정과 검사 라이브러리(entail)
-
Hugging Face Transformers, 이제 GGUF 가중치도 지원하여 바로 불러와 실행 가능 (feat. llama.cpp, ggml)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
