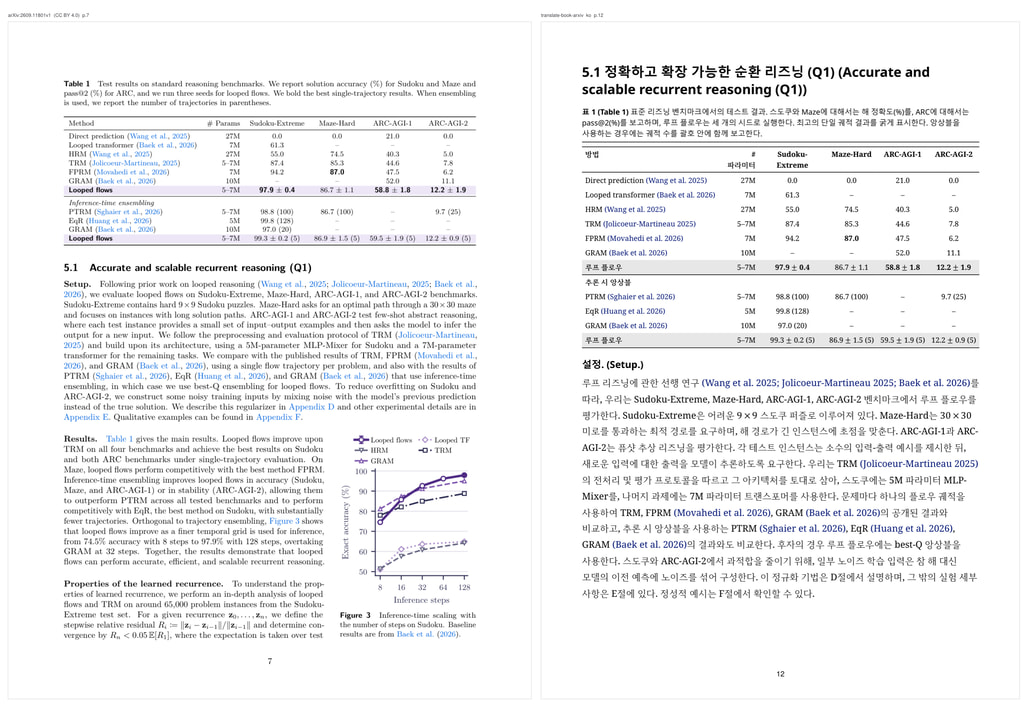
왼쪽: arXiv:2609.11801 "Thinking with Looped Flows" 원문 7쪽 (CC BY 4.0), 오른쪽: 이 스킬로 만든 한국어 번역본 12쪽의 같은 표입니다.
영어 논문을 번역기에 넣어 본 분들은 겪어보셨을텐데, 문장은 그럭저럭 나오는데 수식이 다 깨집니다.
기호가 흩어지고, 식 번호가 사라지고, 그림은 엉뚱한데 붙어 있고요.
결국 가독성이 떨어져서 그냥 원문을 읽게 되더라고요.
그래서 PDF를 번역하지 않고, arXiv에 올라와 있는 LaTeX 원본을 받아서 번역하도록 만들었습니다.
저자가 쓴 원고를 그대로 번역하는 셈이라, 결과물이 "번역된 글"이 아니라 "번역된 논문"으로 나옵니다.
절 구성과 번호, 수식과 식 번호, 표, 캡션이 달린 그림, 본문 인용과 참고문헌까지 원문 구조가 그대로 살아 있고, "식 (3) 참고", "그림 2" 같은 상호 참조들도 그대로 따라옵니다.
원문을 옆에 펴 놓고 봐도 같은 위치를 바로 찾아 읽을 수 있습니다.
쓰는 법
Claude Code 스킬이라 "이 논문 한국어로 번역해줘" 하면 됩니다.
결과물은 바로 인쇄할 수 있는 PDF, 그리고 EPUB, DOCX로 나옵니다.
한국어 말고 다른 언어도 지원되도록 해봤습니다.
- Anthropic 공식 플러그인 디렉터리에 올라가 있어서 claude.ai에서 "Translate Book: arXiv"로 바로 설치할 수 있습니다.
- 또는
npx skills add kcy4334-lgtm/translate-book-arxiv -a claude-code -g - Python, Pandoc, Calibre, Chrome(또는 Edge)이 필요합니다.
python scripts/doctor.py를 돌리면 빠진 게 뭔지 알려 줍니다.
신경 쓴 부분
논문을 여러 조각으로 나눠 동시에 번역하고, 조각끼리 용어집을 공유해, 예를 들어 앞장에서 "attention"을 "어텐션"이라 했다가 뒷장에서 "주의"라고 쓰는 일이 없도록 했습니다.
제일 신경 쓴 건 에러 없이 틀리는 경우입니다.
예를 들어 표에 "97.9 ± 0.4"의 ±가 조용히 빠져서 "97.9 0.4"로 찍혔는데, 클로드가 이를 오류가 없다고 판단해 지나가더라고요.
이런 경우를 잡기 위해 원문과 번역본을 대조하는 검사를 계속 늘려 왔습니다.
원래 deusyu/translate-book이라는 오픈소스를 포크해서 시작했고,
저는 arXiv LaTeX 원본으로 번역하는 경로와 결과를 검사하는 부분을 새로 만들었습니다.
그 밖에 번역 과정을 돕는 보조 에이전트들을 붙이고, 오류나 누락이 줄어들도록 테스트와 디버깅을 반복했습니다.
샘플 및 링크
CC BY 라이선스 논문 하나를 통째로 번역한 책입니다. 참고용으로 번역본 다운로드 링크 첨부하였습니다.
논문 전체를 여러 에이전트가 번역하다 보니 Claude 사용량이 좀 있는데, 이건 차차 줄여 볼 생각입니다.
연구실에서 논문 읽을 때 써 보시고, 깨지는 논문이 있으면 이슈로 알려주시면 감사하겠습니다!
