Xberg 소개
RAG 파이프라인이나 문서 처리 서비스를 만들 때 가장 먼저 부딪히는 벽은 모델이 아니라 입력입니다. PDF는 PyMuPDF로 열고, 워드 문서는 python-docx로 읽고, 스캔 이미지는 Tesseract에 넘기고, 압축 파일은 또 따로 풀어야 합니다. 여기에 표 구조 복원과 읽기 순서 정리까지 붙이면 라이브러리 대여섯 개를 엮은 파이프라인이 만들어집니다. 라이브러리마다 반환 형식과 예외 처리 방식이 달라서, 지원 포맷이 하나 늘 때마다 분기와 예외 처리도 같이 늘어납니다. 운영에 올린 뒤에는 특정 포맷에서만 실패하는 문서를 쫓아다니는 일이 반복됩니다.
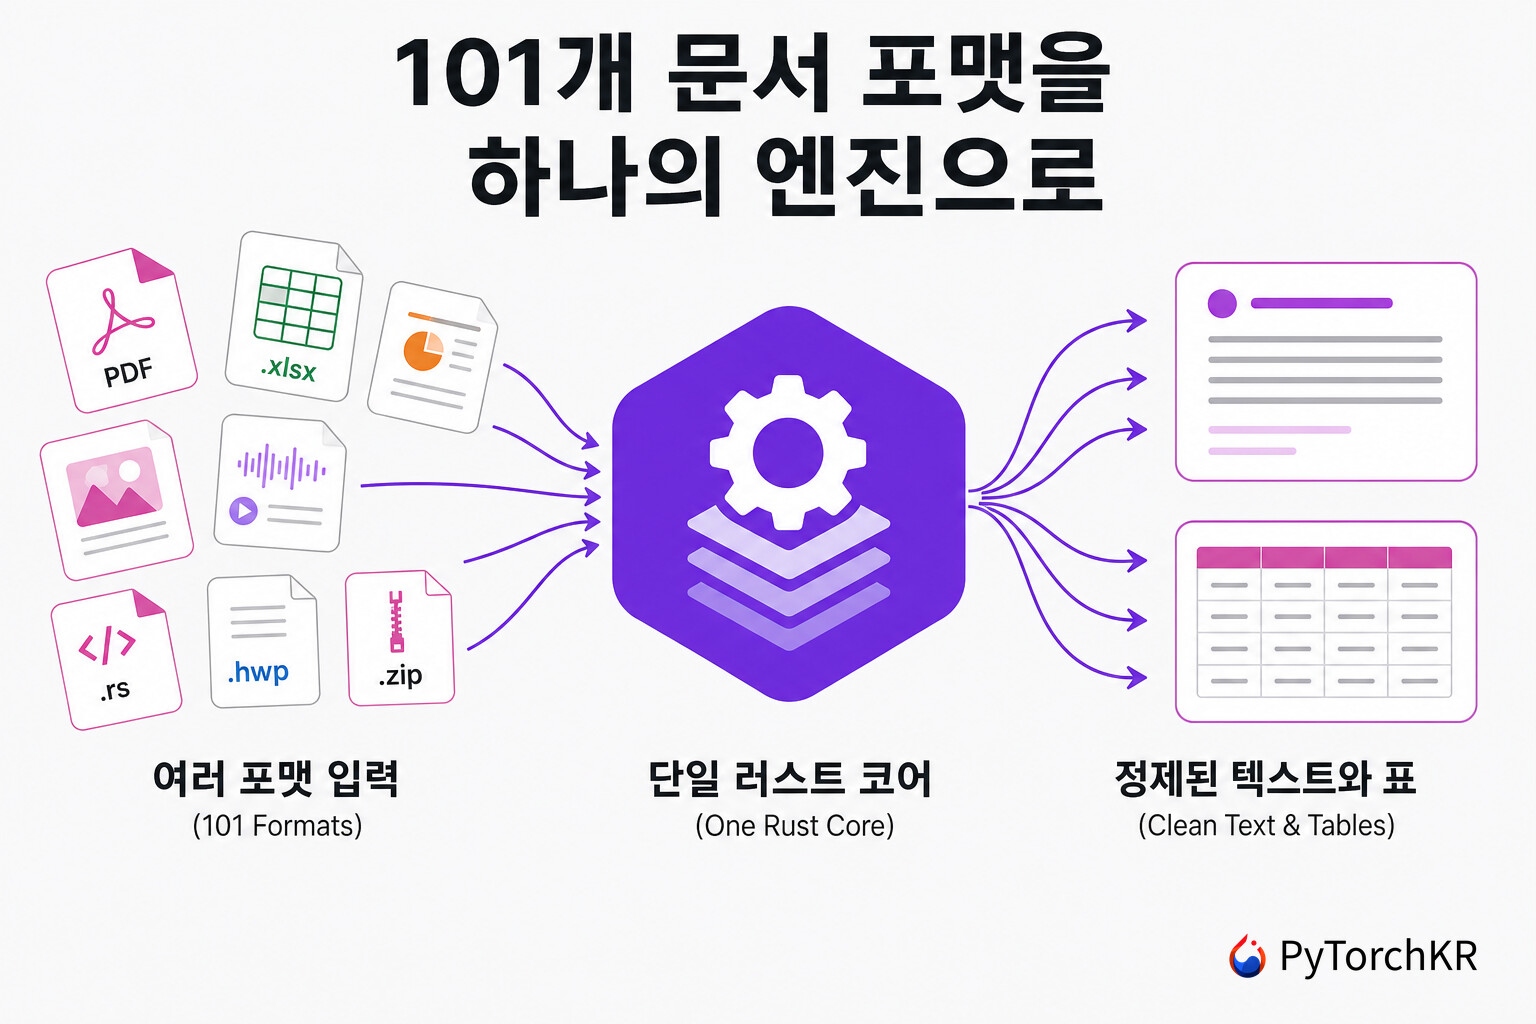
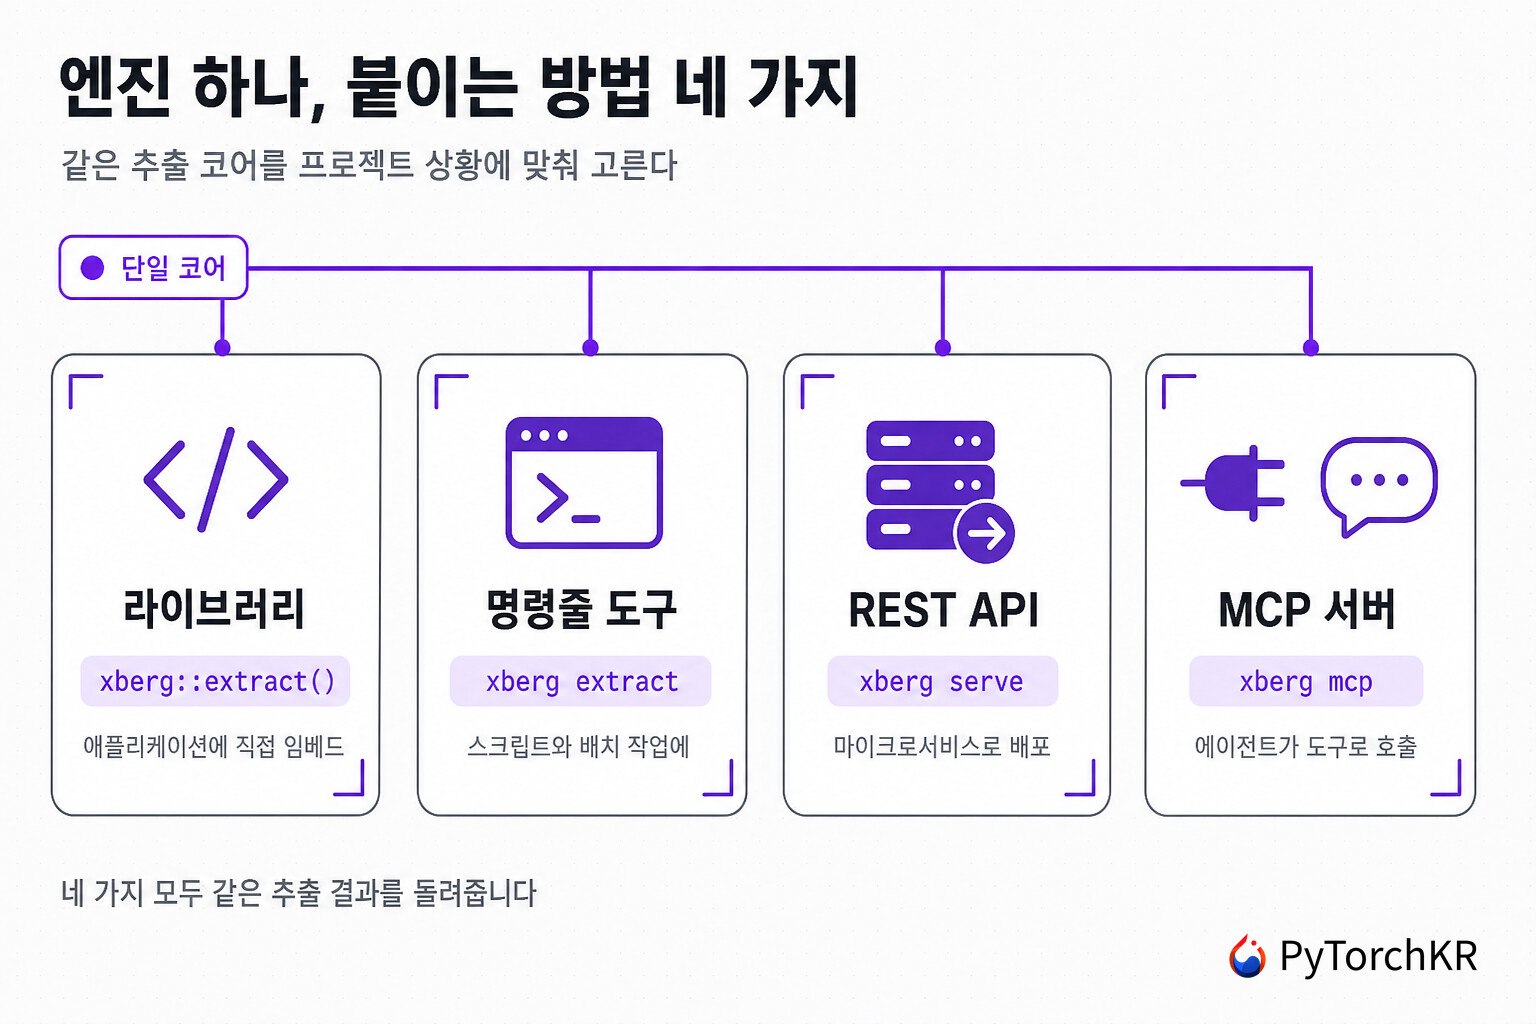
Xberg는 이 조립 작업을 엔진 하나로 대체하려는 문서 인텔리전스(Document Intelligence) 프레임워크입니다. Rust로 작성한 코어 하나가 포맷 감지, 읽기, OCR, 추출을 모두 담당하고, 그 위에 Python, Node.js, Go, Java, C#, Ruby, PHP, Elixir 등 15개 언어 바인딩이 얹혀 있습니다. 프로젝트는 자신을 "Point Xberg at anything — a PDF, a scanned image, a spreadsheet, an audio file, a URL, a whole archive, or a source tree — and get back clean text, tables, metadata, and structured data" 라는 문장으로 소개합니다. 같은 코어를 라이브러리로 임베드할 수도, 명령줄 도구나 REST API 서버로 띄울 수도, MCP 서버로 에이전트에 붙일 수도 있습니다. 개발사인 Kreuzberg, Inc.는 기존 프로젝트인 Kreuzberg를 다시 만들어 v1 계열로 재출시한 것이 Xberg라고 밝히고 있습니다.
지원 범위는 101개 포맷, 파일 확장자 기준으로는 115개입니다. 오피스 문서와 PDF, 이미지, HTML, 이메일, 전자책, 학술 문서, 구조화 데이터가 여기에 들어가고, 출력은 일반 텍스트, 마크다운, Djot, HTML, JSON 트리, 그리고 OCR 메타데이터와 바운딩 박스를 포함한 Structured 형식까지 6가지 중에서 고를 수 있습니다. 국내 사용자에게 눈에 띄는 부분은 한글 문서 포맷인 .hwp 와 .hwpx 가 지원 목록에 포함되어 있다는 점입니다. 코드 저장소를 통째로 넘기면 tree-sitter 기반으로 371개 프로그래밍 언어에서 함수, 클래스, import, 심볼, 독스트링을 뽑아내고 구문 경계를 따라 청크를 나눠 주기도 합니다. 최신 릴리즈는 2026년 8월 4일에 나온 v1.0.14 입니다.
Xberg가 기존 문서 파싱 도구와 다른 점
문서 추출 도구는 이미 여럿 있습니다. Microsoft의 MarkItDown, IBM의 Docling, Unstructured, MinerU, PyMuPDF4LLM 같은 도구들이 각자의 방식으로 같은 문제를 풀고 있습니다. 이들 대부분은 Python 생태계에서 출발했고, 레이아웃 분석에 딥러닝 모델을 적극적으로 쓰는 쪽일수록 정확도는 올라가지만 기동 시간과 메모리 사용량도 함께 올라갑니다.
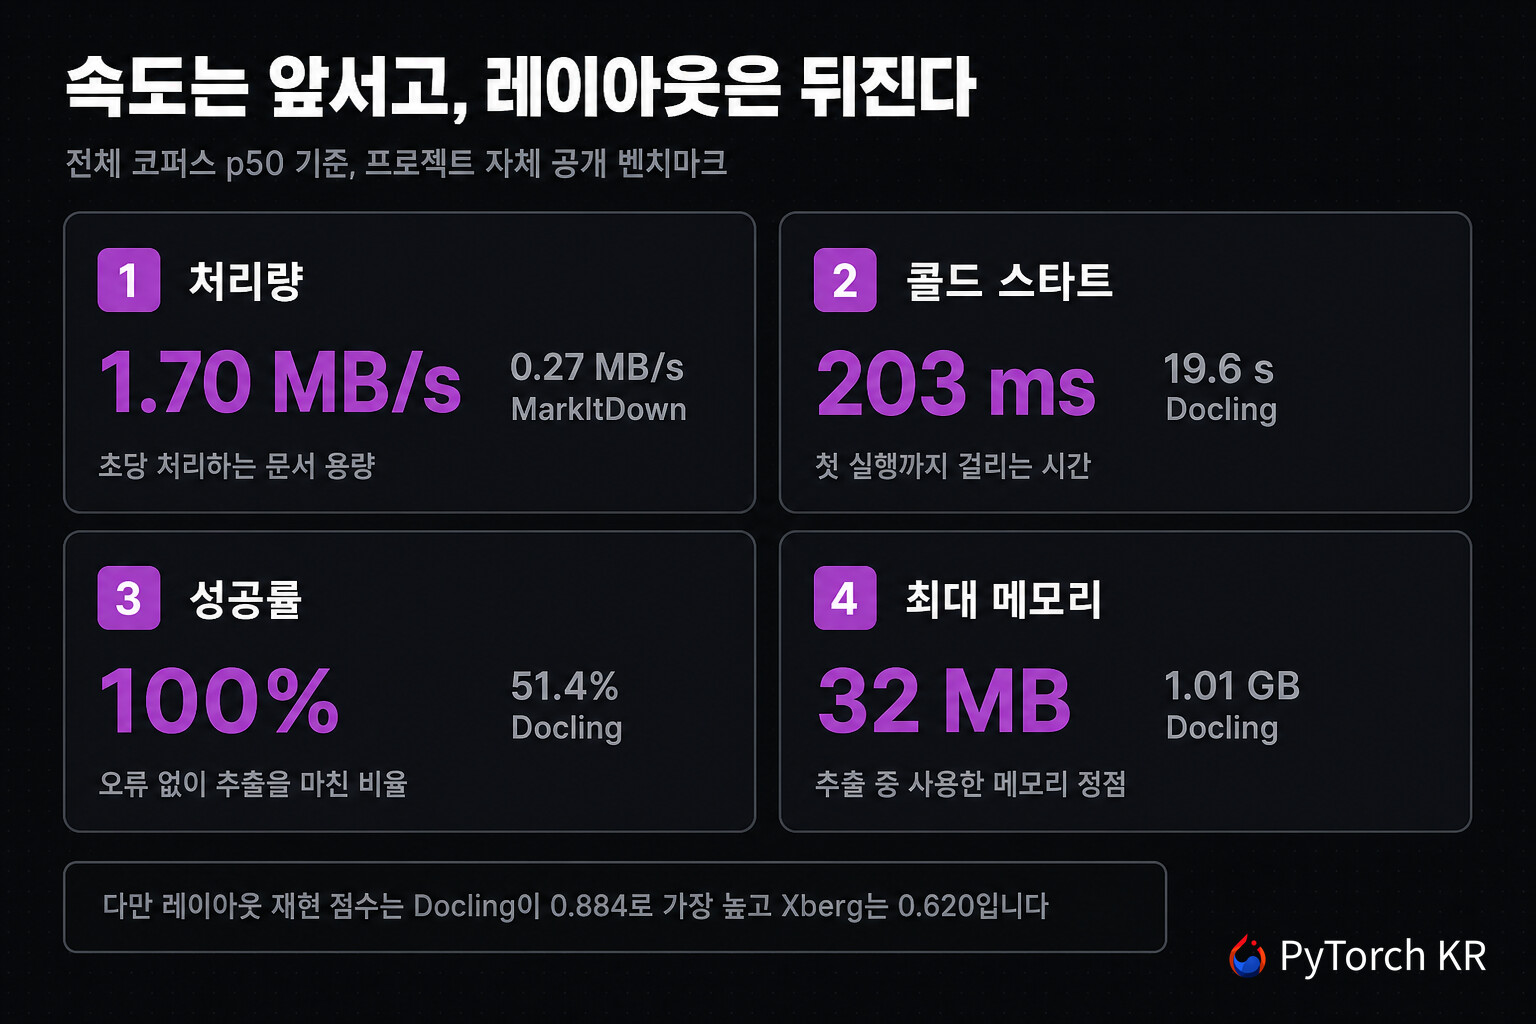
Xberg 측은 벤치마크 페이지에서 전체 코퍼스 기준 p50 수치를 공개하고 있습니다. 아래 표는 그 페이지의 종합 보드를 옮긴 것으로, 마크다운 출력 모드에서 측정한 값입니다.
| 도구 | 처리량 | 콜드 스타트 | 성공률 | 최대 메모리 | 레이아웃 점수(SF1) |
|---|---|---|---|---|---|
| Xberg | 1.70 MB/s | 203 ms | 100.0% | 32 MB | 0.620 |
| LiteParse | 0.10 MB/s | 206 ms | 100.0% | 68 MB | 0.415 |
| MarkItDown | 0.27 MB/s | 4.0 s | 97.5% | 187 MB | 0.495 |
| Unstructured | 0.01 MB/s | 3.2 s | 92.9% | 303 MB | 0.651 |
| Docling | 0.09 MB/s | 19.6 s | 51.4% | 1.01 GB | 0.884 |
| MinerU | 0.00 MB/s | 62.8 s | 45.5% | 3.59 GB | 0.618 |
수치가 한쪽으로만 기울어져 있지는 않습니다. 처리량, 콜드 스타트, 성공률, 메모리에서는 Xberg가 앞서지만, 텍스트 정확도(TF1)는 Docling과 MarkItDown이 1.000으로 만점이고 Xberg는 0.982 입니다. 문서의 레이아웃을 얼마나 충실히 재현하는지 보는 SF1에서는 Docling이 0.884로 가장 높고 Xberg는 0.620에 머무릅니다. 즉 이 벤치마크가 보여주는 것은 "모든 면에서 더 낫다"가 아니라, 레이아웃 재현 정밀도를 일부 내주고 속도와 안정성을 크게 가져갔다는 교환 관계입니다. 성공률 100%와 51.4%의 차이도 눈여겨볼 만합니다 — 전체 코퍼스 중 절반 가까이에서 추출을 끝내지 못하는 도구는 정확도가 높아도 파이프라인에 넣기 어렵습니다.
한 가지 감안할 점은 이 수치가 제3자 평가가 아니라 프로젝트가 직접 공개한 벤치마크라는 것입니다. 측정 조건은 단일 파일 모드, OCR 끄기, 동일 하드웨어이고, 115개 지원 포맷 중 52개에 대해서만 도구 간 직접 비교 데이터가 있다고 페이지에 명시되어 있습니다. 실제 도입 전에는 자신의 문서 집합으로 다시 재보는 편이 안전합니다.
Xberg는 누구에게 유용한가
이미 특정 포맷 한두 가지만 다루는 안정된 파이프라인이 있다면 굳이 교체할 이유는 크지 않습니다. PDF만 처리하면 되는데 101개 포맷 엔진을 들이는 것은 과합니다. 반대로 사용자가 무엇을 업로드할지 예측할 수 없는 서비스, 사내 문서 저장소처럼 포맷이 뒤섞인 데이터를 한 번에 훑어야 하는 작업, 그리고 워커를 여러 개 띄워 대량 배치를 도는 인제스션 파이프라인에서는 콜드 스타트 203ms와 최대 메모리 32MB라는 수치가 그대로 비용 차이로 이어집니다. .hwp 가 섞인 국내 문서 아카이브를 다뤄야 하는 경우도 후보에 들어갑니다.
레이아웃 재현 정밀도가 결과 품질을 좌우하는 작업, 예컨대 복잡한 표가 빽빽한 재무 보고서나 다단 조판 논문을 다룬다면 SF1 점수 차이를 먼저 확인해야 합니다. 이 영역에서는 Docling 쪽이 더 나은 선택일 수 있습니다.
Xberg의 추출 파이프라인과 주요 기능
Xberg의 처리 흐름은 입력 종류를 가리지 않고 하나로 모입니다. 파일 경로, http(s) URL, 표준 입력 중 무엇을 주든 MIME 타입을 자동으로 감지하고, 수 GB 단위 파일은 스트리밍으로 읽습니다. 압축 파일은 안에 든 문서를 재귀적으로 풀어 처리하되 zip 폭탄, 압축률, 중첩 깊이 제한으로 방어합니다. URL을 넘기면 crawlberg 엔진이 문서 하나만 가져올지 링크를 따라가며 크롤링할지 모드에 따라 처리합니다.
스캔 문서와 표를 다루는 방식
텍스트 레이어가 없는 스캔 문서에는 OCR이 붙습니다. 백엔드로 Tesseract, PaddleOCR, Candle, 그리고 비전 모델(VLM)을 고를 수 있고, 하나가 실패하면 다음으로 넘어가는 폴백 체인과 신뢰도 점수, 언어 자동 감지를 제공합니다. 표와 읽기 순서는 별도의 머신러닝 모델이 맡습니다. 레이아웃 분석에는 PP-DocLayout-V3와 RT-DETR을, 표 구조 복원에는 TATR과 SLANet을 사용해 셀 격자를 되살린 뒤 마크다운으로 내보냅니다.
검색과 후처리
추출한 텍스트를 그대로 벡터 DB에 넣을 수 있도록 임베딩까지 엔진 안에 들어 있습니다. 로컬 ONNX 런타임으로 384, 768, 1024 차원 모델을 돌리거나 liter-llm 통합으로 165개 제공자의 호스팅 모델을 쓸 수 있고, 교차 인코더(cross-encoder) 기반 재순위화(reranking)도 지원합니다. 후처리 쪽에는 개체명 인식(NER), YAKE와 RAKE 키워드 추출, 요약, 번역, 개인정보 마스킹, 페이지 분류, QR 코드 검출, 언어 감지가 들어 있습니다. 토큰을 줄이는 TOON 형식도 있는데, 프로젝트는 이 형식이 JSON보다 토큰을 30~50% 줄여 준다고 설명합니다.
스키마를 주면 문서에서 바로 구조화된 JSON을 뽑는 기능도 있습니다. 로컬에서는 Ollama, LM Studio, vLLM을 쓰고 원격으로는 OpenAI, Anthropic, Google을 비롯한 제공자를 연결합니다.
한 가지 주의할 점은 이 기능들이 전부 기본 활성화는 아니라는 것입니다. URL 인제스션, 음성 전사, 재순위화, 레이아웃 분석은 코어 크레이트의 Cargo 기능 플래그(url-ingestion, transcription, reranker, 레이아웃/ORT)로 갈라져 있습니다. 미리 빌드된 언어 패키지와 Docker 이미지는 흔히 쓰는 조합을 묶어 배포하지만, 소스에서 직접 빌드하면 선택한 것만 켜집니다.
Xberg 설치 및 사용 방법
각 언어 생태계의 패키지 관리자로 설치합니다.
pip install xberg                    # Python
npm install @xberg-io/xberg          # Node.js / TypeScript
cargo add xberg                      # Rust
brew install xberg-io/tap/xberg      # CLI 도구
Go 패키지는 저장소 루트가 Go 모듈이 아니어서 go get github.com/xberg-io/xberg 가 실패합니다. go get github.com/xberg-io/xberg/packages/go@latest 처럼 하위 디렉토리를 지정해야 합니다.
Rust에서 문서 하나를 추출하는 최소 예시는 다음과 같습니다.
use xberg::{extract, ExtractInput, ExtractionConfig};

#[tokio::main]
async fn main() -> xberg::Result<()> {
    let config = ExtractionConfig::default();
    let output = extract(
        ExtractInput::from_uri("document.pdf"),
        &config
    ).await?;

    println!("{}", output.results[0].content);
    Ok(())
}
CLI는 extract, batch, detect, formats, version, cache, serve, mcp, api, embed, chunk, completions 12개 명령을 제공합니다. REST API 서버는 xberg serve --host 0.0.0.0 --port 8000 으로 띄우면 하나의 POST 엔드포인트가 모든 포맷을 받아 JSON이나 마크다운을 돌려줍니다.
에이전트에 붙일 때는 MCP 서버 모드를 씁니다. 추출과 배치 추출, MIME 타입 감지, 캐시 관리 등 9개 도구와 3개 프롬프트, 4개 리소스를 노출합니다. Claude Desktop이나 Cursor에는 다음 설정을 추가합니다.
{
  "mcpServers": {
    "xberg": { "command": "xberg", "args": ["mcp"] }
  }
}
Docker 이미지(ghcr.io/xberg-io/xberg)와 Helm 차트도 제공되며, 프로젝트는 이 모든 모드가 GPU 없이 동작한다고 밝히고 있습니다. 브라우저에서 바로 시험해 볼 수 있는 WASM 데모도 문서 사이트에 올라와 있습니다.
Xberg의 라이선스
Xberg는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 저작권 표기는 Kreuzberg, Inc.로 되어 있습니다.
 Xberg 브라우저 데모
 Xberg 공식 홈페이지
 Xberg 문서 사이트
 Xberg 벤치마크 결과
 Xberg 프로젝트 GitHub 저장소
 Xberg Hugging Face 페이지
더 읽어보기
-
pdf-inspector: OCR 없이 PDF를 분류하고 마크다운으로 추출하는 Rust 라이브러리 (feat. firecrawl)
-
MarkItDown, Microsoft가 공개한 PDF, 이미지 및 오피스 문서 👉 Markdown 변환 도구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 도구를 직접 설치해 사용해보셨다면,  파이토치 한국 사용자 모임
 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
