PyTorchKR


 에이전트 실행 환경(Harness)의 자동 진화 및 명시적 상태 관리: 이번 주 선정된 논문들에서는 AI 에이전트의 능력을 극대화하기 위해 모델 자체뿐만 아니라 실행 환경인 하네스(Harness) 를 고도화하는 연구가 두드러졌습니다. Harness^2 와 Harmony Harness는 단일 목표 최적화를 넘어 다양한 환경에 적응할 수 있도록 하네스를 다중 목표로 스스로 진화시키는 방법론을 제안했습니다. 또한 LongHarness는 무한 탐색이나 상태 표류 문제를 방지하기 위해 획득한 증거와 결론의 상호작용을 명시적으로 관리하는 상태 기반 아키텍처를 선보였습니다. 이는 에이전트가 복잡한 작업을 수행할 때 발생하는 혼란을 시스템적으로 통제하고, 자율적인 성능 향상을 이끌어내기 위한 필수적인 발전 방향입니다.
 개방형 환경에서의 장기 작업(Long-horizon) 수행 및 자율성 확보: 사전에 정의된 짧은 작업을 넘어, 예측 불가능한 환경에서 장기간 자율적으로 목표를 달성하려는 에이전트 연구들도 핵심 트렌드입니다. 마인크래프트에서 엔더 드래곤을 물리친 Gemini 4 Argon 연구는 여러 에이전트가 사전 스크립트 없이 수천 개의 프로그램을 작성하고 협력하며 장기 계획을 완수할 수 있음을 증명했습니다. 구글의 Google Earth AI GRA는 복잡한 지리공간 분석을 다단계 워크플로우로 분해하여 스스로 계획하고 실행하며, VEPA는 이러한 자율적 에이전트가 돌이킬 수 없는 실수를 하지 않도록 형식적이고 동적으로 진화하는 안전 가드레일을 구축했습니다. 이는 AI가 통제된 실험실을 벗어나 실제 산업과 소프트웨어 공학 현장에 투입될 수 있는 강력한 자율성을 확보하고 있음을 시사합니다.
 자기회귀(Autoregressive) 생성의 한계 극복 및 아키텍처 효율화: 세 번째 트렌드는 기존 대규모 언어 모델이 가진 느린 순차적 생성 방식의 비효율성을 극복하고 구조적 효율성을 높이려는 아키텍처 혁신입니다. VideoJev는 느린 텍스트 생성 대신 비디오 증거를 직접 점수화하는 시스템 원(System One) 패러다임을 도입해 추론 속도를 100배 이상 비약적으로 향상시켰습니다. 또한 DiscoLoop은 단일 순전파 내에서 다단계 추론을 수행할 수 있도록 이산 임베딩과 연속 은닉 상태를 결합한 루프 구조를 제안했으며, PixSearch와 시맨틱 ID(Semantic ID) 기반 추천 모델 연구는 각각 검색 영역과 다중 토큰 예측(MTP)을 생성 과정에 긴밀하게 통합하여 지연 시간을 크게 줄였습니다. 이러한 시도들은 단순한 모델 크기 경쟁을 넘어, 실제 서비스 환경에 적용 가능한 효율적이고 빠른 추론 구조를 설계하려는 실용적인 움직임입니다.
논문별 핵심 내용 간략 요약
-
개방형 환경을 위한 재귀적 에이전트 하네스 (Harness^2): 정답 검증기가 없는 개방형 환경에서 에이전트의 실행 환경(하네스)을 태스크 수준과 하네스 수준의 두 가지 재귀적 단계를 통해 지속적으로 자가 개선하여, 새로운 시나리오에 대한 적응력과 일반화 성능을 높인 프레임워크를 제안했습니다.
-
다중 에이전트 협력을 통한 마인크래프트 정복 (Gemini 4 Argon): 네 명의 AI 에이전트가 사전 설정된 역할이나 게임 전용 도구 없이 자율적으로 수천 개의 프로그램을 작성하고 협력하여 27시간 만에 마인크래프트의 최종 목표(엔더 드래곤)를 달성한 장기 작업 수행 사례를 보여줍니다.
-
시맨틱 ID 기반 개인화 추천에서의 생성 패러다임 비교: 개인화 추천 시스템에서 시맨틱 ID를 생성할 때 기존의 자기회귀 빔 탐색 방식이 다중 토큰 예측(MTP) 방식보다 정확도 등 주요 성능 지표에서 우수함을 입증하고, MTP의 단점을 보완할 새로운 보조 순위 손실 함수를 도입했습니다.
-
다중 홉 추론을 위한 혼합 채널 루프 아키텍처 (DiscoLoop): 단일 순전파 내에서 복잡한 다단계 추론을 수행할 때 발생하는 깊이-국소적 저장소 문제를 해결하기 위해, 이산 임베딩과 연속 은닉 상태를 결합하여 메모리 활용도와 일반화 성능을 극대화한 루프형 트랜스포머 구조를 제시했습니다.
-
영역 기반 검색을 통합한 종단간 멀티모달 모델 (PixSearch): 시각적 그라운딩과 검색 증강 추론을 자기회귀 생성 과정에 하나로 통합하여, 자아 중심 이미지에서 나타나는 희귀한 객체에 대한 질의응답 성능을 대폭 향상시키고 추론 지연 시간을 크게 단축했습니다.
-
지리공간 추론 에이전트 구축 및 체계적 평가 (Google Earth AI GRA): 복잡한 지리공간 분석 질문을 다단계 워크플로우로 분해하여 처리하는 모듈식 에이전트 시스템을 구축하고, 개방형 문제 해결 능력을 체계적으로 검증하기 위해 실제 전문가 사용 사례에 기반한 새로운 벤치마크들을 도입했습니다.
-
다목적 에이전트 하네스의 구성적 자기진화 (Harmony Harness): 하네스 진화를 다중 목표 최적화 문제로 재정의하여, 상충하는 여러 성능 목표를 동시에 고려하면서도 벤치마크 특화 적응과 범용 메커니즘을 효과적으로 분리하여 발전시키는 진화 탐색 프레임워크를 제안했습니다.
-
상태 기반 증거 관리를 통한 대규모 코퍼스 추론 (LongHarness): 에이전트가 1억 토큰 규모의 방대한 문서에서 증거를 수집할 때 발생하는 무한 탐색과 정보 표류 문제를 방지하기 위해, 획득한 증거와 결론의 상호작용을 명시적으로 추적하고 생명주기를 관리하는 메커니즘을 도입했습니다.
-
LLM 에이전트를 위한 검증된 형식적 정책 진화 (VEPA): 에이전트가 배포 환경에서 새롭게 직면하는 위험에 동적으로 적응할 수 있도록, LLM이 제안한 안전 정책 패치를 결정론적 검증기와 증거 기반 권한 계층을 통해 평가하여 안전하게 적용하는 동적 가드레일 구조를 제시했습니다.
-
비디오 이해를 위한 시스템 원 모델 (VideoJev): 시간이 오래 걸리는 순차적 텍스트 생성 대신 시간 간격과 선택지를 비디오 증거에 직접 점수화하는 의사결정 방식을 도입하여, 다중선택 비디오 질의응답 및 시간적 그라운딩 작업에서 100배 이상의 추론 속도 향상을 달성했습니다.
하네스²: 오픈 월드를 위한 재귀적 에이전트 하네싱 / Harness^2: Recursive Agent Harnessing for an Open World
논문 소개
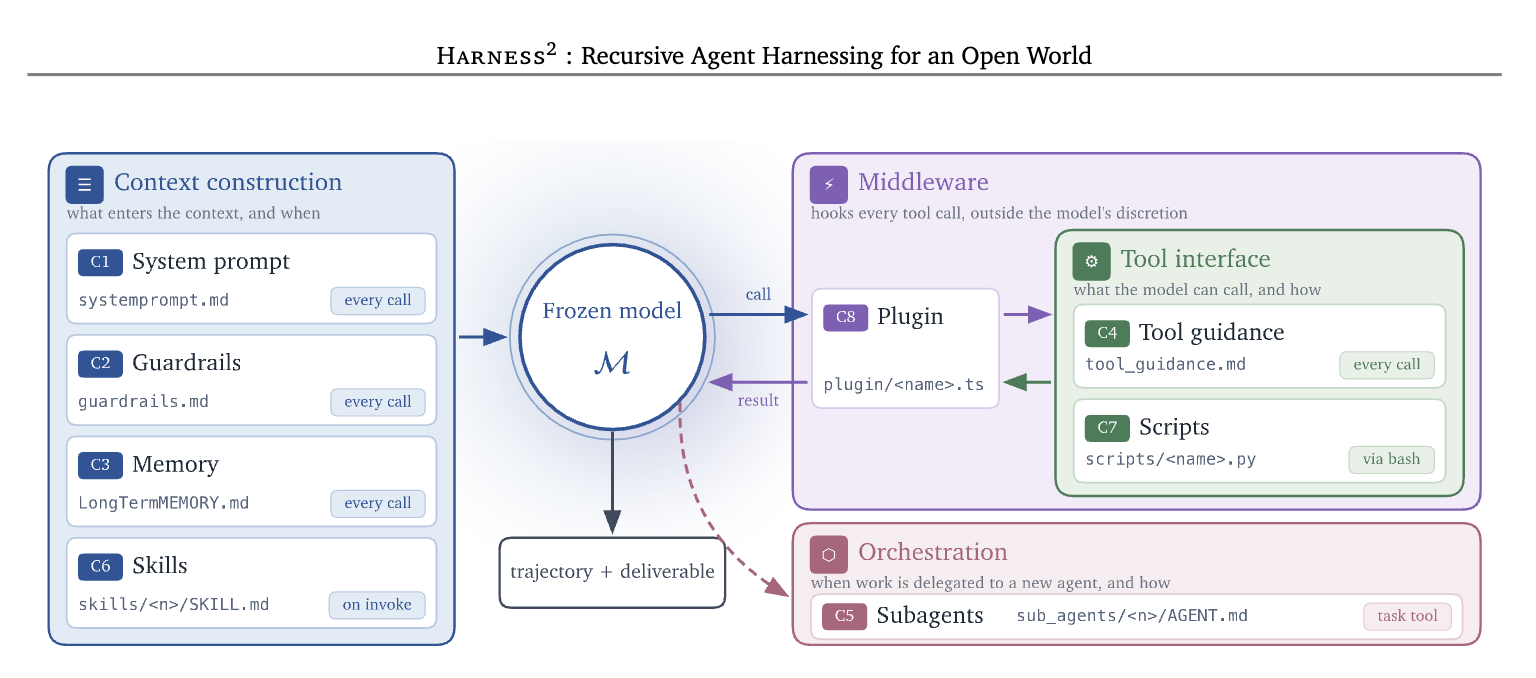
대규모 언어 모델(LLM) 기반 에이전트의 실제 성능은 기본이 되는 모델의 능력만으로는 결정되지 않으며, 에이전트의 실행을 관리하고 제어하는 하네스라는 구조적 요소가 동등하게 중요한 역할을 수행합니다. 재귀적 자기개선(RSI)이라는 개념은 이러한 하네스를 자동으로 진화시켜 에이전트의 성능을 점진적으로 향상시킬 수 있는 가능성을 제시하고 있으나, 실제 개방형 환경에 이를 적용할 때는 해결해야 할 두 가지 근본적인 문제가 존재합니다. 첫째, 테스트 시점에 처음 만나는 새로운 작업들에 대해서는 하네스를 안내할 수 있는 정답 기반 검증자가 존재하지 않으며, 둘째, 기존의 RSI 과정은 특정 작업에 지나치게 의존하는 나머지 새로운 상황으로의 일반화에 실패하는 경향을 보입니다. 이러한 도전에 대응하기 위해 Harness^2는 두 개의 상호 연결된 재귀 수준을 통해 문제를 해결하는 플러그 앤 플레이 방식의 프레임워크를 제시합니다. 첫 번째 수준인 작업 수준 재귀는 제안-탐사-구성(Propose-Probe-Compose)이라는 대조 학습 절차를 활용하여 현재 작업의 하네스를 정제하며, 이 과정은 정답 검증자 없이도 신뢰성 있는 하네스 편집을 가능하게 합니다. 두 번째 수준인 하네싱 수준 재귀는 이러한 편집 과정에서 얻어진 경험을 추출하여 지속적 개선 하네스를 업데이트함으로써, 에이전트가 미래의 작업에 더욱 효과적으로 적응할 수 있게 합니다. WorkBuddy-Bench, JobBench, LAB 등 세 개의 전문 벤치마크에서 평가된 결과, 단 한 번의 개선 단계만으로도 GLM-5와 Gemini 3.5 Flash 모두에 대해 기본 하네스 대비 일관된 성능 향상을 달성했으며, WorkBuddy-Bench에서 최대 11.5점, JobBench에서 4.5점, LAB에서 11.8 퍼센트 포인트의 향상을 보여주었습니다. 이러한 성과는 작업 수준 재귀의 예산을 증가시킬수록 추가적인 개선이 가능함을 시사하며, 개방형 환경에서도 적용 가능한 일반화된 하네스 개선 방법론의 실현 가능성을 입증합니다.
초록(Abstract)
LLM 에이전트의 능력은 기반 모델뿐만 아니라 실행 하네스에도 의존한다. 재귀적 자기개선(RSI)은 이러한 하네스를 자동으로 진화시키는 유망한 접근 방식을 제공한다. 그러나 개방형 환경에서 RSI를 배포하는 것은 여전히 두 가지 중요한 과제에 직면하고 있다. 첫째, 개방형 태스크는 하네스 설계 단계에서 일반적으로 예상하지 못한 것이며 테스트 시간에 새로운 것이므로, 온라인 하네스 편집을 안정적으로 지도할 정답 검증기가 없다. 둘째, RSI 프로세스는 여전히 매우 태스크 특화적이며 새로운 시나리오로 일반화하는 데 실패한다. 우리는 두 개의 연결된 재귀 수준을 통해 이러한 과제를 해결하는 플러그 앤 플레이 재귀적 에이전트 하네싱 프레임워크인 Harness^2를 소개한다. 태스크 수준의 재귀는 정답 검증기 없이 편집을 안정적으로 지도하는 대조적 제안-탐색-구성 스텝을 사용하여 현재 태스크의 하네스를 정제하며, 병렬 또는 순차 재귀를 통해 추가로 확장할 수 있다. 하네싱 수준의 재귀는 이러한 편집에서 경험을 추출하여 지속적 개선 하네스를 업데이트하며, 에이전트가 향후 태스크에 더 잘 적응할 수 있도록 한다. 세 가지 전문 벤치마크와 네 가지 모델-하네스 구성에서 단일 스텝은 GLM-5와 Gemini 3.5 Flash를 기본 하네스에 비해 일관되게 개선하여, WorkBuddy-Bench에서 최대 11.5포인트, JobBench에서 4.5포인트, LAB에서 11.8 포인트의 이득을 달성했으며, 태스크 수준의 재귀 예산이 증가함에 따라 추가적인 성능 향상을 보인다.
LLM agents' capabilities depend not only on their underlying models but also on their execution harnesses. Recursive self-improvement (RSI) offers a promising approach to automatically evolve these harnesses. However, deploying RSI in open-world settings still faces two critical challenges. First, open-world tasks are typically unseen during the harness design phase and novel at test time, leaving no ground-truth verifiers to reliably guide online harness edits. Second, the RSI process remains highly task-specific and fails to generalize to novel scenarios. We introduce Harness^2, a plug-and-play, recursive agent harnessing framework that addresses these challenges through two connected levels of recursion. Task-level recursion refines the current task's harness using a contrastive Propose-Probe-Compose step that reliably guides edits without ground-truth verifiers, and can be scaled further via parallel or sequential recursion. Harnessing-level recursion then extracts experience from these edits to update a continual improvement harness, enabling the agent to better adapt to future tasks. Across three professional benchmarks and four model-harness configurations, a single step consistently improves GLM-5 and Gemini 3.5 Flash over their base harnesses, yielding gains of up to 11.5 points on WorkBuddy-Bench, 4.5 points on JobBench, and 11.8 percentage points on LAB, with further gains as the task-level recursion budget increases.
논문 링크
더 읽어보기
마인크래프트를 정복한 Gemini 4 Argon 에이전트 팀 / A team of Gemini 4 Argon agents beats Minecraft
논문 소개
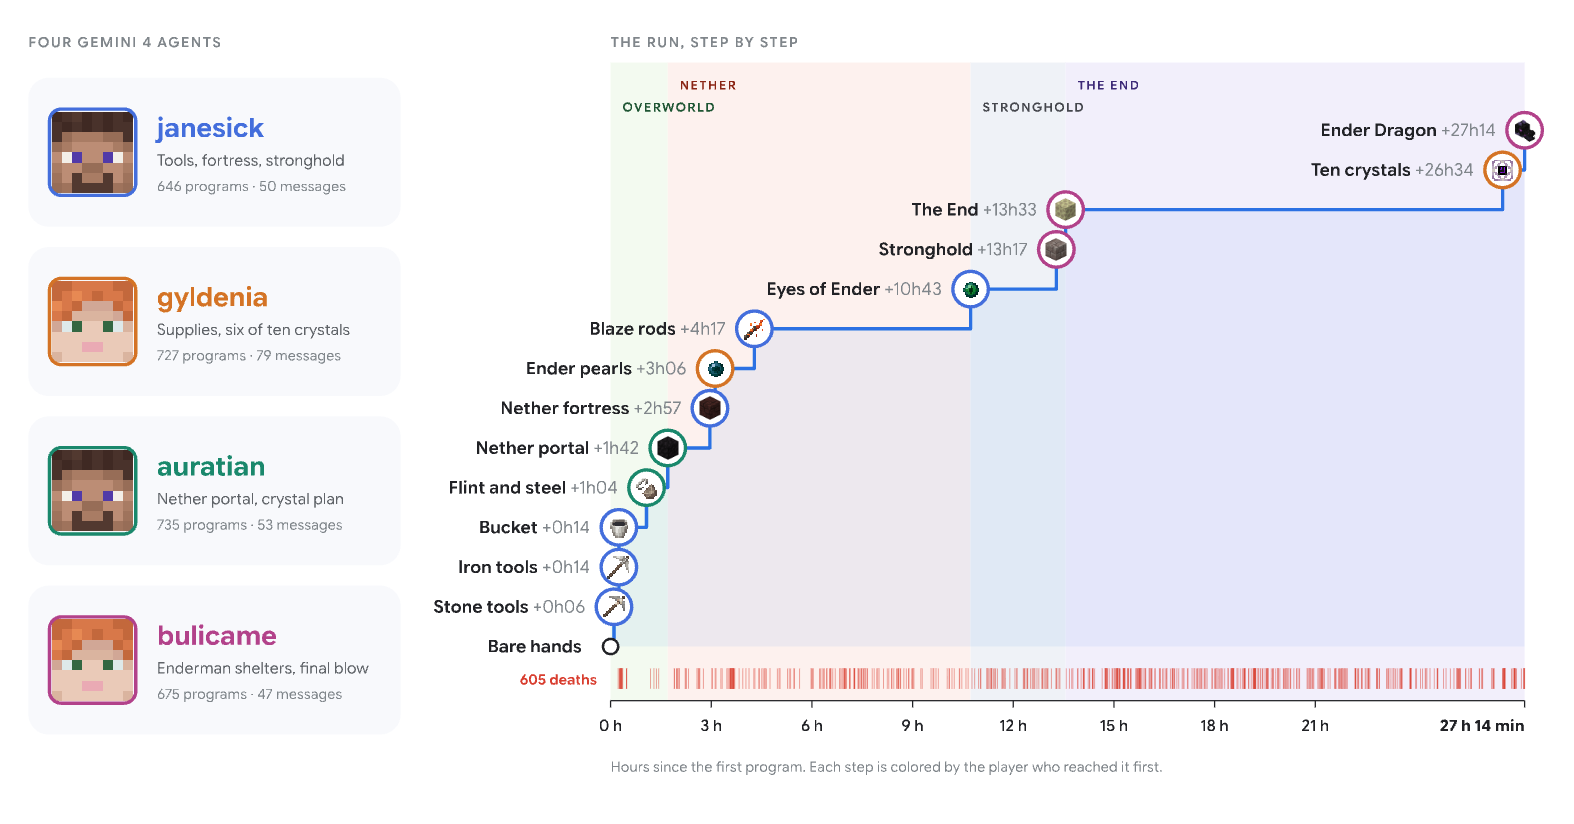
복잡한 장기 과제에서 인공지능 에이전트가 계획을 유지하고, 실행 과정에서 발생하는 실패에 대응하며, 다른 에이전트와 협력할 수 있는지는 중요한 연구 과제입니다. 이를 살펴보기 위해 연구진은 네 개의 Gemini 4 Argon 에이전트를 샌드박스형 마인크래프트 생존 세계에 배치하고, 엔더 드래곤을 물리치는 단일 목표를 부여했습니다. 각 에이전트는 오픈소스 라이브러리인 Mineflayer를 통해 게임 속 플레이어를 제어했으며, 게임 내 채팅과 공유 메모리를 사용해 동료와 정보를 주고받았습니다. 연구진은 역할을 미리 배정하거나 게임 로직을 작성하지 않고, 에이전트가 필요한 프로그램을 직접 계획하고 작성하며 디버깅하도록 했습니다. 따라서 이 접근법은 정해진 행동 순서를 따르는 자동화보다, 목표를 향해 필요한 도구와 실행 절차를 스스로 구성하는 자율적 문제 해결에 초점을 둡니다.
에이전트 팀은 무작위로 생성된 이지 난이도 세계에서 2,783개의 프로그램을 작성하고, 27시간 14분 동안의 실행 끝에 엔더 드래곤을 물리쳤습니다. 이 과정에서 605번 사망했지만, 실패를 과제 종료로 받아들이는 대신 진행 상황을 복구하고 서로의 아이템을 회수하며 목표를 이어갔습니다. 장시간에 걸친 성공은 자원 수집, 장비 마련, 이동과 전투처럼 서로 의존하는 여러 단계를 하나의 일관된 계획으로 연결해야 했다는 점에서 의미가 있습니다. 또한 역할을 사전에 고정하지 않은 상태에서도 팀이 작업을 나누고, 새롭게 알게 된 정보를 공유하며, 동료의 손실을 보완하는 협력 전략을 활용했습니다. 연구진은 실행을 실시간 대시보드로 관찰하고 중단할 수 있었지만, 과제 수행에 직접 개입하지 않았다고 보고합니다.
이 결과의 핵심 기여는 사람이 미리 탐색한 게임 세계나 별도의 게임 전용 도구에 의존하지 않고, 표준 Mineflayer 라이브러리만으로 여러 에이전트가 마인크래프트의 최종 목표를 자율적으로 완수한 사례를 제시했다는 데 있습니다. 특히 수천 개의 프로그램 작성과 하루가 넘는 실행을 통해, 장기 계획의 지속성뿐 아니라 코드 생성·검증·수정과 다중 에이전트 조정이 함께 요구되는 상황을 보여줍니다. 이러한 역량은 마인크래프트에 국한되지 않고, 여러 단계의 구현과 협업이 필요한 소프트웨어 엔지니어링 및 기업 업무 자동화에도 연결될 수 있습니다. 다만 단일 실행의 성공이 다양한 세계와 조건에서 같은 성능을 보장하는 것은 아니며, 논문 역시 결과의 한계와 수행 과정의 특성을 함께 다룹니다.
초록(Abstract)
우리는 샌드박스형 마인크래프트 생존 모드 세계에 4개의 젬미니 4 아르곤 에이전트를 배치하고 그들에게 하나의 목표를 부여했습니다: 엔더 드래곤을 격파하기. 각 에이전트는 마인플레이어라는 오픈소스 라이브러리를 통해 플레이어를 제어했으며, 게임 내 채팅과 공유 메모리를 통해 팀원들과 조정했습니다. 누구도 역할을 지정하지 않았고, 게임 로직을 작성하지 않았습니다. 에이전트들은 모든 프로그램을 스스로 계획하고, 작성하고, 디버깅했습니다. 연구자들은 라이브 대시보드에서 실행을 관찰할 수 있었으며 언제든지 일시 중지하거나 중단할 수 있었지만, 개입할 이유가 없었습니다. 무작위 생성 세계에서 쉬움 난이도로 시작하여, 팀은 2,783개의 프로그램을 작성했고 27시간 14분 만에 엔더 드래곤을 격파했으며, 그 과정에서 605번 사망했습니다. 우리가 알기로는, 이것이 AI 에이전트에 의한 마인크래프트의 첫 번째 종단 간 자율적 완료이며, 사전 정찰 씨드나 인간이 작성한 다른 게임 특화 도구 없이 표준 마인플레이어 라이브러리만을 사용하여 달성했습니다. 승리를 위해서는 에이전트들이 하루 이상 수천 개의 종속적 단계에 걸쳐 일관된 계획을 유지해야 했습니다. 복잡한 실제 소프트웨어 공학 및 엔터프라이즈 작업도 동일한 장시간 코딩 및 다중 에이전트 조정을 요구합니다. 우리는 설정, 실행의 진행 과정, 팀의 전략(작업 분담, 배운 내용 공유, 서로의 아이템 회수), 그리고 이 결과의 한계를 설명합니다.
We placed four Gemini 4 Argon agents in a sandboxed Minecraft survival world and gave them one goal: defeat the Ender Dragon. Each agent controlled a player via an open-source library called Mineflayer and coordinated with its teammates through in-game chat and shared memory. No one assigned roles or wrote game logic. The agents planned, wrote, and debugged every program themselves. Researchers could watch the run on a live dashboard and pause or stop it at any time, but they had no cause to intervene. Starting from a randomly generated world on Easy difficulty, the team wrote 2,783 programs and defeated the dragon in 27 hours and 14 minutes, dying 605 times along the way. To our knowledge, this is the first end-to-end autonomous completion of Minecraft by AI agents, achieved using only the standard Mineflayer library without pre-scouted seeds or other game-specific tools written by humans. Winning required the agents to keep a coherent plan across thousands of dependent steps for more than a day. Complex real-world software engineering and enterprise tasks demand the same long-horizon coding and multi-agent coordination. We describe the setup, how the run unfolded, the team's strategies (dividing the work, sharing what they learned, recovering each other's items), and the limits of the result.
논문 링크
시멘틱 ID를 활용한 개인화 LLM 추천: 자동회귀 빔 서치 vs. 멀티토큰 예측 / Personalized LLM Recommendation with Semantic IDs: Autoregressive Beam Search vs. Multi-Token Prediction
논문 소개
대규모 개인화 추천 시스템은 전통적인 임베딩 테이블 기반 검색에서 대형언어모델(LLM) 기반의 생성형 추천자로 빠르게 전환되고 있습니다. 이러한 전환의 핵심 기술은 시맨틱 ID(Semantic ID, SID)로, 각 항목을 계층적 콘텐츠 코드의 짧은 시퀀스로 표현합니다. SID 기반 접근법의 가장 큰 이점은 단일의 인스트럭션 튜닝된 모델이 개인화된 검색, 콘텐츠 질의응답, 일반 인스트럭션 팔로잉을 통합하면서도, 새로운 콘텐츠의 메타데이터만으로 SID를 생성하여 콜드 스타트 문제를 근본적으로 해결할 수 있다는 것입니다. 그러나 이러한 패러다임의 채택은 중요한 기술적 선택을 요구합니다. SID를 생성할 때 전통적인 자기회귀 빔 탐색을 사용할 것인지, 아니면 모든 토큰을 병렬로 예측하는 멀티토큰 예측(Multi-Token Prediction, MTP) 방식을 사용할 것인지 결정해야 하는 문제입니다.
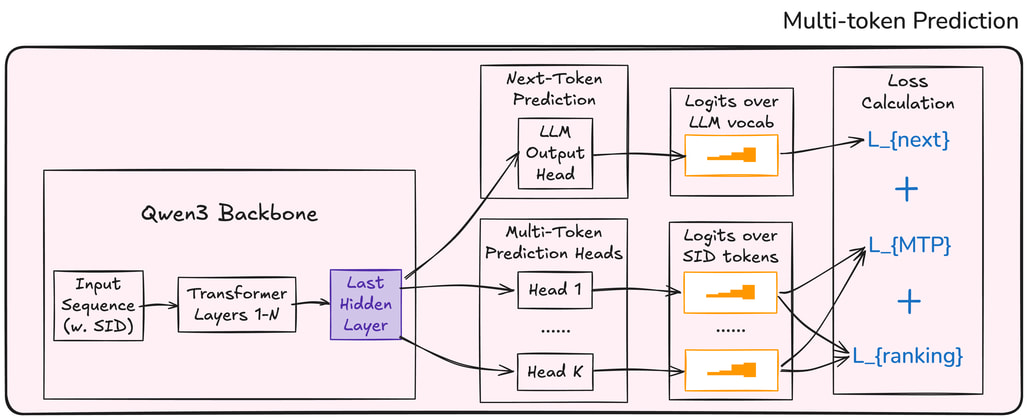
본 연구는 이 두 생성 패러다임에 대한 업계 규모의 상세한 비교를 제시합니다. 자기회귀 방식은 단일 언어 모델 헤드에서 토큰을 순차적으로 생성하며 제약 있는 빔 탐색으로 최적 시퀀스를 탐색하는 반면, MTP 방식은 각 위치마다 전용 헤드를 배치하여 모든 코드를 병렬로 예측하고 디코딩 지연을 크게 줄이는 것을 목표로 합니다. MTP의 근본적인 약점은 예측 헤드들의 독립성으로 인한 코드 간 일관성 부재입니다. 본 논문의 핵심 기술적 기여는 이 문제를 완화하기 위한 보조 순위 손실(auxiliary ranking loss)입니다. 이 손실함수는 정양성 항목의 전체 MTP 스코어가 음성 항목들을 상회하도록 학습을 유도하여, 학습 단계에서 독립적 헤드들을 암묵적으로 결합시킵니다.
실험은 대규모 스트리밍 미디어 카탈로그를 대상으로 개인화된 검색, 콘텐츠 질의응답, 일반 인스트럭션 팔로잉을 포함한 멀티태스크 LLM 환경에서 수행되었으며, Qwen3-8B 규모에서 공정한 비교를 진행했습니다. 실험 결과는 명확합니다. 자기회귀 빔 탐색이 nDCG, Recall, 콘텐츠 QA 정확도를 포함한 대부분의 제품 중요 메트릭에서 MTP를 일관되게 능가합니다. 이는 자기회귀 결합의 실제 가치를 보여주는 것으로, 각 코드가 이전 코드에 의존하는 구조를 활용할 때 더 합리적이고 정확한 SID가 생성됩니다. 한편, 훈련 비용에서 자기회귀 방식이 약 2.6배 낮은 금전적 비용으로 우수하며, MTP만이 원시 추론 처리량에서 이점을 제공합니다. 비-SID 기준 모델 대비 SID 기반 시스템은 콜드 스타트 순위에서 77%, 콘텐츠 QA 정확도에서 22% 개선을 달성했고 훈련 속도는 2.8배 향상되었습니다.
다만 SID 어휘 확장으로 인한 언어 메트릭 회귀가 관찰되었으며, 이는 강화학습 사후학습을 통해 해결됩니다. 이러한 결과는 생성 메커니즘의 선택이 단순한 속도-정확도 트레이드오프가 아니라 훈련 비용, 추론 지연, 순위 품질, 콘텐츠 이해, 언어 생성 능력을 모두 포함하는 다중 목표 최적화 문제임을 의미합니다. 스트리밍 미디어와 같은 대규모 실제 시스템에서 추천 정확도의 개선은 사용자 만족도와 비즈니스 성과에 직결되므로, 본 연구의 깊이 있는 분석은 차세대 LLM 기반 추천 시스템 설계에 중요한 지침을 제공합니다.
초록(Abstract)
대규모 개인화가 임베딩 테이블 검색에서 아이템을 추천하기 위해 시맨틱 ID (SID)를 생성하는 LLM 기반 추천 시스템으로 전환되고 있습니다. 여기서 각 SID는 이산 계층적 콘텐츠 코드의 짧은 수열입니다. 단일 인스트럭션 튜닝된 모델이 검색, 콘텐츠 이해, 언어를 통합할 수 있고, 콘텐츠만을 사용하여 SID를 통해 새로운 타이틀을 추천할 수 있습니다. 그렇다면 모델은 SID를 어떻게 생성해야 할까요? 전통적으로 모델들은 단일 언어 모델링 헤드에 의존하여 토큰을 자동회귀적으로 생성하고, 일반적으로 제약 빔 서치를 사용합니다. 이와 대조적으로, 최근의 연구들은 전용 헤드가 모든 토큰을 병렬로 예측하는 다중 토큰 예측 (MTP)을 탐구하고 있으며, 이는 빔 서치와 관련된 디코딩 지연시간을 크게 감소시킵니다. 우리는 이 두 생성 패러다임의 산업 규모의 직접 비교를 보고합니다: 단일 헤드 자동회귀 디코딩 vs. MTP. 우리는 MTP 목표를 학습하기 위해 결합 SID 점수에 정의된 새로운 보조 순위 손실을 도입합니다. 우리는 대규모 스트리밍 미디어 카탈로그에 대해 개인화된 검색, 콘텐츠 질의응답 (QA), 그리고 명령어 따르기를 공동으로 수행하는 멀티태스크 LLM 내에서 SID 학습 목표를 품질 및 학습/추론 비용 측면에서 평가합니다. 우리의 실험은 단일 헤드 빔 서치가 대부분의 제품 핵심 메트릭에서 MTP를 일관되게 능가함을 보여줍니다: 순위 및 콘텐츠 QA에서, 그리고 Qwen3-8B 규모에서 약 2.6배 낮은 비용으로 학습합니다; MTP는 오직 원시 추론 처리량에서만 이깁니다. 이 발견을 바탕으로 효율적인 학습 및 추론 스택을 상세히 설명하고, 보조 순위 헤드가 장착된 이전의 비-SID 기준선 대비 엔드투엔드 이득을 보고합니다: 항목 콜드스타트 순위 +77%, 콘텐츠 QA 정확도 +22%, 학습 2.8배 가속화, SID 어휘 확장으로 인한 언어 메트릭 회귀. 우리는 강화학습 기반 사후학습으로 언어 회귀를 해결합니다.
Large-scale personalization is shifting from embedding-table retrieval to LLM-based recommenders that generate the Semantic ID (SID) of the item to recommend, where each SID is a short sequence of discrete hierarchical content codes. A single instruction-tuned model can then unify retrieval, content understanding, and language, and recommend brand-new titles from their content alone using SID; then, how should the model generate the SID? Traditionally, models rely on a single language modeling head that generates tokens autoregressively, typically using constrained beam search. In contrast, an emerging body of work explores multi-token prediction (MTP), where dedicated heads predict all tokens in parallel, substantially reducing the decoding latency associated with beam search. We report an industry-scale, apples-to-apples comparison of these two generation paradigms: single-head autoregressive decoding vs. MTP. We introduce a new auxiliary ranking loss, defined over the joint SID score, to train the MTP objective. We evaluate the SID training objectives on both quality and training/inference cost, inside a multi-task LLM that jointly does personalized retrieval, content question-answering (QA), and instruction following over a large streaming-media catalog. Our experiments show single-head beam search consistently beats MTP on most product-critical metrics: ranking and content QA, and trains at roughly 2.6x lower dollar cost on Qwen3-8B scale; MTP wins only on raw inference throughput. Around this finding, we detail an efficient training and inference stack and report end-to-end gains over the previous non-SID baseline equipped with an auxiliary ranking head: +77% item cold-start ranking, +22% content-QA accuracy, +2.8x faster training, with language metric regression traced to SID vocabulary expansion. We address the language regression by reinforcement learning post training.
논문 링크
DiscoLoop: 다중홉 추론을 위한 이산 임베딩과 연속 은닉 상태의 루핑 / DiscoLoop: Looping Discrete Embeddings and Continuous Hidden States for Multi-hop Reasoning
논문 소개
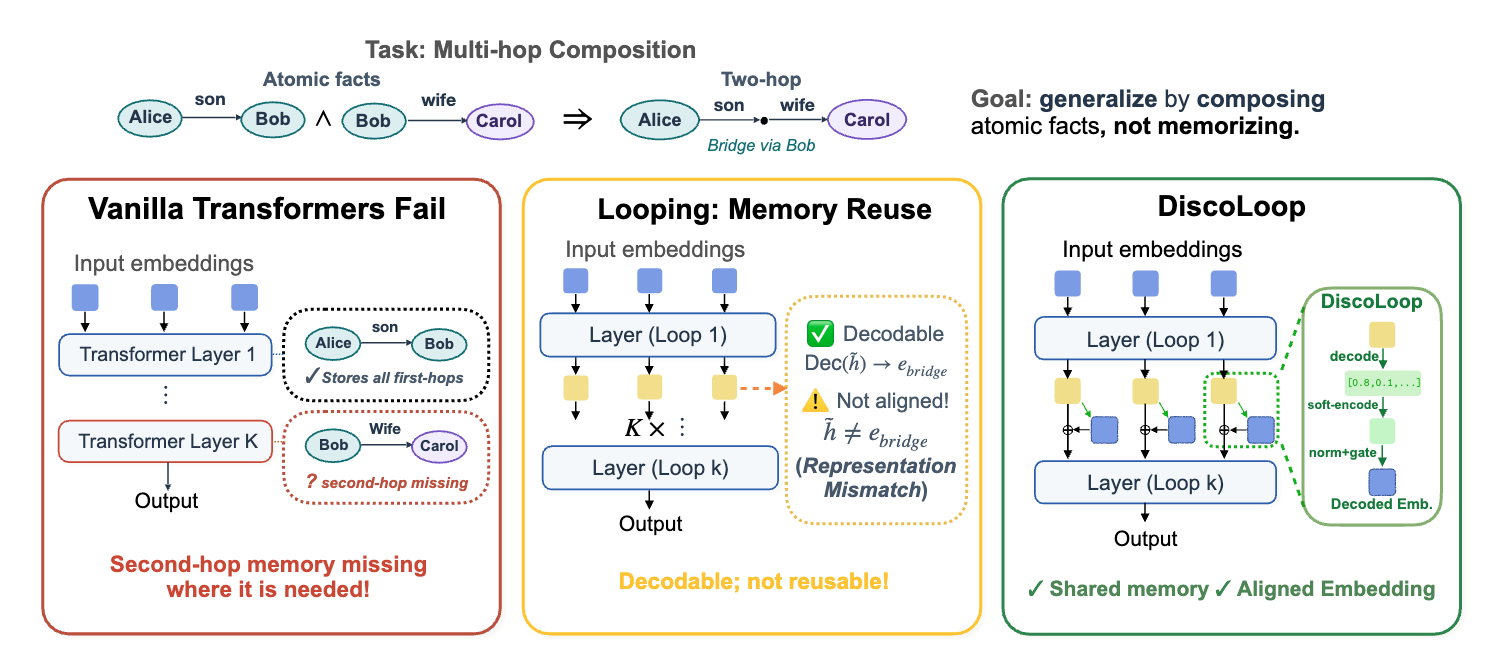
대규모 언어 모델이 중간 단계를 외부적으로 표현할 수 있는 사슬형 사고(Chain-of-Thought, CoT) 환경에서는 우수한 성능을 보이지만, 단일 포워드 패스 내에서 복잡한 다단계 추론을 수행해야 하는 상황에서는 근본적인 어려움에 직면하게 됩니다. 본 연구는 이러한 도전을 두 단계 추론(two-hop reasoning)이라는 대표적인 과제를 통해 분석하는데, 이는 모델이 단일 포워드 패스 내에서 여러 개의 매개변수화된 지식을 통합해야 하는 상황을 의미합니다. 기존의 비순환 트랜스포머 구조가 겪는 핵심 문제는 깊이-국소적 저장소 문제(depth-local storage problem)로, 초기 계층에서 습득한 사실이 두 번째 홉 검색이 발생하는 후기 계층에서 활용 불가능하다는 점입니다. 루프된 트랜스포머가 메모리를 재사용함으로써 이 문제를 어느 정도 완화할 수 있지만, 여전히 일반화 성능에는 한계가 존재합니다. 연구팀은 남은 병목이 표현 계층에 있음을 발견했으며, 구체적으로 첫 번째 루프가 브리지 엔티티를 거의 완벽하게 디코딩 가능하게 만들지만, 해당 은닉 상태가 브리지 토큰 임베딩과 잘 정렬되지 않는다는 점을 확인했습니다. 흥미롭게도 학습이 필요 없는 간단한 재정렬 개입(realignment intervention)이 일반화 갭을 거의 해소할 수 있음을 보였습니다. 이러한 통찰을 바탕으로 본 논문은 불산 임베딩 채널과 연속 은닉 상태 채널을 모두 수행하는 루프 아키텍처인 DiscoLoop을 제안합니다. DiscoLoop은 기호적 추론과 합성 언어 다중 홉 추론 과제에서 거의 완벽한 정확도를 달성하면서도 상당히 적은 훈련 단계로 수렴하며, 실제 사전훈련 환경에 적용될 경우 루프된 트랜스포머 기반 모델들에 비해 더 낮은 훈련 손실과 우수한 벤치마크 성능을 나타냄으로써 혼합 채널 설계가 실제 언어 모델링으로도 효과적으로 확장될 수 있음을 시사합니다.
초록(Abstract)
대규모 언어 모델(LLM)은 중간 단계를 사고의 연쇄(CoT)로 외부화할 수 있을 때 많은 추론 작업에서 강력한 성능을 달성한다. 그러나 많은 질문은 모델이 답변을 생성하기 전에 다단계 추론을 단일 순전파 내에서 내부화할 것을 요구한다. 우리는 이 과제를 2홉 추론을 통해 연구한다. 2홉 추론은 모델이 단일 순전파 내에서 여러 매개변수적 지식을 조합해야 하는 대표적인 작업이다. 표준적인 비반복 트랜스포머는 깊이 국소 저장 문제로 어려움을 겪는다. 즉, 초기 계층에서 학습된 사실들이 2홉 검색이 발생하는 위치에서 사용할 수 없다. 우리는 루프 트랜스포머가 동일한 메모리를 재사용하여 이 문제를 완화하지만, 여전히 불완전하게 일반화됨을 발견했다. 우리는 남은 병목현상이 표현 문제임을 보여준다. 2홉 추론 작업에서 첫 루프는 종종 올바른 브리지 엔티티를 거의 완벽하게 디코딩 가능하게 만들지만, 해당 은닉 상태는 브리지 토큰 임베딩과 여전히 불충분하게 정렬되어 있다. 놀랍게도, 간단한 훈련 없는 재정렬 개입이 일반화 격차를 거의 해소한다. 이 통찰에 기반하여, 우리는 DiscoLoop를 제안한다. DiscoLoop는 이산 임베딩 채널과 연속 은닉 상태 채널을 모두 지닌 루핑 아키텍처이다. DiscoLoop는 기호적 및 합성 언어 다중홉 추론 작업 전반에 걸쳐 훨씬 적은 훈련 단계로 거의 완벽한 정확도를 달성한다. 실제 사전학습에 적용될 때, DiscoLoop는 루프 트랜스포머 기준 모델보다 낮은 훈련 손실과 더 강력한 벤치마크 성능을 달성하며, 이는 혼합 채널 설계가 실제 언어 모델링에 전이됨을 시사한다.
Large language models achieve strong performance on many reasoning tasks when allowed to externalize intermediate steps as Chain-of-Thought (CoT). However, many questions require the model to internalize the multi-step reasoning within a single forward pass before generating the answer. We study this challenge through two-hop reasoning, a representative task where the model must compose multiple pieces of parametric knowledge within a single forward pass. Standard non-recurrent Transformers suffer from a depth-local storage problem: facts learned in earlier layers are unavailable where second-hop retrieval happens. We found that Looped Transformers mitigate this issue by reusing the same memory, but still generalize imperfectly. We show that the remaining bottleneck is representational. In the two-hop reasoning task, the first loop often makes the correct bridge entity nearly perfectly decodable, yet the corresponding hidden state remains poorly aligned with the bridge token embedding. Surprisingly, an easy training-free realignment intervention nearly closes the generalization gap. Building upon this insight, we propose DiscoLoop, a looping architecture whose recurrence carries both a discrete embedding channel and a continuous hidden-state channel. DiscoLoop achieves near-perfect accuracy with substantially fewer training steps across symbolic and synthetic-language multi-hop reasoning tasks. When applied to real-world pretraining, DiscoLoop attains lower training loss and stronger benchmark performance than looped-transformer baselines, suggesting that the mixed-channel design transfers to practical language modeling.
논문 링크
PixSearch: 영역 기반 검색을 통한 지식형 대규모 멀티모달 모델 / PixSearch: Region-Grounded Retrieval for Knowledgeable Large Multimodal Models
논문 소개
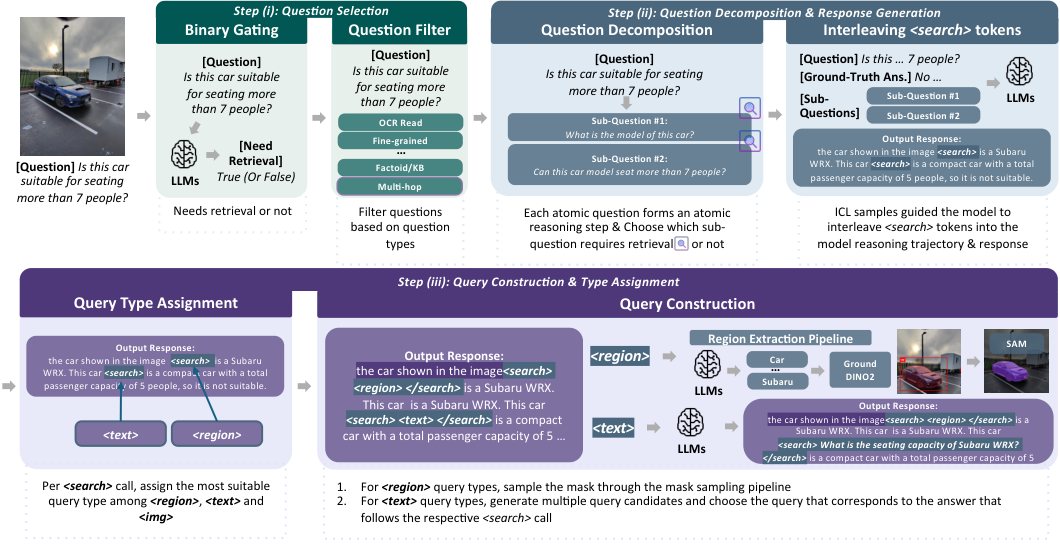
멀티모달 검색-증강 생성(MM-RAG, Multimodal Retrieval-Augmented Generation) 시스템은 시각 질문 답변(VQA, Visual Question Answering) 작업에 외부 지식을 통합하여 성능을 향상시킵니다. 그러나 기존 대부분의 시스템들은 시각 그라운딩, 질의 구성, 답변 생성을 분리하는 모듈식 파이프라인에 의존하고 있으며, 이러한 구조적 분리는 중간 검출 및 캡션 단계에서 발생한 오류를 검색 단계로 전파시키면서 동시에 추론 지연을 증가시키고 진행 중인 추론 과정과의 조율을 제한합니다. 특히 자아 중심 관점의 이미지(egocentric images)에서는 작고 화면의 중앙에서 벗어난 희귀한 객체들에 대한 질문이 자주 나타나는데, 전체 이미지 기반의 검색 방식이 이러한 국소적 영역을 효과적으로 포착하지 못하는 문제가 발생합니다.
PixSearch는 이러한 한계를 극복하기 위해 영역 수준의 시각 그라운딩과 검색-증강 추론을 통합하는 종단 간(end-to-end) 분할 기능을 갖춘 대규모 멀티모달 모델(LMM, Large Multimodal Model)입니다. 자기회귀 생성 과정에서 PixSearch는 검색을 시작할 최적의 시점을 학습하고, 텍스트 기반, 전체 이미지, 그리고 영역 수준의 다양한 검색 경로 간에 질의를 지능적으로 경로 지정합니다. 핵심적인 혁신은 공동으로 학습된 마스크 디코더를 활용하여 목표 객체를 시각 질의로서 정확하게 자르는 능력으로, 이는 국소화된 이미지 정보를 검색 과정에 직접 통합합니다. 검색 과정이 포함된 감독 신호를 활용한 2단계 지도 학습 미세 조정 방식은 검색 트리거링, 질의 선택, 증거 기반 답변 생성을 효과적으로 가르치면서 분할 능력을 동시에 보존합니다. 실험 결과는 이 접근 방식의 효과를 명확히 입증하는데, CRAG-MM(egocentric and entity-centric VQA) 벤치마크에서 전체 이미지 검색 방식 대비 18.3%의 상대 정확도 향상을 달성했으며, 자아 중심 관점의 이미지에서 특히 강력한 성능을 보였습니다. 더욱이 PixSearch는 캐시된 GroundedSAM-LLaVA 파이프라인과 비교하여 추론 지연을 36.4% 단축시켰으며, 더 광범위한 VQA 및 텍스트 전용 질답 작업에서도 경쟁력 있는 성능을 유지합니다.
초록(Abstract)
멀티모달 검색-증강 생성(MM-RAG)은 시각 질의응답(VQA)을 외부 지식으로 증강하지만, 많은 시스템은 시각적 그라운딩, 쿼리 구성, 답변 생성을 분리하는 모듈식 파이프라인에 의존합니다. 이러한 분리로 인해 중간 감지, 마스크, 캡션의 오류가 검색으로 전파되고 지연시간이 증가하며 진행 중인 추론과의 조정이 제한될 수 있습니다. 이러한 제한은 특히 자기중심적 이미지에서 심각하며, 여기서 질문은 전역 검색이 간과할 수 있는 작은, 중심 벗어난, 또는 롱테일 개체에 관한 것이 많습니다. 우리는 영역 수준의 시각적 그라운딩을 검색-증강 추론과 통합하는 엔드-투-엔드 분할형 대규모 멀티모달 모델(LMM) PixSearch를 제안합니다. 자회귀 생성 중에 PixSearch는 검색 시점, 텍스트, 전체 이미지, 영역 수준의 검색에 걸쳐 쿼리를 라우팅하는 방법, 그리고 공동 학습된 마스크 디코더를 사용하여 대상 개체를 시각 쿼리로 자르는 방법을 학습합니다. 검색이 포함된 감독을 활용한 2단계 지도 파인튜닝 체계를 통해 분할 능력을 보존하면서 검색 트리거링, 쿼리 선택, 증거 기반 답변 생성을 학습합니다. 자기중심적 및 개체중심적 시각 질의응답 벤치마크에서 PixSearch는 CRAG-MM에서 전체 이미지 검색 대비 18.3%의 상대적 정확도 향상을 달성하며, 특히 자기중심적 이미지에서 뛰어난 향상을 보이면서도 더 광범위한 시각 질의응답 및 텍스트 전용 질의응답 작업에서 경쟁력을 유지합니다. 또한 캐시된 GroundedSAM-LLaVA 파이프라인과 비교하여 추론 지연시간을 36.4% 감소시킵니다.
Multimodal Retrieval-Augmented Generation (MM-RAG) augments visual question answering (VQA) with external knowledge, but many systems rely on modular pipelines that separate visual grounding, query construction, and answer generation. This separation can propagate errors from intermediate detections, masks, or captions into retrieval while adding latency and limiting coordination with ongoing reasoning. These limitations are especially consequential for egocentric images, where questions often concern small, off-center, or long-tail entities that global retrieval can overlook. We propose PixSearch, an end-to-end segmenting Large Multimodal Model (LMM) that unifies region-level visual grounding with retrieval-augmented reasoning. During autoregressive generation, PixSearch learns when to retrieve, how to route queries across text, whole-image, and region-level retrieval, and how to crop the target entity as a visual query using a jointly trained mask decoder. A two-stage supervised fine-tuning regimen with search-interleaved supervision teaches retrieval triggering, query selection, and evidence-grounded answer generation while preserving segmentation ability. On egocentric and entity-centric VQA benchmarks, PixSearch achieves an 18.3% relative accuracy gain on CRAG-MM over whole-image retrieval, with particularly strong gains on egocentric images, while remaining competitive on broader VQA and text-only QA tasks. It also reduces inference latency by 36.4% compared with a cached GroundedSAM-LLaVA pipeline.
논문 링크
더 읽어보기
Google Earth AI 지리공간 추론 에이전트: 능력 및 체계적 평가 / Google Earth AI Geospatial Reasoning Agent: Capabilities and a Systematic Evaluation
논문 소개
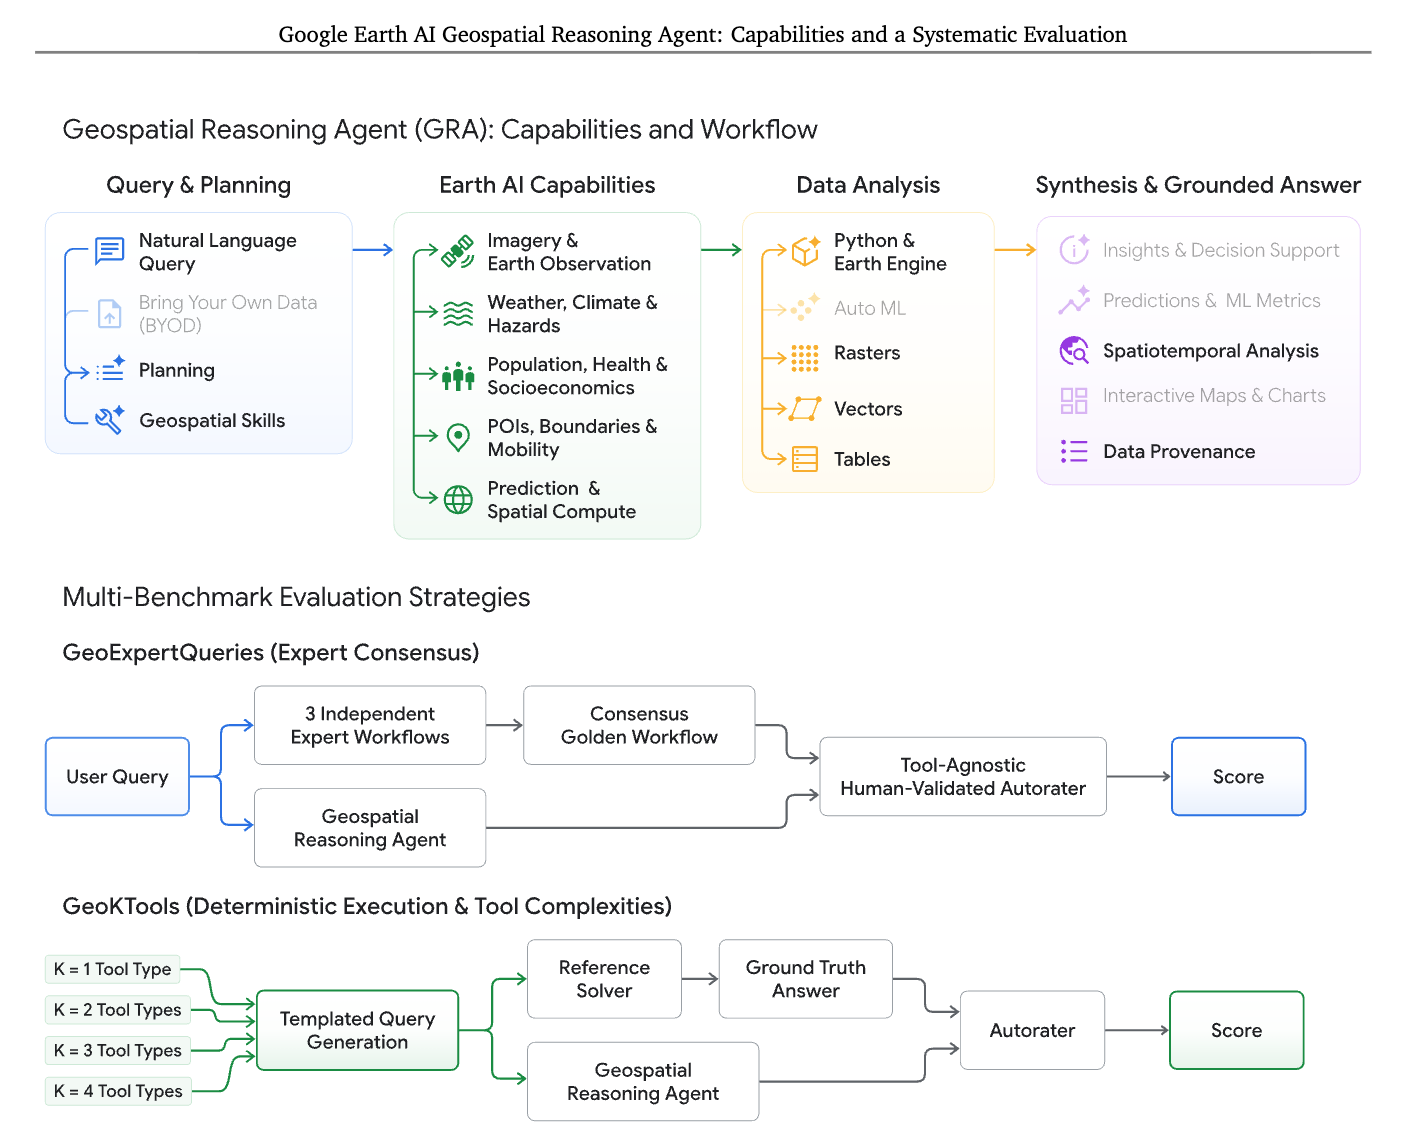
지구공간 데이터를 활용한 행성 수준의 질문에 답하기 위해 Google에서 개발한 지구공간 AI 모델들과 추론 에이전트 시스템이 소개됩니다. 이 시스템은 Gemini 기반의 Geospatial Reasoning Agent (GRA)로서, 지구공간 데이터 소스, 기초 모델, 그리고 전문 도구들을 하나의 통합된 연구 플랫폼으로 조직합니다. GRA의 핵심 혁신은 복잡한 지구공간 분석 질문을 체계적으로 처리하기 위해 모듈식 영역 기술(domain skills)과 사전 지구공간 계획(upfront geospatial planning)을 결합한다는 점입니다. 이러한 구조를 통해 복잡한 사용자 질문을 이해 가능한 다단계 워크플로우로 분해하여 순차적으로 처리함으로써, 단순한 도구 호출을 넘어서는 지능형 추론을 가능하게 합니다.
현실의 지구공간 문제들을 평가하는 것은 다양한 도전 과제를 안고 있습니다. 같은 문제에 여러 타당한 풀이 방식이 존재할 수 있으며, 대규모 데이터 카탈로그에서 필요한 정보를 발견해야 하고, 기준 데이터가 계속 변화하는 환경에서 평가해야 하기 때문입니다. 이러한 평가의 어려움을 체계적으로 해결하기 위해 연구팀은 두 가지 새로운 벤치마크를 설계했습니다. 첫 번째인 GeoExpertQueries는 지구공간 전문가들의 실제 사용 사례에서 비롯된 복잡한 분석 문제들을 제시하며, 각 질문마다 세 명의 독립적인 전문가가 합의한 표준 워크플로우를 제공합니다. 두 번째인 GeoKTools는 템플릿 기반 질문으로 결정론적 기준 솔버(deterministic reference solver)를 포함하며, 필요한 도구 종류의 개수를 체계적으로 변화시켜 평가합니다. 추가적으로 CBGB와 UnivEARTH라는 외부 벤치마크도 활용되었습니다.
GRA의 설계 선택사항들이 실제로 얼마나 효과적인지 검증하기 위해 연구팀은 네 가지 구성을 비교 평가했습니다. 단순 LLM만 사용하는 경우, 기본 도구를 추가한 경우, GRA의 스킬과 도구를 갖추었지만 사전 계획과 실행 지원이 없는 경우, 그리고 완전한 GRA 시스템 모두를 Gemini 3.1 Pro와 3.8 Flash 두 가지 모델 버전으로 평가했습니다. 결과적으로 고급 LLM이라도 기본 도구만으로는 템플릿화된 질문에서는 상당한 성능을 보이지만, 전문가 워크플로우가 필요한 개방형 문제에서는 극히 제한적인 성과만 달성할 수 있음이 드러났습니다. 반면 GRA는 템플릿 기반 질문과 개방형 문제 모두에서 우수한 성능을 나타냈습니다. 특히 흥미로운 발견은 GRA의 스킬과 도구가 성능 향상의 가장 큰 원인이며, 개방형 문제에서는 사전 계획과 실행 지원이 추가적인 이득을 제공한다는 점입니다. 이러한 아키텍처적 개선을 통해 Gemini 3.8 Flash는 더 강력한 Pro 모델과 동등하거나 능가하는 성능을 달성하면서 비용 효율성도 크게 개선되었습니다.
초록(Abstract)
구글 어스 AI는 지리공간 AI 모델들의 계열이며, 이들을 조율하는 에이전트를 함께 제공합니다. 우리는 이 에이전트인 구글 어스 AI의 지리공간 추론 에이전트(GRA)를 제시합니다. GRA는 제미니 기반의 연구 시스템으로서 지리공간 데이터 소스, 파운데이션 모델, 그리고 도구들을 결합하여 우리 행성에 관한 질문에 답변합니다. GRA는 이들을 모듈식 도메인 스킬로 조직화하고 선제적 지리공간 계획과 결합하여 복잡한 쿼리를 다단계 워크플로우로 분해합니다. 이러한 시스템을 평가하는 것은 어렵습니다. 실제 문제들은 여러 타당한 워크플로우를 허용하며, 대규모 카탈로그 전반에서 데이터 발견이 필요하고, 진화하는 정답 데이터에 의존합니다. 우리는 두 개의 벤치마크를 도입하고 그들의 개발 분할을 공개합니다. GeoExpertQueries는 실무자 사용 사례에 기반하고 지리공간 전문가들에 의해 정제된 복잡한 분석 문제들을 제시합니다. 각 문제는 세 명의 독립적인 전문가들로부터의 합의된 황금 워크플로우와 쌍을 이루며, 인간 검증 도구 무관 자동 평가기에 의해 평가됩니다. GeoKTools는 필요한 도구 유형의 개수를 체계적으로 변화시키는 결정론적 참조 솔버를 갖춘 템플릿 기반 쿼리들로 구성됩니다. 우리는 또한 두 개의 외부 벤치마크인 CBGB와 UnivEARTH를 사용하며, 후자는 포화됨을 발견했습니다. GRA의 도구와 그 에이전트 조율의 기여도를 분리하기 위해 우리는 네 가지 구성을 비교합니다. 각각은 제미니 3.1 프로와 3.8 플래시로 평가되며, 다음과 같습니다: 독립형 LLM, 기본 도구를 갖춘 LLM, GRA의 스킬과 도구는 있으나 선제적 계획과 실행 지원이 없는 LLM, 그리고 GRA 자체입니다. 기본 도구만을 사용할 때, 고급 모델은 템플릿 기반 쿼리에서 대부분의 답변을 얻지만 개방형 문제에서는 전문가 워크플로우의 작은 부분만을 충족합니다. GRA는 두 경우 모두에서 우수한 성능을 보입니다. 가장 큰 향상은 GRA의 스킬과 도구로부터 나옵니다. 개방형 문제에서, 그 계획과 실행 지원은 제미니 3.8 플래시를 사용할 때 추가 이득을 제공하며, 플래시가 더 낮은 비용으로 프로와 동등하거나 이를 능가할 수 있게 합니다.
Google Earth AI is a family of geospatial AI models, together with an agent that orchestrates them. We present this agent, Google Earth AI's Geospatial Reasoning agent (GRA), a Gemini-powered research system that combines geospatial data sources, foundation models, and tools to answer questions about our planet. GRA organizes these into modular domain skills and pairs them with upfront geospatial planning to decompose complex queries into multi-stage workflows. Evaluating such systems is hard: real-world problems admit multiple valid workflows, require data discovery across large catalogs, and rely on evolving ground truth. We introduce two benchmarks and release their development splits. GeoExpertQueries poses complex analytical problems grounded in practitioner use cases and refined by geospatial experts; each is paired with a consensus golden workflow from three independent experts and scored by a human-validated, tool-agnostic autorater. GeoKTools consists of templated queries with deterministic reference solvers that systematically vary the number of required tool types. We also use two external benchmarks, CBGB and UnivEARTH; the latter we find to be saturated. To isolate the contribution of GRA's tools and its agentic orchestration, we compare four configurations, each with Gemini 3.1 Pro and 3.8 Flash: a standalone LLM, the LLM with basic tools, the LLM with GRA's skills and tools but without its upfront planning and execution guidance, and GRA itself. With at most basic tools, an advanced model recovers much of the answer on templated queries but satisfies only a small fraction of the expert workflows on open-ended problems; GRA performs well on both. The largest step comes from GRA's skills and tools; on open-ended problems, its planning and execution guidance add a further gain with Gemini 3.8 Flash, letting Flash match or exceed Pro at lower cost.
논문 링크
Harmony Harness: 에이전트 하니스의 다목표 자기진화 / Harmony Harness: Multi-Objective Self-Evolution of Agent Harnesses
논문 소개
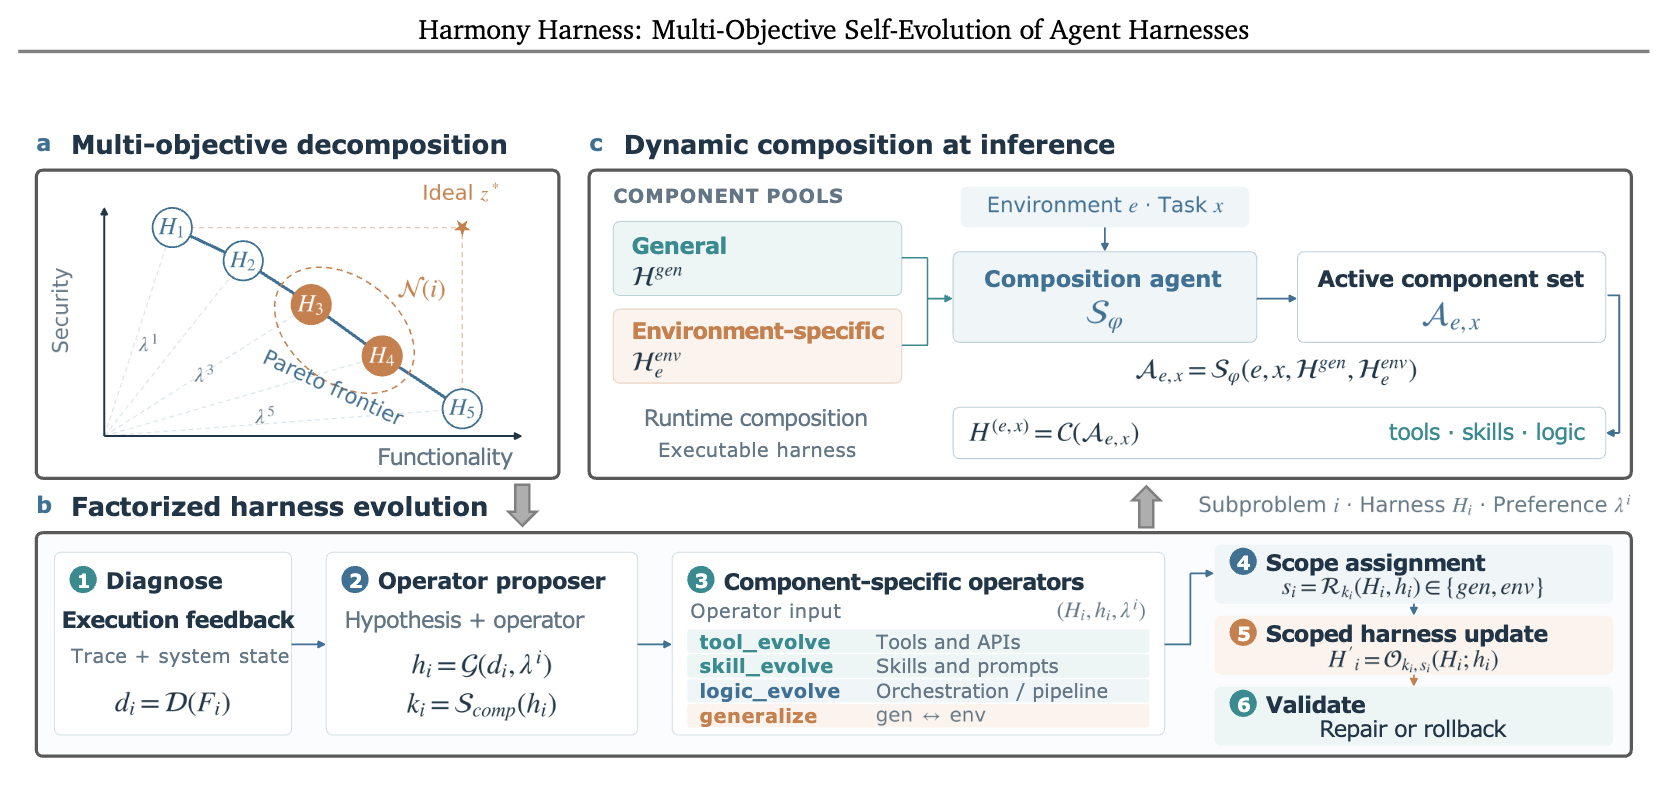
최근 대규모 언어 모델을 기반으로 하는 에이전트 시스템의 성능을 향상시키기 위한 연구들은 에이전트의 구조적 요소인 하네스(harness)를 실행 피드백을 통해 점진적으로 개선할 수 있는 최적화 대상으로 취급하고 있습니다. 그러나 기존의 자동 진화 방식들은 주로 단일한 성능 목표만을 최적화하거나 하네스 전체를 하나의 통합된 구조로 다루기 때문에, 상충하는 여러 목표들을 동시에 고려하고 일반적으로 전이 가능한 설계와 환경 특화적 적응을 구분하는 데 어려움이 있었습니다. 이 논문에서 제시하는 Harmony Harness는 다중 목표 최적화와 구성적 진화의 관점에서 하네스 최적화 문제를 재정의하는 프레임워크입니다. 구체적으로 이 방법은 하네스 진화를 다중 목표 최적화 문제로 공식화하고, 분해 기반의 진화 탐색(decomposition-based evolutionary search) 방식을 활용하여 파레토 경계의 서로 다른 영역에서 최적해들을 유지함으로써 대규모 저장소 수준의 하네스에 대해 사전에 설계된 다양성 지표에 의존할 필요를 없앱니다. 이와 함께 일반 목적의 하네스 메커니즘과 벤치마크 특화 적응을 별도로 개선하는 인수분해된 진화 연산자(factorized evolution operators)와 추론 시간에 이들을 통합하는 동적 구성 워크플로우를 도입합니다. SecRepoBench와 BaxBench 두 벤치마크에서의 광범위한 실험을 통해 Harmony Harness가 기존의 단일 목표 중심 하네스 진화 기법들을 일관되게 능가하며, 두 벤치마크 모두에서 10퍼센트 이상의 성능 향상을 달성함을 보여줍니다. 이러한 결과는 목표 간의 상충 관계를 명시적으로 모델링하고 하네스의 구조적 특성을 반영하는 진화 전략이 기존의 단순 최적화 방식보다 훨씬 더 강력하고 전이 가능성 높은 에이전트 진화를 가능하게 함을 시사합니다.
초록(Abstract)
최근 자체 진화하는 대규모 언어 모델(LLM) 에이전트에 관한 연구는 에이전트 하네스를 실행 피드백을 통해 반복적으로 개선될 수 있는 최적화 대상으로 취급합니다. 그러나 기존 접근법들은 주로 단일 목표를 최적화하고 하네스를 단일형 아티팩트로 진화시키며, 이는 상충하는 목표들을 다루고 환경별 적응으로부터 전이 가능한 설계를 분리하는 능력을 제한합니다. 본 논문에서는 다중 목표 구성적 하네스 진화를 위한 프레임워크인 Harmony Harness를 소개합니다. Harmony Harness는 하네스 진화를 다중 목표 최적화 문제로 공식화하고 분해 기반 진화 탐색을 사용하여 파레토 프론티어의 다양한 영역에 걸쳐 해를 유지하며, 저장소 규모 하네스에 대한 수작업으로 설계된 구조적 다양성 메트릭에의 의존성을 피합니다. 동시에 범용 하네스 메커니즘과 벤치마크별 적응을 별도로 정제하는 인수분해된 진화 연산자와 이들을 추론 시간에 통합하는 동적 구성 워크플로우를 소개합니다. SecRepoBench와 BaxBench 전반에 걸쳐 Harmony Harness는 강력한 하네스-진화 기준을 지속적으로 능가하며, 두 벤치마크 모두에서 10%를 초과하는 성능 향상을 달성합니다. 우리의 결과는 목표 간 트레이드오프와 하네스 구조를 명시적으로 모델링하는 것이 기존의 단일 목표 단일형 접근법보다 상당히 더 강력하고 전이 가능한 에이전트 진화를 생성함을 보여줍니다.
Recent work on self-evolving LLM agents treats the agent harness as an optimization target that can be iteratively improved through execution feedback. Existing approaches, however, largely optimize a single objective and evolve the harness as a monolithic artifact, limiting their ability to handle competing goals and to separate transferable design from environment-specific adaptation. We introduce Harmony Harness, a framework for multi-objective, compositional harness evolution. Harmony Harness formulates harness evolution as a multi-objective optimization problem and uses decomposition-based evolutionary search to maintain solutions across different regions of the Pareto frontier, avoiding reliance on a hand-designed structural diversity metric for repository-scale harnesses. In parallel, we introduce factorized evolution operators that separately refine general-purpose harness mechanisms and benchmark-specific adaptations, together with a dynamic composition workflow that integrates them at inference time. Across SecRepoBench and BaxBench, Harmony Harness consistently outperforms strong harness-evolution baselines, with gains exceeding 10% on both benchmarks. Our results show that explicitly modeling both objective trade-offs and harness structure yields substantially stronger and more transferable agent evolution than existing single-objective, monolithic approaches.
논문 링크
LongHarness: 상태 기반 증거 관리를 통한 1억 토큰 규모 코퍼스의 에이전트 추론 향상 / LongHarness: Advancing Agentic Reasoning over 100M-Token Corpora via Stateful Evidence Management
논문 소개
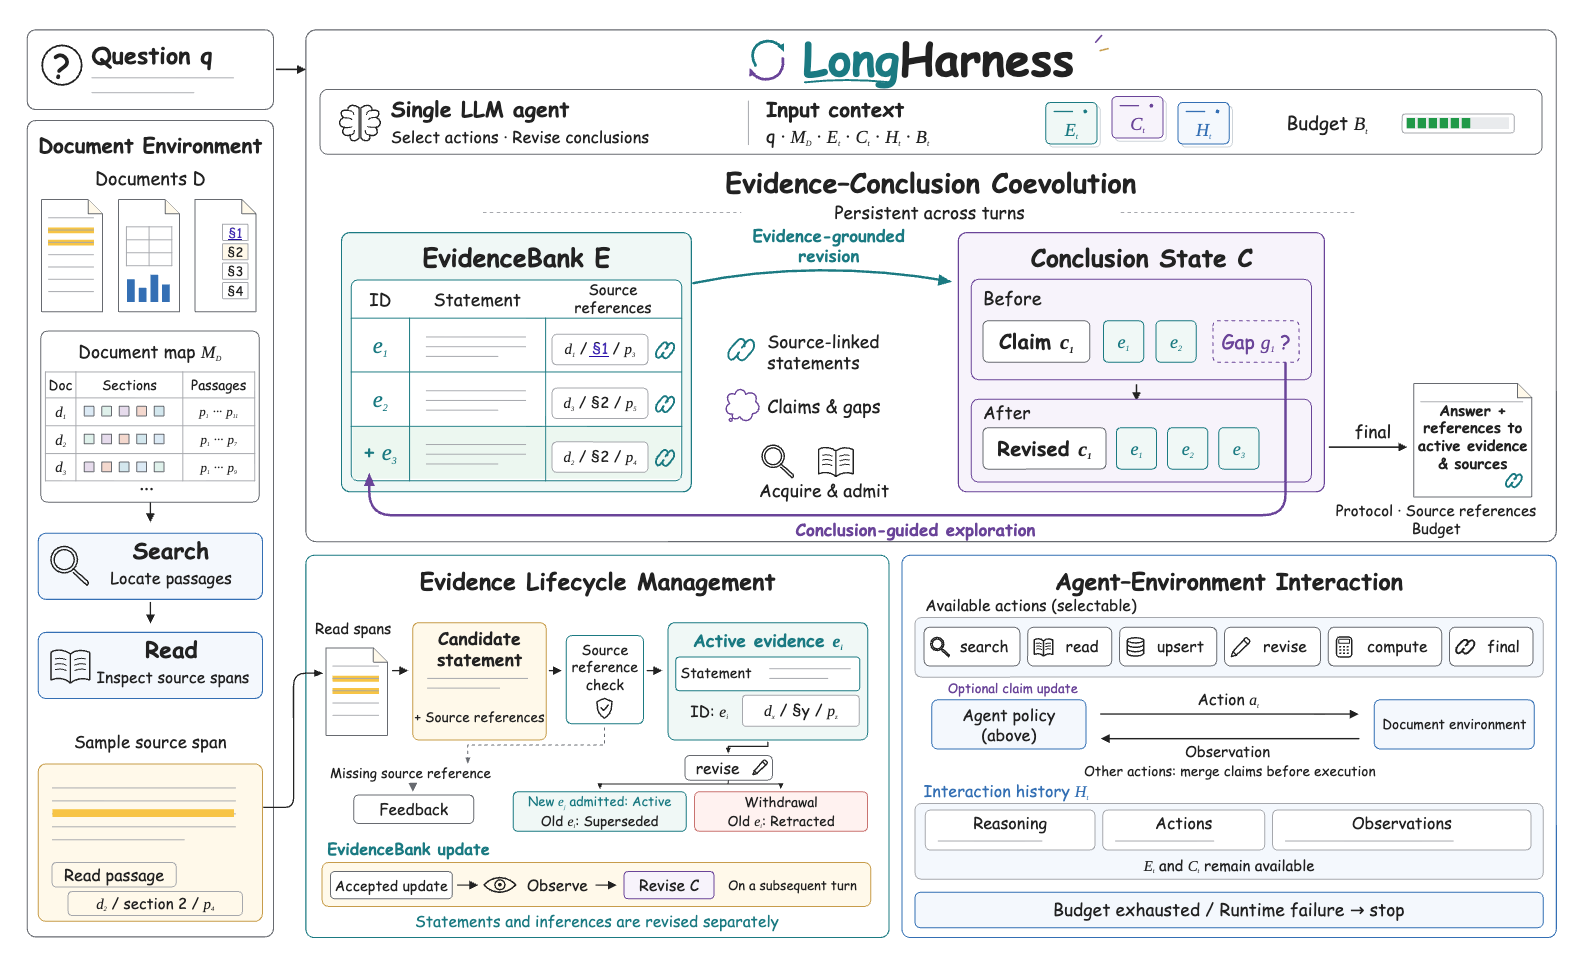
지능형 에이전트가 컨텍스트 윈도우를 초과하는 대규모 문서 컬렉션을 다루면서 신뢰할 수 있는 답변을 도출하는 것은 현대 정보 검색 시스템의 핵심 과제입니다. 기존의 에이전트 하네스들은 이러한 코퍼스에 대한 점진적 접근을 가능하게 했지만, 획득한 증거와 진화하는 결론들이 상호작용 이력 속에서 명시적으로 구분되지 않으면서 두 가지 근본적인 문제를 야기해왔습니다. 무한 탐색(unbounded exploration)이라 불리는 첫 번째 문제는 검색이 계속 확장되면서도 의사결정에 필요한 정보 격차를 실제로 해소하지 못하는 현상이고, 증거-상태 표류(evidence-state drift)라는 두 번째 문제는 이전에 획득한 증거나 이후의 수정 사항들이 현재 결론에 반영되지 않아 추론의 일관성이 깨지는 현상입니다.
본 논문에서 제시하는 LongHarness는 이러한 문제들을 해결하기 위해 증거와 결론 간의 상호작용을 명시적으로 관리하는 모델 독립적 에이전트 하네스입니다. 이 접근 방식의 핵심은 증거-결론 공진화(Evidence-Conclusion Coevolution)라는 메커니즘에 있으며, 이는 미해결 결론들이 탐색을 구체적인 정보 격차로 안내하는 동시에 새로 획득한 증거가 기존 결론들을 강화하거나 수정하도록 설계되었습니다. LongHarness는 이러한 공진화 과정을 증거 라이프사이클 관리(Evidence Lifecycle Management)와 결합하여, 축적된 증거를 활성(Active), 대체됨(Superseded), 철회됨(Retracted), 보관됨(Archived)의 상태로 추적함으로써 증거의 신뢰성과 추적 가능성을 보장합니다.
LongHarness의 효과는 OfficeQA Pro V1 및 V2, AA-LCR, LongBench v2 등 여러 벤치마크에서 광범위하게 검증되었습니다. GLM-5.3-Flash 모델을 사용한 실험에서 OfficeQA Pro V1의 정확 일치율은 직접 추론의 15.8 퍼센트에서 60.2 퍼센트로 향상되었으며, V2에서는 4.4 퍼센트에서 61.1 퍼센트로 개선되었습니다. 기존의 최고 성능 에이전트 하네스인 Claude Code와 Codex에 비해서도 V1에서 12.0 포인트, V2에서 18.9 포인트 우월한 성능을 보였습니다. Qwen3.8-Flash 모델을 사용한 추가 실험에서도 OfficeQA Pro V1에서 61.7 퍼센트의 정확도를 달성하여 Claude Code를 8.3 포인트, Codex를 12.0 포인트 상회했습니다. 이러한 일관된 성과는 LongHarness의 명시적 상태 관리 프레임워크가 1억 토큰 규모의 대규모 코퍼스에서 에이전트 기반 추론의 실효성을 획기적으로 향상시키며, 향후 더욱 강력한 언어 모델들과의 결합을 통해 추가 성능 개선을 기대하게 합니다.
초록(Abstract)
코퍼스 레벨 장문맥 추론은 에이전트가 자신의 컨텍스트 윈도우를 초과하는 문서 컬렉션 전체에서 증거를 획득하고 통합해야 합니다. 기존 에이전트 하니스는 이러한 코퍼스에 대한 점진적 접근을 가능하게 하지만, 획득된 증거와 진화하는 결론은 종종 증가하는 상호작용 이력에 얽혀 있습니다. 이러한 암시적 상태 관리는 두 가지 연결된 실패 모드로 이어질 수 있습니다: 의사결정 관련 정보 격차를 해결하지 않으면서 상호작용 이력을 확장하는 무제한 탐색과, 이전에 획득한 증거나 후속 수정이 현재 결론을 반영하지 못하는 증거-상태 표류입니다. 우리는 획득된 증거와 진화하는 결론 간의 상호작용을 명시적으로 만드는 모델에 무관한 하니스인 LongHarness를 제시합니다. 핵심 메커니즘인 증거-결론 공동 진화는 미해결된 결론을 사용하여 누락된 정보로의 탐색을 안내하는 한편, 새로 획득한 증거는 검색을 지시한 결론을 강화하거나 수정합니다. LongHarness는 이 과정을 증거 생명주기 관리와 결합하며, 이는 누적된 증거를 상호작용 전체에서 최신 상태로 유지하고 추적 가능하게 합니다. 이러한 메커니즘들은 함께 검색을 남은 정보 요구에 집중시키고 결론이 현재 증거와 일치하도록 유지합니다. 우리는 GLM-5.3-Flash와 Qwen3.8-Flash를 사용하여 OfficeQA Pro V1과 V2, AA-LCR, LongBench v2에서 LongHarness를 평가합니다. 동일한 백본을 사용한 직접 추론과 비교하여, LongHarness는 OfficeQA Pro에서 GLM-5.3-Flash의 정확한 일치를 V1에서 15.8%에서 60.2%로, V2에서 4.4%에서 61.1%로 향상시킵니다. 최첨단 에이전트 하니스와 비교하여, V1에서 Claude Code를 12.0 포인트로 능가하고 V2에서 Codex를 18.9 포인트로 능가합니다. Qwen3.8-Flash를 사용하면, LongHarness는 V1에서 61.7%에 도달하며, Claude Code를 8.3 포인트로, Codex를 12.0 포인트로 능가합니다.
Corpus-level long-context reasoning requires agents to acquire and integrate evidence across document collections that exceed their context windows. Existing agent harnesses enable incremental access to these corpora, but acquired evidence and evolving conclusions often remain entangled in a growing interaction history. This implicit state management can lead to two coupled failure modes: unbounded exploration, where retrieval expands the interaction history without resolving decision-relevant information gaps, and evidence-state drift, where previously acquired evidence or subsequent corrections fail to inform the current conclusion. We present LongHarness, a model-agnostic harness that makes the interaction between acquired evidence and evolving conclusions explicit. Its core mechanism, Evidence-Conclusion Coevolution, uses unresolved conclusions to guide exploration toward missing information, while newly acquired evidence strengthens or revises the conclusions that directed the search. LongHarness couples this process with Evidence Lifecycle Management, which keeps accumulated evidence current and traceable throughout the interaction. Together, these mechanisms focus retrieval on remaining information needs and keep conclusions aligned with current evidence. We evaluate LongHarness on OfficeQA Pro V1 and V2, AA-LCR, and LongBench v2 using GLM-5.3-Flash and Qwen3.8-Flash. Compared with direct reasoning using the same backbone, LongHarness improves GLM-5.3-Flash exact match on OfficeQA Pro from 15.8% to 60.2% on V1 and from 4.4% to 61.1% on V2. Against state-of-the-art agent harnesses, it surpasses Claude Code by 12.0 percentage points on V1 and Codex by 18.9 points on V2. With Qwen3.8-Flash, LongHarness reaches 61.7% on V1, outperforming Claude Code by 8.3 points and Codex by 12.0 points.
논문 링크
VEPA: 평생 LLM 에이전트 가드레일을 위한 검증된 진화형 형식 정책 / VEPA: Verified Evolving Formal Policy for Lifelong LLM Agent Guardrails
논문 소개
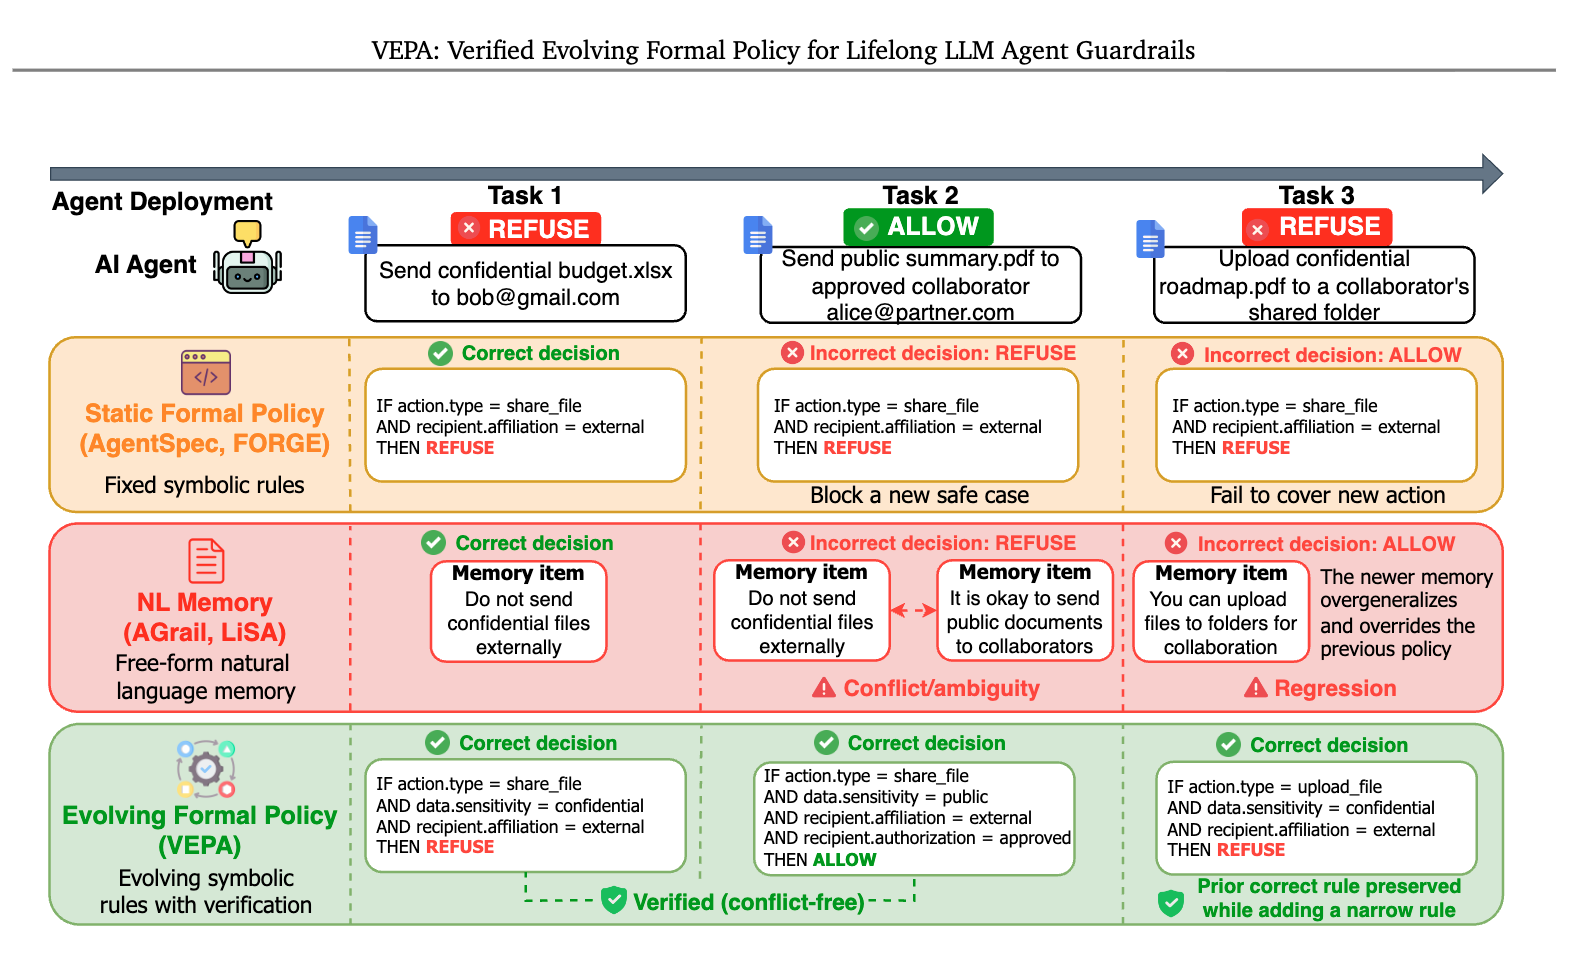
LLM 에이전트가 개인 문서나 변경 가능한 시스템 상태와 같은 민감한 자원에 접근할 수 있게 되면서, 에이전트의 행동으로 인한 안전성과 보안 위험이 심각해지고 있습니다. 런타임 가드레일은 에이전트의 잠재적으로 돌이킬 수 없는 행동을 실행하기 전에 명확하고 재현 가능하며 결정론적인 허용 또는 거부 결정을 내려야 합니다. 그러나 현실적으로 모든 안전성과 보안 요구사항을 배포 이전에 완전히 파악하기는 어려우므로, 새로운 위험이 발생함에 따라 가드레일도 계속 적응해야 합니다. 기존의 적응형 가드레일은 배포 경험에서 학습하지만, 보통 LLM 추론을 통해 안전 정책을 적용하므로 의사결정의 일관성이 떨어지고 정책 해석이 모호해질 수 있습니다. 반면 형식적 가드레일은 정책을 결정론적으로 강제하지만, 일반적으로 사전 배포 정책이나 작업별 정책에만 의존하며 새로운 위험에 적응하는 메커니즘이 부족합니다.
VEPA(Verified Evolving Formal Policy)는 형식적 에이전트 가드레일의 검증된 진화를 위한 프레임워크입니다. VEPA는 형식적 정책을 타입화된 에이전트 이벤트에 대한 실행 가능한 기호적 규칙으로 표현하며, 배포 중에는 배포 피드백으로 안내된 LLM이 새로운 실패를 수정하는 정책 패치를 제안합니다. 그 다음, 결정론적 검증자는 구조적으로 유효하고 충돌이 없는 정책만 수락합니다. 마지막으로 증거 인식 권한 계층은 충분한 증거가 있을 때만 검증된 규칙을 활성화하므로, 불확실한 업데이트가 가드레일 결정에 직접 영향을 미치지 않습니다. 이러한 아키텍처는 세 가지 측면에서 혁신적입니다. 형식적 정책 표현을 통해 결정론적이고 해석 가능한 가드레일을 유지하면서도, LLM 기반의 학습 메커니즘으로 배포 시점에 새로운 위험에 동적으로 대응할 수 있으며, 다층 검증과 증거 기반 활성화를 통해 정책 진화 과정 중에 발생할 수 있는 불안정한 업데이트로부터 시스템을 보호합니다.
VEPA의 성능은 ASSEBench-Safety, ASSEBench-Security, ATBench를 포함한 다양한 벤치마크에서 기존 방식들을 지속적으로 능가했습니다. 혼합 데이터 스트림, 손상된 피드백, 더 긴 배포 기간 등 더 어려운 배포 조건에서도 이러한 이점이 유지되었으므로, VEPA가 단순히 이론적으로 우수한 것뿐만 아니라 실제 배포 환경의 불안정성과 예측 불가능한 상황에도 강건하게 대응할 수 있음을 보여줍니다.
초록(Abstract)
LLM 에이전트들은 비공개 문서 및 변경 가능한 시스템 상태와 같은 민감한 자원에 대해 점점 더 많이 운영되고 있으며, 이는 심각한 안전성 및 보안 위험을 초래할 수 있습니다. 따라서 런타임 가드레일은 잠재적으로 돌이킬 수 없는 에이전트 행동이 실행되기 전에 검사 가능하고, 재현 가능하며, 결정론적인 허용 또는 거부 결정을 내려야 합니다. 하지만 안전성 및 보안 요구사항은 배포 전에 완벽하게 결정되는 경우가 드물기 때문에, 새로운 위험이 나타남에 따라 가드레일은 계속 적응해야 합니다. 기존의 적응형 가드레일은 배포 경험으로부터 학습하지만, 일반적으로 LLM 추론을 통해 안전 정책을 적용하므로 일관성 없는 결정 및 모호한 정책 해석으로 이어질 수 있습니다. 반면 형식적 가드레일은 정책을 결정론적으로 시행하지만, 일반적으로 배포 전 또는 작업 특정 정책에 의존하며 새로 관찰된 위험에 적응할 메커니즘이 없습니다. 우리는 형식적 에이전트 가드레일의 검증된 진화를 위한 프레임워크인 VEPA를 소개합니다. VEPA는 가드레일을 타입 지정된 에이전트 이벤트에 대한 실행 가능한 기호 규칙들의 형식적 정책으로 나타냅니다. 배포 중에는 배포 피드백에 의해 인도되는 LLM을 사용하여 새로 관찰된 실패를 수정하면서 이전에 올바른 동작을 유지하는 정책 패치를 제안합니다. 그 다음, 결정론적 검증기는 구조적으로 유효하고 충돌이 없는 정책만 수락합니다. 마지막으로, 증거 기반 권한 계층은 충분한 증거 지원이 있을 때만 검증된 규칙을 활성화하므로, 불확실한 업데이트는 가드레일 결정에 직접 영향을 미칠 수 없습니다. ASSEBench-Safety, ASSEBench-Security, ATBench에서 VEPA는 결정론적 형식 정책 시행의 범위를 확장하면서 일관되게 기준선을 능가합니다. 이러한 이점들은 혼합 스트림, 손상된 피드백, 더 긴 시간대를 포함한 더욱 어려운 배포 조건 하에서도 유지됩니다.
LLM agents increasingly operate over sensitive resources, such as private documents and mutable system states, which can create serious safety and security risks. Runtime guardrails should therefore make inspectable, reproducible, and deterministic allow or refuse decisions before potentially irreversible agent actions are executed. However, safety and security requirements are rarely complete before deployment, so guardrails need to keep adapting as new risks emerge. Existing adaptive guardrails learn from deployment experience, but they usually apply safety policies through LLM inference, which can lead to inconsistent decisions and ambiguous policy interpretations. Formal guardrails, on the other hand, enforce policies deterministically, but they usually rely on pre-deployment or task-specific policies and have no mechanism to adapt to newly observed risks. We introduce VEPA, a framework for the verified evolution of formal agent guardrails. VEPA represents the guardrail as a formal policy of executable symbolic rules over typed agent events. During deployment, we use an LLM guided by deployment feedback to propose policy patches that fix newly observed failures while preserving previously correct behavior. Then, a deterministic verifier only accepts policies that are structurally valid and conflict-free. Finally, an evidence-aware authority layer activates a verified rule only when it has enough supporting evidence, so uncertain updates cannot directly affect guardrail decisions. Across ASSEBench-Safety, ASSEBench-Security, and ATBench, VEPA consistently outperforms baselines while expanding the scope of deterministic formal-policy enforcement. These gains also hold under more challenging deployment conditions, including mixed streams, corrupted feedback, and longer horizons.
논문 링크
VideoJev: 비디오 이해 및 상호작용을 위한 System One 모델 / VideoJev: System One Model for Video Understanding and Interaction
논문 소개
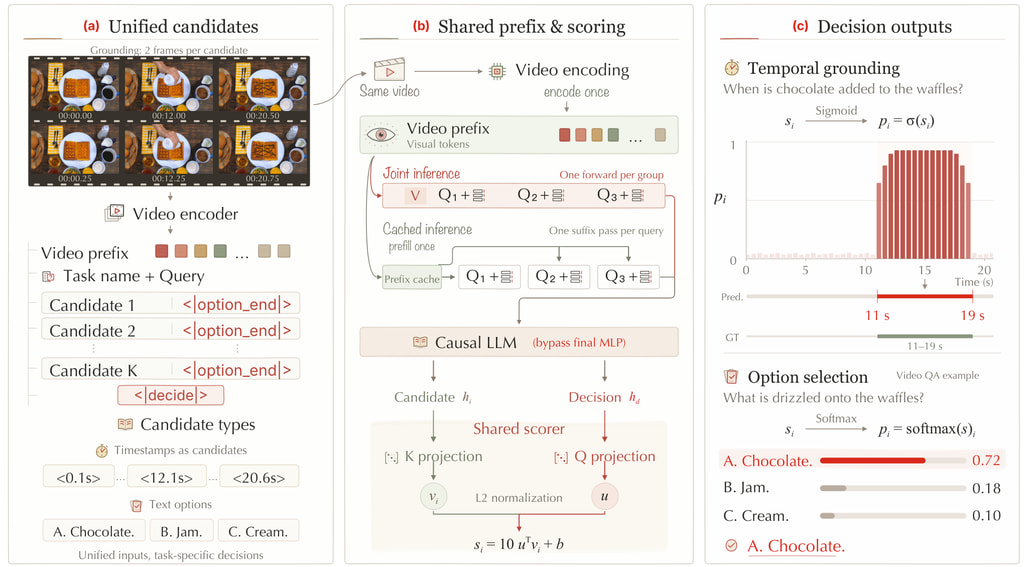
비디오 기반 의사결정 시스템이 각 판단 단계마다 시간이 많이 걸리는 개방형 생성을 수행해야 한다는 제약을 극복하기 위해 VideoJev가 제시됩니다. 본 연구는 시각 에이전트가 동일한 비디오를 여러 번 분석하면서도 효율적인 응답을 제공해야 한다는 실질적 요구에서 출발하며, 이를 해결하기 위해 시스템 원(System One) 패러다임을 비디오 이해에 적용합니다. 기존의 멀티모달 대규모 언어 모델들이 자기회귀적 생성을 통해 타임스탬프나 답변 텍스트를 만드는 방식과 달리, VideoJev는 시간 간격과 선택지를 비디오 증거에 대해 직접 점수화하는 구조로 재설계되었습니다. 이러한 접근은 시간적 그라운딩과 다중선택 비디오 질의응답을 공유된 점수화 헤드를 통해 통합하면서도, 사전학습된 모델의 의미론적 유연성을 완전히 활용합니다.
추론 효율성을 극대화하기 위해 VideoJev는 두 가지 핵심 기법을 도입합니다. 캐시된 추론에서는 비디오가 한 번만 인코딩되고 이후 도착하는 쿼리들이 이 캐시된 시각적 문맥을 재사용하며, 조인트 추론에서는 여러 쿼리가 단일 정방향 전달에서 함께 처리되어 계산을 공유합니다. 세 개의 시간적 그라운딩 벤치마크에서 VideoJev는 백본 모델 대비 평균 mIoU를 6.7에서 10.8점까지 향상시키면서 2.8배에서 3.1배의 추론 속도 향상을 달성합니다. 네 개의 비디오 질의응답 벤치마크에서는 사고 모드 백본과 동등한 정확도를 유지하면서 100배 이상의 속도 향상을 실현합니다. 이와 같은 성능 개선은 구조화된 시각적 판단이 단순한 생성 없이도 복잡한 개방형 에이전트 행동을 효과적으로 지원할 수 있음을 입증하며, 반응형 시각 상호작용이 필요한 실제 응용에서 실질적인 가치를 제공합니다.
초록(Abstract)
시각 에이전트는 비디오 관찰을 적시에 의사결정으로 전환하여 진행 상황을 추적하고 다음 행동을 선택해야 합니다. 새로운 System One 패러다임을 기반으로, 우리는 비디오 이해 및 상호작용을 구조화된 의사결정 작업으로 표현하는 모델 계열인 VideoJev를 소개합니다. 우리는 자동회귀 답변 디코딩을 비디오 증거에 대해 시간 간격과 텍스트 옵션을 점수 매기는 공유 헤드로 대체하여 사전학습된 멀티모달 대규모 언어 모델(MLLM)을 적응시킵니다. 이러한 점수는 이벤트 스팬 또는 답안 선택지를 생성하여, 시간적 그라운딩(temporal grounding)과 객관식 비디오 질의응답을 통합합니다. 이는 MLLM의 의미적 유연성을 에이전트가 직접 사용할 수 있는 효율적인 의사결정과 결합합니다. 상호작용이 진행됨에 따라, 새로운 목표와 중간 결과가 동일한 시각 이력에 대한 추가 쿼리를 유발합니다. 따라서 VideoJev는 들어오는 쿼리에 대한 캐시된 추론(Cached inference)과 단일 순전파에서 여러 쿼리에 대한 공동 추론(Joint inference)을 통해 시각 계산을 재사용합니다. 세 개의 시간적 그라운딩 벤치마크에서 VideoJev-4B와 VideoJev-35B-A3B는 각각 백본 대비 평균 mIoU를 6.7점과 10.8점 향상시켰으며, 측정된 추론 속도 향상은 2.8배~3.1배입니다. 네 개의 비디오 QA 벤치마크에서 둘 다 Thinking 모드에서 백본과 비교 가능한 성능을 달성했으며, 측정된 추론 속도 향상은 100배를 초과합니다. 이러한 결과는 구조화된 시각 판단을 복잡한 개방형 워크플로우로 구성하기 위한 통합된 재사용 가능한 의사결정 인터페이스를 제공합니다.
Visual agents must turn video observations into timely decisions to track progress and choose what to do next. Building on the emerging System One paradigm, we introduce VideoJev, a family of models that cast video understanding and interaction as structured decision tasks. We adapt pretrained multimodal large language models (MLLMs) by replacing autoregressive answer decoding with a shared head that scores temporal intervals and textual options against video evidence. These scores yield event spans or answer choices, unifying temporal grounding and multiple-choice video question answering. This combines the semantic flexibility of MLLMs with efficient decisions that agents can use directly. As an interaction unfolds, new goals and intermediate results prompt further queries about the same visual history. VideoJev therefore reuses visual computation through Cached inference for queries as they arrive and Joint inference for multiple queries in a single forward pass. Across three temporal grounding benchmarks, VideoJev-4B and VideoJev-35B-A3B improve mean mIoU over their backbones by 6.7 and 10.8 points, respectively, with measured inference speedups of 2.8-3.1\times. On four video QA benchmarks, both achieve performance comparable to their backbones in Thinking mode, with measured inference speedups exceeding 100\times. These results offer a unified, reusable decision interface for composing structured visual judgments into complex, open-ended workflows.
논문 링크
더 읽어보기
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일 로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 뉴스 발행에 힘이 됩니다~
