핵심 요약
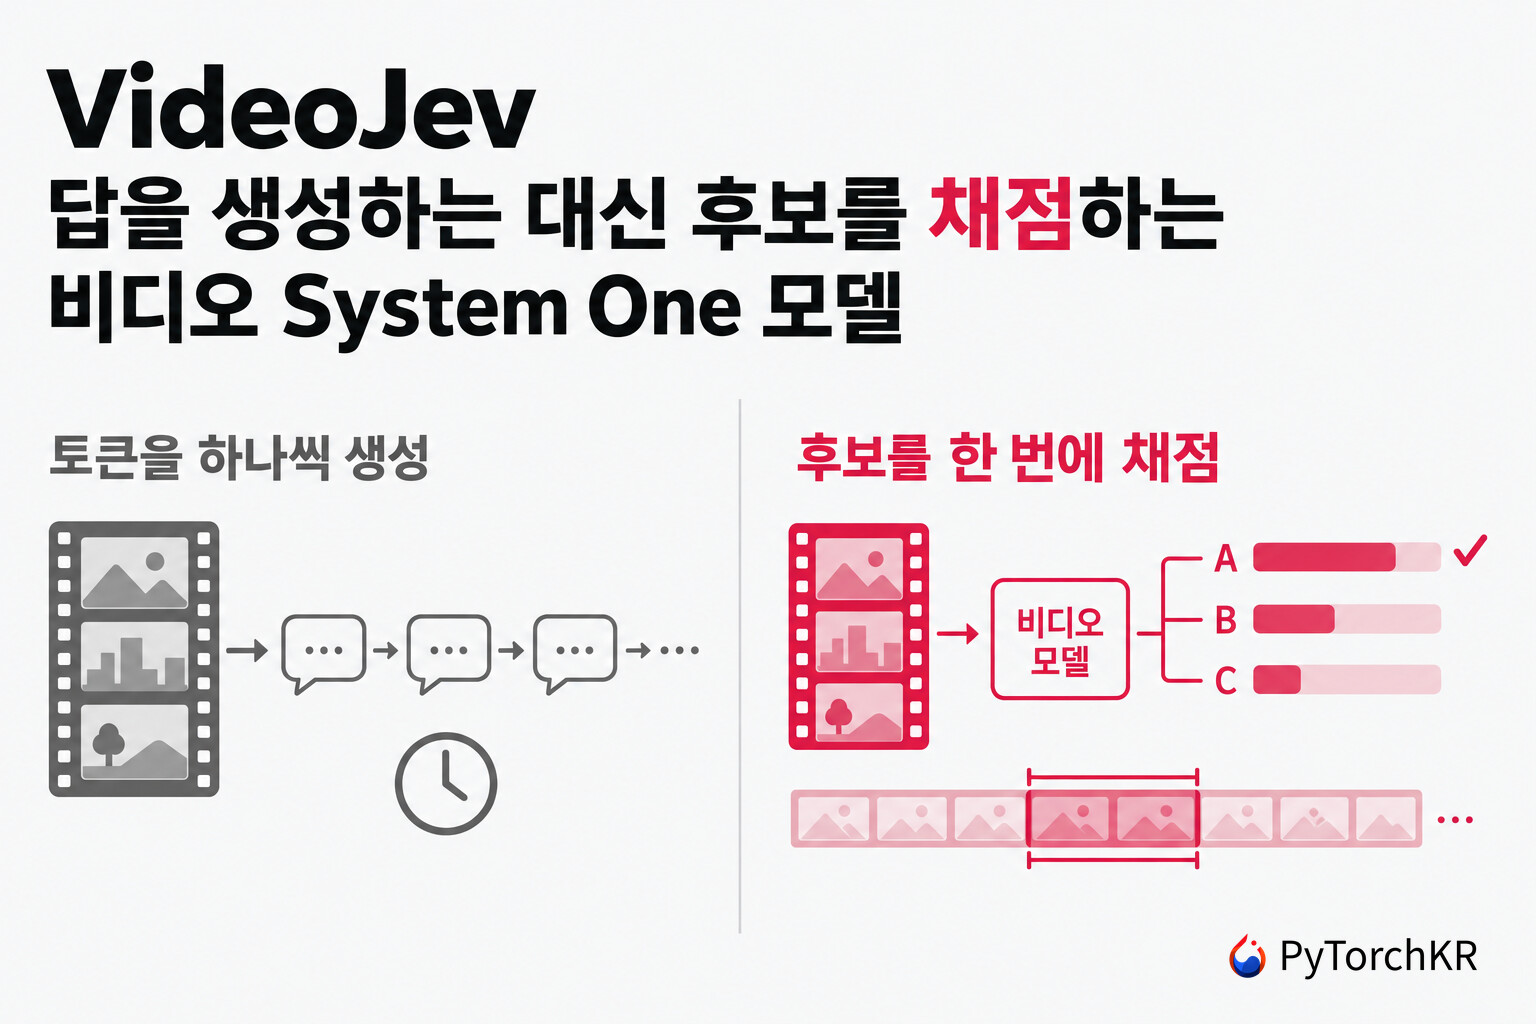
- VideoJev 논문은 비디오 멀티모달 LLM의 출력 헤드를 후보 채점 헤드로 바꿉니다. 그래서 시간 구간 찾기와 객관식 비디오 질의응답을 텍스트 생성 없이 한 번의 순전파로 풉니다.
- 영상 부분을 한 번만 인코딩하고 여러 질문이 그 계산을 공유합니다. 4B 모델은 Joint inference에서 질문을 1개에서 10개로 늘려도 구간 찾기 시간이 55ms만 늘었습니다.
- 시간 구간 찾기 3종 평균 mIoU는 기반 모델(Qwen3.5-4B, Qwen3.6-35B-A3B)보다 6.7점, 10.8점 높고 지연 시간은 2.8~3.1배 짧습니다. 객관식 질의응답 4종 평균은 Thinking 모드와 비슷하지만 Video-MME와 MLVU에서는 Thinking 모드가 여전히 앞섭니다.
- GitHub 저장소와 4B, 35B-A3B 가중치가 Apache 2.0으로 공개됐습니다. 다만 질의응답 학습 데이터 약 24만 문항은 내부 데이터이고, 확률 출력의 보정 오차(ECE)가 8~9%p로 대체로 과신합니다.
VideoJev 소개
VideoJev는 영상을 보고 "이 장면이 언제 나오는가" 와 "보기 중 무엇이 맞는가" 라는 두 종류의 질문에, 답을 글자로 쓰지 않고 후보마다 점수를 매겨 바로 고르는 비디오 모델입니다. 난징대학교 멀티미디어 컴퓨팅 그룹(MCG-NJU)이 JD.com, 중국과학원대학 등 7개 기관과 함께 2026년 10월 13일 arXiv에 논문을 올렸고, 코드와 가중치도 함께 공개했습니다.
지금의 비디오 멀티모달 대규모 언어 모델(Multimodal Large Language Model, MLLM)은 답이 짧아도 생성으로 답합니다. 사건이 몇 초에 일어났는지 물으면 타임스탬프를 토큰으로 하나씩 출력하고, 객관식 문제에도 답 텍스트를 생성합니다. 사람과 대화할 때는 문제가 되지 않습니다. 그런데 에이전트는 같은 영상을 두고 판단을 여러 번 내립니다. 요리 절차를 따라가는 비서라면 "재료를 넣었는가" 를 확인한 뒤에야 다음 단계를 고릅니다.
저자들은 이런 판단이 대부분 구조화된 선택이라는 점에 주목했습니다. 판단 하나하나는 생성이 아니라 선택이므로 더 싸게 처리할 수 있다는 것이 출발점입니다.
이름의 Jev는 TypeSafe AI가 발표한 System One 모델 Jev에서 왔습니다. System One 모델은 문자열을 생성하지 않고, 미리 정한 선택지에 대한 확률적 판단을 소프트웨어가 바로 쓸 수 있는 형태로 내놓는 모델입니다. Jev는 TypeSafe가 서비스로 제공하는 비공개 모델이고, VideoJev는 그 발상을 영상으로 옮긴 오픈 모델입니다. Jev의 가중치를 쓴 것이 아니라 Qwen3.5-4B와 Qwen3.6-35B-A3B를 기반 모델로 다시 학습했습니다. 범용 LLM을 Jev식 결정 모델로 바꾸는 다른 방법은 LLM-as-Jev 글에서 다룬 적이 있습니다.
아래 영상은 프로젝트 페이지에 올라온 VideoJev 소개 영상입니다.
답을 쓰지 않고 후보에 점수를 매기는 구조
VideoJev는 사전 학습된 MLLM에서 두 가지를 바꿉니다. 언어 모델의 마지막 MLP 층과 출력 헤드(LM head)를 떼어 내고, 그 자리에 후보 채점기(candidate scorer) 를 붙입니다. 입력에는 새 토큰 두 개가 들어갑니다. 후보 하나가 끝날 때마다 <|option_end|> 를 붙이고, 후보 목록 끝에는 <|decide|> 를 붙입니다. 두 토큰 모두 기존 <|im_end|> 임베딩에서 초기화합니다.
입력 순서는 영상 토큰, 과제 지시문, 질문, 후보 목록입니다. 인과(causal) 언어 모델이므로 각 후보의 읽기 지점은 영상, 질문, 앞선 후보까지 보고, <|decide|> 는 후보 목록 전체를 봅니다. 채점기는 <|decide|> 의 은닉 상태 h_d 와 각 후보의 은닉 상태 h_i 를 선형 투영으로 512차원에 옮기고 길이 1로 정규화합니다. 점수는 둘의 내적입니다.
배율 10은 고정값이고 b 는 학습하는 스칼라 편향입니다. 마지막 MLP를 떼어 낸 근거는 저자들의 이전 연구 FreeRet입니다. MLP 직전의 특징이 의미 유사도 계산에 쓸 만하다는 관찰입니다. 절제 실험에서 MLP를 남겨 두면 평균 점수가 구간 찾기와 질의응답 모두 0.2점씩 낮았습니다. 저자들은 이 차이를 성능이 사실상 같은 수준으로 보고 더 단순한 쪽을 택했습니다.
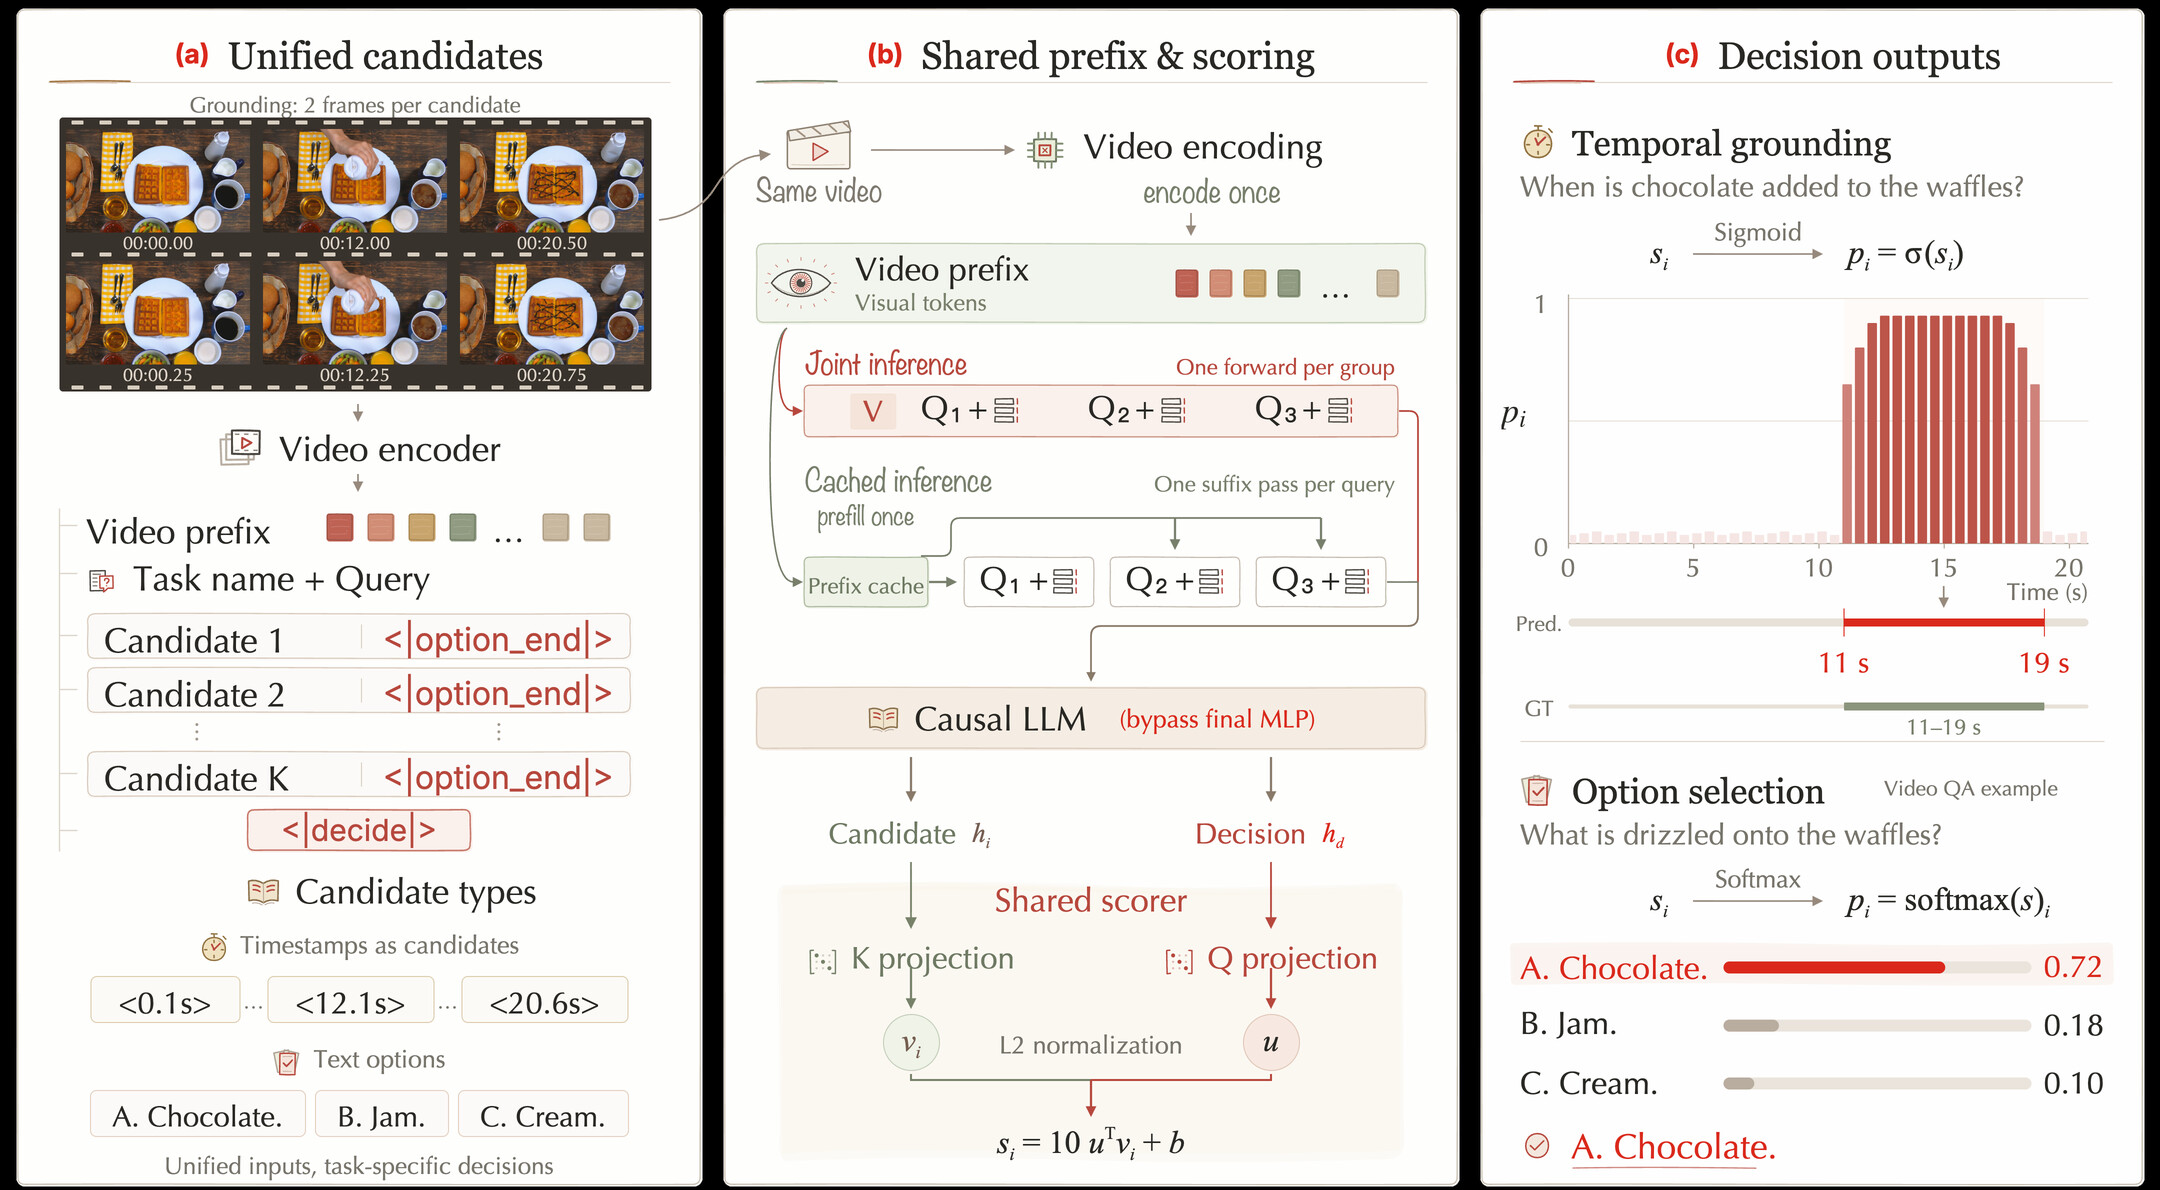
위 그림의 (a)는 두 과제가 같은 입력 형식을 쓰는 모습이고, (c)는 같은 점수를 과제마다 다르게 해석하는 모습입니다. 과제는 지시문, 후보의 종류, 출력 규칙으로 구분합니다.
시간 구간 찾기: 구간마다 소속 확률을 매기고 연속 구간을 고릅니다
시간 구간 찾기(Temporal Grounding) 는 "초록 옷 입은 여성이 파스타를 먹는다" 같은 문장이 영상의 몇 초부터 몇 초까지인지 찾는 과제입니다. 기반 모델은 프레임 두 장을 한 묶음으로 압축하므로, VideoJev는 영상의 타임라인을 프레임 쌍마다 한 칸씩 잘라 후보 구간으로 씁니다. 각 후보는 타임스탬프 문자열로 표시합니다.
각 구간의 점수에 시그모이드를 씌우면 그 구간이 사건에 속할 확률 p_i = \sigma(s_i) 가 됩니다. 한 사건이 여러 구간에 걸치므로 구간마다 따로 맞히는 이진 교차 엔트로피(BCE)를 쓰고, 사건 전체를 덮었는지는 구간 길이로 가중한 Soft IoU 손실 로 따로 학습합니다. Soft IoU는 예측과 정답의 겹침 비율(IoU)을 확률로 미분 가능하게 바꾼 손실입니다.
d_i 는 구간 길이이고 y_i 는 그 구간의 중심이 정답 사건 안에 있으면 1입니다. 절제 실험에서 이 손실을 빼면 평균 mIoU가 65.3에서 60.7로 4.6점 떨어졌습니다. 질의응답 점수도 0.4점 낮아져, 저자들은 시간 학습이 공유 표현에도 도움이 된다고 해석합니다.
추론(inference) 때는 각 점수에서 임계값 \tau = 0.25 에 해당하는 로짓 \log\frac{\tau}{1-\tau} 를 뺀 뒤, 합이 가장 큰 연속 구간 하나를 고릅니다. 최대 부분합 문제이므로 카데인 알고리즘(Kadane's algorithm)으로 O(K) 시간에 풉니다. 저자들은 이 임계값을 두 모델 크기와 모든 실험에서 0.25로 고정했고, 공개 코드에서는 threshold 인자로 바꿀 수 있습니다. 출력이 연속 구간 하나이므로, 한 문장이 영상에서 여러 번 떨어져 일어나는 경우도 구간 하나로만 답합니다(학습 데이터 TimeLens2-93K에는 여러 구간짜리 정답이 12,091쌍 있습니다).
객관식 질의응답: 보기마다 점수를 매기고 소프트맥스로 고릅니다
객관식 비디오 질의응답(Video QA)에서는 후보가 보기 텍스트입니다. 정답이 하나이므로 보기 점수에 소프트맥스(softmax)를 씌워 확률로 만들고 교차 엔트로피로 학습합니다. 학습 때는 문항마다 정해진 방식으로 보기 순서를 섞고 정답 번호를 고칩니다. 보기 위치만 보고 답을 고르는 지름길을 막기 위해서입니다. 보기 위치를 언급하는 문항은 뜻이 바뀌므로 섞지 않습니다. 추론 때는 주어진 순서 그대로 두고 확률이 가장 높은 보기를 고릅니다.
영상을 한 번만 읽는 두 가지 추론 방식
인과 모델에서 영상 부분은 뒤에 오는 질문의 영향을 받지 않습니다. 그래서 영상 부분, 곧 접두 문맥(prefix)의 계산을 여러 질문이 나눠 쓸 수 있고, VideoJev는 이를 두 가지 방식으로 씁니다.
| 방식 | 동작 | 맞는 상황 |
|---|---|---|
| Cached inference | 영상을 한 번 인코딩하고 미리 채우기(prefill)를 한 뒤, 그 캐시에서 질문마다 따로 가지를 쳐 순전파 1회 | 질문이 시간차를 두고 하나씩 도착할 때 |
| Joint inference | 영상 뒤에 질문 여러 개와 각자의 후보 목록을 이어 붙이고, 질문마다 `< | decide |
Joint inference에서는 뒤 질문이 앞 질문의 텍스트와 후보를 볼 수 있습니다. 질문을 서로 가리는 별도 마스크를 쓰지 않은 이유는 FlashAttention 같은 최적화 커널을 그대로 쓰기 위해서입니다. 앞 질문의 정답이나 예측은 끼워 넣지 않으므로 답이 새지는 않는다고 저자들은 밝혔습니다.
질문을 묶어서 처리했을 때 점수는 오히려 소폭 올랐습니다. 저자들은 학습도 같은 배치(layout)로 하기 때문일 수 있다고 봅니다. 4B는 구간 찾기 0.8점, 질의응답 0.5점, 35B-A3B는 각각 0.3점, 0.7점입니다. 14개 비교 중 13개에서 올랐고 35B-A3B의 QVHighlights 하나만 0.1점 내려갔습니다. (단, 프로젝트 페이지에 따르면 35B-A3B는 Cached에 FP32 가중치, Joint에 BF16 가중치를 썼습니다.)
생성 모델은 이 방식을 그대로 쓰기 어렵습니다. 답이 토큰 하나라면 질문 묶음에서 각 답 자리의 다음 토큰 분포를 한 번에 읽을 수 있습니다. 하지만 타임스탬프나 사고 과정(reasoning trace)은 여러 토큰을 생성해야 합니다. 앞 토큰을 다시 입력으로 넣어야 하므로 질문마다 따로 디코딩합니다.
학습 방법과 데이터
학습은 두 단계입니다. 1단계에서는 언어 백본과 새 토큰 임베딩을 얼려 두고 채점 헤드만 영상 30%로 학습합니다. 2단계에서는 나머지 70% 영상으로 언어 백본, 새 토큰 임베딩, 헤드를 함께 학습하면서 구간 찾기에 Soft IoU 손실을 더합니다. 비전 인코더는 두 단계 모두 얼려 둡니다. 저자들은 이 순서를 MLLM의 프로젝터 정렬 단계(LLaVA)에서 가져왔습니다.
다만 이 두 단계가 점수를 올리지는 않았습니다. 같은 데이터를 한 단계로 전부 학습한 경우가 평균 mIoU 0.1점, 질의응답 평균 0.4점 높았고, 질의응답 차이는 대부분 MLVU 한 곳(+2.0점)에서 나왔습니다. 저자들은 백본을 갱신하는 영상이 70%로 줄어드는 비용 이점 때문에 두 단계를 택했다고 설명합니다.
| 항목 | 내용 |
|---|---|
| 구간 찾기 데이터 | TimeLens-100K, TimeLens2-93K (공개) |
| 질의응답 데이터 | 영상 약 1.9만 개, 객관식 문항 약 24만 개의 내부 데이터. 영상 길이 4분~약 2시간, 보기 4~5개 (공개되지 않음) |
| 학습 하드웨어 | NVIDIA H200 64장, BF16, 전역 배치 64팩, 최대 시퀀스 144K 토큰 |
| 학습 프레임워크 | XTuner, 4B는 DeepSpeed ZeRO-2, 35B-A3B는 ZeRO-3 |
| 갱신 횟수 | 1단계 160회, 2단계 375회 |
질의응답 데이터가 공개되지 않았으므로, 공개 저장소로 같은 가중치를 처음부터 재현할 수는 없습니다. 저장소가 제공하는 것은 학습 코드와 JSONL 형식의 사용자 데이터 준비 스크립트입니다.
벤치마크 결과: 구간 찾기는 앞서고, 질의응답은 Thinking 모드와 비슷합니다
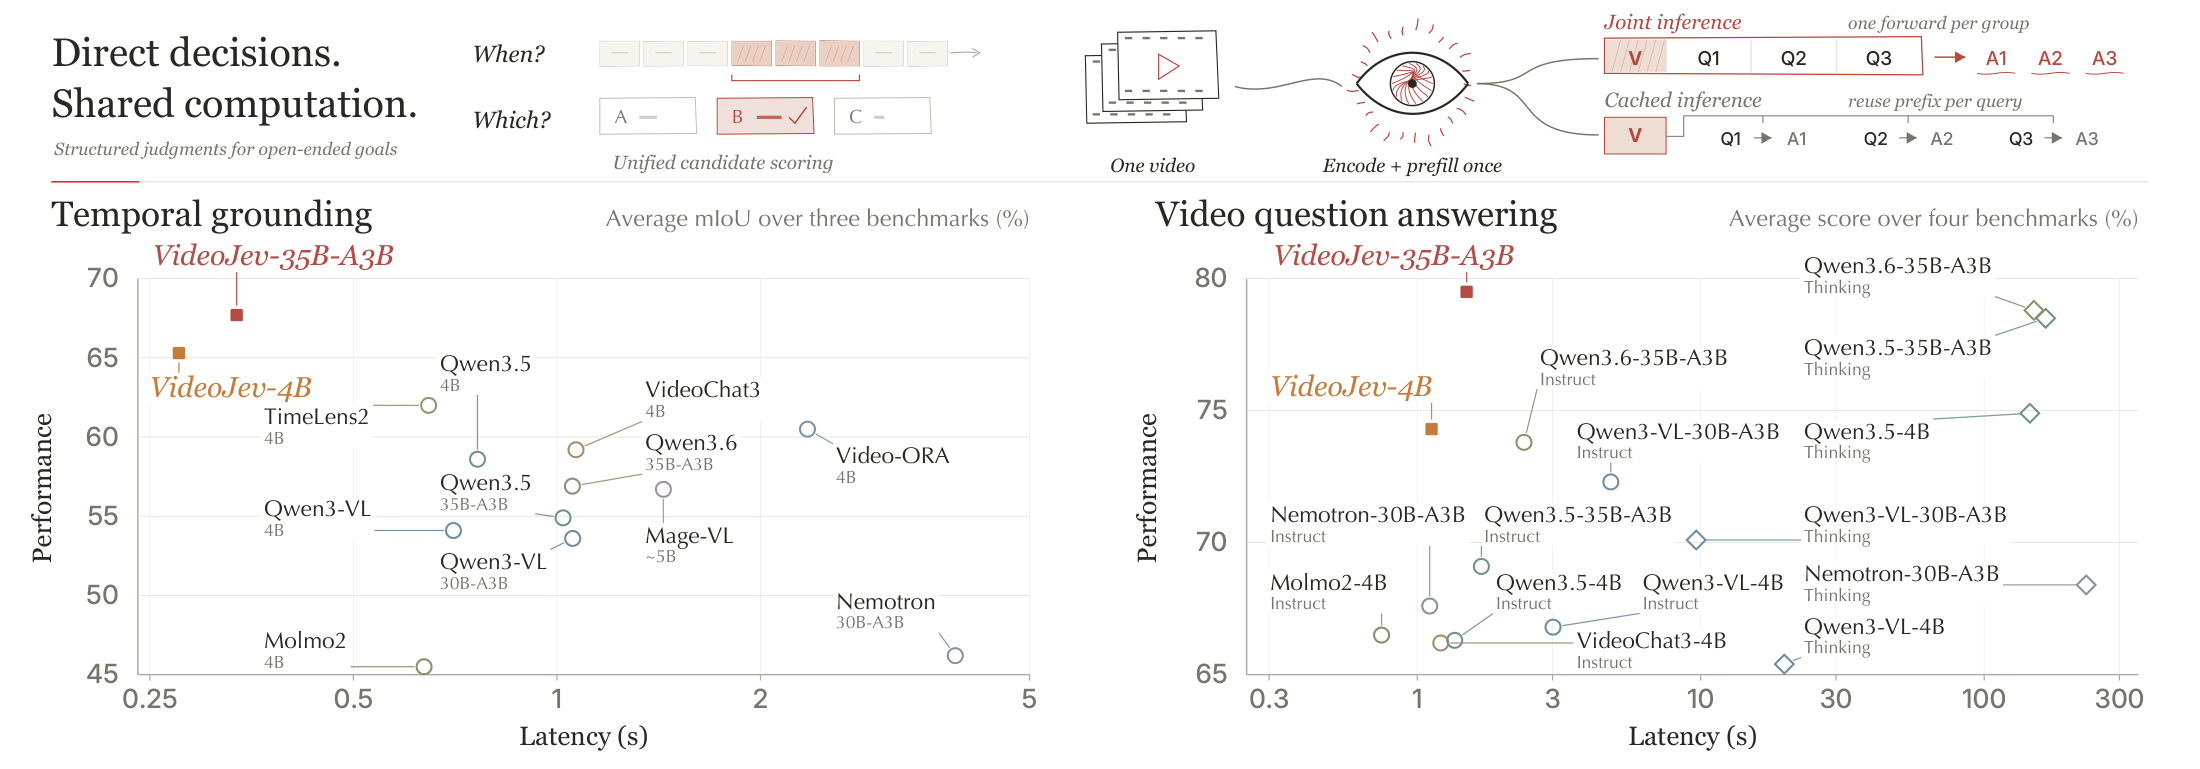
위 그림에서 VideoJev 두 모델은 왼쪽 위 구석에 있습니다. 같은 지연 시간대의 다른 모델보다 점수가 높습니다. 지연 시간은 H200 한 장, 배치 크기 1에서 측정한 모델 순전파 시간이고 영상 디코딩과 전처리는 뺐습니다. 비교 대상 생성 모델도 영상 인코딩과 미리 채우기는 공유하고 답만 질문마다 따로 생성하도록 맞췄습니다.
시간 구간 찾기
구간 찾기는 TimeLens-Bench가 다시 다듬은 정답으로 Charades-STA, ActivityNet Captions, QVHighlights 세 벤치마크를 평가했습니다. mIoU는 예측 구간과 정답 구간의 겹침 비율 평균입니다. 아래 표는 논문 Table 1의 일부입니다.
| 모델 | 지연 시간(초) | Charades | ActivityNet | QVHighlights | 평균 mIoU |
|---|---|---|---|---|---|
| GPT-5 | - | 40.5 | 42.9 | 56.8 | 46.7 |
| Gemini-2.5-Pro | - | 52.8 | 58.1 | 70.4 | 60.4 |
| Qwen3.5-4B | 0.763 | 52.3 | 55.6 | 67.9 | 58.6 |
| TimeLens2-4B | 0.646 | 57.7 | 59.0 | 69.3 | 62.0 |
| VideoJev-4B | 0.276 | 60.1 | 62.8 | 73.2 | 65.3 |
| Qwen3.6-35B-A3B | 1.054 | 47.3 | 56.0 | 67.5 | 56.9 |
| VideoJev-35B-A3B | 0.336 | 63.7 | 65.5 | 74.0 | 67.7 |
VideoJev-4B는 같은 4B 계열에서 가장 높은 TimeLens2-4B(같은 연구실의 이전 모델)보다 평균 3.3점 높고, 겹침 기준이 가장 엄격한 R1@0.7(IoU 0.7 이상을 맞힌 비율)에서도 세 데이터셋 모두 2.8~4.8점 앞섭니다. 35B-A3B는 기반 모델보다 10.8점 높습니다. 기반 모델 Qwen3.6-35B-A3B(56.9)가 Qwen3.5-4B(58.6)보다 낮은 점수에서 출발했다는 점도 표에서 볼 수 있습니다. 표의 Qwen 계열 점수는 저자들이 같은 조건(초당 4프레임, 144K 토큰 컨텍스트)으로 다시 평가한 값이고, GPT-5, Gemini-2.5-Pro, TimeLens2-4B는 각 출처가 발표한 점수를 옮긴 값입니다. 두 상용 모델은 지연 시간도 재지 않았습니다.
객관식 비디오 질의응답
질의응답은 LVBench, Video-MME, LongVideoBench, MLVU 네 벤치마크를 자막과 음성 없이 영상 프레임만으로 평가했습니다. VideoJev는 256K 토큰 컨텍스트, 초당 2프레임, 최대 2,048프레임을 씁니다. 아래 표는 논문 Table 2의 일부입니다.
| 모델 | 지연 시간(초) | LVBench | Video-MME | LongVideoBench | MLVU | 평균 |
|---|---|---|---|---|---|---|
| Qwen3.5-4B Instruct | 1.355 | 60.0 | 70.6 | 61.2 | 73.3 | 66.3 |
| Qwen3.5-4B Thinking | 144.929 | 66.4 | 76.9 | 73.6 | 82.8 | 74.9 |
| VideoJev-4B | 1.123 | 67.9 | 75.0 | 73.6 | 80.6 | 74.3 |
| Qwen3.6-35B-A3B Instruct | 2.379 | 66.0 | 77.1 | 72.4 | 79.5 | 73.8 |
| Qwen3.6-35B-A3B Thinking | 149.777 | 71.4 | 82.5 | 74.9 | 86.2 | 78.8 |
| VideoJev-35B-A3B | 1.493 | 73.4 | 81.8 | 77.1 | 85.9 | 79.5 |
위 표를 통해 세 가지를 알아볼 수 있습니다. 먼저 Instruct 모드의 기반 모델보다는 네 벤치마크 모두 높고, 평균 차이는 4B 8.0점, 35B-A3B 5.7점입니다. 다음으로 Thinking 모드와의 비교에서는 평균만 보면 4B가 0.6점 낮고 35B-A3B가 0.7점 높습니다. 벤치마크별로는 LVBench에서 VideoJev가 앞서고 LongVideoBench에서는 같거나 높지만, Video-MME와 MLVU에서는 두 크기 모두 Thinking 모드가 앞섭니다. 마지막으로 지연 시간은 Thinking 모드 대비 4B가 129배, 35B-A3B가 100배 짧습니다. 즉 "Thinking과 비슷한 성능" 은 평균 기준이고, 사고 과정을 길게 생성하는 쪽이 여전히 이기는 벤치마크가 있습니다.
같은 데이터로 학습한 생성 모델과의 비교
점수 향상이 구조가 아니라 학습 데이터 덕분일 수도 있습니다. 저자들은 이를 가르려고 일반 Qwen3.5-4B를 VideoJev와 똑같은 사후 학습 데이터(영상 58,424개, 문항 404,037개)로 한 단계 미세조정했습니다. 이 모델은 마지막 MLP와 출력 헤드를 그대로 두고 구간이나 보기 글자를 생성하도록 학습합니다. 비교 대상 VideoJev도 한 단계 학습 버전입니다.
| 모델 | 구간 찾기 평균 mIoU | 질의응답 평균 |
|---|---|---|
| Qwen3.5-4B 생성형 미세조정 | 64.1 | 72.8 |
| VideoJev-4B (한 단계 학습) | 65.4 | 74.7 |
차이는 구간 찾기 1.3점, 질의응답 1.9점입니다. 저자들은 결정을 직접 학습하는 구조가 같은 데이터를 더 잘 쓴다고 해석합니다. 다만 Charades 하나에서는 생성형 미세조정이 0.4점 높았고, 차이의 상당 부분은 QVHighlights(2.9점)와 MLVU(4.0점)에서 나왔습니다. 두 과제를 함께 학습한 효과도 따로 쟀습니다. 구간 찾기만 학습했을 때보다 평균 mIoU가 0.7점, 질의응답만 학습했을 때보다 평균 점수가 1.3점 높았습니다.
질문이 늘어날 때의 비용
에이전트가 한 영상에 질문을 계속 던지는 상황을 가정해, 저자들은 질문을 1개에서 10개까지 늘리며 4B 모델의 평균 순전파 시간을 쟀습니다. 구간 찾기는 Charades에서, 질의응답 시간은 Video-Holmes에서 영상 40개씩 뽑아 측정했습니다. 그래프 끝의 정확도 라벨은 시간과 따로, Charades 전체와 LVBench 전체에서 잰 값입니다.
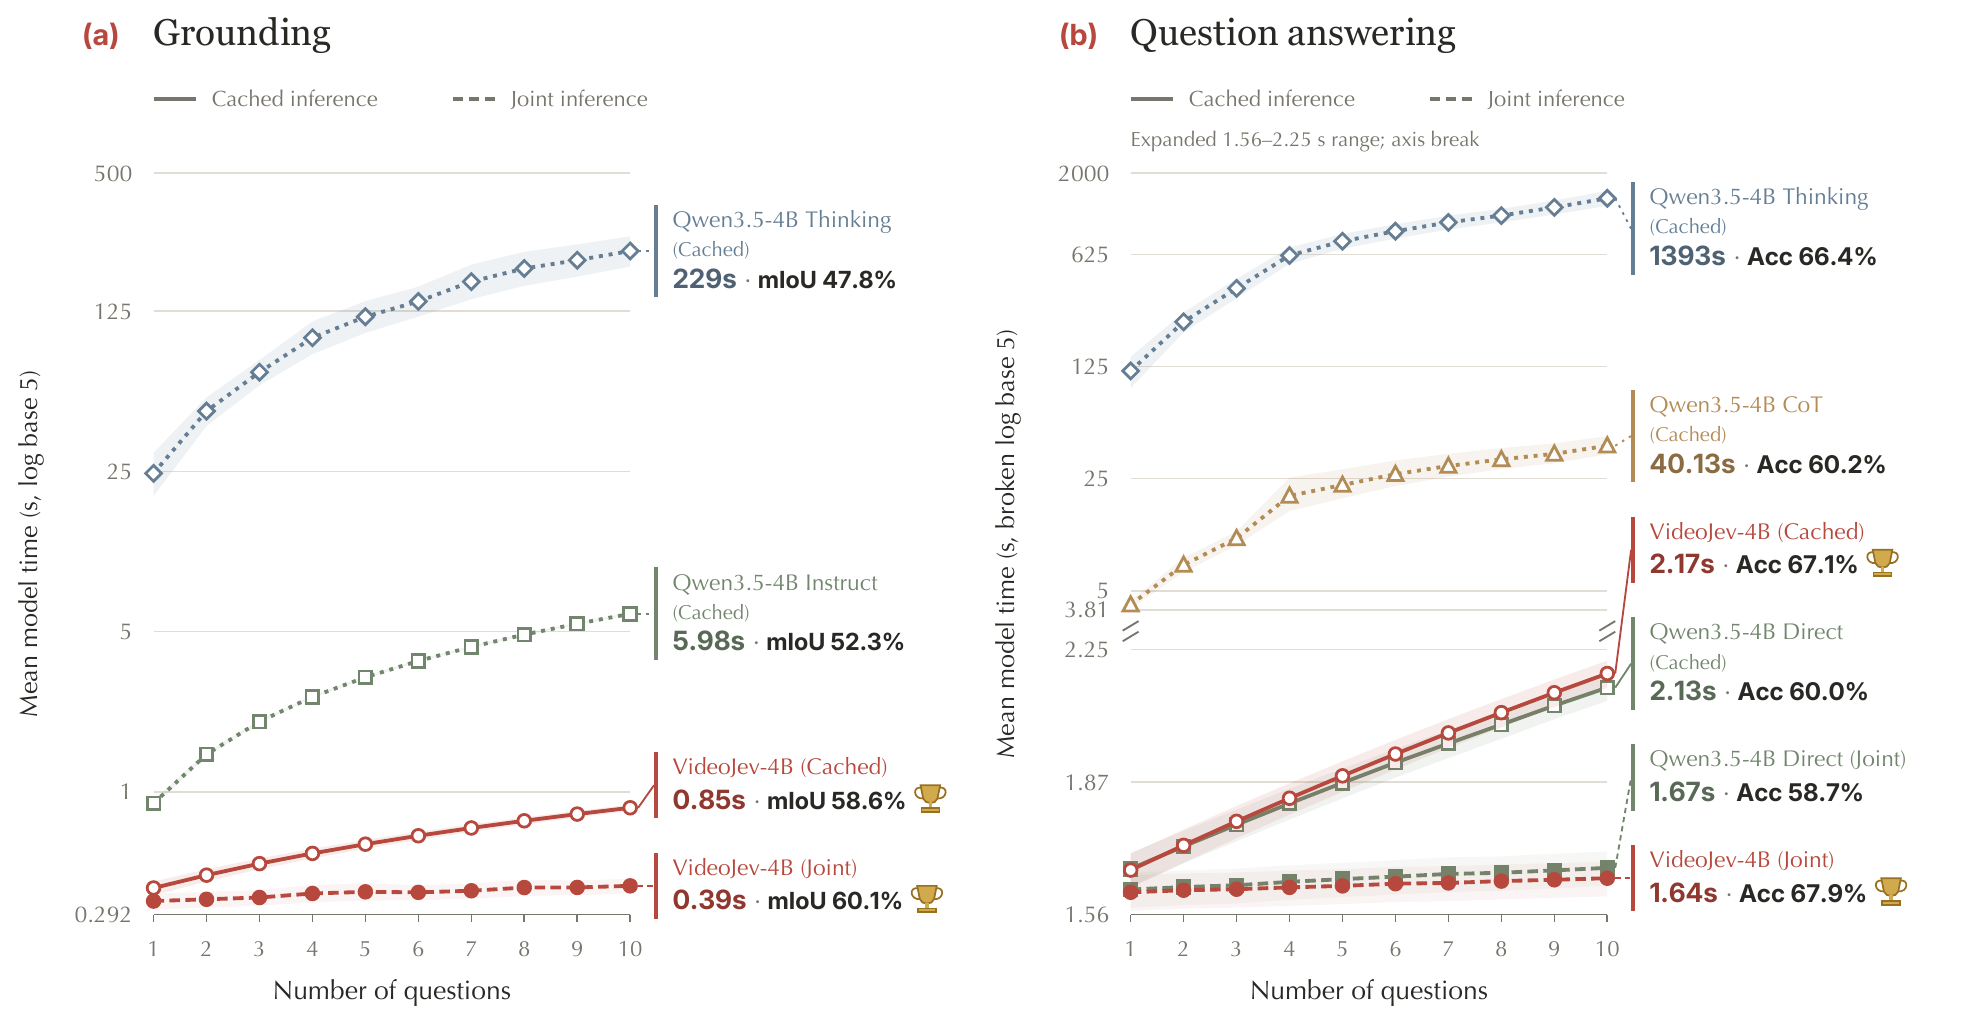
Joint inference는 질문이 1개에서 10개로 늘 때 구간 찾기 55ms, 질의응답 31ms만 늘었습니다. 질문 10개 기준으로 정리하면 다음과 같습니다.
| 과제 | 방식 | 10개 질문 시간 | 품질 |
|---|---|---|---|
| 구간 찾기 | Qwen3.5-4B Thinking | 229초 | mIoU 47.8 |
| 구간 찾기 | Qwen3.5-4B Instruct | 5.98초 | mIoU 52.3 |
| 구간 찾기 | VideoJev-4B Cached | 0.85초 | mIoU 58.6 |
| 구간 찾기 | VideoJev-4B Joint | 0.39초 | mIoU 60.1 |
| 질의응답 | Qwen3.5-4B Thinking | 1,393초 | 정확도 66.4% |
| 질의응답 | Qwen3.5-4B Direct (Joint) | 1.67초 | 정확도 58.7% |
| 질의응답 | VideoJev-4B Joint | 1.64초 | 정확도 67.9% |
Direct 는 생성 모델이 사고 과정 없이 보기 글자 토큰 하나만 내도록 만든 비교 조건입니다. 이 조건도 Joint 방식으로 묶어 처리할 수 있어 시간은 VideoJev와 거의 같습니다. 하지만 정확도는 Cached 방식의 60.0%에서 Joint 방식의 58.7%로 오히려 내려갔습니다.
부록에는 이 방식과 관련된 관찰도 있습니다. 답 칸을 비워 둔 채 질문을 이어 붙이면 Qwen3.5-4B가 두 번째 질문부터 1,446개 중 1,418개에 보기 대신 종료 토큰을 내놓았고, 저자들은 빈 답 기록에 민감하다고 해석했습니다. 그래서 Direct 결과는 유효한 보기 토큰만 남기는 마스크를 씌운 값입니다. 생성 모델에 질문 묶음을 그대로 넣는 방식이 잘 맞지 않는 사례입니다.
참고로 프로젝트 페이지의 Multi-query efficiency 그림은 같은 실험의 mIoU 라벨을 논문과 다르게 표시합니다(예: Joint 56.7, Instruct 45.4). 이 글의 수치는 논문 v1의 Figure 3과 본문을 따랐습니다.
쓰기 전에 알아 둘 한계: 확률 보정과 실패 사례
후보 점수는 확률로 나오므로, 답을 받아들일지 사람이나 더 큰 모델에게 넘길지 정하는 신호로 쓸 수 있습니다. 실제로 35B-A3B는 LVBench에서 확신도 99% 이상인 예측 591개의 정확도가 95.8%로, 전체 정확도 73.4%보다 높았습니다.
다만 확률이 정답률과 맞게 보정(calibration) 돼 있지는 않습니다. 보정은 "80% 확신한 답이 실제로 80% 맞는" 성질입니다. 네 벤치마크 평균 기대 보정 오차(Expected Calibration Error, ECE)는 4B 8.65%p, 35B-A3B 8.13%p이고, 그래프에서 대부분의 점이 대각선 아래에 있습니다. 확신도가 실제 정답률보다 높게 나옵니다.
TypeSafe의 Jev는 보정 자체를 강화 학습 목표로 삼지만, VideoJev는 보정을 따로 학습하지 않았습니다. 저자들은 별도 보정 데이터로 하는 온도 스케일링(temperature scaling)이나 보정을 고려한 학습으로 이 차이를 줄일 수 있다고 봅니다. 이 확률로 자동 판단을 내리려면, 사용할 영상 분포에서 보정을 따로 확인해야 합니다.
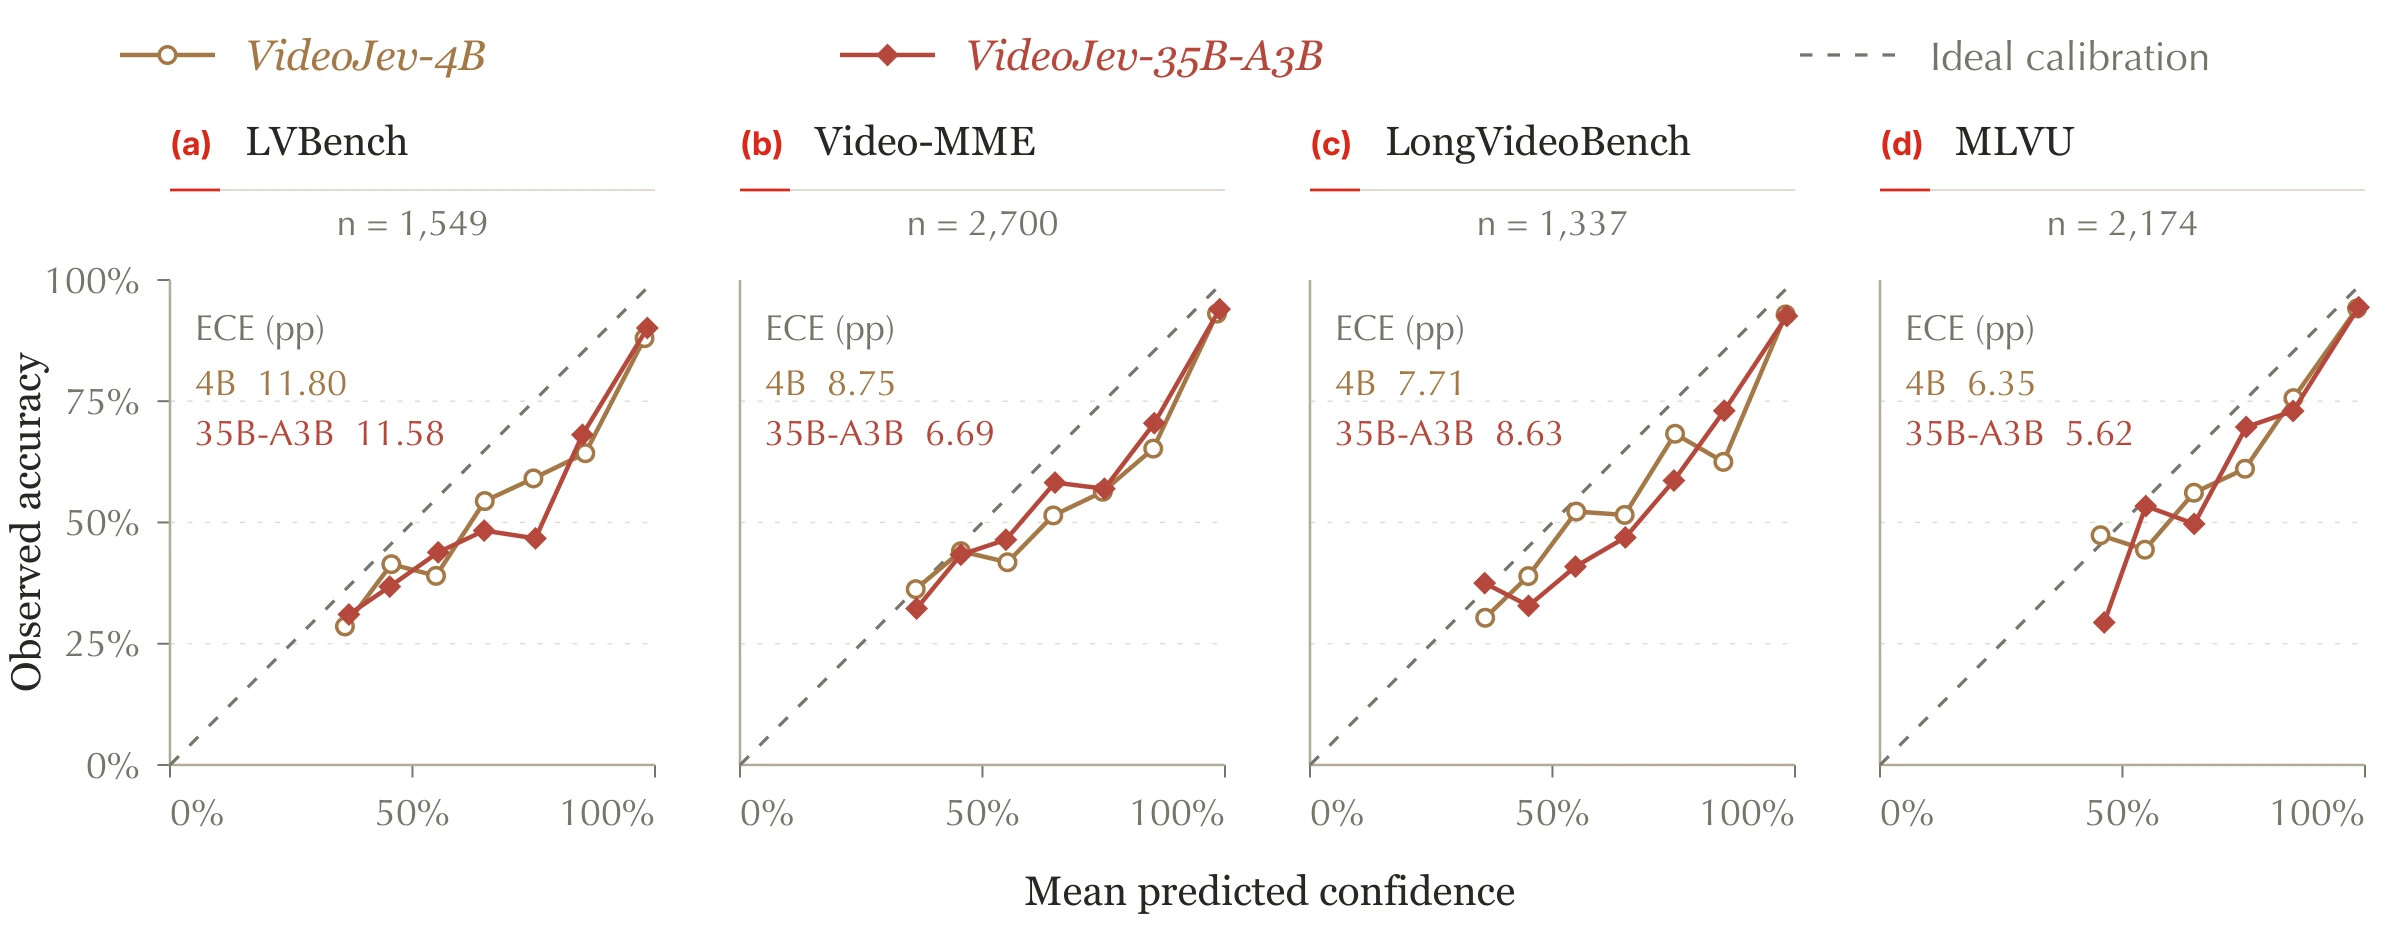
부록의 사례 8개에는 실패도 들어 있습니다. Video-MME의 38초 영상에서 "탁자 위 책이 몇 권인가" 를 묻자, 정답은 4권인데 4B는 3권(64.6%), 35B-A3B는 2권(63.4%)을 골랐습니다. LVBench의 약 1시간 54분짜리 영상에서 특정 시점 인물의 의도를 묻는 문항에서는 4B가 오답에 87.8%를 줬습니다. 작은 물체 세기와 의도 추론처럼 영상 세부를 봐야 하는 문항에서는 확률이 높아도 틀릴 수 있습니다. 또한 지금 구조는 영상 전체를 먼저 인코딩하므로, 실시간 스트리밍 입력 처리는 저자들이 향후 과제로 남겼습니다.
직접 실행해 보기
공개 체크포인트는 Hugging Face 형식이며 trust_remote_code=True 로 불러옵니다. 모델 카드 기준 테스트 환경은 Python 3.12, PyTorch 2.8, CUDA 12.8, NVIDIA H200입니다. FlashAttention 2와 causal-conv1d가 필요합니다. 이 글을 쓰며 코드를 직접 실행하지는 않았고, 아래 출력은 모델 카드에 기록된 4B 결과입니다.
pip install transformers==5.14.1 accelerate safetensors numpy pillow av==18.1.0 \
  flash-linear-attention==0.4.2 fla-core==0.4.2
pip install flash-attn causal-conv1d --no-build-isolation
위 패키지를 설치한 환경에서, 10초짜리 데모 영상으로 구간 찾기 1문항과 객관식 1문항을 한 번에 실행합니다.
import json
import torch
from huggingface_hub import hf_hub_download
from transformers import AutoModel, AutoProcessor

video = hf_hub_download(
    repo_id="ZhuYuhan/VideoJev-Demo", filename="eating_spaghetti.mp4",
    repo_type="dataset", revision="7e2b9685bca592c3b929268f6fcf82c4ad74b267",
)
repo = "ZhuYuhan/VideoJev-4B"
processor = AutoProcessor.from_pretrained(repo, trust_remote_code=True)
model = AutoModel.from_pretrained(
    repo, trust_remote_code=True, dtype=torch.bfloat16,
    device_map={"": "cuda:0"}, attn_implementation="flash_attention_2",
)
model.prepare_for_inference()

questions = [
    {"id": "grounding-1", "task": "grounding",
     "query": "The woman in green eats pasta."},
    {"id": "qa-1", "task": "choice",
     "query": "What is the woman in green eating?",
     "options": ["A. Pasta.", "B. Rice.", "C. Soup."]},
]
results = model.predict_video(
    processor, video, questions,
    fps=2.0, max_frames=2048, context=8192,
)
print(json.dumps(results, indent=2))
구간 찾기 결과에는 구간별 시그모이드 확률과 interval 이 초 단위로 나오고, 객관식 결과에는 보기별 소프트맥스 확률과 0부터 세는 answer_index 가 나옵니다. 4B의 기록된 출력은 구간 [3.0, 10.0], 답 A. Pasta. (확률 0.9999)입니다. 같은 코드에서 35B-A3B는 구간을 [3.0, 8.0] 으로 더 짧게 잡았습니다. 모델 카드의 사용 안내(USAGE.md)는 과제별 설정으로 구간 찾기에 초당 4프레임과 147,456 토큰, 질의응답에 초당 2프레임과 262,144 토큰을 씁니다.
| 모델 | 기반 모델 | 가중치 |
|---|---|---|
| VideoJev-4B | Qwen3.5-4B (dense) | BF16 safetensors 2개 샤드 |
| VideoJev-35B-A3B | Qwen3.6-35B-A3B (MoE, 활성 3B) | BF16 safetensors 15개 샤드 |
35B-A3B를 쓰려면 저장소 이름만 ZhuYuhan/VideoJev-35B-A3B 로 바꿉니다. 학습까지 하려면 XTuner가 필요하고, 35B-A3B는 XTuner의 grouped-GEMM 확장을 컴파일해야 합니다.
VideoJev의 라이선스
VideoJev 코드와 두 체크포인트는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. NOTICE 파일에 따르면 기반 모델 Qwen3.5-4B와 Qwen3.6-35B-A3B, 학습 프레임워크 XTuner도 Apache 2.0입니다. 학습 데이터 중 TimeLens2-93K는 Apache 2.0, TimeLens-100K는 BSD-3-Clause이며, TimeLens-100K의 주석은 Gemini-2.5-Pro로 자동 생성한 것입니다.
 VideoJev 논문
 VideoJev 프로젝트 홈페이지
 VideoJev GitHub 저장소
 VideoJev Hugging Face 컬렉션
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
