
AI Engineering Skills Map 소개
AI Engineering Skills Map은 Andrew Ng과 DeepLearning.AI 팀이 지금의 개발자가 무엇을 먼저 배워야 하는지를 네 갈래로 정리한 역량 지도입니다. 2026년 8월 14일 뉴스레터 The Batch 366호의 레터로 공개되었고, 채용 공고 1만 건 이상의 분석과 수십 건의 전문가 인터뷰를 근거로 삼았습니다.
이 지도가 나온 배경에는 간단한 진단이 하나 깔려 있습니다. 2022년과 지금의 소프트웨어 개발 방식이 확연히 달라졌고, 그 변화를 활용할 줄 아는 사람에게는 프로젝트와 일자리 기회가 열려 있다는 것입니다. 비교 기준으로 2022년을 든 것은 그해 11월 ChatGPT가 공개되기 이전, 다시 말해 LLM을 개발 도구로 쓰는 관행이 생기기 전을 가리킵니다. 문제는 그 사이의 정보 환경입니다. Andrew Ng은 AI를 둘러싼 정보가 "시끄럽고 과장으로 가득 차 있다(noisy, hype-filled)" 고 표현하면서, 그래서 무엇이 정말 배울 가치가 있는 역량인지 판단하기 어려워졌다고 짚습니다. 매주 새 모델과 새 도구가 쏟아지는 환경에서 학습 우선순위를 세우는 일 자체가 하나의 과제가 된 셈입니다.
그래서 이번 정리는 개인의 감상이나 트렌드 예측이 아니라 노동 시장 데이터에서 출발합니다. DeepLearning.AI 팀은 채용 공고 1만 건 이상을 분석하고, AI 전문가와 채용 관리자, 리크루터를 대상으로 수십 건의 구조화 인터뷰를 진행했으며, 설문으로 데이터를 모으고 여기에 온라인상의 다른 자료를 합쳤습니다. Andrew Ng은 이 과정을 "일자리와 전문가 인터뷰로 만든 거대한 데이터셋에 군집화(clustering)를 돌린 것과 비슷하다" 고 비유합니다. 목표는 두 가지로, 하나는 개발자가 학습 우선순위를 정하도록 돕는 것이고 다른 하나는 고용주가 역량 있는 개발자를 알아보도록 돕는 것입니다.
이 군집화가 겨냥한 시점도 눈여겨볼 부분입니다. 그는 이 과정으로 찾으려던 것이 "오늘만이 아니라 가까운 미래에도 가장 중요할 역량" 이라고 밝혔습니다. 지금 채용 공고에 적혀 있는 요구사항을 집계한 결과가 아니라, 그 요구사항이 향하는 방향까지 읽어 낸 결과라는 주장입니다. 이 주장을 어디까지 받아들일지는 글 뒷부분에서 다시 다룹니다.
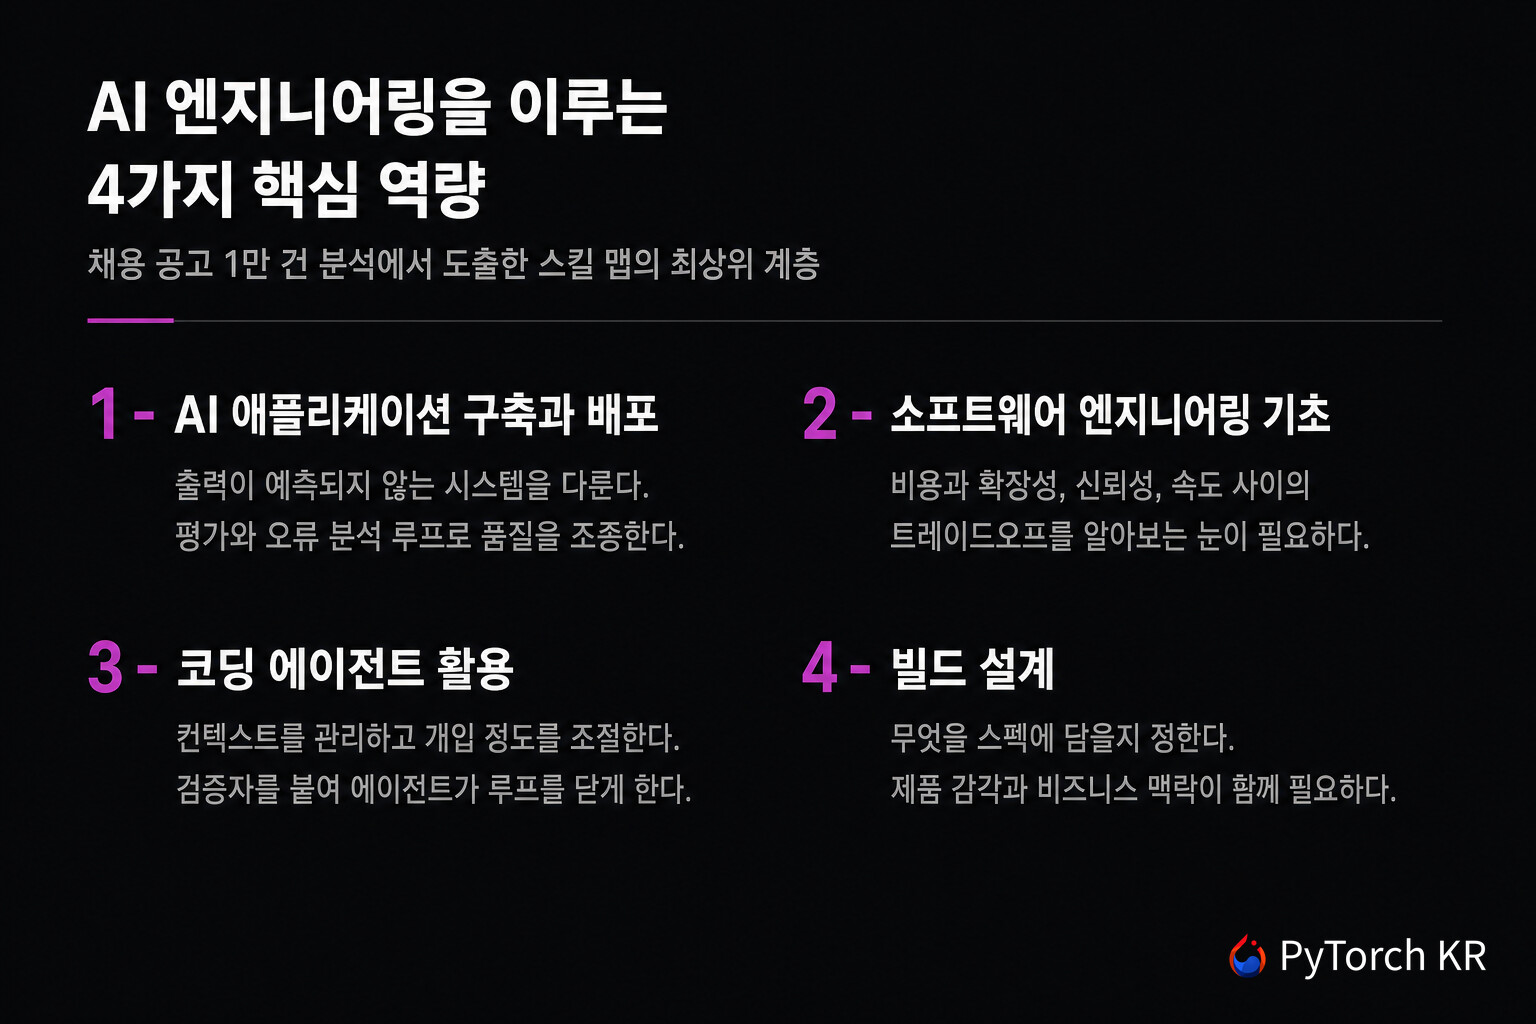
이렇게 도출한 가장 중요한 네 가지 역량은 다음과 같습니다. 원문이 나열한 순서를 그대로 옮긴 것이고, 중요도를 매긴 순위는 아닙니다.
-
AI 애플리케이션 구축과 배포(Building and deploying AI applications)
-
소프트웨어 엔지니어링 기초(Software engineering fundamentals)
-
코딩 에이전트 활용(Using coding agents)
-
빌드 설계(Shaping the build)
이번에 공개된 것은 지도의 최상위 계층뿐이고, 각 항목의 하위 계층은 후속 레터로 나누어 공개될 예정입니다. 이 글에서는 네 역량이 각각 무엇을 뜻하는지, 그리고 원문이 짧게 언급하고 지나간 개념들이 실제로 어떤 작업을 가리키는지를 함께 정리합니다.
직무 이름 대신 역량으로 나눈 이유: 클라우드가 걸어온 길
Andrew Ng이 레터 앞부분에서 용어 문제를 짚고 넘어가는 대목은 지도의 성격을 이해하는 데 중요합니다. 그는 "AI 엔지니어" 라는 직무가 아니라 "AI 엔지니어링 역량" 을 이야기한다고 명시합니다. 앞의 것은 AI 시스템을 만드는 일을 직업으로 삼은 사람을 가리키는 좁은 범주지만, 뒤의 것은 훨씬 넓은 범위를 포괄하기 때문입니다.
이 구분을 설명하며 그가 꺼낸 비유가 클라우드입니다. 오늘날 개발자라면 누구나 클라우드를 다룰 줄 알아야 하지만, 실제로 "클라우드 엔지니어" 라는 직함을 달고 일하는 사람은 그중 일부에 불과합니다. AI 엔지니어링도 같은 경로를 밟으리라는 것이 그의 예상입니다. 풀스택 엔지니어, 데이터 엔지니어, DevOps 엔지니어, 머신러닝 엔지니어, 그리고 AI 엔지니어까지, 모든 개발자가 AI 엔지니어링 역량을 필요로 하게 된다는 이야기입니다.
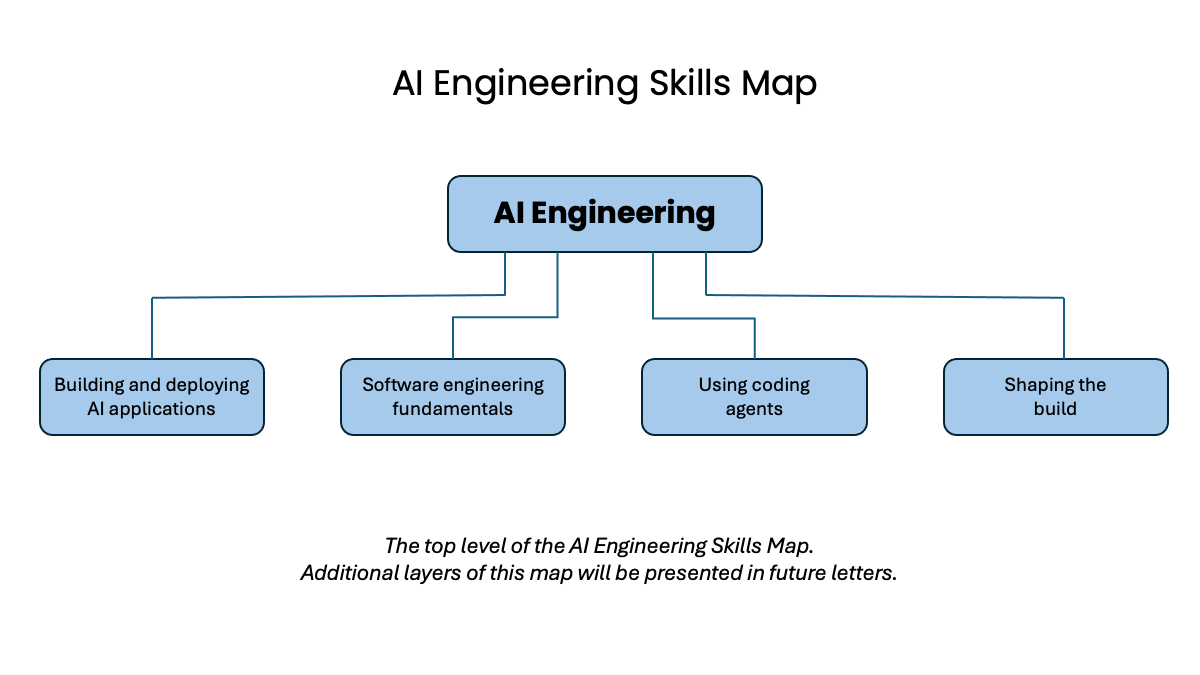
위 그림이 이번에 공개된 지도의 전부입니다. 중앙의 AI Engineering 노드에서 네 개의 자식 노드가 평행하게 뻗어 나가는 단순한 트리이고, 캡션에도 "이 지도의 추가 계층은 앞으로의 레터에서 제시될 예정" 이라고 적혀 있습니다. 계층 구조를 일부러 얕게 유지한 이유는 최상위 네 갈래 자체가 이번 레터의 주장이기 때문입니다.
직무가 아니라 역량으로 접근하는 관점은 Andrew Ng이 이전에 쓴 Forward Deployed Engineers and the Future of AI Engineering 레터와도 이어집니다. 고객사 조직에 상주하며 그 회사에 맞는 에이전틱 워크플로우를 구축해 주는 Forward Deployed Engineer(FDE)를 다룬 글인데, 그는 여기서 AI 엔지니어 역할이 성숙하면서 수십 년 전 소프트웨어 엔지니어가 프론트엔드, 백엔드, 모바일, 데이터 엔지니어링, DevOps로 갈라졌던 것처럼 세분화되리라 전망했습니다. 그러면서 AI FDE, LLMOps 엔지니어, Evals 엔지니어, AI 데이터 엔지니어, 하네스 엔지니어(Harness Engineer) 같은 이름을 후보로 꼽고, 아직 이름조차 없는 역할도 생길 것이라고 덧붙였습니다. 직함이 어떻게 갈라지든 그 아래 깔린 역량은 공통이라는 것이 이번 지도의 전제입니다.
역량 1. AI 애플리케이션 구축과 배포: 예측할 수 없는 출력을 다루는 기술
첫 번째 역량의 출발점은 AI 애플리케이션과 그렇지 않은 애플리케이션의 결정적 차이입니다. Andrew Ng은 그 차이를 출력의 예측 불가능성 한 가지로 압축합니다. LLM에 프롬프트를 넣으면 무엇이 돌아올지 미리 알 수 없고, 심층 학습(Deep Learning) 모델을 학습시켜도 새로운 예제에 어떤 예측을 내놓을지 알 수 없습니다. 반면 전통적인 소프트웨어는 훨씬 예측 가능하게 동작합니다.
이 차이가 실무에서 어떤 부담으로 바뀌는지 생각해 보면 됩니다. 결정론적인 코드에서는 단위 테스트가 통과했는지 실패했는지가 명확하게 갈립니다. 반면 LLM을 끼운 시스템에서는 같은 입력에도 출력이 흔들리므로, 개별 실행의 성공과 실패가 아니라 출력의 분포를 봐야 합니다. 어제까지 잘 돌던 프롬프트가 모델 버전이 올라가면서 조용히 나빠지는 상황도 흔합니다.
| 관점 | 전통적인 소프트웨어 | AI 애플리케이션 |
|---|---|---|
| 같은 입력에 대한 출력 | 같은 출력 | 실행마다 달라질 수 있음 |
| 정확성의 판정 | 통과 또는 실패 | 기준에 따른 점수와 분포 |
| 회귀를 잡는 수단 | 단위 테스트, 통합 테스트 | 평가 데이터셋과 채점 기준 |
| 품질이 나빠지는 계기 | 코드 변경 | 코드 변경, 프롬프트 변경, 모델 교체, 입력 분포 변화 |
| 디버깅의 첫 단계 | 스택 트레이스 추적 | 실패 사례 수집과 유형 분류 |
위 표를 통해 세 가지를 알아볼 수 있습니다. 우선 확인해야 할 대상이 개별 실행에서 사례의 집합으로 옮겨 갑니다. 다음으로 품질이 흔들리는 원인이 내 코드 바깥에도 존재하므로, 모델 공급자가 버전을 올리는 것만으로도 서비스 품질이 바뀔 수 있습니다. 마지막으로 디버깅의 출발점이 다릅니다. 예외가 터진 지점을 따라가는 대신, 무엇이 어떤 방식으로 틀렸는지를 먼저 분류해야 고칠 곳이 보입니다.
그래서 이 역량을 갖춘 사람은 두 층위를 함께 다룹니다. 하나는 AI의 구성 요소를 이해하는 층입니다. Andrew Ng은 LLM, 컨텍스트 엔지니어링(Context Engineering), 검색 증강 생성(Retrieval-Augmented Generation, RAG), 에이전틱 워크플로우(Agentic Workflow), 기계 학습과 심층 학습을 예로 듭니다. 다른 하나는 그렇게 만든 시스템이 더 예측 가능하게 동작하도록 통계적 기법으로 측정하고 조종하고 관리하는 층입니다. 그는 후자를 특히 강조하며, 그 핵심 역량으로 다음을 꼽습니다.
"이 일을 해내는 핵심 역량은 규율 있는 평가(evals)와 오류 분석(error analysis) 루프를 굴릴 줄 아는 것입니다."
"A core skill in doing so is knowing how to drive disciplined evals and error analysis loops."
여기서 말하는 평가(evals)는 벤치마크 점수를 한 번 재보는 일이 아닙니다. 내 서비스가 실제로 마주치는 입력을 모아 데이터셋을 만들고, 무엇을 성공으로 볼지 기준을 정하고, 프롬프트나 모델이나 검색 파이프라인을 바꿀 때마다 그 기준으로 회귀를 확인하는 반복 작업에 가깝습니다. 오류 분석은 그 뒤에 붙는 작업으로, 틀린 사례를 그냥 세는 대신 실패 유형별로 분류해서 어디를 고치면 가장 크게 개선되는지를 찾아내는 과정입니다. 두 작업 모두 데이터를 직접 들여다보는 시간을 요구하기 때문에 자동화 도구를 붙였다고 끝나지 않습니다.
원문이 통계적 기법(statistical techniques) 이라고 표현한 부분도 짚어 둘 만합니다. 평가 결과를 하나의 숫자로 보는 대신, 표본이 몇 개인지, 두 버전의 점수 차이가 그 표본 크기 안에서 의미를 갖는지, 특히 나빠지는 하위 집단이 있는지를 따지는 작업을 가리킵니다. 이 감각이 없으면 예제 스무 개에서 점수가 조금 올랐다는 이유로 프롬프트를 확정하게 되고, 실제 트래픽에서 그 개선이 재현되지 않습니다. 결정론적 코드를 다룰 때는 필요 없던 종류의 판단이라, 소프트웨어 경력이 길어도 따로 익혀야 하는 부분입니다.
AI 애플리케이션 구축과 평가 더 알아보기
Your AI Product Needs Evals - Hamel Husain이 정리한 LLM 애플리케이션 평가 실무 가이드
Evaluating AI Agents - DeepLearning.AI 단기 강좌
Effective context engineering for AI agents - Anthropic 엔지니어링 블로그
역량 2. 소프트웨어 엔지니어링 기초: 트레이드오프가 보여야 조종할 수 있습니다
두 번째 역량은 얼핏 보면 새로울 것이 없어 보이는 항목입니다. 소프트웨어가 어떻게 동작하는지 깊이 이해할수록 더 잘 만들 수 있다는 이야기이기 때문입니다. 그런데 Andrew Ng이 이 항목을 네 갈래 중 하나로 올려놓은 이유는 AI가 기초를 대체하기 때문이 아니라, 오히려 기초가 있어야 AI를 제대로 부릴 수 있기 때문입니다.
소프트웨어를 만드는 일은 비용, 확장성, 신뢰성, 속도 사이에서 균형을 잡는 작업이고 여기에 보안과 프라이버시가 얹히면 복잡도가 한 단계 더 올라갑니다. 기초를 아는 사람은 애초에 어떤 트레이드오프가 존재하는지 를 알아봅니다. 그 인식이 소프트웨어 스택 선택, 시스템 아키텍처 설계, 데이터 저장소 설계, 테스트 전략 같은 결정의 질을 좌우합니다.
이 대목에서 Andrew Ng은 코딩 에이전트를 쓰는 초보 개발자를 예시로 듭니다. 트레이드오프를 모르는 상태로 이른바 바이브 코딩(vibe coding)을 하면 결과가 나빠지는데, 이유는 에이전트가 무능해서가 아닙니다.
"그들이 자신의 코딩 에이전트에 어떤 컨텍스트를 줘야 하는지 모르기 때문에, 에이전트가 내리는 선택은 대체로 나쁜 선택이 됩니다."
"...which will often be poor ones, because they don't know what context to give their coding agent."
에이전트는 주어진 맥락 안에서 그럴듯한 선택을 합니다. 인덱스를 어디에 걸어야 하는지, 이 API가 초당 몇 번 호출될 것인지, 이 데이터가 개인정보인지 같은 정보를 사람이 주지 않으면 에이전트는 그런 제약이 없는 것처럼 코드를 씁니다. 그래서 Andrew Ng은 기초의 가치를 조종 능력으로 정리합니다. 소프트웨어 엔지니어링의 정밀한 언어로 지시할 수 있어야 코딩 에이전트를 좋은 트레이드오프 쪽으로 몰고 갈 수 있다는 것입니다. 캐시를 붙여줘 대신 읽기가 쓰기보다 백 배 많으니 읽기 경로에 TTL 60초 캐시를 두고 쓰기에서 무효화해줘 라고 말할 수 있는 차이입니다.
이 항목이 지도에 올라온 배경에는 흔한 오해 하나가 있습니다. 에이전트가 코드를 대신 써 주니 기초는 덜 중요해졌으리라는 생각입니다. 원문의 논리는 반대 방향입니다. 코드를 쓰는 시간이 줄어들수록 개발자가 쓰는 시간의 대부분은 판단에 몰리고, 판단의 재료가 되는 것이 바로 기초이기 때문입니다. 에이전트가 만들어 낸 결과물을 읽고 이 선택이 우리 트래픽 규모에서 버티는가 를 되물을 수 있는 사람과 돌아가니 넘어가는 사람의 격차는 코드 작성 속도가 빨라질수록 오히려 벌어집니다. Addy Osmani가 정리한 LLM 코딩 워크플로우에서도 같은 문제의식이 반복해서 등장합니다.
소프트웨어 엔지니어링 기초와 AI 네이티브 개발 더 알아보기
OpenAI가 공개한, 소프트웨어 개발 주기별 AI 네이티브 엔지니어링 팀 구축 가이드 - PyTorchKR 정리 글
AI Rewards Generalists Who Can Build New Skills - Andrew Ng의 이전 레터
역량 3. 코딩 에이전트 활용: 언제 개입하고 언제 맡길지 아는 감각
네 항목 가운데 세 번째 역량은 가장 나중에 생겨난 주제입니다. 코딩 에이전트가 일상적인 개발 도구가 된 것 자체가 최근 몇 년 사이의 변화이기 때문입니다. Andrew Ng은 에이전틱 코딩을 잘 쓰는 일이 이제 모든 개발자의 핵심 역량이 되었다고 단언합니다. 이 역량을 갖춘 사람은 에이전트가 어떻게 동작하는지에 대한 좋은 멘탈 모델을 가지고 있고, 에이전트의 한계와 그 한계를 우회하는 방법을 알며, 필요할 때 빠르게 방향을 틀어 줍니다.
여기서 그가 강조하는 감각은 개입의 정도입니다. 얼마나 개입하고 얼마나 내버려 둘지를 아는 것, 그래서 과도한 시간이나 토큰을 낭비하지 않으면서 견고한 소프트웨어를 만들어 내는 것이 이 역량의 실체입니다. 매 단계마다 들여다보면 에이전트를 쓰는 의미가 없고, 반대로 방치하면 잘못된 방향으로 한참을 달려간 뒤에야 알아차리게 됩니다.
Andrew Ng은 이 역량을 구성하는 요소를 구체적으로 열거합니다.
-
컨텍스트 관리: 코딩 에이전트의 컨텍스트에 무엇을 넣고 무엇을 빼야 하는지를 다루는 능력입니다. 저장소 규모가 커질수록 필요한 파일만 정확히 물려 주는 일이 결과 품질을 좌우합니다.
-
계획과 실행 사이의 트레이드오프: 계획 단계에 시간을 더 쓸지, 바로 구현으로 넘어갈지를 판단하는 능력입니다. 작은 수정에 장문의 계획을 요구하면 낭비이고, 큰 변경을 계획 없이 시작하면 되돌리기 어려워집니다.
-
검증자와 평가로 루프 닫기: 에이전트가 스스로 결과를 확인하고 반복할 수 있도록 검증자(verifier)나 평가(evals)를 붙여 주는 일입니다. 사람이 매번 결과를 확인해 주지 않아도 에이전트가 자율적으로 루프를 돌 수 있게 만드는 장치입니다.
-
명세 다루기: 명확한 명세(Spec, 스펙)를 가지고 일하는 방법, 그리고 굳이 명세를 만들 필요가 없는 경우를 구분하는 판단입니다. 원문이 괄호로 덧붙인 "그리고 언제는 굳이 그러지 않아도 되는지" 라는 단서가 이 항목의 핵심입니다.
-
여러 에이전트의 조율: 함께 일하는 여러 에이전트를 오케스트레이션하는 능력입니다. 작업을 어떻게 쪼개고 결과를 어떻게 합칠지가 관건입니다.
-
사고를 막는 안전장치: 에이전트가 프로덕션 데이터베이스를 망가뜨리는 것 같은 함정을 피하는 일입니다. 권한 설정과 샌드박스 분리 같은 기본기가 여기에 해당합니다.
Andrew Ng이 이 항목에 덧붙인 마지막 조건이 흥미롭습니다. 에이전틱 코딩 분야 자체가 빠르게 바뀌고 있어서, 코딩 에이전트를 능숙하게 쓴다는 것은 최신 실무를 아는 것만으로 부족하고 새 도구를 계속 시도해 보고 모범 사례가 바뀔 때마다 자기 워크플로우를 갱신하는 루틴 을 갖추는 것까지 포함한다는 이야기입니다. 특정 도구에 숙달하는 것이 아니라 갱신하는 습관 자체가 역량으로 정의되는 셈입니다.
실제로 Claude Code, Codex, Gemini CLI, OpenCode, Cursor 같은 하네스가 저마다 다른 속도로 기능을 바꾸고 있고, 에이전트에게 도구를 붙이는 MCP(Model Context Protocol), 저장소에 규칙을 남기는 AGENTS.md, 명세 주도 개발을 지원하는 Spec Kit 같은 주변 규약도 계속 늘어나고 있습니다.

 모델과 하네스의 조합이 코딩 성능에 어떻게 작용하는지에 관해서는 다음 글(Artificial Analysis가 공개한 코딩 에이전트 벤치마크)을 참고해주세요:
코딩 에이전트와 하네스 엔지니어링 더 알아보기
Learn Harness Engineering: AI 코딩 에이전트를 신뢰할 수 있게 만드는 하네스 엔지니어링 강의 - PyTorchKR 정리 글
[GN] AI 에이전트를 위한 좋은 스펙 작성법 - PyTorchKR 정리 글
Claude Code: A Highly Agentic Coding Assistant - DeepLearning.AI 단기 강좌
역량 4. 빌드 설계: 명세에 무엇을 담을지 정하는 일
네 번째 역량인 Shaping the build는 앞의 세 가지와 결이 다릅니다. 기술적 숙련이 아니라 무엇을 만들지 정하는 판단에 관한 항목이기 때문입니다. 출발점은 단순한 관찰입니다. 명세가 명확하기만 하면 코딩 에이전트가 그것을 구현해 내는 능력은 빠르게 좋아지고 있다는 것입니다. 참고로 여기서 build는 빌드 시스템이나 CI 파이프라인이 아니라 만들어 내는 결과물 그 자체 를 가리키므로, 빌드 설계라는 표현을 컴파일 설정과 혼동하지 않는 편이 좋습니다.
그래서 엔지니어의 일이 이동합니다. 구현이 더 이상 병목이 아니게 되면 남는 질문은 무엇을 명세에 담을 것인가 가 됩니다. Andrew Ng은 이 변화를 다소 단호하게 표현합니다.
"엔지니어는 더 이상 픽셀 단위까지 완성된 디자인을 받아서 구현만 하는 역할을 기대해서는 안 됩니다."
"Engineers should no longer expect to be given a pixel-perfect design and asked only to implement it."
대신 효과적인 AI 엔지니어링에는 제품 감각과 비즈니스 맥락, 고객 목표에 대한 이해가 필요하고, 그래야 무엇을 만들지 정하는 과정에 직접 참여할 수 있다는 것이 그의 주장입니다. 여기서 그는 이 변화를 부담이 아니라 기회 쪽으로 해석합니다. AI 덕분에 개발자가 이전보다 더 큰 오너십과 주도성을 가질 수 있게 되었고, 흥미로운 문제와 기회를 직접 찾아내 책임 있는 방식으로 실행에 옮길 수 있다는 것입니다.
프로젝트를 앞으로 밀고 나가는 방법을 아는 것도 이 역량에 포함됩니다. 원문이 든 예시는 속도 조절입니다. 언제 MVP(Minimum Viable Product)를 빠르게 만들어 사용자에게 들고 가서 시험해 볼지, 그리고 언제 속도를 늦추고 시간을 더 들여 신중하게 만들지를 구분하는 판단입니다. 두 선택 모두 정답이 될 수 있고 상황이 어느 쪽인지 읽는 것이 역량이라는 이야기입니다.
네 항목 중 이 항목이 가장 논쟁적일 수 있습니다. 조직에 따라 무엇을 만들지 정하는 권한이 엔지니어에게 열려 있지 않은 경우가 많기 때문입니다. 다만 원문의 주장은 권한을 요구하라는 쪽이 아니라, 구현이 병목에서 내려오면 가치가 만들어지는 자리도 함께 이동한다는 관찰에 가깝습니다. 명세를 받아 구현하는 구간이 자동화될수록, 명세를 만드는 구간에 참여하지 않는 엔지니어의 기여는 상대적으로 줄어듭니다. Andrew Ng이 AI-Native Software Development Needs Generalists에서 제너럴리스트를 강조한 것도 같은 흐름 위에 있습니다.
제품 감각과 빌드 설계 더 알아보기
How to Get Through the Product Management Bottleneck - Andrew Ng의 이전 레터
AI-Native Software Development Needs Generalists - Andrew Ng의 이전 레터
네 역량을 잇는 세 개의 루프
이번 레터는 네 역량을 병렬로 나열하고 끝나지만, Andrew Ng이 앞서 쓴 Three Key Loops for Building Great Software 레터를 함께 읽으면 네 항목이 실무에서 어떻게 맞물리는지가 훨씬 선명해집니다. 그 글에서 그는 0에서 1을 만드는 제품 개발을 세 개의 루프로 나눕니다.
| 루프 | 주기 | 도는 주체 | 지도의 어느 역량과 맞닿는가 |
|---|---|---|---|
| 에이전틱 코딩 루프 | 수 분 | 코딩 에이전트 | 코딩 에이전트 활용, AI 애플리케이션 구축과 배포 |
| 개발자 피드백 루프 | 수십 분에서 수 시간 | 개발자 | 소프트웨어 엔지니어링 기초, 빌드 설계 |
| 외부 피드백 루프 | 수 시간에서 수 주 | 사용자, 알파 테스터 | 빌드 설계 |
세 루프를 순서대로 보겠습니다. 첫 루프는 명세와 평가가 주어지면 에이전트가 코드를 쓰고 스스로 시험하며 사양을 만족할 때까지 반복하는 구간이고, 여기서 평가(evals)를 붙여 두면 사람이 개입하지 않아도 루프가 오래 돌아갑니다. 두 번째 루프에서는 개발자가 결과물을 보고 방향을 잡아 주는데, 에이전트가 자기 코드를 시험하는 능력이 좋아지면서 개발자가 QA 역할에 쓰던 시간이 크게 줄었고 그만큼 제품 수준의 판단에 시간을 쓸 수 있게 되었습니다. 세 번째 루프는 사용자 피드백과 A/B 테스트처럼 며칠에서 몇 주가 걸리는 가장 느린 구간입니다.
이 구조에서 사람의 자리를 설명하는 Andrew Ng의 표현이 인상적입니다. 많은 사람이 사람의 기여를 "취향(taste)" 이라고 부르지만, 그는 그보다 맥락 우위(Context Advantage) 라고 부르는 쪽을 선호한다고 밝혔습니다. 우리가 사용자와 제품이 놓인 환경에 대해 AI 시스템보다 더 많이 알고 있고, 그렇게 보면 AI 시스템을 어떻게 개선할지에 대한 경로도 더 분명해지기 때문입니다. 사람이 AI가 모르는 무언가를 알고 있는 한 그 지식을 시스템에 주입하는 사람의 자리는 사라지지 않는다는 정리입니다.
지속적 학습이라는 토대와 앞으로 공개될 하위 계층
Andrew Ng은 네 역량 아래에 공통으로 깔린 것으로 지속적 학습의 태도를 꼽으며 레터를 맺습니다. AI가 계속 빠르게 바뀌므로 새로 등장하는 모범 사례를 받아들이기 위해 모두가 계속 배우고 자기 역량을 갱신해야 한다는 것입니다. 세 번째 역량에서 새 도구를 계속 시도하는 루틴 을 역량의 일부로 정의한 것과 같은 맥락입니다.
이번에 공개된 지도가 최상위 계층뿐이라는 점도 다시 확인해 둘 만합니다. 그는 네 역량 각각에 대해 더 할 이야기가 있으며 앞으로의 레터에서 하나씩 풀어 놓고 더 상세한 AI Engineering Skills Map을 공유하겠다고 예고했습니다. 지도 자체도 AI의 변화에 맞춰 계속 갱신할 계획이라고 밝히면서, 커뮤니티 의견을 반영하기 위한 설문을 함께 열어 두었습니다. 5분에서 7분 정도가 걸리는 분량입니다.
레터에서 이 예고 바로 앞에 놓인 문장도 함께 읽을 만합니다. DeepLearning.AI의 주된 초점이 개발자들이 바로 이 AI 엔지니어링 역량을 갖추도록 돕는 것이라는 문장입니다. 이 지도가 시장 조사 결과이기만 한 것이 아니라, 교육 기관이 자기 커리큘럼의 좌표를 설명하는 문서이기도 하다는 뜻입니다.
한국의 개발자와 팀이 이 지도를 읽는 법
네 갈래를 나란히 놓고 보면 성격이 둘로 갈립니다. 첫 번째와 두 번째 역량은 혼자서도 쌓을 수 있는 개인의 기술 자산에 가깝습니다. 평가 데이터셋을 만들고 오류를 분류하는 훈련, 데이터 저장소와 아키텍처의 트레이드오프를 익히는 공부는 조직의 허락 없이도 시작할 수 있고, PyTorch 같은 프레임워크나 Machine Learning Specialization, AI Python for Beginners 같은 공개 교육 자료로도 접근할 수 있습니다.
반면 세 번째와 네 번째 역량은 환경의 영향을 크게 받습니다. 코딩 에이전트를 능숙하게 쓰려면 그 도구를 쓸 수 있어야 하고, 빌드를 설계하려면 엔지니어가 명세를 만드는 자리에 참여할 수 있어야 합니다. 사내 보안 정책상 외부 코딩 에이전트를 붙이기 어렵거나, 기획과 개발이 명확히 분리되어 엔지니어가 요구사항 정의 단계에 들어가지 못하는 조직이라면 개인의 의지만으로 이 두 역량을 쌓기가 어렵습니다. 그런 조건에서는 개인 프로젝트나 사이드 프로젝트가 연습장 역할을 하게 되고, 조직 차원에서는 어떤 도구를 어떤 경계 안에서 허용할지를 정하는 일이 곧 구성원의 학습 기회를 정하는 일이 됩니다.
이 지도는 채용 공고 분석에서 출발했으므로 다른 용도로도 쓸 수 있습니다. 네 갈래는 지금 시장이 값을 매기고 있는 항목의 목록이기도 하므로, 이력서나 포트폴리오를 정리할 때 각 항목에 대응하는 구체적 사례가 있는지 점검해 보면 됩니다. 평가 파이프라인을 직접 만들어 본 경험, 아키텍처 선택의 근거를 설명할 수 있는 경험, 에이전트를 붙여 실제 기능을 출시해 본 경험, 그리고 무엇을 만들지 정하는 논의에 참여해 본 경험이 각각의 자리에 해당합니다.
지도의 두 번째 목표가 고용주 쪽이었다는 점도 실무에 쓸 데가 있습니다. 면접 구성과 직무 기술서를 네 갈래로 나눠 놓으면 무엇을 확인하지 못하고 있었는지가 드러납니다. 알고리즘 문제와 시스템 설계만으로 짜인 면접은 두 번째 역량을 측정하고 나머지 세 갈래는 손대지 않습니다. 코딩 에이전트 활용을 본다면서 어떤 도구를 써 봤는지만 묻는 면접도 세 번째 역량의 핵심인 개입 판단과 컨텍스트 관리를 비켜 갑니다. 반대로 네 번째 역량은 면접 한 시간으로 확인하기가 특히 어려워서, 지원자가 직접 정의하고 밀어붙인 프로젝트를 놓고 왜 그렇게 잘랐는지 되묻는 방식이 그나마 실제 판단을 드러냅니다.
같은 이유로 이 지도의 한계도 함께 봐 두는 편이 좋습니다. Andrew Ng은 이 작업이 오늘만이 아니라 가까운 미래에 중요할 역량까지 겨냥했다고 밝혔지만, 재료의 상당 부분은 채용 공고와 채용 관리자 인터뷰입니다. 공고는 이미 이름이 붙은 역량을 적는 문서이므로, 시장이 아직 명명하지 못한 기술은 이런 방식으로 잡히기 어렵습니다. 미래를 겨냥한 부분이 데이터에서 나온 결론인지 저자들의 판단인지 원문만으로는 구분되지 않고, 표본의 국가 분포나 직무 구성도 공개되지 않았습니다. 여기에 이 지도가 교육 과정을 만드는 조직의 문서라는 점까지 겹쳐 놓으면, 네 갈래를 절대적 기준으로 받아들이기보다 왜 여기를 잘랐고 그 절단면이 우리 팀 상황과 맞는지를 따져 보는 쪽이 낫습니다. 지도를 계속 갱신하겠다고 밝히고 설문을 열어 둔 것도 이것이 완성된 정답표가 아니라 계속 손볼 초안이라는 뜻입니다.
 The AI Engineering Skills Map 원문 레터
 Andrew Ng의 소개 게시물
https://x.com/andrewyng/status/2088302050706686198
 The Batch 366호 전문
 DeepLearning.AI 홈페이지
더 읽어보기
-
Forward Deployed Engineers and the Future of AI Engineering (영문)
-
Context Hub: AI 코딩 에이전트의 API 환각을 막는 버전 관리 문서 허브 (feat. Andrew Ng)
-
OpenWorker: 채팅이 아닌 완성된 결과물을 만드는 오픈소스 AI 동료 (feat. Andrew Ng)
-
Awesome Harness Engineering: AI 에이전트를 안정적으로 만드는 하네스 엔지니어링 자료 모음
-
The LLM Evaluation Guidebook: Hugging Face가 공개한 LLM 평가를 위한 종합적이고 실질적인 안내서
-
Google, Context Engineering을 위한 세션(Session)과 메모리(Memory)의 개념 및 구현 전략에 대한 기술 백서 공개 [영문/PDF/72p]
-
Gas Town: 20-30개 AI 코딩 에이전트를 안정적으로 조율하는 Git 기반 멀티 에이전트 오케스트레이션 시스템
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글이 유용하셨다면 아래 쪽 좋아요
 를 눌러주세요 — 파이토치 한국 사용자 모임
 이 새로운 소식을 정리하고 공유하는 데 힘이 됩니다!
