Bernini 소개
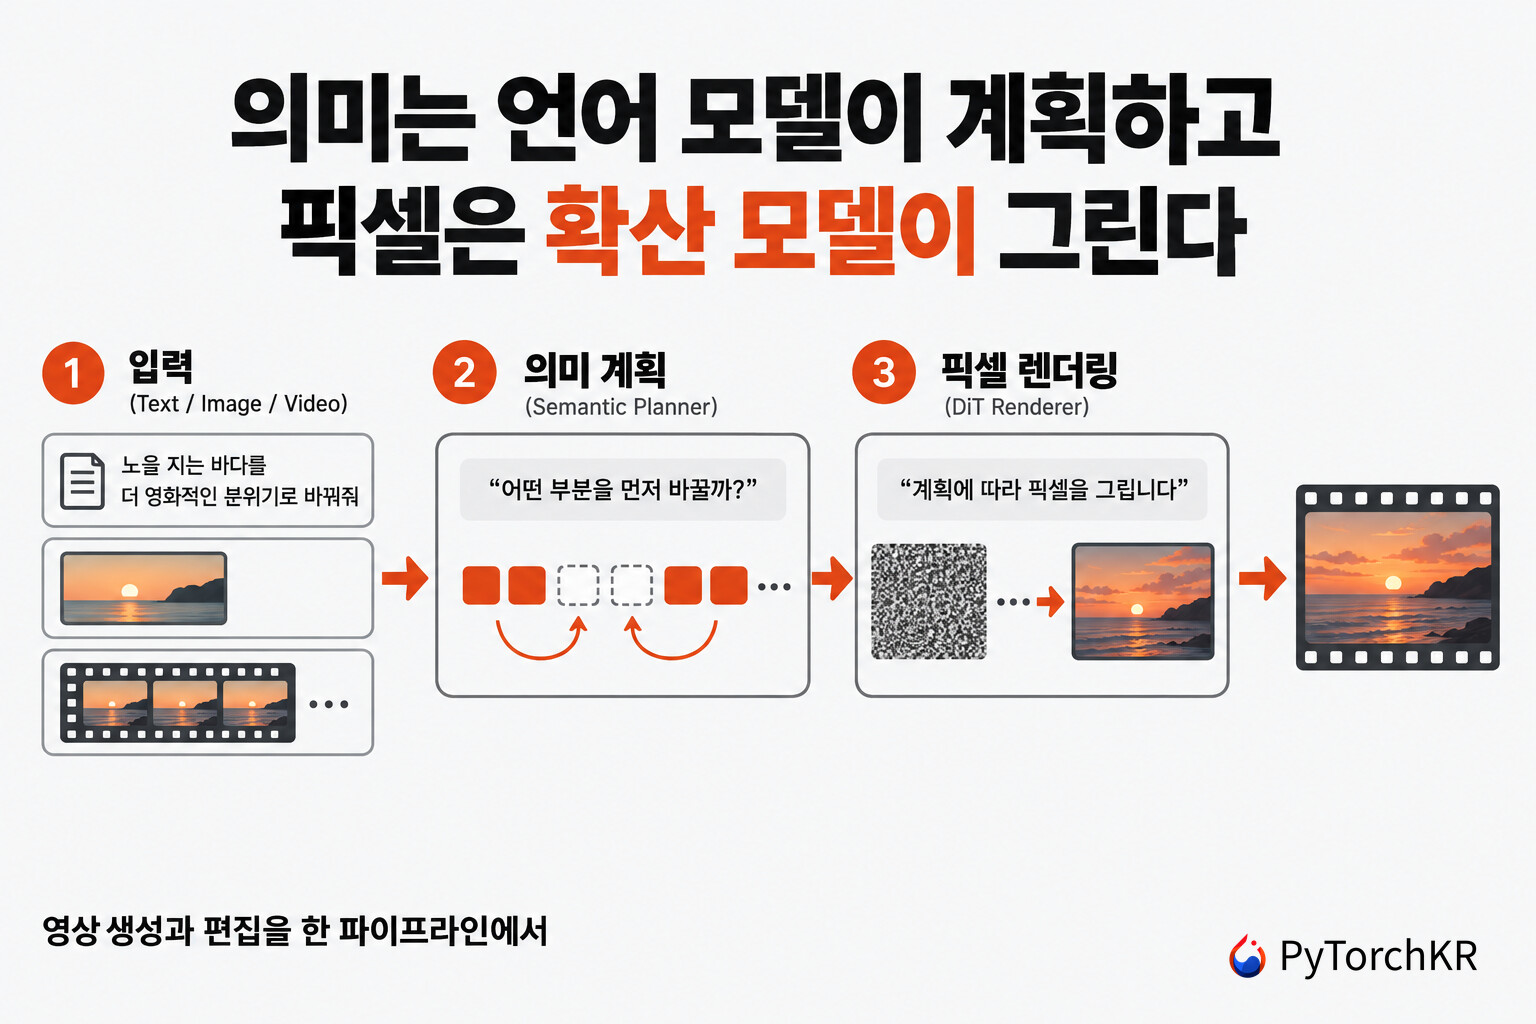
영상을 만들거나 고치는 확산 모델(Diffusion Model)은 대개 텍스트 조건 하나로 픽셀 생성을 통제합니다. 이 구조에서는 지시가 복합적일수록 무엇을 바꾸고 무엇을 그대로 둘지가 렌더러까지 충분히 전달되지 않습니다. ByteDance의 Bernini 팀은 여기서 멀티모달 대규모 언어 모델(MLLM)과 확산 모델을 한 덩어리로 합치는 대신, 둘의 역할을 나누는 방식을 제안했습니다. 앞쪽은 여러 형태의 입력을 읽고 의미를 다루는 데 강하고 뒤쪽은 픽셀을 사실적으로 합성하는 데 강하니, 앞쪽에 계획을 맡기고 뒤쪽에 그리기를 맡기자는 것입니다. 이번에 소개하는 Bernini는 그 분업을 그대로 구현한 영상 생성과 편집 통합 프레임워크로, MLLM 기반 의미 플래너(Semantic Planner)와 DiT 기반 렌더러(Renderer)를 한 파이프라인에 묶은 프로젝트입니다.
두 모델을 잇는 방법이 Bernini의 핵심입니다. 플래너는 결과 영상을 픽셀이나 토큰 ID로 예측하지 않고 ViT 임베딩 공간에서 목표 의미 표현을 직접 예측합니다. 렌더러는 그렇게 나온 의미 표현을 조건으로 받고, 여기에 텍스트 특징을 더하며, 편집 작업일 때는 원본 영상의 VAE(Variational Autoencoder) 특징까지 함께 받아 세부를 보존합니다. 의미 표현이 두 모델 사이의 인터페이스 역할을 하기 때문에 플래너와 렌더러를 따로 학습한 뒤 가볍게만 함께 학습해도 되고, 저자들은 이 덕분에 두 모델이 사전 학습에서 얻은 강점을 지키면서도 학습 비용을 낮출 수 있었다고 설명합니다. 여러 개의 시각 입력을 한 시퀀스에 담을 때 생기는 혼동을 줄이기 위해 세그먼트 인식 3D 회전 위치 임베딩(SA-3D RoPE, Segment-Aware 3D Rotary Positional Embedding)을 도입했고, 플래너 쪽에는 생각의 사슬(Chain-of-Thought) 추론을 함께 적용했습니다.
Bernini는 플래너로 Qwen2.5-VL-7B-Instruct를, 렌더러로 Wan2.2-T2V-A14B (
 Wan2.2: Alibaba에서 공개한 오픈소스 비디오 생성 모델)를 기반으로 삼았습니다. 저장소는 이 둘을 모두 쓰는 전체 파이프라인(Bernini)과 렌더러만 미세조정한 경량 모델(Bernini-R) 두 계열을 함께 공개하며, 두 계열 모두
t2i, i2i, t2v, v2v, rv2v, r2v 여섯 가지 작업을 같은 인터페이스로 처리합니다. 연구 내용은 논문 Bernini: Latent Semantic Planning for Video Diffusion에 정리되어 있고, 추론 코드와 모델 가중치에 이어 렌더러의 학습 코드까지 저장소에 올라와 있습니다.
Bernini와 렌더러 단독 방식 비교
Bernini 저장소가 두 계열을 함께 공개한 덕분에, 의미 계획 단계를 넣었을 때와 뺐을 때의 차이를 같은 저장소 안에서 비교할 수 있습니다. 두 계열의 구성과 강점은 다음과 같습니다:
| 모델 계열 | 구성 | 저자들이 밝힌 강점 |
|---|---|---|
| Bernini | MLLM 기반 의미 플래너 + DiT 기반 렌더러 | 복잡한 지시를 분해하고 의미 변화를 먼저 계획하므로 지시 따르기가 더 강함 |
| Bernini-R | Wan 확산 렌더러를 미세조정한 렌더러 단독 모델 | 구성 요소가 적어 렌더링과 일관성이 안정적이고 설치가 단순함 |
Bernini 팀은 두 계열의 용도를 나눠 두었습니다. 복잡한 생성과 편집 요청에서 지시를 얼마나 잘 따르는지가 중요하면 전체 파이프라인을, 추론을 단순하게 유지하거나 렌더러 자체를 평가하거나 출력 일관성이 지시 따르기보다 중요한 상황이면 Bernini-R을 권장합니다. 실제로 아래 벤치마크에서도 편집 지시를 따르는 항목은 전체 파이프라인이, 일반적인 영상 품질을 보는 항목은 렌더러 단독 모델이 앞섭니다.
경량 변형인 Bernini-R 1.3B는 Wan2.1-1.3B에서 미세조정한 모델입니다. Bernini 팀은 이 모델이 스타일 변환, 자막이나 워터마크 제거, 국소 편집처럼 단순한 작업에서는 14B 변형에 가까운 성능을 내지만 사람을 생성하는 것과 같이 복잡한 작업에서는 뒤처진다고 공개 시점에 밝혀 두었습니다.
Bernini를 사용하면 좋을 사용자
영상 편집 파이프라인을 자체 호스팅해야 하고 H100급 GPU를 여러 장 쓸 수 있는 팀에게 Bernini가 잘 맞습니다. 여섯 가지 작업을 같은 인터페이스로 처리하므로 작업마다 모델을 따로 붙이지 않아도 되고, 상용 영상 편집 API로 보낼 수 없는 영상을 다뤄야 하는 경우에도 쓸 수 있습니다. 렌더러의 학습 코드가 공개되어 있어 자체 데이터로 렌더러를 다시 학습하는 것도 가능합니다.
반대로 소비자용 GPU 한 장으로 영상을 만들려는 개인에게는 Bernini가 아직 적절한 선택지가 아닙니다. 영상 작업은 torchrun으로 여러 프로세스를 실행하고 시퀀스 병렬(Sequence Parallel)을 쓰는 경로로 안내되며, 저장소가 제공하는 실행 스크립트도 프로세스 8개와 8방향 병렬을 기본값으로 둡니다. 단일 GPU 경로는 t2i와 i2i 같은 이미지 작업에만 제공됩니다. 또한 플래너까지 포함한 전체 파이프라인을 처음부터 학습하려는 팀이라면, 현재 저장소에 올라온 학습 가이드가 렌더러(Bernini-R)를 대상으로 한다는 점을 먼저 확인해야 합니다.
Bernini의 동작 원리
Bernini는 텍스트, 원본 이미지, 원본 영상, 그리고 만들어 낼 대상 자리를 모두 ViT로 인코딩해 하나의 시퀀스로 만듭니다. 아래 그림은 Bernini의 전체 구조를 다섯 부분으로 나눠 보여줍니다. (A)는 입력을 통합 시퀀스로 만드는 단계, (B)는 MLLM 플래너, (C)는 DiT 렌더러이고, (D)와 (E)는 시퀀스 안에서 서로 다른 시각 입력을 구분하는 장치입니다:

플래너는 추론 시점에 반복적 마스크 보정(Iterative Masked Refinement) 방식으로 동작합니다. 첫 단계에서는 대상 토큰이 모두 마스크 상태이고, 단계를 거치며 마스크가 채워져 마지막 단계에서 완성된 의미 임베딩이 나옵니다. 이렇게 얻은 임베딩은 MLP 커넥터를 지나 렌더러의 조건으로 전달됩니다. 학습 시점에는 여기에 ViT 임베딩 디코더가 붙어 플래너 쪽과 렌더러 쪽에 각각 흐름 일치(Flow Matching) 손실이 걸립니다.
렌더러는 VAE 잠재 공간(Latent Space)의 토큰에 대해 흐름 일치 기반 노이즈 제거를 수행합니다. DiT 블록은 셀프 어텐션(Self-Attention)과 크로스 어텐션(Cross-Attention)을 함께 쓰는데, 크로스 어텐션에서 쿼리(Query)는 잠재 토큰이고 키(Key)와 값(Value)은 플래너가 넘긴 의미 임베딩입니다. 편집 작업에서는 원본 영상을 VAE 인코더에 통과시킨 특징이 함께 조건으로 들어가고, 마지막에 VAE 디코더가 잠재 표현을 이미지나 영상으로 되돌립니다.
SA-3D RoPE는 이 구조에서 생기는 구체적인 문제 하나를 처리합니다. 여러 개의 시각 입력을 한 시퀀스에 이어 붙이면 원본 이미지의 어떤 위치와 원본 영상의 어떤 위치가 같은 (t, h, w) 좌표를 갖게 되어 서로 구분되지 않습니다. Bernini는 세그먼트마다 다른 위상을 더해 같은 좌표라도 어느 입력에서 왔는지가 구분되도록 만들었습니다. 여기에 더해 세그먼트 단위 혼합 어텐션 마스크(Segment-wise Hybrid Attention Mask)를 써서 텍스트, 원본 이미지, 원본 영상, 대상 영역이 서로를 어디까지 볼 수 있는지를 제어합니다.
Bernini가 지원하는 여섯 가지 작업
Bernini와 Bernini-R은 같은 작업 인터페이스를 공유하며, 각 작업은 실행할 때 작업 유형으로 지정합니다:
| 작업 | 입력과 출력 |
|---|---|
t2i |
텍스트에서 이미지 생성 |
i2i |
이미지 편집 |
t2v |
텍스트에서 영상 생성 |
v2v |
영상 편집 |
rv2v |
참조 이미지를 함께 쓰는 영상 편집 |
r2v |
참조 이미지에서 영상 생성 |
프로젝트 페이지에는 작업별 결과 영상이 올라와 있습니다. 참조 이미지를 쓰는 편집에서는 물체, 재질, 날씨, 스타일을 참조 이미지로 지정할 수 있습니다. 다른 이미지나 영상을 기존 영상 안에 집어넣는 콘텐츠 삽입(Content Insertion) 사례도 따로 정리되어 있고, 참조에서 영상을 만드는 r2v는 참조 이미지를 최대 다섯 장까지 받아 영상 한 편을 만듭니다.
실행에 쓰는 입력은 케이스 파일(Case File)이라는 JSON 하나로 묶습니다. 작업 유형, 가이던스 모드, 프롬프트, 원본 미디어 경로, 출력 경로가 한 파일에 들어가고, 명령줄에는 --case로 그 파일만 넘깁니다. 긴 프롬프트를 명령줄에 늘어놓지 않으려는 구성이며, 저장소의 assets/testcases/ 아래에 작업별 예제가 들어 있습니다. 키 중에서 반드시 있어야 하는 것은 prompt 하나입니다.
Bernini 벤치마크
영상 편집 성능은 Bernini 팀이 자체적으로 구축한 아레나(Arena) 플랫폼의 결과로 공개되어 있습니다. 사람 평가자가 두 모델의 편집 결과를 블라인드로 비교 투표하고, 그 표를 브래들리-테리(Bradley-Terry) 점수와 쌍별 승률 행렬로 집계한 것입니다. 아래 그림의 왼쪽이 점수 순위표, 오른쪽이 행 모델과 열 모델의 쌍별 승률입니다:
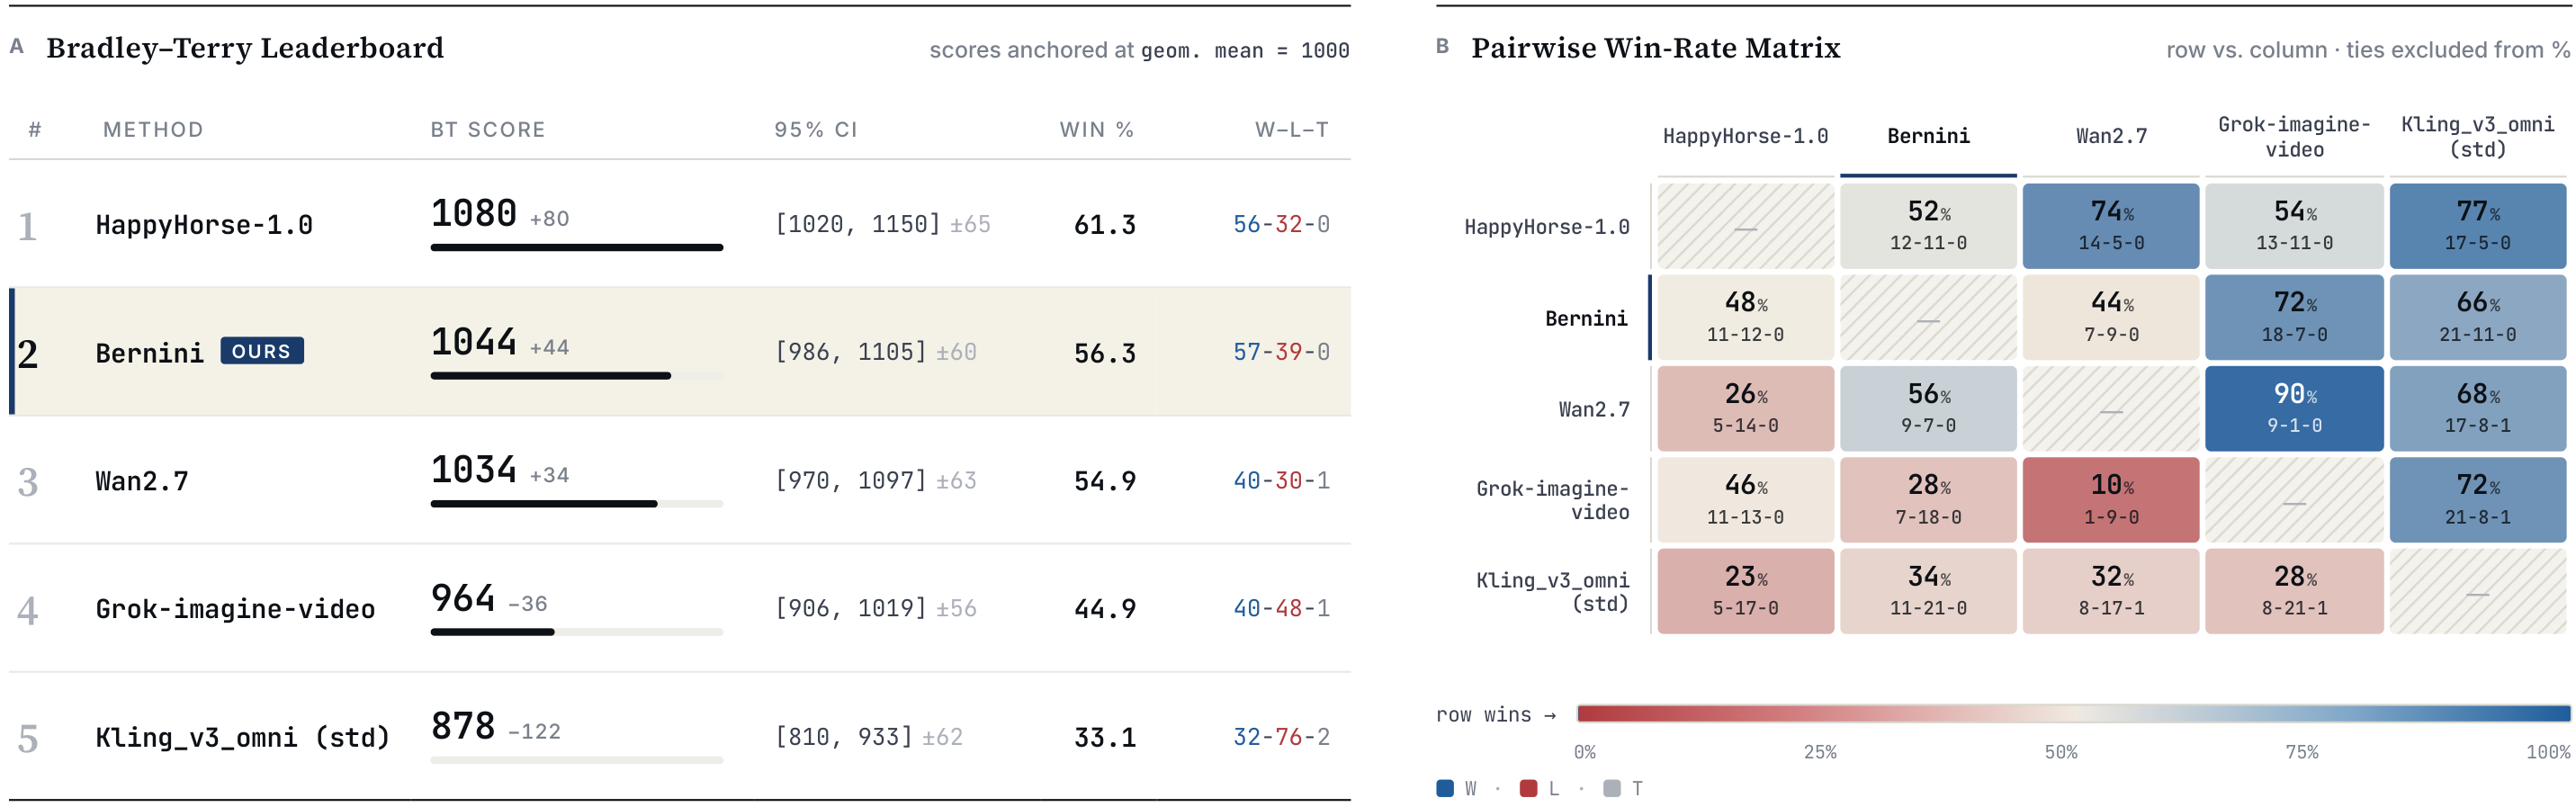
Bernini는 5개 모델 중 브래들리-테리 점수 1044점으로 2위이며, 1위인 HappyHorse-1.0의 1080점과는 36점 차이입니다. 쌍별 승률에서는 Grok-imagine-video를 상대로 72%, Kling_v3_omni(std)를 상대로 66%를 기록한 반면 HappyHorse-1.0에게는 48%, Wan2.7에게는 44%로 밀립니다. Bernini 팀은 이 결과를 두고 자사 모델이 "주요 폐쇄형 상용 모델들 사이에서 최상위 그룹에 도달했다" 고 표현했는데, 순위표 자체는 HappyHorse-1.0에 뒤진 2위를 가리킵니다. 이해관계가 있는 쪽이 만든 평가 환경이라는 점도 함께 감안할 필요가 있습니다.
공개된 네 가지 체크포인트의 벤치마크 수치는 다음과 같습니다:
| 모델 | EditVerse | OpenVE | OpenS2V | VBench | Bernini-v2v (OS) | Bernini-rv2v (OS) |
|---|---|---|---|---|---|---|
| Bernini-R 1.3B | 7.74 | 3.65 | 62.18 | 84.69 | 3.15 | 3.21 |
| Bernini-R 14B | 7.99 | 3.78 | 62.94 | 84.64 | 3.25 | 3.34 |
| Bernini 7+14B | 8.02 | 4.03 | 62.30 | 84.37 | 3.49 | 3.48 |
| Bernini-v2 7+14B | 8.02 | 3.96 | 63.83 | 84.46 | 3.49 | 3.55 |
전체 파이프라인이 모든 항목에서 앞서지는 않습니다. 편집 지시를 평가하는 EditVerse와 OpenVE, 그리고 프로젝트 이름이 붙은 Bernini-v2v (OS), Bernini-rv2v (OS) 항목은 플래너를 포함한 7+14B 계열이 가장 높지만, 영상 품질 전반을 보는 VBench에서는 가장 작은 Bernini-R 1.3B가 84.69로 1위이고 7+14B 계열이 오히려 낮습니다. 두 체크포인트의 차이는 커넥터를 다루는 방식에 있습니다. Bernini-Diffusers는 거의 0으로 초기화한 커넥터에서 곧장 공동 학습을 시작하고, Bernini-Diffusers-v2는 커넥터를 수천 스텝 예열한 뒤 공동 학습에 들어갑니다.
Bernini 설치와 사용
Bernini의 개발과 검증은 NVIDIA H100, CUDA 12.6, Python 3.11.2, PyTorch 2.7.1+cu126 환경에서 이뤄졌습니다. requirements.txt가 torch==2.7.1+cu126, diffusers==0.35.2, accelerate==0.34.2, transformers==4.57.3을 고정하고 있어 CUDA 툴킷도 12.6에 맞추는 편이 안전합니다. GPU는 FlashAttention-3을 쓸 수 있는 호퍼(Hopper) 계열(H100/H800/H200)이 권장되며, 그 외 CUDA GPU에서는 FlashAttention-2나 PyTorch SDPA로 내려갑니다.
설치는 저장소를 받은 뒤 고정된 의존성을 설치하고, 여기에 Open-VeOmni를 따로 설치하는 순서입니다:
git clone https://github.com/bytedance/Bernini.git bernini && cd bernini
pip install -r requirements.txt
# Open-VeOmni 는 --no-deps 로 설치합니다. 그러지 않으면 다른 torch 빌드를 끌고 와
# 고정해 둔 torch==2.7.1+cu126 을 덮어씁니다.
pip install --no-deps git+https://github.com/ByteDance-Seed/VeOmni.git@v0.1.11
Open-VeOmni는 선택 사항이 아닙니다. 단일 GPU 경로를 포함한 모든 추론 경로가 이 패키지를 임포트하므로, 설치를 건너뛰면 실행 자체가 되지 않습니다.
가중치는 허깅페이스에서 내려받습니다. 전체 파이프라인용 Bernini-Diffusers는 Bernini 체크포인트와 Qwen2.5-VL 플래너 자산, Wan2.2 확산 구성 요소를 한 디렉토리에 모아 둔 형태라 Wan 기본 트랜스포머 가중치를 따로 받을 필요가 없습니다:
pip install -U "huggingface_hub"
hf download ByteDance/Bernini-Diffusers --local-dir ByteDance/Bernini-Diffusers
실행은 저장소의 scripts/bernini/ 아래에 작업별로 준비된 스크립트를 쓰는 방식을 권장합니다. 각 스크립트가 권장 샘플링 하이퍼파라미터와 기본 케이스 파일을 이미 포함하고 있고, 영상 작업의 기본 출력은 480p, 16fps, 81프레임입니다:
bash scripts/bernini/run_t2i.sh    # 텍스트에서 이미지 생성
bash scripts/bernini/run_i2i.sh    # 이미지 편집
bash scripts/bernini/run_t2v.sh    # 텍스트에서 영상 생성
bash scripts/bernini/run_v2v.sh    # 영상 편집
bash scripts/bernini/run_rv2v.sh   # 참조 이미지를 함께 쓰는 영상 편집
bash scripts/bernini/run_r2v.sh    # 참조 이미지에서 영상 생성
스크립트는 환경 변수 네 개를 읽습니다. CASE_PATH로 실행할 케이스 파일을, BERNINI_CONFIG로 모델 디렉토리를, NPROC_PER_NODE와 ULYSSES로 프로세스 개수와 율리시스(Ulysses) 시퀀스 병렬 차수를 지정하며 뒤의 두 값은 기본이 8입니다:
CASE_PATH=assets/testcases/v2v/v2v_case2.json \
BERNINI_CONFIG=/path/to/Bernini-Diffusers \
NPROC_PER_NODE=8 ULYSSES=8 \
bash scripts/bernini/run_v2v.sh
렌더러만 쓰는 Bernini-R은 이미지 작업을 단일 GPU에서 돌릴 수 있습니다. --num_frames 1을 붙여 한 프레임만 만들도록 지정하는 점이 이미지 작업의 조건입니다:
python infer_single_gpu.py --config pretrained_models/Bernini-R-Diffusers \
    --case assets/testcases/t2i/t2i.json --num_frames 1 --guidance_mode t2v_apg
생성 품질을 위해 Bernini 팀이 권장하는 선택지가 하나 더 있습니다. --use_pe를 붙이면 OpenAI 호환 엔드포인트를 통해 프롬프트를 보강하는데, 이때 BERNINI_PE_API_KEY, BERNINI_PE_BASE_URL, BERNINI_PE_MODEL 환경 변수로 엔드포인트를 지정해야 하고 모델은 시각 입력을 받을 수 있는 채팅 모델이어야 합니다. 같은 파이프라인을 웹 UI로 쓰고 싶으면 저장소에 함께 들어 있는 gradio_demo.py를 쓰면 되고, 여기서는 작업 유형을 고르면 가이던스 모드가 자동으로 채워집니다.
Bernini의 라이선스
Bernini는 Apache 라이선스 2.0으로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 허깅페이스에 공개된 다섯 개의 가중치 저장소도 모두 같은 Apache-2.0을 따르고 있어, 코드와 가중치에 서로 다른 조건이 걸리지 않습니다.
 Bernini 프로젝트 페이지 (작업별 데모 영상과 구조 설명)
 Bernini 논문: Latent Semantic Planning for Video Diffusion
 Bernini 프로젝트 GitHub 저장소
 Bernini 모델 컬렉션 다운로드
더 읽어보기
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
