CLM 소개
에이전트가 매 순간 해야 할 일이 긴 답변 작성인 것은 아닙니다. 사용할 도구를 고르거나, 가능한 다음 행동을 비교하거나, 이미 생성된 여러 해답 중 하나를 선택하는 경우도 있습니다. 이런 작업에서는 현재 상태와 후보 행동이 얼마나 잘 맞는지 빠르게 판단하는 능력이 필요합니다.
대조 언어 모델(Contrastive Language Model, CLM)은 이 선택 문제를 대조 학습으로 다루는 모델입니다. 연구팀은 2026년 9월 23일 공개한 소개 글에서 CLM을 빠른 의사결정을 위한 System One 모델로 설명합니다. 상태와 행동을 각각 벡터로 변환한 뒤 서로의 유사도를 계산하며, 후보 중 점수가 가장 높은 행동을 선택합니다. 자유로운 문장 생성 대신 주어진 후보의 순위와 확률 분포를 반환합니다.
이번에 공개된 CLM-v0.1-8B는 Qwen3-8B를 인코더로 사용하는 방식으로 구성하여, 기존 모델의 가중치는 고정한 상태에서, 상태 및 행동을 위한 작은 투영 헤드(Projection Head)를 추가로 학습하였습니다. 연구팀은 게임과 도구 호출 평가에서 비교 모델 Jev보다 낮은 지연 시간을 보고했으며, 별도로 미세 조정한 모델을 코딩 에이전트의 검증기로도 평가했습니다. 이 두 평가의 조건과 공개 기본 체크포인트의 역할을 구분해서 살펴보겠습니다.
상태와 행동을 각각 인코딩하는 구조
CLM의 구조는 상태 인코더와 행동 인코더로 나뉩니다. 상태에는 질문이나 에이전트의 현재 작업 맥락이 들어가고, 행동에는 답변이나 도구 선택지, 실행 후보가 들어갑니다. 두 입력을 같은 임베딩 공간(Embedding Space) 에 배치하고 코사인 유사도로 적합도를 계산하는 방식입니다.
각 인코더는 고정된 언어 모델과 학습 가능한 투영 헤드(Projection Head) 로 구성됩니다. 입력의 마지막 토큰에서 얻은 은닉 상태를 정규화하고 다층 퍼셉트론에 통과시킵니다. Qwen3 계열의 배경은 Qwen3 소개 글에서도 확인할 수 있습니다. 공개 CLM 헤드는 Qwen3-8B의 마지막 토큰 풀링 임베딩을 전제로 하므로, 다른 임베딩 모델에 그대로 연결하는 용도로 설계되지는 않았습니다.
학습에는 양방향 InfoNCE 손실(Bidirectional InfoNCE Loss) 을 사용합니다. 정답으로 짝지어진 상태와 행동은 가깝게, 배치 안의 다른 조합은 멀어지도록 학습합니다. 상태에서 행동을 찾는 방향과 행동에서 상태를 찾는 방향을 함께 최적화합니다. 배치 크기를 B, 상태와 행동의 벡터를 s_i, a_i, 온도 계수를 \tau 라고 하면 다음과 같습니다.
추론 시에는 현재 상태와 각 후보의 점수를 구하고, 소프트맥스를 적용해 후보 집합 안의 확률 분포를 만듭니다. 따라서 출력된 확률은 주어진 후보들 사이의 상대적인 값입니다. 높은 확률을 받았다고 해서 해당 행동의 실제 성공 가능성이 그 수치만큼 보장되는 것은 아니며, 올바른 행동이 후보에 없으면 새 행동을 만들어 보완하지도 않습니다.
독립적 인코딩 → 캐싱
상태와 행동을 독립적으로 인코딩하면 캐싱(Caching) 을 각각 적용할 수 있습니다. 게임에서 선택 가능한 행동이 고정되어 있다면 행동 벡터는 미리 계산하고, 매 순간 달라지는 상태만 다시 인코딩하면 됩니다. 원문은 행동 후보가 네 개일 때 매 단계 상태 하나와 행동 네 개를 모두 처리하는 다섯 번의 순전파를, 상태만 처리하는 한 번으로 줄이는 예를 제시하였습니다.
연구팀은 약 1,000개의 후보를 비교하는 실험 결과, Jev 대비 13배 가량의 속도 개선이 있었다고 밝혔습니다. 단, 이러한 수치는 후보 수와 재사용 조건이 있는 경우에 한하여 실험한 결과로, 매번 새로운 상태와 후보를 모두 인코딩해야 하는 작업에서는 이만큼 빠르지 않습니다. 서버의 벡터 캐시 설명에서도 새로운 상태를 계속 처리하는 경우와 기존 상태를 다시 방문하는 경우를 구분합니다.
세 단계 학습 기반의 의미 이해 → 행동 선택 확장
학습 데이터 구성은 질문과 답변의 대응 관계를 먼저 학습한 뒤, 그럴듯한 오답을 구별하고 에이전트 행동에 적응하도록 설계되어 있습니다.
| 단계 | 데이터 | 학습 목적 |
|---|---|---|
| 사전 학습 | 약 6,000만 개의 Nemotron DQA 질문과 답변 쌍 | 질문을 상태, 답변을 행동으로 삼아 폭넓은 의미 대응 관계 학습 |
| 중간 학습 | 약 3,000만 개의 합성 하드 네거티브 | 질문과 의미상 비슷하지만 틀린 답을 구별 |
| 후속 학습 | 약 100만 개의 에이전트 궤적 | 에이전트의 현재 맥락과 다음 결정의 관계에 적응 |
하드 네거티브(Hard Negative) 는 정답과 쉽게 구별되는 무관한 문장 대신, 그럴듯하지만 틀린 후보를 뜻합니다. 연구팀은 Gemini 2.5 Flash-Lite로 생성한 합성 오답을 중간 학습에 사용했습니다. 상태 s_i 에 대한 오답 행동을 h_{ik}^{(a)} 로 나타내면, 상태에서 행동을 찾는 방향의 손실은 다음과 같이 정답과 오답을 비교합니다.
후속 학습에는 Agent Data Protocol의 에이전트 궤적과 Endless-Terminals, LiteCoder-Terminal-SFT의 터미널 실행 기록을 사용합니다. 이때 데이터 혼합의 40%를 기존 Nemotron DQA 예제로, 60%를 에이전트 궤적으로 구성합니다. 기존 데이터를 다시 학습하는 데이터 재사용(Data Replay) 을 넣어 일반적인 질문과 답변의 구별 능력을 유지하려는 구성입니다.
이 선택은 원문의 비교 실험으로 뒷받침됩니다. 기존 데이터를 섞었을 때 하드 네거티브 평가의 top-1 정확도는 69%에서 68.5%로 바뀌었지만, 같은 수의 에이전트 학습 단계에서 에이전트 데이터만 사용하면 56.2%로 낮아졌습니다. 또 약 10만 개의 평가 질문에 정답 하나와 오답 열 개를 붙인 실험에서, 사전 학습만 한 모델은 52.1%, 이후 중간 학습을 추가한 모델은 69.2%를 기록했습니다. 처음부터 하드 네거티브를 함께 학습한 방식의 최고치는 62.4%였습니다. 후자의 차이는 6.8%포인트이며 원문에서는 약 7포인트로 설명합니다.
규모를 키웠을 때의 관찰
연구팀은 스케일링 법칙 실험에서 학습 계산량, 데이터 크기, 투영 헤드 크기, 인코더 크기와 테스트 InfoNCE 손실 사이의 관계도 조사했습니다. 다른 요인이 병목이 되지 않는 조건에서 손실은 L(X)\approx(X_c/X)^{\alpha_X} 와 같은 멱법칙 형태를 보였고, 인코더 크기를 늘릴 때 가장 큰 개선을 관찰했다고 설명합니다.
고정된 계산 예산에서 적절한 헤드 크기를 찾는 실험에서는 최적 크기가 학습 토큰 수에 대해 N^*\propto D^{1.02} 로 증가했으며, 파라미터당 약 310토큰이라는 관계를 보고했습니다. 이 결과는 Nemotron DQA와 해당 실험 범위에서 얻은 손실의 경향입니다. 모든 에이전트 벤치마크의 성공률이 같은 법칙을 따른다는 검증 결과로 확대해서 읽어서는 안 됩니다.
제로샷 평가에서 속도와 성공률을 함께 살펴보기
제로샷 평가는 T-Rex 게임, BFCL v4 도구 호출, WikiRacing, Super Mario를 대상으로 합니다. 연구팀은 전반적인 성능이 Jev와 비슷하면서 지연 시간이 최대 약 9배 낮다고 요약하지만, 개별 과제의 성공률에는 차이가 있습니다.
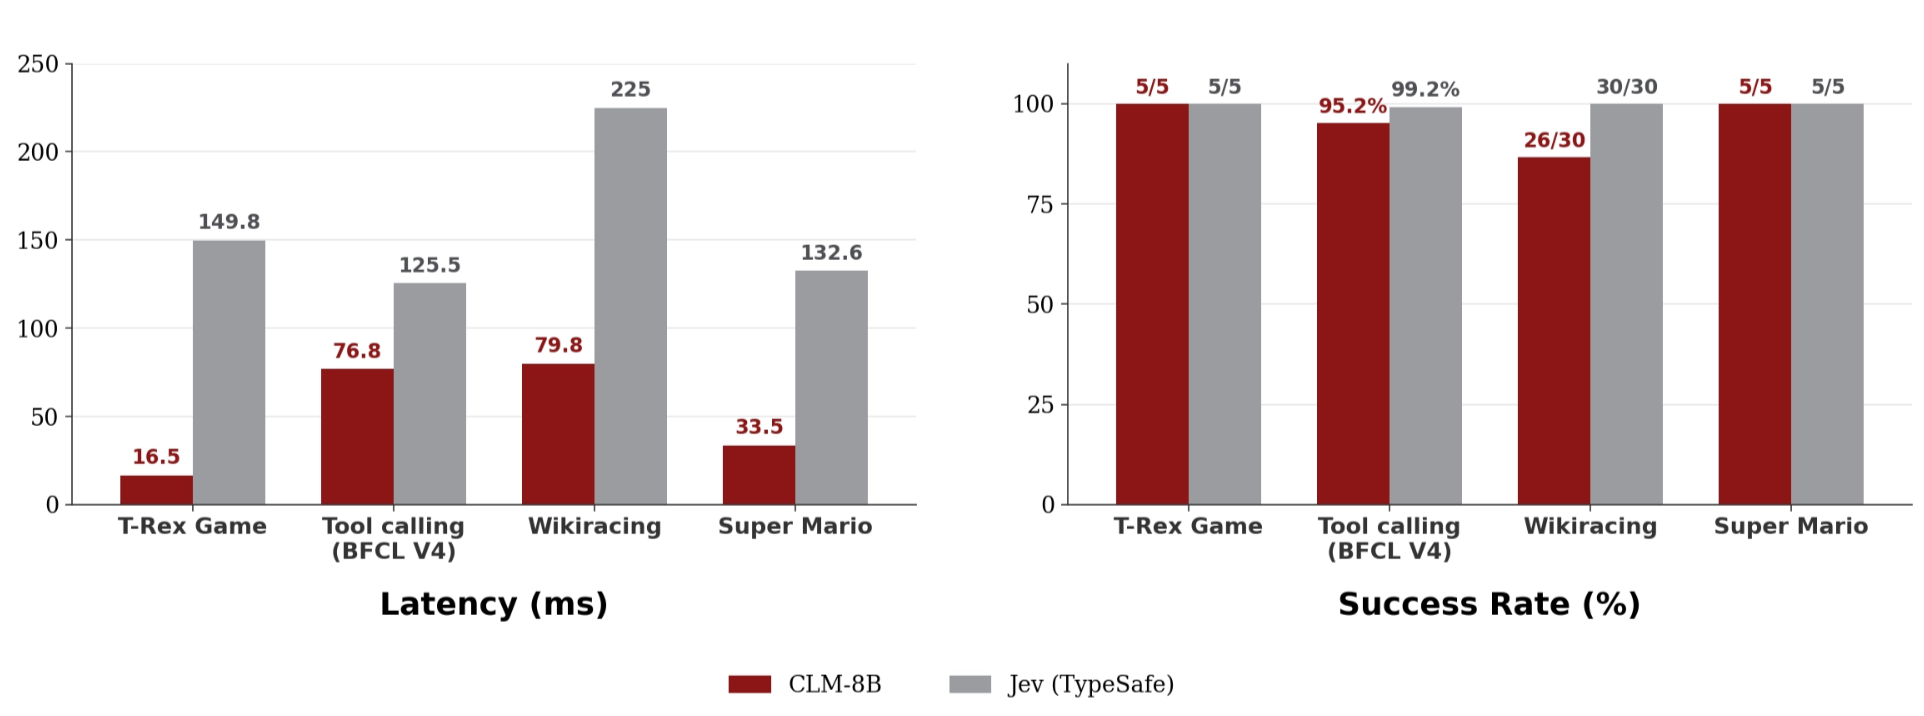
CLM-8B와 Jev의 제로샷 비교입니다. 왼쪽은 지연 시간, 오른쪽은 성공률이며 수치는 연구팀의 측정 결과입니다. 출처: 공식 평가 도표.
| 과제 | CLM-8B 지연 시간 | Jev 지연 시간 | CLM-8B 성공률 | Jev 성공률 |
|---|---|---|---|---|
| T-Rex Game | 16.5ms | 149.8ms | 5/5 | 5/5 |
| Tool calling, BFCL v4 | 76.8ms | 125.5ms | 95.2% | 99.2% |
| WikiRacing | 79.8ms | 225ms | 26/30 | 30/30 |
| Super Mario | 33.5ms | 132.6ms | 5/5 | 5/5 |
최대 약 9배의 속도 차이는 T-Rex의 149.8ms와 16.5ms 비교에서 나옵니다. 반면 도구 호출에서는 성공률이 4.0%포인트 낮고, WikiRacing에서는 성공한 과제 수가 네 개 적습니다. 또한 두 게임의 성공률 표본은 각각 다섯 번이므로, 이 결과만으로 광범위한 게임 환경에서 동일한 성공률을 기대하기는 어렵습니다. 적용하려는 작업에서 허용할 수 있는 지연 시간과 실패율을 함께 평가해야 하는 이유입니다.
코딩 검증기 성능 = 미세 조정의 결과
코딩 분야의 실험에서, CLM은 코드를 처음부터 생성하는 모델이 아닌, 다른 모델이 만든 여러가지 후보군들 중 하나를 고르는 검증기(Verifier) 로서 동작하도록 설계하였습니다. 연구팀은 DeepSWE에서 Opus 5, Terminal-Bench 2.1에서 Fable 5가 만든 후보를 사용했다고 밝힙니다. 미세 조정한 CLM과 Jev가 같은 후보 집합에서 해답을 선택하는 방식으로 비교합니다.
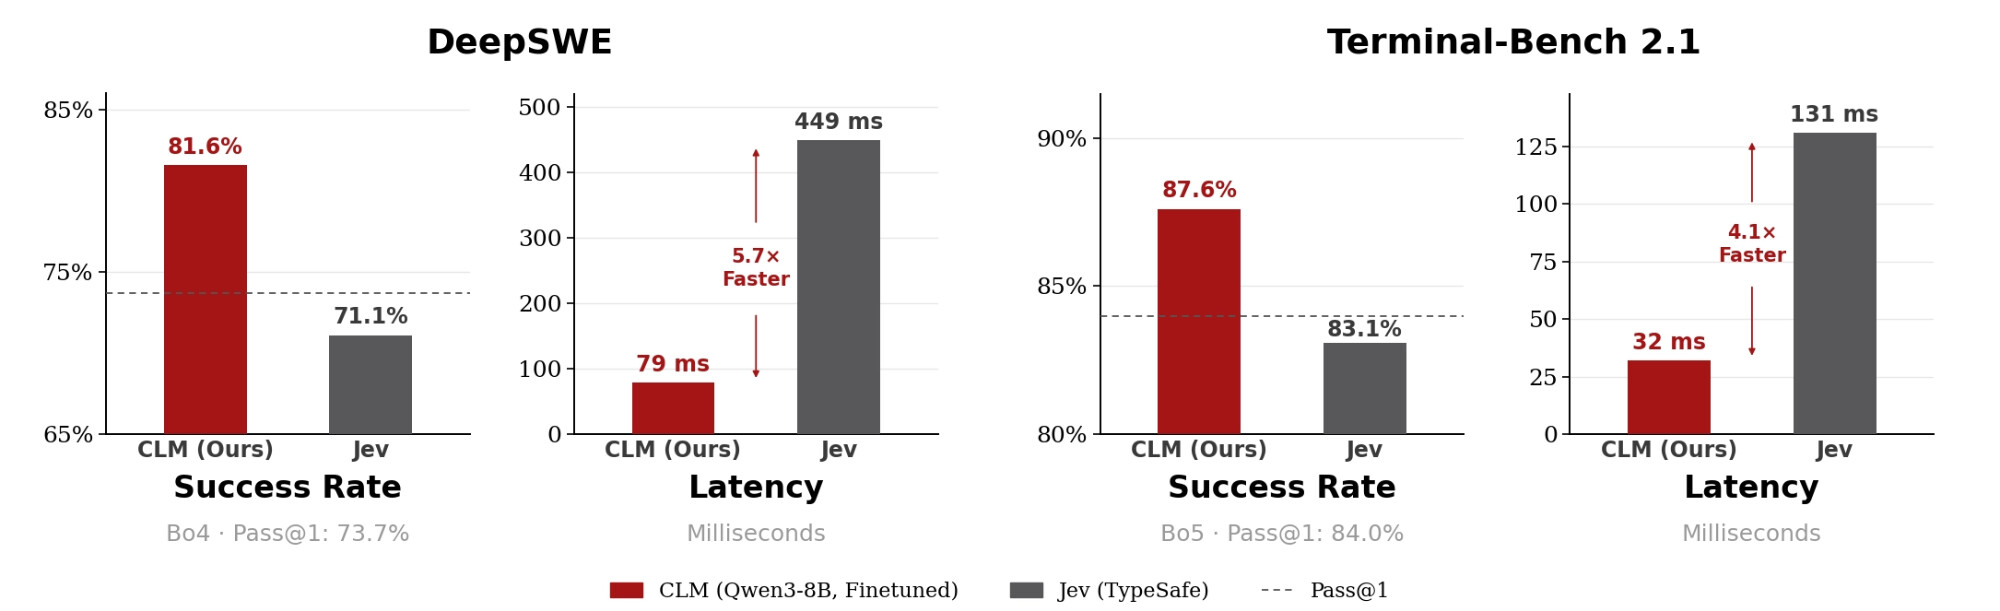
미세 조정한 CLM 검증기의 성공률과 지연 시간: 점선은 Pass@1 기준선, 지연 시간은 H100 기준
| 평가 조건 | DeepSWE | Terminal-Bench 2.1 |
|---|---|---|
| 학습에서 제외한 평가 과제 수 | 38개 | 30개 |
| 후보 선택 방식 | Best-of-4 | Best-of-5 |
| CLM 성공률 | 81.6% | 87.6% |
| Jev 성공률 | 71.1% | 83.1% |
| Pass@1 기준선 | 73.7% | 84.0% |
| CLM 검증 지연 시간 | 79ms | 32ms |
| Jev 검증 지연 시간 | 449ms | 131ms |
연구팀은 이 결과를 최고 성능으로 소개하지만, 이 글에서는 연구팀이 구성한 평가 부분집합에서의 보고값으로 제시합니다. DeepSWE 81.6%는 저장소의 재현 예시에서 38개 중 31개 성공으로 설명합니다. Terminal-Bench의 87.6%는 공개 도표의 수치이며, 단순히 평가 과제 30개 중 몇 개를 성공했다는 정수 비율로 바꾸어 설명하지 않습니다.
또한, 위 지연 시간은 검증 단계의 비교 값으로, 전체 에이전트 실행 시간이 4~6배 줄었다는 뜻이 아님을 유념해야 합니다. 모델 카드의 제한 사항에서도 이 성능이 기본 체크포인트의 제로샷 결과가 아니라 미세 조정한 헤드의 결과임을 명시하고 있으니 참고해주세요.
CLM 모델 배포 및 사용법
공식 빠른 시작 예제는 임베딩 서버와 CLM API 서버를 분리합니다. 먼저 패키지를 설치하고, vLLM으로 Qwen3-8B를 풀링 모드에서 실행한 뒤 CLM 서버를 시작합니다:
pip install contrastive-lm

# 1. encoder (Qwen3-8B embeddings)
vllm serve Qwen/Qwen3-8B --served-model-name qwen3-8b --runner pooling --max-model-len 2048 --port 8090 &

# 2. CLM API on :8700 (downloads the 75 MB reference head on first run)
clm-serve
75MB는 CLM 헤드 다운로드 크기이며, 별도로 사용하는 Qwen3-8B 전체 모델의 크기가 아닙니다. 기본 설정에서 2,048토큰을 넘는 상태는 잘립니다. 긴 상태를 처리하려면 임베딩 서버의 --max-model-len 과 CLM 서버의 --max-tokens 를 함께 높여야 하며, GPU 메모리도 더 필요합니다.
후보 순위 API는 질문과 후보 답변을 직접 비교할 수 있습니다. 아래는 모델 카드의 예제로, 지구의 조석 원인에 대한 답변 후보 세 개를 평가합니다.
from clm import Engine

engine = Engine(emb_url="http://127.0.0.1:8090/v1/embeddings")
engine.rank("What causes tides on Earth?",
            ["The Moon's gravitational pull.", "Photosynthesis in plants.", "Because the Earth is round."])
타입별 질문 API는 참일 확률을 반환하는 Noul, 여러 선택지 중 하나를 고르는 Choice, 순서가 있는 등급의 기댓값을 계산하는 Score 를 제공합니다. 세 형식 모두 상태와 후보를 비교하는 기본 연산을 사용합니다. API의 confidence 는 가장 높은 확률에서 나머지 확률의 평균을 뺀 값으로 정의되어 있으므로, 별도의 신뢰구간과 혼동하지 않아야 합니다.
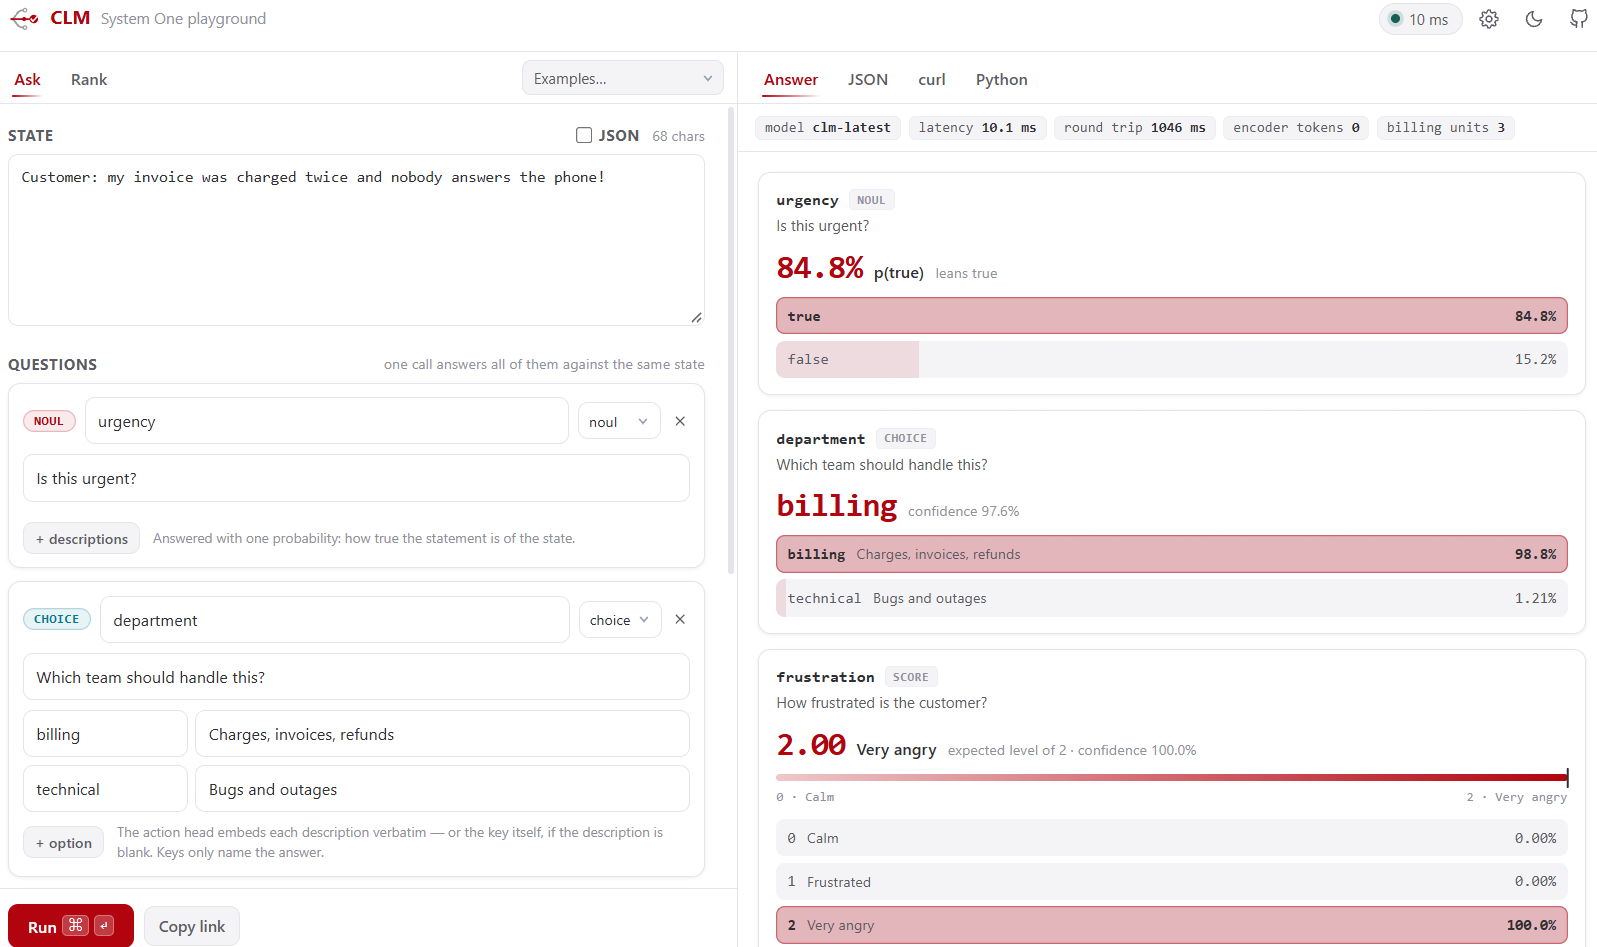

공식 플레이그라운드의 고객 문의 분류 예시입니다. 왼쪽에서 상태와 질문을 설정하고 오른쪽에서 후보별 분포를 확인합니다. 출처: 플레이그라운드 안내.
서버를 시작한 뒤 http://localhost:8700/ 에 접속하면 플레이그라운드를 사용할 수 있습니다. 질문을 추가해 분포를 확인하거나 Rank 탭에서 후보 집합의 순위를 비교할 수 있습니다. 모델의 판단이 기대와 다르면 상태 설명, 후보 설명, 후보 집합을 각각 바꾸어 결과가 어떻게 달라지는지 확인할 수 있는 인터페이스입니다.
공개 범위와 활용 시 확인할 점
CLM은 도구 선택, 고정된 행동 집합의 선택, 이미 생성한 해답의 재정렬처럼 후보를 명시할 수 있는 작업에 적용하는 구조입니다. 반대로 후보 생성 자체가 어려운 작업에서는 별도의 생성 모델이나 규칙이 필요합니다. 후보 설명과 구성에 따라 상대 확률이 달라지므로, 실제 업무에 도입하려면 사용하는 후보 집합과 작업 데이터로 선택 정확도를 확인해야 합니다.
공개 코드와 CLM-8B 가중치는 Apache 2.0으로 배포됩니다. 연구팀은 발표 당시 더 큰 멀티모달 CLM-35B를 학습 중이며 2026년 10월 초 공개를 예고했습니다. 이는 향후 계획으로, 현재 소개한 CLM-v0.1-8B의 제공 기능과 구분해야 합니다.
 Contrastive Language Models 소개 블로그
 CLM GitHub 저장소
 CLM-v0.1-8B 모델 카드
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
vLLM Semantic Router팀, Jev와 유사한 Decision 1.0 기능 및 6개 모델, Decision Studio 공개
-
Fast Jev Compaction: 컨텍스트 정리 시, 불필요한 도구 호출 결과를 제외하는 Claude Code 플러그인
-
Jev Search: 사용자의 질의에 대해, 어디를 검색해야 하는지 URL과 순위만 제공하는 웹 검색 프로젝트
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
