Gemini 4 Argon 소개
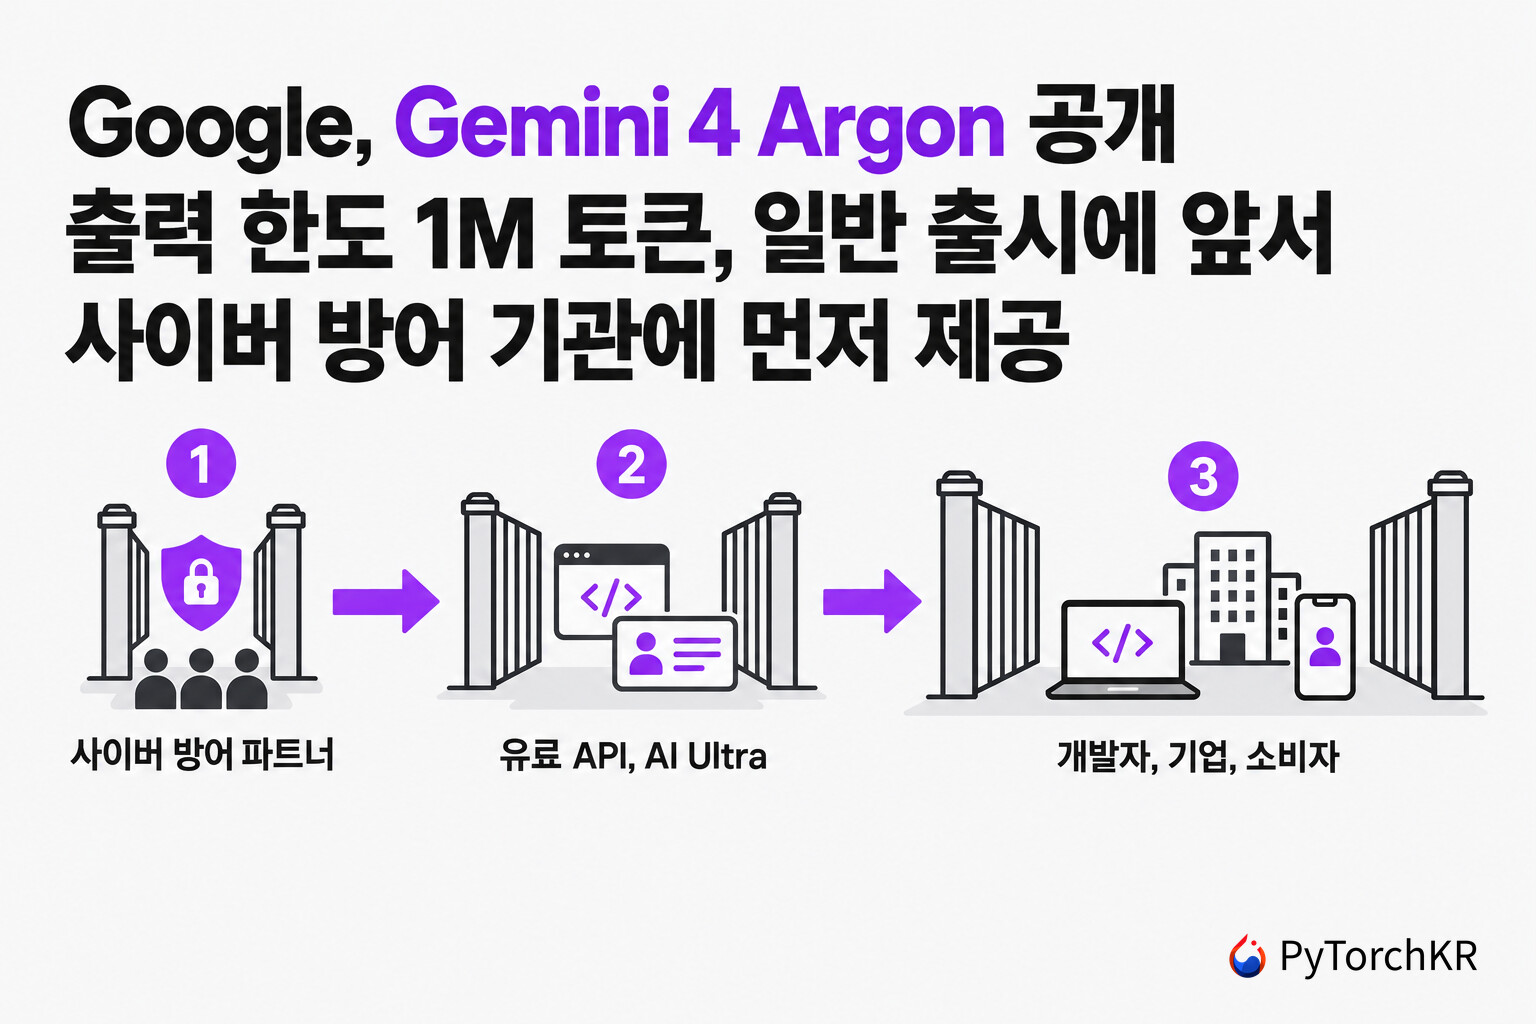
Google이 2026년 9월 30일 새 프런티어 모델 Gemini 4 Argon 을 공개했습니다. 긴 호흡의 다단계 작업을 끝까지 수행하도록 만든 모델로, 출력 토큰 한도를 기존 64K에서 1M으로 늘렸고 소프트웨어 엔지니어링, 법률과 금융 같은 전문 업무, 사이버 보안 방어 영역의 벤치마크에서 1위를 주장합니다. 다만 이번 발표는 일반 출시가 아니라 공개 순서를 먼저 밝힌 발표 에 가깝습니다. 첫 사용자는 개발자가 아니라 Fairwind Program으로 선정된 사이버 방어 기관들입니다.
Google은 이 순서를 택한 이유를 안전성에서 찾습니다. 발표를 쓴 Google DeepMind의 Koray Kavukcuoglu는 이 수준의 능력을 안전하게 내놓으려면 단계적 접근이 필요하다고 적었고, Google은 미국 정부의 자발적인 출시 전 모델 접근(pre-release model access) 절차에도 참여하고 있다고 밝혔습니다. 초기 테스터의 피드백으로 가드레일(guardrail)을 다듬은 뒤 유료 API 고객과 Google AI Ultra 구독자 에게 먼저 열고, 이후 개발자, 기업, 소비자 전반으로 넓힌다는 계획입니다. 구체적인 날짜는 공개하지 않았습니다.
이러한 흐름은 한 달 전 발표와 이어져 있습니다. Google은 9월 2일 Gemini 3.8 Flash와 3.8 Flash Cyber를 내놓으면서 사이버 특화 모델을 신뢰할 수 있는 방어자에게만 제공하는 Fairwind Program을 시작했고, Argon은 그 프로그램에 들어가는 두 번째 모델입니다. Anthropic이 일반 공개하지 않은 Claude Mythos Preview를 Project Glasswing 보안 파트너와 먼저 활용한 것과 비슷한 방식으로, 사이버 능력이 높은 프런티어 모델을 방어자에게 먼저 제공하는 출시 방식이 반복되고 있습니다.
Gemini 4 Argon의 핵심 특징
Google은 Argon의 프런티어급 능력 영역으로 코딩, 전문 업무, 사이버 보안 방어와 함께 창작 글쓰기(creative writing)를 꼽았습니다. 주요 특징은 다음과 같습니다.
-
출력 토큰 한도 1M: 이전 64K에서 약 16배 늘었고, Google은 업계 최대 수준이라고 밝혔습니다. Google은 모델이 한 번의 궤적(trajectory)에서 수십만 토큰을 생성하며 깊게 생각할 여유가 생기면, 어려운 문제를 한 번에 풀어내는 추론(reasoning) 깊이가 달라진다고 설명합니다. 다만 출시 당일 API로 Argon을 평가한 Vals AI의 모델 페이지는 최대 출력 토큰을 262,144(약 262k)로 표기하고 그 값으로 평가를 진행했습니다. 1M 한도가 언제, 어떤 경로에서 적용되는지는 아직 공식 문서에서 확인되지 않습니다.
-
장기 에이전트 작업: 긴 소프트웨어 엔지니어링 과제를 다루는 DeepSWE v1.1에서 77.9%로 최고 기록을 주장합니다. Google 엔지니어들이 일상적인 디버깅부터 대규모 코드베이스 마이그레이션, 알고리즘 설계까지 이미 사용 중이라고 합니다.
-
전문 업무(Knowledge Work): 미국 GDP 기여도로 분야별 가중치를 둔 Vals Index에서 68.9%로 1위이고, Vals Finance Agent v2(65.4%)와 Zapier의 AutomationBench(51.3%)에서도 공개 리더보드 1위입니다. Harvey's Legal Agent Benchmark는 Google이 비교한 4개 모델 중에서는 가장 높지만, 전체 리더보드에서는 5위입니다(아래 설명).
-
시각 이해가 필요한 업무: 긴 영상 이해 벤치마크 LVBench에서 91.7%로, 차트 분석과 긴 영상 속 세부 식별, 여러 문서를 근거로 한 작업을 지원합니다.
-
방어 목적의 사이버 보안 능력: 취약점을 스스로 찾고 검증하고 패치하도록 학습했으며, 신뢰할 수 있는 방어자와 Google 내부 팀에게는 사이버 관련 가드레일을 끈 상태로 제공할 계획입니다.
경쟁 모델과의 벤치마크 비교
아래 그림은 Google이 공개한 전체 벤치마크 표입니다. 비교 대상은 OpenAI GPT-6 Astra, Anthropic Claude Fable 5.1, Claude Opus 5.5이며, 파란색이 Argon이 1위인 항목, 회색이 다른 모델이 1위인 항목입니다.
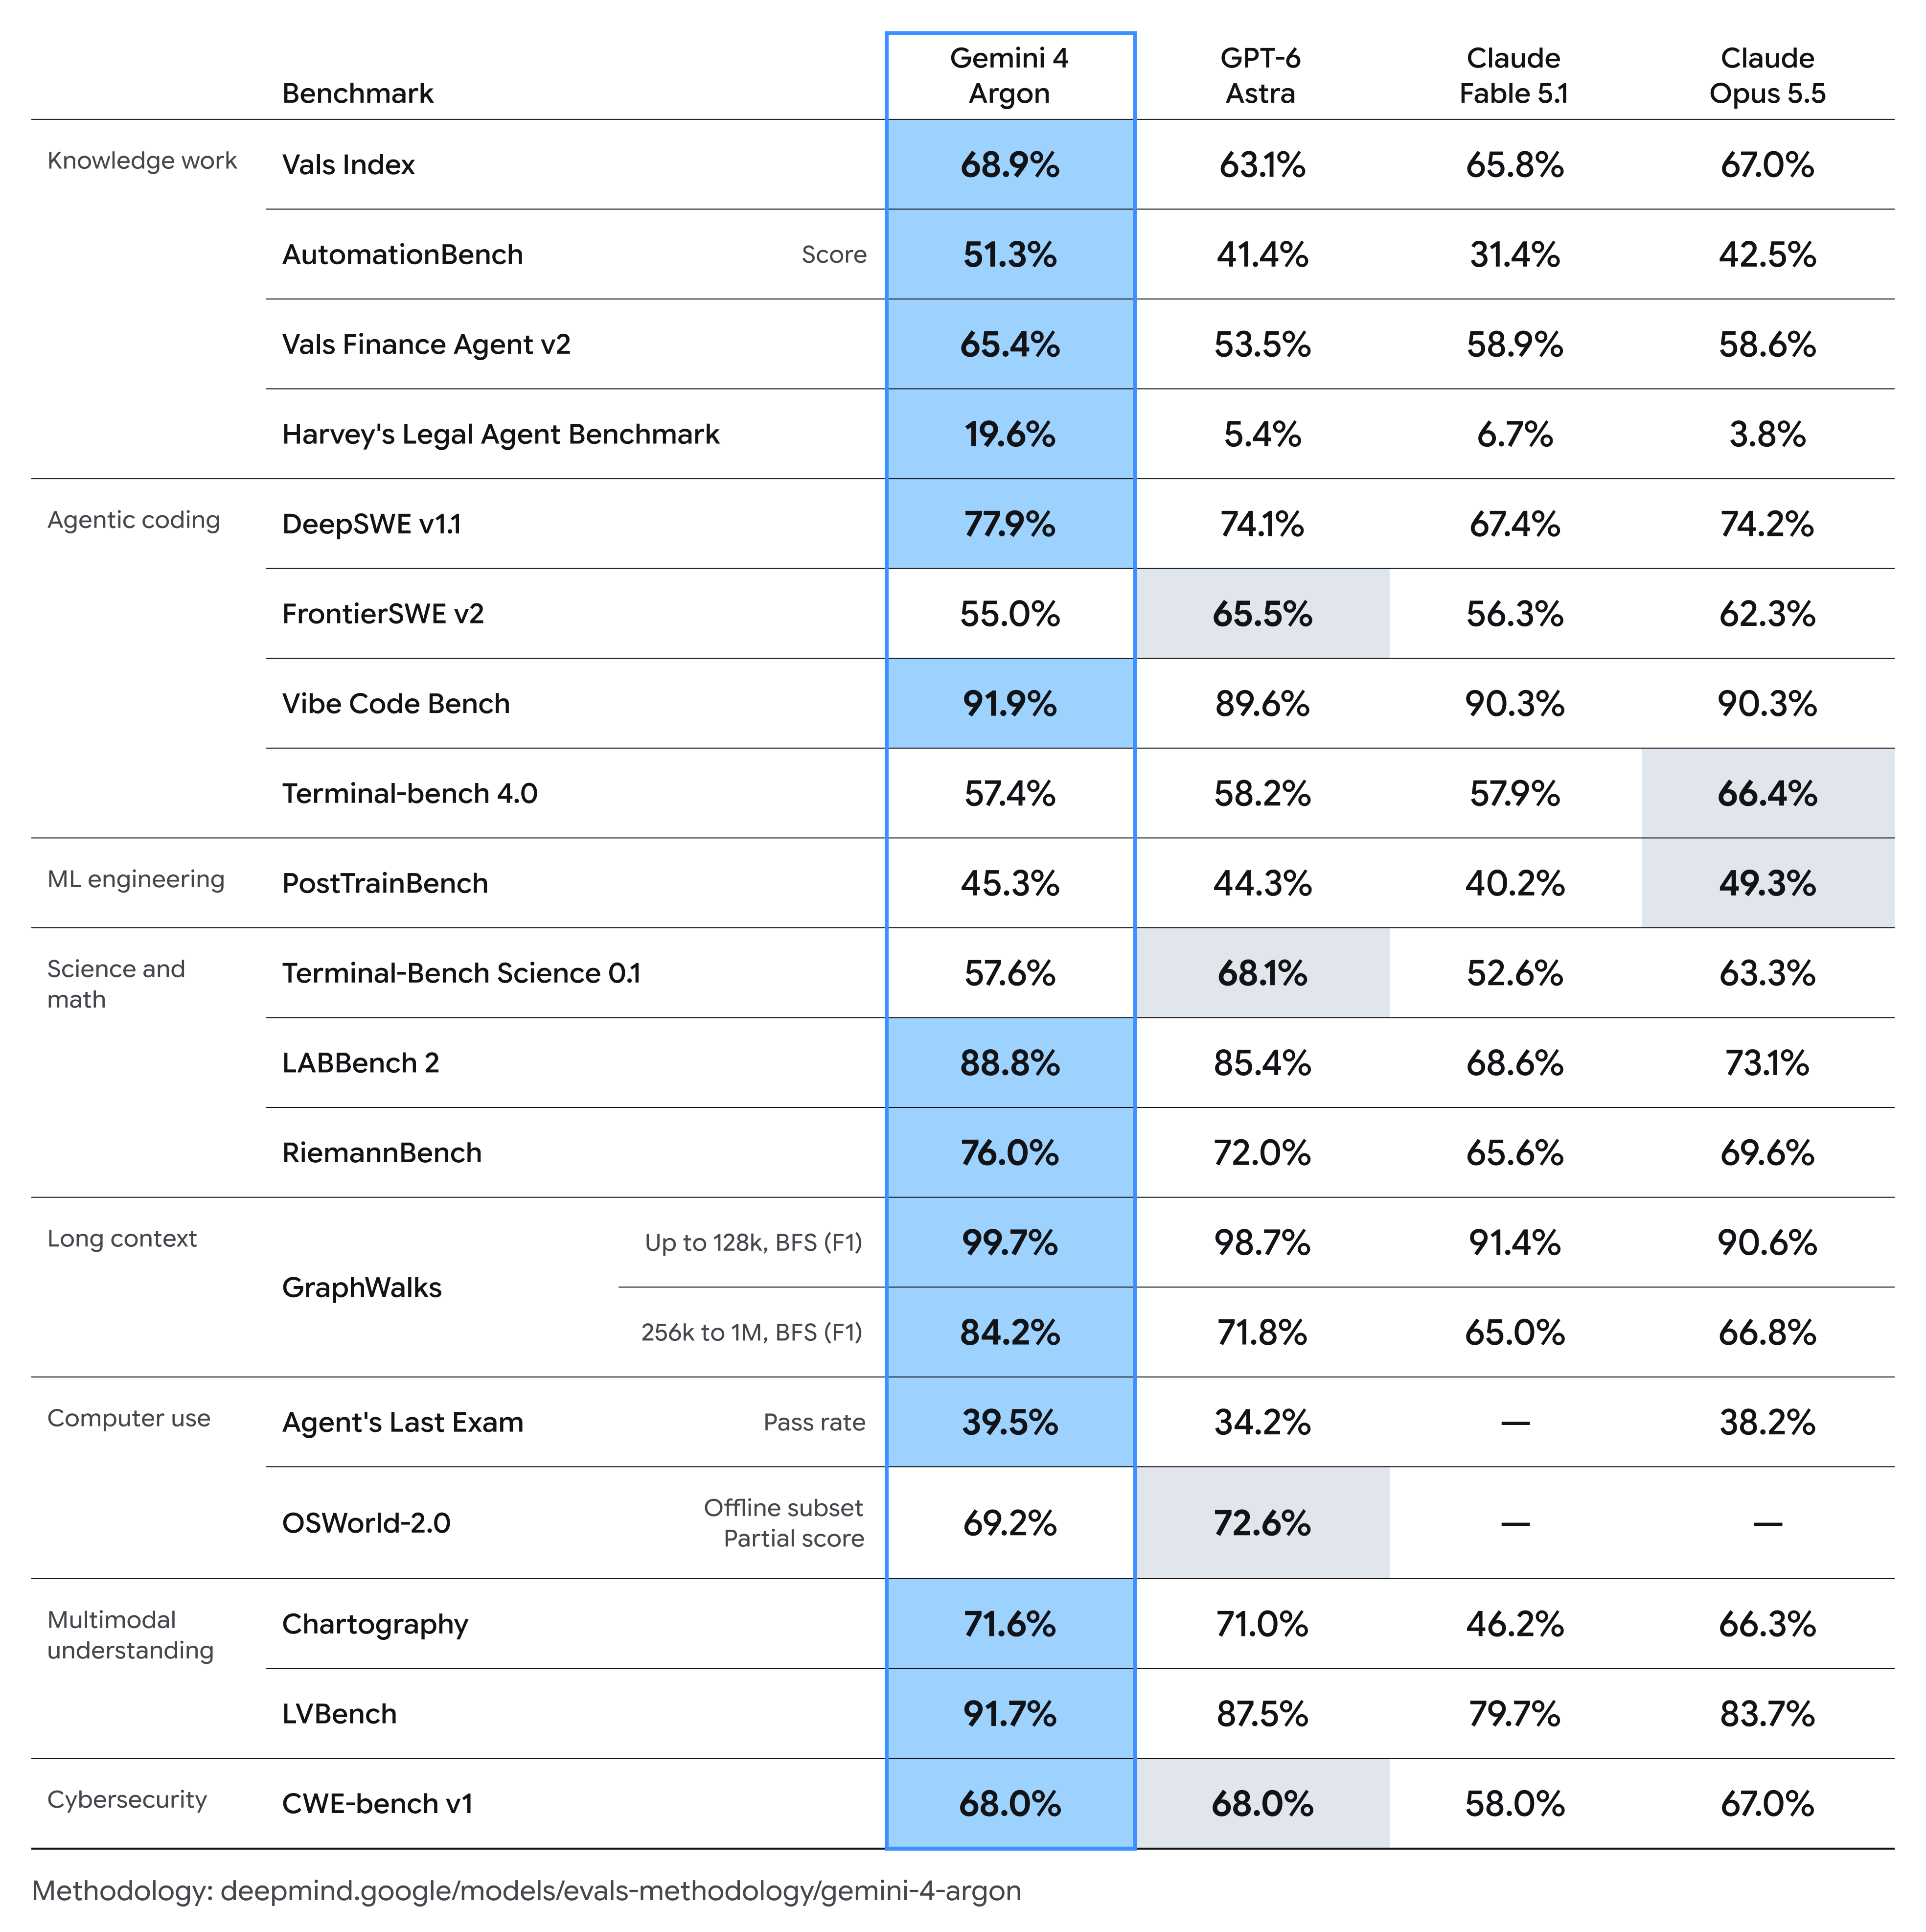
위 표의 대표 항목을 정리하면 다음과 같습니다.
| 벤치마크 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| GraphWalks (256k~1M, BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld-2.0 (오프라인, 부분 점수) | 69.2% | 72.6% | - | - |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
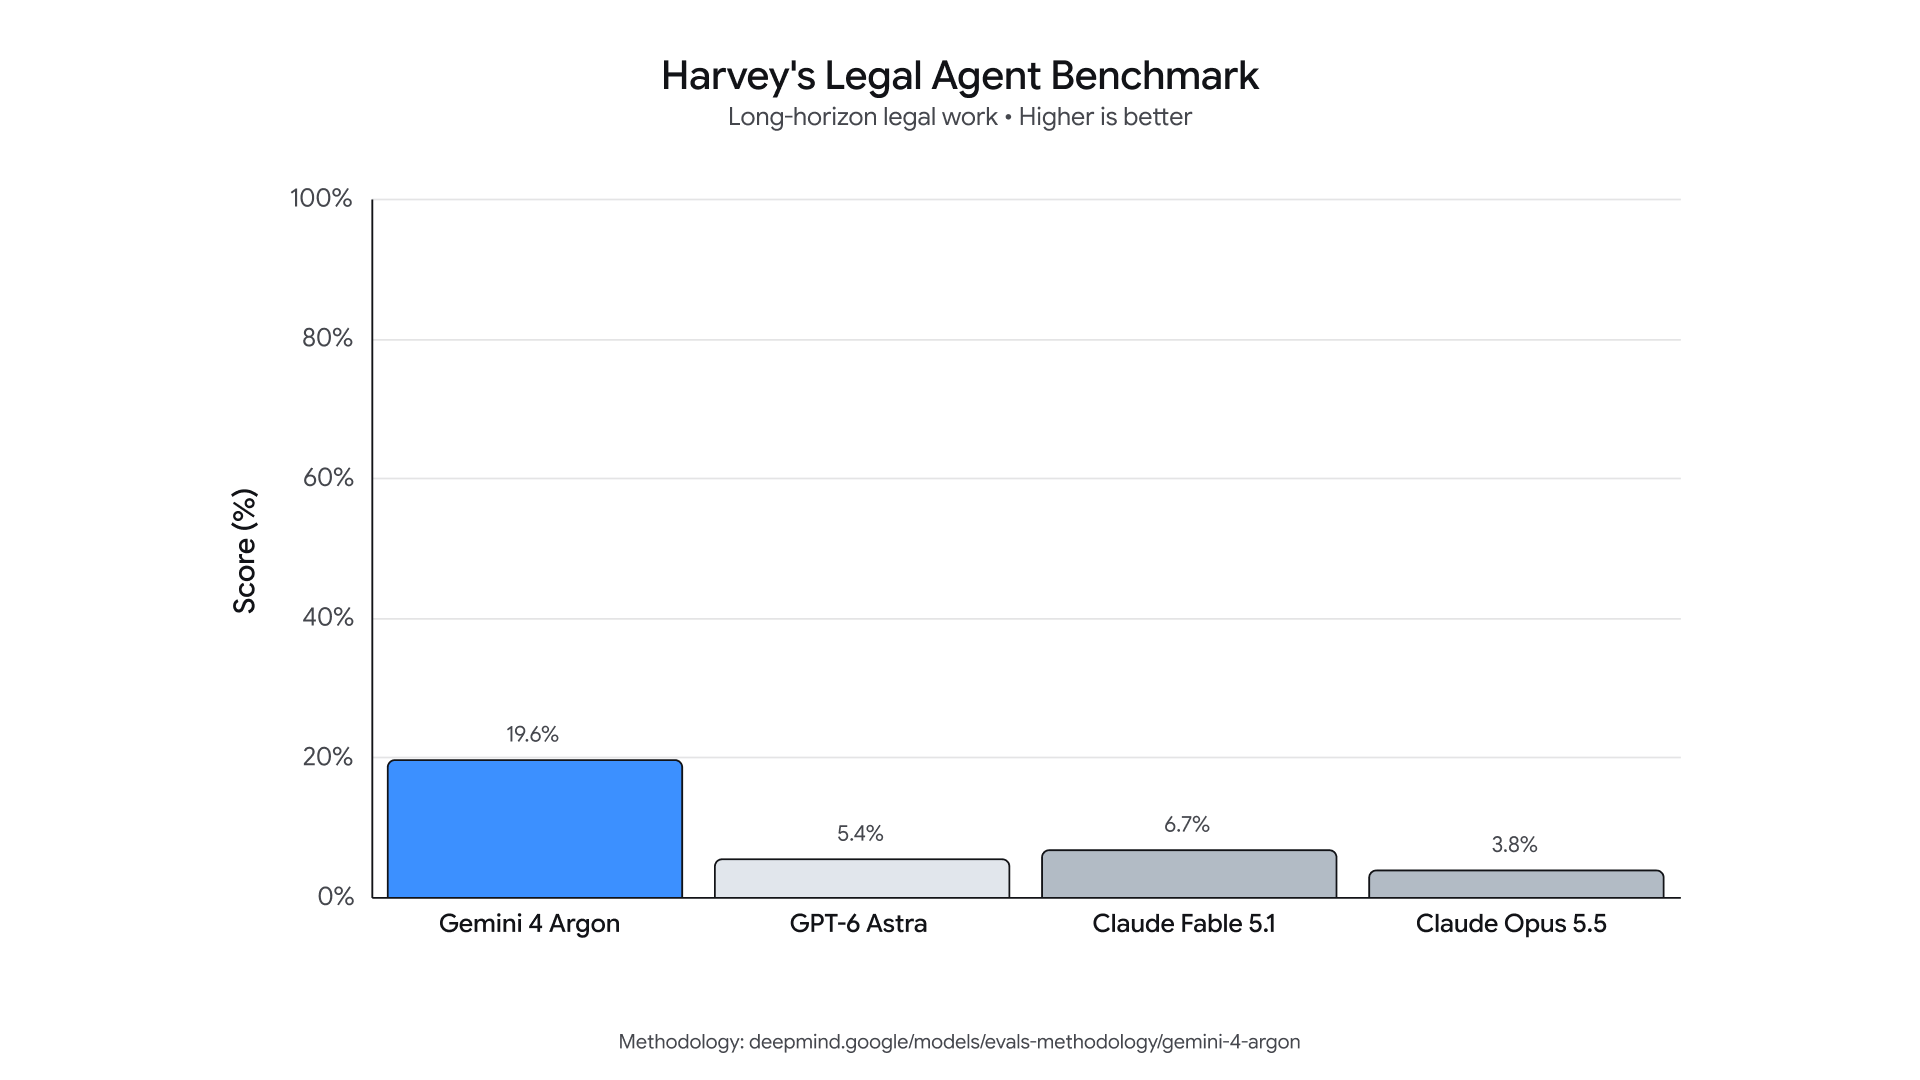
비교한 4개 모델 사이에서 격차가 가장 큰 항목은 법률 에이전트 벤치마크입니다. 다른 세 모델이 3.8~6.7%에 머무는 과제에서 Argon은 19.6%를 기록했습니다. 다만 이 벤치마크를 운영하는 Vals AI 리더보드에는 비교 대상에 없던 Meta의 Muse Spark 계열 4개 모델(1.2가 25.4%로 1위)이 Argon보다 높아, Argon은 73개 모델 중 5위입니다. 이 벤치마크는 과제의 모든 평가 기준을 통과해야 해결로 인정하는데, 개별 기준 통과율로 보면 Argon은 94.0%로 상위 모델들과 비슷합니다. 긴 컨텍스트 항목인 GraphWalks도 256k~1M 토큰 구간에서 2위와 12.4%p 차이가 납니다.
원문 본문이 다루지 않은 항목과 평가 조건
블로그 본문은 1위 항목만 언급하지만, 위 표에는 Argon이 1위가 아닌 항목이 5개 있습니다. 코딩 벤치마크인 FrontierSWE v2(GPT-6 Astra 65.5% 대비 55.0%)와 Terminal-bench 4.0(Opus 5.5 66.4% 대비 57.4%), ML 엔지니어링 과제인 PostTrainBench(Opus 5.5 49.3% 대비 45.3%), Terminal-Bench Science 0.1(GPT-6 Astra 68.1% 대비 57.6%), 컴퓨터 사용 벤치마크인 OSWorld-2.0(GPT-6 Astra 72.6% 대비 69.2%)입니다. 터미널 기반 코딩 에이전트 용도라면 DeepSWE보다 이 항목들을 함께 보는 편이 판단에 도움이 됩니다.
또한 함께 공개된 평가 방법론 문서에는 수치를 읽을 때 알아둘 조건도 적혀 있습니다. 경쟁 모델 수치는 기본적으로 각 제공사가 발표한 값이고, DeepSWE v1.1의 Argon 점수는 Google이 mini-swe-agent 하네스(Harness)로 직접 측정한 반면 GPT-6 Astra는 공개 리더보드, Fable 5.1과 Opus 5.5는 각 시스템 카드에서 가져왔습니다. LVBench는 API 제약 때문에 Gemini는 초당 1프레임, GPT-6 Astra는 800프레임, Fable 5.1은 300프레임, Opus 5.5는 600프레임으로 입력 조건이 모델마다 다릅니다. Terminal-Bench Science는 Argon만 검증기 타임아웃을 6배로 늘려 측정했고, OSWorld-2.0의 Argon 점수는 3회 실행 중 최고값입니다.
외부 리더보드와 대조하면 비교 범위의 차이도 드러납니다. Google의 표에는 Anthropic의 Claude Sonnet 5.5와 Meta의 Muse Spark 계열이 빠져 있는데, Vals AI의 Argon 모델 페이지에 따르면 Vibe Code Bench에서 Argon(91.91%)은 Claude Sonnet 5.5(92.39%)에 이은 2위입니다. Terminal-Bench Science는 Vals가 직접 측정한 값이 44.29%(3위)로, Google이 타임아웃을 늘려 측정한 57.6%와 차이가 큽니다. 반대로 Vals Index에서는 41개 모델 중 1위이면서 테스트당 비용이 $15.68로 Claude Opus 5.5($32.14)의 절반 수준입니다. 그러나 같은 페이지에 따르면 긴 에이전트 과제에서는 비용이 크게 늘어 컴퓨터 사용 벤치마크인 CUA-bench에서는 테스트당 $193.78이 들었고, 점수는 4.83%로 8개 모델 중 7위였습니다. Vals는 이 비용을 도입가가 아닌 정가($4/$20) 기준으로 계산합니다. DeepSWE v1.1의 공개 리더보드(9월 22일 갱신)에는 아직 Argon이 등록되어 있지 않으며, 현재 최고 점수는 GPT-6 Astra, Gemini 3.8 Flash, Claude Opus 5의 74%입니다.
Google 내부에서 먼저 확인한 활용 사례
Google에 따르면 수천 명의 직원이 이미 Argon을 업무에 쓰고 있으며, 전문적인 코딩 작업, 깊이 있는 리서치, 글쓰기 품질을 강점으로 꼽았습니다. Google은 다음 세 가지 사례를 공개했습니다.
-
양자 알고리즘 최적화: 양자 컴퓨팅 연구자들이 주요 응용의 병목이 되는 서브루틴의 시공간 자원(큐비트 수와 게이트 수의 곱)을 줄이는 데 Argon을 사용했습니다. 한 사례에서는 몇 분 만에 공개된 기준치(published baseline)보다 40% 개선된 결과를 냈습니다.
-
데이터센터 메모리 절감: 여러 Argon 에이전트가 전체 서버군의 프로파일링 텔레메트리(telemetry)를 분석해 메모리 최적화 지점을 찾고 직접 적용했습니다. 이 최적화가 배포되면 300TiB 이상의 메모리가 확보되며, 전체 절감량은 500TiB에서 1PiB로 추정합니다.
-
C/C++ 코드베이스의 Rust 전환: re2, libgav1 같은 수만 줄 규모의 핵심 라이브러리부터 80만 줄이 넘는 Fuchsia Zircon 커널까지 Rust로 옮기는 작업을 진행하고 있습니다. 중요한 시스템이 많아 프로덕션 배포 전에 자동화된 감사와 수동 감사, 에뮬레이션 테스트, 리뷰를 거치는 중이라고 합니다.
세 사례 중 libgav1 사례가 가장 구체적입니다. libgav1은 Google의 오픈소스 AV1 영상 디코더인데, Argon 에이전트들은 기존 Rust 포팅 버전에서 SIMD(Single Instruction, Multiple Data) 코드 3만 2천 줄을 대체하는 작업을 맡았습니다. 프로파일 기반 실험을 여러 차례 반복하면서 컴파일러 출력을 분석했고, 컴파일러가 스스로 자동 벡터화(Auto-vectorization) 를 적용할 수 있는 형태의 안전한(safe) Rust 코드를 작성했습니다. 그 결과 출력 영상은 동일하면서 기존 Rust 포팅보다 2.7배 빠른 메모리 안전 디코더가 만들어졌고, 최적화된 C++ 구현에 한층 가까워졌다고 Google은 설명합니다.
사이버 보안 방어 능력과 Fairwind Program
Google은 Argon을 사이버 공격에 대응하는 방어 작업에 특히 강하도록 학습했다고 밝혔습니다. 보안 기업 Wiz는 공공 인프라의 고위험 노출을 무료로 찾아 고치는 Scan for Good 프로그램에서 Argon을 사용하고 있으며, 전 세계 병원에서 쓰는 의료 소프트웨어에서 민감한 개인정보가 노출되는 심각한 취약점을 찾아냈습니다. Google에 따르면 이전 프런티어 모델들은 이 취약점을 놓쳤습니다.
패치 능력은 Collinear가 운영하는 CWE-bench v1으로 측정했습니다. 이름의 CWE(Common Weakness Enumeration)는 소프트웨어 취약점 유형을 분류한 표준 목록입니다. 공개되지 않은 120개의 감사 및 패치 과제로 구성된 벤치마크이며, Argon은 68%로 공동 1위입니다. 이전 모델인 Gemini 3.8 Flash Cyber가 이전 버전(v0)에서 보인 성능을 잇는 결과라고 Google은 설명합니다.
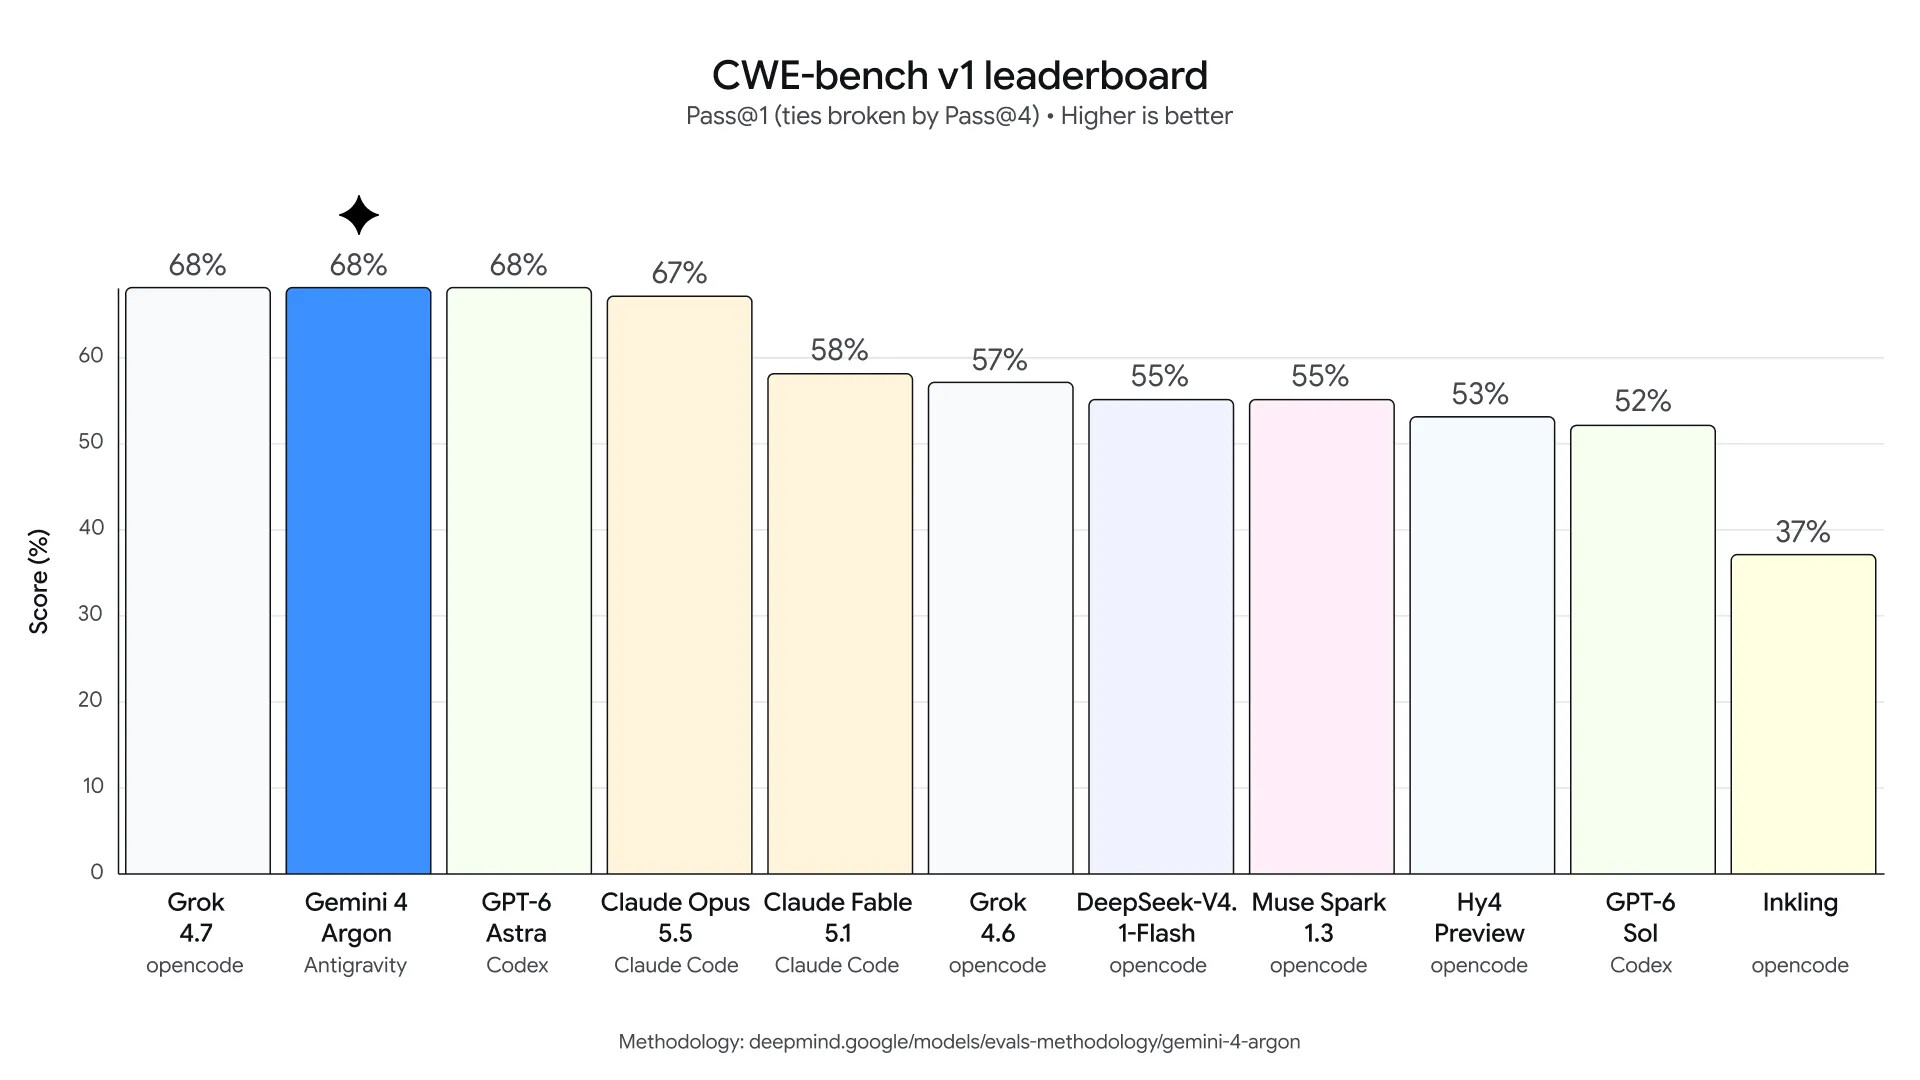
리더보드를 직접 확인하면 공동 1위는 xAI의 Grok 4.7, Gemini 4 Argon, GPT-6 Astra 3개 모델이고 모두 pass@1 68%입니다. 동점을 가르는 pass@4 기준으로는 Grok 4.7이 81%로 가장 높고, Argon이 75%, GPT-6 Astra가 74%로 뒤를 잇습니다. 롤아웃당 평균 비용은 Argon이 $6.63로 리더보드 전체에서 가장 높고, 1%p 차이로 4위인 Claude Opus 5.5는 $0.79입니다. 또한 모델마다 실행 하네스가 달라 Argon은 Antigravity, GPT-6 Astra는 Codex, Claude 계열은 Claude Code, Grok 4.7은 opencode로 측정되었습니다.
취약점 발견 능력은 이전 사이버 특화 모델인 Gemini 3.8 Flash Cyber와 비교했습니다. 20개 프로그래밍 언어의 소스 코드에서 실제 취약점을 찾는 Google 내부 벤치마크에서는 85.8% 대 71.0%, 소스 코드 없이 실제 웹 시스템을 분석해 공격 표면을 찾고 개념 증명(Proof-of-Concept)까지 만드는 Wiz의 블랙박스 침투 테스트 벤치마크에서는 70.9% 대 58.2%입니다. 두 벤치마크 모두 비공개 내부 데이터셋이라 외부에서 재현할 수는 없습니다. 아래 그래프의 세로축은 0이 아니라 20에서 시작합니다.
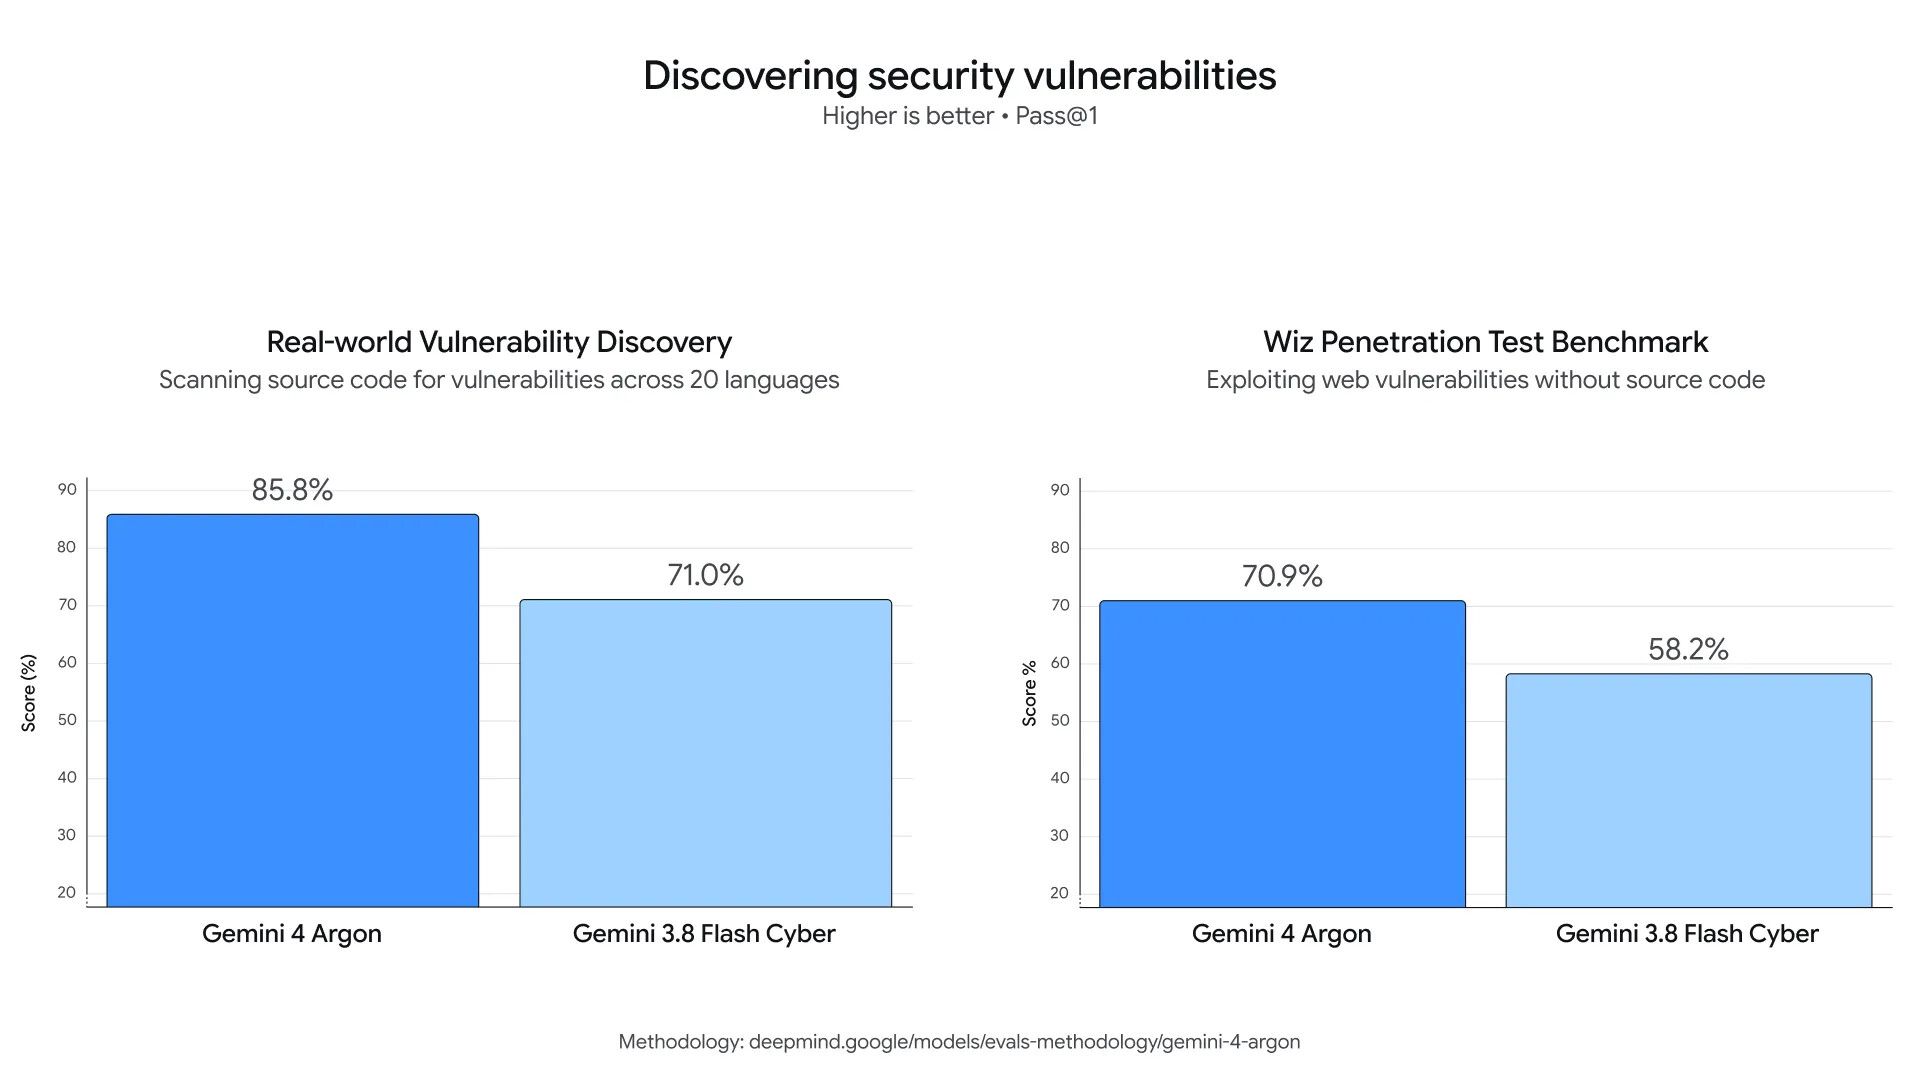
Fairwind Program 페이지에 따르면 현재 전 세계 650곳 이상의 파트너가 참여하고 있으며, 그중 일부가 Argon을 단독으로 쓰거나 Google의 보안 에이전트 CodeMender와 함께 쓸 수 있습니다. 우선 대상은 정부와 국가 사이버 기관, 의료와 통신과 에너지와 금융 같은 핵심 인프라 운영자, 많은 하위 사용자가 의존하는 핵심 기술 플랫폼입니다. 참여 기관은 허가된 위협 시뮬레이션, 리버스 엔지니어링, 방어와 학술 목적의 악성코드 분석 같은 이중 용도(Dual-use) 작업만 할 수 있고, 악성코드 제작은 금지됩니다. 접근 권한은 내부 보안, 침해 대응, 침투 테스트 팀에만 줄 수 있으며, 피싱 방지 MFA와 사용자 단위 인증, 직원별 접근 기록이 필요합니다. Google은 신청 기관의 보안 이력과 윤리적 운영 기록을 사전에 확인하며, 파트너가 접근 권한을 공유하거나 재판매하는 것도 허용하지 않습니다. Gemini Enterprise에서 관리형 모델로 쓰면 데이터 무보존(Zero Data Retention)도 지원합니다.
일반 공개 전에 강화하는 4가지 안전장치
Google은 Argon을 널리 공개하기 전에 다음 4가지 영역의 안전장치를 강화하고 있다고 밝혔습니다.
오남용 방어(Defending against misuse): 사이버 공격과 화학, 생물, 방사능, 핵(CBRN) 공격에 쓰이지 않도록, 유해한 요청은 거부하되 정당한 이중 용도 과학 연구는 허용하도록 설계했습니다. 근거는 Google DeepMind의 Frontier Safety Framework입니다. 이번에는 모델의 내부 활성값(Activation)을 감시해 오남용을 잡는 기법도 개선했는데, 관련 연구는 Google이 공개한 논문 Building Production-Ready Probes For Gemini에 정리되어 있습니다. 이 안전장치는 내부와 외부 레드팀(Red Team)이 수동 공격과 자동 공격을 섞어 견고성을 시험했습니다.
프롬프트 인젝션 방어(Defending against prompt injection attacks): 외부 문서나 웹 페이지에 숨긴 악성 지시로 모델의 행동을 가로채는 간접 프롬프트 인젝션(Indirect Prompt Injection, IPI) 에 대해, 자동화된 레드팀과 적대적 학습(Adversarial Training)으로 방어력을 높였고, Google은 지금까지 자사 모델 중 가장 견고하다고 밝혔습니다. Google이 공개한 Gray Swan의 IPI 벤치마크 결과에서 15회 시도 기준 공격 성공률이 0.7%로 비교 모델 중 가장 낮습니다.
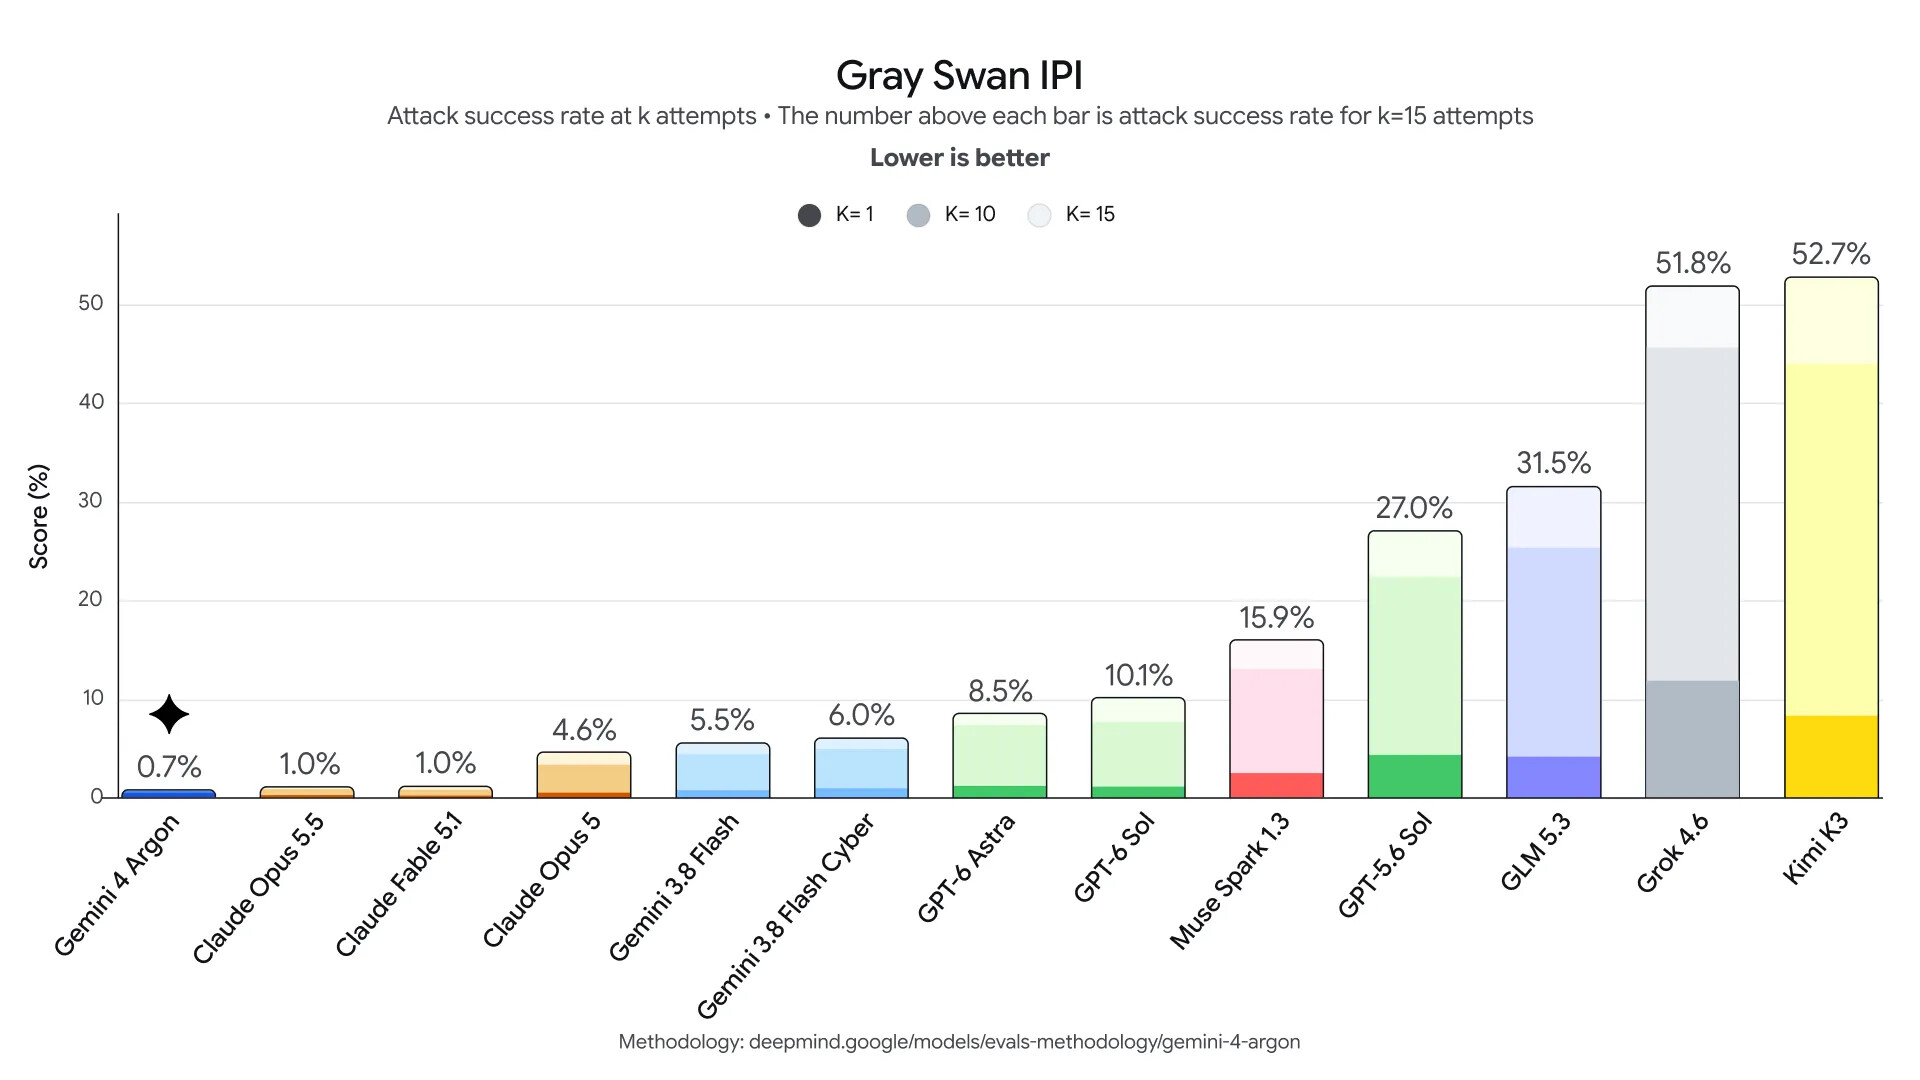
비정렬 모니터링(Monitoring for misalignment): 사용자 의도를 넘어서는 방식으로 과제를 끝내려 하는 행동을 막기 위해, Argon의 사고 사슬(Chain of Thought, CoT)과 행동을 감시하다가 필요하면 실행을 중단하는 장치를 배포합니다. 학습 과정도 비슷한 시스템으로 감시해 전담 대응 팀에 알림을 보냈는데, 그 결과를 다시 학습에 넣지 않도록 주의했다고 합니다. 모니터링 결과가 학습 신호로 들어가면 모델이 감시를 피하는 쪽으로 추론을 바꿀 수 있기 때문입니다. Google은 The case for reasoning transparency 에세이를 함께 링크하며 업계 전체가 추론의 투명성을 지켜야 한다고 요청했습니다. 이 에세이는 GPT-6 Astra 시스템 카드가 보고한 "사고 사슬 모니터링 가능성의 상당한 감소" 를 직접 언급하고 있어, 앞서 PyTorchKR에서 정리한 GPT-6 Astra 출시 글과 함께 읽으면 맥락이 이어집니다.
시스템 강화(Hardening systems): 에이전트 제어 로드맵(AI Control Roadmap)에 따라, 위험도가 높은 학습이나 평가를 시작하기 전에 샌드박스(Sandbox) 환경을 격리하고 봉인합니다. Google은 이런 에이전트 보안 모범 사례를 파트너와 공유하겠다고 밝혔습니다.
가격과 이용 방법
Argon은 도입가(introductory price)로 출시되며, 도입 기간이 끝난 뒤의 정가는 원문 각주에 적혀 있습니다.
| 구분 | 도입가 (100만 토큰당) | 도입 기간 이후 (100만 토큰당) |
|---|---|---|
| 입력 토큰 | $2 | $4 |
| 출력 토큰 | $10 | $20 |
| 캐시된 입력 토큰 | 입력 가격의 95% 할인 ($0.10) | 원문에 별도 표기 없음 |
참고로 한 달 전 공개된 Gemini 3.8 Flash의 도입가는 입력 $0.75, 출력 $3.75입니다. 도입 기간의 길이는 공개되지 않았습니다.
현재 Argon은 Fairwind Program 승인 파트너와 일부 신뢰할 수 있는 테스터(trusted tester), Google 내부에서만 쓸 수 있습니다. 이후 유료 Gemini API 고객과 Google AI Ultra 구독자에게 먼저 열리고, 그다음 개발자, 기업, 소비자로 확대됩니다. Fairwind 대상이 아닌 조직은 공개 모델 기반의 CodeMender와 Google AI Threat Defense 제품을 쓸 수 있으며, 학생은 Google Cloud의 CodeMender를 이용하도록 안내하고 있습니다.
 Gemini 4 Argon 소개 블로그
 Gemini 4 Argon 평가 방법론 문서 (PDF)
 Fairwind Program 홈페이지
더 읽어보기
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
Anthropic, Claude Opus 5.5 출시: Fable 5.1급 성능에 Opus 5보다 40% 낮은 실행 비용
-
Anthropic, Claude Fable 5.1과 Mythos 5.1 출시: 과학 벤치마크 2배와 캐시 읽기 75% 인하
-
Anthropic, 주요 빅테크 및 금융사와 함께 AI 시대의 핵심 소프트웨어 보안을 위한 Project Glasswing 발족
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
