Muse Spark 1.3 소개
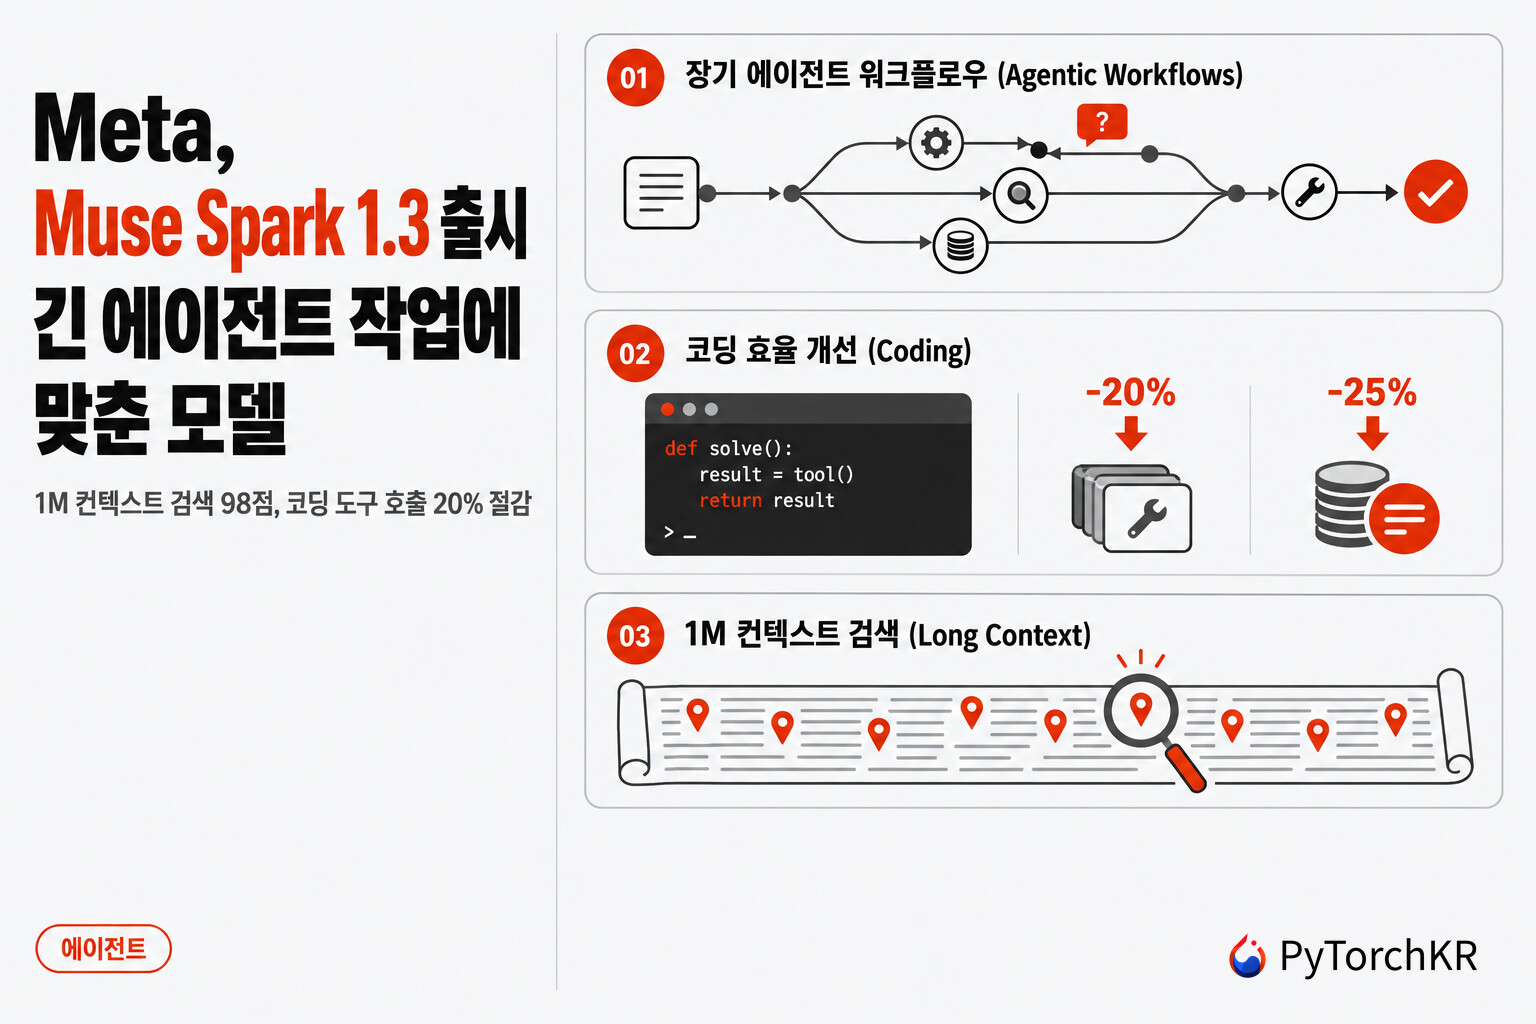
Meta가 2026년 9월 2일 긴 에이전트 작업과 코딩에 초점을 맞춘 모델 Muse Spark 1.3을 출시했습니다. 100만 토큰 컨텍스트 안에서 필요한 대목을 찾아내는 능력이 이전 버전의 55.5점에서 98.1점으로 올라갔고, 같은 코딩 작업을 도구 호출 약 20%와 토큰 약 25%를 덜 쓰면서 처리합니다.
Muse Spark는 Meta Superintelligence Labs가 만드는 모델 계열입니다. 2026년 4월 첫 모델에서 Meta는 장기 호흡의 에이전트 시스템과 코딩 워크플로우를 스스로 부족한 영역으로 지목했고, 이어진 Muse Spark 1.1에서 100만 토큰 컨텍스트와 멀티모달 이해, 컴퓨터 사용 능력을 앞세우며 Meta Model API를 공개 프리뷰로 열었습니다. 그다음 Muse Spark 1.2는 코딩 쪽으로 학습 자원을 몰아주고 터미널 코딩 에이전트 Muse Code를 함께 내놓았습니다 (
 Meta, 터미널 코딩 에이전트 Muse Code와 코딩 특화 모델 Muse Spark 1.2 출시). 1.3은 그 흐름에서 코딩을 유지한 채 에이전트 쪽으로 초점을 넓힌 릴리즈입니다. Meta는 이 계열의 목표를 일관되게 개인용 초지능(Personal Superintelligence) 이라고 부르며, 1.3도 그 방향으로 가는 진전이라고 설명합니다.
이번 발표에서 눈에 띄는 것은 능력의 상한을 자랑하는 대목이 아니라 실사용에서 문제가 되던 것들을 다룬 대목입니다. Meta는 Muse Code와 Meta Model API가 널리 쓰이면서 배운 것을 바탕으로 "실제 환경에서 쓰기 더 쉽게 만들었다" 고 밝혔습니다. 구체적으로는 모호한 지시에 되묻고, 되돌릴 수 없는 행동 전에 확인을 받고, 자기가 못 하는 일을 못 한다고 말하는 행동이 학습 대상에 들어갔습니다. 모델의 점수표보다 이 세 가지가 에이전트를 실제로 도입해 쓰는 입장에서는 더 크게 체감되는 변화입니다.
긴 스레드 하나에서 여러 작업을 동시에 진행하는 협업형 에이전트
Muse Spark 1.3의 설계 목표는 하나의 길게 이어지는 스레드 안에서 여러 워크플로우를 동시에 다루는 것입니다. 열린 목표만 주어져도 도구를 써서 필요한 맥락을 스스로 만들어 냅니다. 이때 참고하는 자료가 서로 어긋나거나 정리되지 않은 상태여도 진행하고, 계획에 빈 곳이 생기면 지시를 기다리지 않고 먼저 메웁니다. 그러면서 알아낸 것을 계속 기록해 두고 마지막에 하나의 산출물로 만들어 냅니다. Meta는 다양한 하네스(Harness) 위에서 모델을 학습시켜 여러 에이전트 환경에 일반화되도록 했다고 설명합니다. 하네스를 어떻게 설계하느냐가 에이전트 성능을 크게 좌우한다는 점은 하네스 엔지니어링 자료 모음에서도 반복해서 확인되는 부분입니다.
되묻고, 도움을 청하고, 확인받는 행동
1.3에서 새로 학습된 행동은 사용자와 주고받는 방식입니다. 지시가 모호하면 명확히 해 달라고 되묻고, 스스로 막히면 사용자를 호출하고, 결과가 큰 행동을 하기 전에는 확인을 받습니다. 긴 작업을 진행할 때 보고 빈도도 사용자 취향에 맞춥니다. 자주 중간 보고를 하거나, 반대로 조용히 백그라운드에서 일하는 두 가지 방식 모두를 따릅니다.
이 항목들이 왜 학습 대상이 되었는지는 에이전트를 몇 시간 단위로 실행해 보면 드러납니다. 모호한 지시를 받은 모델이 되묻지 않고 자기 해석대로 진행하면, 사람은 몇 시간 뒤 완성된 엉뚱한 산출물을 받습니다. 되돌릴 수 없는 행동을 확인 없이 실행하는 쪽은 더 나쁩니다.
어질러진 단일 스레드에서 요청을 올바른 작업에 연결하기
멀티태스킹 쪽도 개선했습니다. 스레드 하나에 여러 작업이 뒤섞인 상태에서 새로 들어온 지시가 어느 작업에 대한 것인지를 이전보다 정확하게 판별합니다. 사용자가 앞선 요청의 방향을 트는 경우와 진행 중인 작업에 끼어드는 경우 모두에 해당합니다. 컨텍스트가 100만 토큰까지 열려 있어도 새로 들어온 지시가 어느 갈래에 대한 것인지 판별하지 못하면 긴 스레드는 유지되지 않습니다.
못 하는 일을 못 한다고 말하는 자기 인식
Meta는 모델이 자기 능력과 한계를 더 잘 파악하도록 학습시켰다고 밝혔습니다. 무엇을 할 수 있고 무엇을 할 수 없는지, 무엇을 알고 무엇을 모르는지, 그리고 언제 막혔는지를 구분하는 능력입니다. 원문의 표현으로는 "막혔을 때 결과를 환각(Hallucination)하는 대신 막혔다고 말한다" 입니다. 지시 수행 쪽 내부 지표인 Agentic IF Index에서 1.3은 57.8점으로 1.2의 46.2점보다 11.6점 높습니다.
Meta는 이 지시 수행 능력을 보여주는 데모도 함께 올려 두었습니다. First Freeze는 메모와 메시지, 카메라 영상, 쇼핑과 결제 맥락을 하나의 안전한 다단계 계획으로 묶는 과정을 보여주는 예시입니다. 다른 데모와 달리 조작이 차단된 애니메이션이라 눌러서 조작할 수는 없습니다. Meta는 여기에 "Muse Spark가 만든 AI 에이전트 프로토타입이며 실제 제품이 아니다" 라는 주석을 달아 두었으니, 제품 발표가 아니라 능력 시연으로 보는 것이 맞습니다.
GDPval 과제로 본 산출물: 항공우주 보고서에서 오디오 믹싱까지
발표에서 가장 구체적인 부분은 실무 과제의 결과물을 그대로 보여준 대목입니다. 여기 쓰인 GDPval은 OpenAI가 만든 평가 데이터셋으로, 미국 9개 주요 산업의 44개 직군에서 뽑은 실무 과제를 모아 문서와 스프레드시트, 슬라이드, 보고서 같은 산출물을 요구합니다 ( GDPval: OpenAI가 공개한, 실무 중심의 AI 성능 평가를 위한 프레임워크). Meta는 Artificial Analysis가 이 데이터셋으로 만든 GDPVal-AA v2의 220개 과제를 사용했습니다.
아래 네 가지가 원문이 공개한 과제와 산출물입니다. 프롬프트가 하나같이 길고 제약이 많은데, 요구 사항을 빠뜨리지 않는 것 자체가 이 평가의 관문입니다.
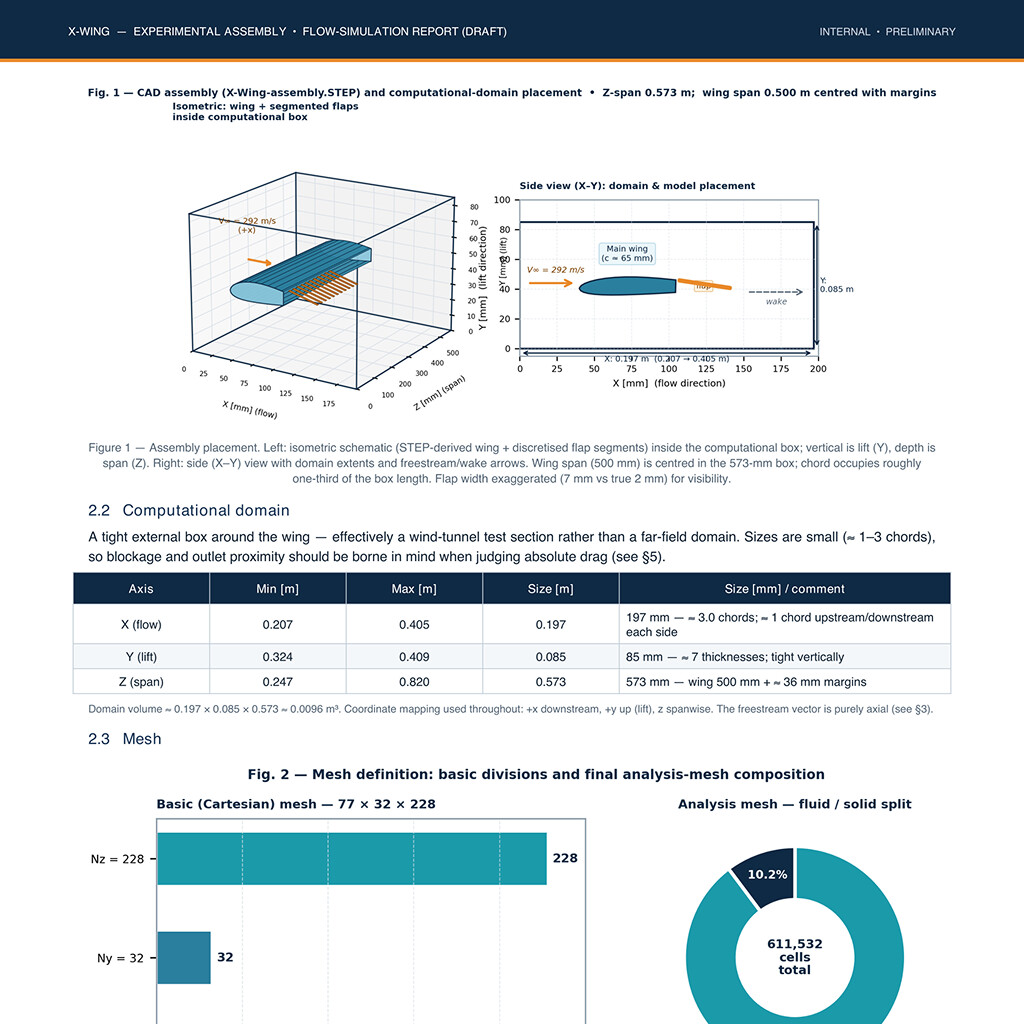
항공우주 유동 시뮬레이션 보고서: 실험용 주익 조립체를 설계하는 기계 엔지니어 역할로, 예비 CFD(Computational Fluid Dynamics, 전산 유체 역학) 시뮬레이션 결과와 CAD(Computer-Aided Design) 모델 STEP 파일을 받아 설계 검토용 보고서 초안을 만드는 과제입니다. 해석 목표와 계산 영역, 격자, 재료 물성, 입구 및 출구 경계 조건을 정리하고, 최대 축방향 속도와 최대 난류 강도, 난류 운동 에너지, 날개에 작용하는 힘을 요약한 뒤, 전역 목표값 표와 주요 물리량의 최소 및 최대값 표를 각각 넣고 PDF로 내보내라는 지시까지 포함돼 있습니다.
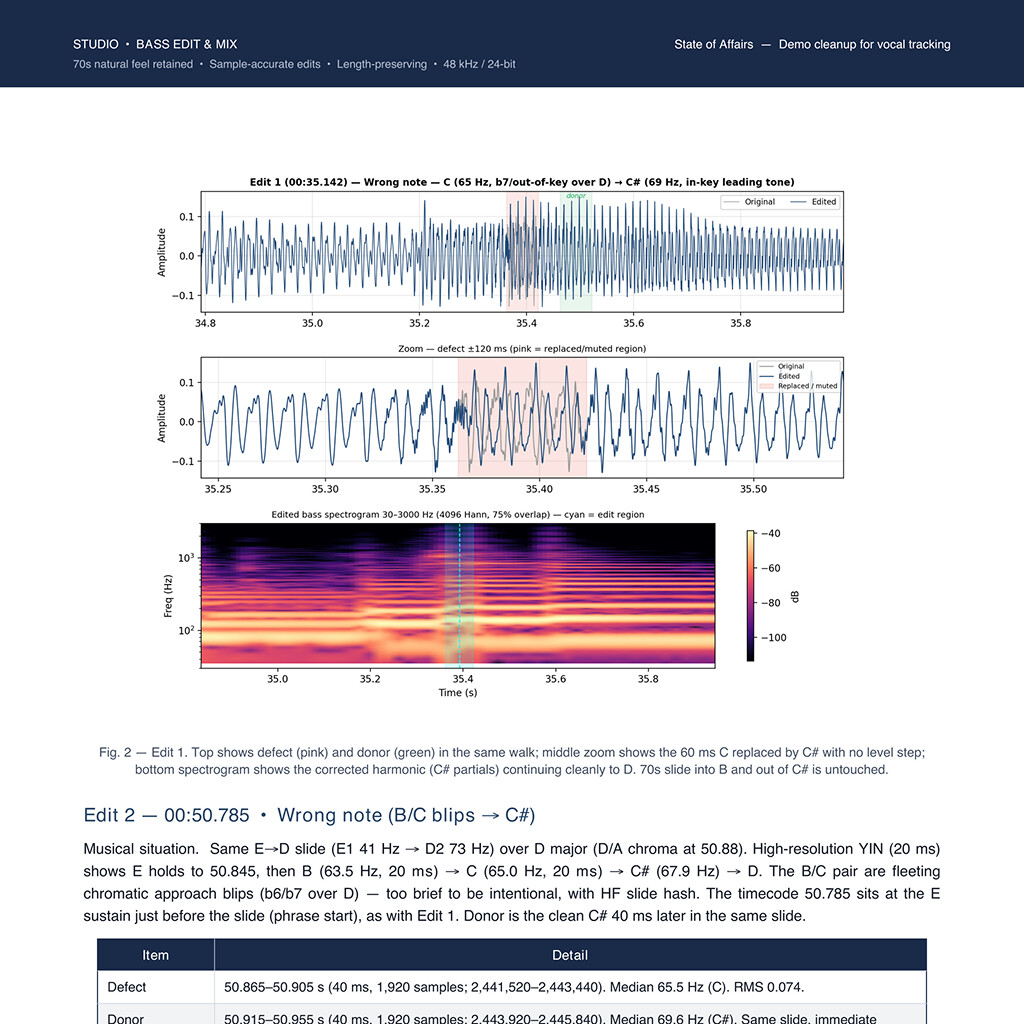
베이스 기타 편집과 믹스: 녹음 스튜디오의 믹스 엔지니어 역할로, 아티스트가 가져온 데모에서 베이스 연주의 실수만 고치는 과제입니다. 조성에서 벗어난 음은 곡 안의 다른 지점에서 맞는 음을 복사해 교체하고, 현 잡음과 클릭은 길이를 바꾸지 않고 무음으로 대체하며, 1970년대풍의 거친 질감은 그대로 남겨야 합니다. 편집한 베이스를 나머지 악기와 다시 섞어 48kHz 24비트 스테레오 WAV로 내보내는 것이 최종 산출물입니다.
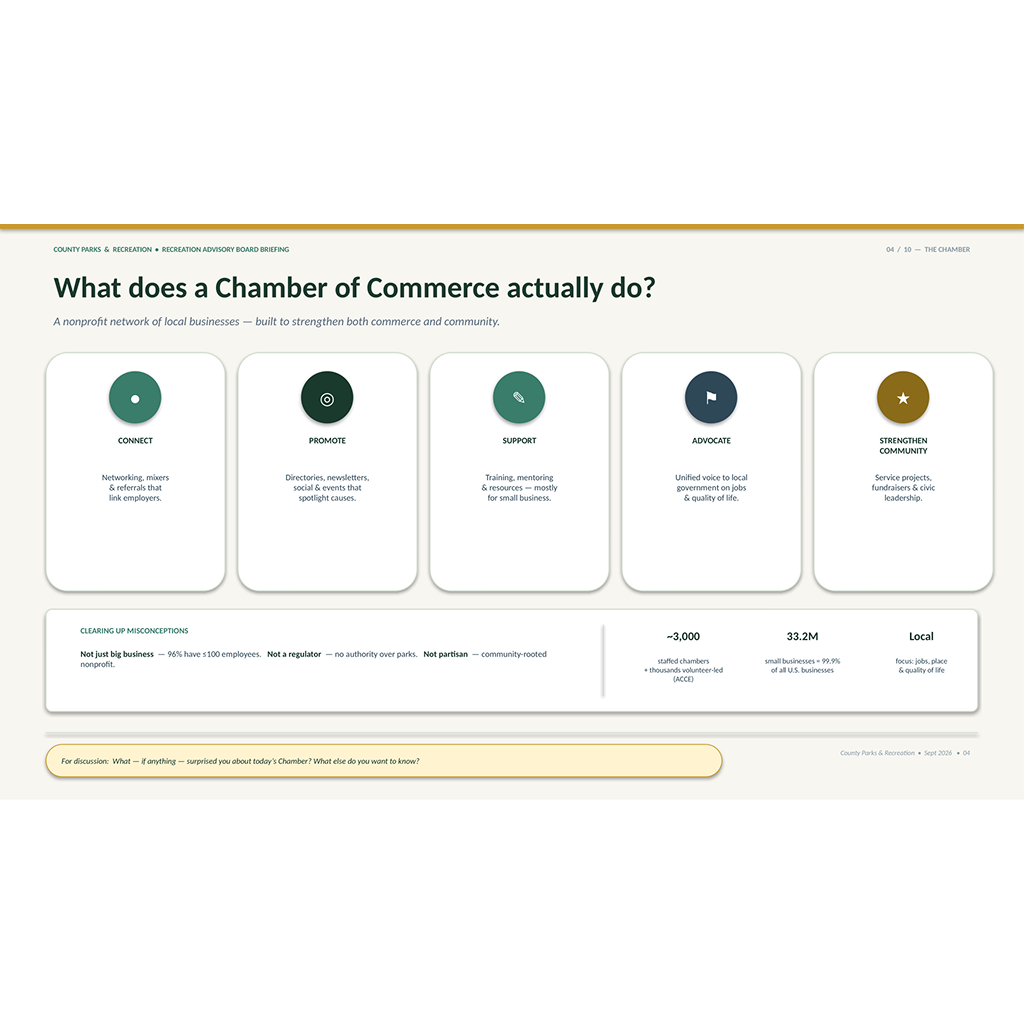
지역 상공회의소 파트너십 발표 자료: 카운티 공원휴양국장 역할로, 민간 협력에 반대해 온 자문위원회를 설득하는 8장에서 10장 분량의 PowerPoint를 만드는 과제입니다. 지역사회 파트너십을 추진해야 하는 이유, 상공회의소가 하는 일, 좋은 파트너가 되는 근거, 기대되는 직간접 효과를 담고, 슬라이드마다 논의를 열어 두라는 조건도 있습니다.
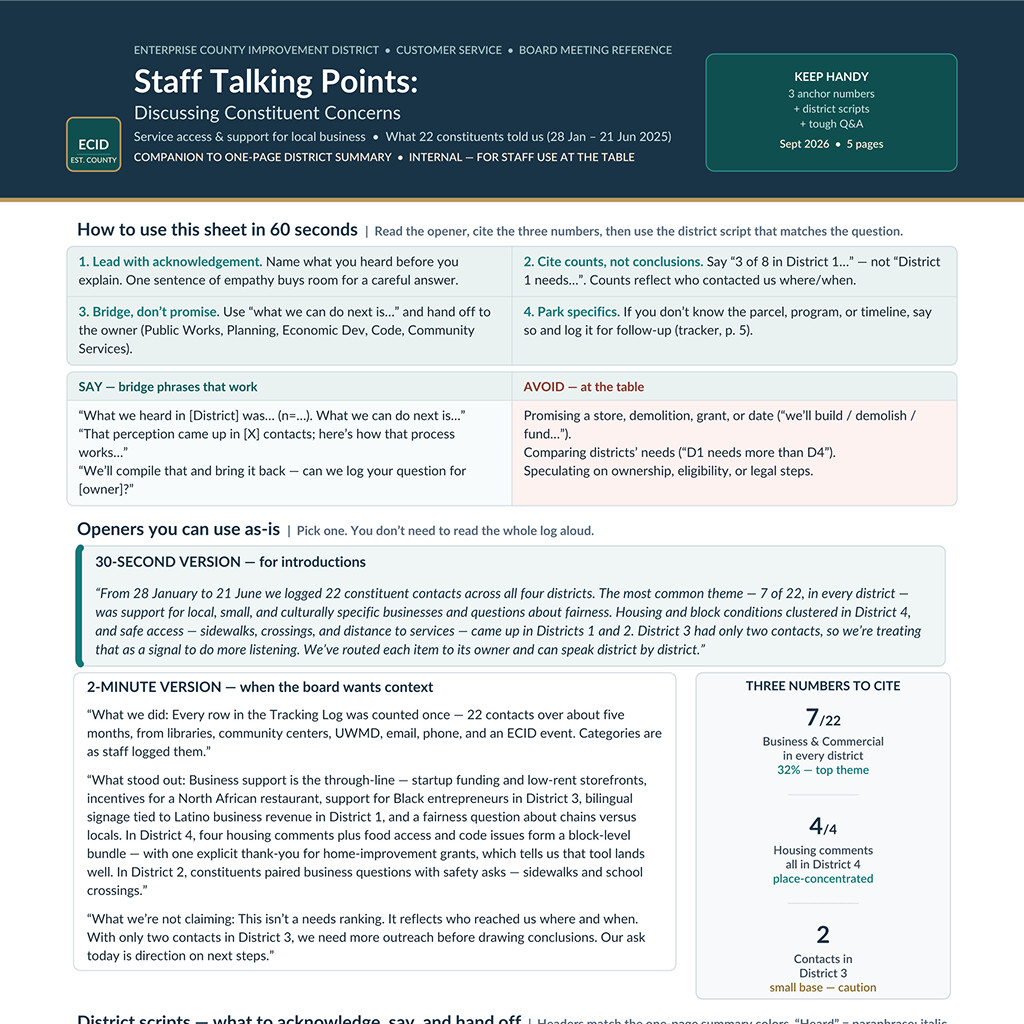
주민 의견 요약과 회의용 토킹 포인트: 개선지구의 고객 서비스 담당자 역할로, 주민 의견 추적 엑셀 파일을 받아 위원별 선거구에 해당하는 내용을 한 장 요약으로 정리하고, 이사회 회의에서 참고할 토킹 포인트를 별도 PDF로 만드는 과제입니다.
GDPVal-AA v2의 채점 방식은 함께 알아 둘 필요가 있습니다. LLM 심사자가 익명화된 산출물을 1대1로 비교하고, 사람 기준선을 1,000으로 고정한 Elo 점수를 주 지표로 씁니다. Muse Spark 1.3은 1,754점으로 사람 기준선보다 높지만 Opus 5의 1,824점에는 뒤집니다. 심사자가 사람이 아니라 LLM이라는 점, 그리고 Elo가 리더보드에 어떤 모델이 함께 올라 있는지에 따라 달라지는 상대 점수라는 점을 함께 감안해야 합니다.
코딩: 같은 일을 더 적은 도구 호출과 토큰으로
코딩 쪽 개선은 점수보다 효율에 무게가 있습니다. Meta는 1.3을 더 많은 장기 코딩 과제로 학습시켰고, 1.2와 비교해 필요하지 않은 곳에서 턴을 덜 쓰고, 덜 장황하며, 전반적인 코드 스타일이 더 깔끔해졌다고 설명합니다. Meta 엔지니어들의 비교에서는 눈에 띄게 빠르고 효율적이었으며 도구 호출을 약 20%, 토큰을 약 25% 덜 사용했습니다.
이 수치가 왜 중요한지는 코딩 에이전트의 비용 구조를 보면 알 수 있습니다. 같은 과제를 같은 정확도로 끝내면서 도구 호출과 토큰을 줄이면 요금과 대기 시간이 함께 내려갑니다. 에이전트를 여러 개 실행하는 방식일수록 이 차이가 누적되므로, 벤치마크 점수 몇 점보다 운영비에 미치는 영향이 큽니다. 다만 이 비교는 Meta 내부에서 자사 엔지니어들이 수행한 것이고, 무엇을 기준으로 어떻게 측정했는지는 공개되지 않았습니다.
Muse Spark 1.3 모델 페이지는 이를 개발자 관점으로 다시 정리해, 첫 시도의 정확도가 높아지고 도구 호출이 안정적이라고 적고 있습니다. 같은 페이지는 멀티모달 인식도 함께 강조합니다. Muse Spark가 영상과 이미지, 문서를 인식하며 시각적 추론이 정해진 절차가 아니라 실제 실행 환경을 거친다는 설명으로, 스크린샷이나 영상 클립을 그대로 입력해 결과물을 만들게 하는 사용 방식을 겨냥합니다.
Meta는 코딩 결과물도 브라우저에서 직접 조작 가능한 형태로 세 가지 올려 두었습니다. Psychic Storm은 자원 수집과 기지 건설, 전투가 들어간 실시간 전략 교전이고, Stimm Tuner는 합성 현음과 대체 튜닝, 스트로브 미터, 기준음 조절을 갖춘 악기 튜너입니다. Startup City 3D는 창업자가 구역을 세우고 카드를 뽑아 스타트업 제국을 겨루는 3D 전략 보드게임입니다. 원문에서는 탭으로 묶여 있어 지나치기 쉬운데, 각각 독립된 페이지로도 열립니다.
벤치마크: 롱컨텍스트와 코딩은 앞서고, 일반 에이전트는 Opus 5에 근접
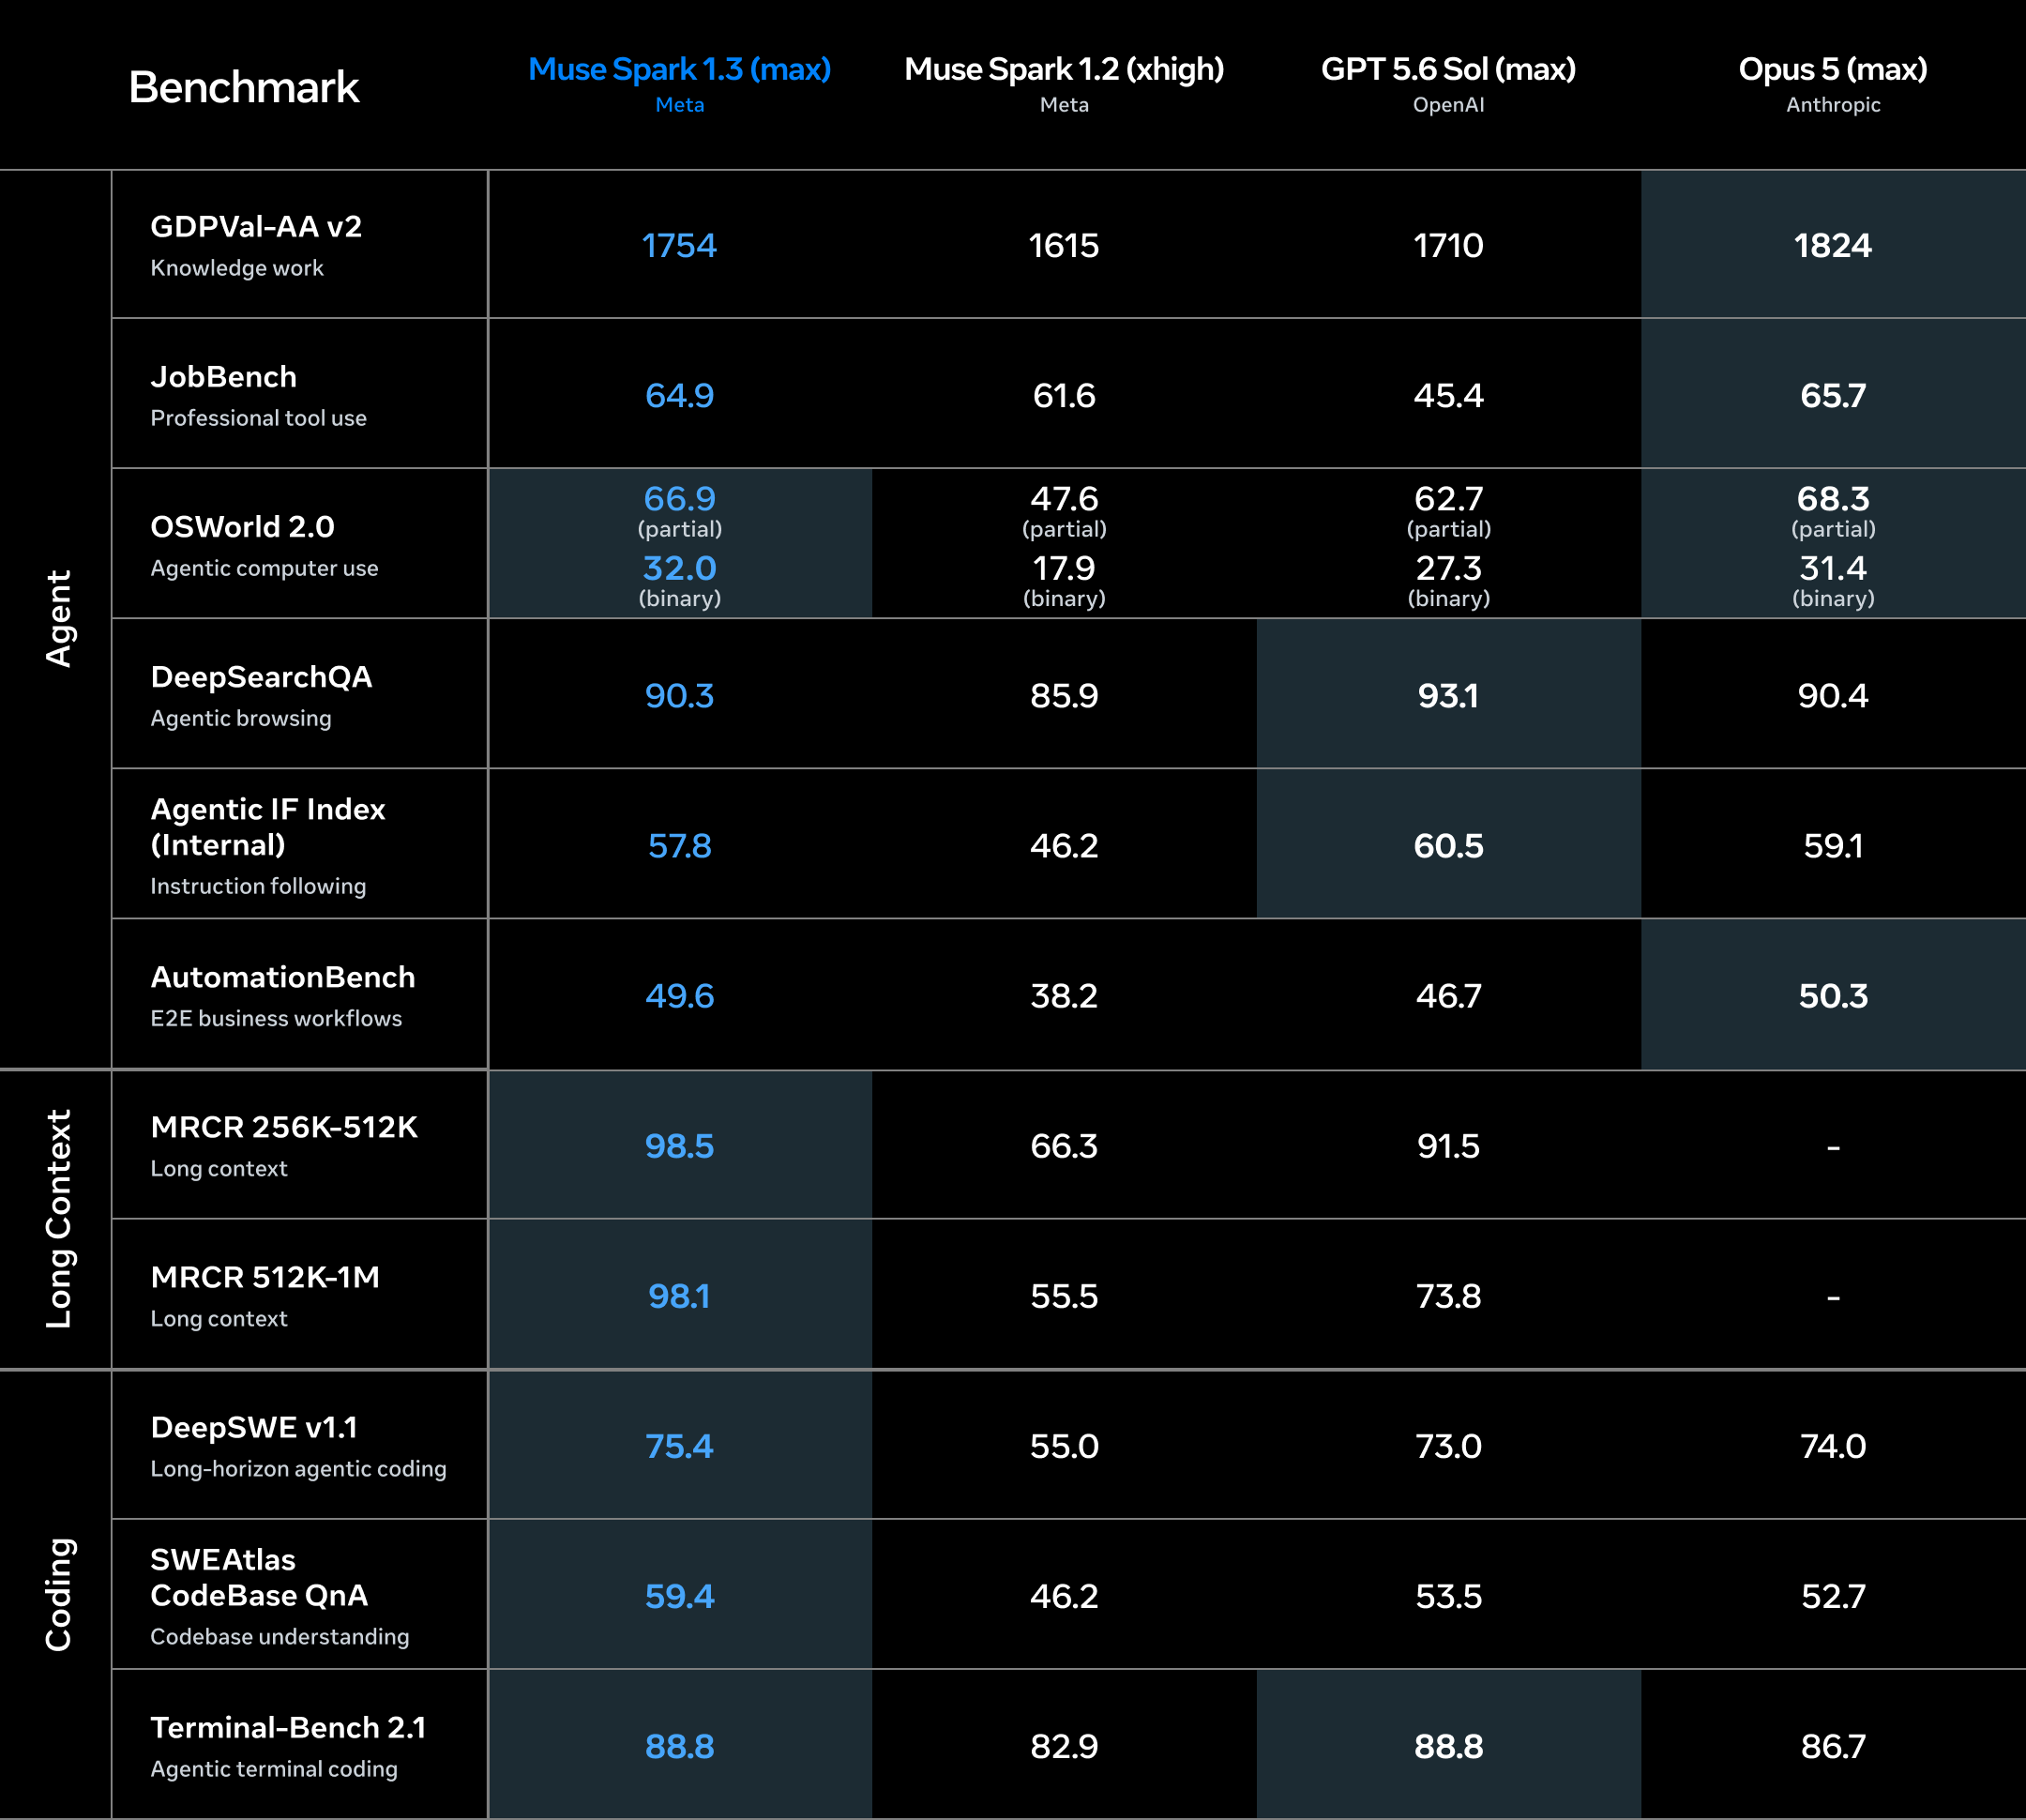
Meta는 11개 항목을 하나의 표로 공개했습니다. 비교 대상은 이전 버전인 Muse Spark 1.2, OpenAI의 GPT 5.6 Sol ( OpenAI, GPT-5.6 Sol, Terra, Luna 프리뷰 공개: 새 네이밍 체계와 강화된 안전 스택), Anthropic의 Claude Opus 5 ( Anthropic, Fable 5급 성능을 절반 가격에 제공하는 Claude Opus 5 공개)입니다. 추론 노력(reasoning effort)은 1.3과 두 경쟁 모델이 max, 1.2는 xhigh입니다.
| 벤치마크 | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT 5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|
| GDPVal-AA v2 실무 지식 노동 (Elo) | 1,754 | 1,615 | 1,710 | 1,824 |
| JobBench 전문 직군 도구 사용 | 64.9 | 61.6 | 45.4 | 65.7 |
| OSWorld 2.0 컴퓨터 사용, 부분 점수 | 66.9 | 47.6 | 62.7 | 68.3 |
| OSWorld 2.0 컴퓨터 사용, 이진 완료 | 32.0 | 17.9 | 27.3 | 31.4 |
| DeepSearchQA 에이전트 웹 탐색 (F1) | 90.3 | 85.9 | 93.1 | 90.4 |
| Agentic IF Index 지시 수행 (Meta 내부) | 57.8 | 46.2 | 60.5 | 59.1 |
| AutomationBench 업무 워크플로우 종단 간 | 49.6 | 38.2 | 46.7 | 50.3 |
| MRCR 256K~512K 롱컨텍스트 | 98.5 | 66.3 | 91.5 | - |
| MRCR 512K~1M 롱컨텍스트 | 98.1 | 55.5 | 73.8 | - |
| DeepSWE v1.1 장기 에이전트 코딩 | 75.4 | 55.0 | 73.0 | 74.0 |
| SWE-Atlas 코드베이스 이해 | 59.4 | 46.2 | 53.5 | 52.7 |
| Terminal-Bench 2.1 터미널 코딩 | 88.8 | 82.9 | 88.8 | 86.7 |
위 표를 통해 세 가지를 알아볼 수 있습니다. 첫째로 롱컨텍스트 검색의 격차가 가장 큽니다. MRCR(Multi-Round Co-reference Resolution)은 100만 토큰까지의 문맥 안에 흩어 놓은 여덟 개의 표적 중 지정된 하나를 찾아 재현하는 순수 검색 과제이며, 도구를 쓰지 않고 응답과 정답 문자열의 시퀀스 일치도 평균으로 채점합니다. 512K에서 1M 구간에서 1.3은 98.1점이고 1.2는 55.5점입니다. 1.1과 1.2가 100만 토큰 컨텍스트를 앞세워 왔지만 실제로 그 뒤쪽 구간에서 지정된 대목을 되살려 내는 정확도는 절반 수준이었던 셈이고, 1.3에서 이 부분이 메워졌습니다. 같은 구간에서 GPT 5.6 Sol은 73.8점이며 Opus 5는 측정값이 없습니다. 컨텍스트 창의 숫자와 그 안에서 실제로 정보를 꺼내 쓰는 능력이 별개라는 점은 장기 실행 과제에 특화된 1M 컨텍스트 모델들에서도 되풀이되는 주제입니다.
둘째로 Meta가 고른 비교 대상 안에서는 코딩 3개 항목 모두 1.3이 최상위입니다. DeepSWE v1.1에서 75.4점으로 Opus 5의 74.0점을 앞서고, 코드베이스 이해를 보는 SWE-Atlas에서 59.4점으로 두 번째인 GPT 5.6 Sol의 53.5점과 5.9점 차이를 냅니다. Terminal-Bench 2.1은 88.8점으로 GPT 5.6 Sol과 같습니다.
셋째로 일반 에이전트 항목에서는 Opus 5가 대체로 앞섭니다. GDPVal-AA v2와 JobBench, OSWorld 2.0 부분 점수, AutomationBench에서 Opus 5가 1위이고 1.3이 그 뒤를 따릅니다. 다만 JobBench는 64.9점 대 65.7점, AutomationBench는 49.6점 대 50.3점으로 차이가 1점 이내입니다. 에이전트 컴퓨터 사용을 보는 OSWorld 2.0은 부분 점수에서 Opus 5가 앞서지만 완전 성공만 인정하는 이진 지표에서는 1.3이 32.0점으로 31.4점의 Opus 5보다 높습니다 ( 장시간의 실제 업무를 통해 컴퓨터 사용 에이전트(CUA)를 평가하는 OSWorld 벤치마크 2.0 공개). 지시 수행을 보는 Agentic IF Index에서는 1.3이 57.8점으로 GPT 5.6 Sol과 Opus 5에 모두 뒤집니다. 자사 내부 지표에서 3위를 그대로 실었다는 점은 표의 신뢰도를 판단할 때 함께 볼 대목입니다.
이 표를 읽을 때 감안할 점
Meta는 평가 방법론 문서를 함께 공개했고, 여기에 표를 읽는 데 필요한 전제가 적혀 있습니다.
- 모델마다 측정 출처가 다릅니다: Meta는 각 모델에 대해 자체 평가와 공식 리더보드, 모델 제공사의 자체 발표 중 "가장 높은 비교 가능한 값" 을 골라 실었다고 밝혔습니다. 예를 들어 DeepSWE v1.1은 1.3만 mini-swe-agent로 직접 실행하고 나머지 모델은 Datacurve 공식 리더보드에서 가져왔으며, Terminal-Bench 2.1과 SWE-Atlas, MRCR의 GPT 5.6 Sol 값은 OpenAI 모델 카드에서 왔습니다.
- 같은 벤치마크의 1.2 점수가 발표 시점과 다릅니다: 1.2 출시 당시 Meta는 DeepSWE v1.1에서 59.3점을 발표했는데 이번 표의 1.2는 55.0점입니다. 1.2 발표 때는 Muse Code 하네스로 측정했고 이번 표는 공식 리더보드 값을 가져왔기 때문입니다. 모델과 하네스의 조합이 점수를 어느 정도 흔드는지는 모델과 하네스를 짝지어 평가한 벤치마크에서 확인할 수 있습니다.
- OSWorld 2.0은 버전이 어긋납니다: 모든 모델이 08.08 버전으로 평가되었고 Muse Spark 1.2만 06.24 버전입니다.
- 서드파티 모델은 최적 설정이 아닐 수 있습니다: Meta는 프롬프트와 도구, 런타임이 타사 모델에 맞춰 조정되지 않았으므로 해당 모델들의 최고 성능을 반영하지 않을 수 있다고 명시했습니다.
- 거부는 0점으로 분모에 남습니다: 모델이 응답을 거부한 경우 점수를 주지 않고 분모에서 빼지도 않습니다. 안전 정책이 엄격한 모델에는 불리하게 작용할 수 있는 처리 방식입니다.
- 비교 대상이 각 사의 최신 모델은 아닙니다: Meta가 고른 GPT 5.6 Sol과 Opus 5보다 뒤에 나온 GPT-6 Astra와 Claude Fable 5.1은 표에 없습니다. 아래에서 보듯 두 모델은 여러 공식 리더보드에서 상위에 있습니다.
- 벤치마크 구성이 1.2 발표와 다릅니다: 1.2가 1위를 기록했던 MCP Atlas는 이번 표에서 빠졌고 JobBench와 AutomationBench, MRCR이 새로 들어왔습니다 ( Auto-BenchMax: 벤치마크와 같은 분포로 데이터를 합성해 MCP-Atlas 점수를 2배로 올린 파이프라인). 버전 간 비교는 이번 표에 함께 실린 값으로만 가능합니다.
공식 리더보드와 대조하면 항목마다 성격이 갈립니다
Meta가 각 항목에 링크해 둔 공식 리더보드를 직접 열어 보면 세 부류로 나뉩니다. 표의 숫자를 그대로 받아들이기 전에 확인할 부분입니다. 아래 리더보드 값은 2026년 9월 18일에 확인한 것이며, 이 값들 자체가 몇 주 사이에도 움직입니다.
타사 값이 공식 리더보드와 일치하는 항목: DeepSWE v1.1이 여기 해당합니다. Datacurve 리더보드의 현재 값은 Opus 5가 74%, GPT 5.6 Sol이 73%, Muse Spark 1.2가 55%로 Meta 표와 같아, 타사 값을 리더보드에서 가져왔다는 방법론 문서의 설명이 확인됩니다. 다만 Muse Spark 1.3은 아직 이 리더보드에 올라 있지 않고, 리더보드 공동 1위는 74%인 GPT-6 Astra와 Gemini 3.8 Flash, Opus 5입니다. 표의 75.4점은 제3자 검증을 거친 값이 아니라 Meta 자체 측정값입니다. OSWorld 2.0도 같은 부류입니다. xlang.ai 공식 리더보드에서 Claude Opus 5(max)는 부분 점수 68.3%, 이진 완료 31.4%로 Meta 표와 같습니다.
시점 차이로 값이 벌어진 항목: GDPVal-AA v2가 여기 해당합니다. Artificial Analysis 리더보드의 Elo는 Muse Spark 1.3(max)이 1,703점, Opus 5(max)가 1,735점, GPT 5.6 Sol(max)이 1,587점, Muse Spark 1.2가 1,523점입니다. Meta 표의 네 값보다 일제히 낮지만 순위는 같습니다. Elo는 리더보드에 모델이 추가될 때마다 전체가 재계산되므로 발표 시점의 값이 그대로 남지 않습니다. 1.2의 점수가 1.2 발표 당시 1,631점, 이번 표에서 1,615점, 현재 리더보드에서 1,523점으로 세 번 다른 것이 그 예입니다. 이 리더보드의 1위는 Meta 표에 없는 Claude Fable 5.1로 1,745점입니다. 값이 얼마나 자주 움직이는지는 열흘 사이의 변화로도 드러납니다. 9월 8일에는 GPT 5.6 Sol(max)이 1,624점, Fable 5.1이 1,764점이었습니다.
제3자 리더보드와 자릿수가 어긋나는 항목: Terminal-Bench 2.1의 격차가 가장 큽니다. Meta 표에서 Opus 5는 86.7점, GPT 5.6 Sol은 88.8점인데, tbench.ai 공식 리더보드에서 Claude Code를 붙인 Opus 5(xhigh)는 53.9%, Codex를 붙인 GPT 5.6 Sol(max)은 37.3%입니다. 두 값의 출처도 서로 다릅니다. 방법론 문서에 따르면 GPT 5.6 Sol 값은 OpenAI 모델 카드에서 가져온 것이고, Opus 5 값은 각 모델의 네이티브 하네스를 Meta 내부 평가 프레임워크에서 돌려 얻은 것입니다. 어느 쪽도 tbench.ai가 검증한 값이 아닙니다. 공식 리더보드 1위는 Codex를 붙인 GPT-6 Astra의 58.2%입니다. 표 셀의 리더보드 링크를 눌렀을 때 전혀 다른 숫자가 보이는 이유입니다.
SWE-Atlas는 조건 자체가 모델마다 달랐습니다. Scale AI 리더보드는 2026년 7월 28일 공지로 Muse Spark와 GLM 5.2 같은 신규 모델에 대해 mini-swe-agent의 스텝 상한을 250에서 500으로 올렸다고 밝혔습니다. 반면 표에 실린 GPT 5.6 Sol과 Opus 5의 값은 방법론 문서에 따르면 각 사의 모델 카드에서 가져온 것입니다.
안전성: 프롬프트 인젝션 내성과 되돌릴 수 없는 행동의 판별
안전성 개선은 에이전트와 코딩 능력에 맞닿은 축을 중심으로 이뤄졌습니다. Meta는 1.3이 적대적 입력과 프롬프트 인젝션(Prompt Injection)에 대한 저항이 개선되어 적대적 견고성(Adversarial Robustness)이 더 강해졌다고 밝혔습니다. 도구를 쥔 에이전트에게 프롬프트 인젝션이 왜 직접적인 위협인지는 프롬프트 인젝션 방어를 자동 레드팀으로 끌어올리는 접근이나 에이전트 브라우저에서 발견된 취약점 사례에서 확인할 수 있습니다.
복잡한 에이전트 과제에서는 무엇이 되돌릴 수 없는 행동인지에 대한 판별이 더 잘 맞춰졌고, 그에 따라 진행 방식을 달리한다고 설명합니다. 앞의 협업 행동에서 확인을 받는 시점을 정하는 판단과 같은 축입니다.
출시 발표문의 안전성 서술은 정성적인 문장에 머물러 있었는데, 엿새 뒤에 사정이 달라졌습니다. Meta는 2026년 9월 8일 개인 에이전트 제품 Muse를 내놓으면서 그 안전 설계를 문서로 공개했고, 이 제품을 구동하는 모델이 Muse Spark 1.3입니다. 여기서 Meta는 1.3이 프롬프트 인젝션 저항 능력에서 "최고 수준에 근접한다" 고 밝혔습니다.
Meta가 설명하는 방어는 대부분 모델 바깥에 있습니다. 사용자마다 전용 리눅스 가상 머신을 두고 에이전트 하네스를 격리된 런타임 셀에 가둔 뒤, 커넥터 동작과 모든 네트워크 송신을 Sentinel이라는 별도 권한 기관이 승인합니다. 에이전트는 실제 자격증명을 보지 못한 채 대체 토큰만 받고, 실제 값은 네트워크 경계에서 치환됩니다. 프롬프트 인젝션에 대해서는 모델 학습, 하네스의 비신뢰 데이터 표시, 독립 분류기 앙상블, 사람 승인의 네 겹을 둡니다. Meta는 같은 날 버그 바운티를 일반에 열면서 한 사용자에게 영향을 주는 프롬프트 인젝션 성공 사례에 최대 13만 달러, 전체로는 최대 30만 달러를 걸었습니다.
다만 이 문서는 제품의 시스템 보안 설계를 다룹니다. 1.1 발표에 딸려 있던 Advanced AI Scaling Framework 기반의 모델 평가 보고서에 해당하는 자료는 1.3에 대해 아직 나오지 않았습니다. 화학 및 생물학, 사이버보안, 통제 상실 같은 프론티어 위험 범주별 수치를 확인해야 하는 경우라면 그 자리는 여전히 비어 있습니다.
가격과 사용 방법
Meta는 1.3을 max 추론 설정과 함께 Muse Code와 Meta Model API 양쪽에 바로 열었습니다. 가격은 1.2와 동일하게 두 줄로 나뉘어 있습니다. 아래 단가는 100만 토큰당 미국 달러입니다.
| 모델 | 컨텍스트 창 | 입력 | 캐시된 입력 | 출력 |
|---|---|---|---|---|
muse-spark-1.3-contributor |
1M | 0.10 | 0.002 | 0.20 |
muse-spark-1.3 |
1M | 1.25 | 0.15 | 4.25 |
두 줄의 차이는 성능이 아니라 데이터 취급입니다. contributor 는 Meta가 제품 개선에 데이터를 사용하는 조건이고, 일반 muse-spark-1.3 은 사용하지 않는 조건입니다. 그 대가로 단가가 입력 12.5배, 출력 21.25배, 캐시된 입력은 75배까지 벌어집니다. 사내 코드가 학습에 쓰이면 곤란한 조직이라면 선택지는 아래쪽 한 줄이고, 이미 공개된 저장소를 다루는 실험이라면 위쪽이 상당히 저렴합니다.
API는 Meta Model API를 통해 제공되며 기준 주소는 https://api.meta.ai/v1, 컨텍스트 창은 1,048,576 토큰입니다. OpenAI SDK와 Anthropic SDK, 그리고 OpenAI 호환 에이전트 CLI와 그대로 호환된다고 문서에 적혀 있어, 쓰던 클라이언트의 기준 주소와 키만 바꾸면 됩니다. 병렬 도구 호출과 도구 호출 인자 스트리밍, 턴을 넘어 이어지는 추론(reasoning)이 기본으로 제공됩니다. OpenRouter에도 올라와 있어 기존 도구에 갈아 끼우는 방식으로도 쓸 수 있습니다.
터미널에서 쓰려면 Muse Code를 설치합니다. macOS와 Linux에서 아래 한 줄로 끝나고, 첫 실행부터 승인 절차와 운영체제 샌드박스가 켜진 상태로 동작합니다.
curl -fsSL https://dev.meta.ai/install.sh | bash
Muse Code 구독은 월 5달러와 15달러, 50달러 세 단계로 나뉘어 있고 5시간 단위 요청 수와 파일 업로드 한도에서 차이가 납니다. Meta Model API 문서에는 멀티 에이전트 오케스트레이션과 서브에이전트 팬아웃, 컴퓨터 사용, 검색 그라운딩 같은 쿡북 예제가 함께 정리돼 있습니다.
다음 단계로 예고된 것: 더 큰 모델과 Muse Spark 오픈 웨이트
Meta는 발표 마지막에 더 큰 모델과 Muse Spark 오픈 웨이트(Open Weights) 공개를 예고했습니다. 현재 공개 가중치로 나와 있는 것은 Muse Spark를 증류(Distillation)해 만든 300억 파라미터 규모의 Muse Glimmer이며, 소비자용 GPU 한 장에서 돌아갑니다. Apache 2.0 라이선스로 배포되어 vLLM과 SGLang, llama.cpp, ExecuTorch 같은 런타임(Runtime)에서 직접 서빙할 수 있습니다 ( ExecuTorch에서 Muse Glimmer로 구현하는 빠른 온디바이스 에이전틱 AI | 파이토치 한국 사용자 모임). 증류 모델이 아니라 Muse Spark 본체의 가중치가 공개된다면 Llama 4 이후 Meta의 공개 모델 전략에서 의미가 큰 변화가 됩니다. 시점과 범위, 라이선스는 아직 밝혀지지 않았습니다.
1.3은 최고 점수를 새로 세운 릴리즈가 아니라 긴 작업에서 문제가 되던 것들을 하나씩 해결한 릴리즈입니다. 100만 토큰 컨텍스트가 뒤쪽 구간에서도 실제로 동작하게 됐고, 코딩은 같은 결과를 더 적은 호출과 토큰으로 처리하며, 모호한 지시에 되묻고 위험한 행동 전에 확인받는 행동이 학습에 들어갔습니다. 일반 에이전트 항목에서 Opus 5에 몇 점씩 뒤지는 상태는 그대로입니다. 표의 타사 수치는 항목마다 출처가 달라, 공식 리더보드와 나란히 놓으면 우위의 크기가 바뀌거나 표에 없는 모델이 위에 올라옵니다. 안전성은 제품 쪽 설계 문서가 뒤늦게 나온 반면 모델 자체의 위험 범주별 평가는 공개되지 않았고, 오픈 웨이트 계획도 아직 문서로 확인할 수 없습니다.
 Muse Spark 1.3 소개 블로그
 Muse Spark 1.3 평가 방법론 문서
https://research.meta.ai/static/muse-spark-1-3-multimodal-evaluation-methodology
Muse 안전 설계 소개 블로그
 Muse Spark 1.3 모델 페이지
Meta Model API 개발자 문서
더 읽어보기
-
ExecuTorch에서 Muse Glimmer로 구현하는 빠른 온디바이스 에이전틱 AI | 파이토치 한국 사용자 모임
-
OpenAI, GPT-5.6 Sol, Terra, Luna 프리뷰 공개: 새 네이밍 체계와 강화된 안전 스택
-
Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
