핵심 요약
- Google Research는 Toward provably private learning from federated data 블로그 글과 같은 제목의 논문에서 새 연합 학습 시스템을 발표했습니다. 기기가 암호화한 학습 데이터는 서버의 TEE(신뢰 실행 환경) 안에서만 풀려 학습에 쓰입니다.
- 데이터를 처리할 수 있는 Python 프로그램과 바이너리는 업로드 전에 공개 투명성 로그(Rekor)에 등록되고, KMS는 그 목록과 일치하는 TEE에만 복호화 키를 줍니다. 그래서 서버가 차등 프라이버시 노이즈를 제대로 넣는지를 외부에서 코드로 확인할 수 있습니다.
- Gboard 영어 다음 단어 예측 A/B 테스트(각 군 3.5M 기기)에서 가장 좋은 TEE 실험군은 기존 운영 모델보다 프라이버시 예산이 약 3배 작았습니다(zCDP 0.641 → 0.215). 학습 기간은 2개월에서 3주로 줄었고, 타이핑 속도 등 핵심 사용성 지표는 같았습니다.
- 지금까지 학습한 모델은 10M 파라미터 이하이고, TEE의 부채널(Side-Channel) 문제, 런타임에 주입하는 비공개 로직, 최선 노력(best-effort) 수준의 데이터 만료(TTL) 같은 신뢰 경계가 남아 있습니다.
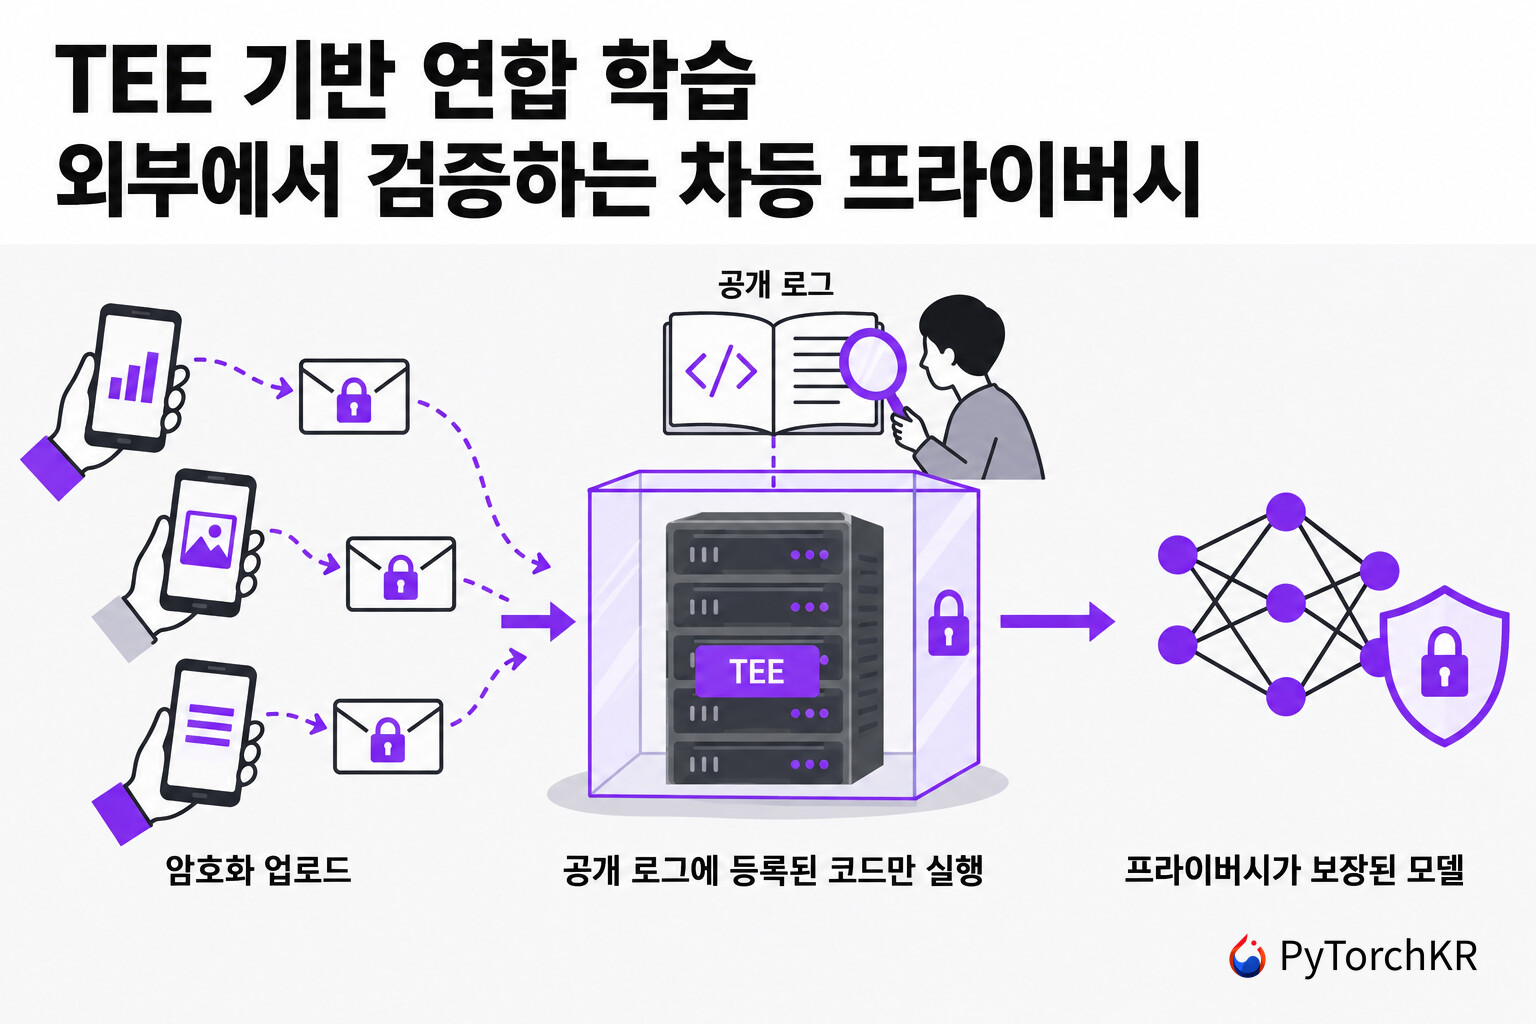
Google의 TEE 기반 연합 학습 소개
Google Research는 2026년 10월 2일 블로그 글로, 신뢰 실행 환경(Trusted Execution Environment, TEE) 위에서 동작하는 차세대 연합 학습(Federated Learning, FL) 시스템을 발표했습니다. 세부 설계와 실험은 arXiv 논문(2609.31494, 9월 30일 v4)에 있습니다. 이 시스템의 핵심은 기기 데이터가 서버로 올라간 뒤에도, 그 데이터를 어떤 코드가 어떻게 처리하는지를 Google 바깥의 제3자가 검증할 수 있게 한 것입니다. 저자들은 이를 "외부에서 검증 가능한 중앙 차등 프라이버시(central DP) 보장을 처음으로 제공한다"고 설명합니다. 이 시스템은 이미 Gboard(Android 키보드)의 영어와 일본어 다음 단어 예측 모델 학습에 쓰이고 있습니다.
연합 학습은 Google이 2017년 블로그 글로 소개한 방법입니다. 데이터를 서버로 모으지 않고, 여러 기기가 각자 가진 데이터로 계산한 결과만 모아 하나의 모델을 학습합니다. Gboard의 다음 단어 예측, Google Messages의 답장 추천, Android의 Smart Text Selection이 이 방법으로 학습되었습니다. 여기에 차등 프라이버시(Differential Privacy, DP) 를 더하면, 학습된 모델에서 특정 사용자의 데이터가 포함되었는지를 알아내기 어렵다는 수학적 보장을 얻습니다. DP는 계산 결과에 정해진 크기의 노이즈를 더해 이 보장을 만듭니다.
문제는 그 노이즈를 누가 더하느냐였습니다. 기존 시스템에서 서버에서 실행되는 로직은 기기도 외부 감사자도 확인할 수 없었습니다. 그래서 블로그의 설명대로, 그래디언트 합에 무작위 노이즈를 올바르게 더한다는 점은 Google을 믿을 수밖에 없었습니다. 이번 시스템은 TEE의 원격 증명(Remote Attestation), 즉 지금 어떤 바이너리가 실행 중인지를 하드웨어가 서명해 증명하는 기능을 이용해 이 신뢰 가정을 줄입니다. Google은 이를 서버 운영자를 믿을 필요를 없애려는 노력의 다음 단계로 소개합니다.
이 글은 연합 학습이나 개인정보 보호 머신러닝을 다루는 연구자와 엔지니어를 위한 정리입니다. 블로그에 없는 논문의 세부 설계(Program API, 접근 정책, 장애 복구)와 실험 수치, 그리고 남은 신뢰 경계를 함께 다룹니다.
기존 연합 학습이 가진 두 가지 한계
Google은 2021년 ACM Queue 글에서 연합 학습 시스템이 지켜야 할 네 가지 프라이버시 원칙을 제시했습니다. 데이터 최소화(Data Minimization), 데이터 익명화(Data Anonymization), 투명성과 통제(Transparency and Control), 검증 가능성과 감사 가능성(Verifiability and Auditability)입니다. 기존 시스템은 앞의 두 원칙에서는 행렬 분해 기반 DP-FTRL(Matrix Factorization DP-Follow-the-Regularized-Leader, MF-DP-FTRL) 같은 DP 학습 알고리즘과 보안 집계(Secure Aggregation)로 성과를 냈지만, 마지막 원칙에서 한계가 있었습니다.
첫째, 서버 쪽 처리를 검증할 수 없었습니다. 초기 연합 학습에서 기기는 바로 집계된다는 전제로 데이터를 올렸습니다. 그러나 서버가 그 데이터를 기록하거나 들여다보지 않았다는 것을 외부에서 확인할 방법이 없었습니다. 보안 집계는 업로드를 암호학적으로 보호했지만, 블로그에 따르면 최신 중앙 DP 보장과 함께 쓸 수 없었습니다. 기존 시스템은 보안 집계를 분산 차등 프라이버시(Distributed DP)와 함께 썼습니다. 기기 소유자는 학습 참여를 거부할 수 있었고, 큰 노력을 들이면 기기 쪽 바이너리도 분석할 수 있었습니다. 그러나 서버 로직은 확인할 수 없었습니다.
둘째, 학습이 기기에 묶여 있었습니다. 기존 시스템은 그래디언트를 기기에서 계산했으므로 학습할 수 있는 모델 크기가 기기 성능에 제한되었습니다. 또 기기는 Wi-Fi에 연결되고 충전 중이며 배터리가 충분할 때만 참여할 수 있습니다. 그래서 하루 중 시간대에 따라 참여 가능한 기기 수가 크게 바뀌었습니다. 블로그에 따르면 이런 모델 하나를 학습하는 데 1~2개월이 걸렸습니다. DP 측면에서도 불리했습니다. 기존 시스템은 한 기기가 일정 기간(예: 144시간)에 한 번만 참여하도록 제한했는데, 이 간격은 기기 가용성의 하루 주기 변화와 원하는 코호트 크기에 맞춰 신중하게 조정해야 했습니다.
시스템 구조: 암호화 업로드에서 익명화된 모델 공개까지
새 시스템은 Google이 앞서 Confidential Federated Computations(arXiv 2404.10764)에서 설명한 범용 아키텍처의 중앙 구성 요소(KMS 등)를 재사용하고, 새 데이터 처리 구성 요소를 더했습니다. 같은 아키텍처는 신조어 발견을 위한 기밀 연합 분석과 생성형 AI 사용 분석(Provably Private Insights)에도 쓰였습니다. 이번 논문은 이 아키텍처 위에서 임의의 Python 프로그램, 특히 ML 학습 루프를 실행하는 배포를 다룹니다. TEE 하드웨어로는 AMD SEV-SNP(Secure Encrypted Virtualization-Secure Nested Paging)와 Intel TDX(Trust Domain Extensions)를 사용합니다.
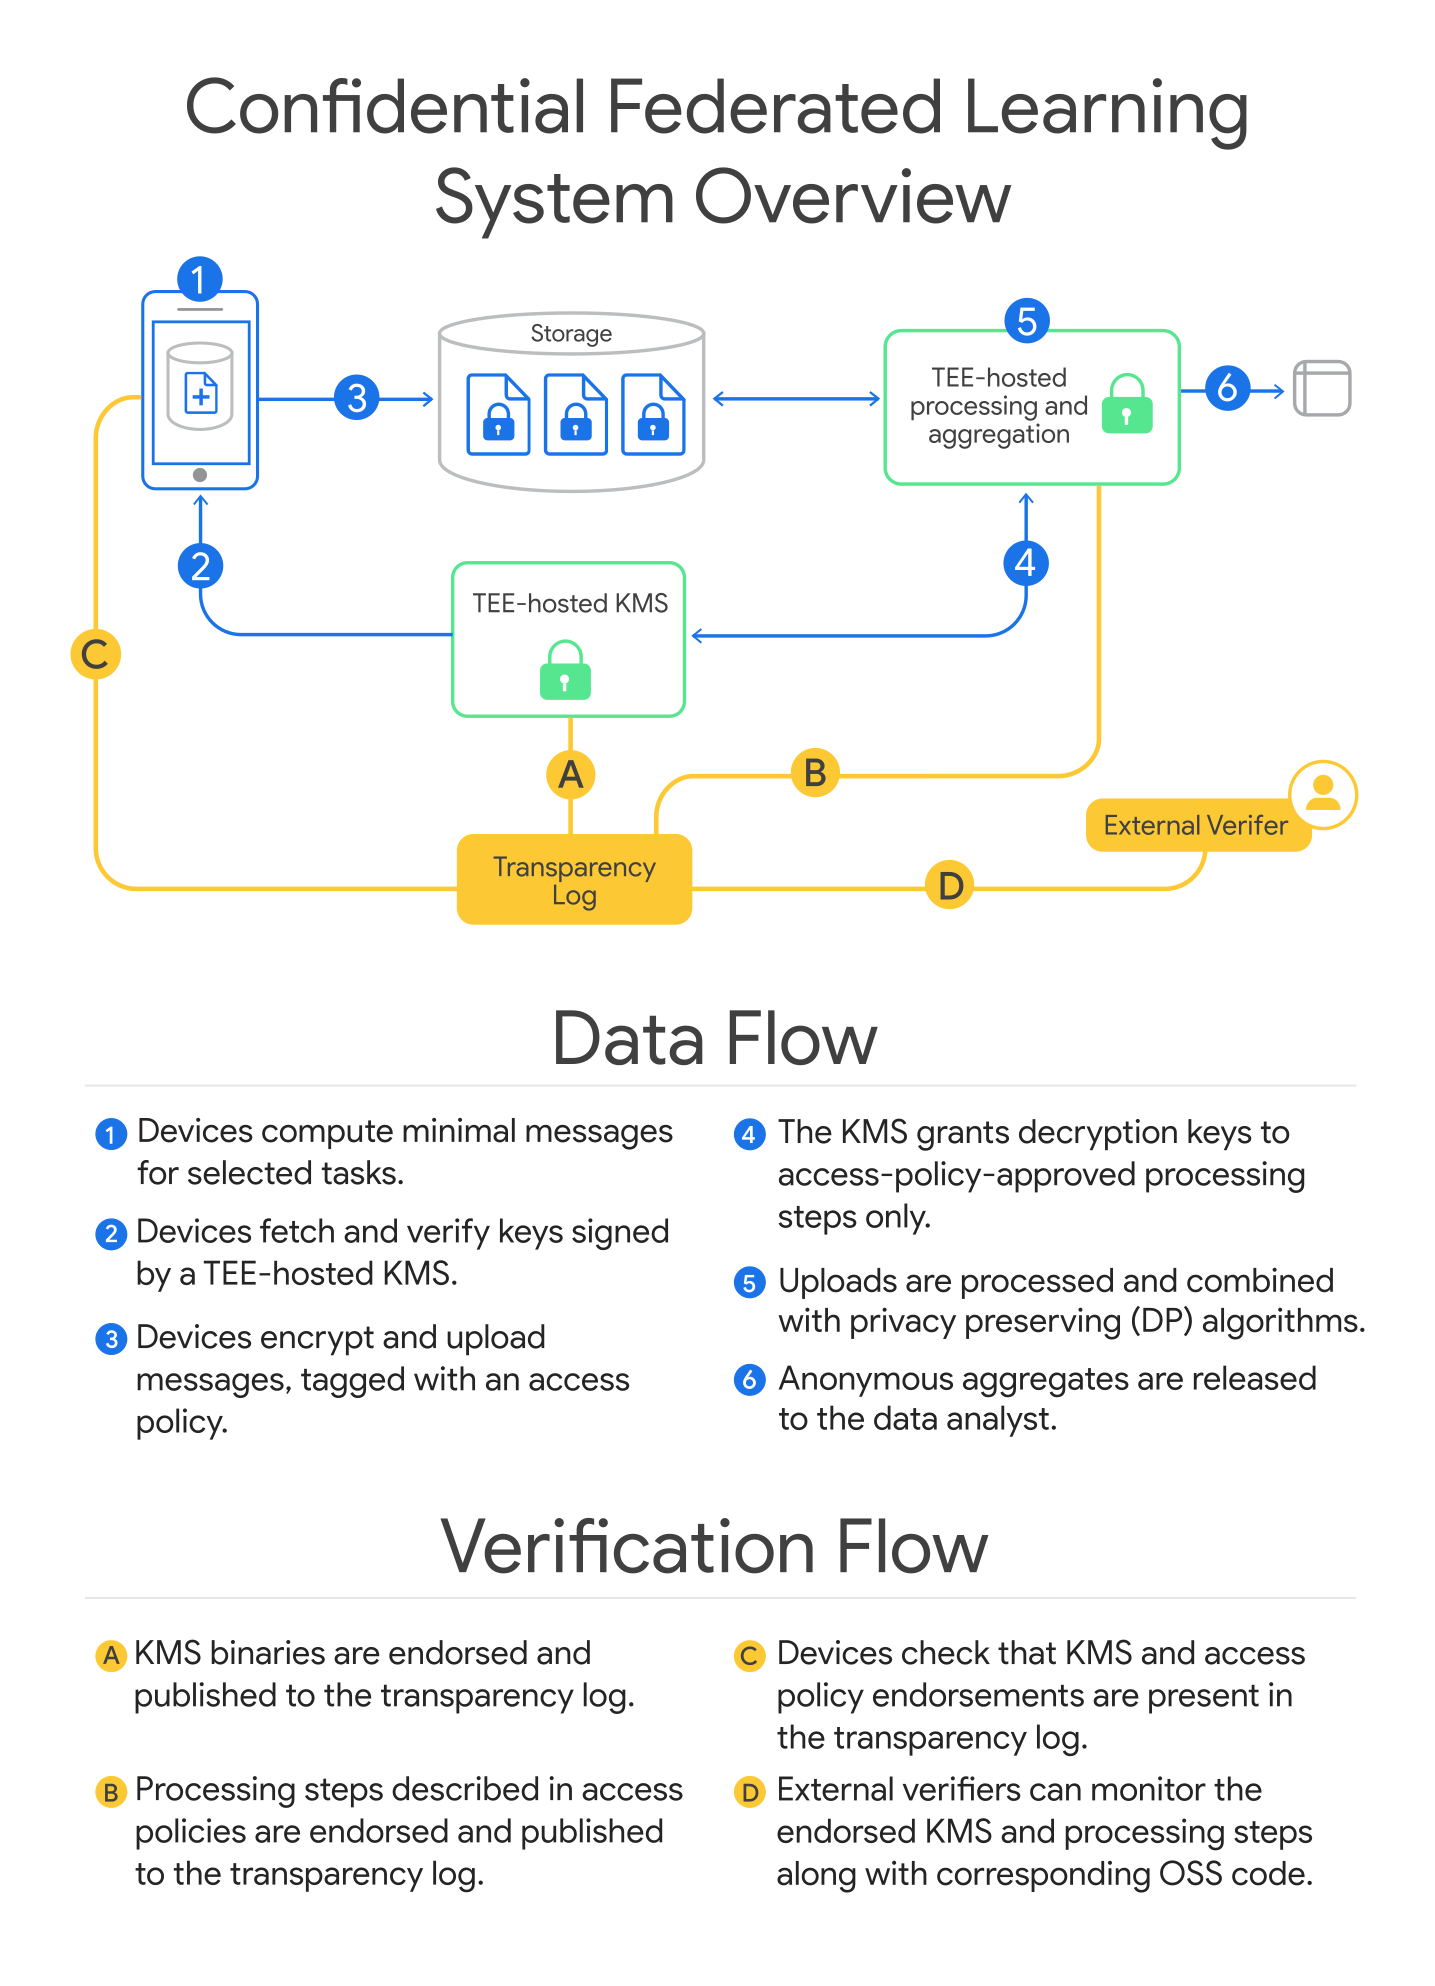
위 그림은 데이터 흐름(파란 숫자)과 검증 흐름(노란 알파벳)을 함께 보여 줍니다. 블로그는 이 시스템이 다음 네 가지 동작으로 이뤄진다고 설명합니다:
데이터 업로드 (Data Upload): 기기는 학습 예제를 기기 안에서 암호화해 업로드합니다. 업로드 전에 기기는 접근 정책(Access Policy) 을 미리 승인합니다. 접근 정책은 이 데이터를 처리할 수 있는 TEE 연산의 목록이며, 이 연산들은 익명화된 결과만 내보냅니다. 기기는 접근 정책이 공개 투명성 로그에 등록되어 있을 때만 업로드합니다.
KMS와 정책 검증 (KMS and Policy Verification): 키 관리 시스템(Key Management System, KMS) 은 RAFT 합의 프로토콜을 구현한 TEE 클러스터입니다. KMS는 접근 정책에 적힌 연산과 일치하는 서버 쪽 TEE에만 복호화 키를 줍니다. 저장소 README에 따르면 KMS는 복호화 키를 메모리에만 복제해 두므로, KMS가 재시작되면 그 키로 암호화된 업로드에는 영영 접근할 수 없습니다.
워크로드 실행 (Workload Execution): 데이터 처리용 TEE가 학습 루프를 구현한 Python 프로그램을 실행합니다. 이 "루트(root)" TEE는 병렬화할 수 있는 하위 작업을 워커(worker) TEE 클러스터에 맡깁니다. 분산 로직은 Federated Language로 표현합니다. Federated Language는 기존 연합 학습 시스템을 구동하던 TensorFlow Federated에서 나온 오픈소스 오케스트레이션 언어로, 특정 ML 프레임워크에 묶이지 않습니다. 학습 루프는 익명화된 모델 가중치를 주기적으로 데이터 분석가에게 공개합니다.
장애 복구 (Fault-Tolerant Recovery): Python 프로그램은 학습 라운드가 끝날 때마다 KMS로 암호화한 복구 상태를 저장합니다. 루트나 워커가 중간에 실패해도 이 상태에서 다시 시작하며, 이 과정에서 프라이버시에 민감한 정보가 추가로 새지 않습니다.
신뢰 사슬: 기기에서 워커 TEE까지
논문은 이 구조를 기기에서 시작해 KMS, 루트 TEE, 워커 TEE로 이어지는 신뢰 사슬(Chain of Trust) 로 설명합니다. 기기는 업로드 전에 두 가지를 확인합니다. KMS의 TEE 소프트웨어가 공개 투명성 로그에 기록되어 있는지, 그리고 데이터 처리 방식을 규정한 접근 정책도 같은 로그에 등록되어 있는지입니다. 확인이 끝나면 기기는 KMS의 공개 키로 데이터를 암호화하고 접근 정책과 암호학적으로 묶어 중간 저장소에 올립니다.
Python 워크로드의 경우 접근 정책에는 실행할 Python 프로그램 원문과 루트, 워커 바이너리의 해시가 직접 들어갑니다. 논문 부록의 접근 정책 예시는 펌웨어, 커널, 기본 OS 이미지, 컨테이너 바이너리라는 네 계층의 측정값을 기준값으로 적어 둡니다. 프로그램 안에는 _MAX_ZCDP = 0.58 같은 프라이버시 예산 상한이 하드코딩됩니다.
접근 정책은 Sigstore의 공개 투명성 로그인 Rekor에 게시됩니다. 그래서 정책이 공개되는 순간 그 Python 프로그램은 사실상 오픈소스가 됩니다. 블로그에 따르면 KMS와 데이터 처리 바이너리는 Confidential Federated Compute 저장소의 오픈소스 코드에서 재현 가능하게 빌드(Reproducible Build)할 수 있습니다. 다만 저장소 README는 바이너리와 소스를 검증 가능하게 연결하는 바이너리 투명성(Binary Transparency)을 아직 최종 목표로 적고 있으며, 그 검증 방법을 안내하는 빌드 문서도 계속 다듬는 중이라고 밝힙니다. 저장소 README에 따르면 이 저장소는 Project Oak 플랫폼 위에서 동작합니다.
마지막 고리는 루트 TEE와 워커 TEE 사이입니다. 둘은 신뢰할 수 없는 gRPC 채널 위에 Noise 프로토콜로 양방향 종단 간 암호화 채널을 만들고, 루트는 이 과정에서 워커의 증명 측정값을 검증합니다. Federated Language의 federated_map, federated_mean 같은 내장 연산이 들어간 부분은 루트가 워커에 나눠 병렬로 실행할 수 있고, 그렇지 않은 부분은 루트가 전부 실행합니다.
Program API: trusted_program과 ExternalHandle
워크로드 작성자는 trusted_program이라는 함수 하나를 가진 Python 프로그램을 씁니다. 서버 쪽 처리 단계가 시작되면, Python 런타임을 담은 루트 TEE 바이너리가 이 함수를 ExternalHandle 인스턴스와 함께 호출합니다.
def trusted_program(external_handle: ExternalHandle):
    # custom workload logic goes here
ExternalHandle은 프로그램이 TEE 바깥과 주고받는 모든 입출력을 담당합니다. 논문은 네 가지 기능을 설명합니다:
- 업로드된 데이터 접근: 기기가 올린 데이터를 읽습니다. 파싱은 프로그램의 몫입니다.
- 사이드로딩(Sideloading): 파이프라인 운영자가 런타임에 넘기는 임의의 정보를 읽습니다. 하이퍼파라미터나 사용자별 전처리처럼 비공개로 두고 싶은 로직을 주입할 때 씁니다. 기기 데이터와 달리 이 정보는 암호화되지 않습니다.
- 통제된 결과 공개: 평문 결과를 TEE 밖으로 내보냅니다. 내보내는 결과가 충분히 익명화되었는지는 워크로드 작성자의 책임이며, 외부 검증자는 공개된 프로그램을 읽어 이를 확인합니다.
- 복구 정보 저장과 로드: 나중에 재시작할 수 있도록 상태를 저장합니다. 이 정보는 TEE를 떠나기 전에 서명되고 KMS 키로 암호화되므로, 같은 프로그램과 바이너리를 실행하는 TEE만 읽을 수 있습니다.
아래는 논문 부록의 예제 프로그램(Listing 1)입니다. 매 라운드마다 데이터를 무작위로 골라 누적 합을 구하고, 노이즈를 더한 합을 공개하면서 복구 정보를 저장합니다. 이 예제의 random.randint(-10, 10)은 API 사용법을 보여 주기 위한 자리표시자이며, 실제 DP 메커니즘이 아닙니다.
from fcp.confidentialcompute.python import external_service_handle

# Entrypoint for TEE-hosted program.
def trusted_program(
    external_handle: external_service_handle.ExternalServiceHandle,
) -> None:

  # Define constants.
  ...

  # Helper function for parsing data.
  def parse_tensor(...):
    ...

  # Sideload the proto definition that describes the upload format.
  fds = descriptor_pb2.FileDescriptorSet()
  with open(external_handle.get_filename_for_config_id(MY_PROTO_ID)) as f:
    fds.ParseFromString(f.read())

  # If recovery information is available (which may be the case if the program
  # was previously interrupted), use it to continue from where the program left
  # off.
  recovery_val = external_handle.restore_recovery_info(RECOVERY_ID)
  if recovery_val is not None:
    starting_round_index, cumulative_sum = tuple(recovery_val.decode())
    starting_round_index += 1
  else:
    starting_round_index = 0
    cumulative_sum = 0

  for round_index in range(starting_round_index, num_rounds):
    # Select available clients at random for this round.
    selected_ids = random.sample(external_handle.blob_ids, NUM_CLIENTS_PER_ROUND)

    # Fetch and parse the data from the selected clients. Add it to the
    # cumulative sum.
    for id in selected_ids:
      tensor = external_handle.resolve_blob_id_to_tensor(id, KEYNAME)
      for data in parse_tensor(tensor, fds, PROTO_MESSAGE_NAME):
        cumulative_sum += data[MY_FIELD]

    # Release a noised sum for this round while also saving the round index and
    # cumulative sum as encrypted intermediate recovery information.
    noised_sum = cumulative_sum + random.randint(-10, 10)
    new_recovery_val = bytes((round_index, cumulative_sum))
    external_handle.save_recovery_info(new_recovery_val, RECOVERY_ID, [(noised_sum, f"round_{round_index}")])
사이드로딩은 비공개 모델 구조나 전처리 로직을 보호하면서 감사 가능성을 유지하려는 장치입니다. 블로그는 프라이버시와 관련된 로직이 모두 Python 프로그램 안에 하드코딩되어 있는 한 사이드로딩된 비공개 로직이 함께 실행되어도 외부에서 검증 가능한 보장이 유지된다고 설명합니다. 다만 이 전제가 지켜졌는지는 감사자가 공개된 프로그램을 읽고 판단해야 합니다.
같은 결과를 두 번 내보내지 않는 장애 복구
KMS는 키만 관리하지 않고, 파이프라인마다 롤백이 방지된 파이프라인 상태(Pipeline State) 도 저장합니다. 루트 TEE는 평문 결과를 내보낼 때마다 이 상태를 원자적으로 갱신해야 합니다. 이 장치가 필요한 이유는 무작위 노이즈 때문입니다.
논문의 예시는 다음과 같습니다. 1,000 라운드를 학습하면서 10 라운드마다 익명화된 체크포인트를 공개하고, 매 라운드 끝에 복구 정보를 저장하는 프로그램이 있다고 합시다. 루트 TEE가 206번째 라운드 중간에 실패하면, 새 루트 TEE는 200~205 라운드 끝에 저장된 복구 정보에서만 재시작을 허용합니다. 그보다 이른 라운드에서 재시작하면 이미 공개한 라운드의 결과를 다시 공개하게 됩니다. 결과에 무작위 노이즈가 들어 있으므로, 같은 라운드의 결과를 여러 번 보면 원래 데이터에 대해 의도보다 많은 정보를 얻을 수 있습니다. 운영자가 예전 복구 정보를 다시 넣는 재전송 공격(Replay Attack)도 같은 방식으로 막습니다.
기존 시스템과 새 시스템 비교
논문 4장은 두 시스템을 프라이버시 원칙별로 비교합니다. 이를 표로 정리하면 다음과 같습니다:
| 항목 | 기존 연합 학습 시스템 | 새 TEE 기반 시스템 |
|---|---|---|
| 기기가 올리는 데이터 | 기기에서 계산한 그래디언트 | 암호화된 학습 데이터 (1회 업로드) |
| 서버가 볼 수 있는 것 | 보안 집계와 분산 DP로 제한된 집계 결과 | 접근 정책에 등록된 워크로드의 결과(지표, DP 모델 가중치)만 |
| 서버 쪽 DP 처리 로직 | 외부 검증 불가 | 공개된 Python 프로그램 (외부 검증 가능) |
| 서버 로직 확인 | 불가 | 투명성 로그와 재현 가능 빌드로 기기와 제3자 모두 확인 |
| 그래디언트 계산 위치 | 기기 | 서버 TEE |
| 기기 참여 일정 | 시간 창(예: 144시간에 1회)으로 간접 제어 | 업로드를 모은 뒤 프로그램이 최적 일정을 계산 |
| 데이터 보존 | 즉시 집계 | KMS가 TTL을 최선 노력 수준으로 강제 |
새 시스템에서 파이프라인 운영자는 원시 학습 데이터에 접근할 수 없습니다. 논문은 파이프라인 운영자를 신뢰할 수 없다고 가정해도 이 주장이 성립한다고 설명합니다. 논문에서 파이프라인 운영자는 워크로드 작성자와 같은 주체인 경우가 많고, 시스템 구성 요소의 소유자나 운영자와는 구분됩니다. 신뢰 사슬이 기기와 서버 TEE를 직접 연결하기 때문입니다. 또 업로드된 데이터는 일정 시간이 지나면 접근 정책에 등록된 TEE도 복호화할 수 없습니다.
Gboard에서 측정한 결과
Gboard는 이 시스템으로 영어와 일본어 다음 단어 예측 모델을 출시했습니다. 논문 5장은 기존 시스템(baseline)과 새 시스템을 세 가지 측면에서 비교합니다.
더 많은 기기가 학습에 참여
일본어 언어 모델에서, 두 시스템이 관찰한 누적 참여 가능 기기 수는 비슷했습니다. 차이는 그중 실제로 학습에 기여한 비율이었습니다. 기존 시스템은 코호트 크기 6,500으로 38일 동안 3,000 라운드를 학습했는데, 참여 가능했던 35.5M 기기 중 8.5M(23.9%)만 데이터를 기여했습니다. 기여하지 못한 기기 중 20.5M은 서버로부터 작업을 한 번도 받지 못했고, 6.5M은 작업을 받았지만 충전 해제 같은 중단으로 끝내 완료하지 못했습니다. 기존 시스템에서는 자주 접속하거나 사람이 적은 시간대에 접속하는 기기가 더 많이 뽑히는 편향도 있었습니다. 새 시스템의 학습도 같은 조건(3,000 라운드, 코호트 6,500)으로 설정했습니다.
새 시스템은 약 6일 동안 17.8M 건의 업로드를 받은 뒤 서버 학습을 시작했고, 이 17.8M 건이 모두 편향 없이 학습에 쓰였습니다. 참여 가능했지만 업로드하지 않은 기기는 대부분 학습에 쓸 데이터가 없었습니다. 기기가 할 일이 업로드 준비로 줄어들어, 중단으로 실패하는 경우도 드물었습니다.
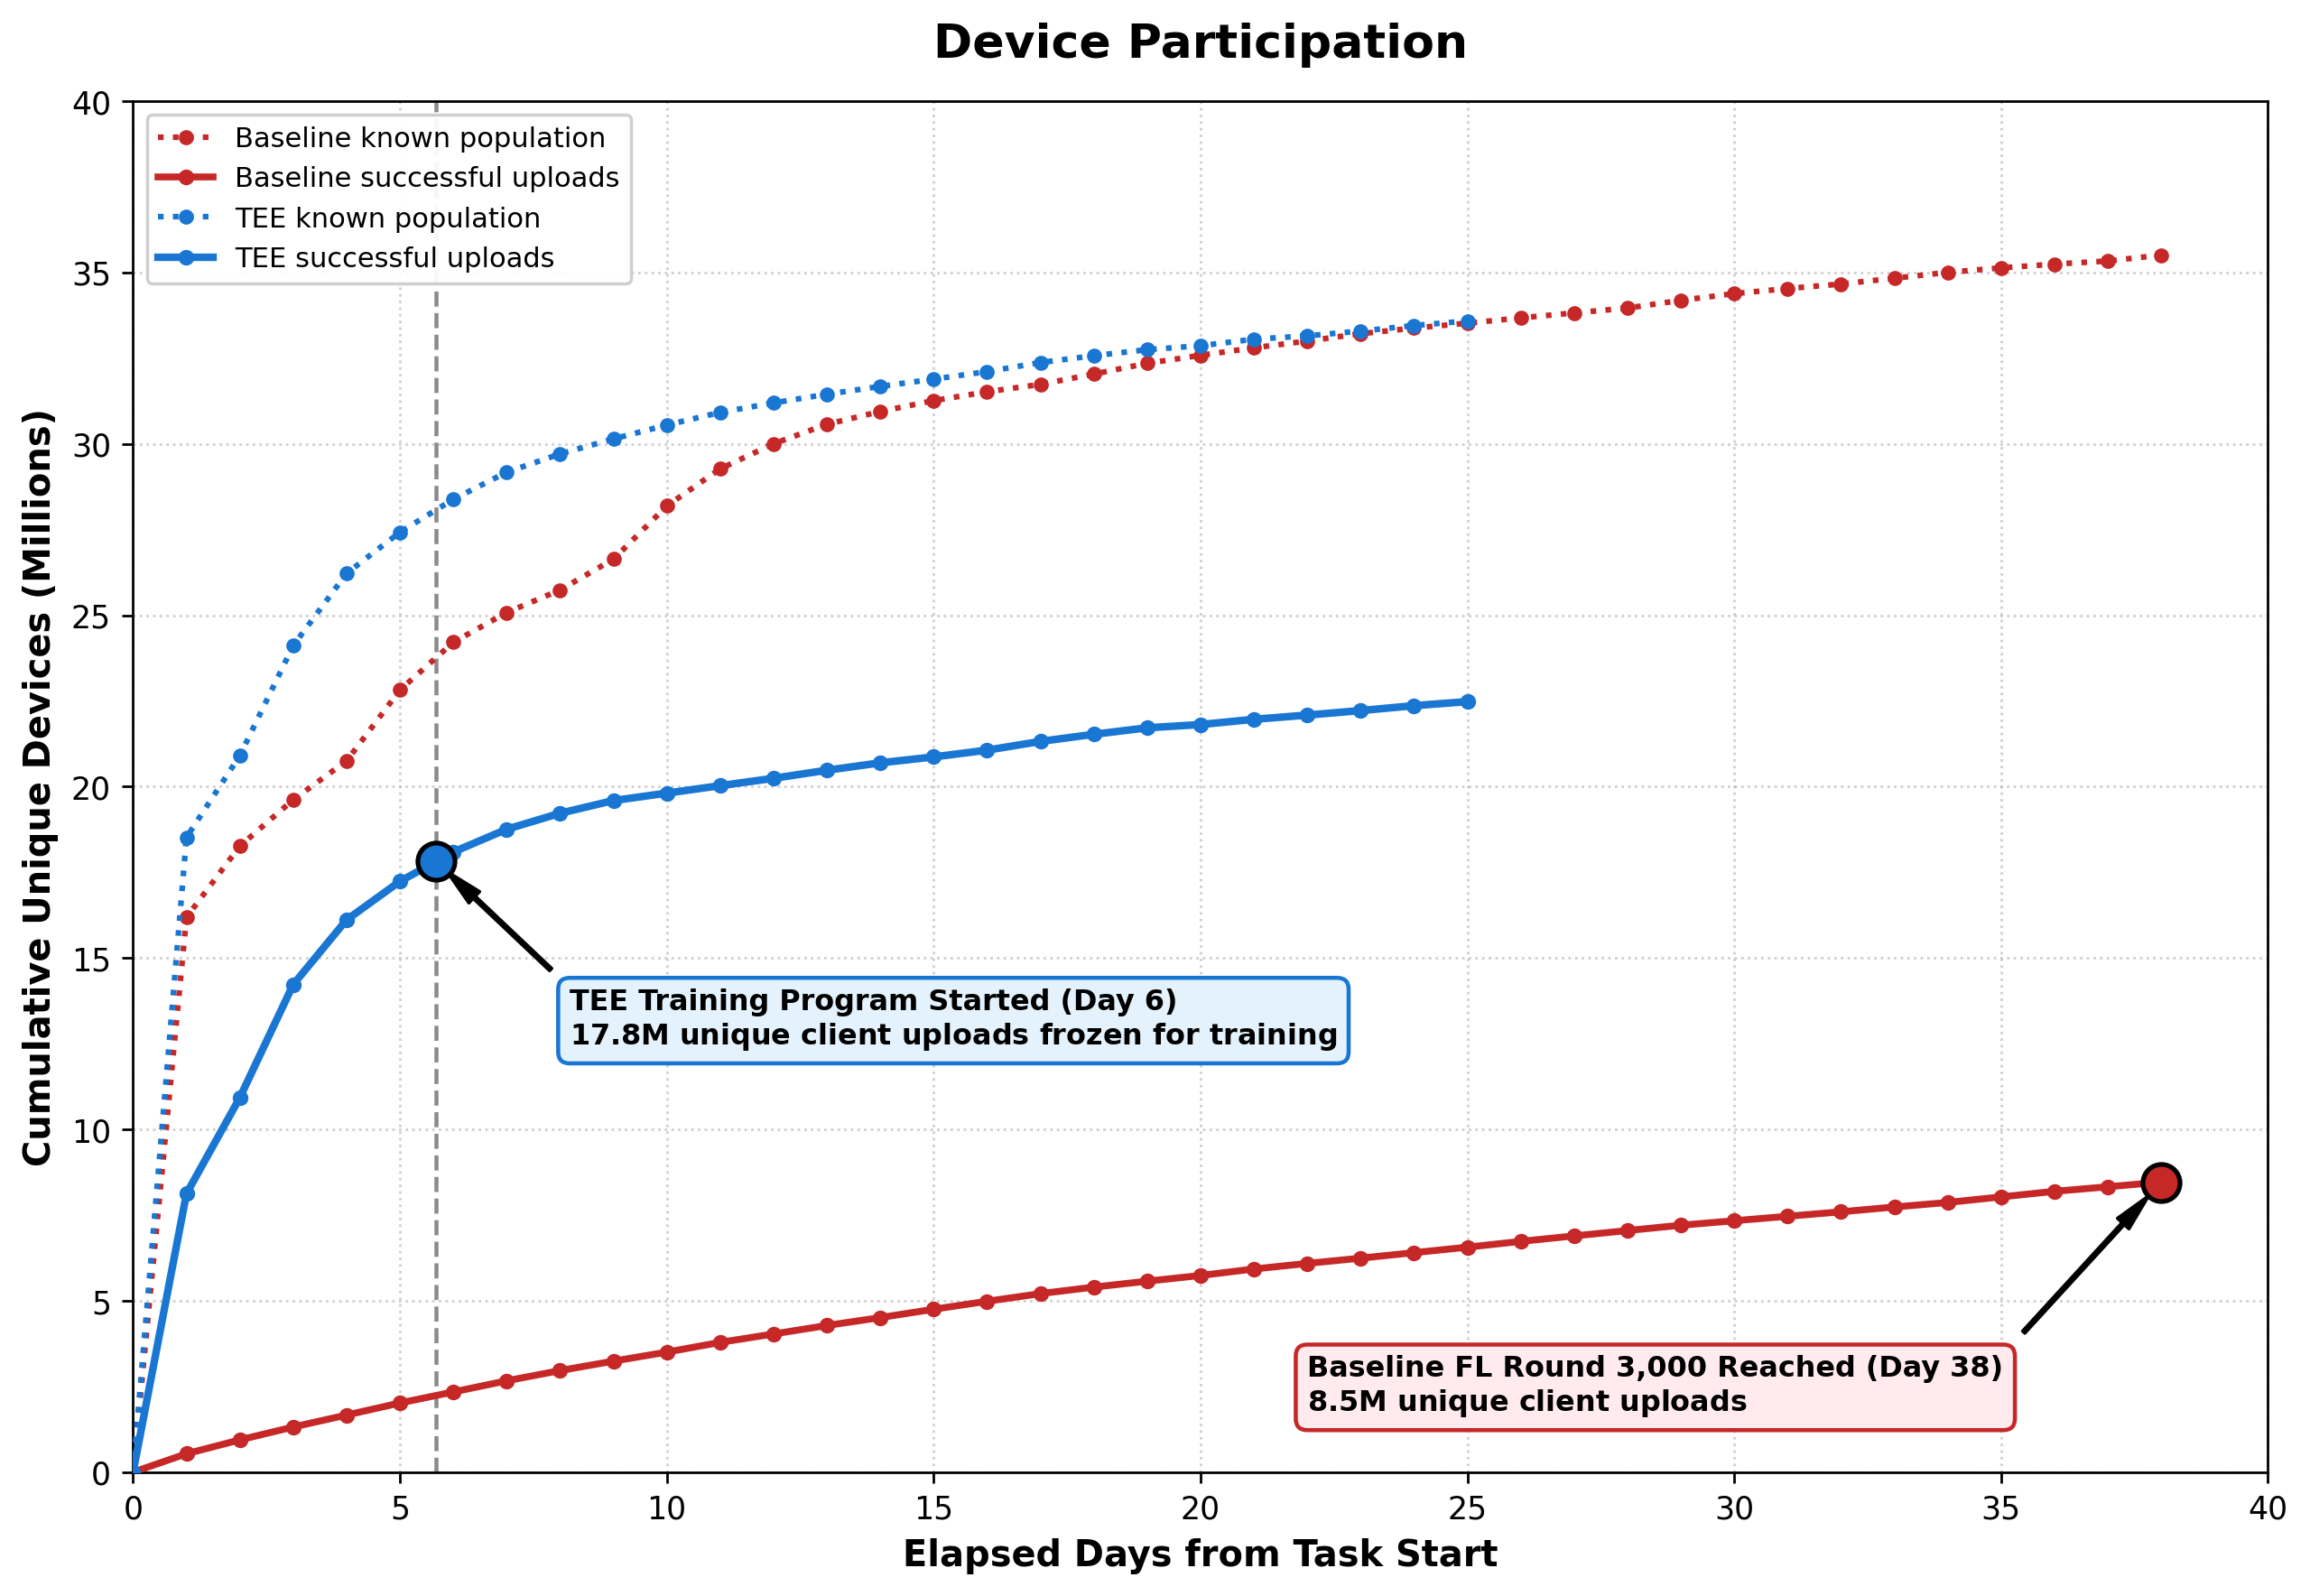
다만 TTL 때문에 생기는 트레이드-오프가 있습니다. 학습이 시작된 뒤에 들어온 업로드는 반영되지 않습니다. 또 키의 TTL이 30일이고 x 일부터 y 일까지 모은 데이터로 y 일에 학습을 시작하면, 프로그램은 30 - (y - x) 일 동안만 결과를 낼 수 있습니다. 따라서 업로드를 더 오래 기다릴지, 학습 시간을 확보할지 정해야 합니다.
같은 노이즈로 더 강한 프라이버시
DP 학습에서 노이즈 배수(Noise Multiplier) \sigma 는 학습에 더하는 노이즈의 크기를 정하는 값이고, 클수록 모델 정확도가 떨어집니다. 프라이버시 예산은 zCDP(zero-Concentrated Differential Privacy) 의 \rho 값으로 표시합니다. zCDP는 Bun과 Steinke가 제안한, DP를 완화한 정의이며, \rho 가 작을수록 프라이버시 보장이 강합니다. 같은 \rho 에서 \sigma 를 낮출 수 있거나, 같은 \sigma 에서 \rho 를 낮출 수 있으면 프라이버시와 효용의 트레이드-오프가 개선된 것입니다.
새 시스템은 모든 업로드를 먼저 모은 뒤 학습을 시작하므로, 프로그램이 런타임에 기기 참여 일정을 최적화할 수 있습니다. 모든 기기가 같은 횟수만큼 참여하게 하고, 한 기기의 두 참여 사이 최소 라운드 간격(minSep)을 가능한 최대로 늘립니다. 한 기기가 참여할 수 있는 최대 라운드 수(maxP)가 줄고 minSep이 늘면, 한 기기가 결과에 미치는 영향이 작아져 같은 노이즈로 더 작은 예산을 쓰게 됩니다. 논문은 이 minSep 값으로 BLT(Buffered Linear Toeplitz) 메커니즘을 구성하고, 목표 zCDP에서 노이즈 배수를 계산합니다.

위 그래프는 영어 모델을 5,000 라운드, 코호트 6,500으로 학습할 때 가능한 zCDP와 노이즈 배수 조합입니다. 기존 시스템은 maxP 8, minSep 561이었고, 새 시스템은 maxP 3, minSep 1,822였습니다. 기존 시스템의 노이즈 배수 7.38을 그대로 쓰면 zCDP가 0.388에서 0.113으로 낮아지고, zCDP를 0.388로 유지하면 노이즈 배수를 3.99로 낮출 수 있습니다. 그래프의 기존 시스템 값은 실제 운영 실행에서 나왔습니다. 이 실행은 노이즈 배수를 7.38로 고정하고 144시간 참여 제한으로 85일 동안 8,616 라운드 이상 학습했으며, 체크포인트 시각으로 maxP와 minSep을 계산해 zCDP를 구했습니다. 새 시스템은 zCDP 0.232를 목표로 했고, 모은 11.8M 업로드를 바탕으로 런타임에 노이즈 배수 5.16을 계산했습니다. 같은 라운드 수의 기존 시스템이 같은 zCDP를 맞추려면 노이즈 배수 9.54가 필요했습니다. 저자들은 노이즈 배수와 효용의 관계도 BLT 최적화로 더 유리해지므로, 이 그래프가 실제 효용 개선을 과소평가한다고 설명합니다.
실서비스 A/B 테스트
마지막으로 Gboard 운영 사용자 일부를 대상으로 A/B 테스트를 진행했습니다. Gboard의 타이핑 디코더는 자동 수정, 단어 완성, 다음 단어 예측에 언어 모델을 두 단계로 씁니다. 1차 후보를 만드는 Neural Search Space(NSS)와, 후보를 다시 순위 매기는 On-The-Fly(OTF) 재점수화입니다. 실험군마다 3.5M 기기가 포함되었습니다.
결과는 다음과 같습니다:
- 프라이버시 예산: TEE 실험군 중 가장 좋은 군은 zCDP 0.215로, 같은 MF-DP-FTRL 메커니즘 기준으로 환산한 기존 운영 모델(zCDP 0.641)보다 약 3배 작았습니다.
- 사용성 지표: 분당 단어 수(Words Per Minute)와 사용자가 Gboard 제안을 고친 비율(Words Modified Ratio)에서 차이가 없었습니다(neutral).
- 학습 기간: TEE 모델은 3주 만에 학습되었고, 기존 운영 모델은 2개월이 걸렸습니다. 블로그는 병목이 기기에서 서버로 옮겨 가, 지금은 학습 속도가 TEE 자원에만 제한된다고 설명합니다.
즉 A/B 테스트가 보여 준 것은 같은 사용성을 더 작은 프라이버시 예산과 더 짧은 학습 기간으로 얻었다는 결과입니다. 블로그와 논문 초록은 "더 강한 프라이버시 보장과 향상된 정확도"를 함께 언급합니다. 그러나 논문 본문의 A/B 테스트가 보고한 지표는 사용성 지표의 중립(neutral) 결과이며, 정확도 수치는 따로 공개하지 않았습니다.
남은 한계와 향후 과제
제목의 Toward가 말하듯, 저자들은 이 시스템을 서버 쪽 처리가 개인 프라이버시를 지킨다는 엄밀한 증명을 향한 한 단계로 소개합니다. 논문과 블로그에서 밝힌 한계는 다음과 같습니다.
TEE 자체의 한계: 현세대 TEE는 보안 보장에 영향을 주는 한계가 알려져 있습니다. 논문은 기밀 가상 머신(Confidential VM) 부채널 분석 연구인 SNPeek(NDSS 2026)을 인용합니다. SNPeek 논문은 TEE 기반 기밀 VM이 부채널 누출을 위협 모델 밖에 두기 때문에, 그 대응이 개발자의 몫으로 남는다고 지적합니다. 블로그는 사이드로딩된 워크로드를 악의적인 서버 쪽 공격으로부터 더 깊이 보호하려면 향후 TEE 하드웨어와 부채널 완화 연구가 더 깊은 보호를 제공할 것으로 기대한다고 씁니다. 사용자별 비공개 전처리도 부채널 관측 가능성 같은 알려진 한계 안에서만 보장됩니다.
검증의 범위: 공개되는 것은 접근 정책에 들어간 Python 프로그램과 바이너리이며, 사이드로딩된 파라미터와 비공개 로직은 공개되지 않습니다. 감사자는 그것이 프로그램 안에서 어떻게 쓰이는지를 보고 DP 보장이 유지되는지 판단합니다. 또 TTL은 KMS가 최선 노력(best-effort) 수준으로 강제합니다. 블로그는 DP 알고리즘과 시스템 구성 요소의 소프트웨어 구현에 대한 완전한 정확성 증명이 언젠가 가능할 것이라고 전망합니다.
아직 쓰지 못한 프라이버시 여유: 현재 파이프라인 운영자는 각 라운드에 어떤 업로드가 쓰였는지 볼 수 있습니다. 업로드 내용은 암호화되어 있어 볼 수 없습니다. 이 정보를 숨기면 샘플링에 의한 프라이버시 증폭(Privacy Amplification by Sampling) 을 적용해 같은 노이즈로 더 작은 예산을 증명할 수 있습니다. 논문은 업로드를 검증 가능하게 섞거나(shuffle), 라운드마다 필요한 것보다 많은 업로드를 가져와 그중 일부만 쓰는 방법을 제안합니다.
규모와 하이퍼파라미터: 지금까지 이 시스템으로 학습한 모델은 10M 파라미터 이하이고, 실험은 14대의 머신에서 진행되었습니다. 더 큰 모델을 학습하려면 워커 TEE가 GPU를 써야 하고, 루트와 워커 사이의 통신 병목도 해결해야 합니다. 또 5장의 실험은 모델마다 설정 하나만 시험했으므로, 최적 하이퍼파라미터는 추가 실험이 필요합니다.
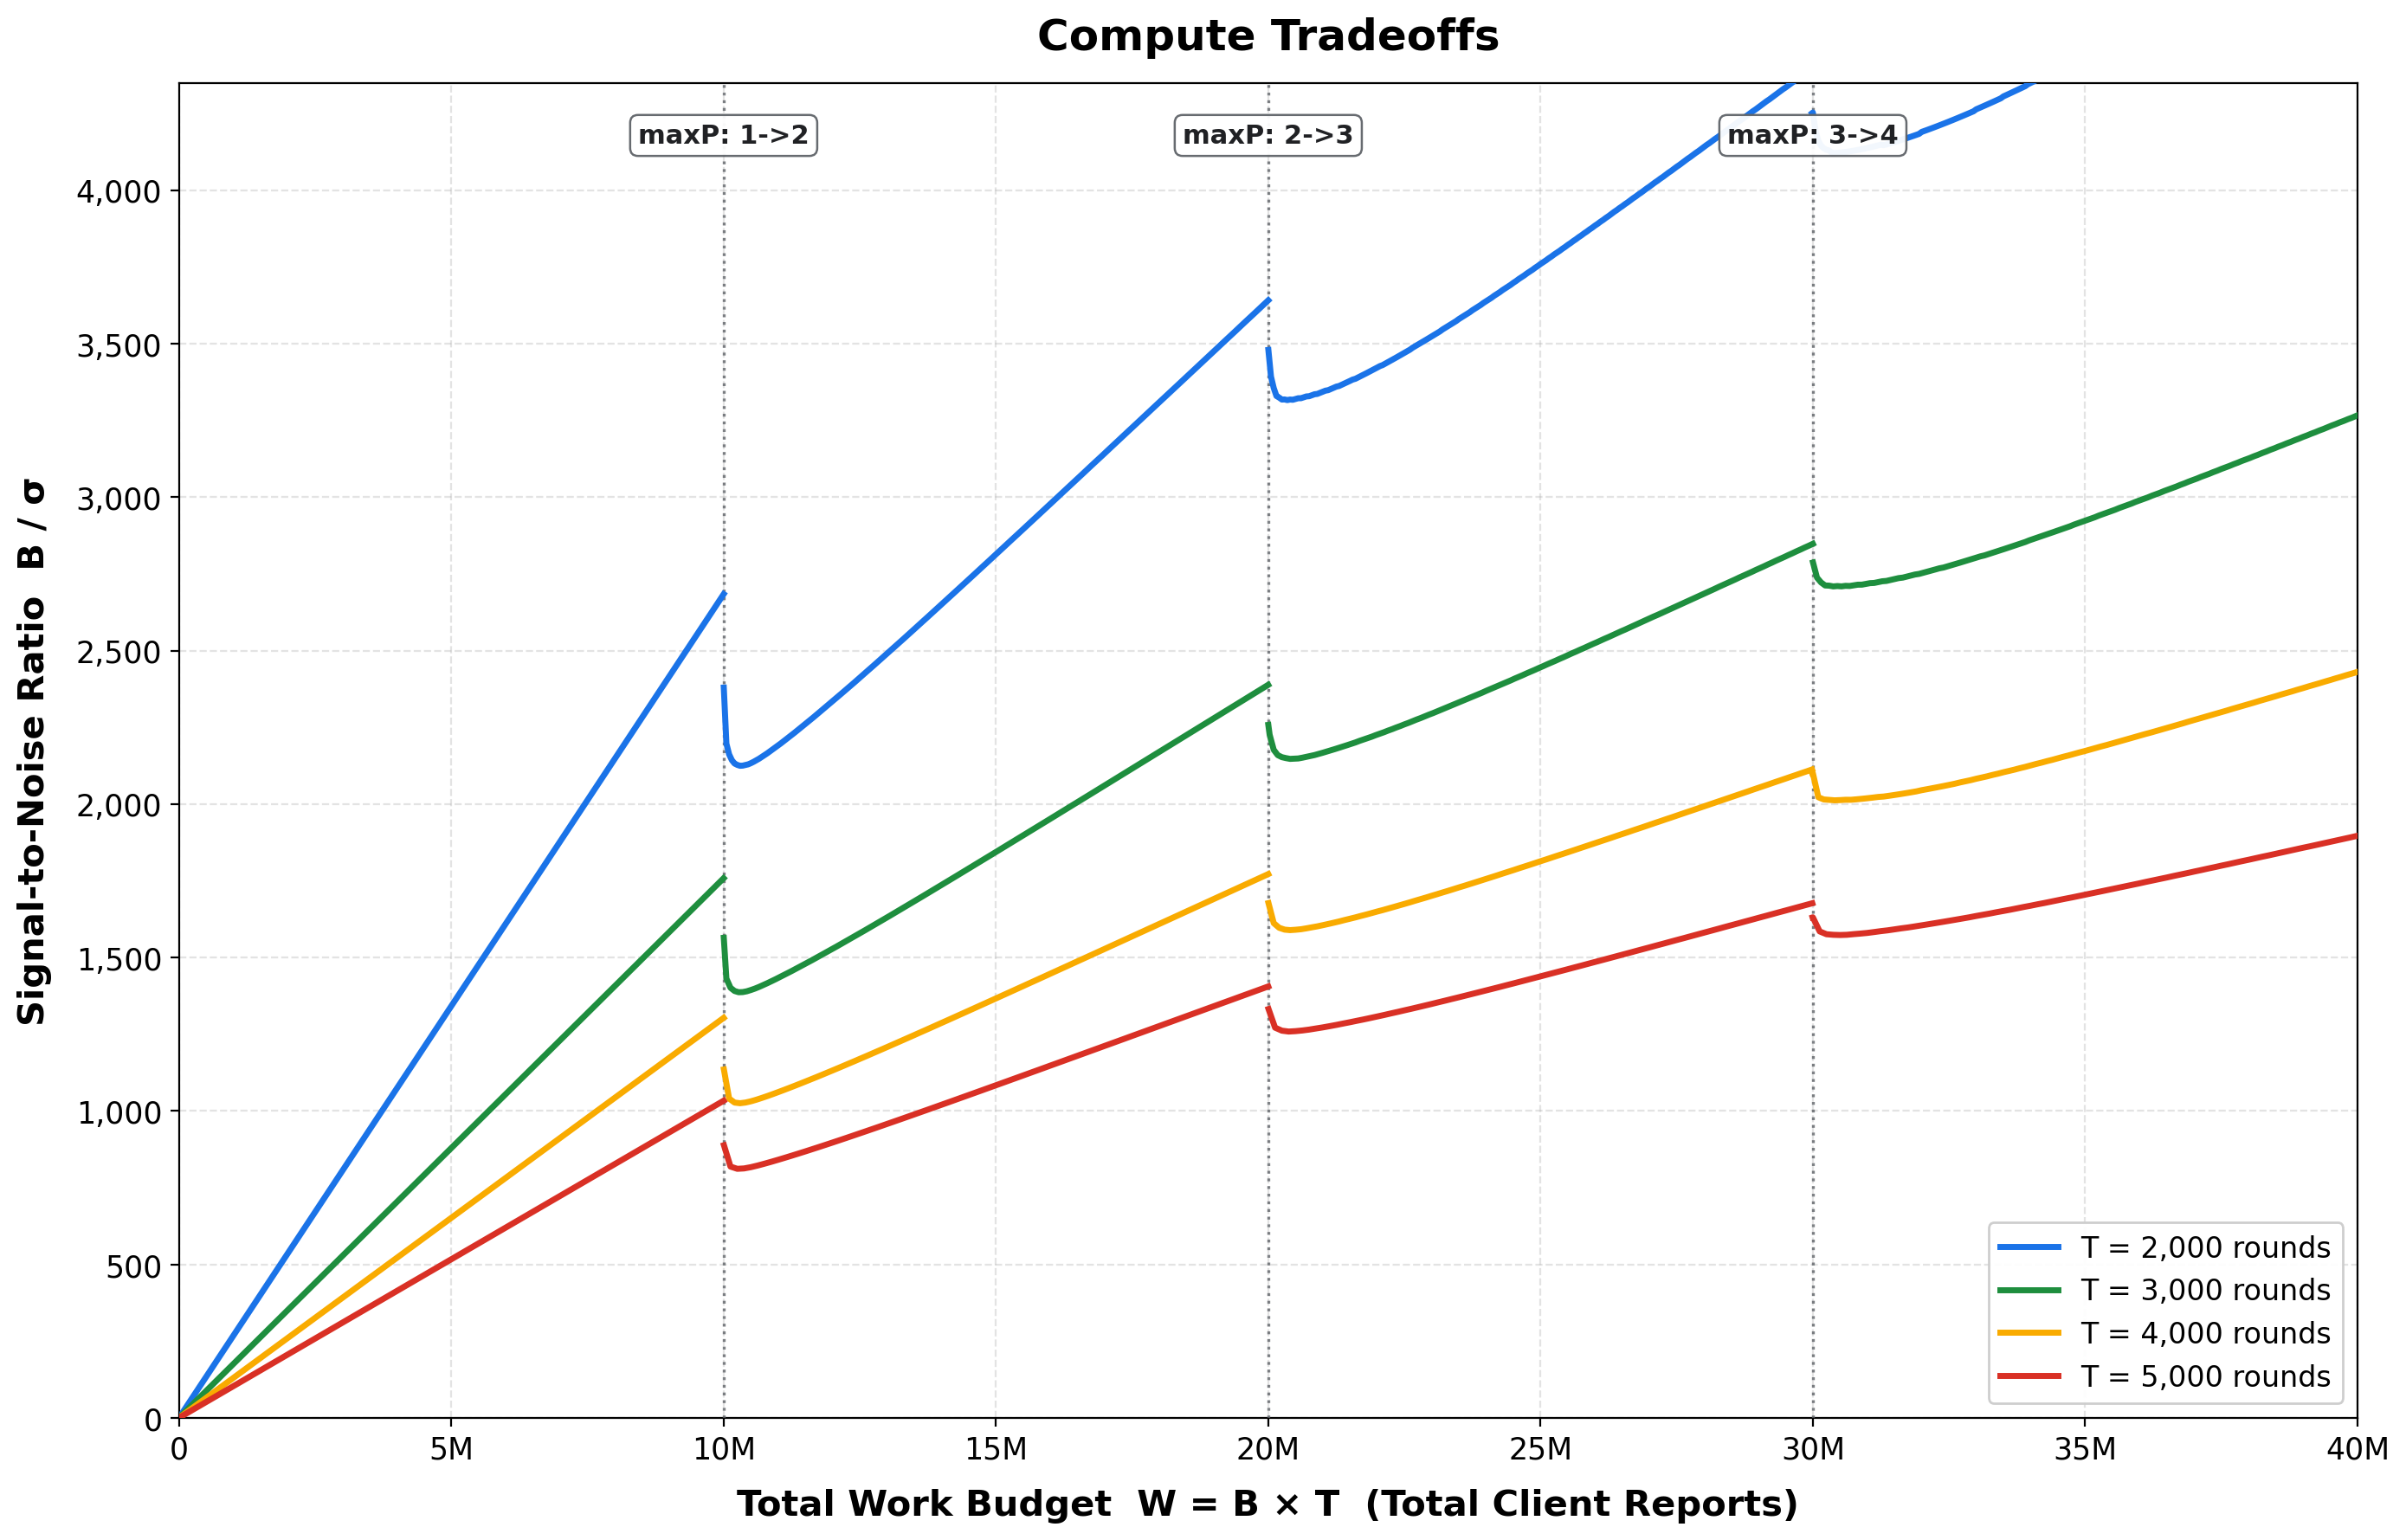
위 그래프는 하이퍼파라미터 선택이 왜 까다로운지 보여 줍니다. 모집단 10M, 목표 zCDP 0.5로 계산한 결과이며, 세로축은 신호 대 잡음비(코호트 크기 B ÷ 노이즈 배수 \sigma)입니다. 같은 작업 예산 T \times B 에서는 코호트를 키울수록 신호 대 잡음비가 좋아집니다. 그러나 작업 예산이 늘어 한 기기의 maxP가 1 늘어나는 지점에서는 노이즈를 더 넣어야 하므로 신호 대 잡음비가 갑자기 떨어집니다. 그래서 논문은 작업 예산을 maxP가 바뀌기 바로 전으로 맞출 것을 제안합니다. 다만 코호트 크기를 키우는 효과는 수렴 속도 측면에서 점점 줄어든다는 점도 함께 지적합니다.
Google은 이 인프라가 학습뿐 아니라 Python으로 표현할 수 있는 임의의 워크로드를 검증 가능하게 실행할 수 있다는 점에 주목하고 있습니다. 합성 데이터 생성, 추론(Inference) 같은 워크로드를 실험하고 있습니다. LLM 추론에 특화된 기존 데이터 처리 TEE와 이번 Python 실행용 TEE를 한 파이프라인에서 함께 쓰는 방향도 탐색하고 있습니다. 차등 프라이버시로 처음부터 학습한 공개 LLM인 VaultGemma가 학습 알고리즘 쪽 접근이라면, 이번 연구는 그 알고리즘이 서버에서 실제로 실행되는지를 외부에서 확인하게 하는 시스템 쪽 접근입니다.
 Toward provably private learning from federated data 소개 블로그
 Toward provably private learning from federated data 논문
 Confidential Federated Compute GitHub 저장소
Federated Language GitHub 저장소
더 읽어보기
-
VaultGemma: 학습 과정에서 어떠한 개인 정보도 모델에 남지 않도록 한 LLM (feat. Differential Privacy)
-
Google이 공개한 AI 에이전트 프라이버시와 보안의 51가지 이슈에 대한 워크숍 보고서 [영문/PDF/116p]
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
