핵심 요약
- vLLM 프로젝트가 2026년 9월 30일 GuideLLM v0.8.0 릴리스를 공개했습니다. 지연 목표(SLO)를 지킨 요청의 처리율(goodput)을 재고, 그 목표를 지키는 최대 동시 요청 수를 찾는
goodput프로파일이 추가되었습니다. - WEKA 형식과 OpenTelemetry(OTEL) 형식의 에이전트 트레이스를 기록된 시간대로 재생할 수 있게 되었습니다. 서브에이전트와 도구 호출까지 포함한 세션 단위로 서빙 부하를 재현합니다.
- 기존 사용자에게 영향이 큰 변경이 있습니다.
--profile의 기본값(sweep)이 사라져 지정하지 않으면 실행이 거부되고,chat같은 예전 내장 시나리오는rhaiis/...시나리오 7개로 바뀌었습니다. GuideLLM 문서의 시작하기 예제와 README에는 아직 예전 방식이 남아 있습니다. - 10월 8일에 나온 v0.8.1이 현재
pip install기본 버전입니다. v0.8.1은 무릎 지점(knee) 탐지 프로파일과 실행 중 경고 규칙을 더했고, 목록 형태의 프로파일 인자를 폐기 예정으로 표시했습니다.
GuideLLM 소개
GuideLLM은 vLLM 프로젝트 산하의 LLM 서빙 성능 벤치마크 도구입니다. OpenAI 호환 서버나 같은 프로세스 안의 vLLM에 실제와 비슷한 요청 패턴을 보냅니다. 그리고 첫 토큰까지의 시간(TTFT, Time To First Token), 토큰 간 지연(ITL, Inter-Token Latency), 처리량 같은 지표를 분포와 함께 기록합니다. 모델을 고른 뒤 "이 하드웨어에서 어느 정도 부하까지 버티는가"를 답하려는 서빙 담당자가 주 사용자입니다.
8월 20일 열린 vLLM Office Hours #56에서 Red Hat의 Samuel Monson과 Jared O'Connell은 GuideLLM이 재는 것이 서버 내부 지표가 아니라 사용자가 겪는 지연이라고 설명했습니다. vLLM이 스스로 보고하는 TTFT와 사용자가 받는 TTFT는 그 사이의 여러 계층 때문에 같지 않다는 것입니다 (34:50). 발표자들은 쓰임새로 배포 전 모델 비교, 용량 계획, 설정 변경의 A/B 비교, 하드웨어 평가를 꼽았습니다 (36:52).
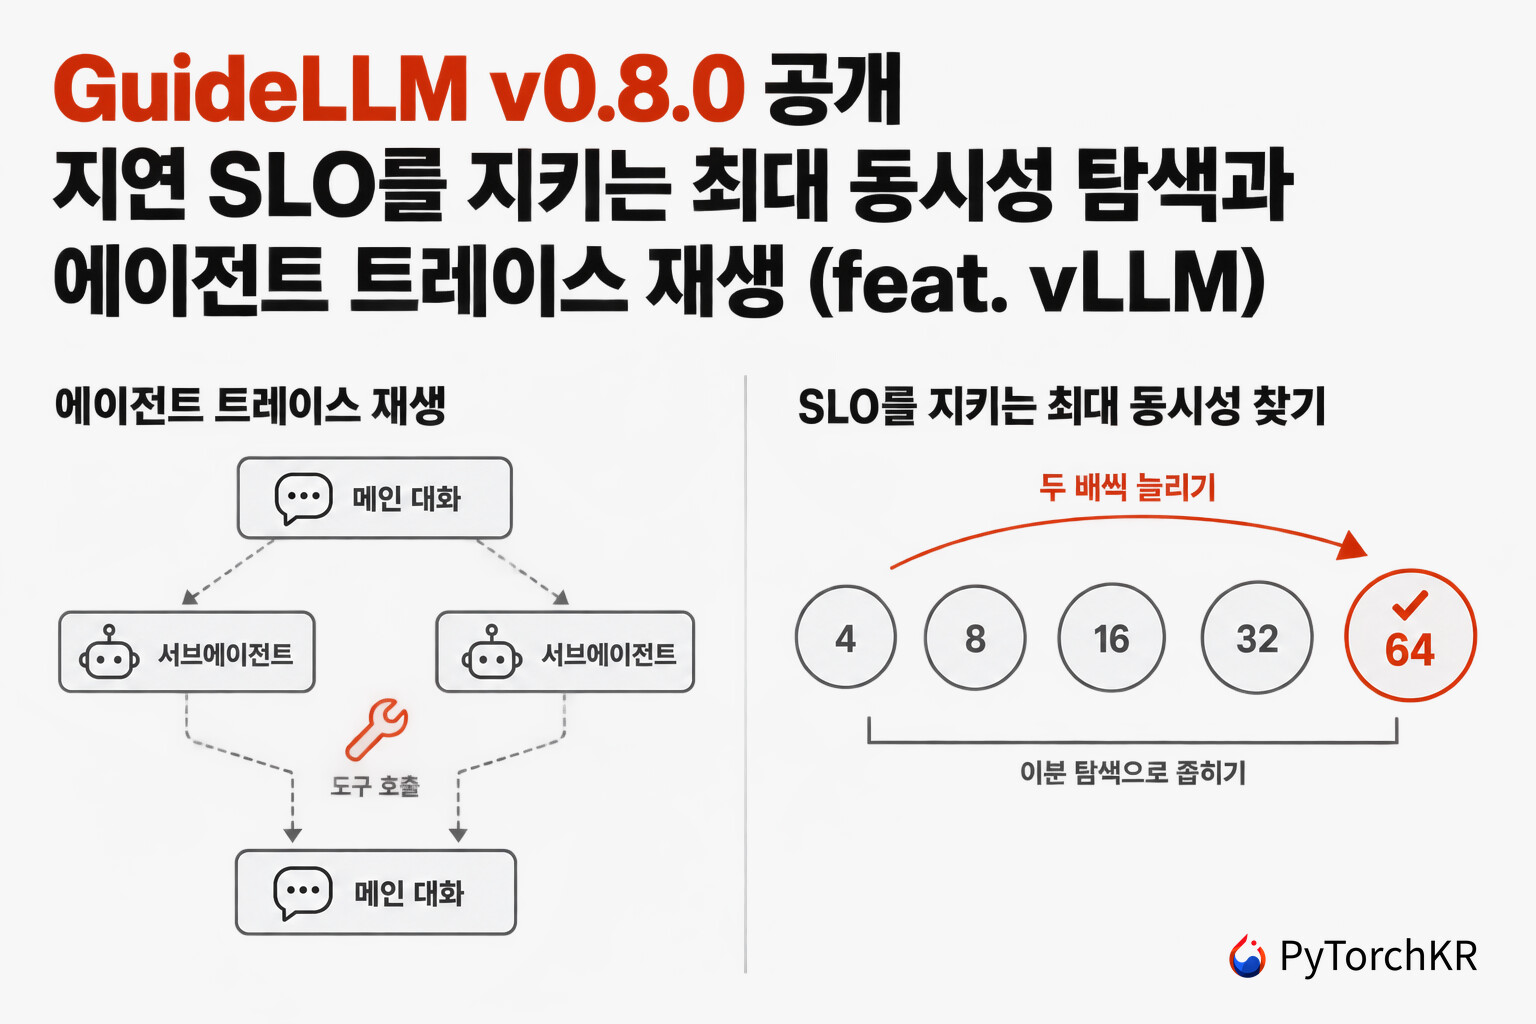
이번 릴리스의 방향은 두 가지입니다. 하나는 "초당 몇 개를 처리했는가" 대신 "목표 지연 안에 몇 개를 처리했는가"로 질문을 바꾸는 goodput 측정입니다. 다른 하나는 코딩 에이전트처럼 한 세션 안에서 수십에서 수천 번 모델을 부르고, 서브에이전트를 실행하고, 도구를 호출하는 부하를 기록 그대로 재현하는 트레이스 재생입니다. 이 글은 릴리스 노트와 v0.8.0 문서, 저장소 소스를 대조하고, GuideLLM에 들어 있는 mock 서버로 새 기능 일부를 직접 실행한 결과를 덧붙입니다. 함께 받은 Office Hours 영상은 v0.7 시점의 발표이므로, 그때 예고한 내용과 실제 v0.8.0을 비교하는 자료로 씁니다.
v0.8.0에서 달라진 것 한눈에 보기
릴리스 노트의 하이라이트를 쓰는 방법과 함께 정리하면 다음과 같습니다.
| 변경 | 쓰는 방법 | 비고 |
|---|---|---|
| SLO 달성률과 goodput 지표 | --metrics '{"kind":"generative","slo":{"ttft_ms":200,"tpot_ms":50}}' |
콘솔, JSON, CSV에 함께 기록 |
| 최대 동시성 탐색 | --profile kind=goodput,target_attainment=0.99 |
동시성을 두 배씩 늘린 뒤 이분 탐색 |
| WEKA, OTEL 트레이스 재생 | --profile kind=replay --data kind=weka,... / kind=otel,... |
서브에이전트와 도구 호출 포함 |
| 최소 요청 수 제약 | --constraint kind=min_requests,count=1000 |
끝부분 처리율이 떨어지지 않게 함 |
| 단일 파일 HTML 리포트 | --output kind=html |
CSS와 JavaScript를 파일 안에 포함 |
| SQLite 데이터 소스 | --data kind=db_file,uri=sqlite:///prompts.db,load_kwargs.sql="SELECT text FROM samples" |
현재는 SQLite만 지원 |
| vLLM 배치 백엔드 | --backend kind=vllm_python_batch,model=...,batch_size=8 |
HTTP 서버 없이 같은 프로세스에서 실행 |
| 내장 시나리오 교체 | --config rhaiis/concurrent-1k-1k-equal 등 7종 |
예전 이름은 사용 불가 |
| 기본 프로파일 제거 | --profile 지정 필수 |
업그레이드 시 스크립트 수정 필요 |
이 밖에 WebSocket 백엔드의 왕복 지연 지표, 신뢰구간, 스케줄 지연 지표, 멀티턴 대화의 턴 위치별 지표가 추가되었습니다. 문서의 시작하기 절은 중국어 번역이 시작되었습니다. 아래에서 앞의 두 기능을 중심으로 살펴봅니다.
지연 SLO로 재는 goodput과 최대 동시성 탐색
처리량만으로는 구분되지 않는 지점
서빙 벤치마크는 보통 초당 요청 수(RPS)나 초당 출력 토큰 수로 결과를 요약합니다. 그런데 서버가 포화된 뒤에는 처리량이 거의 그대로인데 개별 요청의 지연만 늘어나는 구간이 있습니다. 처리량 숫자만 보면 이 구간을 정상 운영 범위로 착각하기 쉽습니다.
서비스 수준 목표(SLO, Service Level Objective) 는 "99% 요청의 TTFT가 200ms 이하"처럼 지연 기준과 그 기준을 지켜야 하는 요청 비율을 함께 정한 운영 목표입니다. GuideLLM v0.8.0은 이 두 부분을 직접 잽니다. --metrics 에 요청 하나가 지켜야 할 지연 기준을 밀리초 단위로 적으면, 모든 기준을 동시에 만족한 요청만 '준수'로 셉니다.
guidellm run \
  --backend kind=openai_http,target=http://localhost:8000 \
  --profile kind=concurrent,streams=32 \
  --data kind=synthetic_text,prompt_tokens=256,output_tokens=128 \
  --metrics '{"kind":"generative","slo":{"ttft_ms":200,"tpot_ms":50}}' \
  --constraint kind=max_duration,seconds=120
기준으로 쓸 수 있는 값은 세 가지입니다.
| 기준 | 비교 대상 | 주의할 점 |
|---|---|---|
ttft_ms |
Time to First Token | 스트리밍 백엔드에서만 측정 가능 |
tpot_ms |
Inter-Token Latency | 첫 토큰을 뺀 토큰 간 지연. 이름과 달리 GuideLLM의 Time Per Output Token(첫 토큰 포함)이 아님 |
e2el_ms |
Request Latency | 스트리밍과 비스트리밍 모두 가능 |
결과로 두 지표가 나옵니다. SLO 달성률(SLO attainment) 은 모든 기준을 지킨 요청의 비율이고, 요청 goodput(request goodput) 은 그런 요청이 초당 몇 개 처리되었는지입니다. 오류가 난 요청은 달성률을 깎는 쪽으로 셉니다. 실행 시간 제한에 걸려 취소된 요청은 서버 탓이 아니므로 뺍니다. 비스트리밍 백엔드에 ttft_ms 를 거는 것처럼 잴 수 없는 기준을 주면, 두 지표는 0이 아니라 '설정되지 않음'으로 나옵니다.
문서는 저장소에 들어 있는 mock 서버(동시 처리 슬롯 16개, 종단 지연 목표 1500ms)로 측정한 예를 보여 줍니다.
| 동시성 | 초당 요청 | 초당 goodput | 달성률 |
|---|---|---|---|
| 16 | 24.6 | 24.6 | 100.0% |
| 26 | 24.4 | 23.2 | 95.1% |
| 32 | 24.3 | 19.3 | 79.6% |
동시성 16과 32의 초당 요청 수는 거의 같지만 goodput은 22% 떨어집니다. 처리량으로만 탐색하면 두 지점을 구분할 수 없다는 것이 문서의 설명입니다.
goodput 프로파일: SLO를 지키는 가장 높은 동시성 찾기
기준을 선언하면 한 부하 수준이 목표를 지키는지는 알 수 있습니다. 새 goodput 프로파일은 한 걸음 더 나아가, 목표를 지키는 가장 높은 동시성을 찾습니다. 용량 계획에서 실제로 묻는 질문이 이것입니다.
guidellm run \
  --backend kind=openai_http,target=http://localhost:8000 \
  --profile kind=goodput,target_attainment=0.99 \
  --data kind=synthetic_text,prompt_tokens=256,output_tokens=128 \
  --metrics '{"kind":"generative","slo":{"ttft_ms":200,"tpot_ms":50}}' \
  --constraint kind=max_duration,seconds=120
target_attainment 는 SLO의 "99% 요청" 부분입니다. 탐색은 어떤 수준에서 목표를 놓칠 때까지 동시성을 두 배씩 늘리고, 그다음 통과한 가장 높은 값과 실패한 가장 낮은 값 사이를 이분 탐색합니다. 저장소 소스(schemas/benchmark/profiles/goodput.py)의 기본값은 시작 동시성 4, 최대 1024, 목표 달성률 0.95, 허용 오차 10%, 최대 탐색 횟수 15회, 신뢰 수준 0.95입니다.
문서는 탐색이 요청 속도(rate)가 아닌 동시성을 바꾸는 이유도 설명합니다. 동시성은 어느 수준에서든 안정 상태에 도달합니다. 반면 서버가 감당할 수 없는 요청 속도를 주면 대기열이 끝없이 쌓이고, 그때 잰 값은 서버가 아니라 대기열을 설명하게 됩니다. 또 각 수준은 goodput이 아니라 달성률로 판정합니다. 달성률은 실제로 측정한 요청에 대한 비율이라, 측정 초반에 서버가 파이프라인을 채우는 시간의 영향을 받지 않습니다.
mock 서버로 직접 돌려 본 탐색 과정
GPU 없이 탐색이 어떻게 진행되는지 보려고, v0.8.0에 들어 있는 guidellm mock-server 를 같은 MacBook(Apple Silicon)에서 띄우고 탐색을 실행했습니다. mock 서버는 TTFT 50ms, 토큰 간 지연 10ms, 출력 128토큰으로 설정했고, 종단 지연 목표는 2500ms, 목표 달성률은 0.95, 탐색 단계마다 20초씩 측정했습니다.
| 탐색 순서 | 동시성 | 달성률 | 판정 |
|---|---|---|---|
| 1~6 | 4, 8, 16, 32, 64, 128 | 100% | 통과 |
| 7 | 256 | 92.7% | 실패 |
| 8 | 192 | 100% | 통과 |
| 9 | 224 | 99.1% | 통과 |
| 10 | 240 | 86.8% | 실패 |
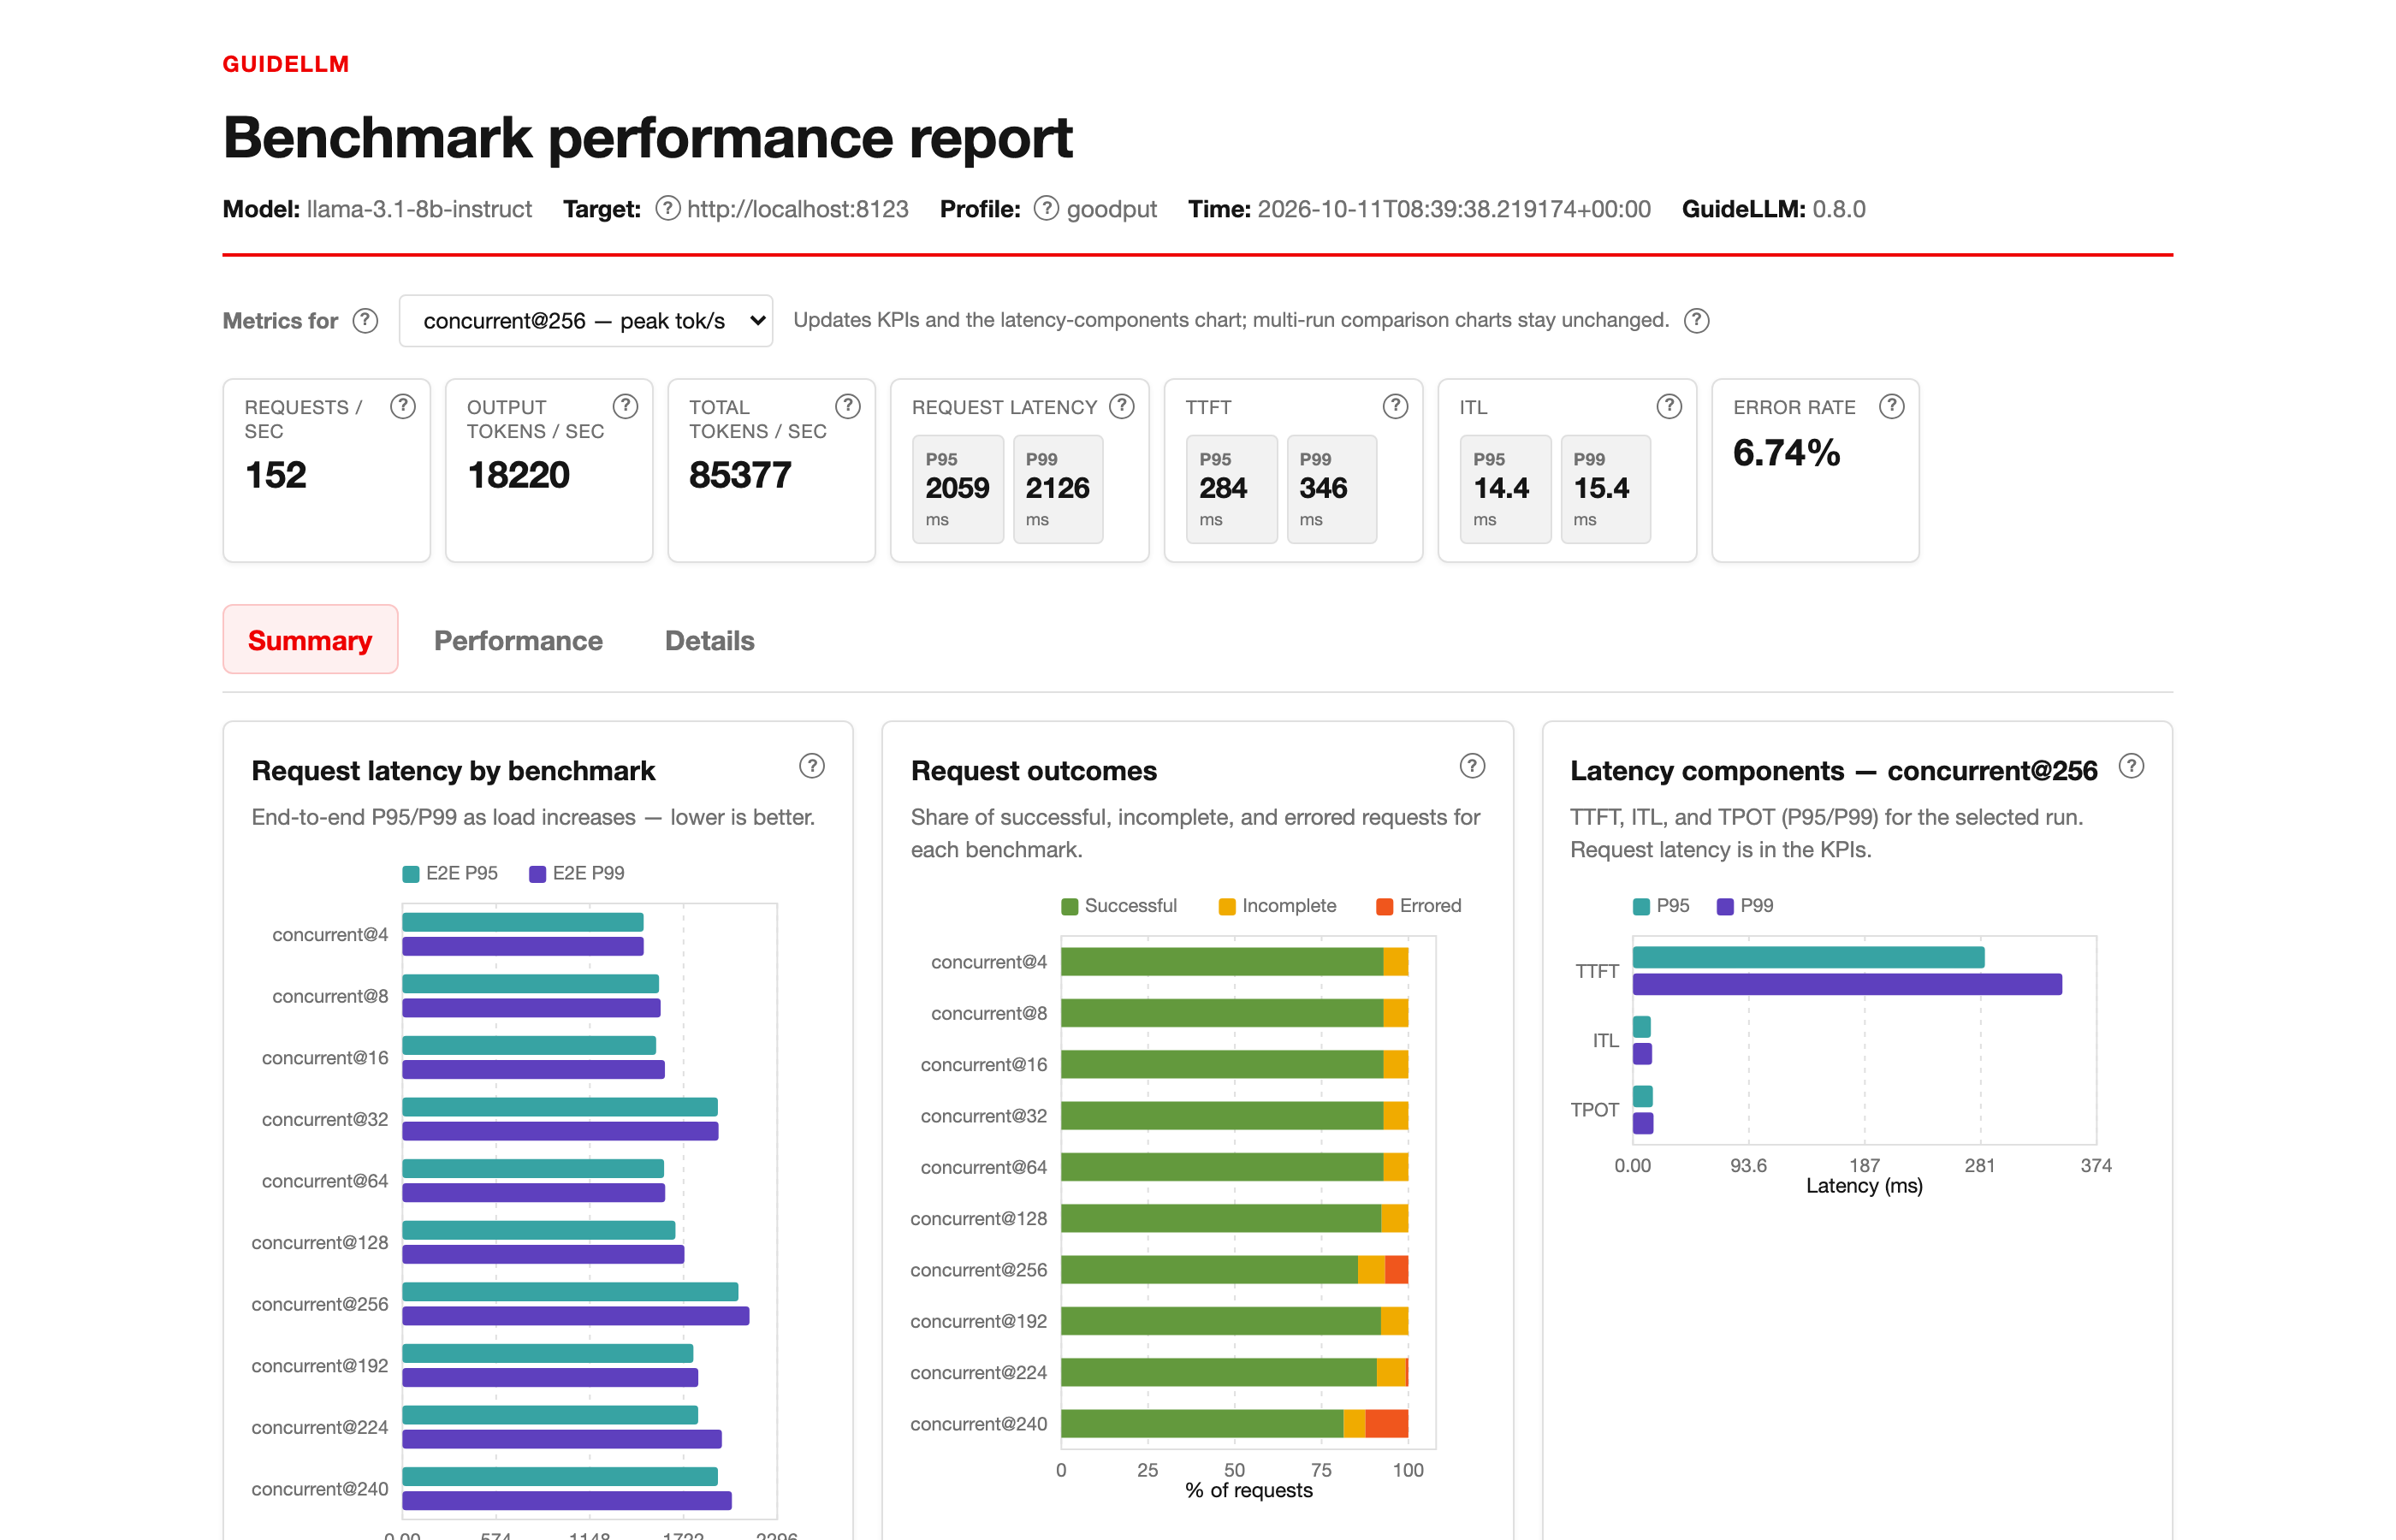
탐색은 10단계, 약 4분 만에 동시성 224에서 통과, 240에서 실패로 수렴했고(stop_reason: converged), 그 결과가 JSON 리포트의 conclusions 항목에 단계별 신뢰구간과 함께 남았습니다. 다만 이 숫자는 성능 지표가 아닙니다. mock 서버는 정해진 시간만큼 기다렸다 응답하는 가짜 서버이고, 부하 생성기와 같은 노트북에서 돌았기 때문에 실패 지점에는 노트북 자원의 한계가 섞여 있습니다. 이 실행에서 확인한 것은 탐색 알고리즘의 동작 순서와 결과가 기록되는 방식까지입니다.
눈여겨볼 점은 경고입니다. 첫 단계(동시성 4)는 달성률이 100%였는데도 GuideLLM이 다음과 같이 경고했습니다.
Goodput probe at concurrency 4 is unresolved: attainment 1.000 with 95% interval [0.931, 1.000] straddles the target 0.950. Increase the per-probe duration or request count to resolve it.
20초 동안 52개 요청만 모여 신뢰구간 하한(0.931)이 목표 0.95보다 낮았기 때문입니다. 문서에 따르면 신뢰구간이 목표에 걸치면 GuideLLM은 정확해 보이는 숫자 대신 경고를 냅니다. 탐색 횟수나 최대 동시성 한도에 걸려 멈춘 경우에도 보고된 값이 최댓값이 아니라 하한이라고 경고합니다.
신뢰구간과 표본 수: p99가 최댓값일 때
이번 릴리스는 요청 단위 지표에 신뢰구간을 붙였습니다(--metrics kind=generative,confidence=0.95). 콘솔은 평균을 80.5 ± 3.9 처럼 신뢰구간 반폭과 함께 보여 주고, 표본이 부족해 구간을 정할 수 없는 백분위수에는 * 를 붙입니다.
지표 문서는 백분위수 신뢰구간에 필요한 최소 요청 수를 신뢰 수준 0.95 기준으로 p95는 72개, p99는 368개, p999는 3688개로 제시합니다. 문서는 성공한 요청이 100개보다 적으면 보고된 p99가 사실상 가장 느린 요청 하나라고 지적합니다. 위 mock 실행에서 첫 시도 때 동시성 4, 2, 1 단계의 p95 열에 모두 * 가 붙은 것도 단계당 요청이 9~36개뿐이었기 때문입니다. 또한 이 구간은 한 번의 실행 안에서 얼마나 정밀하게 쟀는지를 말할 뿐, 같은 벤치마크를 다시 돌렸을 때의 변동을 말하지 않습니다. 실행 간 비교에는 반복 실행이 필요하다고 문서는 덧붙입니다.
에이전트 트레이스 재생: WEKA와 OTEL
왜 단일 요청 벤치마크로는 부족한가
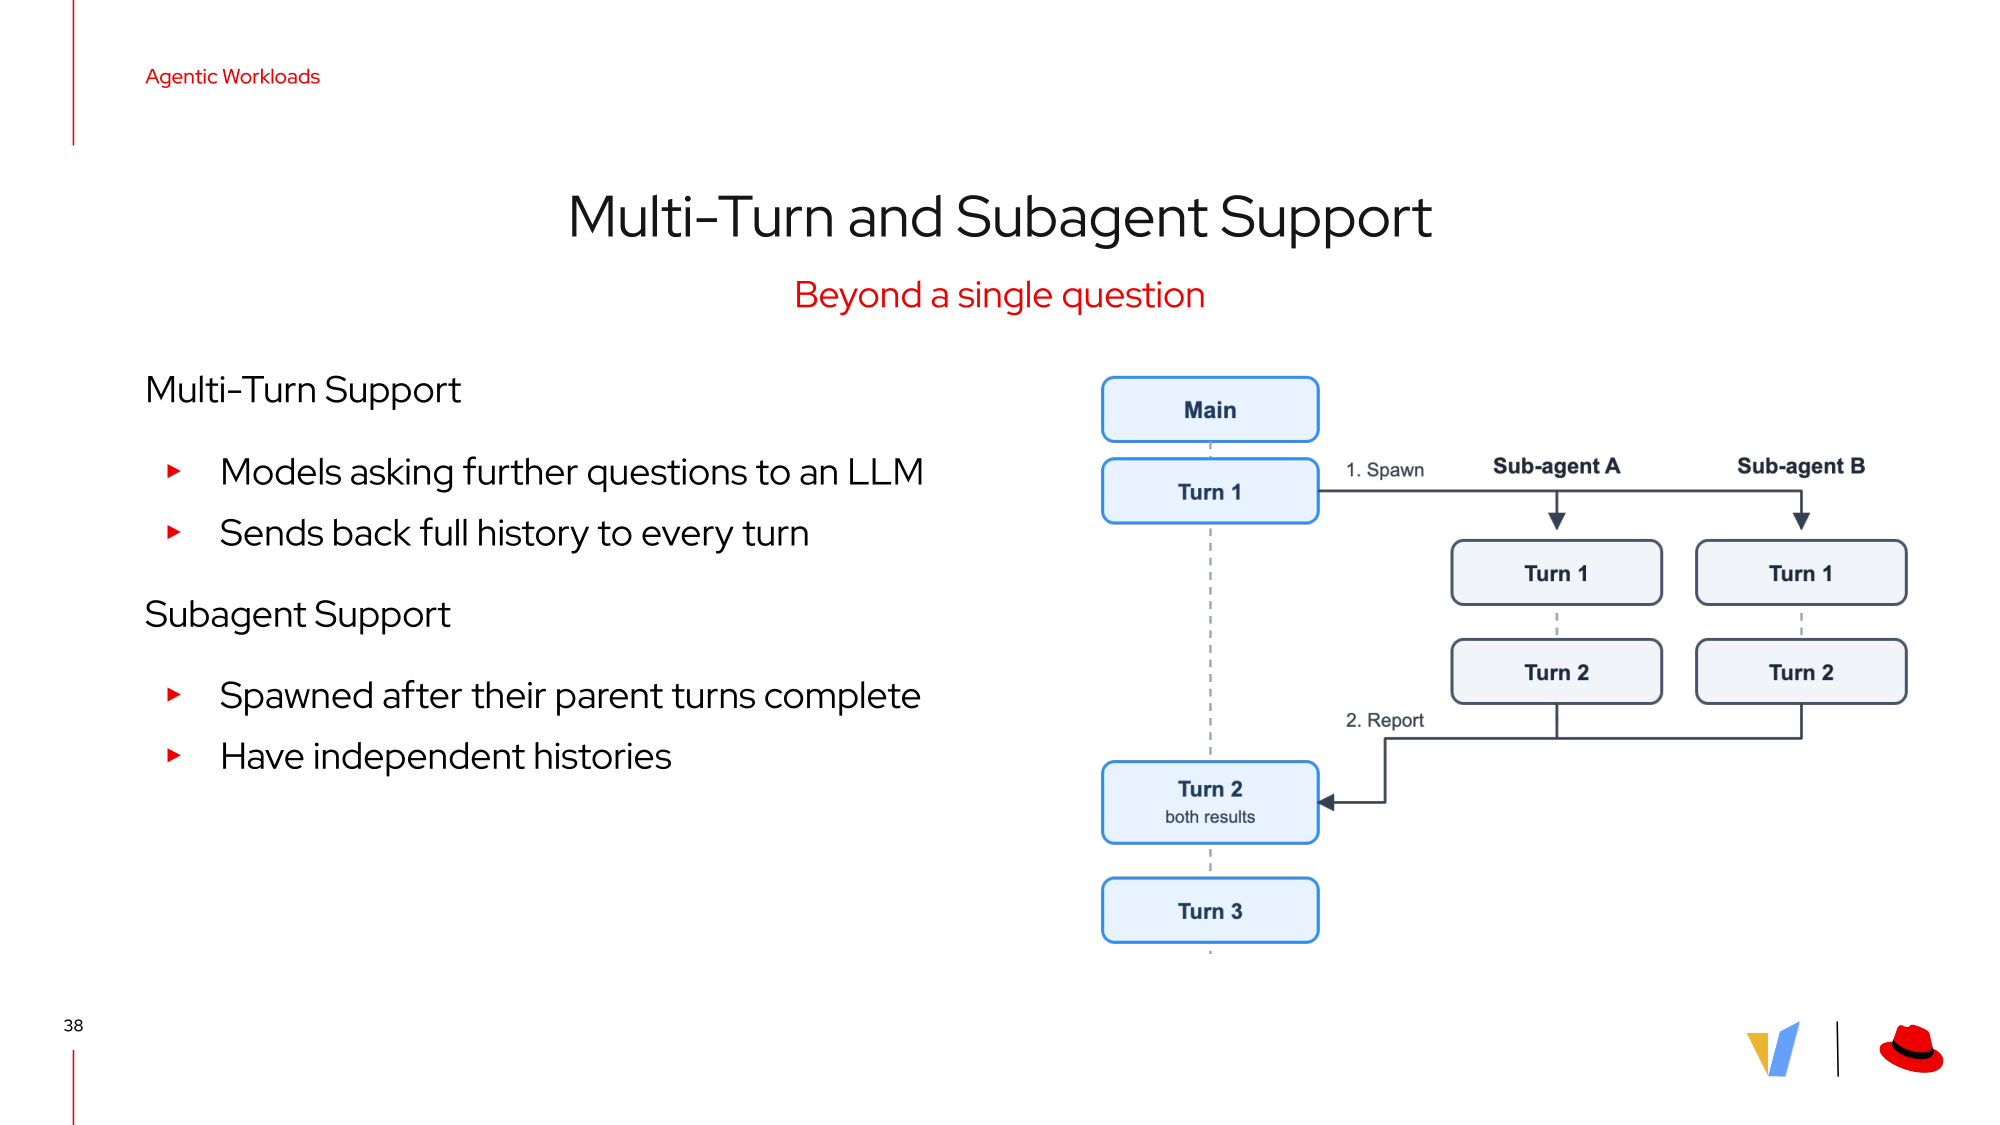
전통적인 서빙 벤치마크는 요청 하나를 보내고 그 안의 이벤트(첫 토큰, 마지막 토큰)를 잽니다. 에이전트 부하는 모양이 다릅니다. 오케스트레이터가 메인 모델과 대화하다가 서브에이전트를 실행하고, 서브에이전트는 자기 대화 기록을 따로 가진 채 도구를 부른 뒤 결과를 메인 대화에 돌려줍니다. 턴마다 이전 대화 기록 전체를 다시 보내므로 접두 문맥 캐시(prefix cache) 적중률이 성능을 크게 좌우합니다.
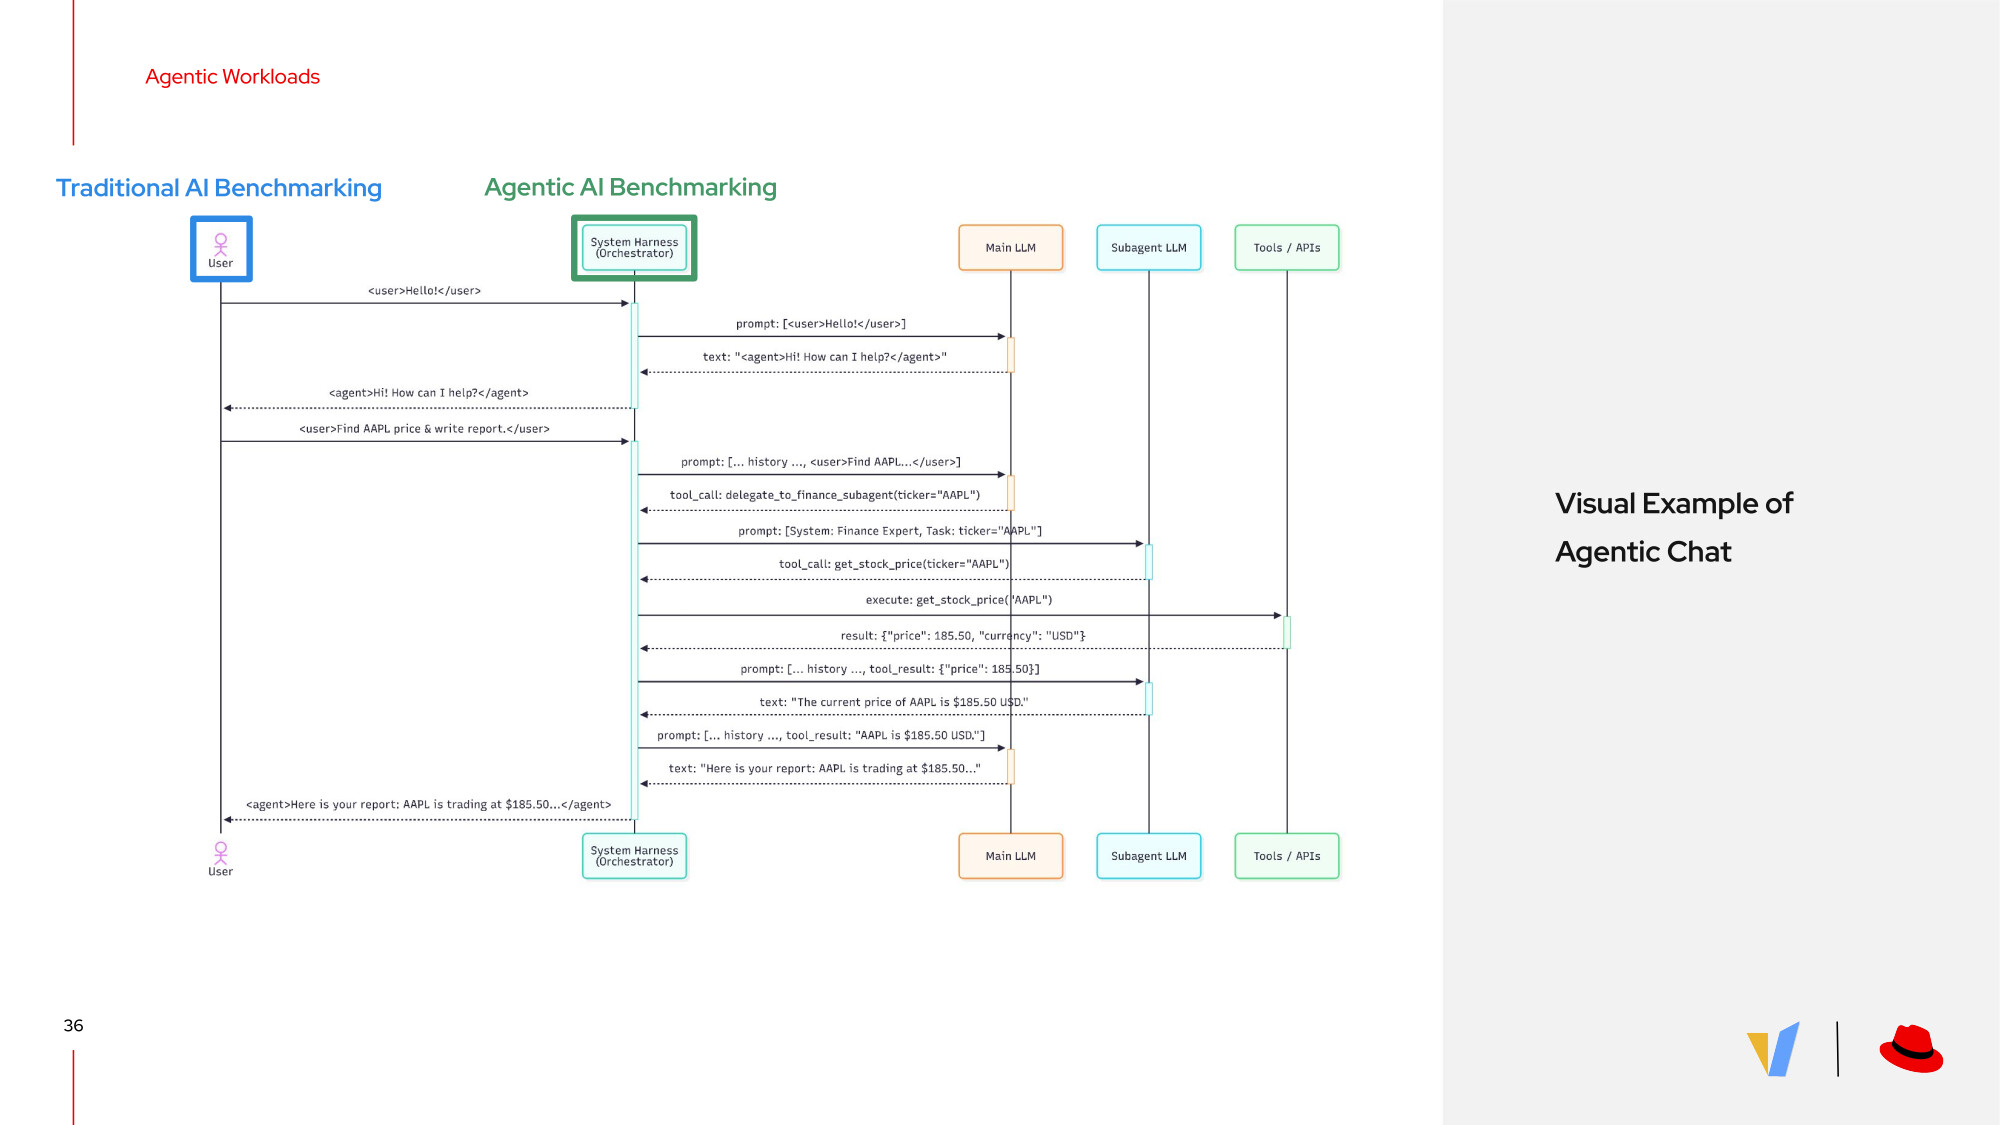
Office Hours 발표자들은 이런 부하를 합성 데이터로 흉내 내는 대신 기록된 트레이스를 재생하자고 제안했습니다. 그래야 KV 캐시 적중률과 캐시 축출(eviction) 시점까지 현실에 가깝게 재현된다는 설명입니다 (46:35). v0.7에서 Mooncake 형식 재생이 먼저 들어왔고, v0.8.0에서 WEKA와 OTEL 형식이 추가되었습니다.
지원하는 트레이스 형식
트레이스 재생은 항상 --profile kind=replay 를 쓰고, --data 에 형식(kind)과 데이터를 가져올 곳(source.kind)을 함께 지정합니다.
| 형식 | 출처 | 재생 단위 |
|---|---|---|
trace_synthetic |
시각, 입력 토큰 수, 출력 토큰 수만 있는 최소 형식 | 행 하나가 독립 요청 |
mooncake |
Mooncake 논문의 서빙 트레이스 형식 | 행 하나가 독립 요청, 해시 ID로 접두 문맥 공유 재현 |
weka |
WEKA의 Augmented Memory Grid 연구용 트레이스 형식 | 대화(세션) 단위, 서브에이전트와 도구 호출 포함 |
otel |
OpenTelemetry GenAI 스팬 | trace_id 하나가 대화 하나 |
WEKA 형식 은 WEKA의 제품 담당자가 Claude Code 세션의 KV 캐시 동작을 분석하려고 만든 형식입니다. 이 형식으로 공개된 SemiAnalysis의 Claude Code 트레이스 데이터셋은 실제 Claude Code CLI 트래픽에서 뽑은 세션 949개, 요청 136,118개(세션당 평균 143.4개)를 담고 있습니다. 이름처럼 서브에이전트 블록을 뺀 판입니다.
guidellm run \
  --backend kind=openai_http,target=http://localhost:8000 \
  --profile kind=replay \
  --data kind=weka,source.kind=huggingface,source.source=semianalysisai/cc-traces-weka-no-subagents-051226 \
  --constraint kind=max_requests,count=30
v0.8.0에서 WEKA 재생은 type: "subagent" 로 선언된 항목을 부모 턴에서 갈라져 나가는 독립 대화 사슬로 만듭니다. 같은 부모 턴 사이에 나열된 서브에이전트들은 병렬로 실행되고, 부모 대화는 그 서브에이전트가 모두 끝난 뒤에 다음 턴을 보냅니다. stop: "tool_use" 로 끝난 요청은 클라이언트 측 도구 호출 턴이 되고, 그다음 요청은 도구 결과를 주입하는 턴이 됩니다. 트레이스에는 실제 도구 스키마와 결과가 없으므로, 따로 tools 를 주지 않으면 GuideLLM의 기본 가짜 도구 정의와 {"status": "ok"} 같은 짧은 결과가 쓰입니다. 문서는 도구와 시스템 프롬프트 접두 문맥을 미리 데워 두는 기능과 평탄화된 에이전트의 해시 ID 분할은 아직 구현되지 않았다고 밝힙니다.
긴 Claude Code 세션은 측정할 모델의 컨텍스트 길이를 넘을 수 있습니다. 이때는 WEKA 데이터 인자 max_context_len 으로 대화별 누적 입력과 출력 토큰의 상한을 정합니다(PR #1177). 상한을 넘는 턴부터 그 대화의 나머지 턴은 버려지고, 첫 턴부터 넘는 대화는 통째로 건너뜁니다. 이 인자는 v0.8.0 소스에는 있지만 문서의 WEKA 인자 표에는 아직 없습니다.
OTEL 형식 은 OpenTelemetry GenAI 규약으로 기록된 스팬을 읽습니다. 성공한 LLM 호출 스팬만 재생하고, execute_tool 스팬은 HTTP 요청으로 보내지 않습니다. 각 LLM 스팬은 그 시점의 전체 입력을 담은 스냅숏이라, 이를 요청으로 바꾸는 방법을 history 로 고릅니다.
history=trace (기본값) |
history=runtime |
|---|---|
| 스팬에 기록된 메시지 전체를 그대로 보냄 | 새로 추가된 메시지만 보내고, 앞 턴은 실시간 응답으로 채움 |
| 가장 정확하지만, 실시간 응답이 기록과 달라진 뒤로는 접두 문맥 캐시가 깨짐 | 캐시에 유리하지만, 실시간 모델 응답이 기록과 달라질수록 정확도가 떨어짐 |
OTEL 재생은 /v1/chat/completions 로만 동작합니다. /v1/completions 나 /v1/responses 로 보내면 빈 요청을 보내지 않고 오류로 중단합니다. 문서는 바로 쓸 수 있는 공개 데이터셋으로 IBM Research의 합성 대화 트레이스 등을 소개합니다. 이 트레이스는 세션마다 LLM 호출이 30~50개이므로, 첫 실행에는 max_requests 로 상한을 두라고 안내합니다. 이 IBM 데이터셋은 CC-BY-NC-4.0과 Llama 3 커뮤니티 라이선스를 따르므로 상업적 용도로는 쓸 수 없고, 위 SemiAnalysis 데이터셋은 Apache-2.0입니다.
기록된 시간을 따르므로 길어질 수 있습니다
mock 서버에 IBM 트레이스를 max_requests=30 으로 재생해 보니, 오류 없이 끝났지만 요청 30개를 처리하는 데 약 110초가 걸렸고 중앙값 동시성은 0이었습니다. 기본 재생 방식(schedule_turn=idle_gap)이 기록된 요청 사이의 쉬는 시간을 그대로 지키기 때문입니다. 따라서 트레이스를 그대로 재생하면 서버에 걸리는 부하가 생각보다 가벼울 수 있습니다.
부하를 높이는 손잡이는 --data 에 있습니다. 문서는 먼저 min_concurrent_sessions (동시에 겹치는 세션 수의 하한), 대기 시간 상한(max_wait, max_session_wait), time_scale (간격 배율, 0.5면 두 배 빠르게)을 조정하라고 권합니다. 그래도 데이터가 측정 시간에 비해 짧을 때만 copies 로 데이터셋을 여러 번 이어 재생합니다. 이때 해시 ID 기반 형식(mooncake, weka)은 재생 회차마다 토큰 블록 표를 따로 만들어, 앞 회차의 토큰을 재사용해 캐시 적중률이 부풀려지지 않게 합니다. 문서는 병렬도를 높일수록 캐시 축출이 벤치마크에 끼어들 가능성도 커진다고 경고합니다.
그 밖의 변경 사항
최소 요청 수 제약(min_requests): max_requests 는 정해진 수에 도달하면 새 요청을 멈추기 때문에, 끝부분에서 진행 중인 요청만 남아 처리율이 떨어집니다. min_requests 는 지정한 수의 요청이 완전히 끝날 때까지 계속 새 요청을 넣고 그 시점에 멈춥니다. 릴리스 노트는 이를 max_seconds 처럼 끝까지 요청률을 유지하는 장점으로 설명합니다.
단일 파일 HTML 리포트: --output kind=html 은 처리량과 지연 차트, 표를 CSS와 JavaScript까지 담은 HTML 파일 하나로 만듭니다. 발표자들은 이전 HTML 출력이 "다루기 까다로웠다"며 가볍게 다시 만들고 있다고 예고했습니다 (48:37). 아래는 위 goodput 탐색 실행으로 만든 리포트의 첫 화면입니다. --output 을 지정하면 기본 출력(JSON, CSV)이 대체되므로, 모두 받으려면 형식마다 --output 을 반복해야 합니다.
진행 로그 기본 출력: 화면 표시를 쓸 수 없는 비대화형 셸에서도 벤치마크 진행 상황이 INFO 로그로 남습니다. 각 단계의 시작과 끝, 그리고 진행 중에는 최대 10초마다 성공, 오류, 미완료 요청 수와 처리율을 기록합니다. 별도 옵션은 필요 없고, --disable-console 은 화면 표시만 끕니다.
SQLite 데이터 소스: --data kind=db_file 에 SQLAlchemy 형식 URI와 SQL 쿼리를 주면 데이터베이스 행을 프롬프트로 씁니다. 현재는 SQLite URI만 지원합니다.
vLLM 배치 백엔드(vllm_python_batch): vLLM의 동기식 LLM 엔진으로 요청을 모아 LLM.generate() 한 번에 보냅니다. 스트리밍을 지원하지 않으므로 TTFT는 잴 수 없고, 문서는 요청별 지연보다 전체 처리량이 중요한 측정에 맞는다고 설명합니다. 기본 batch_size 는 32, 부분 배치를 내보내기까지 기다리는 batch_timeout 은 0.01초입니다.
새 지표: 요청이 예정 시각보다 얼마나 늦게 나갔는지를 재는 dispatch delay와 이를 앞 턴 대기분과 나머지로 나눈 지표, 예정 시각부터 응답 완료까지의 scheduled latency가 추가되었습니다. 부하 생성기 자체가 병목인지 판단하는 데 쓰는 값입니다. 이 지표들은 도착 일정이 있는 constant, poisson, 트레이스 재생에서만 뜻이 있고, synchronous, concurrent, throughput 에서는 0이 아니라 null 로 기록됩니다. 이 밖에 응답의 cached_tokens 수집, WebSocket 백엔드의 왕복 지연(Time To Last Round Trip, Avg RTT), 멀티턴 대화의 턴 위치별 지표가 들어왔습니다.
내장 시나리오 교체: 7개 시나리오가 모두 concurrent 프로파일 기반으로 바뀌었습니다. 예를 들어 rhaiis/concurrent-1k-1k-equal 은 입력 1,000토큰, 출력 1,000토큰으로 동시성 1, 50, 100, 200, 300을 각각 450초씩 측정합니다. rhaiis/concurrent-1k-1k-multiturn 은 5턴 대화와 접두 문맥 캐시를, rhaiis/concurrent-100k-1k-equal 은 입력 10만 토큰을 다룹니다. 단계마다 450초이므로 시나리오 하나가 30분을 넘길 수 있습니다(concurrent-2ki-128-equal 만 45초).
업그레이드 전에 확인할 것
v0.7.x에서 쓰던 명령과 스크립트는 다음 지점에서 깨질 수 있습니다. 아래 두 오류는 v0.8.0을 설치해 직접 재현했습니다.
--profile을 지정해야 합니다. 이전에는 생략하면sweep이 실행되었습니다. v0.8.0은 "프로파일을 기본으로 정해 두는 것이 도움보다 혼란이 크다"는 이유로 이 기본값을 없앴습니다(PR #1135). 생략하면Error: Invalid value for '--profile': - Field required로 실행이 거부됩니다. v0.8.0 문서의 시작하기 기본 예제는 아직--profile없이 "sweep프로파일(기본값)을 실행한다"고 적고 있으므로, 예제를 복사할 때--profile kind=sweep을 직접 붙여야 합니다.- 예전 내장 시나리오(
chat,rag) 이름을 바꿔야 합니다. README의--config chat예제를 실행하면'chat' is not one of 'rhaiis/concurrent-1k-1k-equal', ...오류가 납니다. 새 이름 7개 중 하나를 쓰거나, 예전 설정을 YAML이나 JSON 파일로 옮겨 경로로 넘겨야 합니다. - 작업 프로세스를 만드는 기본 방식이
spawn으로 바뀌었습니다(PR #1058). v0.8.0 설정에서 고를 수 있는 값은spawn과forkserver이고,GUIDELLM__MP_CONTEXT_TYPE환경 변수로 바꿉니다. - v0.8.1을 쓴다면,
'{"kind":"concurrent","streams":[1,2,3]}'처럼 프로파일 안에 목록을 넣는 방식이 폐기 예정 경고를 냅니다. 릴리스 노트는--profile kind=concurrent --override profile.streams 1,2,3형태를 권장합니다. v0.8.0 문서의 일부 예제가 아직 목록 방식을 씁니다.
설치는 릴리스 노트대로 버전을 고정할 수 있습니다. 버전을 적지 않으면 현재는 v0.8.1이 설치됩니다.
pip install guidellm[recommended]==0.8.0
8월 Office Hours의 예고와 실제 v0.8.0 비교
Office Hours 슬라이드는 v0.8.0의 목표 출시일을 9월 30일로 적었고, 실제로 그날 공개되었습니다. 발표에서 예고한 항목과 릴리스를 대조하면 다음과 같습니다.
| 8월 발표의 v0.8.0 예고 | v0.8.0 실제 |
|---|---|
| WEKA 완전 지원 (46:35) | 서브에이전트와 도구 호출 포함 재생 지원. 접두 문맥 예열 등 일부 미구현 |
| OTEL은 "향후 계획" | v0.8.0에 포함 |
| 트레이스 "복제"로 부하 늘리기 | copies, copy_offset 옵션으로 포함 |
| HTML 출력 개편 (48:37) | 단일 파일 HTML 리포트로 포함 |
| 정적 그래프 출력 | v0.7.2(7월 23일)에 이미 --output kind=plot 으로 포함(PR #923) |
| vLLM 배치 API 백엔드 | vllm_python_batch 로 포함 |
| LiteLLM SDK 백엔드 | 미포함. 해당 PR #800은 10월 11일 현재 열려 있음 |
발표 슬라이드의 지원 백엔드 목록에는 LiteLLM SDK가 들어 있었지만, v0.8.0과 v0.8.1 소스에는 LiteLLM 백엔드가 없습니다. 같은 슬라이드는 v0.9.0(2026년 4분기 목표)의 세 가지 계획을 적었습니다. vLLM-Omni 벤치마크를 위한 이미지와 음성 출력 지원, vLLM /metrics 같은 외부 지표를 받기 위한 지표 구조 개편, 성능에 민감한 코드를 Rust로 옮기기 위한 빌드 통합입니다 (48:37).
영상의 질의응답에는 측정 데이터 선택에 관한 실무 조언도 있었습니다 (50:45). 접두 문맥 캐시가 꺼져 있다면 입력 내용은 크게 상관없고 토큰 수만 맞으면 됩니다. 그러나 캐시를 켜면 데이터셋이 실제보다 캐시를 더 많이 또는 더 적게 타지 않는지 확인해야 하고, 합성 데이터는 적중률을 조절할 수 있어 도움이 됩니다.
투기적 디코딩(speculative decoding) 은 작은 초안 모델이 토큰을 먼저 제안하고 큰 모델이 검증하는 방식입니다. 이를 측정할 때 무작위 토큰을 넣으면 제안이 거의 맞지 않아 실제보다 낮은 성능이 나옵니다. 발표 당시 GuideLLM은 투기적 디코딩 지표를 내지 못했고, 발표자는 vLLM이 API 응답에 그 지표를 담아 주지 않기 때문이라고 설명했습니다 (51:46). 같은 자리에서 한 참석자는 Speculators가 GuideLLM을 내부에서 사용해 투기적 디코딩 지표를 얻는 평가 도구를 제공한다고 덧붙였습니다.
그 뒤 v0.8.0에 들어간 PR #1159는 vLLM 0.29를 --per-request-spec-decode-metrics summary 로 실행했을 때 응답에 실리는 요청별 수용률 지표를 요청 기록의 response_metrics 필드에 그대로 남깁니다. GuideLLM이 이 값을 통계로 집계하지는 않으며, vLLM은 이 형식을 실험 기능으로 표시합니다.
GPU 없이 먼저 익혀 보기
GuideLLM에는 OpenAI 호환 API를 흉내 내는 mock 서버가 들어 있어, GPU나 모델 없이 명령 형식과 출력 구성을 먼저 익힐 수 있습니다. 아래는 이 글의 실행에 쓴 절차입니다(Python 3.10~3.13, Linux 또는 macOS).
-
가상 환경에 v0.8.0을 설치합니다.
pip install guidellm[recommended]==0.8.0 -
터미널 하나에서 mock 서버를 띄웁니다.
guidellm mock-server --port 8123 --ttft-ms 50 --itl-ms 10 --output-tokens 128 -
다른 터미널에서 goodput 탐색을 실행합니다. mock 서버의 기본 모델명은 Hugging Face에서 받을 수 없는 이름이므로, 합성 데이터의 토큰 수를 세는 토크나이저를
gpt2로 지정해야 합니다.guidellm run \ --backend kind=openai_http,target=http://localhost:8123 \ --profile kind=goodput,target_attainment=0.95 \ --data kind=synthetic_text,prompt_tokens=256,output_tokens=128 \ --tokenizer kind=huggingface_auto,model=gpt2 \ --metrics '{"kind":"generative","slo":{"e2el_ms":2500}}' \ --constraint kind=max_duration,seconds=20 \ --output kind=json,path=goodput.json \ --output kind=html,path=goodput.html -
goodput.json의conclusions항목에서 단계별 판정을 확인하고,goodput.html을 브라우저로 엽니다.
실제 서버를 측정할 때는 target 을 vLLM 서버 주소로 바꾸고, 측정 결과가 신뢰구간 경고 없이 나올 만큼 max_duration 을 늘립니다. 측정 결과에 dispatch delay가 크게 나오면 서버보다 부하 생성기가 먼저 한계에 닿았다는 뜻이므로, 부하 생성기를 서버와 다른 머신에서 돌려야 합니다.
같은 문제를 다른 방식으로 푸는 도구도 있습니다. PyTorchKR에서 소개한 NVIDIA의 AIPerf는 부하 생성기가 병목이 되지 않도록 설계한 벤치마크 도구입니다. BentoML의 LLM Optimizer는 지연 제약 안에서 서빙 설정을 찾는 데 초점을 둡니다. GuideLLM README의 비교표는 쿠버네티스 SIG의 inference-perf 등과 기능을 나란히 비교합니다.
GuideLLM 문서는 이번 릴리스부터 시작하기 절의 중국어 번역을 시범으로 제공합니다. GuideLLM 프로젝트는 번역 정책 문서에서 유지 비용을 평가한 뒤 확대를 검토하겠다고 밝혔습니다. 한국어 문서는 아직 없습니다.
라이선스
GuideLLM은 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
 GuideLLM v0.8.0 문서
 GuideLLM v0.8.0 릴리스 노트
 GuideLLM GitHub 저장소
 vLLM Office Hours #56, GuideLLM v0.7: Benchmarking Reasoning and Agentic Traces YouTube 영상
더 읽어보기
-
AIPerf: 서버 성능 측정 시, 부하 생성기가 병목이 되지 않도록 NVIDIA가 개발 및 공개한 LLM 추론 벤치마크 도구
-
LLM Optimizer: 다양한 LLM의 추론 성능을 벤치마킹하고 최적화하는 도구 (feat. BentoML)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
