핵심 요약
- vLLM-Omni 기술 보고서는 텍스트, 음성, 이미지, 영상, 로봇 행동을 출력하는 모델을 여러 스테이지(stage)의 파이프라인으로 봅니다. 그리고 오케스트레이터 하나가 요청 수락, 스테이지 진행, 스트리밍, 완료를 관리하는 구조를 설명합니다. 코드는 vLLM-Omni GitHub 저장소에 Apache-2.0 라이선스로 공개되어 있습니다.
- 대상 독자는 옴니 모델, TTS 모델, 확산 모델을 서로 다른 서버로 실행해 연결하고 있는 서빙 담당자입니다. 프로세스마다 파이프라인 하나를 올리되, 모든 모델을 같은 런타임과 OpenAI 호환 API, 로봇용 OpenPI 프로토콜로 노출하는 방법을 확인할 수 있습니다.
- 평가는 vLLM-Omni 팀의 멀티모달 nightly CI(H100)와 별도 H200 측정에서 나왔고, 대부분 vLLM-Omni의 기본 배포와 옵트인 프로필을 비교합니다. SGLang-Omni 같은 다른 프레임워크와의 비교는 이번 판에서 제외했습니다.
- Qwen3-Omni에서 스테이지 사이 청크 스트리밍(
async_chunk)을 끄면 동시 요청 32개에서 첫 토큰 지연이 508 ms에서 3{,}420 ms로 늘었습니다. Qwen3-TTS를 GPU 1장의 단일 스테이지로 합친 프로필은 GPU 2장의 기본 배포보다 처리량이 높았습니다. 가장 큰 차이는 CustomVoice 동시 요청 64개의 2.6\times 였고, 음성 복제(Base)는 같은 조건에서 1.66\times 였습니다. 반면 일부 옵트인 프로필은 시작 단계 오류, 요청 실패, 발화가 멈추지 않는 문제를 함께 보고했습니다.
vLLM-Omni 기술 보고서 소개
vLLM-Omni 기술 보고서는 텍스트 외에 음성, 이미지, 영상, 로봇 행동까지 출력하는 생성 모델을 하나의 서빙 런타임에서 운영하기 위한 시스템 구조와 측정 결과를 정리한 문서입니다. 음성으로 대화하는 비서 하나를 서비스한다고 생각해 봅시다. 사용자의 말을 이해해 답을 텍스트로 만드는 모델, 그 답을 음성 코덱으로 바꾸는 모델, 코덱을 파형으로 복원하는 모델이 차례로 동작해야 합니다. 그런데 사용자는 마지막 단계가 끝나기 전에 첫 소리를 듣고 싶어 합니다.
텍스트 디코드 루프 하나로는 담기지 않는 모델들
최근 생성 모델은 출력 형태뿐 아니라 실행 방식도 서로 다릅니다. 연구팀이 정리한 대표 유형은 다음과 같습니다:
- 옴니 모델: Qwen3-Omni는 다단계 자기회귀(Autoregressive, AR) 파이프라인입니다. 텍스트를 생성하는 thinker 스테이지, 음성 코덱을 만드는 talker 스테이지, 파형을 복원하는 디코더(code2wav)가 차례로 이어집니다.
- TTS 모델: AR 기반 코덱 예측기 뒤에 플로우 매칭(flow matching)이나 보코더(vocoder) 스테이지가 붙고, 첫 음성 패킷을 빨리 내보내려고 청크 단위로 스트리밍합니다.
- 이미지와 영상 생성 모델: 확산 트랜스포머(Diffusion Transformer, DiT)나 플로우 매칭 디노이저를 여러 스텝 반복하며, 앞단에 AR 이해 모델이 붙는 경우도 있습니다.
- 월드 모델: 과거 프레임과 조건으로 다음 영상을 예측하고, 예측한 프레임이 다음 스텝의 조건으로 다시 들어갑니다.
- VLA(Vision-Language-Action) 모델: 관측과 지시를 받아 로봇 행동 청크를 반복해서 출력합니다.
서빙 시스템 입장에서는 배치 방식과 메모리 사용 방식이 다른 스테이지가 한 요청 안에 섞이고, 입력과 출력의 연결도 복잡해집니다. 전이중(full-duplex) 음성 에이전트는 말하는 동안에도 사용자의 음성을 계속 받아야 하고, 로봇 루프는 계속 바뀌는 센서 입력에 맞춰 행동을 스트리밍해야 합니다.
기존 서빙 스택의 한계
vLLM이나 SGLang 같은 LLM 서빙 시스템은 AR 디코딩, KV 캐시 관리, 연속 배칭(continuous batching)에 최적화되어 있고 멀티모달 입력도 받습니다. 하지만 별도의 생성기를 거쳐 음성, 픽셀, 행동을 출력하는 다단계 파이프라인을 기본 실행 단위로 설계하지는 않았습니다.
확산 모델 쪽 스택(Diffusers, xDiT 등)은 디노이징 반복, 캐시, 병렬화를 깊게 최적화합니다. 그러나 AR 스테이지, 스테이지 사이 데이터 전달, 세션 단위 상호작용을 함께 다루는 공통 제어 평면(control plane)은 없습니다.
그래서 실제 배포에서는 서로 다른 런타임을 임시로 이어 붙이는 경우가 많습니다. 연구팀은 이렇게 하면 요청 수락과 수명 주기 관리 로직이 서비스마다 중복되고, 스테이지 단위 스트리밍과 KV 전달을 하나의 요청으로 관리할 수 없다고 지적합니다. Ray Serve나 Triton 앙상블 같은 범용 연결 도구도 임의의 스테이지를 이을 수는 있습니다. 하지만 음성의 첫 패킷 지연이나 전이중 세션 수락 같은 문제는 애플리케이션이 직접 풀어야 합니다.
이 보고서가 다루는 범위
vLLM-Omni는 2025년 11월 vLLM 커뮤니티가 공개한 프로젝트입니다. PyTorchKR에서도 vLLM-Omni 공개 소식으로 공개 당시의 구조를 소개한 적이 있습니다. 2026년 2월에 나온 첫 논문 vLLM-Omni: Fully Disaggregated Serving for Any-to-Any Multimodal Models는 스테이지 그래프, 분리된 엔진, 커넥터 기반 데이터 전달을 제안했습니다. 이 논문은 기준 방법 대비 작업 완료 시간(Job Completion Time, JCT)을 최대 91.4\% 줄였다고 보고했습니다.
이번 기술 보고서는 스테이지 추상화를 유지한 현재 구조를 설명합니다. 달라진 점은 오케스트레이터, 스트리밍 진행, 스테이지 복제 풀, 중간 데이터 이동, 세션을 런타임이 직접 관리한다는 것입니다. 핵심 분업은 한 문장으로 요약됩니다: 스테이지는 모델 구성 요소 하나와 실행 엔진 하나, 자원 예산을 가지고, 오케스트레이터는 요청 수락, 스테이지 간 진행, 클라이언트에 보이는 출력을 맡습니다.
vLLM-Omni의 시스템 구조
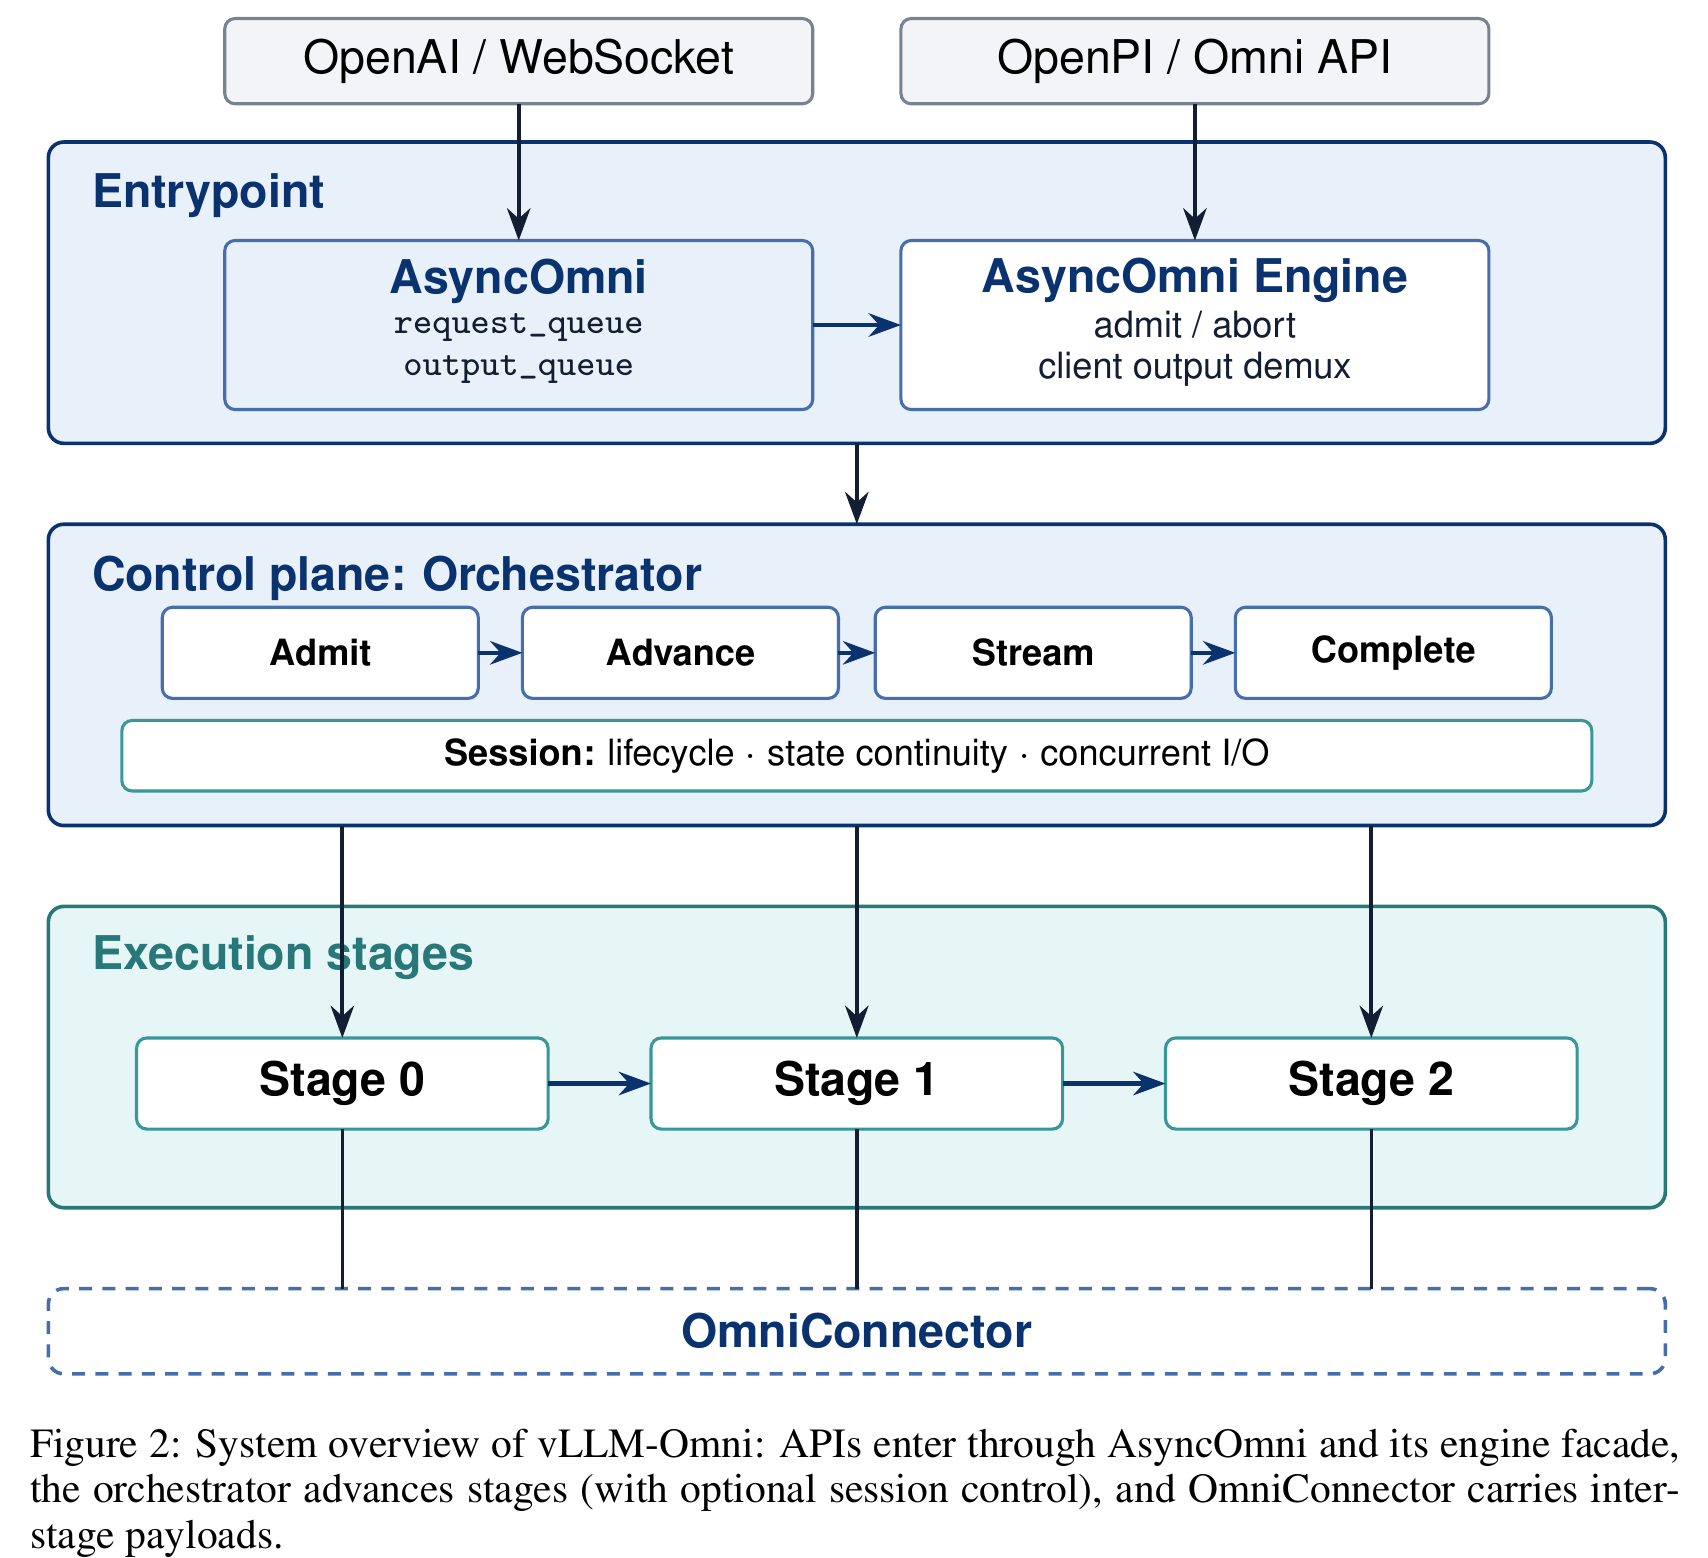
그렇다면 서로 다른 실행 방식의 모델이 어떻게 한 런타임을 공유할까요? 연구팀이 공개한 전체 구조는 아래 그림과 같습니다.
오케스트레이터와 스테이지의 역할 분리
오케스트레이터가 결정하는 것은 세 가지입니다: 다음에 어느 스테이지를 실행할지, 어느 복제본(replica)에 작업을 보낼지, 그리고 결과를 클라이언트에 보낼지 다음 스테이지로 넘길지입니다. 반대로 스테이지 안의 토큰 스케줄링, 페이지 단위 KV 관리, 디노이징 스텝, 큰 텐서 복사는 하지 않습니다. 이런 일은 실행 엔진과 OmniConnector가 맡습니다. 토큰화와 멀티모달 전처리도 진입점에서 미리 끝내므로, 오케스트레이터의 제어 루프는 실행 준비가 끝난 요청만 받습니다.
배포 설정은 세 층으로 구성합니다. 파이프라인 레지스트리는 모델 종류마다 논리 스테이지와 기본 엔진을 선언하고, 배포 오버레이(deploy overlay)는 배치 위치, 커넥터, 스트리밍 여부, 하드웨어 설정을 파이프라인을 고치지 않고 덮어씁니다. 선택적인 병렬 전략은 텐서 병렬, 데이터 병렬, 스테이지 복제 수를 실제 장치 배치로 펼칩니다. 모델 구조와 클러스터 배치를 분리한 설계입니다.
요청의 완료 조건도 단순한 "마지막 스테이지 도착"이 아닙니다. 요청마다 최종 출력 스테이지 집합이 있고, 그 집합의 모든 스테이지가 끝나야 요청이 완료됩니다. 그래서 옴니 음성 요청은 thinker의 텍스트를 계속 스트리밍하는 동안 파형 복원이 오디오를 만들 수 있고, 두 출력이 모두 끝난 뒤에 완료됩니다.
스테이지를 넘기는 두 방식: 배치 전달과 async_chunk
요청이 들어오면 오케스트레이터는 스테이지 0에 작업을 제출하고 스테이지 출력을 폴링합니다. 폴링 대신 출력이 생길 때 깨어나는 이벤트 방식도 있는데, 2단계 Qwen3-TTS 파이프라인에서는 이것이 기본값이고 다른 파이프라인에서는 선택 사항입니다. 각 출력은 클라이언트로 보낼지, 다음 스테이지로 넘길지, 또는 둘 다 할지 판정됩니다.
다음 스테이지로 넘기는 방식은 두 가지입니다:
- 배치(전체 페이로드) 전달: 앞 스테이지가 끝난 뒤 오케스트레이터가 다음 스테이지 요청을 만들어 제출합니다.
async_chunk: 오케스트레이터가 받는 쪽 스테이지에 자리표시자(placeholder) 요청을 미리 제출해 둡니다. 앞 스테이지가 토큰이나 코덱 프레임을 만드는 즉시 워커가 커넥터로 청크를 발행하고, 뒤 스테이지가 이를 받아 바로 디코딩합니다. 오케스트레이터는 수명 주기만 관리하고, 청크마다 제어 평면으로 다시 전달하지 않습니다.
연구팀은 async_chunk를 첫 오디오 패킷까지의 지연(Time To First Packet, TTFP)을 줄이는 주된 장치로 설명합니다. 배치 방식에서는 talker가 발화 전체의 코덱을 다 만들 때까지 파형 디코더가 기다려야 하지만, 청크 방식에서는 코덱 예측과 파형 복원이 겹쳐서 진행됩니다. 어떤 연결(edge)을 스트리밍할지는 파이프라인 설정에서 연결마다 고를 수 있습니다.
클라이언트 쪽 스트리밍도 같은 요청 ID 안에서 처리합니다. 스트리밍 입력의 첫 청크는 이어 받을 수 있는(resumable) 스테이지 0 요청이 되고, 이후 청크는 같은 ID의 업데이트로 추가됩니다. 입력 종료 신호가 오면 더 이상 붙지 않고, 모르는 ID로 온 업데이트는 버립니다. 늦게 도착한 청크가 이미 취소된 요청을 되살리지 못하게 하려는 장치입니다. 또한 클라이언트가 텍스트만 요청하면, 이를 선언한 옴니 파이프라인에서는 talker와 code2wav 스테이지를 건너뜁니다.
실행 엔진과 스테이지 복제
확산이 아닌 스테이지는 vLLM의 워커와 스케줄러를 재사용합니다. thinker나 talker처럼 연속 배칭과 KV 캐시가 필요한 스테이지는 AR 워커가, code2wav처럼 어휘 로짓 대신 텐서를 출력하는 스테이지는 생성 워커가 실행합니다. 스테이지마다 vLLM V1 러너와 실험적인 Model Runner V2(MRv2) 중 하나를 고를 수 있어 한 파이프라인 안에 둘을 섞을 수 있습니다. CUDA에서 Qwen3-TTS의 기본 배포는 MRv2를 쓰고, Qwen3-Omni, MiniCPM-o 4.5 턴 모드, Higgs Audio v3, CosyVoice3 등은 V1이 기본이며 MRv2는 옵트인 프로필로 제공됩니다. CUDA가 아닌 플랫폼은 V1에 머뭅니다.
확산 스테이지는 별도의 확산 엔진에서 실행됩니다. 호환되는 작업끼리 배치를 묶고, 일부 파이프라인은 디노이징 스텝 사이에서도 연속 배칭을 지원합니다. 중간 프레임 스트리밍이나 요청 중간 취소가 필요하면 디노이징 스텝 하나하나가 스케줄 단위가 됩니다. TeaCache, Cache-DiT 같은 스텝 캐시와 시퀀스 병렬, CFG(Classifier-Free Guidance) 병렬은 오케스트레이터가 아니라 이 엔진 안에서 적용됩니다. 월드 모델처럼 확산 실행과 요청을 넘나드는 KV 상태가 함께 필요한 경우를 위해, vLLM 블록 매니저 위에 페이지 단위 KV 풀을 둔 AR-확산 백엔드도 선택적으로 제공합니다.
용량은 스테이지마다 하나씩 있는 StagePool로 늘립니다. 풀은 여러 복제 엔진을 가지며, 한 요청을 같은 복제본에 고정(sticky affinity)해서 스트리밍 업데이트, 멀티턴 입력, 스테이지 내부 KV가 같은 곳에 머물게 합니다. 아직 고정되지 않은 요청은 라운드 로빈이나 최소 대기열 같은 부하 분산 정책을 따릅니다. 텐서 병렬, 데이터 병렬, 파이프라인 병렬, 전문가 병렬은 각 복제본 안에서 적용됩니다. 그래서 운영자는 thinker 용량과 보코더 용량을 따로 늘릴 수 있습니다.
스테이지 사이를 오가는 데이터: 네 가지 페이로드와 OmniConnector
스테이지끼리 주고받는 데이터는 어텐션 KV보다 범위가 넓습니다. 연구팀은 이를 네 종류의 타입이 있는 페이로드로 나눕니다:
| 페이로드 | 예시 연결 | 내용 |
|---|---|---|
| 은닉 상태(hidden states)와 임베딩 | thinker → talker | Qwen3-Omni에서 선택한 층의 은닉 상태, 프롬프트 임베딩, TTS 특수 임베딩 |
| 코덱 코드 | talker → code2wav | RVQ(Residual Vector Quantization) 행 같은 이산 오디오 토큰과 청크 경계 메타데이터 |
| 페이지 단위 KV 블록 | prefill → decode, AR → DiT | vLLM 페이지 블록 테이블에서 꺼낸 키/값 텐서 |
| 잠재 표현(latents) | DiT → VAE | 확산과 월드 모델 스테이지의 잠재 텐서와 부가 텐서 |
이 데이터를 실제로 옮기는 것은 OmniConnector입니다. 인터페이스는 put, get, cleanup, 상태 확인으로 좁게 정의되어 있습니다. 생산자가 키 하나로 페이로드를 발행하면 공유 메모리 이름이나 원격 전송 핸들 같은 작은 메타데이터만 제어 대기열로 이동하고, 소비자는 이 메타데이터로 실제 데이터를 가져옵니다. 커넥터는 내용이 은닉 상태인지 KV인지 해석하지 않습니다.
백엔드는 배치 위치에 따라 고릅니다. 한 노드 안에서는 공유 메모리가 기본이고, 노드를 넘을 때는 Mooncake의 TCP, RDMA 경로 같은 전송 엔진을 씁니다. 연결마다 백엔드를 따로 고를 수 있어서, 같은 노드의 thinker → talker는 공유 메모리로, 원격 DiT로 가는 KV는 전송 엔진으로 보내는 구성이 가능합니다. KV 전달은 같은 커넥터를 쓰되 별도 관리자가 맡습니다. AR → DiT 연결에서는 끝난 AR 블록을 KV 전용 키로 발행하고, 확산 러너가 디노이징 전에 past_key_values로 주입합니다.
연구팀은 이 분업을 하나의 불변 조건으로 정리합니다: 요청 수락, 라우팅, 완료는 오케스트레이터가, 페이로드 바이트는 커넥터가 가집니다. 오케스트레이터는 대용량 텐서 버스가 되지 않습니다.
세션: 한 번의 생성보다 오래 지속되는 상호작용
일부 워크로드는 "요청 하나를 생성하고 끝내는" 모델로 설명되지 않습니다. 전이중 음성 에이전트, 여러 번 이어지는 월드 모델 롤아웃, 생성 도중 편집을 받는 영상, 관측을 반복해서 보내는 로봇 정책이 그렇습니다. vLLM-Omni는 이를 별도 런타임이 아니라 같은 오케스트레이터의 확장으로 처리하고, 세션이 공통으로 다루는 일을 네 가지로 나눕니다:
- 수명 주기: 세션을 열고, 갱신하고, 신호를 보내고, 닫습니다. 배포 프로필이 포화되면 새 세션을 거절하고, 유휴 임대(idle lease)와 축출(eviction)로 자원을 회수합니다.
- 상태 연속성: 대화 KV, 잠재 버퍼, 턴 경계 펜스(fence)를 유지합니다. 펜스 메타데이터는 이전 턴의 늦은 업데이트가 새 응답을 바꾸지 못하게 막습니다.
- 수락 제어: 동시 세션 수의 상한을 둡니다. 실시간 음성 경로는 세션당 GPU 사용량이 크기 때문입니다.
- 동시 양방향 입출력: 재생 중에도 마이크 음성을 계속 받고, 로봇은 같은 세션 ID로 관측을 보내고 행동 청크를 받습니다.
다만 연구팀은 전이중 제어와 월드 모델 세션 상태가 아직 발전 중인 하위 시스템이며 모든 배포에서 기본으로 켜지는 기능이 아니라고 적었습니다. 네이티브 /v1/duplex 프로토콜도 문서상 실험 기능입니다. Qwen3-Omni의 /v1/realtime 경로는 진행 중인 요청에 연속 입력을 붙이는 턴 단위 실시간 채팅 API이며, 전이중 세션이 아닙니다. 연구팀은 아키텍처 주장의 범위를 좁게 잡습니다. 상호작용 방식마다 런타임을 따로 두지 않고 공통 세션 제어 모델로 올린다는 것까지가 주장입니다.
하드웨어, 효율화 기능, 생태계
이 구조가 운영 환경에서 쓰이려면 가속기, 메모리 최적화, 학습 프레임워크와도 맞물려야 합니다. 연구팀은 이 부분을 세 층으로 설명합니다.
하드웨어 플랫폼은 upstream vLLM의 플랫폼 플러그인 방식을 따릅니다. 프로세스 시작 때 OmniPlatform 하나가 결정되고, 오케스트레이터, 스테이지, 커넥터의 계약은 그대로 둔 채 워커, 어텐션 백엔드, 장치 준비 코드만 바뀝니다. CUDA가 기본 경로이고 ROCm과 MUSA는 공용 GPU 워커를 재사용합니다. Ascend NPU와 Intel XPU는 전용 AR, 생성 워커와 벤더 통신 백엔드를 씁니다.
효율화 기능은 런타임을 바꾸지 않고 스테이지에 붙는 옵션입니다:
- 양자화(Quantization): FP8, INT8, ModelOpt FP8과 NVFP4, GGUF, AutoRound, 일부 확산 모델용 SVDQuant 방식 W4A4, CUDA 전용 bitsandbytes를 지원합니다. Ascend에는 MXFP8, MXFP4 경로가 따로 있습니다. 확산 모델은 기본적으로 트랜스포머 본체만 양자화하고, 옴니와 TTS 파이프라인은 주로 thinker나 언어 모델 스테이지만 양자화합니다. 연구팀은 검증되지 않은 백엔드와 모델 조합은 실험 기능으로 보라고 밝혔습니다.
- 오프로드와 슬립: 확산 스테이지는 쓰지 않는 모듈을 CPU로 옮길 수 있고, 슬립 모드는 서빙과 학습 사이에 가중치를 내려놓습니다. 가장 깊은 단계의 깨우기와 재적재 동작은 아직 완성되지 않았다고 명시되어 있습니다.
- 컴파일과 캐시: 확산 스테이지는 자주 쓰는 블록에만
torch.compile을 적용하는 지역 컴파일(regional compilation)이 기본입니다. TeaCache와 Cache-DiT는 스텝 간 계산을 재사용하는 주력 캐시인데, 둘을 동시에 켜는 구성은 지원하지 않습니다.
생태계 연결로는 모델별 배포 레시피, OpenAI 호환 엔드포인트를 호출하는 ComfyUI 노드, 그리고 upstream vLLM 릴리스 라인 추적이 있습니다. vLLM-Omni는 vLLM의 major, minor 버전을 따라가며, 버전이 어긋나면 import 시점에 경고합니다. 강화 학습 쪽에서는 VeRL-Omni가 vLLM-Omni를 롤아웃 백엔드로 사용합니다. vLLM-Omni는 생성 경로, 워커 대상 RPC, 확산 LoRA 추가와 제거, 슬립과 깨우기 같은 좁은 제어 지점만 제공하고, 가중치 동기화와 옵티마이저 상태는 범위 밖에 둡니다.
API와 지원 모델
외부에서 보이는 API는 오케스트레이터 위의 얇은 어댑터입니다. 하나의 Omni 프로세스에 로드된 하나의 파이프라인이 아래 표면 중 해당하는 것을 노출합니다.
| API 표면 | 전송 방식 | 대표 스테이지 구성 | 스트리밍 |
|---|---|---|---|
| 채팅 | HTTP/SSE | thinker → talker → code2wav | 텍스트, 오디오 |
| 음성 합성(TTS) | HTTP/SSE/WebSocket | talker → code2wav | 청크 단위 오디오 |
| 이미지 | HTTP | DiT, 또는 AR → DiT | 전체 페이로드 |
| 영상 | HTTP 비동기 작업 또는 동기 | 영상 DiT, 플로우 | 폴링 또는 바이트 |
| 실시간 영상 | WebSocket | 옴니 AR 또는 DiT 세션 | 프레임, 청크 |
| 전이중 음성 | WebSocket | llm → tts → code2wav | 양방향 |
| OpenPI 로봇 | WebSocket(msgpack) | 정책 DiT, AR-DiT | 관측 → 행동 |
로봇 정책 서빙은 채팅 API에 맞지 않아서 OpenPI 호환 WebSocket 어댑터를 따로 둡니다. JSON 대신 msgpack을 쓰고, 연결 직후 서버가 행동 길이(action horizon), 행동 키, 이미지 해상도를 알려 줍니다. 클라이언트는 첫 추론 전에 로봇 구성이 맞는지 확인할 수 있습니다. 로봇 정책은 처리량보다 에피소드 사이 상태가 섞이지 않는 것이 중요하므로, 보통 한 번에 한 시퀀스만 받고 세션 고정에 의존합니다. 참고로 CPU 병목을 줄이려고 API 서버 프로세스를 여러 개 실행하는 --api-server-count 모드는 현재 확산 스테이지가 있는 파이프라인을 거부합니다.
보고서의 지원 모델 표는 서빙 구조 기준으로 79개 행을 나열합니다. 거의 같은 변형은 한 행으로 묶었습니다:
- AR 옴니(8): Qwen3-Omni, Qwen2.5-Omni, MiniCPM-o 4.5, Ming-flash-omni 2.0 등
- 전이중(2): PersonaPlex, Nemotron VoiceChat
- TTS(21)와 오디오 생성(3): Qwen3-TTS, CosyVoice3, Fish Speech S2 Pro, Voxtral TTS, Higgs Audio, IndexTTS, MOSS-TTS 계열, Stable-Audio-Open 등
- 이미지(24): Qwen-Image 계열, FLUX.1과 FLUX.2, SDXL, SD3.5, 그리고 AR → DiT 구성인 GLM-Image, HunyuanImage-3.0, BAGEL 등
- 영상(14): Wan2.1/2.2, LTX-2 계열, HunyuanVideo-1.5, 영상과 오디오를 함께 생성하는 MiniMax H3 등
- 월드 모델(4): Cosmos3, DreamZero-DROID, LingBot-World 2.0, SANA-WM
- VLA(3): GR00T N1.7, \pi_0 , InternVLA-A1
지원 범위는 릴리스마다 바뀌므로, 최신 목록은 공식 문서의 지원 모델 페이지에서 확인해야 합니다.
평가 설정: 무엇을 무엇과 비교했나
결과 수치를 보기 전에 측정 조건을 먼저 살펴봐야 합니다. 이 보고서의 표들은 같은 조건에서 나온 하나의 실험이 아니기 때문입니다.
- 하드웨어와 시점이 표마다 다릅니다. 이미지, 영상, 월드 모델 결과는 2026년 9월 14일 기준 공개 H100 nightly CI에서 가져왔습니다. Qwen3-Omni의
async_chunk비교와 복제 실험은 매일 돌지 않아서 2026년 7월 5일부터 11일까지의 H100 레시피 기준값 평균입니다. Qwen3-Omni 동시성 실험, TTS, MiniCPM-o 결과는 H200에서 따로 측정했습니다. - 비교 대상은 대부분 vLLM-Omni 자신입니다. 각 모델의 기본 배포와 PR 번호로 표기된 옵트인 최적화 프로필을 비교하고, 외부 프레임워크와의 비교와 엔지니어링 지표 집계는 이번 판에서 제외했습니다.
- 부하 모델: 폐루프 동시성 C 는 동시에 처리 중인 요청을 최대 C 개로 유지합니다. Qwen3-Omni Fixed-Len 실험은 입력 2,500 토큰, 출력 900 토큰이고, TTS는 Seed-TTS 영어 텍스트를 씁니다.
측정 지표는 다음과 같습니다:
- TTFT(Time To First Token): thinker가 첫 텍스트 토큰을 내보내기까지의 시간
- TTFP(Time To First Packet): 첫 오디오 패킷까지의 시간, 듣는 사람에게는 첫 소리가 나기까지의 시간
- E2EL(End-to-End Latency): 요청 제출부터 응답 완료까지의 시간
- RTF(Real-Time Factor): 오디오 합성 시간을 생성된 오디오 길이로 나눈 값. \text{RTF} < 1 이면 재생보다 생성이 빠릅니다.
- audio-s/s: 1초 동안 생성한 오디오의 길이(초), 즉 오디오 처리량
실험 결과
Qwen3-Omni: async_chunk를 끄면 무엇이 달라지나
H100 2장에서 Qwen3-Omni의 async_chunk를 켜고 끈 결과입니다. 동시 요청이 적을 때는 차이가 작지만, 부하가 커질수록 벌어집니다.
| 동시성 C | 모드 | TTFT 평균 (ms) | E2EL 평균 (s) | RTF 평균 |
|---|---|---|---|---|
| 1 | async_chunk | 96.4 | 18.51 | 0.117 |
| 1 | async_chunk 끔 | 115.8 | 25.07 | 0.169 |
| 8 | async_chunk | 271.9 | 31.91 | 0.236 |
| 8 | async_chunk 끔 | 446.7 | 37.62 | 0.247 |
| 32 | async_chunk | 507.8 | 72.63 | 0.630 |
| 32 | async_chunk 끔 | 3,420.1 | 136.62 | 0.927 |
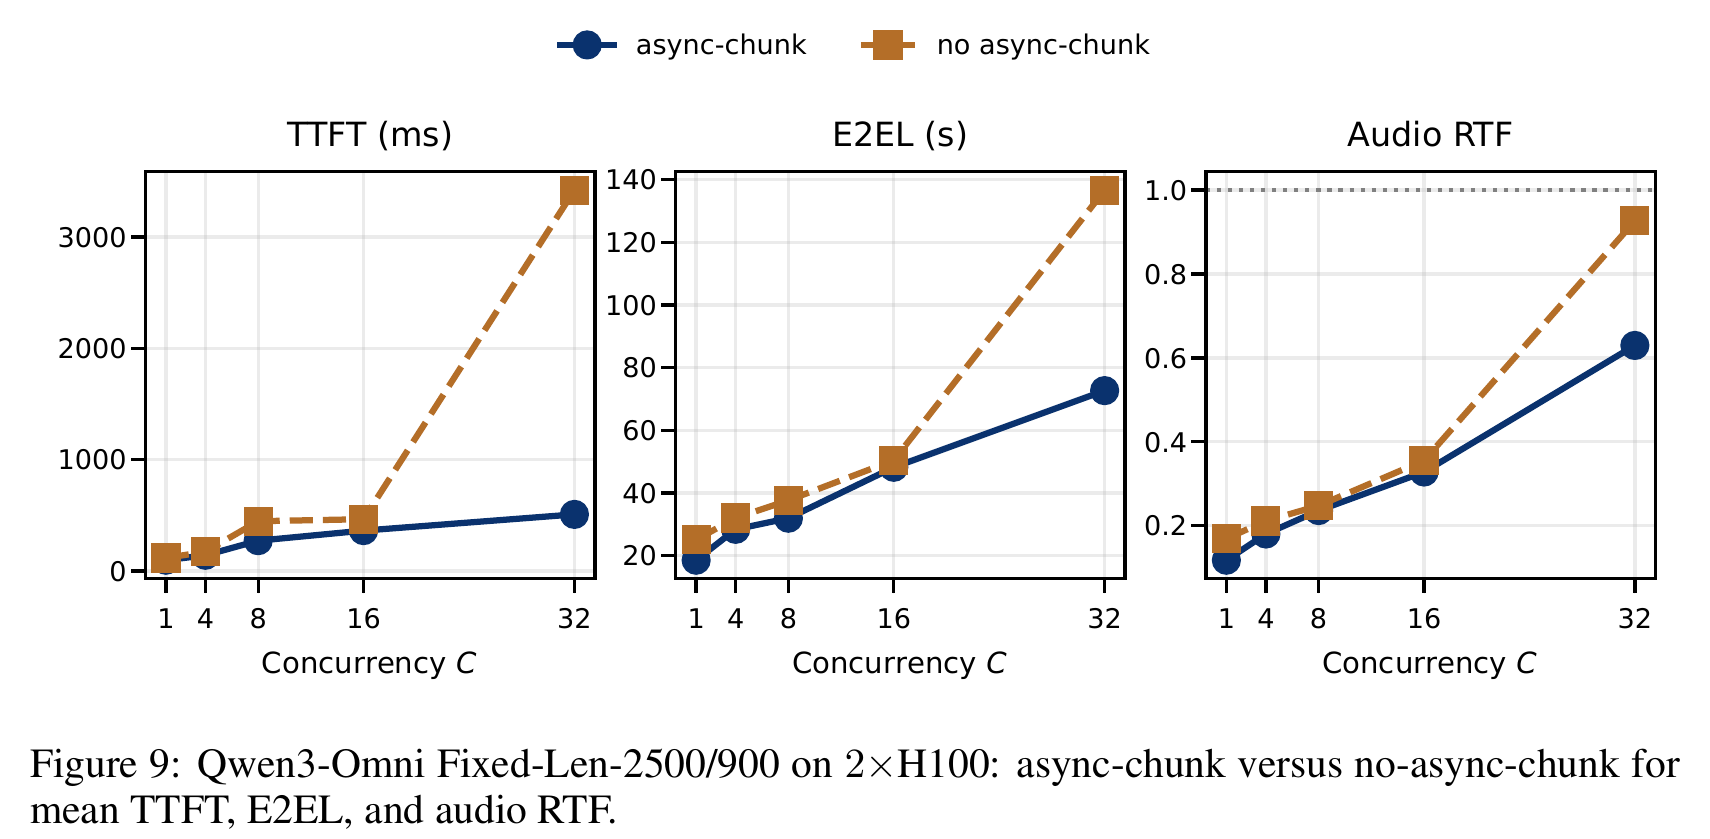
동시 요청 32개에서 청크 스트리밍을 끄면 TTFT가 6.7\times , E2EL이 1.9\times 늘었고, RTF는 0.93 으로 실시간 재생 한계인 1에 가까워졌습니다. 연구팀은 E2EL과 RTF가 나빠진 이유를, 청크가 없으면 code2wav가 talker의 코덱 시퀀스가 끝나기를 기다려야 해서 오디오 경로의 대기 시간이 길어지기 때문이라고 설명합니다. TTFT가 크게 늘어난 원인은 따로 분석하지 않았습니다.
Qwen3-Omni: 동시성 확장과 MRv2 프로필
H200 2장에서 기본 배포(V1 러너)와 MRv2 옵트인 프로필을 비교한 동시성 실험입니다(각 칸은 3회 반복의 중앙값).
| 동시성 C | TTFT (기본 / MRv2, ms) | TTFP (기본 / MRv2, ms) | E2EL (기본 / MRv2, s) | RTF (기본 / MRv2) |
|---|---|---|---|---|
| 1 | 96.0 / 110.7 | 241.6 / 212.1 | 15.04 / 12.34 | 0.109 / 0.083 |
| 8 | 156.4 / 206.9 | 439.5 / 355.8 | 32.89 / 19.20 | 0.178 / 0.111 |
| 32 | 322.2 / 336.3 | 1,064.6 / 500.4 | 75.06 / 39.53 | 0.423 / 0.212 |
두 배포 모두 C=32 까지 RTF가 1 아래에 머물렀습니다. MRv2는 C \ge 16 에서 E2EL과 RTF를 대략 절반으로 줄였고, C=32 에서 TTFP를 1{,}065 ms에서 500 ms로 낮췄습니다. 대신 thinker의 TTFT는 조금 높았습니다. 주의할 점은, 측정한 커밋에서 MRv2 프로필이 시작 단계에서 실패했다는 것입니다. 공용 MRv2 모델 상태 코드가 융합된 Qwen3-TTS talker에만 있는 속성을 읽었기 때문이며, 연구팀은 한 줄짜리 방어 코드를 넣고 측정했다고 밝혔습니다.
입력 모달리티를 바꾼 개방형 부하(Random-MM) 실험도 있습니다. 텍스트와 오디오를 함께 출력하면 MRv2가 평균 E2EL을 15 ~ 33\% 줄였습니다(오디오, 이미지, 영상 입력에서 5.28 초 → 3.53 초). 텍스트만 출력하는 경우는 음성 스테이지를 건너뛰므로 두 배포 모두 1초 안에 끝났습니다.
텍스트만 요청할 때의 오버헤드
같은 Qwen3-Omni를 텍스트 전용으로 쓸 때, 스테이지 그래프를 거치는 비용은 얼마나 될까요? 연구팀은 H200 1장에서 vLLM-Omni의 텍스트 전용 경로와 thinker만 띄운 vLLM 엔드포인트를 비교했습니다.
| 시스템 | 동시성 C | TTFT 평균 (ms) | E2EL 평균 (s) |
|---|---|---|---|
| vLLM-Omni 텍스트 전용 | 1 | 75.0 | 3.79 |
| thinker 전용 vLLM | 1 | 70.9 | 3.66 |
| vLLM-Omni 텍스트 전용 | 32 | 860.1 | 13.73 |
| thinker 전용 vLLM | 32 | 562.4 | 13.67 |
C=1 에서는 두 방식의 차이가 6\% 이내였고, C=32 에서도 E2EL은 같았습니다. 그러나 C=32 의 TTFT는 vLLM-Omni가 약 53\% 높았고, 연구팀은 이 차이 중 스테이지 그래프와 오케스트레이터가 차지하는 몫을 아직 분리하지 못했다고 밝혔습니다. MRv2 프로필은 이 경로에서 더 느렸고, 두 번의 실행에서 C=32 세 번째 반복 중 thinker가 종료되어 128개 요청 중 32개가 실패했습니다. 그래서 위 표는 기본 배포의 값입니다.
스테이지 복제: talker와 code2wav만 늘리기
H100 3장 구성에서는 thinker를 1장에 두고 talker와 code2wav 복제본을 2개로 늘렸습니다. C=8 에서 RTF는 0.190 으로, 같은 동시성의 2장 async_chunk 구성(0.236 )보다 낮았습니다. 연구팀은 이를 중간 부하에서 병목이던 오디오 스테이지의 대기열이 풀린 결과로 해석합니다. 다만 3장 구성은 GPU가 1장 더 많고, 2장 구성과 직접 비교할 수 있는 동시성은 8과 32뿐입니다.
반면 C=32 에서는 RTF가 0.732 로 2장 구성(0.630 )보다 오히려 높았습니다. 연구팀은 이 구간에서는 thinker의 요청 수락과 스테이지 간 전달이 먼저 병목이 되어, code2wav 복제본을 늘려도 효과가 없는 것으로 봅니다. C=32 의 TTFT도 3장 구성이 911.6 ms로 2장 구성(507.8 ms)보다 높았습니다.
TTS 서빙: 단일 스테이지 융합과 패킹
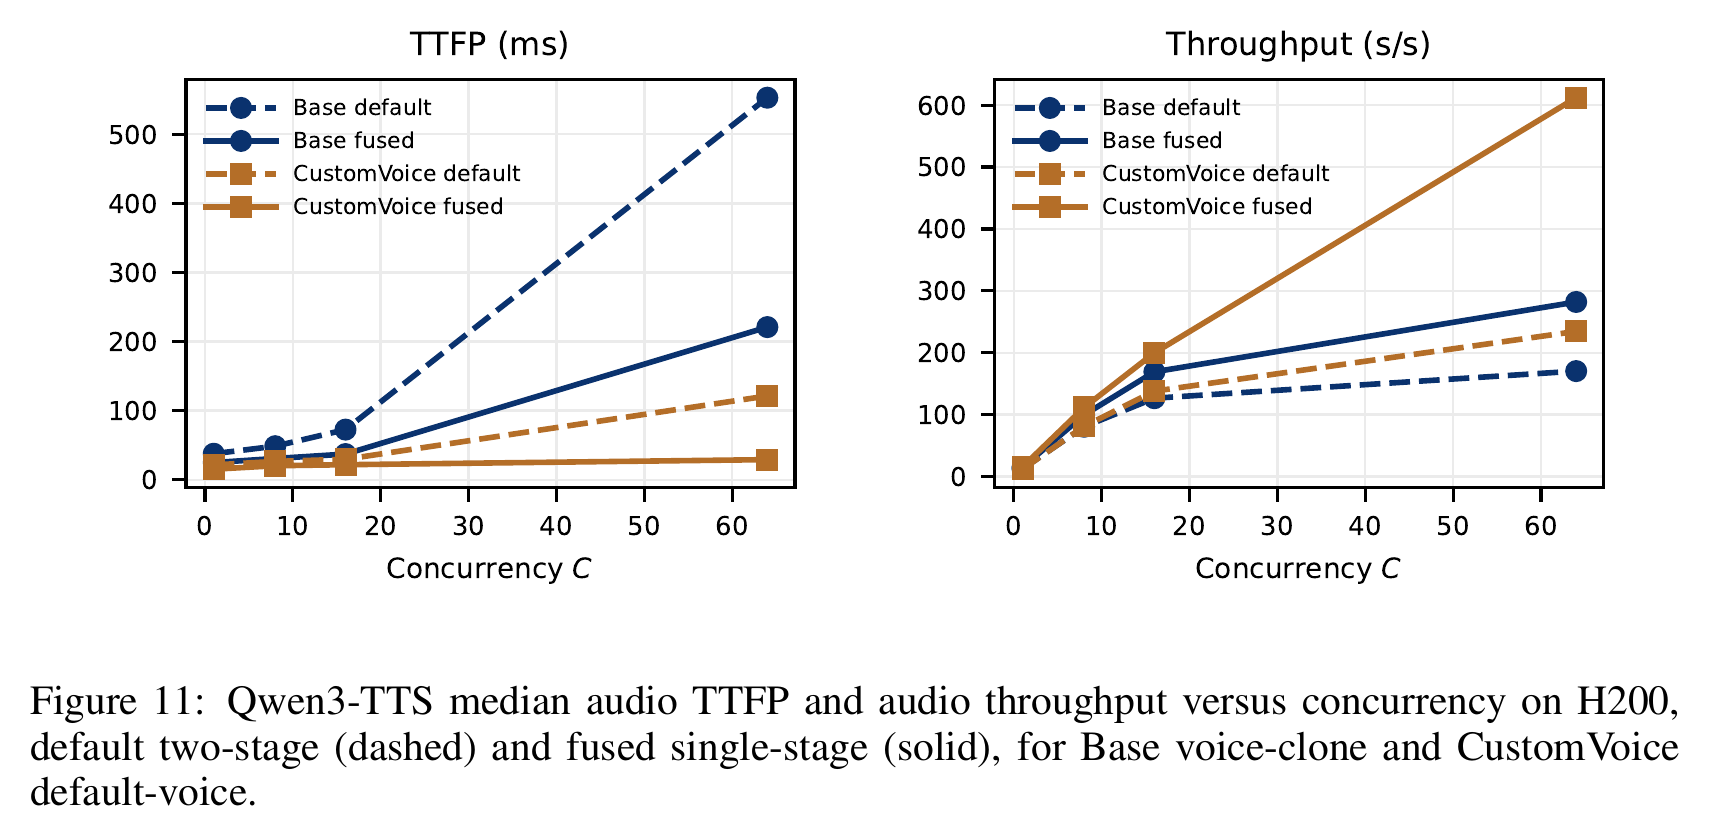
TTS 결과는 H200에서 각 모델의 기본 배포와 옵트인 최적화 프로필을 비교했습니다. 주요 칸만 옮기면 다음과 같습니다(TTFP는 중앙값).
| 모델 / 작업 | C | TTFP (기본 → 최적화, ms) | 처리량 (기본 → 최적화, audio-s/s) |
|---|---|---|---|
| Qwen3-TTS CustomVoice | 1 | 21.5 → 15.3 | 11.9 → 15.6 |
| Qwen3-TTS CustomVoice | 64 | 121.3 → 29.1 | 234.6 → 612.1 |
| Qwen3-TTS Base (음성 복제) | 64 | 552.8 → 220.9 | 170.4 → 282.1 |
| CosyVoice3 (음성 복제) | 64 | 51,145.9 → 1,673.8 | 4.9 → 78.4 |
| Higgs Audio v3 | 64 | 7,208.8 → 148.2 | 29.1 → 311.0 |
| Fish Speech S2 Pro (음성 복제) | 64 | 22,326.2 → 2,166.0 | 10.4 → 40.4 |
| MOSS-TTS-Local (음성 복제) | 64 | 285.2 → 145.2 | 181.1 → 239.2 |
Qwen3-TTS의 기본 배포는 talker와 Code2Wav 디코더를 GPU 2장의 두 스테이지로 나눕니다. 최적화 프로필은 talker가 스트리밍 코덱 디코더를 직접 가지고 PCM을 반환하는 GPU 1장의 단일 스테이지입니다. 연구팀에 따르면 이 융합 프로필은 GPU를 절반만 쓰면서 측정한 모든 칸에서 더 빨랐습니다. 이 결과는 앞에서 설명한 "스테이지를 나눠 따로 늘린다"는 설계와 반대 방향입니다. 연구팀도 코덱 디코더가 talker와 GPU를 같이 쓸 만큼 가벼우면 둘을 합쳐 스테이지 사이 전달을 없애는 편이 낫다고 정리합니다.
다른 TTS 모델에서도 기본 배포가 부하를 따라가지 못하는 경우가 보였습니다:
- CosyVoice3: 기본 배포는 동시성과 무관하게 처리량이 약 4.9 audio-s/s에 머물러, C=64 에서 TTFP가 약 51초까지 늘었습니다. Flow와 HiFT 디코딩을 요청 사이에서 묶는 패킹(packed) 스트리밍 프로필은 처리량을 16\times 높였습니다. 샘플 24개의 Whisper WER은 3.6\% 로 기본(3.9\% )과 비슷했습니다.
- Higgs Audio v3: MRv2 프로필이 전 구간에서 TTFP를 80 ~ 150 ms로 유지하며 C=64 처리량을 10.7\times 높였습니다. Whisper WER은 4.9\% 로 기본(5.3\% )과 비슷했습니다.
- Fish Speech S2 Pro: 고동시성 프로필이 처리량을 3.9\times 높였지만, C=64 에서 RTF가 여전히 1을 넘었습니다. Whisper WER은 3.9\% 로 기본(3.6\% )보다 조금 높았습니다.
- MOSS-TTS-Local: MRv2 프로필 세 가지 중 기본 MRv2 프로필은 기본 배포보다 느렸고(C=64 에서 144 대 181 audio-s/s), 고동시성 프로필과 저지연 프로필은 처리량이 기본보다 높았습니다. 표에 실린 저지연 프로필은 TTFP를 41 ~ 61\% 줄였습니다.
Qwen3-TTS Base(음성 복제)의 수치는 서버가 참조 음성을 이미 처리한 상태를 가정합니다. 새로 시작한 서버에서는 참조 음성 캐시가 비어 있어 C=1 TTFP가 두 배포 모두 약 131 ms였습니다.
이미지와 영상 생성
이미지와 영상 결과는 H100 nightly CI 레시피에서 나왔고, 병렬화와 캐시를 붙였을 때의 지연 변화를 보여줍니다.
| 구성 | 장치 | 평균 지연 (s) |
|---|---|---|
| Qwen-Image 1536^2 , 35 스텝 | H100 1장 | 23.60 |
| 위와 같음, Ulysses2 + CFG2 병렬 | H100 4장 | 8.22 |
| 위와 같음, Cache-DiT 추가 | H100 4장 | 5.20 |
| Qwen-Image-Edit 512^2 , 20 스텝 | H100 1장 | 8.84 |
| 위와 같음, Cache-DiT 추가 | H100 1장 | 3.47 |
| Wan2.2-I2V-A14B 832 \times 480 , 81 프레임, 4 스텝 | H100 1장 | 26.20 |
| 위와 같음, USP2 + HSDP 슬라이싱 | H100, USP2 | 18.04 |
| Cosmos3-Nano T2V(텍스트 → 영상) 1280 \times 720 , 189 프레임 | H100 2장 | 28.88 |
| MiniMax-H3 T2V 1344 \times 768 , 209 프레임 | H100 4장 | 31.15 |
| MiniMax-H3 V2V(영상 → 영상), 같은 해상도 | H100 4장 | 103.18 |
Qwen-Image 512^2 의 스텝 실행 실험에서는 GPU 1장에서 동시 요청을 늘리면 요청당 지연은 늘지만 초당 요청 수는 0.412 에서 0.816 으로 올랐습니다. 디노이징 작업을 요청 사이에서 묶어 같은 스텝 루프를 나눠 쓰기 때문입니다. MiniMax-H3의 V2V가 T2V보다 3배 이상 느린 것은, 텍스트에 더해 입력 영상 텐서를 조건으로 받는다는 점과 맞아떨어진다고 연구팀은 적었습니다. 이미지와 영상 결과는 지연과 처리량만 보고하며, 생성 품질 지표는 없습니다.
전이중 음성: MiniCPM-o 4.5
MiniCPM-o 4.5는 H200 1장에서 기본 레시피(V1 러너, 전이중 세션 모드)로 측정했습니다. 동시성을 1에서 8로 늘리자 평균 TTFP는 433 ms에서 1{,}533 ms로, RTF는 0.18 에서 0.90 으로 올랐고, C=8 출력 128개의 Whisper WER은 1.6\% 였습니다.
옵트인 MRv2 프로필은 전이중 세션 모드가 아닌 턴 모드라서 같은 조건의 비교는 아닙니다. 이 프로필은 같은 작업에서 더 빨랐지만(C=8 평균 TTFP 658 ms), 출력의 13\% 에서 목표 문장 뒤에 관계없는 음성을 덧붙이며 멈추지 않았습니다. 이 때문에 WER이 12.9\% (네이티브 채팅 템플릿 사용 시 11.0\% )로 올라 연구팀은 이 값을 결과로 보고하지 않았습니다. 또한 이 표의 값은 스트리밍 상태를 보는 지표(TTFT, TTFP, RTF, 처리량)이며, 끼어들기(barge-in)나 수락 제어 프로토콜을 평가한 것은 아닙니다. 연구팀에 따르면 응답 도중 끼어들기는 모델마다 달라서, MiniCPM-o 4.5는 지원하고 PersonaPlex와 Nemotron VoiceChat은 지원하지 않습니다.
한계와 읽을 때 주의할 점
이 보고서는 vLLM-Omni의 설계와 운영 상태를 투명하게 공개한 문서에 가깝고, 다른 시스템보다 빠르다는 것을 보이는 논문은 아닙니다. 수치를 인용할 때 고려할 점은 다음과 같습니다.
- 외부 비교가 없습니다. 관련 연구에서 SGLang-Omni와 M* 같은 다단계 옴니 서빙 시스템을 언급하지만, 이번 판에서는 이들과의 성능 비교를 제외했습니다. vLLM-Omni를 다른 프레임워크 대신 쓸지는 이 보고서만으로 판단할 수 없습니다.
- 옵트인 프로필의 안정성이 고르지 않습니다. Qwen3-Omni MRv2는 한 줄 수정 없이 시작되지 않았고, 텍스트 전용 경로에서는 요청이 실패했으며, MiniCPM-o 4.5 MRv2는 발화를 멈추지 못했습니다. 최적화 프로필은 PR 단위로 들어온 것이 많으므로, 쓰려는 버전에서 해당 프로필의 상태를 직접 확인해야 합니다.
- 표끼리 직접 비교하기 어렵습니다. H100과 H200, 서로 다른 날짜와 커밋, 서로 다른 GPU 수의 결과가 섞여 있습니다. 같은 표 안의 비교만 같은 조건입니다.
- 지원 목록과 측정 범위는 다릅니다. 79개 행은 지원 모델이고, 성능을 측정한 모델은 그중 일부입니다. 이미지와 영상 결과는 대부분 동시성 1의 단일 요청 측정입니다.
- 측정은 NVIDIA GPU뿐입니다. ROCm, Ascend NPU, Intel XPU 지원을 설명하지만, 다른 하드웨어에서의 측정은 향후 과제로 남겼습니다. 세션 기반 워크로드 확대와 폐루프 로봇 평가도 마찬가지입니다.
- 확산 쪽 페이지 단위 KV는 일부 DiT 파이프라인에서만 동작합니다. 연구팀은 모델 계열마다 지원 범위와 캐시를 고려한 수락 제어가 아직 고르지 않다고 적었습니다.
그럼에도 이 보고서는 생성 모델 서빙의 기본 단위가 "토큰을 생성하는 루프 하나"에서 "여러 엔진이 이어진 요청 하나"로 바뀌고 있다는 점을 구체적인 구현으로 보여줍니다. 음성, 이미지, 행동 생성 모델을 서비스하는 팀이라면, 어느 스테이지를 나누고 어느 스테이지를 합칠지, 스테이지 사이에서 무엇을 스트리밍할지를 설계할 때 참고할 기준점이 될 수 있습니다.
vLLM-Omni 설치 및 사용 방법
공식 Quickstart 기준으로 Linux와 Python 3.12가 필요합니다. vLLM과 vLLM-Omni는 major, minor 버전이 같아야 하며, 버전이 다르면 vLLM-Omni를 import할 때 경고가 나옵니다. 아래 명령은 문서 작성 시점의 소스 설치 예시로, vLLM 0.31.0을 CUDA 환경에 설치합니다. 배포된 vLLM-Omni 0.30.0 휠은 vLLM 0.30.0과 짝을 이루므로, 휠로 설치하거나 다른 방법을 쓰려면 설치 가이드를 확인해야 합니다.
- 가상 환경을 만들고 활성화합니다.
uv venv --python 3.12 --seed
source .venv/bin/activate
- CUDA 환경이라면, 버전을 맞춘 vLLM을 설치합니다.
uv pip install vllm==0.31.0 --torch-backend=auto \
  --extra-index-url https://wheels.vllm.ai/db9527a46873454610df6dbedf79a36d6bf1a7f6
- vLLM-Omni 저장소를 받아 설치합니다.
git clone https://github.com/vllm-project/vllm-omni.git
cd vllm-omni
uv pip install -e .
--omni플래그로 서버를 실행합니다. 아래 예시는 Z-Image-Turbo 이미지 생성 모델을 8091 포트에 띄웁니다.
vllm serve Tongyi-MAI/Z-Image-Turbo --omni --port 8091
- 서버가 실행 중인 상태에서, 다른 터미널에서 OpenAI 호환 이미지 생성 API를 호출합니다.
curl -s http://localhost:8091/v1/images/generations \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "a cup of coffee on the table",
    "size": "1024x1024",
    "response_format": "b64_json",
    "seed": 42
  }' | jq -r '.data[0].b64_json' | base64 -d > coffee.png
모델별 배포 설정은 vLLM 레시피에서 찾을 수 있습니다.
 vLLM-Omni Technical Report: A Unified Serving Runtime for Omni-Modality Generation 논문
vLLM-Omni: Fully Disaggregated Serving for Any-to-Any Multimodal Models 논문
 vLLM-Omni 공식 문서
 vLLM-Omni GitHub 저장소
더 읽어보기
-
vLLM팀, 실시간 음성 상호작용 등, 옴니모달(Omni-Modality) 모델 서빙을 위한 vLLM-Omni 공개
-
Qwen3-TTS: 500만 시간의 학습 데이터, 12Hz 초저지연 토크나이저로 완성한 오픈소스 Omni-Audio 모델
-
MOSS-TTS-Local-Transformer-v1.5, 로컬 서빙에 최적화된 48kHz 스트리밍 TTS 모델 (feat. SGLang-Omni)
-
SeedRealtime: ByteDance Seed의 보면서 듣고 말하는 전이중(Full-Duplex) 모델
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
