핵심 요약
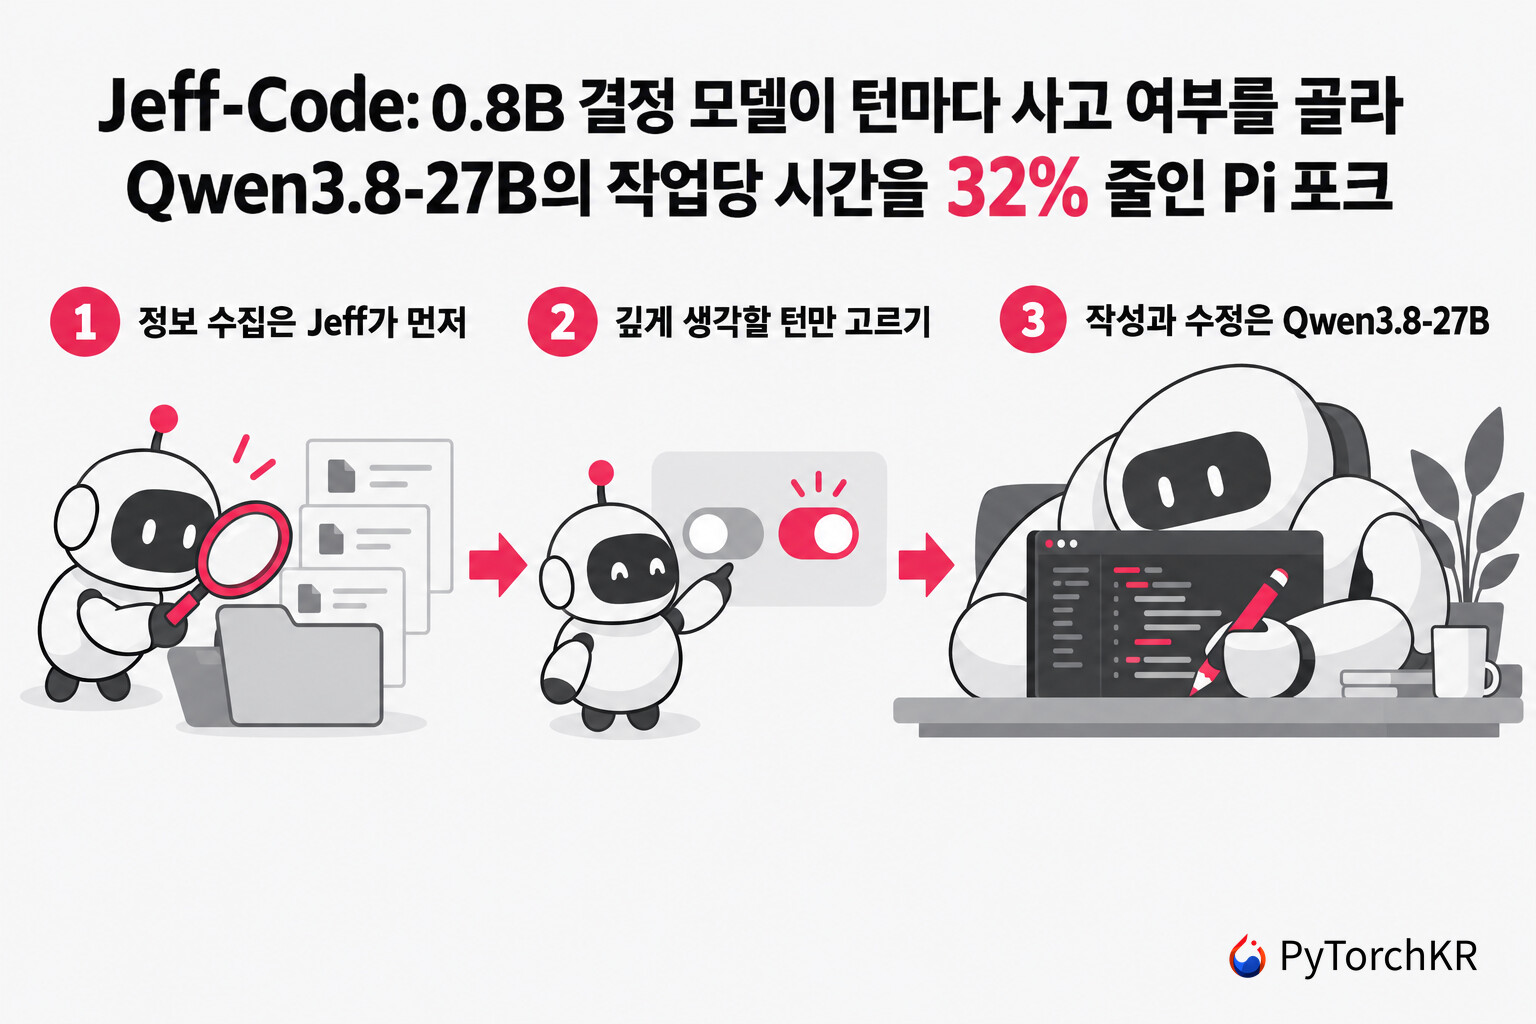
- Jeff-Code는 Pi 코딩 에이전트를 포크한 연구용 코드입니다. 0.8B 결정 모델 Jeff가 Qwen3.8-27B의 매 턴 앞에서 두 가지를 정합니다. 파일 읽기나 코드 검색 같은 정보 수집 단계를 자기가 먼저 실행할지, 이번 턴에 Qwen의 사고 모드를 켤지입니다.
- 6개 벤치마크에서 짝지은 과제 1,242개를 실행했습니다. 통과율은 62.8%와 62.4%로 차이가 확인되지 않았습니다(-0.2%p, 95% 구간 -2.6 ~ +2.1). 과제당 시간은 0.68배였고, JeffHub 소개 페이지의 "47% 빠름"은 이 값의 역수입니다. 전체 과제 시간의 합계는 0.86배로 덜 줄었습니다.
- 평가 로그를 보면 Qwen 턴의 74.1%가 사고 없이 돌았고, Qwen 턴 82,435번에 비해 Jeff가 대신 실행한 단계는 2,600번이었습니다. 사고를 모든 턴에서 끄면 더 빠르지만 통과율이 7.6%p 떨어졌습니다.
- 수치는 저장소 관리자가 낸 평가 보고서 기준이며, 보고서 머리에는 중간(INTERIM) 표시가 있습니다. 두 어댑터는 Qwen3.8-27B와 Jeff v1.3 베이스 조합에서만 측정되었고, Terminal-Bench 2.0에서는 속도 향상이 뚜렷하지 않았습니다.
Jeff-Code 소개
Jeff-Code는 로컬에서 실행하는 27B 추론(reasoning) 모델 코딩 에이전트의 시간을 줄이려는 프로젝트입니다. 큰 모델이 매 턴마다 하던 판단 중 일부를 0.8B 결정 모델에게 넘기는 방식입니다. Qwen3.8-27B 같은 추론 모델은 행동 하나를 고르기 전에 사고(thinking) 토큰을 먼저 생성합니다. 그런데 코딩 에이전트의 턴 중 상당수는 파일 하나를 열거나 폴더 목록을 보는 일처럼 깊은 사고가 필요 없는 일입니다. Jeff-Code는 이런 턴을 골라내는 일을 작은 모델에게 맡깁니다.
여기서 판단을 맡는 모델이 Jeff입니다. Jeff는 Qwen3.5-0.8B를 미세조정(fine-tuning)한 결정 모델(Decision Model) 입니다. 문장을 생성하지 않고, 상황 설명과 선택지 목록을 받아 선택지마다 보정된 확률을 한 번의 순전파로 돌려줍니다. 저자들은 이를 사람의 빠른 직관적 판단에 빗대어 System 1 모델이라고 부릅니다.
Jeff는 TypeSafe AI의 Jev와 같은 요청 형식을 쓰지만, README는 TypeSafe와 관계없는 독립 프로젝트라고 밝힙니다. 학습 코드는 오픈소스 재현 레시피인 AutoJev에서 출발했습니다. Jev와 비슷한 다른 오픈 결정 모델은 Decision Index와 JevBench 비교 글에서 정리했습니다.
에이전트 본체는 Mario Zechner와 기여자들이 만든 오픈소스 코딩 에이전트 Pi입니다. Jeff-Code는 Pi를 포크해 에이전트 루프 안에 Jeff를 넣었고, Pi의 MIT 라이선스를 그대로 따릅니다. 저자들은 Pi의 확장 프레임워크로는 빠른 결정 모델을 에이전트 루프 깊숙이 넣을 수 없어서 포크했다고 설명합니다. Pi를 로컬 모델과 함께 쓰는 방법은 Gemma 4와 Pi Coding Agent 글에서 다룬 적이 있습니다. 이 글은 Jeff-Code의 두 가지 결정이 어떻게 동작하는지, 어댑터를 어떤 데이터로 학습했는지, 그리고 공개된 평가 수치를 어떻게 읽어야 하는지를 정리합니다.
매 턴 앞에서 Jeff가 내리는 두 가지 결정
Qwen이 턴을 시작하기 전에 Jeff-Code는 Jeff에게 질문 두 개를 보냅니다. 두 질문은 각각 다른 LoRA 어댑터가 답합니다. LoRA 어댑터는 베이스 모델의 가중치는 그대로 두고 작은 추가 가중치만 학습한 모듈입니다. 두 어댑터 모두 같은 Jeff v1.3 베이스 위에서 동작하므로 서버 하나에 함께 올릴 수 있습니다. README에 따르면 질문 하나에 약 0.2초가 걸리고, 평가 로그의 중앙값은 사고 여부 질문이 186ms, 단계 질문이 219ms였습니다.
결정 1: 정보 수집 단계는 Jeff가 먼저 실행합니다 (code 어댑터)
Jeff-Code는 매 턴 전에 지금까지 알려진 정보로 다음 단계 메뉴를 만듭니다. 메뉴에는 과제 설명이나 앞선 출력에 이미 등장한 파일, 폴더, 프로그램, 패키지만 들어갑니다. Qwen이 행동할 수 있는 대상과 같은 범위입니다. Jeff는 도구를 먼저 고르고 그다음 인자를 고릅니다. 가장 높은 선택지의 확률이 임계값 0.40 이상일 때만 그 단계를 실행하고, 아니면 Qwen에게 턴을 넘깁니다. JeffHub 페이지에 따르면 한 번에 최대 8단계까지 연속으로 실행할 수 있고, Qwen은 그 결과를 이미 받아 둔 상태로 턴을 시작합니다.
Jeff가 맡을 수 있는 단계는 다음과 같습니다.
- 파일 읽기, 폴더 목록 보기, 코드 검색, 설치된 도구 확인, 실행 중인 서비스와 포트 확인
- 테스트나 빌드 실행, Qwen이 직전에 실행한 명령 반복
- 실행 승인 설정이 허용할 때: Qwen이 작성한 스크립트 실행, 빠진 패키지 설치
파일 작성과 수정은 항상 Qwen이 맡습니다. 또한 학습과 실제 사용 조건을 같게 맞추려고, Jeff-Code 안에서 Qwen은 bash 도구만 씁니다. 학습에 쓰지 않은 채점용 과제에서 잰 오프라인 정확도는 92%입니다.
결정 2: 이번 턴에 깊게 생각할지 고릅니다 (code-router 어댑터)
code-router 어댑터는 Qwen의 사고 수준 네 가지(off, low, medium, xhigh)에 각각 확률을 매깁니다. 공개된 설정에서는 xhigh의 확률이 0.6 이상일 때만 사고를 켜고, 나머지 턴은 사고 없이 보냅니다. 평가에 쓴 실행에서는 low와 medium이 한 번도 쓰이지 않았습니다. 실제 동작은 "끄거나, 최대로 켜거나" 두 가지였던 셈입니다. 저자들의 테스트에서 Qwen의 low와 medium은 최대 수준과 거의 같은 길이로 생각해서, 시간을 줄여 주지 못했습니다.
Jeff가 돌려주는 확률이 보정되어 있다는 점이 여기서 중요합니다. 보정(calibration) 은 모델이 "60% 확신한다"고 했을 때 실제로도 약 60% 맞는 성질입니다. 확률이 보정되어 있으면 임계값 하나로 속도와 신중함 사이의 균형을 조절할 수 있습니다. 임계값을 높이면 사고를 켜는 턴이 줄어 빨라지지만 덜 신중해집니다. 같은 방식으로 잰 code-router 어댑터의 오프라인 정확도는 68%입니다.
Pi에서 함께 바뀐 안전장치
Jeff-Code는 두 어댑터 외에도 Pi의 에이전트 루프를 몇 군데 바꿨습니다. 이 중 루프 가드와 사고 토큰 상한은 평가에서 Jeff를 켠 설정에만 있었고, 기준선에는 없었습니다. 폭주 차단은 기준선을 포함한 모든 실행에서 켜져 있었습니다. 평가 결과를 읽을 때 다시 언급하므로 여기서 정리해 둡니다.
| 변경 | 내용 |
|---|---|
| 턴 단위 사고 설정 | Pi는 세션 전체에서 사고를 켜거나 끕니다. Jeff-Code는 턴마다 사고 수준을 고정값이나 Jeff의 판단으로 정합니다 |
| 루프 가드 | 최근 6단계 안에서 같거나 거의 같은 행동이 반복되면 그 답을 버리고 최대 사고로 다시 묻습니다. 명령이 두 번 연속 실패해도 다음 턴을 최대 사고로 보냅니다 |
| 폭주 차단 | Qwen의 사고나 출력이 같은 내용을 반복하면 응답을 멈추고 최대 사고로 다시 묻습니다 |
| 사고 토큰 상한 | 사고가 8,000토큰에 이르면 그때까지의 사고로 답하게 합니다. Pi 세션을 끝내 버리는 32K 출력 한도 초과도 이것으로 막습니다 |
| 서버 풀과 로그 | GPU마다 Jeff 서버를 하나씩 두고 한 주소로 묶습니다. Qwen 요청과 Jeff 결정은 모두 JSON Lines로 기록합니다 |
두 어댑터의 학습 데이터: Qwen이 실제로 한 행동을 라벨로 쓰기
두 어댑터 모두 Jeff가 "Qwen이라면 다음에 무엇을 할지"를 예측하도록 학습했습니다. 학습 데이터 자체는 공개하지 않았고, 데이터 출처와 라벨 생성 방법은 JeffHub 페이지와 모델 카드에 적혀 있습니다.
code 어댑터의 라벨은 기록된 Qwen 세션에서 Qwen이 실제로 다음에 실행한 정보 수집 단계입니다. 라벨은 코드로 만들었고, 다른 모델은 관여하지 않았습니다. 데이터는 세 단계로 모았고, 이 순서대로 커리큘럼 학습을 했습니다. 1단계 데이터는 3단계 데이터의 절반 크기로 줄여서 썼습니다.
- 공개 데이터셋 ukisai/Qwen3.8-27B-multi-turn-agent-sft의 Qwen3.8-27B 에이전트 세션 약 14,400개. 각 대화 기록에서 Jeff의 선택지 목록을 다시 만들었습니다
- 공개된 Qwen3.8-27B의 Terminal-Bench 세션. 각 과제의 컨테이너 안에서 다시 실행했습니다
- 저자들이 Jeff-Code에서 직접 돌린 Qwen3.8-27B 세션. Jeff는 행동하지 않고 매 턴 전에 선택지 목록만 기록했습니다
code-router 어댑터의 라벨은 더 손이 많이 갑니다. 먼저 Qwen이 최대 사고(xhigh)로 진행한 턴을 기록합니다. 그다음 같은 요청을 사고 off(temperature 0), low, medium 순서로 다시 보내고, 행동이 충분히 좋았던 첫 수준을 라벨로 삼습니다. 어느 수준도 충분하지 않으면 라벨은 xhigh입니다.
"충분히 좋다"는 우선 코드 규칙으로 판정합니다. 같은 종류의 단계를 같은 대상에 실행했으면 같은 의도로 봅니다. 코드 규칙으로 판정할 수 없으면 Alibaba Cloud DashScope에서 호스팅하는 Qwen3.8-Max가 판정합니다. 판정 모델은 과제와 최근 3단계를 보고 "이 시점에서 Step 2가 Step 1만큼 과제에 도움이 되는가?"에 예나 아니요로 답합니다. 인라인 스크립트, 프로그램 실행, 파일 작성과 수정, 최종 답변은 항상 판정 모델로 보냈습니다.
이렇게 만든 학습 라벨의 비율은 off 약 27%, low 약 8%, medium 약 5%, xhigh 약 60%입니다. README는 이렇게 엄격한 라벨 때문에 라우터가 조심스럽게 동작하고, 그 조심성이 통과율을 지킨다고 설명합니다. 모델 카드에 따르면 저자들은 더 느슨한 기준으로도 라벨을 만들어 봤습니다. 그렇게 학습한 라우터는 거의 모든 턴에서 사고를 꺼 버려서 쓰지 않았다고 합니다. 두 결정을 한 모델로 학습한 전체 미세조정본도 비교했는데, 오프라인 정확도가 사실상 같아서 어댑터를 공개했습니다.
평가에는 학습에 쓰지 않은 과제만 썼고, 저자들은 과제 단위로 분리했다고 밝힙니다. 모든 학습 과제를 평가 과제와 비교하는 누출 검사도 했다고 적었습니다.
| 벤치마크 | 평가 과제 | 학습 과제 | 분리 방식 |
|---|---|---|---|
| SWE-bench Verified | 500 (전체) | 0 | 이 벤치마크의 저장소는 학습에 쓰지 않음 |
| Terminal-Bench 2.0 | 40 | 45 | 89개 중 평가 과제와 거의 같은 4개는 양쪽에서 제외 |
| SWE-rebench | 189 | 671 | 저장소 단위로 분리 |
| Terminal-Bench Pro | 100 | 90 | 과제 단위 |
| SkillsBench | 44 | 42 | 과제 단위 |
| Harbor Index | 41 | 30 | 과제 단위 |
평가 결과: 통과율 차이 없이 과제당 시간 0.68배
비교 기준선은 같은 Jeff-Code 빌드에서 Jeff 기능을 모두 끈 Qwen3.8-27B입니다. 기준선은 모든 턴에서 최대 사고를 켜고, 사고 토큰 상한을 두지 않았습니다. README는 이것이 일반 Pi가 Qwen을 실행하는 방식이라고 설명합니다. 각 과제는 기준선과 Jeff-Code 설정으로 같은 시각에 같은 Qwen 서버에서 나란히 실행했고, 결과는 과제 단위로 짝지어 비교했습니다. 평가 보고서에 따르면 Qwen 서버는 두 종류였습니다. 하나는 B200에서 NVFP4로 vLLM 0.29를 돌렸고, 다른 하나는 H100에서 FP8로 vLLM 0.30을 돌렸습니다.
| 벤치마크 | 짝지은 과제 | Qwen 단독 | Jeff-Code | 통과율 차이, p (95 구간) | 과제당 시간 (95% 구간) |
|---|---|---|---|---|---|
| SWE-bench Verified | 486 | 70.6% | 70.8% | +0.4 (-3.5 ~ +4.3) | 0.63배 (0.57 ~ 0.69) |
| SWE-rebench (2회) | 370 | 58.9% | 58.1% | -0.8 (-5.7 ~ +3.5) | 0.66배 (0.61 ~ 0.73) |
| Terminal-Bench Pro (2회) | 195 | 61.2% | 62.8% | +1.5 (-4.6 ~ +7.7) | 0.64배 (0.55 ~ 0.76) |
| Terminal-Bench 2.0 (과제당 3회) | 108 | 75.9% | 70.0% | -4.6 (-12.1 ~ +3.7) | 0.96배 (0.78 ~ 1.16) |
| SkillsBench | 42 | 28.6% | 31.0% | +2.4 (-11.9 ~ +16.7) | 0.91배 (0.68 ~ 1.20) |
| Harbor Index | 41 | 12.2% | 9.8% | -2.4 (-12.2 ~ +7.3) | 0.71배 (0.51 ~ 0.99) |
| 6개 합산 | 1,242 | 62.8% | 62.4% | -0.2 (-2.6 ~ +2.1) | 0.68배 (0.64 ~ 0.72) |
표의 과제당 시간은 과제마다 "Jeff-Code 시간 / 기준선 시간" 비율을 구한 뒤 기하평균을 낸 값이고, 1보다 작으면 빠른 것입니다. 통과율 차이는 두 설정이 모두 끝난 과제만 세므로, 두 통과율의 단순 차이와 조금 다를 수 있습니다. 6개 벤치마크 모두에서 통과율 차이의 95% 구간이 0을 포함합니다. 즉, 어느 벤치마크에서도 통과율 차이가 확인되지 않았습니다. 과제당 시간의 중앙값은 0.70배였습니다.
전체 과제 시간의 합계는 0.86배(0.80 ~ 0.93)로, 과제당 평균보다 덜 줄었습니다. README의 설명에 따르면 약 5%의 과제에서 Jeff-Code가 기준선보다 30분 넘게 더 오래 돌았습니다. 기준선이 몇 분 만에 포기한 과제를 Jeff-Code는 시간 한도까지 계속 시도했기 때문입니다. 그 과제들에서 Jeff-Code는 26개, 기준선은 24개를 풀었습니다.
저자들은 사고를 단순히 끄는 설정과 임계값을 바꾼 설정도 함께 돌렸습니다. 두 설정 모두 Jeff-Code와 같은 안전장치를 썼습니다.
| 설정 | 짝지은 과제 | 통과율 차이, p (95 구간) | 과제당 시간 |
|---|---|---|---|
| 모든 턴에서 사고 끄기 | 752 | -7.6 (-10.6 ~ -4.5) | 0.55배 |
| Jeff, 사고 임계값 0.7 | 755 | -4.5 (-7.6 ~ -1.4) | 0.64배 |
| Jeff, 사고 임계값 0.6 (공개 설정) | 1,242 | -0.2 (-2.6 ~ +2.1) | 0.68배 |
사고를 모든 턴에서 끄면 시간이 가장 많이 줄지만, 통과율이 분명하게 떨어집니다. Terminal-Bench 2.0만 보면 -13.5%p까지 떨어졌습니다. 다만 위의 두 비교 설정은 SWE-bench Verified를 돌리지 않았습니다. 그래서 짝지은 과제 수가 공개 설정의 1,242개보다 적습니다.
결과를 읽을 때 확인할 점
"47% 빠름"과 "32% 단축"은 같은 숫자입니다
JeffHub 페이지와 README 첫 줄의 "47% 빠름"은 과제당 시간 0.68배의 역수(약 1.47)입니다. 같은 결과를 "과제당 시간 32% 단축"으로 읽을 수도 있습니다. 전체 작업량 기준으로 보면 시간 합계가 0.86배이므로 14% 줄었습니다. 여러 과제를 한꺼번에 돌릴 때 기대할 수 있는 절감은 과제당 평균보다 작을 수 있습니다.
시간 절감의 대부분은 사고를 끈 턴에서 나옵니다
평가 보고서의 동작 통계에서 공개 설정은 1,251개 세션, 82,435개 Qwen 턴을 기록했습니다. 그중 74.1%가 사고 없이 돌았습니다. 반면 Jeff가 Qwen 대신 실행한 단계는 2,600번으로, 세션당 약 2번이고 턴 수의 약 3%입니다. 보고서에는 두 어댑터 중 하나만 켠 설정이 없어서, 각 어댑터가 시간 절감에 얼마나 기여했는지는 따로 측정되지 않았습니다. 다만 위 횟수로 보면, 시간 절감은 주로 code-router가 사고를 끈 턴에서 나왔을 가능성이 큽니다. 이 판단은 보고서의 횟수에 근거한 편집자의 해석입니다.
기준선과의 차이에는 안전장치도 포함됩니다
기준선에는 루프 가드와 사고 토큰 상한이 없고, Jeff-Code 설정에는 있습니다. 공개 설정에서 사고 토큰 상한으로 잘린 응답은 458번, 루프 가드가 다시 물은 경우는 3,139번이었습니다. 따라서 기준선 대비 0.68배라는 수치는 Jeff의 두 결정과 안전장치를 함께 넣은 결과입니다. Jeff의 결정만의 효과에 가까운 비교 대상은 같은 안전장치를 쓴 "모든 턴에서 사고 끄기" 설정입니다. 과제 구성이 같지는 않지만(이 설정은 SWE-bench Verified를 돌리지 않았습니다), Jeff는 시간을 0.55배에서 0.68배로 조금 더 쓰는 대신 통과율 7.6%p 하락을 피했습니다.
벤치마크마다 결과가 다릅니다
Terminal-Bench 2.0에서는 과제당 시간이 0.96배로, 속도 향상이 확인되지 않았습니다. 통과율 차이도 -4.6%p이고 95% 구간이 -12.1%p까지 내려가므로, 5%p 넘는 하락을 배제할 수 없습니다. 보고서도 이 벤치마크에서는 목표를 충족하지 못했다고 판정했습니다. SkillsBench와 Harbor Index는 과제가 41~42개뿐이라 구간이 넓습니다. 원본 Terminal-Bench와 Terminal-Bench Science도 돌렸지만, 두 설정 모두 0%를 풀어 합산에서 뺐습니다.
보고서가 밝힌 측정 조건
- 보고서 제목은 "final report"이지만 머리에 INTERIM 표시가 있습니다. 수집 시점에 아직 실행 중인 세션이 있었고(공개 설정과 기준선에서 10개), 이 세션들은 짝을 이루지 못해 비교에서 빠졌습니다. 모델 카드는 수치를 관리자의 자체 보고(Self-reported)로 표시하며, 다른 사람이 다시 실행한 결과는 아직 없습니다. 평가 세트도 아직 카드에 첨부되지 않았습니다.
- 프로젝트 소유자가 정한 목표는 "같은 통과율에서 25% 빠르게"였습니다. "같은 통과율"을 95% 구간 하한이 -5%p 위에 있는 것으로 정한 기준은 소유자가 아니라 보고서가 고른 것입니다.
- Jeff 설정의 일부 세션은 Jeff 서버 용량 문제를 고친 뒤 몇 시간 늦게 다시 돌렸습니다. 같은 Qwen 서버였지만 서버 부하는 달랐을 수 있습니다. 합산에 들어간 재실행 블록은 63개입니다.
- 시스템이 세션을 강제 종료한 27개 블록(메모리 부족 등)과 하네스 버그가 있던 Terminal-Bench 2.0 과제
pytorch-model-recovery는 모든 설정에서 뺐습니다.
적용 범위
두 어댑터는 Jeff-Code와 Qwen3.8-27B 조합에서만 측정되었고, Jeff-Code가 요청을 직접 만들어 보냅니다. 다른 코딩 모델이나 다른 에이전트에 그대로 쓸 수 있는지는 확인되지 않았습니다. 어댑터는 학습한 베이스 버전에 묶여 있어서 Jeff v1.3 베이스에서만 동작합니다.
모델 카드의 language 필드는 영어(en) 하나이고, 평가한 6개 벤치마크도 영어 과제입니다. 따라서 한국어로 과제를 지시했을 때의 동작은 검증되지 않았습니다.
README는 이 저장소를 연구용 코드로 소개합니다. 모든 개발과 측정은 벤치마크 컨테이너(Harbor) 안에서 했습니다. 대화형 사용도 동작하지만 테스트는 훨씬 적었다고 README는 밝힙니다.
직접 실행해 보려면
Jeff-Code를 실행하려면 두 서버가 필요합니다. 하나는 OpenAI 호환 API로 Qwen3.8-27B를 서빙하는 서버(예: vLLM)이고, 다른 하나는 두 어댑터를 올린 Jeff 서버입니다. 아래 명령은 README의 실행 절차를 그대로 옮긴 것입니다.
- Jeff 저장소의 안내대로 Jeff를 설치합니다.
- Jeff-Code 저장소 루트에서, Jeff 환경의 Python으로 베이스 모델과 두 어댑터를 받은 뒤 Jeff 서버를 실행합니다.
jeff_serve.py는 Jeff-Code 저장소의tools/jeff-first/에 있습니다. 어댑터 폴더 이름은 Jeff-Code가 요청할 때 쓰는 어댑터 이름이므로 그대로 둡니다.
hf download mstrasser/jeff-base --revision v1.3 --local-dir jeff-base-v1.3
hf download mstrasser/jeff-adapter-code --revision v1.3 --local-dir adapters/jeff-step
hf download mstrasser/jeff-adapter-code-router --revision v1.3 --local-dir adapters/jeff-router
JEFF_CHECKPOINT=jeff-base-v1.3 JEFF_ADAPTERS=adapters JEFF_DEVICE=cuda JEFF_HOST=0.0.0.0 PORT=8920 \
  JEFF_CPU_THREADS=8 python tools/jeff-first/jeff_serve.py      # with the Python of the Jeff environment
- Jeff-Code 저장소 루트에서
npm install && npm run build로 빌드합니다. ~/.jeff/agent/models.json에 Qwen을 OpenAI 호환 모델로 추가합니다."reasoning": true,"compat": {"thinkingFormat": "qwen-chat-template"},"maxTokens": 32768을 넣어야 합니다.- 평가에 쓴 설정으로 환경 변수를 지정하고 실행합니다.
export JEFF_FIRST_MODE=jeff
export JEFF_FIRST_JEFF_URL=http://localhost:8920
export JEFF_FIRST_JEFF_STEP_ADAPTER=jeff-step
export JEFF_FIRST_JEFF_STEP_THRESHOLD=0.40               # Jeff's top option needs 0.40, otherwise Qwen takes over
export JEFF_FIRST_THINKING_ROUTER=jeff-off-unless:jeff-router:0.6
export JEFF_FIRST_THINKING_LIMIT=8000
export JEFF_FIRST_OUTPUT_TRIM=off                      # required; leave off
export JEFF_FIRST_RUN_APPROVAL=all                       # all, seen or never: may Jeff run scripts Qwen wrote and install packages
export JEFF_FIRST_DRIVER_BUILD=qwen3.8-27b               # the exact Qwen build, written to the trace
export JEFF_FIRST_TRACE_FILE=$HOME/jeff-code/trace.jsonl # its folder must exist
export JEFF_FIRST_TASK_ID=my-project
./jeff-test.sh
jeff 모드에서는 모든 설정이 필수입니다. 하나라도 빠지거나 값이 잘못되면 JeffFirst:로 시작하는 오류를 내고 멈춥니다. JEFF_FIRST_MODE를 지우면 Jeff 없는 일반 Pi로 동작합니다.
컨테이너 밖에서 실행한다면, JEFF_FIRST_RUN_APPROVAL 값을 먼저 정해야 합니다. 평가는 벤치마크 컨테이너 안에서 all로 돌았습니다. all은 Jeff가 Qwen이 작성한 스크립트를 실행하고 apt나 pip으로 패키지를 설치하는 것을 허용합니다. 코드상 seen은 그 과제에서 이미 한 번 실행된 스크립트의 재실행과, Qwen이 이미 쓴 설치 도구(apt 또는 pip)만 허용합니다. never는 둘 다 막습니다.
llama.cpp로 Jeff를 돌릴 수도 있습니다. GGUF 버전은 Hugging Face의 -gguf 저장소에 있습니다. JeffHub 페이지에 따르면 code 어댑터는 Q4_K_M에서도 전체 정밀도와 97.9% 같은 행동을 했습니다. 반면 code-router 어댑터는 Q4_K_M에서 사고 켜기와 끄기 판단의 약 6%가 바뀌었습니다(Q8_0에서는 0.8%). 그래서 저자들은 code-router를 Q8_0 베이스에서만 서빙하라고 안내합니다. 자세한 방법은 Running Jeff with llama.cpp 문서에 있습니다.
라이선스
Jeff-Code 코드는 Pi에서 이어받은 MIT 라이선스로 배포되어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. code와 code-router 어댑터, 그리고 Jeff v1.3 베이스 모델은 Apache License 2.0입니다. 다만 두 모델 카드는 학습에 쓴 세션 데이터와 벤치마크 과제의 라이선스가 어댑터 학습과 공개를 허용하는지를 아직 확인 중(To confirm)이라고 적고 있습니다. code-router 카드는 판정에 쓴 호스팅 모델(Qwen3.8-Max)의 이용 약관도 확인 중이라고 밝힙니다. 따라서 어댑터를 상업적으로 쓰려면, 이 항목들이 확정되었는지 모델 카드에서 먼저 확인해야 합니다.
 Jeff-Code GitHub 저장소
 Jeff-Code 소개 페이지 (JeffHub)
 code 어댑터 모델 카드 (정보 수집 단계)
code-router 어댑터 모델 카드 (사고 여부 판단)
Jeff GitHub 저장소 (0.8B 결정 모델)
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
-
Gemma 4와 Pi Coding Agent로 완전히 로컬에서 실행하는 코딩 에이전트 만들기 (feat. LM Studio)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
