Liquid AI d1 소개
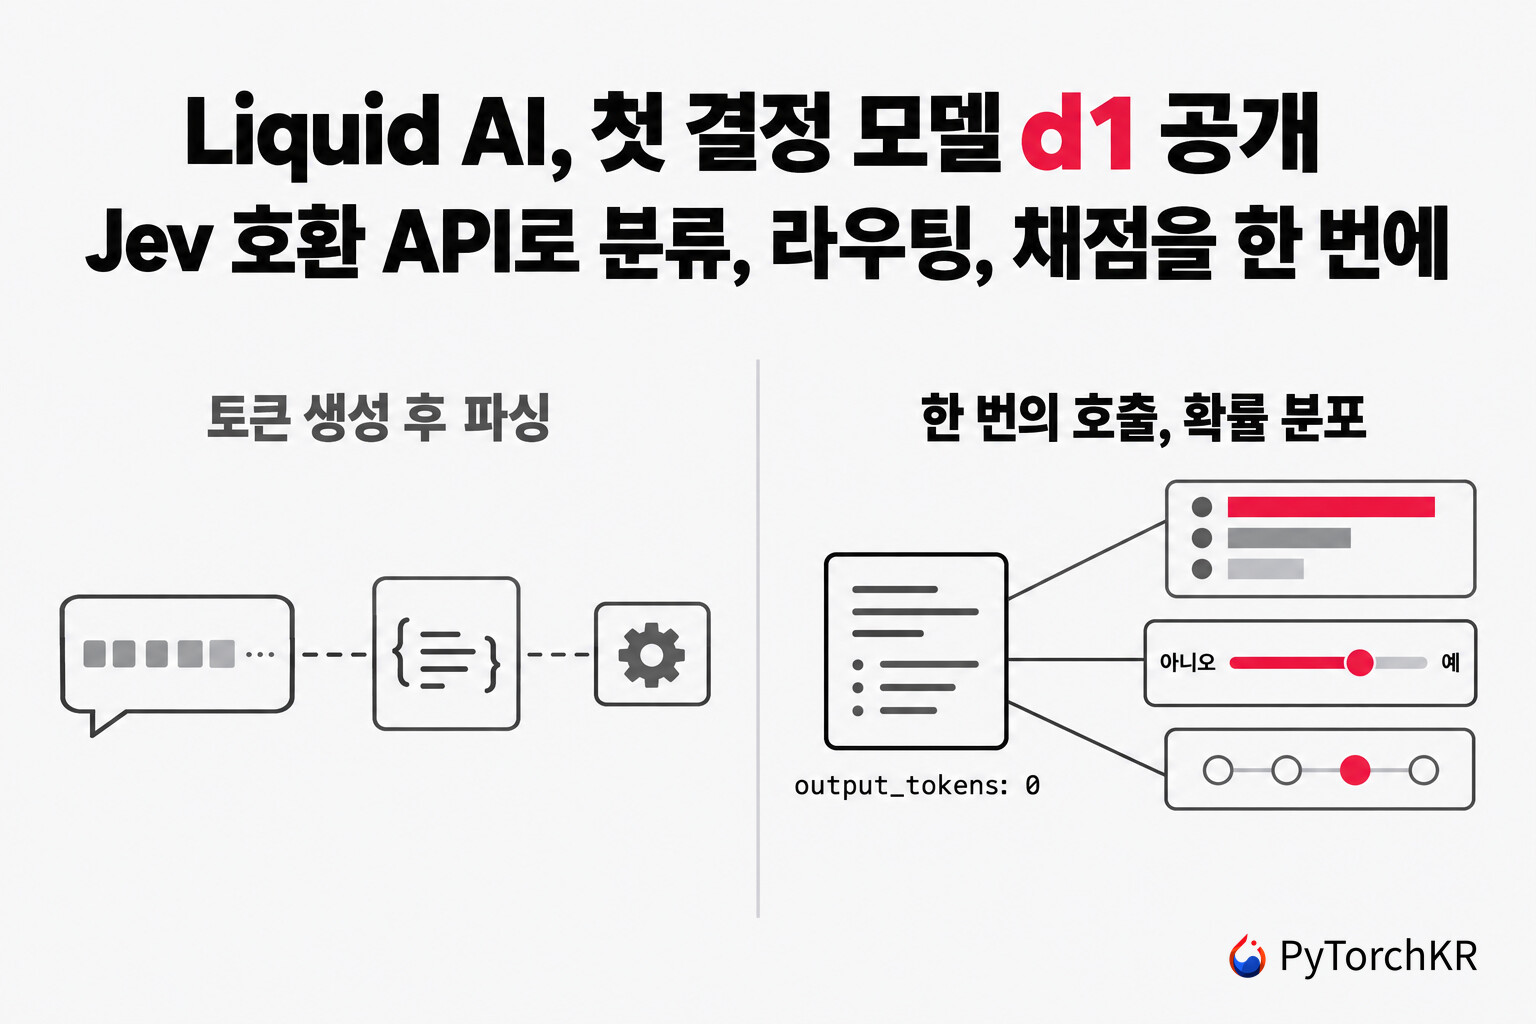
Liquid AI가 공개한 d1 은 문장을 생성하지 않고, 애플리케이션이 미리 정한 선택지에 대한 확률을 한 번의 호출로 돌려주는 이 회사의 첫 결정 모델(Decision Model) 입니다. 고객 문의를 어느 팀으로 보낼지, 이 메시지가 유해한지, 장애의 긴급도가 어느 단계인지처럼 답의 후보가 호출 전에 정해져 있는 판단을 겨냥하며, 응답의 output_tokens 는 항상 0입니다. 가중치는 공개되지 않았고 Liquid API로만 제공됩니다.
d1을 이해하려면 먼저 이 모델이 들어선 자리를 봐야 합니다. 2026년 9월 TypeSafe AI가 System One 모델 이라는 이름으로 Jev를 공개하면서, 토큰 대신 타입이 정해진 확률적 결정을 내놓는 모델이라는 범주가 생겼습니다. 이후 몇 주 사이에 Jev를 공개 가중치로 재현하려는 프로젝트가 쏟아졌습니다. PyTorchKR에서도 kev, vLLM Semantic Router 팀의 Decision 1.0, Laya를 소개했고, 1천여 개 프로젝트를 정리한 Jev 생태계 목록도 나왔습니다. d1은 LFM 시리즈로 소형 모델을 만들어 온 기존 모델 회사가 이 흐름에 자체 API로 합류한 사례입니다.
d1에서 가장 먼저 눈에 띄는 점은 인터페이스가 Jev와 같다 는 것입니다. 질문 유형 이름(Noul, Choice, Score)이 같고, 공식 문서의 Python 예제는 TypeSafe가 배포하는 typesafe-sdk의 TypeSafeClient 에 base_url="https://api.liquid.ai" 만 바꿔 넣어 호출합니다. 엔드포인트 경로도 /decisions/v1/systemone 입니다. 따라서 이미 Jev로 판단 로직을 짠 개발자라면 API 키, 주소, 모델 이름 세 가지만 바꿔 d1을 시험할 수 있습니다.
이 글은 Liquid AI가 공개한 결정 모델 문서, LLM 호출을 결정 모델로 옮기는 가이드, 실시간 레이싱 게임 예제인 Road Decider, 그리고 X 발표 게시물을 함께 읽고 정리했습니다. 별도의 기술 블로그나 기술 보고서는 아직 없으며, 발표 게시물의 벤치마크 수치는 공개 리더보드 데이터와 대조해 따로 살펴봅니다.
LLM 호출을 결정 모델로 바꿔야 하는 경우
Liquid AI의 가이드는 이전 대상을 한 문장으로 정리합니다. 답이 N개의 알려진 선택지 중 하나라면 결정 모델을, 모델이 새로 지어내야 하는 문자열이라면 LLM을 쓰라는 것입니다. 가이드는 이를 경계가 있는 결정(Bounded Decision) 이라고 부르며, 가능한 답의 집합이 호출 전에 정해져 있는 경우를 가리킵니다.
현재 많은 서비스는 분류나 라우팅에도 LLM의 구조화된 출력(Structured Output)을 씁니다. Pydantic 모델이나 JSON 스키마로 enum을 정의하고, 모델이 그 스키마에 맞게 토큰을 생성하면 파싱합니다. 이 방식은 동작은 하지만 한 단어짜리 답에도 출력 토큰을 과금하고, 답이 길어질수록 지연이 늘며, 모델이 스스로 적은 "confidence": 0.9 는 실제 정답 확률과 무관한 문자열입니다. 가이드는 두 방식의 차이를 다음과 같이 비교합니다.
| 항목 | LLM | 결정 모델 (d1) |
|---|---|---|
| 출력 | 생성된 토큰을 파싱해 라벨로 변환 | 확률이 붙은 타입 지정 결정 |
| 지연 | 출력 길이와 추론 길이에 따라 증가 | 생성할 토큰이 없어 낮고 예측 가능 |
| 출력 토큰 | 한 단어 답에도 과금 | 0 |
| 불확실성 | 없거나, 신뢰하기 어려운 자기 보고 수치 | 모든 답에 보정된 확률 |
| 스키마 오류 | 깨진 JSON, 스키마 밖 값 가능 | 없음. 답은 항상 질문 유형과 일치 |
| 여러 판단 | 순차 호출 또는 복잡한 프롬프트 | 한 번의 호출에서 병렬 평가 |
반대로 이메일, 요약, 코드 같은 텍스트 생성, 자연어로 답해야 하는 열린 질의응답, 멀티턴 대화, 수학이나 계획처럼 여러 단계를 거치는 추론은 여전히 LLM의 몫이라고 가이드는 명시합니다. 결정 모델 문서가 꼽는 적합한 용도는 분류, 라우팅, 채점, 분류 후 우선순위 지정(Triage), 콘텐츠 모더레이션, 가드레일, LLM 평가자(LLM-as-a-Judge) 대체, 에이전트의 도구 호출 승인, 모델 라우팅과 캐스케이드입니다.
위 표에서 "보정된 확률"은 Liquid AI의 설명이라는 점은 짚어 둘 필요가 있습니다. 문서에는 d1의 보정(Calibration) 을 측정한 수치, 예를 들어 예측 확률과 실제 정답률의 차이를 나타내는 ECE(Expected Calibration Error) 같은 값이 없습니다. 발표 다음 날 외부 벤치마크가 d1의 ECE를 처음 측정했는데(아래 "외부에서 측정한 첫 결과" 참고), 그 벤치마크도 영어 합성 데이터라 한계가 분명합니다. 확률이 정말 정답률과 맞는지는 결국 각자 레이블이 있는 데이터로 확인해야 합니다.
세 가지 질문 유형: Noul, Choice, Score
d1에 던지는 모든 질문은 세 유형 중 하나입니다. 문서는 코드가 필요로 하는 답의 모양에 맞춰 유형을 고르라고 권합니다.
| 답의 형태 | 유형 | 반환값 | 예시 |
|---|---|---|---|
| 순서 없는 범주 중 하나 | Choice | 선택한 옵션, 옵션별 확률, confidence |
이 티켓은 어느 부서가 처리해야 하나? |
| 단계가 정의된 순서형 척도 | Score | 확률 가중 점수, 단계별 확률, confidence |
이 버그는 얼마나 심각한가? |
| 예/아니오, 확률 자체가 쓸모 있는 경우 | Noul | 0에서 1 사이의 확률 하나 | 이 메시지에 개인정보가 들어 있나? |
Noul 은 예일 확률 하나를 돌려줍니다. 문서는 이를 슬라이딩 스케일 위의 불리언에 비유합니다. 한 가지 주의할 점은 0.5가 "중간 정도"라는 뜻이 아니라 예와 아니오 사이에서 가장 불확실하다는 뜻이라는 것입니다. 숙련도, 불만의 정도, 심각도처럼 정도 를 재고 싶다면 Noul이 아니라 단계를 정의한 Score를 써야 합니다.
Choice 는 가장 확률이 높은 옵션과 전체 분포, 그리고 답이 얼마나 뚜렷한지를 요약한 confidence 를 함께 돌려줍니다. 2순위 옵션에 확률이 얼마나 몰려 있는지 알 수 있으므로, 애매한 사례를 표시하거나 대체 경로로 보내는 데 쓸 수 있습니다.
Score 는 사용자가 나열한 단계를 0부터 번호를 매기고, 각 단계의 확률로 가중 평균한 연속값을 돌려줍니다. 문서의 응답 예시들을 대조해 보면 점수는 다음 식과 일치합니다.
여기서 K 는 단계 수, p_i 는 i 번째 단계의 확률입니다. 예를 들어 3단계 긴급도 질문에서 p_1 = 0.004, p_2 = 0.996 이면 점수는 1 \times 0.004 + 2 \times 0.996 = 1.996 이 되고, 문서의 응답도 1.996 입니다. 점수가 정수로 강제되지 않으므로, 코드에서 score >= 2.5 처럼 임계값을 걸 수 있습니다.
문서는 유형을 고르기 어려울 때 코드가 다음에 무엇을 하는지를 기준으로 삼으라고 합니다. 범주에 따라 분기하면 Choice, 연속값을 임계값과 비교하면 Score, 불리언으로 통과 여부를 가르면 Noul입니다.
첫 번째 호출과 응답 읽기
API 키는 Liquid 콘솔의 Dashboard > API Keys 에서 발급하며 liquid_ 로 시작합니다. 한 번의 호출에는 모델 이름, 판단할 상태(state), 그리고 이름이 붙은 질문 목록이 들어갑니다. 상태는 고객 메시지나 로그 같은 일반 텍스트여도 되고, 필드가 있는 JSON 객체여도 됩니다.
pip install typesafe-sdk
import os
from typesafe_sdk import TypeSafeClient, Noul

client = TypeSafeClient(
    api_key=os.environ["LIQUID_API_KEY"],
    base_url="https://api.liquid.ai",
)

result = client.system_one(
    model="d1:free",
    state="I have been waiting over three weeks for my order and nobody has responded to my emails. This is completely unacceptable.",
    questions={
        "is_complaint": Noul(
            instructions="Is this message a complaint from the customer?",
        ),
    },
)
print(result.answers["is_complaint"].noul)  # 0.999
TypeScript는 @typesafe-ai/sdk의 client.systemOne() 을 쓰고, SDK 없이 cURL로 https://api.liquid.ai/decisions/v1/systemone 에 같은 JSON을 보내도 됩니다. 응답은 질문 이름을 키로 하는 answers 와 사용량 정보로 구성됩니다.
{
  "model": "d1:free",
  "answers": {
    "is_complaint": {
      "type": "noul",
      "noul": 0.999
    }
  },
  "usage": {
    "input_tokens": 84,
    "output_tokens": 0
  }
}
usage.input_tokens 는 상태와 질문을 평가하는 데 쓴 토큰 수이고, output_tokens 는 결정 모델이 토큰을 생성하지 않으므로 항상 0입니다. 즉 비용과 지연은 입력 길이, 곧 상태와 질문 설명의 길이가 좌우합니다.
한 번의 호출로 분류, 라우팅, 우선순위를 함께 판단하기
결정 모델의 실용적인 이점은 같은 상태에 서로 다른 유형의 질문을 한꺼번에 던질 수 있다는 데 있습니다. 문서의 예제는 결제 페이지 오류 티켓 하나에 대해 버그 여부(Noul), 담당 팀(Choice), 긴급도(Score)를 한 번에 묻습니다. 상태에는 메시지와 함께 요금제, 연간 반복 매출(ARR), 가입일 같은 계정 정보를 JSON으로 넣었습니다.
import json
from typesafe_sdk import Choice, Noul, Score

ticket = {
    "message": "The checkout page crashes with a white screen whenever I try to apply a promo code. I've tried three different browsers. This is blocking a $4,200 order for our team and we need to place it before our procurement window closes on Friday.",
    "account": {
        "plan": "enterprise",
        "arr": 52000,
        "customer_since": "2022-03-15",
    },
}

result = client.system_one(
    model="d1:free",
    state=json.dumps(ticket),
    questions={
        "is_bug": Noul(
            instructions="Is the customer reporting a software bug (as opposed to a usage question, feature request, or account issue)?",
        ),
        "team": Choice(
            instructions="Which team should handle this ticket?",
            criteria={
                "billing": "Billing, invoicing, charges, and payment method issues",
                "engineering": "Software bugs, crashes, and technical malfunctions",
                "frontend": "UI/UX issues, display problems, and browser-specific bugs",
                "account": "Account setup, permissions, plan changes, and access issues",
            },
        ),
        "urgency": Score(
            instructions="How urgent is this ticket? Consider business impact, time sensitivity, and customer tier.",
            criteria=[
                "Low: no immediate impact, standard queue",
                "Medium: some business impact, handle within 24 hours",
                "High: significant business impact or time-sensitive, handle within 4 hours",
            ],
        ),
    },
)
Choice의 criteria 는 옵션 이름과 설명을 담은 딕셔너리이고, Score의 criteria 는 순서가 있는 리스트라는 차이가 있습니다. 응답은 다음과 같습니다.
{
  "is_bug": {
    "type": "noul",
    "noul": 0.9998
  },
  "team": {
    "type": "choice",
    "choice": "engineering",
    "probabilities": {
      "engineering": 0.80,
      "frontend": 0.18,
      "billing": 0.02,
      "account": 0.0005
    },
    "confidence": 0.74
  },
  "urgency": {
    "type": "score",
    "score": 1.996,
    "confidence": 0.995,
    "probabilities": {
      "0": 0.0002,
      "1": 0.004,
      "2": 0.996
    },
    "legend": {
      "0": "Low: no immediate impact, standard queue",
      "1": "Medium: some business impact, handle within 24 hours",
      "2": "High: significant business impact or time-sensitive, handle within 4 hours"
    }
  }
}
이 응답에서 담당 팀 질문은 흥미로운 사례입니다. 프로모션 코드 적용 시 흰 화면이 뜨는 문제는 engineering 과 frontend 양쪽에 걸쳐 있고, 모델도 0.80과 0.18로 확률을 나눴습니다. 그런데 confidence 는 1순위 확률인 0.80이 아니라 0.74입니다. Liquid AI 문서는 confidence 를 답이 얼마나 뚜렷한지 요약한 값이라고만 설명하지만, 같은 SDK를 만든 TypeSafe의 확신도 문서는 이 값이 확률 분포의 퍼짐으로부터 계산되며, 한 옵션에 확률이 모두 몰리면 1, 고르게 퍼질수록 낮아진다고 설명합니다. 그 문서가 데모에서 쓰는 근사식은 옵션 수 K 와 1순위 확률 p_{\max} 로 다음과 같습니다.
d1 문서의 응답에 이 식을 대입하면 값이 거의 맞습니다. 옵션 4개에 p_{\max} = 0.80 이면 (3.2 - 1)/3 pprox 0.73 이고(응답은 0.74), 옵션 5개에 0.9997인 부서 분류 예시는 0.9996, 4단계 Score에 0.9996인 긴급도 예시는 0.9995로 응답과 같습니다. 즉 confidence 는 1순위 확률이 아니라 옵션 수로 보정한 값이므로, 옵션이 많을수록 같은 1순위 확률에서도 더 낮게 나옵니다. 임계값을 정할 때 1순위 확률과 혼동하면 안 됩니다. Noul 답에는 confidence 가 없습니다.
문서의 후처리 코드는 세 답을 조합해 에스컬레이션 여부를 정하고, 팀 판단의 confidence 가 0.5 미만이면 2순위 팀을 함께 표시합니다.
answers = result.answers

is_bug = answers["is_bug"].noul > 0.7
team = answers["team"].choice
team_confidence = answers["team"].confidence
urgency = answers["urgency"].score

if is_bug and urgency > 1.5:
    print(f"ESCALATE to {team} on-call (SLA: 4h)")
elif urgency > 1.0:
    print(f"PRIORITIZE in {team} queue (SLA: 24h)")
else:
    print(f"QUEUE in {team} standard backlog")

if team_confidence < 0.5:
    probs = answers["team"].probabilities
    runner_up = sorted(probs.items(), key=lambda x: x[1], reverse=True)[1]
    print(f"NOTE: Routing uncertain. Runner-up: {runner_up[0]} ({runner_up[1]:.0%})")

# ESCALATE to engineering on-call (SLA: 4h)
# The NOTE line only prints when team confidence is below 0.5.
이 구조는 TypeSafe가 Jev 문서에서 권했던 원자적인 질문을 여러 개 던지고, 결합은 코드에서 하라는 설계 원칙과 같습니다. 정책이 바뀌면 프롬프트를 다시 쓰는 대신 0.7, 1.5 같은 임계값이나 조건문을 고치면 됩니다.
기존 LLM 호출을 d1로 옮기는 방법
결정 모델 가이드는 여섯 가지 작업 유형마다 같은 문제를 LLM과 d1로 푼 코드를 나란히 보여 줍니다. LLM 쪽 예제는 OpenAI 호환 엔드포인트라면 어디서나 동작하는 OpenAI Python SDK의 client.chat.completions.parse() 를 씁니다.
| 작업 | 기존 LLM 패턴 | d1의 유형 |
|---|---|---|
| 분류 | enum이나 JSON 스키마를 쓴 구조화된 출력 | Choice |
| 라우팅 | 목록에서 하나를 고르게 하는 프롬프트 | Choice |
| 이진 판단 | true/false를 돌려주는 프롬프트 | Noul |
| 채점 | 숫자나 등급을 돌려주는 프롬프트 | Score |
| 재순위화 | 검색 결과를 LLM이 채점하거나 거름 | Noul 또는 Score |
| 여러 판단 | 같은 입력에 분류 호출을 여러 번 | 조합해서 한 번에 |
분류: Pydantic 스키마에서 criteria로
LLM 방식은 Literal 로 부서 목록을 정의한 Pydantic 모델을 response_format 으로 넘기고, 파싱된 값을 읽습니다.
from pydantic import BaseModel
from typing import Literal

class Classification(BaseModel):
    department: Literal["billing", "technical", "shipping", "returns", "account"]

inquiry = "I was charged twice for my subscription last month."

completion = client.chat.completions.parse(
    model="your-model",
    messages=[
        {
            "role": "system",
            "content": "Classify this customer inquiry into a department.",
        },
        {"role": "user", "content": inquiry},
    ],
    response_format=Classification,
)

department = completion.choices[0].message.parsed.department  # "billing"
d1에서는 스키마 클래스가 사라지고, 각 옵션의 설명이 라벨 옆 criteria 에 들어갑니다. 대신 1순위 답과 함께 전체 분포를 받습니다.
from typesafe_sdk import Choice

inquiry = "I was charged twice for my subscription last month."

result = client.system_one(
    model="d1:free",
    state=inquiry,
    questions={
        "department": Choice(
            instructions="Which department should handle this customer inquiry?",
            criteria={
                "billing": "Charges, invoices, refunds, or payment methods",
                "technical": "Bug reports, feature requests, or how-to questions",
                "shipping": "Order status, delivery tracking, or address changes",
                "returns": "Return requests, exchanges, or product condition",
                "account": "Login issues, profile updates, or subscription management",
            },
        ),
    },
)

department = result.answers["department"].choice       # "billing"
confidence = result.answers["department"].confidence    # 0.99
runner_up = sorted(
    result.answers["department"].probabilities.items(),
    key=lambda x: x[1], reverse=True,
)[1]  # ("account", 0.0006)
라우팅: 불확실하면 더 강한 모델로
가이드가 드는 라우팅 예제는 작은 LLM으로 요청의 난이도를 가려 fast, standard, powerful 등급의 모델로 보내는 패턴입니다. d1로 바꾸면 라우터 자체가 confidence 를 내므로, 판단이 애매할 때 가장 강한 등급으로 보내는 대체 경로를 코드 몇 줄로 만들 수 있습니다. 등급을 추가하거나 빼는 일도 프롬프트를 다시 쓰지 않고 criteria 만 고치면 됩니다.
route = result.answers["route"]
selected = route.choice        # "fast"
confidence = route.confidence  # 0.98

# If the router is uncertain, fall back to the most capable tier
if confidence < 0.5:
    selected = "powerful"
이진 판단과 채점: 임계값을 코드로
모더레이션 예제에서 LLM은 is_harmful: bool 하나를 돌려주지만, d1의 Noul은 0.98 같은 확률을 돌려줍니다. 그래서 0.8 초과는 차단, 0.2 미만은 허용, 그 사이는 사람 검토로 보내는 3단 정책을 코드로 짤 수 있습니다. 가이드는 결정 모델이 같은 입력을 반복 평가할 때 결과가 더 일관적이어서 판정이 뒤집히는 일이 줄어든다고도 적었지만, 이를 뒷받침하는 측정값은 제시하지 않았습니다.
채점 예제도 같은 방식입니다. LLM은 Literal[1, 2, 3, 4] 로 정수를 강제하는 반면, d1의 Score는 2.999 같은 연속값과 단계별 분포를 함께 돌려줍니다. 가이드는 이를 JSON 파싱, 스키마 검증, 형식 오류로 인한 재시도가 모두 사라지는 변화로 설명합니다.
재순위화: 호출 수는 그대로
검색 증강 생성(Retrieval-Augmented Generation, RAG) 파이프라인에서 검색된 청크의 관련성을 LLM이 1~5점으로 매기던 부분을 Noul로 바꾸는 예제도 있습니다. 관련성 점수가 확률이므로 "0.5 초과만 남긴다"처럼 기준을 바로 정할 수 있다는 것이 가이드의 설명입니다.
scored_chunks = []
for chunk in chunks:
    result = client.system_one(
        model="d1:free",
        state=f"Query: {query}\n\nPassage: {chunk}",
        questions={
            "relevant": Noul(
                instructions="Is this passage relevant to answering the query?",
            ),
        },
    )
    scored_chunks.append({
        "chunk": chunk,
        "score": result.answers["relevant"].noul,
    })

top_chunks = sorted(scored_chunks, key=lambda x: x["score"], reverse=True)
# Each score is a calibrated probability (0.0 to 1.0).
# Set a threshold to filter: [c for c in scored_chunks if c["score"] > 0.5]
다만 코드를 보면 청크마다 한 번씩 호출하는 반복문은 LLM 버전과 똑같이 남아 있습니다. 여러 질문을 한 번에 묻는 이점은 같은 상태 에 대한 질문에만 적용되고, 청크마다 상태가 다른 재순위화에서는 호출 수가 줄지 않습니다. 가이드가 말하는 이득은 각 호출이 더 빠르고 싸다는 쪽이며, 비교 대상인 BGE Reranker 같은 전용 교차 인코더(Cross-Encoder) 재순위화 모델과의 비교는 없습니다.
여러 판단: 세 번의 왕복을 한 번으로
마지막 예제는 의도 분류, 긴급도 채점, 버그 여부 판단을 LLM에 세 번 따로 호출하던 코드를 d1 호출 한 번으로 합칩니다. 가이드는 네트워크 왕복이 세 번에서 한 번으로 줄고, 세 판단이 정확히 같은 상태를 보고 내려지며, 질문이 병렬로 평가되므로 질문을 하나 더 넣어도 지연이 거의 늘지 않는다고 설명합니다. LLM도 세 스키마를 하나로 합쳐 한 번에 호출할 수는 있지만, 그 경우에도 라벨만 받고 확률은 받지 못한다는 점을 가이드는 함께 지적합니다.
심화 학습: 결정 모델의 설계 패턴

실시간 게임 루프 안에서 d1 쓰기: Road Decider 예제
Liquid AI의 cookbook 저장소에 추가된 Road Decider는 결정 모델을 1초에 여러 번 호출하는 상황을 보여 주는 픽셀 아트 레이싱 게임입니다. 두 대의 차가 똑같은 도로를 나란히 달리고, 도로는 시간이 갈수록 빨라집니다. 차마다 목숨이 세 개씩 있고 다른 차와 부딪히면 하나씩 잃으며, 결승선 없이 한쪽의 목숨이 모두 떨어질 때까지 경주가 이어집니다. 방향키로 직접 d1과 겨루는 You vs d1 모드와, 두 결정 모델이 대결하는 Jev vs d1 모드가 있습니다.
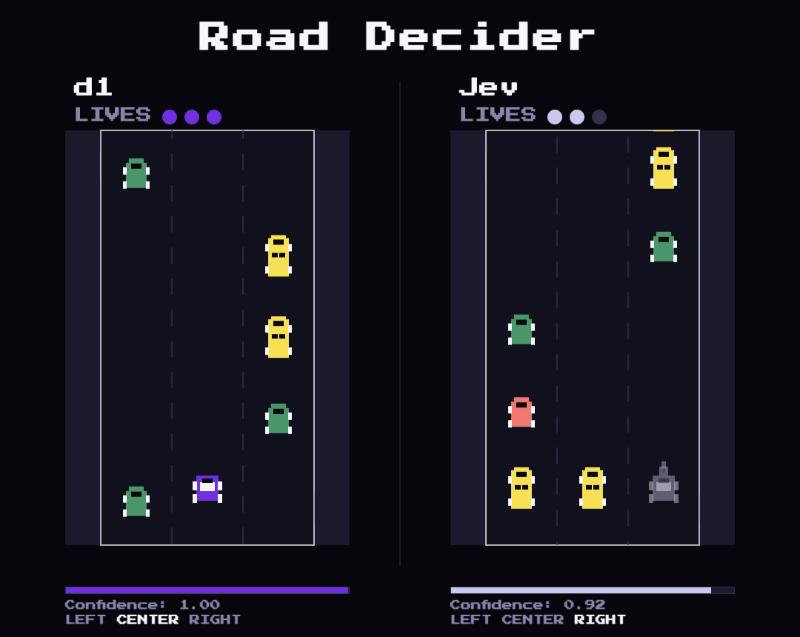
위 화면은 저장소가 제공한 한 장면이며, 한 장면의 목숨 수와 확신도만으로 두 모델의 우열을 판단할 수는 없습니다. 이 예제의 가치는 결정 모델을 앱에 넣는 네 단계를 바닐라 JavaScript로 짧게 보여 준다는 데 있습니다.
1단계, 질문 정의: ai/ai.js는 세 차선 중 하나를 고르는 Choice 질문 하나를 씁니다. instructions 에는 가장 가까운 줄이 가장 급하고, 안전도가 같으면 현재 차선을 유지하라는 판단 기준을 적었습니다.
const QUESTION = {
  lane: {
    type: "choice",    // return one named option + probability distribution
    instructions:
      "Pick the safest lane. Row 1 is most urgent. Prefer the current lane when options are equally safe.",
    criteria: {        // the options the model picks from
      left: "Left lane",
      center: "Center lane",
      right: "Right lane",
    },
  },
};
2단계, 상태 만들기: buildState 함수는 앞쪽 다섯 줄을 훑어 차선마다 첫 장애물까지의 거리를 한 줄씩 요약합니다.
export function buildState(car, road) {
  const currentLane = LANES[Math.round(car.laneIndex)];
  // scan the rows ahead for obstacles
  const lookAhead = road.getLookAhead(car.y, CONFIG.LOOK_AHEAD_ROWS);

  const laneSummaries = LANES.map((lane) => {
    const firstObstacle = lookAhead[lane].findIndex((item) => item !== null);
    if (firstObstacle === -1) return `${lane}: clear`;
    return `${lane}: obstacle at row ${firstObstacle + 1}`;
  });

  // combine into a single text block for the model
  return [
    `Current lane: ${currentLane}. Pick the lane with the most room ahead.`,
    "",
    ...laneSummaries,
  ].join("\n");
}
이렇게 만든 상태는 다음과 같은 짧은 텍스트입니다.
Current lane: center. Pick the lane with the most room ahead.

left: obstacle at row 2
center: clear
right: obstacle at row 4
README는 이 형식을 고른 이유를 실험 결과로 설명합니다. 도로를 격자 그대로 넣는 것보다 차선별 요약과 첫 장애물까지의 거리를 넣었을 때 훨씬 확신도 높은 결정이 나왔다는 것입니다. 결정 모델도 LLM처럼 상태를 어떻게 표현하느냐에 따라 결과가 크게 달라지므로, 원시 데이터를 그대로 넘기기보다 판단에 필요한 특징을 코드로 먼저 뽑아 두는 편이 낫습니다.
3단계, API 호출: 브라우저는 /api/decision/d1 이나 /api/decision/jev 로 요청을 보내고, vite.config.js의 개발 서버 프록시가 Authorization 헤더를 붙여 실제 API로 전달합니다. API 키가 브라우저에 노출되지 않도록 서버 쪽에 두는 구조입니다. 두 모델의 요청 본문은 같고, 주소와 키, 모델 이름만 다릅니다.
4단계, 응답 해석: 응답에서 차선과 confidence 를 꺼내 차를 움직이고, 확신도를 각 도로 아래에 실시간으로 표시합니다. 답은 항상 정의한 옵션 중 하나이므로, normalizeDecision 의 검사는 깨진 응답만 막으면 됩니다.
function normalizeDecision(data) {
  const answer = data?.answers?.lane;
  if (!LANES.includes(answer?.choice)) {
    throw new Error("Unexpected response from the decision API.");
  }

  return {
    lane: answer.choice,
    probabilities: answer.probabilities,
    confidence: answer.confidence,
  };
}
Liquid AI는 README에서 결정 주기를 게임 속도에 따라 초당 2~5회라고 적었습니다. config.js를 보면 주기는 500ms에서 시작해 10초마다 80ms씩 줄고 200ms에서 멈춥니다. 또한 game/game.js는 이전 요청이 끝나기 전에는 다음 요청을 보내지 않으므로, 네트워크 왕복이 200ms보다 길어지면 실제 결정 횟수는 그만큼 줄어듭니다. 참고로 Jev Decision Index가 기록한 Jev 호스팅 API의 왕복 지연은 중앙값 524.1ms였습니다. Liquid AI는 d1의 지연 수치를 공개하지 않았고, 외부 벤치마크가 클라이언트에서 한 번에 한 요청씩 잰 중앙값은 d1이 525ms, Jev가 710ms였습니다. 어느 쪽이든 200ms 주기보다 길기 때문에, 후반부에는 게임이 정한 주기보다 드물게 결정이 내려집니다.
실행 방법과 설정
Node.js 18 이상과 Liquid API 키가 필요하고, Jev vs d1 모드를 쓰려면 OpenRouter API 키도 필요합니다.
git clone https://github.com/Liquid4All/cookbook.git
cd cookbook/examples/road-decider
cp .env.example .env
# Edit .env: add LIQUID_API_KEY, and optionally OPENROUTER_API_KEY
npm install
npm run dev
| 변수 | 기본값 | 설명 |
|---|---|---|
LIQUID_API_KEY |
d1용 API 키. 필수 | |
LIQUID_MODEL_NAME |
d1:free |
d1 모델 이름 |
LIQUID_BASE_URL |
https://api.liquid.ai |
d1을 제공하는 API 주소 (https://openrouter.ai 도 가능) |
OPENROUTER_API_KEY |
Jev vs d1 모드용 OpenRouter 키 | |
OPENROUTER_MODEL_NAME |
typesafe/jev-1.13 |
Jev 모델 이름 |
OPENROUTER_BASE_URL |
https://openrouter.ai |
Jev를 제공하는 API 주소 |
config.js 는 주소의 호스트에 따라 엔드포인트 경로를 고릅니다. OpenRouter는 /api/alpha/decisions, 그 밖의 주소는 /decisions/v1/systemone 입니다. 즉 OpenRouter는 이미 결정 모델용 알파 엔드포인트인 Decisions API로 Jev를 제공하고 있고(OpenRouter 키만 있으면 누구나 쓸 수 있으며 입력 토큰만 과금), 이 예제는 d1이 OpenRouter에 올라오면 주소만 바꿔 쓸 수 있도록 미리 짜여 있습니다. X 발표 게시물도 d1이 곧 OpenRouter에서 제공될 것이라고 밝혔지만, 10월 1일 기준 OpenRouter 모델 목록에 d1은 아직 없습니다.
"Jev를 처음 넘은 모델"이라는 주장 읽기
Liquid AI는 X 발표에서 d1을 Hugging Face의 Decision Index에서 Jev를 넘어선 첫 모델이라고 소개하고, 다국어 평가에서 앞서고, 프롬프트 인젝션(Prompt Injection)에 더 강하며, 긴 입력을 더 잘 다룬다고 덧붙였습니다. 함께 올린 그림은 다섯 개 영역별 점수를 Jev 1.13과 비교합니다.
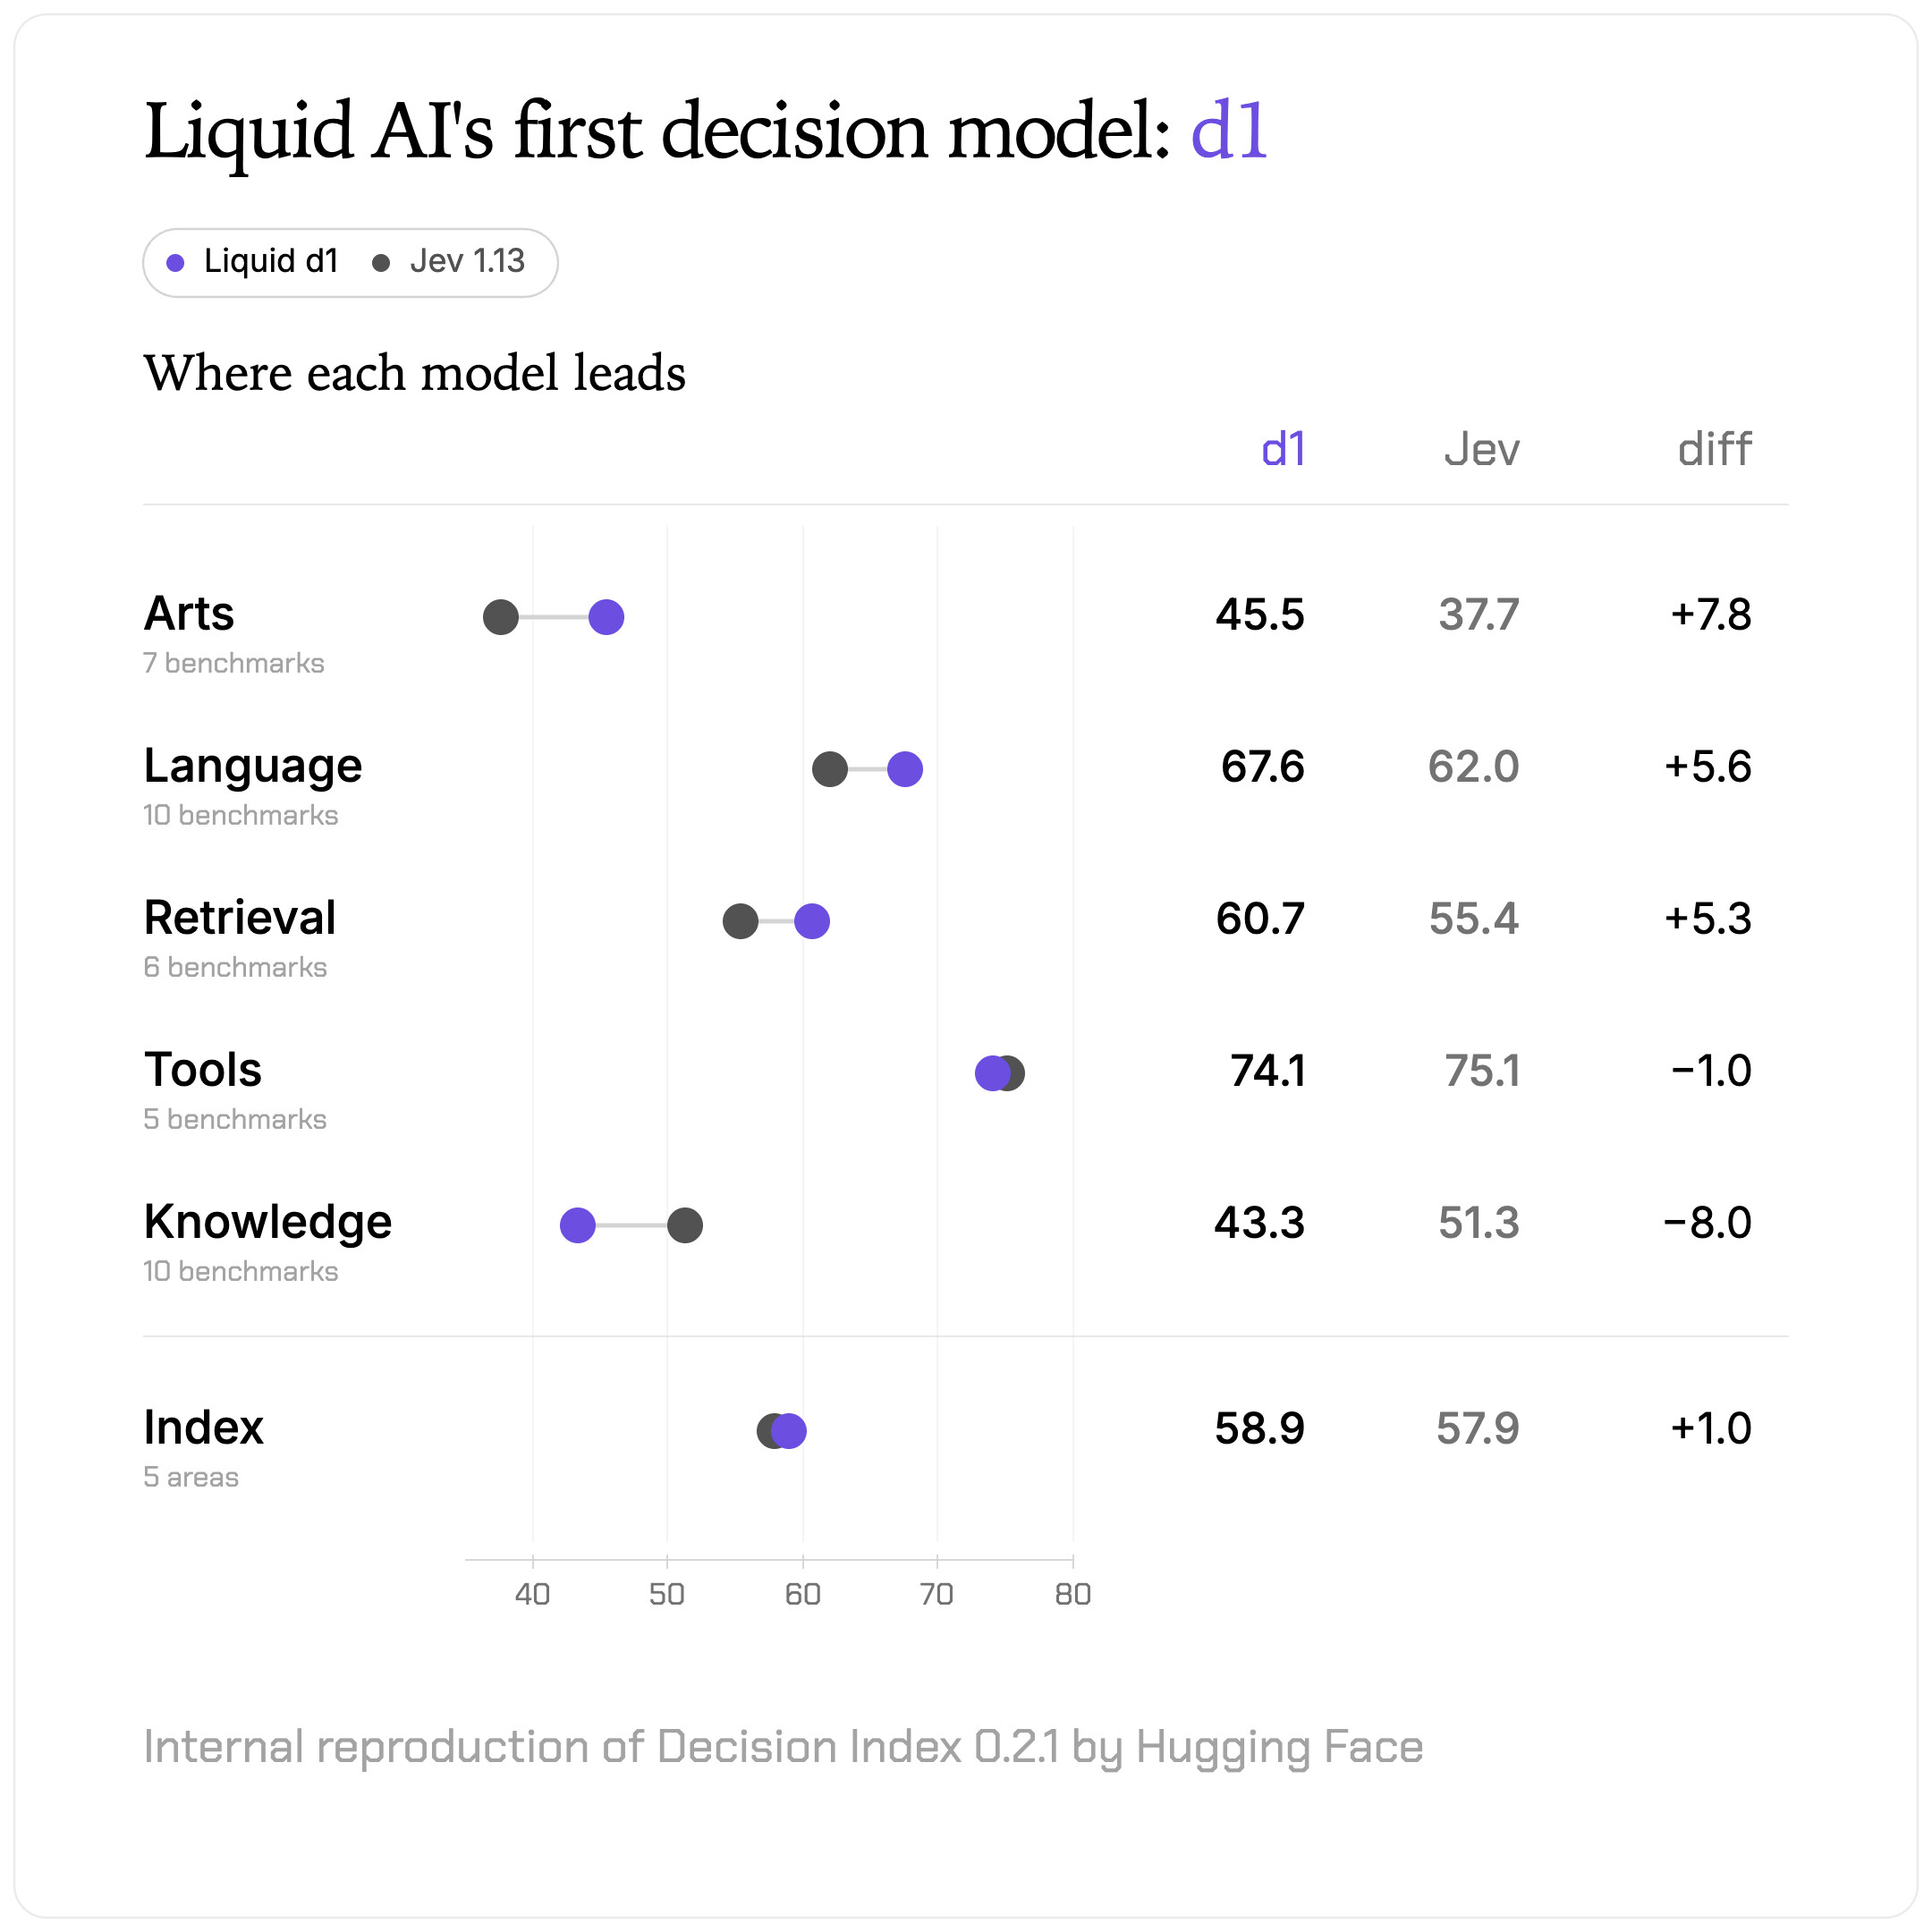
| 영역 (벤치마크 수) | d1 | Jev 1.13 | 차이 |
|---|---|---|---|
| Arts (7) | 45.5 | 37.7 | +7.8 |
| Language (10) | 67.6 | 62.0 | +5.6 |
| Retrieval (6) | 60.7 | 55.4 | +5.3 |
| Tools (5) | 74.1 | 75.1 | -1.0 |
| Knowledge (10) | 43.3 | 51.3 | -8.0 |
| Index (5개 영역) | 58.9 | 57.9 | +1.0 |
이 수치를 해석할 때 먼저 확인할 것은 Decision Index가 무엇이고 누가 측정했는가 입니다. Decision Index는 Hugging Face 조직 멤버인 Apolinário(multimodalart) 계정의 Jev Decision Index Space가 운영하는 리더보드로, Jev를 공개적으로 재현하려는 모델들을 한 벤치마크 묶음으로 채점합니다. README는 스스로를 비공식이며 커뮤니티가 관리하고, TypeSafe AI와 무관하다고 밝힙니다. 0.2.1판은 도구 호출(BFCL, API-Bank 등), 언어 이해(ANLI, HellaSwag 등), 검색과 분류(BANKING77, CLINC150 등), 지식과 추론(GPQA Diamond, MMLU-Pro, GSM8K 등), 예술과 예측(ForecastBench, New Yorker 등) 다섯 영역의 38개 벤치마크를 쓰고, 각 벤치마크 점수를 무작위 추측이 0, 만점이 100이 되도록 보정한 뒤 영역별로 평균합니다. 영역 가중치는 같지 않습니다. 방법론 문서에 따르면 Arts는 10%로 고정되고, 나머지 네 영역이 90%를 벤치마크 수의 제곱근에 비례해 나눠 Knowledge와 Language가 각각 25.85%, Retrieval이 20.02%, Tools가 18.28%를 차지합니다. 채점 코드는 apolinario/decision-index 저장소에 MIT 라이선스로 공개되어 있어, 누구나 같은 묶음을 직접 돌려 볼 수 있습니다.
리더보드 데이터(2026-09-28 생성)와 대조하면 몇 가지가 분명해집니다.
-
Jev 쪽 수치는 공개 데이터와 일치합니다: 리더보드의 Jev 1.13.0 종합 점수는 57.91이고, 영역별 점수도 Liquid 그림의 Jev 열과 소수 첫째 자리까지 같습니다(Knowledge만 51.40 대 51.3으로 0.1 차이).
-
d1의 점수는 Liquid AI가 직접 잰 값입니다: 그림 하단에 *Hugging Face Decision Index 0.2.1의 내부 재현(Internal reproduction)*이라고 적혀 있고, 공개 리더보드의 70개 항목에 d1은 없습니다. 리더보드에 있는 Liquid 계열 항목은 커뮤니티가 Liquid AI의 LFM(Liquid Foundation Models) 계열 소형 모델인 LFM2.5를 미세조정(Fine-tuning) 한
LFM2.5-2.6B-RLCD(6.76점)와LFM2.5-350M-RLCD(1.38점)뿐입니다. -
"처음"이라는 주장 자체는 공개 순위와 맞습니다: 현재 공개 리더보드 1위는 Surogate Rune 26B-A4B v3의 57.44점으로 Jev보다 0.47점 낮습니다. d1의 58.9점이 공개 재현에서도 유지된다면 Jev를 넘은 첫 항목이 됩니다.
-
종합 1.0점 차이는 영역별 편차보다 훨씬 작습니다: 위 가중치로 Liquid의 영역별 점수를 합산하면 d1은 58.92, Jev는 57.91로 그림의 종합 점수가 그대로 재현됩니다. 영역별 기여를 나눠 보면 Language(+1.45)와 Retrieval(+1.06)이 격차를 만들고, 가장 크게 앞선 Arts(+7.8점)는 가중치가 10%라 +0.78만 보탭니다. 반대로 Knowledge의 8.0점 열세는 -2.07로 가장 큰 감점입니다. 따라서 수학, 과학, 코드 추론이 들어간 판단이라면 Jev가 여전히 나을 수 있고, 도구 호출 판단은 거의 같습니다. 종합 점수보다 자기 작업에 가까운 영역을 보는 편이 정확합니다.
-
나머지 세 주장은 이 그림으로 뒷받침되지 않습니다: Decision Index의 38개 벤치마크는 대부분 영어 데이터셋이며, 발표가 말한 다국어 평가, 프롬프트 인젝션 내성, 긴 입력 처리에 대한 수치나 평가 방법은 문서에도 게시물에도 없습니다.
외부에서 측정한 첫 결과: typed-decisions
발표 다음 날인 9월 30일, System One 형식의 공개 벤치마크인 typed-decisions가 d1을 측정해 리더보드에 올렸습니다. 이 벤치마크는 보안 경보, 에이전트 실행 기록, 청구서, 고객 응대 네 가지 업무의 상태 하나에 타입이 지정된 질문 다섯 개를 한 번에 던지고, 답의 확률 분포가 기준 분포와 얼마나 가까운지를 KL 발산(Kullback-Leibler Divergence) 과 Brier 점수로 잽니다. 테스트 셋은 400건, 2,000개 결정입니다.
| 모델 | 정확도 ↑ | KL ↓ | Brier ↓ | ECE ↓ | p50 지연 |
|---|---|---|---|---|---|
| meraGPT Decider 1 | 0.768 | 0.096 | 0.052 | 0.180 | 526 ms |
| Liquid AI d1 | 0.742 | 0.475 | 0.155 | 0.124 | 525 ms |
| TypeSafe Jev 1.13.0 | 0.727 | 1.442 | 0.148 | 0.144 | 710 ms |
이 결과에서 d1은 Jev보다 정확도와 KL, ECE에서 앞서고, Brier는 Jev가 0.148로 d1(0.155)보다 약간 낫습니다. 데이터셋 카드는 Jev가 거의 모든 확률을 한 답에 몰아 KL이 크게 나쁘다고 설명합니다. 질문 유형별로는 d1이 Noul(0.840)과 Choice(0.732)에서 1위와 같은 수준이고, Score(0.677 대 0.739)에서 뒤집니다.
다만 이 표를 읽을 때는 세 가지를 함께 봐야 합니다. 첫째, 데이터가 영어 합성 데이터이고, 기준 분포가 약 4B급 교사 모델에서 뽑은 세 샘플의 평균이라, 카드 스스로 밝히듯 점수는 정답률이 아니라 교사와의 일치도입니다. 둘째, 1위인 Decider 1을 이 벤치마크의 카드가 직접 홍보하고 있어 운영 주체와 이해관계가 겹칩니다. 셋째, 모든 행이 질문 다섯 개를 한 요청에 묶어 보냈는데, 카드에 따르면 Jev의 예/아니오 정확도는 질문을 하나씩 보낼 때 0.843, 묶어 보낼 때 0.788로 요청 형태에 따라 달라집니다. 그래도 d1이 Jev보다 낫다는 Liquid AI의 주장을 벤더 밖에서 확인한 첫 자료라는 의미는 있습니다.
도입 전에 확인할 점
d1을 실제 서비스에 넣기 전에 공개 자료로는 답이 없는 부분이 몇 가지 있습니다.
-
가중치와 미세조정: Liquid AI 모델 목록에서 d1은 "API" 전용으로 표시되고, Hugging Face 가중치, GGUF, ONNX 배포가 모두 없으며 미세조정 지원도 "No"입니다. 기존 LFM 모델들이 대부분 공개 가중치로 배포되는 것과 다른 점이고, 온디바이스 실행도 현재는 불가능합니다. 다만 발표 스레드에서 앞으로 내려받아 로컬에서 실행할 수 있게 되느냐는 질문에 Liquid AI 계정이 for sure라고 답했으므로, 로컬 배포 계획은 있는 것으로 보입니다. 시점과 라이선스는 밝히지 않았습니다.
-
가격과 사용 한도: 문서와 예제 모두 모델 이름으로
d1:free만 쓰며, 요금표나 사용 한도는 공개되지 않았습니다. 무료 등급이 언제까지 유지되는지도 알 수 없습니다. -
지원 언어: 발표는 다국어 평가에서 앞선다고 했지만 지원 언어 목록은 없습니다. 한국어 입력에서 확률이 얼마나 믿을 만한지는 한국어 레이블 데이터로 직접 측정해 봐야 합니다.
-
모델 정보: 파라미터 수, 아키텍처, 최대 입력 길이, 학습 방식 모두 공개되지 않았습니다. LFM 계열을 기반으로 했는지도 문서에는 나오지 않습니다.
-
SDK 의존성: 공식 예제가 TypeSafe AI의 SDK를 쓰므로, 두 회사의 API 사양이 앞으로도 같게 유지될지는 지켜봐야 합니다. 이 호환성이 공식 협력인지 사양만 맞춘 것인지도 문서에 설명이 없습니다.
-
예제 코드의 라이선스: cookbook 저장소에는 라이선스 파일이 없어, 예제 코드를 가져다 쓸 때의 조건이 명시되어 있지 않습니다.
Jev 생태계 속 d1의 위치
지금까지 PyTorchKR에서 다룬 결정 모델들과 비교하면 d1의 위치가 조금 더 분명해집니다. Decision Index 점수는 공개 리더보드 0.2.1판 기준이며, d1만 Liquid AI의 자체 측정값입니다.
| 모델 | 개발 | 제공 방식 | Decision Index |
|---|---|---|---|
| Jev 1.13 | TypeSafe AI | 비공개, API | 57.91 |
| d1 | Liquid AI | 비공개, API | 58.9 (자체 측정) |
| Rune 26B-A4B v3 | Surogate | 공개 가중치 (GGUF) | 57.44 |
| Decision 1.0 Lux 9B | vLLM Semantic Router 팀 | 공개 가중치, Apache 2.0 | 43.49 |
| kev 9B | Jared Palmer | 공개 어댑터, Apache-2.0 | 38.48 |
| Laya | Convai Innovations | 공개 가중치, Apache-2.0 | 6.04 |
공개 가중치 모델들은 직접 서빙하고 미세조정할 수 있다는 장점이 있지만, 규모가 작은 모델일수록 종합 점수가 크게 낮습니다. 반면 d1은 Jev와 같은 API 사용 경험을 유지하면서 Jev와 비슷한 점수대를 주장하는 호스팅 모델입니다. 따라서 Jev를 쓰던 팀에게는 공급자를 하나 더 확보한다는 의미가 있고, 새로 결정 모델을 시험하려는 팀에게는 같은 SDK로 두 모델을 번갈아 호출하며 자기 데이터에서 비교해 볼 수 있는 조건이 생겼습니다.
 Liquid AI 결정 모델 문서
LLM 호출을 결정 모델로 옮기는 가이드
 Road Decider 예제 (Liquid AI cookbook)
 Liquid AI의 d1 발표 게시물
https://x.com/liquidai/status/2105003472332693869
 Jev Decision Index 리더보드
typed-decisions 벤치마크 데이터셋
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
vLLM Semantic Router팀, Jev와 유사한 Decision 1.0 기능 및 6개 모델, Decision Studio 공개
-
Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
