MegaMemory 소개
코딩 에이전트를 며칠 이상 쓰다 보면 같은 작업을 반복하게 됩니다. 어제 세 시간 동안 인증 흐름을 읽고 어디를 고쳐야 하는지 파악해 두었는데, 오늘 새 세션을 열면 에이전트는 그 파일들을 처음 보는 것처럼 다시 읽습니다. 이 문제를 푸는 흔한 방향은 코드베이스를 미리 인덱싱해 두는 것이고, PyTorchKR 에도 CodeGraph나 codebase-memory-mcp처럼 코드를 그래프로 만들어 두는 도구가 소개된 적이 있습니다. 다만 함수와 파일의 호출 관계를 그린 그래프는 무엇이 무엇을 부르는지는 알려주지만, 왜 이 모듈이 이렇게 생겼는지, 지난주에 어떤 결정을 내렸는지는 담고 있지 않습니다.
이번에 소개할 MegaMemory는 그 기록을 코드 구조에서 추출하지 않고 에이전트가 직접 쓰게 하는 방향을 택한 MCP(Model Context Protocol) 서버입니다. MegaMemory에는 추상 구문 트리(AST, Abstract Syntax Tree) 파서도 정적 분석기도 없습니다. 대신 에이전트가 코드를 읽고 자기 말로 개념을 적어 두고, 다음 작업을 시작하기 전에 그 개념을 자연어로 질의합니다. 그래서 그래프에 쌓이는 노드는 함수나 클래스 같은 코드 심볼이 아니라 기능, 모듈, 패턴, 설계 결정 같은 개념(Concept) 입니다.
MegaMemory는 npm 패키지로 배포되며 Node.js 18 이상을 요구합니다. 모든 기록은 프로젝트마다 하나씩 생기는 SQLite 데이터베이스인 .megamemory/knowledge.db 에 남고, 의미 검색에 쓰는 임베딩(Embedding)은 프로세스 안에서 직접 계산합니다. 첫 실행에서 약 23MB 짜리 모델을 한 번 내려받은 뒤에는 API 키도, 추가 네트워크 호출도 필요하지 않습니다.
MegaMemory가 도는 세 단계 루프
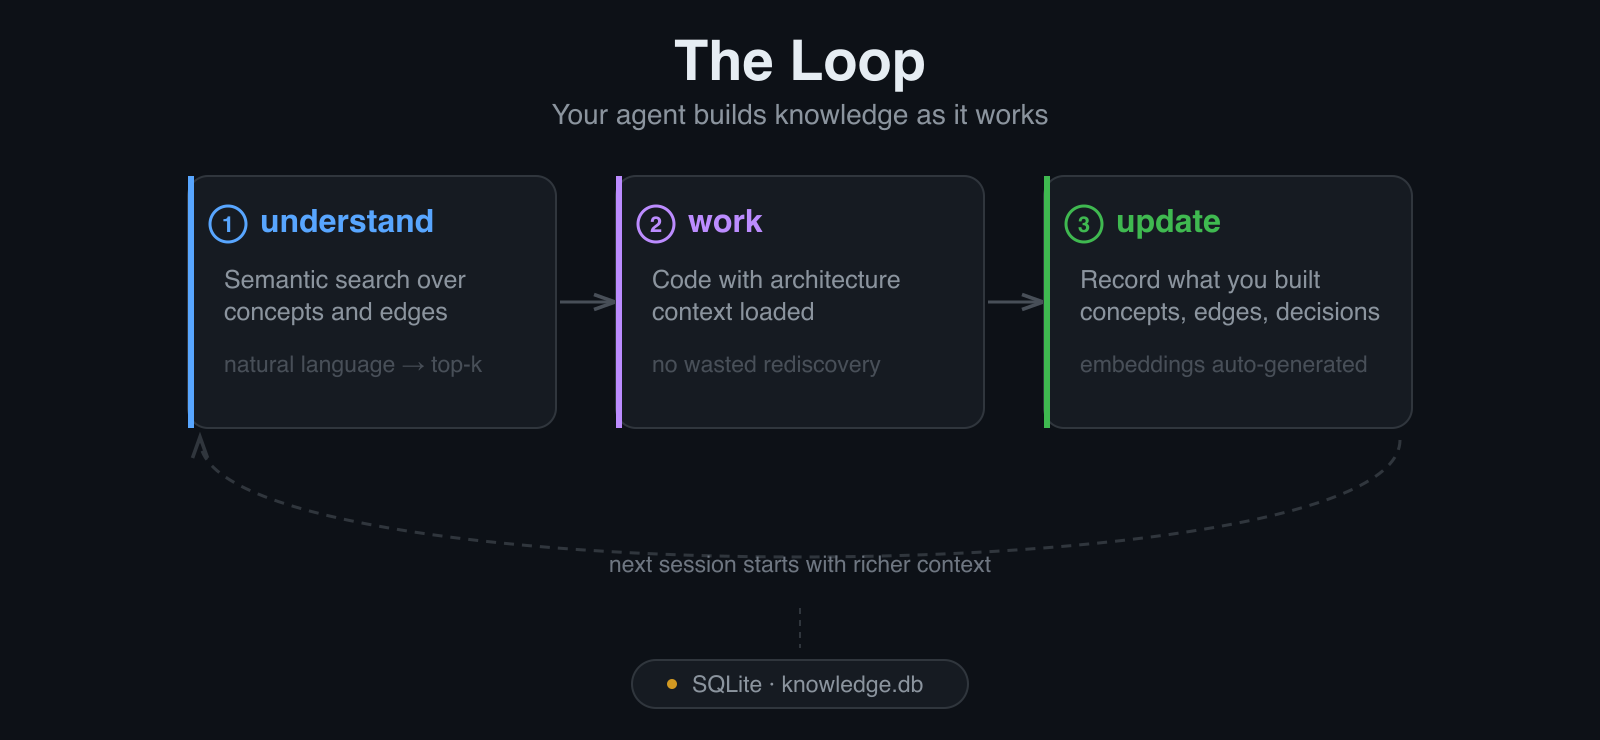
MegaMemory의 사용 흐름은 이해, 작업, 갱신 세 단계로 정리됩니다. 세션을 시작할 때 에이전트가 list_roots 를 호출해 최상위 개념부터 훑고, 작업에 들어가기 전에 understand 에 자연어 질의를 던져 관련 개념을 받아 오거나 정확한 식별자를 알고 있으면 get_concept 으로 바로 찾습니다. 작업이 끝나면 create_concept 또는 update_concept 으로 무엇을 만들었는지 기록합니다.
또한 이 순서에서 중요한 것은 갱신이 마지막에 온다는 점입니다. 인덱싱 도구는 코드가 바뀌면 다시 인덱싱해야 하지만, MegaMemory는 작업을 마친 에이전트가 그 자리에서 결과를 적으므로 별도의 재인덱싱 단계가 없습니다. 반대로 에이전트가 기록을 남기지 않으면 그래프는 그대로 멈춰 있습니다. 따라서 설치 과정에서 워크플로 지침을 에디터의 지시문 파일에 함께 써 넣고, 초기 그래프를 채우는 /user:bootstrap-memory 와 세션 지식을 저장하는 /user:save-memory 명령을 등록합니다.
MegaMemory의 아키텍처
MegaMemory는 코딩 에이전트와 표준 입출력(stdio)으로 통신하는 MCP 서버 하나, 개념과 관계를 담는 SQLite, 그리고 임베딩 계산기로 구성되어 있습니다:
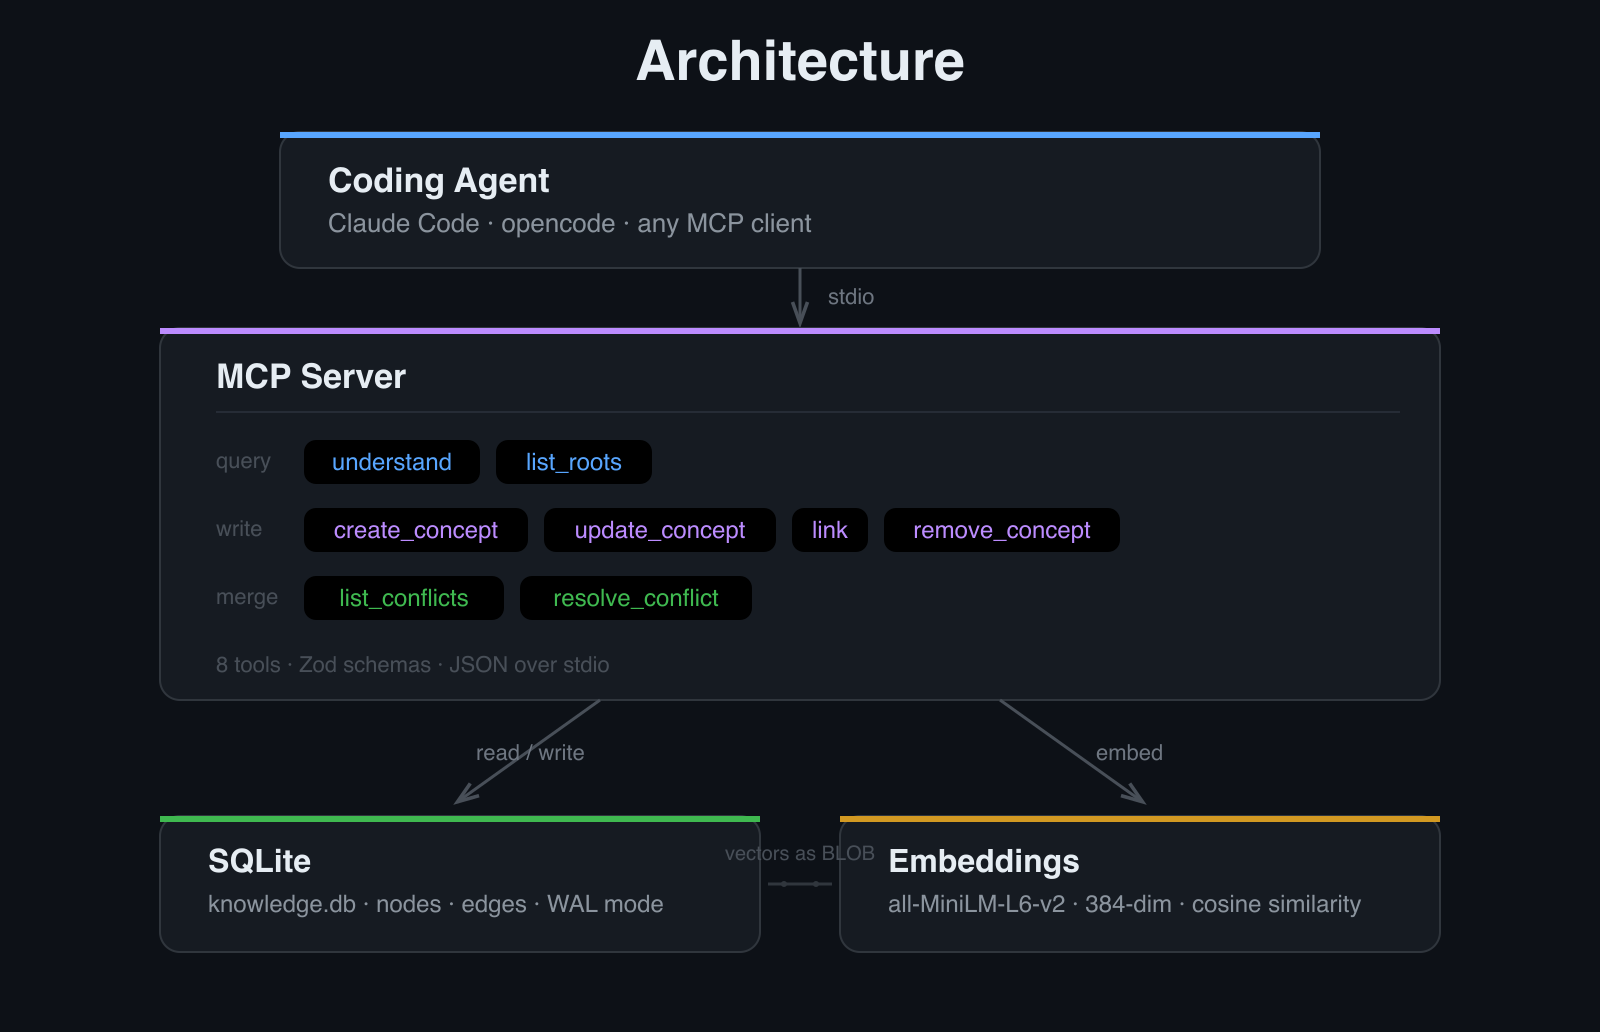
임베딩 모델은 Xenova/all-MiniLM-L6-v2의 ONNX 양자화(Quantization) 버전이고 벡터 차원은 384 입니다. 저장 계층은 libsql 기반 SQLite 를 WAL(Write-Ahead Logging) 모드로 쓰며, 삭제는 실제 삭제가 아니라 이력을 남기는 소프트 삭제(Soft Delete)이고 스키마 버전은 현재 v3 입니다. 검색은 노드 임베딩 전체를 훑는 코사인 유사도 계산이며, 저자는 이 방식이 노드 1만 개 미만 규모에서 충분히 빠르다고 밝히고 있습니다.
에이전트가 호출할 수 있는 도구는 9개입니다:
| 도구 | 하는 일 |
|---|---|
understand |
자연어 질의로 개념을 의미 검색해 자식과 간선, 부모 맥락까지 함께 반환 |
get_concept |
정확한 식별자로 개념 하나를 조회 |
create_concept |
간선과 파일 참조를 포함한 새 개념 추가 |
update_concept |
기존 개념의 필드를 수정하고 임베딩을 자동 재생성 |
link |
두 개념 사이에 유형이 있는 관계 생성 |
remove_concept |
사유를 남기고 소프트 삭제, 이력은 보존 |
list_roots |
최상위 개념과 직계 자식 목록 조회 |
list_conflicts |
병합 그룹별로 해소되지 않은 충돌 조회 |
resolve_conflict |
현재 코드베이스를 근거로 검증한 내용으로 충돌 해소 |
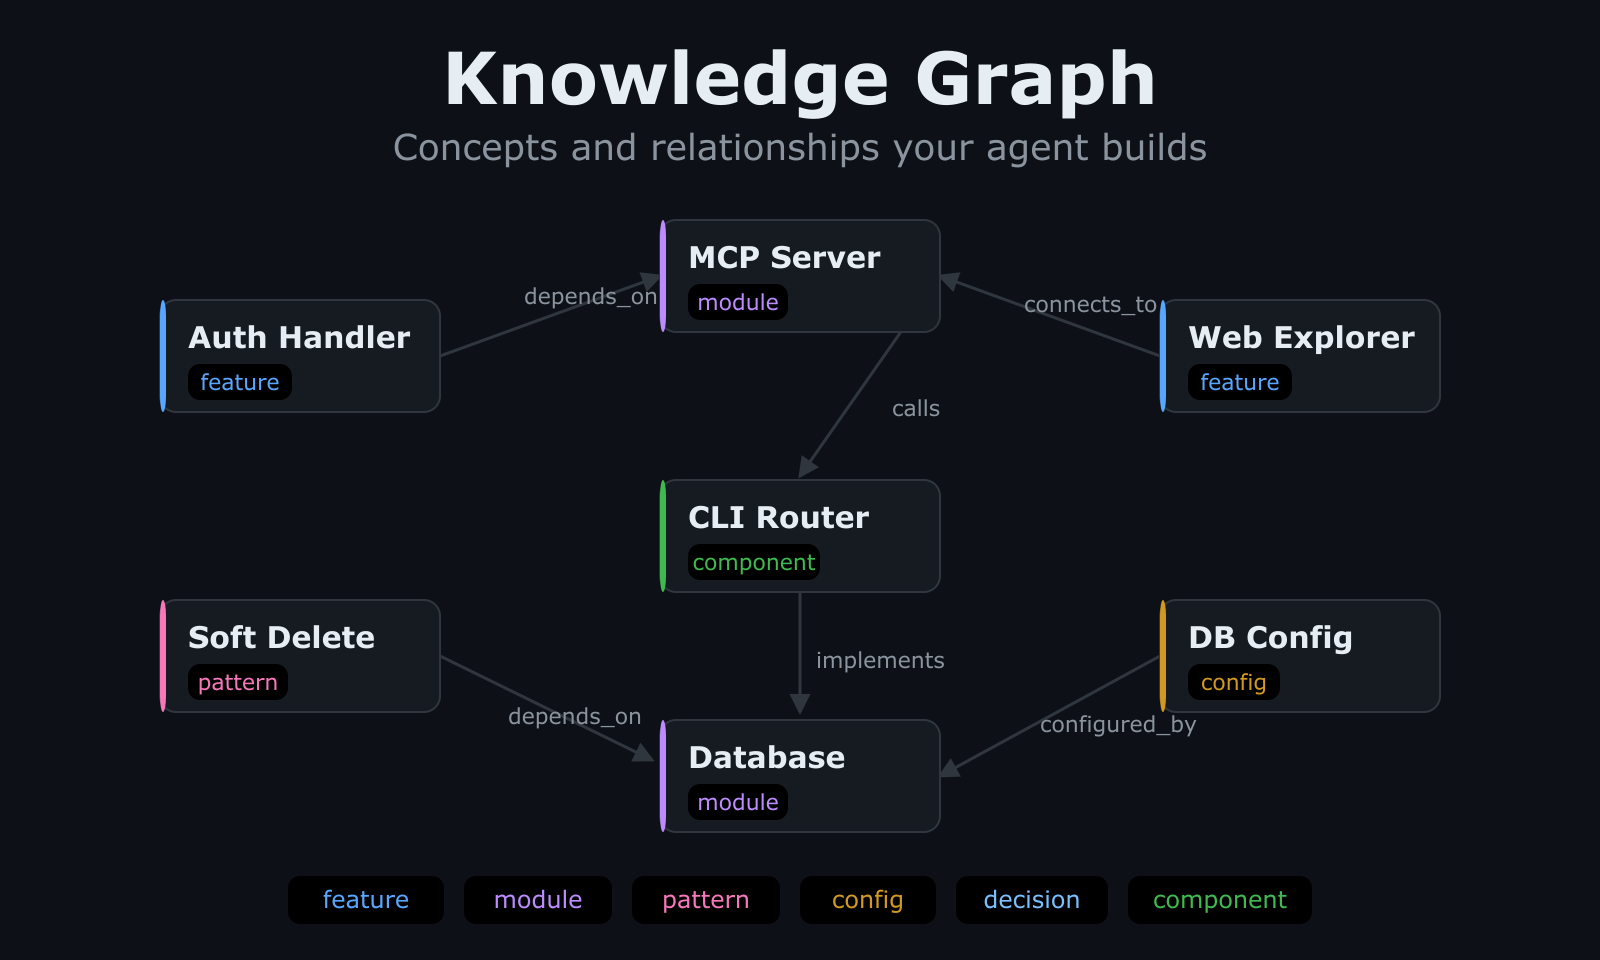
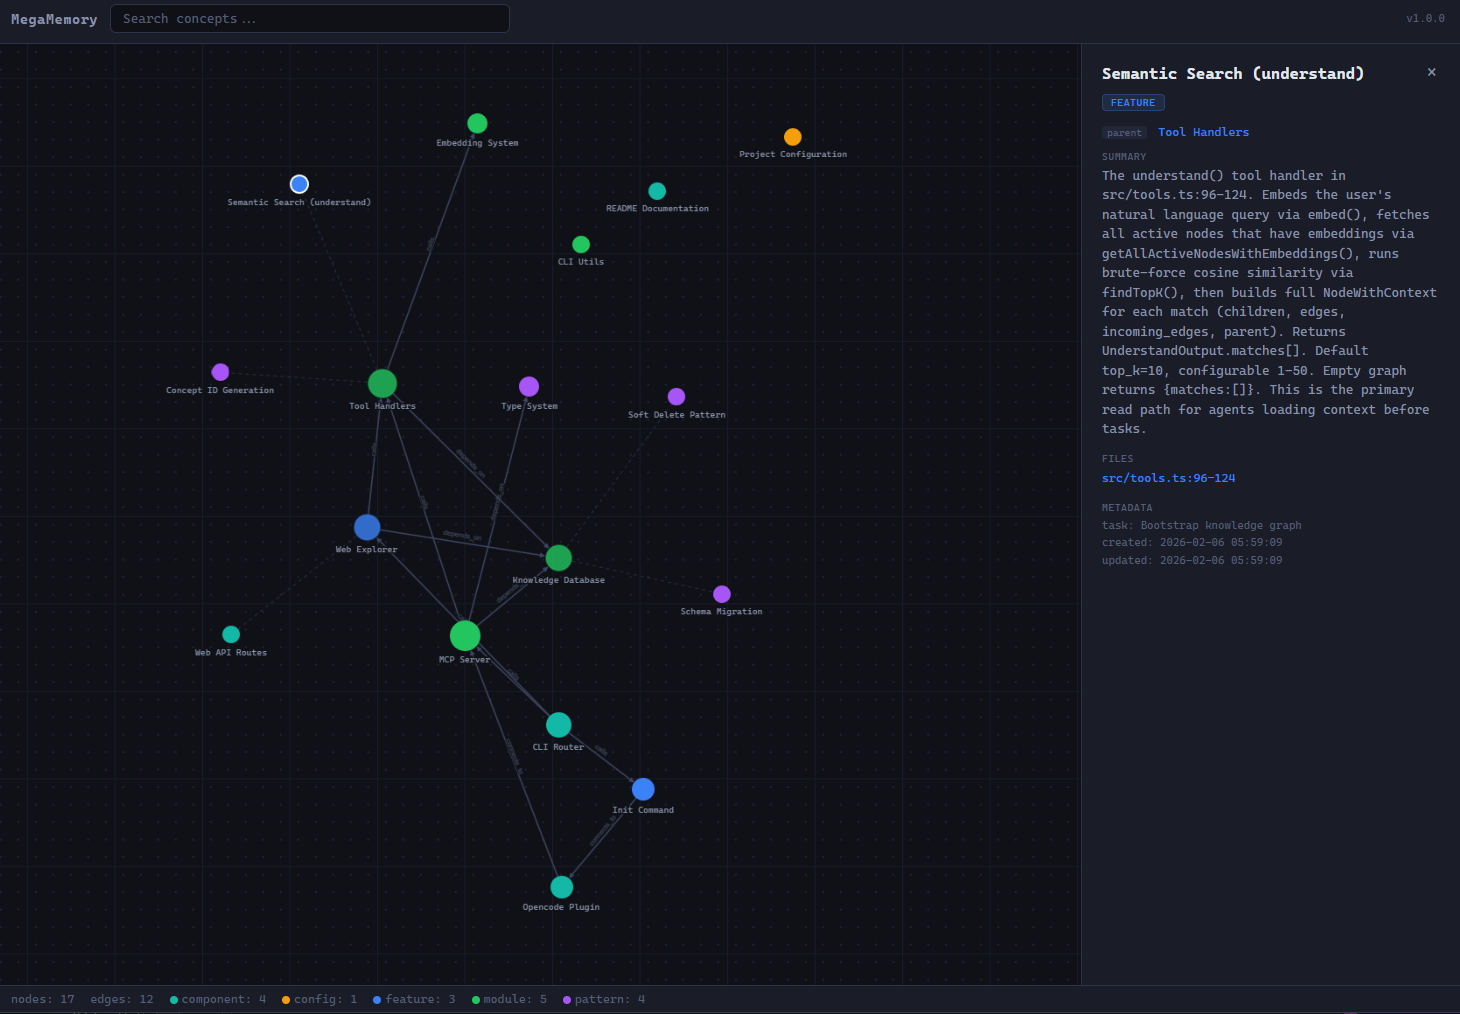
개념에는 feature, module, pattern, config, decision, component 여섯 가지 종류가 있고, 개념 사이의 관계는 connects_to, depends_on, implements, calls, configured_by 다섯 가지로 표현합니다. 아래 그림은 이 종류와 관계가 실제 그래프에서 어떻게 이어지는지 보여줍니다:
MegaMemory 설치와 에디터 연결
설치는 전역 npm 설치 한 줄이고, 이어서 대화형 설치기를 실행해 에디터를 고릅니다:
npm install -g megamemory
megamemory install
에디터를 미리 정했다면 --target 으로 바로 지정할 수 있습니다. 대상마다 건드리는 파일이 다릅니다:
| 대상 | 설정되는 것 |
|---|---|
opencode (  Opencode: 다양한 LLM을 사용할 수 있는, 터미널 기반의 오픈소스 AI 코딩 에이전트) |
~/.config/opencode/opencode.json 의 MCP 서버, ~/.config/opencode/AGENTS.md 의 워크플로 지침, ~/.config/opencode/tool/megamemory.ts 플러그인, /user:bootstrap-memory 와 /user:save-memory 명령 |
| Claude Code | ~/.claude.json 의 MCP 서버, ~/.claude/CLAUDE.md 의 워크플로 지침, ~/.claude/commands/ 의 명령 |
| Antigravity | 작업 공간 단위의 ./mcp_config.json |
| Codex | ~/.codex/config.toml 의 MCP 서버, ~/.codex/AGENTS.md 의 워크플로 지침 |
예를 들어 opencode 를 대상으로 지정하는 명령은 다음과 같습니다:
megamemory install --target opencode
opencode 는 설치 후 재시작이 필요합니다. 남의 설정 파일을 고치는 설치기이므로 안전 장치도 함께 걸려 있습니다. 설치기는 기존 설정을 읽어 병합하는 데 성공한 뒤에만 파일을 갱신하고, 이미 있는 플러그인과 명령 파일은 MegaMemory 가 관리하는 파일로 표시되어 있지 않으면 덮어쓰지 않습니다.
그 밖의 MCP 클라이언트에는 인자 없는 megamemory 명령을 stdio MCP 서버로 등록하면 됩니다. 데이터베이스 경로는 작업 디렉토리 기준 .megamemory/knowledge.db 이고, MEGAMEMORY_DB_PATH 로 바꿀 수 있습니다. 설정에 넣는 항목은 다음과 같습니다:
{
  "megamemory": {
    "type": "local",
    "command": ["megamemory"],
    "enabled": true
  }
}
쌓인 그래프는 브라우저에서도 볼 수 있습니다. megamemory serve 를 실행하면 노드를 종류별 색으로, 간선 수에 비례한 크기로 그린 탐색기가 열립니다. 부모와 자식 관계는 점선, 그 밖의 관계는 실선입니다. 기본 포트는 http://localhost:4321 이고 이미 쓰이는 중이면 다른 포트를 물어봅니다:
브랜치가 갈릴 때 knowledge.db 를 병합하는 방법
이 프로젝트에서 눈에 띄는 설계는 병합 명령이 따로 있다는 점입니다. 브랜치마다 작업이 갈리면 .megamemory/knowledge.db 도 각자 갱신되는데, SQLite 파일은 git 이 자동으로 병합할 수 없습니다. 텍스트 형식을 고르면 이 문제가 없지만 의미 검색을 위한 벡터를 넣기 어려워지므로, MegaMemory 는 저장 형식을 SQLite 로 두고 병합을 직접 구현하는 쪽을 선택했습니다. 그래서 병합에 쓰는 명령이 세 개 준비되어 있습니다:
megamemory merge main.db feature.db --into merged.db --left-label main --right-label feature-xyz
megamemory conflicts
megamemory resolve <merge-group-uuid> --keep left
병합은 개념 식별자를 기준으로 비교합니다. 같은 노드는 중복을 제거하고, 충돌하는 노드는 병합 그룹 UUID 하나 아래에 ::left 와 ::right 변형으로 남겨 둡니다. 사람이 --keep left, --keep right, --keep both 로 고를 수도 있고, 에이전트에게 맡길 수도 있습니다. 에이전트가 /merge 를 실행하면 list_conflicts 로 충돌 목록을 받고 양쪽 내용을 현재 소스 파일과 대조한 다음, 검증 사유와 함께 resolve_conflict 를 호출합니다. 저자는 이 절차를 어느 한쪽을 무작정 선택하는 것이 아니라 코드베이스가 지금 반영하고 있는 상태로 해소하는 것이라고 설명합니다.
MegaMemory는 누구에게 유용한가
한 프로젝트를 여러 세션에 걸쳐 오래 다루면서 코딩 에이전트에게 매번 같은 배경을 설명하고 있는 개발자에게 MegaMemory는 지금 시도해 볼 만한 선택입니다. 설치가 npm 한 줄이고, 임베딩까지 로컬에서 계산해 API 키가 필요 없으며, 기록이 프로젝트 디렉토리 안의 파일 하나로 남기 때문에 도입과 철수 비용이 모두 낮습니다. opencode, Claude Code, Antigravity, Codex 를 함께 쓰는 환경이라면 같은 그래프를 네 곳에서 공유하는 구성도 됩니다.
다만 규모가 큰 저장소에서는 확인할 점이 있습니다. 검색이 전체 노드를 훑는 방식이라 저장소가 밝힌 적정 규모가 노드 1만 개 미만이고, 개념을 쓰는 주체가 에이전트이므로 에이전트가 기록을 남기지 않으면 그래프는 늘지 않습니다. 코드가 바뀔 때 자동으로 갱신되는 인덱스를 기대한다면 이 도구의 전제와 어긋납니다. 사람이 쓴 문서를 그래프로 관리하고 싶다면 마크다운을 형식으로 쓰는 lat.md 쪽이, 여러 에이전트가 하나의 기억을 공유하는 서버형 구조를 원한다면 memsearch 쪽이 더 가깝습니다.
MegaMemory의 라이선스
MegaMemory는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
 MegaMemory 프로젝트 GitHub 저장소
더 읽어보기
-
codebase-memory-mcp: 코드베이스를 지식 그래프로 인덱싱하는 코드 인텔리전스 MCP 서버 (및 기반 연구)
-
Graphify: 복잡한 코드베이스를 한눈에 - AI 코딩 어시스턴트를 위한 지식 그래프(Knowledge Graph) 도구
-
lat.md(Agent Lattice): AI 코딩 에이전트와 사람을 위한 마크다운 기반 코드베이스 지식 그래프
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 도구를 직접 설치해 사용해보셨다면, 파이토치 한국 사용자 모임 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
