Reverify 소개
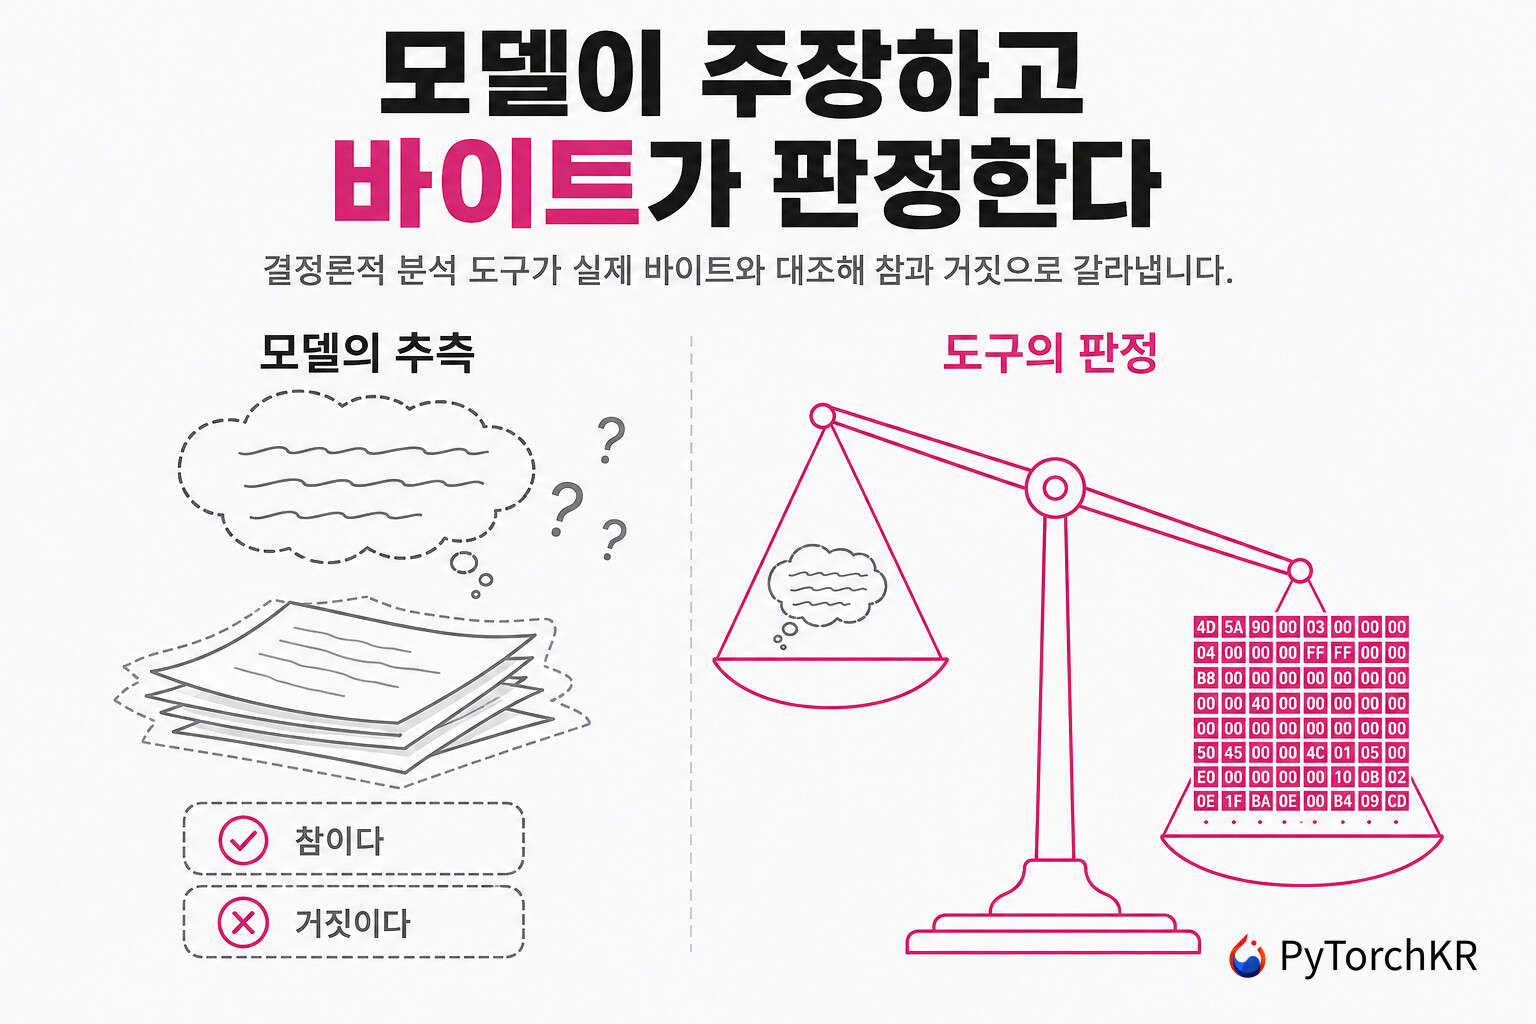
언어 모델은 소스 코드를 읽는 일은 잘하지만 바이너리를 읽는 일에서는 신뢰하기 어렵습니다. 구조체나 알고리즘을 복원해 달라고 하면 오프셋과 크기, 동작을 자신 있게 지어내고, 그것을 사실처럼 서술합니다. 저자는 소스 코드에서보다 바이너리 분석에서 이 환각(hallucination) 문제가 훨씬 심각하며, "방금 저거 모델이 지어낸 건가?" 라는 의심이 실무에서 AI를 리버스 엔지니어링(reverse engineering)에 쓰지 못하게 만드는 가장 큰 걸림돌이라고 정리합니다.
Reverify는 그 의심을 사람이 아니라 도구가 대신 풀게 만드는 프로젝트입니다. 언어 모델과 결정론적인 순수 파이썬 리버스 엔지니어링 도구 모음을 짝지어 두고, 판정 권한을 모델이 아니라 도구 쪽에 둡니다. 모델이 구조체나 알고리즘에 관한 가설을 내놓으면 도구가 그 가설을 실제 바이트와 대조해 역어셈블하거나, 패턴을 찾아보거나, 에뮬레이터에서 실행해 봅니다. 대조를 통과한 것만 결과로 보고되므로, 출력이 모델의 상상이 아니라 바이너리에 근거를 두게 됩니다.
Reverify의 결정론적 핵심부는 PE/ELF/Mach-O 파싱, x86/x64/ARM/ARM64 역어셈블, 와일드카드를 쓰는 바이트 배열 검색, CPU 에뮬레이션, Protobuf와 TLV 해체, Frida 후킹 스크립트 생성을 순수 파이썬으로 제공합니다. Ghidra 없이 설치되고, 필요하면 성숙한 엔진으로 그 자리에서 갈아탑니다. CLI와 함께 MCP(Model Context Protocol) 서버로도 동작해서 Claude Code나 Cursor 같은 에이전트가 도구를 직접 호출할 수 있습니다. 프로젝트는 사용 범위를 악성코드 분석, CTF, 상호운용성 연구, 그리고 본인이 소유하거나 분석이 허용된 소프트웨어로 명시해 두고 있습니다.
Reverify는 누구에게 맞는가
바이너리 분석에 AI를 붙여 보고 싶지만 결과를 믿을 근거가 없어 미뤄 둔 분석가에게 Reverify가 잘 맞습니다. 순수 파이썬 핵심부만으로도 동작하므로 무거운 도구를 먼저 설치할 필요가 없고, 판정 결과가 근거로 삼은 바이트와 함께 돌아오기 때문에 도구의 판정 자체도 사람이 다시 확인할 수 있습니다. CTF처럼 정답이 파일 안에 있는 작업에서 특히 효과가 분명합니다.
반대로 모델이 알아서 분석 보고서를 써 주기를 기대하는 사용자에게는 Reverify가 적절한 선택지가 아닙니다. 이 도구는 사람이나 에이전트가 검증할 주장을 구조화된 형식으로 제시해야 동작하며, 함수 경계나 호출 그래프처럼 프로그램 분석 엔진이 있어야 답할 수 있는 질문은 angr를 따로 설치해야 다룰 수 있습니다. 설치하지 않으면 엔트리 포인트와 익스포트처럼 독립적으로 확실한 항목 외에는 추측 대신 판정 보류로 답합니다.
Reverify의 검증 루프
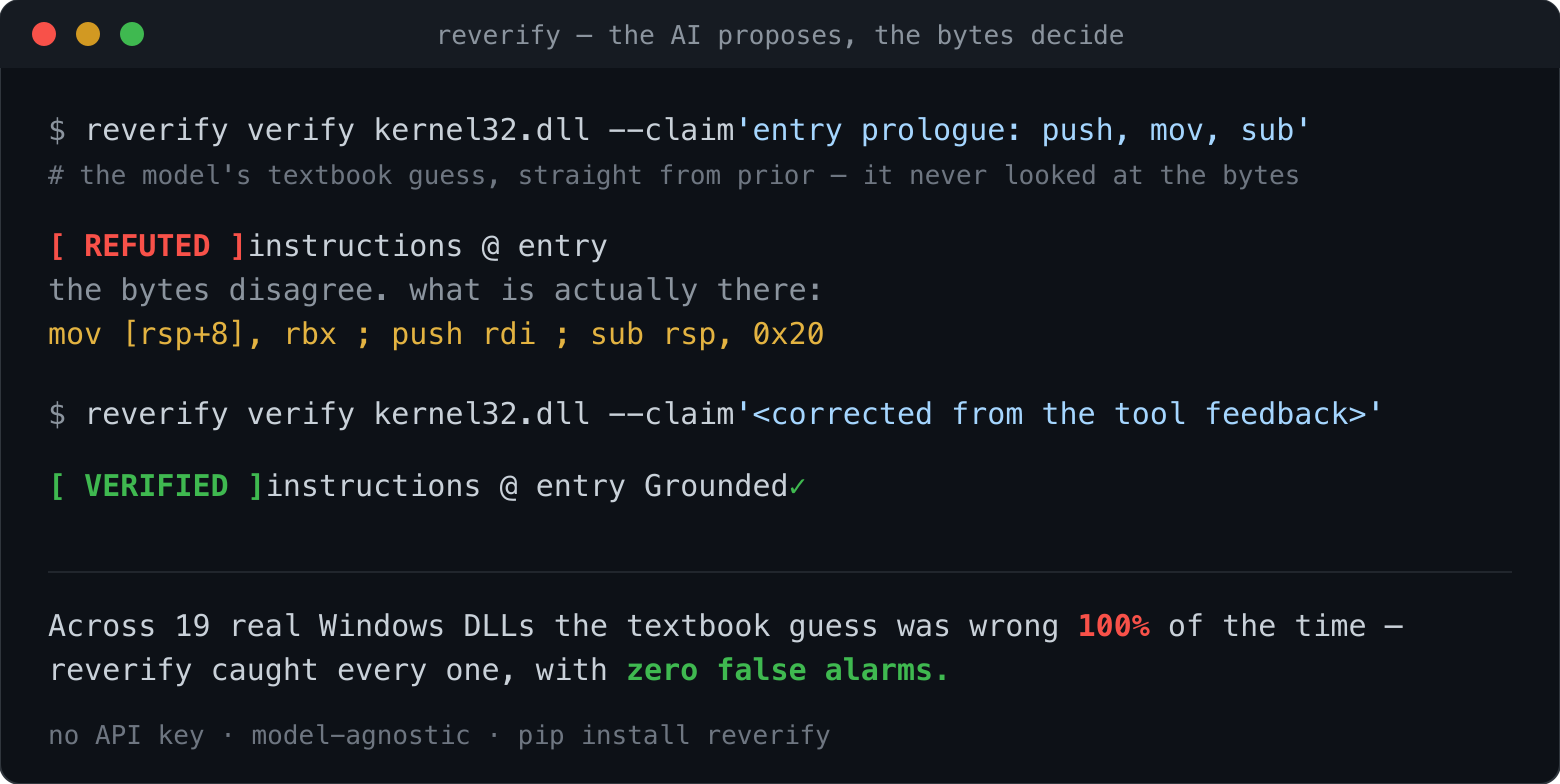
Reverify에서 주장(claim)은 바이너리에 관한 가설 하나를 가리키고, 도구는 그 주장에 대해 VERIFIED, REFUTED, INCONCLUSIVE 중 하나를 실제로 관찰한 바이트와 함께 돌려줍니다. 저장소가 공개한 예시는 모델이 교과서에 나오는 함수 서두를 그대로 주장했다가 반증당하고 정정하는 과정을 보여줍니다:
주장은 JSON으로 씁니다. 아래는 파일 오프셋 4096 위치의 명령어 세 개를 확인하는 예시입니다:
reverify verify sample.bin --claim '{
  "kind": "instructions", "offset": 4096,
  "mnemonics": ["push", "mov", "sub"], "note": "function prologue"
}'
주장의 종류는 bytes_at처럼 특정 위치의 바이트를 보는 것부터 pattern_present, string_present, import_present, export_present, section_present처럼 존재 여부를 보는 것, emulate_result처럼 실제로 실행해 레지스터 값을 확인하는 것까지 준비되어 있습니다. 오프셋은 기본적으로 파일 오프셋이며 "space" 값을 rva나 va로 지정하면 다른 주소 공간으로 해석되고, 검증기가 섹션 테이블을 거쳐 변환한 뒤 세 주소를 모두 근거에 적어 돌려줍니다. bytes_at이 반증되면 기대한 바이트가 실제로는 어디에 있는지까지 알려 줍니다.
값을 단정하는 대신 읽기만 하고 싶을 때는 "observe": true를 넣고, 어떤 주장이 다른 주장 위에 서 있다면 "depends_on"으로 묶어 뿌리가 반증될 때 그 위의 주장까지 무효로 만들 수 있습니다. 주장을 JSON 파일로 모아 한 번에 검증할 수도 있으며, 하나라도 반증되면 CLI가 0이 아닌 값으로 종료하므로 에이전트나 CI 작업이 이 결과를 통과 조건으로 쓸 수 있습니다.
Reverify가 검증 결과에 등급을 매기는 방식
이런 구조에서 가장 쉬운 우회는 통과하기 쉬운 주장만 내놓는 것입니다. 파일이 MZ로 시작한다거나 .text 섹션이 있다고 주장하면 언제나 검증에 성공합니다. 그래서 Reverify는 검증 통과 여부와 별개로 그 주장이 실제로 얼마나 많은 것을 말했는지를 함께 잽니다. 결과마다 정보량 가중치(weight)가 붙는데, 모델에게 이미 보여 준 정보를 되풀이한 주장, 중복된 주장, 바이너리에 실재하지 않는 인라인 코드와 데이터에 관한 주장, 도구가 앞서 출력한 내용을 그대로 옮긴 주장은 가중치가 0입니다. 그 외의 주장은 바이너리 자체에서 측정한 값, 즉 기대한 내용이 이 파일에 얼마나 자주 나타나는지와 엔트로피가 얼마나 되는지로 가중치가 정해집니다.
그래서 0으로 채운 영역이나 어디에나 나오는 흔한 함수 서두는 검증에 성공해도 거의 아무런 무게를 갖지 못합니다. 하나도 반증되지 않았고 검증된 가중치의 합이 --min-information(기본값 1.0)에 도달했을 때에만 복원 결과를 근거 있음으로 인정하는데, 저자는 이 방식이 사실이면서 정보량이 있고 반복되지 않는 주장에만 점수를 주는 FActScore의 CORE 개선안을 따른 것이라고 밝히고 있습니다.
판정의 강도에도 등급이 있습니다. prove_equiv 주장은 Z3를 써서 두 수식이 모든 입력에 대해 같음을 증명하고, behavior_equiv 주장은 원본 함수와 복원한 함수를 같은 입력으로 돌려 결과를 비교한 뒤 어긋나면 반례를 돌려줍니다. 반면 함수 경계와 호출 그래프, 상호 참조를 다루는 의미 계층은 angr의 휴리스틱 분석 결과 위에 서 있어서 함수를 놓치거나 쪼갤 수 있습니다. 저자는 이 점을 감추지 않고 해당 판정을 VERIFIED보다 한 단계 아래인 DERIVED 등급으로 따로 기록하며, 어느 엔진이 낸 판정인지도 함께 남깁니다. 엔진 자체도 검사 대상이어서, angr와 무관하게 파싱한 익스포트 테이블이 엔진이 복원한 함수 목록과 일치해야 합니다.
Reverify의 원장과 맥락 초기화
에이전트로 긴 분석을 돌리다 보면 대화 맥락이 가득 차서 요약되거나 초기화됩니다. 이때 무엇이 상태이고 무엇이 잡담이었는지 대화록만 보고는 가릴 수 없어서 손실이 생깁니다. Reverify의 루프는 그 경계를 이미 긋고 있다는 점을 활용합니다. 남길 가치가 있는 것은 도구가 검증하고, 관찰하고, 증명하고, 반증한 내용뿐이고 모델이 혼자 한 말은 애초에 신뢰 대상이 아니었으므로 버려도 잃을 것이 없다는 논리입니다.
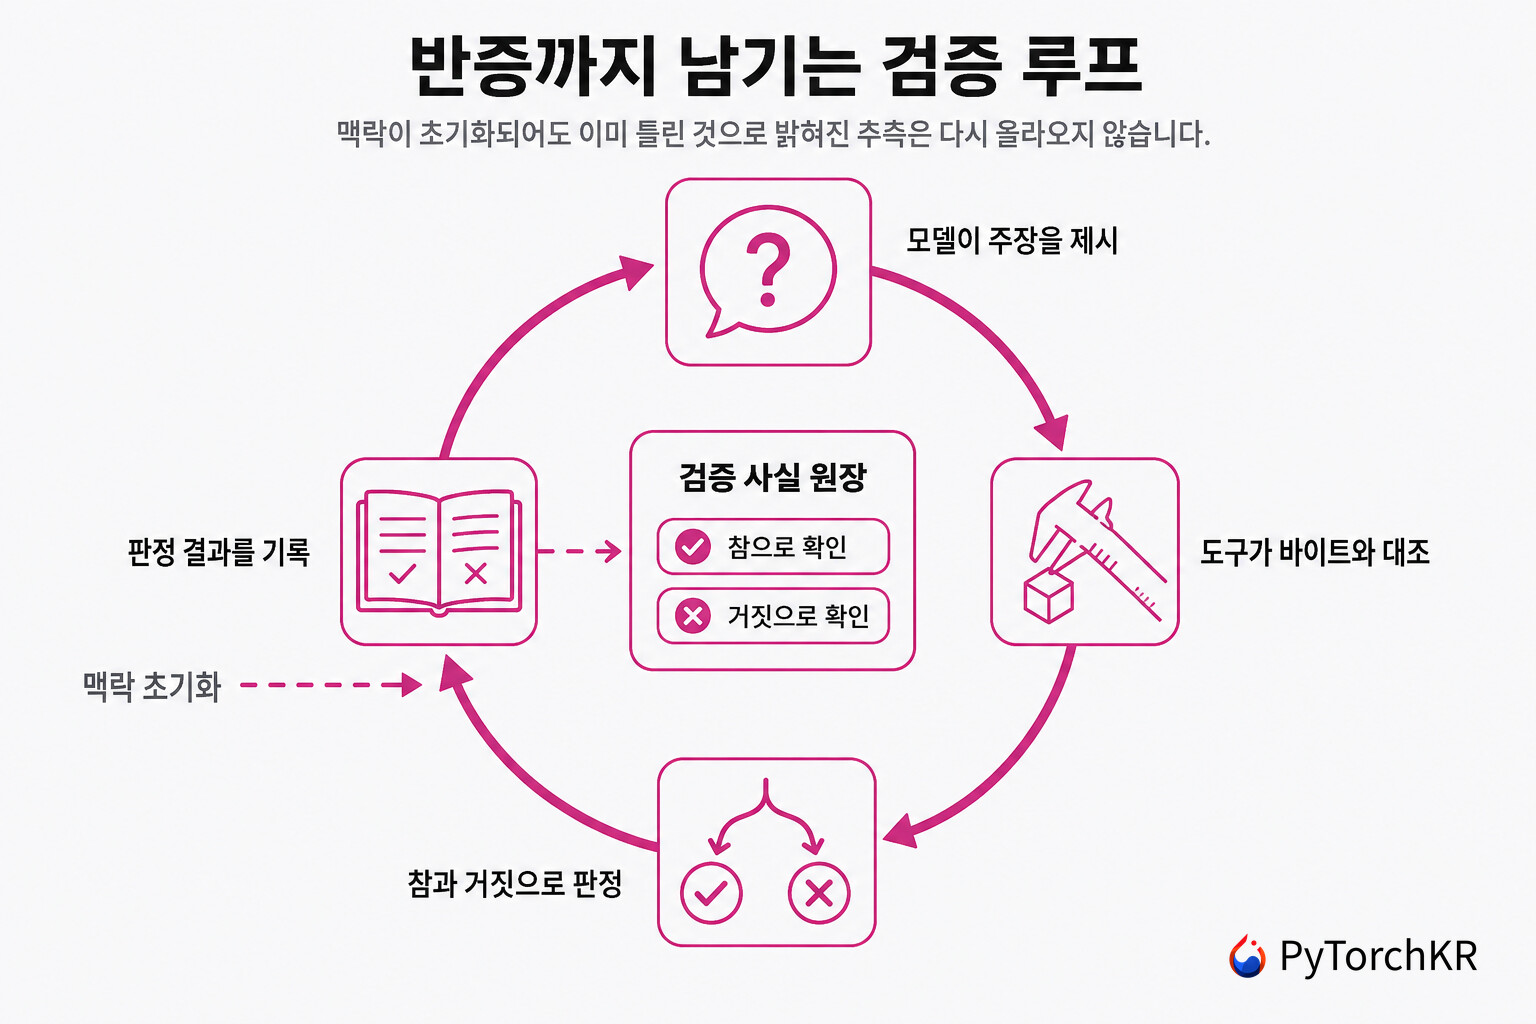
v0.8.0부터 그 상태는 바이너리마다 .reverify/ledger/<sha256>.json 파일로 디스크에 기록됩니다. 파일 내용의 해시를 키로 쓰기 때문에 이름을 바꿔 복사한 파일도 같은 원장을 공유하며, 매 라운드가 끝날 때마다 저장되므로 프로세스가 죽거나 맥락이 초기화되어도 같은 지점에서 이어집니다. 여기서 특히 눈여겨볼 부분은 반증된 주장이 KNOWN FALSE로 되살아난다는 점입니다. 요약이 가장 먼저 버리는 것이 이런 부정적 결과인데, 그것을 남겨 두어야 새 맥락에서 같은 잘못된 추측이 다시 올라오지 않습니다.
원장이 커져도 맥락은 커지지 않습니다. 프롬프트에는 최근 사실 --max-facts개만 보이고, 보이는 사실 목록은 --prompt-budget 글자 수에 맞춰 결정적인 순서로 잘립니다. 저장소가 든 예시로는 kernel32.dll의 43,000자짜리 목록이 섹션 테이블과 엔트리 포인트, 헤더를 온전히 남긴 채 20,000자 예산에 들어갑니다. 점수 계산은 잘리지 않은 전체 목록으로 하기 때문에, 사실을 숨겨서 그것을 다시 주장해 점수를 얻는 일이 생기지 않습니다.
MCP 경로에서는 별도 설정 없이 같은 일이 일어납니다. re_verify_claim 도구가 근거 있는 결과를 모두 기록하고, 호스트가 맥락을 압축하거나 비운 뒤에 re_ledger 도구가 그것을 돌려줍니다. Claude Code에서는 reverify ledger --hook으로 세션 시작 훅을 걸어 둘 수 있습니다.
Reverify가 공개한 벤치마크
저장소는 검증기가 실제 환각을 잡아내는지를 재현 가능한 형태로 측정해 두었습니다. 측정 방법은 단순합니다. 모델에게 함수의 진입부가 어떻게 생겼는지 물으면 대체로 교과서적인 프레임 포인터 서두인 push rbp ; mov rbp, rsp를 답한다는 점을 이용해, 그 답을 역어셈블 결과를 전혀 보지 않은 채 실제 시스템 파일 여러 개에 그대로 적용하고 검증기가 어떻게 판정하는지를 봅니다.
윈도우 시스템 DLL 19개(64비트 9개, 32비트 10개)를 대상으로 한 결과는 다음과 같습니다:
prior wrong (hallucination rate): 19/19 = 100%
false VERIFIED (must be 0)       : 0
true bytes after 1 feedback round: 19/19 = 100%
64비트 파일들은 레지스터를 그림자 공간에 저장하며 시작했고 32비트 파일들은 핫패치용 mov edi, edi 스텁으로 시작해서, 교과서적인 답은 매번 틀렸습니다. 검증기는 그 19개를 모두 반증했고 틀린 주장을 한 번도 VERIFIED로 인정하지 않았습니다. 같은 측정을 aarch64 리눅스 ELF 19개에도 돌려 같은 수치를 얻었습니다.
여기서 저자가 붙인 단서를 함께 읽는 편이 정확합니다. 저자는 100%라는 값이 진입점 서두에 한정된 수치이며 진입점은 CRT와 DLL 시작 스텁이라 원래 교과서와 다른 모양을 가진다고 적어 두었습니다. 내부 함수를 무작위로 골랐다면 비율이 달라졌을 것이며, 이 측정은 잘 알려진 하나의 선입견을 깨끗하게 찔러 본 것이지 모든 환각을 조사한 것이 아니라는 설명입니다. 한 번의 피드백으로 정답에 도달했다는 항목도 두 번째 라운드가 도구의 출력을 다시 진술한 것이므로, 점수를 매기는 복원 루프에서는 그 진술이 되풀이로 검출되어 정보량 가중치를 얻지 못한다고 밝히고 있습니다. aarch64 결과에 대해서도 x86용 선입견은 애초에 틀릴 것이 예상되는 약한 시험이므로, 의미 있는 값은 아키텍처와 무관하게 유지된 오판정 0건 쪽이라고 분명히 하고 있습니다.
Reverify 설치와 사용
PyPI에서 받으면 CLI와 MCP 서버가 함께 설치됩니다:
# Install the CLI + MCP server from PyPI:
pip install reverify        # pure-Python core; or "reverify[full]" for capstone+unicorn+lief
reverify auto sample.bin --json

# Or run straight from a checkout — pure standard library, nothing to install:
python reverify/cli.py auto sample.bin --json
python reverify/cli.py parse-pe sample.exe --json
python reverify/cli.py disasm 90505831C0C3 --arch x86_64
pip install "reverify[full]"로 설치하면 역어셈블은 capstone, 에뮬레이션은 Unicorn, 파일 파싱은 LIEF가 맡도록 그 자리에서 올라갑니다. 함수 경계와 호출 그래프가 필요하면 pip install "reverify[angr]"를 추가합니다. 어느 엔진이 켜져 있는지는 reverify backends로 확인합니다.
복원 루프와 원장을 쓰는 명령은 다음과 같습니다:
reverify reconstruct target.exe --goal "..."   # resumes from .reverify/ automatically
reverify ledger target.exe                     # what is established, what is known false
reverify ledger --hook                         # Claude Code SessionStart hook (compact|clear|resume)
MCP 서버는 python reverify/mcp_server.py로 띄웁니다. 에이전트를 이 서버에 연결하면 파싱, 역어셈블, 검색을 직접 호출할 수 있고, re_verify_claim 도구를 거치면 에이전트가 자기 가설을 보고하기 전에 바이트로 판정받게 만들 수 있습니다.
Reverify의 라이선스
Reverify는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
 Reverify 프로젝트 GitHub 저장소
더 읽어보기
-
x64dbg-MCP Server: 런타임 설치 없이 x64dbg를 AI 어시스턴트에 연결하는 Zig 기반 플러그인
-
Reversa: 레거시 코드에서 AI 코딩 에이전트용 명세를 역으로 추출하는 다중 에이전트 프레임워크에 대한 연구
-
Anthropic, AI 에이전트 배포를 위한 Zero Trust 보안 프레임워크 eBook 공개 [영문/PDF/36p]
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
