핵심 요약
- 비영리 평가 기관 METR가 2026년 8월 12일부터 10월 29일까지 Anthropic 내부 자료로 AI가 AI 개발을 얼마나 빠르게 만드는지 평가하고, 11월 5일 공개 보고서를 냈습니다. METR는 2026년 10월 현재 잘 정의된 과제에서 Anthropic 모델의 능력이 오르는 속도가 2024년 3월~2025년 10월의 약 2배라고 판단했고, 실제 값이 1.3배나 3배여도 놀랍지 않다고 적었습니다.
- 내부 미공개 모델까지 넣은 벤치마크 종합 지표 AECI(Anthropic이 Epoch Capabilities Index를 자체 구성한 지수)의 연간 상승폭은 2025년 10월을 기점으로 +15점에서 +29점으로 커졌고, 이는 1.9배(95% 신뢰구간 1.5~2.8배) 가속에 해당합니다. METR는 이 가속이 훈련 컴퓨트 확대 속도 때문은 아니라고 확신했고, 현재 가속의 약 80%가 AI 사용 덕분이라고 추측했습니다.
- 함께 낸 Anthropic 8월 위험 보고서 리뷰에서 METR는 공개본이 가속 근거를 낮춰 서술했고, 7월 15일 시점에 RSP의 "2배 가속" 조기 경보 임계선을 이미 넘었을 가능성도 있다고 봤습니다. 당시 모델의 직접적인 재앙 위험이 낮았다는 판단에는 동의했습니다.
- METR가 결론에 가장 유용하다고 본 근거의 대부분은 Anthropic이 가림 처리(redaction)했고, 계약에 있던 컴퓨트 배분 검증은 Anthropic이 중간에 범위에서 뺐습니다. METR 스스로 독자가 자신들의 판단에 기대야 하는 정도가 바람직한 수준보다 크다고 밝혔습니다.
METR의 Anthropic AI R&D 가속 평가 소개
AI 회사가 다음 모델을 만드는 데 AI를 쓰기 시작하면, 더 좋은 모델이 개발을 더 빠르게 만들고 그 결과 더 좋은 모델이 더 빨리 나오는 고리가 생길 수 있습니다. 이번 보고서는 이 고리가 실제로 돌기 시작했는지, 돌고 있다면 얼마나 빠른지를 회사 바깥의 평가자가 회사 안쪽 자료로 확인하려 한 결과물입니다. METR는 보고서 첫머리에서, AI가 AI 개발을 크게 가속하기 시작하면 극단적이고 위험한 능력이 갑자기 나타날 수 있다는 점을 평가의 이유로 듭니다.
METR(Model Evaluation & Threat Research)는 프런티어 AI 모델을 평가하는 비영리 기관입니다. PyTorchKR에서는 METR의 긴 작업 수행 능력 측정 연구와 OpenAI 모델의 Hugging Face 침해 사건 조사를 소개한 적이 있습니다. Anthropic은 자사 책임 있는 확장 정책(Responsible Scaling Policy, RSP)에서 AI R&D 가속을 핵심 위험 지표로 둡니다. 다만 이번 평가에서 METR는 RSP의 임계선에 맞추지 않고, AI가 AI 개발을 얼마나 가속하는지 전체 그림을 그리는 데 집중했다고 밝혔습니다.
Anthropic은 그동안 이 주제의 수치를 스스로 공개해 왔습니다. 9월에는 AI R&D 자동화 지수와 안전 연구 컴퓨트 비중 같은 사내 지표를, 10월에는 주니어 채용 감소와 에이전트 작업량 같은 사내 고용 변화를 내놓았습니다. 두 글 모두 Anthropic이 자기 자료로 쓴 것입니다. 이번 보고서는 같은 질문을 외부 기관이 비공개 자료를 보고 판단했다는 점이 다릅니다. Anthropic은 사전 학습(pretraining)과 강화학습(Reinforcement Learning, RL) 지표, 분야별 훈련 컴퓨트, 내부 모델의 벤치마크 점수를 제공했습니다. AI 속도 향상 분석, 미래 모델 예측, 직원 인터뷰도 제공했고, METR는 이 접근을 "전례 없는(unprecedented)" 수준이라고 표현했습니다.
평가는 METR 직원 4명이 주 저자(Tom Cunningham, Nate Rush, Parker Whitfill, Hjalmar Wijk)로 참여해 전일 근무 기준 2.5명 규모로 11주 동안 진행했습니다. METR는 약 100쪽 분량의 전체 보고서(Full Report)를 10월 22일 Anthropic에 전달했고, 이번에 공개한 것은 Anthropic의 가림 처리를 거친 요약본입니다. 이 프로젝트는 Anthropic이 10월 15일 발표한 METR 직원 6명의 "직원 수준 접근(employee-like access)" 상주 평가와는 별개입니다. METR는 이번 평가에서 데이터, 문서, 모델에 대한 무중개 접근을 받지 않았고, 필요한 자료를 하나씩 요청하는 방식으로 일했습니다. METR는 실제 접근 수준이 기대를 넘었다고 평가했지만, Anthropic이 너무 민감하다고 본 소수의 요청은 거절되었습니다. METR는 Anthropic에서 대가를 받지 않았고, 보안을 위해 Anthropic 기기에서 작업했으며, 데이터 분석과 시각화에 쓴 토큰을 무료로 받았습니다.
아래에서는 먼저 보고서가 쓰는 "가속"이라는 말의 정의를 정리하고, METR의 세 가지 결론과 그 근거를 차례로 봅니다. 이어서 함께 공개된 Anthropic 위험 보고서 리뷰, 가림 처리와 독립성 문제, METR가 스스로 밝힌 한계를 다룹니다.
읽기 전에: "2배 가속"이 뜻하는 것
이 보고서에서 가속(acceleration) 은 성장 속도가 빨라진 정도, 곧 두 성장률의 비율입니다. 가속이 2배이면 예전 속도로 2년 걸릴 진척을 1년에 이룹니다. 예를 들어 AECI 점수가 원래 1년에 15점씩 올랐는데 지금 30점씩 오른다면 가속은 2입니다. 지수적으로 커지는 값이라면 계산이 달라집니다. 1년에 3배씩 커지던 값이 2배 가속되려면 1년에 3^2 = 9 배씩 커져야 하고, 가속은 \ln 9 / \ln 3 = 2 로 계산합니다.
METR는 진척을 재는 지표 하나마다 성장률 세 가지를 나눠 봅니다.
- 과거 성장률(historical growth rate): 추세가 바뀌기 전의 성장률입니다.
- 현재 성장률(current growth rate): 2026년 10월 시점의 성장률입니다.
- 반사실 성장률(counterfactual growth rate): Anthropic이 AI를 쓰지 못했다면 2026년 10월에 보였을 성장률입니다.
앞의 두 값은 관측할 수 있지만 반사실 성장률은 추측할 수밖에 없습니다. METR가 예시로 든 가짜 데이터에서는 과거 성장률이 연 2배, 현재 성장률이 연 9배, AI가 없었을 때의 성장률이 연 3배입니다. 이때 AI 덕분의 가속은 \log 9 / \log 3 = 2 이고, 과거 대비 가속은 \log 9 / \log 2 \approx 3.2 입니다. 즉 "과거보다 얼마나 빨라졌는가"와 "AI 때문에 얼마나 빨라졌는가"는 다른 질문입니다.
METR는 두 가지 구분을 더 강조합니다. 첫째, 특정 시점의 순간 가속(instantaneous acceleration) 과, 2025년 10월 이후 쌓인 진척 중 AI 몫을 따지는 누적 가속(cumulative acceleration) 은 다릅니다. 2025년에는 AI가 아닌 요인이 컸고 AI의 영향은 시간이 갈수록 커졌으므로, METR는 누적 가속이 대체로 순간 가속보다 작을 것으로 예상합니다. 둘째, 직원 한 명이 AI 덕분에 일을 몇 배 빨리 하는지(개인 생산성 향상, uplift)는 가속과 같은 값이 아닙니다. 수확 체감을 이기고 같은 성장률을 유지하려면 노동이나 노동 생산성 같은 투입도 계속 커져야 하므로, 가속이 일어나려면 대체로 투입의 성장률 자체가 크게 빨라져야 합니다. 그래서 METR는 생산성 향상의 절대 크기보다 그 성장률이 바뀌었는지를 더 중요하게 봅니다. Anthropic RSP v3.4의 각주도 진척 속도 2배가 연구자 생산성 2배와 같은 개념이 아니라고 적습니다.
METR가 내린 세 가지 주관적 결론
METR는 10월 AI R&D 가속 평가 방법 제안 글에서 이런 평가가 답해야 할 질문을 네 가지로 정리했습니다. 능력이 얼마나 빨리 오르고 있는지, 그 가속이 AI 때문인지, 가까운 시기에 성장을 막을 병목이 있는지, 그리고 그 방법이 훨씬 큰 가속을 놓치지 않았을지입니다. 이번 보고서의 결론은 앞의 세 질문에 하나씩 답하고, 네 번째 질문은 아래 한계 절에서 다룹니다. METR는 팀 안에서도 이견이 있었고 불확실성이 크다는 점을 결론마다 붙였습니다.
능력 향상 속도 (Pace of capabilities progress): 이번 평가에 참여한 METR 직원 대부분은 2026년 10월 현재 Anthropic이 잘 정의된 과제에서 모델 능력을 2024년 3월~2025년 10월의 약 2배 속도로 끌어올리고 있을 가능성이 높다고 봅니다. 실제 값이 1.3배나 3배에 가까워도 놀랍지 않다고 적었습니다. 덜 정의된 넓은 과제에서도 같은 가속이 나타나는지는 더 불확실합니다. METR는 원래 이런 큰 가속은 놀라운 일이라고 봤습니다. 수확 체감과 컴퓨트 의존성 때문에 다른 투입이 크게 늘어야만 가능하기 때문입니다. 판단에는 아래의 AECI 1.9배 결과가 크게 작용했고, 가림 처리된 다른 근거도 약 2배 가속을 더 진지하게 받아들이게 했습니다. 그 근거 중 일부는 가속이 2배를 넘고 시간이 갈수록 커질 수 있음을 시사했습니다. 다만 METR는 그 값이 2배보다 훨씬 크다면 놀랄 것이라고 적었습니다.
AI 귀속 (Attribution to AI): METR는 컴퓨트 확대, 채용, 데이터 개선, 알고리즘 발견, 다른 병목 해소를 가속의 후보 원인으로 살폈습니다. 훈련 컴퓨트 확대 속도가 원인이 아니라는 점은 확신했지만, 그 밖에는 Anthropic 직원들 사이에도 합의가 없었고 결정적인 근거도 찾지 못했습니다. 그래서 METR의 결론은 두 문장입니다. 2025년 말의 가속에는 AI가 아닌 요인이 크게 작용했을 가능성이 높고, 2026년 10월 현재 가속의 대부분(약 80%)은 AI 때문이라고 추측합니다. 시간이 갈수록 AI의 기여가 커졌고, 살펴본 다른 요인으로는 지속되는 가속을 설명하기 어렵다는 것이 근거입니다.
추가 가속을 막을 병목 (Bottlenecks to further acceleration): 가장 큰 우려는 AI가 만든 가속이 복리처럼 쌓이는 경우입니다. METR는 그런 가속을 막을 뚜렷한 병목, 곧 성장을 멈추게 할 제한된 투입이나 가파른 수확 체감을 찾지 못했습니다. 그래서 앞으로 1년 동안 능력 향상이 더 빠른 가속으로 이어질 위험이 상당하다고 봅니다. 다만 평가 기간에 병목에 대한 이해가 여러 번 바뀌었으므로, 중요한 병목을 놓쳤을 수 있다고 덧붙였습니다.
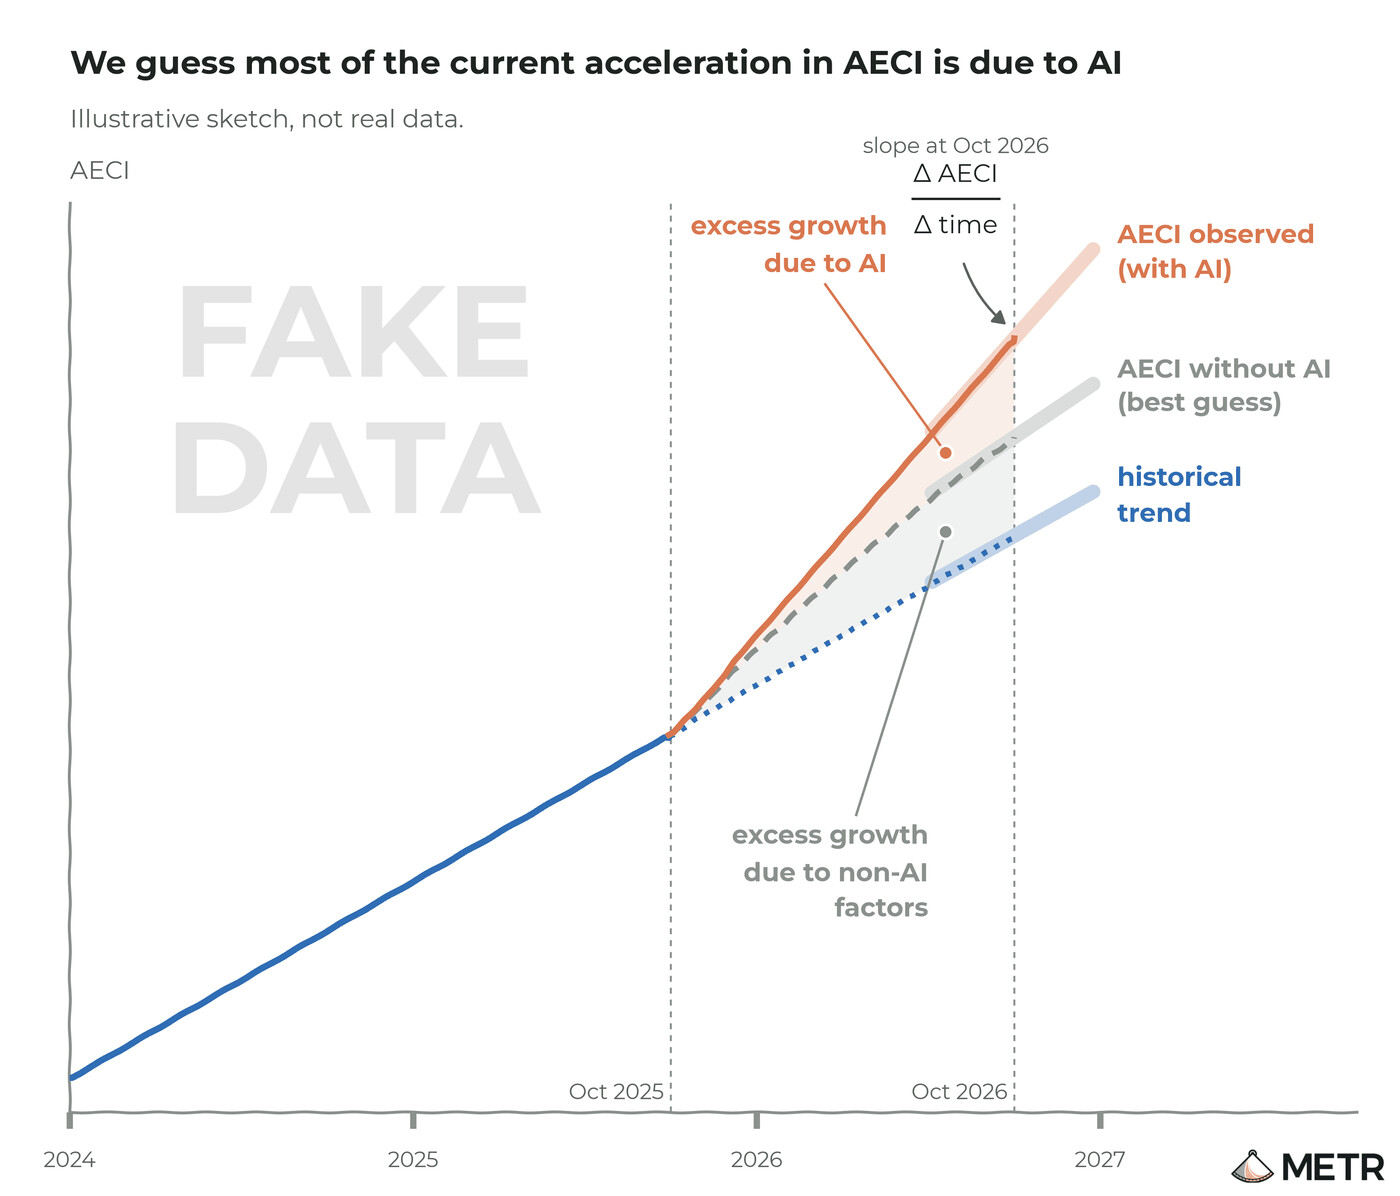
위 그림은 METR가 AI 귀속 판단을 설명하려고 그린 스케치이며 실제 데이터가 아닙니다. 2025년 10월 이후 관측된 성장은 과거 추세보다 빠르고, 그 초과분은 AI가 아닌 요인의 몫(회색 영역)과 AI의 몫(주황 영역)으로 나뉩니다. METR는 현재 시점의 기울기에서 AI 몫이 대부분이라고 추측합니다. AECI와 학습 파이프라인 단계별로 AI의 누적 효과와 순간 효과를 따로 추정한 상세 값은 가림 처리되었습니다.
근거 1: 내부 모델을 포함한 AECI 추세
AECI 1.9배: 지난 1년에 2년 치 진척
AECI 는 Anthropic이 Epoch AI의 ECI(Epoch Capabilities Index)를 자기 방식으로 만든 능력 지수입니다. 여러 내부, 외부 벤치마크 점수를 하나의 잠재 능력 점수로 묶습니다. METR는 Epoch가 공개한 ECI 계산 코드로 모델별 AECI를 추정했고, 모델 안에서 벤치마크 점수를 복원 추출하는 부트스트랩(bootstrap)으로 95% 신뢰구간을 구했습니다.
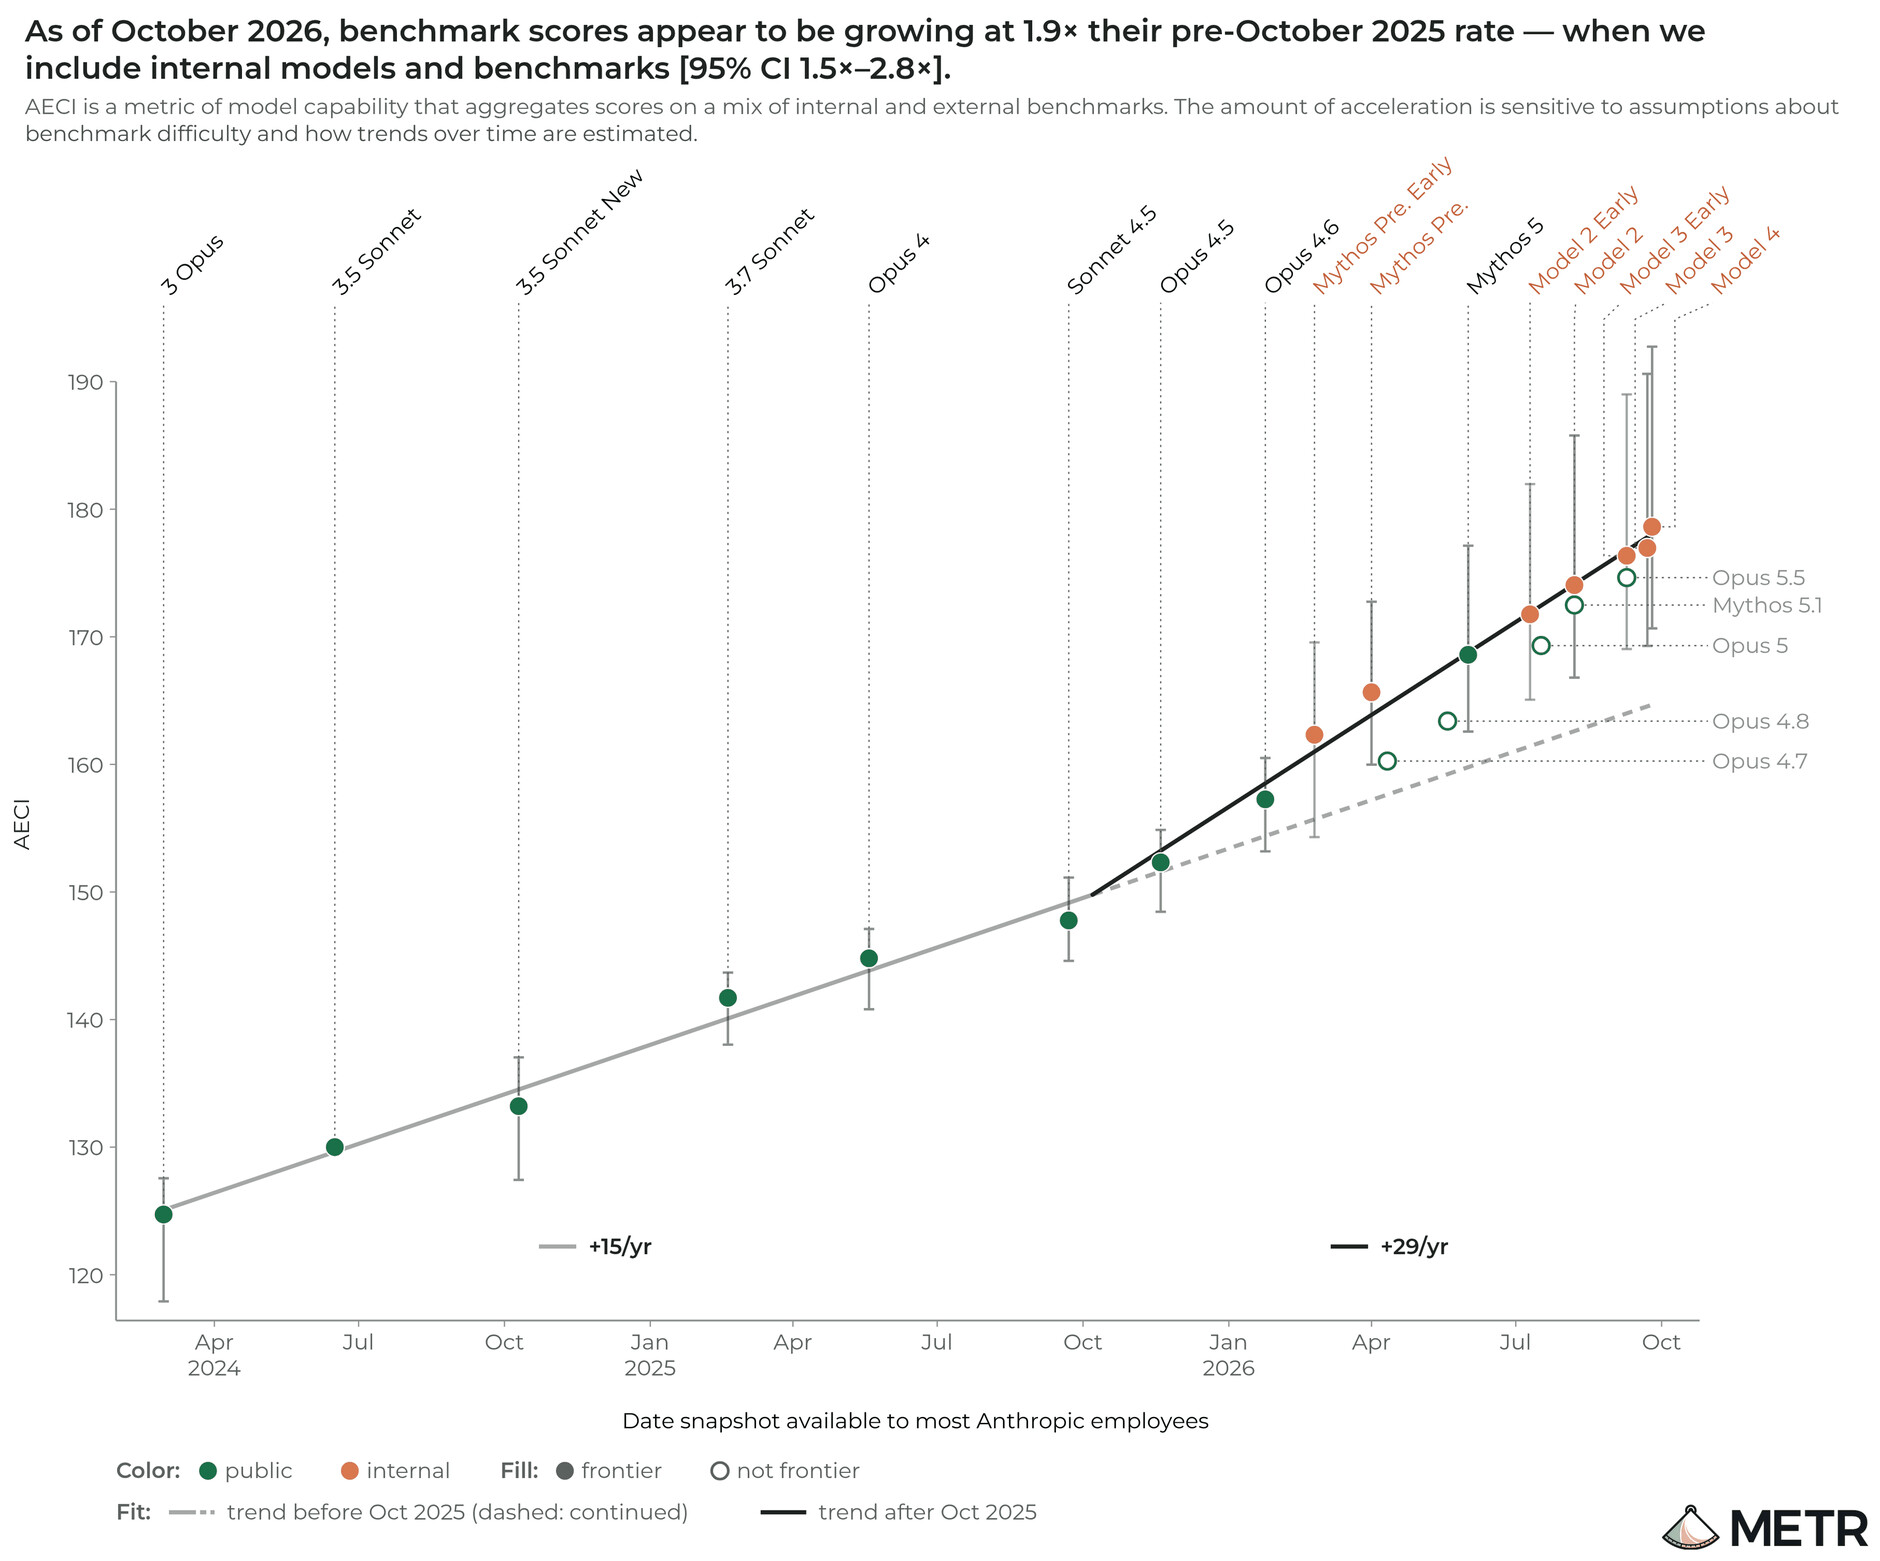
결과는 2025년 10월 이후 1.9배(95% 신뢰구간 1.5~2.8배) 가속입니다. 위 그래프에서 2025년 10월 이전 추세선은 연 +15점, 이후 추세선은 연 +29점입니다. METR는 이것을 Anthropic이 지난 1년 동안 2023년 10월~2025년 10월, 대략 Claude 2.1에서 Sonnet 4.5까지의 2년 치 벤치마크 진척을 이룬 것으로 풀이합니다. 추세가 꺾이는 지점은 데이터로 추정했고 2025년 10월 7일이 나왔습니다.
이 분석의 특징은 공개되지 않은 내부 모델을 포함했다는 점입니다. 2026년 7월에 훈련을 마친 Model 2, 8~9월의 Model 3, 9~10월의 Model 4가 들어갔고, 이름은 METR에 공유된 코드명입니다. 날짜도 공개 출시일이 아니라 Anthropic 직원 대부분이 그 스냅숏을 쓸 수 있게 된 날을 씁니다. METR는 Anthropic이 최근 모델을 출시 전에 조금 더 오래 내부에 두고 있어, 이 방식이 대체로 조금 더 큰 가속을 보인다고 설명합니다. Haiku 5.5 시스템 카드가 보고한 1.7배보다 METR의 값이 큰 주된 이유도 최근 내부 모델을 넣었기 때문입니다.
분석 선택에 따라 1.1배에서 2.9배까지
METR는 벤치마크 포함 기준, 모델 날짜 부여 방식, 포함 모델, 벤치마크 포화 처리 방식을 바꿔 가며 결과가 얼마나 달라지는지 확인했습니다. 결과를 가장 크게 바꾼 것은 연결 함수(link function) 입니다. AECI는 모델의 잠재 능력과 벤치마크 점수 사이를 로지스틱 함수로 잇는데, 이는 벤치마크 안의 문제 난이도가 좌우 대칭이고 꼬리가 지수적으로 줄어든다는 가정입니다. 이 가정을 바꾸면 결과는 다음과 같습니다.
| 연결 함수 | 문제 난이도 분포에 대한 가정 | 가속 (95% 신뢰구간) | 표본 외 R² |
|---|---|---|---|
| 로지스틱 (기본값) | 대칭, 지수적 꼬리 | 1.9배 (1.5~2.8) | 87.2% |
| 프로빗(probit) | 쉬운 문제와 어려운 문제의 꼬리가 더 짧음 | 1.8배 (1.3~2.7) | 87.1% |
| 코시(cauchit) | 쉬운 문제와 어려운 문제의 꼬리가 더 김 | 2.8배 (2.0~4.1) | 86.1% |
| 보 로그-로그(complementary log-log) | 쉬운 문제만 꼬리가 김 (찍어서 맞히기 쉬운 문제가 많은 경우) | 1.1배 (0.8~1.5) | 87.1% |
| 로그-로그(log-log) | 어려운 문제만 꼬리가 김 (극단적으로 어려운 문제가 몇 개 있는 경우) | 2.9배 (2.1~4.9) | 86.9% |
| 학습한 연결 함수 (Stukel 계열) | 양쪽 꼬리 길이를 데이터로 추정 | 2.6배 (1.8~4.1) | 87.0% |
적합도는 코시를 빼면 거의 같고, METR는 어느 하나를 고를 선험적 근거가 없다고 밝힙니다. 기본값으로 로지스틱을 쓰는 이유는 Epoch와 Anthropic이 쓰는 기본값이기 때문입니다. 연결 함수 외의 선택은 결과를 크게 바꾸지 않았습니다. 포함하는 스냅숏을 바꾸면 1.9~2.2배, 벤치마크 구성을 바꾸면 1.9~2.2배, 정규화(regularization) 강도를 바꾸면 1.9~2.1배였습니다. 비전 벤치마크를 빼면 2.2배, Claude가 AI R&D와 관련 있다고 분류한 벤치마크만 남기면 2.0배, 85%를 넘은 벤치마크를 그 뒤로 쓰지 않으면 1.9배였습니다. METR는 개선된 AECI가 나오더라도 가속이 전혀 없거나 3배를 넘는다면 놀랄 것이라고 정리합니다.
다른 회사 모델을 넣으면 1.4배
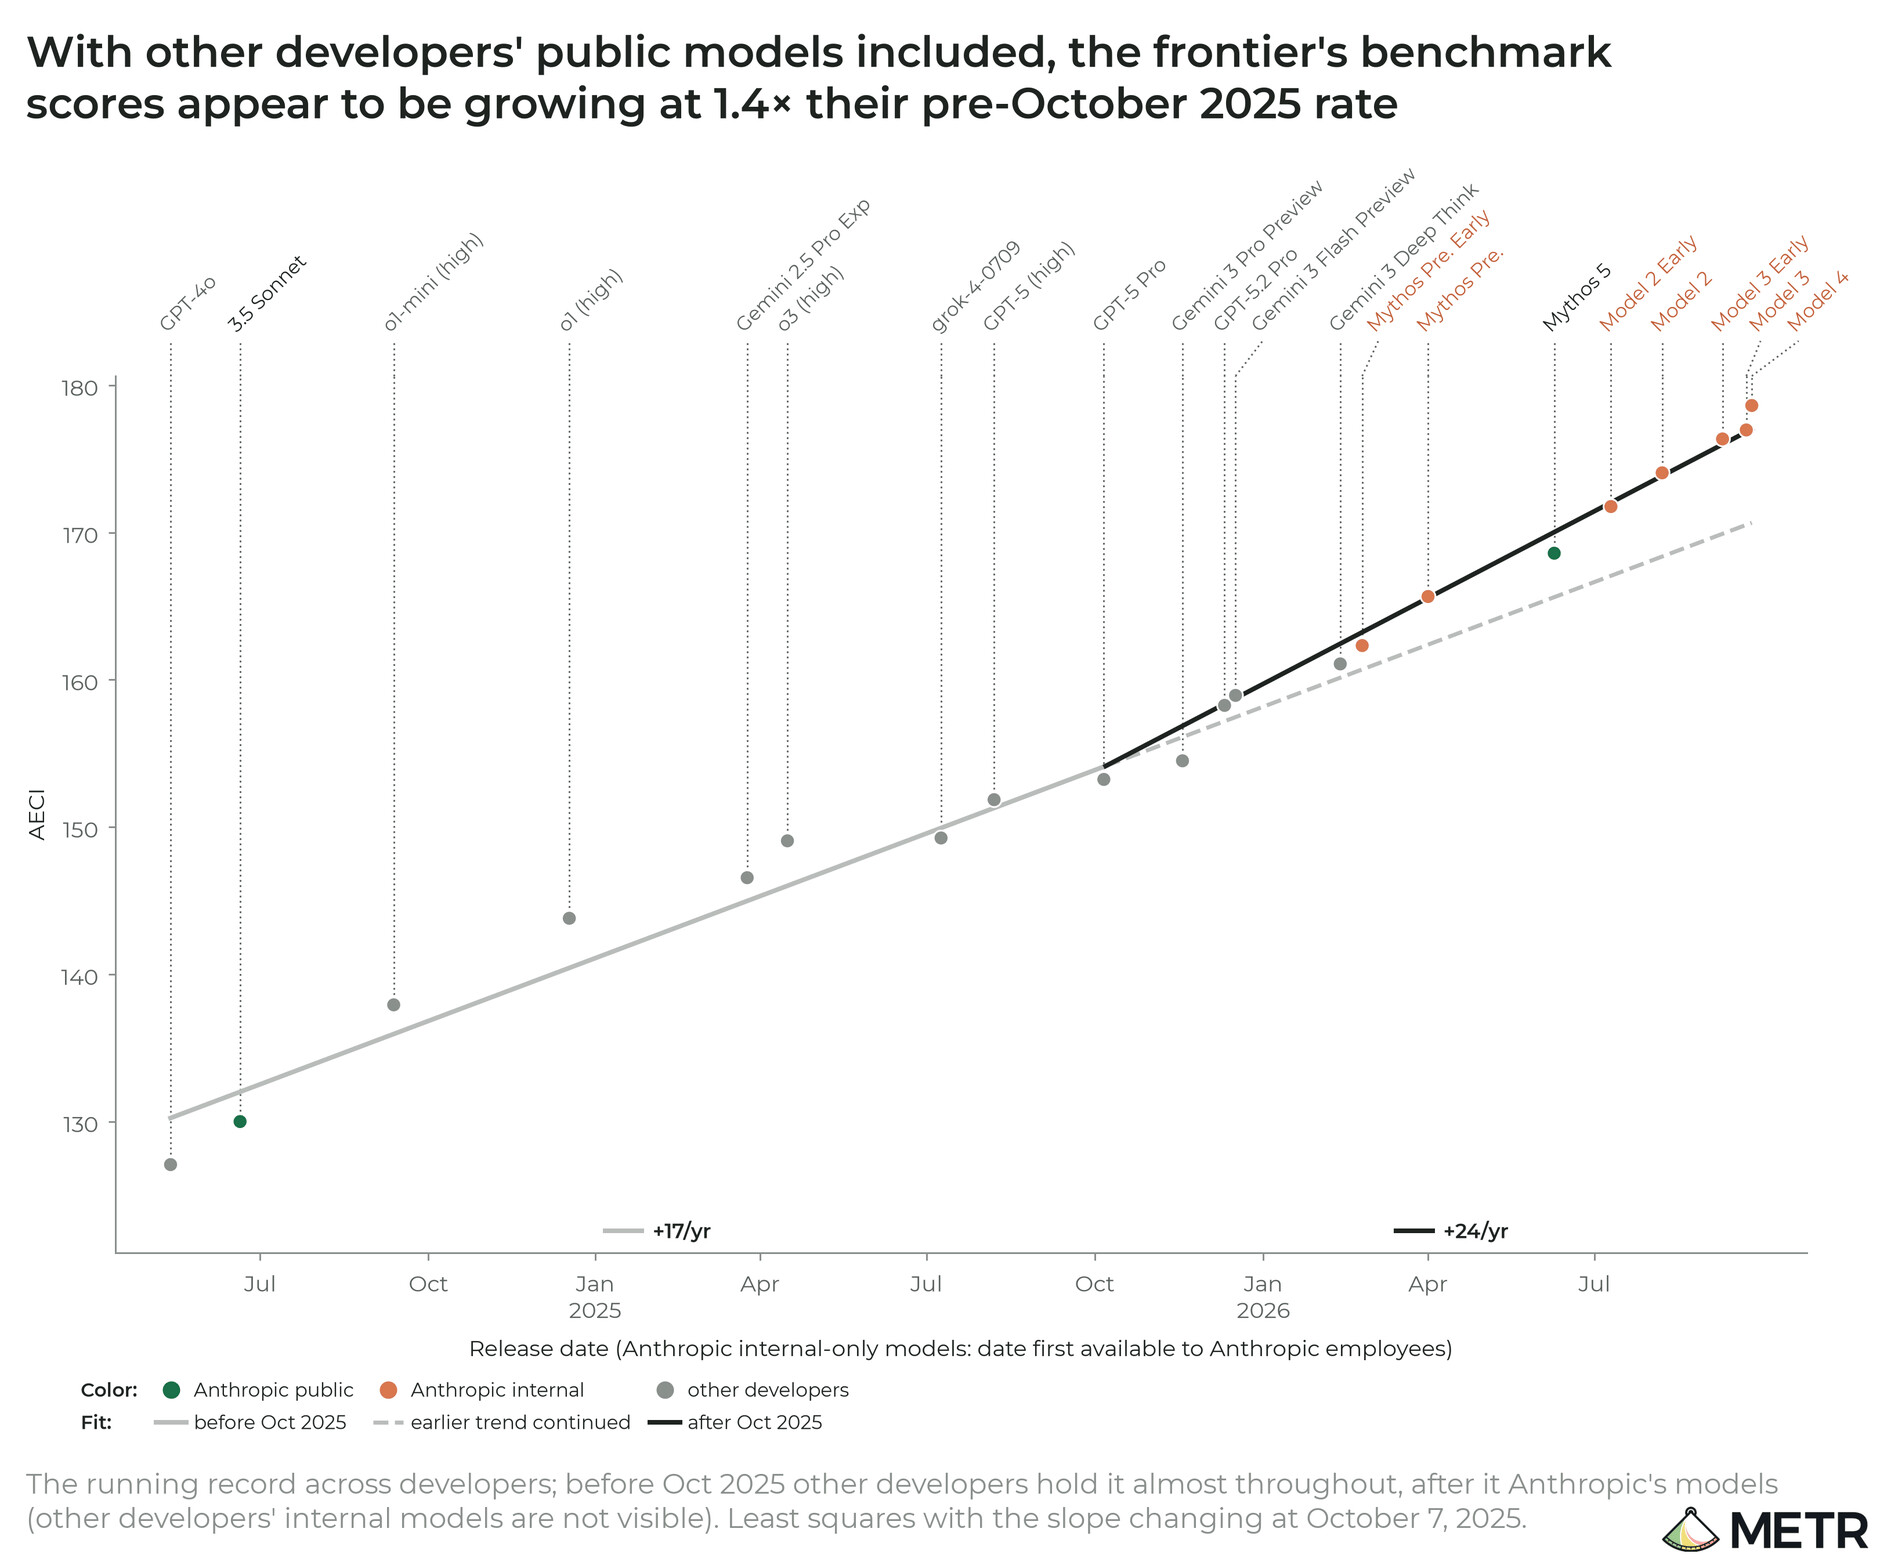
Anthropic 모델만이 아니라 모든 회사의 프런티어 모델로 추세를 그리면 추세는 연 +17점에서 +24점으로 바뀌고, 가속은 1.4배로 줄어듭니다. 이 그래프에서 과거 추세는 주로 다른 회사 모델로, 현재 추세는 주로 Anthropic 모델로 추정됩니다. 다른 회사의 내부 모델은 보이지 않는다는 점도 그래프 하단에 적혀 있습니다. METR는 이 차이를 두 가지로 해석할 수 있다고 봅니다.
- Anthropic 모델이 2025년까지 프런티어보다 뒤처져 있었다면 Anthropic의 과거 진척이 낮게 잡힌 것이고, 1.9배는 과대 추정이며 1.4배가 더 정확합니다.
- Anthropic 모델이 다른 회사 모델보다 벤치마크에 덜 최적화되어 있다면, 과거 추세의 앞쪽 점들이 벤치마크에 과적합된 것이고, 1.4배가 과소 추정이며 1.9배가 더 정확합니다.
METR는 둘 중 어느 쪽인지 판정하지 않았습니다. Epoch의 공개 ECI와 METR 추정이 다른 가장 큰 이유도 추세를 Anthropic 모델로 한정했다는 점과 최근 내부 모델을 넣었다는 점이라고 설명합니다.
한 번의 도약인가, 기울기 변화인가
Anthropic의 이전 시스템 카드와 8월 위험 보고서는 Mythos Preview에서 능력이 한 번 뛰어오른 뒤 원래 추세로 돌아갔다는 가설을 제시했습니다. METR는 Mythos 5까지의 데이터로만 두 가설을 적합한 뒤, 그 이후의 내부 모델을 얼마나 잘 맞히는지 비교했습니다.
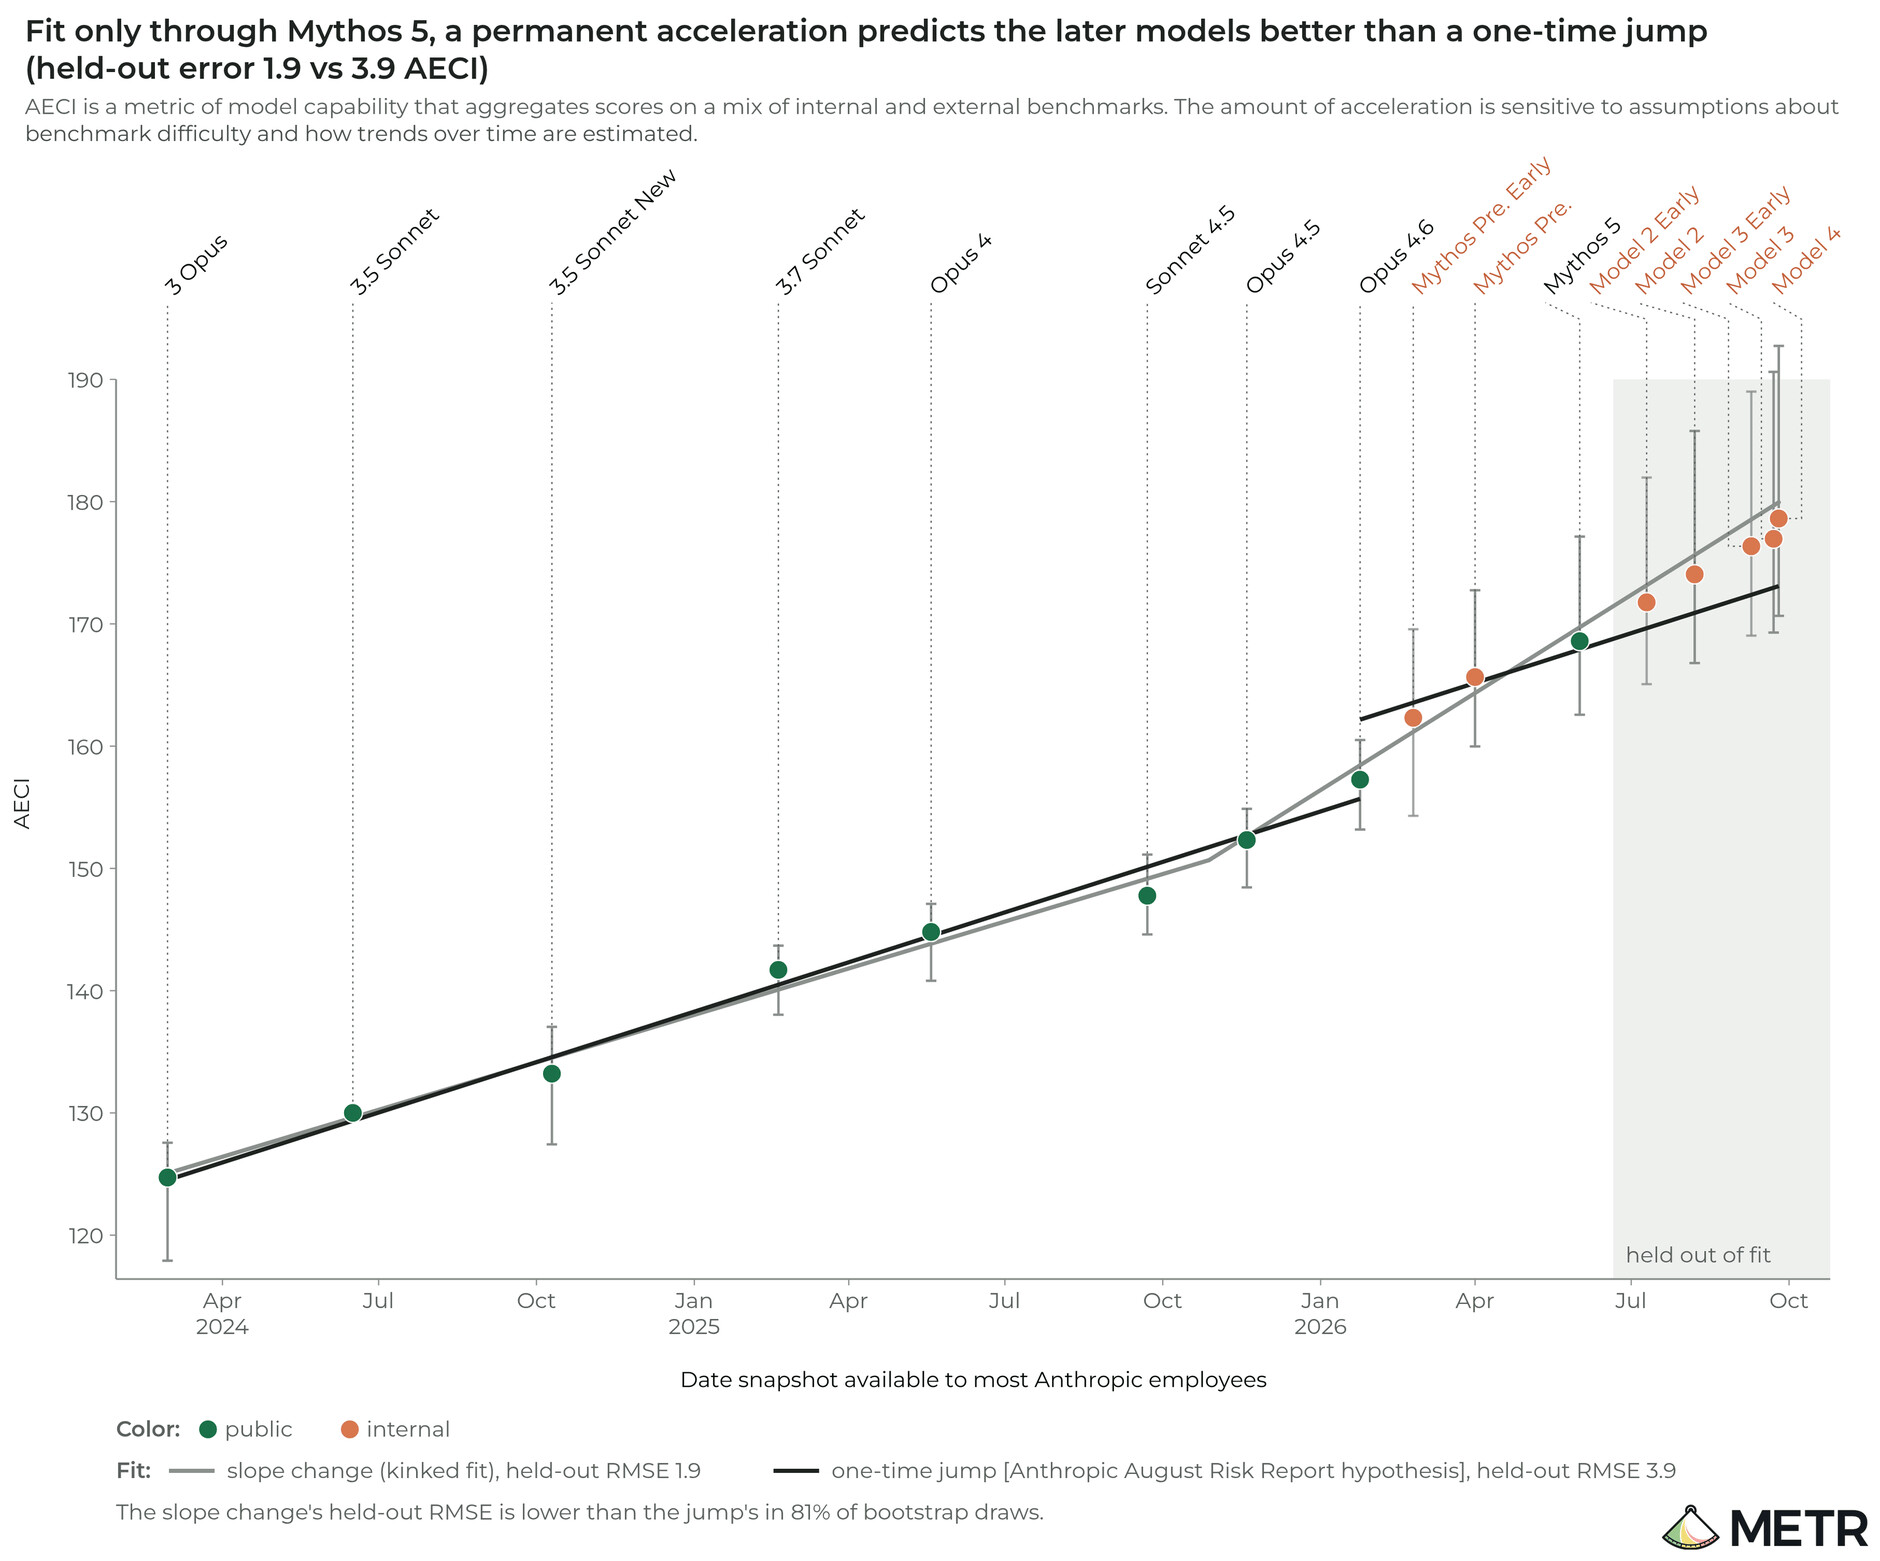
기울기가 바뀌었다는 모형의 표본 외 오차(RMSE)는 1.9점, 한 번 뛰어올랐다는 모형은 3.9점이었고, 부트스트랩 표본의 81%에서 기울기 변화 모형이 더 나았습니다. METR는 최근 모델 때문에 일회성 도약 가설의 설득력이 떨어졌다고 봅니다.
포화된 벤치마크와 토큰 예산
AECI 자체의 한계도 보고서에 정리되어 있습니다. Model 4는 자신이 평가받은 15개 AECI 벤치마크 모두에서 50%를 넘었습니다. 9개월 전 Opus 4.6은 50% 미만인 벤치마크가 많았습니다. METR는 Model 4에게 어려운 벤치마크가 없다는 점 때문에 지금과 앞으로 AECI를 측정할 수 있을지 "다소 불안하다(somewhat nervous)"고 적었습니다. 15개 중 3개는 로그 오즈 공간에서 평평하거나 오목해 로지스틱 가정에 맞지 않았고, 이 3개를 빼고 다시 계산하자 Model 4의 점수는 178.6점에서 179.7점으로 1점 오르는 데 그쳤습니다.
벤치마크에 쓴 토큰이 너무 적어 최근 모델의 능력을 덜 끌어냈을 가능성도 있습니다. Anthropic 내부 벤치마크의 보통 과제 1회 시도에는 입력 약 250만, 출력 약 7.2만 토큰이, 에이전트 코딩 벤치마크에는 입력 약 1,000만, 출력 약 9.4만 토큰이 쓰였습니다. 느슨한 비교로 Epoch AI는 GPQA, AIME, SWE-bench에서 과제당 입력 약 50만, 출력 약 1만 토큰을 씁니다. METR는 토큰을 더 쓰면 모델마다 AECI가 몇 점 오를 수 있지만 모델 간 효과가 비슷해 가속 추정은 그대로일 것이라고 추측합니다. 다만 이 부분은 깊이 조사하지 않았다고 밝혔습니다.
근거 2와 3: 컴퓨트가 아니라면 무엇이 가속했나
훈련 컴퓨트 확대 속도는 원인이 아니다
METR는 가속이 훈련 컴퓨트 규모 확대가 빨라진 데서 온 것이 아니라는 설득력 있는 근거를 받았다고 적었습니다. 그 근거의 세부 내용은 가림 처리되었습니다. 전체 보고서에는 능력 향상을 컴퓨트, 데이터, 알고리즘 진척으로 나눈 분석이 있었지만, 공개본에 남은 것은 이 한 문장의 결론뿐입니다. 전체 보고서는 사전 학습 강도와 RL 강도가 각각 알고리즘, 데이터 품질, 컴퓨트의 함수이고 두 강도가 다시 능력을 정한다는 회계 틀로 근거를 정리했는데, 이 틀을 실제로 적용한 부분도 모두 가림 처리되었습니다.
직원 자기 보고: Model 4에서 평균 약 12배
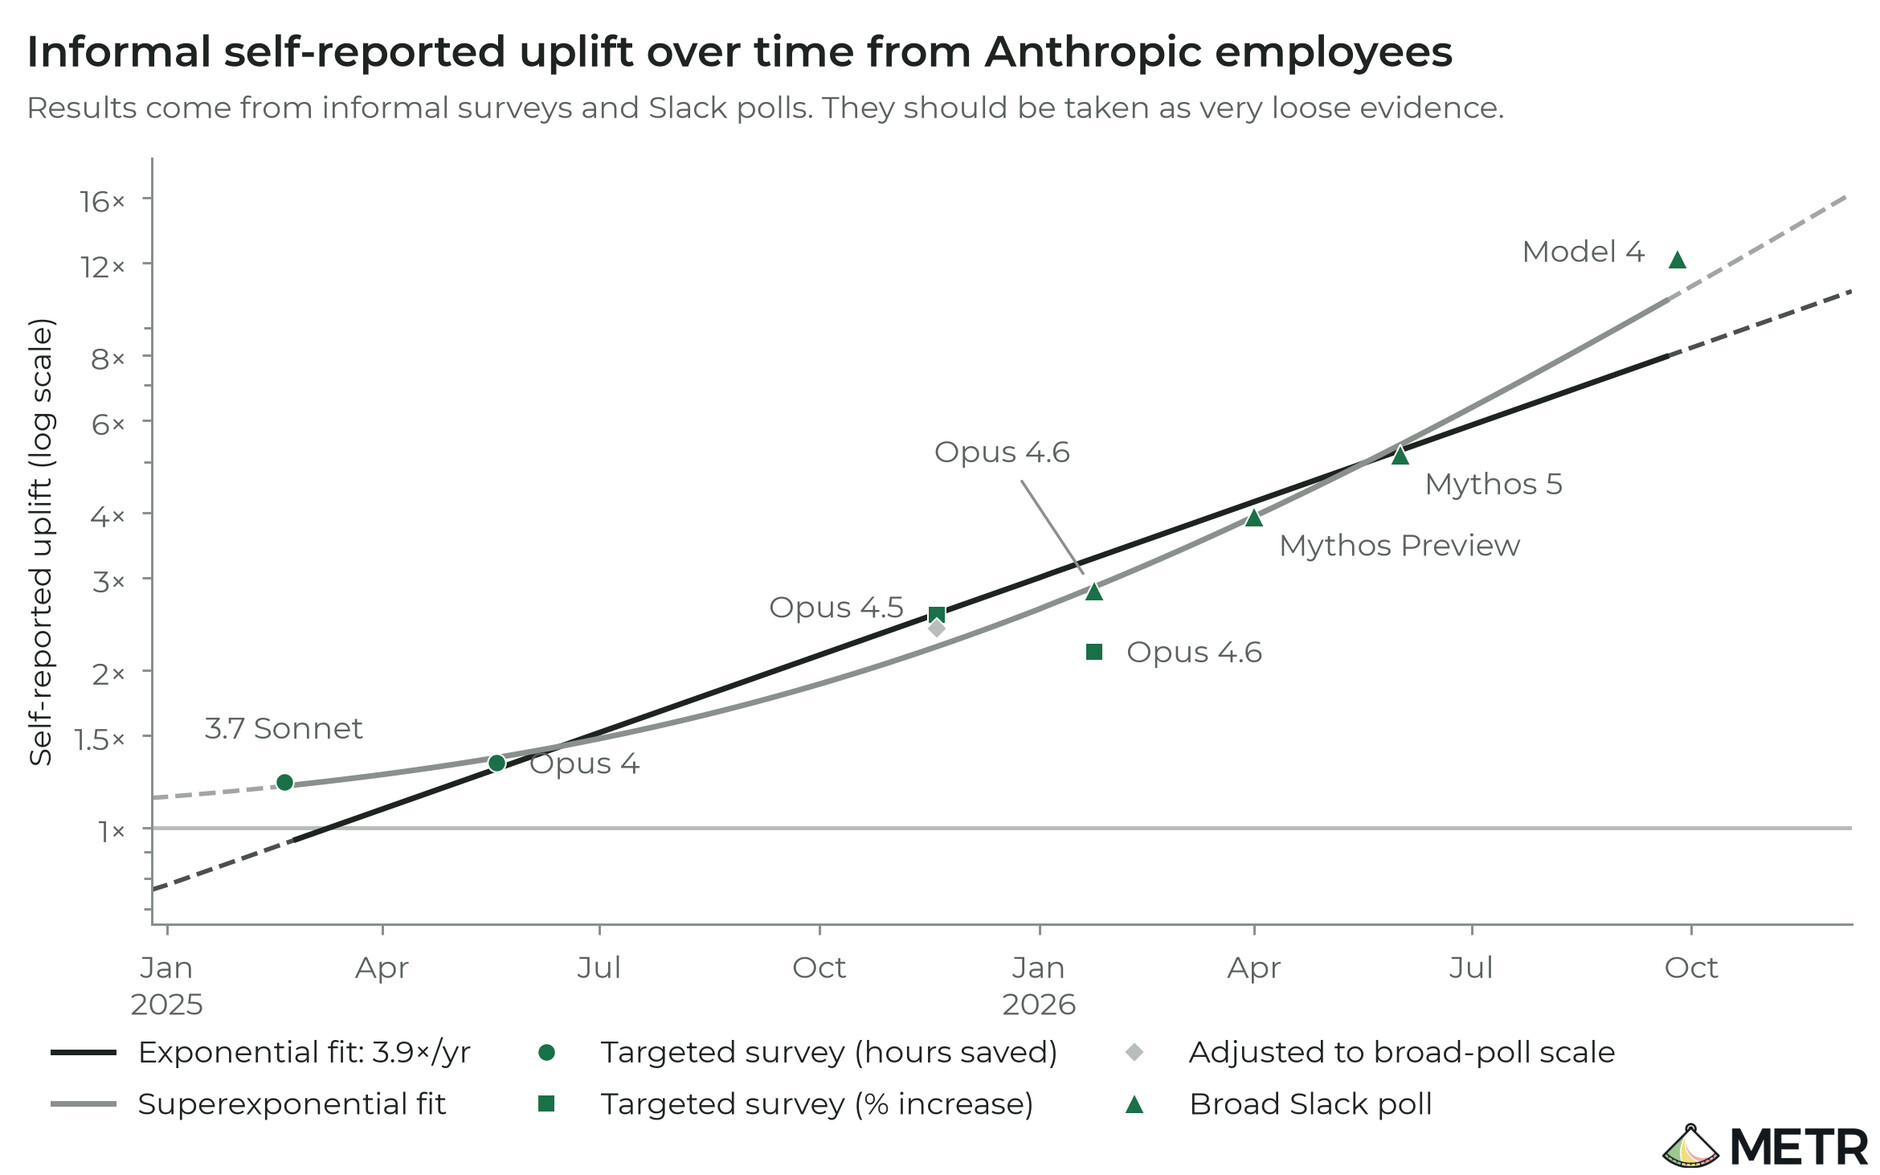
Anthropic은 AI 덕분에 일이 얼마나 빨라졌는지에 대한 직원 자기 보고 자료를 여러 출처에서 공유했습니다. 가장 최근 자료는 Slack 투표로, 직원들이 그 시점 최신 모델 덕분에 얼마나 빨라졌는지 이모지 반응으로 답한 것입니다. 2026년 10월 가장 강한 내부 모델(Model 4)에 대한 평균 자기 보고 값은 약 12배였습니다. 위 그래프에서 지수 적합은 연 3.9배 성장입니다.
METR는 이 자료를 매우 느슨한 근거로만 봅니다. 응답자가 직원 전체를 대표하지 않을 수 있고, 응답에 들인 고민이 적습니다. 자기 보고가 실제 생산성 효과를 과대평가할 수 있다는 METR의 2025년 개발자 생산성 연구 결과도 근거로 듭니다. 그럼에도 값이 꾸준히 커졌다는 점은 주목했습니다. 앞에서 정리했듯 개인 생산성 향상 배수는 가속과 같은 값이 아닙니다. 주요 영역의 가속을 설명하려면 개인 생산성 향상이 어느 속도로 커져야 하는지에 대한 METR의 상세 분석은 가림 처리되었습니다.
인터뷰: 2배 이상 가속을 약하게 지지
METR와 Anthropic은 각자 여러 연구자를 인터뷰해 AI가 자기 분야의 진척을 얼마나 빠르게 했는지 물었습니다. 답은 넓게 퍼져 있었지만 METR가 받은 인상은 2배 가속 근처였습니다. METR는 인터뷰 기록 전체를 Claude에게 주고, 사람마다 인용을 모아, 그 사람이 Claude 덕분에 자기 분야에서 2배를 넘는 가속을 지지하는지 판정하게 했습니다. 결과는 예 2명, 대체로 예 3명, 경계 또는 불분명 4명, 대체로 아니오 0명, 아니오 2명이었고, METR는 이를 2배 이상 가속을 약하게 지지하는 결과로 해석합니다. 인터뷰 대상자마다 질문을 다르게 이해했다는 점도 밝혔습니다. 누적 속도인지 순간 속도인지, 개인 기준인지 조직 기준인지가 사람마다 달랐습니다.
보고서 부록의 인용 몇 가지를 옮깁니다. 민감한 세부 내용은 원문에서도 가려져 있습니다.
"아이디어에서 실험까지 걸리는 시간이 80% 정도 줄었고, 나머지 20%는 실수가 줄고 예전에는 일회성 작업이 너무 많이 들어 재지 못하던 까다로운 것을 잴 수 있게 된 덕분이다."
"Like 80% reduction in time between idea and experiment, other 20% some mix of making fewer mistakes and being able to measure fiddly things that would've required too much one-off work before."
Researcher A (판정: 예), METR 인터뷰 기록
"내가 3배 더 생산적이지 않다고 보기는 어렵다. 박사후연구원과 대학원생이 있는 것 같은 느낌이고, 우리는 더 큰 프로젝트를 향해 일하고 있다."
"It is hard to see how I am not being 3x more productive. I feel like I have postdocs and grad students, and we are working towards a larger project."
Researcher B (판정: 예), METR 인터뷰 기록
"AI 덕분은 15~20% 정도로 추정한다. 자기 보고 생산성 증가는 믿지 않는다."
"Guesses 15-20% is due to AI. Don't believe in self-reported productivity increase."
Researcher L (판정: 아니오), METR 인터뷰 기록
또 다른 연구자(Researcher K, 판정: 아니오)는 가장 큰 이유로 채용을 꼽았습니다. 여러 연구자가 Opus 4.5, Opus 4.6, Mythos Preview를 차례로 거치며 쓸모가 크게 뛰었다고 말한 점은 판정과 관계없이 겹칩니다. 예를 들어 Researcher J는 Opus 4.5가 처음으로 자율 코드 작성에 쓸모 있었고, Mythos Preview와 에이전트 스캐폴드 조합이 처음으로 자율 실험에 쓸모 있었다고 말했습니다.
완전 자율 기여는 아직, 그러나 "초기 징후"
METR는 지금의 R&D 가속이 주로 AI의 보조에서 오고, 완전 자율 기여에서 오지는 않는다고 들었습니다. AI는 아직 모델 학습 과정의 가장 중요한 부분에서 매우 의미 있는 완전 자율 기여를 하지 못합니다. 다만 연구자들은 그런 기여가 곧 나올 수 있다는 초기 징후(signs of life) 를 설명했고, 성숙도는 영역마다 크게 달랐습니다. 이 판단은 파이프라인의 여러 부분을 자동화하는 연구자들의 인터뷰, 영역별 자동화 정도에 대한 내부 보고서, 특정 파이프라인의 과제 중 사람이 만든 것과 AI가 만든 것의 비율 분석에서 나왔고, 세부 내용은 가림 처리되었습니다.
앞으로 12개월 안의 병목은 찾지 못했다
METR는 알고리즘 진척, 훈련 컴퓨트, 실험 컴퓨트, 데이터 중 어디에서도 앞으로 12개월 안에 작동할 뚜렷한 병목의 근거를 보지 못했습니다. 다만 더 자세한 정보를 받을 때마다 병목에 대한 이해가 여러 번 바뀌었으므로 현재 평가에 확신은 없다고 적었습니다. 특정 병목들에 대한 분석은 가림 처리되었습니다.
병목과 별개로, METR는 가속 자체를 재는 내부 지표도 살폈습니다. 사전 학습과 RL의 알고리즘 효율, 컴퓨트 활용률, 추론(inference) 효율, 데이터 효율 같은 내부 지표도 살폈는데, METR는 이 지표들의 방법론 변형을 확인하는 데 몇 주를 썼고 이것이 가장 큰 불확실성의 원천이라고 밝혔습니다. 이 내부 근거는 상당한 가속을 지지했습니다. 일부는 가속이 2배를 넘고 커지고 있을 가능성도 보였지만, 해석에는 큰 불확실성이 남습니다.
Anthropic 8월 위험 보고서 리뷰: 공개본과 비공개본의 차이
METR는 같은 저자들로 Anthropic 8월 위험 보고서의 "자동화된 R&D의 위험(Risks from automated R&D)" 절에 대한 리뷰도 함께 공개했습니다. 리뷰는 평가가 시작된 직후 Anthropic의 요청으로 추가되었고, 정확한 범위는 공식화되지 않은 채 협의로 정해졌습니다. METR는 Anthropic이 8월 14일에 건넨 비공개 원본을 공개본과 비교할 수 있었습니다.
RSP v3.4는 "핵심 영역의 자동화된 R&D"에 두 가지 능력 임계선을 둡니다. 하나는 Anthropic의 연구 과학자와 연구 엔지니어 전체를 경쟁력 있는 비용(5배 이내)으로 완전히 대체할 수 있는 모델이 나오는 경우입니다. METR는 이를 완전 대체 임계선(Full Substitution Threshold) 이라고 부릅니다. 다른 하나는 AI R&D 자동화 때문에 AI 진척 속도가 극적으로 빨라지는 경우로, METR의 이름으로는 2배 가속 임계선(2x Acceleration Threshold) 입니다. RSP에 이 이름들이 있는 것은 아니고, METR가 설명을 위해 붙인 이름입니다.
완전 대체 임계선에 대해서는 METR가 Anthropic의 논리에 대체로 동의했습니다. Anthropic은 연구 인력을 모델로 바꿀 동기가 강한데도 여전히 연구자가 필요하다는 점을 근거로 들었습니다. 다만 AI R&D에 필요한 한계를 보여 줄 포화되지 않은 벤치마크가 없어서, 정렬, 도구, 감독, 능력 끌어내기 문제가 능력은 이미 있는 모델의 자동화를 막고 있을 수 있다는 걱정은 커졌다고 적었습니다.
2배 가속 임계선에 대해서는 METR가 공개본의 주장이 지나치게 확신에 차 있다고 봤습니다. METR와 Anthropic의 관련 연구자 대부분은 7월 15일 시점에 이 임계선을 넘지 않았다고 보는 쪽이지만, METR는 넘었을 가능성도 충분하다고 판단합니다. 공개본의 세 주장과 METR의 지적을 표로 정리하면 다음과 같습니다.
| 공개본의 주장 | 비공개본과 METR의 확인 | METR의 지적 |
|---|---|---|
| 선행 지표는 2025년 초중반부터 의미 있는 가속을 보이지만 "2배 미만"이다 | 비공개본의 현재 진척률과 과거 진척률을 METR가 결합해 계산하면 가속은 1.97배. METR 자체 분석은 정의와 기간에 따라 1.3~2.8배 | 독자는 "2배 미만"을 2보다 뚜렷이 낮은 값으로 읽으므로 "약 2배"가 맞는 표현 |
| 2025년의 가속은 AI가 아닌 요인 때문이라고 상당히 확신한다 | 비공개본은 AI 덕분의 가속이 2배를 넘었을 가능성도 "그럴 법하다(plausible)"고 적음 | 공개본은 AI 귀속에 대한 불확실성을 줄여서 전달함 |
| Mythos 5는 Mythos Preview와 비슷한 폭만큼 추세 위에 있어, 일회성 도약을 약하게 지지한다. Model 2는 Mythos 5보다 약 1.5점 높다 | 비공개본은 Model 2의 이후 스냅숏이 더 높을 것으로 예상한다고 적었고, 실제로 이후 스냅숏은 Mythos Preview에서 Mythos 5로 오른 만큼 올랐음. 당시 데이터로 다시 계산하면 가속 약 1.5배, 벤치마크를 추가한 뒤 같은 모델 집합으로는 1.9배 | 일회성 도약과 지속 가속을 당시 데이터로 구분할 수 없었고, 선행 지표를 함께 보면 지속 가속이 더 간명함 |
METR는 각 주장마다 자신들이 선호하는 대체 문구도 제시했습니다. 첫 번째 주장에 대해서는 "선행 지표는 정의와 기간에 따라 1.3에서 2.8 사이의 상당한 가속을 보인다. 이 선행 지표가 최종 능력과 어떻게 이어지는지는 불확실하다"를 제안했습니다.
그럼에도 METR는 7월 15일 시점의 모델이 자동화된 R&D를 통해 직접 재앙적 위험을 일으킬 가능성은 낮았다는 Anthropic의 결론에는 동의했습니다. 2배 수준의 반사실 가속이 있었다 해도 Anthropic이 우려 시나리오로 든 재앙적 위험에는 그보다 훨씬 큰 가속이 필요할 가능성이 높고, 당시 모델이 AI R&D를 완전히 자동화할 수도 없었다고 봤기 때문입니다. 다만 앞으로 6개월 안에 능력 향상 속도가 상당히 더 빨라질 가능성을 배제할 수 없고, 그러면 이 영역의 위험이 빠르게 "높음"으로 바뀔 수 있다고 덧붙였습니다.
무엇이 가려졌고, 평가는 얼마나 독립적이었나
공유된 근거와 공개된 근거
보고서 맨 위에는 METR가 계약상 단독으로 붙일 수 있는 "가림 처리 요약(Redaction summary)"이 있습니다. METR는 최상위 위험 결론은 자유롭게 공개할 수 있었지만, 그 결론에 가장 유용했던 근거의 대부분을 Anthropic이 가렸다고 밝혔습니다. Anthropic은 가림 처리의 목적을 "다른 AI 개발사를 가속할 수 있는 기밀 정보를 빼는 것"이라고 설명했고, METR는 실제로 가려진 정보가 그 범위에 머물렀고, 그 대부분은 매우 상위 수준의 정보였다고 적었습니다. 다만 회사의 사업상 이익과 대중이 위험을 이해할 이익을 비교하는 일은 자신들이 판단할 위치에 있지 않다며, 가림 처리가 정당했는지는 평가하지 않았습니다.
| 정보 유형 | METR에 공유 | 공개 보고서에 결과 서술 |
|---|---|---|
| 내부 모델 능력: 벤치마크 점수 | 예 | 예 |
| 내부 모델 능력: 핵심 중간 지표 | 예 | 아니오 |
| 알고리즘 진척 추정 | 예 | 아니오 |
| AI 기여의 근거 | 예 | 일부 |
| 핵심 R&D 투입 측정 | 대부분 | 아니오 |
| 병목과 예측의 세부 | 일부 | 아니오 |
| 직원 인터뷰 | 예 | 일부 |
이 밖에도 학습 파이프라인 주요 영역별 가속과 AI 귀속의 상세 추정, 컴퓨트, 데이터, 알고리즘별 진척 분해, 미래 모델 지표 예측이 공개되지 못했습니다. 일정을 보면 Anthropic은 10월 25일 가림 처리 지침을 줬고, 10월 27~29일 지침을 더 엄격하게 바꿨습니다. 두 기관은 새 지침에 맞추려고 마감을 약 5일 미뤘고, METR는 11월 3일 최종 공개본을 제출했습니다.
중간에 빠진 컴퓨트 배분 검증
계약 범위에는 원래 Anthropic의 컴퓨트 배분, 특히 능력 연구와 안전 연구 사이의 배분을 검증하는 일이 들어 있었습니다. Anthropic은 프로젝트 중간에 이 부분을 범위에서 빼고 AI R&D 가속에만 집중하도록 바꿨습니다. METR가 컴퓨트 사용에 대해 실질적인 결론을 내리기 전에 취소되었고, Anthropic은 당분간 위험 평가에 집중하려는 것이며 컴퓨트 배분 검증은 나중에 다시 다루겠다고 밝혔습니다.
이 지점은 Anthropic이 9월에 공개한 측정 제안과 함께 보면 의미가 분명해집니다. Anthropic은 Measurements for understanding the pace of AI development inside frontier labs에서 2026년 7월 한 주 동안 AI R&D 컴퓨트 중 안전 연구 몫이 6%였다고 공개했습니다. 같은 글에서 Anthropic은 개발사가 범주 정의를 함께 공개하고 분류를 독립 제3자가 확인하게 하는 방식으로 이 값을 보고할 수 있다고 제안했습니다. METR의 이번 평가에서는 바로 그 제3자 확인에 해당하는 부분이 빠진 셈입니다.
이해 상충, Claude 의존, 비공식 압력
METR는 자기 보고서의 약점도 부록에 적었습니다.
- 이해 상충: 프로젝트 시작 시점에 참여 팀원 한 명이 Anthropic과 입사를 논의하고 있었고, 제안을 받았지만 거절했습니다. 이 팀원은 전 직장인 경쟁사의 지분도 갖고 있었습니다. METR는 당시 정책(v1.0)에 따라 이해 상충이 없는 팀원이 그 사람의 작업을 모두 검토하고 정확성을 책임지게 했습니다. 10월 9일 이후 시작하는 위험 평가에 적용하는 새 정책이라면 이 경우 해당 팀원은 빠져야 합니다. 프로젝트 참여자 중 Anthropic 지분 보유자는 없었습니다.
- 소수 직원에 대한 의존: 대부분의 데이터는 Anthropic 기술직원 두 명을 통해 받았습니다. METR는 다른 직원 약 15명을 인터뷰했고, 상당수를 METR가 직접 골랐으며, 두 창구의 설명과 인터뷰 내용 사이에서 불일치를 보지 못했다고 밝혔습니다.
- Claude에 대한 의존: 받은 데이터 수집과 분석의 대부분, 받은 문서의 상당 부분, METR 자체 분석의 대부분에 Claude가 깊이 관여했습니다. 원리상 Claude가 데이터 인식을 왜곡할 수 있지만, 사람 인터뷰와 대조해도 체계적 편향으로 볼 불일치는 찾지 못했다고 적었습니다.
- 비공식 압력: 이런 평가는 자발적이므로, METR는 Anthropic을 지나치게 비판하면 이 회사나 다른 회사가 앞으로 협력을 꺼릴 수 있다는 점을 고려했다고 밝혔습니다. 리뷰 초안에는 Anthropic이 소통의 명확성과 악의적 오독 여지를 줄이는 방향의 강한 피드백을 줬습니다. METR는 일부가 "지나치게 강압적(overly forceful)"이었다고 느꼈지만, 최종 결과가 크게 왜곡되지는 않았다고 판단했습니다.
보고서 끝에는 AI Evaluator Forum(AEF)의 AEF-1 최소 운영 조건 체크리스트도 실려 있습니다. "독립 검토가 가능할 만큼 방법론 세부를 공유했는가"(4.1), "시스템 제공자에게 우려스러운 결과를 감출 가림 처리 권한이 없었는가"(4.6), "책임 있는 공개 정책을 수립했는가"(5.4)에는 METR가 직접 "아니오"라고 적었습니다. 미공개 모델에 대한 쿼리 접근(1.1.1)도 이번 평가에는 핵심이 아니라고 보고 요청하지 않았습니다. METR는 전반적으로 Anthropic이 일부러 오도하려 했을 가능성은 극히 낮다고 보면서도, 더 깊은 접근이 있으면 그런 위험을 더 줄일 수 있다고 적었습니다.
METR가 스스로 밝힌 과소 추정과 과대 추정 가능성
METR는 이번 평가의 구조적 한계로 접근 범위를 먼저 듭니다. 직원 수준 접근이 있었다면 문서를 바로 읽고, 내부 토론을 보고, 더 다양한 사람과 자주 대화할 수 있었을 것입니다. METR는 관련 정보 대부분에 접근했다고 보지만, 존재를 몰라 요청하지 못한 정보는 놓쳤을 수 있다고 밝혔습니다. 실제로 평가 도중 핵심 데이터의 해석이 여러 번 뒤집혔고, METR는 맥락이 부족해 잘못 해석한 부분이 아직 남아 있을 가능성이 높다고 적었습니다. 그 위에서 METR가 꼽은 과소 추정과 과대 추정의 가능성은 다음과 같습니다.
| 가속을 과소 추정했을 가능성 | 가속을 과대 추정했을 가능성 |
|---|---|
| 성장률 자체가 계속 빨라지는 쌍곡선(hyperbolic) 성장이라면 현재 가속과 가까운 미래의 가속을 크게 낮춰 잡았을 수 있습니다. AECI에는 뚜렷한 신호가 없지만 가림 처리된 다른 근거가 이를 더 그럴듯하게 만듭니다. 모델 결과는 훈련이 끝난 뒤에야 관측되므로 훈련 기간만큼 늦게 보이기도 합니다. | AI가 아닌 요인이 최근 가속의 전부나 대부분을 설명할 수 있습니다. 그렇다면 앞으로의 고성장과 추가 가속을 예상할 이유도 줄어듭니다. |
| 자동화가 생각보다 가까울 수 있습니다. 사람이라는 병목이 빠지면 가속이 매우 빨라질 수 있습니다. | 가속이 자동 채점이 쉬운 잘 정의된 과제에 한정될 수 있습니다. 최근 진척이 AECI에 들어간 유형의 과제에 과적합되었을 수도 있습니다. |
| AECI가 실제 영향을 낮게 반영할 수 있습니다. 수학 분야 ECI는 크게 가속하지 않았지만 수십 년 동안 풀리지 않던 밀레니엄 상 문제(Millennium Prize Problems)가 풀리고 있다는 것이 METR의 예시입니다. | 과거 성장률이 일시적 요인으로 유난히 낮았다면 가속을 과대 추정했을 수 있습니다. Anthropic 모델의 2025년 말 이전 AECI 성장률은 업계 프런티어보다 낮았습니다. |
이 보고서에서 확인된 것과 확인되지 않은 것
정리하면 공개본으로 바깥에서 확인할 수 있는 정량 근거는 AECI 분석과 그 강건성 점검, 직원 자기 보고 그래프, 인터뷰 인용 정도입니다. 그마저도 앞에서 본 것처럼 분석 가정과 비교 대상에 따라 값이 크게 달라지고, 지표 자체도 포화되어 가고 있습니다. METR가 약 2배 판단을 더 진지하게 받아들이게 한 근거는 가림 처리되었고, 핵심 중간 지표, 알고리즘 진척 추정, 투입 측정, 병목 분석도 공개되지 않았습니다. METR 스스로 이 보고서가 "근거에 대한 투명성"을 달성하지 못했다고 적은 이유입니다.
반면 이 보고서가 남긴 것도 분명합니다. 외부 평가자가 비공개 내부 모델까지 넣어 가속을 추정한 수치, 회사의 공개 위험 보고서와 비공개 원본의 문구 차이, 가림 처리와 범위 축소와 이해 상충이 각각 어떤 내용이었는지가 기록으로 남았습니다. 숫자만 보면 "AI가 AI 개발을 2배 빠르게 한다"로 줄이기 쉽습니다. 그러나 보고서의 실제 주장은 잘 정의된 과제에서 측정된 능력 향상 속도가 약 2배이고, 그 가속의 대부분이 AI 덕분이라는 추측입니다.
 METR의 Anthropic AI R&D 가속 독립 평가 보고서
METR의 Anthropic 8월 위험 보고서 AI R&D 절 리뷰
METR의 AI R&D 가속 평가 방법 제안 글
 METR의 보고서 발표 X 스레드
https://x.com/METR_Evals/status/2118412183860351084
더 읽어보기
-
Anthropic, 내부의 AI 개발 속도를 측정하는 3가지 지표 공개: Claude가 AI R&D의 26%를 주도
-
Anthropic 사내 고용 변화: 주니어 기술직 채용 27%에서 9%로, 에이전트 작업은 사람의 6배 [영문/PDF/20p]
-
OpenAI, 자동화 연구 인턴 목표 달성 발표와 함께 공개한 사내 측정치: 에이전트 노동이 사람의 3.1배
-
긴 작업(Long Task)을 수행하는 인공지능(AI)의 능력 측정에 대한 연구 소개 (feat. METR)
-
OpenAI의 내부 모델 평가 중 Hugging Face를 해킹한 사건에 대한 조사 보고서 3편 정리: OpenAI, Hugging Face, METR 등
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
