핵심 요약
- Mistral은 Le Chonk 가중치 공개 블로그에서 10월 6일 API 프리뷰로 먼저 내놓았던 Mistral Large 4의 가중치를 10월 29일 공개했습니다. 프리뷰 이후 3주 동안 강화학습을 더 돌린 체크포인트입니다.
- Hugging Face 모델 카드 기준으로 총 약 1조 개 매개변수 중 토큰당 490억 개를 쓰는 MoE 모델입니다. 1M 토큰 컨텍스트와 이미지 입력을 지원하고, 기본 FP8 체크포인트만 약 1.06TB입니다.
- Artificial Analysis 코딩 에이전트 지수(Coding Agent Index)에서 48점으로 GLM-5.3(49점)과 비슷한 점수를 내면서 작업당 토큰은 약 47% 적게 썼습니다. 반면 같은 기관의 사이버 지수(Cyber Index)에서는 51%로, Mistral 블로그 차트에 나온 7개 모델 중 DeepSeek-V4.1-Flash(57%)와 MiMo-V2.6-Pro(56%)에 이은 3위입니다. 종합 지능 지수(Intelligence Index v5)도 26점으로 중국 상위 모델들(30~32점)보다 낮습니다.
- 라이선스는 MIT를 고친 Mistral Ecosystem Open-Weight License입니다. 사내 사용과 제품 내장은 자유롭습니다. 다만 제3자가 입력과 매개변수를 제어하며 추론이나 사후 학습에 쓰도록 모델을 제공하는 MaaS(Model-as-a-Service) 사업자는, 상업적으로 쓰기 전에 별도 계약이 필요합니다.

Mistral Large 4 소개
Mistral Large 4는 프랑스 Mistral AI가 유럽에 있는 자체 데이터센터의 NVIDIA Grace Blackwell GPU 3,800장으로 처음부터 학습한 1조 개 매개변수 규모의 멀티모달 모델입니다. Mistral이 공식 별명으로 붙인 이름은 Le Chonk 입니다. 텍스트와 이미지를 입력으로 받아 텍스트를 내놓고, 지시 따르기와 추론, 코딩, 에이전트 작업을 한 벌의 가중치로 처리합니다. 모델 카드는 시각적 그라운딩(Visual Grounding)에서 상용 프론티어 모델도 앞선다고 쓰지만, 프리뷰 발표가 예로 든 수치는 Dense 200에서 GPT-6 Astra 41% 대비 42%로 1%p 차이입니다.
이 모델은 두 번에 나뉘어 나왔습니다. Mistral은 10월 6일 Introducing Mistral Large 4 발표에서 API 프리뷰를 열면서 가중치를 이달 말까지 공개하겠다고 약속했습니다. 그 사이에는 사이버 보안 업체, 정부 기관과 함께 실제 환경에서 레드팀 평가를 했다고 밝혔습니다. 그리고 10월 29일, 프리뷰 이후 강화학습(Reinforcement Learning)을 3주 더 진행한 체크포인트의 가중치를 Hugging Face에 올렸습니다. 그래서 같은 이름의 모델이라도 프리뷰 발표의 수치와 이번 공개 글의 수치가 다르고, 일부는 측정 주체도 다릅니다. 이 차이는 아래에서 따로 정리합니다.
대형 오픈 웨이트 모델 경쟁은 그동안 중국 회사들이 이끌었습니다. 7월에는 Moonshot AI가 Kimi K3를, 9월에는 Xiaomi가 MiMo-V2.6을 공개했습니다. 10월에는 미국 쪽에서 Meta의 Muse Spark Open이 공개됐고, Reflection AI는 Beam을 발표했습니다. Muse Spark Open 발표 당시 Meta의 비교표에는 Mistral Large 4가 있었지만, 가중치를 받을 수 없어 자체 보고값과, 있는 경우 Artificial Analysis 결과를 썼다고 밝혔습니다. 이제는 누구나 직접 평가할 수 있습니다.
이 글은 Mistral의 공개 블로그와 프리뷰 발표, Hugging Face 모델 카드, Hugging Face 블로그, 체크포인트의 config.json 과 라이선스 파일을 대조해 정리합니다. 벤치마크와 속도 수치는 Mistral, Hugging Face, 또는 이들이 인용한 외부 평가 기관의 값이며, 직접 실행해 확인한 값은 아닙니다. Mistral은 전체 기술 보고서를 곧 공개하겠다고 밝혔습니다.
모델 구조: 1조 개 중 490억 개만 쓰는 MoE와 두 종류의 희소성
Mistral Large 4의 텍스트 디코더는 전문가 혼합(Mixture-of-Experts, MoE) 구조입니다. 토큰마다 라우터가 일부 전문가 네트워크만 골라 계산하므로, 전체 매개변수는 약 1조 개지만 토큰 하나를 처리할 때 쓰는 매개변수는 490억 개입니다. Hugging Face 블로그는 이 모델이 희소성을 두 군데에서 쓴다고 설명합니다. 하나는 피드포워드 층에서 전문가를 고르는 것이고, 다른 하나는 어텐션에서 이전 토큰 위치 중 일부만 고르는 것입니다.
| 항목 | 값 |
|---|---|
| 디코더 층 수 | 72개 (첫 층은 밀집 FFN, 나머지 71개는 MoE) |
| 은닉 차원 / 어텐션 헤드 | 6,144 / 64 |
| 전문가 구성 | 라우팅 전문가 128개 중 토큰당 4개 + 항상 켜지는 공유 전문가 1개 |
| 어텐션 | MLA(Multi-head Latent Attention, KV 압축 차원 512) + DSA 인덱서(질의당 최대 2,048개 위치 선택) |
| 위치 인코딩 | 3개 층은 RoPE(YaRN 확장), 4번째 층마다 NoPE |
| 컨텍스트 | 1,048,576 토큰 |
| 어휘 크기 | 204,800 |
| 비전 인코더 | Pixtral 계열 16억 개 매개변수, 30층, 14×14 패치 |
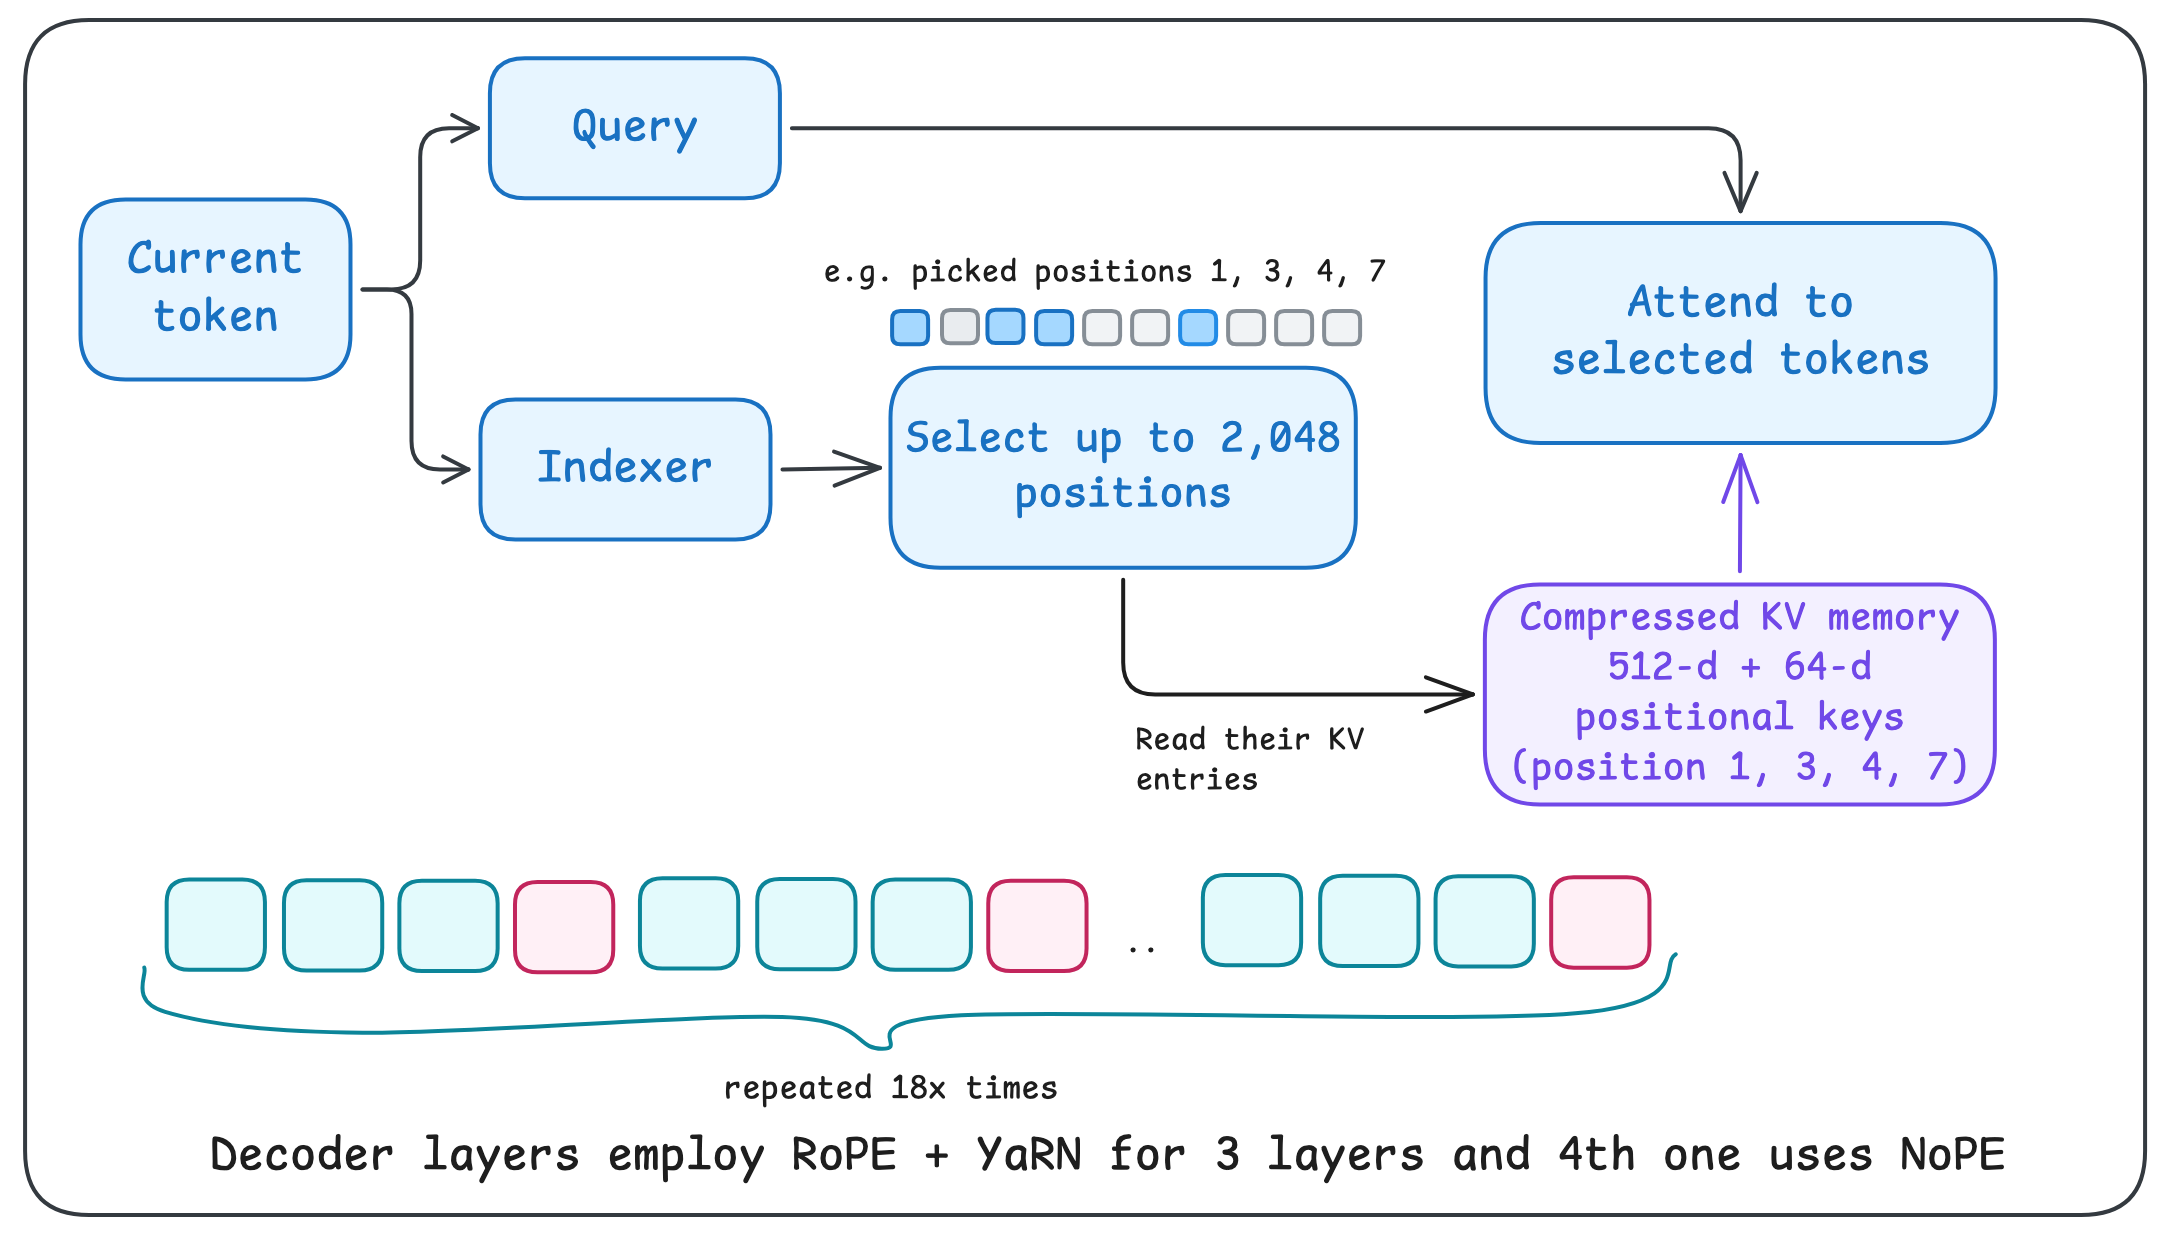
MLA(Multi-head Latent Attention) 는 키와 값을 작은 잠재 벡터로 압축해 저장하므로 KV 캐시가 줄어듭니다. 여기에 DeepSeek 희소 어텐션(DeepSeek Sparse Attention, DSA) 방식의 인덱서가 붙어, 질의마다 전체 문맥이 아니라 최대 2,048개 위치만 골라 어텐션을 계산합니다. Hugging Face 블로그는 이 인덱서를 GLM 5.3 같은 다른 모델에서도 보이는 방향으로 소개하고, 층 사이에서 KV 상태도 공유한다고 적었습니다. 체크포인트의 config.json 을 보면 39번 층부터 4층마다, 모두 9개 층이 35번 층의 KV를 다시 씁니다(0부터 센 번호). 위치 인코딩으로는 학습된 주파수별 배율을 더한 YaRN 방식의 RoPE를 쓰며, Mistral은 이를 LeRope 라고 부릅니다.
체크포인트에 들어 있는 DSpark 초안 헤드
체크포인트에는 추측 디코딩(Speculative Decoding) 용 DSpark 초안 헤드가 함께 들어 있습니다. BF16으로 된 밀집 MLA 층 3개가 순환 마르코프 헤드로 토큰 3개짜리 블록을 제안하고, 본 모델이 이를 검증합니다. 출력은 본 모델 단독 실행과 같고, Mistral은 처리량이 최대 1.9배 올랐다고 밝혔습니다. 실제 이득은 하드웨어와 워크로드에 따라 다릅니다. vLLM에서는 --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}', SGLang에서는 --speculative-algorithm DSPARK 로 켭니다.

 DSpark 초안 모델을 붙인 다른 사례는 다음 글(LFM2.5-VL-3B-DSpark)을 참고해주세요:
추론 강도 세 단계
추론(reasoning) 강도는 요청마다 reasoning_effort 로 low, medium, high 중 하나를 고르며 기본값은 high 입니다. Mistral은 low 가 기존의 None 모드를 대신한다고 설명합니다. Hugging Face 블로그도 추론을 끌 수 없고, Transformers 구현에서 none 을 넣으면 high 로 동작한다고 적었습니다. 따라서 빠른 응답이 필요하면 none 대신 low 를 명시해야 합니다. 권장 샘플링 값은 세 단계 모두 temperature=1.0, top_p=0.95 이고, max_completion_tokens 에는 추론 토큰도 포함됩니다.
프리뷰에서 정식 공개까지: 바뀐 수치와 측정 주체
Mistral은 프리뷰 이후 3주간의 추가 강화학습으로 코딩과 방어적 사이버 보안 능력이 크게 올랐고, 아직 성능이 포화되는 신호는 없다고 밝혔습니다. 같은 벤치마크의 두 시점 값을 나란히 놓으면 다음과 같습니다:
| 벤치마크 | 프리뷰 (10월 6일) | 공개 체크포인트 (10월 29일) | 비고 |
|---|---|---|---|
| Terminal-Bench 4.0 | 28.3% (자체 보고) | 41.4% (Artificial Analysis) | 측정 주체가 다름, 출력 토큰 30% 감소 |
| Coding Agent Index | 49.8% (측정 주체 미기재) | 48% (high, Artificial Analysis) |
직접 비교 어려움 |
| Finch (FinWorkBench) | 67.4% | 73.3% | |
| B3 공격 저항률 | 93.3% | 97.1% | |
| 사이버 악성 요청 거절률 | 95.3% | 96.6% |
공개 블로그는 Terminal-Bench 4.0이 "13%p 올라 41%" 가 됐다고 썼습니다. 하지만 공개 블로그의 차트 범례를 보면 프리뷰 값 28%는 "self reported" 이고 41.4%는 Artificial Analysis 측정값입니다. 측정 주체가 다른 두 값의 차이라서, 13%p 전체를 학습 개선으로 단정할 수는 없습니다. Coding Agent Index도 프리뷰 발표값 49.8%는 측정 주체가 밝혀져 있지 않아, 공개 체크포인트의 Artificial Analysis 값 48%와 직접 비교하기 어렵습니다. Hugging Face 블로그의 벤치마크 절에도 프리뷰 수치(49.8%, 28.3%, B3 93.3%)가 그대로 남아 있으니, 인용할 때는 어느 시점의 값인지 확인해야 합니다.
코딩 에이전트 성능: 토큰 효율과 1위가 아닌 항목
공개 블로그가 가장 앞세운 결과는 토큰 효율입니다. Artificial Analysis의 코딩 에이전트 지수에서 Mistral Large 4(high)는 48점을 받았고 작업당 평균 850만 토큰을 썼습니다. 오픈 웨이트 1위인 GLM-5.3은 49점에 1,590만 토큰, DeepSeek V4.1 Flash 1017은 46점에 1,670만 토큰입니다. GLM-5.3 대비 토큰 사용량은 약 47% 적습니다. medium 으로 낮추면 580만 토큰에 35점입니다.
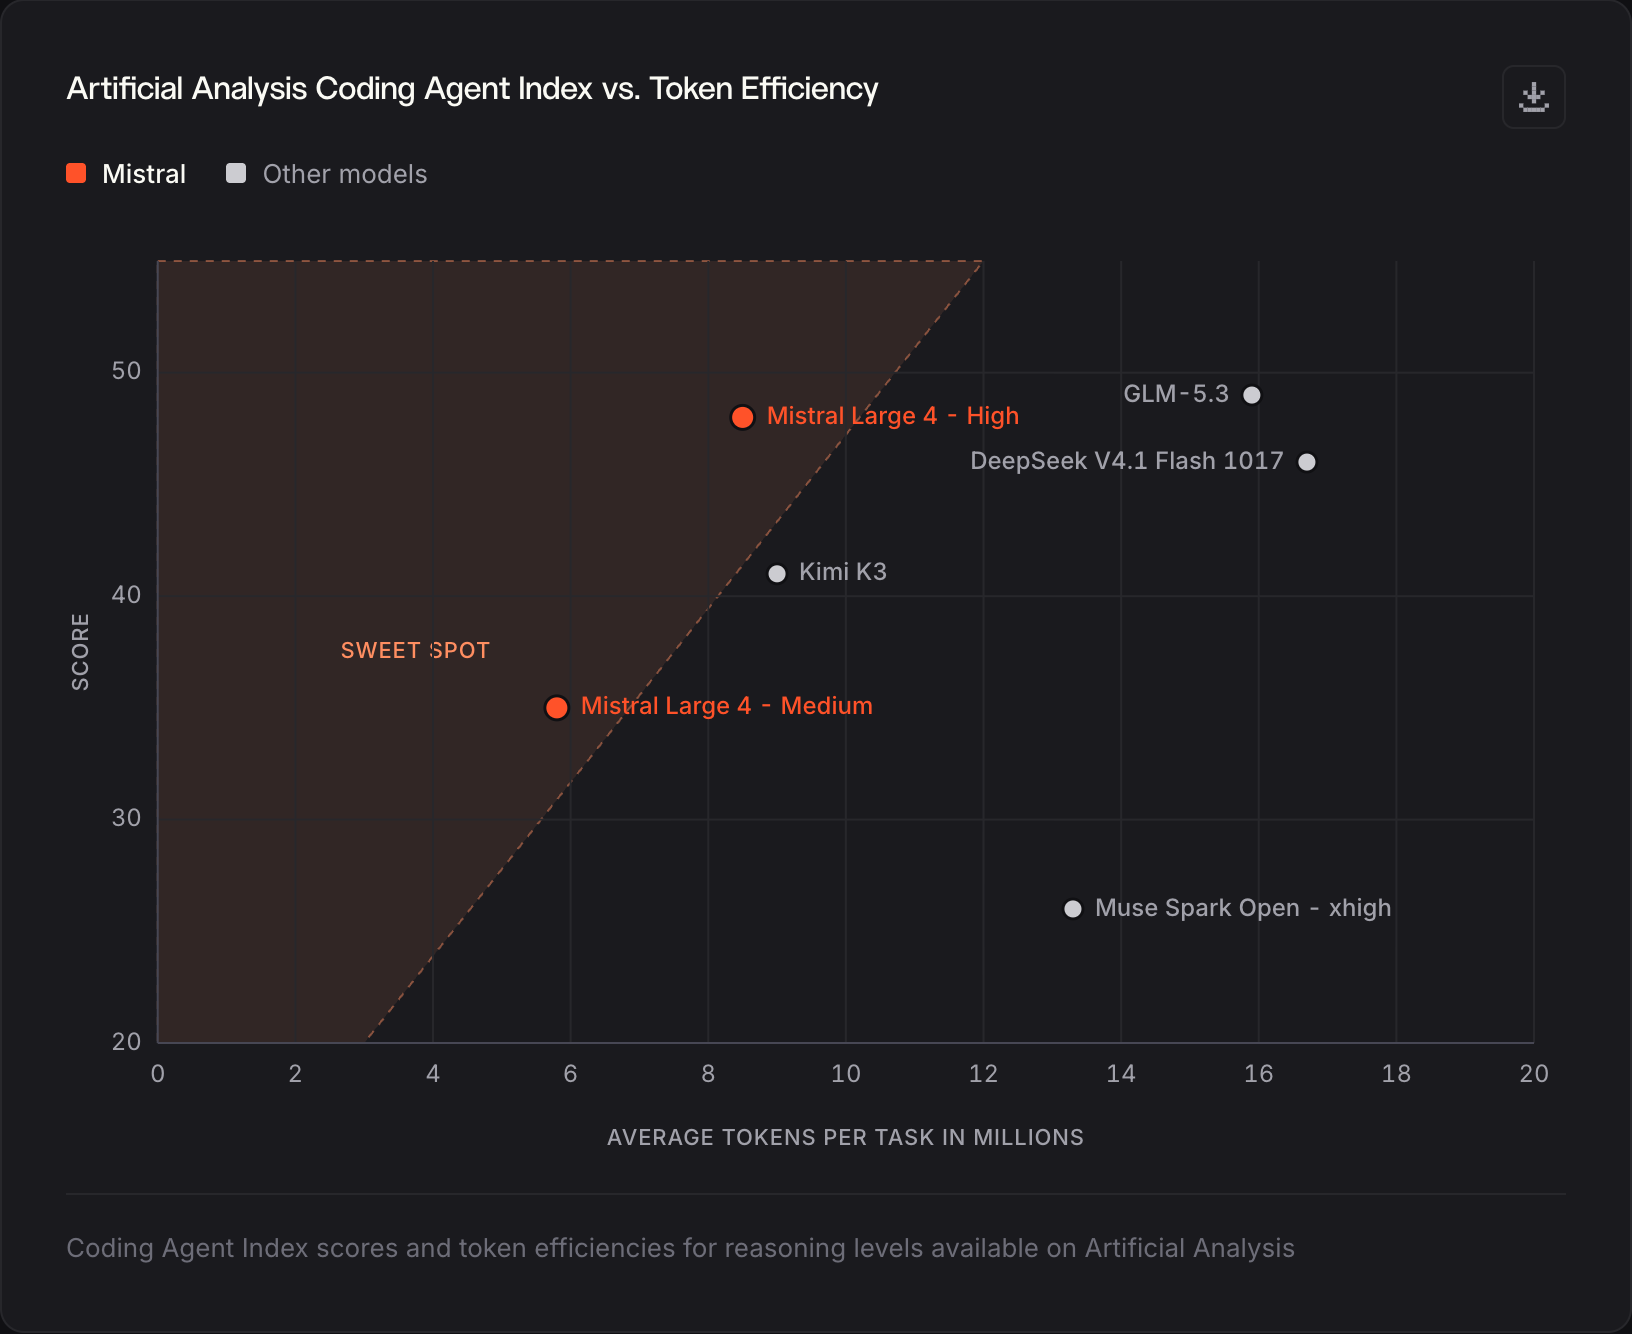
작업당 토큰이 절반 가까이 줄면, API 단가가 같아도 한 작업의 비용과 대기 시간이 함께 줄어듭니다. 다만 점수만 보면 Mistral Large 4는 이 지수의 1위가 아니라 GLM-5.3과 사실상 동률이며, Mistral도 이를 동률로 표현했습니다.
Artificial Analysis의 코딩 에이전트 벤치마크가 모델과 하네스 조합을 어떻게 평가하는지는 다음 글을 참고해주세요:
나머지 코딩 결과는 다음과 같습니다. Mistral이 오픈 웨이트 코딩 1위의 근거로 든 수치들이지만, 차이가 작은 항목이 섞여 있습니다:
| 평가 | Mistral Large 4 | 비교 모델 | 비고 |
|---|---|---|---|
| FrontierCode 2.0 (Cognition 비공개) | 19.7% | DeepSeek V4.1 Flash 19.3%, GLM-5.3 17.8%, Kimi K3 17.3% | 저장소 관리자가 병합할 만한 변경인지까지 평가, 0.4%p 차 1위 |
| Terminal-Bench 4.0 (Artificial Analysis) | 41.4% | GLM-5.3 40%, DeepSeek V4.1 Flash 1017 31%, Kimi K3 21% | 1.4%p 차 1위 |
| Surge 블라인드 쌍대 비교 (Mistral Large 4 승률) | GLM-5.3 상대 64%, Kimi K3 상대 64%, DeepSeek V4.1 Flash 상대 56%, Claude Opus 5.5 상대 22% | 사람 평가자가 두 답 중 하나를 선택 |
Cognition의 FrontierCode 2.0은 공개되지 않은 벤치마크라 외부에서 재현할 수 없습니다. Surge AI의 사람 평가에서는 상용 모델 Claude Opus 5.5에게 22% 대 78%로 졌습니다. 오픈 웨이트 모델들과의 비교에서는 앞섰습니다.
종합 지능 지수: Hugging Face 블로그 기준 오픈 웨이트 5위
Hugging Face 모델 카드에 실린 Artificial Analysis 지능 지수(Intelligence Index v5) 그림을 보면, Mistral Large 4는 26점입니다. GLM-5.3과 DeepSeek V4.1 Flash 1017이 32점, MiMo-V2.6-Pro가 30점으로 앞서고, Muse Spark Open(25점)과 DeepSeek-V4-Pro-0813(23점)은 뒤에 있습니다. Mistral은 이를 서구권 오픈 웨이트 모델 중 최고 점수로 설명했고, Hugging Face 블로그는 10월 29일 기준 오픈 웨이트 5위라고 적었습니다. 즉 범용 지표에서는 중국 상위 모델보다 뒤에 있고, Mistral은 코딩과 사이버 보안을 강점으로 내세웁니다.
사이버 보안: 블로그 차트 7개 모델 중 3위, 거절률은 가장 높음
Mistral이 이번 모델에서 가장 크게 내세운 분야는 방어적 사이버 보안입니다. 공개 블로그는 Artificial Analysis 사이버 지수에서 51%를 받았다고 밝혔습니다. 이 지수는 코드베이스에서 취약점을 찾아 재현하는 능력을 잽니다. 그 취약점을 기존 기능을 깨지 않고 패치하는지도 함께 봅니다. 다만 같은 블로그의 차트를 보면 이 지수의 1위는 Mistral Large 4가 아닙니다.
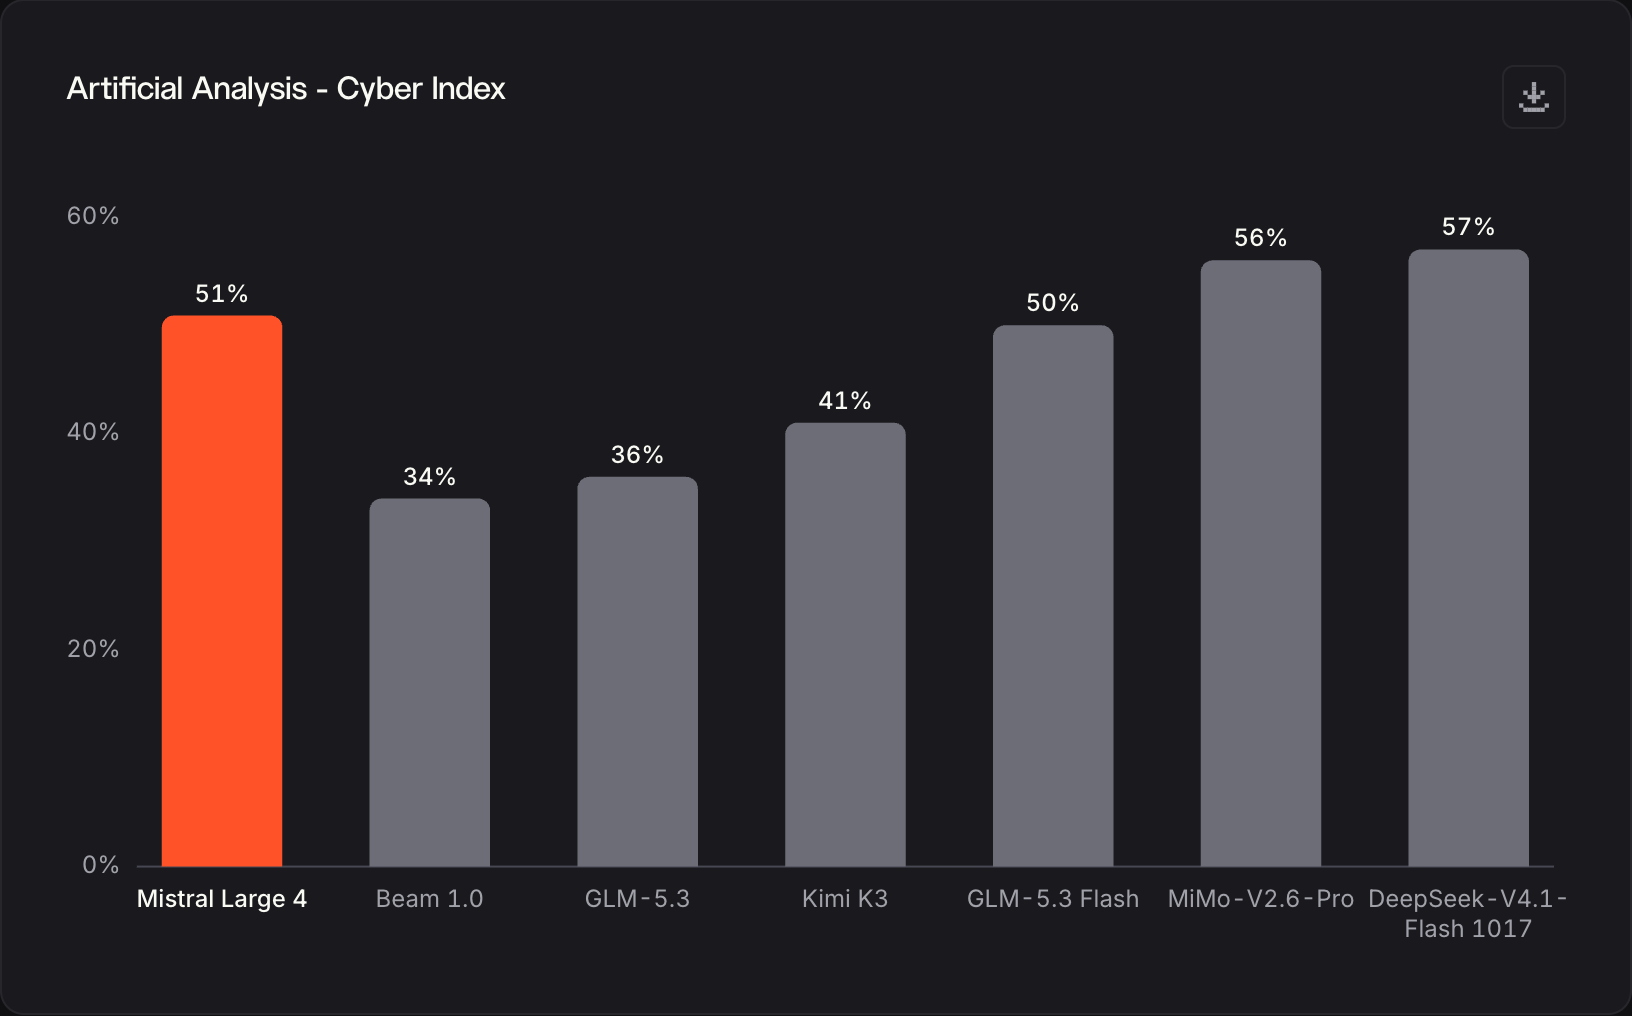
DeepSeek-V4.1-Flash 1017(57%)과 MiMo-V2.6-Pro(56%)가 앞서고, GLM-5.3 Flash(50%)가 바로 뒤에 있습니다. 그런데 공개 블로그 요약문과 모델 카드는 "방어적 보안 오픈 웨이트 벤치마크 선두", "오픈 웨이트 중 최고 수준" 이라고 씁니다. 프리뷰 발표의 표현인 "중국 밖에서 개발된 오픈 웨이트 모델 중 큰 차이로 1위" 가 차트와 맞는 설명입니다.
세부 과제에서는 강점이 확인됩니다. 프리뷰 발표에 따르면 사이버 지수 안의 한 과제에서 82%로 모든 모델 중 가장 높았습니다. 오픈소스 소프트웨어의 실제 취약점을 재현하고 패치하는 과제입니다. 보안 경진대회 문제 40개로 구성된 Cybench에서는 93%를 풀었습니다.
Mistral은 같은 과제에서 Claude Opus 5.5와 GPT-6 Astra 같은 상용 모델이 작업을 거절해 0점에 가까웠다고 설명합니다. 취약점을 고치려면 먼저 그 취약점이 실제로 동작함을 증명해야 하는데, 상용 모델의 안전 필터가 그 단계를 막는다는 주장입니다. 이 수치들은 프리뷰 시점의 값이며, 공개 블로그는 다시 싣지 않았습니다.
거절률과 가드레일 수정 예고
악성 요청 거절에서는 JailbreakBench, StrongREJECT, AgentHarm의 사이버 관련 프롬프트 평균 거절률이 96.6%로, Mistral이 비교한 오픈 모델 중 가장 높았습니다. Kimi K3가 93.6%, GLM-5.3이 87.1%, Gemma-4-31B가 84.1%, DeepSeek-V4-Pro가 50.7%입니다.
그러나 공개 블로그에는 이런 단서도 있습니다. Mistral은 프리뷰 기간에 실제 트래픽에서 사이버 보안 관련 사용을 모니터링했습니다. 실제 대상에 대한 블랙박스 공격 요청은 모델이 거절했지만, "실제 공격 수행 능력을 높여 줄 잠재력" 이 보였다고 합니다. 그래서 가드레일을 수정하고 있고 앞으로 몇 달간 계속 업데이트하겠다고 밝혔습니다. 이 수정이 이미 공개된 가중치에 어떻게 반영되는지는 원문에 설명이 없습니다. 펜테스트와 레드팀용으로 조정한 특화 변형은 Orange Cyberdefense 같은 설계 파트너에게만 심사와 계약을 거쳐 프리뷰로 제공됩니다.
같은 문제에 대한 다른 오픈 웨이트 모델의 접근도 비교해 볼 만합니다. Moonshot AI는 Kimi K3.1 Pro의 가중치를 공개하기 전에 중간 학습 데이터와 강화학습 환경에서 사이버 보안 데이터를 뺐습니다. 반면 Mistral은 사이버 능력을 앞세우고 거절 행동으로 오용을 막는 쪽을 택했습니다.
업무용 벤치마크: 금융 스프레드시트, 웹 탐색, 에이전트 보안
코딩과 보안 외의 업무 지표는 다음과 같습니다. 세 지표 모두 Mistral이 고른 비교 대상과의 결과입니다:
| 평가 | Mistral Large 4 | 비교 모델 |
|---|---|---|
| Finch (FinWorkBench), 금융, 회계 스프레드시트 작성과 편집 | 73.3% | Kimi K3 77.33%, DeepSeek-V4-Pro-0813 67.44%, GLM-5.3 65.12% |
| BrowseComp, 웹 탐색 | 84.5% (초기 SFT 체크포인트 75.0%) | Kimi K3 91.2%, DeepSeek V4.1 Flash 1017 83.4%, GLM-5.3 82.5% |
| B3 에이전트 보안 벤치마크, 공격 저항률 | 97.1% | GLM-5.3 93.3%, Kimi K3 88.1%, Gemma-4-31B 82.9%, DeepSeek-V4-Pro 58.6% |
Finch와 BrowseComp에서는 Kimi K3가 앞섭니다. B3는 Lakera가 공개한 에이전트 보안 벤치마크입니다. Mistral은 이 점수를 시스템 프롬프트 유출이나 악성 코드 주입 같은 공격에 대한 저항으로 소개하고, 이 모델을 호스팅하면 추가 조정 없이도 안전한 에이전트를 운영할 수 있다고 썼습니다. 하지만 벤치마크 점수가 개별 서비스의 프롬프트 주입 방어를 보장하지는 않으므로, 도구 권한 제한 같은 기존 방어는 그대로 필요합니다.
데모: 위성 추적 앱과 Django 취약점 패치
공개 블로그에는 세 개의 인터랙티브 데모가 있습니다. 하나는 Mistral Large 4가 사람 도움 없이 지구 궤도의 위성과 우주 쓰레기 약 1만 9천 개를 보여 주는 3D 추적 앱 Orbital Trace를 만드는 과정입니다. 데모 기록에 따르면 모델은 실제 궤도 데이터(TLE)로 18,820개 객체를 만들고, Playwright로 브라우저에서 앱을 직접 확인했습니다. 렌더링 속도를 초당 5프레임에서 33프레임으로 올린 뒤, 독립 검증기의 14개 항목 중 12개를 통과했습니다. 남은 2개를 고친 다음 14개를 모두 통과했습니다. 다음 영상은 그중 국제우주정거장(ISS)을 선택해 궤도선과 정보 카드가 제대로 뜨는지 시험하는 장면입니다:
다른 데모는 Django의 취약점(CVE-2026-1312)을 사이버 하네스 안에서 재현하고 패치하는 과정입니다. 에이전트들은 진입점 18개를 찾고, 데이터 흐름을 추적하고, 공격 시나리오를 써서 검증한 뒤 패치를 만듭니다. 패치는 order_by 에 점(.)이 들어간 정렬 문자열이 원시 SQL로 그대로 넘어가던 경로를 막습니다. 블로그는 카나리 익스플로잇이 더 이상 동작하지 않을 때까지 패치를 고쳤다고 설명하지만, 데모 기록 자체는 "직접 확인과 문법 컴파일만 했고, Django 전체 테스트나 패치된 앱에 대한 HTTP 재현은 기록되지 않았다" 고 밝힙니다. 세 번째 데모는 분자 안 전자 분포를 계산하는 양자 화학 프로그램을 처음부터 작성하고, 표준 화학 도구와 결과를 대조하는 과제입니다.
직접 실행하려면: 체크포인트 크기와 서빙 경로
가중치는 Mistral Large 4 컬렉션에서 받을 수 있습니다. 기본 저장소는 FP8 체크포인트이고, Blackwell GPU 전용 NVFP4 체크포인트가 따로 있습니다. llama.cpp 팀과 Unsloth는 GGUF 형식의 양자화(Quantization)본을, AMD는 MI350용 MXFP4 체크포인트를 올렸습니다. 각 모델 카드와 Hugging Face API로 확인한 크기는 다음과 같습니다:
| 체크포인트 | 크기 | 비고 |
|---|---|---|
| FP8 (기본) | 약 1.06TB | 비전 인코더, 출력층, 일부 어텐션 투영층은 BF16 유지 |
| NVFP4 | 약 610GB | 라우팅 전문가만 NVFP4, 어텐션과 공유 전문가는 FP8. Blackwell GPU 전용 |
| GGUF Q4_K_M (ggml-org) | 약 635GB | |
| GGUF Q2_K | 약 381GB | |
| GGUF IQ2_XXS | 약 298GB | Q2_K와 함께 통합 메모리 512GB에 들어감 |
| Unsloth GGUF UD-IQ1_S | 약 233GB | 256GB 메모리용 1비트. Unsloth 측정 원본과 1순위 토큰 일치율 90.6% |
| AMD Quark MXFP4 | 약 578GB | MI350 계열, vLLM ROCm 전용 이미지 |
Hugging Face 블로그가 밝힌 실측 예는 다음과 같습니다. 2비트 양자화본은 통합 메모리 512GB인 Apple Silicon Ultra 한 대에서 돌아갑니다. M3 Ultra에서 Q2_K는 프리필 초당 약 90토큰, 생성 초당 15토큰이었습니다. Hugging Face Inference Endpoints의 레시피는 H200 8장에 FP8 가중치를 텐서 병렬과 전문가 병렬로 나눠 올립니다. 컨텍스트를 최대 131K, 동시 요청을 16개로 제한한 구성입니다. 단일 요청 생성 속도는 초당 약 65토큰이었고, DSpark 초안이 잘 맞는 대화 프롬프트에서는 초당 120~138토큰이었습니다.
vLLM과 SGLang
모델 카드는 vLLM을 권장하며, Mistral Large 4 지원이 들어간 전용 Docker 이미지 vllm/vllm-openai:mistral-large-4 를 쓰라고 안내합니다. vLLM 레시피도 아직 어떤 vLLM 릴리스나 nightly 휠에도 지원이 들어가지 않았다고 밝히고 있어, 지금 vLLM으로 돌리려면 이 이미지(AMD GPU는 vllm/vllm-openai-rocm:mistral-large-4)를 써야 합니다. 같은 레시피에 따르면 GPU 8장에 나눠 올릴 때 GPU당 가중치가 FP8은 약 128GiB, NVFP4는 약 76GiB입니다. 검증된 구성은 B300 8장(FP8, NVFP4), B200 8장(NVFP4), GB300 트레이, H200 16장(FP8, TP16 또는 PP2×TP8), AMD MI350X 8장이고, 컨텍스트 길이는 256K까지만 검증했습니다. 모델 카드의 FP8 서빙 명령(텐서 병렬 8)은 다음과 같습니다:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
--tool-call-parser mistral 과 --reasoning-parser mistral 은 도구 호출과, 응답에서 추론 부분을 분리하는 데 필요합니다. 메모리가 부족하면 --max-model-len 이나 --max-num-seqs 를 낮춥니다. 처리량과 지연 시간별 설정은 vLLM 레시피에, SGLang 설정은 SGLang 쿡북에 있습니다. SGLang도 전용 이미지 lmsysorg/sglang:mistral-large-4 를 씁니다.
서버가 뜨면 OpenAI 호환 API로 호출합니다. 다음은 모델 카드의 예제입니다:
from openai import OpenAI

# Modify OpenAI's API key and API base to use vLLM's API server.
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

model = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Write me a sentence where every word starts with the next letter in the alphabet - start with 'a' and end with 'z'.",
        }
    ],
    reasoning_effort="low",  # Increase with 'medium' or 'high'.
    temperature=1.0,
    top_p=0.95,
    max_completion_tokens=4096,
)

print("REASONING")
print("~~~~~~~~~")
print(response.choices[0].message.reasoning)
print("CONTENT")
print("~~~~~~~")
print(response.choices[0].message.content)
Transformers, 미세조정, 코딩 에이전트
Transformers에서는 AutoModelForMultimodalLM 과 AutoProcessor 로 불러옵니다. 모델 카드는 main 브랜치 설치를 안내하지만, 10월 29일 PyPI에 나온 5.22.0 휠부터 mistral_large4 모듈이 들어 있어 pip install --upgrade transformers 로 충분합니다. 미세조정(Fine-tuning)은 TRL 예제(B300 8장 노드 하나에서 FP8 체크포인트에 LoRA 적용, GPU당 142GiB)와 Axolotl 문서(B200 8장에서 NVFP4 체크포인트에 LoRA 적용)가 있습니다. Axolotl은 컴퓨팅 자원이 부족해 최소한의 테스트만 했다고 밝혔습니다.
Mistral의 오픈소스 터미널 코딩 에이전트 Mistral Vibe도 모델 카드에 따르면 Mistral Large 4로 구동됩니다. uv tool install mistral-vibe 또는 pip install mistral-vibe 로 설치하고, Mistral API에서는 mistral-large-4 모델을 고릅니다. 직접 띄운 vLLM 서버에 연결하려면 ~/.vibe/config.toml 에 공급자를 추가합니다. 모델 카드의 설정 예시는 max_context_length = 1048576, auto_compact_threshold = 800000 을 씁니다.
모델 카드의 언어 태그에는 한국어(ko)가 들어 있고, Mistral은 160개 이상 언어를 지원한다고 밝혔습니다. 다만 이번 발표 자료에는 한국어 벤치마크가 따로 없습니다.
가격과 라이선스
API로 쓰려면 Mistral 문서의 모델 페이지에 있는 mistral-large-4 를 호출합니다. 가격은 100만 토큰당 입력 0.70달러, 캐시된 입력 0.07달러, 출력 2.10달러입니다. OpenRouter와 NVIDIA 호스팅 엔드포인트에서도 쓸 수 있습니다. Microsoft는 Microsoft Foundry가 이 모델을 고객에게 제공하는 첫 클라우드 공급자라고 밝혔습니다. 기업 고객은 Mistral의 맞춤 학습 서비스 Forge로 자체 데이터에 맞게 모델을 조정할 수 있습니다.
라이선스 파일을 직접 읽으면 조건은 다음과 같습니다. Mistral Ecosystem Open-Weight License는 MIT 라이선스를 고친 것으로, 저작권 고지를 포함하는 조건으로 사용, 수정, 배포, 판매, 추가 학습, 파생 모델 제작을 허용합니다. 단, 라이선스 사용자나 그 계열사가 MaaS(Model-as-a-Service) 사업을 하면, 모델이나 파생 모델을 상업적으로 쓰기 전에 Mistral과 별도 상업 라이선스를 맺어야 합니다. 라이선스는 MaaS를 제3자가 API나 호스팅 엔드포인트로 모델의 입력, 매개변수, 학습 데이터를 실질적으로 제어하며 추론이나 사후 학습에 접근하게 하는 것으로 정의합니다.
라이선스가 MaaS 정의에서 빼거나 계약 요건을 면제하는 경우는 네 가지입니다:
- 특정 기능이나 하네스 안에 모델 기능을 넣은 최종 사용자 제품
- 다른 곳에 호스팅된 모델로 요청을 중계만 하는 경우
- 제3자에게 모델을 제공하지 않는 사내 사용
- Mistral 공식 제품을 통한 사용
즉 사내 코딩 에이전트나 자사 서비스의 한 기능으로 쓰는 것은 계약 없이 가능합니다. 반면 라이선스는 판매 여부가 아니라 제3자의 제어 여부로 MaaS를 정의합니다. 제3자가 제어할 수 있는 추론이나 미세조정 API로 이 모델을 제공하는 사업자는, 사내 사용 외의 상업적 사용 전반에 계약이 필요합니다.
 Le Chonk: Built for Coders, Trusted by Defenders 가중치 공개 블로그
Introducing Mistral Large 4 프리뷰 발표 블로그
 Mistral Large 4 모델 카드 (Hugging Face)
Welcome Le Chonk: Mistral Large 4 on Hugging Face 블로그
 Mistral 문서의 Mistral Large 4 모델 페이지
더 읽어보기
-
Meta, Mac Studio 두 대에서 돌아가는 816B 오픈 웨이트 모델 Muse Spark Open 공개 (feat. MLX)
-
Kimi K3.1 Pro 출시: K3보다 33% 낮은 API 가격, 사이버 보안 데이터를 뺀 3T급 오픈 웨이트 모델 (가중치는 11/4까지 공개 예정)
-
Xiaomi, RL 코드와 학습 환경까지 공개한 1.02T 옴니모달 MiMo-V2.6 출시, 오픈소스 지능 지수 1위
-
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄이고 플래그십 V4-Pro를 대체하는 552B 규모의 MoE 모델
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
