핵심 요약
- Reflection AI가 Beam 소개 블로그에서 첫 오픈 웨이트(Open-Weight) 모델 Beam을 발표했습니다. 전체 501B, 토큰당 활성 23B 파라미터의 희소 MoE 모델이며 코딩, 추론, 에이전트 작업을 겨냥합니다.
- 지금은 Reflection 플랫폼의 대기자 명단으로 일부 사용자에게만 열려 있습니다. 가중치(Apache 2.0 라이선스), 기술 보고서, 모델 카드, 개발자용 자료는 10월 중 공개할 예정이라고 밝혔습니다.
- 강화학습에 NVIDIA GB300 GPU 10.5K개를 4주 동안 써서 1억 회가 넘는 롤아웃을 만들었고, 연산을 늘리는 동안 성능이 계속 올랐다고 보고합니다.
- 같은 발표의 비교표에서 Beam은 GLM 5.3과 Qwen 3.8 Max에 보고된 모든 칸에서, Kimi K3에는 한 칸을 빼고 모두 뒤집니다. 비슷한 크기의 DeepSeek V4.1 Flash에도 아홉 칸 중 일곱 칸에서 뒤지며, 내세우는 장점은 절대 성능이 아니라 추론 연산 효율입니다.

Reflection AI와 Beam 소개
Beam은 Reflection AI가 처음으로 가중치를 공개하겠다고 밝힌 대규모 언어 모델입니다. 전체 파라미터는 501B이지만 토큰 하나를 처리할 때는 23B만 계산에 참여하는 희소 전문가 혼합(Sparse Mixture-of-Experts, MoE) 구조이고, 코딩과 에이전트 작업에 맞춰 학습했습니다. 발표 시점(2026년 10월 5일)에는 가중치가 아직 없고, 확인할 수 있는 근거는 발표 블로그의 표와 그림뿐입니다.
Reflection AI는 Building Frontier Open Intelligence 글에서 20억 달러를 투자받았다고 밝힌 회사입니다. 팀은 PaLM, Gemini, AlphaGo, AlphaCode 개발에 참여한 연구자들로 꾸렸다고 소개합니다. 당시에는 자율 코딩 분야에 대규모 MoE 학습과 강화학습 플랫폼을 적용해 왔고, 이를 범용 에이전트 추론으로 넓히겠다고 했습니다. 회사 소개 페이지에는 모델 가중치, 기술 보고서, 강화학습 도구와 환경을 공개하겠다는 세 가지 약속이 적혀 있습니다. Beam은 그 약속이 처음으로 모델 형태로 나온 결과입니다.
발표 블로그는 Beam이 서구권 오픈 웨이트 모델의 최고 수준을 끌어올렸다고 소개합니다. 비교표에 함께 오른 서구권 오픈 모델은 Thinking Machines Lab의 Inkling과 NVIDIA의 Nemotron 3 Ultra입니다. 더 큰 오픈 모델에 대해서는 코딩과 에이전트 작업에서 GLM 5.2와 경쟁할 만하고 Qwen3.8-Max에 근접한다고 적었습니다. Kimi K3에 대해서는 "Kimi K3 같은 최전선 오픈 모델이 순수 능력에서는 여전히 앞서 있다"고 인정하고, 대신 추론 시점의 효율을 Beam의 장점으로 내세웁니다.
정리하면 이 글의 독자가 지금 판단할 수 있는 것은 두 가지입니다. 첫째, 가중치가 나오면 500B급 모델을 직접 운영할 계획이 있는 팀에게 Beam이 후보가 될 만한지입니다. 둘째, 1억 회 롤아웃 규모의 비동기 강화학습과 사전학습 안정화 기법 중 어떤 것이 공개 자료로 다시 나올지입니다. 아래에서는 발표 블로그의 수치를 옮기되, 회사가 고른 비교 축과 표 안에서 진 칸을 함께 적습니다.
한눈에 보는 Beam의 제원은 다음과 같습니다:
- 구조: 희소 MoE, 전체 501B / 활성 23B 파라미터, 52개 층, 세분화된 라우팅 전문가(Fine-Grained Routed Experts), 로컬 어텐션과 글로벌 어텐션을 번갈아 배치
- 입출력: 텍스트 전용 (이미지 등 다른 모달리티는 텍스트로 바꿔 넣어야 함)
- 컨텍스트: 미드트레이닝에서 유효 컨텍스트를 1M 토큰까지 확장, 강화학습 롤아웃의 최대 길이는 256K 토큰
- 사전학습: 23.8T 토큰, NVIDIA GB300 NVL72 6,144개 GPU로 4주 미만
- 강화학습: GB300 GPU 10.5K개로 4주, 롤아웃 1억 회 이상
- 추론 강도 조절: 추론 강도(Reasoning Effort) 파라미터로 응답 길이와 성능을 맞바꿈
- 공개 계획: 10월 중 Apache 2.0 가중치, 기술 보고서, 모델 카드, 실행과 평가와 파인튜닝용 전체 스택
벤치마크로 본 Beam의 위치: 같은 표 안의 이긴 칸과 진 칸
발표 블로그의 벤치마크 표는 탭 네 개로 나뉘어 있어 첫 탭만 화면에 보입니다. 아래는 네 탭을 모두 옮긴 것입니다. NR은 해당 모델의 점수가 보고되지 않은 칸입니다. 블로그는 효율 그림의 설명에서 다른 모델의 평가 점수 출처로 Artificial Analysis와 DataCurve를 밝혔고, 표의 출처는 따로 적지 않았습니다. AA Omniscience 행만 Reflection AI가 직접 측정했다고 표시되어 있습니다.
에이전트 코딩과 터미널 (Agentic Coding/Terminal)
| 벤치마크 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 44.4 | NR | NR | 44.0 | 61.0 | 68.0 | 51.0 | 74.2 |
| SWE Bench Pro v2-Hard | 77.2 | 56.9 | NR | NR | 84.3 | 88.2 | NR | NR |
| SWE Bench Pro v1 | 65.5 | 54.3 | 46.4 | 62.1 | NR | NR | 67.7 | NR |
| Terminal Bench v2.1 | 80.1 | 63.8 | 56.4 | 81.0 | 88.2 | 88.3 | 86.6 | 90.6 |
| SWE Atlas Codebase QnA | 34.6 | NR | NR | NR | 61.0 | 68.0 | NR | NR |
| SWEBench Multilingual | 78.0 | NR | 67.7 | NR | NR | NR | NR | NR |
| SWEBench Verified | 80.9 | 77.6 | 70.7 | NR | NR | NR | NR | NR |
도구 호출과 검색 (Tool Calling / Search)
| 벤치마크 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AutomationBench public | 37.0 | NR | NR | 26.2 | 48.2 | 46.7 | 39.8 | 54.8 |
| MCP Atlas | 78.7 | 76.0 | 63.1 | 77.8 | 84.2 | 82.3 | 84.5 | NR |
| tau3 banking | 38.0 | 25.0 | 22.6 | 37.1 | NR | 37.1 | 55.2 | NR |
| BrowseComp (컨텍스트 관리 사용) | 77.4 | 77.1 | 44.4 | NR | NR | 91.2 | NR | NR |
| DeepSearchQA (컨텍스트 관리 사용) | 80.1 | NR | NR | NR | NR | 95.0 | NR | NR |
추론 (Reasoning)
| 벤치마크 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AIME 2026 | 97.8 | 97.1 | NR | 99.2 | NR | NR | NR | NR |
| HLE (도구 없음) | 36.2 | 29.7 | 26.7 | 40.5 | 42.3 | 46.9 | 43.6 | 39.1 |
| SciCode | 49.7 | 46.1 | 44.6 | NR | 59.0 | 58.7 | 52.1 | 52.0 |
| CriPT AA | 16.3 | 5.4 | 3.1 | 20.9 | 19.1 | 23.4 | 20.0 | 14.3 |
| GPQA Diamond | 90.5 | 87.2 | 87 | 91.2 | 91.7 | 93.5 | 92.6 | 90.9 |
일반 능력 (General Capabilities)
| 벤치마크 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AA-LCR | 79.3 | 77.3 | 79.3 | 78.3 | 79.7 | 88.7 | 80.3 | 84.0 |
| LongBench v2 | 65.5 | NR | 61.9 | 64.0 | NR | NR | 66.3 | NR |
| IFBench | 79.7 | 79.8 | 81.7 | 73.3 | NR | NR | 82.8 | NR |
| AA Omniscience (공개 분할, 자체 측정) | 13.0 | 14.2 | 8.6 | NR | 22.6 | NR | NR | 6.6 |
위 표에서 세 가지를 알 수 있습니다.
서구권 오픈 모델과의 비교에서는 Beam이 대부분 앞섭니다. Inkling(전체 975B, 활성 41B)보다 SWE Bench Pro v1에서 11.2점, Terminal Bench v2.1에서 16.3점, HLE(Humanity's Last Exam)에서 6.5점 높습니다. 다만 IFBench에서는 Inkling(79.8)과 Nemotron 3 Ultra(81.7)가 앞서고, AA Omniscience에서는 Inkling이 1.2점 앞서며, AA-LCR은 Nemotron 3 Ultra와 같습니다.
대형 오픈 모델과의 비교에서는 결과가 갈립니다. GLM-5.2(전체 744B, 활성 40B)와는 함께 보고된 13칸 중 Beam이 8칸, GLM-5.2가 5칸에서 앞섭니다. Beam은 DeepSWE, SWE Bench Pro v1, 도구 호출 지표에서 앞서고, GLM-5.2는 AIME 2026, HLE(40.5 대 36.2), CriPT AA(20.9 대 16.3), GPQA Diamond, Terminal Bench v2.1(81.0 대 80.1)에서 앞섭니다. 즉 GLM-5.2에 뒤지는 쪽은 주로 추론 지표입니다.
그보다 큰 모델과는 격차가 분명합니다. GLM 5.3은 보고된 12칸 전부, Qwen 3.8 Max는 13칸 전부에서 Beam보다 높습니다. Kimi K3는 14칸 중 tau3 banking(38.0 대 37.1) 한 칸만 Beam에 내줍니다. 블로그가 Qwen3.8-Max에 근접한다고 한 코딩과 에이전트 지표에서도 DeepSWE(51.0 대 44.4), Terminal Bench v2.1(86.6 대 80.1), SWE Bench Pro v1(67.7 대 65.5) 모두 Qwen 3.8 Max가 앞섭니다. 저장소 이해를 묻는 SWE Atlas Codebase QnA에서는 Beam이 34.6점으로 GLM 5.3(61.0)과 Kimi K3(68.0)에 크게 못 미칩니다.
비슷한 크기의 DeepSeek V4.1 Flash와의 비교는 발표문이 직접 다루지 않는 부분입니다. DeepSeek-V4.1-Flash는 552B 규모에 디코드 기준 활성 16B로, 크기는 Beam과 비슷하고 활성 파라미터는 더 적습니다. 그런데 같은 표에서 DeepSeek V4.1 Flash는 함께 보고된 아홉 칸 중 일곱 칸에서 Beam보다 높습니다. 차이가 큰 칸은 DeepSWE v1.1(74.2 대 44.4), Terminal Bench v2.1(90.6 대 80.1), AutomationBench(54.8 대 37.0), AA-LCR(84.0 대 79.3), HLE(39.1 대 36.2)이고, SciCode와 GPQA Diamond는 2점 안쪽의 차이입니다. Beam이 앞서는 칸은 CriPT AA와 AA Omniscience 두 칸입니다. 다른 모델의 점수는 외부 측정 자료에서 왔을 가능성이 높아, 하네스(Harness)와 설정이 Beam의 측정과 같다는 보장은 없습니다. 그래도 Beam의 효율을 비슷한 크기의 모델 중 최고로 읽는 해석은 이 표만으로는 성립하지 않습니다.
NR 칸이 많다는 점도 읽을 때 고려해야 합니다. SWEBench Verified와 SWEBench Multilingual은 Beam이 높은 점수를 낸 지표이지만, 대형 모델 다섯 개의 점수가 모두 비어 있어 서구권 모델과의 비교로만 쓰입니다.
추론 효율 주장: 3~4배 적은 연산은 어떤 조건에서 나온 숫자인가
발표 블로그의 핵심 주장은 효율입니다. 고급 추론 벤치마크에서 "GLM-5.2와 비슷한 점수를 3~4배 적은 추론 연산으로 낸다"고 쓰고, 2T 이상의 Qwen 3.8-Max와 비교하면 차이가 더 크다고 말합니다. 아래 두 그림은 DeepSWE v1.1, HLE, Terminal Bench 2.1 점수를 각각 추정 생성 연산량(FLOPs)과 평균 생성 토큰 수에 대해 그린 것입니다. Beam의 점 여러 개는 추론 강도 설정을 바꾼 결과입니다.
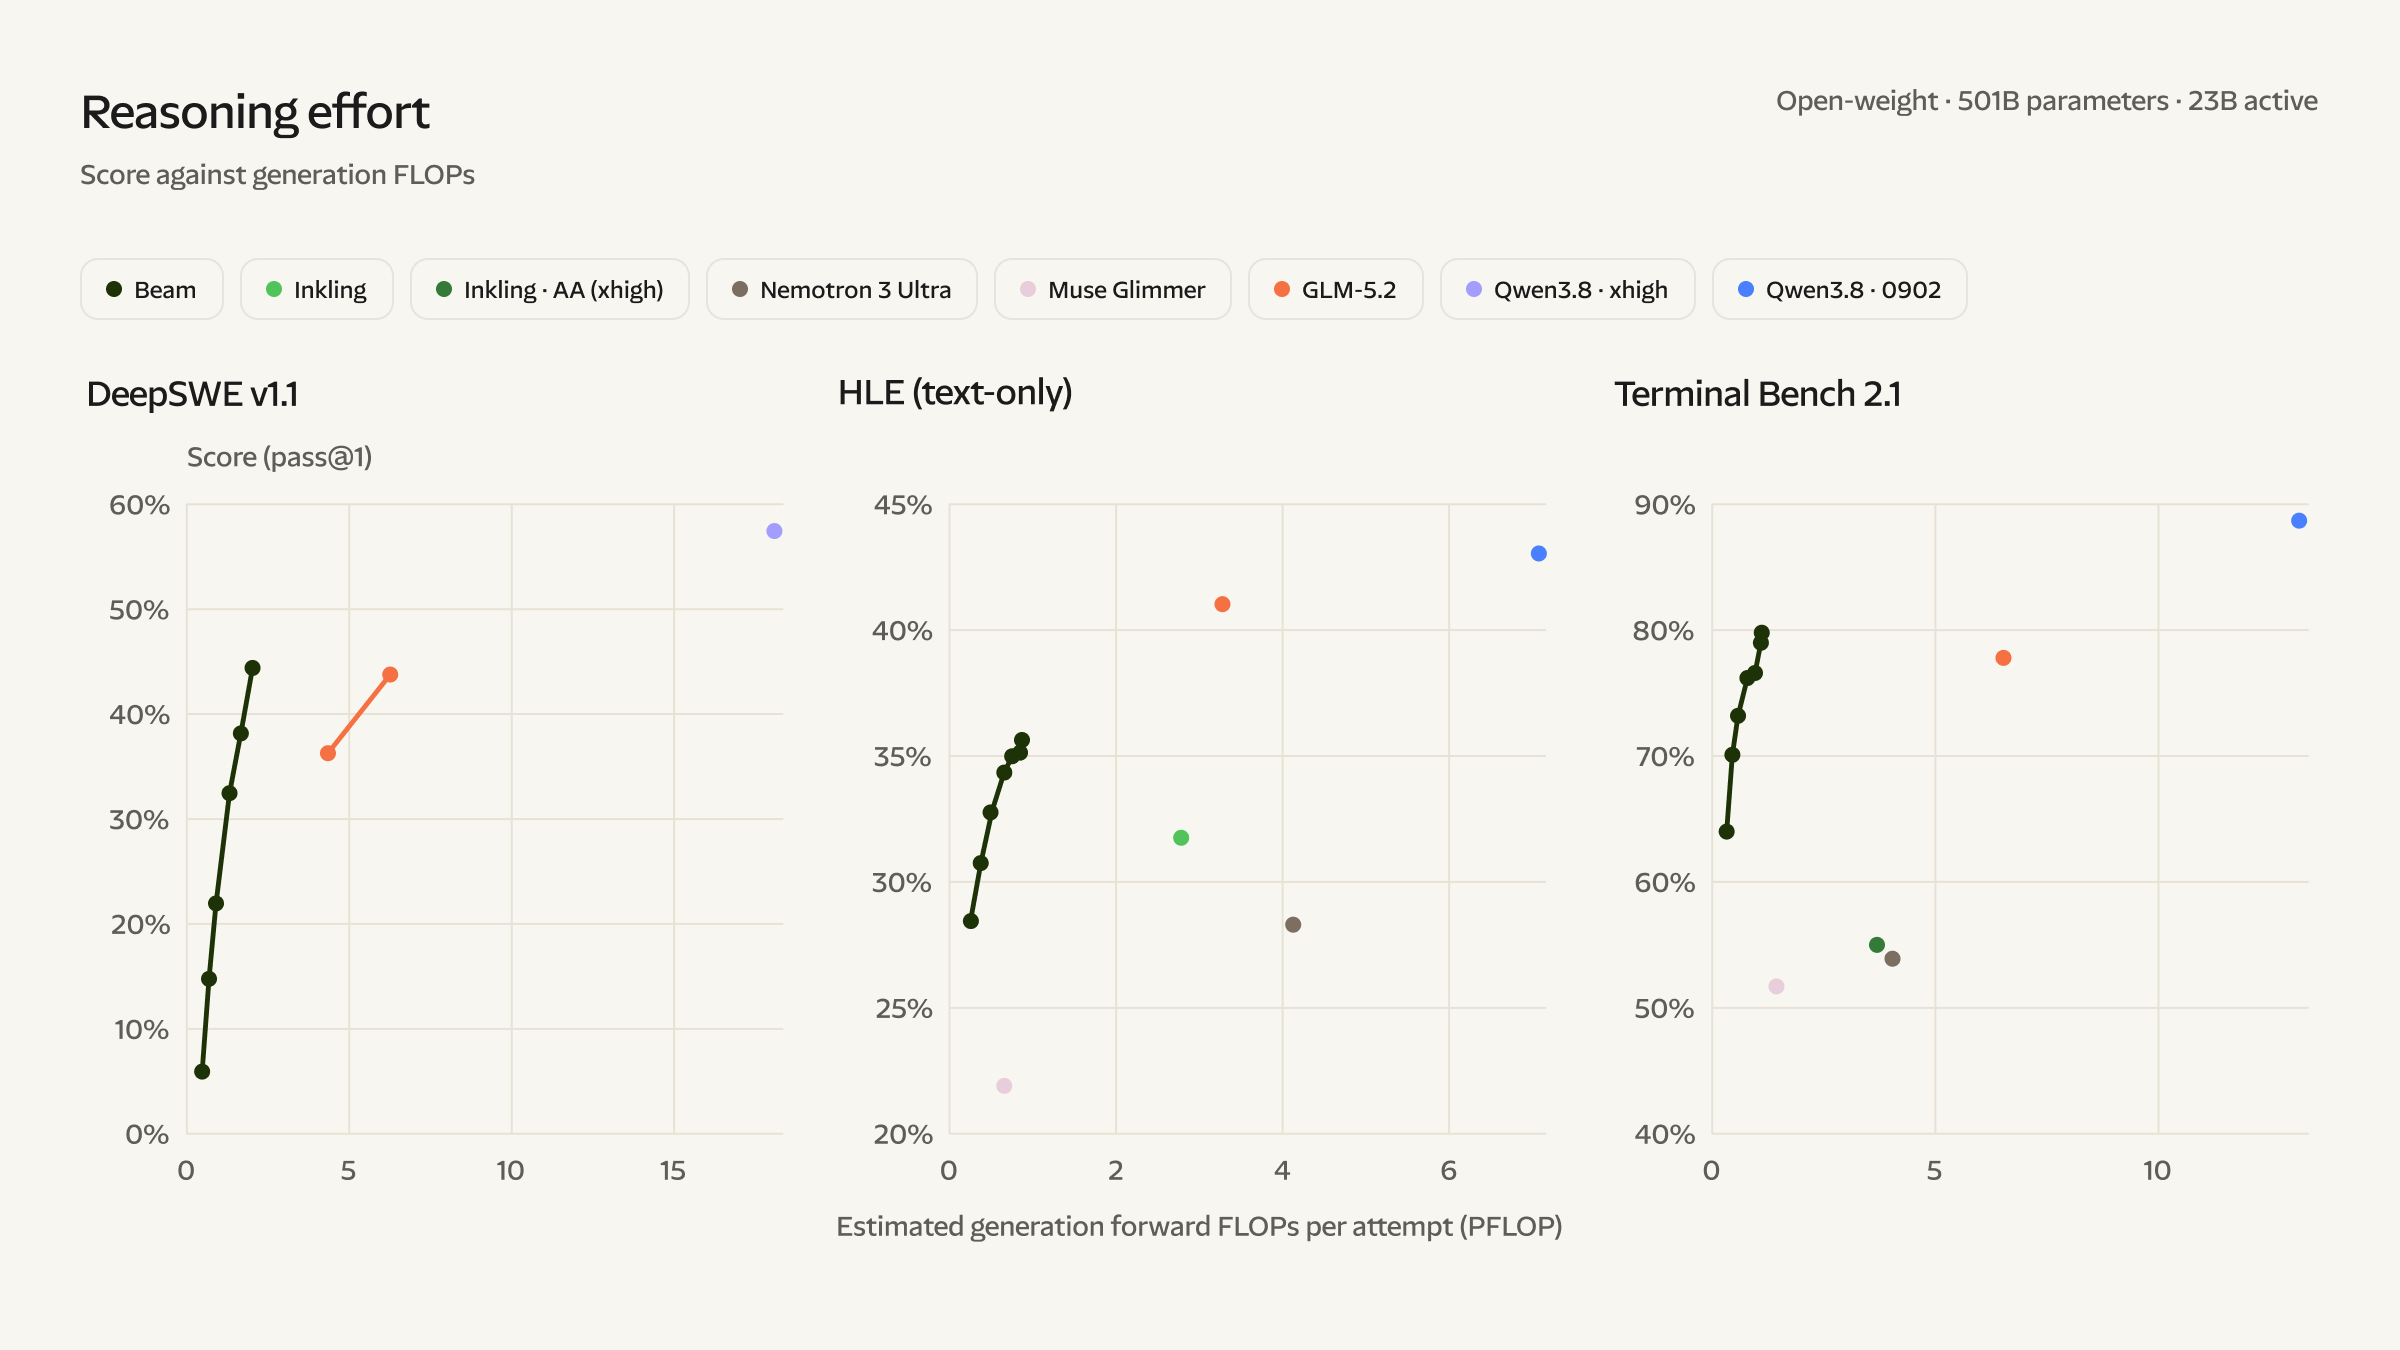
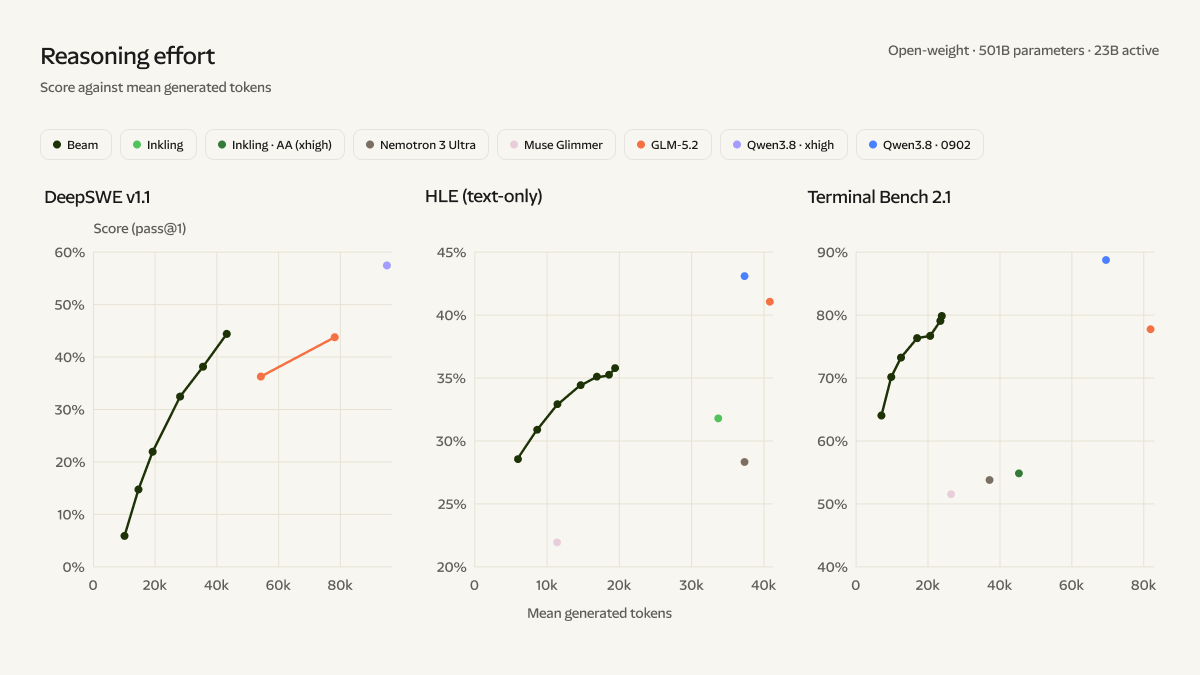
연산량은 측정값이 아니라 다음 식으로 추정한 값입니다:
여기서 N_{\text{active}} 는 토큰당 활성 파라미터 수이고, \bar{T}_{\text{gen}} 은 시도당 평균 생성 토큰 수(추론 토큰과 최종 답 포함)입니다. 블로그 스스로 프롬프트 프리필(Prefill), 컨텍스트 길이에 따라 커지는 어텐션 연산, 서빙 오버헤드를 뺐다고 밝혔고, 따라서 실제 추론 비용이 아니라 대략적인 연산 비교라고 적었습니다.
이 계산 방식에는 짚어 둘 점이 있습니다. 활성 파라미터와 생성 토큰만 세기 때문에 활성 파라미터가 작은 모델과 답을 짧게 쓰는 모델에 유리합니다. 에이전트 작업처럼 입력 컨텍스트가 길고 도구 결과가 계속 쌓이는 경우에는 프리필과 어텐션 비용의 비중이 커지는데, 이 부분이 빠져 있습니다. 또한 501B 전체 가중치를 메모리에 올려야 한다는 서빙 비용도 이 식에는 드러나지 않습니다.
그림에서 대략 읽으면, DeepSWE와 Terminal Bench 2.1에서는 주장이 맞습니다. DeepSWE에서 Beam은 약 2 PFLOP로 44%대를 내고, GLM-5.2는 약 6 PFLOP로 비슷한 점수를 냅니다. 반면 HLE에서는 Beam의 최고점이 36% 안팎이고 GLM-5.2는 41% 수준이어서, 점수가 비슷하다고 보기 어렵습니다. 블로그는 이 주장을 고급 추론 벤치마크에 대해 했는데, 세 그림 중 추론 벤치마크는 HLE 하나이고 바로 그 HLE에서 격차가 가장 큽니다. Terminal Bench 2.1의 GLM-5.2 점은 그림에서 약 78%로 찍혀 있는데, 위 표에는 81.0으로 Beam(80.1)보다 높게 적혀 있습니다. 그림과 표가 서로 다른 출처의 점수를 쓴 것으로 보이며, 어느 쪽을 쓰느냐에 따라 순위가 바뀝니다.
고연산 강화학습: 1억 회 롤아웃과 비동기 학습
강화학습을 확장 축으로 삼다
Reflection AI는 고연산 강화학습(High-Compute Reinforcement Learning) 을 Beam의 핵심 확장 축으로 삼았다고 설명합니다. 강화학습 규모를 키우면 문제 풀이 전략을 더 넓게 탐색할 수 있다는 논리입니다. 롤아웃이 길어지면 여러 단계의 추론, 도구 사용, 환경 피드백에 따른 수정도 배울 수 있다고 봅니다. 여기서 롤아웃(Rollout) 은 모델이 환경 안에서 과제를 처음부터 끝까지 한 번 수행한 기록을 말합니다.
규모는 다음과 같습니다. NVIDIA GB300 GPU 10.5K개를 4주 동안 써서 최대 컨텍스트 256K 토큰의 롤아웃을 1억 회 넘게 만들었고, 학습과 채점에 샌드박스 약 13억 개를 썼습니다. 이를 위해 코딩, 에이전트, STEM 분야의 고품질 환경 100만 개를 마련했다고 합니다. 블로그는 이것이 지금까지 오픈 연구소가 수행한 가장 큰 강화학습 중 하나라고 보고, 강화학습 연산을 늘리는 동안 평가 성능이 정체 없이 계속 올랐다고 적었습니다.
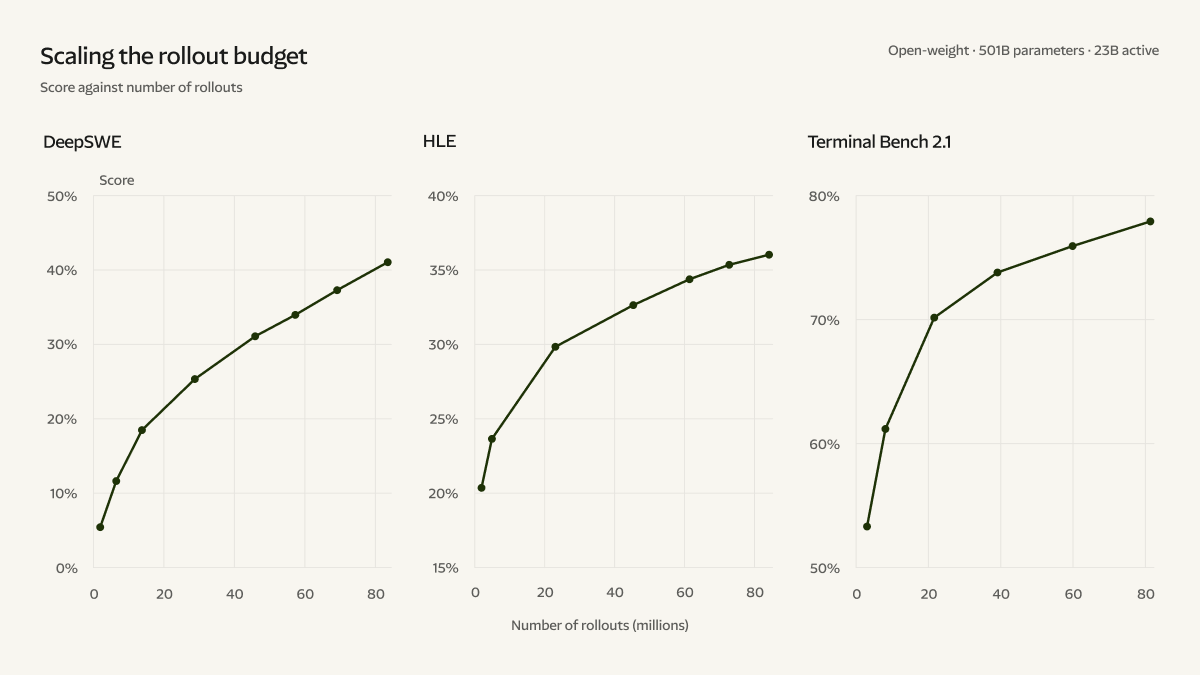
위 그림은 전체 1억 회 중 추론 전문가 모델에 쓴 8천만 회 구간입니다. 세 벤치마크 모두 곡선 끝부분까지 오르고 있습니다. 비교 대상으로 블로그는 Inkling이 3천만 회, MiMo가 75만 3천 회의 롤아웃으로 학습했다고 적었습니다.
하루 전 데이터로도 안정적으로 배우는 비동기 학습
Beam은 비동기 정책 그래디언트(Asynchronous Policy Gradient) 로 학습했습니다. 롤아웃을 만드는 쪽과 모델을 업데이트하는 쪽이 서로를 기다리지 않으므로 GPU가 쉬지 않습니다. 대신 학습에 들어오는 데이터가 이미 몇 버전 지난 모델로 만든 것일 수 있습니다. 이를 정책 지연(Policy Staleness) 이라고 합니다. 롤아웃이 길면 한 롤아웃 안에서도 앞쪽 토큰과 뒤쪽 토큰을 서로 다른 체크포인트가 만들게 되고, 학습 엔진과 추론 엔진의 수치 차이가 문제를 키웁니다.
Reflection AI는 이 조건에서 학습을 안정적으로 유지하는 새 알고리즘을 개발했고, 파이프라인 전반에서 학습과 추론 사이의 불일치를 줄였다고 설명합니다. 알고리즘의 구체적인 내용은 블로그에 없고, 기술 보고서에서 다룰 것으로 보입니다.
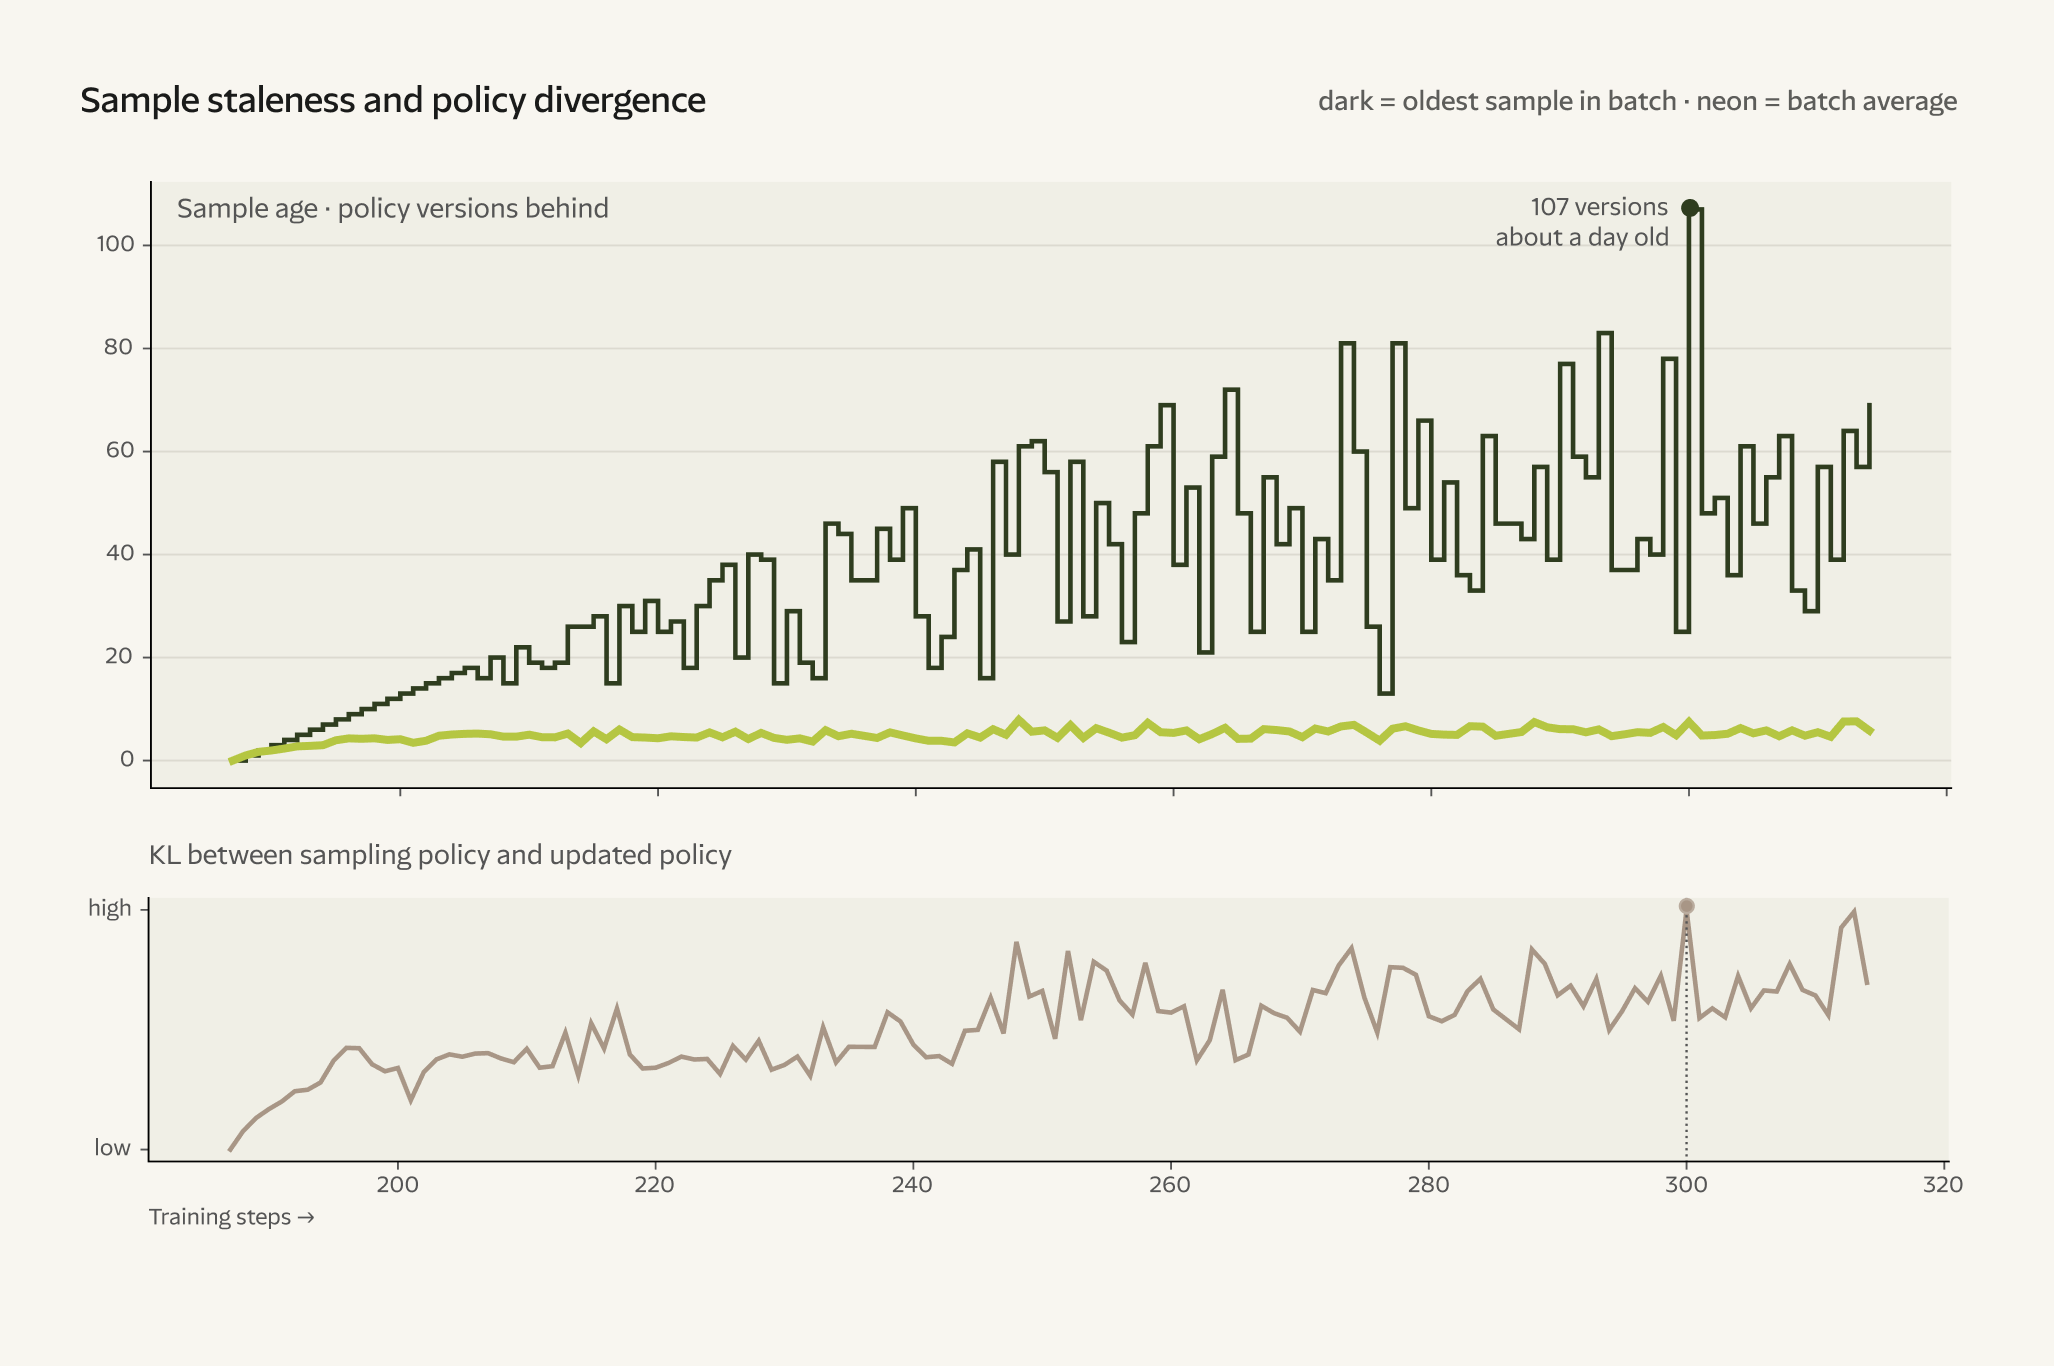
위쪽 그래프는 배치 안에서 가장 오래된 샘플이 현재 정책보다 몇 버전 뒤처졌는지를 보여 줍니다. 300단계 부근에서 107개 버전, 약 하루 전에 만든 샘플까지 학습에 들어갔지만 배치 평균 지연은 10 버전 안쪽에 머뭅니다. 아래쪽 그래프의 KL 발산(Kullback-Leibler Divergence)은 지연이 커질수록 함께 올라가지만 폭주하지는 않습니다. 세로축에 수치 대신 high와 low만 표시되어 있어, 얼마나 안정적인지를 수치로 확인할 수는 없습니다.
짧게 생각하는 법부터 배우게 한 길이 페널티
Beam의 강화학습에는 조절 가능한 길이 페널티가 들어 있습니다. 문제를 풀면 보상을 주되 불필요한 토큰에는 불이익을 주는 방식입니다. 블로그에 따르면 강화학습 초반에는 응답 길이가 줄어드는데도 성능이 올랐고, 후반에 에이전트 능력이 강해지면서 다시 길어졌지만 그 토큰은 추가 성능으로 이어졌습니다.
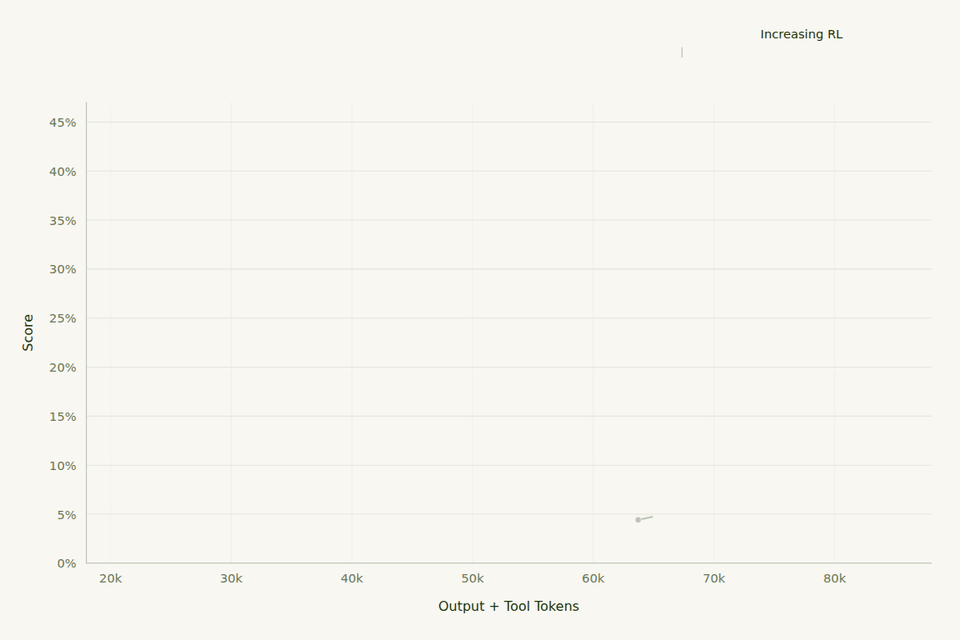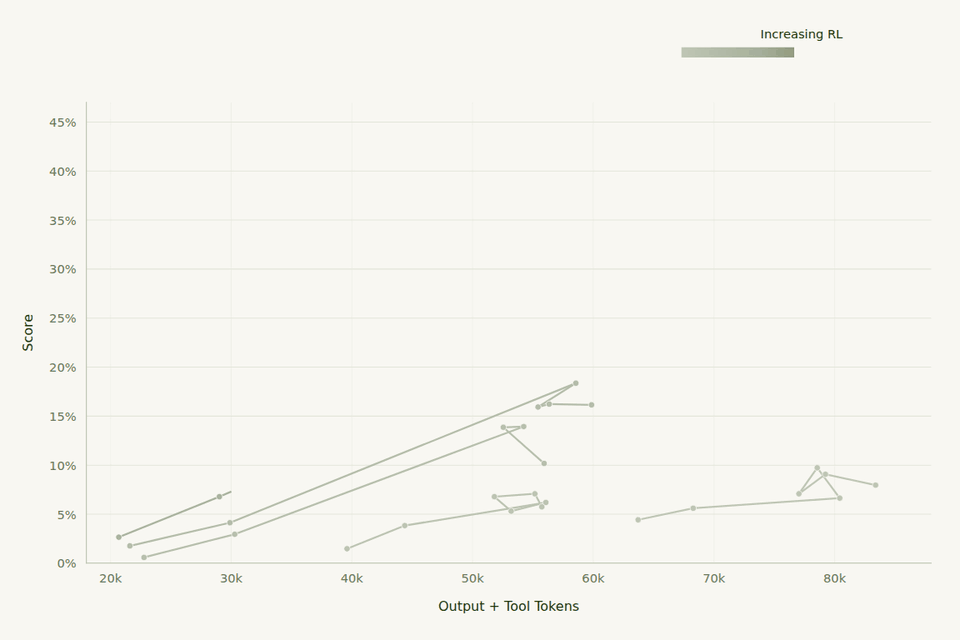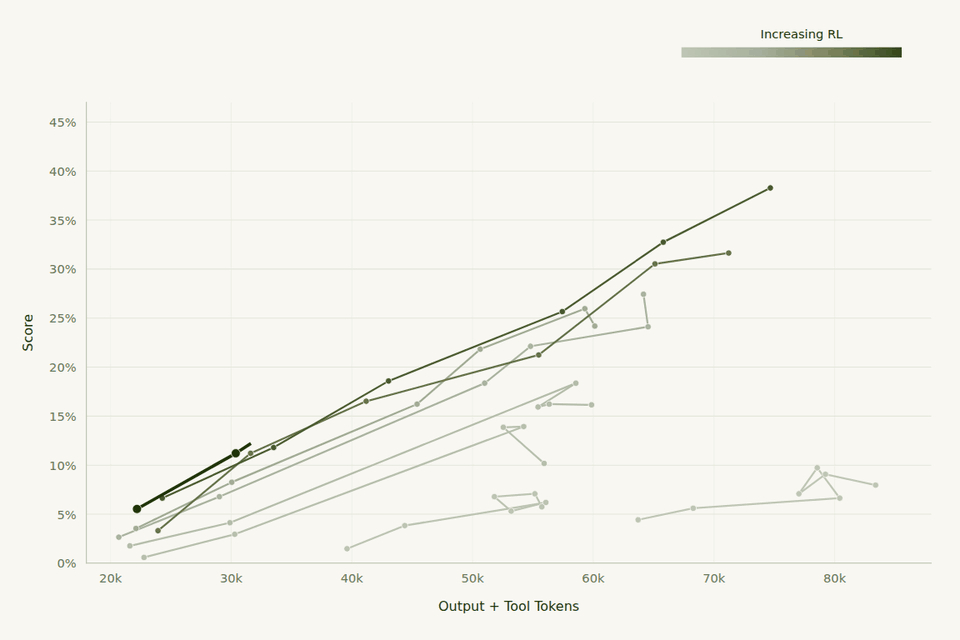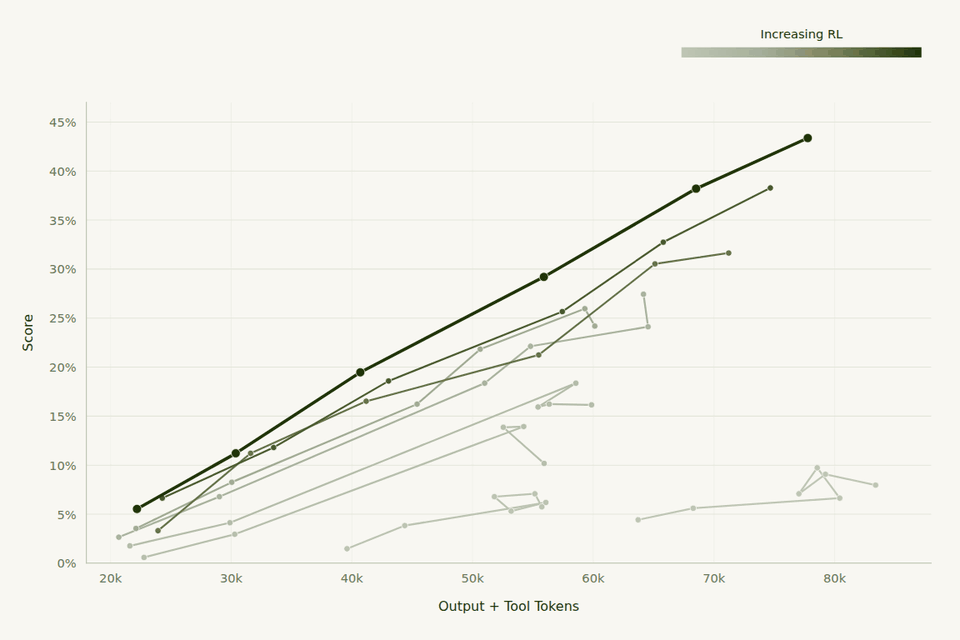
각 선은 강화학습의 한 시점이고, 선 위의 점은 서로 다른 추론 강도 설정입니다. 블로그는 파레토 경계(Pareto Frontier)가 두 단계로 움직였다고 설명합니다. 먼저 정책이 토큰을 아껴 쓰는 법을 배우면서 경계가 줄어들고, 이후 높은 추론 강도 설정이 더 높은 성능 쪽으로 경계를 넓혔습니다. 사용자는 추론 강도 파라미터로 이 트레이드-오프를 고를 수 있습니다. 낮게 두면 짧게 답하고, 높게 두면 어려운 과제에서 더 길게 추론합니다.
학습하지 않은 브라우징으로 번진 능력과 데모
블로그는 추론, 소프트웨어 엔지니어링, 터미널 과제로 학습하는 구간에서 학습 데이터에 없던 브라우징 성능도 함께 올랐다고 보고합니다. 웹 접근을 주면 다른 LLM에 질의하고 OCR API로 문서를 읽는 행동도 스스로 익혔다고 합니다. 이 관찰을 보여 주려고 네 가지 데모를 공개했습니다:
- 우주비행사 자유낙하 게임: p5.js로 지구를 향해 떨어지는 우주비행사가 소행성을 피하거나 빔으로 부수는 3D 게임을 만들었습니다. Beam은 텍스트 전용이지만 화면이 어떻게 보여야 할지를 텍스트로 추론했다고 설명합니다.
- 육지와 바다 판별 실험: X에서 화제가 된 퍼즐을 재현했습니다. 경도 -179°~179°, 위도 -89°~89°를 180×90 격자(16,200개 점)로 나누고 각 점이 육지인지 바다인지 맞히게 했고, Beam은 95.5%를 맞혔습니다. 블로그는 이를 Opus 5(92.5%)와 Fable 5(97.8%) 사이라고 비교합니다.
- 뉴욕 지하철 실시간 지도: 공개된 NYC MTA 데이터로 실시간 지하철 지도를 만들었습니다. 문서 검색, 인증 요구사항 확인, 노선과 지도 지오메트리 수집, 역 사이 열차 이동 표현, 프런트엔드와 백엔드 구축, 서버 유지까지 모델이 수행했다고 합니다.
- 파인튜닝 노트북: Beam을 OpenCode에 연결해 Unsloth를 참고하게 하고, 최신이자 가장 작은 Gemma-4 모델을 Text2SQL 과제로 파인튜닝하는 노트북을 만들게 했습니다. 블로그는 그 결과 Gemma의 보류 테스트셋 정확도가 66.5% 올랐다고 적었는데, 이것이 상대 증가율인지 퍼센트포인트인지는 밝히지 않았습니다.
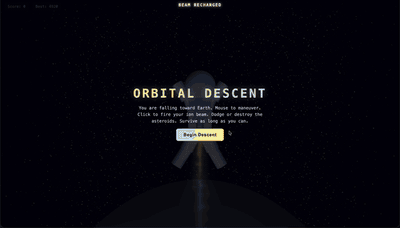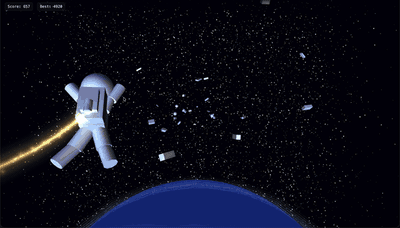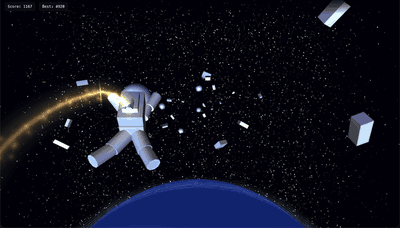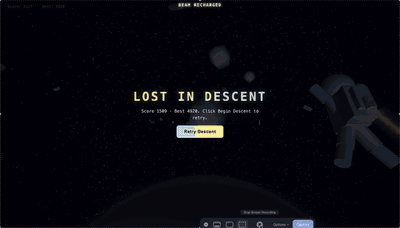
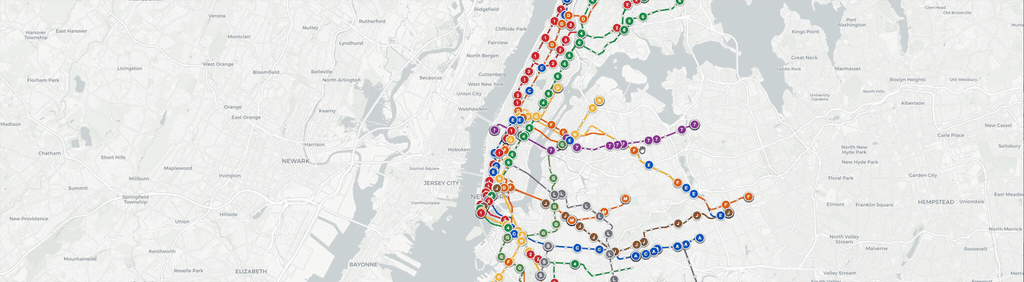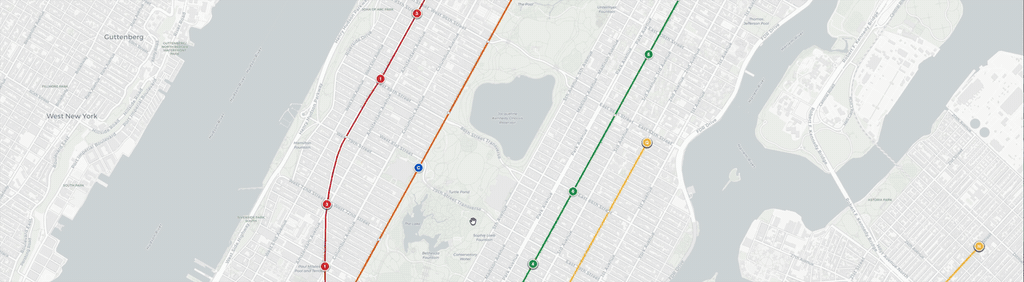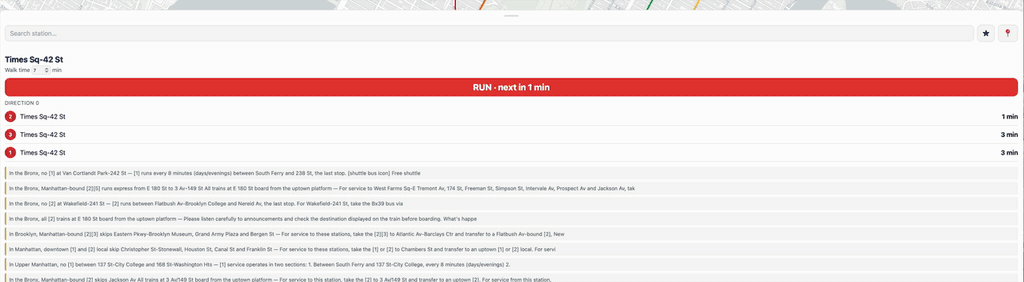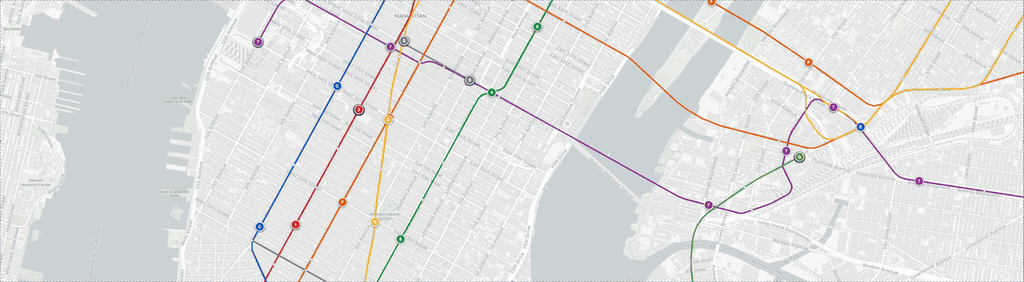
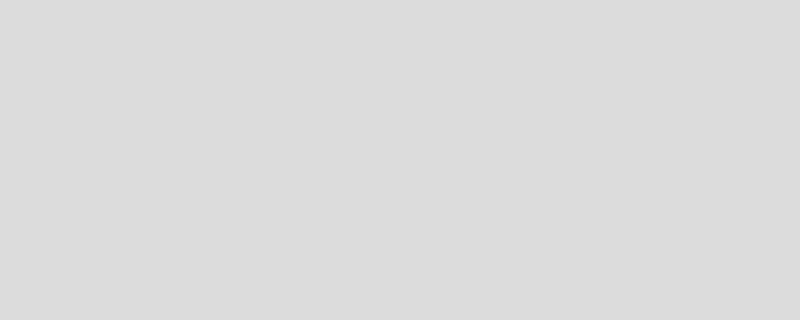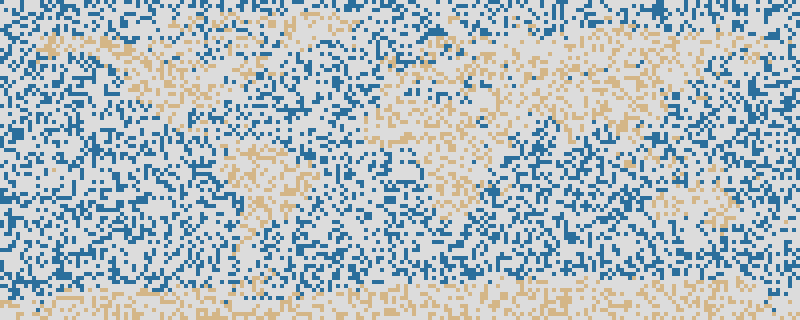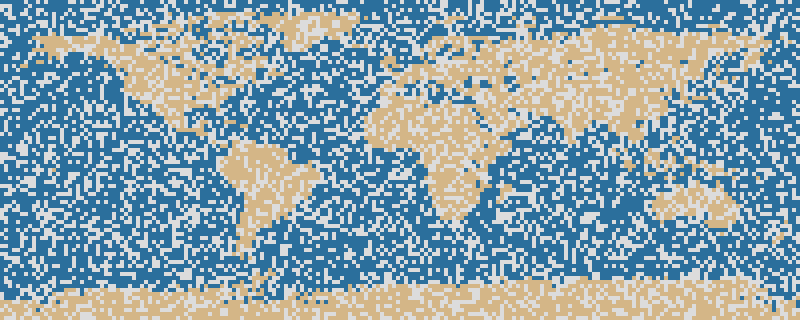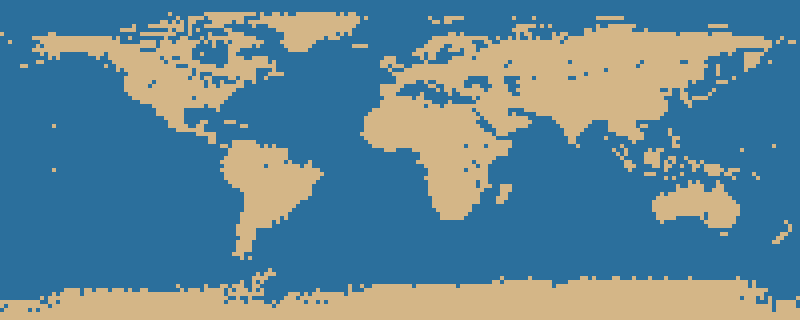
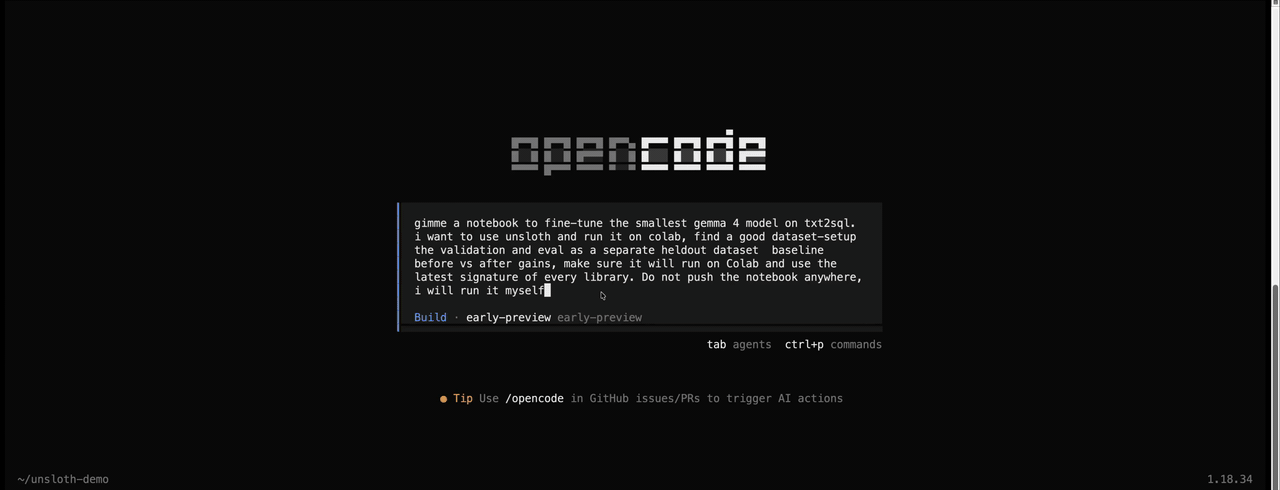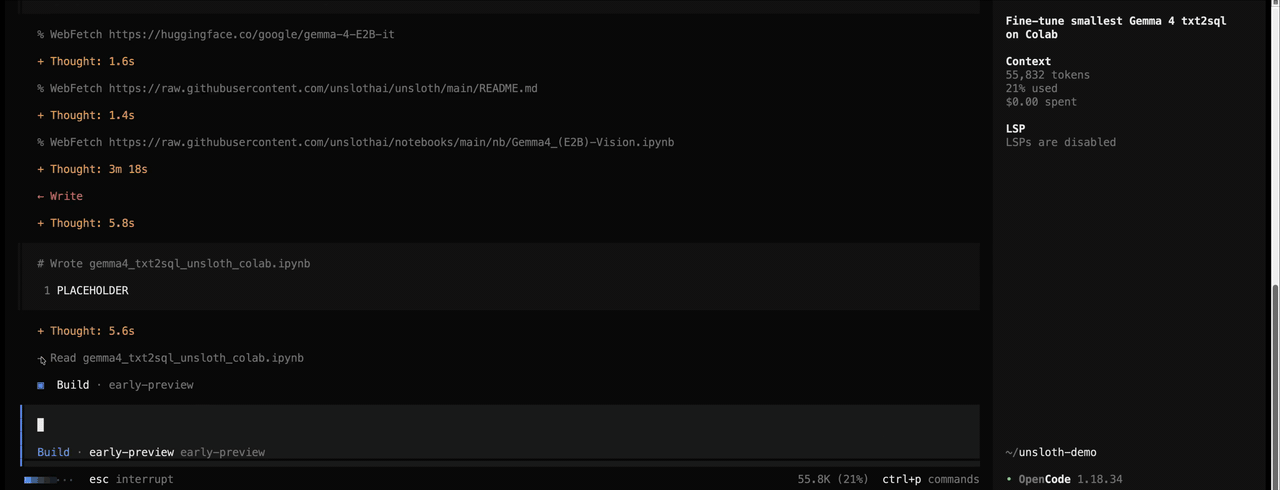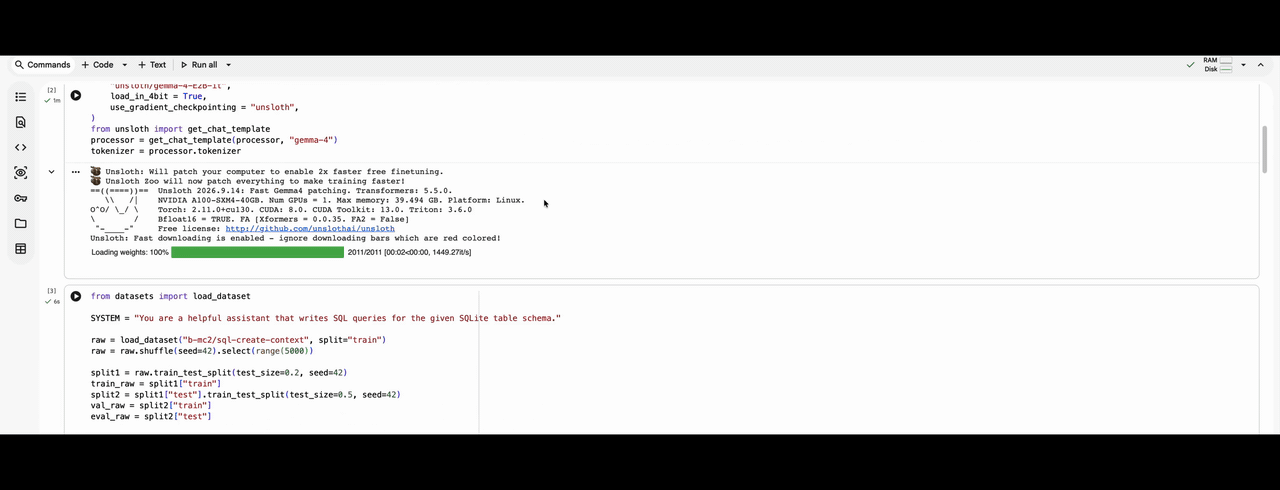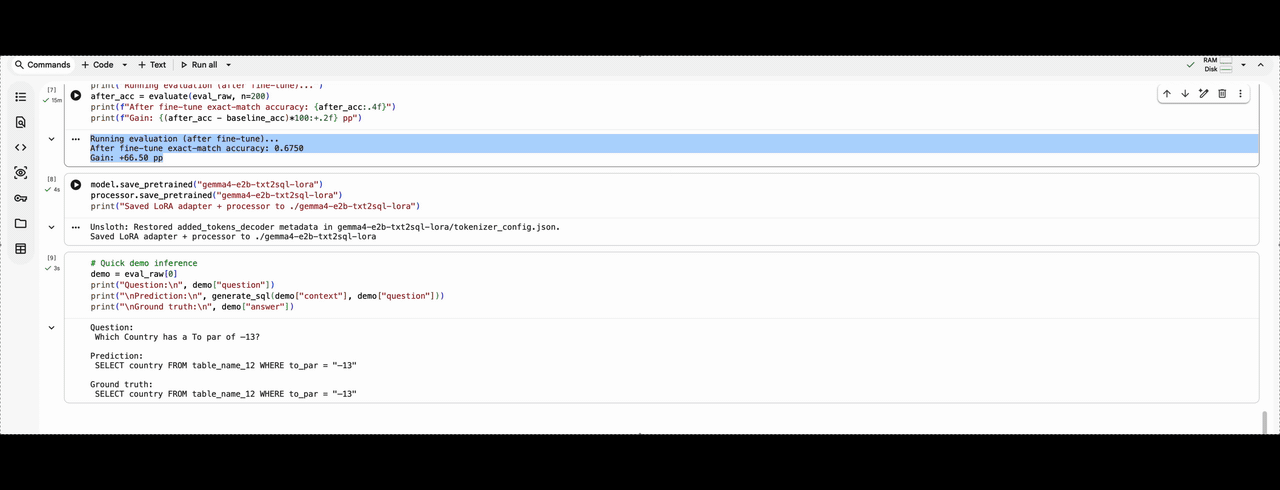
데모는 각 과제의 첫 요청과 결과, 사용자의 추가 지시를 함께 보여 준다고 합니다. 데모는 가능성을 보여 주는 사례이고, 같은 과제를 몇 번 시도해 몇 번 성공했는지 같은 수치는 없습니다.
100만 개의 강화학습 환경을 만드는 반복 큐레이션
대규모 강화학습에는 어렵고 품질이 좋은 과제가 많이 필요합니다. Reflection AI는 환경 100만 개 가까이를 주로 합성 데이터 파이프라인으로 만들고, 외부 업체 데이터와 오픈소스 자료로 보충했습니다. 과정은 세 단계를 반복합니다:
- 수집과 합성: 소프트웨어 엔지니어링, 터미널 사용, 경쟁 프로그래밍, STEM, 웹 검색, 도구 사용, 일반 지식 작업에서 환경을 만들거나 가져옵니다.
- 필터링: 모델이 항상 풀거나 절대 못 푸는 과제를 빼고, 설명이 부족하거나 오해를 부르거나 찍어서 맞힐 수 있거나 보상 해킹이 가능한 과제를 걸러 냅니다.
- 강화학습으로 시험: 실제로 학습에 넣어 보고 드러난 품질과 난이도 문제를 다음 수집과 필터링에 반영합니다.
블로그는 데이터 품질에서 타협하면 성능이 정체되거나 학습 문제가 생겼고, 과제 품질을 체계적으로 개선한 것이 끝까지 성능을 끌어올린 핵심이었다고 적었습니다.
평균 11만 개 롤아웃을 동시에 돌린 인프라
에이전트 강화학습은 롤아웃 생성, 도구 실행, 결과 평가, 모델 업데이트를 모두 대규모로 해야 합니다. Reflection AI는 이 과정들이 서로 독립적으로 돌면서 경험과 모델 업데이트만 주고받는 비동기 플랫폼을 만들었고, 학습 중 평균 11만 개의 롤아웃을 동시에 실행했습니다. 블로그가 꼽은 일곱 가지 기능과 수치는 다음과 같습니다:
| 기능 | 내용과 수치 |
|---|---|
| 완전 비동기 실행 | 에이전트가 롤아웃을 만드는 동안 트레이너가 학습하고 새 버전을 배포. 모든 토큰에 그 토큰을 만든 모델 버전을 기록해 정책 지연을 학습 알고리즘이 반영 |
| 유연한 연산 배분 | 추론 대 학습 GPU 비율을 3.9:1에서 5.4:1 사이로 조정. 학습 상태를 잃지 않고 트레이너를 다섯 가지 GPU 메시 구성으로 재구성 |
| 빠른 모델 업데이트 | 새 가중치가 추론 서버 전체에 도달하는 시간 중앙값 약 12초. 랙 사이는 RoCE, 랙 안은 NVLink로 계층 전달해 랙 간 트래픽 75% 감소, 전체 반영 속도 2.2배 |
| 추론 장애 대응 | 학습을 멈추지 않고 추론 장애 71건 처리. 복구 시간 중앙값 8분, 손실 용량은 서빙 GPU-분의 0.02% |
| 대규모 환경 | 동시 샌드박스 최대 17만 개. 클러스터 20개 이상, 클라우드 2곳, 리전 4곳에서 샌드박스 생성 요청 10억 건 이상 처리. 새 샌드박스의 90%가 10초 안에 준비 |
| 효율적인 트레이너 패킹 | 동적 패킹으로 학습 배치를 평균 99.99% 채움. 평균 롤아웃 길이가 약 70% 늘어나는 동안 GPU당 처리량 변화를 1.5% 안쪽으로 유지 |
| 관측성과 보상 무결성 | 토큰 단위 기록으로 매 단계 학습과 추론의 수치 일치를 점검. 별도 판정 모델이 통과한 답안을 검증기 악용 여부로 다시 검사하고, 기록을 재생해 보상을 감사 |
마지막 항목은 보상 해킹(Reward Hacking) 대응에 해당합니다. 검증기의 허점을 이용해 통과한 답안이 있는지 별도 판정 모델이 다시 확인합니다. 대규모 에이전트 강화학습 인프라를 공개한 다른 사례로는 prime-rl 0.6.0과 MAI-Thinking-1 기술 보고서가 있으니 함께 비교해 보셔도 좋습니다.
강화학습을 받쳐 주는 사전학습: 안정성과 데이터 품질
작은 모델로 확인한 스케일링 레시피
Reflection AI는 Beam을 만들기 전에 크기를 키워 가며 여러 모델을 사전학습해 스케일링 레시피를 검증했습니다. 성능을 예측할 수 있도록 모델 단계를 설계하고, 자체 코드와 웹 검증셋을 만들고, 모든 학습 데이터에서 검증셋과 겹치는 부분을 제거했다고 합니다. 블로그에 따르면 최종 Beam Base는 예측한 성능에 도달했습니다.
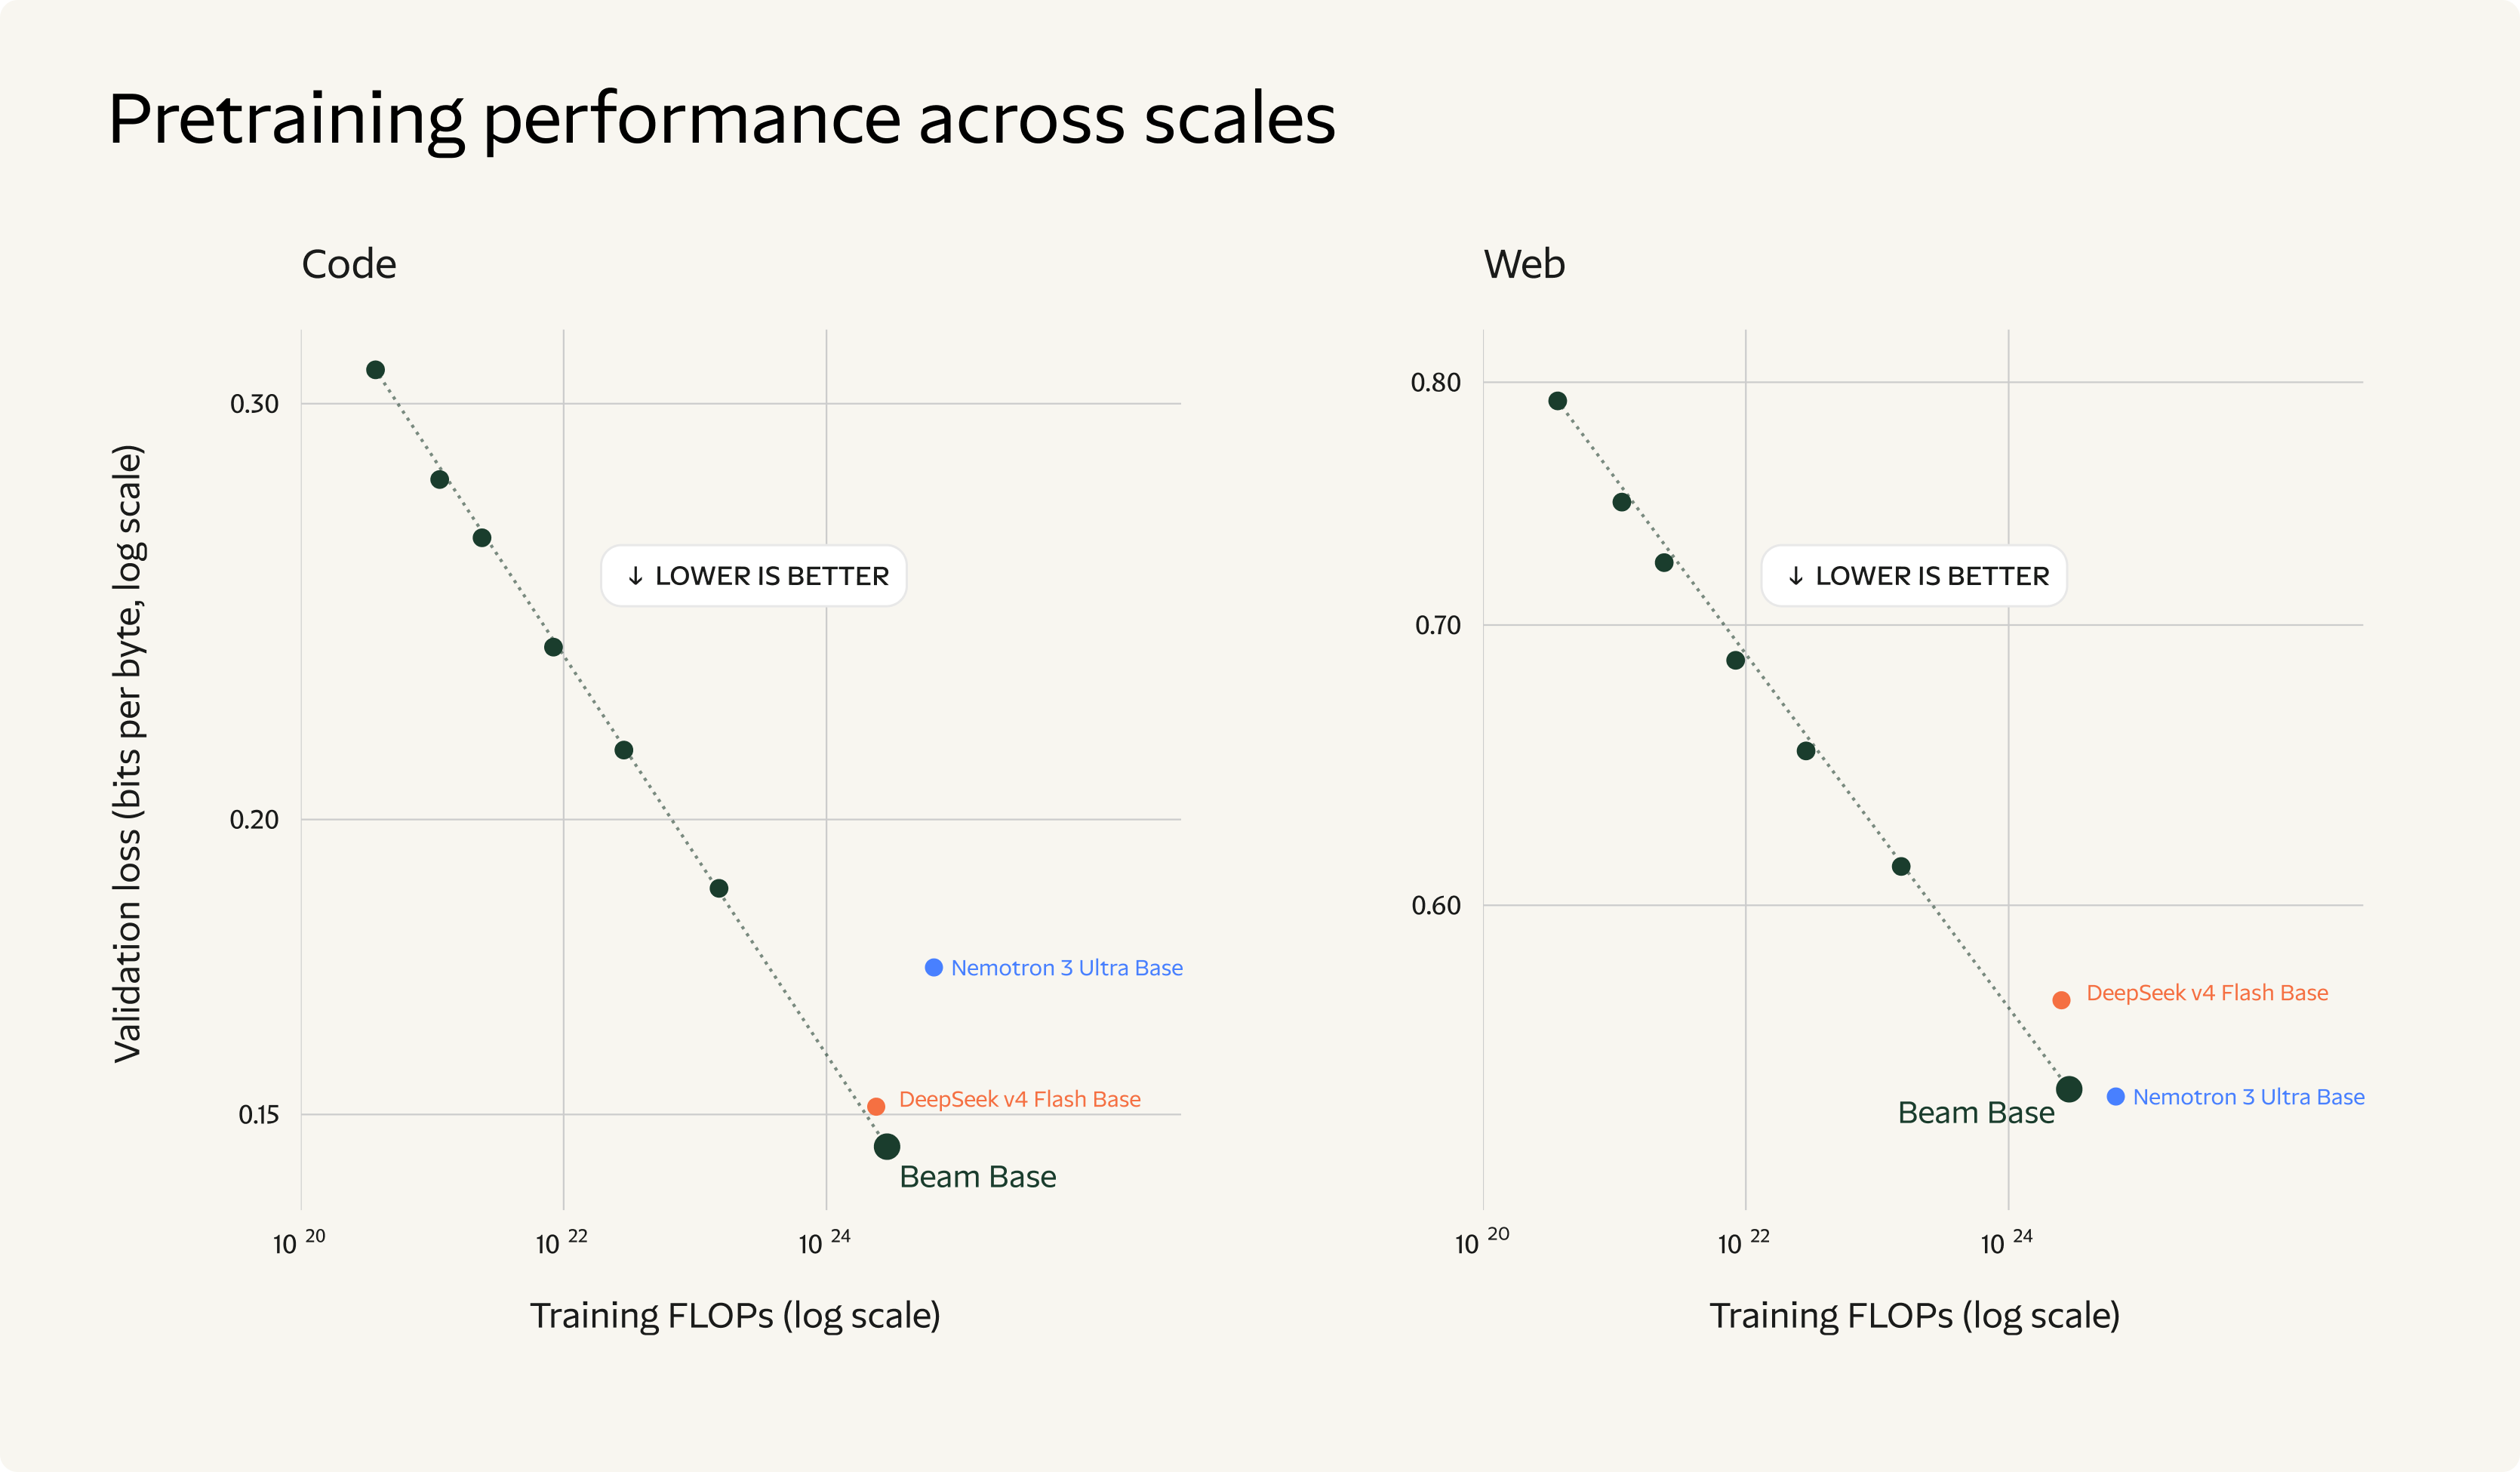
연산량 네 자릿수 범위에서 점들이 거의 직선 위에 놓입니다. 코드 검증 손실에서는 Beam Base가 DeepSeek V4 Flash Base와 Nemotron 3 Ultra Base보다 낮습니다. 웹 검증 손실에서는 Nemotron 3 Ultra Base가 Beam Base와 비슷하거나 조금 낮은 손실을 내지만, 연산량은 조금 더 많은 쪽에 찍혀 있습니다. 블로그는 이를 비교 가능한 오픈 베이스 모델 중 손실 대비 연산이 파레토 최적이라고 표현합니다. 검증셋은 Reflection AI가 직접 만든 것이라 다른 회사가 같은 조건에서 재현하려면 공개를 기다려야 합니다.
전문가를 고르게 쓰게 만든 부하 분산
MoE 모델은 일부 전문가에게만 토큰이 몰리면 나머지 전문가가 학습되지 않습니다. Beam의 출발점은 DeepSeek-V3가 채택한 보조 손실 없는 부하 분산(Auxiliary-Loss-Free Load Balancing) 입니다. 이 방식은 2024년 8월 논문에서 제안되었고, 발표 블로그는 DeepSeek-V3 기술 보고서를 출처로 인용합니다. Beam은 여기에 두 가지를 더했습니다. 하나는 전문가 편향(Bias) 업데이트 폭을 코사인 스케줄로 줄여 학습 후반의 라우팅 흔들림을 줄인 것입니다. 다른 하나는 시퀀스 단위 부하 분산으로, 사전학습 분포 밖의 데이터에서도 전문가를 고르게 쓰게 해 분포가 바뀌는 강화학습 단계를 대비한 것입니다.

 보조 손실 없는 부하 분산에 관련해서는 다음 기술 보고서(DeepSeek-V3 Technical Report)를 참고해주세요:
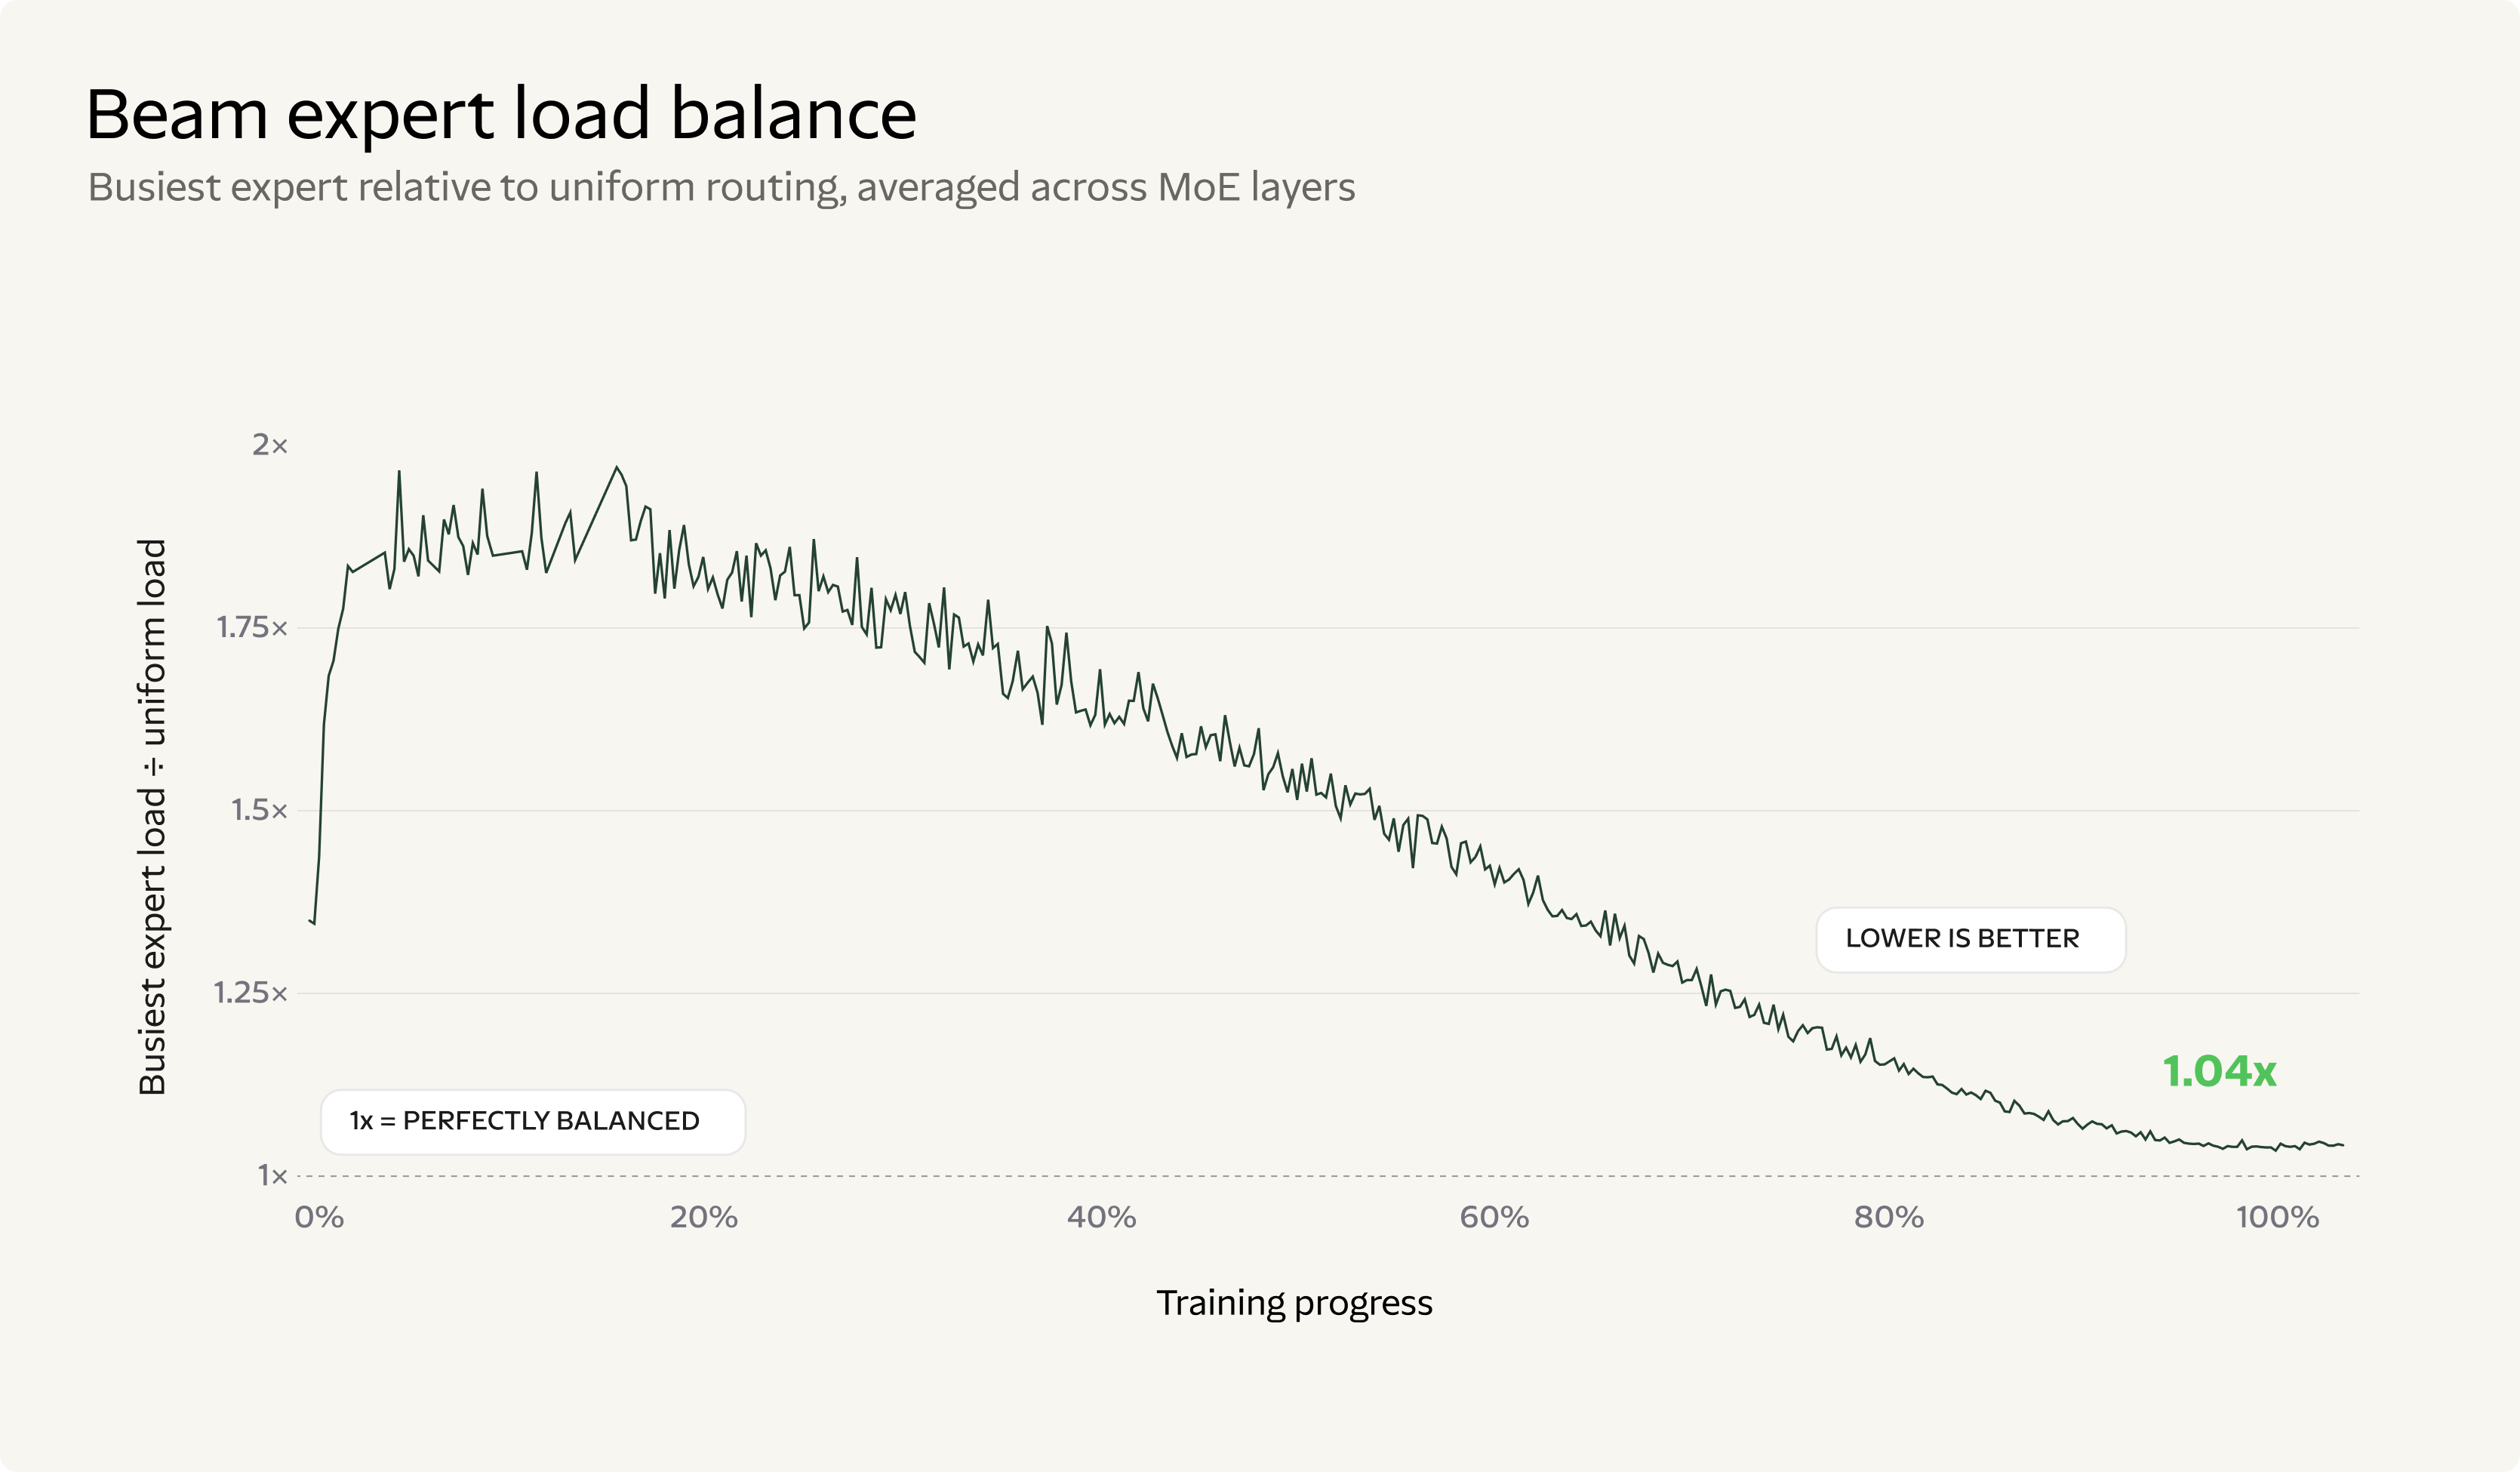
가장 바쁜 전문가의 부하는 학습 초반 균등 부하의 약 1.9배까지 올라갔다가, 사전학습이 끝날 때 MoE 층 평균 1.04배로 내려왔습니다. 1배가 완전 균등이므로, 사전학습이 끝난 시점에는 거의 모든 전문가가 비슷한 양의 토큰을 처리합니다.
잔차 스트림이 깊이에 따라 커지지 않게
층을 지날 때마다 서브레이어 출력이 더해지는 잔차 스트림(Residual Stream) 은 모델이 깊어질수록 값이 커지기 쉽습니다. Beam은 깊이에 따라 스케일을 조정해 이 증가를 상쇄하는 방법을 직접 개발했고, 여기에 SandwichNorm, 원소 단위 어텐션 게이팅(Elementwise Attention Gating), FP32 잔차 누적을 더했습니다. FP32 누적은 잔차에 작은 값을 더할 때 생기는 반올림 오차를 줄이기 위한 것입니다.
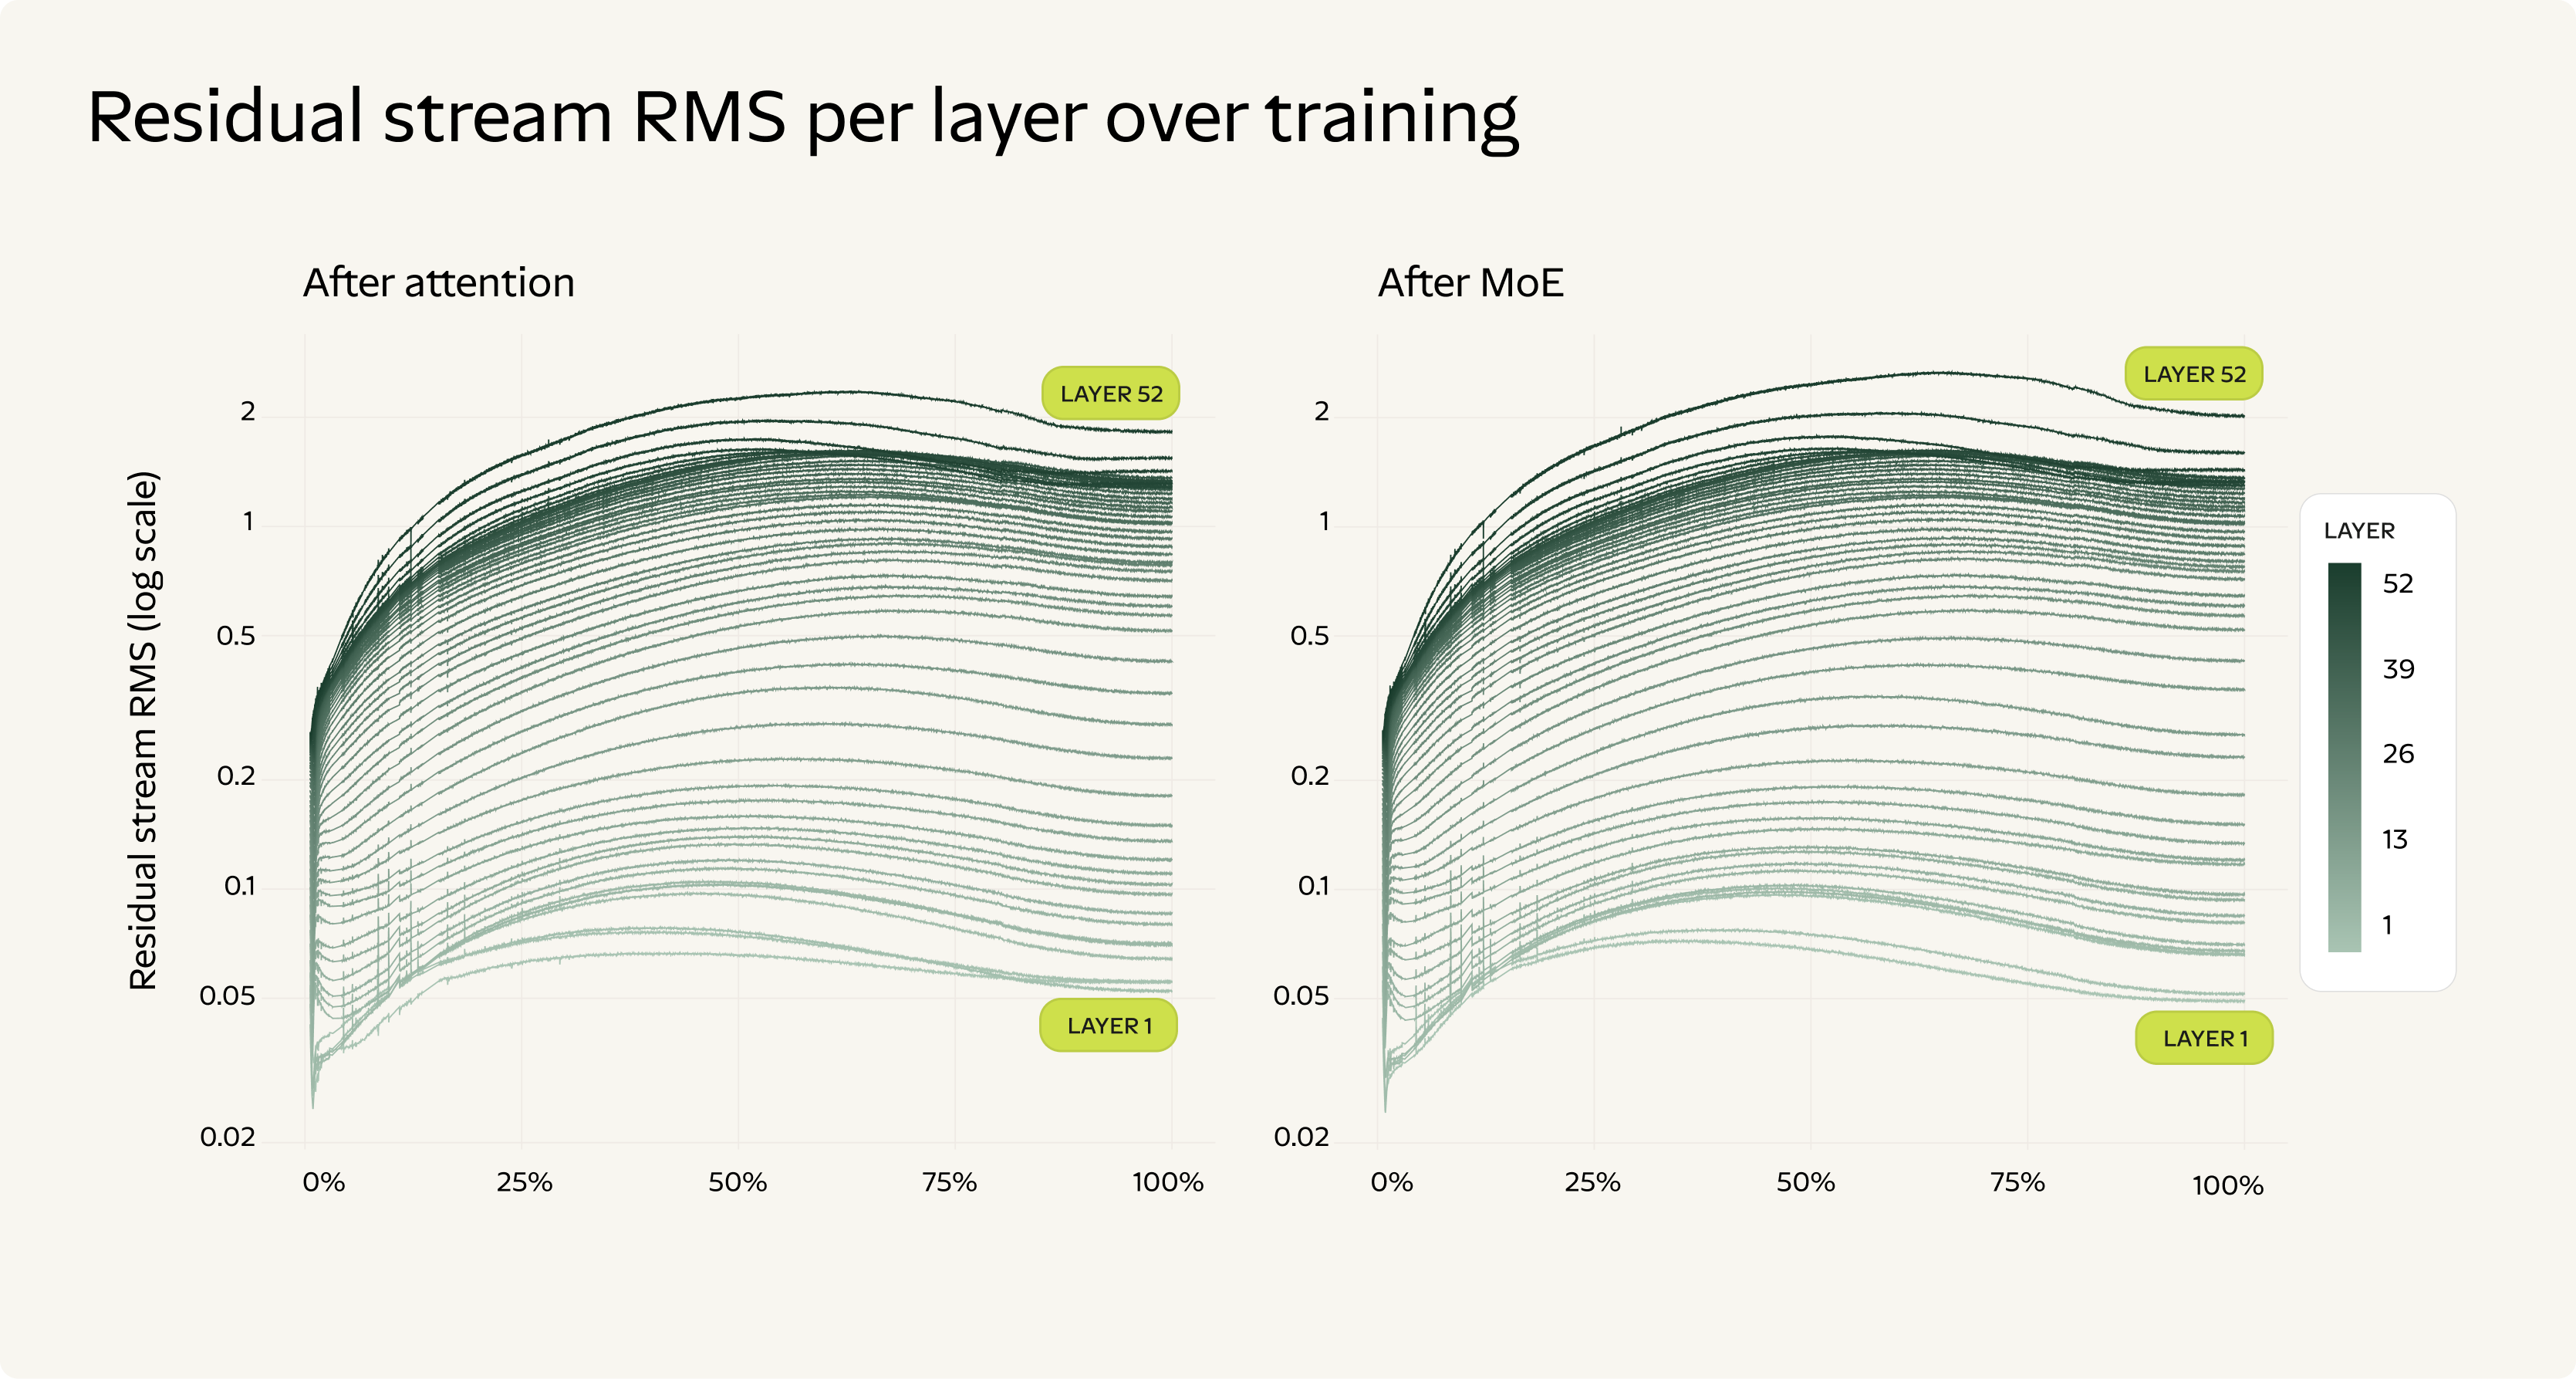
52개 층 모두에서 잔차 스트림의 RMS가 깊이에 따라 매끄럽게 달라질 뿐, 지속적으로 커지지 않습니다. 블로그는 이 안정성이 사전학습뿐 아니라 강화학습과 정렬 단계까지 유지되었다고 적었습니다.
웹 토큰의 95%를 버리고 1.8T를 되살린 데이터 큐레이션
Beam은 웹, 공개 자료, 라이선스를 받은 독점 데이터셋에서 모은 23.8T 토큰으로 사전학습했습니다. 웹에 공개되어 있고 라이선스 제약이 없는 코드와 코드 문서는 거의 전부 학습에 넣었다고 합니다.
웹, 코드, STEM 콘텐츠마다 품질 분류기를 직접 학습해 데이터를 세밀한 품질 등급으로 나누고, 품질이 높은 쪽에 더 많은 비중을 두었습니다. 원시 인터넷 토큰의 약 95%는 파싱, 중복 제거, 큐레이션 과정에서 제거됩니다. 한편 Reflection AI는 기존 웹 필터를 썼다면 약 1.8T의 고품질 토큰을 놓쳤을 것이라고 보고하며, 그중에는 자체 큐레이션한 웹 코드 토큰의 87%가 포함됩니다.
코드는 언어마다 필터를 따로 조정하고, 자동 생성된 저품질 코드와 학습할 수 없는 콘텐츠를 제거했습니다. 손상된 콘텐츠나 학습 안정성을 해칠 수 있는 코드를 찾는 분류기도 학습했고, 지나치게 많은 언어와 파일 형식은 비중을 낮췄습니다. STEM 지식을 위해서는 비전-언어 OCR 모델과 자체 품질 분류기를 결합한 PDF 처리 파이프라인을 수천 개 GPU에서 돌려 페타바이트 단위의 기술 문서를 처리했습니다. 코드와 기술 문서는 학습 중 여러 번 반복해 노출했고, 반복이 일반화를 해치지 않도록 퍼지 중복 제거와 패킹 알고리즘에 신경 썼다고 합니다.
4주 미만의 사전학습과 92.3% 굿풋
사전학습은 NVIDIA GB300 NVL72 6,144개 GPU 클러스터에서 처음부터 끝까지 4주가 안 걸렸습니다. Reflection AI는 인프라 대부분을 자체 개발했다고 밝혔습니다. 토폴로지를 고려하는 Kubernetes 기반 스케줄러, 노드 상태를 계속 감시하는 노드 수명주기 시스템, 반자동으로 되감고 재시작하는 무음 데이터 손상(Silent Data Corruption, SDC) 탐지 시스템이 여기에 포함됩니다.
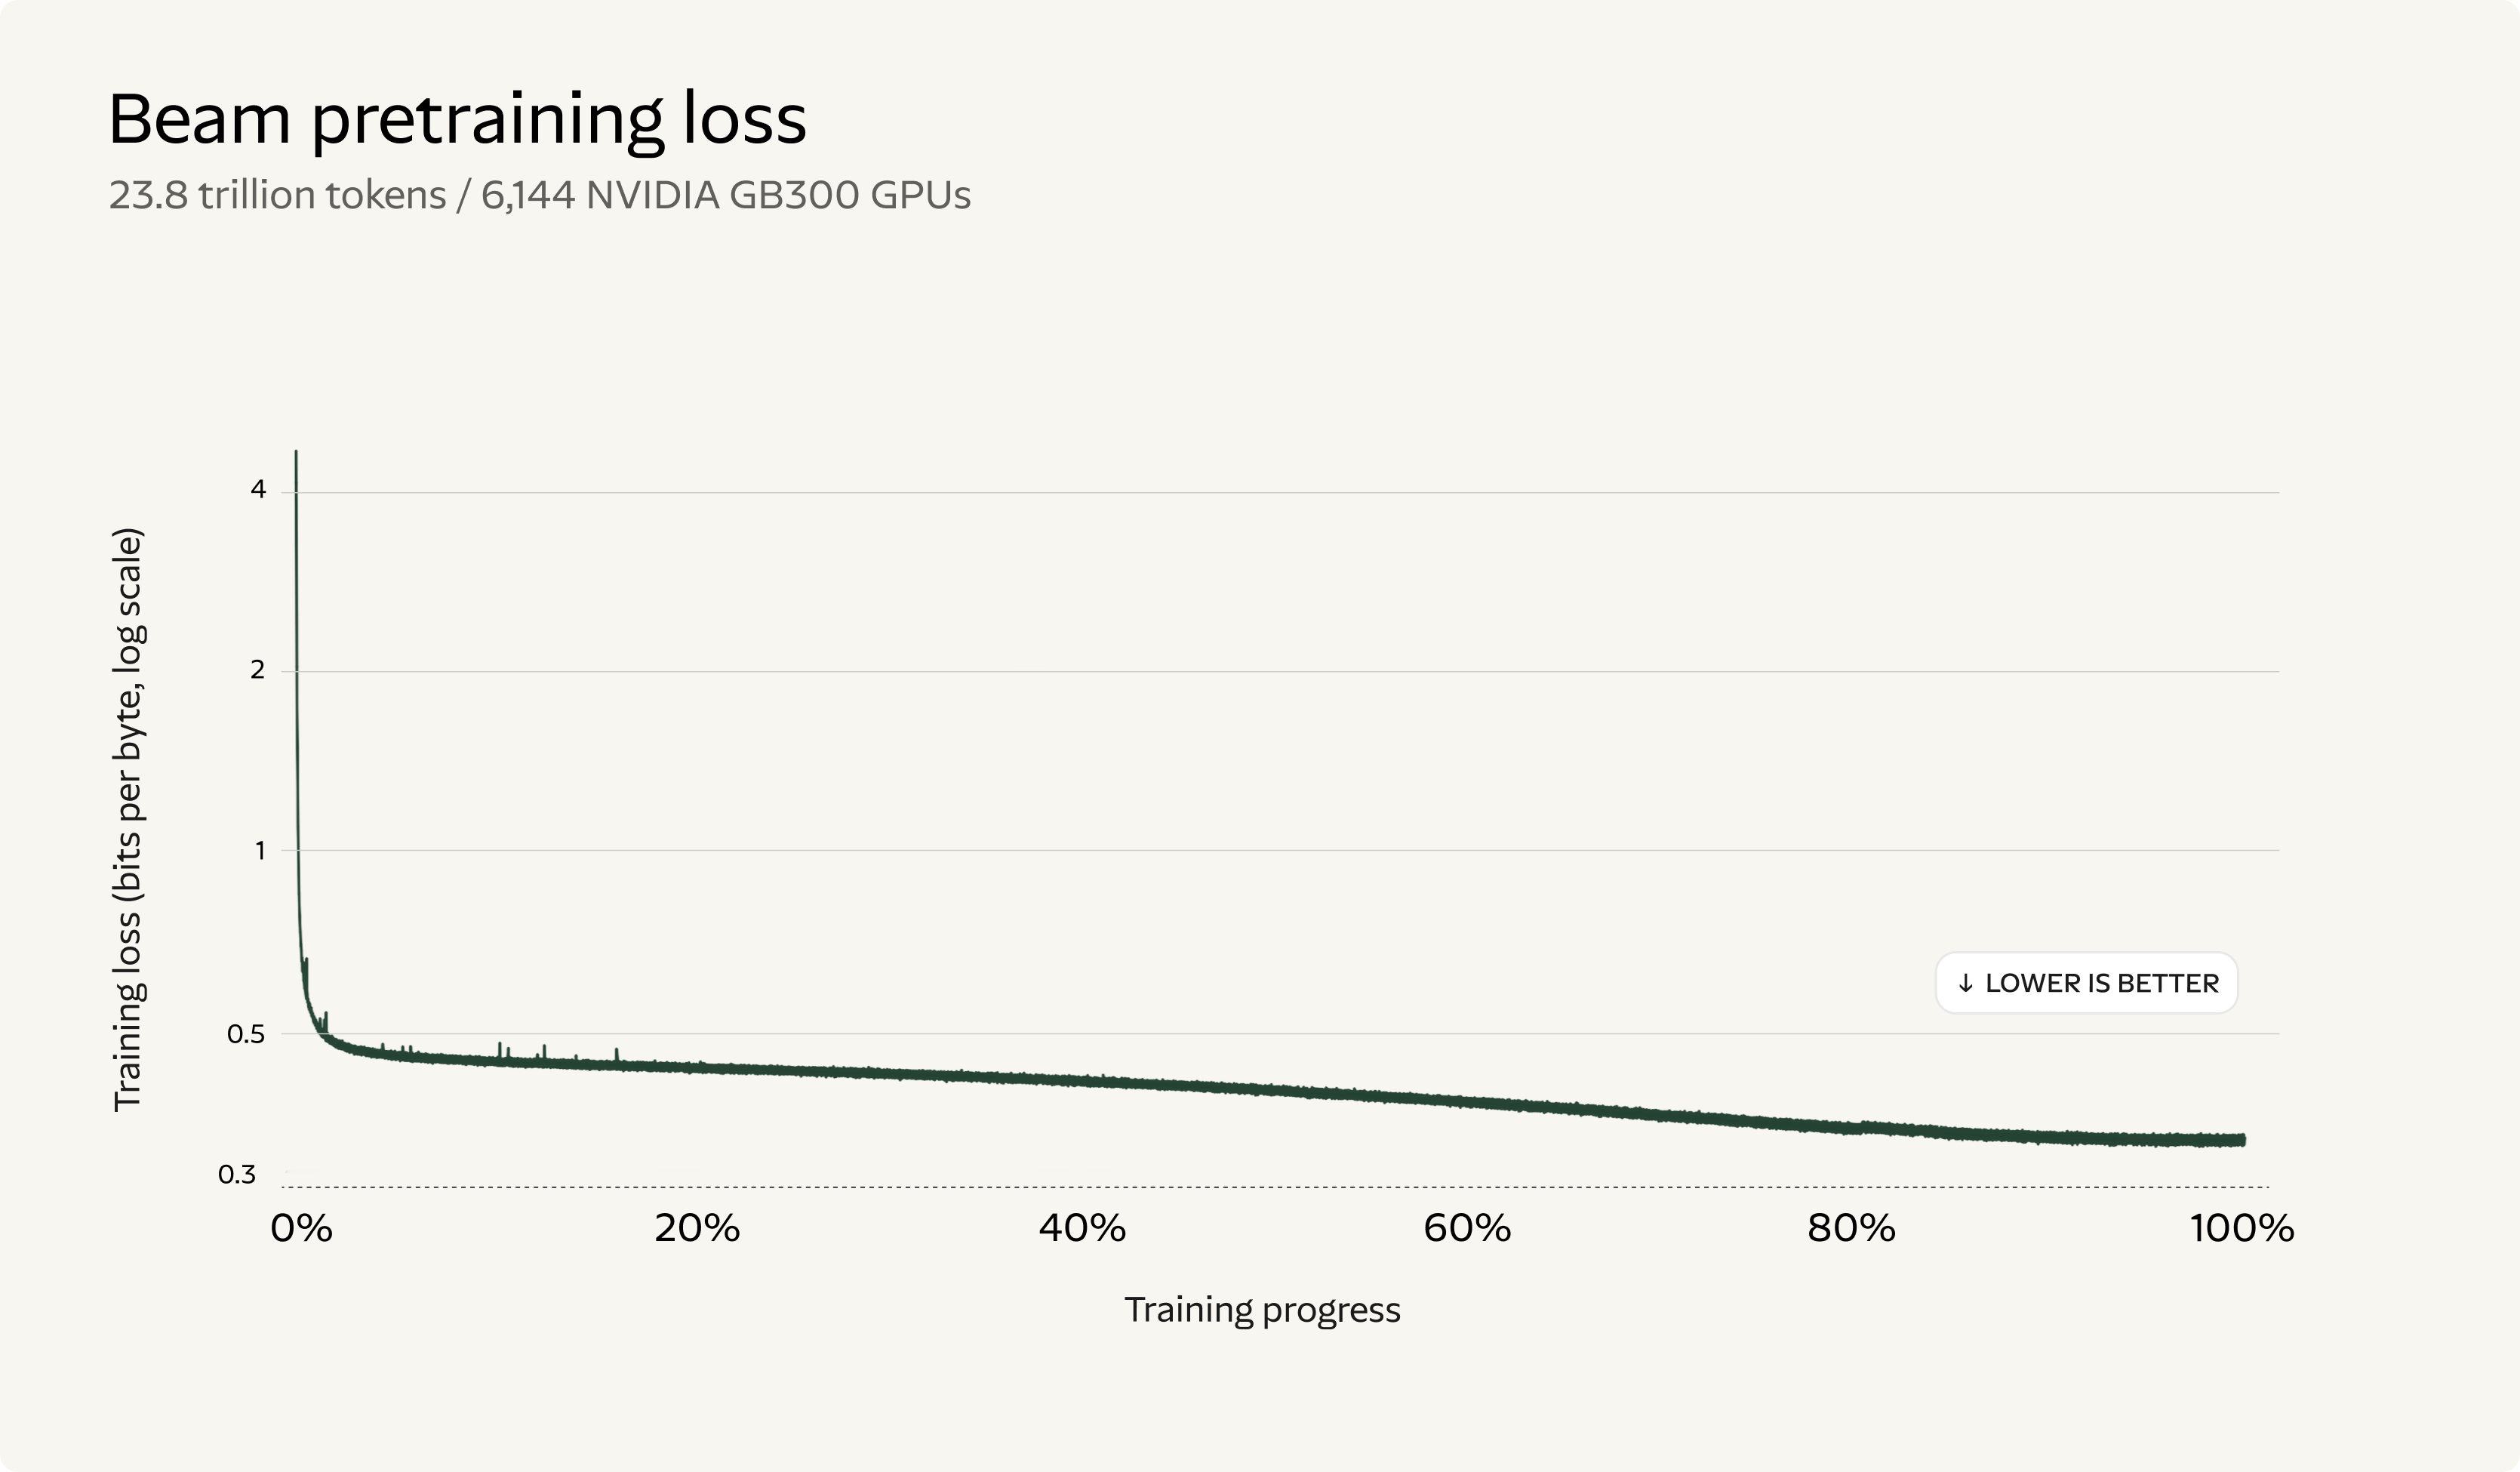
전체 학습 동안 반자동 되감기는 아홉 번 있었고, 원인은 비결정적인 그래디언트 노름 스파이크 또는 SDC 의심이었습니다. 최종 모델에 남은 학습 단계에 쓰인 시간의 비율인 굿풋(Goodput) 은 체크포인트, 장애 탐지, 노드 상태 관리를 개선한 끝에 학습 후반 92.3%에 이르렀습니다.
강화학습을 위한 출발점을 만드는 미드트레이닝
미드트레이닝(Midtraining)은 고연산 강화학습의 기반을 만드는 단계로 설계했습니다. 실제 과제에서 고른 예시를 변형하고 결합하고 확장해, 원시 데이터만으로는 배우기 어려운 능력을 가르치는 학습 데이터로 만드는 다단계 파이프라인을 썼습니다. 긴 논리 사슬을 담은 추론 문서도 여기에 포함됩니다. 유효 컨텍스트를 1M 토큰으로 늘린 것도 이 단계이며, 코드 저장소, 장기 과제, 긴 문서를 섞어 긴 시퀀스에서 관련 정보를 찾고 연결하도록 학습했습니다.
안전과 정렬: 두 교사 모델을 하나로 합치기
안전과 정렬을 위해 Reflection AI는 사전학습 체크포인트에서 두 번째 모델을 따로 학습했습니다. 모델이 따라야 할 원칙을 겨냥한 데이터로 별도의 SFT와 강화학습을 거친 모델입니다. 그다음 대규모 강화학습 교사와 안전 및 정렬 교사의 능력을 다중 교사 온-정책 증류(Multi-Teacher On-Policy Distillation, MOPD) 로 합쳤습니다.
Beam의 원칙은 세 단계로 나뉩니다:
어겨서는 안 되는 규칙: 안전 정책을 따르고, AI 에이전트라는 정체성을 유지합니다.
항상 지켜야 하는 성질: 주어진 컨텍스트를 활용하고, 정확하게 주장하고, 불확실성을 인정하고, 사용자의 요청을 투명하게 따릅니다.
기본 대화 스타일: 직접적이고, 꼼꼼하고, 효율적이며, 사용자가 다음에 필요로 할 것을 먼저 예상합니다.
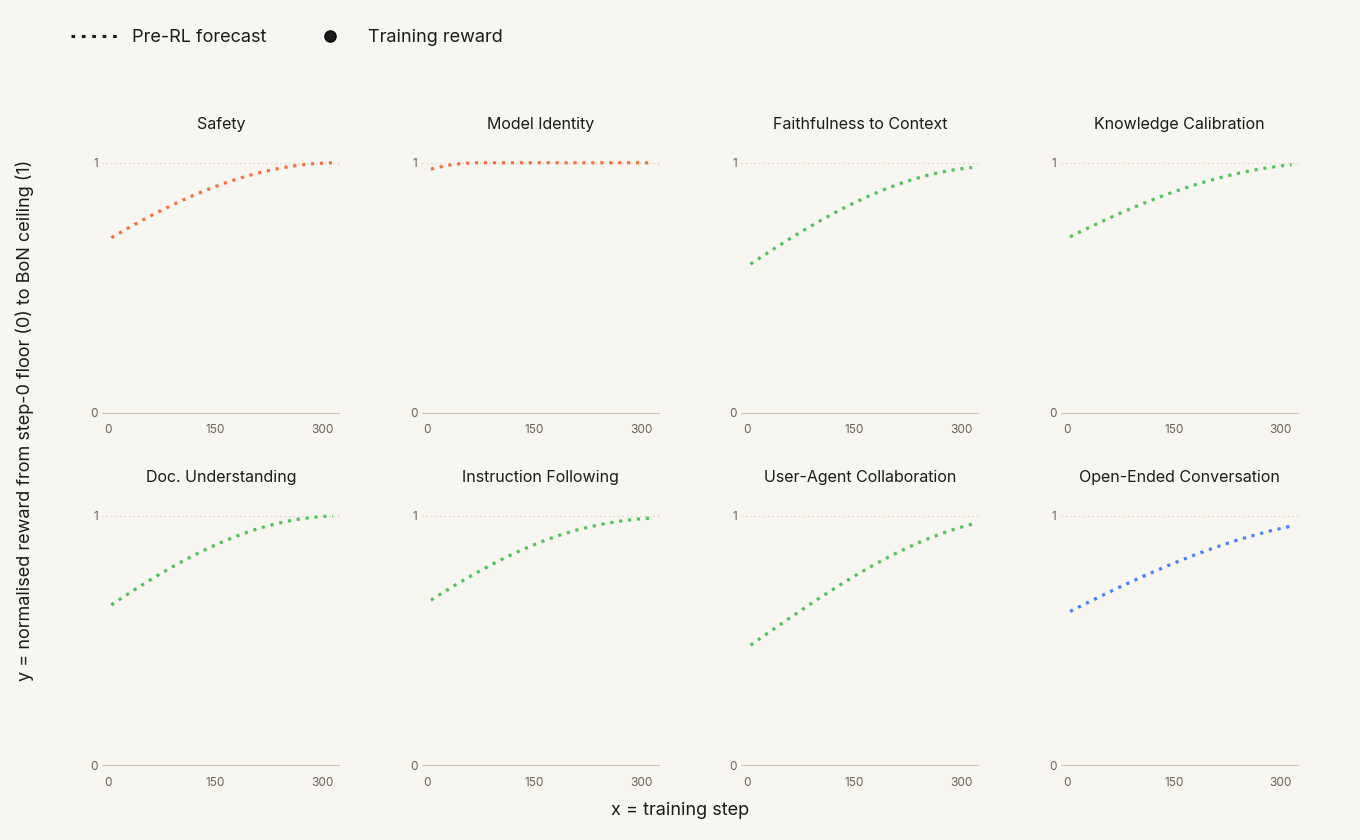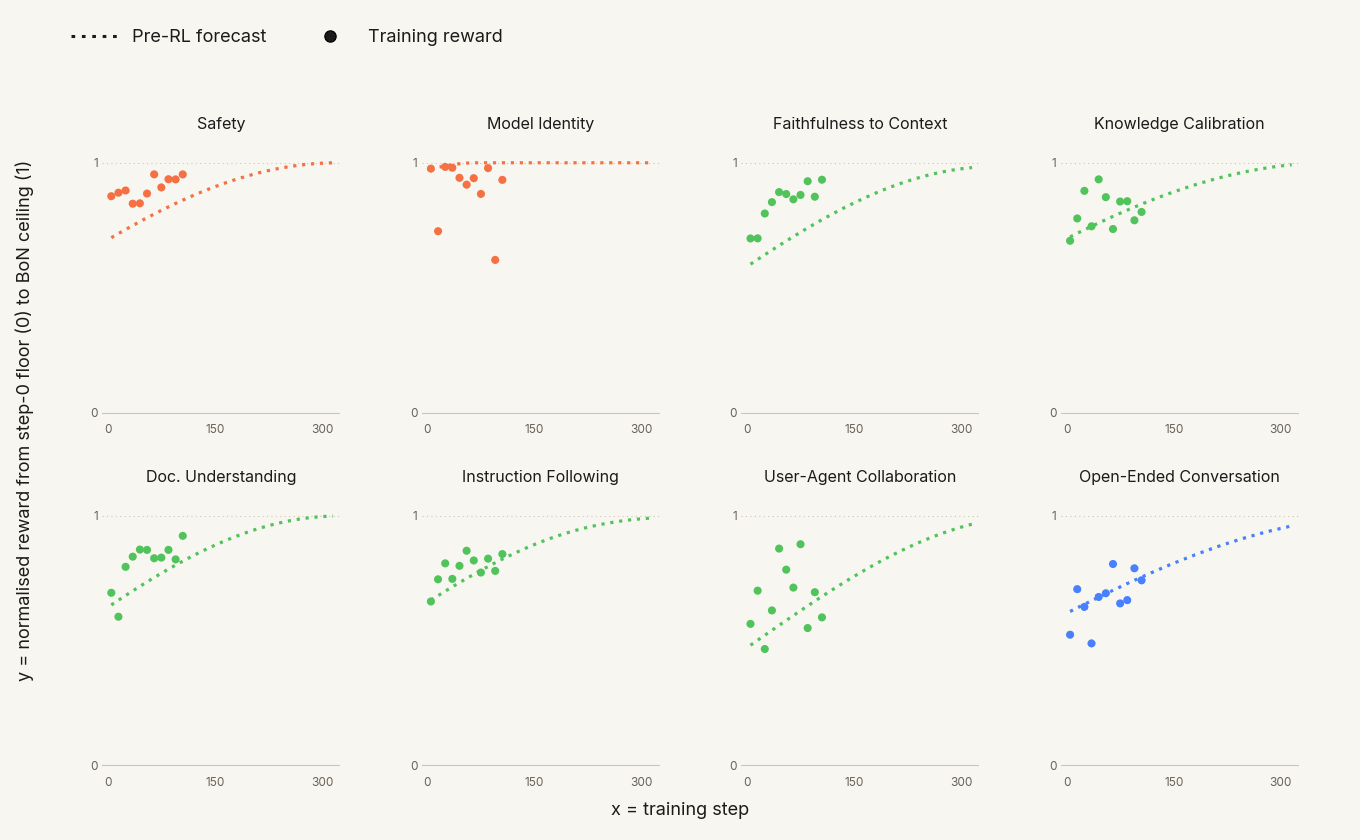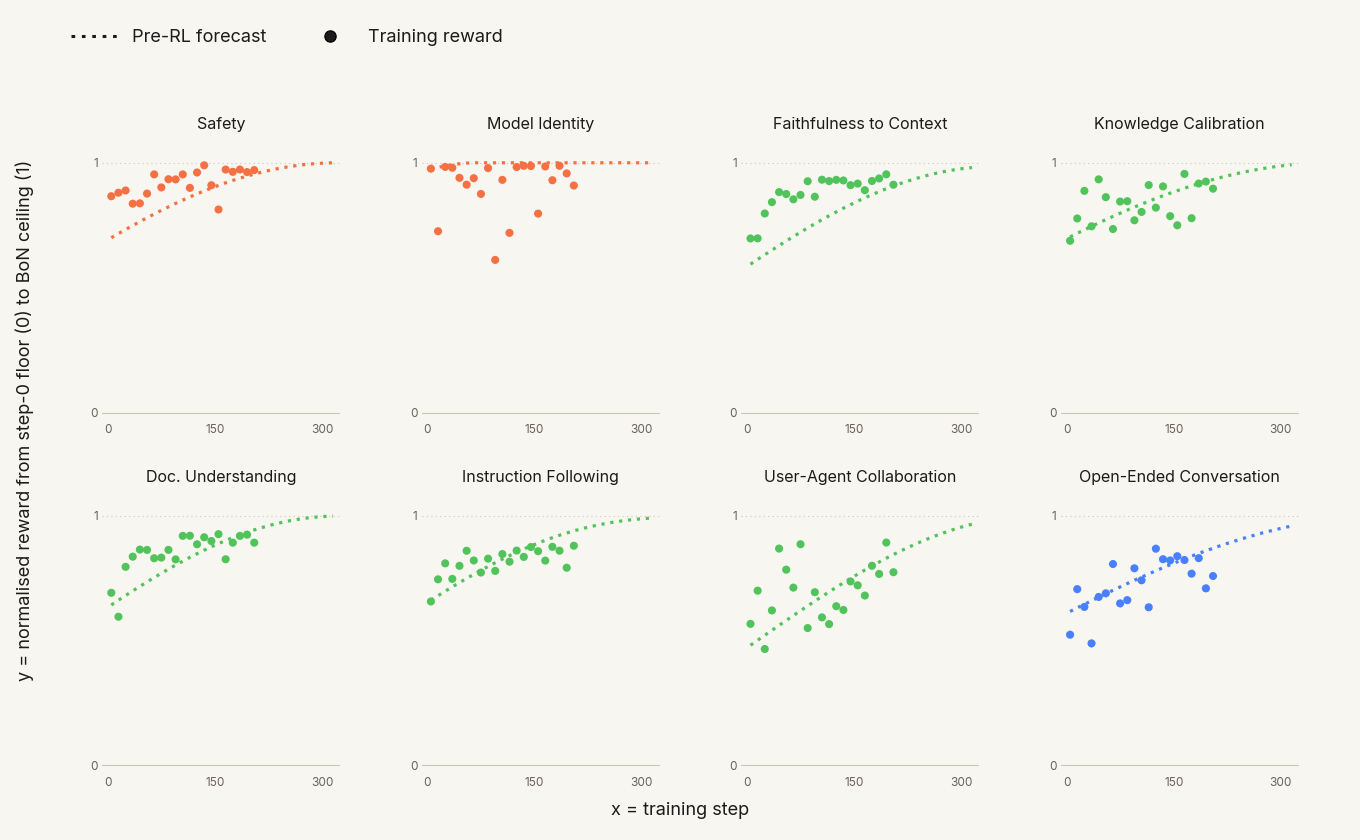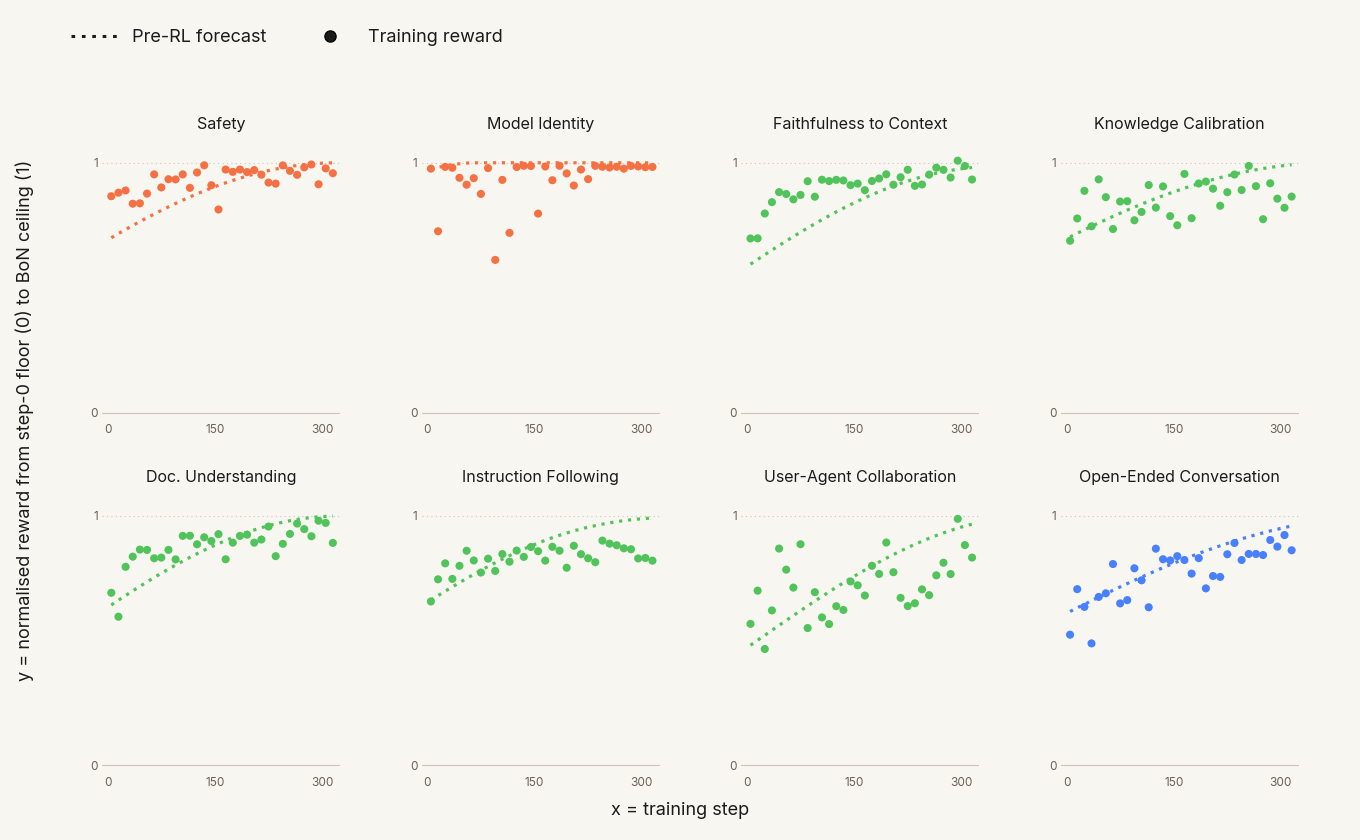
정렬 단계의 강화학습 환경 중 상당수는 정답을 기계적으로 확인할 수 없어 생성형 보상 모델이 판정했습니다. 그런데도 Reflection AI는 강화학습 전에 보상이 어떻게 오를지를 예측할 수 있었다고 보고합니다. 예측과 실제 결과의 상관계수가 r = 0.79로, Best-of-N 상한만 썼을 때의 r = 0.46보다 높았습니다. 이 예측 덕분에 루브릭과 보상 설계를 반복해 개선하고, 환각(Hallucination)과 과도한 서식 같은 행동을 줄일 수 있었다고 합니다. 위 그림에서는 영역마다 예측이 맞는 정도가 다릅니다. 모델 정체성은 처음부터 상한 가까이에 있고, 사용자-에이전트 협업은 점들의 흩어짐이 큽니다.
안전 학습에는 숙의적 정렬(Deliberative Alignment) 기법을 써서 안전 정책을 모델의 추론 과정 안에 넣었습니다. 데이터셋은 적대적으로 반복해 만들었습니다. 매 회차마다 모델을 학습하고, 그 모델에서 해로운 응답이나 과도한 거절을 끌어내는 프롬프트를 만들고, 성공한 공격을 다음 회차의 SFT 데이터에 넣는 방식입니다. 안전 강화학습에는 단일 턴, 멀티 턴, 탈옥(Jailbreak), 그리고 시뮬레이션된 공격자가 도구를 쓰는 모델에게 위험한 행동을 압박하는 에이전트 시나리오를 함께 넣어, 과도한 거절과 해로운 순응을 동시에 줄이려 했습니다.
숙의적 정렬에 관련해서는 다음 논문(Deliberative Alignment: Reasoning Enables Safer Language Models)을 참고해주세요:
안전 평가 결과는 이번 발표에 없습니다. Reflection AI는 결과를 기술 보고서에 싣고, 내부에서 만든 안전 평가를 오픈소스로 공개해 오픈 생태계가 함께 쓰는 기준으로 만들겠다고 밝혔습니다. 블로그 첫머리에서 Beam이 최종 레드팀(Red-Teaming) 테스트와 평가를 진행 중이라고 적은 만큼, 공개 시점의 모델이 이번 발표의 수치와 같을지도 확인이 필요합니다.
가중치 공개 전에 확인할 것과 아직 확인할 수 없는 것
Reflection AI가 약속한 공개 범위는 넓습니다. 이번 달 안에 Apache 2.0 가중치, 문서, 실행과 평가와 파인튜닝을 위한 전체 스택을 내놓고, 배포 파트너와 여러 오픈소스 라이브러리 및 하네스 통합을 함께 발표하겠다고 했습니다. Beam은 시리즈의 첫 모델이고, 다음 모델은 이미 학습 중이라고 합니다. 2026년 10월 7일 기준으로 Hugging Face에서 Reflection AI의 Beam 가중치는 찾을 수 없었습니다.
공개 전까지는 다음 질문에 답할 자료가 없습니다:
- 아키텍처 세부: 전문가 수와 활성 전문가 수, 로컬과 글로벌 어텐션의 비율과 창 크기, 깊이 기반 잔차 스케일링의 식은 블로그에 없습니다.
- 비동기 강화학습 알고리즘: 하루 지난 데이터로도 안정적이었다는 "새 알고리즘"의 내용이 빠져 있습니다.
- 평가 조건: Beam의 점수를 어떤 하네스와 추론 강도로 쟀는지, 외부 자료에서 가져온 다른 모델 점수와 조건이 같은지 알 수 없습니다.
- 안전 평가 결과: 기술 보고서에서 공개한다고만 밝혔습니다.
- 실제 서빙 비용: 501B 가중치를 올리는 데 필요한 메모리, 지원 추론 엔진, 양자화(Quantization) 버전 여부는 발표에 없습니다.
가중치를 직접 운영할 계획이라면, 공개 후 모델 카드에서 위 항목과 함께 1M 컨텍스트에서의 실제 성능과 추론 강도별 토큰 사용량을 먼저 확인해 보시기를 권합니다. 특히 추론 효율 주장은 프리필과 어텐션을 뺀 추정치이므로, 입력이 긴 에이전트 워크로드에서는 직접 측정해야 비용을 비교할 수 있습니다.
 Introducing Beam: Reflection's 501B open-weight model 소개 블로그
 Reflection 플랫폼 (Beam 얼리 액세스 신청)
더 읽어보기
-
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄이고 플래그십 V4-Pro를 대체하는 552B 규모의 MoE 모델
-
Z.AI, 장기 실행 과제(Long-Horizon)에 특화된 1M 컨텍스트 오픈소스 모델 GLM-5.2 출시
-
Qwen, Max 계열 최초로 가중치를 공개하는 2.4T 규모 플래그십 모델 Qwen3.8-Max 출시 및 공개 예정
-
1조 파라미터 규모로 에이전틱 강화학습을 수행하는 prime-rl 0.6.0의 최적화 총정리 (feat. Prime Intellect)
-
MAI-Thinking-1 기술 보고서: 데이터 파이프라인부터 RL 인프라까지, 프런티어 모델 학습의 전 과정을 해부한 '힐 클라이밍 머신' (feat. Microsoft AI)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
