핵심 요약
- NVIDIA와 EPFL 연구진이 NVIDIA 기술 블로그 글에서 원자간 포텐셜 모델 PET의 FP32 행렬 곱을 Tensor Core로 돌린 결과를 공개했습니다. 방법은 FP32를 낮은 정밀도 조각으로 나눠 계산하는 BF16x9와 TF32x3입니다.
- B300에서 BF16x9는 분자 동역학(MD) 한 스텝을 최대 1.7배, A100에서 TF32x3는 최대 1.5배 빠르게 했습니다. 모델 재학습과 구조 변경은 없었습니다.
- 일반 TF32(1회 곱)는 더 빨랐지만 에너지가 표류했고, 구조 이완이 수렴하지 못했습니다. TF32x3는 같은 시험에서 FP32와 비슷하게 동작했습니다.
- BF16x9는 연산 능력(compute capability) 10.0과 10.3인 GPU(B200, GB200, B300, GB300)에서만 실제로 가속됩니다. PyTorch 2.15부터는
torch.backends.cuda.matmul.fp32_precision = "bfx9"한 줄로 켤 수 있습니다.
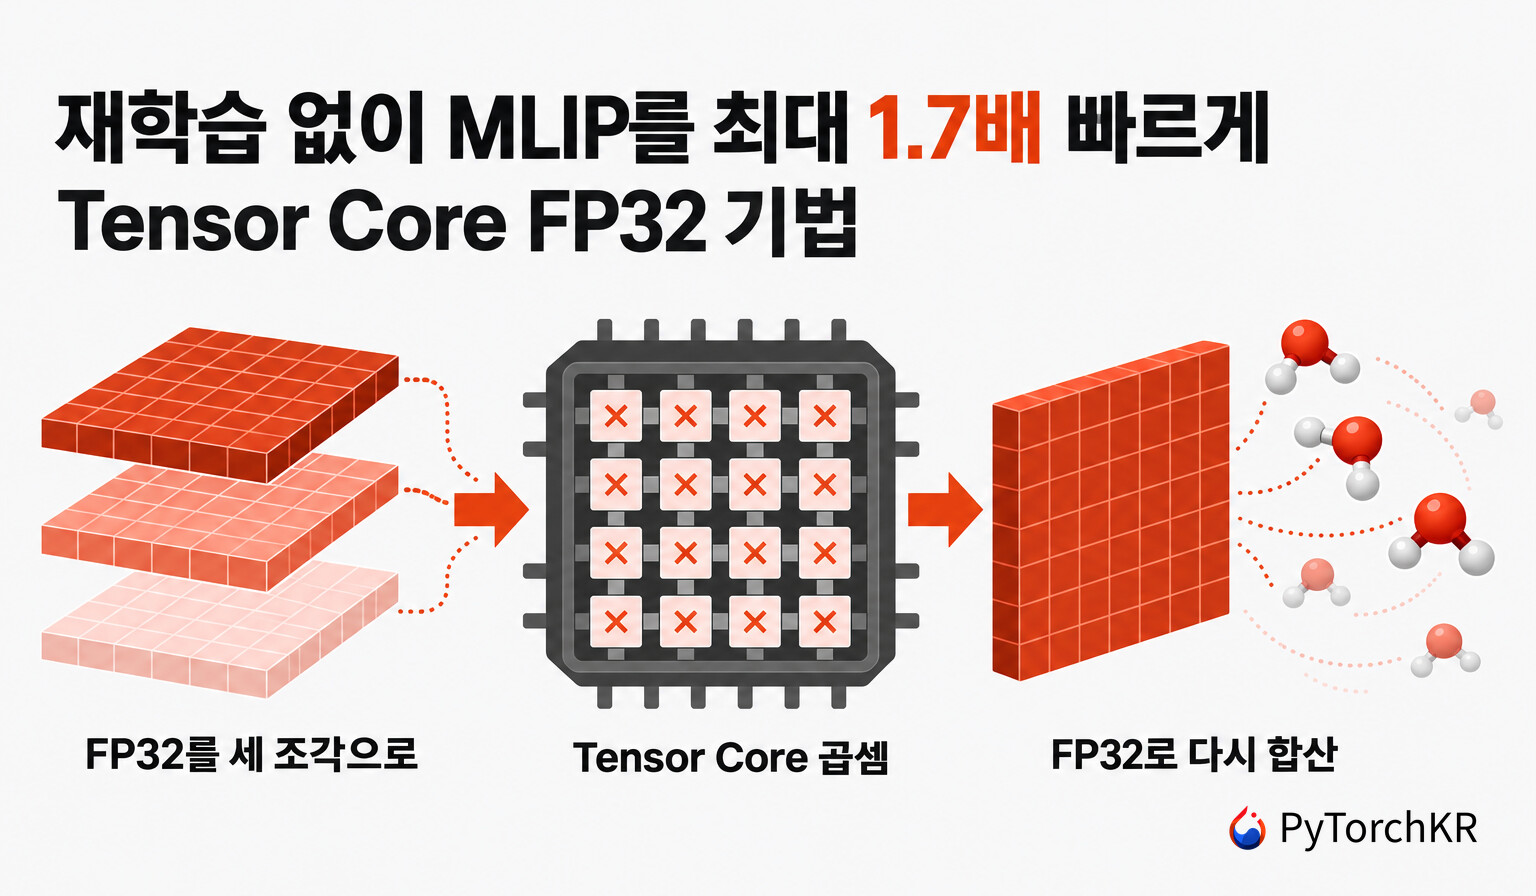
Tensor Core FP32 기법 소개
머신러닝 원자간 포텐셜(Machine Learning Interatomic Potential, MLIP) 은 원자 배치를 입력받아 에너지와 원자에 걸리는 힘을 예측하는 신경망입니다. 밀도 범함수 이론(Density Functional Theory, DFT) 같은 양자역학 계산은 정확하지만 비싸서 큰 계나 긴 시뮬레이션에 쓰기 어렵습니다. 고전적인 원자간 포텐셜은 빠르지만 함수 형태가 고정되어 있어 여러 원자 환경에 두루 맞추기 어렵습니다. MLIP는 그 사이에서 필요한 정확도를 상당 부분 유지하면서 비용을 크게 낮추려는 접근입니다.
문제는 수치 정밀도입니다. MLIP에서 힘은 예측한 에너지를 원자 좌표로 미분해 얻습니다. 분자 동역학은 이 힘으로 수많은 시간 스텝(timestep)에 걸쳐 원자의 속도와 위치를 갱신합니다. 그래서 작은 오차가 쌓여 궤적 자체가 불안정해질 수 있습니다. 이런 이유로 많은 MLIP가 지금도 FP32(32비트 단정밀도 부동소수점) 로 추론(inference)합니다. 최신 NVIDIA GPU가 BF16(Brain Floating Point 16) 이나 TF32(TensorFloat-32) 같은 낮은 정밀도에서 훨씬 높은 Tensor Core 행렬 곱 처리량을 내는데도 그 성능을 쓰지 못하는 셈입니다.
원문이 다루는 Tensor Core FP32 기법 은 이 간극을 메우는 방법입니다. FP32 입력을 낮은 정밀도 조각 여러 개로 나누고, 조각끼리의 곱을 Tensor Core에서 계산한 뒤, FP32로 누적해 다시 합칩니다. 입력과 출력은 그대로 FP32이고 모델의 가중치와 구조도 바꾸지 않습니다.
원문은 2026년 10월 29일 NVIDIA 기술 블로그에 실렸습니다. 저자는 NVIDIA 인턴십 중 이 연구를 수행한 미시간 대학교 박사과정생 Anoushka Bhutani, NVIDIA ALCHEMI 팀의 Atul Thakur와 Erica Tsai, NVIDIA 솔루션 아키텍트 매니저 Kristopher Keipert입니다. 여기에 EPFL의 COSMO(Computational Science and Modeling) 연구실을 이끄는 Michele Ceriotti가 함께했습니다. 이 글은 기법이 실제 MLIP에서 얼마나 빨라지는지와 물리적으로 믿을 만한지를 함께 시험했습니다.
시험 대상은 Lab COSMO가 만든 트랜스포머 기반 MLIP인 Point Edge Transformer(PET) 입니다. 원문은 PET가 이미 실행 시간의 상당 부분을 고도로 최적화된 범용 행렬 곱(General Matrix Multiplication, GEMM)에 쓰고 있어서, 추가로 빨라질 여지가 적은 까다로운 시험 대상이라고 설명합니다. PET 모델들은 UPET 저장소에 BSD 3-Clause 라이선스로 공개되어 있습니다.
FP32 행렬 곱을 낮은 정밀도로 쪼개는 두 방법: BF16x9와 TF32x3
두 방법은 같은 원리를 GPU 세대에 맞게 구현한 것입니다. Blackwell GPU에서는 BF16 조각 세 개를 쓰는 BF16x9를, Ampere GPU에서는 TF32 조각 두 개를 쓰는 TF32x3를 씁니다.
Blackwell의 BF16x9: 세 조각, 아홉 번의 곱
BF16x9는 FP32 값 하나를 크기 단계가 다른 BF16 세 개로 나타냅니다. 아래 그림처럼 x = x_0 + 2^{-8}x_1 + 2^{-16}x_2 로 나누면, 각 BF16 조각이 유효숫자 8비트씩을 맡아 합계 24비트로 FP32의 유효숫자(significand)를 덮습니다. 두 행렬 A, B 를 이렇게 나누면 3 \times 3 = 9 개의 BF16 행렬 곱이 생깁니다. 이 곱들을 크기 단계가 같은 것끼리 다섯 묶음(band)으로 모은 뒤, 가장 작은 묶음부터 FP32 누산기에 차례로 더합니다.
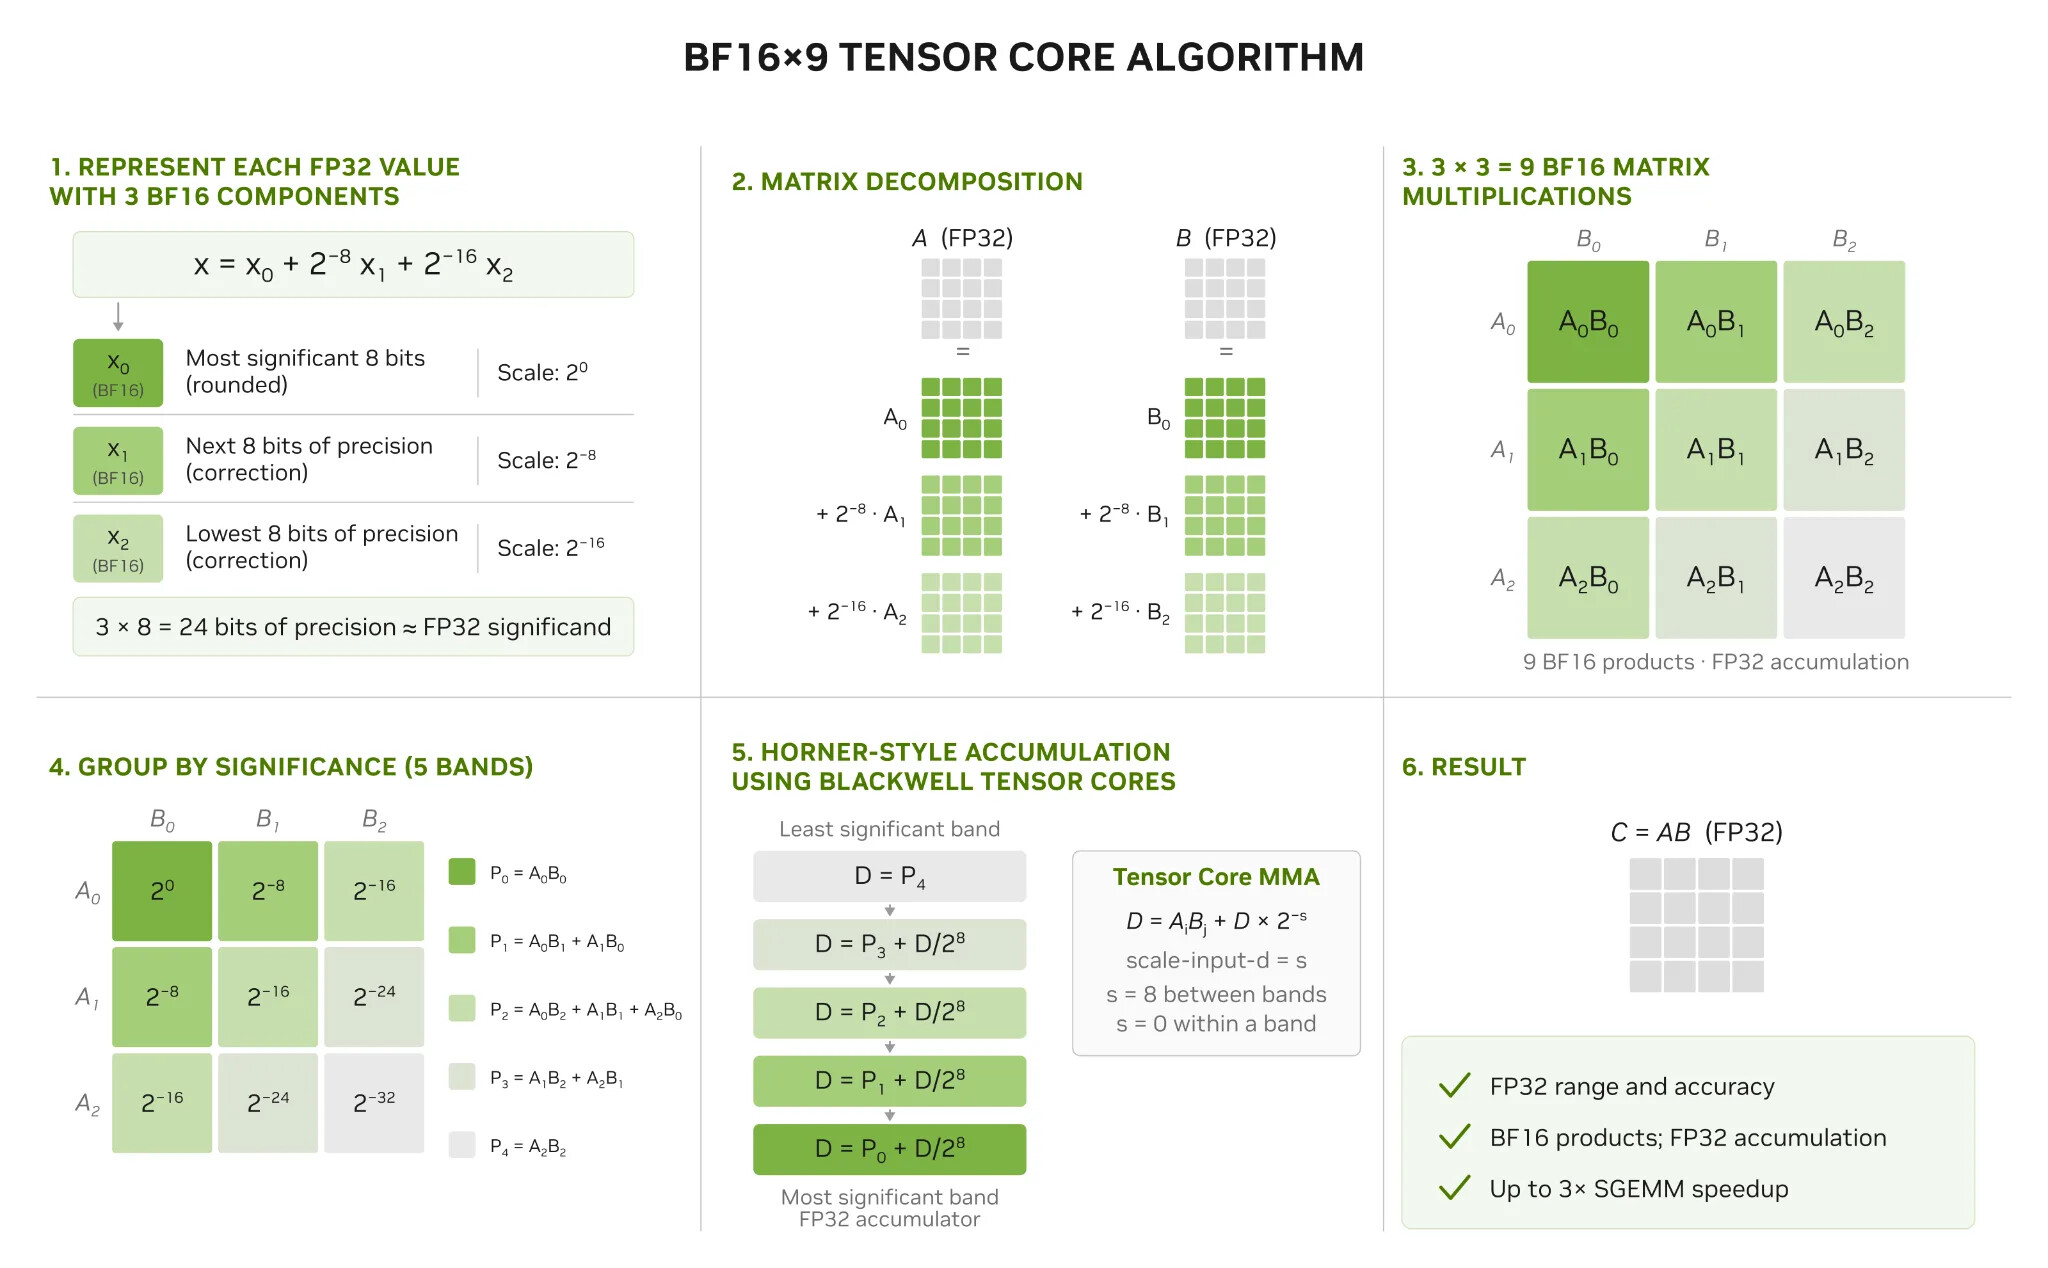
NVIDIA cuBLAS가 이 경로를 제공합니다. 환경 변수 CUBLAS_EMULATE_SINGLE_PRECISION=1 을 설정하면, 호환되는 PyTorch GEMM이 모델 코드나 커스텀 GEMM 없이 이 경로를 탑니다. 알고리즘 자체는 NVIDIA 연구진의 논문 Exceeding the Numerical and Performance Characteristics of IEEE-754 SGEMM with BFloat16 Tensor Cores on GPUs for Scientific Computing에 정리되어 있습니다. 논문 초록은 BF16과 FP32가 같은 지수 범위를 쓰고, Blackwell에 스케일링 하드웨어가 들어 있다는 점을 이 방식의 근거로 듭니다.
Ampere의 TF32x3: 두 조각, 세 번의 곱
TF32x3는 같은 생각을 Ampere GPU에 적용합니다. FP32 값을 큰 TF32 조각 a_{\mathrm{hi}} 와 나머지를 담는 작은 TF32 조각 a_{\mathrm{lo}} 로 나눕니다. 원문 설명에 따르면, 이 구현은 BF16x9와 달리 스케일링 계수를 쓰지 않습니다. 네 개의 곱 가운데 가장 작은 나머지끼리의 곱은 버리고 세 개만 계산합니다.
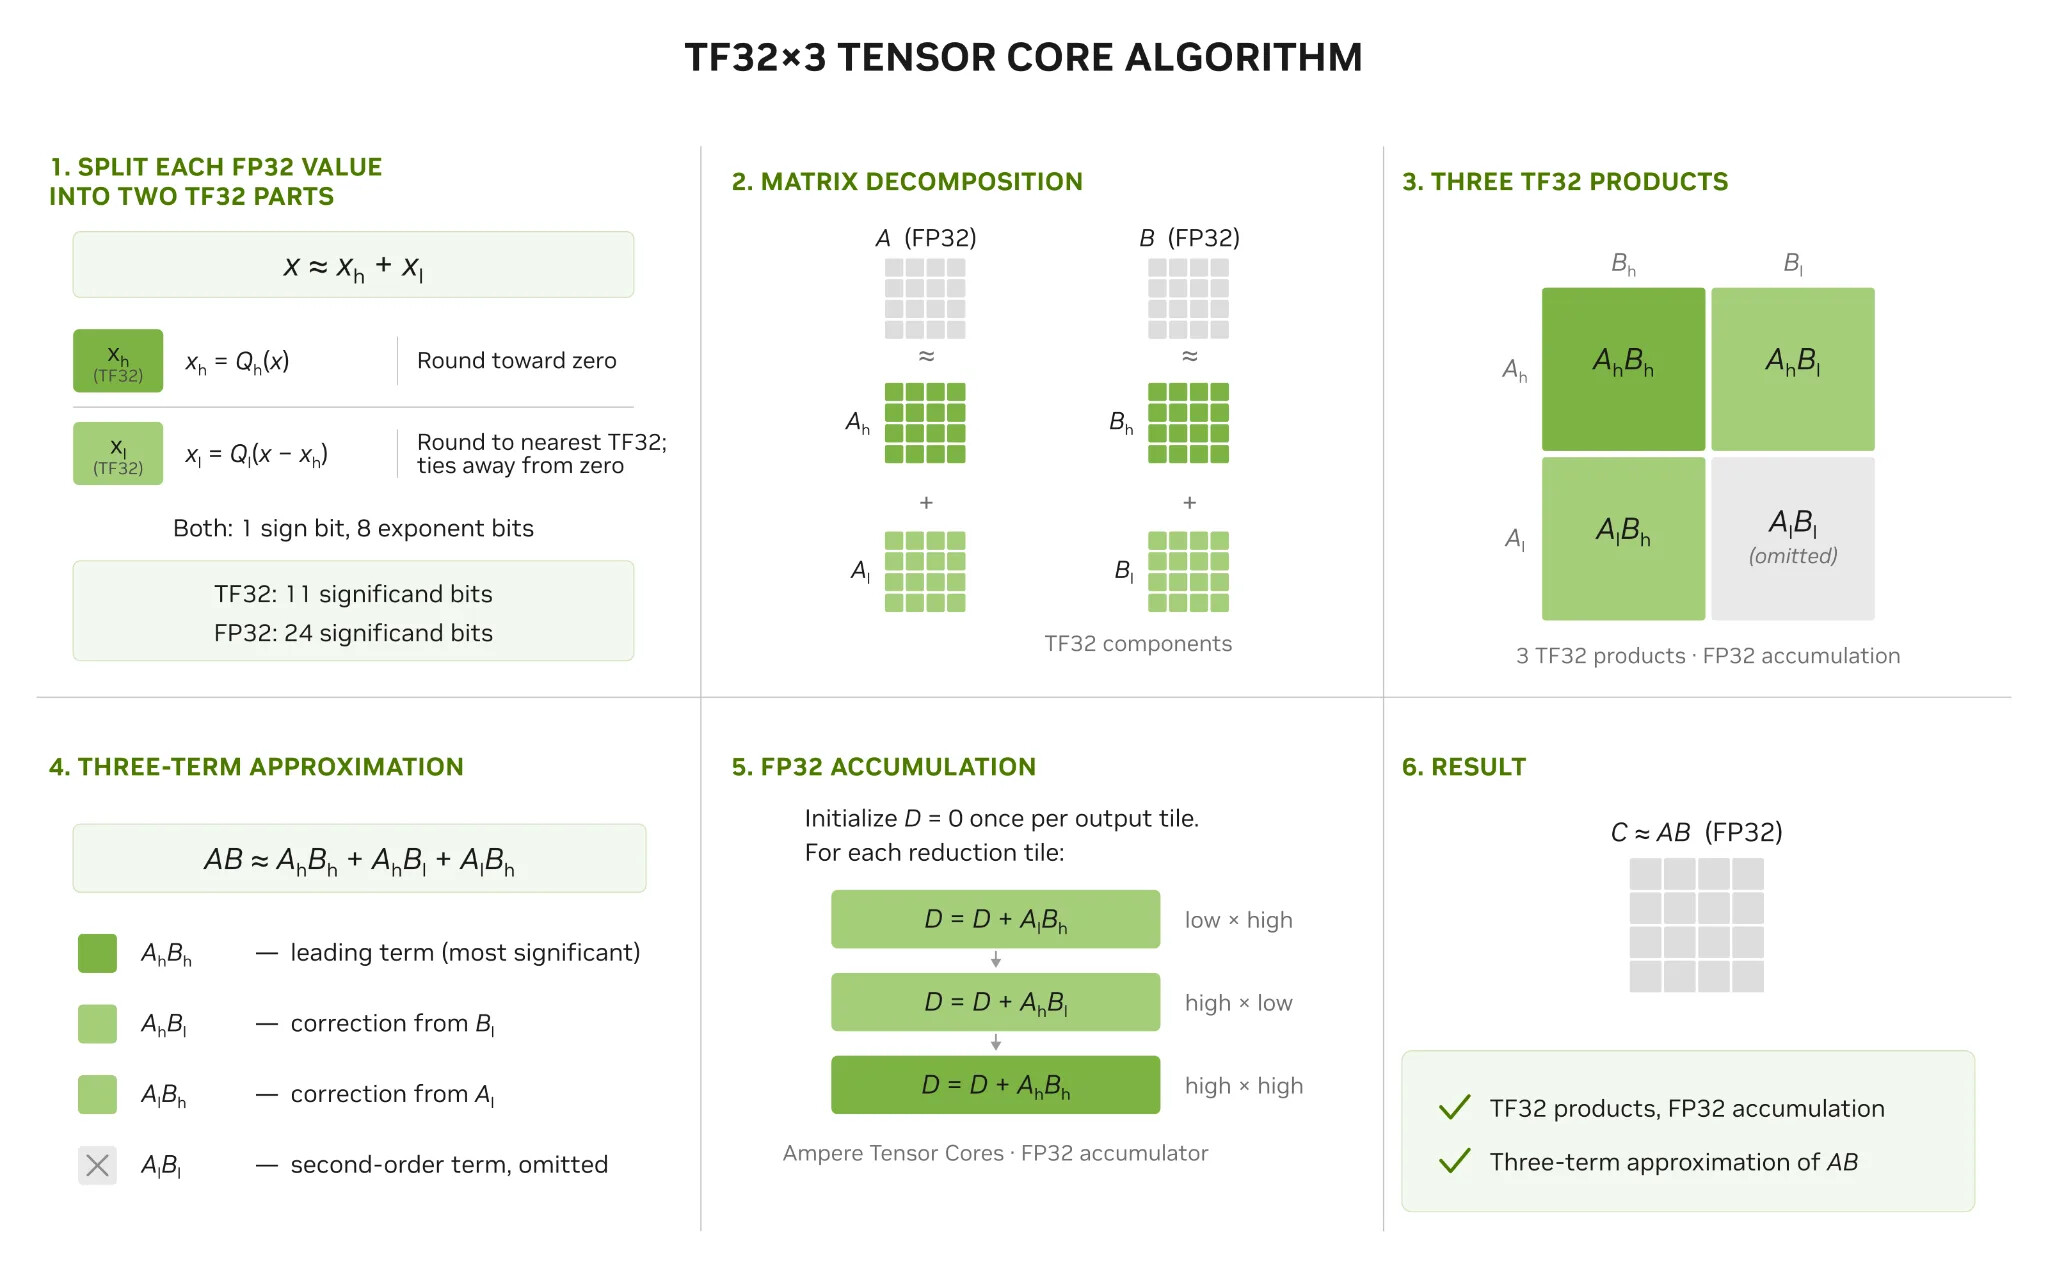
원문은 TF32x3 설명에 Ootomo와 Yokota의 2022년 논문 Recovering single precision accuracy from Tensor Cores while surpassing the FP32 theoretical peak performance를 링크합니다. 원문이 실제로 쓴 구현은 NVIDIA CUTLASS의 OpMultiplyAddFastF32 연산자로, 이 논문보다 앞선 CUTLASS 2.8.0(2021년 11월)에 들어갔습니다. (논문은 누적을 Tensor Core 밖에서 하고 스케일링을 더한 별도 구현을 제안합니다.)
두 방법 한눈에 비교하기
아래 표는 원문과 cuBLAS 문서의 내용을 정리한 것입니다.
| 항목 | BF16x9 | TF32x3 |
|---|---|---|
| 대상 GPU | Blackwell, 연산 능력 10.0과 10.3 | Ampere(sm80), Hopper(sm90)로도 컴파일 가능 |
| FP32 하나당 조각 | BF16 3개 (스케일링 사용) | TF32 2개 (스케일링 없음) |
| 계산하는 곱 | 9개 | 3개 (나머지끼리의 곱 생략) |
| 제공 경로 | cuBLAS 환경 변수, 수학 모드, 연산 타입 | CUTLASS OpMultiplyAddFastF32 (직접 연결 필요) |
| 모델 코드 변경 | 없음 | nn.Linear 를 커스텀 레이어로 교체 |
| 원문 시험 GPU | NVIDIA B300 | NVIDIA A100 |
PET 실측: GEMM 커널과 분자 동역학 한 스텝
원문은 2,600만(26M) 파라미터의 PET-MAD 소형 체크포인트(pet-mad-s-v1.6.0-nn-32)를 원자 192개짜리 물 상자와, 이를 복제한 원자 17,280개짜리 초격자(supercell)에서 시험했습니다. 원문이 2억 5,500만(255M) 파라미터 대형 체크포인트라고 부르는 pet-mad-m-v1.6.0 은 192개 원자 계에서만 시험했습니다. 비교 기준은 같은 모델을 기본 FP32 경로로 돌렸을 때의 에너지, 힘, 응력(stress)입니다.
다만 체크포인트 이름과 파라미터 수는 UPET 쪽 자료와 맞지 않습니다. UPET 모델 문서의 크기 표에서 M은 1억 900만(109M) 파라미터이고, 255M은 L 크기입니다. PET-MAD-1.6은 XS, S, M 크기만 있습니다. 원문 그림 6의 축 라벨은 이 모델을 L 로 표시합니다. 아래에서는 원문 표기대로 "대형 체크포인트"라고 적습니다.
Blackwell B300의 BF16x9: GEMM 최대 2.5배, MD 스텝 최대 1.7배
PET의 큰 GEMM은 17,280개 원자 계에서 2.2~2.5배, 192개 원자 계에서 1.2~1.4배 빨라졌습니다. 아래 그림에서 아래쪽 두 막대(4096³, 8192³)는 PET의 원자 수와 맞지 않는 정사각 행렬로, 일반 기준값으로 보입니다(2.41배, 2.28배).
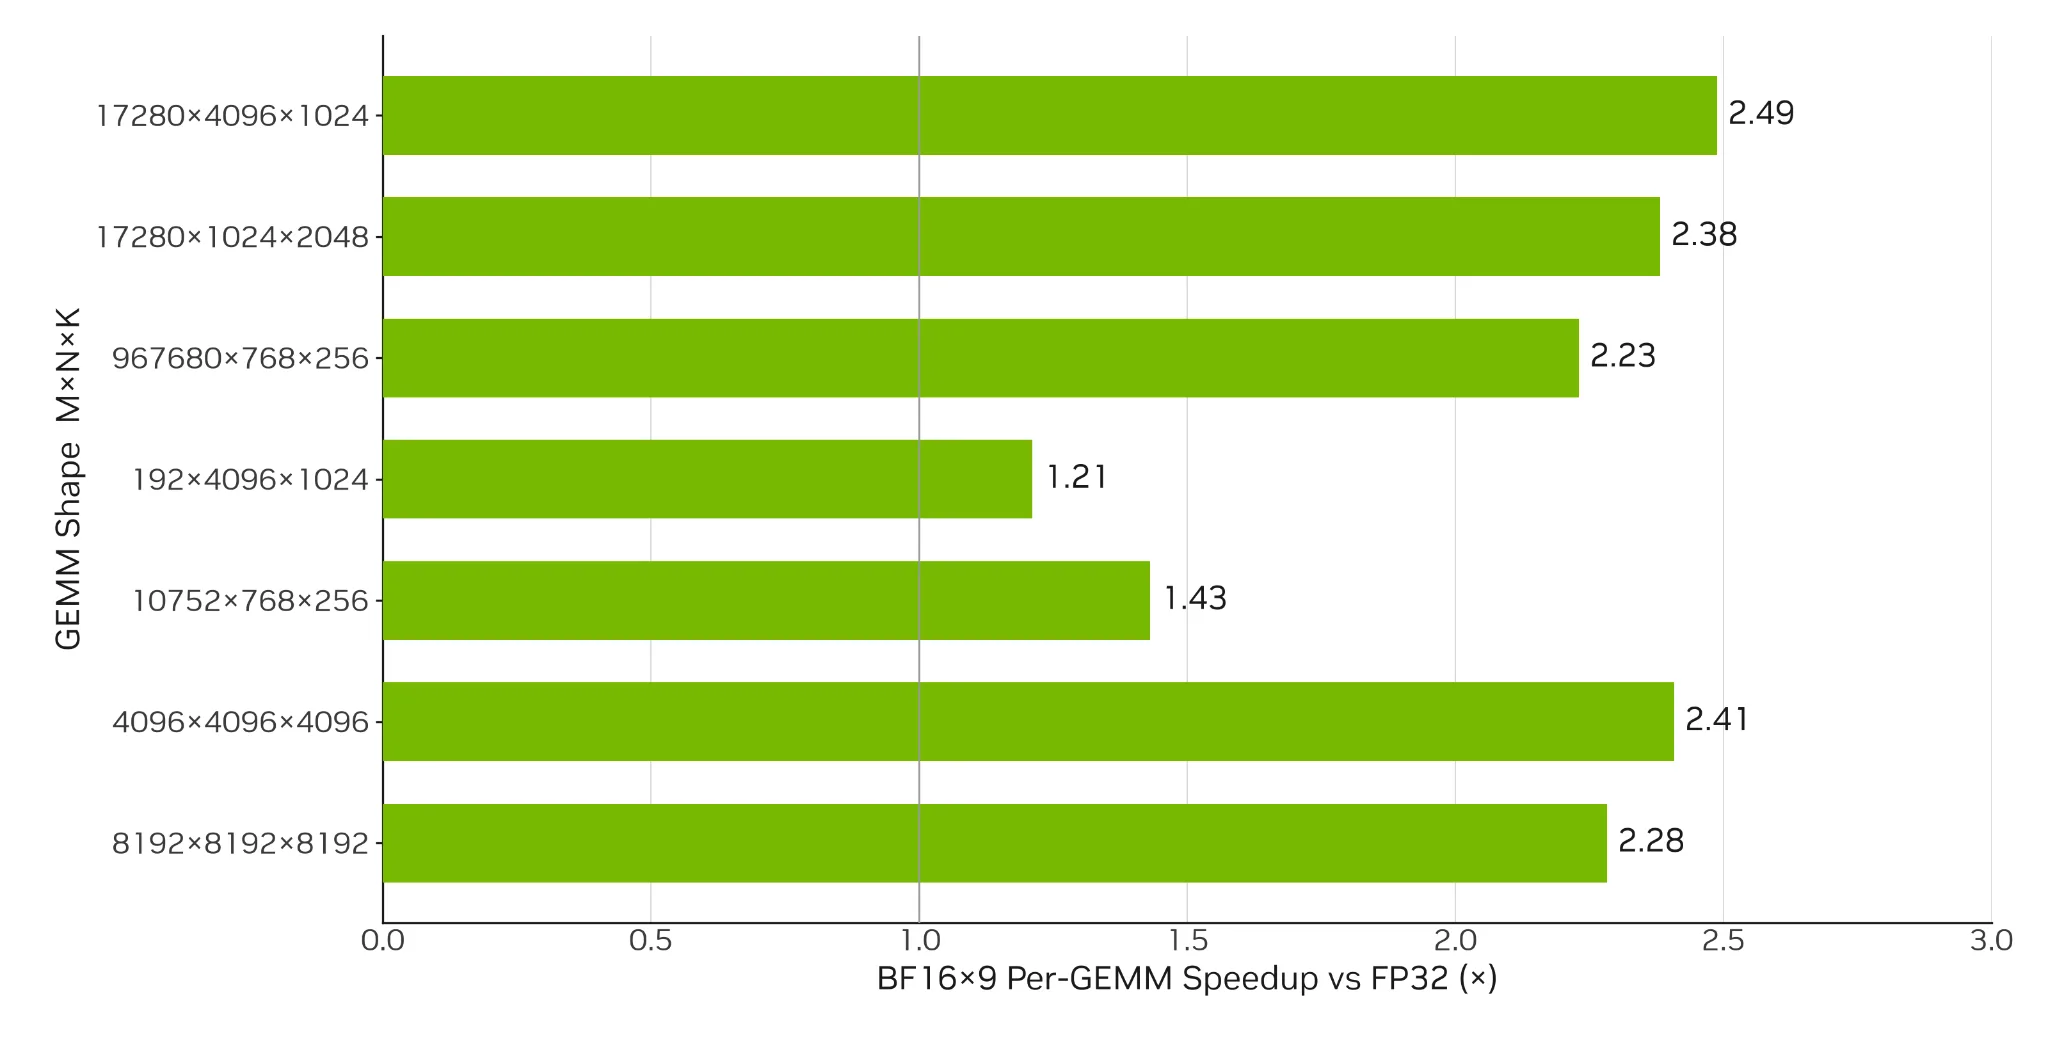
cuBLAS는 BF16x9를 언제 쓸지 두 가지 전략으로 고릅니다. performant 전략 은 cuBLAS가 더 빠를 것으로 판단할 때만 BF16x9를 쓰고, eager 전략 은 지원되는 연산이면 항상 씁니다. cuBLAS 문서에 따르면 기본값은 performant이고, 환경 변수 CUBLAS_EMULATION_STRATEGY 에 performant 나 eager 를 지정해 바꿀 수 있습니다. 비교 기준은 컴파일한 FP32 경로입니다.
- 192개 원자 계: MD 스텝이 performant 전략에서 1.22배, eager 전략에서 1.09배 빨라졌습니다.
- 17,280개 원자 계: performant 전략에서 1.70배, eager 전략에서 1.37배 빨라졌습니다.
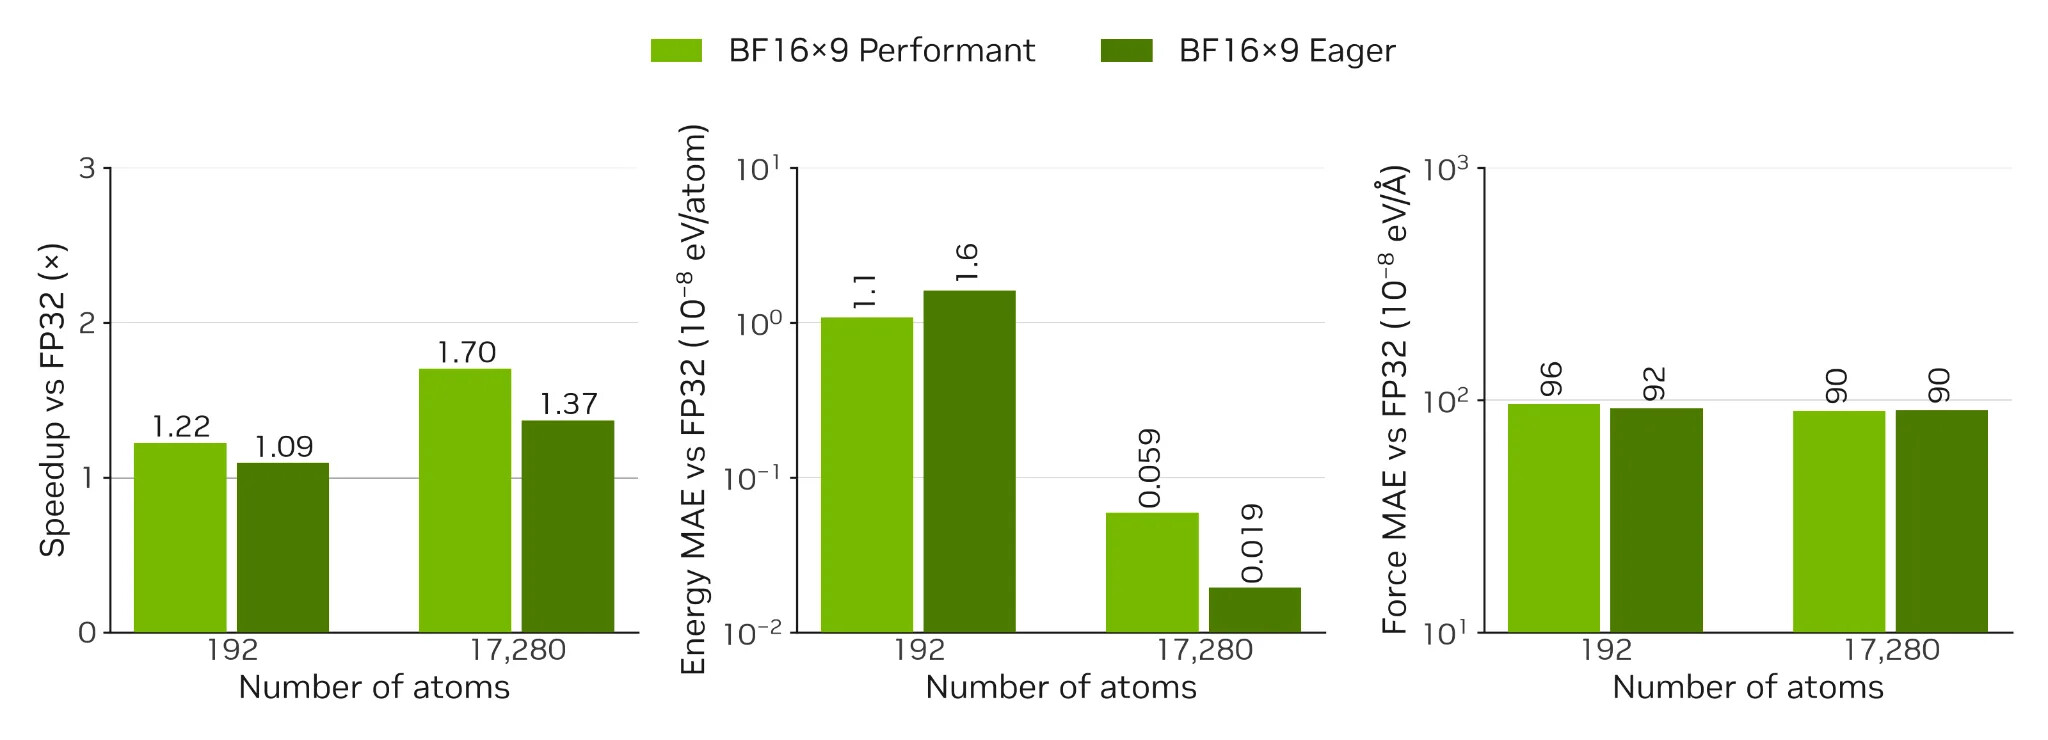
정확도 쪽에서 원문은 BF16x9로 생긴 오차가 모델 자체의 비결정성(non-determinism)보다 작다고 보고합니다. 그림의 수치로 보면 원자당 에너지 오차(MAE)는 약 1.9 \times 10^{-10} \sim 1.6 \times 10^{-8} eV이고, 힘 오차는 약 0.9 \sim 1.0 \times 10^{-6} eV/Å입니다. 원문은 PET가 이미 실행 시간의 많은 부분을 최적화된 GEMM으로 처리하는데도, 재학습이나 커스텀 커널 없이 추가 성능을 끌어냈다는 점을 강조합니다.
Ampere A100의 TF32x3: GEMM 1.7~1.9배, MD 스텝 최대 1.5배
cuBLAS의 BF16x9 경로는 Ampere를 지원하지 않습니다. Ampere에서 연구진은 TF32x3를 직접 연결했습니다. PET의 표준 nn.Linear 레이어를, CUTLASS C++ TF32x3 커널을 호출하는 커스텀 TF32Linear 레이어로 바꿨습니다. 참고 구현은 CUTLASS의 Example 27이며, 핵심 설정은 다음 한 줄입니다.
cutlass::arch::OpMultiplyAddFastF32
이 연산자는 입력과 출력을 float 로 선언합니다. 그래서 PET는 평소처럼 FP32 활성값과 가중치를 넘기고 FP32 결과를 받습니다. 모델의 나머지 부분에서 보면 이 레이어는 표준 nn.Linear 와 똑같이 동작하고, 내부의 행렬 곱 구현만 바뀝니다. PET는 에너지를 미분해 힘을 구하므로, 연구진은 레이어 입력 쪽 기울기 전파에도 TF32x3를 썼습니다. 덕분에 에너지와 힘 계산이 모두 TF32x3로 돌아갑니다. 가중치 기울기는 표준 PyTorch 경로를 쓰지만, 가중치가 고정된 추론에서는 필요하지 않습니다.
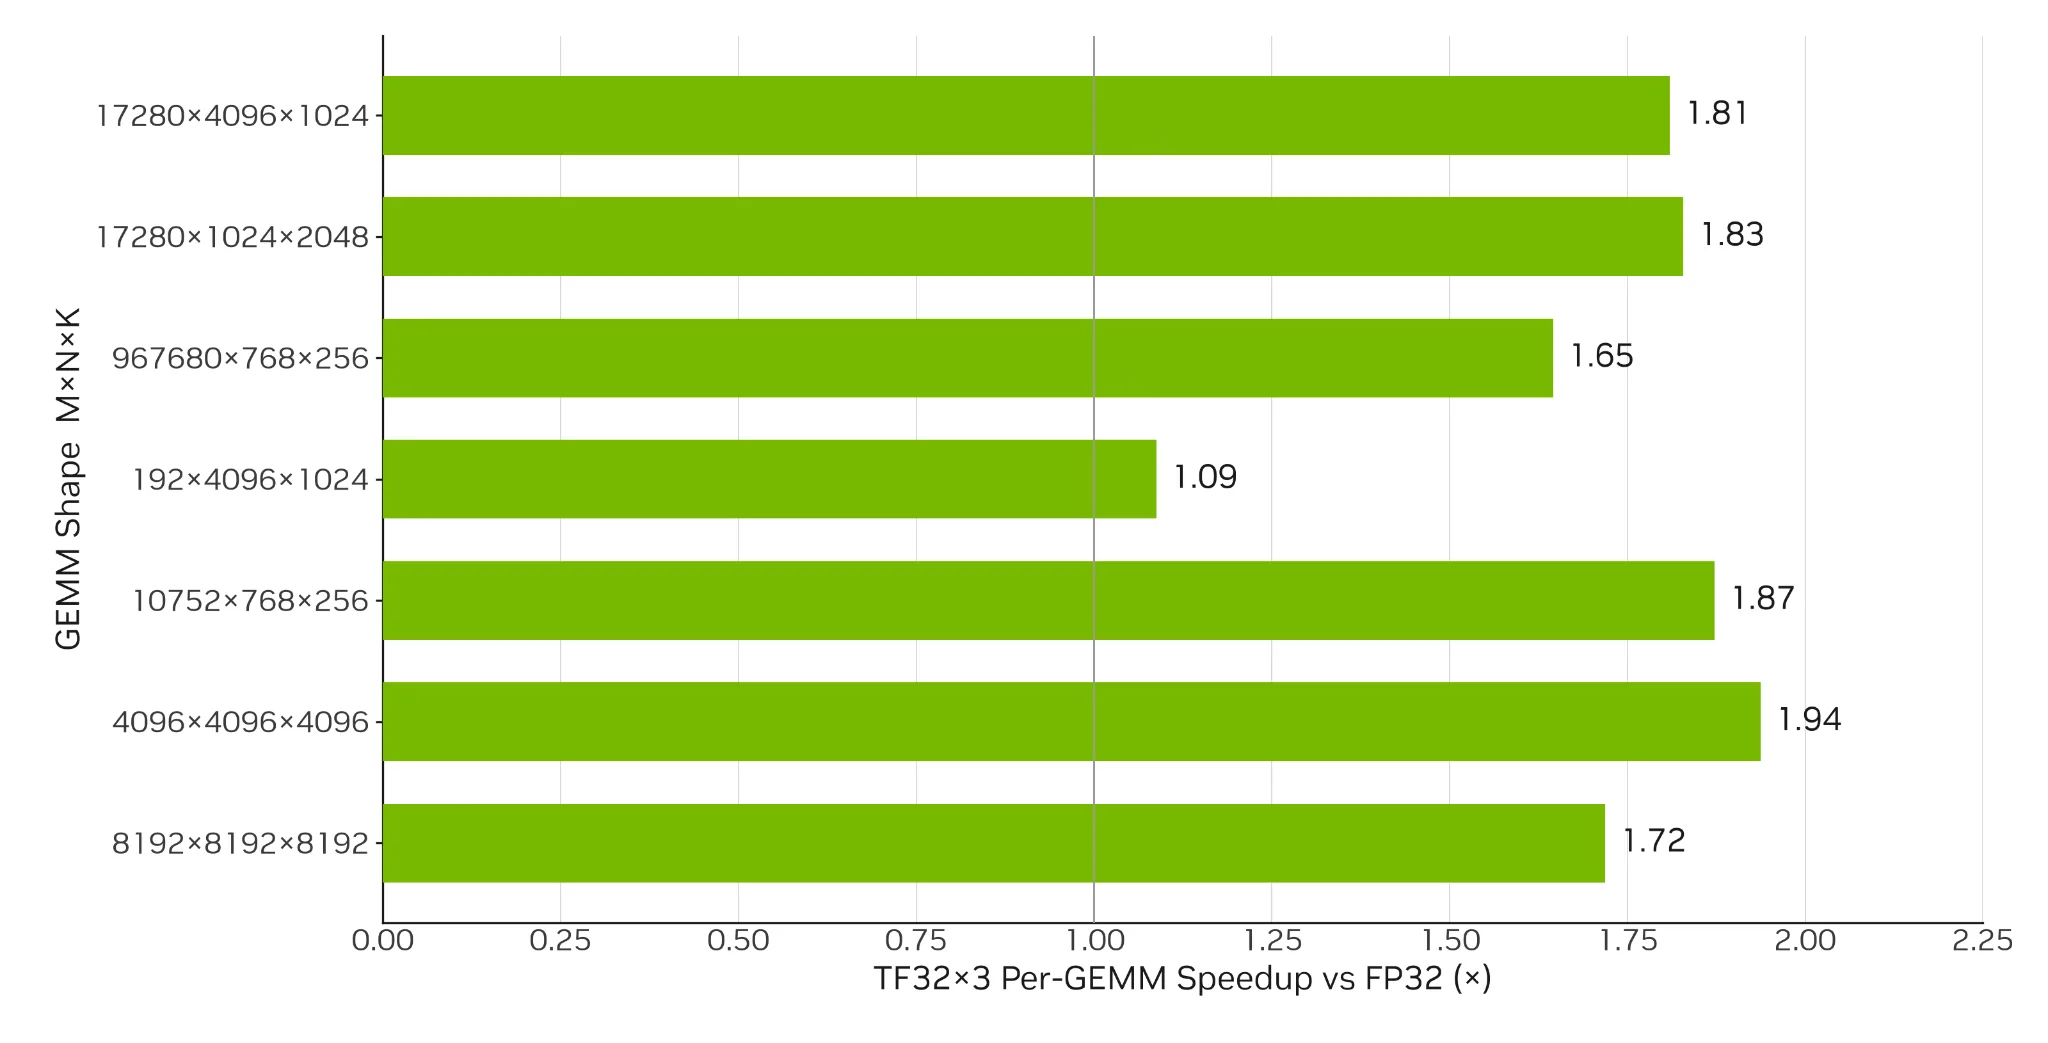
원문은 PET의 주요 선형 레이어 모양에서 GEMM이 약 1.7~1.9배 빨라졌다고 적습니다. 그림을 보면 17,280개 원자 계의 세 GEMM은 1.81배, 1.83배, 1.65배입니다. 1.87배는 192개 원자 계의 GEMM 하나, 1.94배는 4096³ 기준 행렬에서 나왔습니다. 원문 결론의 최대 1.9배라는 수치는 이 두 값과 맞습니다.
아래 그림은 MD 스텝 속도와 단일 지점 정확도를 일반 TF32(1회 곱)와 TF32x3로 비교합니다. 각 방법은 자기 FP32 기준선과 비교했습니다.
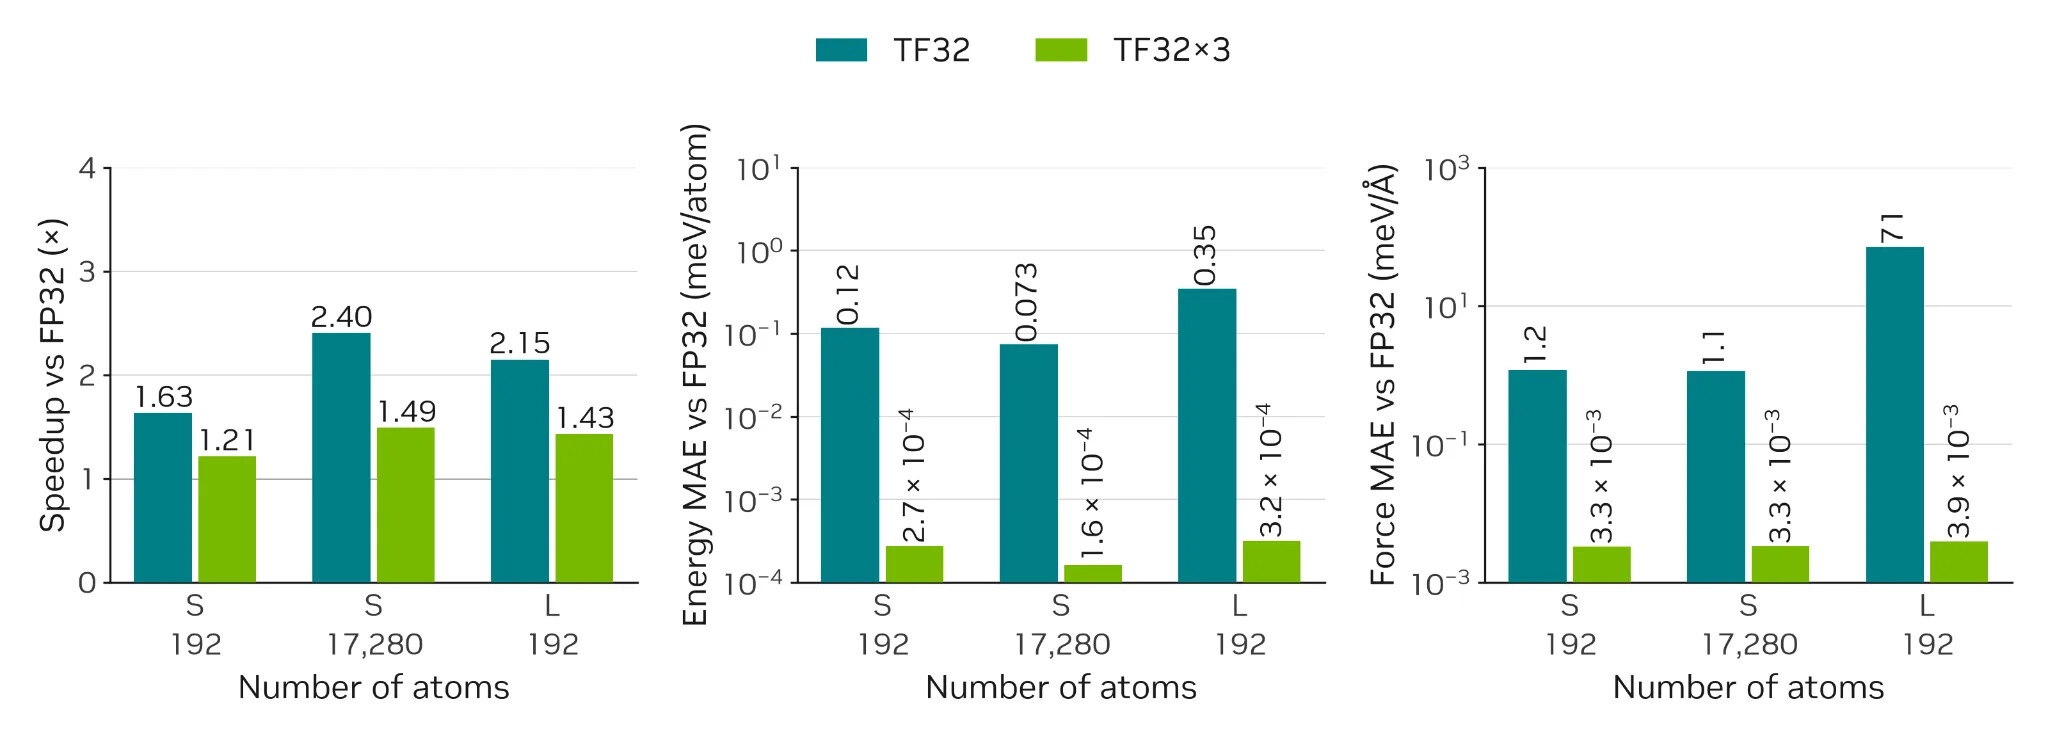
- 소형 체크포인트(26M): TF32x3는 힘 오차를, FP32를 다시 컴파일해 돌렸을 때 생기는 차이의 약 3배 수준으로 유지했습니다. 17,280개 원자 계에서 MD 스텝은 1.49배 빨라졌습니다.
- 대형 체크포인트: 192개 원자 계에서 TF32x3는 1.43배로, 같은 계의 소형 체크포인트(1.21배)보다 더 빨라졌습니다. 힘 오차는 3.9 \times 10^{-6} eV/Å로 소형과 거의 같았습니다.
일반 TF32는 1.63~2.40배로 더 빨랐지만 오차가 컸습니다. 원문 그림에서는 대형 체크포인트의 차이가 두드러집니다. 일반 TF32의 힘 오차가 소형에서는 약 1.1~1.2 meV/Å였는데, 대형에서는 71 meV/Å로 크게 뛰었습니다. 같은 조건에서 TF32x3는 3.3 \sim 3.9 \times 10^{-3} meV/Å에 머물렀습니다.
속도보다 중요한 시험: 에너지 곡면, 에너지 보존, 구조 이완
단일 지점의 에너지와 힘이 FP32와 비슷하다는 것은 첫 번째 관문일 뿐입니다. 힘은 학습된 퍼텐셜 에너지 곡면(Potential Energy Surface, PES) 의 기울기이고, 수많은 스텝에 걸쳐 적분됩니다. 원문은 작은 수치 불규칙성도 곡면을 거칠게 만들거나, 궤적을 불안정하게 하거나, 물리적으로 맞지 않는 에너지 표류(drift)를 낼 수 있다고 설명합니다. 그래서 연구진은 TF32x3를 세 가지 물리 시험에 추가로 넣었습니다.
에너지 곡면의 매끄러움과 에너지 보존
첫 번째 시험에서는 백금 표면 Pt(111)의 꼭대기 자리(on-top site)에서 일산화탄소(CO) 분자 하나를 형태를 유지한 채 위로 끌어올렸습니다. 탄소 높이 1.2Å부터 6.0Å까지 8.1 \times 10^{-2} Å 간격으로 60개 지점에서 전체 에너지를 계산했습니다. TF32x3는 FP32의 매끄러운 곡선을 그대로 따라갔고, 일반 TF32는 확대한 구간(3.0~3.9Å)에서 점마다 들쭉날쭉한 변동을 보였습니다.
두 번째 시험은 192개 원자 물 상자의 30ps NVE 시뮬레이션입니다. NVE 앙상블 은 입자 수, 부피, 전체 에너지를 고정한 조건이라, 적분이 정확하면 전체 에너지가 일정한 범위 안에서만 흔들려야 합니다. FP32와 TF32x3는 비슷한 범위에서 흔들렸고, 일반 TF32는 그보다 큰 체계적 표류를 보였습니다. 그림에서 일반 TF32의 곡선은 약 10ps 이후 다른 두 곡선에서 점점 멀어집니다.

구조 이완: 일반 TF32는 끝내 수렴하지 못했다
구조 이완(structural relaxation) 은 원자에 걸리는 힘이 기준값 아래로 내려갈 때까지 원자 배치를 반복해서 고치는 최적화입니다. 예측한 힘을 매 스텝 쓰기 때문에, 힘이 조금만 어긋나도 최적화 경로가 바뀌거나 수렴하지 못할 수 있습니다. 연구진은 539개 원자로 된 칸토르 합금(Cantor alloy, CoCrFeMnNi) 슬랩(Co₁₀₈Cr₁₀₈Fe₁₀₈Mn₁₀₇Ni₁₀₈)을 PET와 FIRE2(Fast Inertial Relaxation Engine 2.0) 최적화기로 이완했습니다. 실행에는 NVIDIA ALCHEMI Toolkit을 썼습니다.
세 번 반복한 결과는 다음과 같습니다.
- FP32: 218 스텝에 수렴했습니다.
- TF32x3: 218~222 스텝에 수렴했고, 세 번 모두 힘 기준 1.0 \times 10^{-3} eV/Å에 도달했습니다. 스텝당 속도는 1.46배였습니다.
- 일반 TF32: 스텝당 2.03배로 가장 빨랐지만, 세 번 모두 500 스텝 안에 수렴하지 못했습니다. 힘은 약 1.2 \times 10^{-3} eV/Å에서 더 내려가지 않았고, 스텝 한도를 1,000으로 늘려도 수렴하지 못했습니다.
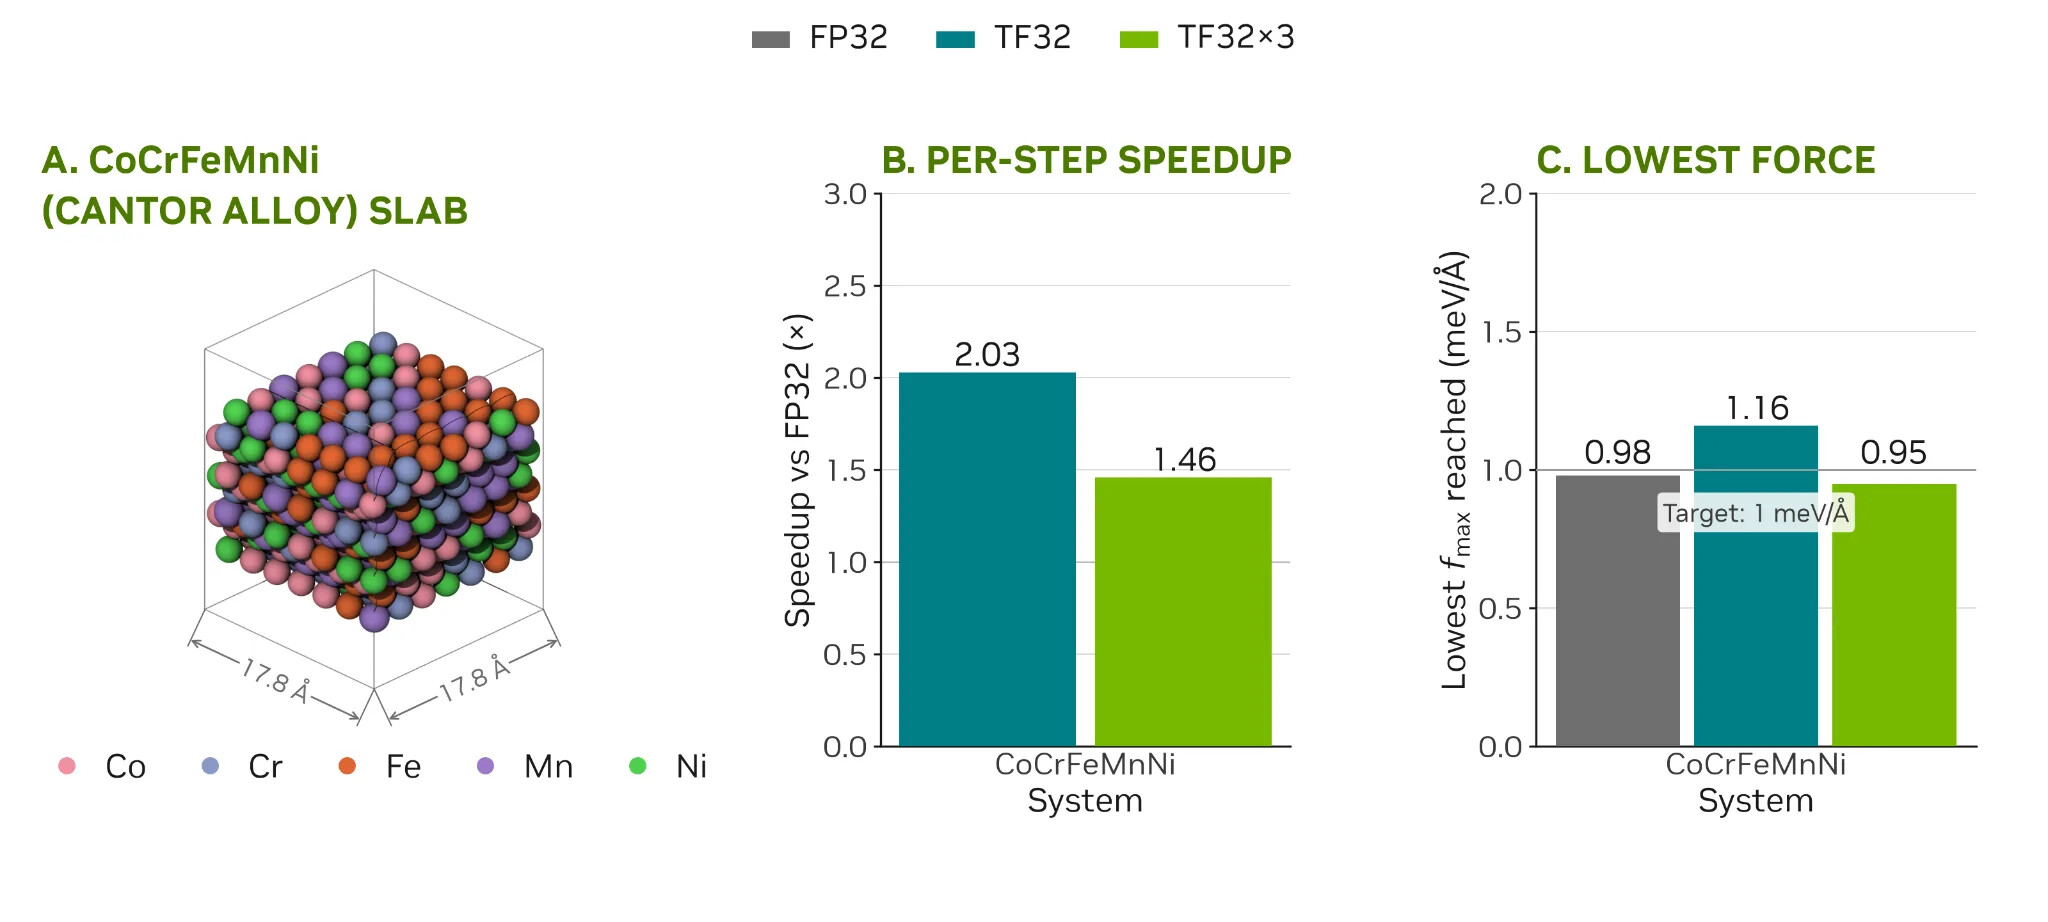
원문은 이 결과를, FP32 워크플로의 수렴 동작을 해치지 않고 속도를 얻은 사례로 정리합니다.
PyTorch에서 직접 써 보려면: GPU 세대별 경로
원문은 "재학습이나 구조 변경 없이 오늘 바로 시도해 보라"고 권하지만, 실제 진입 경로는 GPU 세대에 따라 크게 다릅니다. 아래 내용 중 PyTorch 설정과 GPU 지원 범위는 원문에 없고, PyTorch 2.15 CUDA 문서와 cuBLAS 문서, NVIDIA의 GPU 연산 능력 표에서 확인한 것입니다.
B200, GB200, B300, GB300을 쓴다면 BF16x9를 설정만으로 켤 수 있습니다. cuBLAS 문서 기준으로 BF16x9는 연산 능력 10.0(B200, GB200)과 10.3(B300, GB300)에서 CUDA 12.9 이상일 때 지원됩니다. GeForce RTX 50 시리즈, RTX PRO Blackwell, DGX Spark(GB10)는 같은 Blackwell 세대여도 연산 능력이 12.x라 대상이 아닙니다. 원문과 같은 방식으로 PyTorch 코드를 건드리지 않으려면 환경 변수를 씁니다.
export CUBLAS_EMULATE_SINGLE_PRECISION=1
export CUBLAS_EMULATION_STRATEGY=performant   # 또는 eager
PyTorch 2.15.0(2026년 10월 28일 출시)에 새로 들어간 설정으로도 켤 수 있습니다.
import torch

torch.backends.cuda.matmul.fp32_precision = "bfx9"
PyTorch 문서에 따르면 이 모드는 CUDA 12.9 이상으로 빌드된 PyTorch에서만 설정할 수 있고, ROCm이나 더 오래된 CUDA 빌드에서는 오류가 납니다. 연산 능력 10.0과 10.3이 아닌 NVIDIA GPU에서는 설정은 받아들이지만 그냥 FP32로 계산합니다. torch.compile 아래에서도 FP32 행렬 곱은 cuBLAS 호출로 남습니다. 다만 FP32 FlexAttention처럼 BF16x9를 유지할 수 없는 융합 Triton 커널은 경고를 한 번 출력하고 IEEE FP32로 계산합니다. 문서는 이 방식이 FP32 입력 비트를 모두 보존하지만 IEEE-754 규격을 따르는 연산은 아니며, 상대 정확도는 작업마다 다르다고 덧붙입니다.
A100 같은 Ampere나 Hopper GPU를 쓴다면 아직 설정 하나로 끝나지 않습니다. 원문은 TF32Linear 레이어의 코드를 함께 공개하지 않았습니다. CUTLASS Example 27을 바탕으로 nn.Linear 를 대체하는 확장을 직접 만들어야 하고, 힘 계산을 위해 입력 기울기 쪽 커널까지 연결해야 합니다. 원문도 TF32x3 성능은 모델의 행렬 모양과 하드웨어에 맞춘 커널 튜닝에 달려 있다고 적습니다.
이름이 비슷한 PyTorch 설정과 혼동하지 않도록 주의합니다. fp32_precision = "tf32" (예전 allow_tf32 설정)가 켜는 방식은 원문의 "일반 TF32"와 같은 1회 TF32 곱 계열입니다. 단, 원문은 일반 TF32를 어떤 설정으로 돌렸는지 밝히지 않습니다. torch.set_float32_matmul_precision("high") 는 PyTorch 문서상 TF32 1회 곱이나 FP32를 BF16 두 개의 합으로 다루는 방식을 쓰며, 원문의 TF32x3와 다릅니다.
한계와 판단 기준
원문이 밝힌 한계는 다음과 같습니다. 전체 속도 향상은 계의 크기와 실행 시간 중 GEMM이 차지하는 비중에 달려 있습니다. 작은 계에서는 커널 실행 오버헤드, 이웃 원자 처리, 그래프 연산 같은 GEMM 밖의 일이 차지하는 비중이 커서 이득이 적습니다. 소형 체크포인트에서 같은 방법끼리 비교하면, 192개 원자 계의 MD 스텝 향상(1.09~1.22배)은 17,280개 원자 계(1.37~1.70배)보다 작습니다.
정밀도 특성은 방법마다 다릅니다. 원문은 BF16x9가 행렬 곱 시험에서 FP64 기준 대비 기본 FP32와 같거나 더 나은 정확도를 냈다는 BF16x9 논문의 결과를 근거로, 지원 하드웨어에서는 FP32 GEMM을 그대로 대체할 수 있다고 봅니다. 반면 TF32x3는 정확도 특성이 조금 다르므로, 모델의 정확도와 물리적 안정성 요구에 맞춰 따로 검증하라고 권합니다.
시험 범위도 함께 봐야 합니다. 에너지 곡면, 에너지 보존, 구조 이완 시험은 TF32x3만 받았고 BF16x9는 받지 않았습니다. 원문은 BF16x9를 그래프 구성 최적화, 연산 융합, 커스텀 커널, CUDA 그래프와 함께 쓰면 추가 이득이 있을 수 있다고 하면서도, 이 조합 효과는 측정하지 않았다고 밝힙니다. 또 모델은 PET 하나, 계는 물, Pt(111)-CO, 칸토르 합금 세 종류입니다. 원문은 실행 시간 대부분이 큰 FP32 GEMM인 다른 MLIP와 정밀도에 민감한 과학 머신러닝 모델에서도 이 방법을 평가해 볼 만하다는 정도로 결론을 맺습니다.
 Unlocking Tensor Core Performance for Machine Learning Interatomic Potentials 소개 블로그
 UPET GitHub 저장소
 BF16x9 논문
TF32 Tensor Core 단정밀도 복원 논문 (Ootomo, Yokota)
더 읽어보기
-
CUDA Tile: NVIDIA가 제시하는 차세대 타일(Tile) 기반 GPU 프로그래밍 (feat. cuTile Python, Tile IR, TileGym)
-
nvmath-python: CUDA 기반의 NVIDIA 라이브러리를 Python 환경에서 사용 가능할 수 있는 고성능 수학 라이브러리
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
