GPT-6 Astra에 맞춘 스킬과 AGENTS.md 재점검 가이드 소개
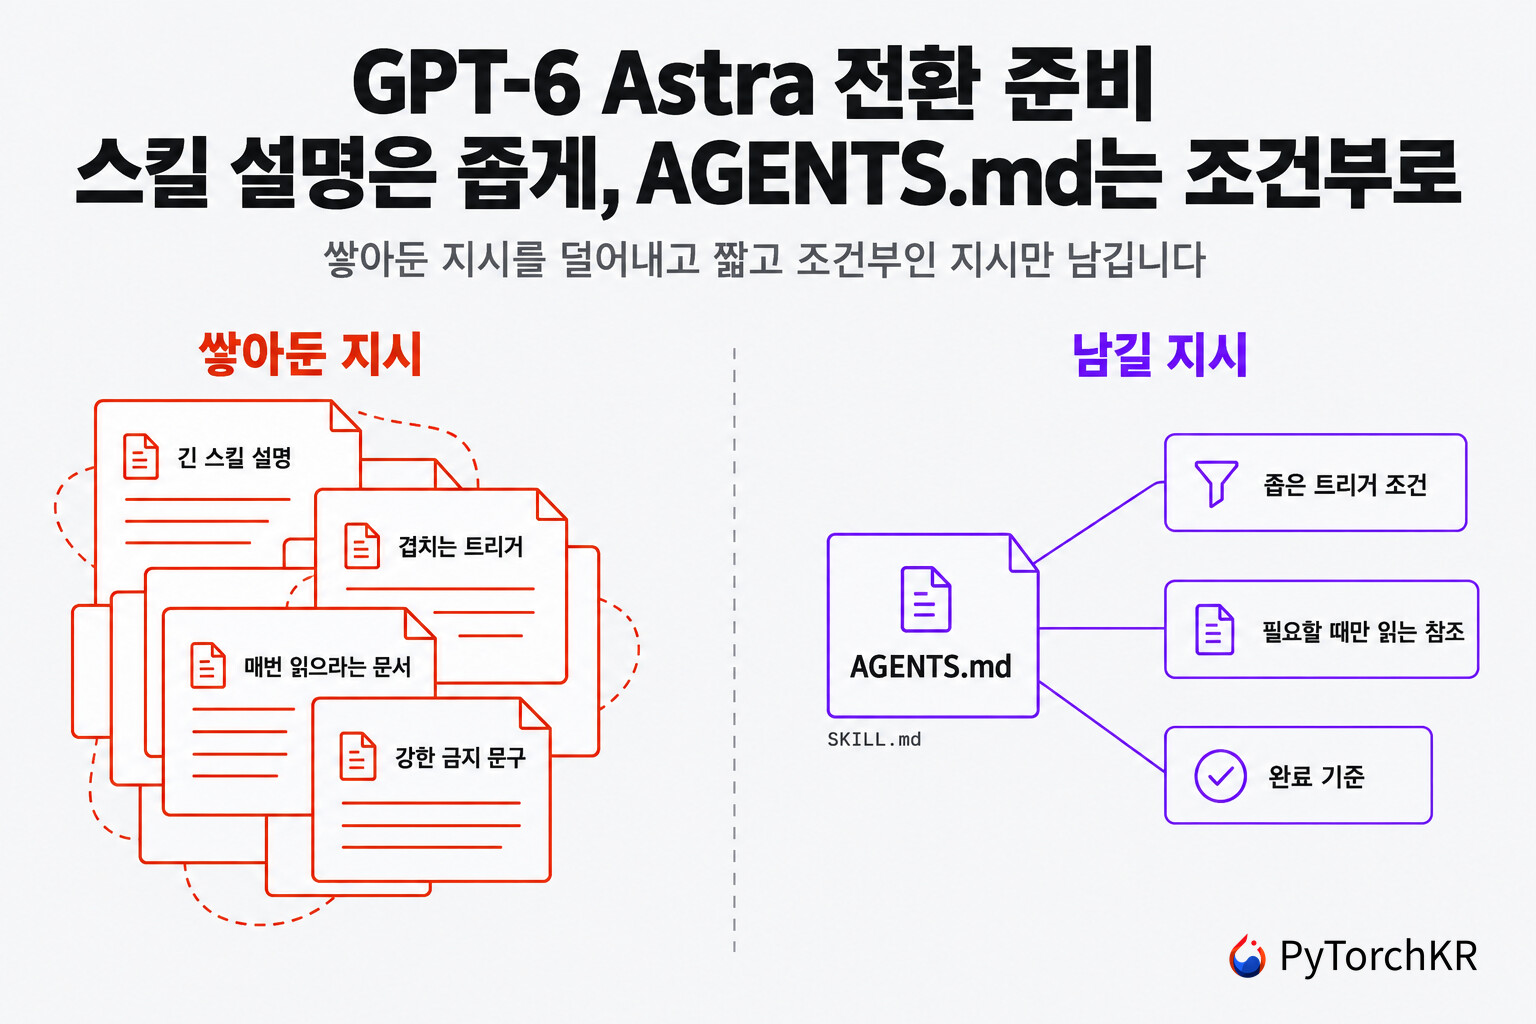
OpenAI의 Codex 팀이 2026년 9월 11일 개발자 블로그에 Rethinking skills and prompts for GPT-6 Astra 를 공개했습니다. Eric Provencher가 쓴 이 글은 새 모델을 쓰기 시작할 때 API 파라미터를 바꾸는 이야기가 아니라, 지난 1년 동안 저장소와 사용자 설정에 쌓여 온 지시(instructions) 를 덜어내는 이야기입니다. 글이 대상으로 삼는 지시는 세 가지, 스킬(Skill)과 AGENTS.md, 그리고 작업을 시킬 때 쓰는 프롬프트입니다.
전제는 단순합니다. 코딩 에이전트가 빠르게 좋아졌고, 그에 따라 모범 사례도 빠르게 바뀌고 있다는 것입니다. 원문은 첫 문단에서 이를 "모델이 더 유능해지면서, 예전에는 손을 많이 잡아 주고 보조 코드(Scaffolding)를 깔아 줘야 했던 일이 이제는 그렇지 않다"고 정리합니다. 문제는 그 손잡아 주기의 흔적이 파일로 남아 있다는 점입니다. 원문이 각 항목에서 드는 예시가 그것으로, 테스트를 실행하도록 독려하는 한 줄, 모델이 허락 없이 일을 처리해 버려서 넣은 금지 문구, "편집 전에 문서 세 개를 먼저 읽어라" 같은 지시는 그것을 넣게 만든 모델이 사라진 뒤에도 저장소에 그대로 남습니다. 각각은 한 줄이지만 모두 합치면 모델이 매 요청에서 읽어야 하는 분량이 되고, 지시끼리 서로 어긋나기 시작합니다.
원문의 조언은 GPT-6 Astra 공식 활용 가이드와 짝을 이룹니다. 공식 가이드가 Responses API 파라미터 정리와 모델의 다섯 가지 행동 특성을 프롬프트로 조정하는 방법을 다뤘다면, 이번 블로그는 그 프롬프트가 실제로 놓이는 자리, 즉 저장소에 체크인된 지시 파일과 사용자 홈에 쌓인 스킬 폴더를 다룹니다. 공교롭게도 같은 시기에 Anthropic도 Claude Code의 시스템 프롬프트에서 80% 이상을 덜어낸 이유를 발표했습니다. 두 회사가 각자의 프런티어 모델을 내놓으면서 사용자에게 같은 숙제를 내주고 있는 셈이라, 아래에서는 원문의 항목을 하나씩 정리한 뒤 두 회사의 조언을 나란히 놓고 비교합니다.
스킬 설명 한 줄이 중요한 이유, 컨텍스트 예산은 2%입니다
원문이 말하는 스킬(Skill) 은 Markdown 파일로 저장된 프롬프트이며, 여기에 참고 자료와 스크립트를 함께 묶을 수 있습니다. 특정 워크플로우를 다루거나 특정 앱을 사용할 때의 지침으로 가장 쓸모가 있다는 것이 원문의 설명입니다. 형식 자체는 Agent Skills 개방형 표준을 따르고, 폴더 안에 SKILL.md 하나가 필수이며 scripts/, references/, assets/ 는 선택입니다. 표준 문서는 이 형식이 "원래 Anthropic이 개발해 개방형 표준으로 공개한 것"이며 여러 에이전트 제품이 채택했다고 밝히고 있습니다. 커뮤니티에서는 Anthropic이 Claude용으로 처음 공개한 Skills 기능으로 소개한 바 있고, 지금은 공개 명세로 관리됩니다.
my-skill/
  SKILL.md        # 필수: 지침 + 메타데이터(name, description)
  scripts/        # 선택: 실행 가능한 코드
  references/     # 선택: 참고 문서
  assets/         # 선택: 템플릿, 리소스
  agents/
    openai.yaml   # 선택: 표시 정보, 호출 정책, 도구 의존성
여기서 description 이 하는 일이 이 글의 핵심입니다. Codex가 스킬을 고르는 방식은 두 가지인데, 사용자가 /skills 를 실행하거나 $ 를 입력해 직접 고르는 명시적 호출(Explicit invocation) 과, 작업 내용이 스킬 설명과 맞으면 모델이 알아서 고르는 암묵적 호출(Implicit invocation) 입니다. 후자가 동작하려면 모델의 컨텍스트에 모든 스킬의 이름과 설명이 미리 올라가 있어야 합니다. 이것이 Codex 스킬 공식 문서가 말하는 점진적 공개(Progressive Disclosure) 의 첫 단계입니다. 표준 문서는 이 과정을 발견(Discovery), 활성화(Activation), 실행(Execution)의 세 단계로 정리합니다. 시작 시점에는 이름과 설명만 올라가고, 작업이 설명과 맞으면 그때 SKILL.md 전문을 컨텍스트에 읽어들이며, 그 뒤에 묶인 스크립트나 참고 문서를 필요한 만큼 불러옵니다.
원문은 사람들이 이제 프로젝트마다 스킬을 잔뜩 넣어 두는 것이 기본값이 되었다고 지적하면서, 여기에 두 가지가 겹친다고 말합니다. 많은 설명이 지나치게 길다는 것이 하나이고, 스킬을 너무 많이 넣으면 Codex가 설명을 줄여서 끼워 넣기 시작한다는 것이 다른 하나입니다. 모델이 보는 설명이 짧아질수록 어떤 스킬을 골라야 하는지 판단하기 어려워집니다. 공식 문서에는 이 동작의 구체적인 수치가 적혀 있습니다. 초기 스킬 목록은 모델 컨텍스트 윈도우의 최대 2%, 컨텍스트 윈도우를 알 수 없으면 8,000자까지만 쓰도록 제한되어 있고, 그 예산을 넘으면 Codex는 먼저 설명을 줄이며, 그래도 모자라면 일부 스킬을 초기 목록에서 빼고 경고를 표시할 수 있습니다.
실제로 Codex CLI는 이 상황에서 다음과 같은 경고를 출력합니다.
warning: Skill descriptions were shortened to fit the 2% skills context budget.
Codex can still see every skill, but some descriptions are shorter. Disable
unused skills or plugins to leave more room for the rest.
스킬 카탈로그가 늘어난 것도 이 예산을 압박하는 요인입니다. NVIDIA와 Hugging Face를 비롯한 여러 조직이 검증된 스킬 모음을 공개하면서 쓸 만한 스킬을 하나씩 설치하다 보면 목록이 금세 수십 개가 됩니다. 어떤 스킬을 몇 개나 어떤 순서로 쓸지 예측하는 문제는 별도의 연구 주제가 될 만큼 까다로워졌고, 설명이 잘린 상태에서는 그 판단이 더 어려워집니다.
이 예산은 초기 목록에만 걸리고, 모델이 스킬 하나를 고른 뒤에는 그 스킬의 SKILL.md 를 온전히 읽습니다. 즉, 설명이 잘리는 것은 읽는 양 의 문제가 아니라 고르는 정확도 의 문제입니다. 원문이 더 나쁜 경우로 꼽는 것도 같은 맥락인데, 설명끼리 서로 모순되거나 스킬을 써야 할 시점을 과장해서 적어 두면 모델이 작업에 도움이 되지 않는 지침을 불러오게 됩니다. 안 쓰는 스킬을 지우지 않고 비활성화만 하고 싶다면 ~/.codex/config.toml 에 [[skills.config]] 항목으로 enabled = false 를 지정하면 됩니다.
심화 학습: 스킬 형식과 컨텍스트 예산

좁은 트리거 조건, 적용 시점을 분명히 밝히는 설명문
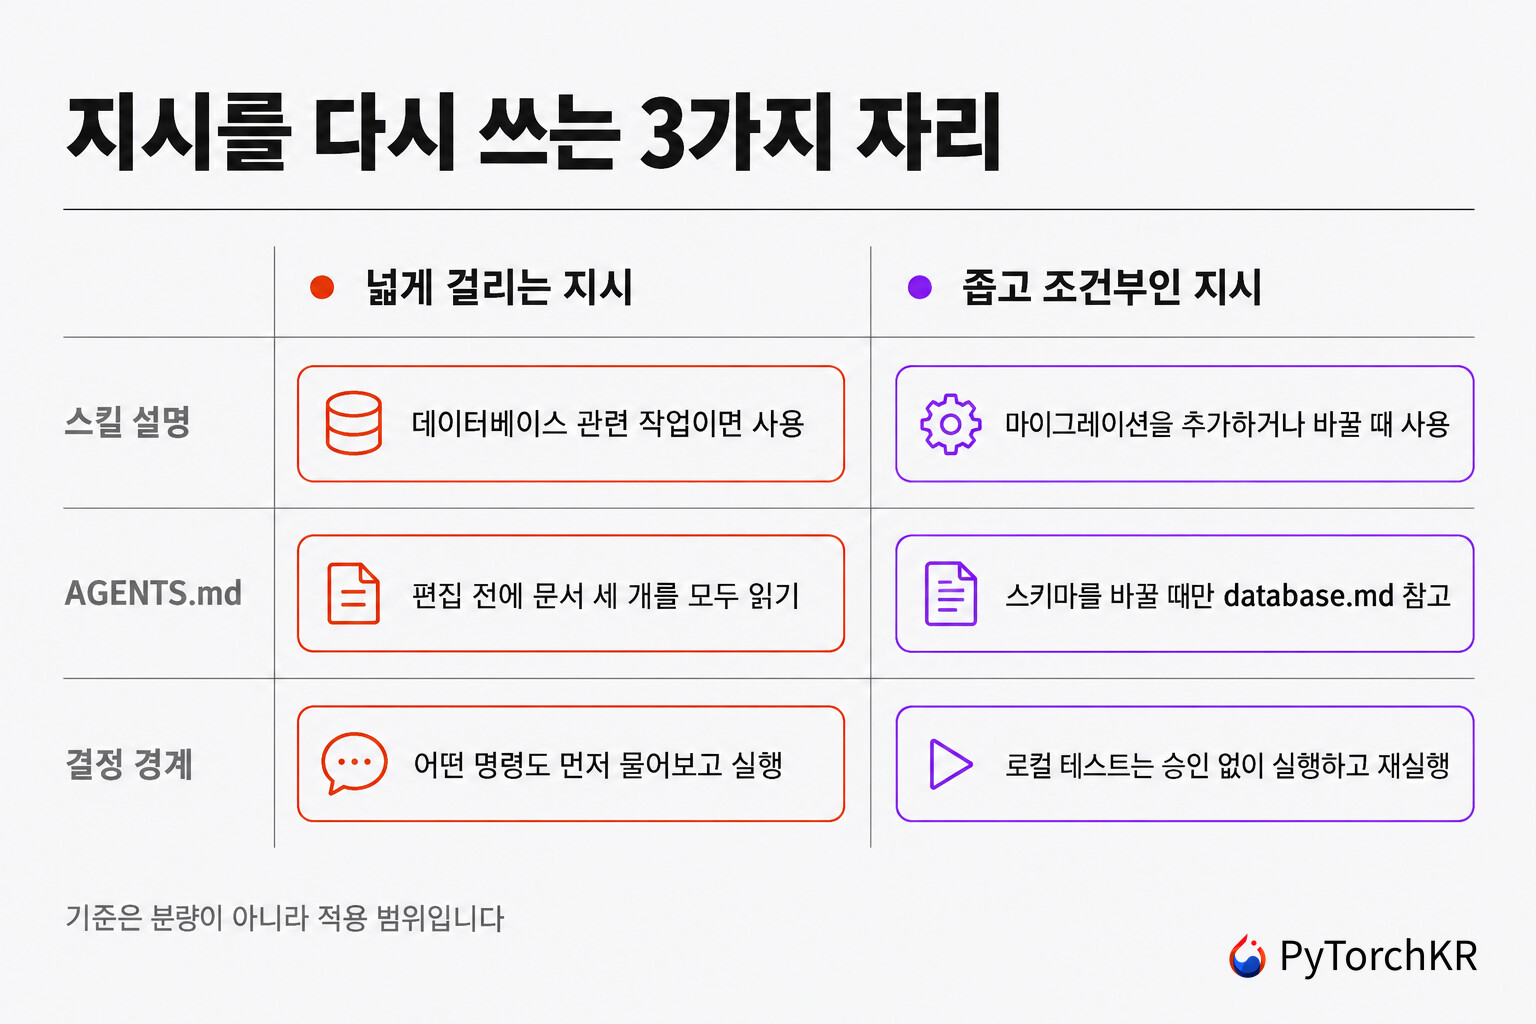
원문은 스킬을 만들 때 흔히 쓰는 $skill-creator 스킬의 지침을 최근에 갱신했다고 밝히면서, 실무에서 관찰된 실패 모드를 줄이기 위한 세 가지 원칙을 제시합니다. 첫 번째는 설명을 가능한 한 짧게 쓰되, 모델이 언제 이 스킬을 써야 하는지는 분명히 드러나게 하라는 것입니다. 원문이 든 예시를 그대로 옮기면 다음과 같습니다.
나쁜 예시입니다.
Create and validate Postgres schema migrations. Use when working with
databases, queries, models, or persistence.
좋은 예시입니다.
Create and validate Postgres schema migrations. Use when adding or changing
a migration, or reviewing its rollout.
두 설명의 앞 문장은 같고 뒤의 적용 범위만 다릅니다. 원문은 이 차이를 "나쁜 설명은 마이그레이션을 다뤄야 할 때만이 아니라 데이터베이스와 조금이라도 관련된 무엇을 건드리든 모델이 이 스킬을 쓰도록 밀어붙일 수 있다"고 설명합니다. databases, queries, models, persistence 는 백엔드 작업 대부분에 걸리는 낱말이라, 이 스킬은 스키마 마이그레이션과 무관한 조회 코드 수정에서도 선택될 수 있습니다. 반대로 adding or changing a migration, or reviewing its rollout 은 작업의 종류를 지정합니다.
공식 문서는 여기에 한 가지 실용적인 조언을 덧붙입니다. 암묵적 호출이 설명에 의존하므로, 설명이 짧아지더라도 매칭이 살아남도록 핵심 사용 사례와 트리거가 되는 낱말을 앞쪽에 배치하라는 것입니다. 위의 좋은 예시가 그 형태입니다. 첫 문장이 무엇을 하는 스킬인지 말하고, 둘째 문장이 언제 쓰는지를 좁게 한정합니다.
스킬을 읽는 것도 비용입니다, 루트 문서는 라우터로
두 번째 원칙은 점진적 공개입니다. 원문은 쓸모 있는 스킬의 핵심 지표로 이 항목을 꼽으면서, 스킬을 읽는 행위 자체가 컨텍스트를 차지해 압축(Compaction) 에 그만큼 가까워지고, 지금 작업에 해당되지 않는 지침까지 함께 들어온다고 지적합니다. 압축은 대화가 컨텍스트 한계에 닿았을 때 앞선 내용을 요약해 자리를 비우는 동작으로, 여기에 도달할수록 모델이 붙들고 있던 세부 사항이 흐려집니다.
처방은 구조입니다. 워크플로우가 여러 개인 스킬이라면 루트 문서를 최소한의 라우터(Router)로 만들고, 보조 문서와 스크립트를 가리키게 하라는 것입니다. 어디를 봐야 하는지 알 정도의 지침만 주고, 지금 상관없는 내용을 읽도록 강제하지 않는 것이 기준입니다.
my-skill/
  SKILL.md                    # 어떤 작업에 어느 문서를 볼지만 적는다
  references/
    migration-rollout.md      # 롤아웃 검토할 때만 읽는다
    schema-conventions.md     # 스키마를 새로 쓸 때만 읽는다
  scripts/
    validate.py               # 결정적 동작이 필요한 부분만 스크립트로
공식 문서도 같은 방향의 권고를 둡니다. 스킬 하나는 한 가지 일에 집중하게 하고, 결정적 동작이나 외부 도구가 필요한 경우가 아니면 스크립트보다 지침을 우선하라는 것입니다. $skill-creator 가 스킬을 만들 때도 지침만 있는 형태(Instruction-only) 가 기본값입니다. 워크플로우를 말로 설명하기보다 보여 주는 편이 쉽다면 Record & Replay로 작업을 녹화해 스킬 초안을 뽑을 수도 있습니다.
여정표 대신 판단 여지, 그리고 저장소 스킬은 다른 모델도 읽습니다
세 번째 원칙은 지침의 밀도에 관한 것입니다. 원문은 많은 스킬이 정교한 여정표나 레시피처럼 쓰여 있다고 지적합니다. 단계마다 무엇을 하고 다음에 무엇을 하라고 정해 둔 형태입니다. 이런 방식이 통했던 이유는 모델이 모호한 지시를 잘 다루지 못했기 때문인데, 모델이 뉘앙스와 모호함을 훨씬 잘 이해하게 되면서 지나치게 구체적인 지침은 이제 결과를 오히려 해칠 수 있다는 것입니다.
여기에 원문은 한 가지 단서를 답니다. 저장소에 체크인된 스킬은 다른 기여자의 에이전트도 읽는다는 점입니다. 그 에이전트는 다른 모델을 쓸 수 있고, GPT-5.6 Sol이나 Luna에게 도움이 되는 지침이 GPT-6 Astra에게는 과한 제약이 될 수 있습니다. Sol은 GPT-5.6 세대의 플래그십이고 Luna는 같은 세대에서 가장 빠르고 저렴한 티어입니다. 따라서 저장소에 남길 지침을 정할 때는 그 지침을 어떤 모델들이 읽게 될지를 함께 고려해야 합니다. 개인 홈 디렉토리의 스킬은 내가 쓰는 모델만 생각하면 되지만, .agents/skills 에 커밋하는 순간 그 파일은 팀 전체의 하네스(Harness) 설정이 됩니다.
스킬을 어디에 두느냐가 누가 읽는지를 정합니다
원문이 저장소 스킬과 개인 스킬을 구분한 이유는 Codex가 스킬을 찾는 위치가 여러 곳이기 때문입니다. 공식 문서는 REPO, USER, ADMIN, SYSTEM 네 가지 범위와 그에 딸린 여섯 곳의 탐색 위치를 정의하는데, 어느 위치에 파일을 두느냐가 곧 그 지침을 누가 읽게 되는지를 정합니다.
| 범위 | 위치 | 읽게 되는 대상 |
|---|---|---|
REPO |
$CWD/.agents/skills |
Codex를 실행한 디렉토리에서 일하는 사람 |
REPO |
$CWD/../.agents/skills |
상위 폴더를 공유하는 하위 모듈 전체 |
REPO |
$REPO_ROOT/.agents/skills |
그 저장소를 쓰는 모든 기여자 |
USER |
$HOME/.agents/skills |
나 자신, 내가 여는 모든 저장소에서 |
ADMIN |
/etc/codex/skills |
그 머신이나 컨테이너를 쓰는 모든 사용자 |
SYSTEM |
Codex에 기본 포함 | 모든 사용자, $skill-creator 가 여기 해당 |
Codex는 현재 작업 디렉토리부터 저장소 루트까지 올라가며 각 단계의 .agents/skills 를 훑습니다. 이름이 같은 스킬이 둘 있어도 병합하지 않고 둘 다 선택지에 노출하므로, 저장소에 커밋한 스킬과 홈 디렉토리에 둔 개인 스킬이 이름까지 같으면 모델이 어느 쪽을 골라야 할지 판단해야 합니다. 이름 충돌 자체가 원문이 지적한 서로 모순되는 설명의 한 형태인 셈입니다.
특정 스킬이 자꾸 엉뚱한 작업에서 선택되는데 지우기는 아까운 경우라면, 설명을 고치는 것 말고 다른 선택지도 있습니다. 스킬 폴더의 agents/openai.yaml 에 호출 정책을 지정하면 암묵적 호출만 막고 명시적 호출은 남길 수 있습니다.
policy:
  allow_implicit_invocation: false
이 값을 false 로 두면 Codex는 사용자 프롬프트를 보고 이 스킬을 스스로 고르지 않고 $ 로 직접 부를 때만 동작합니다. 적용 범위가 정말 넓지만 아무 때나 실행되면 곤란한 배포 스킬처럼, 트리거 조건을 좁게 다시 쓰기 어려운 경우에 쓰는 장치입니다.
스킬을 여러 저장소에 배포하고 싶다면 폴더를 복사해 다니는 대신 플러그인(Plugin)으로 묶는 것이 공식 권고입니다. 플러그인은 스킬 여럿과 MCP 서버 연결을 한 패키지로 묶어 ChatGPT와 Codex가 공유하는 디렉토리로 배포합니다. 예제를 모아 두었던 openai/skills 저장소는 폐기되었고, 지금은 openai/plugins 저장소와 플러그인 제작 가이드가 그 자리를 대신합니다.
AGENTS.md는 저장소 전체에 걸리므로 조건부로 씁니다
AGENTS.md는 코딩 에이전트를 위한 개방형 문서 형식으로, 2026년 9월 현재 6만 개가 넘는 오픈소스 프로젝트가 채택하고 있습니다. OpenAI가 2025년에 제안한 뒤 여러 에이전트가 함께 읽는 사실상의 표준이 되었습니다. 스킬과 결정적으로 다른 점은 적용 범위입니다. 스킬은 모델이 고를 때만 읽히지만, AGENTS.md 는 모델이 그 저장소에서 일하는 동안 항상 적용됩니다. 원문이 각 지시를 자주 다시 보고 아직도 필요한지 물어보라고 권하는 이유입니다.
원문이 드는 예시는 "필요한 것만 읽게 하라"는 항목입니다.
나쁜 예시입니다.
Before every edit, read architecture.md, database.md, and deployment.md.
좋은 예시입니다.
Use architecture.md for service boundaries, database.md for schema changes,
and deployment.md when preparing a deployment.
원문은 나쁜 예시의 문제를 오타 수정에 빗대어 설명합니다. 편집할 때마다 문서 더미나 저장소 전체 지도를 요구하는 것은 오타 하나를 고치는 작업에는 과하고, GPT-6 Astra는 모든 변경 전에 프로젝트 전체를 훑도록 떠밀지 않아도 무엇을 읽어야 하는지 스스로 알아낼 수 있다는 것입니다. 원문은 이 상황을 "모델에게 매 편집 전에 파일을 읽게 하는 것은 컨텍스트를 태우고 작업을 느리게 만드는 훌륭한 방법"이라고 적었습니다. 다만 문서를 가리키는 것 자체는 여전히 도움이 되며, 조건부이기만 하면 된다는 단서를 덧붙입니다. 좋은 예시의 문장 구조가 그것으로, 각 문서를 어떤 상황에서 보라는 대응 관계를 명시합니다. 그리고 원문은 그 문서들을 최신 상태로 유지하라는 당부도 함께 남깁니다.
원문의 예시는 문장 하나 단위이지만, 실제 저장소의 AGENTS.md 는 이런 문장이 여러 개 쌓여 있는 형태입니다. 위의 기준을 그대로 적용하면 다음과 같이 바뀝니다. 먼저 이전 모델 시절에 쌓인 형태입니다.
# AGENTS.md

- Before every edit, read architecture.md, database.md, and deployment.md.
- Always run the full test suite before you finish.
- Never modify files outside the package you were asked to change.
- Never run any command without asking the user first.
- Stop and report back after the first implementation so I can review it.
같은 내용을 조건부 지시와 완료 정의로 다시 쓴 형태입니다.
# AGENTS.md

## Docs
Use architecture.md for service boundaries, database.md for schema changes,
and deployment.md when preparing a deployment.

## Tests
The local tests use disposable fixtures and have no production access. Run
them, fix failures caused by the requested change, and rerun affected tests
without asking for approval at each step.

## Scope
Changes outside the requested package need a note in the summary explaining
why they were necessary.
바뀐 지점은 세 가지입니다. 문서를 읽는 조건이 상황별로 갈렸고, 전체 테스트 스위트를 무조건 실행하라는 지시가 안전 근거와 함께 범위를 좁힌 허용 문장으로 바뀌었으며, Never 로 시작하던 두 줄 중 하나는 금지 대신 설명 요구로 바뀌고 다른 하나는 사라졌습니다. 마지막 줄의 "첫 구현 뒤에 멈추고 보고하라" 는 아래 지속성 항목에서 다루는 이유로 지웠습니다. 이 형태가 정답이라는 뜻은 아니고, 각 줄이 지금 모델에게도 필요한지를 묻는 절차의 결과입니다.
지우는 것만 있는 것은 아닙니다. 이전 모델은 테스트를 실행하고 자기 작업을 검증하도록 독려해 줘야 했지만, GPT-6 Astra는 그것을 스스로 하기 때문에 같은 지시가 오히려 불필요한 테스트를 유발합니다. 반대로 Astra는 철저하게 일하지만 작업을 어디까지 밀고 나갈지에 대해서는 더 조심스러워질 수 있어서, 때로는 계속하라는 신호가 필요합니다. 원문은 로컬 테스트 스위트처럼 안전하다고 아는 워크플로우에 대해서는 AGENTS.md 로 권한을 열어 주라고 권하며, 다음 문장을 예시로 제시합니다.
로컬 테스트는 일회용 픽스처(Fixture)를 사용하며 프로덕션 접근 권한이 없습니다. 테스트를 실행하고, 요청된 변경으로 생긴 실패를 고치고, 영향을 받은 테스트를 다시 실행하되 매 단계마다 승인을 요청하지 마세요.
"The local tests use disposable fixtures and have no production access. Run them, fix failures caused by the requested change, and rerun affected tests without asking for approval at each step."
이 문장이 하는 일을 뜯어보면 세 부분입니다. 앞의 한 문장이 왜 안전한지(일회용 픽스처, 프로덕션 접근 없음)를 밝히고, 가운데가 허용하는 행동을 열거하고, 마지막이 승인 요청을 생략해도 되는 범위를 지정합니다. 근거 없이 "승인 없이 진행하라" 고만 적으면 모델은 그 범위가 어디까지인지 알 수 없으므로, 판단의 재료를 함께 주는 형태입니다.
AGENTS.md와 저장소 지시 설계
결정 경계, 이전 모델을 막으려고 쓴 문구가 Astra에서는 과하게 작동합니다
원문이 별도 항목으로 떼어 놓은 주제는 경계를 서술하는 방식입니다. 이전 모델이 허락 없이 일을 처리해 버린 경험이 있다면, 그것을 막으려고 강한 문구를 넣어 두었을 가능성이 큽니다. 원문은 그런 문구가 유용할 수 있다고 인정하면서도, GPT-6 Astra는 OpenAI의 모델 중 가장 정렬(Alignment)이 잘 된 모델이라 판단력이 훨씬 나아졌고 안전하다고 알지 못하면 작업을 수행하지 않으므로, 그에 맞게 대해야 한다고 말합니다.
문제는 그 강한 문구가 Astra에서는 다르게 작동한다는 점입니다. 원문의 표현을 옮기면, 다른 모델이 선을 넘지 못하게 하려고 적어 둔 경계 문구를 그대로 둔 채 Astra로 옮기면 "Astra가 그 문구를 너무 진지하게 받아들여, 여러분이라면 계속하기를 바랐을 지점에서 작업을 멈출 수 있다"는 것입니다. 먼저 물어보라고 적어 둔 문구였다면, 사용자 입장에서는 모델이 확인을 요청하며 작업을 멈추는 증상으로 나타납니다.
이 증상의 원인을 찾는 도구는 GPT-6 Astra 공식 활용 가이드에 이미 나와 있습니다. 가이드는 모델이 멈추거나 방향을 바꾼 원인이 된 스킬과 지시를 스스로 지목하게 하는 프롬프트를 제시하는데, 지시 파일이 여러 개 로드되는 환경에서 조용히 상충하는 한 줄을 찾아내는 용도입니다. 원문의 결정 경계 항목과 그 프롬프트를 함께 쓰면, 감사 대상을 눈으로 전부 훑는 대신 모델이 걸린 지점만 지목하게 할 수 있습니다.
지속성, 첫 구현에서 돌아오는 모델에게 완료를 먼저 정의합니다
마지막 항목은 지속성(Persistence) 입니다. 원문은 GPT-5.6 Sol이 요청을 받으면 긴 구간을 이어서 작업하는 데 익숙한 사용자라면, GPT-6 Astra가 언제 멈출지에 대해 더 조심스럽게 느껴질 수 있다고 설명합니다. 아직 할 일이 남아 있는데도 첫 구현에 도달한 시점에 검토를 받으러 돌아올 수 있다는 것입니다.
원문이 제시하는 처방은 시작하기 전에 완료를 정의하는 것입니다. Astra가 완전히 끝낼 때까지 계속하도록 밀어 줘야 할 수도 있는데, 작업에 구현을 실행해 보는 것과 결과를 확인하는 것, 실패한 것을 고치는 것이 포함된다면 그 세 가지를 요청에 함께 적으라는 것입니다. 여기에 원문이 덧붙이는 지적이 실무적으로 중요합니다. 첫 구현 뒤에 검토를 위해 멈추라는 요구사항은 모델을 더 이른 정지 지점으로 끌어당깁니다. 그러니 그 정지가 정말로 여러분이 내려야 하는 결정인지 확인해 보라는 것입니다. 첫 구현을 검토하겠다는 습관이 이전 모델 시절에 생긴 것이라면, Astra에서는 그 습관 자체가 작업을 절반에서 끊는 원인이 됩니다.
첫 시도를 넘어 더 탐색하게 하고 싶다면 무엇을 탐색할지와 어디서 멈출지를 말하라는 것이 원문의 마지막 조언입니다. 탐색 범위를 열어 두기만 하면 모델이 멈출 지점을 스스로 정해야 하고, 조심스러운 쪽으로 정해집니다.
OpenAI와 Anthropic이 같은 시기에 내놓은 같은 숙제
원문을 Anthropic이 2026년 7월에 발행한 Claude 5 세대 컨텍스트 엔지니어링 규칙과 나란히 놓으면 겹치는 부분이 상당합니다. Anthropic은 Claude Code의 시스템 프롬프트에서 80% 이상을 덜어내고도 자사 코딩 평가에서 측정 가능한 성능 손실이 없었다고 밝히면서, 이전 모델을 안전하게 쓰려고 넣어 둔 강한 지시가 새 모델에서는 판단을 막는 제약으로 작동한다고 설명했습니다. 위의 결정 경계 항목과 같은 진단입니다.
| 항목 | OpenAI Codex 팀 (GPT-6 Astra) | Anthropic (Claude 5 세대) |
|---|---|---|
| 대상 | 저장소와 사용자의 스킬, AGENTS.md, 작업 프롬프트 |
제품의 시스템 프롬프트, 사용자의 스킬, CLAUDE.md |
| 진단 | 이전 모델을 위해 쌓은 지시가 서로 충돌하고 컨텍스트를 소모 | 과잉 제약이 한 컨텍스트에 모여 서로 충돌 |
| 지시 밀도 | 여정표와 레시피 형태의 구체적 지침을 완화 | 규칙에서 판단으로, 세부 규칙 대신 기준 제시 |
| 컨텍스트 관리 | 점진적 공개, 루트 SKILL.md 를 라우터로 |
앞쪽 적재에서 점진적 공개와 지연 로딩으로 |
| 자동화 도구 | $skill-creator 지침 갱신, Astra에게 감사 위임 |
claude doctor 로 스킬과 CLAUDE.md 크기 점검 |
| 더하는 항목 | 로컬 테스트 권한과 완료 정의를 같은 글에서 제시 | 이 글은 삭제에 집중, 같은 항목은 Fable 5 프롬프팅 가이드에 따로 |
눈에 띄는 것은 마지막 행입니다. 컨텍스트 엔지니어링을 다룬 Anthropic의 글이 무엇을 지울지에 집중하는 반면, OpenAI의 이번 글은 지우는 항목과 더하는 항목을 한 글에 함께 둡니다. 로컬 테스트 권한을 열어 주는 문장과 완료 정의가 후자입니다.
다만 이것을 두 회사의 입장 차이로 읽으면 곤란합니다. Anthropic도 Claude Fable 5 프롬프팅 가이드에서는 조기 종료를 별도 항목으로 다룹니다. 긴 세션에서 모델이 도구 호출 없이 의도만 남기고 턴을 끝내거나 이미 근거가 충분한데도 허락을 구하려고 멈추는 경우를 지적하면서, 사람이 지켜보지 않는 자율 파이프라인에 넣을 시스템 리마인더(System Reminder)를 제시합니다. 그 리마인더의 마지막 문장은 "턴을 끝내기 전에 마지막 문단을 확인하라. 그것이 계획, 분석, 질문, 다음 단계 목록, 혹은 아직 하지 않은 일에 대한 약속이라면, 지금 도구 호출로 그 일을 하라"입니다. OpenAI가 "시작하기 전에 완료를 정의하라"로 푸는 문제를 Anthropic은 "턴을 끝내기 전에 마지막 문단을 점검하라"로 푸는 셈입니다. 프런티어 모델이 조심스러워지는 경향은 한 회사의 특성이 아니라 이 세대의 공통 증상에 가깝고, 두 회사의 최신 가이드가 그것을 각자의 자리에서 다루고 있습니다.
한 저장소를 두고 Codex와 Claude Code를 함께 쓰는 팀이라면 이 대조를 그냥 읽고 넘기기 어렵습니다. AGENTS.md 는 여러 에이전트가 함께 읽는 형식이고 스킬도 같은 개방형 표준을 공유하므로, 한 저장소의 지시 파일 하나가 서로 다른 회사의 모델에 동시에 걸립니다. 원문이 저장소 스킬을 두고 "다른 기여자의 에이전트도 읽는다"고 단서를 단 이유가 여기 있습니다. Astra를 위해 금지 문구를 걷어낸 결과가 다른 모델에서는 안전장치를 걷어낸 것이 될 수 있으므로, 모델 전용 지침은 저장소 루트가 아니라 개인 홈 디렉토리나 사용자 프롬프트 쪽에 두는 편이 안전합니다.
또 하나 짚어 둘 점은 두 회사 모두 이 작업을 모델 세대가 바뀔 때마다 반복하는 정기 점검으로 규정한다는 것입니다. 원문도 릴리즈마다 기존 가정을 다시 볼 만했지만 GPT-6 Astra에서는 그것이 어느 때보다 중요하다고 적습니다. 하네스에 쌓인 지시를 일회성 설정이 아니라 유지보수 대상으로 보는 시각은 하네스 엔지니어링 자료 모음처럼 이 주제만 따로 모으는 저장소가 생길 만큼 자리를 잡았습니다.
지금 저장소에서 점검할 여섯 가지
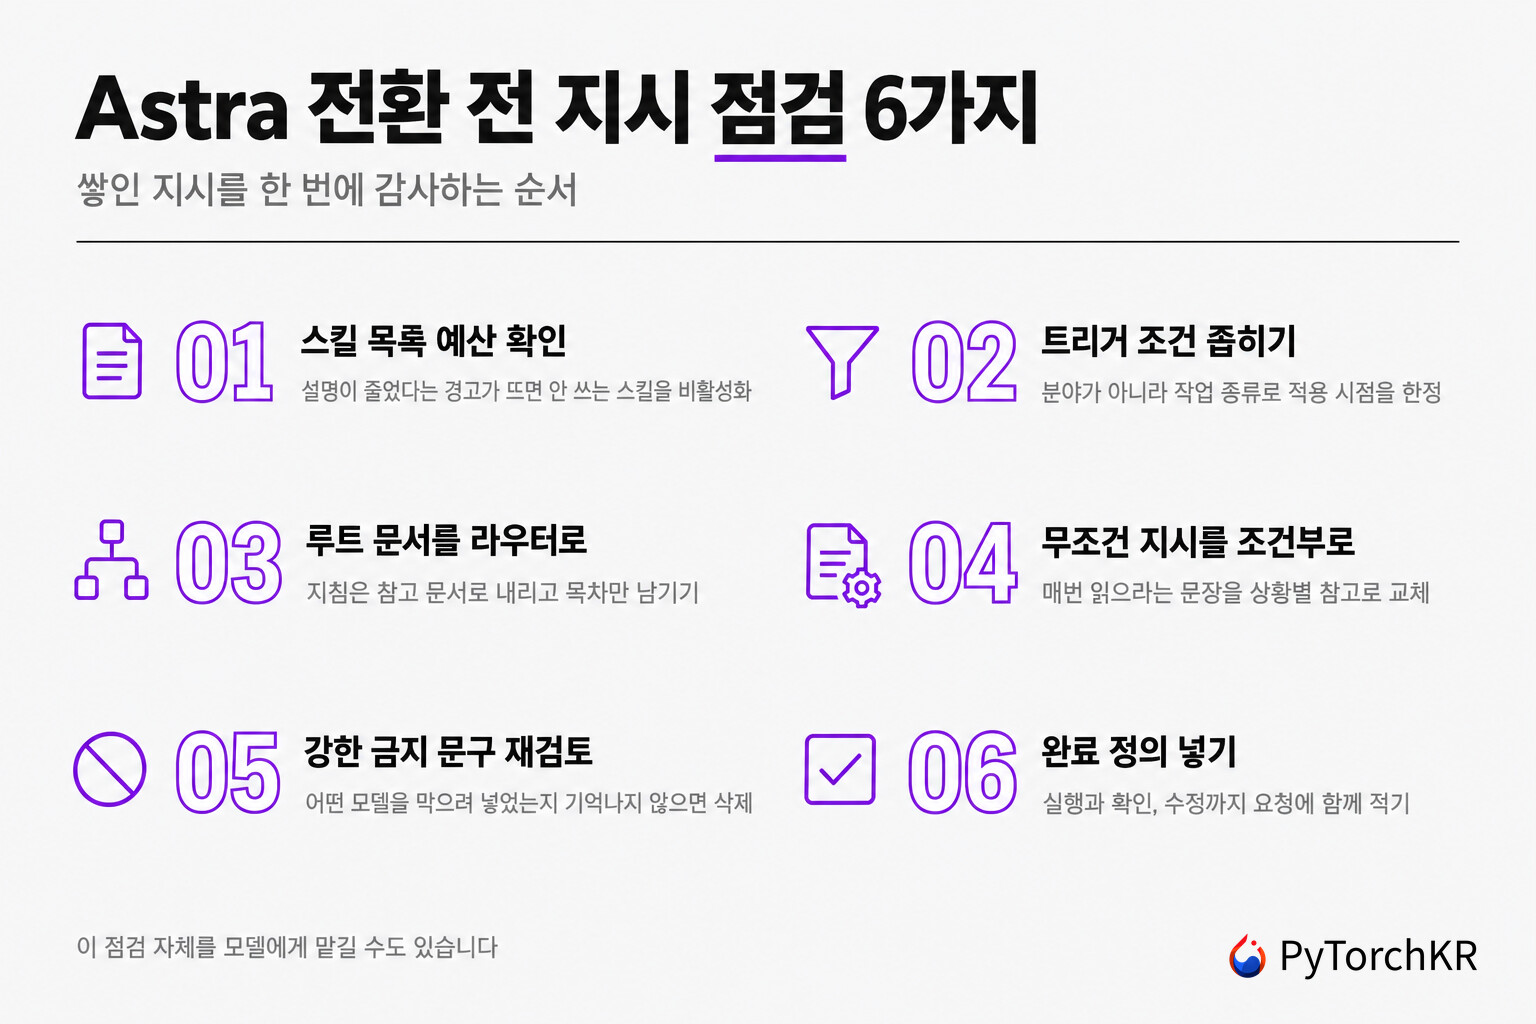
원문의 내용을 실제 점검 항목으로 옮기면 다음과 같습니다.
스킬 목록이 예산을 넘고 있는지 확인합니다. Codex를 실행했을 때 설명이 줄어들었다는 경고가 뜬다면 이미 2% 예산을 넘긴 상태입니다. 안 쓰는 스킬과 플러그인을 ~/.codex/config.toml 의 [[skills.config]] 로 비활성화해 자리를 돌려줍니다.
설명문의 트리거 조건을 좁힙니다. Use when working with databases... 처럼 분야를 통째로 가리키는 문장을 Use when adding or changing a migration... 처럼 작업 종류로 바꿉니다. 설명이 잘려도 매칭이 살아남도록 핵심 낱말을 앞쪽에 둡니다.
루트 SKILL.md 를 라우터로 바꿉니다. 워크플로우가 여러 개인 스킬은 루트 문서에 어느 상황에 어느 문서를 볼지만 적고, 실제 지침은 references/ 로 내립니다.
AGENTS.md 의 무조건 지시를 조건부로 바꿉니다. "매번 X를 읽어라" 를 "Y를 할 때 X를 참고하라" 로 바꾸고, 테스트를 실행하라고 독려하는 문장이 남아 있으면 지웁니다.
강한 금지 문구를 다시 읽습니다. 어떤 모델의 어떤 행동을 막으려고 넣은 문장인지 기억나지 않는다면, 그 문장은 지금 모델에게는 과한 제약일 가능성이 높습니다.
작업 프롬프트에 완료 정의를 넣습니다. 실행과 결과 확인, 실패 수정까지 포함해야 하는 작업이라면 그것을 요청에 적고, 습관적으로 붙이던 "첫 구현 후 검토받아라" 를 정말 필요한지 확인합니다.
원문은 마지막 문단에서 이 점검을 사람이 손으로 다 할 필요는 없다고 말합니다. 새 모델은 집을 정리할 좋은 기회이지만 모든 것을 수동으로 검토할 필요는 없으므로, 이 글에서 논의한 내용을 기준으로 GPT-6 Astra에게 감사를 맡기고, 그다음에는 이전에는 시도하지 않았을 것을 만들러 가라는 것입니다. 지시를 정리하는 작업 자체를 에이전트에게 넘기라는 제안이라, 감사 프롬프트를 한 번 써 두면 다음 모델 세대에서도 그대로 재사용할 수 있습니다.
 Rethinking skills and prompts for GPT-6 Astra 소개 블로그
Codex 스킬 공식 문서
AGENTS.md 공식 사이트
Agent Skills 개방형 표준 명세
 OpenAI Plugins 저장소 (Codex 스킬과 플러그인 예제)
더 읽어보기
-
OpenAI가 공개한 GPT-6 Astra 공식 활용 가이드: 자주 되묻는 모델을 끝까지 일하게 하는 프롬프팅과 마이그레이션
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
Anthropic, Claude Code 시스템 프롬프트 80% 삭제: Claude 5 세대 컨텍스트 엔지니어링 규칙 6가지
-
Anthropic, 에이전트 스킬의 테스트, 측정 및 개선의 자동화를 지원하도록 skill-creator 플러그인 개선
-
Awesome Harness Engineering: AI 에이전트를 안정적으로 만드는 하네스 엔지니어링 자료 모음
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
