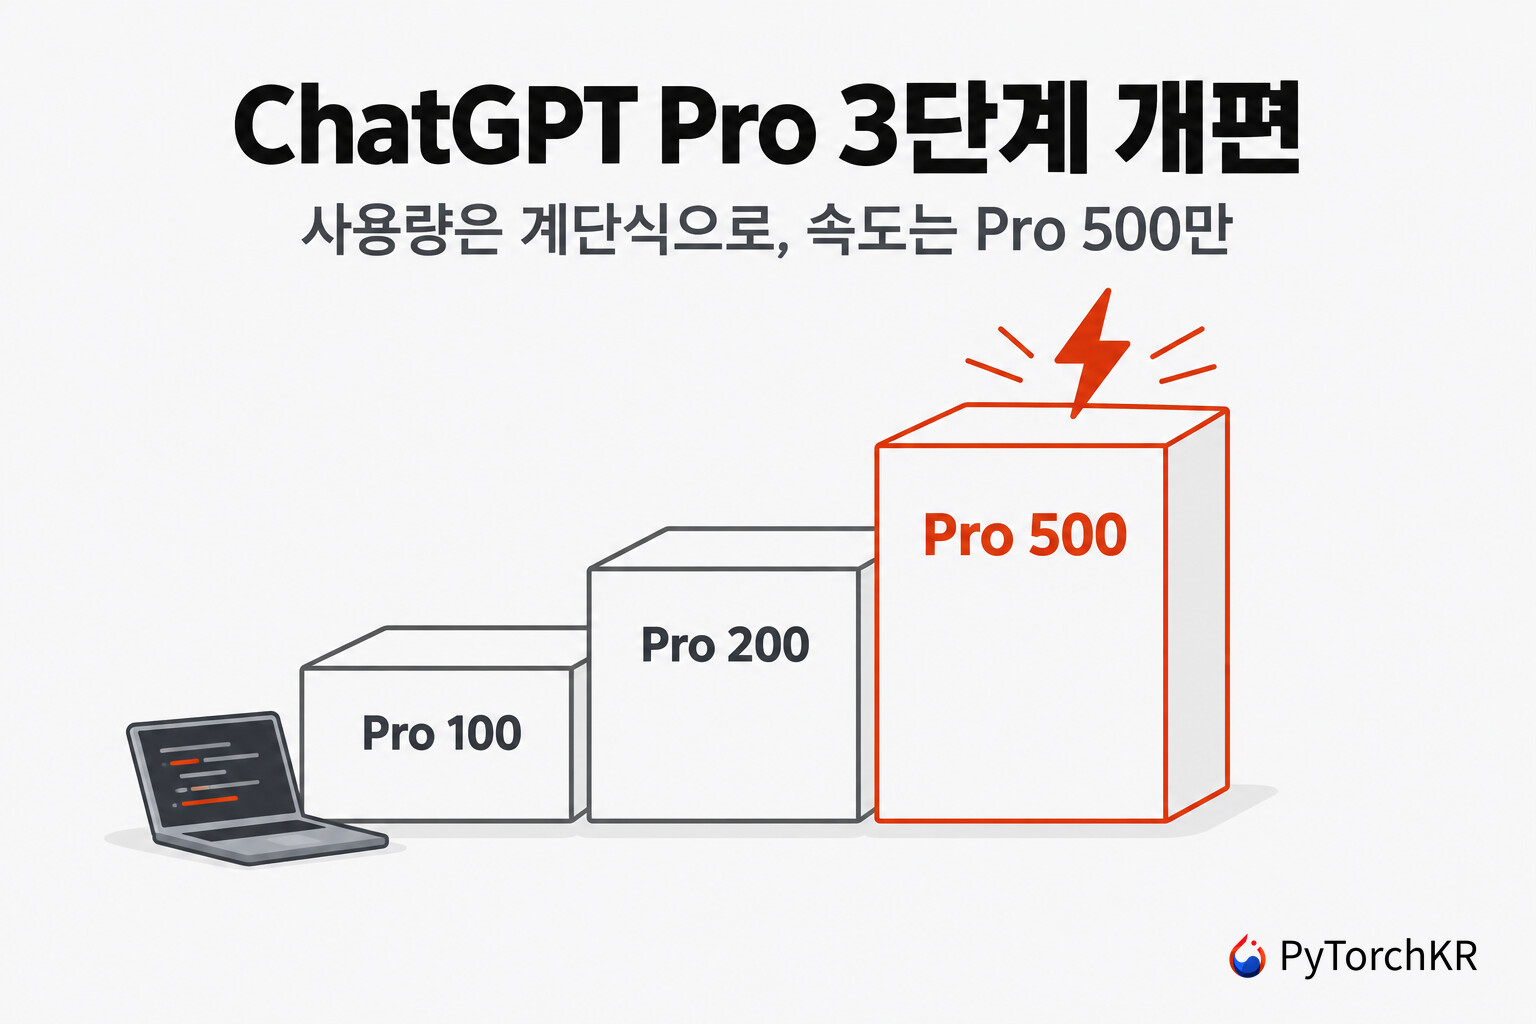
ChatGPT Pro 요금제 개편 소개
OpenAI가 2026년 9월 29일 ChatGPT Pro 요금제를 Pro 100(월 $100), Pro 200(월 $200), Pro 500(월 $500) 의 세 등급으로 재편했습니다. 새로 추가된 Pro 500은 가장 많은 사용량과 함께 GPT-6 Astra의 초고속 모드인 Ultrafast 를 쓸 수 있는 유일한 개인 요금제이고, 기존 Pro 200은 가격은 그대로 두되 포함 사용량을 낮췄습니다.
이번 개편은 DevDay 2026에서 함께 발표된 25가지 소식 중 하나로, 리캡에서는 두 문장으로만 소개되었습니다. 하지만 실제 구독자 입장에서는 영향이 큰 변화입니다. 같은 $200를 내는 Pro 200 구독자라도 언제 가입했는지에 따라 10월 29일까지는 사용량이 다르고, Pro 500의 Ultrafast는 빨라지는 만큼 사용량을 더 빨리 소진하도록 설계되어 있기 때문입니다. 게다가 ChatGPT Work와 Codex가 사용량을 공유하므로, 코딩 에이전트를 주로 쓰는 개발자라면 어떤 등급이 자기 작업량에 맞는지 다시 따져 볼 필요가 있습니다.
이 글은 Pro 요금제 도움말 문서를 중심으로, Codex의 속도(Speed) 문서와 요금(Pricing) 문서, 그리고 API의 Ultrafast 모드 가이드를 함께 대조해 정리했습니다. 무엇이 바뀌었는지, 기존 구독자에게 어떤 일이 생기는지, Ultrafast가 실제로 무엇을 사고파는 기능인지를 차례로 살펴보겠습니다.
무엇이 바뀌었나: 세 등급의 가격과 사용량
한눈에 보는 Pro 100, Pro 200, Pro 500
도움말 문서는 세 등급의 차이를 "Pro 200은 Pro 100보다 많은 사용량을, Pro 500은 세 등급 중 가장 많은 포함 사용량을 제공한다"고만 설명하고 구체적인 배수는 적지 않습니다. 배수는 두 곳에서 확인됩니다. Pro 100과 Pro 200은 Codex와 ChatGPT를 담당하는 OpenAI의 Tibo(Thibault Sottiaux)가 발표 당일 X에 올린 설명에서, Pro 500은 영문 DevDay 리캡에서 나옵니다.
| 등급 | 월 요금 (USD) | 사용량 (Plus 대비) | Ultrafast | 출처 |
|---|---|---|---|---|
| Plus | $20 | 1배 | 미포함 | 기준 |
| Pro 100 | $100 | 5배 | 미포함 | Tibo의 X 게시물 |
| Pro 200 | $200 | 10배 (기존 구독자는 10월 29일까지 20배) | 미포함 | Tibo의 X 게시물 |
| Pro 500 | $500 | 25배 | 포함 | 영문 DevDay 리캡 |
세 등급 모두 월 단위로만 결제할 수 있고, 연간 결제나 여러 달 선결제는 제공하지 않습니다. ChatGPT 요금 페이지에 따르면 Pro 공통으로 GPT-6 Astra 기반의 Pro 추론, 상시 에이전트 dot, 무제한 이미지 생성(남용 방지 한도 적용), 최대 수준의 딥 리서치와 메모리가 포함되며, GPT Reasoning 모델의 전체 컨텍스트 창은 400K 토큰입니다. 또한 Codex 요금 문서에 따르면 Pro 요금제에는 현재 5시간 사용량 한도가 없습니다. 다만 주간 한도는 적용될 수 있고, Plus의 Codex 사용량은 여전히 5시간 단위로 집계됩니다. Pro 500에는 Ultrafast 외에 차이가 하나 더 있습니다. DevDay 리캡에 따르면 OpenAI가 호스팅하는 브라우저에서 에이전트가 작업하는 Agents API의 컴퓨터 사용(computer use)이 Codex와 ChatGPT Work에서는 Pro 500과 Enterprise에만 제공됩니다. 데스크톱 앱의 기존 Computer Use 기능은 Codex 요금 비교표에서 Plus와 Pro 모두 지역 제한이 있는 기능으로 표시되어 있어, Pro 500 전용인 것은 이 호스팅 브라우저 방식으로 보입니다.
비율로 보면 "대량 구매 할인"이 사라졌다
위 표를 달러당 사용량으로 바꿔 보면 이번 개편의 성격이 드러납니다. Plus는 $20에 1배, Pro 100은 $100에 5배, Pro 200은 $200에 10배, Pro 500은 $500에 25배이므로, 네 요금제 모두 $20당 Plus 1배분이라는 같은 비율 을 갖게 되었습니다. 개편 전 Pro 200은 $200에 20배, 즉 $20당 2배분으로 Plus보다 두 배 효율적인 요금제였습니다.
따라서 이제는 비싼 요금제일수록 단가가 싸다는 계산이 성립하지 않습니다. 등급을 고르는 기준은 단가가 아니라 한 달에 필요한 총량 과 Ultrafast가 필요한지 두 가지로 좁혀집니다. 사용량이 Pro 100의 5배로 충분하다면 Pro 200을 유지할 이유가 약해지고, 반대로 Pro 200의 10배를 넘게 쓰는 사람은 Pro 500으로 올라가도 단가 손해가 없습니다.
다만 이 배수는 모두 Plus 대비 상대값 이라는 점에 주의해야 합니다. Tibo는 같은 게시물에서 "바닥(floor)을 높이면서 요금제 간 상대적 차이를 바꾸는 것"이라고 설명했습니다. Plus의 기준 사용량 자체가 이번에 늘어났다는 뜻이므로, Pro 200의 배수가 20배에서 10배로 줄었다고 해서 절대 사용량이 정확히 절반이 되었다고 단정할 수는 없습니다. 배수가 어느 한도를 기준으로 하는지(사용량을 공유하는 Codex와 ChatGPT Work의 한도인지, 채팅의 모델별 한도까지 포함하는지)도 공식 문서에는 명시되어 있지 않습니다. 참고로 Codex 요금 문서에 따르면 Plus와 Pro에서는 ChatGPT for Excel도 같은 사용량 한도를 공유합니다. OpenAI는 절대 사용량을 공개하지 않으며, 현재 한도와 초기화 시각은 사용량 대시보드나 Codex CLI의 /status 명령으로 확인해야 합니다.
Pro 200 구독자에게 생기는 일
신규 가입 재개와 낮아진 사용량
Pro 200은 9월 초 GPT-6 Astra 출시 이후 수요가 몰리면서 신규 가입이 멈췄던 요금제입니다. ChatGPT Plus 도움말에는 지금도 "2026년 9월 10일부터 Pro $200 요금제(Pro 20X)의 신규 가입과 업그레이드를 일시 중단한다"는 공지가 남아 있고, 이 기간에도 기존 Pro 200 구독과 Pro 100 가입은 영향을 받지 않았습니다. 공지의 Pro 20X 라는 이름이 보여 주듯, 개편 전 Pro 200은 Plus의 20배 요금제였습니다. 이번 개편으로 신규 가입이 다시 열렸지만, 도움말 문서는 "유예(grandfathering) 대상이 아닌 신규 구독에는 이전보다 낮은 사용량이 적용된다"고 밝히며 그 이유를 "점점 더 효율적이 되는 모델을 반영한 것"이라고 설명합니다. 월 요금은 $200 그대로입니다.
기존 구독자 유예 조건
기존 구독자에게는 한시적인 유예가 있습니다. 조건과 예외를 정리하면 다음과 같습니다.
- 유예 대상: 적격 기준일(eligibility cutoff) 시점에 Pro 200 구독이 활성 상태였거나, 그 전 7일 사이에 활성 상태였던 구독
- 유예 기간: 활성 구독을 유지하는 동안 2026년 10월 29일까지 이전 사용량을 유지하며, 그 이후에는 낮아진 사용량으로 전환됩니다. 요금은 계속 월 $200입니다.
- 해지 후 재가입: 기준일 전 7일 사이에 구독이 만료되었던 사람도 다시 가입하면 10월 29일까지 이전 사용량을 받을 수 있습니다. 해지 예약은 즉시 구독을 끝내지 않으므로, 현재 결제 주기가 끝나기 전에는 해지를 취소할 수 있습니다.
- 안내 방식: 이 변경의 영향을 받는 사용자에게만 세부 내용이 담긴 이메일이 발송됩니다. Tibo는 기존 구독자에게 "상당한 추가 크레딧"도 지급한다고 밝혔습니다.
- Pro 500 기능은 아님: 이전 사용량을 유지하더라도 구독은 여전히 Pro 200이며, 요금제가 업그레이드되거나 Ultrafast가 추가되지는 않습니다.
도움말 문서는 적격 기준일의 정확한 날짜를 적지 않았습니다. 자신이 유예 대상인지는 OpenAI의 안내 이메일을 받았는지로 확인하고, 실제 남은 한도는 사용량 대시보드에서 확인하는 것이 확실합니다.
10월 29일 이후를 위한 선택지
유예가 끝나면 기존 Pro 200 구독자는 세 가지 중 하나를 고르게 됩니다. 사용량이 5배로 충분하다면 Pro 100으로 내려가도 앞서 본 것처럼 단가 손해가 없습니다. 10배 안쪽이면 Pro 200을 유지하고, 한도가 부족한 달에만 크레딧을 사서 채우는 방법이 있습니다. 매달 10배를 넘기거나 에이전트 응답 속도가 작업의 병목이라면 Pro 500이 맞습니다. 등급 변경은 설정 → 내 플랜 에서 할 수 있으며, 해지는 구독을 구매한 플랫폼(ChatGPT 웹, Apple, Google Play)에서 해야 합니다. 앱을 삭제한다고 구독이 해지되지는 않습니다.
Ultrafast: 더 빠른 토큰 생성과 더 빠른 사용량 소진
Ultrafast란 무엇인가
Ultrafast 는 OpenAI가 "속도가 가장 중요한 작업을 위한 프리미엄 속도 등급"이라고 부르는 서비스 등급(service tier) 입니다. 모델 자체가 바뀌는 것이 아니라 같은 모델을 더 빠른 추론(inference) 인프라에서 실행하는 방식으로, 앞서 GPT-5.6 Sol을 대상으로 공개된 Ultrafast 프리뷰에서 OpenAI는 이 등급이 Cerebras와의 협력으로 구동된다고 밝혔습니다. 다만 이번 GPT-6 Astra Ultrafast의 인프라는 리캡과 문서에 따로 언급되어 있지 않습니다. Cerebras의 웨이퍼 스케일 추론 하드웨어는 CS-4 출시 소개 글에서도 다룬 바 있습니다. 당시 프리뷰는 GPT-5.6 Sol을 표준 처리 대비 최대 14배, 초당 최대 750 출력 토큰으로 실행하는 일부 고객 대상의 제한 공개였고, 이번에 GPT-6 Astra에서 정식으로 제공되기 시작했습니다.
리캡에 따르면 Ultrafast는 Codex에서 최대 8배(초당 300토큰), API에서 최대 6배 빠른 토큰 생성을 제공합니다. 속도 문서는 이 8배가 표준 모드의 GPT-6 Astra 대비 토큰 생성 속도 를 잰 것이며 "과금 배율이나 전체 작업 완료 시간이 아니다"라고 명시합니다. 코딩 에이전트의 한 턴에는 토큰 생성 외에도 테스트 실행, 파일 읽기, 도구 호출 대기가 섞여 있으므로, 작업 전체가 8배 빨리 끝나는 것은 아닙니다. GPT-6.1 Sol의 Ultrafast 지원은 곧 추가될 예정이라고만 발표되었습니다.
Fast 모드와 Ultrafast 비교
Codex에는 이미 속도를 높이는 Fast 모드 가 있습니다. 두 모드는 제공 대상과 사용량 배율이 크게 다릅니다.
| 구분 | Fast 모드 | Ultrafast |
|---|---|---|
| 지원 모델 | GPT-6.1 Sol, GPT-6 Astra, GPT-6 Sol, GPT-6 Luna 등 | GPT-6 Astra (GPT-6.1 Sol 예정) |
| 속도 | GPT-5.6, GPT-5.5는 1.5배 (GPT-6 계열 배수는 미공개) | GPT-6 Astra 표준 대비 최대 8배 (Codex) |
| 포함 사용량 소진 배율 | 표준의 2.5배 | 표준의 8배 |
| 구매 크레딧, Enterprise 종량제 배율 | 표준의 2배 | 표준의 6배 |
| 제공 요금제 | Plus, Pro, Business, Enterprise, Edu | Pro 500, 적격 Enterprise와 Edu |
| 사용하는 곳 | ChatGPT 데스크톱 앱, Codex CLI, IDE 확장 | Codex, ChatGPT Work |
Fast 모드는 CLI에서 /fast 로 켜고 끌 수 있고, /statusline 으로 하단 상태 표시줄에 띄울 수 있습니다. 기본값으로 고정하려면 config.toml 에 다음처럼 적습니다.
service_tier = "fast"

[features]
fast_mode = true
Ultrafast는 모델 선택기(model picker)에서 고릅니다. OpenAI는 속도 문서와 요금 문서에서 "이 과금 배율은 속도 향상을 뜻하지 않는다"고 반복해서 강조합니다. Ultrafast의 속도 배수와 소진 배수가 모두 8배로 같은 숫자이지만, 둘은 서로 다른 값입니다.
Pro 500의 25배를 Ultrafast로만 쓰면
Ultrafast가 포함 사용량을 표준의 8배로 소진한다는 점을 Pro 500의 사용량과 함께 계산해 보면, 이 기능의 성격이 분명해집니다. 이 계산은 공개된 배율만으로 단순화한 것이며, 실제 소진량은 모델, 컨텍스트, 추론 강도, 도구 사용에 따라 달라집니다.
즉 Pro 500의 포함 사용량을 전부 Ultrafast로 쓰면, GPT-6 Astra 표준 모드 기준으로 Plus 약 3배분의 작업량 에 해당합니다. 이는 표준 모드만 쓰는 Pro 100(5배)보다도 적은 양입니다. 같은 방식으로 Pro 100에서 Fast 모드만 쓰면 5 / 2.5 = 2배분이 됩니다. Ultrafast는 작업량을 늘려 주는 기능이 아니라, 사용량을 더 써서 기다리는 시간을 줄이는 기능 입니다.
그래서 Pro 500의 25배는 Ultrafast를 필요한 순간에만 켜고 나머지는 표준 모드로 쓰는 사용 방식을 전제로 할 때 의미가 큽니다. 장애 대응처럼 몇 분이 중요한 작업이나, 에이전트와 짧은 턴을 빠르게 주고받는 대화형 작업에만 Ultrafast를 쓰고, 오래 걸려도 되는 배치성 작업은 표준 모드로 실행하는 식입니다. 프리뷰 글에서 OpenAI가 든 예시도 장애 대응, 금융 이상 거래 탐지, 실시간 고객 상담처럼 "상황이 아직 변하고 있는 동안" 답이 필요한 작업이었습니다.
포함 사용량을 다 쓰면 Ultrafast는 보유한 크레딧에서 차감되며, 이때는 표준 크레딧 단가의 6배가 적용됩니다. Codex 토큰 단가표 기준 GPT-6 Astra 표준 단가는 100만 토큰당 입력 250, 캐시된 입력 25, 출력 1,250 크레딧이므로, Ultrafast에서는 각각 1,500, 150, 7,500 크레딧이 됩니다.
제공 대상과 제한
Ultrafast의 제공 범위는 요금제와 워크스페이스 설정에 따라 좁게 정해져 있습니다.
- 개인 요금제: Pro 등급 중 Pro 500에서만 쓸 수 있습니다. 출시 시점에는 Pro 100이나 Pro 200에서 크레딧을 구매해도 Ultrafast가 열리지 않으며, 다른 셀프서비스 요금제(Plus, Business 등)도 마찬가지입니다.
- Enterprise: 기본값은 꺼져 있고, 워크스페이스 소유자가 워크스페이스 권한에서 특정 사용자나 워크스페이스 전체에 켜야 합니다. 크레딧 기반 또는 USD 사용량 기반 계약을 쓰는 워크스페이스만 대상이며, 사용량 대신 속도 한도(rate limit)로 운영하는 레거시 Enterprise 요금제는 지원되지 않습니다. 기존의 사용자별 지출 한도가 Ultrafast에도 적용됩니다.
- Edu: 크레딧을 사용하는 적격 Edu 요금제에서 쓸 수 있습니다.
- 데이터 레지던시: 미국 밖에서의 추론 레지던시(inference residency)를 요구하는 워크스페이스는 쓸 수 없습니다. 문서는 워크스페이스의 위치만으로 적격 여부가 결정되지는 않는다고 덧붙입니다.
- API 키 로그인: Codex에 ChatGPT 계정이 아닌 API 키로 로그인하면 위의 크레딧 배율이 아니라 API 토큰 가격이 적용됩니다.
API에서 Ultrafast 쓰기
요청 방법과 WebSocket 권장
ChatGPT 구독과 별개로, Ultrafast는 OpenAI API의 가장 빠른 서비스 등급으로도 제공됩니다. GPT-6 Astra에서는 모든 API 사용자가 낮은 속도 한도로 쓸 수 있고, GPT-5.6 Sol의 Ultrafast는 계정 담당 팀을 통해 프리뷰 접근을 요청해야 합니다. 사용 방법은 Responses API 요청에 model="gpt-6-astra" 와 service_tier="ultrafast" 를 지정하는 것입니다.
가이드는 도구 호출을 연달아 하는 에이전트 애플리케이션이라면 WebSocket 모드 사용을 강력히 권장합니다. 지속 연결이 없으면 요청마다 생기는 네트워크 오버헤드가 지연 시간 이득을 깎아 먹기 때문입니다. 아래는 가이드의 예제로, 하나의 연결에서 두 개의 응답을 스트리밍하면서 두 번째 요청에 첫 응답의 ID를 previous_response_id 로 넘깁니다.
# Install: pip install --upgrade "openai[realtime]"
# Set OPENAI_API_KEY in your environment.

from openai import OpenAI

client = OpenAI()
previous_response_id: str | None = None
prompts = [
    "Explain why the sky is blue in one sentence.",
    "Now explain why sunsets look red.",
]

with client.responses.connect() as connection:
    for prompt in prompts:
        connection.response.create(
            model="gpt-6-astra",
            service_tier="ultrafast",
            previous_response_id=previous_response_id,
            input=prompt,
        )
        for event in connection:
            if event.type == "response.output_text.delta":
                print(event.delta, end="", flush=True)
            elif event.type == "response.completed":
                previous_response_id = event.response.id
                print()
                break
            elif event.type in {"response.failed", "response.incomplete", "error"}:
                raise RuntimeError(event.to_json())
        else:
            raise RuntimeError("Connection closed before the response finished.")
HTTP 요청도 SDK로 그대로 쓸 수 있습니다. 도구 호출이 잦지 않은 단발성 요청이라면 이쪽이 간단합니다.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="Explain why the sky is blue in one sentence.",
    service_tier="ultrafast",
)

print(response.output_text)
API 가격과 속도 한도
API 가격 페이지 기준으로 gpt-6-astra 의 서비스 등급별 단가(100만 토큰당, 짧은 컨텍스트)는 다음과 같습니다. Ultrafast는 표준의 6배, Fast의 3배입니다.
| 서비스 등급 | 입력 | 캐시된 입력 | 캐시 쓰기 | 출력 |
|---|---|---|---|---|
| Standard | $10.00 | $1.00 | $12.50 | $50.00 |
| Fast | $20.00 | $2.00 | $25.00 | $100.00 |
| Ultrafast | $60.00 | $6.00 | $75.00 | $300.00 |
긴 컨텍스트 요청의 Ultrafast 단가는 입력 $120, 캐시된 입력 $12, 캐시 쓰기 $150, 출력 $450입니다. 기본 속도 한도는 사용 등급(usage tier)에 따라 분당 토큰 수(TPM)로 정해집니다.
| API 사용 등급 | 분당 토큰 수 (TPM) |
|---|---|
| Tier 1~3 | 500,000 |
| Tier 4 | 1,000,000 |
| Tier 5 | 5,000,000 |
리전 제약도 확인해야 합니다. Ultrafast는 미국 데이터 레지던시와 글로벌 처리만 지원 하며, EU를 비롯한 미국 외 지역 처리 엔드포인트에서는 쓸 수 없습니다. 글로벌 처리로 API를 쓰는 경우에는 문제가 없지만, 사내 규정 때문에 미국 외 지역 처리를 써야 하는 조직이라면 도입 전에 먼저 검토해야 합니다.
어떤 요금제를 고를까
지금까지 살펴본 내용을 사용 패턴별로 정리하면 다음과 같습니다.
| 사용 패턴 | 권장 | 이유 |
|---|---|---|
| Plus의 5시간 한도에 자주 걸림 | Pro 100 또는 Plus + 크레딧 | Pro는 5시간 한도가 없고, 단가는 Plus와 같음 |
| 월 사용량이 Plus의 5~10배 | Pro 200 | Pro 100으로 모자라는 달이 많다면 |
| 기존 Pro 200, 유예 후 사용량이 부족 | Pro 500 또는 크레딧 보충 | 매달 부족하면 Pro 500, 가끔이면 크레딧 |
| 에이전트 응답 속도가 작업의 병목 | Pro 500 | 개인 요금제 중 Ultrafast는 Pro 500뿐 |
| 서비스에 빠른 Astra 응답 생성이 필요 | API Ultrafast | 구독이 아닌 토큰 과금, WebSocket 권장 |
한 가지 더 기억할 점은 크레딧의 범위입니다. 크레딧은 Codex, ChatGPT Work, ChatGPT for Word, Excel, PowerPoint의 적격 사용에만 쓸 수 있고, 모든 ChatGPT 모델과 기능의 사용량을 늘려 주지는 않습니다. 크레딧 잔액 확인과 구매는 ChatGPT의 설정 → 사용량(Usage) 이나 Codex의 사용량 및 결제(Usage & Billing) 에서 할 수 있습니다. 또한 지원팀은 ChatGPT나 Codex의 사용량 한도를 초기화해 줄 수 없고, 사용량이 잘못 집계된 경우에만 조사를 요청할 수 있습니다. 따라서 한도에 걸리면 다른 모델을 쓰거나, 초기화 시각을 기다리거나, 크레딧을 사거나, API 키로 로컬 작업을 이어 가는 방법이 있습니다. 계정 공유, 접근 권한 재판매, 자동화된 데이터 추출은 이용 약관 위반으로 계정이 제한될 수 있습니다.
구독 관리에서 알아 둘 점
도움말 문서의 나머지 FAQ 중 개발자가 자주 부딪힐 만한 항목을 정리하면 다음과 같습니다.
- 모델이 일시적으로 사용 불가: 모델별 허용량은 등급마다 다르고, 한도에 도달한 모델은 허용량이 초기화될 때까지 쓸 수 없습니다. 이는 구독 종료나 계정 제한이 아니며, 설정으로 한도를 우회하거나 늘릴 수 없습니다.
- Business 워크스페이스 합류: 개인 워크스페이스를 따로 유지하면 Pro 구독도 해지할 때까지 그대로 유지됩니다. 개인 워크스페이스를 Business로 병합하면 구독 처리 방식이 달라지므로, 병합 전에 워크스페이스 이전 안내를 먼저 확인해야 합니다.
- 갱신 결제 실패: 결제가 한 번 실패했다고 구독이 바로 끝나지는 않습니다. 웹 구독은 청구 이메일의 결제 복구 안내를, Apple과 Google Play 구독은 스토어의 결제 설정을 확인합니다.
- 환불: 해지해도 이전 결제가 자동으로 환불되지 않습니다. chatgpt.com과 Google Play 결제는 해당 계정으로 로그인한 상태에서 OpenAI 지원팀에, Apple App Store 결제는 Apple에 직접 요청합니다. 환불이 승인되면 그 결제로 이용하던 접근 권한은 보통 종료됩니다.
정리: 등급별 단가는 같아지고, 속도가 새로운 축이 되다
이번 개편을 한 문장으로 요약하면, 사용량의 단가는 모든 요금제에서 같아졌고 그 위에 속도라는 새로운 선택지가 생겼다 는 것입니다. 개편 전 Pro 200은 많이 쓰는 사람에게 단가가 가장 싼 요금제였지만, 이제는 Plus부터 Pro 500까지 $20당 Plus 1배분이라는 같은 비율을 갖습니다. 그 대신 OpenAI는 Ultrafast라는 속도 옵션을 가장 비싼 등급에 묶었고, 이 속도는 표준 대비 8배의 사용량을 대가로 합니다.
개발자 입장에서는 얼마나 많이 쓰는지와 얼마나 빨리 결과를 받아야 하는지를 나누어 생각해야 합니다. 대부분의 코딩 작업은 표준 모드로 충분하고, Ultrafast는 사람이 화면 앞에서 결과를 기다리는 짧은 대화형 작업에서 가치가 큽니다. 기존 Pro 200 구독자라면 10월 29일 전에 사용량 대시보드로 실제 사용 패턴을 확인하고, Pro 100, Pro 200, Pro 500 중 어디에 맞는지 다시 판단해 보시기 바랍니다. 같은 기간에 GPT-5.5가 10월 14일 ChatGPT와 Codex에서 지원 종료되므로, 저장된 모델 설정도 함께 점검하는 것이 좋습니다.
 ChatGPT Pro 요금제 도움말 문서
https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
Codex 속도(Fast, Ultrafast) 문서
OpenAI API Ultrafast 모드 가이드
더 읽어보기
-
Previewing Ultrafast mode: GPT-5.6 Sol at up to 14X the speed (OpenAI)
-
OpenAI DevDay 2026 발표 25가지 총정리: 상시 에이전트 dots부터 GPT-6.1 Sol, 플러그인 확장까지
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
OpenAI가 공개한 GPT-6 Astra 공식 활용 가이드: 자주 되묻는 모델을 끝까지 일하게 하는 프롬프팅과 마이그레이션
-
OpenAI Codex 팀이 권하는 GPT-6 Astra 전환 준비, 스킬 설명은 좁게 AGENTS.md는 조건부로
-
Cerebras, 웨이퍼 3장을 한 랙에 담은 Nexus 아키텍처로 GPU 대비 최대 30배 빠른 추론이 가능한 CS-4 출시
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
