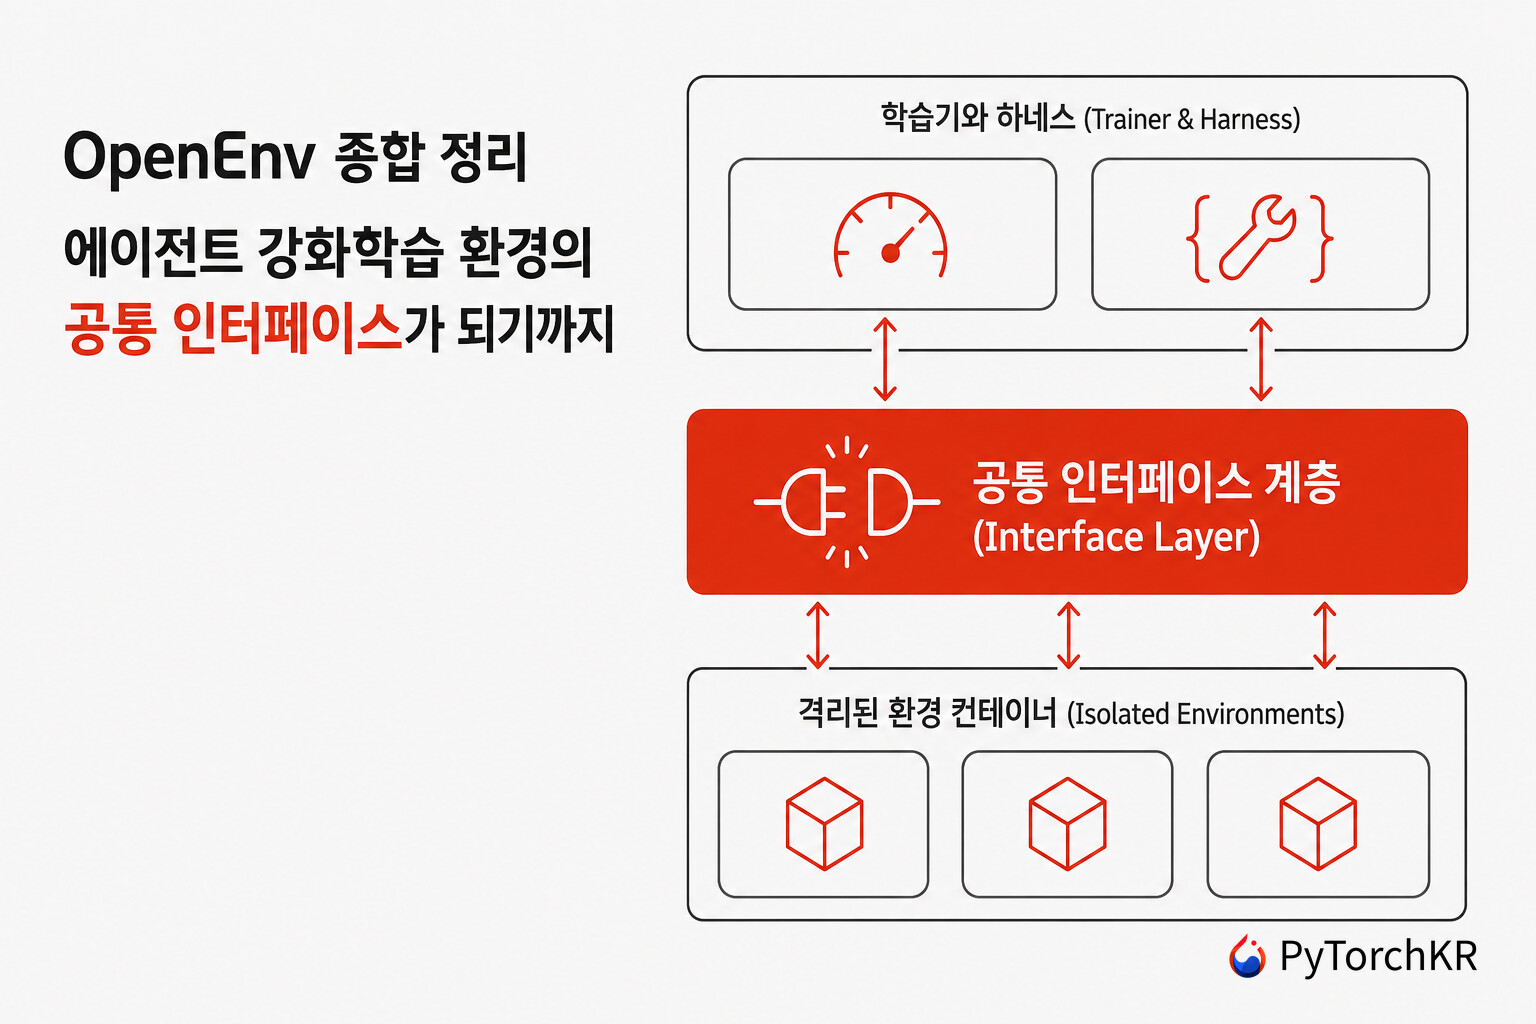
OpenEnv 소개: 에이전트에게 부족한 것은 모델이 아니라 환경입니다
OpenEnv는 AI 에이전트가 상호작용할 환경(Environment) 을 만들고, 배포하고, 학습 루프에 연결하는 절차를 하나의 규격으로 묶는 오픈소스 인터페이스 라이브러리입니다. 터미널, 브라우저, 코드 저장소, 캘린더처럼 에이전트가 실제로 조작하는 대상을 격리된 컨테이너로 감싸고, 그 안에서 무엇을 볼 수 있고 무엇을 할 수 있는지를 명시적으로 선언합니다. 2025년 10월 Meta와 Hugging Face가 공동으로 시작했고, 2026년 6월에는 11개 조직으로 구성된 기술위원회가 운영을 맡는 중립 프로젝트로 전환했습니다.
강화학습(Reinforcement Learning, RL) 으로 에이전트를 학습시키려면 세 가지가 필요합니다. 정책을 갱신하는 학습기, 모델이 도구를 부르고 결과를 읽는 하네스(harness), 그리고 그 행동이 실제로 실행되는 환경입니다. TRL(Transformers Reinforcement Learning), TorchForge, verl 같은 프로젝트가 복잡한 연산 인프라 위에서 AI를 확장하는 방법을 보여 주었지만, 첫 글은 "연산은 동전의 한쪽 면일 뿐이다" 라고 적으면서 다른 한쪽 면을 개발자 커뮤니티, 즉 에이전틱 시스템을 가능하게 만드는 사람과 도구로 지목합니다. 공동의 환경 허브를 여는 이유가 여기 있습니다.
에이전틱 환경이 정의하는 것은 에이전트가 작업을 수행하는 데 필요한 전부이면서 그 이상은 아닙니다. 도구, API, 자격 증명, 실행 컨텍스트가 거기 들어가고, 그 밖의 것은 들어가지 않습니다. 이 경계가 에이전트의 행동에 명료함과 안전성, 샌드박스 수준의 통제를 부여합니다.
이러한 맥락에서 OpenEnv가 잡은 위치는 새로운 학습 알고리즘이나 보상 설계 도구가 아닙니다. 학습기와 하네스와 환경이 서로를 몰라도 맞물릴 수 있게 하는 공통 소켓 입니다. Gymnasium이 정립한 reset(), step(), state() 문법을 그대로 물려받되, 환경을 로컬 파이썬 객체가 아니라 Docker 컨테이너 안에서 도는 WebSocket 서버로 바꿔 놓았습니다. 규격을 지킨 환경이라면 어떤 학습기든 별도 어댑터 코드 없이 구동할 수 있고, 학습에 쓴 그 환경을 배포 시점의 도구 서버로도 그대로 쓸 수 있습니다.
이 글은 Hugging Face 블로그에 실린 OpenEnv 관련 글 세 편을 하나로 엮은 정리입니다. 각 글은 약 8개월에 걸친 서로 다른 국면을 담고 있어서, 한 편만 읽으면 지금의 OpenEnv와 어긋나는 부분이 생깁니다. 그래서 세 글의 내용을 시간순으로 이어 붙인 뒤, 2026년 9월 3일 현재 저장소와 공식 문서에서 확인한 실제 상태를 함께 표시했습니다.
| 시점 | 원문 | 국면 |
|---|---|---|
| 2025년 10월 23일 | Building the Open Agent Ecosystem Together | Meta와 Hugging Face의 공동 발표, OpenEnv Hub와 0.1 스펙 공개 |
| 2026년 2월 12일 | OpenEnv in Practice | Turing이 기여한 Calendar Gym으로 도구 사용 에이전트를 실측 |
| 2026년 6월 8일 | The Open Source Community is backing OpenEnv | 11개 조직 기술위원회로 거버넌스 이전, 저장소를 huggingface/OpenEnv로 이동 |
| 2026년 9월 3일 | 저장소와 공식 문서 | 별 2,541개, 포크 433개, 저장소 내 환경 38종, 허브 환경 4,600개 이상, 최신 릴리스 0.4.1 |
프론티어 랩은 모델과 하네스를 함께 학습시키고, 오픈소스는 그럴 수 없었습니다
OpenEnv가 왜 지금 필요한지는 하네스라는 단어에서 출발합니다. Claude Code, Codex, OpenClaw, Hermes 같은 에이전트 하네스는 모델을 감싸서 도구를 호출하고 결과를 되먹이는 실행 껍데기입니다. 최근 모델 성능 향상의 상당 부분이 모델 자체가 아니라 이 껍데기의 개선에서 왔고, 여기에 더해 프론티어 랩은 모델과 하네스를 함께 학습시킵니다 . GPT-5.5와 Opus 4.8은 각자의 하네스를 쓰도록 학습되어 있습니다. 모델이 하네스 밖으로 어느 정도 일반화되기는 하지만, 함께 학습된 조합의 효율을 따라가지는 못합니다.
세 번째 글이 원하는 것은 이 이득을 오픈소스 모델에서도 얻는 것입니다. 하네스를 효과적으로 쓰는 로컬 모델을 학습시키는 것이 하나이고, 모델을 특정 작업에 특화시켜 연산을 절약하는 것이 다른 하나입니다.
그런데 오픈소스에서는 이 조합이 성립하지 않습니다. 개발자는 아무 하네스에, 아무 모델을, 아무 추론(inference) 엔진 위에서, 자기가 중요하다고 생각하는 용도로 씁니다. 조합의 자유는 커뮤니티의 근본 성질이지만 동시에 학습 효율의 손실이기도 합니다. 세 번째 글이 이 비대칭을 정면으로 지적하면서 OpenEnv를 "하네스와 환경, 학습기 사이를 잇는 라이브러리" 로 다시 규정한 이유가 여기 있습니다. 조합이 고정되지 않는 세계에서 효율을 되찾는 방법은, 조합을 강제하는 것이 아니라 조합의 접점을 규격화하는 것입니다.
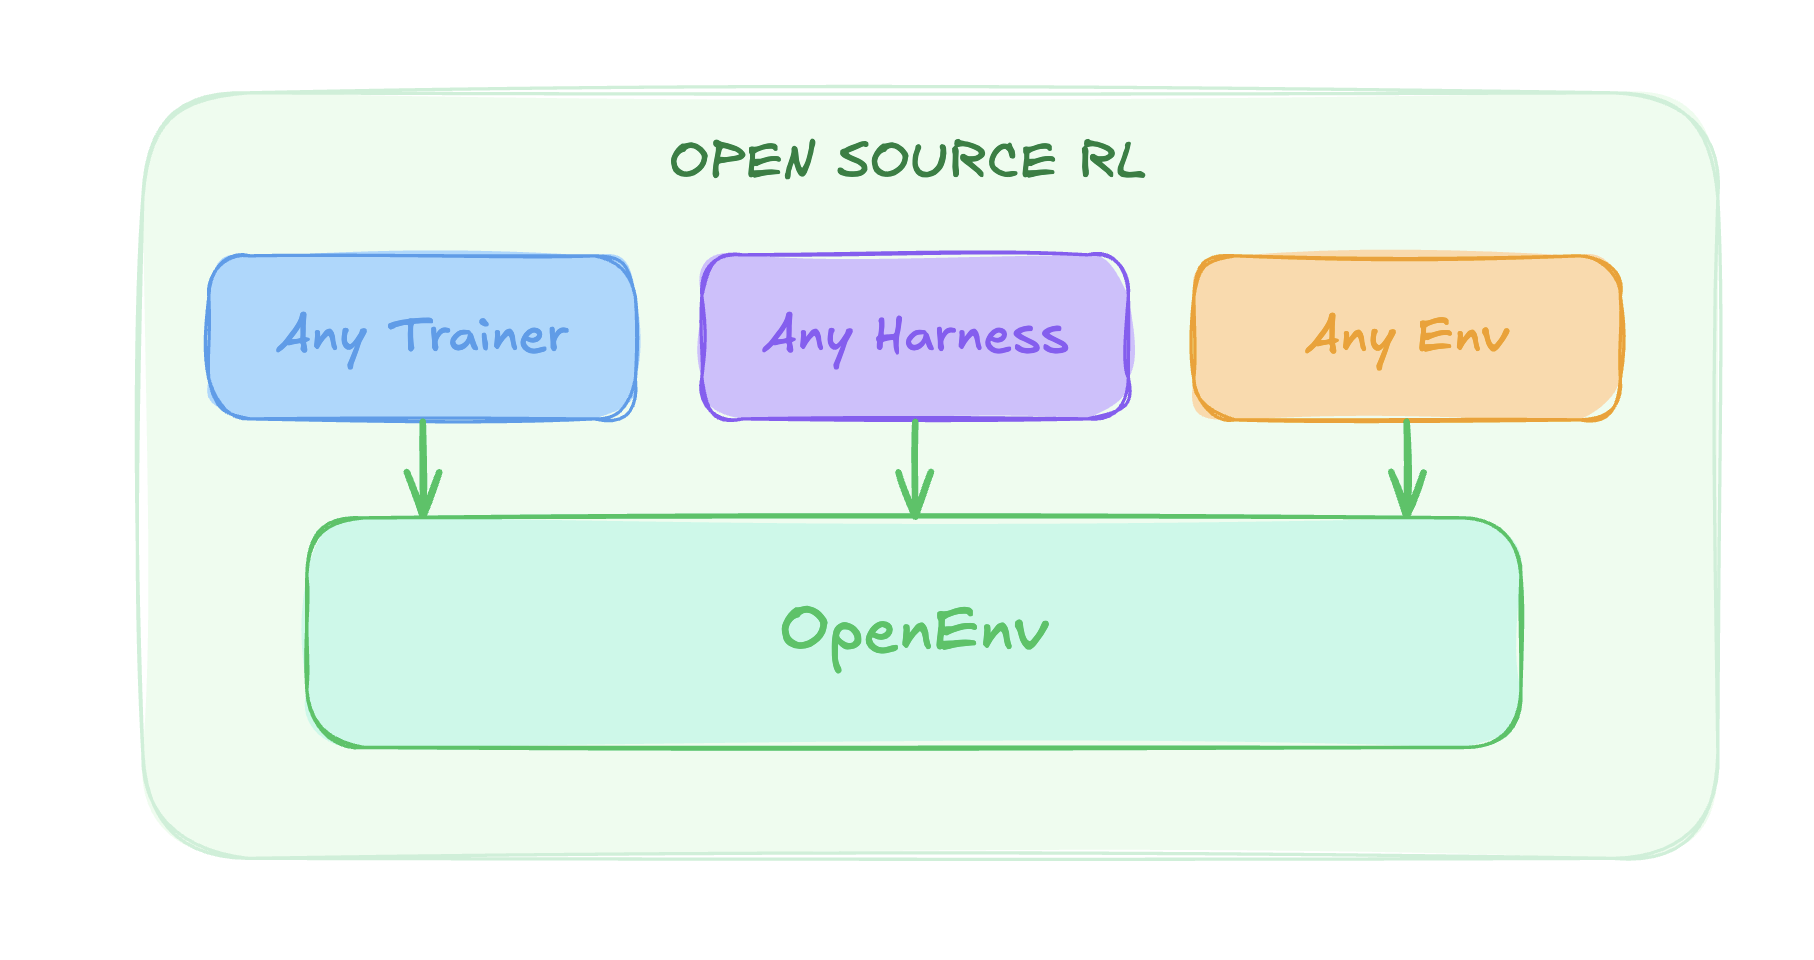
첫 글이 허브를 여는 이유로 든 것은 목록이 아니라 자동성입니다. OpenEnv 규격을 지켜 허브에 올린 환경은 별도 작업 없이 세 가지 기능을 얻습니다. 사람이 직접 Human Agent가 되어 환경을 조작해 보는 것, 모델을 붙여 환경 안의 작업을 풀게 하는 것, 그리고 그 환경이 어떤 도구를 노출하고 관측을 어떻게 정의하는지 들여다보는 것입니다. 전체 RL 학습을 돌리기 전에 환경을 빠르게 검증하고 고쳐 나갈 수 있습니다.
사용 사례로 첫 글이 꼽은 것도 학습만이 아닙니다. 여러 컬렉션에서 환경을 끌어와 RL 후속 학습에 쓰는 것, 환경을 만들어 생태계의 RL 도구와 상호운용되는지 확인하고 협업자와 공유하는 것, FAIR의 Code World Model처럼 최신 기법을 에이전틱 코딩과 소프트웨어 엔지니어링 환경을 붙여 재현하는 것, 그리고 환경을 만들어 그 위에서 학습한 뒤 같은 환경으로 추론까지 돌리는 전체 파이프라인이 함께 열거되어 있습니다.
또 하나의 배경은 안전과 의미의 문제입니다. 요즘 에이전트는 수천 가지 작업을 자율적으로 수행할 수 있지만, 모델에게 수백만 개의 도구를 그대로 노출하는 것은 합리적이지도 안전하지도 않습니다. 첫 글은 환경이 담당해야 할 것을 세 가지로 정리합니다. 작업에 무엇이 필요한지에 대한 명확한 의미 규정, 격리된 실행과 안전 보장, 그리고 인증이 필요한 도구와 API에 대한 매끄러운 접근입니다. 즉 환경은 단순한 시뮬레이터가 아니라 작업에 필요한 것만 정확히 노출하는 경계 입니다.
Gymnasium의 문법을 물려받고, 전송과 배포를 바꿨습니다
OpenEnv의 API는 강화학습을 해 본 사람에게는 낯설지 않습니다. 에피소드를 시작하는 reset(), 행동 하나를 실행하는 step(action), 에피소드 메타데이터를 읽는 state()가 전부입니다. 저장소도 이 계보를 명시적으로 인정하며, Farama Foundation 팀이 Gymnasium에서 해낸 작업에서 API가 크게 영감을 받았다고 감사를 표하고 있습니다.
달라진 것은 문법이 아니라 그 문법이 놓인 자리입니다. 두 번째 글은 이 변화가 평가의 질문 자체를 바꾼다고 정리합니다. "이것이 통제된 데모에서 동작하는가" 를 묻던 자리에 "이것이 현실 세계에서 신뢰할 만하게 작동하는가" 가 들어선다는 것입니다. Turing이 함께 발행한 기술 문서는 이 차이를 네 가지 전환으로 정리합니다.
- 지속 연결 세션(Persistent WebSocket Session): 요청마다 연결을 새로 맺는 무상태 HTTP 대신 WebSocket 연결을 유지합니다. 연결 비용이 사라지고, 서버가 여러 스텝에 걸친 문맥을 그대로 들고 있으므로 다중 턴 워크플로우에 유리합니다.
- 프로덕션 우선 설계(Production-First Design): 환경 하나가 곧 배포 가능한 컨테이너 마이크로서비스입니다. Docker와 FastAPI로 포장되고,
/health엔드포인트로 상태를 확인하며,/docs에서 OpenAPI 문서가 자동 생성됩니다. - 타입 안전성(Type Safety): 행동과 관측을 Pydantic 모델로 선언하므로, 잘못된 인자가 실행 전에 걸러지고 스키마가 자동으로 문서화됩니다.
- 세션별 인스턴스 격리(Factory Pattern): 환경 인스턴스를 공유하지 않고, WebSocket 연결마다 팩토리가 새 인스턴스를 만듭니다. 롤아웃을 병렬로 돌릴 때 상태가 섞이지 않습니다.
이 네 가지를 표로 대비하면 다음과 같습니다.
| 항목 | Gymnasium 계열 | OpenEnv |
|---|---|---|
| 전송 | 로컬 함수 호출 또는 무상태 HTTP | WebSocket 지속 연결, HTTP 병행 |
| 배포 단위 | 로컬 스크립트, 파이썬 패키지 | Docker 컨테이너 마이크로서비스 |
| 타입 검증 | 파이썬 기본 타입, 수동 검증 | Pydantic 모델 기반 자동 검증 |
| 동시성 | 공유 인스턴스, 프로세스 복제 | 세션별 격리 인스턴스 |
| 도구 노출 | 별도 규격 없음 | MCP 도구 호출을 1급으로 지원 |
| 공유 경로 | 각자 배포 | Hugging Face Spaces 기반 환경 허브 |
클라이언트 쪽 코드는 다음과 같습니다. 비동기가 기본이고, 동기 코드에서는 .sync() 래퍼(wrapper)를 씁니다.
import asyncio
from echo_env import CallToolAction, EchoEnv

async def main():
    # Connect to a running Space (async context manager)
    async with EchoEnv(base_url="https://openenv-echo-env.hf.space") as client:
        # Reset the environment
        result = await client.reset()
        print(result.observation.echoed_message)  # "Echo environment ready!"

        # Send messages
        result = await client.step(
            CallToolAction(
                tool_name="echo_message",
                arguments={"message": "Hello, World!"},
            )
        )
        print(result.observation.result)  # "Hello, World!"
        print(result.reward)

asyncio.run(main())
환경을 어디에 띄울지는 클라이언트 생성 방식으로 결정합니다. 원격 Space는 base_url로, 로컬 개발은 EnvClient.from_docker_image()로, 클라우드 샌드박스는 같은 호출에 provider=DaytonaProvider()처럼 런타임 제공자를 붙여서 연결합니다. 설치된 패키지나 알려진 환경은 AutoEnv.from_env("coding")으로 자동 탐색됩니다. 현재 제공되는 런타임은 LocalDockerProvider, DockerSwarmProvider, UVProvider, DaytonaProvider, ACASandboxProvider이고 Kubernetes 제공자는 계획 단계입니다.
OpenEnv API 더 알아보기
OpenEnv Concepts - 핵심 추상화와 스텝 루프, 연결 방식 정리
Gymnasium Documentation - OpenEnv API가 계보를 물려받은 원본 규격
RFC 001: Baseline API and Interface Specifications
환경 한 개의 해부도: 매니페스트, 모델, 서버, 컨테이너
OpenEnv 환경은 정해진 뼈대를 갖습니다. openenv init my_env 한 줄이 다음 구조를 만들어 냅니다. 매니페스트 파일 openenv.yaml이 이름과 버전, 클라이언트 클래스, 행동과 관측 타입, 기본 이미지 태그를 선언하고, models.py가 데이터 구조를, server/가 환경 로직과 FastAPI 앱과 Dockerfile을 담습니다.
name: my_env
version: 0.1.0
description: My custom environment

client:
  class_name: MyEnvClient
  module: my_env.client

action:
  class_name: MyAction
  module: my_env.models

observation:
  class_name: MyObservation
  module: my_env.models

default_image: my-env:latest
spec_version: 1
행동과 관측, 상태 타입은 pydantic.BaseModel을 직접 상속하지 않고 openenv.core.env_server.types의 기반 클래스를 상속합니다. 기반 Observation이 이미 done과 reward 필드를 들고 있고 step()이 그 값을 채우기 때문입니다. 여기서 한 가지 관례가 Gymnasium과 갈립니다. OpenEnv의 step()은 튜플을 돌려주지 않고, 보상과 종료 여부를 반환된 관측 객체에 실어 보냅니다.
from openenv.core.env_server.interfaces import Environment

class MyEnvironment(Environment[MyAction, MyObservation, MyState]):
    def reset(self, seed=None, episode_id=None, **kwargs) -> MyObservation:
        ...

    def step(self, action: MyAction, timeout_s=None, **kwargs) -> MyObservation:
        ...

    @property
    def state(self) -> MyState:
        ...
서버 쪽은 create_app이 환경을 FastAPI 애플리케이션으로 감쌉니다. 이때 인스턴스가 아니라 클래스 를 넘기는 것이 중요합니다. 앞서 언급한 세션별 격리가 여기서 실현되며, WebSocket 세션마다 팩토리가 새 환경 인스턴스를 만들게 됩니다.
from openenv.core.env_server import create_app

app = create_app(
    MyEnvironment,
    MyAction,
    MyObservation,
    env_name="my_env",
)
개발 중에는 내장 웹 인터페이스가 유용합니다. 왼쪽에 사람이 직접 행동을 입력하는 HumanAgent 창, 오른쪽에 상태 관측 창이 놓인 2분할 화면으로, 환경의 Action 타입에서 입력 폼을 자동 생성하고 WebSocket으로 실시간 갱신합니다. 로컬에서는 기본적으로 꺼져 있고 ENABLE_WEB_INTERFACE=true로 켠 뒤 http://localhost:8000/web에서 확인합니다. 첫 글이 강조했던 "사람이 직접 에이전트가 되어 환경과 상호작용해 본다" 는 검증 절차가 이 화면입니다. 전체 RL 학습을 돌리기 전에 환경이 제대로 동작하는지 눈으로 확인할 수 있습니다.
환경 제작과 배포는 CLI 명령으로 이어집니다.
| 명령 | 하는 일 |
|---|---|
openenv init <env_name> |
템플릿에서 새 환경 뼈대 생성 |
openenv import <source> --name <env_name> |
ORS/OpenReward와 Verifiers 형식의 외부 환경을 OpenEnv로 감싸기 |
openenv serve |
자동 재적용 옵션과 함께 로컬에서 환경 서빙 |
openenv build |
환경의 Docker 이미지 빌드 |
openenv validate |
환경 설정이 규격에 맞는지 검사 |
openenv push |
Hugging Face Spaces로 배포 |
openenv fork <space-id> |
허브의 Space를 내 계정으로 복제 |
보상은 환경 안에서 계산합니다: Rubric 시스템
OpenEnv에서 보상은 외부 코드가 아니라 환경 내부에서 계산됩니다. 그 계산 단위가 루브릭(Rubric) 이며, WeightedSum, Gate, Sequential로 조합할 수 있습니다. 주관적 기준에는 LLM 심판(judge)을 붙이고, 에피소드가 끝난 뒤에야 점수를 알 수 있는 경우에는 TrajectoryRubric으로 지연 보상을 처리합니다. 기반 Environment가 __init__에서 rubric 인자를 받고, reset에서 self._reset_rubric()을, step에서 self._apply_rubric(action, observation)을 호출하는 구조입니다.
이 설계는 프로젝트의 설계 논의 문서인 RFC(Request for Comments) 004로 도입되었고, 궤적 단위 채점을 위한 지연 보상 지원이 2026년 1월 29일 병합되었습니다. 보상 계산을 환경 안에 두면 같은 환경을 여러 학습기가 공유할 때 채점 기준이 흔들리지 않는다는 장점이 있습니다. 다만 뒤에서 보게 될 것처럼, 이 결정은 2026년 6월의 프로젝트 재정의 이후 다시 논의 대상이 되었습니다.
보상과 채점 더 알아보기
Rewards Guide - 환경 안에서 보상을 정의하는 방법
RFC 004: Rubric System for Reward Computation
같은 환경을 학습에도 서비스에도 쓰는 방법: 시뮬레이션 모드와 프로덕션 모드
OpenEnv에서 가장 실용적인 설계이면서 문서를 읽지 않으면 놓치기 쉬운 부분이 모드 구분입니다. OpenEnv는 서로 다른 두 가지 모드를 가지며, 공식 문서는 이를 "시뮬레이션 모드는 궤적 시간(trajectory time)을 모델링하고, 프로덕션 모드는 서비스 시간(service time)을 모델링한다" 고 설명합니다.
시뮬레이션 모드(Simulation Mode) 는 기본값이며 학습과 평가를 위한 것입니다. 오케스트레이터가 에피소드의 주인이 되어 reset()으로 시작하고 step()으로 행동을 하나씩 실행하며 reward, done, state()를 롤아웃의 일부로 읽습니다. 이 모드에서 서버는 /ws, /mcp, /reset, /step, /state를 모두 노출합니다.
프로덕션 모드(Production Mode) 는 도구를 직접 노출하기 위한 것입니다. 클라이언트가 에피소드 경계를 통제하지 않고 MCP 도구를 살아 있는 서비스처럼 호출합니다. 이 모드에서는 /reset, /step, /state가 등록되지 않고 /ws와 /mcp만 남습니다. 문서는 여기서 한 가지를 분명히 경고합니다. /ws가 남는 것은 그것이 인프라 경계이기 때문이고, 에이전트에게 노출해도 된다는 뜻이 아닙니다. 에이전트를 향하는 경계는 /mcp이며, 프로덕션 배포에서 에이전트가 서비스에 직접 닿을 수 있다면 운영자가 네트워크나 인증, 게이트웨이 계층에서 /ws를 막아야 합니다.
전환은 라우트 등록 시점의 한 줄로 이루어집니다.
from fastapi import FastAPI

from openenv.core.env_server.http_server import HTTPEnvServer
from openenv.core.env_server.types import ServerMode

app = FastAPI()
server = HTTPEnvServer(env=MyEnv, action_cls=MyAction, observation_cls=MyObservation)

# Training / evaluation
server.register_routes(app, mode=ServerMode.SIMULATION)

# Direct MCP serving
server.register_routes(app, mode=ServerMode.PRODUCTION)
도구 자체를 모드별로 다르게 노출할 수도 있습니다. MCPEnvironment의 @self.tool(mode="simulation")과 @self.tool(mode="production") 데코레이터로 학습 루프에서만 보이는 채점 도구와 실제 클라이언트에게만 보이는 조회 도구를 분리합니다. 첫 글이 사용 사례로 꼽았던 "환경을 만들고, 같은 환경에서 학습하고, 같은 환경을 추론에도 쓰는 전체 파이프라인" 이 이 구조로 구현됩니다.
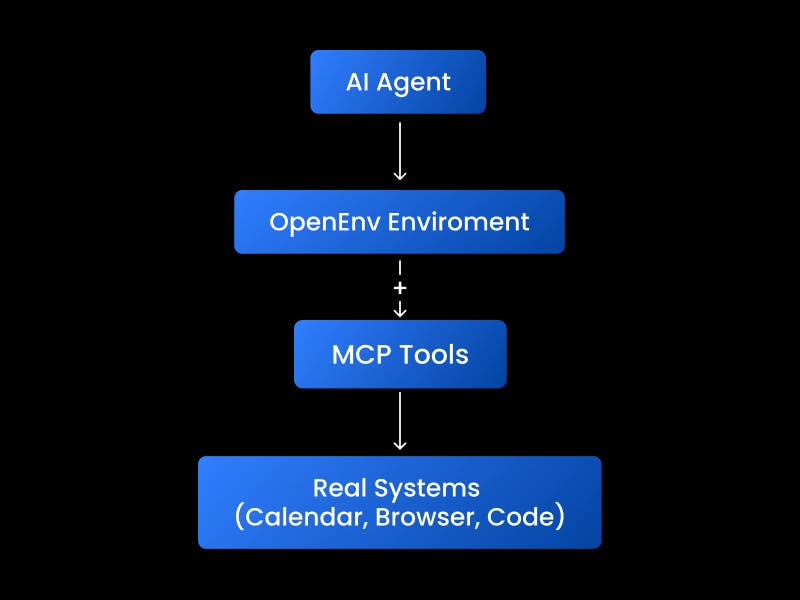
MCP(Model Context Protocol) 는 두 모드 모두에서 쓰이지만 역할이 다릅니다. 시뮬레이션 모드에서 MCP 도구는 환경의 행동 공간(action space)의 일부이며, step(ListToolsAction())으로 도구를 탐색하고 step(CallToolAction(...))으로 호출합니다. 도구 호출이 행동으로 계수되므로 학습기가 도구 사용에 보상을 할당하고 궤적을 온전히 기록할 수 있습니다. 프로덕션 모드에서는 MCP가 1차 인터페이스가 되어 클라이언트가 도구를 직접 부릅니다. MCP 지원은 RFC 003으로 2026년 1월 21일 병합되었으며, PyTorchKR에도 MCP의 개념을 정리한 학습 자료와 최근 규격 변화를 다룬 글이 올라와 있습니다.
모드와 MCP 더 알아보기
Simulation vs Production Mode - 두 모드의 라우트 차이와 운영 주의점
MCP Environment Lifecycle - MCP 환경의 생애 주기
RFC 003: Add MCP Support, Phase 1
학습 루프에 붙이기: TRL의 GRPOTrainer로 Wordle 풀기
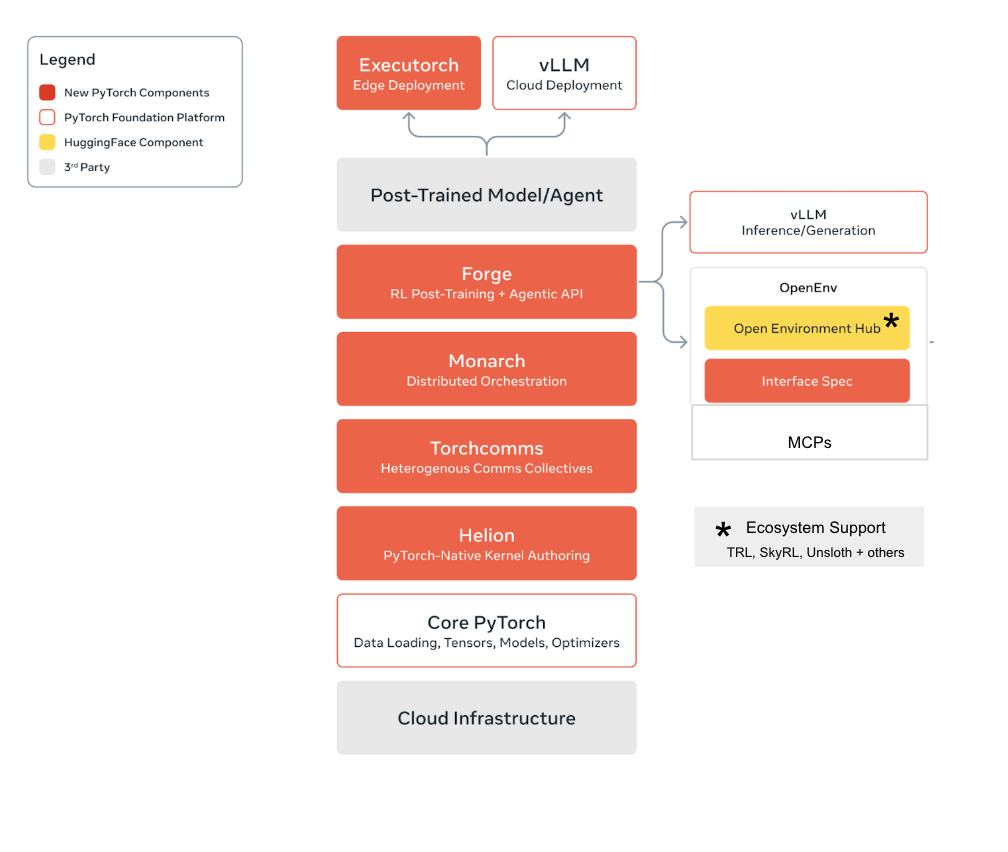
그러나 규격만 있으면 아무것도 학습되지 않습니다. OpenEnv가 실제로 의미를 갖는 지점은 학습 프레임워크와의 연결입니다. 첫 글이 공개한 rl-stack 도식은 Meta가 개발 중인 후속 학습 스택 안에서 OpenEnv의 자리를 보여 줍니다. Core PyTorch 위에 커널 저작 계층인 Helion, 이종 통신 계층인 Torchcomms, 분산 오케스트레이션 계층인 Monarch, RL 후속 학습과 에이전틱 API를 담당하는 Forge가 쌓이고, 그 옆에서 OpenEnv가 환경 허브와 인터페이스 스펙, MCP를 제공합니다.
가장 손에 잡히는 예시는 TRL로 Wordle을 학습시키는 공식 튜토리얼입니다. 여기서 핵심은 GRPOTrainer의 environment_factory 인자입니다. 이 인자에 환경 클래스를 넘기면 학습기가 롤아웃마다 인스턴스를 새로 만들고, 모델 응답을 생성해 도구 호출을 파싱하고, 해당 메서드를 실행하고, done=True가 나올 때까지 반복하고, 어떤 토큰이 모델 생성이고 어떤 토큰이 환경 출력인지 구분하는 tool_mask까지 관리합니다. 사용자는 환경 클래스와 보상 함수만 정의하면 됩니다.
from textarena_env import TextArenaAction, TextArenaEnv

class WordleEnv:
    def __init__(self):
        self.client = TextArenaEnv(base_url="https://openenv-wordle.hf.space")

    def reset(self, **kwargs) -> None | str:
        result = self.client.reset()
        # The game returns cumulative feedback each turn (new text appended at the end), so
        # we store the previous full response and slice out only the newly appended part.
        self._last_full_feedback = result.observation.messages[0].content
        self.reward = 0.0
        self.done = False
        return self._last_full_feedback

    def guess(self, guess: str) -> str:
        """
        Make a guess in the Wordle environment.

        Args:
            guess: The guessed word, formatted as '[abcde]'

        Returns:
            The feedback message from the environment.
        """
        if self.done:
            raise ValueError("Game over.")
        result = self.client.step(TextArenaAction(message=guess))
        _full_feedback = result.observation.messages[0].content
        # Just take the new feedback since the last guess
        feedback = _full_feedback[len(self._last_full_feedback):]
        self._last_full_feedback = _full_feedback
        # Penalize invalid moves
        if "You attempted an invalid move" in feedback:
            self.reward = 0.0
        else:
            self.reward = result.reward
        self.done = result.done
        return feedback
환경이 스스로 보상을 추적하므로 보상 함수는 그것을 읽어 오는 한 줄로 끝납니다. 도구 노출 규칙도 단순합니다. reset을 제외한 공개 메서드 중 독스트링이 있는 것이 자동으로 호출 가능한 도구가 됩니다.
def reward_func(environments, **kwargs) -> list[float]:
    return [env.reward for env in environments]
from trl import GRPOTrainer

trainer = GRPOTrainer(
    model="Qwen/Qwen3-1.7B",
    reward_funcs=reward_func,
    train_dataset=dataset,
    args=grpo_config,
    environment_factory=WordleEnv,
)
한 가지 실무 주의사항이 문서에 명시되어 있습니다. 허브에 올라간 공용 Space는 동시 실행 수가 제한되어 있으므로, 실제 학습에서는 Space를 자기 계정으로 복제하거나 Docker로 로컬에서 돌리라고 권합니다. GRPO(Group Relative Policy Optimization) 자체를 더 알고 싶다면 PyTorchKR에 간결한 구현을 소개한 글이 있습니다.
현재 OpenEnv와 연결되는 학습 프레임워크는 다음과 같습니다.
| 프레임워크 | 연결 형태 |
|---|---|
| TRL | GRPOTrainer의 environment_factory로 GRPO 학습 |
| torchforge | examples/grpo_blackjack/의 블랙잭 GRPO 학습 예제 |
| Unsloth | gpt-oss 기반 2048 게임 학습 Colab 노트북 |
| SkyRL | UC Berkeley의 SkyRL에서 OpenEnv 환경으로 학습 |
| ART | OpenPipe의 ART로 OpenEnv 환경 학습 |
| Oumi | TRL과 함께 쓰는 GRPO 노트북 |
| Lightning AI | OpenEnv 템플릿 제공 |
첫 글이 호환 확대 대상으로 함께 이름을 올렸던 verl은 현재 저장소의 연동 목록에는 올라 있지 않습니다.
학습 연동 더 알아보기
Train a reasoning model with TRL - OpenEnv 환경으로 추론 모델을 학습하는 전 과정
OpenEnv Tutorial Notebook - Colab에서 바로 실행하는 처음부터 끝까지 예제
GitHub Repository
Turing의 Calendar Gym: 캘린더가 왜 까다로운 시험대인가
두 번째 글은 규격 이야기가 아니라 실측 이야기입니다. OpenEnv 지지 조직 명단에도 이름을 올린 Turing이 프로덕션 수준의 캘린더 관리 환경을 기여하고, 그 안에서 도구 사용 에이전트를 평가했습니다. 글의 첫 문장이 문제의식을 그대로 담고 있습니다. 에이전트는 통제된 연구 환경에서는 인상적인 성적을 내지만, 여러 단계를 추론해야 하고 실제 도구와 API를 다뤄야 하고 부분적인 정보만 주어지며 상태와 권한이 살아 있는 실제 시스템에서는 무너진다는 것입니다.
캘린더를 고른 이유는 겉보기의 단순함과 실제 복잡도의 격차입니다. 회의 하나를 잡는 일은 쉬워 보이지만, 실제 캘린더 관리는 시간, 권한, 여러 사용자, 불완전한 정보를 여러 단계에 걸쳐 함께 추론해야 하는 작업입니다. Calendar Gym은 이 조건을 추상화하지 않고 그대로 노출합니다. 사용자와 캘린더에 걸친 접근 제어 목록(Access Control List, ACL), 다른 사용자 상태에 대한 제한된 가시성, 순서를 지켜 연결해야 하는 다단계 워크플로우가 그것입니다. 에이전트는 캘린더 목록 조회부터 이벤트와 권한 수정까지 폭넓은 연산을 다루면서, 실패한 행동과 잘못된 가정과 부족한 권한을 스스로 처리해야 합니다. 각 세션은 격리된 환경에서 실행되므로 실행 간 비교가 신뢰할 만합니다.
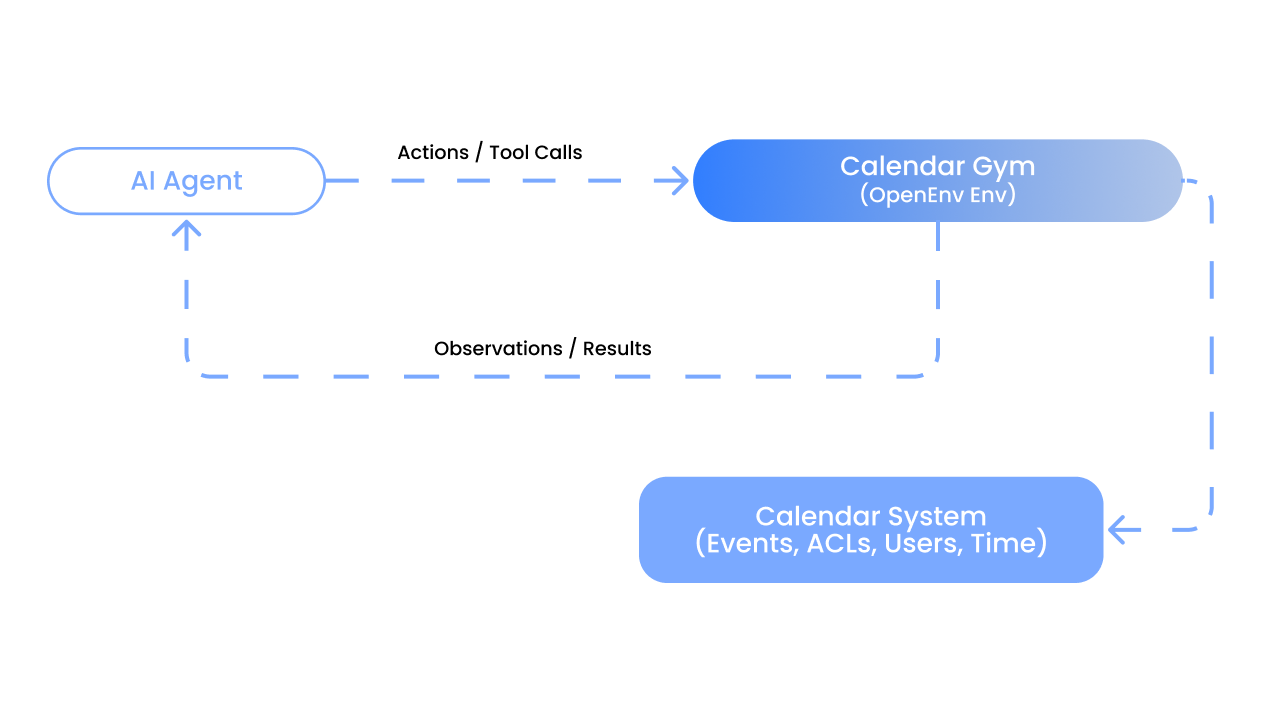
사용 방식은 MCP 도구 호출 그대로입니다. 원문의 예시는 환경에 접속해 도구 목록을 확인하고 캘린더를 조회한 뒤 이벤트를 만드는 흐름을 보여 줍니다.
from openenv_wrapper.client import MCPEnvClient
from openenv_wrapper.data_models import MCPAction

with MCPEnvClient.from_hub(base_url="TuringEnterprises/calendar-gym") as client:
    # Connect and reset the environment
    result = client.reset()
    print("Reset successful:", result.observation.success)

    # Discover available tools
    result = client.step(MCPAction(action_type="ListToolsAction"))
    print("Available tools:", len(result.observation.tools_list))

    # List calendars
    result = client.step(MCPAction(
        action_type="ToolCallAction",
        tool_name="calendars_list",
        arguments={}
    ))
    calendars = result.observation.tool_result["items"]
    print("Calendars:", calendars)

    # Create an event
    result = client.step(MCPAction(
        action_type="ToolCallAction",
        tool_name="events_insert",
        arguments={
            "calendarId": "primary",
            "summary": "Team Sync",
            "start": {"dateTime": "2026-01-15T14:00:00Z"},
            "end": {"dateTime": "2026-01-15T15:00:00Z"}
        }
    ))
    print("Event created:", result.observation.success)
이 코드는 2026년 2월 당시의 MCPEnvClient와 MCPAction 인터페이스를 씁니다. 지금 저장소의 예제는 openenv.core.env_server.mcp_types의 ListToolsAction과 CallToolAction을 step()에 직접 넘기는 형태로 정리되었으므로, 위 코드를 그대로 붙여 쓰기보다 현재의 MCP 환경 튜토리얼을 기준으로 삼는 편이 안전합니다.
실측 결과가 지목한 세 가지 병목
평가 결과에서 나온 세 가지 발견은 캘린더에 국한되지 않습니다. Turing은 이 실패 양상이 상태가 살아 있는 시스템에서 장시간 작동하는 에이전트 전반에 나타난다고 보고, 평가 프레임워크가 권한과 부분 관측 가능성(partial observability), 다단계 워크플로우를 따로가 아니라 함께 시험해야 한다고 결론짓습니다.
다단계 추론이 1차 병목입니다. 에이전트는 게임처럼 떨어지는 개별 행동에는 잘 대응하지만, 여러 단계에 걸친 워크플로우를 올바른 순서로 연결하는 데 실패합니다. 실제 작업은 여러 API 호출의 연쇄를 요구하고, 단계 사이에 문맥을 유지해야 하며, 긴 워크플로우에서는 오류 복구 능력이 결정적입니다. 벤치마크가 단일 도구 호출이 아니라 서로 의존하는 여러 단계의 지속적 추론을 시험해야 한다는 결론이 여기서 나옵니다.
모호함이 성능을 크게 떨어뜨립니다. 같은 작업을 명시적인 캘린더 식별자로 표현했을 때와 자연어 설명으로 표현했을 때의 성공률 차이가 이 발견의 핵심입니다. "Bob의 프로젝트 캘린더에 Alice 접근 권한을 부여하라" 는 작업에서, 명시적 ID를 주면 89%가 성공했지만 자연어 설명으로 바꾸면 41%로 떨어졌습니다. 실패 양상은 세 가지로 나뉩니다. 검증 없이 첫 번째 일치 항목을 쓰는 추측, 같은 대상을 반복 조회하는 과다 질의, 존재하지 않는 캘린더 ID를 만들어 내는 환각(hallucination)입니다. 대응은 LLM이 참조를 알아서 해소하기를 기대하지 않고, 에이전트 루프 자체에 조회와 검증과 사용의 순서를 심는 것입니다.
올바른 도구를 고르는 것만으로는 부족합니다. 실패한 도구 호출 500건을 분석한 결과, 도구 선택이 틀린 경우는 23%뿐이었습니다. 나머지 대부분은 도구는 맞았지만 인자가 잘못되었거나 순서가 틀린 경우였습니다.
| 실패 유형 | 비중 |
|---|---|
| 잘못된 도구를 선택 | 23% |
| 도구는 맞고 인자가 틀림 | 51% |
| 도구와 인자는 맞고 순서가 틀림 | 18% |
| 그 외 (타임아웃, 인증) | 8% |
인자 오류의 구체적 형태는 필수 필드 누락, 문자열과 객체를 혼동하는 타입 불일치, 잘못된 열거값 사용입니다. 원문 부록은 이 세 가지를 실제 오류 페이로드와 함께 정리하면서, 각각에 대한 대응이 인자 검증과 예시 중심 프롬프팅이라고 결론짓습니다. 특히 스키마 검증 오류에 대해서는 구조화된 검증 오류를 돌려주어 모델이 조용히 실패하는 대신 스스로 수정해 재시도할 수 있게 하라고 권합니다. 권한 오류에 대해서는 필요한 OAuth 스코프를 문서화하고 구조화된 조치 안내를 함께 돌려주라고 하며, 날짜 형식 오류에 대해서는 시간대 오프셋을 명시한 RFC3339로 표준화하고 올바른 예시를 최소 하나 문서에 넣으라고 합니다.
즉 이 실측이 향하는 결론은 모델을 더 키우는 쪽이 아니라 환경 설계 쪽입니다. 에이전트의 신뢰성은 도구 선택 능력만큼이나 실행 품질과 구조화된 피드백에 달려 있고, 그 피드백을 설계하는 주체가 환경이기 때문입니다. Calendar Gym은 Hugging Face Space로 복제해 볼 수 있고, 지금은 OpenEnv 저장소의 envs/calendar_env로도 들어와 있습니다.
Calendar Gym 더 알아보기
Evaluating Tool-Using Agents in Production-Oriented Environments with OpenEnv - 설계와 벤치마크 방법론, 정량 결과를 담은 Turing의 기술 문서
Calendar Environment Docs
거버넌스의 이동: Meta 저장소에서 11개 조직의 기술위원회로
2026년 6월 8일의 세 번째 글은 기능 발표가 아니라 소유 구조의 발표입니다. OpenEnv는 이제 기술위원회(Technical Committee) 가 조율하며, 저장소도 meta-pytorch/OpenEnv에서 huggingface/OpenEnv로 옮겼습니다. 이전 주소는 현재 새 주소로 넘어갑니다. 위원회에 참여하는 조직은 다음 열한 곳입니다.
Meta-PyTorch, Reflection, Unsloth, Modal, Prime Intellect, NVIDIA, Mercor, Fleet AI, Microsoft, Hugging Face, RadixArk

여기에 더해 위원회 밖에서 프로젝트를 지지하고 채택한 조직 목록이 저장소에 정리되어 있습니다. PyTorch Foundation, vLLM, UC Berkeley의 SkyRL, Lightning AI, Axolotl AI, Stanford Scaling Intelligence Lab, Mithril, OpenMined, Scaler AI Labs, Scale AI, Patronus AI, Surge AI, LastMile AI, Halluminate, Turing, Scorecard, Snorkel AI, SGLang, Miles입니다. 학습 프레임워크, 추론 엔진, 데이터 라벨링, 평가, 샌드박스 인프라가 한 명단에 들어 있다는 점이 이 프로젝트가 겨냥하는 접점의 범위를 보여 줍니다. PyTorch Foundation 산하 프로젝트들의 최근 동향은 PyTorchKR의 PyTorch Foundation 프로젝트 소식 정리에서도 다룬 바 있습니다.
거버넌스와 함께 패키지 이름도 바뀌었습니다. 초기 openenv-core는 2025년 10월 21일 0.1.0으로 시작해 2026년 5월 11일 0.3.0까지 나왔고, 그 뒤를 openenv가 2026년 6월 2일 0.3.0으로 이어받아 현재 0.4.1까지 왔습니다. 첫 글이 PyPI 링크로 안내한 openenv-core를 지금 그대로 설치하면 구버전을 받게 되므로, 현재의 설치 명령은 pip install openenv입니다.
보상 프레임워크가 아니라 프로토콜 계층이라는 선언
세 번째 글은 거버넌스 변경과 나란히 OpenEnv의 범위도 함께 조였습니다. 글은 OpenEnv가 무엇인지 를 조인다고 표현하면서, OpenEnv를 RL 환경의 상호운용 계층(Interoperability Layer) 으로 규정합니다. 환경이 어떻게 배포되고 소비되는지를 표준화하는 것이 일이고, 보상을 어떻게 정의하는지나 학습 루프가 어떻게 도는지는 지시하지 않는다는 것입니다. 보상 정의와 채점 루브릭, 학습기별 로직은 그것을 전문으로 하는 라이브러리의 몫이고, OpenEnv는 그 모두가 꽂히는 공통 소켓이 되겠다는 선언입니다.
실무적으로 이 선언은 세 가지를 뜻합니다.
하나의 인터페이스, 여러 환경. 모든 환경이 익숙한 Gymnasium 형식의 reset(), step(), state()를 클라이언트와 서버 구조 위에서 노출합니다. OpenEnv를 말할 수 있는 학습기라면 규격을 지킨 어떤 환경이든 별도 코드 없이 구동할 수 있습니다.
익숙한 프로토콜과 표준 포장. 환경은 HTTP와 WebSocket 같은 표준 프로토콜로 서빙되고 Docker로 포장됩니다. MCP가 1급 시민이므로 OpenEnv 환경은 MCP 서버와 즉시 호환되며, 같은 환경이 시뮬레이션 모드와 프로덕션 모드에서 일관되게 동작합니다.
환경 라이브러리 간 상호운용. Verifiers나 harbor 같은 서로 다른 생태계의 환경을 정의하고 소비할 수 있고, 원하는 인프라와 허브를 고를 수 있습니다. OpenEnv는 그들의 경쟁자가 아니라 그 아래에 놓이는 배포와 인터페이스 계층입니다.
앞서 본 루브릭 시스템이 환경 안에서 보상을 계산한다는 점을 떠올리면 이 선언과 긴장이 생깁니다. 프로젝트가 스스로 내놓은 답이 다음 절에서 볼 로드맵의 첫 항목, 즉 보상을 외부 라이브러리에 맡기고 OpenEnv는 배포 계층으로 남는 방향입니다.
2026년 9월 현재: RFC 로드맵은 어디까지 왔는가
세 번째 글은 앞으로 몇 달 동안 집중할 다섯 가지를 제시했습니다. 외부 보상, 데이터셋 기반 태스크셋, 하네스 통합 지속, TRL과 Unsloth와 Miles를 아우르는 종단 간 예제, 그리고 환경의 품질과 모델 학습 기여도를 측정하는 자동 검증입니다. 이 글이 발행된 지 약 3개월이 지난 2026년 9월 3일 기준으로 저장소를 확인하면 진행 상황이 고르지 않습니다.
| RFC | 주제 | PR | 문서에 적힌 Status |
|---|---|---|---|
| 000 | 프로젝트 단계와 설계 원칙 | 병합 (2025년 10월 21일) | In Review |
| 001 | 기본 API와 인터페이스 규격 | 병합 (2025년 10월 17일) | In Review |
| 002 | 에이전트의 환경 도구 탐색 | 병합 (2025년 10월 17일) | In Review |
| 003 | MCP 지원 1단계 | 병합 (2026년 1월 21일) | In Review |
| 004 | 보상 계산을 위한 루브릭 시스템 | 병합 (2026년 1월 29일) | 표기 없음 |
| 005 | 에이전틱 하네스 통합 | 병합 (2026년 2월 18일) | In Review |
| 006 | 외부 환경 가져오기 | 열림 | 검토 중 |
| 006 | Hugging Face 데이터셋 기반 RL 환경 | 열림 | 검토 중 |
| 008 | 환경 자동 검증 | 문서 병합, 추적 이슈 열림 | In Review |
| 010 | 환경 토큰 월드 모델링 (ECHO) | 병합 (2026년 6월 17일) | Draft |
표를 두 열로 나눈 이유가 있습니다. PR이 병합되었다는 것은 그 문서와 코드가 저장소에 들어왔다는 뜻이고, RFC 자체가 수락되었다는 뜻은 아닙니다. rfcs/README.md가 정의한 RFC 생애 주기는 In Review, Accepted, Implemented, Rejected, Superseded 다섯 단계인데, 병합된 문서들도 헤더의 Status 필드는 여전히 In Review에 머물러 있고 RFC 010은 Draft입니다. 구현이 들어간 항목과 문서상 단계가 어긋나 있으므로, 어느 기능이 실제로 동작하는지는 RFC 번호가 아니라 저장소 코드와 공식 문서로 확인하는 편이 안전합니다.
번호가 둘 다 006인 것은 오기가 아닙니다. 6월 글이 RFC 006과 RFC 007로 지목한 두 제안이 각각 006-external-environment-imports.md와 006-hf-rl-environment-datasets.md라는 파일명으로 열려 있고, 둘 다 아직 병합되지 않았습니다. 여기에 RFC 010 문서는 006부터 009까지가 자기개선형 gym 계열(커리큘럼 및 적대적 설계자, 하네스 최적화, 모의 파운드리, 궤적에서 환경 생성) RFC를 위해 예약되어 있다고 적고 있습니다. 로드맵의 번호 체계가 재배치되는 중이라는 뜻이므로, 6월 글의 번호를 그대로 인용하면 지금 저장소와 맞지 않습니다.
가장 흥미로운 병합 건은 6월 17일에 들어온 RFC 010입니다. 에이전트 RL에서는 보통 환경의 응답 토큰을 마스킹하고 에이전트의 행동 토큰만으로 학습합니다. ECHO 는 여기에 정책이 환경의 관측 토큰까지 예측하도록 만드는 교차 엔트로피 항을 얹습니다.
정책은 이미 그 관측 토큰을 조건으로 삼고 있고 같은 순전파에서 로짓도 이미 계산하고 있으므로, 월드 모델링 신호는 사실상 공짜로 얻어집니다. 추가 롤아웃도, 교사 모델도, 별도의 월드 모델도 필요 없고 이미 있는 로짓에 다른 마스크를 씌우는 것뿐입니다. ECHO 논문이 보고하는 결과는 RL이 약 2.3배 빨라지고, TerminalBench-2.0 pass@1이 대략 두 배가 되며, 교사 없이 전문가 SFT 이득의 50%에서 104%를 회복하고, 보상을 끈 검증기 없는 설정에서도 미학습 작업 성능이 개선된다는 것입니다. 원논문은 ECHO: Terminal Agents Learn World Models for Free이며 2026년 5월 23일 공개되었습니다.
OpenEnv 쪽에서 이 목적 함수를 켜려면 두 가지가 필요합니다. 하나는 궤적을 토큰 단위 역할 라벨과 함께 표현하는 것이고, 다른 하나는 최적화기 접점에 월드 손실 설정을 두는 것입니다. RFC는 토큰 역할을 네 가지로 나눕니다.
| 역할 | 의미 | 손실 |
|---|---|---|
context |
시스템 프롬프트, 보조 코드(Scaffolding), 셸 프롬프트 | 없음 |
action |
에이전트 및 어시스턴트 토큰 | GRPO 학습 대상 |
env_output |
실제 도구 및 환경 출력 | 월드 모델링 대상 |
warning |
하네스 상용구 (되울린 명령, [stdout] 태그, 래퍼) |
기본적으로 환경 손실에서 제외 |
warning 역할이 따로 있는 이유가 실무적으로 눈에 띕니다. 하네스가 되울리는 상용구까지 예측하도록 학습하면 신호가 상용구 쪽으로 흐려지므로, 진짜 환경 출력과 하네스 잡음을 구분해야 한다는 것입니다. 이 구분을 만들려면 롤아웃 시점에 토큰 역할 구간을 기록하거나, 기존의 역할 태그가 붙은 메시지와 채팅 템플릿에서 다시 유도해 내야 합니다. 궤적 기록 형식이 왜 규격의 일부가 되어야 하는지를 보여 주는 사례입니다.
저장소의 38종과 허브의 4,600종: 두 층으로 나뉜 환경 생태계
환경이 몇 개인지는 어디를 세는지에 따라 두 자리 수와 네 자리 수로 갈립니다. 저장소의 envs/ 디렉토리와 공식 문서의 환경 목차에는 각각 38개가 올라 있고, 이쪽은 관리자가 고른 큐레이션 목록입니다. 반면 Hugging Face Spaces에서 openenv 태그로 검색하면 2026년 9월 3일 기준 4,600개가 넘게 나옵니다. RFC 008 문서는 2026년 8월 4일 시점에 허브가 4,300개 이상의 환경을 호스팅한다고 적었고, 추적 이슈 #778은 2026년 6월 8일에 이미 4,000개를 넘겼다고 적었습니다. 커뮤니티가 올린 환경의 주제도 데이터센터 운영, 유전체학과 신약 탐색, 재난 트리아지, 물류 배차, 환각 탐지처럼 저장소 목록에 없는 영역까지 뻗어 있습니다.
저장소에 들어 있는 38종은 성격이 꽤 넓게 갈립니다. 클라이언트 연동을 초 단위로 검증하는 Echo, 샌드박스에서 코드를 실행하는 Coding과 E2B 기반의 Jupyter, 터미널 중심의 Terminus, 여러 도구를 쓰는 Coding Tools, 브라우저 자동화의 BrowserGym, 저장소를 다루는 Git과 OpenCode와 Pi, 게임 계열의 Atari와 OpenSpiel과 Chess와 Snake와 Connect4, 텍스트 게임의 TextArena, 물리 및 제어의 DM Control과 CARLA와 SUMO-RL과 Unity, 추론 과제의 Reasoning Gym과 QED Math, 안전 진단의 DIPG Safety, 금융 도메인의 FinRL과 FinQA, 그리고 RFC 010과 함께 들어온 Agent World Model까지 있습니다. 공식 문서 목차도 이 점을 명시하면서, 최신 추가분은 OpenEnv 조직 페이지나 agent-environment 태그가 붙은 Spaces에서 확인하라고 안내합니다.
인접 프로젝트들과의 관계: OpenEnv가 하지 않겠다고 선언한 것
이 영역에는 OpenEnv만 있는 것이 아닙니다. PyTorchKR에도 인접한 프로젝트를 다룬 글들이 있어서 함께 놓고 보면 OpenEnv의 위치가 더 분명해집니다. Kimi K3의 강화학습을 구동하는 셀프호스팅 샌드박스 런타임 AgentENV처럼, 특정 모델 학습을 위한 자체 환경 런타임을 만드는 흐름이 있습니다. 1조 파라미터 규모의 에이전틱 강화학습을 다루는 prime-rl은 학습기 쪽의 규모 문제를 파고들고, Open-AgentRL은 학습 프레임워크와 환경을 한 묶음으로 제공합니다. 정적인 벤치마크 환경을 에이전트의 약점에 맞춰 재구성하는 EnvHarness 연구나 브라우저에서 돌아가는 오픈소스 MMO 환경 World of ClaudeCraft처럼 환경 자체를 연구 대상으로 삼는 작업도 있습니다.
OpenEnv가 이들과 다른 점은 무엇을 하지 않겠다고 선언했는지에 있습니다. 학습 알고리즘을 제공하지 않고, 보상 설계 방법론을 규정하지 않고, 특정 모델이나 하네스에 최적화하지 않습니다. 남는 것은 접점의 규격뿐이고, 그 규격이 여러 조직에게 동시에 받아들여지느냐가 이 프로젝트의 성패를 가릅니다. 6월의 거버넌스 이전이 기능 발표보다 중요했던 이유이기도 합니다.
지금 시작하기
설치는 코어 패키지와 환경 클라이언트를 따로 받는 구조입니다. 환경마다 의존성이 다르기 때문에 코어는 최소한으로 유지됩니다.
pip install openenv
pip install git+https://huggingface.co/spaces/openenv/echo_env
환경을 직접 만들어 배포하는 흐름은 CLI 두 줄입니다. openenv init으로 뼈대를 만들고, 필요하면 기존 외부 환경을 openenv import로 감싼 뒤, openenv push로 Hugging Face Spaces에 올립니다.
openenv init my_game_env
cd my_game_env
openenv push
처음부터 끝까지 한 번 훑어보고 싶다면 저장소가 제공하는 Colab 노트북과 GPU Mode 강의 기반의 Zero to Hero 튜토리얼이 있습니다. torchforge로 LLM에게 블랙잭을 학습시키는 예제도 대표 예제로 제시되어 있습니다.
남아 있는 한계
OpenEnv 저장소는 스스로를 실험 단계라고 명시합니다. 버그와 미완성 기능, 그리고 향후 버전에서 바뀔 수 있는 API를 예상해야 한다고 적혀 있고, 버그 수정은 환영하지만 큰 변경은 기술위원회와 커뮤니티가 범위와 호환성과 릴리스 시점을 조율할 수 있도록 먼저 이슈 트래커에서 의사를 밝히기를 권합니다. 실제로 이 글에서 다룬 세 편의 원문 사이에도 저장소 위치, 패키지 이름, MCP 클라이언트 인터페이스가 각각 한 번씩 바뀌었습니다.
로드맵 쪽에서도 아직 열려 있는 항목이 눈에 띕니다. 보상을 외부 라이브러리에 맡기는 제안과 데이터셋으로 태스크셋을 구성하는 제안은 3개월이 지난 지금도 PR 상태이고, 번호 체계까지 재배치되는 중입니다. 저장소의 열린 이슈가 102건인 점도 프로젝트가 아직 빠르게 움직이는 단계임을 보여 줍니다.
가장 무거운 숙제는 환경 품질입니다. 허브에 4,000개가 넘는 환경이 쌓인 상태에서 수동 검토는 규모를 따라갈 수 없고, RFC 008 문서는 실제로 새어 나간 결함 유형을 구체적으로 열거합니다. 빈 해답에 최대 보상을 주는 검증기, 올바른 해답이 최대 점수보다 낮게 채점되는 경우, 관측 안에 정답이 노출되는 경우, 실행마다 보상이 달라지는 경우입니다. 제출된 검증기 하나는 빈 문자열에 보상 1.0을 돌려주었다고 적혀 있습니다. 지금은 openenv validate가 구조적 검사의 일부만 다루고, openenv push는 그와 어긋나는 별개의 검사를 경고로만 내며, 어느 것도 게이트로 작동하지 않고 매니페스트 스키마도 없습니다.
RFC 008이 제시하는 기준은 이슈 #778이 정의한 여섯 가지 속성입니다. 인프라에서 확장되는가(재현 가능한 빌드), 학습 가능한가(모델이 수백 스텝 안에 성능을 올릴 수 있는가), 안전한가(모델이 생성한 행동이 격리되는가), 보상 해킹에 취약하지 않은가(보상이 주장하는 것을 실제로 뜻하는가), 관측과 상태와 도구와 작업이 선언된 대로 들여다보이는가, 그리고 실행과 호스트와 시간이 달라져도 같은 입력이 같은 결과를 내는가입니다. 이 여섯 가지가 44개의 인수 테스트로 분해되고, 검증은 정적(레벨 1), 런타임(레벨 2), 의미(레벨 3), 통계(레벨 4)의 네 단계로 나뉩니다. 레벨 1부터 3까지는 작성자가 노트북이나 CI에서 추론 없이 수 초에서 수 분 안에 돌릴 수 있고, 참조 모델과 추론 연산이 필요한 레벨 4는 운영자 몫으로 남겨 둡니다.
여기서 이 프로젝트의 성격이 한 번 더 드러납니다. RFC 008이 명시한 설계 약속은 "로컬 검증과, 누구든 허브를 만들 수 있게 하는 계약을 제공한다. 허브 자체는 제공하지 않는다" 입니다. 허브는 Hugging Face뿐 아니라 사설 랩의 심사 시스템과 앞으로의 운영자들까지 여럿이 될 것이므로, 공용 저장소에 허브 구현을 하나 넣어 두면 특정 운영자의 답이 조용히 표준이 되어 버린다는 것입니다. 그래서 저장소는 러너와 큐, 제출 API, 게이트 정책을 담지 않고 결과가 서로 비교 가능해지기 위해 모두가 합의해야 하는 조각만 담습니다. 다만 문서는 검증의 한계도 함께 적어 둡니다. 검증이 말해 주는 것은 어떤 환경이 학습에 쓰일 수 있다 는 것이고, 학습에 쓰여야 한다 는 것이 아닙니다. 형식적 정합성과 실행 가능성을 인증할 뿐 연구 가치를 인증하지는 않습니다.
마지막으로 두 번째 글의 실측이 남긴 함의를 다시 짚어 둘 필요가 있습니다. 규격이 갖춰졌다고 에이전트가 잘 동작하는 것은 아닙니다. 명시적 식별자에서 89%였던 성공률이 자연어 표현에서 41%로 떨어지고, 실패한 도구 호출의 절반 이상이 도구를 제대로 골랐는데도 인자를 틀린 경우였습니다. OpenEnv가 제공하는 것은 그 실패를 재현 가능하고 측정 가능한 형태로 만들어 주는 바닥이고, 그 위에서 무엇을 고칠지는 여전히 환경과 하네스를 설계하는 사람의 몫입니다.
 Building the Open Agent Ecosystem Together, Introducing OpenEnv 소개 블로그
OpenEnv in Practice, Evaluating Tool-Using Agents in Real-World Environments 소개 블로그
The Open Source Community is backing OpenEnv for Agentic RL 소개 블로그
 OpenEnv GitHub 저장소
 OpenEnv 공식 문서
 OpenEnv 환경 허브
라이선스
OpenEnv는 BSD 3-Clause License로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 저작권 표시와 라이선스 전문을 함께 배포하고, 기여자의 이름을 홍보에 무단으로 쓰지 않는 조건만 지키면 됩니다.
더 읽어보기
-
1조 파라미터 규모로 에이전틱 강화학습을 수행하는 prime-rl 0.6.0의 최적화 총정리 (feat. Prime Intellect)
-
Open-AgentRL: LLM 에이전트 강화를 위한 통합 오픈소스 프레임워크 (feat. RLAnything & DemyAgent)
-
오픈소스 AI의 미래를 이끌다: PyTorch Foundation 프로젝트 최신 소식 | 파이토치 한국 사용자 모임
-
[Deep Research] Model Context Protocol(MCP) 개념 및 이해를 위한 학습 자료
-
[Deep Research] 강화학습의 개념과 주요 기법 분석, LLM에서의 활용 및 발전 방향에 대한 보고서
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
