핵심 요약
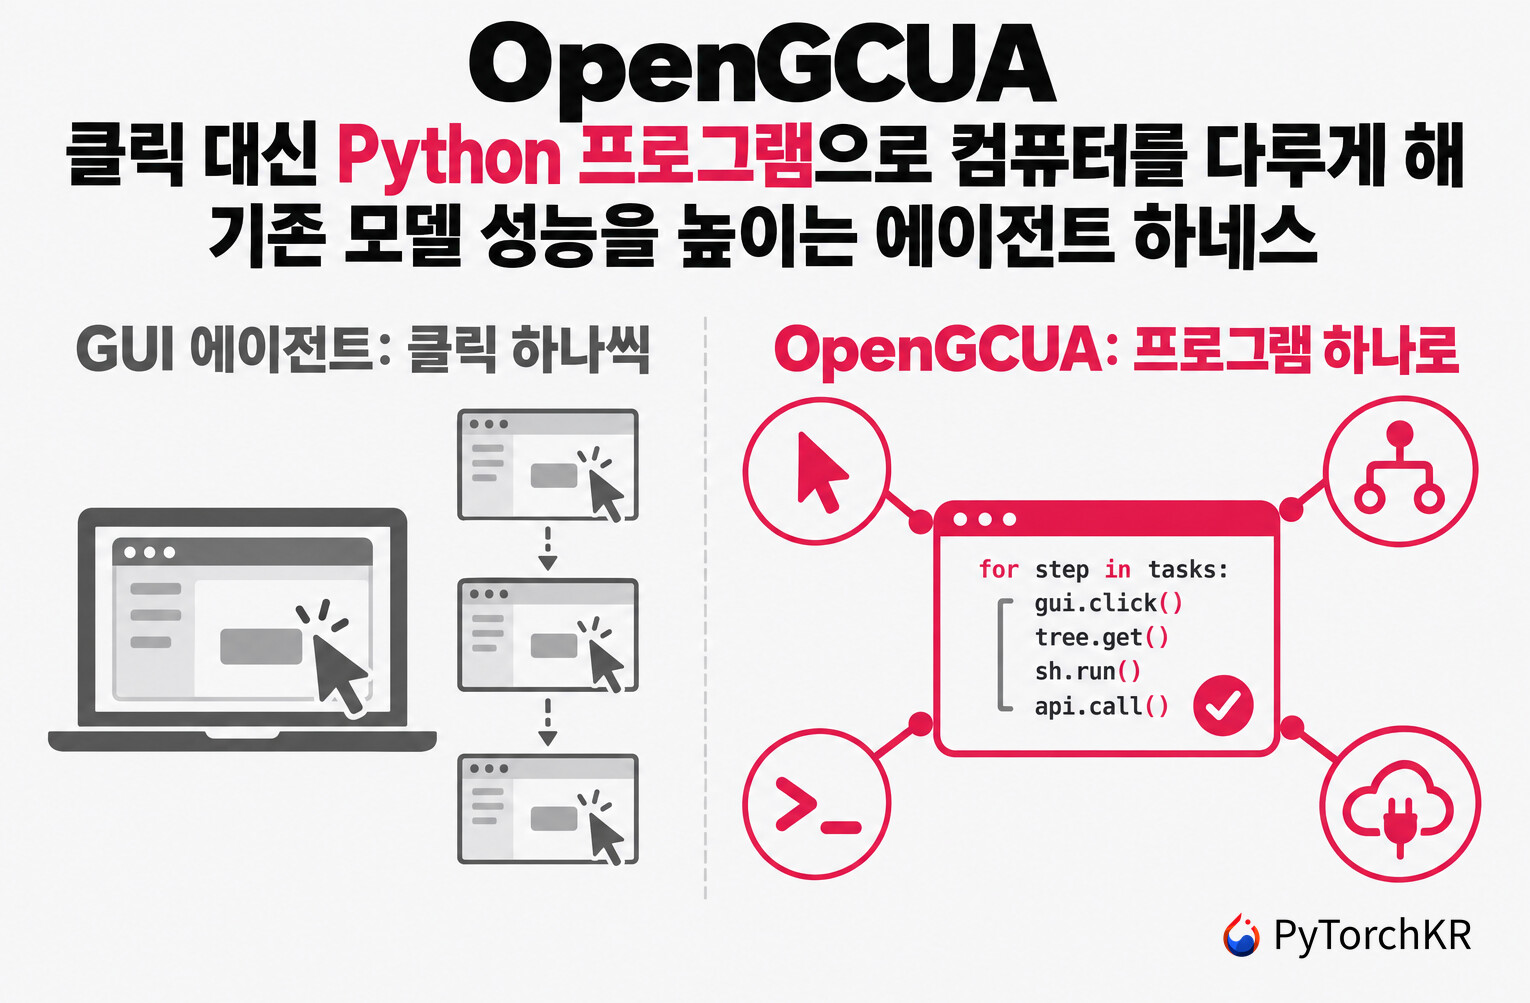
- OpenGCUA는 컴퓨터 사용 에이전트가 화면을 보고 클릭 하나씩 하는 대신, 매 단계 Python 프로그램 하나로 GUI 조작, 접근성 트리, 셸 명령, API 호출을 묶어 실행하게 하는 에이전트 하네스와 SDK입니다.
- 개발팀은 기술 보고서에서 모델을 새로 학습하지 않고 하네스만 바꿔 측정한 결과를 공개했습니다. OSWorld-v2 오프라인 82개 과제에서 기존 모델 8종의 평균 부분 점수가 45.3점에서 64.9점으로 올랐고, 과제당 단계 수는 평균 53.0% 줄었습니다.
- 이번 공개분은 프롬프트와 참조 에이전트 코드, 8개 모델의 평가 궤적, 아직 초기 단계(preliminary)인 macOS 실기기 하네스와 Cross-Device SDK입니다. 학습된 GCUA 모델은 다음 릴리스에서 공개할 계획입니다.
- 실기기 하네스는 macOS 14 이상에서 돌고, 구매나 삭제 같은 중대한 동작 전에 사용자에게 묻는 규칙이 코드가 아니라 시스템 프롬프트 지시로만 들어 있어, 개발팀은 잃어도 되는 상태의 컴퓨터에서만 실행하라고 안내합니다.
OpenGCUA 소개
컴퓨터 사용 에이전트(Computer-Use Agent, CUA)는 오랫동안 화면 캡처를 보고 마우스와 키보드 동작을 하나씩 내보내는 방식으로 연구되어 왔습니다. 이 방식은 픽셀만 있으면 어떤 앱이든 다룰 수 있지만, 표의 행 수십 개를 채우는 일처럼 같은 동작이 반복되는 작업에서는 클릭마다 모델을 다시 호출해야 합니다. 최근 GPT-6 Astra 같은 상용 시스템은 GUI 조작에 셸 명령과 접근성 트리(Accessibility Tree, 창 안의 버튼과 입력란을 역할과 이름, 값으로 나열한 구조 정보) 접근을 함께 쓰는 쪽으로 옮겨 가고 있습니다. OpenGCUA 기술 보고서는 GPT-6 Astra 출시와 함께 OpenAI의 컴퓨터 사용 가이드가 마우스와 키보드용 computer 도구에 주로 기대기보다 PyAutoGUI나 Playwright로 짧은 프로그램을 쓰라고 권하기 시작한 점(computer 도구도 대안으로 남아 있습니다)을 이 전환의 근거로 듭니다. 그러나 이런 시스템의 프롬프트, 실기기 하네스, 실행 기록은 공개되어 있지 않아서 연구자가 설계를 재현하거나 비교하기 어렵습니다. 이번에 소개하는 OpenGCUA는 Alibaba Group의 MAI-UI 팀이 이 빈자리를 채우려고 공개한, 범용 컴퓨터 사용 에이전트의 전체 스택을 열겠다는 프로젝트입니다.
OpenGCUA 팀은 범용 컴퓨터 사용 에이전트(Generalist Computer-Use Agent, GCUA)를 구성 요소가 아니라 결정 방식으로 정의합니다. 매 단계마다 무엇을 관찰할지, 어떻게 행동할지, 작업을 어떻게 정리할지를 하네스 규칙이 아니라 모델이 정한다는 것입니다. 이를 위해 OpenGCUA는 두 가지 설계를 씁니다. 첫째는 코드 실행(Code Execution)으로, 모델이 GUI 조작과 셸 명령을 반복문과 조건문이 있는 Python 프로그램 하나로 묶습니다. 둘째는 하네스-모델 결정 이전(Harness-to-Model Decision Transfer)으로, 스크린샷을 언제 볼지와 진행 상황을 어떻게 기록할지를 하네스 규칙에서 모델의 선택으로 옮깁니다.
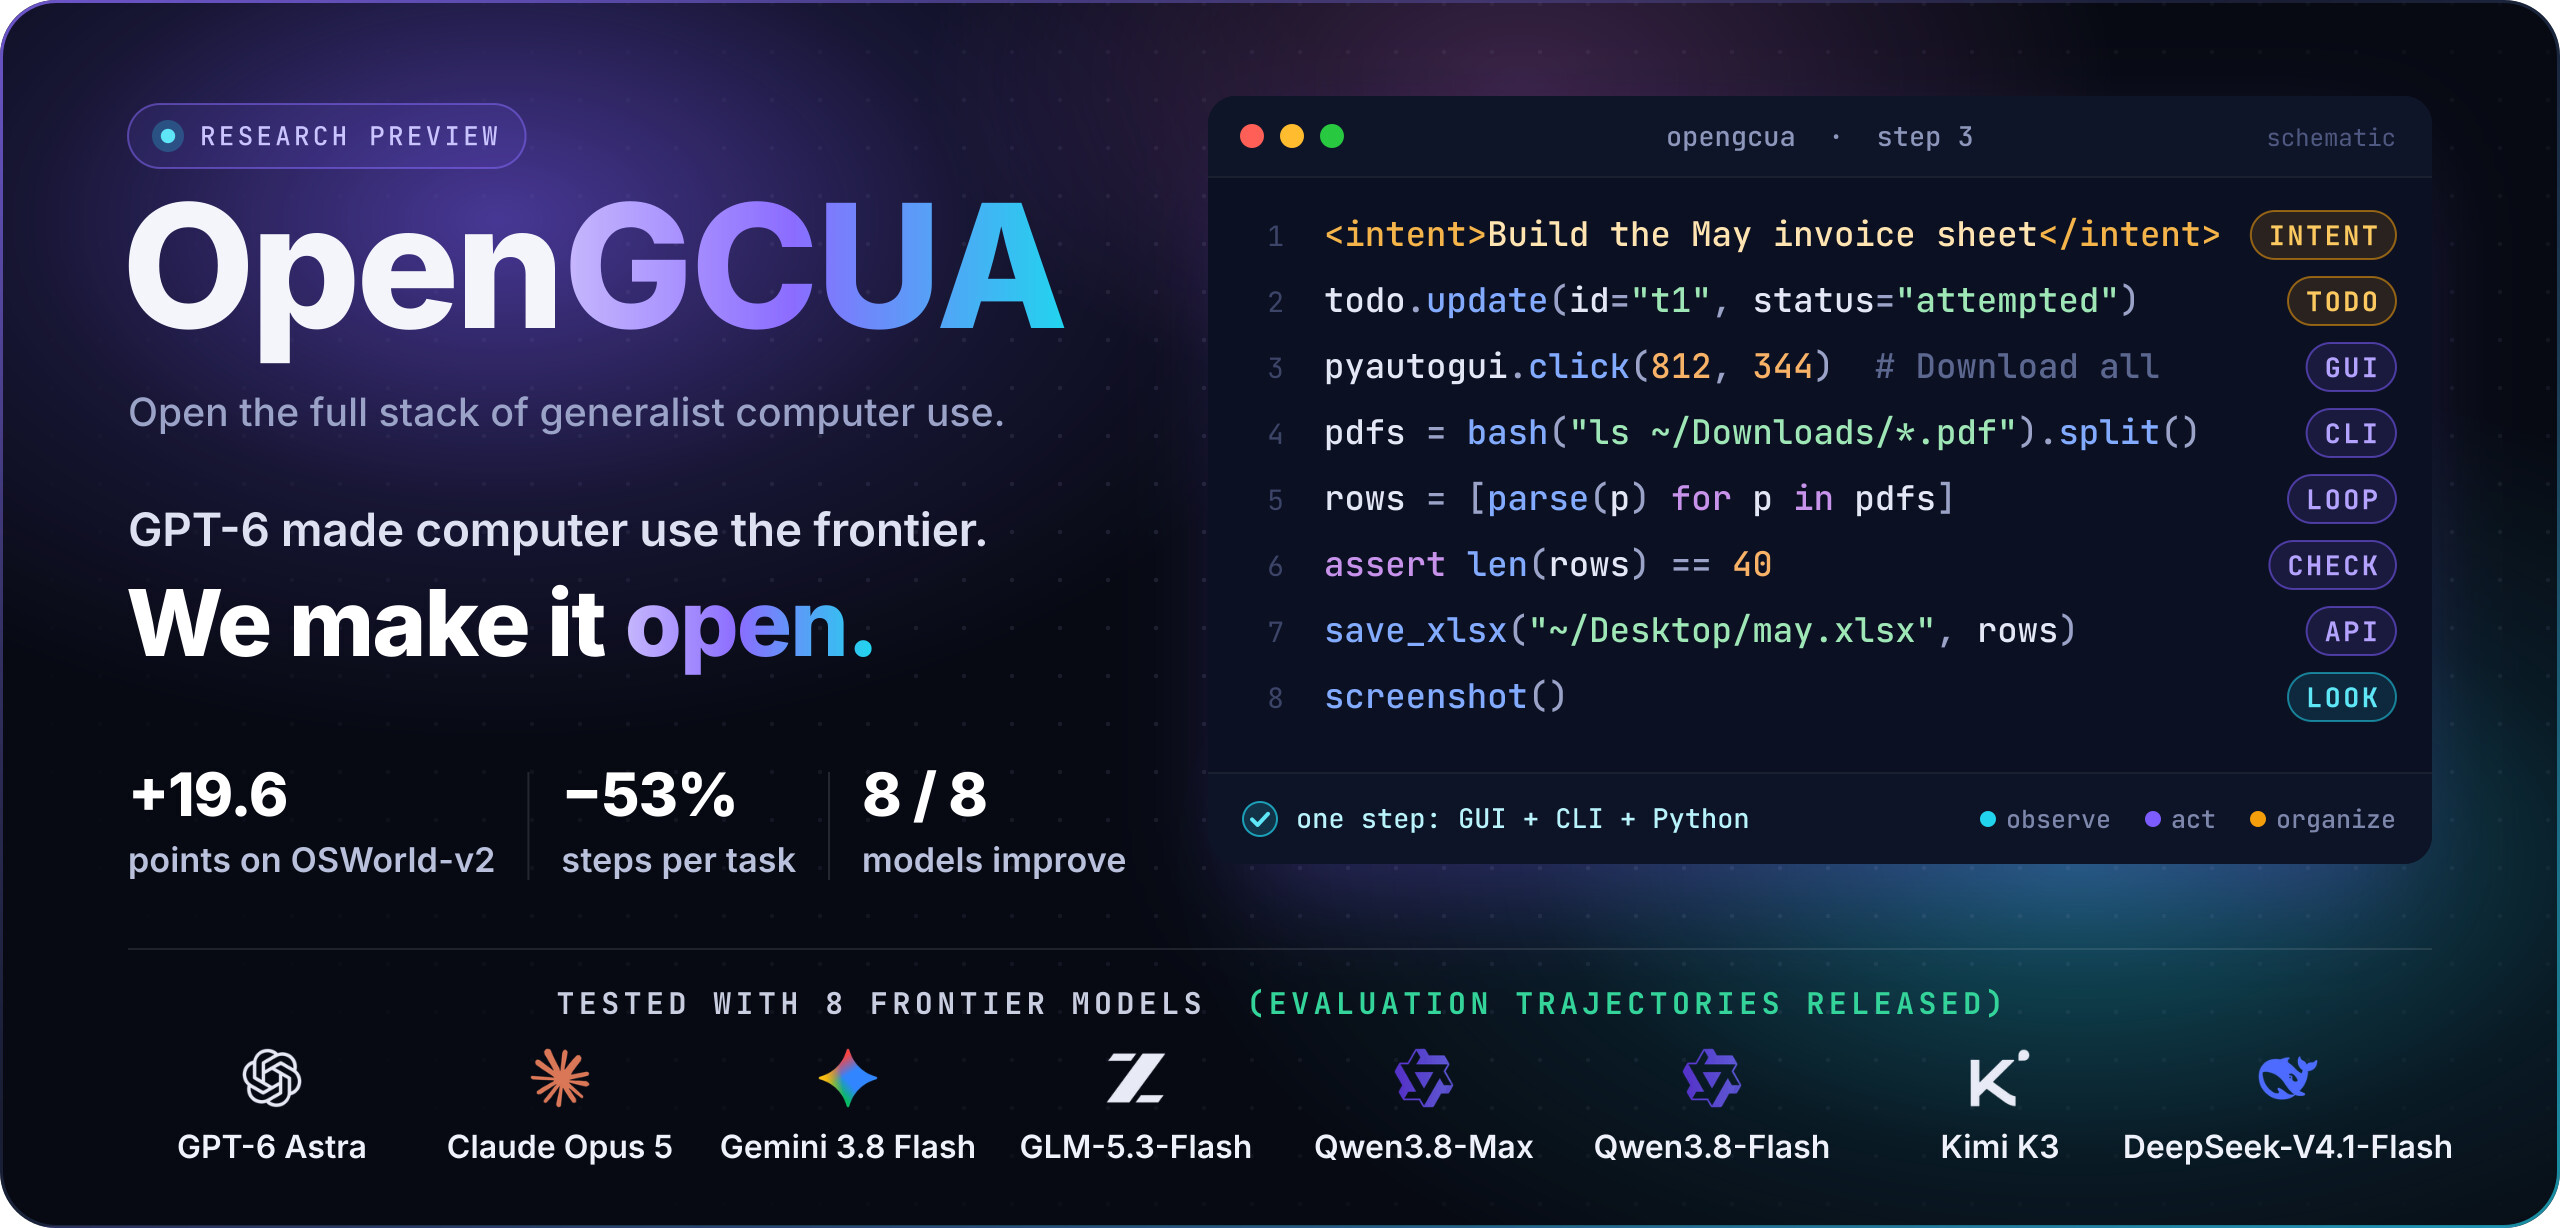
이번 첫 공개에는 학습된 모델이 들어 있지 않습니다. 대신 OpenGCUA 팀은 기존 모델 8종(GPT-6 Astra, Claude Opus 5, Gemini 3.8 Flash, Qwen3.8-Max, Qwen3.8-Flash, Kimi K3, DeepSeek-V4.1-Flash, GLM-5.3-Flash)을 같은 하네스에 넣어 설계 효과를 검증했습니다. 그 과정의 프롬프트와 평가 궤적, macOS에서 실제로 쓰는 하네스와 SDK도 함께 공개했습니다. 평가에는 장시간 업무형 벤치마크인 OSWorld-v2(OSWorld 2.0)를 썼습니다. macOS 쪽 입력 전달은 trycua의 Cua Driver(
 Cua Driver: Windows와 Linux 데스크톱 백그라운드 컴퓨터 사용 프로젝트 (feat. Claude Code, MCP))를 수정 없이 사용합니다.
OpenGCUA와 기존 컴퓨터 사용 에이전트 비교
OpenGCUA 기술 보고서는 기존 에이전트 계열을 같은 수식으로 놓고, 각 계열이 세 가지 결정 중 무엇을 미리 고정하는지 비교합니다. 보고서 표 1을 옮기면 다음과 같습니다:
| 계열 | 무엇을 관찰하나 | 어떻게 행동하나 | 작업 정리 |
|---|---|---|---|
| GUI 에이전트 | 매 단계 스크린샷 | GUI 동작 하나 | 하네스 규칙 (예: 최근 k장의 스크린샷 유지) |
| CLI 에이전트 | 명령 출력만 | 셸 명령과 스크립트 | 일부를 모델이 결정 (예: 컨텍스트 요약) |
| 멀티 에이전트 하이브리드 | 하위 에이전트마다 고정 | 하위 에이전트마다 고정 | 오케스트레이터와 하위 에이전트가 나눔 |
| Qwen-UI-Agent (GUI+CLI) | 매 단계 스크린샷과 명령 출력 | GUI와 CLI 동작 배치(batch) | 하네스 규칙 |
| OpenGCUA (GCUA) | 모델이 단계마다 선택, 프로그램 출력 | 모든 인터페이스를 쓰는 프로그램 | 모델이 결정 |
같은 팀이 앞서 공개한 Qwen-UI-Agent는 GUI와 CLI 동작을 한 번의 호출에 여러 개 묶어 한꺼번에 보내는 배치 방식이었습니다. 보고서는 이 배치(batch)를 *"제어 흐름이 없는 프로그램"*으로 부릅니다. 배치 방식에서는 모델이 첫 클릭의 결과를 보기 전에 모든 클릭을 정해야 하지만, 코드 실행에서는 프로그램이 실행되는 동안 조건 분기와 반복, 결과 확인이 이뤄집니다. 멀티 에이전트 하이브리드와의 차이는 인터페이스를 고르는 시점입니다. 오케스트레이터가 하위 작업마다 한 번 고르는 대신, OpenGCUA에서는 모델 하나가 매 단계 고르고 한 프로그램 안에서 여러 인터페이스를 섞을 수 있습니다.
코드를 에이전트의 실행 기반으로 보는 관점 자체는 Code as Agent Harness 서베이에서도 정리된 흐름입니다. OpenGCUA는 같은 관점을 컴퓨터 사용 에이전트에서 8개 모델로 측정했다는 점이 다릅니다.
OpenGCUA를 사용하면 좋을 사용자
OpenGCUA는 컴퓨터 사용 에이전트를 연구하거나 직접 하네스를 만드는 개발자에게 가장 쓸모가 큽니다. 8개 모델이 OSWorld-v2 108개 과제를 수행한 전체 궤적(모델이 쓴 코드, 관찰, 실행 결과)이 공개되어 있어서, 모델별로 어떤 프로그램을 쓰고 어디서 실패하는지 직접 분석할 수 있습니다. 하네스 설계의 영향을 비교하려는 연구자에게는 코드 실행과 각 메커니즘을 하나씩 켜고 끈 절제 실험(ablation) 결과도 출발점이 됩니다.
반면 자기 Mac을 맡길 완성된 비서를 찾는 사용자에게는 아직 이릅니다. 실기기 하네스와 SDK는 개발팀 스스로 preview 단계로 표시하고 있고, 결제 같은 중대한 동작을 코드로 막는 확인 절차는 아직 구현되지 않았습니다. 업무용 데이터가 있는 컴퓨터에서 바로 실사용하려는 사용자에게는 OpenGCUA가 아직 적절한 선택지가 아닙니다. OSWorld 점수를 직접 재현하려는 경우에도 공개된 OSWorld 예제가 참조 에이전트 코드일 뿐 전체 평가 실행기가 아니라는 점을 감안해야 합니다.
OpenGCUA의 전체 구성: 공개된 것과 다음 릴리스
OpenGCUA는 모델, 에이전트 설계, 실기기 실행, 궤적, 효율, 평가의 여섯 층을 차례로 공개하는 것을 목표로 합니다. 아래 그림은 층별 공개 상태를 보여 주며, 초록색 RELEASED는 공개됨, 노란색 PRELIMINARY는 초기 버전, 점선 NEXT는 다음 공개 예정입니다:

이번에 공개된 구성 요소는 다음과 같습니다:
- OSWorld 통합 예제: packages/harness/examples/osworld의 스크린샷 동작 에이전트와 코드 실행 에이전트 두 파일입니다. 환경 구성, 과제 스케줄링, 채점은 호출하는 쪽이 맡고, 전체 OSWorld 평가 실행기는 들어 있지 않습니다.
- 평가 궤적: 8개 모델 각각이 OSWorld-v2 108개 과제를 수행한 기록을 궤적 탐색 페이지에서 보고 zip 파일로 내려받을 수 있습니다. 재시도와 채점되지 않은 시도까지 모두 3,480건이 남아 있어, 점수 집계에 쓴 시도(오프라인 82개 과제)와 나머지 시도를 비교해 볼 수 있습니다.
- macOS 실기기 하네스: packages/harness의 터미널 에이전트와 데모 스튜디오, 그리고 메뉴 막대에서 쓰는 네이티브 macOS 앱입니다.
- Cross-Device SDK: packages/sdk의 Python 패키지
qwen-intelligence-sdk로, Rust 코어 위에 macOS, Android, 브라우저, Linux 어댑터를 둡니다.
다음 릴리스의 중심은 컴퓨터 사용과 브라우저 사용을 한 모델로 묶은 GCUA 모델입니다. ROADMAP.md는 이 모델을 자체 데이터, 자사 대형 모델의 자기 증류(self-distillation), 공개 라이선스 데이터로만 학습하고 비공개 모델의 출력을 증류(distillation)하지 않겠다고 밝힙니다. 다만 ROADMAP.md의 상태 표는 첫 프리뷰(v0.1) 기준으로 남아 있어, 평가 궤적을 "예정"으로 표시하고 가중치 공개를 v0.2에 둡니다. 실제로는 궤적이 이미 공개되어 있고, GitHub의 v0.2.0과 v0.3.1 릴리스에는 가중치가 없습니다. 날짜는 약속하지 않는다고 개발팀이 밝히고 있으므로, 모델 공개 시점은 릴리스 페이지에서 확인해야 합니다.
OpenGCUA의 코드 실행 방식
OpenGCUA의 코드 실행 하네스에서 모델은 단계마다 Python 프로그램 하나를 출력합니다. OSWorld-v2 설정에서는 데스크톱 조작에 PyAutoGUI를, 셸 명령에 bash() 함수를 쓰고, 실기기 하네스는 브라우저 조작용 Playwright를 추가로 씁니다. 하네스는 코드 블록을 꺼내 문법을 확인한 뒤 실행하고, 표준 출력과 오류, 실행 상태를 다음 입력으로 돌려줍니다.
아래는 OSWorld-v2의 고객 관리(CRM) 과제에서 GPT-6 Astra가 실제로 출력한 한 단계입니다. ... 표시 줄은 생략된 부분입니다:
<intent>Apply the 29 evidence-based status changes while preserving all original
customer details.</intent>
<code>
todo.update(id="updates", kind="task", content="Applying 29 reviewed status changes ...",
            status="attempted")
r = bash(r"""...
cat > /tmp/apply_lead_statuses.py <<'PY'
...
current=api(p,'/api/crm/workspace')['workspace']
assert current==original,'Workspace changed since original review; stopped before edits.'
for change in changes:
    d=api(p,'/api/crm/leads/'+change['leadId'],'PATCH',{'status':change['to']})
    ...
    assert lead['status']==change['to']
...
print('VERIFIED:',len(log),'status changes; all 40 statuses correct; ...')
PY
python /tmp/apply_lead_statuses.py""")
if r.ok:
    todo.update(id="status_updates", kind="task",
                content="Applied and API-verified all 29 planned status changes. ...",
                status="claimed_verified")
</code>
이 한 단계에서 모델은 의도를 밝히고 계획을 기록한 뒤, 앱 상태가 마지막으로 확인한 뒤 바뀌었으면 멈추는 스크립트를 작성해 실행합니다. 스크립트는 앱의 자체 API로 29건을 수정하고 하나씩 확인하며, 스크립트가 성공한 뒤에만 기록을 검증 완료로 바꿉니다.
기술 보고서는 GPT-6 Astra의 궤적에서 반복해서 나타난 코드 실행 패턴 다섯 가지를 정리합니다. 아래 그림은 그중 세 가지로, 왼쪽부터 Cross-Interface Composition(GUI 클릭과 파일 검사를 번갈아 수행), Loop-Based Execution(웹 페이지 7개 섹션을 반복문으로 방문하며 DOM으로 확인), Result-Dependent Execution(초안이 일치할 때만 Send 클릭)입니다:
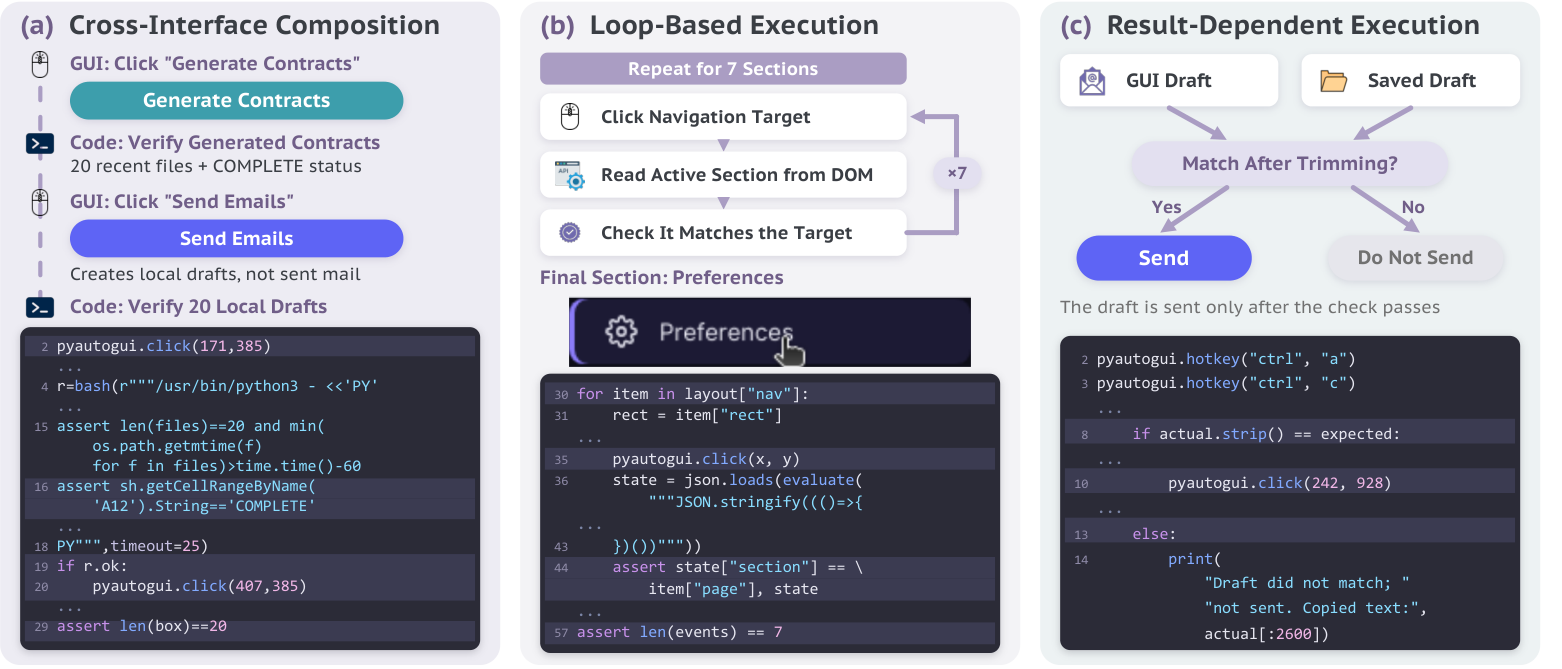
나머지 두 패턴은 다음 판단에 쓸 관찰을 프로그램이 미리 준비하는 것(3차원 객체의 25개 시점을 한 장의 번호 붙은 이미지로 모으기)과, 바뀌어야 할 부분과 바뀌면 안 되는 부분을 assert로 확인하는 것(슬라이드 배경 2개를 고친 뒤 프레젠테이션 파일의 나머지 64개 항목이 그대로인지 검사)입니다. 저자들은 이런 assert가 독립적인 평가를 대신하지는 않는다고 덧붙입니다.
OpenGCUA의 하네스-모델 결정 이전
코드 실행이 "어떻게 행동할지"를 다룬다면, 하네스-모델 결정 이전은 "무엇을 관찰할지"와 "작업을 어떻게 정리할지"를 다룹니다. 현재 구현은 세 가지 인터페이스를 모델에게 줍니다:
screenshot(): 모델이 다음 입력에 새 스크린샷이 필요한지 정합니다. 프로그램 출력만으로 충분하면 스크린샷 없이 진행합니다. 환경은 매 단계 스크린샷을 기록하지만, 모델이 받는 입력만 달라집니다.todo: 진행 상황, 확인한 사실, 남은 질문을 기록합니다. 상태값은 대기, 시도함, 바뀌었지만 미확인(changed_unverified), 검증했다고 판단함(claimed_verified)으로 나뉩니다. 이 상태는 모델의 판단이지 환경을 독립적으로 검증한 결과가 아닙니다.<intent>: 프로그램을 실행하기 전에 그 목적을 한 문장으로 밝힙니다. 실기기에서는 이 문장을 사용자에게 보여 주어, 코드를 읽지 않아도 에이전트가 무엇을 하려는지 알 수 있게 합니다.
오래된 스크린샷을 여러 장씩 한꺼번에 지우는 롤링 스크린샷 버퍼(rolling screenshot buffer)와 오래된 도구 출력을 짧은 자리표시로 바꾸는 마이크로 압축(micro-compaction)은 여전히 하네스 규칙으로 남겨 두었습니다. 기술 보고서 표 4는 코드 실행을 기준선으로 두고 각 메커니즘을 하나씩 더한 결과입니다. 캐시 적중률(Cache hit)은 입력 토큰 중 캐시에서 처리된 비율이고, 생략은 보고서가 적지 않은 값입니다:
| 구성 | Qwen3.8-Max 점수 | 단계/과제 | 캐시 적중률(%) | DeepSeek-V4.1-Flash 점수 | 단계/과제 | 캐시 적중률(%) |
|---|---|---|---|---|---|---|
| 코드 실행 | 62.4 | 54.9 | 75.6 | 56.7 | 74.5 | 61.9 |
| + screenshot | 64.3 | 63.0 | 86.1 | 58.1 | 90.0 | 76.3 |
| + todo | 64.0 | 56.7 | 생략 | 58.5 | 74.1 | 생략 |
| + intent | 61.5 | 53.4 | 생략 | 53.3 | 82.4 | 생략 |
| + micro-compaction | 63.4 | 58.7 | 68.6 | 56.8 | 79.7 | 58.9 |
| + rolling screenshot buffer | 64.4 | 53.2 | 91.6 | 57.2 | 79.2 | 75.3 |
| + 전체 메커니즘 | 64.0 | 57.0 | 84.1 | 57.7 | 84.9 | 70.5 |
필요할 때만 스크린샷을 보게 하자 두 모델 모두 캐시 적중률이 10.5%p, 14.4%p 올랐고 점수도 조금 올랐습니다. 다만 단계 수는 오히려 늘었습니다(54.9에서 63.0, 74.5에서 90.0). todo는 두 모델의 점수를 올렸고, intent는 두 모델 모두 점수가 내려갔습니다. 저자들은 intent의 목적이 벤치마크 점수가 아니라 실기기 사용자의 이해라고 설명합니다. 두 모델의 선택된 실행(selected runs) 결과라 차이가 1~3점인 항목은 실행 간 편차와 구분하기 어렵다는 점도 함께 봐야 합니다.
OpenGCUA 벤치마크: OSWorld-v2 결과
OpenGCUA 팀은 GPT-6 Astra 출시 때의 평가 방식을 따라 OSWorld-v2(v2.1) 108개 과제 중 인터넷 접속이 필요한 26개를 뺀 오프라인 82개 과제로 평가했습니다. 점수는 과제별 부분 점수(partial credit)의 평균(0~100)이고, 비교 기준선은 배치 동작을 지원하는 GUI 전용 에이전트입니다. 아래 그림의 회색 막대가 기준선(GUI-only baseline, batched actions), 보라색 막대가 OpenGCUA 전체 구성이며, 왼쪽은 부분 점수(Partial score), 오른쪽은 과제당 단계 수(Steps per task)입니다:
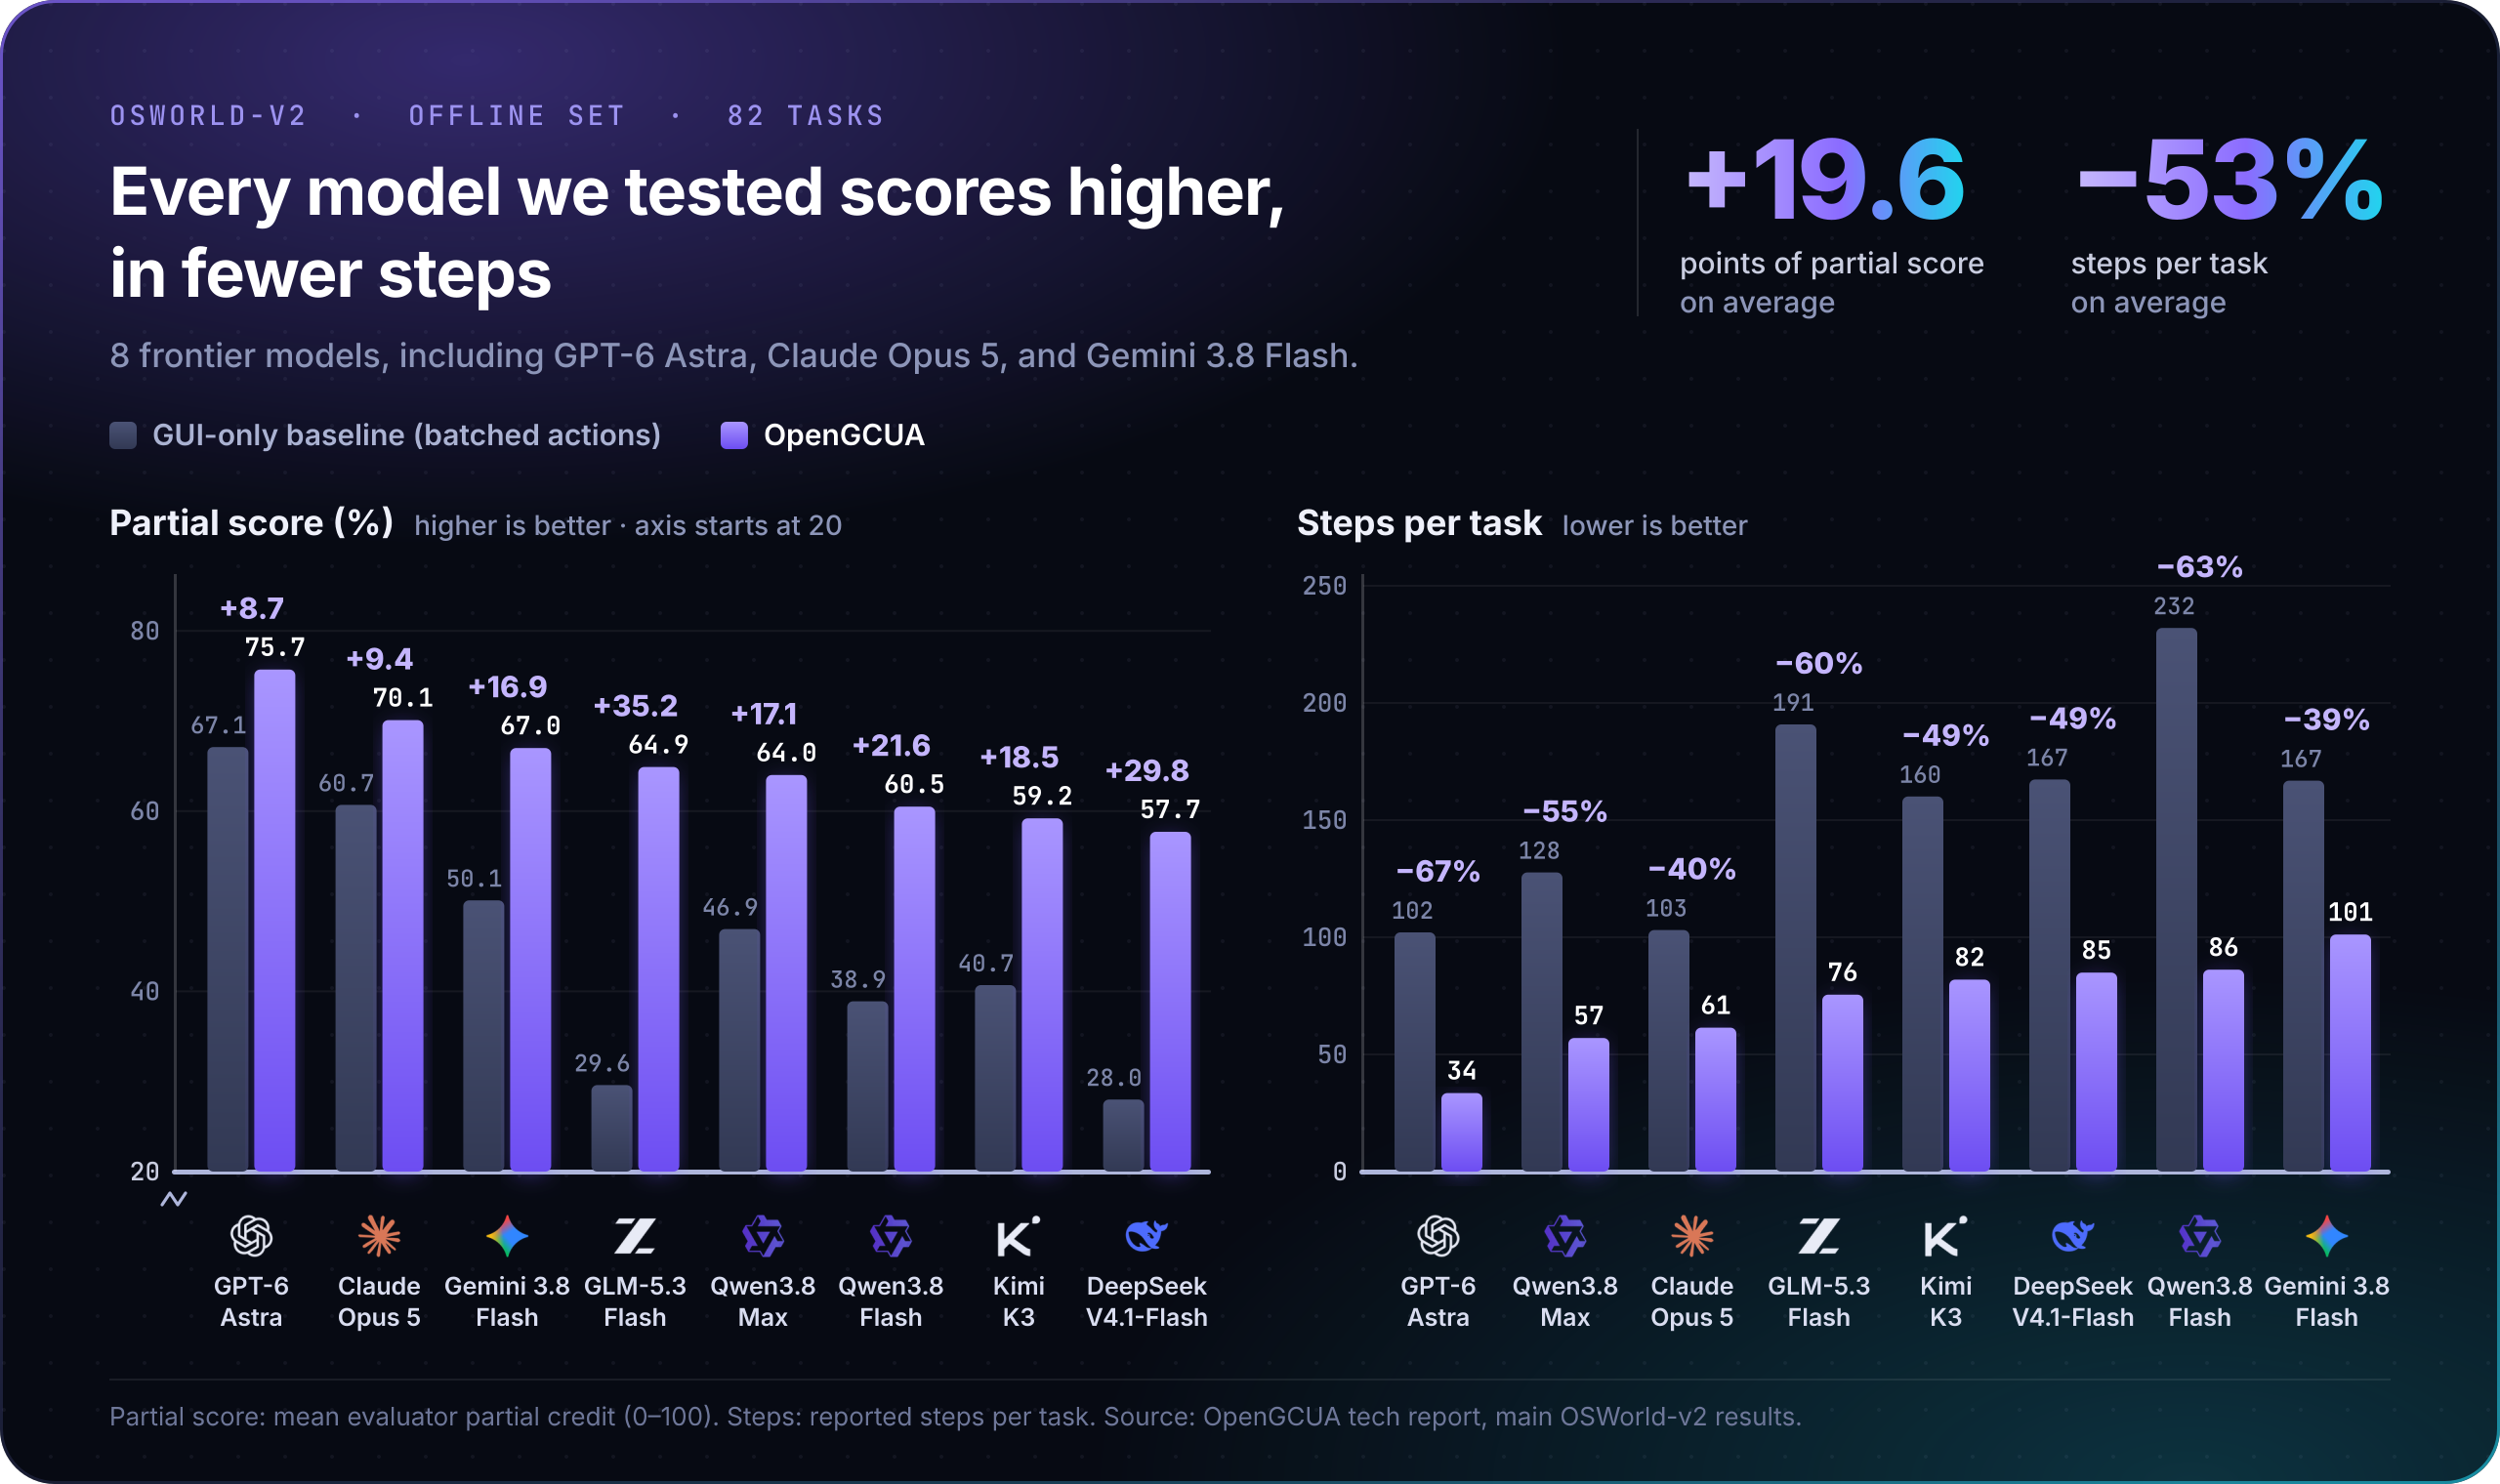
8개 모델 모두 점수가 오르고 단계가 줄었습니다. 평균 부분 점수는 45.3점에서 64.9점으로 19.6점 올랐고, 모델별 단계 감소율의 평균은 53.0%입니다. 기준선이 약했던 모델일수록 더 많이 올랐습니다. GLM-5.3-Flash가 29.6점에서 64.9점(+35.2), DeepSeek-V4.1-Flash가 28.0점에서 57.7점(+29.8)이 되면서, 최고와 최저 모델의 격차는 39.1점에서 18.0점으로 줄었습니다. 가장 높은 GPT-6 Astra는 67.1점에서 75.7점으로 오르면서 과제당 단계가 102.1에서 33.5로 줄었습니다. 출력 토큰은 8개 중 6개 모델에서 줄었지만(평균 27.2%), GPT-6 Astra는 단계가 3분의 1로 줄어도 출력 토큰은 거의 같았습니다(30.8K에서 31.9K).
이 결과를 읽을 때 세 가지를 같이 봐야 합니다. 첫째, 기준선 선택의 영향입니다. 아래 코드 실행 절제 실험 그림에서 배치 GUI(GUI + batch)의 점수는 Qwen3.8-Max와 DeepSeek-V4.1-Flash에서 단일 동작 GUI(GUI single action)보다 오히려 낮습니다(50.9 대 46.9, 29.5 대 28.0). 19.6점은 이 배치 GUI 기준선 대비 수치입니다. 둘째, 모든 수치는 개발팀이 고른 실행(selected runs)이고, 부록 A에 따르면 각 실행 안에서 과제마다 가장 높은 시도가 아니라 가장 마지막 시도를 집계했습니다. 셋째, 같은 GUI와 셸 접근 권한을 준 배치 GUI+CLI 기준선과 비교하면 OpenGCUA 전체 구성과의 차이는 4.4~9.1점으로 줄어듭니다. 절제 실험에서도 배치 GUI에 셸 접근만 더했을 때 세 모델의 점수가 10.3~26.2점 올라, 배치 GUI 대비 코드 실행 개선폭의 절반 이상이 셸 접근을 더한 단계에서 나왔습니다.
아래 그림은 Qwen3.8-Max, DeepSeek-V4.1-Flash, GLM-5.3-Flash 세 모델에서 실행 방식만 바꾼 절제 실험이며, 위는 과제 점수(Task score), 아래는 과제당 단계 수(Steps/task)입니다:
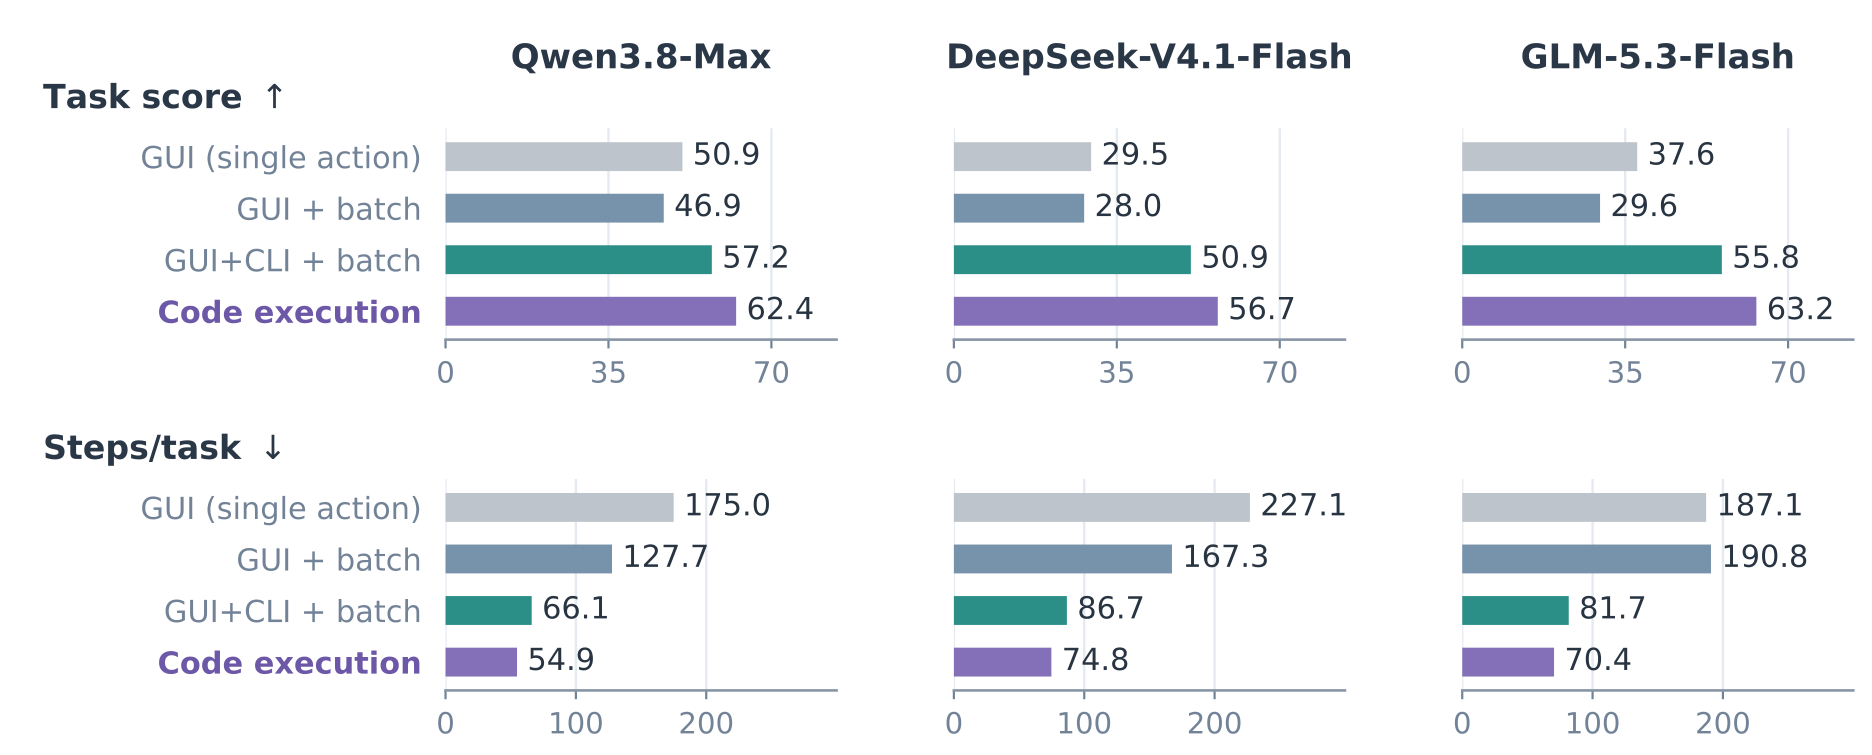
같은 GUI와 셸 접근에서 코드 실행은 배치 GUI+CLI보다 세 모델 평균 6.1점 높고 단계는 14.8% 적었습니다. 저자들은 중간 결과가 다음 동작을 정하는 데 모델 호출이 필요 없다는 점과 모델이 이미 가진 프로그래밍 능력을 그대로 쓸 수 있다는 점이 이 개선을 설명할 수 있다고 봅니다.
비용 관점의 분석도 있습니다. 같은 실행에 과제당 지출 상한을 사후에 적용하면, 공개 API 가격 기준으로 Qwen3.8-Flash는 과제당 약 0.38달러에 60.5점, GPT-6 Astra는 약 15.26달러에 최고 점수 75.7점을 냈습니다. 예산이 늘면 최고 점수 모델이 Qwen3.8-Flash, GLM-5.3-Flash, Gemini 3.8 Flash, GPT-6 Astra 순으로 바뀝니다. 시간 상한 분석은 모델마다 API 대역폭과 동시 실행 환경 수를 통제하지 않아, 저자들도 참고용으로만 제시합니다.
OpenGCUA의 실기기 하네스와 Cross-Device SDK
벤치마크는 과제마다 깨끗한 환경을 준비해 주지만, 사용자의 Mac은 그렇지 않습니다. OpenGCUA 팀은 실기기에서 새로 생기는 요구 사항 다섯 가지를 꼽습니다:
- 사용자와 에이전트가 마우스, 키보드, 포커스 창을 함께 씁니다.
- 에이전트가 추론(reasoning)하는 동안에도 창이 열리고 닫히고 움직입니다.
- 사용자가 작업 도중 요청을 고치거나 조건을 더합니다.
- 대상 앱, 창, 탭이 뒤에 가려져 있을 수 있어 관찰 대상을 명시해야 합니다.
- 이전에 쓰던 파일, 탭, 로그인 세션이 남아 있는 상태에서 작업이 시작됩니다.
이를 위해 실기기 하네스는 모델, 런타임(Runtime), Device SDK, 드라이버, 실제 앱과 OS의 다섯 층으로 나뉩니다. 모델이 프로그램을 쓰고(Writes a Program), 런타임이 지속되는 인터프리터에서 실행하며(Runs the Program), SDK 호출을 드라이버가 실제 앱 조작으로 바꿉니다(Acts on Real Apps):
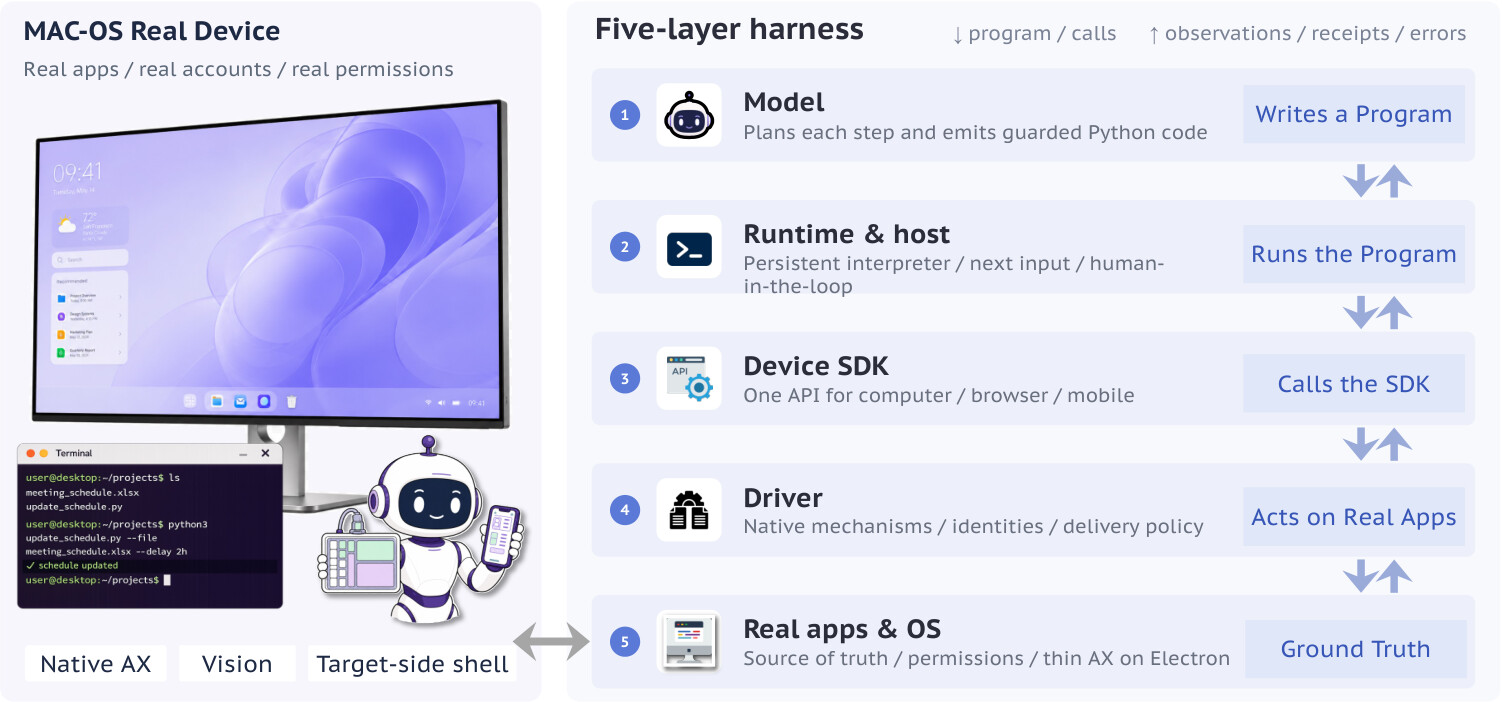
사용자 작업을 방해하지 않도록 하네스는 접근성 요소에 대한 직접 조작을 먼저 쓰고, 그다음 창을 지정한 좌표 입력, 마지막으로 화면 앞으로 창을 가져오는 입력을 씁니다. 앞으로 가져오는 입력이 필요하면 사용자에게 허용 여부를 묻고, 터미널 UI에서는 거부가 기본 선택입니다. 로그인이나 모호한 대상처럼 에이전트가 혼자 풀 수 없는 상황에는 ask_user로 사용자에게 묻습니다.
안전 범위는 꼼꼼히 확인해야 합니다. packages/harness/README.md는 중대한 동작에 대한 확인 절차(confirmation gating)를 아직 구현 중으로 표시하고, 그전까지는 상태를 잃어도 되는 컴퓨터에서만 실행하라고 적어 두었습니다. 현재 코드에서 구매, 전송, 게시, 삭제, 권한 변경 전에 ask_user로 먼저 묻는 규칙은 mac_agent.py의 시스템 프롬프트 지시로만 들어 있어, 모델이 지시를 따르는지에 달려 있습니다. QUICKSTART.md에 따르면 앞의 허용 절차는 SDK를 거치는 동작에만 적용되고, 모델이 직접 작성한 Python과 Bash 코드에는 적용되지 않습니다. Ctrl-C로 턴을 중단해도 이미 실행된 동작은 되돌려지지 않습니다.
Cross-Device SDK는 모든 동작을 특정 기기, 앱, 창, 탭에 묶습니다. 접근성 정보를 쓰는 ui.ax와 이미지와 좌표를 쓰는 ui.vision을 분리하고, 프로그램이 관찰한 데이터 중 mu.emit으로 넘긴 것만 모델에게 전달합니다. 모델은 자기에게 전달된 관찰에 나온 요소 번호만 쓸 수 있고, 화면이 바뀌어 낡은 참조는 추측하지 않고 거부됩니다. 다만 SDK의 Windows 어댑터는 v1.0 계획에 있고, 현재 네 어댑터도 모두 preview 상태입니다.
실기기 결과는 macOS 과제 4개(워크북 추론, PDF 양식 작성, 쇼핑 조사, 호텔 비교)에서 같은 하네스로 모델만 바꿔 측정했습니다. 아래 그림은 과제당 추론 토큰(Reasoning tokens per task), GPT-6 Astra 대비 배수(vs GPT-6 Astra), 완료한 과제 수(Done)입니다:

GPT-6 Astra는 과제당 34.5단계, 출력 12.9K 토큰(추론 2.6K)으로 4개를 모두 끝냈고, Qwen3.8-Max는 50.8단계, 73.4K 토큰(추론 50.2K)을 쓰고 3개를 끝냈습니다. 그러나 추정 비용은 Qwen3.8-Max가 과제당 1.49달러, GPT-6 Astra가 18.29달러로 순서가 반대입니다. 같은 하네스로 돌린 별도의 이전 실행을 분석한 사례에서 Qwen3.8-Max는 스크린샷 한 장을 찍는 4줄짜리 프로그램에 추론 토큰 2,030개를 썼습니다(GPT-6 Astra는 11개). 워크북 과제에서는 125개 문항 중 고정된 행 범위로 85개만 처리하고, 빠진 문항이 있는지 확인하지 않았습니다. 과제 4개에 모델별 실행 한 번씩이라, 저자들도 이 결과가 일반적인 모델 순위가 아니라 평가한 구성의 특성을 보여 줄 뿐이라고 적고 있습니다. DeepSeek은 호텔 과제 궤적이 없어 집계에서 빠졌습니다.
개발팀은 실제 Mac에서 같은 비자 신청서를 OpenGCUA, OpenGCUA(GUI 우선), GUI + 배치, Codex 네 방식으로 채우는 비교 영상도 공개했습니다. 영상마다 재생 속도가 달라서, 경과 시간은 영상 안의 시계로 확인해야 한다고 개발팀은 안내합니다:
OpenGCUA 설치와 사용
macOS 소스 하네스를 쓰려면 macOS 14 이상, uv, Python 3.11~3.14(3.12 권장), Rust/Cargo 1.89 이상, Xcode Command Line Tools가 필요합니다. SDK는 PyPI에 올라가 있지 않으므로, 아래처럼 저장소에서 설치하거나 GitHub 릴리스의 wheel 파일(macOS arm64, Linux x86_64)을 받아 설치합니다. 저장소 루트에서 실행하는 설치 명령은 다음과 같습니다:
git clone https://github.com/Tongyi-MAI/OpenGCUA.git
cd OpenGCUA

uv venv --python 3.12
source .venv/bin/activate
uv pip install -e ./packages/sdk -e ./packages/harness/runtime

# Install the native driver app. Its daemon is included in the app bundle.
.venv/bin/mu setup macos
.venv/bin/mu doctor macos

.venv/bin/mu setup browser --engine chromium
.venv/bin/mu doctor browser --engine chromium

# Create a private local configuration from the shipped defaults.
cp packages/harness/configs/macos_demo.json packages/harness/configs/local.json
mu setup macos는 /Applications/CuaDriver.app을 설치합니다. 설치 뒤 시스템 설정 → 개인정보 보호 및 보안에서 CuaDriver.app에 손쉬운 사용(Accessibility)과 화면 기록(Screen Recording) 권한을 주고, CuaDriver를 다시 실행한 다음 mu doctor macos로 확인합니다. 권한이 없으면 드라이버가 PERMISSION_DENIED를 돌려줍니다.
모델 설정은 packages/harness/configs/local.json에서 다음 항목을 바꿉니다. 기본 예시는 Alibaba Cloud DashScope의 OpenAI 호환 엔드포인트입니다:
{
  "api_key": "YOUR_API_KEY",
  "model_name": "qwen3.8-flash",
  "llm_base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
  "llm_protocol": "openai"
}
Chat Completions 호환 게이트웨이는 "openai", Responses API의 암호화된 추론을 턴 사이에 이어 쓰려면 "openai-thinking", Anthropic Messages 엔드포인트는 "anthropic"을 씁니다. 설정을 마쳤으면 터미널 에이전트나 브라우저 데모 스튜디오를 실행합니다:
# Persistent visual terminal conversation. Type /exit or press Ctrl-D to stop.
.venv/bin/python packages/harness/runtime/mac_agent.py

# Force the original line-oriented output (also useful for scripts and logs).
.venv/bin/python packages/harness/runtime/mac_agent.py --ui plain

# Or start the demo studio at http://127.0.0.1:8800.
bash packages/harness/runtime/start_demo.sh
macOS 하네스는 로컬 SKILL.md 워크플로를 필요할 때 불러 쓰는 Agent Skills ( Anthropic, Agent Skills 표준을 AAIF에 기증: SKILL.md는 그대로, 배포와 보안은 남은 과제)를 지원합니다. 처음에는 각 스킬의 이름과 짧은 설명만 모델에게 알리고, 사용자가 고르거나 에이전트가 skills.load("name")을 호출할 때 전체 지침을 불러옵니다. 한 세션에서 선택되는 스킬은 하나입니다. 저장소에는 PDF 양식 작성과 DingTalk 워크플로 두 가지가 들어 있으며, 스킬이 컴퓨터 권한을 주거나 스크립트를 자동 실행하지는 않습니다.
SDK만 따로 쓸 수도 있습니다. 패키지 이름은 qwen-intelligence-sdk이고 qwen_intelligence로 가져옵니다(mai_ui는 같은 API의 내부 이름). 아래 예시는 TextEdit의 접근성 트리와 창 목록을 모델에게 전달하며, 실행 전에 TextEdit을 열어 두어야 합니다:
import asyncio
from qwen_intelligence import Runtime

async def main():
    async with Runtime() as runtime:
        await runtime.add_macos(name="local-mac")
        async with runtime.session() as mu:
            mac = await mu.register("local-mac", name="mac")
            app = await mac.apps.get("com.apple.TextEdit")
            await mu.emit(await app.ui.ax.observe())   # TextEdit's accessibility tree
            await mu.emit(await app.windows.list())

asyncio.run(main())   # open TextEdit first
설치 과정이 부담스럽다면 GitHub 릴리스의 OpenGCUA-macOS-arm64.dmg를 받아 메뉴 막대 앱으로 쓸 수도 있습니다. Apple Silicon과 macOS 14 이상이 필요하고, 개발 빌드라 Apple 공증(notarization)을 받지 않은 상태입니다. 터미널 에이전트는 기능이 더 자주 바뀌고, 앱은 안정성 위주로 느리게 갱신된다고 개발팀은 설명합니다.
OpenGCUA의 라이선스
OpenGCUA는 Apache-2.0 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
 OpenGCUA 평가 궤적 탐색 페이지
 OpenGCUA 프로젝트 홈페이지
 OpenGCUA 기술 보고서: Toward a Fully Open Stack for Generalist Computer Use
 OpenGCUA GitHub 저장소
더 읽어보기
-
Cua Driver: Windows와 Linux 데스크톱 백그라운드 컴퓨터 사용 프로젝트 (feat. Claude Code, MCP)
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
c/ua, 고성능의 경량 컨테이너를 통해 직접 운영체제를 조작하는 프레임워크 (feat. Computer-Use Agent)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
